Nota do autor: hoje preciso chamar a API e continuo usando o grok-4.7. Até 2026-11-13, o Grok 4.8 ainda não tem ID de modelo; este artigo verifica, com base nas fontes, os 3 pontos fracos do Grok 4.7 e vê se o 4.8 já tem evidências de que os corrige.
Se você já chama grok-4.7 em produção, provavelmente está hesitando com uma coisa: vale a pena parar e esperar o Grok 4.8? Vamos direto à conclusão: se hoje você vai chamar a API, use grok-4.7. Até 2026-11-13, o Grok 4.8 não tem ID de modelo, nem model card, nem pontuação em leaderboard, nem preço. O “esta semana” dito por Musk é apenas um teste em pequena escala (soft rollout) para usuários do Grok Bot, não uma abertura de API.
Este não é um anúncio antecipado no estilo “a versão nova será necessariamente melhor”. O artigo compara apenas três pontos fracos que dá para confirmar nos dados públicos do Grok 4.7. Cada um vem com a fonte: auto-relato oficial, leaderboard de terceiros ou fala do próprio Musk. Depois, vemos se o Grok 4.8 já tem evidências de que os corrige.
Valor principal: ao terminar a leitura, você vai saber onde estão exatamente os pontos fracos do Grok 4.7, de quem são os dados e como controlar custos por faixas de 200 mil tokens antes do lançamento do Grok 4.8.
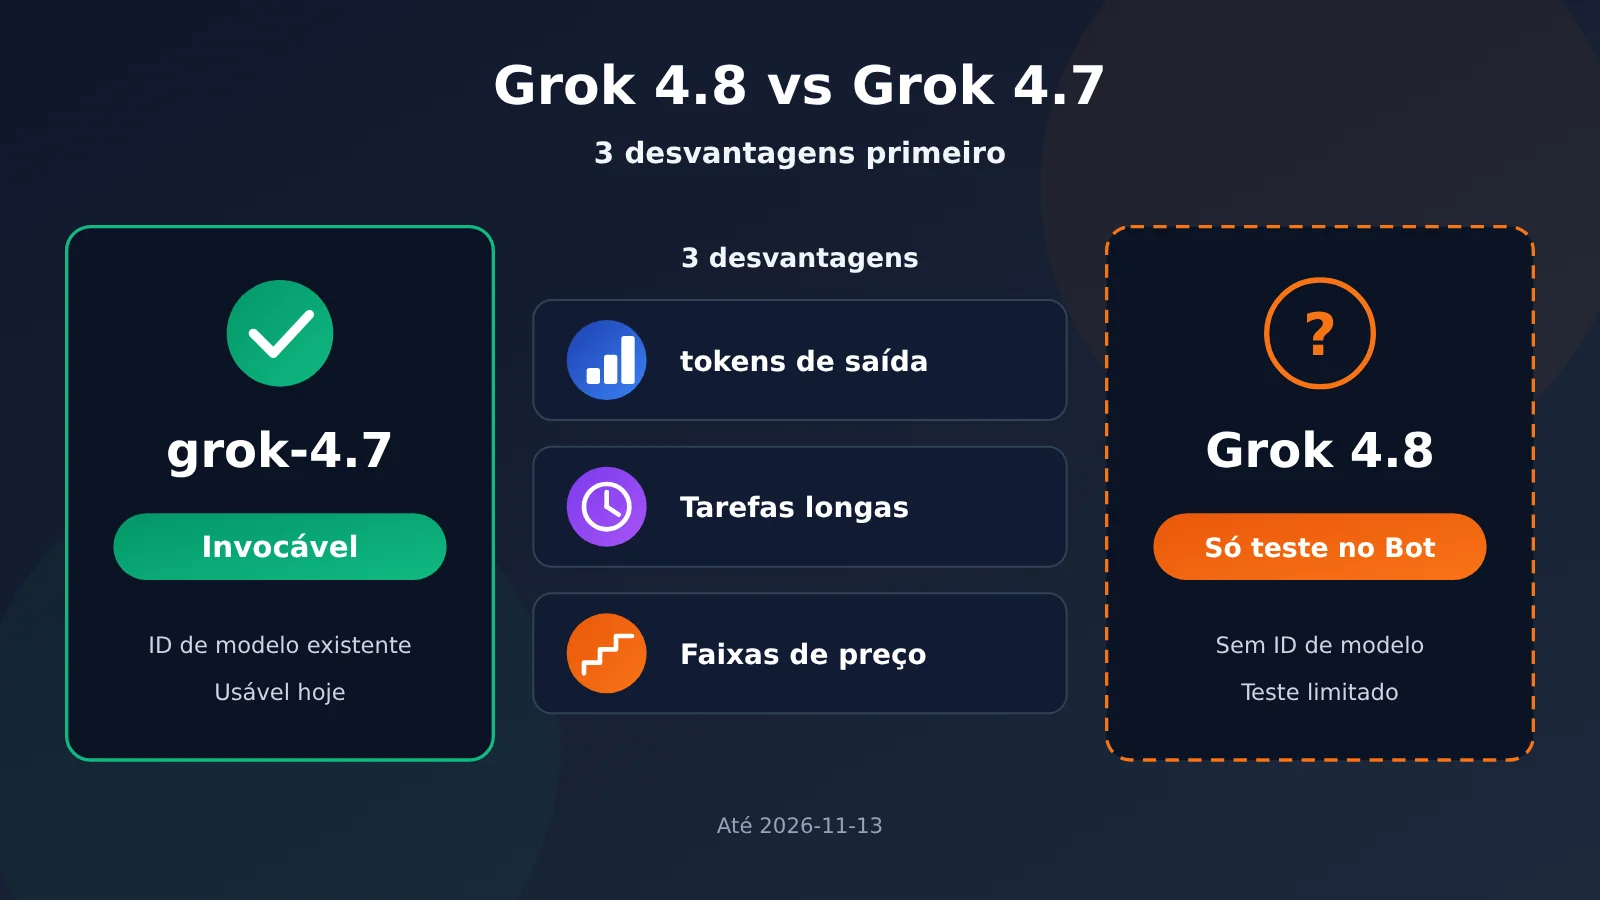
Grok 4.8 vs Grok 4.7: como escolher hoje
Esta comparação não se parece com as comparações habituais entre versões antigas e novas. O Grok 4.8, por enquanto, tem apenas algumas frases do Musk no X, sem nenhuma pontuação que possa ser verificada. Por isso, o sentido real de “comparação” aqui é: quais pontos fracos do Grok 4.7 já foram registrados em dados públicos e se as mudanças conhecidas do Grok 4.8 conseguem cobrir esses pontos fracos.
| Sua situação | Recomendação | Motivo |
|---|---|---|
| Precisa colocar em produção ou alterar a API esta semana | Use grok-4.7 | Na lista de modelos da plataforma só existe grok-4.7 |
| Está avaliando a escolha de longo prazo | Primeiro rode um baseline com grok-4.7 | O 4.8 não tem ranking, então não dá para comparar lado a lado |
| Quer testar o 4.8 o quanto antes | Fique de olho na lista de modelos da plataforma | O lançamento suave do Bot não significa que a API esteja disponível |
| Tem exigências extremamente altas para tarefas longas | Não deposite suas esperanças no 4.8 | Não há evidências de que a diferença em tarefas longas tenha diminuído |
Vale esclarecer que “Bot users” se refere aos usuários do Grok Bot, e não a robôs de hardware. “soft rollout” é uma liberação em pequena escala, não uma interface aberta para desenvolvedores. Tratar isso como “um ID de modelo que já pode ser trocado” vai levar diretamente a erros na chamada.
Grok 4.8 vs Grok 4.7: as diferenças centrais — de onde vêm os 3 pontos fracos
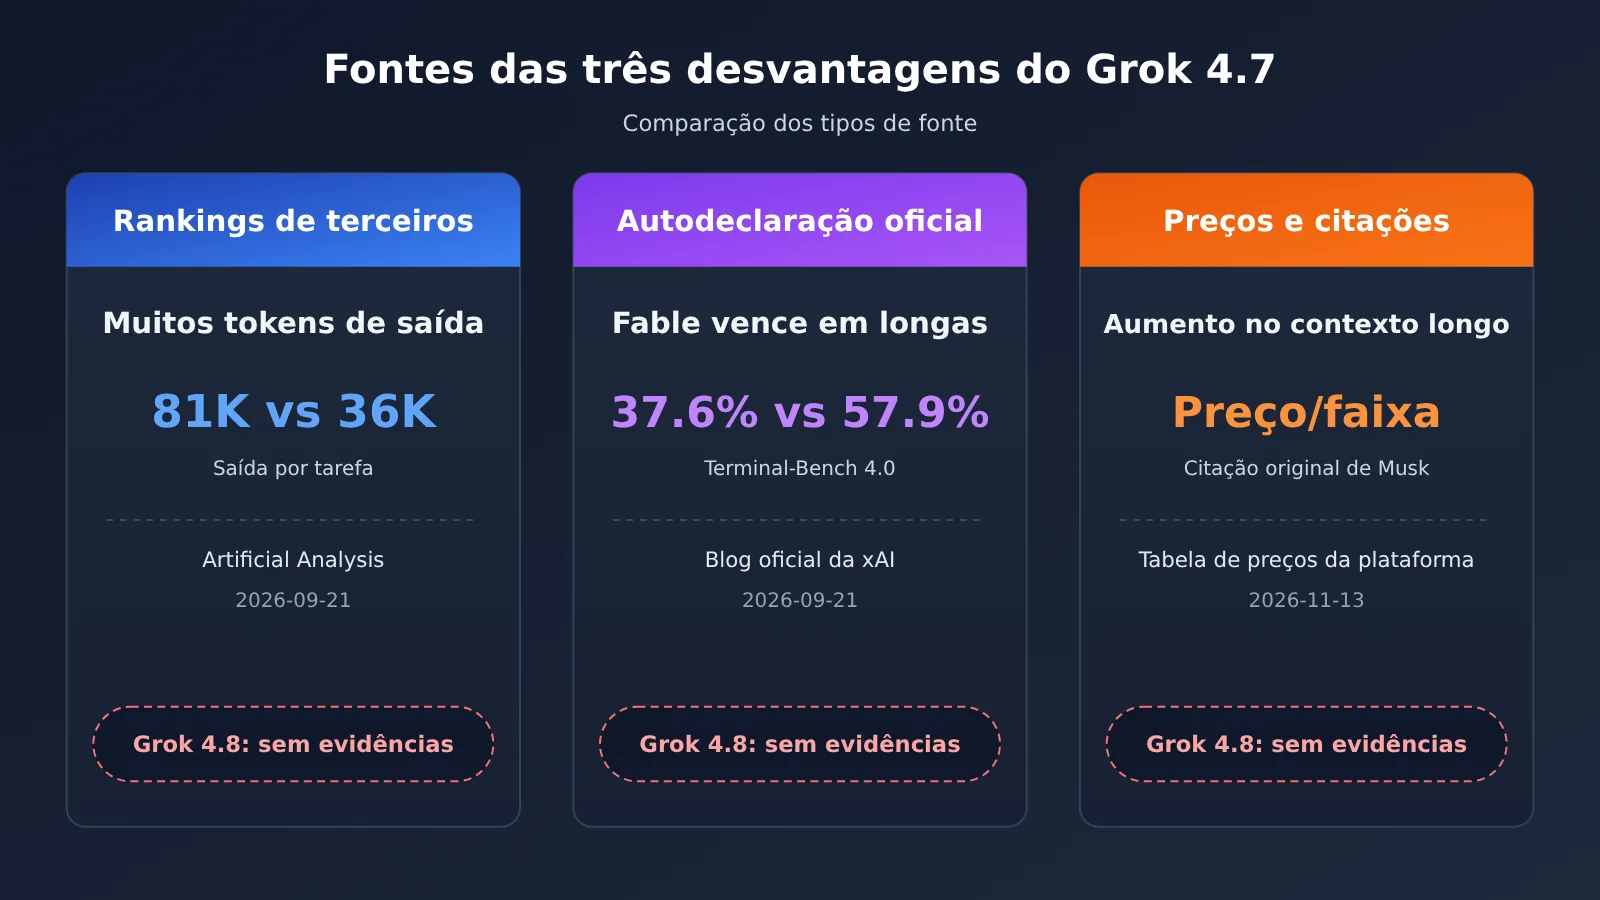
A tabela abaixo lista primeiro o tipo de fonte de cada um dos três pontos fracos. A análise a seguir segue rigorosamente essa ordem.
| Ponto fraco | Tipo de fonte | Data da fonte | Grok 4.8 tem evidência para compensar? |
|---|---|---|---|
| Tokens de saída em excesso | Ranking de terceiros (Artificial Analysis) | 2026-09-21 | Não |
| Fica atrás do Fable em tarefas longas de várias horas | Autorrelato oficial (tabela do blog da xAI) | 2026-09-21 | Não |
| Aumento de preço por faixa de contexto longo + Musk não reconhece a base | Tabela de preços da plataforma + fala original de Musk | 2026-11-13 / 2026-11-10 | Não |
Ponto fraco 1: Grok 4.7 gera tokens de saída em excesso (ranking de terceiros)
A fonte aqui é a avaliação do Grok 4.7 publicada pela Artificial Analysis em 2026-09-21. Trata-se de um ranking de terceiros, não de dados oficiais nem de testes feitos pelo autor deste artigo. Eles testaram no nível xhigh: o índice de inteligência do Grok 4.7 ficou em 46, dois pontos acima do Grok 4.6. A pontuação subiu, mas o preço disso foi um aumento perceptível nos tokens de saída.
A comparação de volume de saída da mesma avaliação está abaixo. Repare que os dois números do Grok 4.6 correspondem a níveis diferentes e não podem ser somados em um só:
- Grok 4.7 (xhigh): cerca de
81,000tokens de saída por tarefa do índice de inteligência - Grok 4.6 (high): cerca de
36,000tokens de saída - Grok 4.6 (xhigh): cerca de
38,000tokens de saída — a avaliação afirma que o 4.7 é mais que o dobro disso - GPT-6 Astra (max): cerca de
27,000tokens de saída
Para sentir a ordem de grandeza, dá para fazer uma conta rápida com o preço oficial de saída de $6 / 1M tokens: 81 mil tokens de saída dão cerca de $0.49, e 36 mil ficam em torno de $0.22. Isso é apenas uma forma de converter as tarefas do ranking, só para mostrar “onde o dinheiro vai em uma mesma questão” — não é a fatura real de nenhuma plataforma.
A Artificial Analysis também registra que o contexto do Grok 4.7 é de 500K, com preço de $2 / $6 e cache hit de $0.50, tudo igual ao 4.6. Ou seja: o preço unitário não subiu, mas cada tarefa cospe mais tokens — na prática, o custo por tarefa aumentou.
Ponto fraco 2: Grok 4.7 ainda fica atrás do Fable em tarefas longas de várias horas (dados oficiais da própria xAI)
Essa parte vem da tabela comparativa do blog oficial da xAI (2026-09-21), ou seja, são dados autodeclarados pela própria empresa. As quatro colunas do cabeçalho são, nesta ordem: Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max e Fable 5.1 Max. Os dois itens que melhor mostram a diferença nas tarefas longas são estes:
- Terminal-Bench 4.0: Grok 4.7
37.6%, Fable 5.1 Max57.9%(Grok 4.6 ficou em20.3%, GPT-5.6 Sol em37.3%) - CursorBench 4.0: Grok 4.7
46.3%, Fable 5.1 Max51.8%(Grok 4.6 ficou em40.4%, GPT-5.6 Sol em41.7%)
Mas a tabela oficial não significa “atraso em tudo”. O ganho do Grok 4.7 sobre o 4.6 é concreto, e ele lidera em dois benchmarks especializados:
- EEBench: Grok 4.7
64.0%, acima dos53.0%do 4.6, dos39.4%do GPT-5.6 Sol e dos56.4%do Fable 5.1 - Harvey Legal Agent Benchmark: Grok 4.7
19.6%, acima de15.8%/2.5%/6.7% - DeepSWE v1.1: Grok 4.7
71.0%, com a própria xAI observando que foi high effort, não xhigh, ligeiramente abaixo dos72.7%do GPT-5.6 Sol - AA Briefcase v1.1: Grok 4.7
1657, ligeiramente abaixo dos1678do Fable - HealthBench Professional: Grok 4.7
56.7%, abaixo dos60.5%do GPT-5.6 Sol e dos62.1%do Fable
| Benchmark da tabela oficial | Em relação ao Grok 4.6 | Em relação ao GPT-5.6 Sol | Em relação ao Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | claramente mais alto | praticamente empatado, um pouco mais alto | diferença evidente |
| CursorBench 4.0 | mais alto | mais alto | mais baixo |
| DeepSWE v1.1 | mais alto | ligeiramente mais baixo | ligeiramente mais alto |
| EEBench | mais alto | mais alto | mais alto |
| Harvey Legal Agent | mais alto | mais alto | mais alto |
| HealthBench Professional | mais alto | mais baixo | mais baixo |
Há ainda outro conjunto de dados de um ranking de terceiros, que precisa ser destacado à parte. A avaliação da Artificial Analysis mostra que, em relação ao Grok 4.6, o Grok 4.7 está 4.5 pontos acima no Terminal-Bench 4.0 e 3.0 pontos acima no GDP.pdf; mas está 3.7 pontos abaixo no AA-LCR e 1.1 ponto abaixo no AutomationBench-AA. Aqui, os “+4.5 pontos” e o 37.6% contra 20.3% da tabela oficial não pertencem ao mesmo conjunto de pontuações absolutas e não podem ser misturados.
Terceira lacuna: faixas de preço do Grok 4.7 e as palavras de Musk (tabela de preços + citação)
A terceira lacuna tem duas partes: primeiro, o preço para contexto longo; depois, a posição do próprio Musk em relação ao 4.7. Vamos começar pelo preço. A tabela geral da plataforma e a interface de preços não registram de forma totalmente consistente os valores acima de 200 mil tokens:
| Item de preço | Tabela geral de modelos da plataforma | Interface de preços billing_expr |
|---|---|---|
| Entrada / saída / leitura de cache até 200 mil tokens | Informado | Informado, consistente com a tabela geral |
| Entrada acima de 200 mil | Informado | Informado, consistente com a tabela geral |
| Saída acima de 200 mil | Não informado separadamente | Informado |
| Leitura de cache acima de 200 mil | Não informado separadamente | Informado |
Os números específicos são estes; os dados de preço têm data de 2026-11-13 e todos os valores são por 1M tokens:
- Faixa inferior (0–200,000 tokens): entrada
$2, saída$6, leitura de cache$0.5; a tabela geral e a expressão de preços são consistentes - Entrada na faixa superior (200,001–500,000 tokens):
$4; tabela geral e expressão de preços consistentes - Saída na faixa superior: a expressão de preços traz
$12; a tabela geral não traz essa faixa - Leitura de cache na faixa superior: a expressão de preços traz
$1; a tabela geral não traz essa faixa
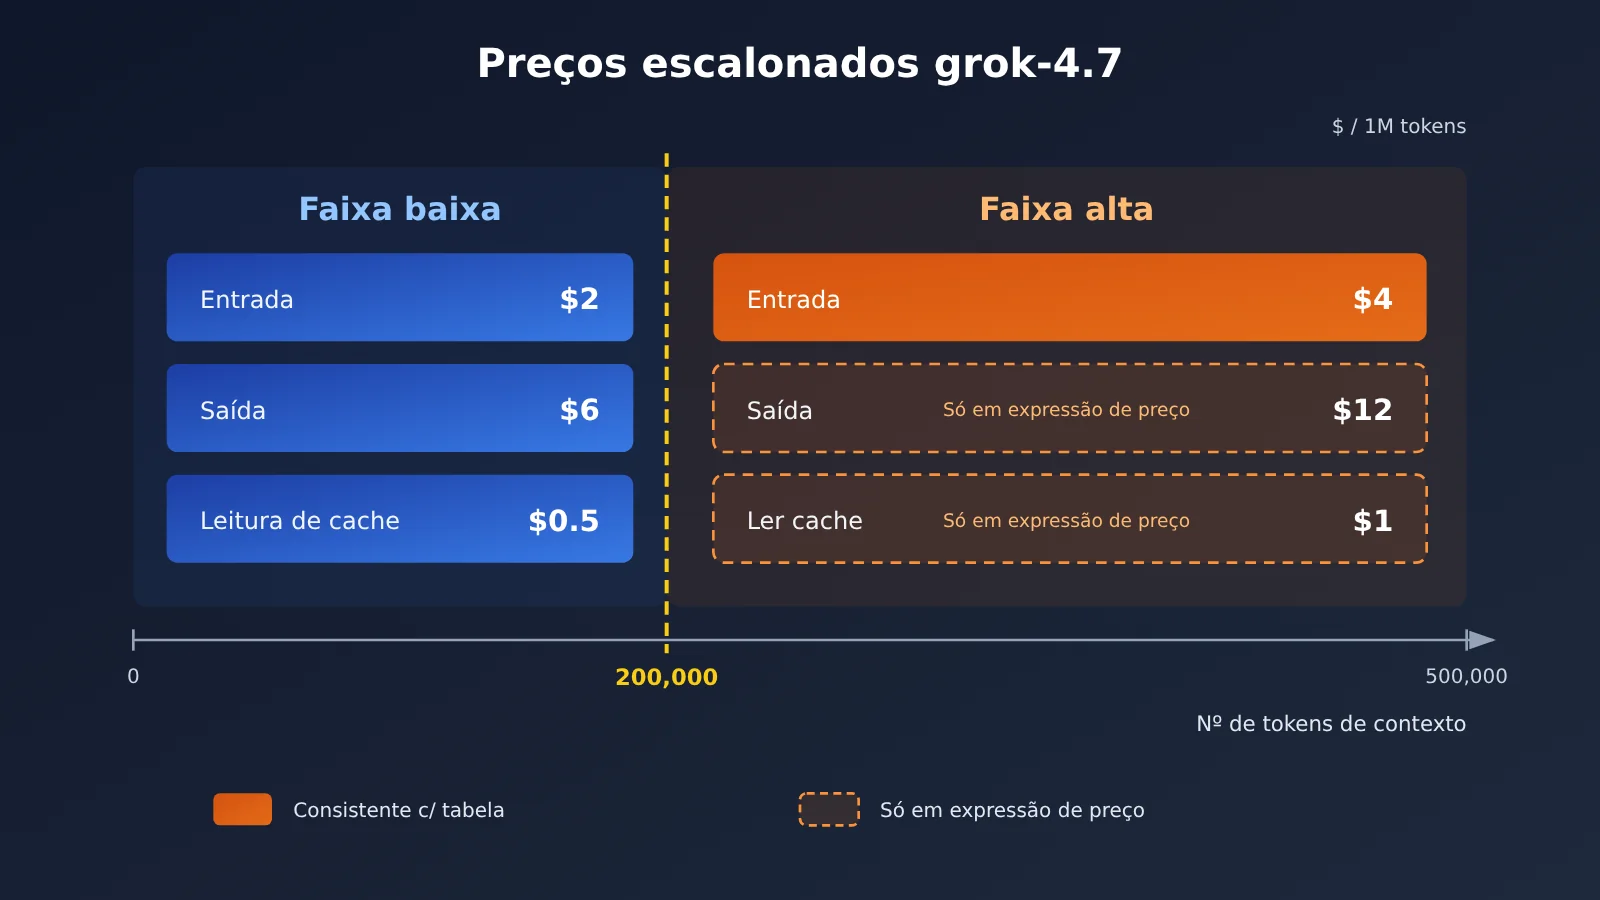
As informações de preço no diagrama acima vêm da interface de preços e da tabela geral de modelos da APIYI (apiyi.com); data de verificação: 2026-11-13; prevalece a lista de modelos da plataforma.
Agora, as declarações. Em 2026-11-10, às 17:35, Musk disse no X que o Grok 4.8 “will bear no resemblance to 4.7 (thankfully). It is not yet incredible”. No mesmo dia, às 18:22, ele respondeu dizendo “Not as good. Opus 5.5 is a masterpiece.”, ou seja, o 4.8 ainda não é tão bom quanto o Opus 5.5. Ele também estima que o Grok 5 pode superar o Opus 5.5 em dois ou três meses.
Essas são opiniões, não pontuações do Grok 4.8. Quando um fundador diz que a nova versão “não lembra o 4.7, ainda bem”, isso só mostra que ele não aprova a base do 4.7; não permite concluir que o 4.8 já tenha melhorado nas três lacunas acima.
O Grok 4.8 consegue cobrir essas 3 lacunas?
Só dá para falar do que está no post original do Musk. Ele menciona ter abandonado o JAX/SGLang e reescrito do zero, em C/C++, a stack de aprendizado por reforço (RL) e de inferência; o pré-treinamento já foi concluído; os dados de SFT passaram por uma limpeza pesada; e o 4.8 está atualmente na fase de RL, com “evals are starting to climb”. O post não traz nome de ranking nem pontuação, e também não informa o número de parâmetros.
Cruzando essas informações com as três lacunas, a conclusão é bem conservadora:
- Tokens de saída em excesso: a fase de RL até pode influenciar o comprimento da saída, mas ele não mencionou eficiência de tokens.
- Tarefas longas atrás do Fable: não há menção ao Terminal-Bench nem ao CursorBench, e nenhum dado sobre tarefas longas.
- Preço acima de 200 mil tokens: nenhuma informação de preço, e o 4.8 não aparece em nenhuma tabela de preços.
Então a especulação para no nível de “reescreveu a stack de RL e de inferência e limpou os dados de SFT”. Não há evidência de que as três lacunas acima tenham sido fechadas. Vale a pena esperar o 4.8 ganhar model card e rankings de terceiros para fazer a comparação item a item.
Agora, ao chamar o grok-4.7: como dividir as faixas de 200 mil tokens
Antes de o 4.8 chegar, o mais prático é controlar bem o custo do grok-4.7. O ponto-chave está na linha dos 200 mil tokens: assim que a entrada passa dela, o preço unitário dobra na hora, e pela expressão da tabela de preços a saída e a leitura de cache também dobram. Abaixo, informações de integração aplicáveis e sugestões de faixas:
- ID do modelo:
grok-4.7, endpoint chat, gruposCodexResponses,Default,SVIP - Endereço da API: formato compatível com OpenAI, base_url
https://api.apiyi.com/v1, basta definir model comogrok-4.7 - Controle da faixa baixa: mantenha o contexto de cada requisição dentro de
200,000tokens; use resumos e trechos recuperados em vez de enfiar o documento inteiro - Orçamento da faixa alta: se realmente precisar de contexto longo, estime com entrada
$4, saída$12e leitura de cache$1, e fique atento a esta inconsistência: a tabela geral não traz a saída da faixa alta - Comprimento da saída: considerando a primeira lacuna, defina max_tokens para as tarefas que precisam, evitando que a saída fuja do controle nos níveis de raciocínio mais alto
Modelos e preços seguem a lista de modelos da plataforma; as informações mais recentes estão em docs.apiyi.com/models. O blog oficial também menciona que o Grok 4.7 tem uma variante fast, com velocidade de saída cerca de duas vezes maior e preço cerca de duas vezes maior, mas a tabela geral da plataforma não tem um ID separado para o fast — na hora de chamar, não invente o nome por conta própria.
🚀 Início rápido: quando o grok-4.8 chegar, o APIYI (apiyi.com) vai disponibilizar esse modelo o mais rápido possível. Até lá, use a mesma chave API para rodar a linha de base do grok-4.7; quando o 4.8 estiver disponível, basta mudar o parâmetro model para comparar.
Grok 4.8 vs Grok 4.7: recomendações por cenário
Cenários em que faz sentido continuar com o Grok 4.7
- Tarefas técnicas de cunho jurídico e de engenharia: na tabela oficial, o Grok 4.7 ocupa o primeiro lugar em EEBench e em Harvey Legal Agent — não há motivo para esperar em tarefas desse tipo.
- Operações com contexto controlado dentro de 200 mil tokens: dá para ficar de forma estável na faixa de preço mais baixa, com preço unitário idêntico ao do 4.6.
- Projetos que precisam entrar em produção imediatamente: grok-4.7 é a única versão ajustável no momento.
Cenários em que vale continuar observando o Grok 4.8
- Agentes de várias horas / tarefas longas de terminal: a diferença em Terminal-Bench 4.0 e Fable 5.1 é evidente, então vale avaliar outros modelos em paralelo como alternativa.
- Tarefas em lote sensíveis ao custo de tokens de saída: rankings de terceiros mostram que a saída do 4.7 tende a ser mais longa; se o 4.8 melhorar isso, a redução de custo será direta — mas por enquanto não há evidências.
- Aplicações que dependem muito de contexto acima de 200 mil: o preço da faixa alta dobra, então vale ficar de olho em como será a cobrança depois que o 4.8 entrar no ar.
Grok 4.8 vs Grok 4.7: recomendações para a decisão
| Foco de atenção | Ação atual | Quando reavaliar |
|---|---|---|
| Estabilidade de produção | Usar grok-4.7 | Quando o 4.8 aparecer na lista de modelos da plataforma |
| Custo por tarefa | Controlar o contexto e o comprimento da saída | Quando houver dados de uso de tokens do 4.8 por terceiros |
| Capacidade em tarefas longas | Avaliar modelos alternativos em paralelo | Quando o 4.8 publicar notas como as do Terminal-Bench |
| Transparência de preços | Orçar com base na interface de tabela de preços | Quando a tabela geral da plataforma completar o preço da faixa alta de saída |
💡 Sugestão de escolha: qual versão escolher depende de sua tarefa ser longa ou não e de ela ultrapassar ou não os 200 mil tokens com frequência. A recomendação é rodar suas próprias amostras pela APIYI apiyi.com usando o mesmo conjunto de interfaces e só então decidir se vale migrar as tarefas longas para outro modelo.
Perguntas frequentes
Q1: O Grok 4.8 já pode ser chamado via API?
Não. Até 13/11/2026, o Grok 4.8 não tem ID de modelo; tanto a tabela geral de modelos da plataforma quanto o endpoint de preços listam apenas o grok-4.7. O lançamento discreto desta semana mencionado por Musk é voltado apenas para usuários do Grok Bot.
Q2: Grok 4.8 contra Grok 4.7 — afinal, qual é mais forte?
No momento não dá para julgar. O Grok 4.8 não tem nenhum ranking ou pontuação pública; Musk apenas disse que “as avaliações estão subindo”, “ainda não impressiona” e “fica atrás do Opus 5.5”. Isso é postura, não dado comparável.
Q3: De onde vem a afirmação de que o Grok 4.7 gera muitos tokens de saída?
Vem da avaliação independente da Artificial Analysis de 21/09/2026, no nível de teste xhigh. Cada tarefa gera cerca de 81 mil tokens de saída, contra 36 mil do 4.6 high e 38 mil do 4.6 xhigh. Não é dado oficial.
Q4: O Grok 4.7 piorou em tudo em relação ao Grok 4.6?
Não. Na tabela oficial, o Grok 4.7 fica acima do 4.6 em vários itens, como Terminal-Bench, CursorBench e EEBench. Já os rankings de terceiros mostram AA-LCR 3,7 pontos abaixo e AutomationBench-AA 1,1 ponto abaixo — são recuos pontuais.
Q5: Como chamar o grok-4.7 agora?
Cadastre-se na APIYI apiyi.com e obtenha uma chave API; novos usuários têm cota de teste gratuita. Use o SDK compatível com OpenAI, preencha o base_url com o endereço da interface da plataforma e defina model como grok-4.7.
Q6: Afinal, como é cobrada a saída acima de 200 mil tokens?
A expressão de preços indica saída a $12 e leitura de cache a $1; já a tabela geral traz apenas a entrada de faixa alta a $4, sem um item separado para saída de faixa alta. Os dois registros não são totalmente consistentes; na hora de fazer orçamento, recomendo estimar de forma conservadora pela expressão de preços e usar a lista de modelos da plataforma como referência.
Q7: Como migrar quando o Grok 4.8 for lançado?
O feed em tempo real da plataforma ainda não tem registro de lançamento do Grok 4.8. Depois que ele entrar no ar, normalmente basta trocar o parâmetro model; sugiro primeiro comparar, com o mesmo lote de amostras, tokens de saída, taxa de sucesso em tarefas longas e custo por faixa, e só então migrar o tráfego.
Grok 4.8 vs Grok 4.7 – Principais pontos (Key Takeaways)
- A escolha de hoje: se você precisa chamar a API, use grok-4.7 — o Grok 4.8 ainda não tem ID de modelo.
- Ponto fraco 1 (ranking de terceiros): em xhigh, são cerca de 81 mil tokens de saída por tarefa — output longo demais.
- Ponto fraco 2 (dados do próprio fabricante): Terminal-Bench e CursorBench ainda ficam atrás do Fable 5.1.
- Não é atraso em tudo: no EEBench e no Harvey, o Grok 4.7 está em primeiro lugar.
- Ponto fraco 3 (tabela de preços + declaração): acima de 200 mil tokens de entrada, o preço dobra — e o Musk não endossa a base do 4.7.
- O que se sabe sobre o 4.8: reescrita do RL e da stack de inferência, limpeza do SFT — mas nenhuma evidência de que os três pontos fracos tenham sido resolvidos.
- Como começar: rode primeiro a linha de base do grok-4.7 via APIYI (apiyi.com) e, quando o 4.8 entrar no catálogo, compare direto.
Resumo
Os pontos centrais da comparação Grok 4.8 vs Grok 4.7:
- Disponibilidade: até 13/11/2026, só o grok-4.7 pode ser chamado — lançamento soft do bot não significa API aberta.
- Três pontos fracos: excesso de tokens de saída (ranking de terceiros), atraso em tarefas longas em relação ao Fable (dados oficiais) e aumento de preço em contexto longo com a declaração do fundador (tabela de preços e citações) — cada um de uma fonte diferente.
- As evidências do 4.8: por enquanto só existem declarações sobre reescrita do RL e da stack de inferência e limpeza do SFT; não há notas, preços nem model card.
Em vez de parar e esperar, vale a pena primeiro ajustar as faixas de contexto e o comprimento de saída do grok-4.7 e, quando o 4.8 tiver dados verificáveis, comparar item por item. A recomendação é validar o desempenho do grok-4.7 no seu caso de uso via APIYI (apiyi.com), com uma interface unificada, deixando uma linha de base pronta para a migração futura.
📚 Referências
- Blog oficial da xAI — Lançamento do Grok 4.7: tabela comparativa de benchmarks e preços divulgada pela própria empresa
- Link:
x.ai/news/grok-4-7 -
Descrição: fonte dos dados de Terminal-Bench 4.0, CursorBench 4.0, EEBench e outros
-
Artificial Analysis — Avaliação do Grok 4.7: ranking de terceiros, incluindo consumo de tokens de saída
- Link:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
Descrição: índice de inteligência, comparação de tokens de saída, mudanças em itens como AA-LCR
-
Post de Musk no X (2026-11-10): declaração literal sobre o progresso do Grok 4.8
- Link:
x.com/elonmusk/status/2120088070443655190 -
Descrição: reescrita de RL e da stack de inferência, limpeza de SFT, lançamento suave do Bot
-
Resposta de Musk no X (2026-11-10): posicionamento sobre a comparação entre 4.8 e Opus 5.5
- Link:
x.com/elonmusk/status/2120099798078656909 -
Descrição: origem do “Not as good”
-
Tabela geral de modelos APIYI: modelos grok-4.7, grupos e preços escalonados
- Link:
docs.apiyi.com/models - Descrição: modelos e preços conforme esta referência, data de verificação 2026-11-13
Autor: Equipe técnica APIYI
Intercâmbio técnico: sinta-se à vontade para nos contatar pela página inicial do site APIYI; mais materiais estão disponíveis no centro de documentação docs.apiyi.com