Nota do autor: usando o Iceman, um modelo stealth gratuito sem dono declarado no OpenCode, como exemplo, este artigo separa três camadas de informação — declarações oficiais, parâmetros do catálogo e pistas não confirmadas —, apresenta um checklist de 5 verificações antes da integração e explica como combinar vários ids ao interpretar rankings de uso.
Gratuito, sem limite de requisições e com uma janela de contexto enorme, mas ninguém sabe quem o criou. Esse tipo de modelo stealth gratuito virou comum recentemente em ferramentas de programação, e muitos desenvolvedores pensam logo em “integrar ao projeto e testar”. Este artigo usa o Iceman, do OpenCode, como caso prático para responder a uma pergunta específica: o que você precisa confirmar antes de enviar código ou dados de negócio para um modelo gratuito de origem desconhecida?
Não é um artigo para te convencer a não usar. Modelos stealth gratuitos podem perfeitamente ser usados em validação de protótipos e experimentos com código público. O ponto é separar quais informações servem como base para o uso, quais são apenas boatos e que impacto real as cláusulas de treinamento e retenção terão sobre os seus dados.
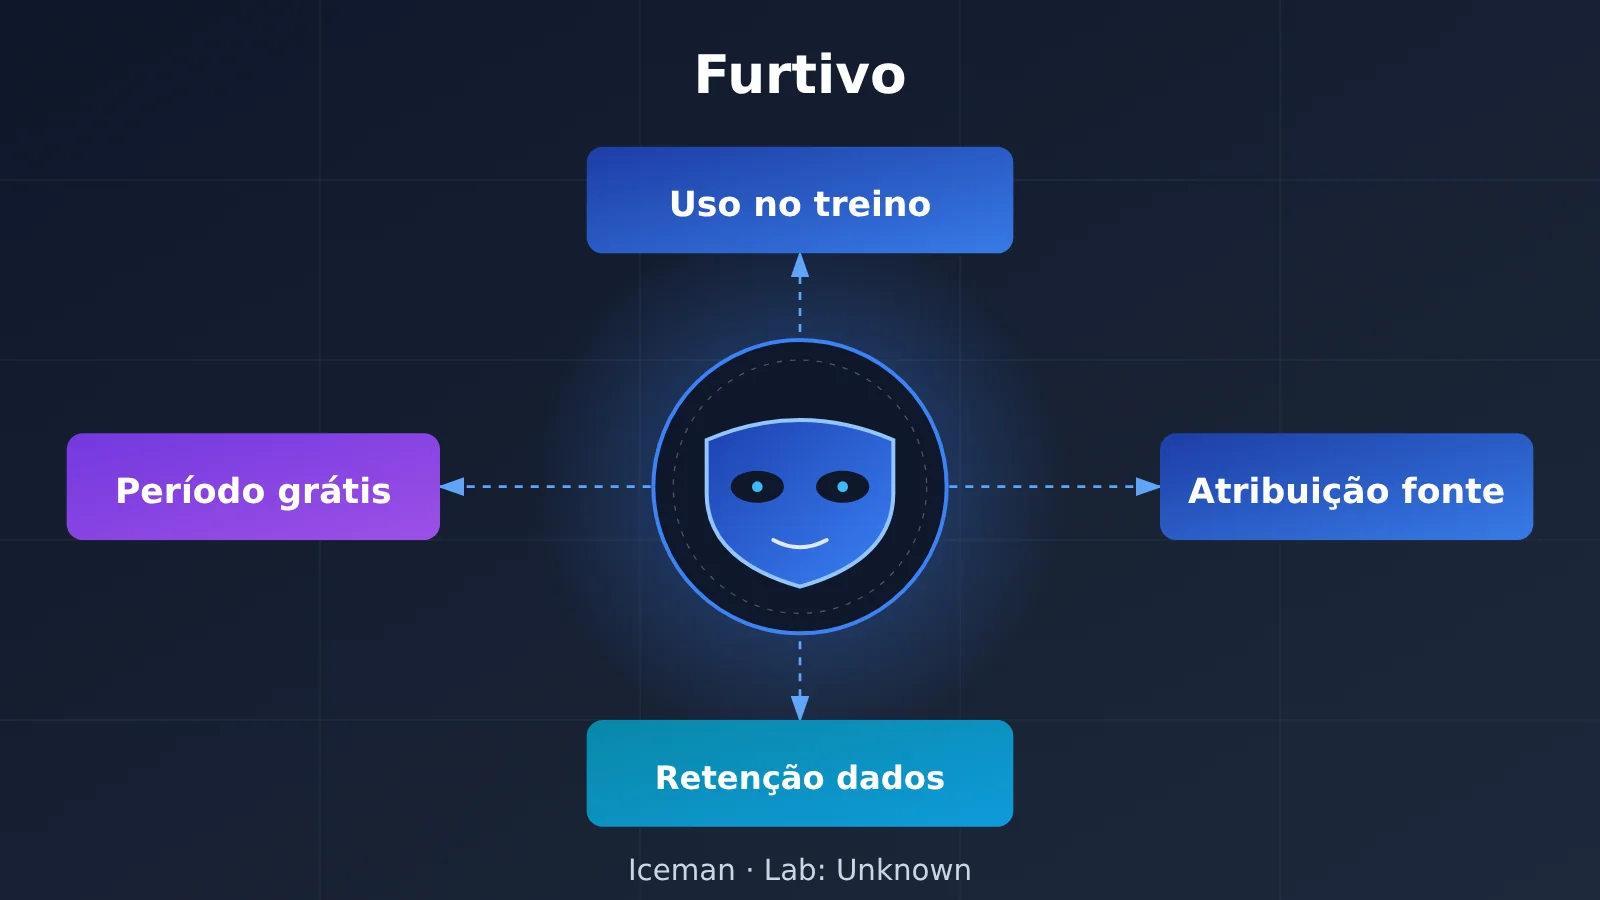
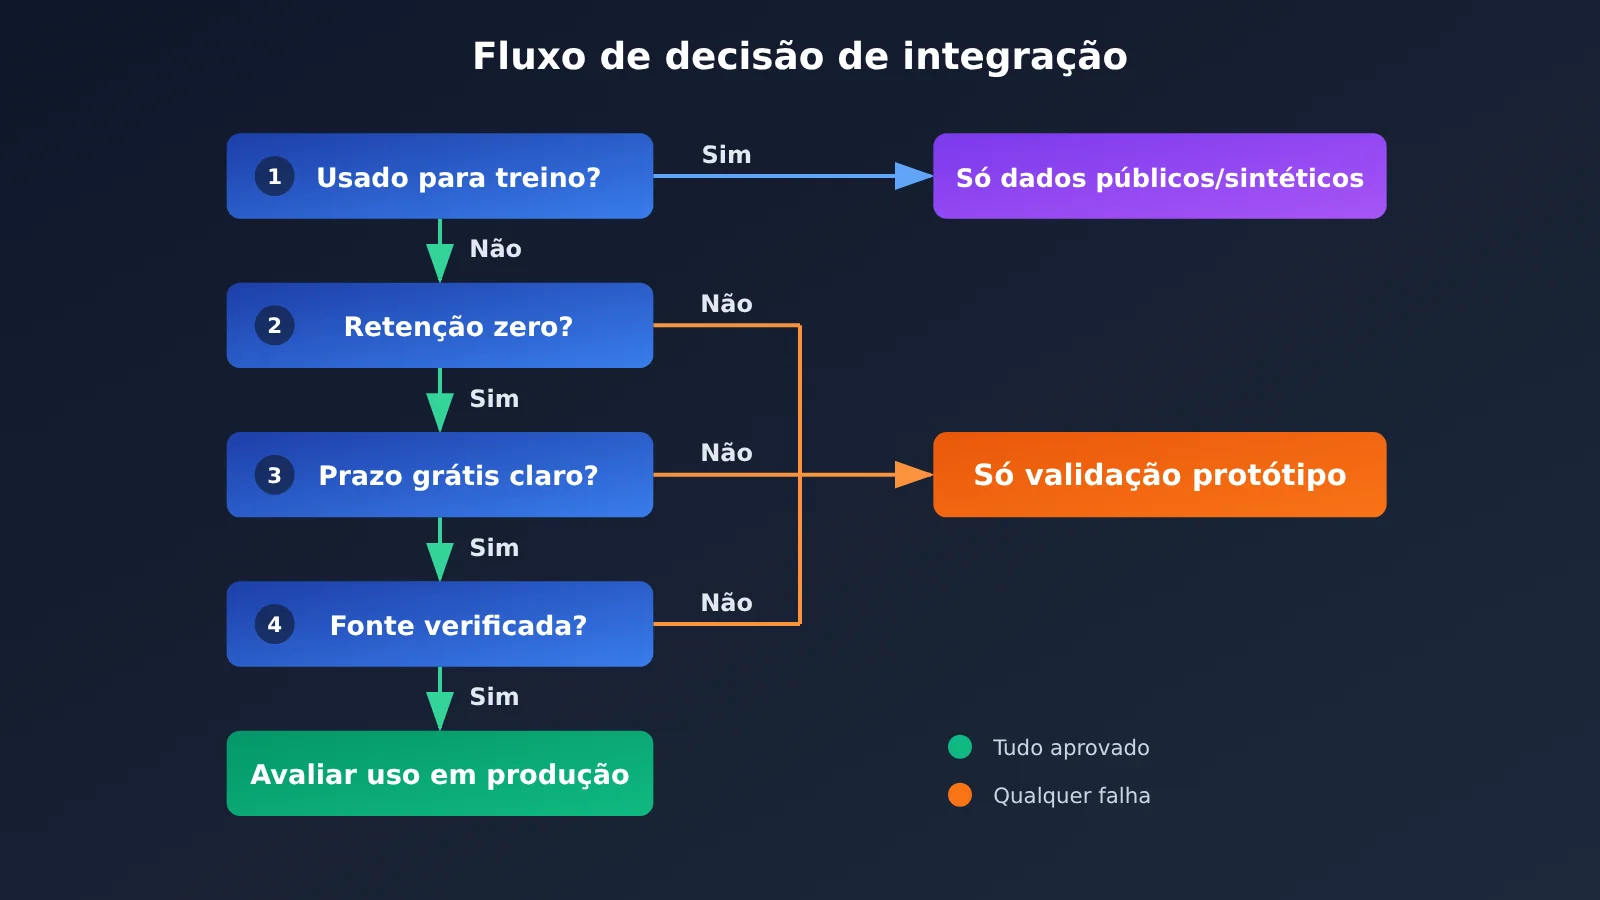
O que você leva deste artigo: ao terminar a leitura, você terá um checklist reutilizável para avaliar modelos stealth, cobrindo quatro dimensões: uso dos dados para treinamento, retenção zero de dados, prazo de gratuidade e atribuição de origem. Também vai aprender a identificar leituras erradas de rankings, como o “crescimento falso causado pela troca de id”.
Pontos principais do Iceman, o modelo stealth gratuito
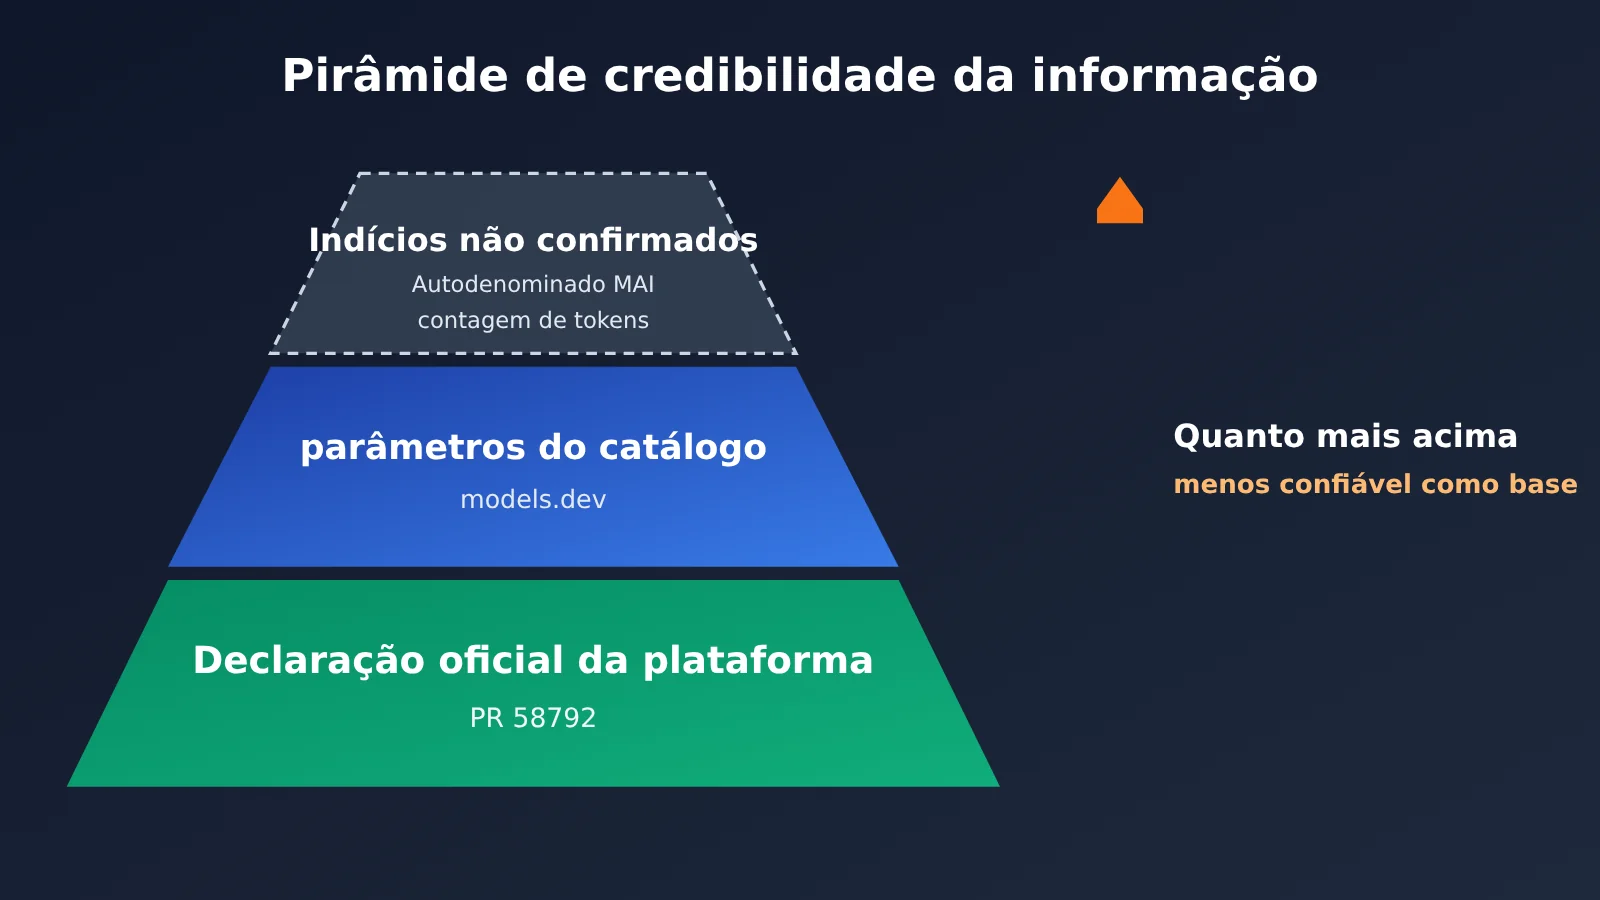
Até 2026-11-04 18:31 UTC, o Iceman ainda não havia sido reivindicado por nenhum laboratório de IA. Segundo os dados de uso do OpenCode, desde 23 de outubro ele acumulou cerca de 3,37 trilhões de tokens processados sob dois ids. A tabela abaixo separa as informações sobre ele em três camadas de confiabilidade — e é essa separação que sustenta todas as conclusões a seguir.
| Camada de informação | Conteúdo específico | Pode servir como base para uso? |
|---|---|---|
| Declaração oficial da plataforma | PR 58792 mesclado no OpenCode: gratuito por tempo limitado, sem limite de requisições, comandos usados para treinamento, retenção de dados diferente de zero | ✅ Sim, é um fato no nível dos termos |
| Parâmetros do catálogo | Catálogo models.dev: janela de contexto de 262.144 tokens, saída de até 131.072 tokens, suporte a raciocínio e chamada de ferramentas, texto entra e texto sai | ✅ Sim, para escolha técnica |
| Pistas não confirmadas | Rastreamentos de terceiros dizem que ele se autodenomina Microsoft MAI, e a contagem de tokens coincide com MAI Thinking 1 | ❌ Não, só pode ser tratado como boato |
Detalhes dos termos oficiais do modelo stealth Iceman
Em 24 de outubro, o OpenCode adicionou o Iceman ao plano Go de US$ 10 por mês, conforme o pull request 58792 do repositório, mesclado às 20:24 UTC. O nome do modelo é Iceman Contributor Free, e os termos dizem “gratuito por tempo limitado, sem limite de requisições”. A mesma alteração também marca duas coisas: os comandos enviados a ele serão usados para treinamento, e a política de retenção de dados não é de retenção zero.
Esses dois pontos são o que os desenvolvedores mais precisam observar. Eles determinam de forma mais direta do que a janela de contexto e o comprimento de saída quais dados podem ser enviados. Além disso, o PR adicionou esse id à lista de modelos stealth do OpenCode; por isso, a coluna do laboratório na página de uso aparece como Unknown. Em outras palavras, a própria plataforma deixa claro: a origem é desconhecida.
O verdadeiro significado de Contributor no nome dos modelos stealth
Muita gente interpreta o Contributor em iceman-contributor como o nome de algum laboratório ou contribuidor. Na verdade, ele se refere a um modelo de troca do OpenCode: dados de treinamento em troca de acesso gratuito. O Muse Spark 1.3 e 1.2, da Meta, também têm versões Contributor, o que mostra que se trata de um rótulo genérico da plataforma, e não de uma pista sobre a origem do modelo.
Portanto, ao ver Contributor, a leitura correta é “os dados deste canal vão para o treinamento”, e não “esta é a versão de contribuição de algum laboratório”. Esse ponto será o primeiro item da lista de verificação mais adiante.
O impacto das cláusulas de treinamento dos modelos furtivos gratuitos sobre código e dados privados
“Comandos usados para treinamento” soa abstrato, mas no projeto vira uma questão bem concreta: cada trecho de contexto que você envia pode se tornar amostra de treinamento do modelo de outra pessoa. No cenário de ferramentas de programação, o contexto geralmente não é só a pergunta que você digitou — inclui também conteúdos de arquivos carregados automaticamente, logs de erro, arquivos de configuração e até variáveis de ambiente.
Retenção de dados diferente de zero significa que o conteúdo da requisição fica armazenado no servidor por um tempo. Quanto tempo, onde, e quem processa: nada disso dá para confirmar quando a origem do modelo é desconhecida. Em projetos corporativos, isso costuma esbarrar direto em cláusulas de confidencialidade de contrato ou em exigências de conformidade de dados. A tabela abaixo lista os riscos reais por tipo de dado.
| Tipo de dado | Origem típica | Risco com treinamento + retenção não nula | Recomendação |
|---|---|---|---|
| Código aberto ou público | Repositórios públicos, projetos de exemplo | Baixo, o conteúdo já é público | Pode usar |
| Código de negócio privado da empresa | Repositórios internos, algoritmos centrais | Alto, pode vazar detalhes de implementação e arquitetura | Não recomendado enviar |
| Chaves e configurações | .env, arquivos de configuração, scripts de CI |
Extremamente alto, credenciais podem ser retidas e usadas em treinamento | Deve ser excluído |
| Dados pessoais de usuários | Logs, amostras de banco de dados, tickets | Extremamente alto, envolve conformidade de dados pessoais | Proibido enviar |
| Dados sintéticos ou anonimizados | Fixtures de teste, dados Mock | Baixo a médio, depende da qualidade da anonimização | Utilizável após anonimização |
Aqui vale um alerta especial para o problema do “contexto implícito” nas ferramentas de programação. Muitos agentes leem automaticamente os arquivos do workspace: você acha que só perguntou como escrever uma função, mas na prática toda a estrutura de diretórios e os arquivos vizinhos podem ter sido empacotados na requisição. Ao usar canais que treinam com os dados, o caminho mais seguro é trabalhar em um workspace isolado, contendo apenas dados públicos ou sintéticos.
Como verificar modelos stealth gratuitos: checklist de 5 itens antes da integração
A lista abaixo não é específica do Iceman; ela vale para qualquer modelo gratuito e sem origem reivindicada. Os quatro primeiros itens vêm dos termos e da atribuição; o quinto, da interpretação dos dados. Recomendamos transformar isso em um processo de revisão fixo dentro do time.
| Nº | Item de verificação | Onde confirmar | Status atual do Iceman |
|---|---|---|---|
| 1 | Os comandos são usados para treinamento? | Termos da plataforma, histórico de alterações na configuração do modelo | Sim, usados para treinamento |
| 2 | Há retenção zero de dados? | Termos da plataforma, aviso de privacidade | Não, não há retenção zero de dados |
| 3 | Qual é o prazo de gratuidade? | Anúncios da plataforma, descrição do plano | Diz apenas “por tempo limitado”; prazo desconhecido |
| 4 | A atribuição de origem foi confirmada? | Declaração oficial do laboratório | Não confirmada; o laboratório aparece como Unknown |
| 5 | Os dados de uso foram separados por id? | Todos os ids relevantes no ranking de uso | Sim, separados entre iceman e iceman-contributor |
Atribuição de origem de modelos stealth: por que pistas não são confirmação
Sobre a origem do Iceman, o site de rastreamento stealthmodels.com relata que a conta @aitrackerbot no X descobriu que o Iceman se apresenta como o MAI da Microsoft, e que o método de contagem de tokens de prompt é idêntico ao do MAI Thinking 1. Mas os próprios testes do site descobriram que ele coincide com o MAI Thinking 1 e também com a linha GPT-6 da OpenAI. Isso significa que a contagem de tokens não consegue distinguir esses modelos.
O “autodeclarado” do modelo também não é confiável: os modelos repetem informações de identidade presentes nos dados de treinamento e também podem ser deliberadamente definidos pelo comando de sistema. Até o momento, a Microsoft não fez nenhuma declaração. Portanto, o enquadramento correto dessa informação é “uma pista”, e não um fato que você possa registrar no seu documento de seleção técnica.
Precedentes históricos de reivindicação de modelos stealth
Olhando para modelos stealth anteriores do OpenCode, a reivindicação costuma acontecer no lançamento ou em poucas semanas. O ox-alpha foi reivindicado pela Z.ai como GLM-5.3 Flash, o cat-jam foi reivindicado pela Reflection AI como Beam, e o Space Bunny foi reivindicado pela MiniMax como M3.1 Flash 26 dias após a primeira aparição. Até 4 de novembro, o Iceman já estava no ar há 11 dias e seguia sem reivindicação.
O valor dos precedentes está em oferecer expectativa, não previsão. Ele mostra que a reivindicação pode levar algumas semanas e que, nesse período, escala, origem e duração da gratuidade do modelo são incógnitas; seu plano não pode depender dessas incógnitas.
Introdução rápida ao modelo stealth gratuito: interpretando o ranking de uso com a fusão de múltiplos ids
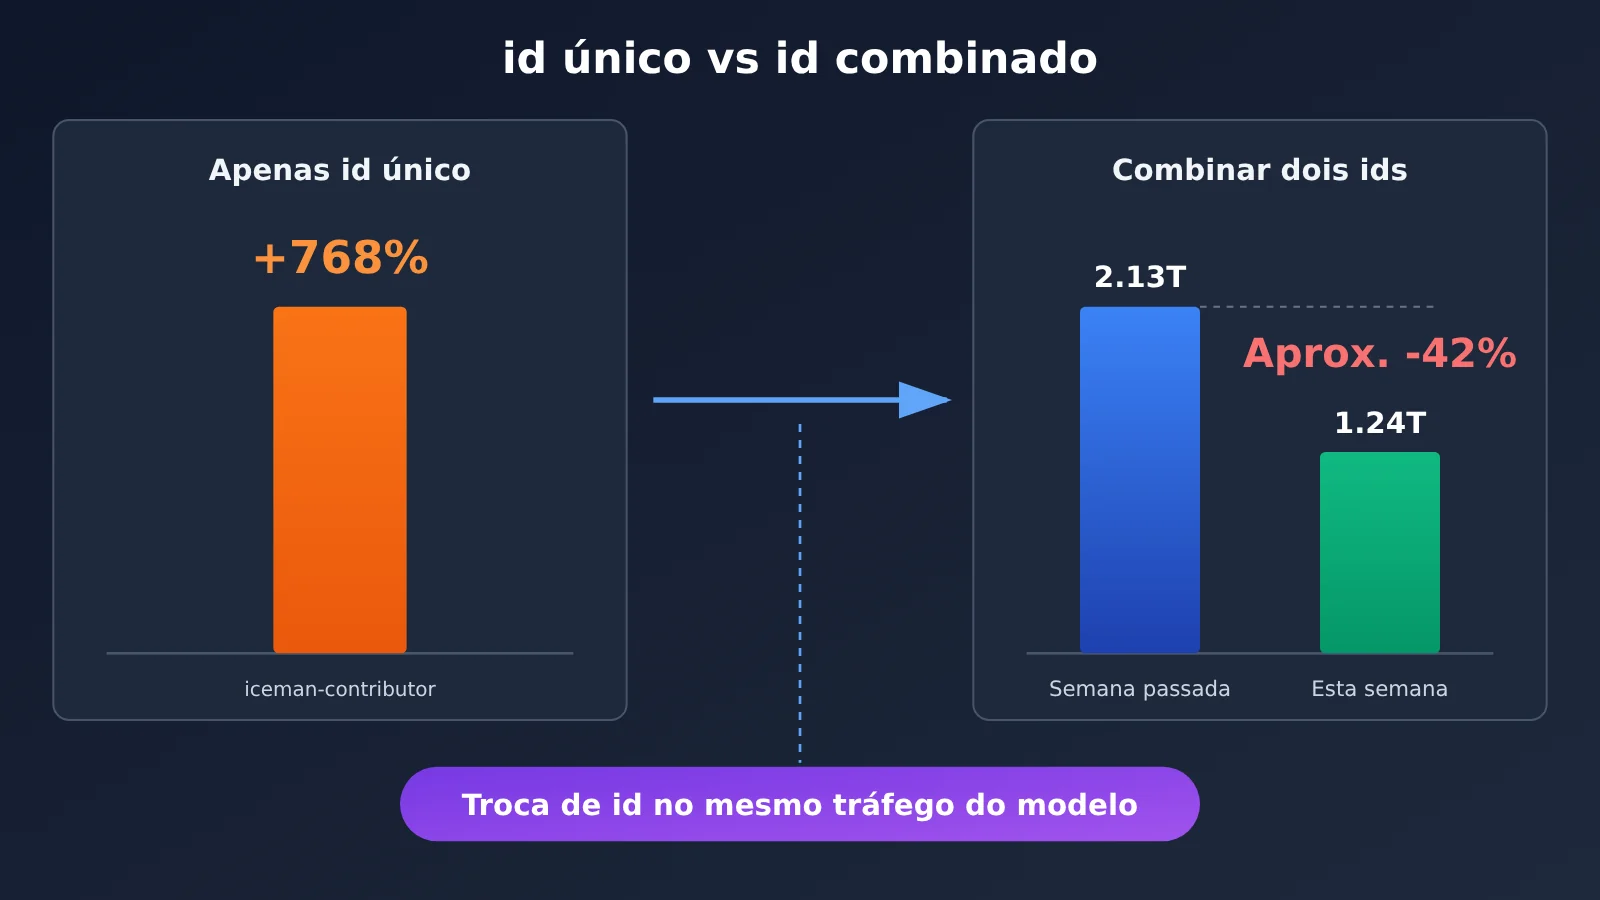
O desempenho do Iceman no ranking semanal do OpenCode é um caso clássico de leitura equivocada de榜单. Se você olhar apenas um único id, chega à conclusão de “crescimento explosivo”; somando os dois ids, a conclusão é exatamente o oposto.
| id | Posição no ranking semanal | Tokens desta semana | Variação vs. semana anterior |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| Total | — | aprox. 1.24T | aprox. -42% (aprox. 2.13T na semana anterior) |
O +768% não é crescimento, e sim o tráfego do mesmo modelo migrando de um id para outro. Os dois ids somados rodaram cerca de 1.24 trilhão de tokens nos últimos 7 dias, uma queda de aproximadamente 42% em relação aos cerca de 2.13 trilhões da semana anterior. O uso diário atingiu o pico de aproximadamente 653 bilhões de tokens em 28 de outubro, e entre 29 de outubro e 3 de novembro ficou entre 162 bilhões e 251 bilhões por dia.
Exemplo minimalista: mesclar ids para calcular a variação real semana a semana
O trecho de código Python abaixo demonstra a lógica de mesclagem, com dados extraídos dos números públicos citados acima. Os valores de cada id na semana passada foram inferidos a partir dos valores desta semana e da variação percentual, portanto são aproximados.
# Múltiplos ids do mesmo modelo, tokens desta semana (em bilhões) e variação semana a semana
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# Inferir o valor da semana passada a partir da variação: last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本周合计:{this_total}B")
print(f"上周合计(反推):{last_total:.0f}B")
print(f"合并后环比:{(this_total / last_total - 1):.1%}")
Ao executar, você chega a algo em torno de 1.237B nesta semana, na casa dos 2.100B na semana passada e uma variação combinada de aproximadamente -41% a -42%, o que bate basicamente com os dados totais divulgados na reportagem. A inferência reversa carrega erro de arredondamento, então em uma análise real o ideal é ler diretamente os dados semanais originais de cada id.
Ver a implementação completa: o gate de política de modelos antes da integração
O código abaixo transforma a checklist em um “gate de política” simples. Ele não chama a interface de nenhuma plataforma específica: apenas, com base nos metadados que você preenche depois da verificação manual, decide se um determinado tipo de dado pode ser enviado a um modelo. Você pode colocá-lo na frente da sua própria camada de roteamento de requisições.
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # item de verificação 1
    zero_data_retention: bool        # item de verificação 2
    free_until: Optional[str]        # item de verificação 3, None indica prazo desconhecido
    lab_confirmed: bool              # item de verificação 4
    related_ids: tuple = ()          # item de verificação 5, usado para consolidar estatísticas

# Nível de sensibilidade dos dados: 0 público, 1 anonimizado/sintético, 2 código privado, 3 chaves ou privacidade
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """Retorna o nível máximo de sensibilidade permitido para envio, com base nos termos do modelo"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # treinamento ou retenção não zero: apenas dados públicos e sintéticos
    if not p.lab_confirmed:
        return 1          # origem não reivindicada: igualmente limitado a dados de baixa sensibilidade
    return 2              # só depois de confirmar termos e atribuição é que se considera código privado

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # chaves e dados de privacidade nunca vão para canais gratuitos externos
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """Retorna a lista de problemas que impedem a adoção em produção; lista vazia significa que pode ir para avaliação"""
    issues = []
    if p.used_for_training:
        issues.append("提示词用于训练")
    if not p.zero_data_retention:
        issues.append("非零数据保留")
    if p.free_until is None:
        issues.append("免费期限未知,存在突然收费或下线风险")
    if not p.lab_confirmed:
        issues.append("来源未认领,无法评估模型规模与长期可用性")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允许' if can_send(iceman, kind) else '拒绝'}")

print("生产接入阻碍:", production_ready(iceman))
Sugestão prática: mantenha os metadados acima como uma configuração compartilhada pela equipe, atualizando-a sempre que os termos da plataforma ou o status de reivindicação do modelo mudarem. Assim, quando um novo colega for usar qualquer modelo gratuito, ele consegue reaproveitar exatamente o mesmo conjunto de critérios de decisão, em vez de decidir no achismo.
Perguntas frequentes (FAQ)
P1: O que é um modelo furtivo gratuito?
Um modelo furtivo (stealth model) é um modelo disponibilizado na plataforma sob um codinome, com a identidade do laboratório ainda não revelada. A página de uso da plataforma costuma mostrar a origem dele como Unknown. O Iceman é um dos integrantes da lista de modelos furtivos do OpenCode e, até 2026-11-04, ainda não havia sido reivindicado.
P2: Qual é a diferença entre Iceman e iceman-contributor?
Pelos dados públicos, são dois ids usados pelo ranking de uso do OpenCode para rastrear o mesmo modelo: no ranking semanal, um dispara e o outro despenca, mas na prática o tráfego apenas migra de um id para o outro. O termo “contributor” se refere ao modelo de troca da plataforma — “dar acesso gratuito em troca de dados de treinamento” — e não ao nome de um laboratório.
P3: Por quanto tempo dura o período gratuito do Iceman?
Não há resposta pública por enquanto. As alterações do OpenCode só dizem “gratuito por tempo limitado, sem limite de requisições”, sem data de encerramento. O tamanho do modelo, quem o desenvolve e a duração da gratuidade são informações ainda desconhecidas; por isso, não é recomendável basear uma solução de produção no status gratuito dele.
P4: Para quais cenários um modelo furtivo gratuito é mais indicado?
Partindo do princípio de que os termos deixam claro “uso para treinamento, retenção diferente de zero”, os cenários mais adequados incluem:
– **Experimentos em projetos open source**: lidar com código que já é público, como escrever exemplos ou testes para uma biblioteca open source.
– **Avaliação exploratória de capacidade**: usar questões sintéticas para testar o raciocínio e a chamada de ferramentas, entendendo o comportamento com uma grande janela de contexto.
– **Protótipos de aprendizado pessoal**: montar demos sem dados reais para verificar se o fluxo de interação é viável.
P5: Como aplicar essa checklist de verificação de modelos furtivos no time?
Sugiro três passos: primeiro, incluir as 5 verificações no documento de admissão de modelos; depois, bloquear na camada de roteamento conforme o nível de sensibilidade dos dados, como no portão de políticas descrito acima; por fim, configurar um workspace separado para as ferramentas de programação, evitando que o Agent carregue arquivos privados automaticamente. Quando os termos mudarem, basta atualizar os metadados.
P6: Se o modelo diz ser produto de determinada empresa, dá para confiar?
Não dá para confiar de imediato. A autoapresentação do modelo pode vir do corpus de treinamento ou do prompt de sistema, e a forma de contagem de tokens também pode ser idêntica entre vários modelos. No caso do Iceman, testes de terceiros descobriram que sua contagem coincide igualmente com a do MAI Thinking 1 e da série GPT-6, o que não permite distingui-los. A atribuição só vale quando confirmada oficialmente pelo laboratório.
P7: Depois que um modelo furtivo é reivindicado, o que acontece com os dados enviados antes?
A reivindicação só altera a informação sobre a origem; não muda os termos aplicáveis no momento em que você enviou os dados. Se, naquela época, os termos diziam que os dados seriam usados para treinamento com retenção diferente de zero, então a forma de tratamento já estava definida. É por isso que a verificação precisa acontecer antes do envio, e não depois da reivindicação.
Principais conclusões sobre modelos stealth gratuitos
- Primeiro veja os termos, depois os parâmetros: o uso para treinamento e a retenção de dados determinam o que você pode enviar; o comprimento do contexto só determina quanto você pode enviar.
- Contributor é um esquema de troca: significa trocar dados de treinamento por acesso gratuito, não indica a origem do modelo.
- Pistas não são confirmação: a identidade autodeclarada do modelo e a contagem de tokens não provam a quem ele pertence.
- Trate o prazo de gratuidade como desconhecido: o “por tempo limitado” não tem data de término; não dependa disso no seu plano.
- No ranking, combine os ids: o +768% do Iceman, depois de mesclar os ids, na verdade é cerca de -42%.
- Isole sempre dados sensíveis: chaves, dados privados e código central proprietário não devem ser enviados para canais de treinamento.
Resumo
Se um modelo stealth gratuito pode ou não entrar no projeto depende dos dados que você pretende enviar, não de ele ser gratuito. Usando o Iceman como exemplo, o que pode servir de base são os termos da plataforma e os parâmetros do catálogo: uso para treinamento, retenção de dados diferente de zero, gratuidade por tempo limitado, contexto de 262,144, suporte a raciocínio e chamada de ferramentas. O que não pode servir de base são as pistas sobre o desenvolvedor; antes de uma confirmação oficial, elas são apenas rumores.
A metodologia reutilizável pode ser resumida em três pontos:
- Separe as informações por camadas: distinga declarações da plataforma, parâmetros do catálogo e pistas não confirmadas; use apenas as duas primeiras para decidir.
- Use conforme a classificação dos dados: canais de treinamento devem lidar apenas com dados públicos ou sintéticos; código proprietário e dados privados devem ser tratados à parte.
- Leia rankings com os ids combinados: quando um mesmo modelo tem vários ids, some todos antes de calcular a taxa de crescimento, para não ser enganado por um crescimento falso causado pela troca de id.
Independentemente de quem venha a reivindicar o Iceman depois, esse método de verificação pode ser usado por muito tempo com o próximo modelo stealth que aparecer.
📚 Materiais de Referência
- ArtificialWatch – Análise de uso e atribuição do Iceman: fonte central dos fatos deste artigo
- Link:
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
Descrição: reúne os dados de uso dos dois ids do Iceman, as mudanças nos termos e as pistas de atribuição, publicados em 2026-11-04
-
Página de uso do OpenCode Data: dados de uso do iceman e do iceman-contributor
- Link:
opencode.ai/data -
Descrição: permite visualizar diretamente o ranking semanal e o consumo de tokens de cada id
-
Catálogo de modelos do models.dev: parâmetros técnicos do Iceman
- Link:
models.dev -
Descrição: fornece informações de catálogo como janela de contexto, saída máxima, raciocínio e chamada de ferramentas
-
Rastreamento de modelos stealth do stealthmodels.com: fonte dos relatos sobre pistas de atribuição
- Link:
stealthmodels.com - Descrição: registra testes sobre a identidade autodeclarada e a contagem de tokens do Iceman, apenas como referência de pistas
Autor: Equipe técnica da APIYI
Nota: As informações deste artigo estão atualizadas até 2026-11-04. O status de reivindicação e o prazo de gratuidade do Iceman podem mudar a qualquer momento; considere sempre os termos mais recentes da plataforma.