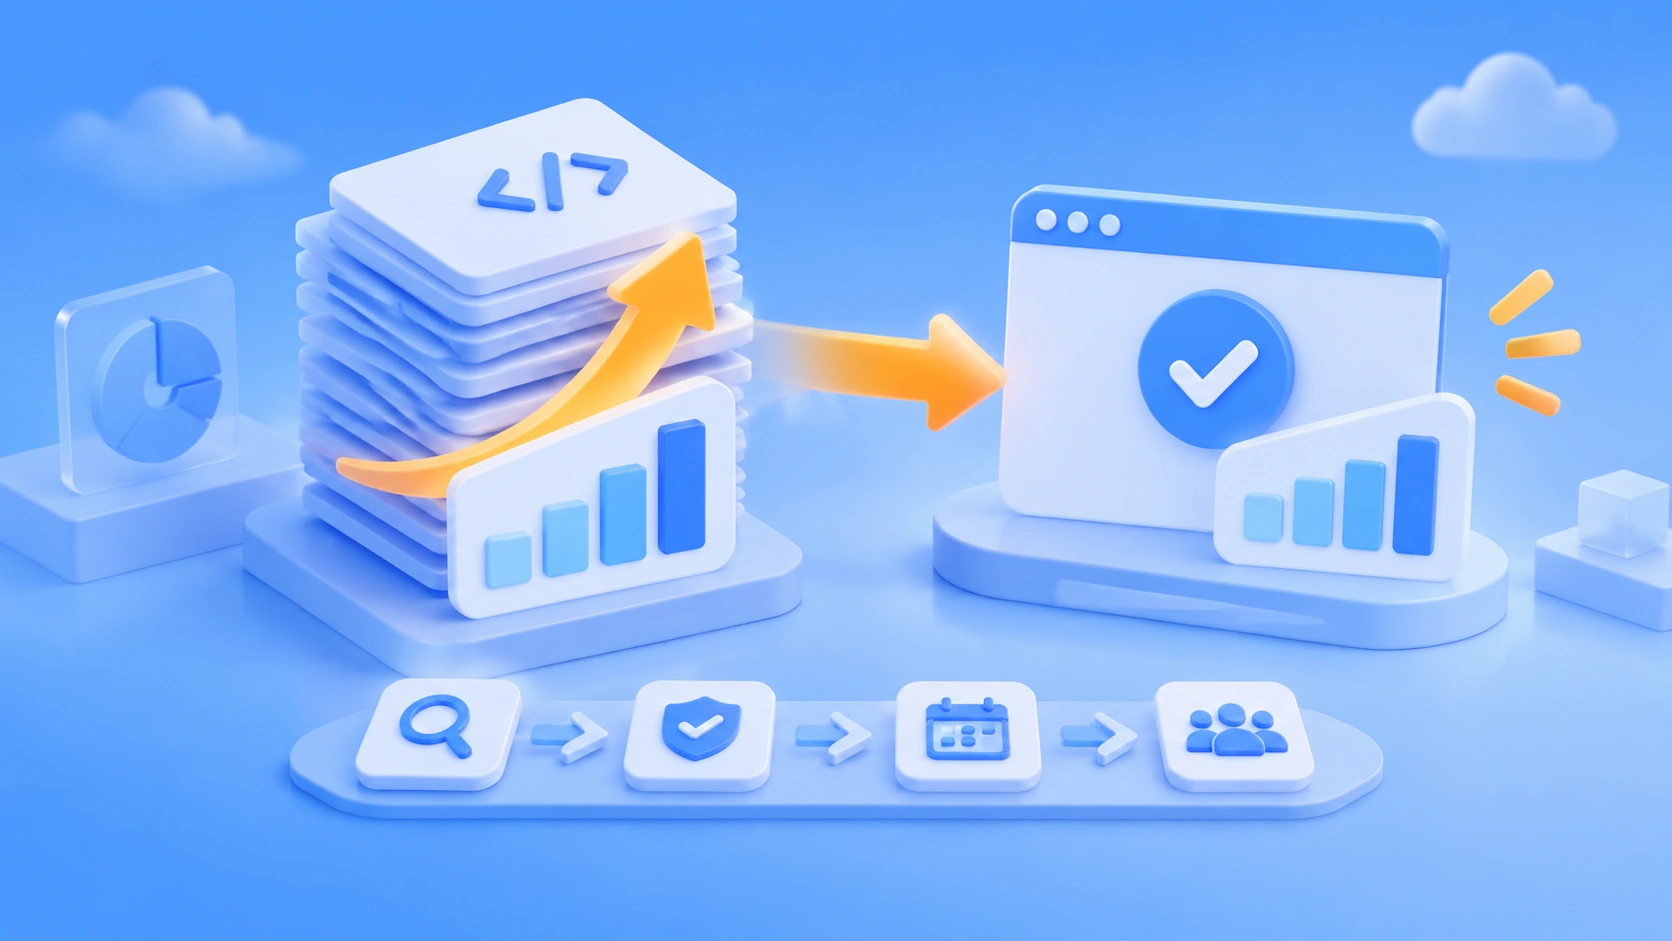
Nota do autor: agentes de IA fizeram o número de linhas de código crescer 30%, mas os tickets entregues cresceram apenas 12%. Este artigo usa dados de pesquisa para localizar o gargalo e apresenta etapas práticas de ganho de eficiência que o time pode aplicar imediatamente.
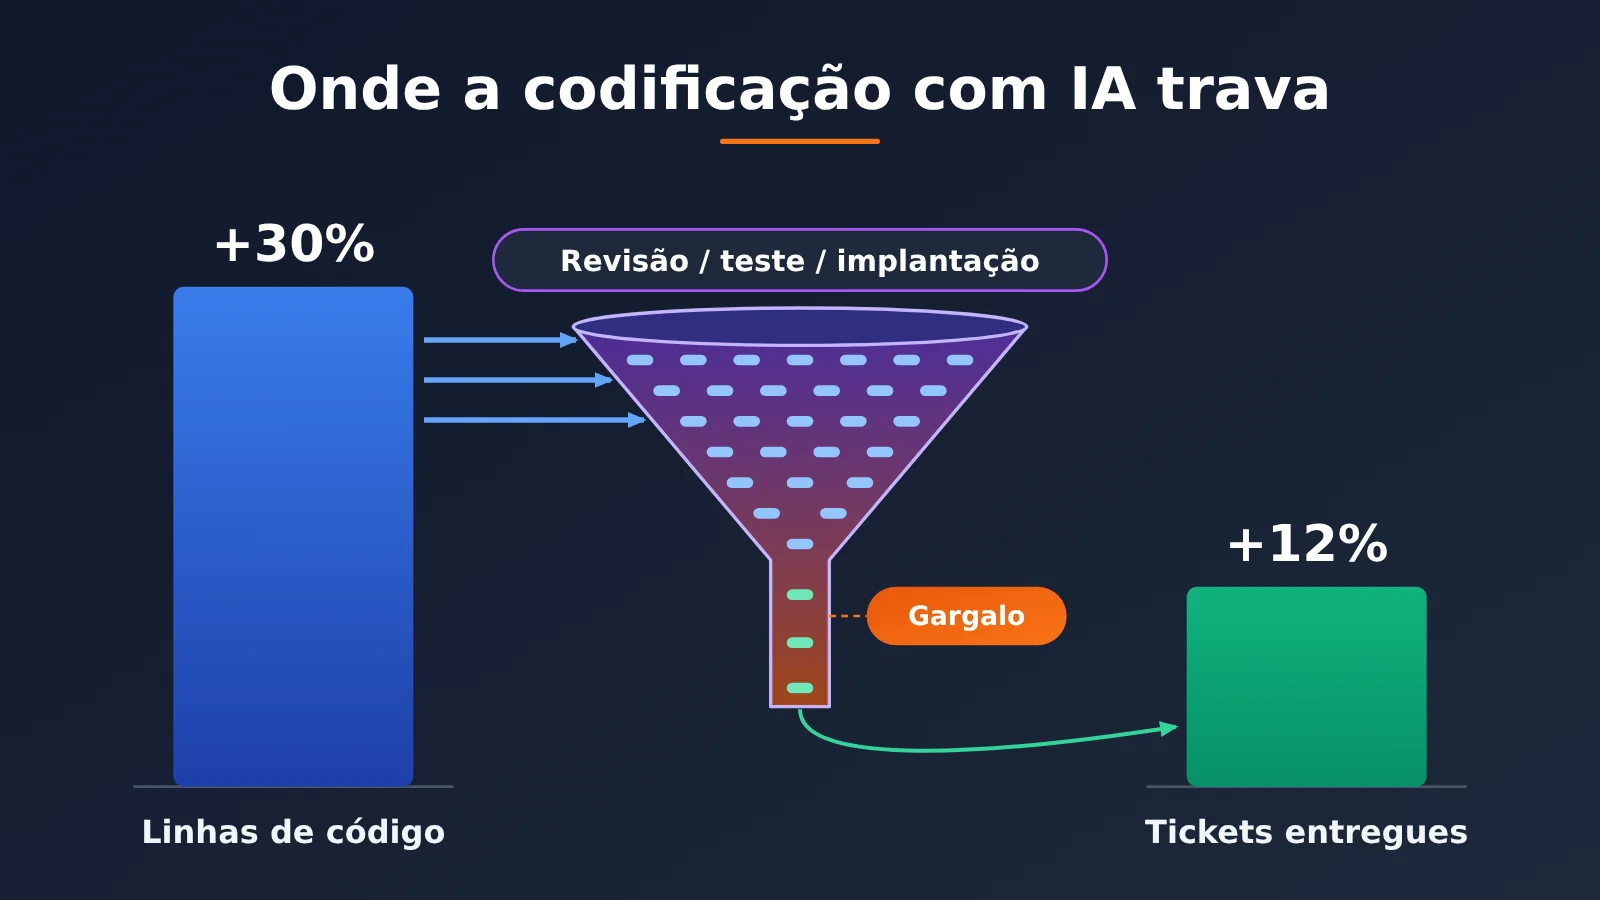
Muitos times, depois de adotar agentes de IA, percebem mais commits, mais pull requests, mas a entrega de demandas não acelera muito. Um estudo recente de Harvard, feito com a plataforma Jellyfish e cobrindo 718 empresas, chegou a uma conclusão quantitativa: o volume de código cresceu 30%, mas a entrega cresceu apenas 12%; a diferença é consumida principalmente por etapas posteriores, como a revisão de código.
Este não é mais um artigo pessimista sobre programação com IA. A conclusão do estudo é clara: agentes de IA realmente aumentaram a produção; o problema é que toda a pipeline de entrega não escalou junto. Este artigo primeiro decompõe os dados e depois apresenta um método em 5 etapas, da medição à reformulação de processos.
Valor central: ao terminar a leitura, você conseguirá identificar em qual etapa a eficiência da codificação com IA do seu time está travada e saber o que mudar primeiro e como medir se as melhorias estão funcionando.
Pontos principais sobre o gargalo de produtividade na codificação com IA
Esta pesquisa cobre o período de janeiro de 2021 a março de 2026, com mais de 700 empresas, 700 mil funcionários e cerca de 300 milhões de eventos de trabalho no total. As fontes de dados incluem informações de RH, sistemas de controle de versão de código, sistemas de tickets, ferramentas de agenda e registros de uso de ferramentas de IA generativa como GitHub Copilot, Cursor e Claude Code. O tamanho da amostra é bastante raro em estudos desse tipo.
| Ponto-chave | O que a pesquisa encontrou | O que isso significa para o time |
|---|---|---|
| Crescimento da produção | Agentes de IA trazem +30% em linhas de código, +20% em commits e +23% em pull requests | A etapa de codificação de fato ficou mais rápida |
| Crescimento da entrega | O número de tickets resolvidos por pessoa por mês cresceu apenas 12% | A produção não se converteu em entrega na mesma proporção |
| Distribuição do tempo | Engenheiros passam só 30%–40% do tempo escrevendo código | Otimizar apenas a codificação tem um teto baixo |
| Pressão sobre a revisão | Tempo de revisão +49%, comentários +53% e proporção de pull requests que precisam de retrabalho dobrou | O gargalo migrou para a etapa de revisão |
| Revisão com IA | Mesmo com revisão assistida por IA, a proporção de pessoas envolvidas na revisão ainda aumentou 14% | Apenas adicionar ferramentas de revisão com IA não resolve o problema |
Entendendo a diferença de produtividade entre assistentes de IA e agentes de IA
A pesquisa separou dois tipos de ferramenta. Os assistentes de programação (voltados principalmente a autocomplete e conversa) trouxeram ganhos pequenos: +12% em linhas de código, +9% em commits e +5% em pull requests; desses, apenas o crescimento de commits teve significância estatística. Mais importante ainda: os assistentes de programação não aumentaram a quantidade de tickets resolvidos, ou seja, quase não tiveram impacto mensurável na entrega.
Já os agentes de IA (capazes de concluir tarefas de várias etapas de forma autônoma) cresceram de forma significativa nas três métricas de produção e trouxeram um aumento de 12% nos tickets. Isso mostra que “deixar a IA assumir a tarefa inteira” vale mais do que “pedir para a IA completar algumas linhas”, mas também significa que o volume de código e a carga de revisão que chegam às etapas seguintes crescem juntos. A pesquisa também destaca que o aumento da carga de revisão não pode ser explicado pelo tamanho maior de um único pull request; o problema é que o próprio código exige mais discussão e alteração.
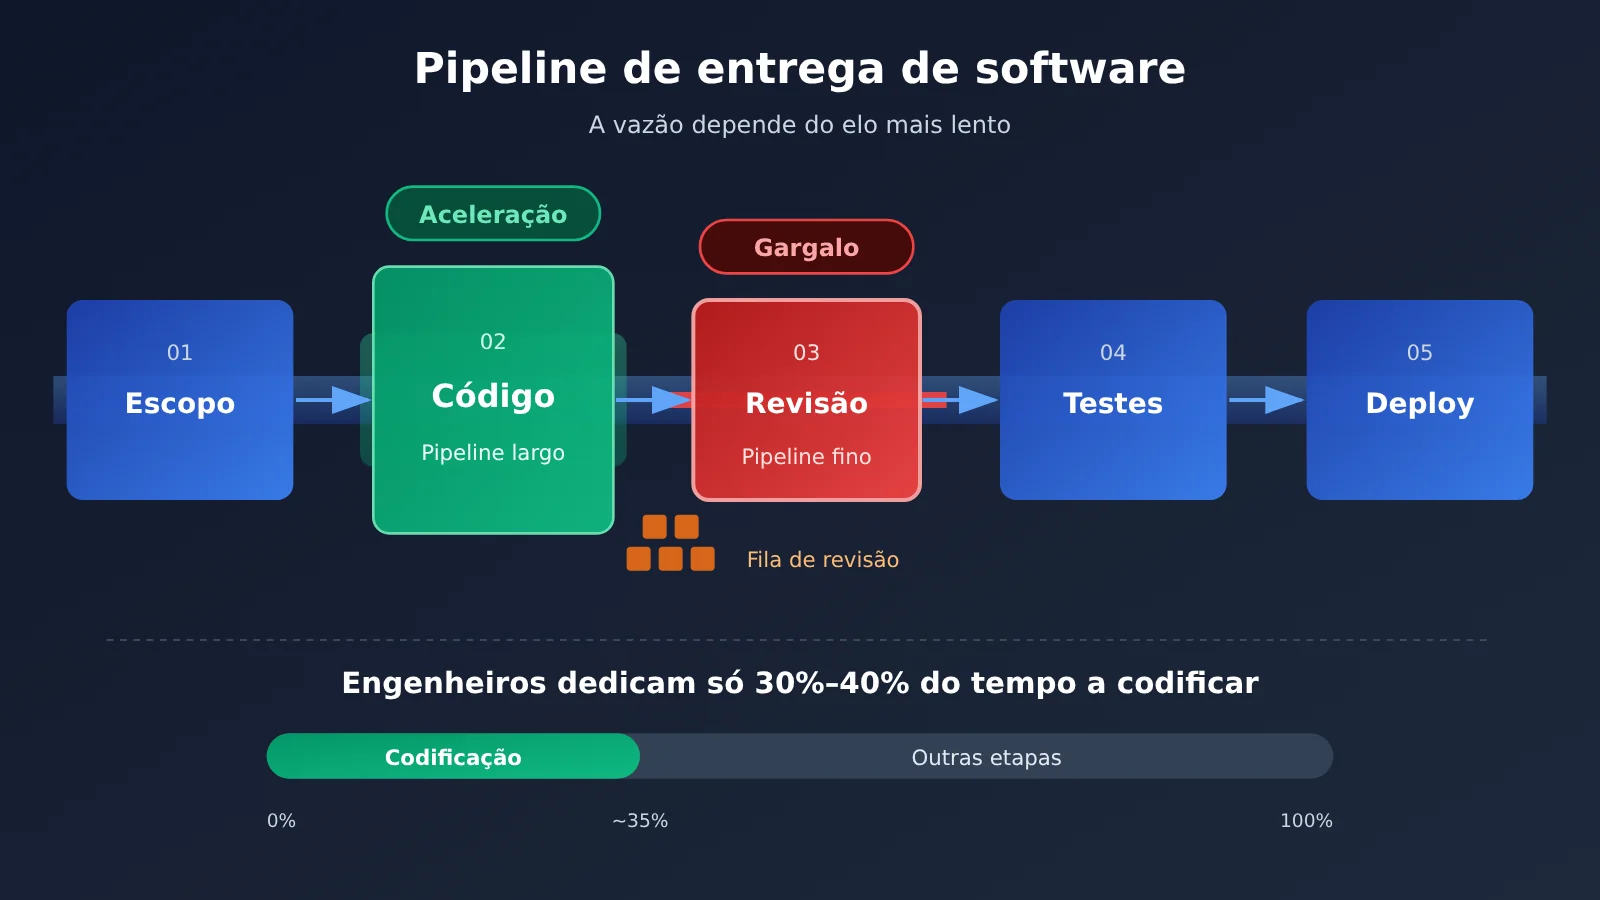
Onde está o gargalo do ganho de eficiência na codificação com IA: entendendo pela Teoria das Restrições
A vazão de um pipeline de entrega depende do elo mais lento. Quando a codificação representa apenas 30%–40% do tempo do engenheiro, mesmo dobrando a velocidade de codificação, o ciclo total seria reduzido em no máximo cerca de um terço — e, na prática, a codificação acelerada ainda despeja mais trabalho pendente na revisão e nos testes.
Alguns números da pesquisa montam a cadeia causal completa: os agentes escrevem mais, e o número de pull requests cresce; o número de comentários por pull request aumenta 53%, indicando que os revisores precisam gastar mais esforço para entender e questionar o código escrito pela IA; a proporção de pull requests que precisam de alterações dobra, mostrando que a qualidade do primeiro envio está caindo. Esses custos recaem todos sobre os revisores humanos — que são justamente as pessoas mais experientes e com menos tempo disponível na equipe.
| Etapa | Mudança trazida pela IA | Sintomas típicos | Prioridade |
|---|---|---|---|
| Planejamento e escopo | Quando a descrição do requisito é vaga, a IA escreve “com confiança” na direção errada | Retrabalho, pull request totalmente descartado | Alta |
| Codificação | Velocidade melhora visivelmente | Volume de código explode, a produtividade individual parece ótima | Já otimizada |
| Revisão de código | Quantidade para revisar e complexidade sobem ao mesmo tempo | Fila de revisão, vai-e-vem de comentários | Máxima |
| Testes | Cobertura não acompanha o volume de código novo | Aumento de regressões | Alta |
| Deploy e operação | Entendimento do código pelos engenheiros fica mais raso | Diagnóstico de falhas mais lento | Médio e longo prazo |
As discussões na comunidade também confirmam isso. Um desenvolvedor comentou que “cada linha de código é um risco em potencial”, e outro apontou que o agente é um colaborador pouco confiável, que pode fazer coisas absurdas só para concluir a tarefa. Há ainda a visão de que o tempo médio de recuperação de falhas (MTTR) se tornará um indicador importante para avaliar o impacto da IA, porque quanto mais raso o entendimento do engenheiro sobre o código que ele mesmo entregou, mais difícil fica o diagnóstico.
Guia rápido para acelerar a programação com IA: método de 5 passos para destravar
Os métodos abaixo estão organizados em ordem crescente de esforço de implementação, e a equipe pode avançar na sequência. Em cada etapa, procure definir métricas mensuráveis para evitar conclusões do tipo “parece que ficou mais rápido”, que não podem ser verificadas.
Passo 1: estabeleça a linha de base de entrega da produtividade em programação com IA
Não saia trocando de ferramenta antes da hora: primeiro monte o sistema de medição. A pesquisa só conseguiu identificar a discrepância porque olhou ao mesmo tempo para métricas de produção e de entrega. Muitas equipes olham apenas para linhas de código e número de commits e acabam achando que ganharam muita produtividade.
Recomenda-se acompanhar dois grupos de métricas ao mesmo tempo: no lado da produção, número de commits e de merge requests; no lado da entrega, tickets encerrados por pessoa por mês e o ciclo da demanda desde o início até o deploy. Some a isso três métricas de revisão: tempo médio de revisão de um merge request, número de comentários por merge request e proporção de retrabalho. Em geral, esses dados podem ser exportados diretamente da plataforma Git e de sistemas de tickets como o Jira.
| Categoria de métrica | Métrica específica | Fonte dos dados | O que observar |
|---|---|---|---|
| Produção | Número de commits, número de merge requests | Plataforma Git | Apenas referência, não usar para avaliação de desempenho |
| Entrega | Tickets encerrados por pessoa por mês, ciclo da demanda | Sistema de tickets | Métrica principal |
| Revisão | Tempo de revisão, número de comentários, taxa de retrabalho | Plataforma Git | Alerta de gargalo |
| Qualidade | Número de incidentes em produção, MTTR | Monitoramento e registro de incidentes | Saúde de longo prazo |
Etapa 2: Antecipar o planejamento de requisitos para o agente de codificação de IA
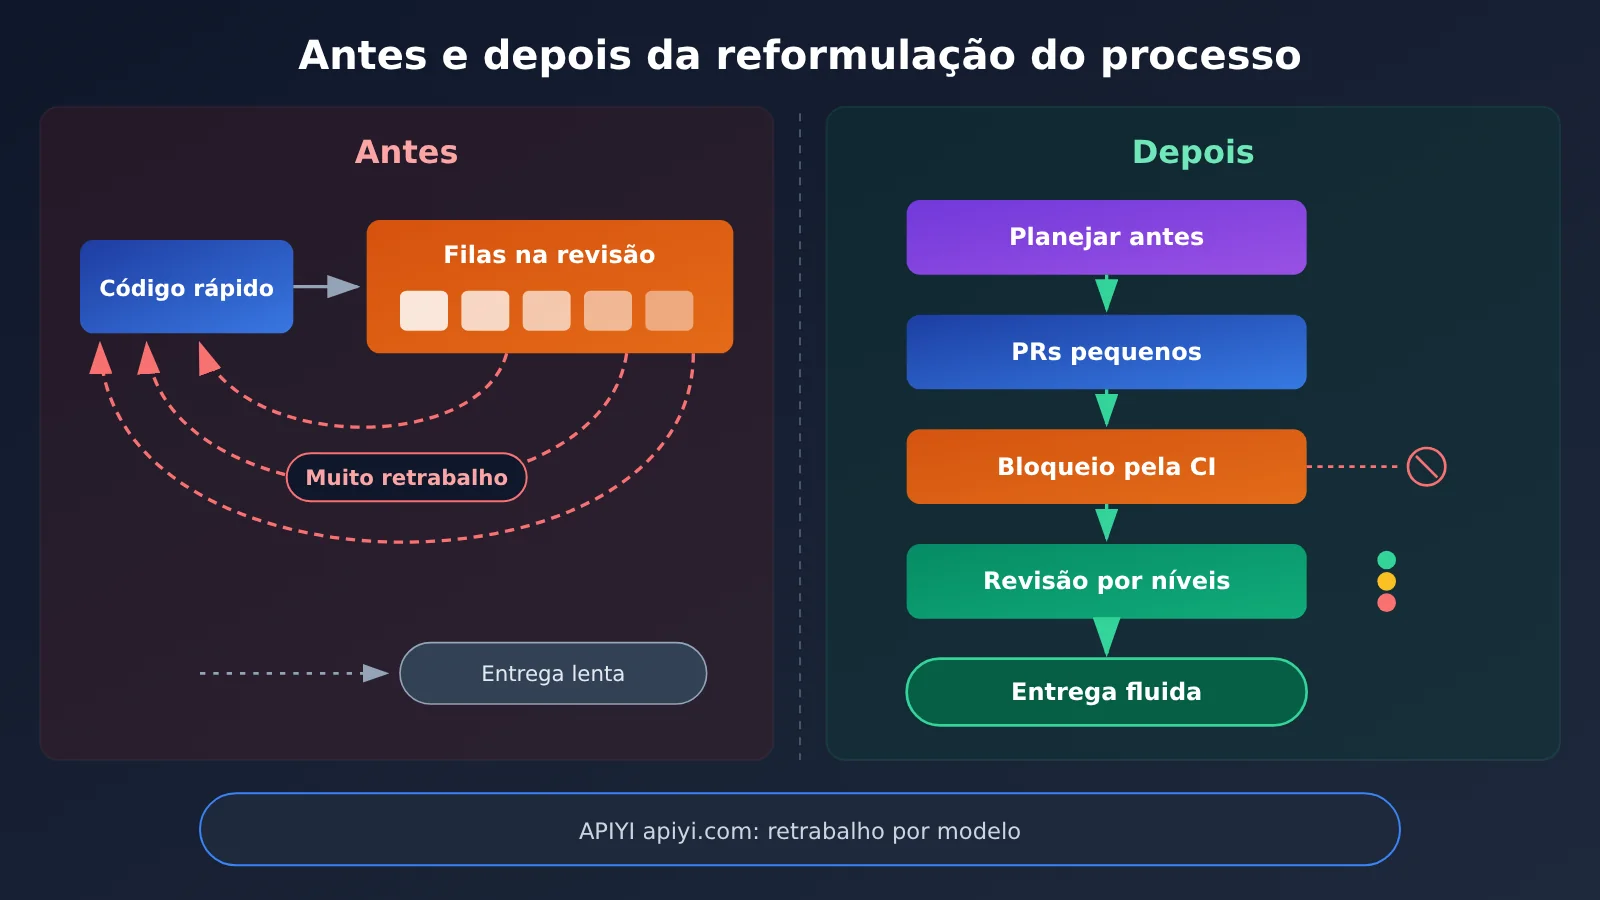
Agentes são mais propensos a “se desviar com confiança” quando os requisitos são vagos. Em vez de derrubar um merge request inteiro na fase de revisão, é melhor gastar dez minutos antes de começar para escrever com clareza a descrição da tarefa: quais módulos alterar, quais interfaces não tocar, quais são os critérios de aceitação e quais testes precisam ser adicionados.
Uma prática útil é fazer o agente primeiro gerar um plano de implementação, que os engenheiros confirmam antes de entrar na codificação. O custo de modificação na fase de planejamento é muito menor do que na fase de código, e também permite que os revisores saibam antecipadamente o escopo das mudanças. Essa etapa parece aumentar o tempo inicial, mas reduz diretamente problemas como “o dobro da proporção de merge requests que precisam de retrabalho”.
Etapa 3: Controlar a granularidade dos merge requests de código gerado por IA
A atenção do revisor é um recurso limitado. Mesmo que pesquisas mostrem que o aumento da carga de revisão não se deve totalmente ao fato de um único merge request ficar maior, controlar a granularidade ainda é a forma mais direta de reduzir a carga cognitiva. Recomenda-se definir limites claros para as tarefas do agente: um merge request resolve apenas um problema, e refatorações e mudanças de funcionalidade devem ser enviadas separadamente.
Também é preciso exigir que o agente descreva no merge request a motivação da mudança, o escopo de impacto e os resultados dos testes próprios. Os revisores podem julgar o risco simplesmente lendo a descrição, em vez de inferir a intenção a partir de centenas de linhas de diff, e o número de idas e vindas nos comentários diminui significativamente.
🎯 Dica técnica: Diferentes modelos apresentam diferenças notáveis na divisão de tarefas e na qualidade do planejamento. A APIYI apiyi.com oferece chamadas de API para modelos populares abordados neste artigo, como Claude e GPT, sendo compatível com os formatos de interface OpenAI e Anthropic. As equipes podem alternar entre modelos dentro do mesmo fluxo de trabalho do agente e comparar qual modelo gera merge requests com menor taxa de retrabalho. Consulte a documentação da APIYI em docs.apiyi.com para saber como integrar.
Passo 4: Entregue os testes e a autoverificação ao agente, não ao revisor
Pesquisas mostram que, após introduzir a revisão assistida por IA, a proporção de pessoas envolvidas na revisão ainda aumentou 14%. Isso indica que adicionar uma IA à etapa de revisão não é suficiente. A abordagem mais eficaz é mover o controle de qualidade para mais cedo: fazer o agente complementar testes unitários, executar os testes localmente, fazer verificação estática e formatação antes do envio.
Você pode definir “testes aprovados, verificações aprovadas” como pré-condição obrigatória para enviar um merge request, com bloqueio automático pelo CI. Assim, os revisores podem se concentrar na razoabilidade do design, nas condições de contorno e na lógica de negócio, em vez de apontar ponteiro nulo e problemas de nomenclatura. Ferramentas de revisão por IA são adequadas como primeiro filtro, mas a decisão final ainda deve ser tomada por quem entende do negócio.
Passo 5: Revisão em níveis e estratificação de risco de código com IA
Nem todo código gerado por IA precisa do mesmo nível de revisão. É possível classificar as alterações por risco: documentação, testes e código boilerplate passam por revisão leve; lógica de negócio passa por revisão normal; alterações envolvendo autenticação, pagamentos, migração de dados e concorrência devem passar por revisão profunda de engenheiro sênior, e o autor precisa explicar claramente cada alteração.
| Nível de risco | Tipo de alteração | Forma de revisão | Nº sugerido de revisores |
|---|---|---|---|
| Baixo | Documentação, casos de teste, código boilerplate | Triagem inicial por IA + confirmação humana rápida | 1 pessoa |
| Médio | Lógica de negócio comum | Revisão humana completa | 1–2 pessoas |
| Alto | Autenticação, pagamentos, migração de dados, concorrência | Revisão profunda por engenheiro sênior + apresentação do autor | 2 pessoas ou mais |
Por fim, inclua o MTTR no acompanhamento de longo prazo. Se o entendimento do código pelos engenheiros for ficando cada vez mais raso, os problemas aparecerão em incidentes em produção. Exigir periodicamente que o autor explique o código de IA que ele mesmo mesclou é uma forma de baixo custo de evitar que “ninguém realmente entenda esse trecho de código”.
🚀 Início rápido: Se você está montando um agente de codificação interno para o time, pode solicitar uma cota de teste no APIYI apiyi.com, usar o mesmo conjunto de instruções de tarefa para chamar modelos diferentes e registrar o tempo de revisão e a taxa de retrabalho dos merge requests gerados, para então decidir o modelo principal.
Referência de seleção de modelos para agentes de codificação com IA
A seleção de modelos, por si só, não resolve gargalos de processo, mas afeta a qualidade da primeira submissão e, por consequência, a carga de revisão. A tabela abaixo traz recomendações direcionais a partir do papel no fluxo de trabalho; os resultados concretos devem ser validados por testes da própria equipe.
| Função no fluxo de trabalho | Foco de capacidade | Critério de escolha | Plataformas disponíveis |
|---|---|---|---|
| Geração do plano de implementação | Compreensão de contexto longo, divisão de tarefas | Escolher um modelo de ponta com forte capacidade de raciocínio | APIYI apiyi.com, API oficial |
| Escrita e refatoração de código | Qualidade do código, aderência às restrições | Escolher modelos com bom desempenho em avaliações de programação | APIYI apiyi.com, API oficial |
| Complemento de testes e autoverificação | Estabilidade e grande volume de chamadas | Escolher modelos com melhor custo-benefício | APIYI apiyi.com, API oficial |
| Revisão inicial por IA | Detectar defeitos comuns | Usar um modelo diferente do de escrita, para evitar pontos cegos da mesma origem | APIYI apiyi.com, API oficial |
💰 Nota de custo: fluxos de trabalho com agentes têm grande volume de chamadas, e a forma de cobrança (preço unitário de entrada, saída e acerto de cache) determina diretamente o custo. Este artigo não lista preços específicos; para todos os modelos, consulte os preços e as formas de cobrança em tempo real na página de preços do APIYI: docs.apiyi.com/models.
Perguntas frequentes (FAQ)
Q1: O que significa “o volume de código cresce 30% com IA, mas a entrega só cresce 12%”?
Essa é a conclusão de um estudo da Universidade de Harvard com dados da Jellyfish: depois de adotar agentes de IA, o número de linhas de código cresceu 30%, mas os tickets resolvidos por engenheiro por mês cresceram apenas 12%. A diferença vem principalmente das etapas seguintes do fluxo, como revisão de código e testes, que passaram a ser o novo gargalo.
Q2: Qual é a diferença de ganho de produtividade entre assistentes de programação com IA e agentes de IA?
Os assistentes de programação tiveram um crescimento de produção menor: apenas o aumento de 9% nos commits foi estatisticamente significativo, e não houve aumento no número de tickets resolvidos. Já os agentes de IA fizeram linhas de código, commits e pull requests crescerem 30%, 20% e 23%, respectivamente, além de um aumento de 12% nos tickets.
Q3: Os dados deste estudo sobre ganho de produtividade com codificação por IA são confiáveis?
O período analisado vai de janeiro de 2021 a março de 2026, cobrindo mais de 700 empresas, 700 mil funcionários e cerca de 300 milhões de eventos de trabalho. A estimativa de alocação de horas também foi validada por uma pesquisa com 100 engenheiros, e tanto o tamanho da amostra quanto a validação cruzada são sólidos.
Q4: Adotar ferramentas de revisão de código com IA resolve o gargalo da revisão?
Só isso não basta. O estudo mostra que, após adotar a revisão assistida por IA, a proporção de pessoas participando das revisões ainda aumentou 14%. O caminho mais eficaz é antecipar testes e autoverificação para antes do commit e, em seguida, combinar com revisão em níveis, fazendo com que a revisão humana se concentre nas mudanças de alto risco.
Q5: Como validar a baixo custo o impacto de diferentes modelos na carga de revisão?
A recomendação é comparar vários modelos usando o mesmo lote de tarefas reais:
1. Registre-se no APIYI (apiyi.com) e obtenha créditos de teste
2. Seguindo as instruções da documentação do APIYI em docs.apiyi.com, integre ao seu agente atual no formato compatível com OpenAI ou Anthropic
3. Registre, para cada modelo, o tempo de revisão, o número de comentários e a taxa de retrabalho dos pull requests gerados
Assim você escolhe o modelo com base em dados, não em impressões.
Q6: Como estimar o custo de usar agentes de codificação com IA na equipe?
Primeiro, calcule o consumo médio de Tokens de entrada e saída por tarefa e depois multiplique pelo preço unitário do modelo e pelo volume mensal de tarefas. Tarefas de agentes costumam ter contextos muito longos, e o acerto de cache afeta bastante o custo. Para preços unitários específicos e as regras de cobrança de cache, consulte a página de preços do APIYI em docs.apiyi.com/models.
Q7: Quais são os riscos de longo prazo do ganho de produtividade com codificação por IA?
O principal risco é que os engenheiros passem a entender menos o código. A visão da comunidade é que, quando o código continua crescendo sem compreensão suficiente, as falhas podem ficar mais frequentes e a investigação mais difícil. Recomenda-se acompanhar a longo prazo o tempo médio de recuperação de falhas e exigir que os autores consigam explicar claramente o código gerado por IA que eles mesmos mesclaram.
Principais pontos sobre eficiência na codificação com IA
- Produzir não é entregar: os agentes de IA aumentam o volume de código em 30%, mas os tickets entregues crescem apenas 12%
- Codificar ocupa só 30% a 40% do tempo: otimizar apenas a escrita de código tem um teto de ganho muito baixo
- A revisão é o principal gargalo: o tempo de revisão sobe 49%, os comentários 53% e a proporção de retrabalho dobra
- Revisão por IA não é bala de prata: mesmo depois de adotá-la, a proporção de pessoas participando das revisões ainda cresce 14%
- Antecipar os portões de qualidade: planejamento antecipado, commits menores e autoverificação antes do envio são o que funciona melhor
- Acompanhar o MTTR no longo prazo: evitar que o time “escreva muito e entenda pouco” sobre o código gerado por IA
- Escolher modelos com base em dados: é possível comparar a taxa de retrabalho de cada modelo por meio da interface unificada da APIYI apiyi.com
Resumo
Onde a eficiência da codificação com IA trava? A pesquisa já deu a resposta:
- O gargalo mudou de lugar: com a codificação mais rápida, a revisão de código, os testes e o planejamento passaram a ser os novos limitadores
- As métricas precisam ser lidas em pares: indicadores de produção devem ser acompanhados junto com métricas de entrega, revisão e qualidade
- Mudar o processo importa mais do que trocar de ferramenta: planejamento antecipado, controle de granularidade, autoverificação antecipada e revisão em níveis, nessa ordem
O ganho real de eficiência não é fazer a IA escrever mais código, e sim fazer com que menos código passe pela revisão com maior qualidade na primeira tentativa. A recomendação é usar um ciclo de iteração para levantar os dados de linha de base e depois implementar aos poucos o método de 5 passos acima.
Se precisar comparar o desempenho de diferentes modelos dentro de um fluxo de trabalho com agentes, vale validar rapidamente pela APIYI apiyi.com: a plataforma é compatível com os formatos de interface da OpenAI e da Anthropic, e os preços podem ser consultados em docs.apiyi.com/models.
📚 Referências
- InfoQ 中文: A geração de código por IA é limitada pelos gargalos das etapas seguintes — versão em chinês do relatório da pesquisa
- Link:
infoq.cn/article/c3vTLNrRwfCzw8SAmz90 -
Descrição: inclui a metodologia da pesquisa, os dados centrais e as discussões da comunidade
-
InfoQ original em inglês: Jellyfish AI Productivity — versão em inglês do relatório da pesquisa
- Link:
infoq.com/news/2026/10/jellyfish-ai-productivity -
Descrição: indicado para quem precisa consultar as formulações originais em inglês
-
Central de documentação APIYI: instruções de integração e interface dos modelos
- Link:
docs.apiyi.com -
Descrição: formas de integração nos formatos compatíveis com OpenAI e Anthropic
-
Página de preços de modelos APIYI: critérios de cobrança de cada modelo
- Link:
docs.apiyi.com/models - Descrição: os preços unitários de entrada, saída e cache seguem os dados em tempo real desta página
Autor: equipe técnica APIYI
Contato técnico: fale conosco pela página inicial do APIYI em apiyi.com; mais materiais de integração estão disponíveis na central de documentação docs.apiyi.com