Catatan penulis: Agen AI membuat jumlah baris kode tumbuh 30%, tetapi tiket yang terkirim hanya naik 12%. Artikel ini memakai data riset untuk memetakan letak hambatannya, lalu memberikan langkah peningkatan efisiensi yang bisa langsung diikuti tim.
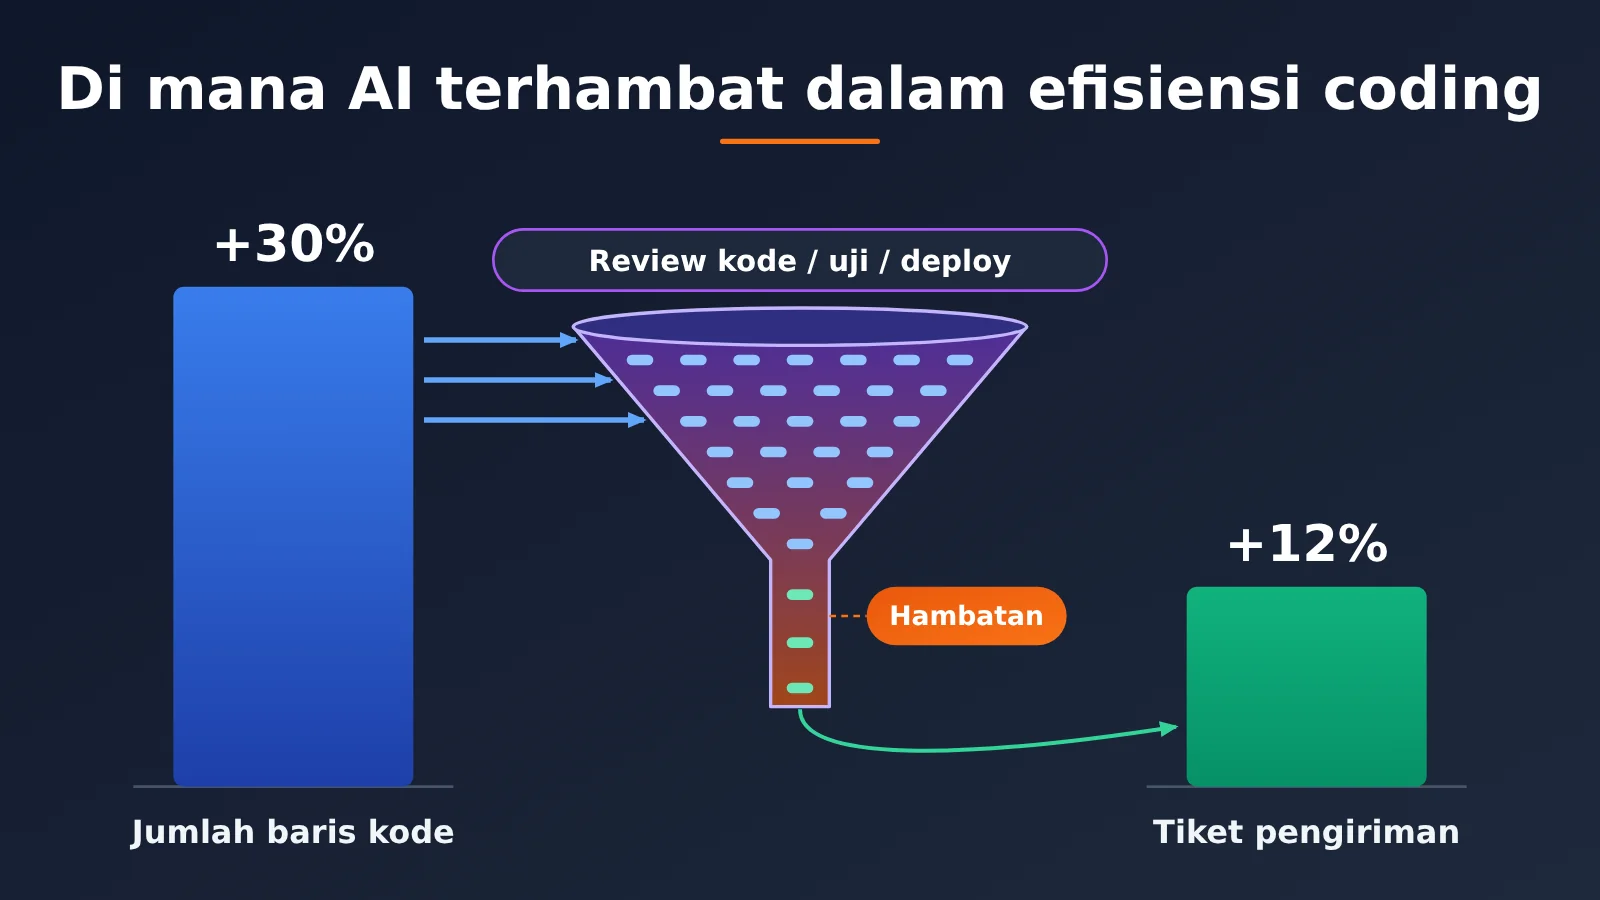
Banyak tim yang mengadopsi agen AI menemukan bahwa commit bertambah, merge request bertambah, tetapi pengiriman kebutuhan tidak menjadi jauh lebih cepat. Sebuah riset terbaru dari Universitas Harvard yang memanfaatkan platform Jellyfish dan mencakup 718 perusahaan memberikan kesimpulan terukur: volume kode naik 30%, delivery hanya naik 12%, dan selisihnya sebagian besar dimakan oleh tahap hilir seperti code review.
Ini bukan artikel lain yang meremehkan pemrograman dengan AI. Kesimpulan risetnya jelas: agen AI memang mendorong pertumbuhan output, masalahnya seluruh pipeline delivery tidak ikut diperbesar kapasitasnya. Artikel ini akan membedah datanya lebih dulu, lalu memberikan metode 5 langkah mulai dari pengukuran hingga perombakan proses.
Nilai inti: setelah membaca artikel ini, Anda bisa menilai di tahap mana peningkatan efisiensi coding AI tim Anda tersendat, serta tahu apa yang harus diubah lebih dulu dan bagaimana mengukur apakah perbaikan itu benar-benar efektif.
Poin Inti dari Hambatan Efisiensi Coding dengan AI
Periode data penelitian ini membentang dari Januari 2021 hingga Maret 2026, mencakup lebih dari 700 perusahaan dan 700 ribu karyawan, dengan total sekitar 300 juta peristiwa kerja. Sumber datanya meliputi informasi SDM, sistem kontrol versi kode, sistem tiket, alat penjadwalan, serta catatan penggunaan alat AI generatif seperti GitHub Copilot, Cursor, dan Claude Code — ukuran sampel yang tergolong langka di antara studi sejenis.
| Poin | Temuan Penelitian | Artinya bagi Tim |
|---|---|---|
| Pertumbuhan output | Agen AI menghasilkan baris kode +30%, commit +20%, merge request +23% | Tahap coding memang jadi lebih cepat |
| Pertumbuhan pengiriman | Tiket yang diselesaikan per orang per bulan hanya naik 12% | Output tidak berbanding lurus dengan pengiriman |
| Alokasi waktu | Engineer hanya menghabiskan 30%–40% waktunya untuk menulis kode | Kalau hanya mengoptimalkan coding, batas atasnya sangat rendah |
| Tekanan review | Durasi review +49%, jumlah komentar +53%, proporsi merge request yang perlu dikerjakan ulang berlipat dua | Hambatan berpindah ke tahap review |
| Review oleh AI | Setelah menghadirkan review berbantuan AI, proporsi orang yang terlibat dalam review justru naik 14% | Sekadar menambah alat review AI tidak menyelesaikan masalah |
Perbedaan Efisiensi antara Asisten AI dan Agen AI
Penelitian ini membedakan dua jenis alat. Asisten coding (yang berfokus pada completion dan percakapan) memberikan peningkatan kecil: baris kode +12%, commit +9%, merge request +5%, dan hanya pertumbuhan catatan commit yang signifikan secara statistik. Yang lebih penting, asisten coding tidak meningkatkan jumlah tiket yang terselesaikan — artinya, hampir tidak ada dampak yang terukur terhadap pengiriman.
Sementara agen AI (yang mampu menyelesaikan tugas multi-langkah secara mandiri) menunjukkan pertumbuhan signifikan pada ketiga indikator output, sekaligus membawa kenaikan 12% pada jumlah tiket. Ini menunjukkan bahwa “membiarkan AI mengerjakan tugas secara utuh” lebih bernilai daripada “membiarkan AI membantu menulis beberapa baris”, tetapi sekaligus berarti volume kode dan beban review yang diterima di hilir ikut membesar. Penelitian ini juga secara khusus mencatat bahwa kenaikan beban review tidak bisa dijelaskan oleh membesarnya ukuran satu merge request, melainkan karena kode itu sendiri membutuhkan lebih banyak diskusi dan revisi.
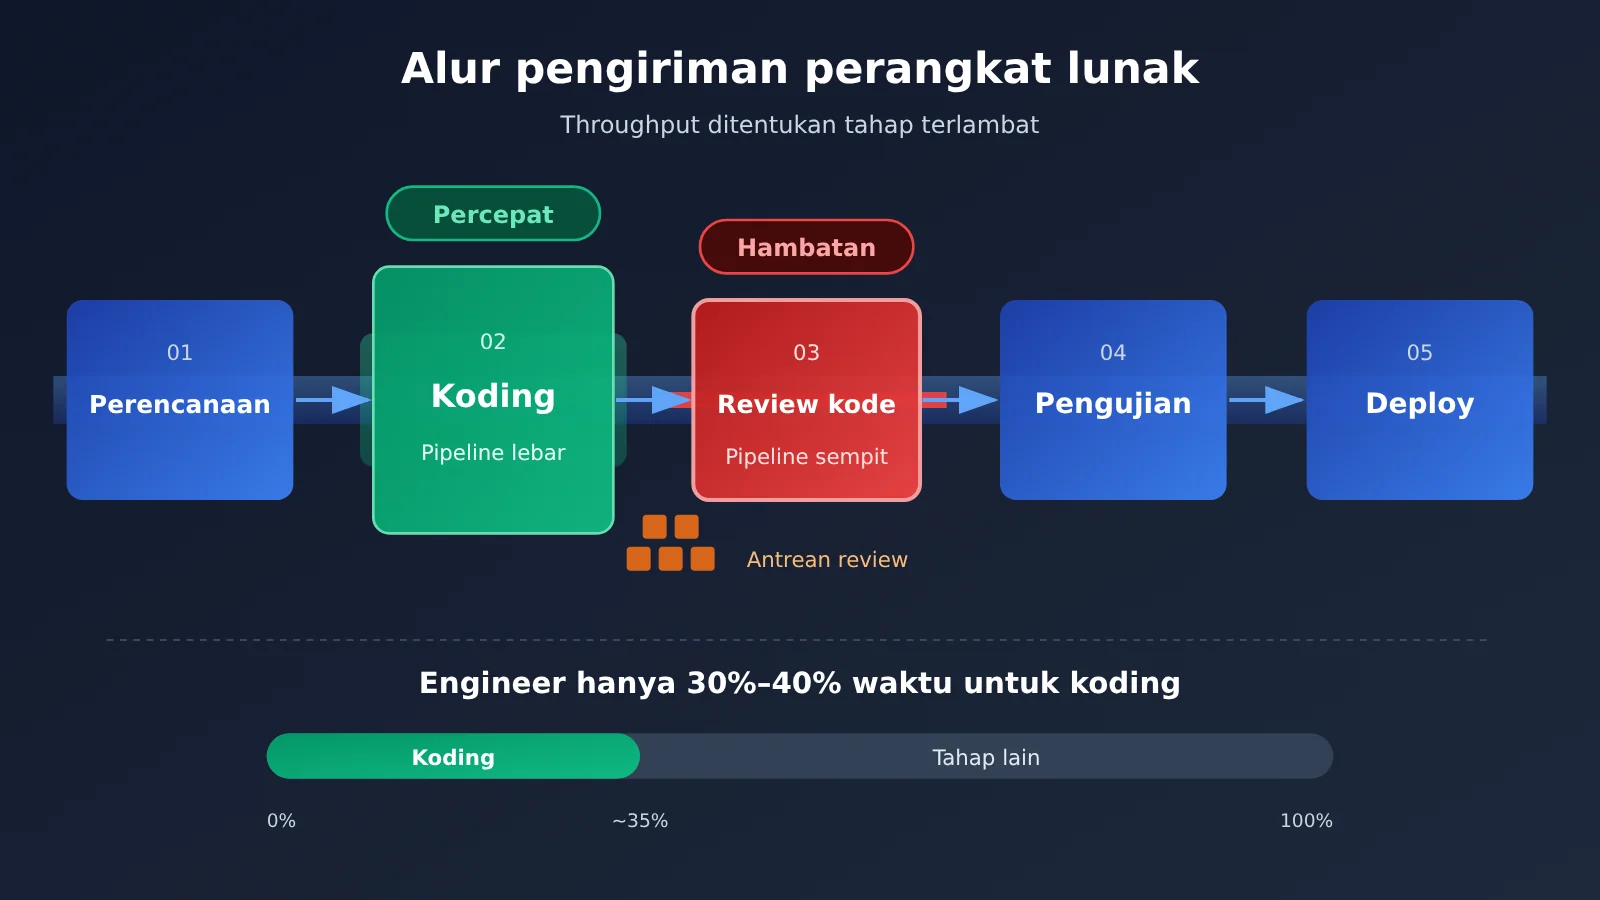
Di Mana Titik Macet Peningkatan Efisiensi Coding AI: Memahaminya lewat Teori Kendala
Throughput pipeline pengiriman bergantung pada tahap yang paling lambat. Ketika coding hanya menghabiskan 30%–40% waktu engineer, bahkan menggandakan kecepatan coding paling banyak hanya memangkas sekitar sepertiga dari total siklus. Kenyataannya, coding yang dipercepat justru menumpuk lebih banyak pekerjaan yang menunggu di tahap review dan pengujian.
Beberapa angka dari riset bisa merangkai rantai sebab-akibat yang utuh: agen menulis lebih banyak, merge request pun bertambah; jumlah komentar per merge request naik 53%, artinya reviewer harus mengeluarkan lebih banyak tenaga untuk memahami dan mempertanyakan kode yang ditulis AI; proporsi merge request yang perlu direvisi berlipat dua, artinya kualitas pengiriman pertama menurun. Semua biaya ini jatuh ke tangan reviewer manusia, padahal reviewer justru orang paling berpengalaman dan paling sibuk di tim.
| Tahap | Perubahan yang dibawa AI | Gejala umum | Prioritas |
|---|---|---|---|
| Perencanaan dan cakupan | Saat deskripsi kebutuhan tidak jelas, AI akan “dengan percaya diri” menulis ke arah yang salah | Pengerjaan ulang, merge request dibatalkan seluruhnya | Tinggi |
| Coding | Kecepatan meningkat jelas | Volume kode melonjak, output per orang terlihat bagus | Sudah dioptimalkan |
| Code review | Jumlah yang menunggu review dan kompleksitasnya naik bersamaan | Antrean review, komentar bolak-balik | Tertinggi |
| Pengujian | Cakupan tidak mengejar volume kode baru | Masalah regresi bertambah | Tinggi |
| Deployment dan operasional | Pemahaman engineer atas kode jadi lebih dangkal | Penelusuran gangguan jadi lebih lambat | Jangka menengah–panjang |
Diskusi di komunitas juga mengonfirmasi hal ini. Ada developer yang berkomentar “setiap baris kode adalah risiko potensial”, ada pula yang menyebut agen adalah kolaborator yang kurang andal dan bisa melakukan tindakan ngawur demi menyelesaikan tugas. Pandangan lain menyebut MTTR (mean time to recovery) akan menjadi metrik penting untuk menilai dampak AI, karena semakin dangkal pemahaman engineer terhadap kode yang dikirimkannya, semakin sulit penelusuran masalahnya.
Memulai Peningkatan Efisiensi Coding AI dengan Cepat: Metode 5 Langkah untuk Mendobrak Kebuntuan
Metode di bawah ini disusun dari investasi terkecil hingga terbesar, sehingga tim dapat menjalankannya secara berurutan. Setiap langkah sebisa mungkin disertai metrik yang dapat diukur, agar tidak terjebak pada penilaian “terasa lebih cepat” yang sulit diverifikasi.
Langkah 1: Bangun baseline pengiriman untuk peningkatan efisiensi coding AI
Jangan buru-buru mengganti alat, bangun dulu sistem pengukurannya. Riset dapat menemukan kesenjangan karena melihat metrik output dan metrik pengiriman secara bersamaan. Banyak tim hanya melihat jumlah baris kode dan jumlah commit, sehingga salah mengira peningkatan efisiensi sudah sangat berhasil.
Sebaiknya lacak dua kelompok metrik sekaligus: dari sisi output, lihat jumlah commit dan jumlah merge request; dari sisi pengiriman, lihat tiket yang ditutup per orang per bulan serta siklus kebutuhan dari awal hingga rilis. Tambahkan tiga metrik dari sisi review: rata-rata durasi review merge request, jumlah komentar per merge request, dan proporsi yang perlu rework. Data ini biasanya dapat diekspor langsung dari platform Git dan sistem tiket seperti Jira.
| Kategori metrik | Metrik spesifik | Sumber data | Fokus observasi |
|---|---|---|---|
| Output | Jumlah commit, jumlah merge request | Platform Git | Hanya sebagai referensi, bukan untuk penilaian kinerja |
| Pengiriman | Jumlah tiket yang ditutup per orang per bulan, siklus kebutuhan | Sistem tiket | Metrik target utama |
| Review | Durasi review, jumlah komentar, tingkat rework | Platform Git | Peringatan dini bottleneck |
| Kualitas | Jumlah insiden produksi, MTTR | Pemantauan dan catatan insiden | Kesehatan jangka panjang |
Langkah 2: Lakukan perencanaan kebutuhan di awal untuk agen pengkodean AI
Agen paling mudah “percaya diri melenceng” saat kebutuhan ambigu. Daripada membatalkan seluruh merge request di tahap review, lebih baik luangkan sepuluh menit sebelum mulai untuk menulis penjelasan tugas dengan jelas: modul mana yang harus diubah, antarmuka mana yang tidak boleh disentuh, apa kriteria penerimaannya, dan test apa saja yang perlu ditambahkan.
Praktik yang berguna adalah meminta agen lebih dulu mengeluarkan rencana implementasi, lalu engineer mengonfirmasinya sebelum masuk ke tahap pengkodean. Biaya perubahan di tahap perencanaan jauh lebih rendah dibanding tahap kode, dan juga membuat reviewer tahu cakupan perubahan lebih awal. Langkah ini terlihat menambah waktu di awal, tetapi bisa langsung menurunkan masalah seperti “proporsi merge request yang perlu rework menjadi dua kali lipat”.
Langkah 3: Kendalikan granularitas merge request untuk kode yang dihasilkan AI
Perhatian reviewer adalah sumber daya yang terbatas. Meskipun penelitian menunjukkan kenaikan beban review tidak sepenuhnya karena satu merge request menjadi lebih besar, mengendalikan granularitas tetap menjadi cara paling langsung untuk mengurangi beban kognitif. Disarankan untuk menetapkan batasan yang jelas untuk tugas agen, satu merge request hanya menyelesaikan satu masalah, refactor dan perubahan fitur diajukan secara terpisah.
Sekaligus minta agen menuliskan motivasi perubahan, cakupan dampak, dan hasil pengujian mandiri di deskripsi merge request. Reviewer bisa menilai risiko hanya dengan membaca deskripsi, bukan menyimpulkan maksud dari ratusan baris diff, sehingga jumlah bolak-balik komentar akan berkurang secara signifikan.
🎯 Saran teknis: Model yang berbeda menunjukkan perbedaan jelas dalam pemecahan tugas dan kualitas perencanaan. APIYI apiyi.com menyediakan pemanggilan API untuk model-model utama yang dibahas di artikel ini seperti Claude dan GPT, sekaligus kompatibel dengan dua format antarmuka OpenAI dan Anthropic. Tim dapat berganti model dalam alur kerja agen yang sama, membandingkan model mana yang menghasilkan merge request dengan tingkat rework lebih rendah. Cara integrasinya lihat dokumentasi APIYI di docs.apiyi.com.
Langkah 4: Serahkan pengujian dan pemeriksaan mandiri kepada agen, bukan kepada reviewer
Penelitian menemukan bahwa setelah memperkenalkan tinjauan berbantuan AI, proporsi orang yang terlibat dalam tinjauan justru meningkat 14%. Ini menunjukkan bahwa menambahkan AI di tahap tinjauan saja tidak cukup. Pendekatan yang lebih efektif adalah memindahkan gerbang kualitas ke depan: biarkan agen menyelesaikan pelengkapan unit test, menjalankan test secara lokal, pemeriksaan statis, dan formatisasi sebelum melakukan submit.
“Test lulus, pemeriksaan lulus” dapat dijadikan prasyarat wajib sebelum mengirim merge request, dan CI akan memblokirnya secara otomatis. Dengan begitu, reviewer dapat fokus pada kewajaran desain, kondisi batas, dan logika bisnis, bukan menunjuk null pointer dan masalah penamaan. Alat tinjauan AI cocok sebagai filter pertama, tetapi keputusan akhir tetap harus dilakukan oleh orang yang memahami bisnisnya.
Langkah 5: Tinjauan berjenjang dan pelapisan risiko coding AI
Tidak semua kode yang dihasilkan AI memerlukan tinjauan dengan intensitas yang sama. Perubahan dapat diklasifikasikan berdasarkan risiko: dokumentasi, test, dan kode boilerplate menjalani tinjauan ringan; logika bisnis menjalani tinjauan reguler; perubahan yang menyangkut autentikasi, pembayaran, migrasi data, dan konkurensi wajib ditinjau secara mendalam oleh engineer senior, dan penulis harus dapat menjelaskan setiap perubahan dengan jelas.
| Tingkat Risiko | Jenis Perubahan | Metode Tinjauan | Saran Jumlah Reviewer |
|---|---|---|---|
| Rendah | Dokumentasi, kasus uji, kode boilerplate | Tinjauan awal AI + konfirmasi manual cepat | 1 orang |
| Sedang | Logika bisnis reguler | Tinjauan manual lengkap | 1–2 orang |
| Tinggi | Autentikasi, pembayaran, migrasi data, konkurensi | Tinjauan mendalam engineer senior + penjelasan penulis | 2 orang atau lebih |
Terakhir, MTTR harus dimasukkan ke dalam pemantauan jangka panjang. Jika pemahaman engineer terhadap kode semakin dangkal, masalah akan terungkap saat terjadi gangguan di lingkungan produksi. Secara berkala meminta penulis menjelaskan kode AI yang mereka merge adalah cara hemat biaya untuk mencegah “tidak ada yang benar-benar memahami kode ini”.
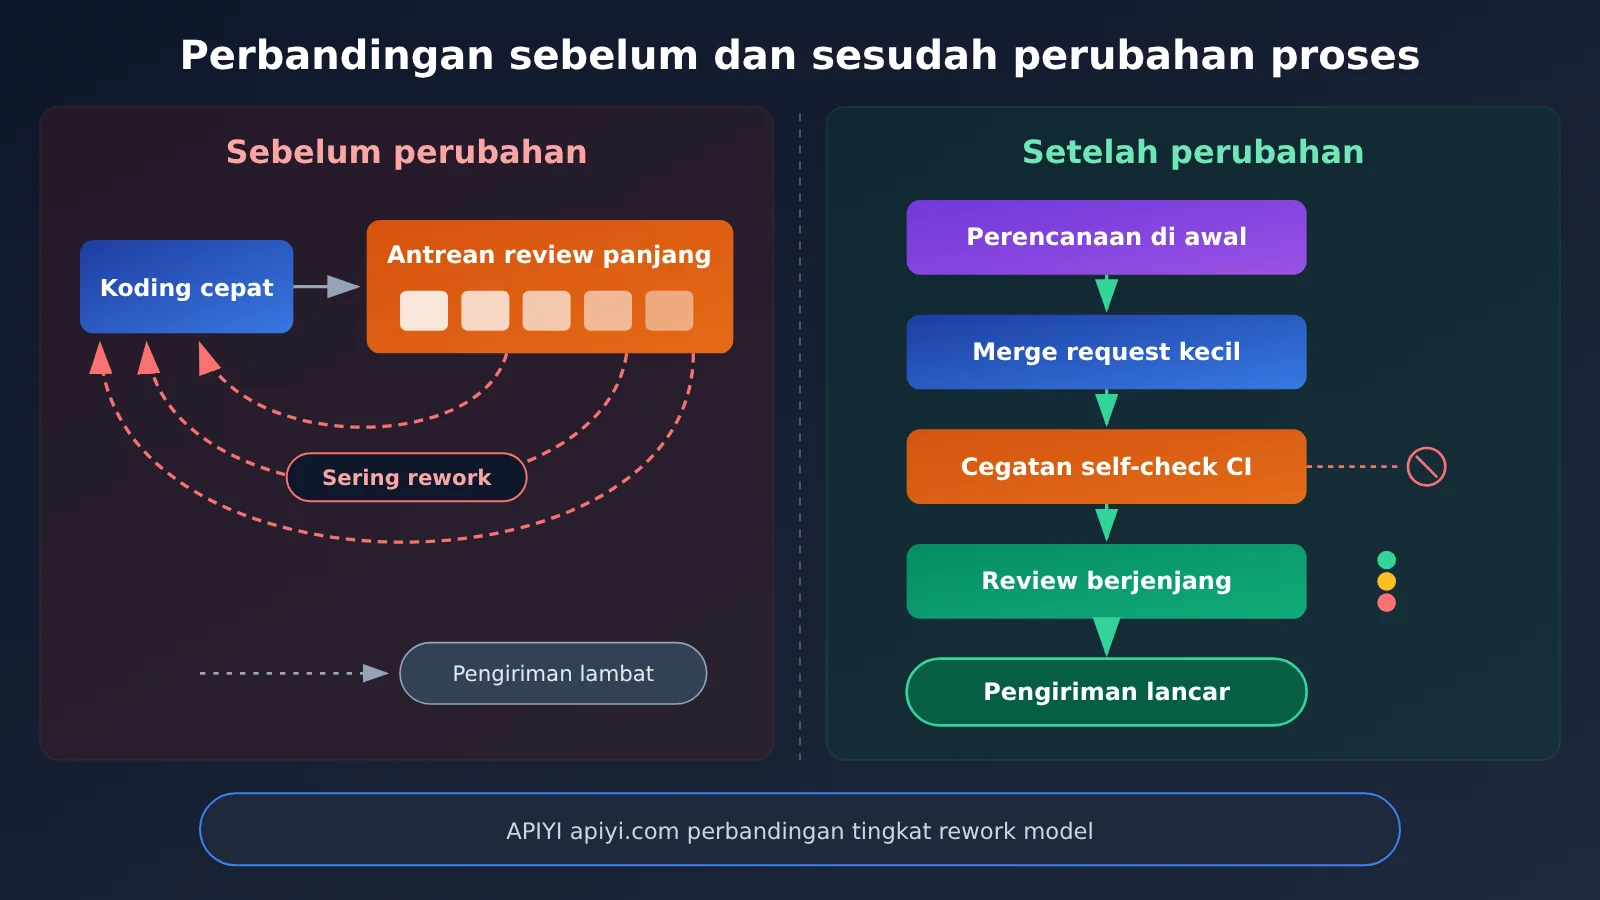
🚀 Mulai cepat: Jika Anda sedang membangun agen coding internal tim, Anda dapat terlebih dahulu mengajukan kuota uji di APIYI apiyi.com, menggunakan satu set instruksi tugas yang sama untuk memanggil model yang berbeda, mencatat durasi tinjauan dan tingkat rework dari merge request yang dihasilkan, lalu menentukan model utama.
Referensi Pemilihan Model untuk Agen Coding AI
Pemilihan model saja tidak bisa menyelesaikan hambatan proses, tetapi akan memengaruhi kualitas commit pertama, yang pada akhirnya berdampak pada beban tinjauan. Tabel berikut memberikan saran arah berdasarkan peran dalam alur kerja; untuk hasil konkretnya, silakan mengacu pada pengujian tim Anda sendiri.
| Peran dalam Alur Kerja | Fokus Kemampuan | Pendekatan Pemilihan | Platform yang Tersedia |
|---|---|---|---|
| Pembuatan rencana implementasi | Pemahaman konteks panjang, pemecahan tugas | Pilih model unggulan dengan kemampuan penalaran yang kuat | APIYI apiyi.com, API resmi |
| Penulisan dan refaktor kode | Kualitas kode, kepatuhan pada batasan | Pilih model dengan performa baik pada evaluasi pemrograman | APIYI apiyi.com, API resmi |
| Penambahan tes dan pemeriksaan mandiri | Stabil, volume panggilan besar | Pilih model dengan rasio harga-kinerja yang tinggi | APIYI apiyi.com, API resmi |
| Tinjauan awal AI | Menemukan cacat umum | Bedakan dari model penulis kode, hindari titik buta dari sumber yang sama | APIYI apiyi.com, API resmi |
💰 Keterangan biaya: Alur kerja agen memiliki volume panggilan yang besar, sehingga dasar penagihan (harga satuan input, output, dan cache hit) langsung menentukan biaya. Artikel ini tidak mencantumkan harga spesifik; seluruh harga dan cara penagihan model mengacu pada data real-time di halaman harga APIYI docs.apiyi.com/models.
FAQ (Pertanyaan Umum)
Q1: Apa arti “jumlah kode AI naik 30%, tetapi hasil pengiriman hanya naik 12%”?
Ini adalah kesimpulan penelitian Harvard University menggunakan data Jellyfish: setelah memakai agen AI, jumlah baris kode meningkat 30%, tetapi tiket yang diselesaikan per engineer per bulan hanya naik 12%. Kesenjangan ini terutama muncul karena tahap hilir seperti tinjauan kode dan pengujian menjadi bottleneck baru.
Q2: Seberapa besar perbedaan peningkatan efisiensi antara asisten pemrograman AI dan agen AI?
Peningkatan output asisten pemrograman lebih kecil; hanya pertumbuhan commit sebesar 9% yang signifikan secara statistik, dan tidak ada peningkatan jumlah tiket yang diselesaikan. Agen AI membuat baris kode, commit, dan permintaan merge masing-masing tumbuh 30%, 20%, dan 23%, serta menghasilkan pertumbuhan tiket sebesar 12%.
Q3: Apakah data penelitian peningkatan efisiensi pemrograman AI ini kredibel?
Periode data adalah Januari 2021 hingga Maret 2026, mencakup lebih dari 700 perusahaan, 700 ribu karyawan, dan sekitar 300 juta peristiwa kerja. Estimasi alokasi jam kerja juga divalidasi melalui survei terhadap 100 engineer, sehingga skala sampel dan validasi silangnya cukup kuat.
Q4: Apakah memperkenalkan alat tinjauan kode AI dapat mengatasi bottleneck tinjauan?
Tidak cukup hanya dengan itu. Penelitian menunjukkan bahwa setelah memperkenalkan tinjauan berbantuan AI, proporsi orang yang terlibat dalam tinjauan masih naik 14%. Pendekatan yang lebih efektif adalah memindahkan pengujian dan pemeriksaan mandiri ke sebelum commit, lalu melengkapinya dengan tinjauan berjenjang agar tinjauan manual fokus pada perubahan berisiko tinggi.
Q5: Bagaimana cara memvalidasi dampak berbagai model terhadap beban tinjauan dengan biaya rendah?
Disarankan membandingkan beberapa model menggunakan kumpulan tugas nyata yang sama:
1. Daftar di APIYI apiyi.com dan dapatkan kuota pengujian
2. Ikuti dokumentasi APIYI di docs.apiyi.com untuk menghubungkan agen AI yang ada dalam format kompatibel OpenAI atau Anthropic
3. Catat durasi tinjauan, jumlah komentar, dan tingkat pengerjaan ulang dari permintaan merge yang dihasilkan setiap model
Dengan begitu, pemilihan model dapat didasarkan pada data, bukan kesan.
Q6: Bagaimana memperkirakan biaya penggunaan agen pemrograman AI di tim?
Pertama, hitung rata-rata Token input dan output yang dikonsumsi per tugas, lalu kalikan dengan harga satuan model dan jumlah tugas per bulan. Tugas agen AI sering kali memiliki konteks yang sangat panjang, sehingga cache hit dapat memengaruhi biaya secara signifikan. Untuk harga satuan dan ketentuan penagihan cache, silakan mengacu pada halaman harga APIYI di docs.apiyi.com/models.
Q7: Apa saja risiko jangka panjang dari peningkatan efisiensi pemrograman AI?
Risiko utamanya adalah pemahaman engineer terhadap kode menjadi lebih dangkal. Pandangan komunitas menyebutkan bahwa ketika basis kode terus berkembang tetapi pemahaman kurang, gangguan bisa lebih sering terjadi dan lebih sulit dilacak. Disarankan untuk melacak rata-rata waktu pemulihan gangguan dalam jangka panjang dan mewajibkan penulis dapat menjelaskan kode AI yang mereka merge.
Poin-Poin Utama Efisiensi Pengkodean AI
- Output bukan berarti terkirim: Agen AI membuat volume kode naik 30%, tetapi tiket pengiriman hanya naik 12%
- Pengkodean hanya menyita 30–40% waktu: Jika hanya mengoptimalkan penulisan kode, plafon peningkatan efisiensi keseluruhan akan rendah
- Review adalah hambatan nomor satu: Durasi review +49%, komentar +53%, proporsi rework meningkat dua kali lipat
- Review AI bukan peluru perak: Setelah diterapkan, proporsi staf yang terlibat dalam review tetap naik 14%
- Geser gerbang kualitas ke depan: Perencanaan di awal, commit berbutir kecil, dan self-check sebelum commit adalah yang paling efektif
- Pantau MTTR jangka panjang: Cegah tim “lebih banyak menulis daripada memahami” kode AI
- Pilih model berdasarkan data: Bandingkan tingkat rework tiap model melalui antarmuka terpadu APIYI apiyi.com
Ringkasan
Di mana efisiensi pengkodean AI terhambat, penelitian sudah memberi jawaban:
- Hambatan telah bergeser: Setelah pengkodean menjadi lebih cepat, review kode, pengujian, dan perencanaan menjadi titik pembatas laju yang baru
- Metrik harus dilihat berpasangan: Metrik output harus dilacak bersama metrik pengiriman, review, dan kualitas
- Mengubah proses lebih penting daripada mengganti alat: Perencanaan di awal, kontrol granularitas, self-check yang digeser ke depan, review berjenjang, dijalankan sesuai urutan
Peningkatan efisiensi yang sesungguhnya bukan membuat AI menulis lebih banyak kode, melainkan membuat lebih sedikit kode lolos review dengan kualitas pertama yang lebih tinggi. Disarankan menjalankan satu siklus iterasi untuk mendapatkan data baseline, lalu menerapkan metode 5 langkah di atas secara bertahap.
Jika perlu membandingkan performa berbagai model dalam alur kerja agen, disarankan melakukan validasi cepat melalui APIYI apiyi.com. Platform ini kompatibel dengan format antarmuka OpenAI dan Anthropic, sedangkan harga mengacu pada docs.apiyi.com/models.
📚 Referensi
- InfoQ versi Mandarin: Kode Hasil AI Terhambat Bottleneck di Tahap Hilir: laporan penelitian versi Mandarin
- Tautan:
infoq.cn/article/c3vTLNrRwfCzw8SAmz90 -
Keterangan: mencakup metode penelitian, data inti, dan diskusi komunitas
-
InfoQ versi bahasa Inggris asli: Jellyfish AI Productivity: laporan penelitian versi Inggris
- Tautan:
infoq.com/news/2026/10/jellyfish-ai-productivity -
Keterangan: cocok untuk pembaca yang perlu merujuk ke pernyataan asli dalam bahasa Inggris
-
Pusat Dokumentasi APIYI: penjelasan integrasi model dan antarmuka API
- Tautan:
docs.apiyi.com -
Keterangan: cara integrasi dengan format yang kompatibel dengan OpenAI dan Anthropic
-
Halaman Harga Model APIYI: dasar penghitungan biaya setiap model
- Tautan:
docs.apiyi.com/models - Keterangan: harga satuan input, output, dan cache mengacu pada data real-time di halaman ini
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama APIYI apiyi.com; materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com