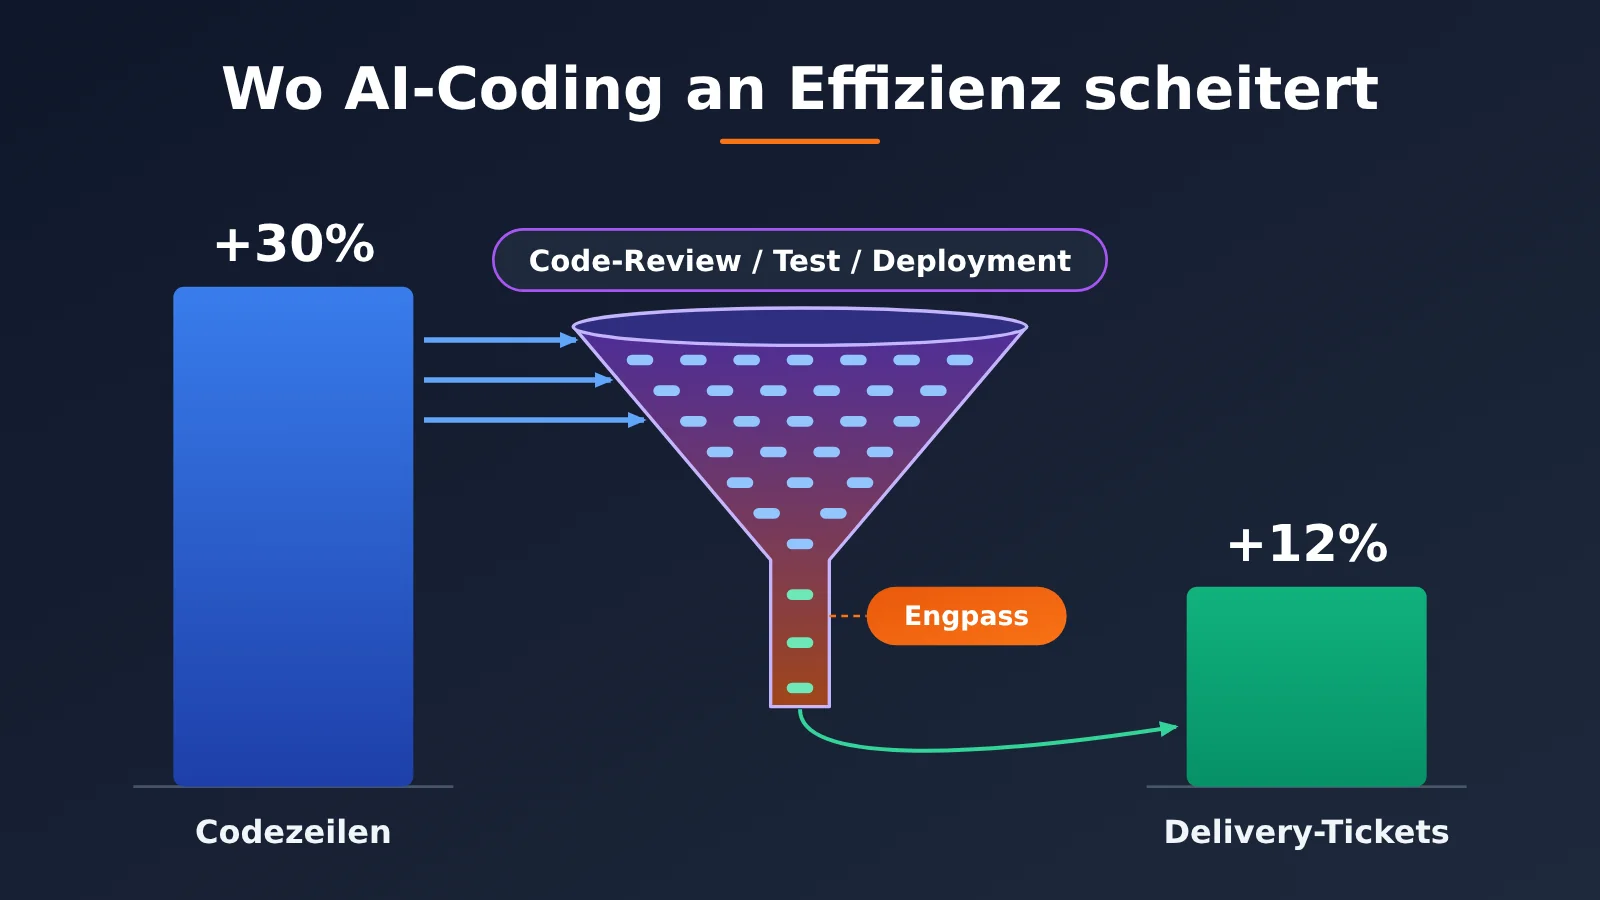
Anmerkung des Autors: KI-Agenten lassen die Zahl der Codezeilen um 30 % steigen, doch die ausgelieferten Tickets wachsen nur um 12 %. Dieser Artikel lokalisiert den Engpass anhand von Forschungsdaten und zeigt Effizienzschritte, die Teams direkt umsetzen können.
Viele Teams stellen nach der Einführung von KI-Agenten fest: Es gibt mehr Commits, mehr Merge Requests – aber die Anforderungen werden nicht viel schneller ausgeliefert. Eine aktuelle Studie der Harvard University mit der Jellyfish-Plattform unter 718 Unternehmen liefert ein quantifiziertes Ergebnis: Der Codeumfang steigt um 30 %, die Auslieferung nur um 12 % – die Lücke wird vor allem von nachgelagerten Schritten wie Code-Reviews aufgefressen.
Das ist kein weiterer Artikel, der KI-gestützte Programmierung schlechtredet. Die Schlussfolgerung der Studie ist eindeutig: KI-Agenten sorgen tatsächlich für mehr Output; das Problem ist, dass die gesamte Delivery-Pipeline nicht mitgewachsen ist. Dieser Artikel schlüsselt zunächst die Daten auf und stellt dann eine 5-Schritte-Methode vor, die von der Messung bis zur Prozessumgestaltung reicht.
Der zentrale Nutzen: Nach der Lektüre können Sie einschätzen, an welcher Stelle die KI-Codierungseffizienz in Ihrem Team hängt, und Sie wissen, was Sie zuerst ändern sollten und wie Sie messen, ob die Verbesserung wirkt.
Kernpunkte des Effizienzengpasses bei der KI-gestützten Programmierung
Der Untersuchungszeitraum dieser Studie reicht von Januar 2021 bis März 2026 und umfasst mehr als 700 Unternehmen, 700.000 Mitarbeitende und rund 300 Millionen Arbeitsereignisse. Zu den Datenquellen zählen Personaldaten, Versionskontrollsysteme, Ticketsysteme, Kalender- und Planungstools sowie Nutzungsprotokolle generativer KI-Tools wie GitHub Copilot, Cursor und Claude Code – eine Stichprobengröße, die in vergleichbaren Studien selten ist.
| Punkt | Forschungsergebnis | Bedeutung für Teams |
|---|---|---|
| Produktionssteigerung | KI-Agenten bringen +30 % Codezeilen, +20 % Commits und +23 % Merge Requests | Die Codierungsphase wird tatsächlich schneller |
| Liefersteigerung | Die pro Person und Monat gelösten Tickets steigen nur um 12 % | Der Output wird nicht im gleichen Verhältnis in ausgelieferte Ergebnisse übersetzt |
| Zeitverteilung | Ingenieurinnen und Ingenieure verbringen nur 30 %–40 % ihrer Zeit mit Programmieren | Wer nur die Codierung optimiert, stößt sehr schnell an eine niedrige Obergrenze |
| Review-Druck | Review-Dauer +49 %, Kommentare +53 %, der Anteil der Merge Requests mit Nacharbeit verdoppelt sich | Der Engpass verschiebt sich in die Review-Phase |
| KI-Review | Nach der Einführung KI-gestützter Reviews steigt der Anteil der am Review beteiligten Personen weiterhin um 14 % | Zusätzliche KI-Review-Tools allein lösen das Problem nicht |
Die Unterschiede bei der Effizienzsteigerung zwischen KI-Assistenten und KI-Agenten im Detail
Die Studie unterscheidet zwei Arten von Tools. Programmierassistenten (vor allem Autovervollständigung und Chat) bringen nur geringe Verbesserungen: +12 % Codezeilen, +9 % Commits und +5 % Merge Requests, wobei nur der Anstieg bei den Commits statistisch signifikant ist. Noch entscheidender: Programmierassistenten führen zu keiner höheren Zahl gelöster Tickets – sie haben also praktisch keinen messbaren Einfluss auf die Auslieferung.
KI-Agenten (die mehrstufige Aufgaben selbstständig erledigen) zeigen dagegen bei allen drei Output-Kennzahlen deutliche Zuwächse und sorgen für 12 % mehr gelöste Tickets. Das bedeutet: „Die KI eine vollständige Aufgabe übernehmen lassen“ ist wertvoller als „die KI ein paar Zeilen ergänzen lassen“ – zugleich aber wächst dadurch die Codemenge, die stromabwärts ankommt, und damit auch der Prüfaufwand. Die Studie weist außerdem ausdrücklich darauf hin, dass sich der gestiegene Review-Aufwand nicht durch größere einzelne Merge Requests erklären lässt: Das Problem liegt im Code selbst, der mehr Diskussion und Überarbeitung erfordert.
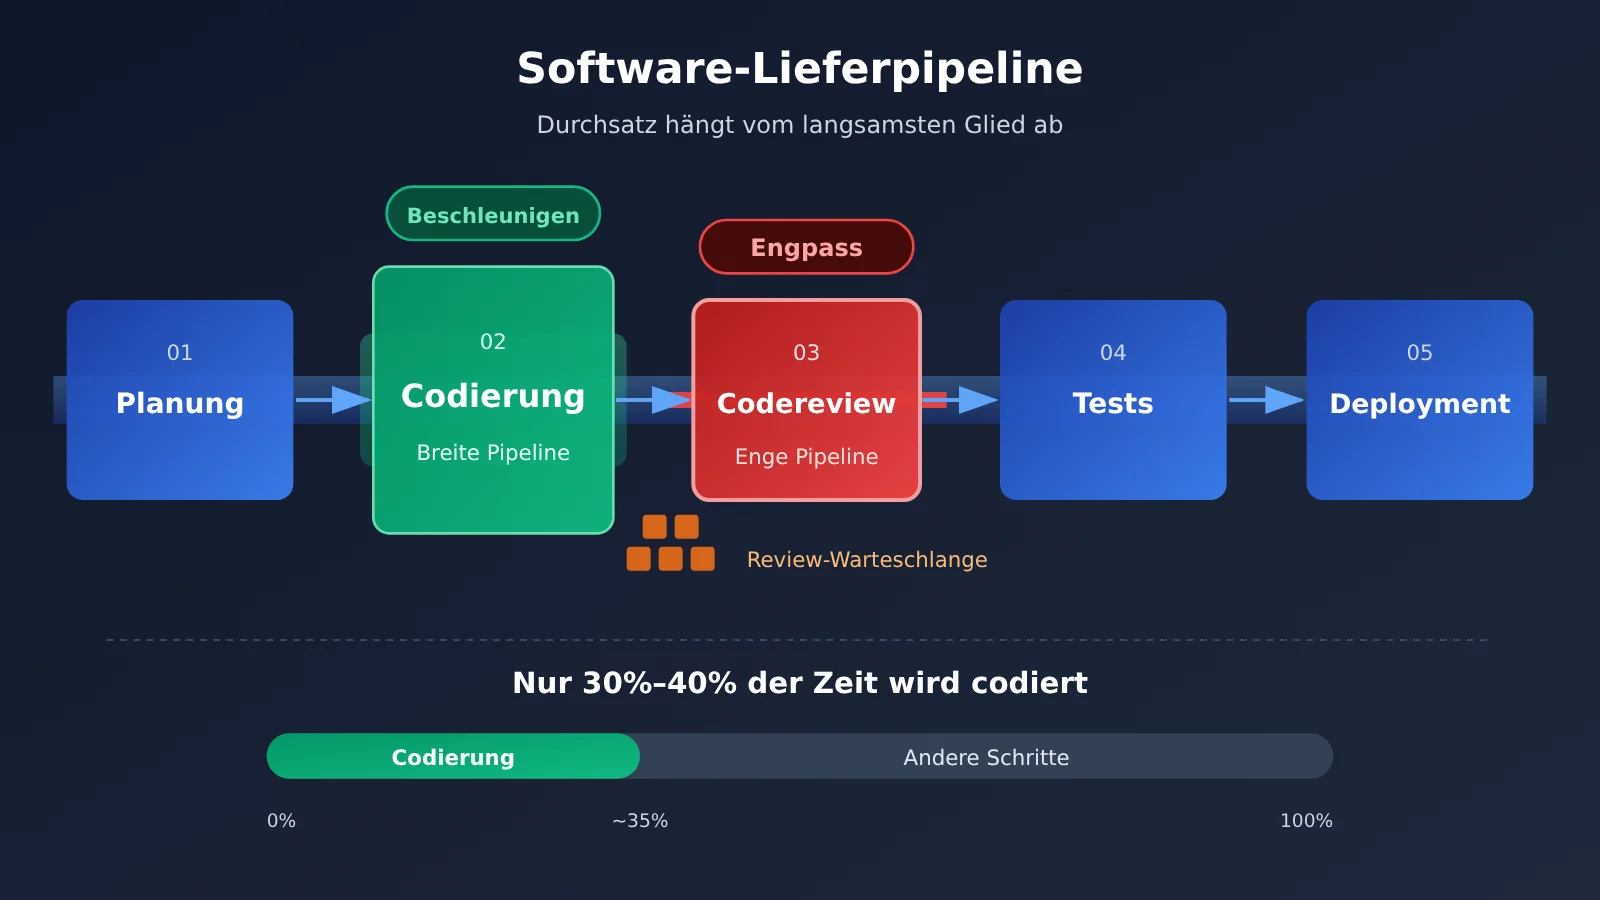
Wo die Bottlenecks bei der KI-gestützten Codierung liegen: Verständnis mit der Theory of Constraints
Der Durchsatz einer Delivery-Pipeline wird vom langsamsten Glied bestimmt. Wenn das Codieren nur 30–40 % der Zeit von Entwicklerinnen und Entwicklern ausmacht, lässt sich der gesamte Zyklus selbst bei doppelter Codiergeschwindigkeit höchstens um etwa ein Drittel verkürzen. Gleichzeitig schiebt das beschleunigte Codieren in der Praxis mehr offene Arbeit in Review und Tests.
Mehrere Zahlen aus der Forschung ergeben eine vollständige Ursache-Wirkungs-Kette: Agenten schreiben mehr, also entstehen mehr Merge Requests; die Zahl der Kommentare pro Merge Request steigt um 53 %, was zeigt, dass Reviewende mehr Aufwand brauchen, um KI-generierten Code zu verstehen und infrage zu stellen; der Anteil der Merge Requests, die überarbeitet werden müssen, verdoppelt sich, was auf eine sinkende Qualität der ersten Einreichung hindeutet. Diese Kosten landen bei den menschlichen Reviewenden – und das sind oft die erfahrensten und zeitlich am stärksten ausgelasteten Personen im Team.
| Phase | Veränderung durch KI | Typische Symptome | Priorität |
|---|---|---|---|
| Planung und Umfang | Bei unklaren Anforderungen schreibt die KI „selbstbewusst“ in die falsche Richtung | Nacharbeit, Merge Request wird komplett verworfen | Hoch |
| Codierung | Geschwindigkeit deutlich erhöht | Codeumfang explodiert, individuelle Produktivität wirkt gut | Bereits optimiert |
| Code-Review | Anzahl und Komplexität der offenen Reviews steigen gleichzeitig | Review-Warteschlangen, endloses Kommentar-Hin-und-Her | Höchste |
| Tests | Testabdeckung hält mit der Menge des neuen Codes nicht Schritt | Mehr Regressionsprobleme | Hoch |
| Deployment und Betrieb | Das Verständnis der Entwickelnden für den Code wird geringer | Fehlersuche wird langsamer | Mittel- bis langfristig |
Auch die Diskussion in der Community bestätigt das. Ein Entwickler kommentierte: „Jede Codezeile ist ein potenzielles Risiko.“ Andere wiesen darauf hin, dass Agenten keine besonders zuverlässigen Kollaborateure seien und bei dem Versuch, eine Aufgabe zu erledigen, auch absurde Dinge tun könnten. Nach einer weiteren Einschätzung wird die mittlere Wiederherstellungszeit (MTTR) zu einem wichtigen Indikator für die Bewertung der KI-Auswirkungen, denn je weniger Entwickelnde den Code verstehen, den sie ausliefern, desto schwieriger wird die Fehlersuche.
AI-Coding-Effizienz schnell umsetzen: Die 5-Schritte-Methode zum Durchbruch
Die folgenden Methoden sind nach aufsteigendem Aufwand geordnet, sodass Teams sie der Reihe nach umsetzen können. Bei jedem Schritt werden möglichst messbare Kennzahlen angegeben, um unüberprüfbare Einschätzungen wie „es fühlt sich schneller an“ zu vermeiden.
Schritt 1: Eine Lieferbasis für die AI-Coding-Effizienz etablieren
Wechseln Sie nicht voreilig die Tools – bauen Sie zuerst das Messsystem auf. Der Grund, warum die Studie ein Gefälle feststellen konnte, liegt darin, dass sie sowohl Produktions- als auch Lieferkennzahlen betrachtet hat. Viele Teams schauen nur auf Codezeilen und Commit-Zahlen und glauben dann fälschlicherweise, die Effizienzsteigerung sei sehr erfolgreich gewesen.
Es empfiehlt sich, zwei Gruppen von Kennzahlen gleichzeitig zu verfolgen: Auf der Produktionsseite die Anzahl der Commits und Merge Requests; auf der Lieferseite die pro Person und Monat geschlossenen Tickets sowie den Zyklus vom Anforderungsbeginn bis zum Go-live. Ergänzen Sie drei Kennzahlen aus dem Review-Bereich: die durchschnittliche Review-Dauer eines Merge Requests, die Kommentaranzahl pro Merge Request und den Anteil an Nacharbeit. Diese Daten lassen sich in der Regel direkt aus Git-Plattformen und Ticketsystemen wie Jira exportieren.
| Kennzahlenkategorie | Konkrete Kennzahl | Datenquelle | Beobachtungsschwerpunkt |
|---|---|---|---|
| Produktion | Anzahl Commits, Merge Requests | Git-Plattform | Nur als Referenz, nicht zur Bewertung |
| Lieferung | Pro Person und Monat geschlossene Tickets, Anforderungszyklus | Ticketsystem | Zentrale Zielkennzahl |
| Review | Review-Dauer, Kommentaranzahl, Nacharbeitsquote | Git-Plattform | Engpass-Warnung |
| Qualität | Anzahl Online-Störungen, MTTR | Monitoring und Vorfallprotokolle | Langfristige Gesundheit |
Schritt 2: Die Anforderungsplanung vorab an den KI-Coding-Agenten übergeben
Wenn Anforderungen vage sind, neigen Agenten am ehesten dazu, selbstbewusst in die falsche Richtung zu laufen. Anstatt in der Review-Phase einen ganzen Merge Request wieder zu verwerfen, ist es besser, vor dem Start zehn Minuten in eine klare Aufgabenbeschreibung zu investieren: Welche Module geändert werden sollen, welche Schnittstellen nicht angefasst werden dürfen, wie die Abnahmekriterien aussehen und welche Tests ergänzt werden müssen.
Eine praktische Vorgehensweise: Der Agent gibt zuerst einen Umsetzungsplan aus, den die Ingenieure bestätigen, bevor es ans Codieren geht. Änderungen in der Planungsphase sind deutlich günstiger als in der Codierungsphase und geben Reviewern frühzeitig einen Überblick über den Änderungsumfang. Dieser Schritt scheint zunächst Zeit im Vorfeld zu kosten, reduziert aber direkt Probleme wie den „doppelt so hohen Anteil an Merge Requests, die nachgearbeitet werden müssen“.
Schritt 3: Die Granularität der Merge Requests für KI-generierten Code steuern
Die Aufmerksamkeit von Reviewern ist eine begrenzte Ressource. Auch wenn Studien zeigen, dass die gestiegene Review-Last nicht allein an größeren einzelnen Merge Requests liegt, bleibt die Kontrolle der Granularität das direkteste Mittel, um die kognitive Belastung zu senken. Es empfiehlt sich, für Agentenaufgaben klare Grenzen zu setzen: Ein Merge Request löst nur ein Problem, Refactoring und funktionale Änderungen werden getrennt eingereicht.
Gleichzeitig sollte der Agent verpflichtet werden, in der Merge-Request-Beschreibung das Änderungsmotiv, den Auswirkungsbereich und die Ergebnisse der Selbsttests anzugeben. Reviewer können das Risiko dann anhand der Beschreibung einschätzen, statt aus Hunderten Zeilen Diff die Absicht zurückzuerschließen – die Zahl der Hin-und-Her-Kommentare sinkt spürbar.
🎯 Technischer Hinweis: Modelle unterscheiden sich deutlich in der Aufgabenzerlegung und der Qualität ihrer Pläne. APIYI apiyi.com bietet API-Zugriff auf die in diesem Artikel erwähnten gängigen Modelle wie Claude und GPT und ist gleichzeitig mit den beiden Schnittstellenformaten von OpenAI und Anthropic kompatibel. Teams können innerhalb desselben Agenten-Workflows die Modelle wechseln und vergleichen, welches Modell Merge Requests mit geringerer Nacharbeitsquote erzeugt. Wie Sie das einbinden, erfahren Sie in der APIYI-Dokumentation unter docs.apiyi.com.
Schritt 4: Tests und Selbstprüfung an den Agenten übergeben, nicht an die Reviewer
Eine Untersuchung ergab, dass der Anteil der am Review beteiligten Personen nach der Einführung KI-gestützter Reviews dennoch um 14 % gestiegen ist. Das zeigt: Es reicht nicht, im Review-Prozess einfach eine KI zu ergänzen. Wirksamer ist es, die Qualitätskontrolle nach vorne zu verlagern: Der Agent soll schon vor dem Einreichen Unit-Tests ergänzen, Tests lokal ausführen, statische Checks und Formatierung erledigen.
Man kann „Tests bestanden, Checks bestanden“ als harte Voraussetzung für das Einreichen eines Merge Requests festlegen und die CI Verstöße automatisch blockieren lassen. Reviewer können sich dadurch auf die Sinnhaftigkeit des Designs, Grenzfälle und die Geschäftslogik konzentrieren, statt auf Nullpointer und Namensprobleme hinzuweisen. KI-Review-Tools eignen sich als erster Filter, die endgültige Entscheidung sollte aber weiterhin von Menschen kommen, die das Geschäft verstehen.
Schritt 5: Abgestufte Reviews und Risikostufung für KI-generierten Code
Nicht jeder KI-generierte Code muss gleich intensiv geprüft werden. Man kann Änderungen nach Risiko einstufen: Dokumentation, Tests und Boilerplate-Code kommen in ein leichtes Review; Geschäftslogik in ein reguläres Review; Änderungen an Authentifizierung, Zahlungen, Datenmigration oder Nebenläufigkeit müssen von Senior-Engineers intensiv geprüft werden – und der Autor muss jede Änderung erklären können.
| Risikostufe | Änderungstyp | Review-Form | Empfohlene Reviewer-Anzahl |
|---|---|---|---|
| Niedrig | Dokumentation, Testfälle, Boilerplate-Code | KI-Vorprüfung + schnelle manuelle Bestätigung | 1 Person |
| Mittel | Reguläre Geschäftslogik | Vollständiges manuelles Review | 1–2 Personen |
| Hoch | Authentifizierung, Zahlungen, Datenmigration, Nebenläufigkeit | Intensives Review durch Senior-Engineers + Erklärung durch den Autor | 2 Personen oder mehr |
Schließlich sollte man die MTTR langfristig verfolgen. Wenn das Verständnis der Engineers für den Code immer oberflächlicher wird, zeigen sich die Probleme bei Störungen im Produktivbetrieb. Regelmäßig vom Autor erklären zu lassen, welchen KI-Code er selbst gemergt hat, ist ein kostengünstiges Mittel, um zu verhindern, dass „niemand diesen Code wirklich versteht“.
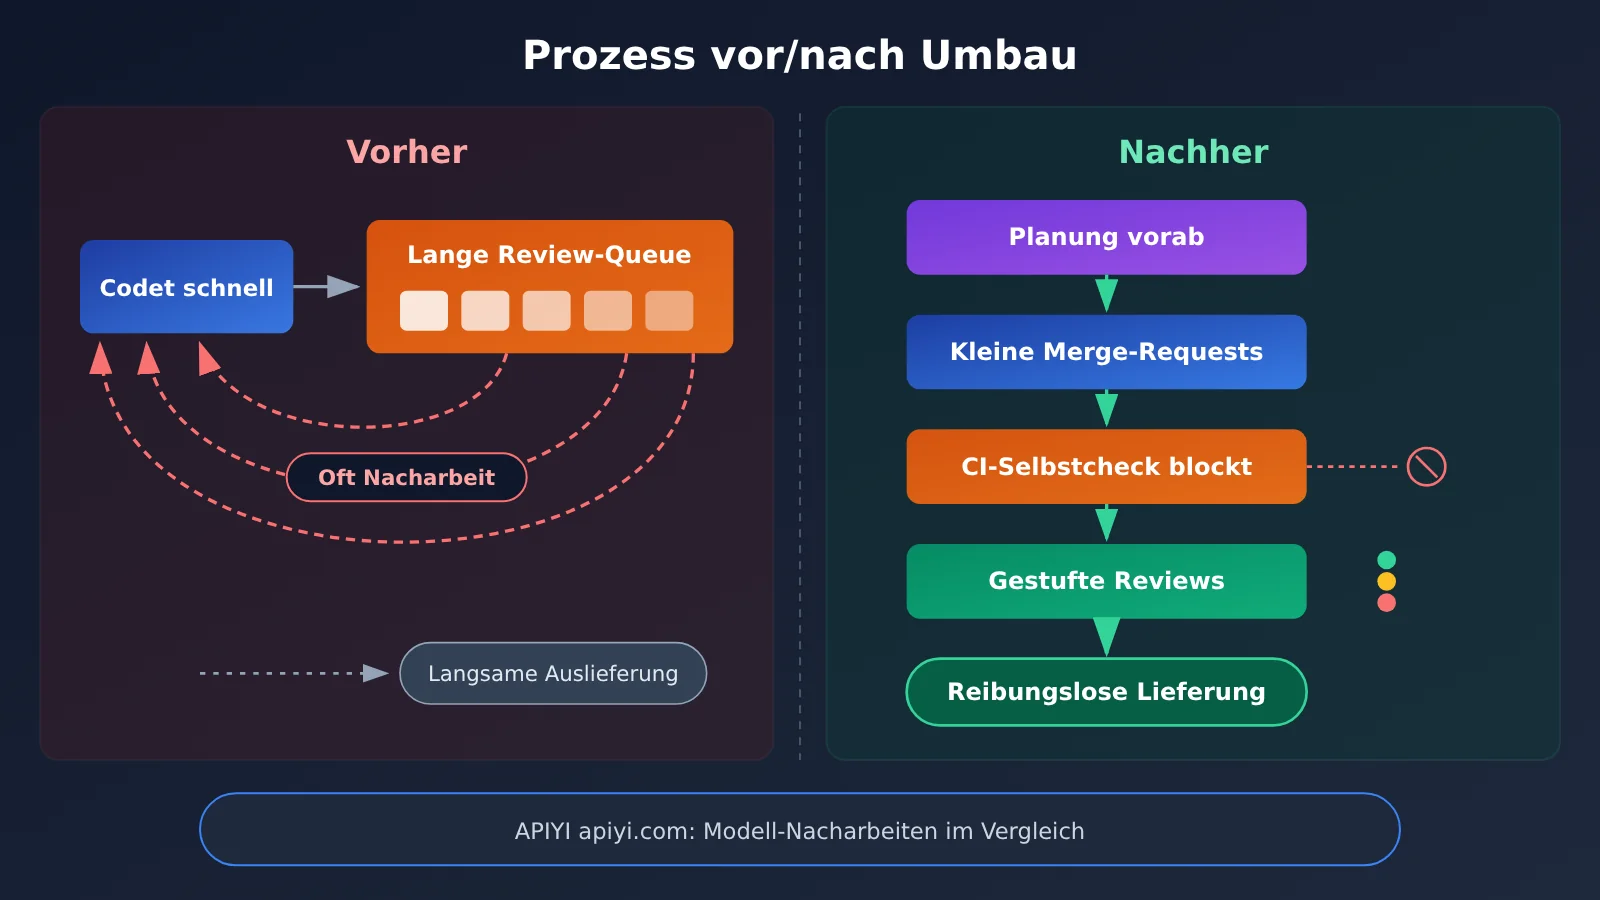
🚀 Schnellstart: Wenn du gerade einen internen Coding-Agenten für dein Team aufbaust, kannst du zuerst bei APIYI apiyi.com Testguthaben beantragen, dieselbe Aufgabenbeschreibung mit verschiedenen Modellen durchspielen und die Review-Dauer sowie die Nacharbeitsquote der erzeugten Merge Requests festhalten. Danach entscheidest du, welches Modell dein Hauptmodell wird.
Modellauswahl-Referenz für KI-Coding-Agenten
Die Modellauswahl allein löst keine Prozessengpässe, beeinflusst aber die Qualität des ersten Commits und damit den Review-Aufwand. Die folgende Tabelle gibt aus Sicht der Workflow-Rollen eine richtungsweisende Empfehlung. Die konkreten Ergebnisse sollten Sie anhand der Tests Ihres eigenen Teams bewerten.
| Workflow-Rolle | Kompetenzschwerpunkt | Auswahlansatz | Verfügbare Plattformen |
|---|---|---|---|
| Erstellung des Implementierungsplans | Verständnis langer Kontexte, Aufgabenzerlegung | Ein Flaggschiffmodell mit starker Schlussfolgerungsfähigkeit wählen | APIYI apiyi.com, offizielle API |
| Code schreiben und refaktorisieren | Codequalität, Einhaltung von Vorgaben | Ein Modell mit guten Ergebnissen in Programmier-Benchmarks wählen | APIYI apiyi.com, offizielle API |
| Testergänzung und Selbstprüfung | Stabil, hohes Aufrufvolumen | Ein Modell mit gutem Preis-Leistungs-Verhältnis wählen | APIYI apiyi.com, offizielle API |
| KI-Erstprüfung | Häufige Fehler erkennen | Vom schreibenden Modell abweichen, um blinde Flecken aus derselben Quelle zu vermeiden | APIYI apiyi.com, offizielle API |
💰 Kostenhinweis: Agent-Workflows haben ein hohes Aufrufvolumen. Die Abrechnungsgrundlage (Einzelpreise für Eingabe, Ausgabe und Cache-Treffer) bestimmt die Kosten direkt. Dieser Artikel nennt keine konkreten Preise. Alle Preis- und Abrechnungsinformationen der Modelle entnehmen Sie bitte den Echtzeitdaten auf der Preisseite von APIYI unter docs.apiyi.com/models.
Häufig gestellte Fragen (FAQ)
F1: Was bedeutet „KI-Coding lässt die Code-Menge um 30 % wachsen, aber die Lieferung nur um 12 %“?
Das ist das Ergebnis einer Harvard-Studie auf Basis von Jellyfish-Daten: Nach dem Einsatz von KI-Agenten wuchs die Zahl der Codezeilen um 30 %, doch die pro Ingenieur und Monat gelösten Tickets stiegen nur um 12 %. Die Lücke entsteht vor allem dadurch, dass nachgelagerte Schritte wie Code-Review und Tests zum neuen Engpass werden.
F2: Wie groß ist der Effizienzunterschied zwischen KI-Programmierassistenten und KI-Agenten?
Bei Programmierassistenten fällt der Produktivitätszuwachs kleiner aus: Nur das Plus von 9 % bei den Commits ist statistisch signifikant, und die Zahl gelöster Tickets steigt nicht. KI-Agenten hingegen steigern Codezeilen, Commits und Merge Requests um 30 %, 20 % bzw. 23 % und sorgen für ein Plus von 12 % bei den Tickets.
F3: Sind die Daten dieser Studie zur Effizienzsteigerung beim KI-Coding vertrauenswürdig?
Der Datenzeitraum reicht von Januar 2021 bis März 2026 und umfasst mehr als 700 Unternehmen, 700.000 Mitarbeitende und rund 300 Millionen Arbeitsereignisse. Die Schätzung der Arbeitszeitverteilung wurde zusätzlich durch eine Umfrage unter 100 Ingenieuren validiert – Stichprobengröße und Kreuzvalidierung sind also recht solide.
F4: Löst die Einführung von KI-Code-Review-Tools den Review-Engpass?
Allein reicht das nicht. Die Studie zeigt, dass nach der Einführung KI-gestützter Reviews der Anteil der am Review beteiligten Personen noch um 14 % zunahm. Wirksamer ist es, Tests und Selbstprüfung vor den Commit zu verlagern und zusätzlich auf abgestufte Reviews zu setzen, damit sich die manuelle Prüfung auf risikoreiche Änderungen konzentriert.
F5: Wie lässt sich mit geringem Aufwand prüfen, wie stark verschiedene Modelle die Review-Last beeinflussen?
Empfohlen ist, mehrere Modelle anhand derselben realen Aufgaben zu vergleichen:
1. Bei APIYI apiyi.com registrieren und Testguthaben abrufen
2. Gemäß der APIYI-Dokumentation unter docs.apiyi.com das bestehende Agent-System im OpenAI- oder Anthropic-kompatiblen Format anbinden
3. Für jedes Modell die Review-Dauer, die Kommentaranzahl und die Nacharbeitsrate der generierten Merge Requests erfassen
So wählen Sie Modelle anhand von Daten statt nach Eindruck.
F6: Wie lassen sich die Kosten für KI-Coding-Agenten im Team schätzen?
Zählen Sie zunächst den durchschnittlichen Verbrauch an Eingabe- und Ausgabe-Tokens pro Aufgabe und multiplizieren Sie ihn mit dem Modellpreis und dem monatlichen Aufgabenvolumen. Agent-Aufgaben haben oft einen sehr langen Kontext, und Cache-Treffer beeinflussen die Kosten deutlich. Konkrete Preise und die Abrechnungsregeln für Caching entnehmen Sie bitte der APIYI-Preisseite docs.apiyi.com/models.
F7: Welche langfristigen Risiken birgt die Effizienzsteigerung beim KI-Coding?
Das Hauptrisiko ist, dass das Verständnis der Ingenieure für den Code oberflächlicher wird. In der Community herrscht die Ansicht, dass Störfälle häufiger und die Fehlersuche schwieriger werden kann, wenn die Codebasis stetig wächst, das Verständnis aber nicht mithält. Empfohlen ist, die durchschnittliche Wiederherstellungszeit bei Störfällen langfristig zu verfolgen und von den Autoren zu verlangen, dass sie den von ihnen gemergten KI-Code erklären können.
Kernaussagen zur Effizienzsteigerung beim KI-Coding
- Output ist nicht gleich Delivery: KI-Agenten steigern die Code-Menge um 30 %, die ausgelieferten Tickets aber nur um 12 %
- Coding macht nur 30 bis 40 Prozent der Zeit aus: Wer nur das Schreiben von Code optimiert, stößt bei der Gesamteffizienz sehr schnell an eine Obergrenze
- Review ist der größte Engpass: Review-Dauer +49 %, Kommentare +53 %, Nacharbeitsquote verdoppelt
- KI-Review ist keine Wunderwaffe: Nach der Einführung stieg der Anteil der Personen, die am Review beteiligt sind, weiter um 14 %
- Qualitätsprüfung nach vorne verlagern: Planung vorziehen, kleine Commits, Selbstprüfung vor dem Commit – das wirkt am besten
- MTTR langfristig im Blick behalten: verhindern, dass Teams „viel KI-Code schreiben, aber wenig davon verstehen“
- Modelle mit Daten auswählen: Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich die Nacharbeitsquoten der einzelnen Modelle vergleichen
Fazit
Wo die Effizienzsteigerung beim KI-Coding hängen bleibt – darauf hat die Forschung schon Antworten:
- Der Engpass hat sich verlagert: Wird das Coding schneller, werden Code-Review, Tests und Planung zur neuen Bremse
- Kennzahlen immer im Paar betrachten: Output-Kennzahlen müssen gemeinsam mit Delivery-, Review- und Qualitätskennzahlen verfolgt werden
- Prozesse ändern ist wichtiger als Tools zu wechseln: Planung vorziehen, Granularität kontrollieren, Selbstprüfung nach vorne verlagern, Reviews abstufen – Schritt für Schritt
Echte Effizienzsteigerung heißt nicht, dass die KI mehr Code schreibt, sondern dass weniger Code mit höherer Erstqualität durch das Review kommt. Die Empfehlung: Erst einen Sprint lang Basisdaten erheben und dann die oben beschriebenen fünf Schritte nach und nach umsetzen.
Wenn Sie in Agenten-Workflows die Leistung verschiedener Modelle vergleichen möchten, empfiehlt sich ein schneller Test über APIYI apiyi.com. Die Plattform ist mit den API-Formaten von OpenAI und Anthropic kompatibel; die Preise finden Sie unter docs.apiyi.com/models.
📚 Referenzen
- InfoQ Chinesisch: Von KI generierter Code wird durch nachgelagerte Engpässe ausgebremst: Chinesische Version des Forschungsberichts
- Link:
infoq.cn/article/c3vTLNrRwfCzw8SAmz90 -
Beschreibung: Enthält Forschungsmethodik, Kerndaten und Community-Diskussionen
-
InfoQ Englischer Originalartikel: Jellyfish AI Productivity: Englische Version des Forschungsberichts
- Link:
infoq.com/news/2026/10/jellyfish-ai-productivity -
Beschreibung: Für Leser geeignet, die die englischen Originalformulierungen nachlesen möchten
-
APIYI Dokumentationszentrum: Modellintegration und Schnittstellenbeschreibung
- Link:
docs.apiyi.com -
Beschreibung: Zugang über OpenAI- und Anthropic-kompatible Formate
-
APIYI Modellpreisseite: Abrechnungsgrundlagen der einzelnen Modelle
- Link:
docs.apiyi.com/models - Beschreibung: Die Preise für Eingabe, Ausgabe und Caching richten sich nach den Echtzeitdaten auf dieser Seite
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com.