Nota do autor: uma análise dos critérios de cobrança de Tokens de entrada, saída, cache e raciocínio, além de conteúdo multimodal, com métodos práticos para conferir o uso nos logs de chamadas, identificar “aumentos repentinos de custo” e lidar com mudanças de preço.
No fim do mês, você abre a fatura e percebe que o custo de um modelo aumentou bastante em relação ao mês anterior, embora o número de chamadas quase não tenha mudado. Essa é uma situação comum para equipes que já usam APIs de Modelos de Linguagem Grande em produção. Neste artigo, apresentamos um método de análise por item de cobrança + conferência com os logs de chamadas para ajudar você a entender e verificar a fatura da API.
Este não é um levantamento de preços. Como os preços dos fornecedores mudam com frequência, não listamos valores unitários específicos. O foco está nos critérios de cobrança e nos métodos de conferência que continuam úteis ao longo do tempo.
Um sinal do setor que vale observar: em novembro de 2026, uma empresa de infraestrutura de IA estava recrutando para uma vaga de operações de plataformas de Modelos de Linguagem Grande. Entre as responsabilidades, aparecia explicitamente a “verificação de custos e cobranças”, incluindo a conferência dos critérios de cobrança de Tokens de entrada e saída, Tokens de cache, Tokens de raciocínio e conteúdo como imagens, áudio e vídeo. A pessoa também deveria identificar rapidamente faturas anormais, mudanças de preço e divergências de cobrança. Se o fornecedor da plataforma precisa de alguém dedicado a isso, é porque os critérios de cobrança são complexos por si só. Como usuário da API, você também precisa criar sua própria rotina de conferência.
O que você vai aprender: ao terminar a leitura, você saberá de onde vem cada item da fatura da API de Modelos de Linguagem Grande, como conferir o uso com os logs de chamadas e como identificar rapidamente a causa de um “aumento repentino no custo de uma mesma requisição”.
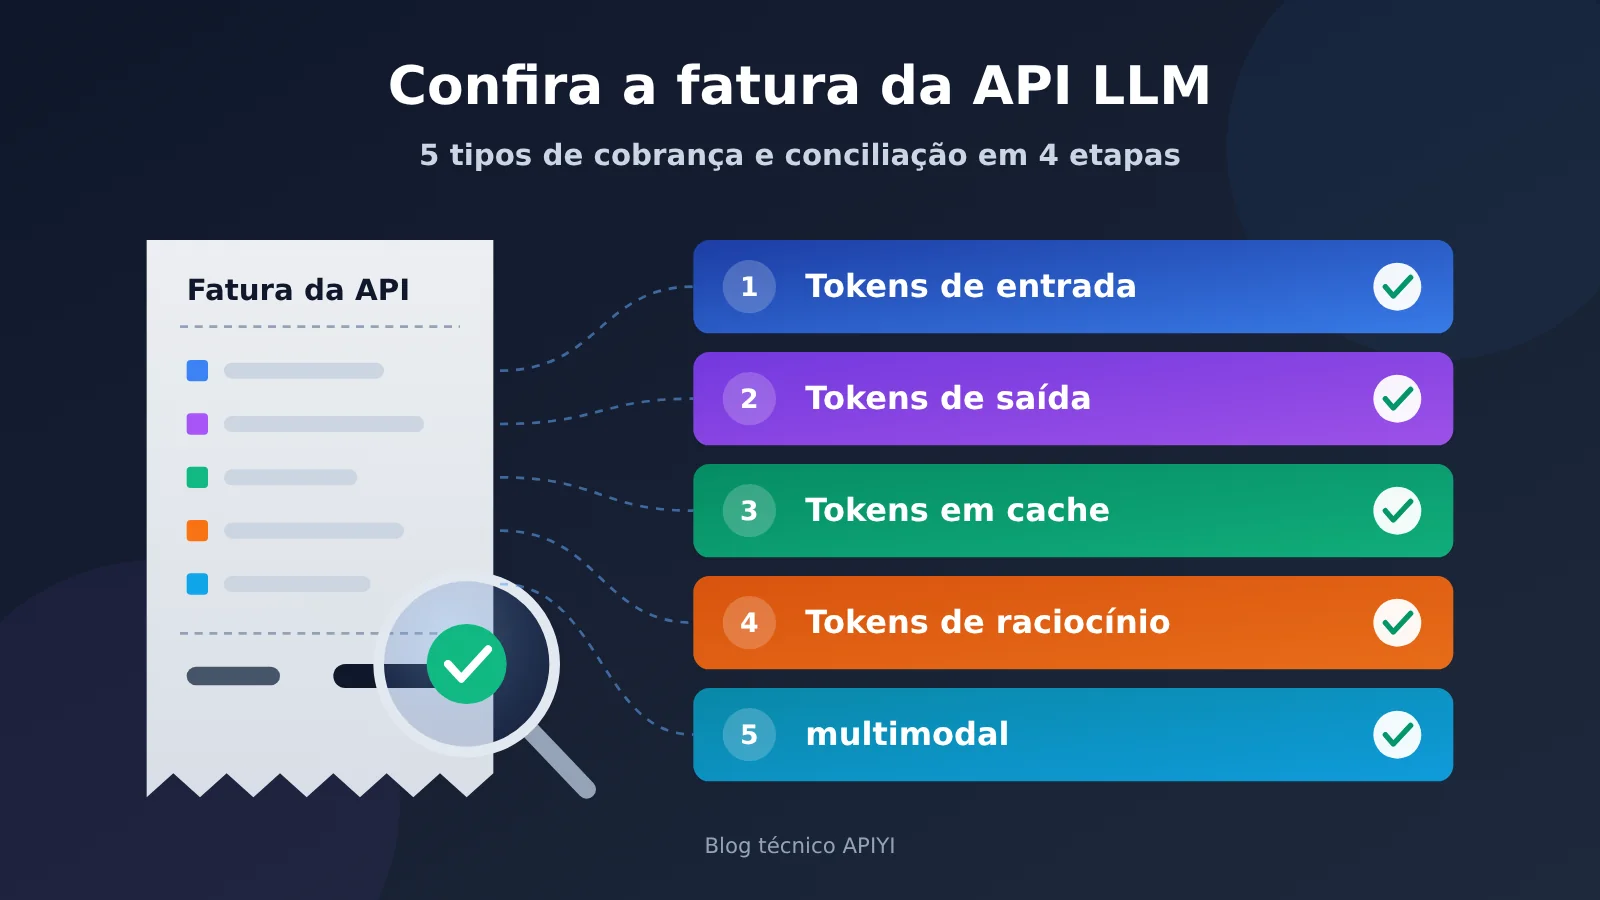
Pontos essenciais da cobrança de APIs de Modelos de Linguagem Grande: 5 categorias
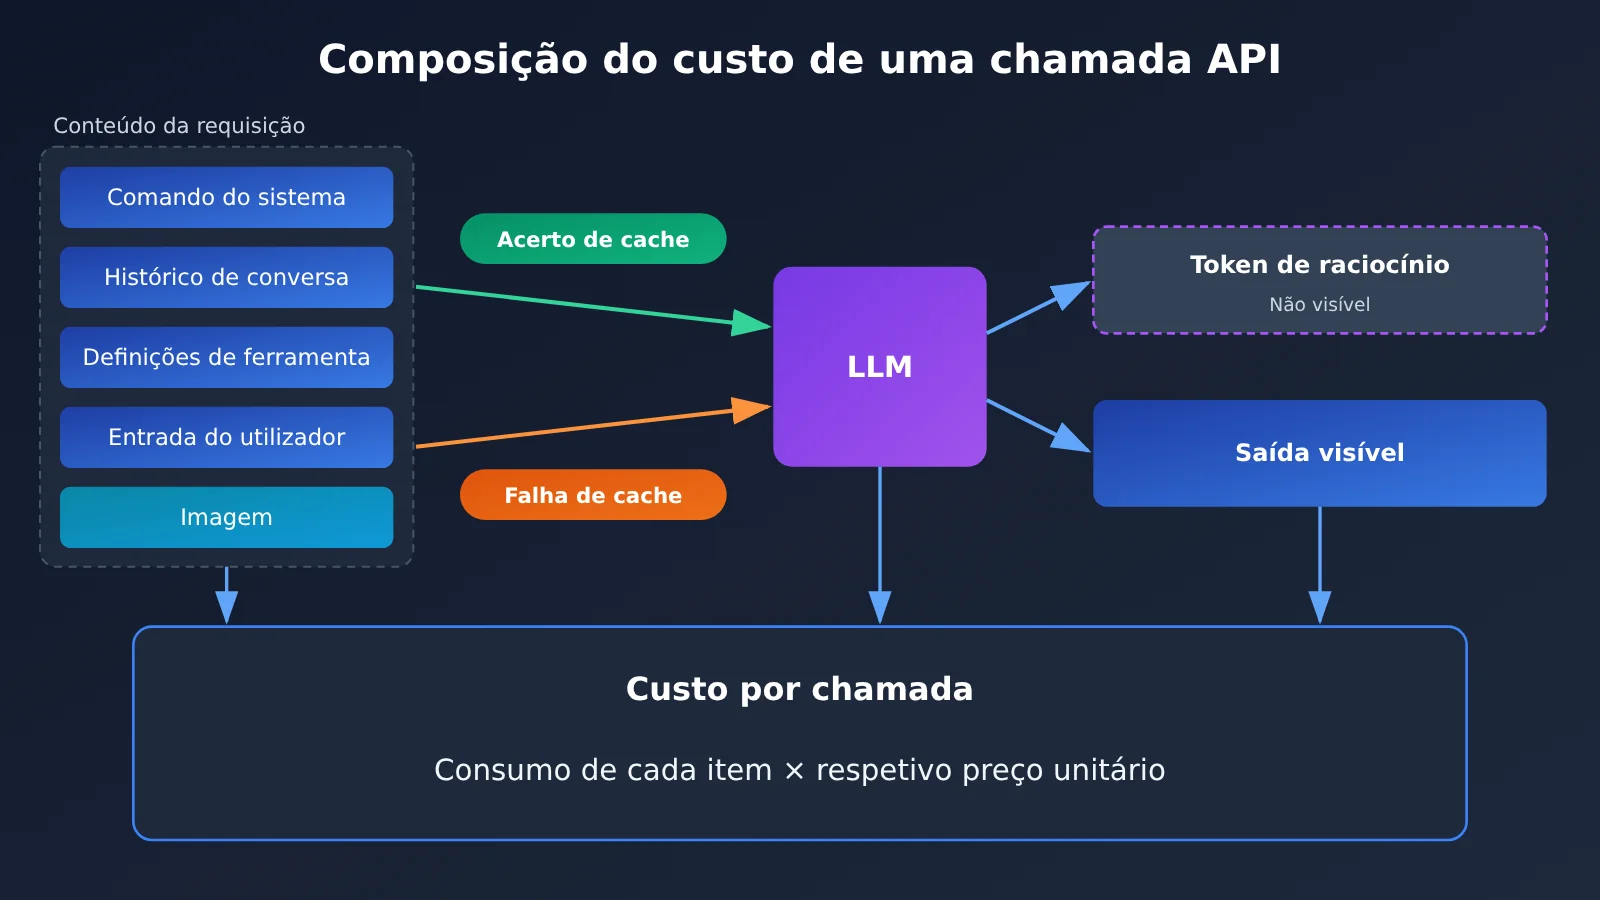
O custo de uma invocação do modelo geralmente não é tão simples quanto “número de chamadas × preço unitário”. Cada categoria tem preços e origens diferentes. Analisar tudo junto pode levar a uma interpretação equivocada da estrutura de custos.
| Categoria de cobrança | Origem | Características comuns de preço | O que conferir na fatura |
|---|---|---|---|
| Tokens de entrada | Comando de sistema, histórico da conversa, definições de ferramentas, documentos recuperados e entrada do usuário | Cobrança por Token, geralmente mais barata que a saída | Se o contexto está crescendo sem que você perceba |
| Tokens de saída | Resposta visível gerada pelo modelo | Cobrança por Token, geralmente com preço unitário maior que o da entrada | Comprimento das respostas e configuração de max_tokens |
| Tokens de cache | Prefixo de entrada recuperado do cache | A parte recuperada costuma ter desconto; alguns fornecedores cobram separadamente pela gravação | Se a taxa de acertos está caindo |
| Tokens de raciocínio | Processo interno de raciocínio dos modelos de raciocínio | Geralmente cobrados como saída, mas nem sempre aparecem na resposta | Se o raciocínio está ficando mais longo |
| Cobrança multimodal | Entrada ou geração de imagens, áudio e vídeo | Cobrança por imagem, segundo, resolução ou conversão em Tokens | Se os parâmetros de especificação mudaram |
Por que a fatura da API de um Modelo de Linguagem Grande pode não bater
O primeiro motivo são os Tokens invisíveis. Você pode ter escrito apenas uma pergunta do usuário no código, mas a requisição enviada pode incluir milhares de Tokens em comandos de sistema, histórico de várias rodadas e Schemas de ferramentas. Modelos de raciocínio também podem gerar muitos Tokens de raciocínio que o usuário não vê. Tudo isso entra na fatura, mesmo sem aparecer na interface.
O segundo motivo é a falta de padronização nos critérios de cobrança. Para entrada de imagens, por exemplo, alguns fornecedores cobram por imagem, enquanto outros convertem a resolução em Tokens. Com o cache, alguns fornecedores o ativam automaticamente, outros exigem uma declaração explícita; alguns dão desconto apenas na leitura, enquanto outros também cobram pela gravação. Ao comparar modelos e fornecedores, é preciso primeiro alinhar esses critérios.
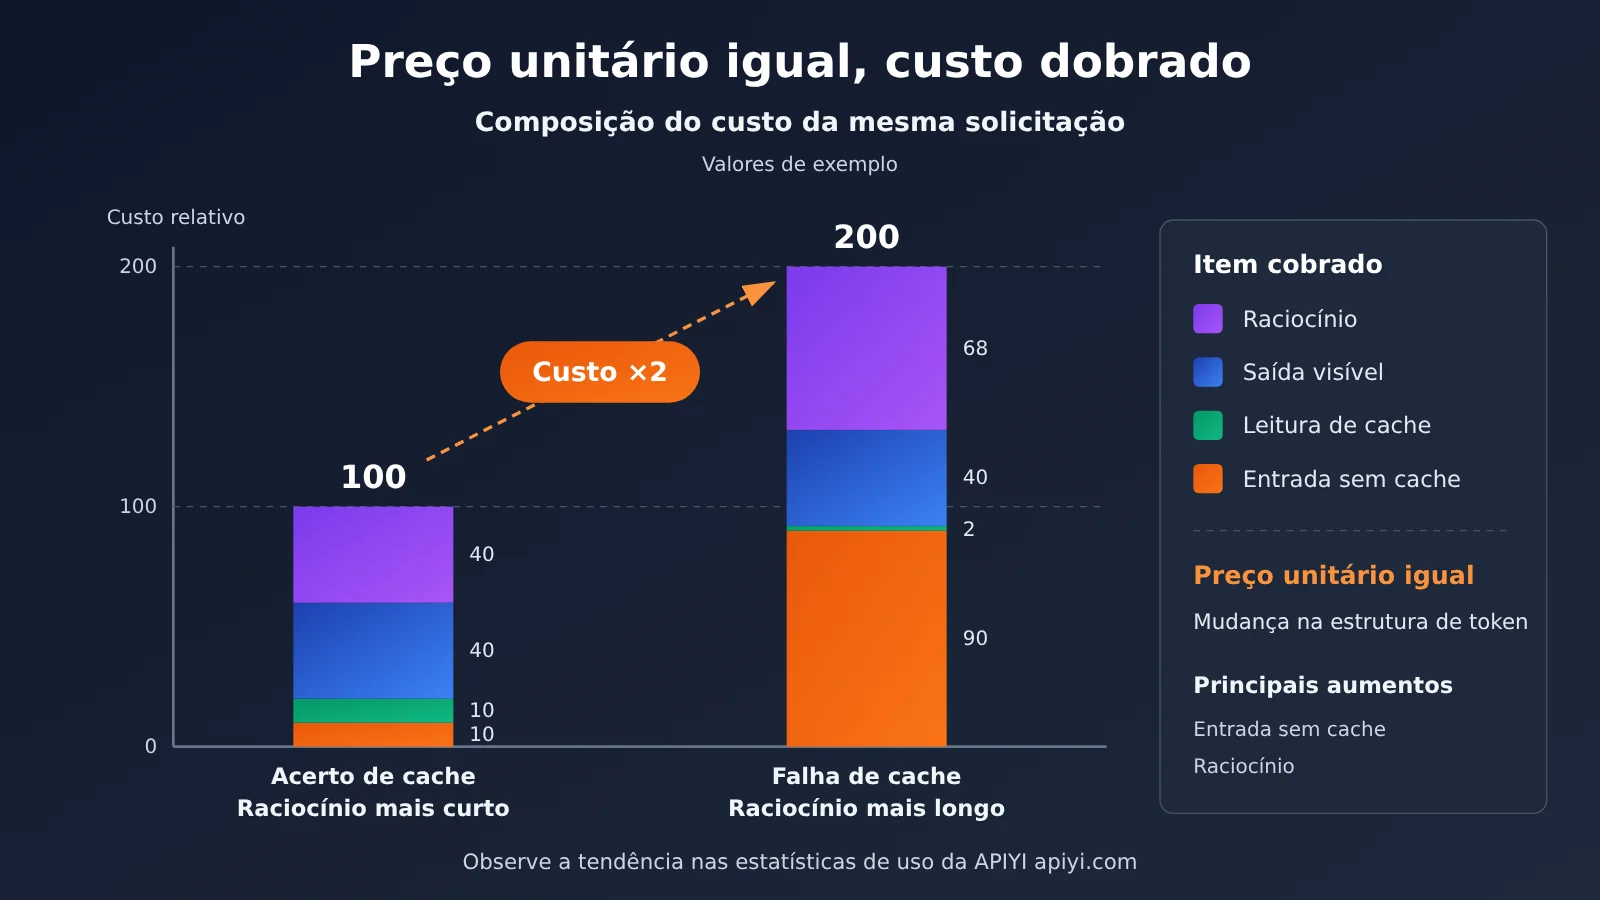
O terceiro motivo é que as variáveis mudam com o tempo. Um alias de modelo pode passar a apontar para uma nova versão, uma pequena alteração no prefixo do comando pode invalidar todo o cache, e um modelo de raciocínio pode pensar por mais tempo diante de uma pergunta mais difícil. Mesmo sem mudança no preço unitário, a fatura pode mudar.
Entenda cada item da cobrança de APIs de Modelos de Linguagem Grande
Tokens de entrada: a parte mais fácil de subestimar
Os tokens de entrada incluem tudo o que o modelo “lê” em uma solicitação, não apenas a mensagem do usuário. Em conversas com várias rodadas, o histórico anterior é reenviado a cada rodada. Quanto mais longa a conversa, maior o custo de entrada por rodada, e o custo total cresce aproximadamente com o quadrado do número de rodadas.
Aplicações RAG também consomem muitos tokens de entrada. A quantidade de trechos de documentos recuperados e o tamanho de cada trecho determinam diretamente esse custo. Com Function Calling, o JSON Schema que define as ferramentas é contabilizado como entrada em cada solicitação. Quanto mais ferramentas, maior o custo fixo.
Outro ponto importante: cada modelo pode usar um tokenizador diferente. O número de tokens de um mesmo texto em chinês pode variar bastante entre modelos, então não dá para usar a contagem de um modelo para estimar o custo de outro.
Tokens de saída: preço mais alto, controlados diretamente por parâmetros
Os tokens de saída são o conteúdo da resposta gerada pelo modelo. A maioria dos fornecedores cobra um preço por token de saída bem mais alto que por token de entrada. Por isso, pedir que o modelo seja mais direto costuma gerar mais economia do que reduzir a entrada.
max_tokens define um limite para o custo de saída, mas não é uma garantia. Se a resposta for truncada, a parte já gerada ainda será cobrada. Quando uma transmissão é interrompida, o tratamento dos tokens já gerados também pode variar entre plataformas; consulte a documentação oficial.
Tokens em cache: a economia depende do reaproveitamento
O cache de comandos funciona assim: quando várias requisições compartilham o mesmo prefixo, como um comando de sistema ou um documento longo, o fornecedor pode reutilizar a parte já processada e aplicar um desconto a esses tokens de entrada.
Confira algumas regras comuns de cache:
- Ativação automática: alguns fornecedores ativam o cache por padrão; outros exigem que a posição do cache seja marcada explicitamente na requisição;
- Correspondência do prefixo: normalmente, o conteúdo precisa ser idêntico desde o início; qualquer alteração no prefixo invalida o reaproveitamento de todo o trecho posterior;
- Comprimento mínimo e prazo de validade: prefixos muito curtos podem não ser armazenados; depois que o cache expira, é necessário gravá-lo novamente;
- Cobrança pela gravação: alguns fornecedores cobram mais pela primeira gravação no cache do que pela entrada normal; apenas as leituras posteriores saem mais baratas.
Na conferência dos custos, contabilize separadamente os “tokens de leitura do cache” e os “tokens de entrada normal”. Assim, você evita interpretar uma queda na taxa de acerto do cache como um aumento no volume de chamadas.
Tokens de raciocínio: invisíveis, mas cobrados
Modelos de raciocínio fazem um processamento interno antes de responder, e esses tokens geralmente são cobrados pelo preço de saída. Em muitos casos, o conteúdo desse raciocínio não é retornado integralmente: você só consegue ver a quantidade nos campos de uso.
A quantidade de tokens de raciocínio varia conforme a dificuldade da pergunta e o parâmetro de intensidade de raciocínio. Mesmo usando a mesma API, perguntas mais difíceis podem aumentar a conta. Se a aplicação só precisa fazer classificações simples ou converter formatos, usar um modelo de raciocínio geralmente significa pagar por um processamento desnecessário.
Cobrança multimodal: primeiro, confirme “pelo que se paga”
As formas de cobrança multimodal variam bastante, por isso vale consultar a página oficial de preços de cada modelo. A tabela abaixo apresenta métodos comuns de cobrança; confira as regras atuais publicadas por cada fornecedor.
| Tipo | Método comum de cobrança | Parâmetros que afetam o custo | O que conferir |
|---|---|---|---|
| Entrada de imagens (compreensão) | Convertida em tokens conforme a resolução ou cobrada por imagem | Dimensões da imagem, parâmetro de nível de detalhe | Registre a resolução real antes e depois do upload |
| Geração de imagens | Cobrada por imagem ou por tokens de saída | Dimensões, nível de qualidade, quantidade gerada | Registre os parâmetros de cada solicitação |
| Entrada/saída de áudio | Cobrada por duração ou convertida em tokens de áudio | Duração do áudio, método de processamento e amostragem | Registre a duração real do áudio |
| Síntese de voz | Cobrada por número de caracteres ou por tokens | Comprimento do texto, categoria da voz | Registre o comprimento do texto usado na síntese |
| Geração/compreensão de vídeo | Cobrada por segundo, por quadro ou por faixa de resolução | Duração, resolução, taxa de quadros | Registre a combinação de duração e resolução |
| Embedding | Cobrado por tokens de entrada | Comprimento do texto, tamanho do lote | Contabilize separadamente do preço normal de entrada |
🎯 Dica técnica: em cenários multimodais, é melhor usar um ponto de entrada único para facilitar o gerenciamento das diferentes formas de cobrança. A apresentação oficial da APIYI apiyi.com informa que os modelos da plataforma usam um saldo unificado e que ela oferece estatísticas de uso e logs de chamadas. Confira primeiro quais campos aparecem nos logs do console e, depois, decida quais parâmetros precisam ser registrados à parte na planilha de conciliação.
Primeiros passos com a fatura de API de Modelos de Linguagem Grande: conciliação em 4 etapas
A ideia central da conciliação é simples: multiplique o consumo registrado pelo preço unitário registrado para obter o custo esperado e compare o resultado com a fatura da plataforma. Se a diferença ultrapassar a margem de tolerância, investigue item por item.
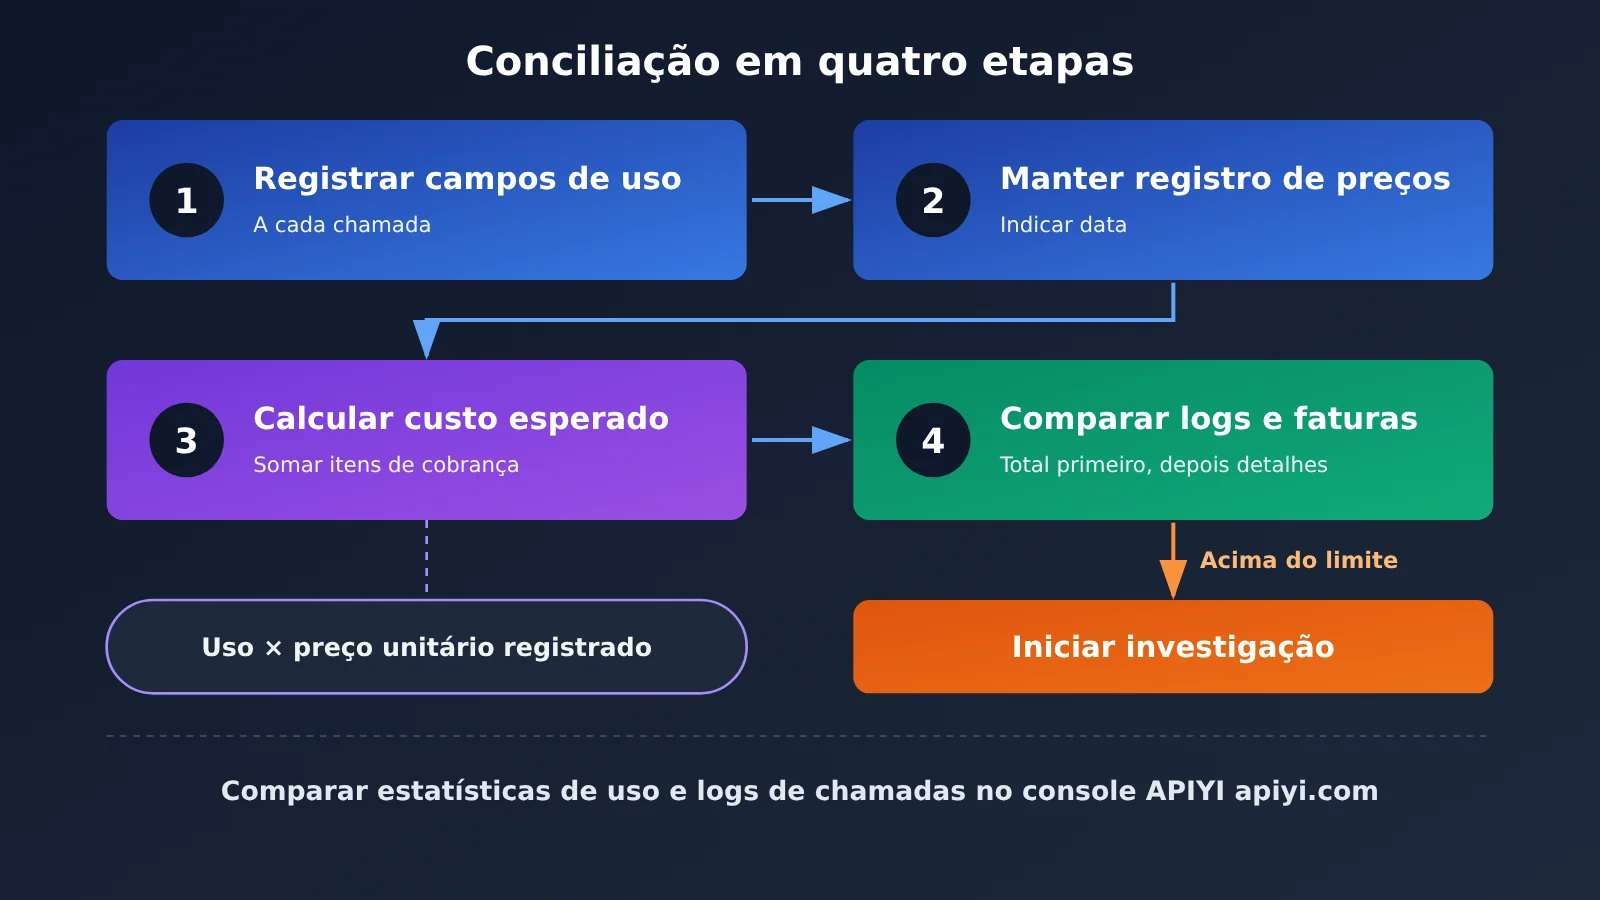
Etapa 1: registre os campos de consumo após cada chamada
APIs compatíveis com o formato da OpenAI geralmente retornam um objeto usage na resposta. Veja abaixo os campos mais comuns e seus significados. Os dados retornados podem variar entre modelos e plataformas, então faça uma requisição de teste antes da integração para confirmar.
| Campo (nomes comuns no formato compatível com OpenAI) | Significado | Item de cobrança correspondente |
|---|---|---|
prompt_tokens |
Total de tokens de entrada da requisição | Entrada (incluindo a parte em cache) |
prompt_tokens_details.cached_tokens |
Parte da entrada encontrada no cache | Leitura de cache |
completion_tokens |
Total de tokens de saída | Saída (pode incluir a parte de raciocínio) |
completion_tokens_details.reasoning_tokens |
Parte da saída usada para raciocínio | Raciocínio |
model |
Nome do modelo que gerou a resposta | Usado para identificar mudanças de versão |
Recomendamos salvar pelo menos as seguintes informações a cada chamada:
- Horário da requisição, ID da requisição e identificador do cenário de uso;
- Nome do modelo especificado na requisição e
modelretornado na resposta; - Todos os campos de consumo da tabela acima; registre os campos ausentes como vazios, não como 0;
- Parâmetros de requisições multimodais, como tamanho da imagem, duração do áudio e quantidade gerada;
- Se a chamada usou streaming, se houve nova tentativa e se a resposta foi truncada (
finish_reason).
Lembre-se de que prompt_tokens e completion_tokens geralmente representam os totais, enquanto cache e raciocínio são detalhes incluídos nesses valores. Ao calcular o custo, subtraia primeiro esses detalhes dos totais e depois multiplique cada parcela pelo preço unitário correspondente. Caso contrário, você pode contabilizar valores duas vezes ou deixar de aplicar descontos.
Passo 2: mantenha um histórico de preços com datas
Não fixe os preços unitários diretamente no código. Mantenha uma tabela de histórico de preços em que cada linha registre o nome do modelo, o item cobrado, o preço unitário, a moeda, a data de vigência e a fonte (página oficial de preços ou anúncio da plataforma).
Quando houver uma alteração de preço, adicione uma nova linha em vez de sobrescrever o valor anterior. Assim, você poderá recalcular a fatura de qualquer dia com os preços vigentes naquela data. Se você fizer chamadas por uma plataforma agregadora como a APIYI, use os preços unitários publicados pela plataforma e registre também a data da consulta.
Passo 3: calcule o custo esperado
O custo esperado de cada chamada pode ser calculado somando os seguintes itens:
- Tokens de entrada não encontrados no cache × preço unitário de entrada;
- Tokens lidos do cache × preço unitário de leitura do cache (se houver cobrança por gravação no cache, adicione esse valor);
- Tokens de saída visíveis × preço unitário de saída;
- Tokens de raciocínio × preço unitário correspondente (na maioria dos casos, igual ao de saída; confira a documentação oficial);
- Custos multimodais, calculados separadamente conforme os critérios de cobrança de cada modalidade.
Ao consolidar os valores por dia, modelo e cenário de uso, você terá um registro de quanto espera gastar.
Etapa 4: compare com os logs e a fatura da plataforma
Compare seus registros com as estatísticas de uso e os logs de chamadas da plataforma. Comece pelo valor total, depois compare os valores por modelo e, por fim, identifique as requisições específicas.
Defina uma margem de tolerância. Pequenas diferenças são comuns por causa do câmbio, da precisão do faturamento e dos fusos horários usados nas estatísticas. Só é necessário investigar item por item quando a diferença ultrapassar esse limite.
🚀 Comece rápido: se você já faz chamadas a modelos na APIYI apiyi.com, exporte os logs de um período e compare cada chamada com o campo
usageque você registrou. A distinção entre tokens de cache e de raciocínio nos logs depende dos campos oferecidos pela plataforma no momento. Se eles não estiverem separados, use os campos das respostas registrados localmente para detalhar os dados.
Sinais de anomalia na fatura de uma API de Modelo de Linguagem Grande: como investigar mudanças repentinas nos custos
Uma mudança repentina no custo de requisições do mesmo tipo é um sinal que merece atenção. A tabela abaixo reúne causas comuns e como investigá-las.
| Anomalia | Possível causa | Como investigar |
|---|---|---|
| Custo por chamada aumentou, mas o volume de chamadas não mudou | O alias do modelo passou a apontar para uma nova versão, com preço unitário ou consumo de tokens diferente | Compare o campo model nas respostas antes e depois da mudança |
| Custo de entrada aumentou, mas o total de tokens de entrada não mudou | A taxa de acerto do cache caiu | Veja a proporção de cached_tokens e verifique se o prefixo do comando foi alterado |
| Custo de saída aumentou, mas o tamanho da resposta visível não mudou | Aumento dos tokens de raciocínio | Observe a tendência de reasoning_tokens e confira os parâmetros de intensidade do raciocínio |
| Tokens de entrada aumentam lentamente e de forma contínua | Histórico da conversa sem truncamento, mais trechos recuperados ou mais definições de ferramentas | Examine amostras do corpo completo das requisições |
| Número de chamadas maior que o volume de operações | Novas tentativas do cliente ou reenvio após timeout | Elimine duplicatas nas estatísticas usando os IDs de requisição e de operação |
| Aumento repentino nos custos de imagens ou vídeos | Resolução, nível de qualidade ou quantidade de gerações aumentou | Compare os parâmetros de especificação nas requisições |
| Preço unitário da fatura difere do snapshot de preços | Alteração de preços pelo fornecedor oficial ou pela plataforma | Consulte a página de preços e os anúncios e atualize o snapshot de preços |
Falha no cache: o aumento de custo mais difícil de perceber
Falhas no cache costumam surgir de uma mudança aparentemente inofensiva. Por exemplo, adicionar a data atual ao início do comando de sistema ou inserir o ID do usuário no prefixo. Assim, o prefixo de cada requisição fica diferente, o cache deixa de ser aproveitado e o custo de entrada volta ao preço integral.
A prática recomendada é colocar o conteúdo fixo no início e o conteúdo variável no final. Depois de alterar o modelo de comando, confira no dia seguinte se a taxa de acerto do cache mudou.
Variação na extensão do raciocínio: a dificuldade também afeta a fatura
O custo dos modelos de raciocínio está relacionado à dificuldade das perguntas. Se, em um determinado dia, os usuários fizerem de repente várias perguntas complexas, os tokens de raciocínio aumentarão de forma perceptível. Essa é uma variação normal. Mas, se eles continuarem aumentando sem mudança no tipo de requisição, verifique se houve alteração na versão do modelo ou nos parâmetros de raciocínio.
Hábitos para acompanhar mudanças de preço na fatura da API de Modelos de Linguagem Grande
Não dá para controlar as mudanças de preço, mas dá para controlar a rapidez com que você as identifica. Veja uma rotina de acompanhamento fácil de manter:
- Toda semana: confira a tendência de gastos por modelo e o custo médio por chamada, procurando mudanças bruscas;
- Todo mês: faça uma conferência completa da fatura e investigue cada diferença que ultrapassar o limite definido;
- Após cada alteração em um modelo de comando: acompanhe a taxa de acertos do cache por 1 a 2 dias;
- Antes de trocar ou atualizar um modelo: compare o consumo de tokens e os custos do modelo antigo e do novo usando um volume pequeno de chamadas;
- Acompanhe os anúncios: assine as atualizações de preços e modelos dos fornecedores ou plataformas que você usa e atualize seu registro de preços assim que recebê-las;
- Fixe as versões: em produção, procure usar nomes de modelos com números de versão específicos para evitar surpresas causadas pela atualização automática de aliases.
💡 Dica: se sua aplicação usa modelos de vários fornecedores, conferir faturas em contas diferentes pode consumir muito tempo. Com o acesso unificado pela APIYI apiyi.com, você pode consultar o uso de diferentes modelos em um mesmo saldo e conjunto de logs, facilitando a comparação do custo por chamada. Vale conferir no console quais detalhes estão disponíveis.
Perguntas frequentes FAQ
Q1: O que é um Token na fatura de API de um Modelo de Linguagem Grande?
Token é a unidade básica que o modelo usa para processar texto. Ele pode ser entendido como um fragmento resultante da divisão do texto. Um caractere chinês pode corresponder a um ou mais Tokens, dependendo do tokenizador do modelo. A fatura costuma cobrar separadamente pelas quantidades de Tokens de entrada, saída, cache e raciocínio.
Q2: Qual é a diferença entre Tokens em cache e Tokens de entrada comuns?
Ambos são Tokens de entrada, mas os Tokens em cache correspondem à parte que aproveitou um prefixo já armazenado e geralmente têm desconto. Os Tokens de entrada comuns são cobrados pelo preço cheio. Alguns fornecedores também cobram separadamente pela gravação inicial no cache, então vale contabilizar as três categorias à parte na conciliação.
Q3: Por que os Tokens de raciocínio não aparecem na resposta?
Os Tokens de raciocínio são gerados durante o processo interno do modelo. Muitos modelos não retornam o raciocínio completo a quem fez a chamada, informando apenas a quantidade nos campos de uso. Eles costumam ser cobrados pelo preço dos Tokens de saída, então o custo pode ser alto mesmo quando a resposta é curta.
Q4: Por que o custo de uma mesma solicitação pode mudar de repente?
Há três motivos mais comuns: o alias do modelo passou a apontar para uma nova versão, uma mudança no prefixo do comando invalidou o cache ou o raciocínio ficou mais longo. Outras causas incluem cobranças duplicadas por novas tentativas e o aumento dos parâmetros de especificação multimodal. Para identificar a causa, confira cada item da tabela de sinais de anomalia deste artigo.
Q5: Como usar os logs da plataforma para conferir a fatura de API de um Modelo de Linguagem Grande?
Primeiro, registre no seu sistema o campo `usage` de cada resposta e o ID da solicitação. Depois, exporte os logs de chamadas da plataforma e compare cada solicitação. No caso da APIYI apiyi.com, por exemplo, você pode consultar as estatísticas de uso e os logs de chamadas no console. Confira quais campos estão disponíveis nos logs e compare-os com os registros locais.
Q6: Como estimar o custo de modelos multimodais?
Primeiro, consulte a página oficial de preços para confirmar a forma de cobrança: por imagem, por segundo ou por Tokens calculados com base na resolução. Depois, registre nos logs das solicitações os parâmetros relevantes, como tamanho da imagem, duração do áudio e resolução e duração do vídeo. Use esses parâmetros e os preços unitários para fazer a estimativa.
Q7: Por onde começar quando a conciliação mostra diferenças?
Primeiro, confirme se o registro de preços está atualizado para descartar mudanças de tarifa. Depois, compare o número de chamadas para identificar novas tentativas e solicitações duplicadas. Por fim, separe as diferenças por modelo e por item de cobrança para descobrir se elas estão na entrada, no cache, no raciocínio ou na parte multimodal.
Q8: Quais são as limitações desse método de conciliação?
Ele depende dos campos de uso retornados na resposta. Se alguns modelos ou interfaces não fornecerem detalhes de cache e raciocínio, será preciso depender da fatura da plataforma. Além disso, câmbio, precisão da cobrança e fuso horário das estatísticas podem causar pequenas diferenças. Por isso, defina limites razoáveis em vez de esperar valores exatamente iguais.
Principais pontos sobre a fatura de API de Modelos de Linguagem Grande
- O custo reúne várias categorias: entrada, saída, cache, raciocínio e recursos multimodais têm preços diferentes e precisam ser contabilizados separadamente.
- Os tokens de entrada vão muito além da pergunta do usuário: comandos de sistema, histórico, documentos recuperados e definições de ferramentas também contam como entrada.
- O acerto de cache depende de prefixos idênticos: coloque o conteúdo fixo no início e as variáveis no final; após alterar o template, confira a taxa de acerto.
- Tokens de raciocínio são cobrados, mesmo quando não aparecem: evite modelos de raciocínio em tarefas simples e acompanhe a evolução da quantidade de tokens usados para raciocínio.
- Em recursos multimodais, primeiro pergunte “qual é a unidade de cobrança?”: pode ser por imagem, segundo ou resolução. Consulte a página oficial de preços.
- Concilie em quatro etapas: registre o uso, mantenha um histórico de preços, calcule o custo esperado e compare-o com os logs e a fatura.
- Uma entrada unificada facilita a conciliação: com o saldo unificado e os logs de chamadas da APIYI apiyi.com, é possível conferir o uso de vários modelos em um só lugar.
Resumo
Para entender e conferir a fatura de API de Modelos de Linguagem Grande, concentre-se em três pontos:
- Separe os custos: divida o custo de cada chamada em entrada, cache, saída, raciocínio e recursos multimodais, identificando a origem de cada parcela;
- Mantenha seus próprios registros: salve os campos de uso e os parâmetros de especificação de cada chamada em um banco de dados e mantenha um histórico de preços com data;
- Compare regularmente: acompanhe as tendências semanalmente e confira o total da fatura a cada mês. Se os custos mudarem de repente, investigue a versão do modelo, os acertos de cache, a quantidade de tokens de raciocínio, as tentativas de repetição e os parâmetros de especificação.
Os operadores das plataformas verificam esses critérios de cobrança, mas quem usa as APIs também precisa criar o hábito de conferir as próprias faturas. Se sua empresa precisa usar modelos de vários provedores, uma opção é centralizar o acesso pela APIYI apiyi.com, consultar o uso e os logs de chamadas em um único console e aplicar os métodos deste artigo para fazer a conferência.
📚 Referências
- Vaga no V2EX: operações de plataforma de Modelos de Linguagem Grande em uma empresa de infraestrutura para agentes de IA: as responsabilidades incluem “verificação de custos e faturamento”
- Link:
v2ex.com/t/1254263 -
Descrição: publicada em 03-11-2026, a vaga descreve a necessidade de verificar os critérios de cobrança de tokens de entrada e saída, tokens de cache, tokens de raciocínio, imagens, áudio e vídeo, além de identificar cobranças anormais, alterações de preço e divergências no faturamento
-
Páginas oficiais de preços dos fornecedores de modelos: a única fonte confiável para preços unitários e regras de cobrança
- Link: consulte a seção de preços ou documentação no site oficial do fornecedor utilizado
- Descrição: os preços mudam com frequência; registre sempre a data da consulta ao citá-los
Autor: equipe técnica da APIYI
Troca de experiências técnicas: tem dúvidas sobre a conferência de cobranças de APIs de Modelos de Linguagem Grande? Entre em contato pela página inicial da APIYI, em apiyi.com. Para mais informações sobre integração, consulte a central de documentação em docs.apiyi.com.