Nota do autor: ao comparar o custo de modelos, olhar apenas o preço por milhão de tokens pode levar à escolha errada. Este artigo apresenta uma forma de calcular o custo com base em “preço unitário × consumo real de tokens” e o passo a passo para testar novamente os modelos com uma pequena amostra das suas próprias tarefas.
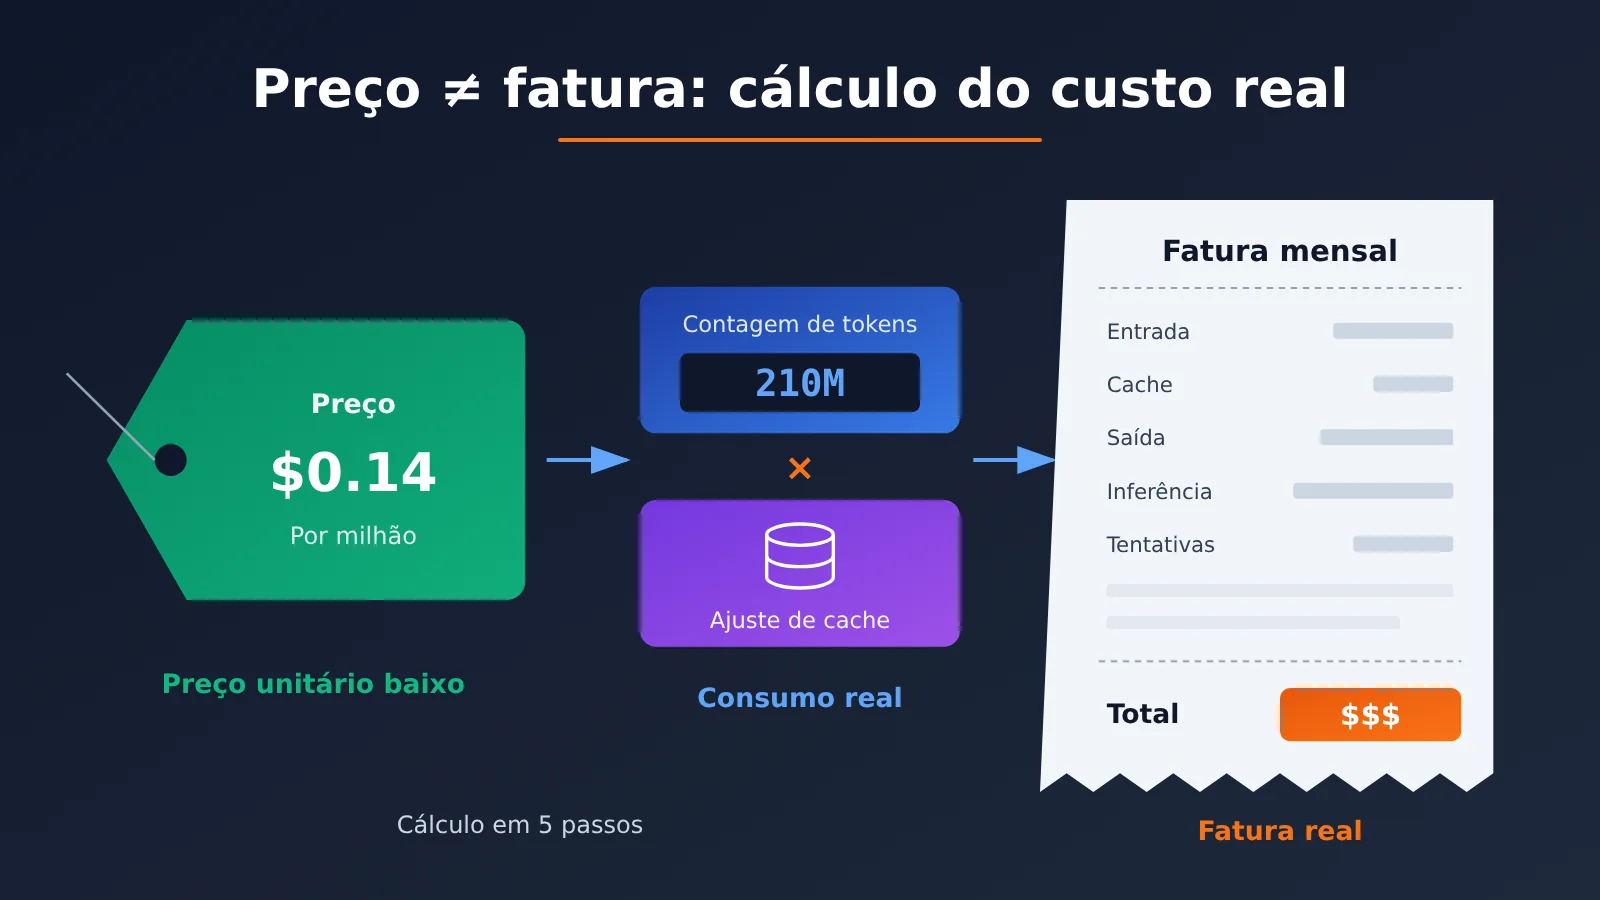
Na hora de escolher um modelo, muitas equipes começam pela página de preços. Veem que o modelo A custa apenas alguns centavos por milhão de tokens, enquanto o modelo B custa vários dólares, e concluem que o A é mais econômico. Mas a fatura no fim do mês muitas vezes não bate com a expectativa: às vezes, o modelo “barato” acaba custando mais. Neste artigo, apresentamos um método para calcular o custo real: “preço unitário × consumo real de tokens + ajuste de cache”. Assim, você consegue fazer as contas ainda na fase de escolha.
Esta não é mais uma compilação de tabelas de preços. Tabelas ficam desatualizadas; o método de cálculo, não. Vamos transformar exemplos de análises públicas em uma abordagem geral e depois aplicá-la às suas próprias tarefas.
O que você vai aprender: ao terminar a leitura, você saberá explicar por que “preço de tabela baixo não significa fatura baixa” e calcular o custo por tarefa de cada modelo candidato usando de 20 a 50 requisições reais.
Principais pontos sobre o custo real dos modelos
| Ponto | Explicação | Impacto na escolha |
|---|---|---|
| O preço unitário é apenas um dos fatores | A conta é a soma da quantidade de cada tipo de token multiplicada pelo respectivo preço | Comparar apenas os preços unitários é olhar para apenas metade da fórmula |
| Diferenças de tokenização | Um mesmo texto pode ser dividido em quantidades diferentes de tokens por cada modelo | O custo de entrada precisa ser calculado com a contagem real de cada modelo |
| Tokens de raciocínio | O processo de raciocínio de modelos desse tipo geralmente é cobrado como saída, mesmo sem ficar visível para o usuário | Uma resposta curta pode gerar uma conta alta |
| Acerto de cache | Quando um prefixo repetido é encontrado no cache, ele é cobrado a um preço menor | A diferença é significativa em cenários com comandos de sistema longos e conversas de várias rodadas |
| Taxa de sucesso e novas tentativas | Respostas erradas ou em formato inadequado exigem uma nova execução | Custo efetivo = custo por execução ÷ taxa de sucesso |
Por que olhar apenas o preço por milhão de tokens leva a um cálculo errado do custo real
O preço por milhão de tokens mede “quanto custa cada token”, mas a conta mostra “quanto custa concluir uma tarefa”. Entre os dois, há uma variável fundamental: quantos tokens são necessários para concluir essa tarefa. A diferença entre modelos nesse quesito costuma ser maior que a diferença de preço unitário.
Um exemplo aparece em uma medição publicada por um blog independente em 1º de agosto de 2026: DeepSeek V4 Flash e Gemini 3.6 Flash tiveram a mesma pontuação na Artificial Analysis, com 50 pontos cada. O primeiro custava $0.14/M e o segundo, $1.50/M, uma diferença de aproximadamente 10 vezes no preço unitário. Mas, na mesma avaliação, o primeiro consumiu cerca de 210 milhões de tokens, enquanto o segundo consumiu cerca de 59 milhões — uma diferença de mais de 3 vezes. O consumo maior anulou boa parte da vantagem de preço, e a diferença real ficou bem abaixo de 10 vezes.
Outro ponto é a diferença de tokenização. Em um artigo de 12 de agosto de 2026 da mesma fonte, um documento idêntico foi enviado a 9 modelos para contagem. O resultado variou de 614 a 957 tokens, uma diferença de aproximadamente 56% entre o maior e o menor valor. Ou seja, mesmo que dois modelos tenham exatamente o mesmo preço de entrada, o custo de entrada para o mesmo comando pode variar em mais da metade.
💡 Nota sobre os dados: os números acima vêm de medições pontuais de um blog independente. As tarefas de avaliação, as versões dos modelos e os preços mudam com o tempo, então esses dados servem apenas para mostrar que essas diferenças existem. Não use os valores diretamente no seu orçamento: faça seus próprios testes com suas tarefas.
Composição da fatura do modelo: quais tipos de token entram no custo real
Para calcular o custo com precisão, primeiro é preciso saber quais itens são cobrados na fatura. Na maioria dos fornecedores, a cobrança pode ser dividida nas categorias abaixo. Os nomes e a cobrança separada de cada item dependem da documentação oficial de cada empresa.
| Item de cobrança | Significado | Forma comum de cobrança | Ponto fácil de ignorar |
|---|---|---|---|
| Entrada sem acerto de cache | Comando enviado pela primeira vez na solicitação, sem acerto de cache | Preço unitário de entrada | Depende do tokenizador: o mesmo texto pode ter custos diferentes |
| Entrada com acerto de cache | Parte do prefixo idêntica à de uma solicitação anterior | Preço de leitura do cache, geralmente bem menor que o de entrada | O prefixo precisa ser exatamente igual para haver acerto |
| Gravação em cache | Alguns fornecedores cobram separadamente pela primeira gravação no cache | Pode ser mais caro que a entrada comum | Com baixa taxa de acerto, pode sair mais caro |
| Saída visível | Resposta que o usuário vê ao final | Preço unitário de saída | O preço de saída costuma ser várias vezes maior que o de entrada |
| Tokens de raciocínio | Processo interno de pensamento do modelo | Geralmente cobrados pelo preço unitário de saída | Não aparecem na resposta, mas entram na fatura |
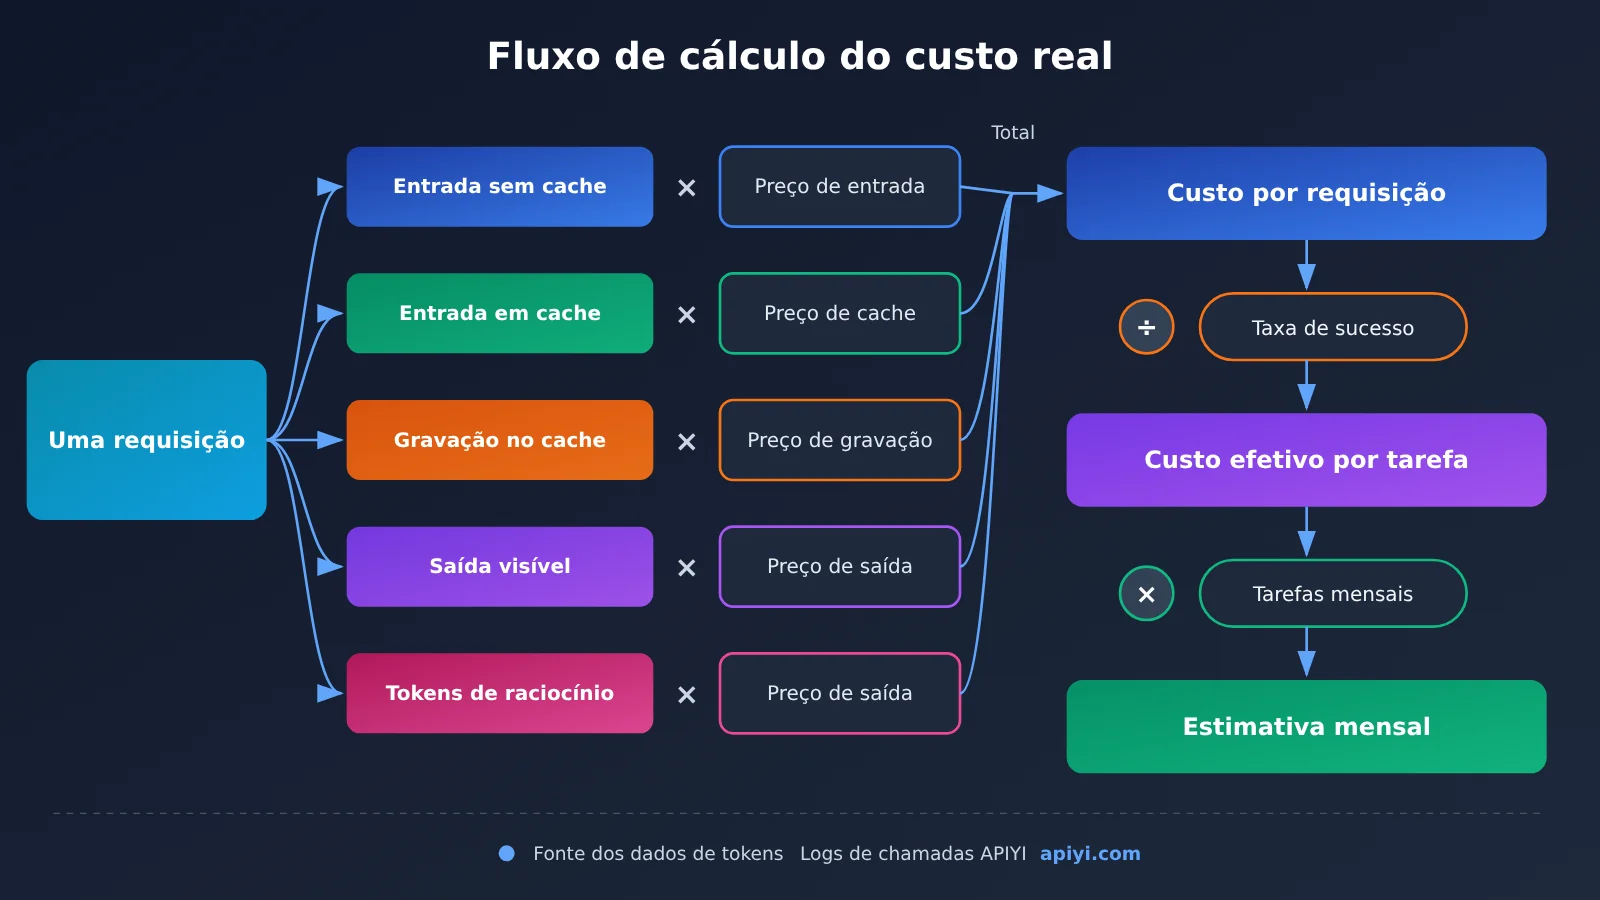
Juntando esses itens em fórmulas, temos a estrutura central de cálculo deste artigo:
- Custo por solicitação = tokens de entrada sem acerto de cache × preço unitário de entrada + tokens com acerto de cache × preço unitário de cache + tokens de gravação em cache × preço unitário de gravação + (saída visível + tokens de raciocínio) × preço unitário de saída
- Custo efetivo por tarefa = custo por solicitação × número médio de invocações ÷ taxa de sucesso da tarefa
- Estimativa mensal = custo efetivo por tarefa × volume mensal de tarefas
O impacto do cache costuma ser subestimado. Um artigo da mesma fonte, publicado em 6 de agosto de 2026, menciona que o preço do DeepSeek V4 Flash com acerto de cache é cerca de 50 vezes menor que sem acerto, enquanto os preços de cache de diferentes provedores de hospedagem podem variar em até 28 vezes. Isso mostra que a fatura de um mesmo modelo pode ser completamente diferente dependendo do canal usado. Por isso, confira o preço de cache no canal que você realmente utiliza.
Como os tokens de raciocínio ampliam o custo real
Modelos de raciocínio são uma das fontes mais comuns de surpresas: o preço anunciado é baixo, mas a conta sai cara. O usuário faz uma pergunta curta e o modelo responde com 200 caracteres, mas pode ter consumido milhares de tokens pensando antes de responder. Essa parte costuma ser cobrada pela tarifa de saída, que já é várias vezes maior que a de entrada.
Estimativas públicas de terceiros também mostram isso. Um artigo de 4 de agosto de 2026 afirma que o Qwen 3.8 Max teve uma pontuação 3 pontos maior que o DeepSeek V4 Flash no Artificial Analysis, mas custou cerca de 345 vezes mais e foi cerca de 6 vezes mais lento nos 3 testes realizados. Outro artigo da mesma série, usando o mesmo método de avaliação, apresenta estes resultados: o Kimi K3 marcou 57 pontos ao custo de $2,437; o DeepSeek V4 Flash marcou 50 pontos ao custo de $72; e o Qwen 3.7 Max marcou 46 pontos, mas custou $1,604. Sim, é possível ter uma pontuação menor e um custo maior — e a explicação costuma estar no consumo de tokens.
Também há diferenças entre versões de um mesmo fornecedor. Segundo um artigo, do Claude Opus 4.5 ao 4.8 e ao Opus 5, o preço anunciado é o mesmo: $5/$25. Ainda assim, os testes mostraram uma diferença de cerca de 1,30 vez no consumo de tokens. O preço não muda, mas a conta pode variar 30% — algo fácil de deixar passar ao atualizar a versão de um modelo.
Estime o custo real pelo consumo de tokens: comece em 5 passos
Este é um processo de estimativa com uma pequena amostra que não exige scripts complexos. O princípio central é simples: para a mesma tarefa e a mesma entrada, contabilize separadamente os tokens de entrada, saída, cache e raciocínio.
Passo 1: prepare uma amostra representativa de tarefas
Selecione de 20 a 50 solicitações do ambiente de produção ou de demandas reais, cobrindo os principais tipos de tarefa, como perguntas e respostas curtas, documentos longos e conversas com várias rodadas. Mantenha os comandos de sistema e o contexto completos nas amostras, pois é nesses prefixos repetidos que ocorrem os principais acertos de cache. Não teste apenas com um simples “olá”: isso não revela as diferenças de tokenização nem o efeito do cache.
Etapa 2: mantenha as variáveis fixas e invoque cada modelo candidato
Use o mesmo comando de sistema, a mesma entrada do usuário e as mesmas configurações de max_tokens e temperatura para cada modelo candidato. Se um modelo de raciocínio oferecer um parâmetro de intensidade de raciocínio, registre o nível usado no teste: a quantidade de tokens de raciocínio pode variar bastante entre níveis.
Nessa etapa, uma interface unificada evita bastante trabalho. Com plataformas agregadoras como APIYI apiyi.com, é possível alternar entre modelos de diferentes fornecedores usando a mesma chave API e o mesmo método de chamada compatível com OpenAI. Basta alterar o nome do modelo para executar toda a comparação, sem precisar criar contas, adicionar créditos e adaptar SDKs para cada fornecedor.
Etapa 3: registre cada tipo de token
Após cada chamada, leia a quantidade de tokens no campo usage da resposta. No formato compatível com OpenAI, os campos mais comuns incluem:
usage.prompt_tokens: número total de tokens de entradausage.prompt_tokens_details.cached_tokens: parcela atendida pelo cacheusage.completion_tokens: número total de tokens de saídausage.completion_tokens_details.reasoning_tokens: parcela de tokens de raciocínio
Os nomes dos campos variam entre fornecedores. No formato da Anthropic, por exemplo, cache_read_input_tokens e cache_creation_input_tokens diferenciam a leitura e a gravação de cache. Consulte a documentação de cada fornecedor para confirmar os detalhes.
Se preferir não analisar as respostas por conta própria, você também pode consultar os registros da plataforma. A APIYI oferece logs e estatísticas de uso para cada chamada, o que facilita comparar o consumo da mesma amostra em diferentes modelos. Antes de fazer os cálculos, confirme no console e nas informações de cobrança da plataforma se os logs discriminam tokens de cache e de raciocínio e se há cobrança diferenciada para acertos de cache.
🚀 Comece rápido: experimente primeiro uma comparação em pequena escala com 20 amostras na APIYI apiyi.com. Assim, você consegue entender a ordem de grandeza do consumo de tokens de cada modelo antes de decidir se vale ampliar a amostra. Com a cobrança em um saldo unificado, os gastos com testes de vários modelos ficam concentrados em uma só conta, o que também facilita a conferência depois.
Etapa 4: consolide os resultados no modelo de cálculo
Preencha a tabela abaixo com os resultados registrados, usando uma linha para cada modelo. Na coluna de preços, não deixe de informar a data da consulta e a fonte.
| Campo | Como preencher | Fonte dos dados |
|---|---|---|
| Modelo e versão | Informe o número exato da versão ou o sufixo de data | Parâmetros da chamada |
| Preços e data da consulta | Use uma coluna para cada preço: entrada, saída, leitura e gravação de cache | Página oficial de preços ou página de preços da plataforma utilizada |
| Média de tokens de entrada sem acerto de cache | Média das amostras | usage da resposta ou logs da plataforma |
| Média de tokens com acerto de cache | Média das amostras; calcule também a taxa de acerto | usage da resposta ou logs da plataforma, como as estatísticas de uso da APIYI |
| Média de tokens de saída visível | Total de saída menos a parte de raciocínio | usage da resposta |
| Média de tokens de raciocínio | Registre separadamente para modelos de raciocínio | usage da resposta |
| Taxa de sucesso das tarefas | Proporção de tarefas aprovadas por avaliação manual ou por regras | Registros de avaliação |
| Custo efetivo por tarefa | Calcule usando a fórmula apresentada anteriormente | Cálculo consolidado |
Etapa 5: tome decisões com base no custo efetivo por tarefa
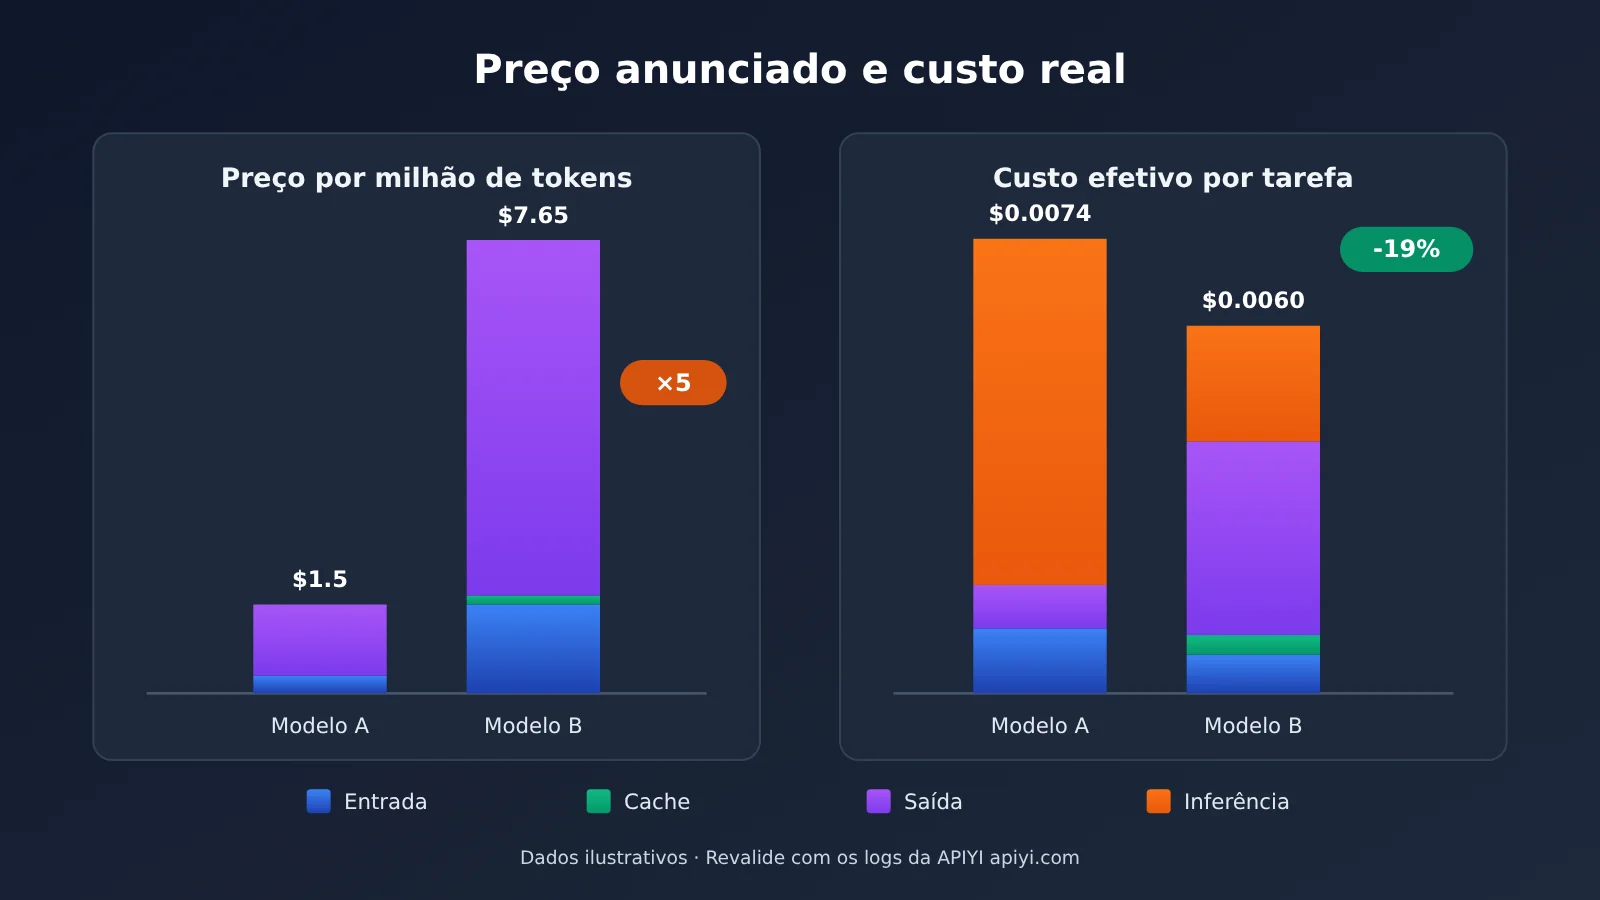
No fim, o que importa comparar não é o preço unitário, mas sim o “custo efetivo por tarefa”. A seguir, usamos preços ilustrativos para demonstrar o cálculo. Os números foram inventados para explicar o método e não representam os preços reais de nenhum modelo.
Suponha que o modelo A cobre $0.3/M por entrada e $1.2/M por saída; o modelo B cobre $1.5/M por entrada, $6/M por saída e $0.15/M por leitura de cache. Seus preços unitários são 5 vezes os do modelo A.
| Item de cálculo | Modelo A (preço menor) | Modelo B (preço maior) |
|---|---|---|
| Tokens de entrada sem acerto de cache | 3,000 | 400 |
| Tokens com acerto de cache | 0 | 2,000 |
| Tokens de saída visível + raciocínio | 500 + 4,000 | 500 + 300 |
| Custo de entrada | $0.0009 | $0.0006 + $0.0003 |
| Custo de saída | $0.0054 | $0.0048 |
| Custo por requisição | $0.0063 | $0.0057 |
| Taxa de sucesso das tarefas | 85% | 95% |
| Custo efetivo por tarefa | Cerca de $0.0074 | Cerca de $0.0060 |
Nesse cenário ilustrativo, a tokenização do modelo B é mais compacta, reduzindo a entrada total em 600 tokens; a maior parte de seu comando de sistema longo foi encontrada no cache; e seu processo de raciocínio também foi bem mais curto. No fim, apesar de ter preços unitários 5 vezes maiores, o modelo B apresentou um custo efetivo cerca de 19% menor que o do modelo A. Na prática, o resultado pode ser o contrário — por isso é importante repetir o teste com suas próprias tarefas.
Cuidados ao calcular o custo real
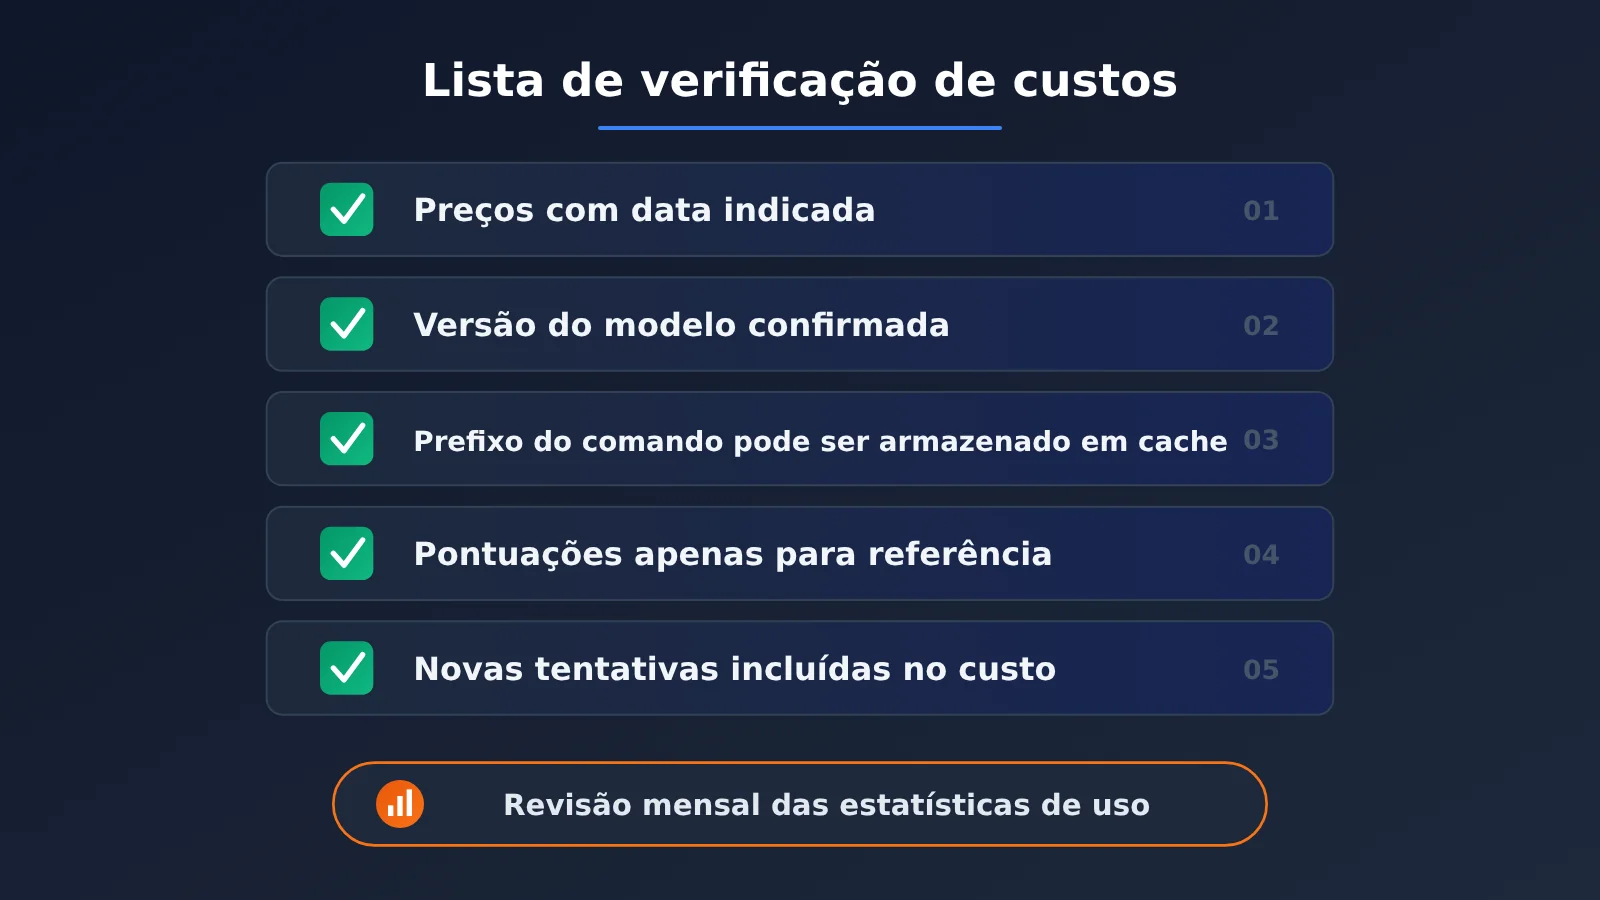
A metodologia de cálculo em si não é complicada, mas alguns detalhes podem distorcer os resultados. Vale conferir cada um deles antes de começar:
- Indique a data dos preços: os preços dos modelos mudam com frequência. Uma das fontes menciona, por exemplo, que o DeepSeek V4 Pro 0813 passou a ter preços diferenciados para horários de pico e fora de pico a partir de 16 de agosto de 2026. O preço de um mesmo modelo também pode variar conforme o horário e o canal.
- Confira a versão apontada pelo alias do modelo: um artigo menciona que um nome de modelo aparentemente “mais usado” na verdade invocava uma versão antiga. Durante os testes, registre o identificador do modelo retornado na resposta para evitar testar a versão A e colocar a versão B em produção.
- O cache depende de prefixos iguais: colocar conteúdo dinâmico, como carimbos de data e hora ou IDs de usuários, no início do comando faz com que o prefixo mude a cada chamada, praticamente impedindo o aproveitamento do cache. Nos testes, use a mesma estrutura de comando da produção.
- Use benchmarks de terceiros apenas como referência: pontuações gerais de serviços como o Artificial Analysis e custos calculados por tarefa refletem a distribuição de tarefas das próprias avaliações, que não necessariamente corresponde ao seu cenário de negócio.
- Inclua as tentativas adicionais: novas execuções causadas por limites de requisições com erro 429, erros de formato ou respostas inadequadas também geram custos. Calcule a taxa de sucesso com base nos resultados reais da avaliação.
💰 Dica para otimizar custos: depois de concluir os cálculos, você pode usar o “custo efetivo por tarefa” como principal critério de escolha, com os resultados dos benchmarks e a latência como restrições. Na APIYI apiyi.com, basta alterar o nome do modelo para trocá-lo, facilitando ajustes rápidos na configuração de produção quando as conclusões da análise mudarem. Continue usando os registros de chamadas para monitorar o consumo real.
Perguntas frequentes FAQ
Q1: Qual é o “custo real” de um modelo?
O custo real é o valor efetivamente pago para concluir uma tarefa específica, não o preço anunciado por milhão de tokens. Ele é calculado multiplicando a quantidade real de cada tipo de token — entrada sem cache, leitura do cache, gravação no cache, saída visível e raciocínio — pelo respectivo preço unitário. Depois, considera-se a taxa de sucesso e as tentativas adicionais para obter o custo efetivo por tarefa.
Q2: Por que o mesmo documento tem quantidades diferentes de tokens em modelos diferentes?
Cada modelo usa um tokenizador próprio, que divide textos em chinês, código e pontuação de maneiras diferentes. Em uma análise pública, o mesmo documento foi contabilizado entre 614 e 957 tokens em 9 modelos. Por isso, o custo de entrada precisa ser calculado com a contagem informada por cada modelo, sem aplicar a contagem de um modelo aos demais.
Q3: É necessário incluir os tokens de raciocínio no custo?
Sim. A maioria dos fornecedores contabiliza os tokens de raciocínio como saída e cobra o preço correspondente. Eles não aparecem no corpo da resposta, mas podem representar a maior parte dos tokens de saída. Ao avaliar modelos de raciocínio, é recomendável registrar `reasoning_tokens` separadamente e comparar os modelos no mesmo nível de intensidade de raciocínio.
Q4: Quanto uma leitura do cache pode economizar?
Depende do preço do cache cobrado pelo fornecedor e da sua taxa de acerto. As fontes de referência indicam que o preço de leitura do cache do DeepSeek V4 Flash é cerca de 1/50 do preço sem cache, mas os preços de cache de diferentes provedores podem variar em até 28 vezes. Os maiores ganhos aparecem em cenários como comandos de sistema longos, prefixos fixos de bases de conhecimento e conversas com várias rodadas. Consulte os preços do serviço que você usa para obter os valores exatos.
Q5: Como fazer uma estimativa rápida de custos para vários modelos com uma amostra pequena?
Uma opção é usar uma plataforma que ofereça acesso unificado a vários modelos:
1. Cadastre-se na APIYI apiyi.com e obtenha uma chave API
2. Prepare de 20 a 50 amostras de tarefas reais, mantendo os comandos e parâmetros fixos
3. Faça as chamadas trocando o nome do modelo a cada vez e reúna os totais de cada tipo de token usando os logs de chamadas e as estatísticas de uso
4. Calcule o custo efetivo por tarefa seguindo o modelo apresentado neste artigo
Assim, você pode fazer toda a comparação com uma única conta e o mesmo método de chamada, reduzindo o trabalho de abrir contas e conferir cobranças em vários fornecedores.
Q6: Posso usar diretamente o “custo por tarefa” informado em blogs de terceiros?
Não é recomendável usá-lo diretamente no orçamento. Esses dados ajudam a identificar combinações de modelos que podem apresentar diferenças no consumo de tokens e a reduzir a lista de candidatos. Mas as tarefas avaliadas, as versões dos modelos, os preços e as condições de cache podem ser diferentes dos seus. Para chegar ao valor final, teste novamente com suas próprias amostras.
Q7: Quais são as limitações desse método de estimativa?
Uma amostra pequena só reflete os tipos de tarefa que ela abrange. Se a distribuição das tarefas do seu negócio mudar, será preciso testar novamente. Além disso, os logs de algumas plataformas podem não distinguir os tokens de cache e de raciocínio; nesse caso, você precisará coletá-los por conta própria no campo `usage` da resposta do modelo. Preços e versões dos modelos também mudam, então vale repetir os testes após cada alteração de preço ou atualização.
Principais pontos para calcular o custo real dos modelos
- O preço unitário é só metade da conta: a cobrança depende do preço multiplicado pelo consumo real de tokens.
- As diferenças de tokenização não podem ser ignoradas: o número de tokens de um mesmo documento pode variar mais de 50% entre modelos.
- Tokens de raciocínio aumentam o custo de saída: o processo de raciocínio, mesmo invisível, também é cobrado como saída.
- O preço do cache varia conforme o canal: a taxa de acerto e o preço unitário do cache determinam juntos o custo de comandos longos.
- Decida com base no custo efetivo por tarefa: inclua a taxa de sucesso e as novas tentativas no cálculo.
- Use um ponto de acesso unificado para repetir os testes: com a interface unificada e os logs de invocação da APIYI, fica mais fácil testar a mesma amostra em vários modelos.
Resumo
Para estimar o custo real de um modelo com base no consumo de tokens e no cache, três pontos são essenciais:
- Detalhe a cobrança: contabilize separadamente os tokens de entrada sem acerto no cache, de leitura e gravação de cache, de saída visível e de raciocínio. Multiplique cada categoria pelo preço correspondente.
- Repita os testes com suas próprias tarefas: benchmarks de terceiros e preços servem apenas como referência. Os dados confiáveis são os medidos na mesma tarefa e com a mesma entrada.
- Compare o custo efetivo por tarefa: inclua a taxa de sucesso e as novas tentativas e, depois, considere o volume mensal de tarefas para planejar o orçamento.
Os preços dos modelos mudam e novos modelos surgem o tempo todo, mas esse método de cálculo pode ser reutilizado por muito tempo. Antes de escolher seu próximo modelo, faça uma comparação com 20 amostras reais e só então decida qual colocar em produção. Se precisar alternar rapidamente entre modelos de vários fornecedores, use o acesso unificado da APIYI em apiyi.com e confira o consumo real de cada modelo diretamente nos logs de invocação.
📚 Referências
- Ofox.ai Blog, página 23: inclui resumos de artigos sobre o consumo de tokens do DeepSeek V4 Flash e do Gemini 3.6 Flash, diferenças de preço de cache e estimativas de custo da série Qwen
- Link:
ofox.ai/blog/page/23/ -
Observação: os artigos foram publicados em agosto de 2026. Os dados vêm de medições pontuais feitas por terceiros e servem apenas como referência
-
Ofox.ai Blog, página 22: inclui comparações da contagem de tokens de um mesmo documento em 9 modelos, diferenças de consumo entre versões do Claude e preços do DeepSeek V4 Pro por faixa de horário
- Link:
ofox.ai/blog/page/22/ -
Observação: útil para conhecer exemplos concretos de diferenças de tokenização e entre versões
-
Ofox.ai Blog, página 25: inclui comparações de custo por tarefa entre Kimi K3, GLM-5.2 e Opus 4.8
- Link:
ofox.ai/blog/page/25/ - Observação: preços e resultados de benchmarks mudam com o tempo. Antes de usá-los, consulte as páginas oficiais de preços de cada fornecedor
Autor: Equipe técnica APIYI
Troca de experiências técnicas: entre em contato conosco pela página inicial do site APIYI apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com