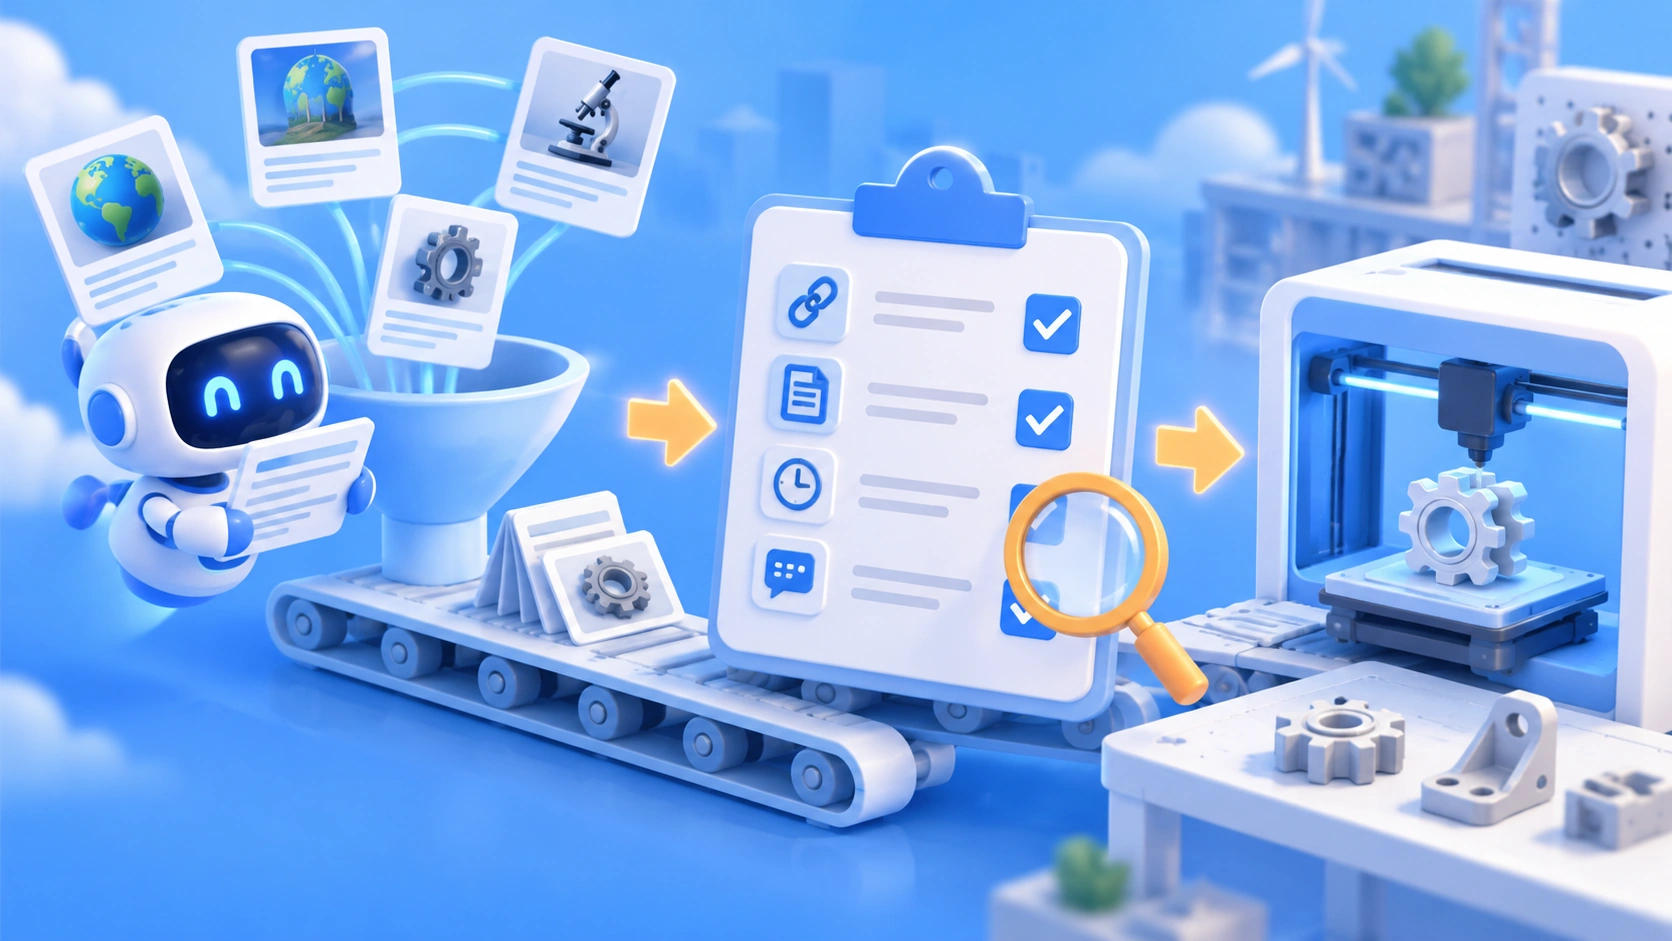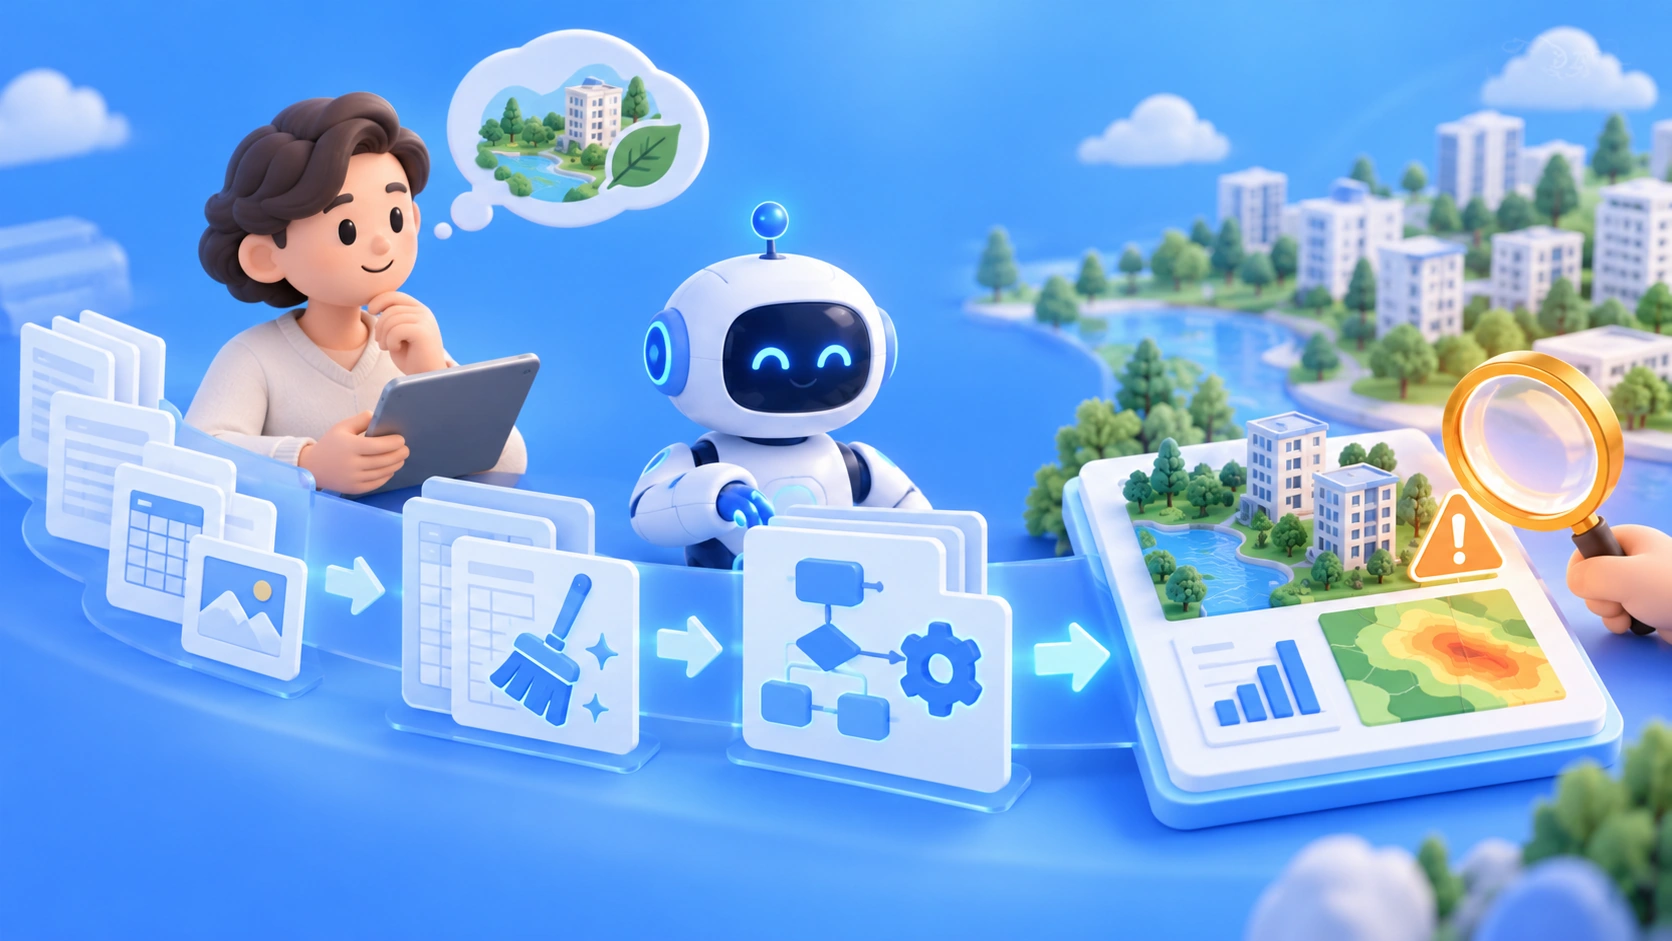
Nota do autor: usando como exemplo o projeto de avaliação de riscos ambientais da Heimstaden, este artigo analisa como profissionais sem experiência em desenvolvimento dividem o trabalho com o Codex na descoberta e limpeza de dados e na construção de fluxos. Também explica por que as decisões metodológicas e a validação humana precisam continuar nas mãos dos especialistas da área.
Muitos analistas de negócios conhecem bem seu setor, mas não sabem programar. Quando surge um projeto com “dados espalhados por dezenas de fontes públicas, cada uma em um formato diferente”, tradicionalmente eles precisam esperar pela equipe técnica ou contratar consultores externos. Partindo de um caso real já divulgado publicamente, este artigo apresenta uma forma de dividir o trabalho entre pessoas e IA quando profissionais sem experiência em desenvolvimento usam o Codex para construir fluxos de processamento de dados. O foco está em dois limites essenciais: quem responde pela metodologia e a necessidade de validação humana.
Este não é um texto promocional sobre como “a IA pode fazer tudo por você”. O caso traz números impressionantes, mas também muitos detalhes que não foram divulgados. Vamos separar com clareza o que se sabe do que é inferência.
O que você vai aprender: ao final da leitura, você saberá quais etapas de um projeto de dados são adequadas para um agente de programação e quais responsabilidades precisam continuar com você. Também entenderá como transformar uma análise pontual em uma capacidade que a equipe pode aperfeiçoar continuamente.
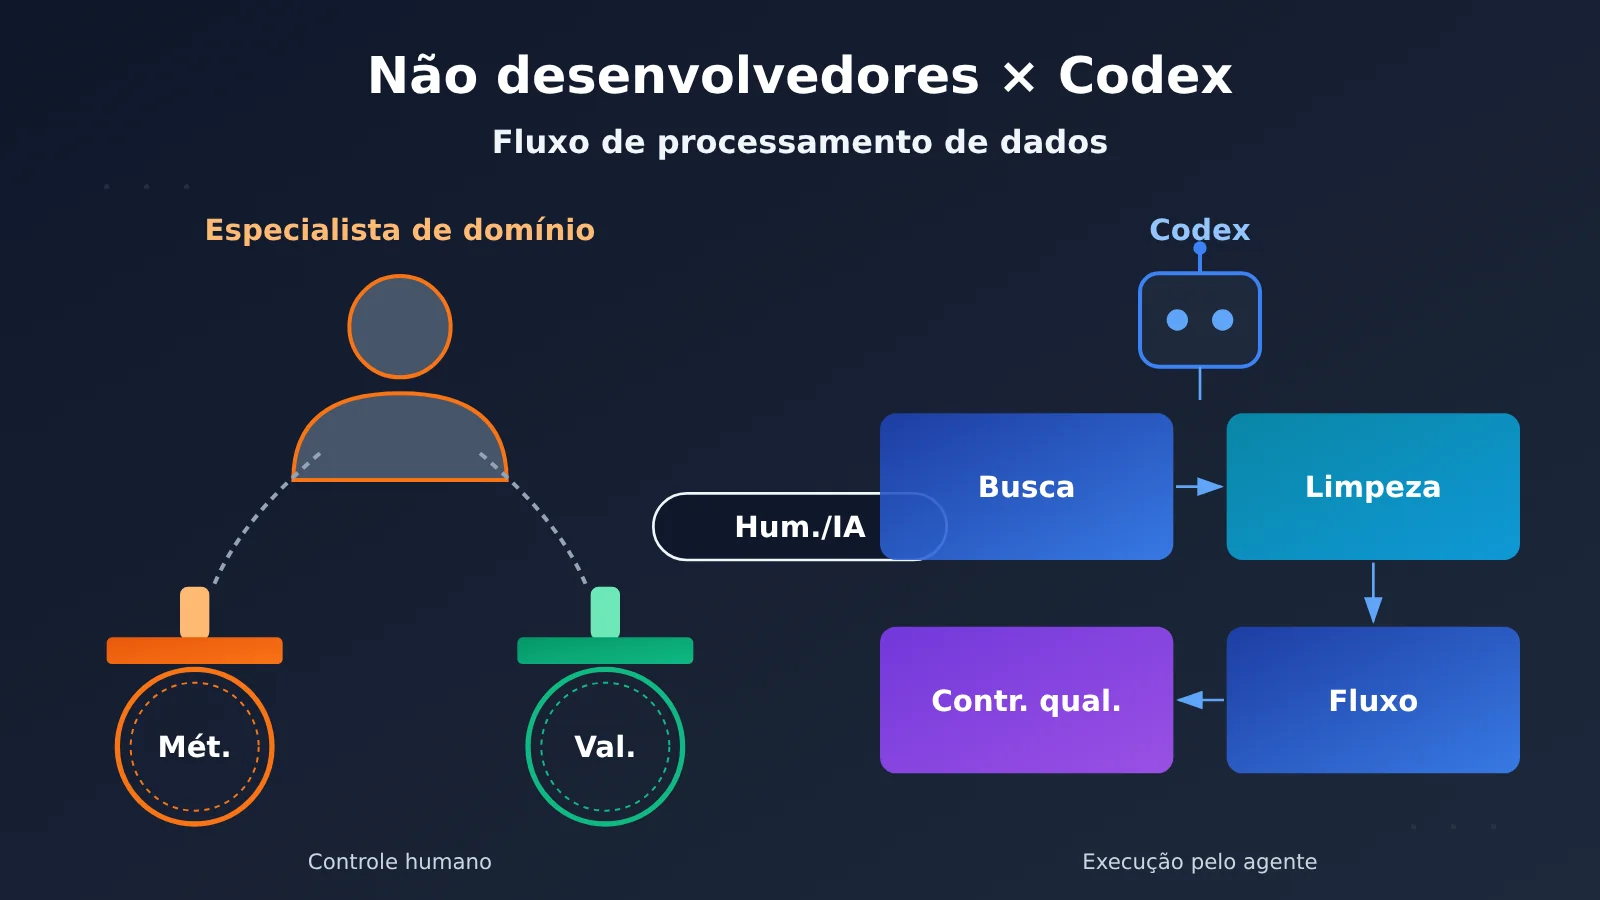
Pontos essenciais para criar fluxos de processamento de dados com Codex sem ser desenvolvedor
Em 3 de novembro de 2026, a OpenAI publicou um estudo de caso sobre a Heimstaden, operadora europeia de imóveis residenciais. Uma das histórias é a de Julia Erlandsen, analista de sustentabilidade ambiental que, sem experiência em desenvolvimento de software, usou o Codex para realizar uma avaliação de riscos ambientais em todo o portfólio de ativos. A tabela abaixo resume os principais aprendizados do caso.
| Ponto | O que diz o caso | Valor para o leitor |
|---|---|---|
| Natureza do problema | As informações existem, mas estão dispersas em fontes públicas, formatos e conjuntos de dados diferentes | Identificar projetos com dados dispersos, especialmente adequados para o uso de agentes |
| Papel do agente | Descoberta, limpeza e padronização de dados, verificações de qualidade e desenvolvimento de fluxos de processamento reproduzíveis | Saber quais etapas podem ser delegadas |
| Papel da especialista | A analista manteve o controle da metodologia e da validação | Preservar a credibilidade das conclusões |
| Resultado em escala | Avaliação de 20.112 ativos, gerando mais de 6 milhões de linhas de dados utilizáveis | Mostrar que mesmo quem não é desenvolvedor pode lidar com dados em grande escala |
| Benefício de longo prazo | Um projeto pontual se tornou uma capacidade reproduzível, sem necessidade de consultores externos | Manter o domínio da metodologia e evoluí-la internamente |
Como funciona a divisão de tarefas no fluxo de dados com Codex
A frase mais importante do caso é curta: o Codex ajudou na descoberta, limpeza e padronização dos dados, nas verificações de qualidade e no desenvolvimento de fluxos de processamento reproduzíveis, enquanto Julia manteve o controle da metodologia e da validação. Isso estabelece uma divisão clara. As tarefas de limpar os dados e montar um fluxo funcional podem ser delegadas ao agente; já a definição dos critérios de risco e a verificação dos resultados devem continuar nas mãos de pessoas.
Essa divisão importa porque a avaliação de riscos ambientais serve de base para avaliações de risco climático, conformidade de relatórios e decisões de investimento. Se a metodologia partir de pressupostos adotados por padrão pelo agente, a analista não conseguirá explicar a investidores ou auditores como chegou às conclusões. As próprias palavras de Julia reforçam esse ponto: “Agora somos donos dessa metodologia e podemos continuar desenvolvendo-a por conta própria.” Ser dono, nesse caso, significa entender e controlar a lógica da avaliação, e não apenas ter uma tabela de resultados em mãos.
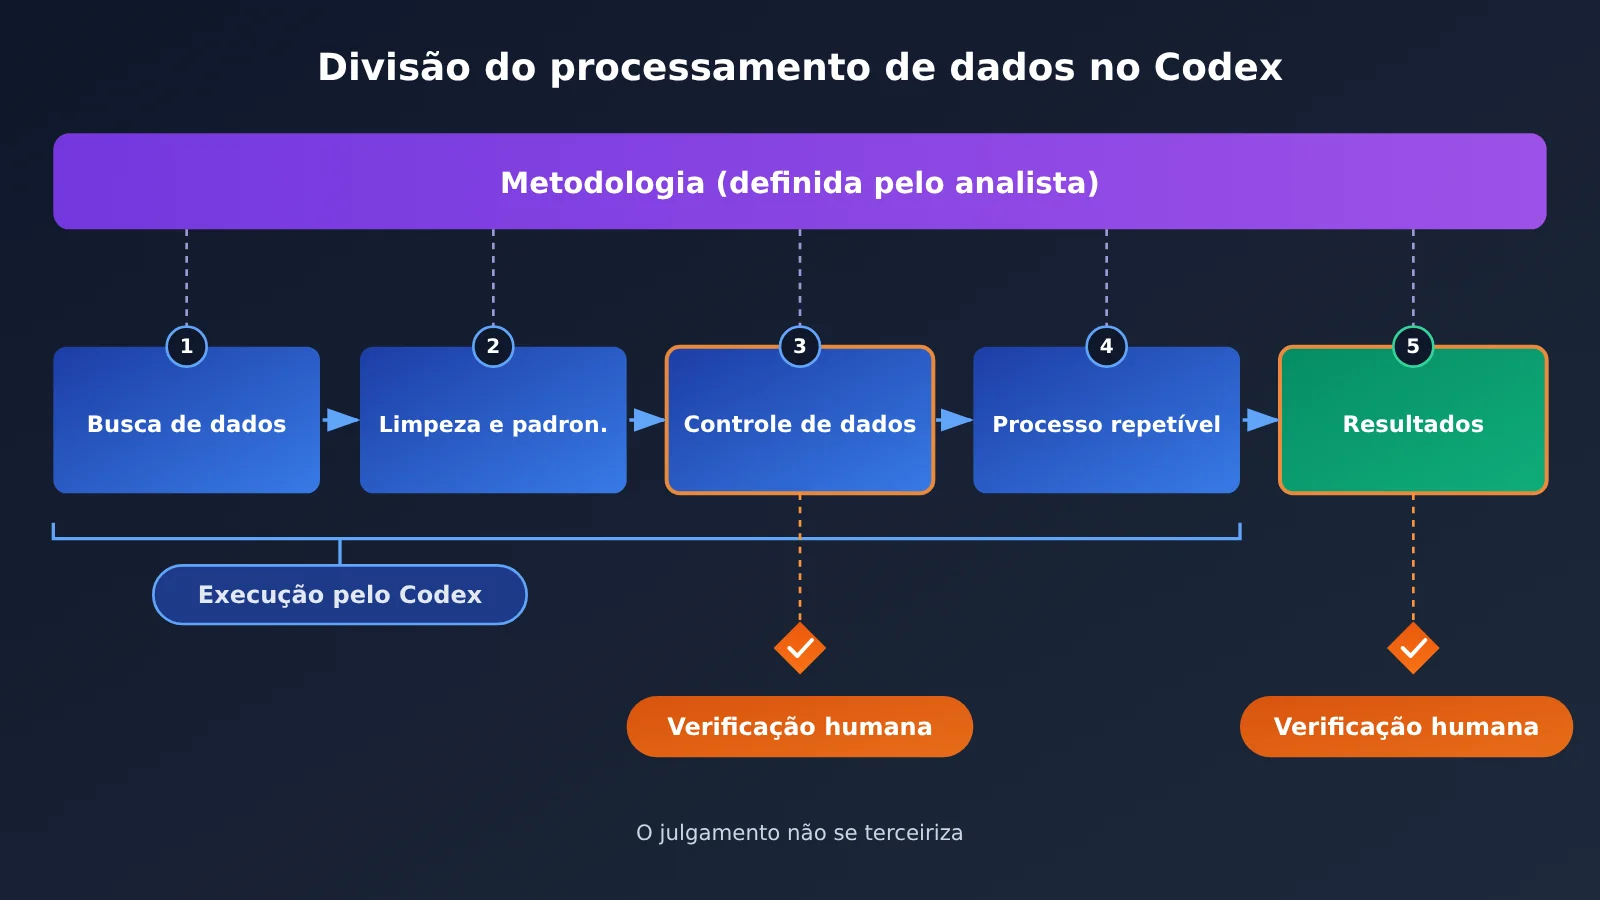
Princípios de divisão de responsabilidades em fluxos de processamento de dados com o Codex para não desenvolvedores
A divisão de responsabilidades no caso pode ser resumida em uma tabela mais geral. A coluna “Detalhes divulgados no caso” indica se o texto original trouxe informações sobre cada etapa. As práticas sugeridas foram organizadas com base na experiência comum em projetos de dados e não representam necessariamente as operações reais da Heimstaden.
| Etapa | Responsabilidade do agente de programação | Responsabilidade do especialista de domínio | Detalhes divulgados no caso |
|---|---|---|---|
| Descoberta de dados | Pesquisar e listar possíveis fontes de dados, explicando o significado dos campos | Avaliar a autoridade das fontes e sua adequação ao objetivo da avaliação | Fontes específicas não divulgadas |
| Limpeza e padronização | Padronizar formatos, unidades e codificações; fazer a correspondência de coordenadas e endereços | Decidir como tratar valores ausentes e conflitantes | Regras não divulgadas |
| Verificação de qualidade | Criar verificações automatizadas e gerar listas de anomalias | Definir o que conta como anomalia e revisar amostras | Métodos e taxas de erro não divulgados |
| Construção do fluxo | Organizar as etapas em um fluxo de processamento que possa ser executado novamente | Confirmar que a lógica do fluxo é consistente com a metodologia | Informado apenas que é “reproduzível” |
| Metodologia e conclusões | Executar cálculos conforme as instruções | Definir a estrutura de avaliação, os pesos e os limites, além de responder pelos resultados | Informado explicitamente que essa responsabilidade permanece com o analista |
Com base nessa tabela, podemos resumir 5 princípios para dividir as responsabilidades:
- A execução pode ser delegada, o julgamento não. O agente é bom em transformar um pedido vago como “organize os dados” em ações concretas, mas só quem conhece o setor pode responder se determinado limite faz sentido.
- Documente a metodologia antes de passá-la ao agente. A estrutura de avaliação deve ser um documento que você consiga explicar por conta própria, e não um conjunto de instruções soltas em uma conversa.
- A validação precisa de uma perspectiva independente. Pedir ao agente que criou o fluxo para verificar o próprio trabalho só permite identificar parte dos problemas. A revisão humana por amostragem e a comparação com referências externas são indispensáveis.
- O fluxo precisa ser reproduzível. Um resultado manual produzido uma única vez não permite iterações; um fluxo que pode ser executado novamente, sim, é um ativo.
- A responsabilidade pelas conclusões é sempre de uma pessoa. A estratégia geral de IA da Heimstaden também enfatiza que os funcionários são responsáveis por revisar e aprovar decisões, e que o conteúdo gerado por IA deve passar por verificação humana antes de ser divulgado.
🎯 Dica técnica: se alguma etapa do seu fluxo de dados precisar invocar um Modelo de Linguagem Grande, por exemplo, para classificar descrições textuais não estruturadas em níveis de risco, você pode usar a APIYI, em apiyi.com, para acessar vários modelos populares por meio da mesma interface. Comparar as avaliações de diferentes modelos sobre o mesmo conjunto de amostras facilita a identificação de vieses sistemáticos em algum deles e é, por si só, uma forma de validação de baixo custo.
Guia rápido de processamento de dados com Codex para quem não programa
O caso não revela qual versão do Codex Julia usou, nem detalha como ela interagiu com a ferramenta ou organizou o fluxo de trabalho. Por isso, os passos abaixo não reproduzem o caso: são um ponto de partida para analistas sem experiência em desenvolvimento, inspirado na divisão de tarefas apresentada. Como solicitado, não há código aqui. As listas indicam apenas o que fornecer ao agente e o que você deve conferir em cada etapa.
Primeiro passo: descreva a metodologia em linguagem natural
Antes de começar, documente a lógica da avaliação em um arquivo, por exemplo, chamado methodology.md. Inclua pelo menos o objetivo da avaliação, os indicadores necessários, os critérios de cálculo de cada indicador, os limites para classificar os níveis de risco e as regras para lidar com dados ausentes. Esse documento registra que a metodologia é sua: sempre que pedir ao agente para alterar o fluxo, use-o como referência.
Segundo passo: deixe o agente descobrir os dados, mas tome a decisão final
Explique ao agente o objetivo da avaliação e peça que liste as possíveis fontes de dados, os campos disponíveis em cada uma, a frequência de atualização e as limitações conhecidas. Avalie se cada fonte é confiável e se sua cobertura corresponde à distribuição dos seus ativos. Peça ao agente que coloque os dados originais baixados em um diretório raw separado e nunca os altere. Todo o processamento posterior deve ser feito em cópias.
Terceiro passo: limpeza e padronização, com registro de todas as alterações
Informe ao agente suas regras de padronização, como formatos de endereço e data, sistema de coordenadas e unidades, e peça que ele crie um fluxo de processamento. O requisito principal é que cada etapa de transformação gere um registro das alterações: quantas linhas foram excluídas, quantos registros foram consolidados e quais não puderam ser associados. Assim, você pode avaliar se o processamento faz sentido sem precisar entender o código.
Etapa 4: faça a verificação de qualidade em duas camadas
A primeira camada fica por conta do agente: peça que ele crie verificações automáticas para identificar valores duplicados ou ausentes, valores fora dos limites permitidos e falhas na correspondência de ativos, entre outros problemas. Ele também deve gerar uma lista de anomalias. A segunda camada fica por sua conta: selecione aleatoriamente uma parte dos ativos e confira os resultados manualmente, da maneira que você conhece. Defina a proporção da amostra e os critérios de tolerância com antecedência no documento de metodologia e registre-os separadamente em uma tabela como validation_log.
Etapa 5: transforme o processo em um fluxo reproduzível
Depois de confirmar que os resultados são confiáveis, peça ao agente que organize todo o processo em um fluxo que possa ser executado novamente com um clique e prepare um guia de operação. As instruções devem permitir que um colega que também não saiba programar consiga executá-lo. Só então o projeto deixa de ser uma “análise pontual” e se torna uma “capacidade reutilizável”.
| Etapa | O que você fornece ao agente | O que você precisa conferir | Riscos comuns |
|---|---|---|---|
| Metodologia | Objetivo da avaliação e conhecimento do setor | Documento de metodologia escrito por você | Critérios dos indicadores pouco claros, gerando retrabalho constante |
| Descoberta de dados | Objetivo e escopo de cobertura | Lista de fontes e descrição das limitações | Inclusão de dados de fontes não confiáveis ou desatualizados |
| Limpeza e padronização | Regras de padronização | Registro das alterações em cada etapa | Exclusão silenciosa de dados, deixando os resultados aparentemente limpos |
| Verificação de qualidade | Definição de anomalias e proporção da amostra | Lista de anomalias e resultados da amostragem manual | Confiar apenas nas verificações automáticas e ignorar erros sistemáticos |
| Consolidação do processo | Requisitos de execução e atualização | Fluxo reproduzível e guia de operação | Só o agente “lembra” como executar o fluxo |
🚀 Comece agora: se a terceira ou a quarta etapa exigir um Modelo de Linguagem Grande para interpretar campos de texto, como descrições de riscos em relatórios públicos de diferentes países, você pode primeiro comparar as respostas de alguns modelos usando uma pequena amostra na APIYI apiyi.com. Escolha o mais consistente e integre-o ao fluxo oficial, em vez de apostar todo o conjunto de dados em um único modelo desde o início.
Comparação do fluxo de processamento de dados com Codex e outras abordagens
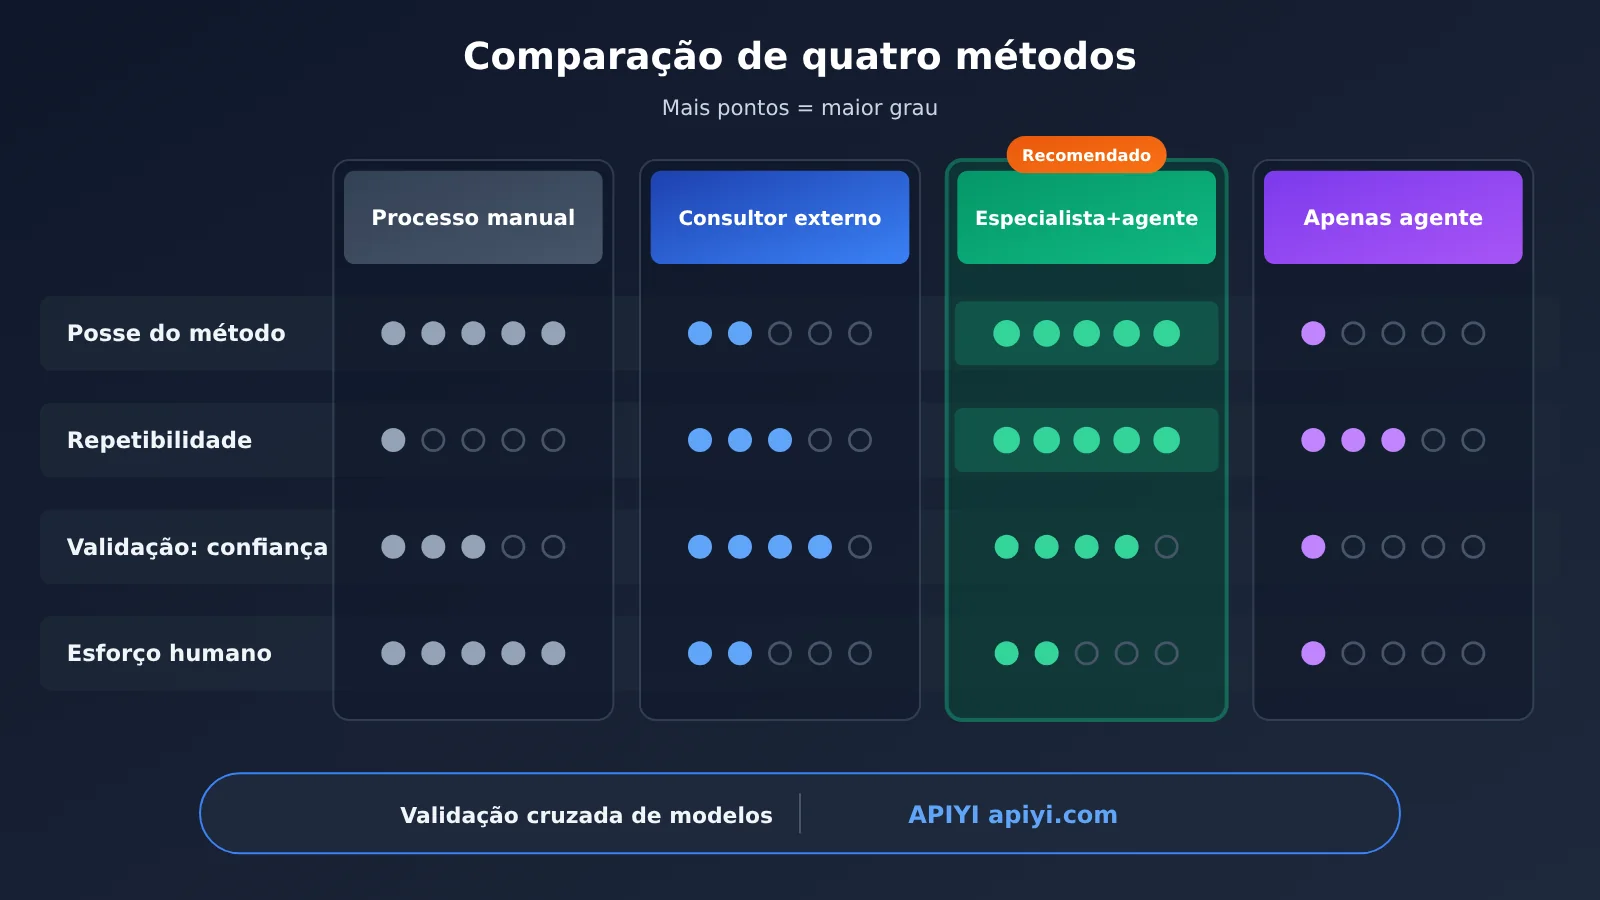
| Abordagem | Controle da metodologia | Reprodutibilidade | Confiabilidade da validação | Principal problema |
|---|---|---|---|---|
| Processamento totalmente manual | Com o especialista | Baixa, geralmente difícil de executar novamente | Depende da atenção de cada pessoa | Alto consumo de pessoal; o caso estimava 5 pessoas trabalhando por 1 ano |
| Consultores externos | Geralmente com os consultores | Média, depende das entregas dos consultores | Alta, mas pouco transparente | Atualizações posteriores exigem novas contratações |
| Especialista + agente de programação | Com o especialista | Alta, o fluxo pode ser executado novamente | Alta, desde que haja validação humana adequada | Exige que o especialista saiba estruturar bem a metodologia |
| Tudo delegado ao agente | Indefinido, implícito nas suposições padrão | Média | Baixa, difícil explicar a origem das conclusões | Não é possível defender as conclusões perante terceiros |
Como interpretar a comparação
Comparação com consultores externos: consultores externos têm algumas vantagens em experiência especializada e velocidade de entrega. Mas a metodologia costuma ficar com eles. Quando chega a hora de atualizar a avaliação no ano seguinte, é preciso negociar e pagar novamente. Em comparação, o modelo “especialista + agente de programação” mantém a metodologia dentro da organização. A Heimstaden também afirmou que o projeto evitou a contratação de consultores externos que, de outra forma, seria necessária.
Comparação com a delegação total ao agente: passar o projeto inteiro para o agente parece a opção mais simples e também gera resultados rapidamente. Mas o agente faz suposições por conta própria sobre muitos detalhes, como preencher valores ausentes ou excluir valores atípicos. Essas suposições podem não seguir as práticas do setor. Em avaliações que precisam fundamentar a conformidade de relatórios e decisões de investimento, conclusões desse tipo dificilmente resistem a questionamentos.
Os números sobre economia de pessoal precisam ser vistos com objetividade. O texto original diz que a “necessidade estimada para a entrega” caiu de 5 pessoas trabalhando por 1 ano para 2 pessoas trabalhando por 2 meses. Em uma conversão aproximada, são 60 pessoas-mês contra 4 pessoas-mês. Mas essa é uma estimativa da própria empresa, sem verificação independente, e não informa como as funções foram divididas entre as 2 pessoas.
💡 Sugestão: se sua equipe já tem uma metodologia, mas precisa de capacidade de execução técnica, “especialista + agente de programação” é a abordagem que mais vale a pena experimentar. Nas etapas do fluxo que exigem a invocação do modelo, a interface unificada da APIYI apiyi.com permite alternar e comparar diferentes modelos, sem precisar reescrever todo o fluxo quando for necessário trocar de modelo.
O que se sabe e o que não se sabe sobre o caso de processamento de dados com Codex
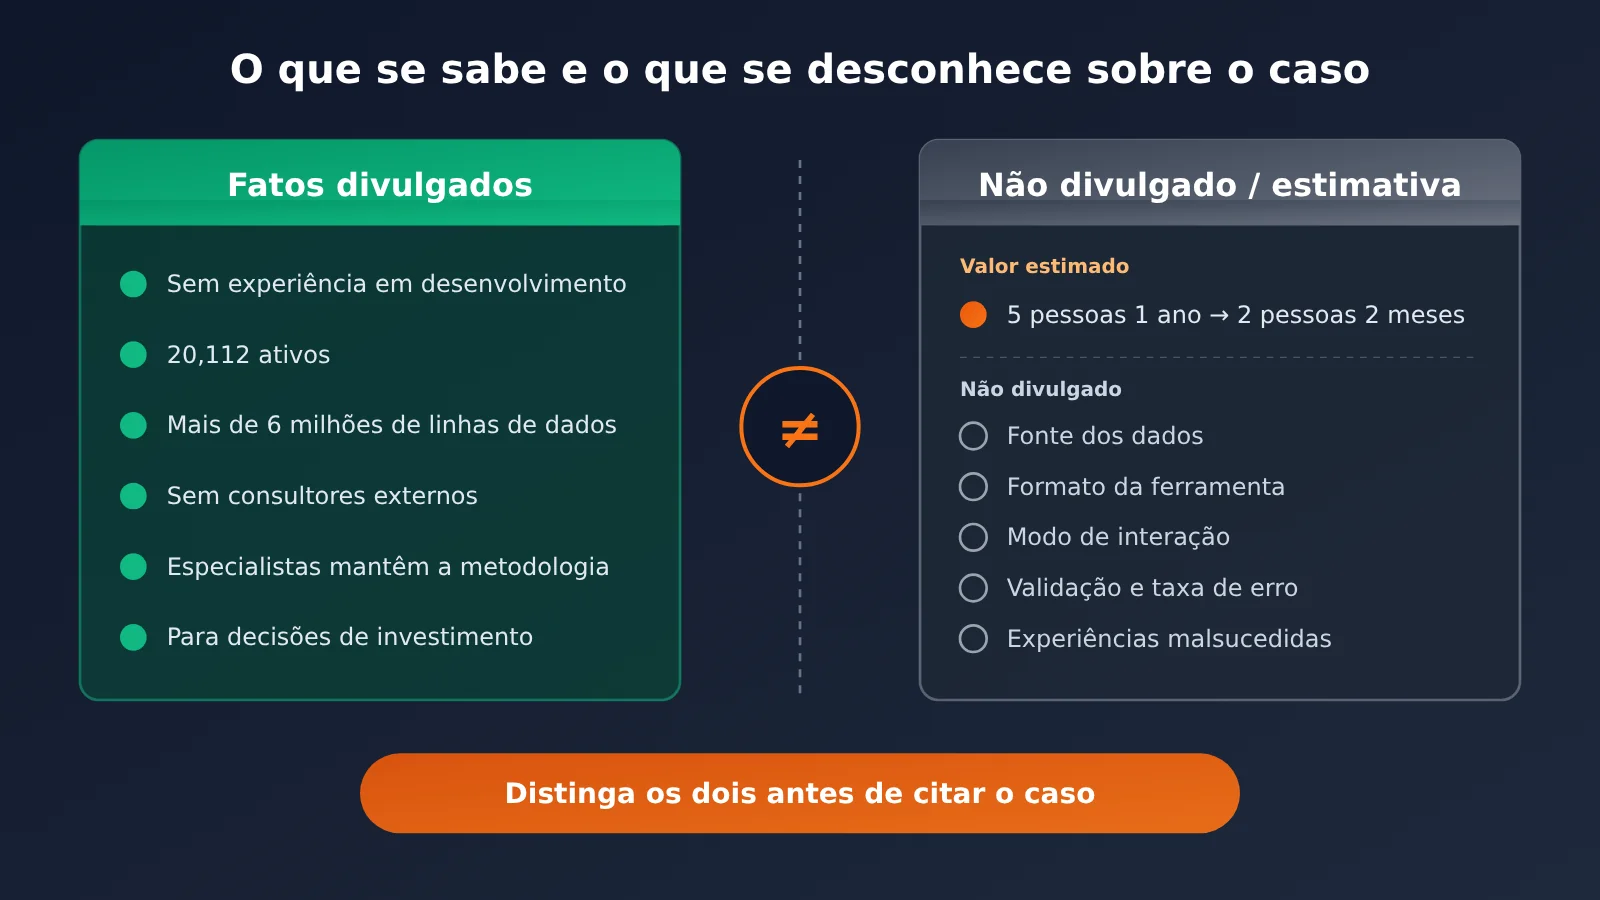
Para evitar tirar conclusões além do que o caso permite, separamos as informações apresentadas no texto original daquelas que não foram divulgadas.
| Categoria | Conteúdo |
|---|---|
| Divulgado | A analista não tinha experiência em desenvolvimento de software; o Codex deu suporte à descoberta de dados, limpeza e padronização, controle de qualidade e desenvolvimento de fluxos de trabalho; a analista continuou responsável pela metodologia e validação; foram avaliados 20.112 ativos, gerando mais de 6 milhões de linhas de dados; não foi necessário contratar consultores externos; os resultados foram usados em avaliações de risco climático, relatórios e decisões de investimento |
| Estimativa | A necessidade de recursos para a entrega caiu de 5 pessoas por 1 ano para 2 pessoas por 2 meses, segundo estimativa da empresa |
| Não divulgado | As fontes de dados específicas; como o Codex foi utilizado (aplicativo para desktop, CLI ou outro); a forma de interação e o fluxo de trabalho; os métodos específicos de validação e a taxa de erros; as dificuldades e falhas encontradas durante o uso |
Essas lacunas não diminuem o valor da divisão de responsabilidades como referência, mas significam que você não pode simplesmente reproduzir os números de eficiência do caso. Em projetos reais, é bem provável que o tempo gasto organizando a metodologia e fazendo a validação manual seja maior do que o tempo dedicado a “pedir ao agente que escreva o fluxo de trabalho”. Vale lembrar uma frase que resume a visão da liderança da Heimstaden: a IA não conserta um processo ruim, mas pode potencializar bastante um processo bom.
Perguntas frequentes (FAQ)
Q1: O que significa uma pessoa sem experiência em desenvolvimento usar o Codex para criar um fluxo de processamento de dados?
Significa que um especialista de domínio sem experiência em programação descreve suas necessidades em linguagem natural para um agente de programação. O agente realiza tarefas técnicas, como obtenção, limpeza e verificação dos dados e criação do fluxo, enquanto o especialista define a metodologia e valida os resultados. O projeto de avaliação de riscos ambientais da Heimstaden é um exemplo público dessa abordagem.
Q2: Qual é a diferença entre isso e simplesmente fazer perguntas sobre dados ao ChatGPT?
O uso em formato de perguntas e respostas costuma atender a questões pontuais, com resultados difíceis de reproduzir. O valor do agente de programação está em criar um fluxo de processamento que pode ser executado novamente. Quando os dados são atualizados, é possível executá-lo de novo; quando a metodologia muda, é possível ajustá-lo. É isso que o caso descreve como a transformação de “um projeto de análise complexo em uma capacidade reproduzível”.
Q3: Quando esse caso foi publicado?
O caso foi publicado pela OpenAI em 3 de novembro de 2026 e retrata práticas recentes de uso de agentes de programação em empresas. Os números e as ferramentas específicas podem mudar com o tempo, mas o princípio de divisão de tarefas — “deixar a execução com o agente e o julgamento com o especialista” — tem valor mais duradouro.
Q4: Quais projetos de dados são mais adequados para esse modelo de divisão de tarefas?
– **Integração de dados públicos de várias fontes**: como conjuntos de dados ambientais, climáticos e populacionais distribuídos entre diferentes instituições
– **Relatórios periódicos**: relatórios de conformidade e divulgação que precisam ser refeitos a cada trimestre ou ano
– **Avaliações em lote de carteiras de ativos**: situações em que milhares de registros precisam receber pontuações com critérios padronizados
Q5: Como começar rapidamente quando o fluxo precisa invocar um Modelo de Linguagem Grande?
Você pode começar criando uma conta na APIYI, em apiyi.com, e usar a mesma interface para invocar alguns dos principais modelos. Depois, compare os resultados de classificação ou extração em um pequeno conjunto de amostras representativas. Após confirmar a estabilidade e a consistência dos critérios, integre o modelo ao fluxo oficial. A comparação entre modelos também pode servir de apoio à validação humana.
Q6: Qual deve ser o nível de validação humana?
O caso não divulgou os métodos de validação nem as taxas de erro. Uma prática geral é definir antecipadamente a proporção da amostra e os critérios de tolerância a erros, revisar uma a uma as anomalias sinalizadas pelas verificações automáticas e conferir uma amostra aleatória dos resultados considerados normais. Também é importante compará-los com referências externas conhecidas. Todos os registros de validação devem ser guardados para auditorias futuras.
Q7: Quais são as limitações desse modelo?
Primeiro, os números de eficiência são estimativas da empresa e não foram verificados de forma independente. Segundo, pessoas sem experiência em desenvolvimento ainda precisam saber descrever a metodologia com clareza; caso contrário, o agente apenas ampliará a confusão. Terceiro, o caso não menciona dificuldades nem experiências malsucedidas. Na prática, pode ser difícil entender por que um fluxo apresentou erro e, quando necessário, ainda será preciso pedir ajuda a colegas da área técnica para investigar o problema.
Q8: Por que é tão importante dominar a própria metodologia?
Quando a equipe domina a metodologia, ela consegue modificá-la e explicá-la diretamente na próxima atualização de dados, mudança regulatória ou questionamento de investidores, sem precisar contratar consultores novamente. É dessa autonomia de longo prazo que Julia fala ao dizer: “Agora dominamos essa metodologia e podemos continuar desenvolvendo-a por conta própria”.
Pontos principais do fluxo de processamento de dados com Codex para quem não é desenvolvedor
- Divisão de responsabilidades: deixe a descoberta, a limpeza, a verificação de qualidade dos dados e o fluxo de trabalho com o agente; mantenha a metodologia e a validação sob responsabilidade dos especialistas
- Metodologia primeiro: documente claramente a estrutura de avaliação antes de pedir ao agente que a execute
- Validação independente: verificações automáticas, amostragem manual e comparação com benchmarks externos são indispensáveis
- Repetibilidade é essencial: um fluxo que pode ser executado novamente é um ativo; resultados pontuais não permitem iteração
- Cuidado com os números: a redução de 5 pessoas durante 1 ano para 2 pessoas durante 2 meses é uma estimativa e não deve ser aplicada diretamente a outros projetos
- Comparar modelos ajuda na validação: nas etapas que exigem a invocação de Modelos de Linguagem Grande, a interface unificada da APIYI permite fazer verificações cruzadas entre modelos
Conclusão
Para quem não é desenvolvedor e usa o Codex para criar fluxos de processamento de dados, a principal lição não são os números de eficiência, mas a divisão clara de responsabilidades:
- O agente cuida da execução: descoberta de dados, limpeza e padronização, verificações de qualidade e fluxos repetíveis podem ficar com ele
- Os especialistas cuidam das decisões: definir a metodologia e validar os resultados é fundamental para chegar a conclusões confiáveis e explicáveis
- O conhecimento fica na organização: manter o controle da metodologia e poder executar o fluxo novamente transforma um projeto pontual em uma capacidade que a organização pode aprimorar continuamente
Se você tem em mãos um projeto com dados espalhados e sem acesso a recursos técnicos, vale começar documentando a metodologia e depois fazer um piloto em pequena escala. Nas etapas que envolvem a invocação de Modelos de Linguagem Grande, você pode usar a APIYI, em apiyi.com, para comparar o desempenho de vários modelos em uma interface unificada e acrescentar uma camada de apoio à validação manual.
📚 Referências
- Caso de cliente da OpenAI – Heimstaden: como a Heimstaden usou o ChatGPT e o Codex para transformar a gestão de imóveis residenciais
- Link:
openai.com/index/heimstaden/ - Descrição: única fonte dos fatos apresentados neste caso, incluindo a divisão de responsabilidades e os dados estimados do projeto de avaliação de riscos ambientais
Autor: Equipe técnica da APIYI
Troca de experiências técnicas: Entre em contato conosco pela página inicial do site da APIYI. Para mais informações sobre integração de modelos, acesse a central de documentação em docs.apiyi.com