Nota do autor: em 2 de novembro de 2026, a xAI desativou oficialmente o identificador grok-imagine-image-quality. As solicitações antigas não retornam erro, mas passaram a usar o Image 2.0 Low nos bastidores. Partindo dessa migração do Grok Imagine, este artigo analisa os riscos da gestão de versões de APIs de IA e como lidar com eles.
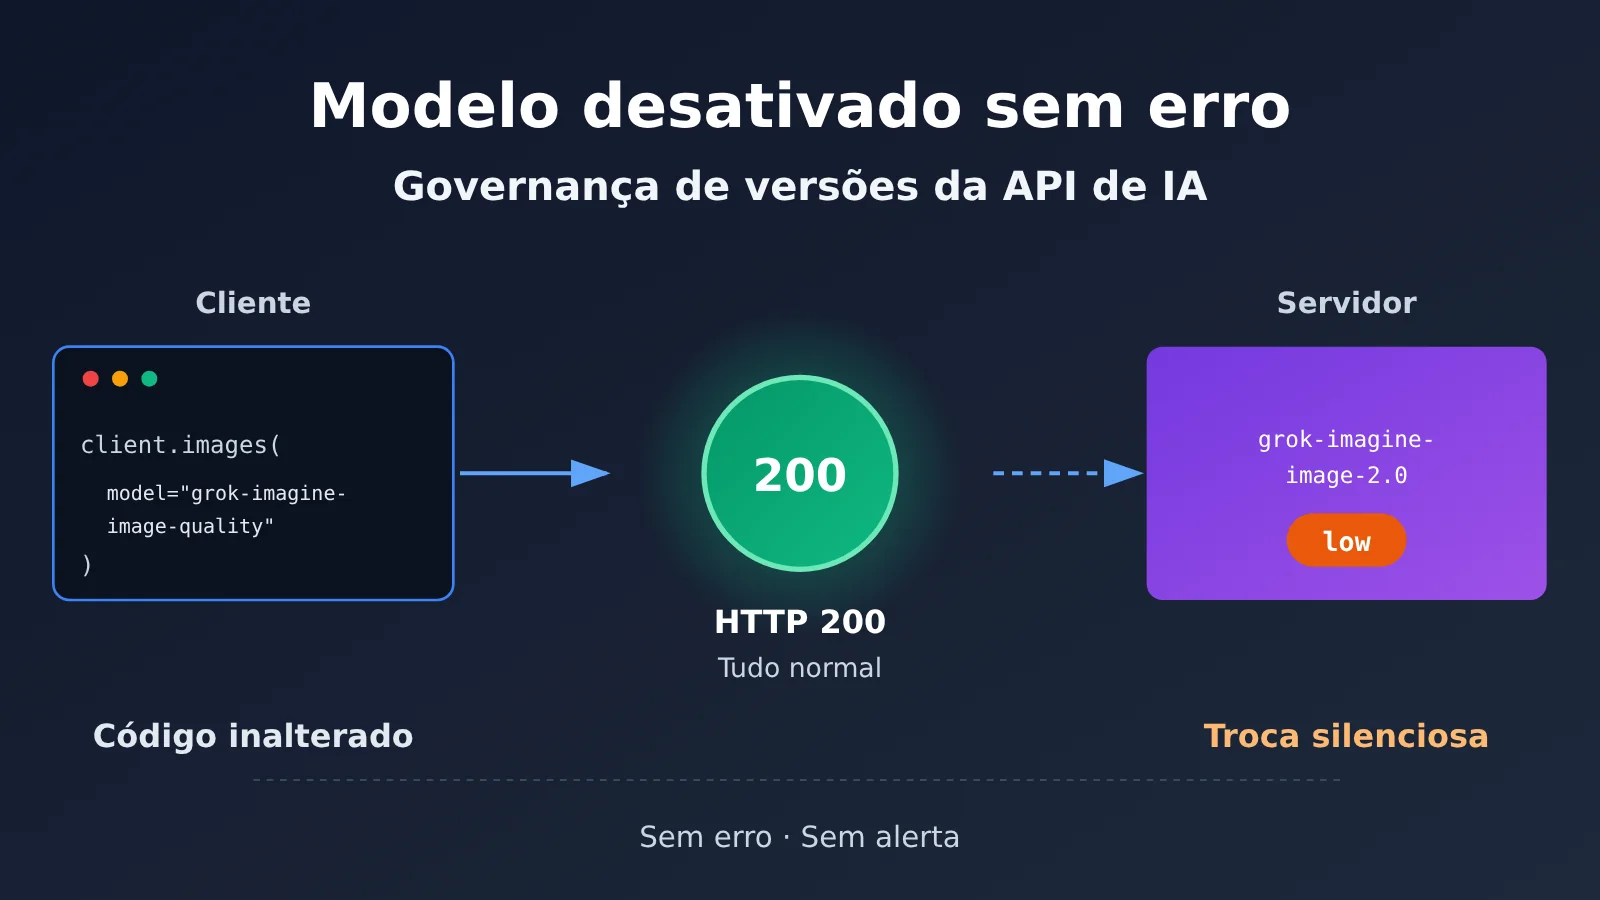
Hoje, 2 de novembro de 2026, a xAI colocou em prática a migração de modelos de imagem anunciada anteriormente. O identificador antigo grok-imagine-image-quality continua funcionando, mas o modelo executado agora é o grok-imagine-image-2.0, com a qualidade fixada em low. Para a maioria das aplicações, nenhuma linha de código mudou, as solicitações continuam recebendo respostas e o painel de monitoramento não mostra nenhum alerta vermelho.
Isto não é um comunicado de incidente. As regras de migração vêm da documentação oficial publicada pela xAI em 2 de setembro, com 60 dias de antecedência. Até o momento, não há evidências de falhas em larga escala afetando usuários. O que vale discutir é o problema de engenharia que essa mudança revela: compatibilidade da interface e sucesso nas chamadas não significam que o modelo, a qualidade dos resultados e os custos permaneçam iguais.
O que você vai aprender: ao final deste artigo, você saberá exatamente o que mudou na migração do Grok Imagine, entenderá por que APIs de IA precisam de uma gestão de versões independente do monitoramento comum de disponibilidade e terá uma lista de verificação para avaliar seu sistema imediatamente.
Resumo da descontinuação do modelo Grok Imagine
Vamos começar pelos fatos confirmados na documentação oficial. Vale destacar que 2 de novembro não é a data de lançamento do Image 2.0 (ele já havia sido lançado em 7 de agosto), mas a data em que a descontinuação de um identificador antigo da API entra em vigor.
| Informação | Detalhes |
|---|---|
| Data de vigência | 2 de novembro de 2026 (anunciado em 2 de setembro, com aviso prévio de 60 dias) |
| Fonte | Guia oficial de migração da xAI |
| Identificador descontinuado | grok-imagine-image-quality |
| Modelo substituto | grok-imagine-image-2.0, com quality fixado em low |
| Endpoints afetados | /v1/images/generations e /v1/images/edits |
| Compatibilidade | O identificador antigo continua sendo reconhecido, e as estruturas de solicitação e resposta permanecem compatíveis |
| Não afetado | A xAI confirmou que o grok-imagine-image (1.0) não é afetado por essa mudança |
| Como verificar | O campo model na resposta informa o modelo que realmente atendeu à solicitação |
A cadeia de redirecionamento dos identificadores antigos do Grok Imagine
Um detalhe fácil de passar despercebido nessa migração é o “redirecionamento em cadeia”. Em 15 de maio de 2026, a xAI já havia descontinuado o grok-imagine-image-pro, ainda mais antigo, e redirecionado suas solicitações para o grok-imagine-image-quality. Depois de 2 de novembro, essa cadeia ganhou mais uma etapa.
Ou seja, um aplicativo cuja configuração nunca foi atualizada e que ainda usa o identificador pro agora utiliza, na prática, o Image 2.0 Low. Já não é possível saber qual modelo está realmente em uso apenas conferindo a string model no arquivo de configuração.
| Identificador configurado no aplicativo | Status | Caminho real após 2 de novembro |
|---|---|---|
grok-imagine-image-pro |
Descontinuado em 15 de maio | pro → quality → 2.0 (low) |
grok-imagine-image-quality |
Descontinuado em 2 de novembro | quality → 2.0 (low) |
grok-imagine-image-2.0 |
Disponível oficialmente | 2.0, com opção de low / medium / auto |
grok-imagine-image |
1.0, ainda disponível | Não é afetado por essa mudança |
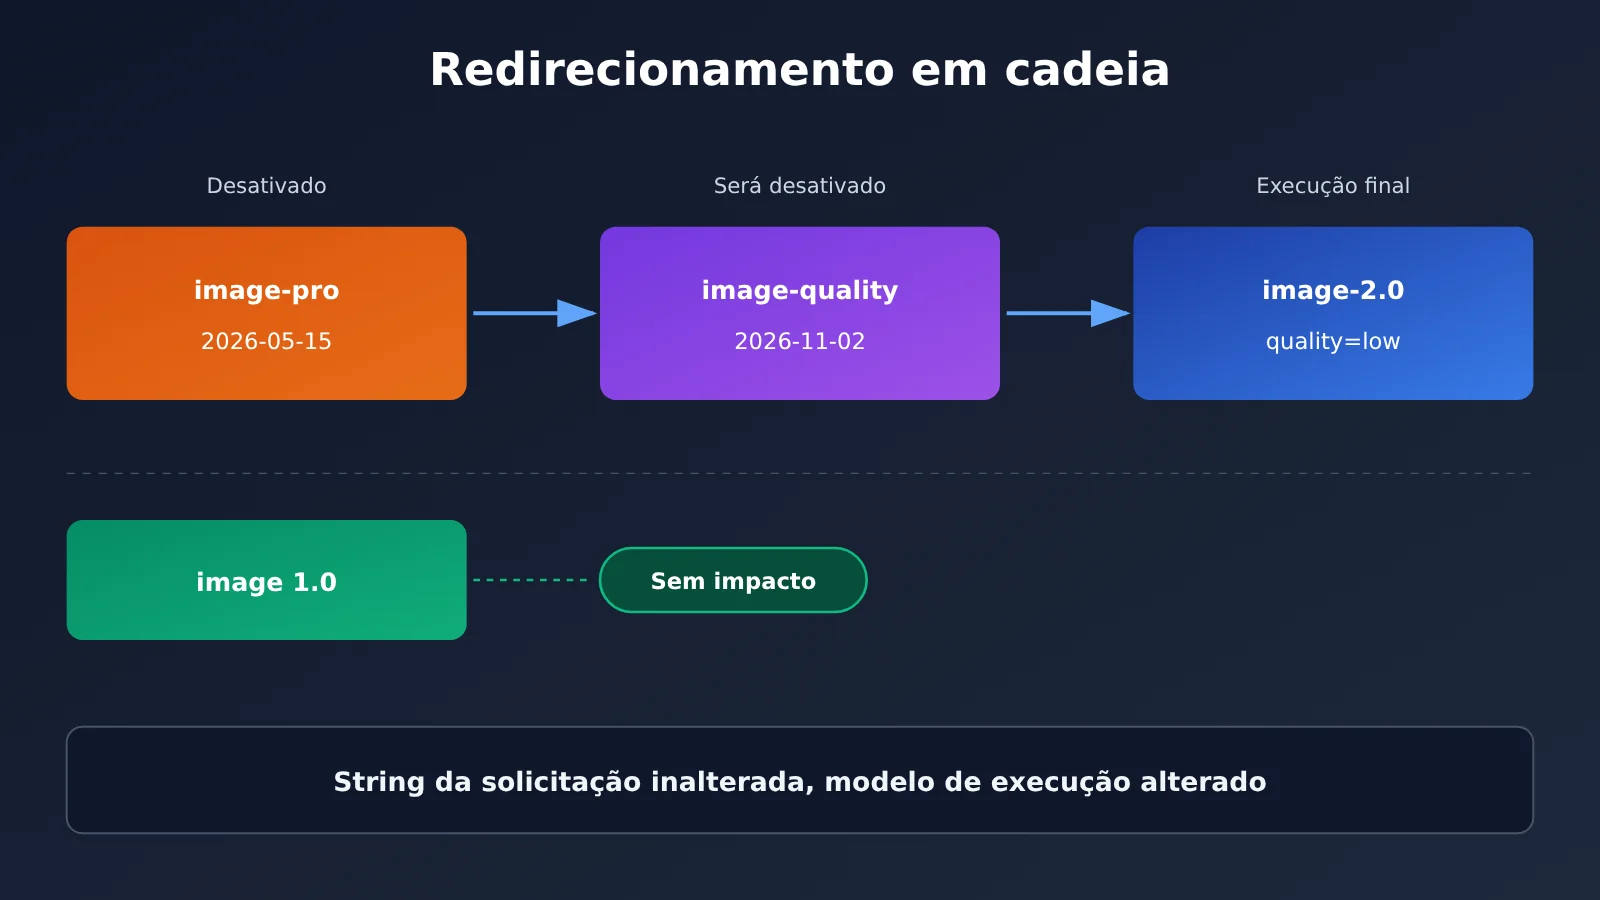
4 riscos de governança de versões de APIs de IA revelados pela migração do Grok Imagine
A análise a seguir parte dos mecanismos oficiais para identificar riscos de engenharia. Não se trata de uma estatística de incidentes ocorridos na xAI. Esses riscos podem ser divididos em quatro categorias: identidade do modelo, qualidade da saída, cobrança e monitoramento.
Risco 1: mudança na identidade do modelo
A string enviada pelo cliente continua a mesma, mas o modelo executado no servidor muda. A xAI informa o modelo efetivamente usado no campo model da resposta, o que é uma boa notícia — desde que seu sistema registre e compare esse campo. Muitos aplicativos apenas fixam o nome do modelo na requisição e nunca leem as informações retornadas na resposta.
Risco 2: mudanças na qualidade e no estilo da saída
A confirmação oficial é de que “a estrutura da requisição é compatível”, não de que “as imagens geradas serão iguais”. No lançamento do Image 2.0, a xAI destacou recursos como a capacidade de seguir comandos com várias condições, lidar com textos pequenos e layouts complexos e editar imagens usando várias imagens de referência. Ao mesmo tempo, alguns usuários do Reddit r/grok relataram que a versão 2.0 não funcionava tão bem quanto a anterior em detalhes de pele, iluminação natural e preservação da imagem original.
Essas avaliações são experiências pessoais e subjetivas, voltadas principalmente ao produto para consumidores. Não é possível concluir, a partir delas, que a versão 2.0 tenha piorado em todos os aspectos. Mas elas mostram algo importante: o mesmo comando pode produzir uma composição, um estilo ou um resultado de edição localizada diferente depois da troca de modelo. Isso precisa ser verificado com testes de regressão, em vez de presumir que “compatível” significa “sem problemas”.
Risco 3: mudanças na cobrança e nos níveis de qualidade
Esta migração é um caso em que o preço caiu, mas justamente por isso ajuda a destacar a importância de configurar o nível de qualidade. A tabela abaixo mostra os preços oficiais da xAI por imagem de saída, em dólares e sem incluir o custo de entrada das imagens de referência:
| Resolução | Quality anterior | 2.0 Low | 2.0 Medium |
|---|---|---|---|
| 1K | $0.05 | $0.04 | $0.06 |
| 1.5K | $0.06 | $0.05 | $0.07 |
| 2K | $0.07 | $0.06 | $0.08 |
Para 10.000 imagens 1K por mês, o custo teórico de saída seria de aproximadamente $400 se você mantiver o identificador antigo, que passa a usar automaticamente o 2.0 Low — $100 a menos que os $500 do Quality anterior. Se optar pelo 2.0 Medium, o custo sobe para $600, ou $100 a mais que na versão anterior. Na edição de imagens, também é preciso somar $0.01 por imagem de referência. Por exemplo, com 1 imagem de referência e 1 imagem 1K de saída, o custo é de $0.06 no Quality anterior, $0.05 no 2.0 Low e $0.07 no 2.0 Medium.
Uma diferença mais fácil de passar despercebida está nos valores padrão. A partir de 28 de agosto, se quality não for informado no 2.0, o padrão será auto. Atualmente, auto seleciona low para texto para imagem e medium para edição de imagens — a documentação oficial usa “currently”, portanto essa escolha não é permanente. Assim, “manter o identificador antigo” e “mudar para o 2.0 sem informar quality” não são opções equivalentes para edição, e seus custos também diferem. Vale notar ainda que a tabela de preços inclui 1.5K, mas a documentação dos parâmetros de geração lista explicitamente apenas 1k e 2k para resolution. É preciso testar se é possível especificar 1.5k.
Risco 4: pontos cegos no monitoramento
Se a aplicação acompanha apenas códigos de status HTTP, taxa de sucesso e tempo de resposta, a troca de modelo fica praticamente “invisível” nas métricas. O modo assíncrono (deferred) de geração de imagens da xAI oferece outro exemplo: pending retorna HTTP 202, done retorna HTTP 200 e failed também retorna HTTP 200, com informações de erro no corpo da resposta. HTTP 200 não significa necessariamente que a operação foi concluída com sucesso.
Comparação das estratégias de gestão de versões dos modelos
A estratégia da xAI de “continuar reconhecendo identificadores antigos e substituir o modelo no servidor” é apenas uma das possibilidades, não uma regra comum a todos os fornecedores. Ao comparar a documentação oficial de algumas empresas, as diferenças ficam claras.
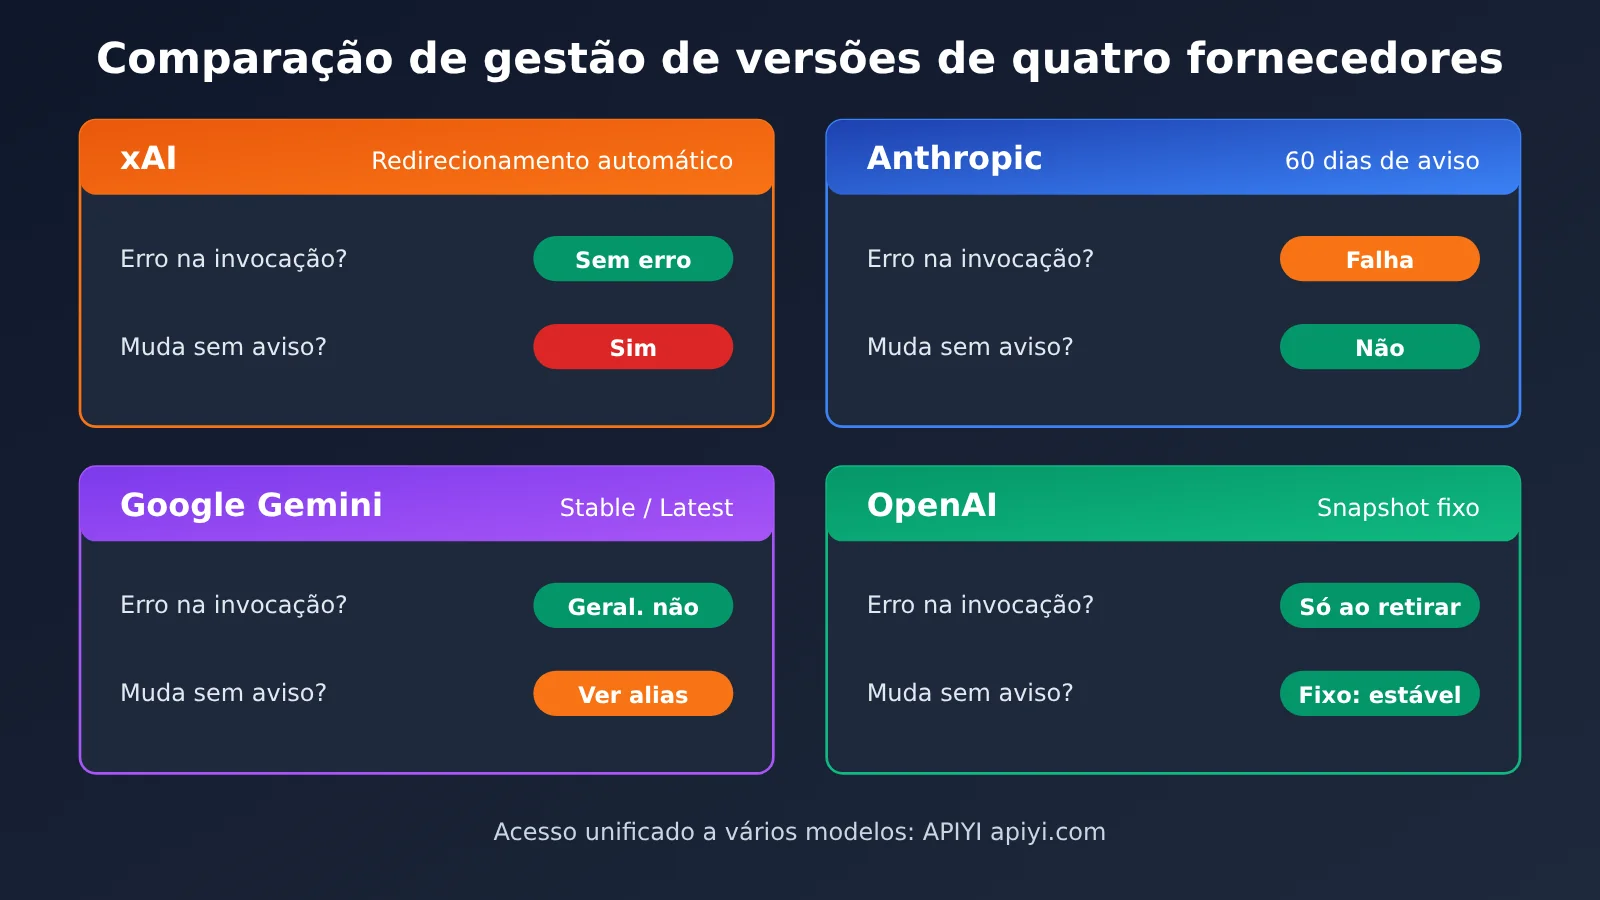
| Fornecedor | Estratégia oficial de versões | Comportamento após desativação ou alteração | O que isso significa para desenvolvedores |
|---|---|---|---|
| xAI | Identificadores desativados continuam sendo reconhecidos, com redirecionamento no servidor | Não há erro, mas o modelo executado muda | É essencial verificar o campo model na resposta |
| Anthropic | Quatro estágios: Active / Legacy / Deprecated / Retired | Após Retired, as solicitações falham; para modelos públicos, o aviso é dado com pelo menos 60 dias de antecedência | A falha fica evidente, mas é preciso acompanhar os avisos de descontinuação |
| Google Gemini | Stable / Preview / Latest / Experimental | O alias Latest muda automaticamente para novas versões; alterações que quebram a compatibilidade são anunciadas com antecedência | Stable é recomendado para produção; use Latest com cuidado |
| OpenAI | Recomenda fixar snapshots dos modelos em produção | A compatibilidade retroativa da estrutura da API não garante resultados consistentes | Fixe snapshots e crie um conjunto de avaliação, mas continue atento às datas de desativação |
Comparação com a xAI: a xAI oferece a transição mais “suave” em termos de compatibilidade com o cliente: o código antigo não para de funcionar de repente. Em compensação, a mudança de modelo não aparece na forma de erro. Já a estratégia da Anthropic de fazer as solicitações falharem após Retired é mais “barulhenta”, mas torna o problema visível mais cedo.
Comparação entre Google e OpenAI: o Google incorporou explicitamente ao alias Latest a ideia de “manter o identificador enquanto a versão muda”, mostrando que esse tipo de mecanismo é público e comum. A OpenAI, por outro lado, recomenda fixar snapshots em produção e criar um conjunto de avaliação. As duas abordagens mostram que a gestão de versões não é um problema isolado de uma empresa, mas um desafio de engenharia para quem usa qualquer API de IA.
💡 Dica para escolher: a semântica de versões varia bastante entre fornecedores. Ao integrar vários modelos, é recomendável registrar tanto o “modelo solicitado” quanto o “modelo executado”. Se você usa a APIYI apiyi.com para acessar modelos de diferentes fornecedores por meio de uma interface compatível com a OpenAI, também vale manter esses dois campos na camada da aplicação para facilitar as comparações.
Como estruturar a governança de versões de APIs de IA: logs, custos e implementação gradual
Primeiro passo: diferencie o modelo solicitado do modelo executado
As convenções semânticas de IA generativa do OpenTelemetry incluem dois atributos importantes: gen_ai.request.model indica o modelo solicitado pelo cliente, enquanto gen_ai.response.model indica o modelo que gerou a resposta. A xAI não fornece automaticamente todos os campos de telemetria, então a própria aplicação precisa coletar e mapear esses dados. Veja alguns campos recomendados para os logs da aplicação (são sugestões de engenharia, não exigências oficiais):
| Campo | Finalidade | Observações |
|---|---|---|
requested_model / served_model |
Identificar redirecionamentos silenciosos | O valor de served_model vem do campo model da resposta |
quality_requested / quality_effective |
Acompanhar o nível de qualidade | Se o valor efetivo só puder ser inferido pela documentação, marque-o como tal |
response_status / business_status |
Distinguir o resultado HTTP do resultado da operação | Uma operação assíncrona com status failed também pode retornar HTTP 200 |
cost_usd |
Registrar o custo real de cada operação | Na xAI, pode ser calculado a partir de cost_in_usd_ticks |
reference_image_count / resolution |
Atribuir custos | Em operações de edição, inclua o custo das imagens de entrada |
prompt_template_version / evaluation_result |
Comparar resultados em testes de regressão | Não registre por padrão comandos sensíveis nem imagens dos usuários |
Etapa 2: registre no código o modelo efetivamente usado e o custo
A documentação oficial de Cost Tracking da xAI, atualizada em 10/10/2026, informa que o objeto usage da resposta pode incluir cost_in_usd_ticks. A conversão é feita pela fórmula cost_usd = cost_in_usd_ticks / 10000000000: no exemplo oficial, 400000000 ticks equivalem a US$ 0,04. Esse campo é específico da xAI, então, ao usar um SDK ou uma plataforma de terceiros, é importante verificar se ele é repassado sem alterações.
O exemplo mínimo abaixo demonstra a ideia de comparar os modelos a cada requisição:
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
REQUESTED_MODEL = "grok-imagine-image-2.0"  # 示例名称,可用模型以平台实际列表为准

resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={"model": REQUESTED_MODEL, "prompt": "A tech magazine cover",
          "quality": "low", "resolution": "1k", "n": 1},
    timeout=180,
).json()

served = resp.get("model")
if served and served != REQUESTED_MODEL:
    print(f"[版本告警] 请求 {REQUESTED_MODEL},实际执行 {served}")
Veja a implementação completa, com verificação de custo e status da operação
import time
import logging
import requests
from typing import Optional

logging.basicConfig(level=logging.INFO)
log = logging.getLogger("model_governance")

BASE_URL = "https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
TICKS_PER_USD = 10_000_000_000  # xAI 官方换算:1 美元 = 10^10 ticks


def generate_image(
    prompt: str,
    model: str,
    quality: str = "low",          # 显式填写,避免 auto 默认值随上游变化
    resolution: str = "1k",
    api_key: str = "YOUR_API_KEY",
    expected_unit_cost: Optional[float] = None,
) -> dict:
    start = time.time()
    r = requests.post(
        f"{BASE_URL}/images/generations",
        headers={"Authorization": f"Bearer {api_key}"},
        json={"model": model, "prompt": prompt, "quality": quality,
              "resolution": resolution, "n": 1},
        timeout=180,
    )
    latency_ms = int((time.time() - start) * 1000)
    body = r.json() if r.content else {}

    # 1. 执行模型校验
    served_model = body.get("model")

    # 2. 业务结果校验:HTTP 200 不等于拿到可用图片
    data = body.get("data") or []
    has_image = bool(data and (data[0].get("url") or data[0].get("b64_json")))
    business_ok = r.status_code == 200 and has_image and not body.get("error")

    # 3. 成本:字段可能不被透传,缺失时记录为 None 而不是 0
    ticks = (body.get("usage") or {}).get("cost_in_usd_ticks")
    cost_usd = ticks / TICKS_PER_USD if ticks is not None else None

    record = {
        "requested_model": model,
        "served_model": served_model,
        "quality_requested": quality,
        "resolution": resolution,
        "response_status": r.status_code,
        "business_status": "ok" if business_ok else "failed",
        "latency_ms": latency_ms,
        "cost_usd": cost_usd,
    }

    if served_model and served_model != model:
        log.warning("模型重定向: %s -> %s", model, served_model)
    if cost_usd is not None and expected_unit_cost is not None \
            and abs(cost_usd - expected_unit_cost) > 1e-6:
        log.warning("单价偏离预期: 预期 %.4f 实际 %.4f", expected_unit_cost, cost_usd)

    log.info("generation record: %s", record)
    return record


if __name__ == "__main__":
    generate_image(
        prompt="A clean product shot on white background",
        model="grok-imagine-image-2.0",  # 以平台模型列表为准
        quality="low",
        expected_unit_cost=0.04,
    )
🚀 Comece agora: para validar essa lógica de registro, cadastre-se na APIYI apiyi.com e obtenha créditos de teste. Depois, use alguns comandos do seu negócio para testar os campos de log. Os modelos de imagem disponíveis, os parâmetros de qualidade aceitos e os preços reais devem ser consultados na lista de modelos e na página de preços da plataforma. Os preços de plataformas terceirizadas não são iguais aos preços oficiais da xAI.
Terceiro passo: conjunto fixo de testes e validação gradual
Com base no método Canary Release do Google SRE e nas recomendações da OpenAI para conjuntos de avaliação, a migração de modelos de imagem pode seguir estas etapas: primeiro, prepare um conjunto fixo de amostras que cubra pôsteres com texto, imagens de produtos, edição de retratos, composições com vários elementos e alterações localizadas; depois, mantenha fixos o comando, a imagem de entrada, a resolução, a qualidade, a proporção e a quantidade de imagens geradas. Em seguida, compare a aderência às instruções, a preservação dos elementos principais, a precisão do texto, as alterações fora da área editada, a taxa de aprovação na avaliação humana e o custo por imagem aprovada. Por fim, se o roteamento permitir esse controle, faça a mudança com uma pequena parcela do tráfego e acompanhe as métricas antes de ampliá-la.
Um ponto importante: a descontinuação foi imposta pela xAI. Portanto, os desenvolvedores não devem presumir que poderão voltar ao modelo subjacente antigo do Quality, que já foi descontinuado. Aqui, “reverter” significa mudar para um modelo alternativo que tenha sido validado e ainda esteja disponível, pausar a funcionalidade afetada ou ajustar o parâmetro quality — não restaurar uma versão antiga que já não pode ser acessada.
Impacto da migração do Grok Imagine para desenvolvedores e plataformas de API
Impacto para desenvolvedores
- Amplie o escopo da busca: não procure apenas por
grok-imagine-image-quality, mas também por aliases mais antigos, comogrok-imagine-image-pro. - Defina os parâmetros explicitamente: ao migrar diretamente para a versão 2.0, especifique low ou medium. Não deixe que auto decida a faixa de qualidade e o custo das operações de edição.
- Atualize os cálculos de custo: quando a xAI diz que o preço é “US$ 0,01 menor por imagem”, a comparação se refere ao preço de saída. Em operações de edição com imagem de referência, a redução do custo total será diferente.
- Valide os resultados separadamente: além da taxa de sucesso das chamadas, inclua critérios de aceitação para o negócio e métricas de custo por resultado aprovado.
Impacto para plataformas agregadoras de APIs
Para plataformas que oferecem acesso a vários modelos, a gestão de versões está se tornando uma necessidade real dos clientes. Eles precisam saber para qual modelo do provedor cada solicitação foi encaminhada, acompanhar as datas e as mudanças de preço associadas à desativação e ao redirecionamento, garantir que parâmetros importantes como quality sejam repassados corretamente e ter acesso a informações rastreáveis sobre modelos e cobranças. Essas são áreas que vale a pena avaliar e desenvolver.
🎯 Dica técnica: se você acessa modelos de vários provedores por uma plataforma agregadora como a APIYI apiyi.com, confira três pontos durante a migração: se o campo model na resposta reflete o modelo realmente usado pelo provedor, se o parâmetro quality está sendo repassado e se a cobrança corresponde ao preço unitário esperado. Caso encontre alguma divergência, guarde o ID da solicitação e entre em contato com o suporte técnico da plataforma. Isso é bem mais eficiente do que revisar a fatura depois.
Perguntas frequentes (FAQ)
P1: O que significa a desativação do modelo Grok Imagine?
A partir de 2 de novembro de 2026, o identificador `grok-imagine-image-quality` da API da xAI foi desativado, mas ainda pode ser usado. O servidor redireciona as solicitações para `grok-imagine-image-2.0`, sempre com o nível low. Tanto a interface de geração quanto a de edição são afetadas; o modelo 1.0, `grok-imagine-image`, não é afetado.
P2: O código antigo vai retornar erro 404 ou falhar?
Não. Segundo a documentação oficial, o identificador antigo ainda é reconhecido e as solicitações são redirecionadas automaticamente, mantendo a compatibilidade das estruturas de solicitação e resposta. É justamente aí que está o cuidado: a ausência de erros não significa que os resultados e o preço unitário continuem iguais. Isso é diferente da estratégia da Anthropic, em que as solicitações falham depois que um modelo entra no estado Retired.
P3: Basta mudar para grok-imagine-image-2.0 para tudo continuar exatamente como antes?
Não exatamente. Ao usar o 2.0 sem informar quality, o padrão é auto: atualmente, texto para imagem usa low e edição de imagens usa medium. Já o identificador antigo fica fixo em low. Para edição no nível medium, o preço por imagem em 1K é de US$ 0,06, acima dos US$ 0,05 do antigo Quality. É recomendável definir o nível explicitamente e avaliar os resultados com um conjunto fixo de testes.
P4: Como saber qual modelo meu sistema está usando de fato?
Leia e registre o campo `model` da resposta e compare-o com o modelo solicitado. Registre também o custo real calculado a partir de `cost_in_usd_ticks`, se esse campo estiver disponível. Ao fazer chamadas por plataformas de terceiros, como APIYI apiyi.com, confirme se esses campos são repassados sem alterações. Consulte a página oficial da plataforma para verificar a disponibilidade e os preços dos modelos.
P5: Se os resultados do novo modelo não forem satisfatórios, posso voltar ao antigo Quality?
Não conte com isso. A desativação é imposta pelo provedor original, e o acesso ao modelo que rodava por trás do antigo Quality não é garantido. Uma alternativa é ajustar o parâmetro quality, trocar para outro modelo validado para o seu caso de uso ou desativar temporariamente a funcionalidade afetada. Ter uma alternativa já testada e usar a interface unificada da APIYI apiyi.com para testar a troca entre modelos ajuda a evitar decisões de última hora.
P6: O Image 2.0 é melhor que a versão antiga?
Não há uma resposta única. No lançamento, a xAI afirmou que o modelo estava em segundo lugar nos rankings da Arena para texto para imagem e edição de imagens naquele momento — um resultado histórico de 7 de agosto. Um retrato dos rankings no fim de outubro mostrava o modelo em 5º lugar na classificação geral de edição de imagem única e em 6º na de texto para imagem. Alguns usuários da comunidade também demonstraram insatisfação com o realismo das imagens e a preservação da imagem original. As capacidades anunciadas oficialmente, os testes independentes e as preferências subjetivas são critérios diferentes. A referência mais confiável é o conjunto de testes do seu próprio negócio.
Pontos principais da governança de versões de APIs de IA
- Uma chamada bem-sucedida não significa que o modelo continua o mesmo: os identificadores antigos do Grok Imagine não retornam erro, mas já foram redirecionados silenciosamente para o 2.0 Low.
- Aliases podem gerar uma cadeia de redirecionamentos: pro → quality → 2.0 Low. Não basta verificar a string de configuração.
- Valores padrão também mudam: atualmente, auto seleciona low para geração e medium para edição. Defina a opção explicitamente.
- Avalie o custo pela cobrança real: operações de edição incluem custos de entrada da imagem de referência, então a redução total pode diferir da redução no preço de saída.
- HTTP 200 não garante o sucesso da operação: tarefas assíncronas com status failed também podem retornar 200.
- Cada fornecedor tem sua própria política: redirecionamento, falha, troca dinâmica de Latest e snapshots fixos exigem abordagens diferentes.
- Comece pelos logs: na APIYI apiyi.com, use a cota de teste para implementar o registro dos campos de modelo solicitado e modelo executado.
Resumo
As principais lições da migração do Grok Imagine são:
- Políticas de compatibilidade podem esconder mudanças: a xAI escolheu um redirecionamento que minimiza o impacto para os clientes. Mudanças de modelo, nível e preço unitário não aparecem como erros.
- A governança de versões precisa de mecanismos próprios: registrar tanto o modelo solicitado quanto o executado, acompanhar os custos reais e validar os resultados da operação são medidas que o monitoramento comum de disponibilidade não cobre.
- Planeje a reversão com antecedência: a descontinuação obrigatória pelo fornecedor não pode ser revertida. Por isso, é importante ter modelos alternativos e configurações de parâmetros previamente testados.
Faça uma verificação hoje mesmo: procure os identificadores antigos de modelos no código, compare-os com o campo model da resposta, defina explicitamente o parâmetro quality para edição e geração e prepare um conjunto fixo de amostras de teste. Uma opção é usar a APIYI apiyi.com para criar um ambiente de testes comparativos entre modelos com uma interface unificada. Assim, você melhora a observabilidade das versões antes da próxima mudança do fornecedor.
📚 Referências
- Guia de migração de modelos de imagem da xAI de 2026-11-02: regras de desativação e redirecionamento
- Link:
docs.x.ai/developers/migration/imagine-image-quality-nov-2 -
Descrição: fonte primária sobre identificadores desativados, modelos substitutos, níveis de qualidade e escopo do impacto
-
Histórico de desativações da xAI de 2026-05-15: registro da migração do identificador pro
- Link:
docs.x.ai/developers/migration/may-15-retirement -
Descrição: referência essencial para entender os redirecionamentos em cadeia
-
Página oficial de preços e modelos Image 2.0 da xAI: resoluções e preços unitários por nível
- Link:
docs.x.ai/developers/pricing -
Descrição: base para calcular os custos de saída e de entrada de imagens de referência
-
Documentação de parâmetros de geração de imagens da xAI: valor padrão de quality e status assíncrono
- Link:
docs.x.ai/developers/model-capabilities/images/generation -
Descrição: comportamento de auto e status HTTP no modo deferred
-
xAI Cost Tracking: campo de custo real por requisição
- Link:
docs.x.ai/developers/cost-tracking -
Descrição: significado e conversão de cost_in_usd_ticks
-
Documentação de descontinuação de modelos da Anthropic: quatro etapas do ciclo de vida dos modelos
- Link:
docs.anthropic.com/en/docs/about-claude/model-deprecations -
Descrição: comparação com a política de falha de requisições após o modelo atingir o status Retired
-
Documentação de versões de modelos Google Gemini: diferença entre Stable e Latest
- Link:
ai.google.dev/gemini-api/docs/models -
Descrição: mecanismo de troca automática de versões por aliases
-
Engenharia de comandos e visão geral da API da OpenAI: fixação de snapshots e recomendações de avaliação
- Link:
developers.openai.com/api/docs/guides/prompt-engineering -
Descrição: recomendações oficiais para fixar snapshots em produção e criar conjuntos de avaliação
-
Google SRE Canary Release: método de lançamento gradual
- Link:
sre.google/workbook/canarying-releases/ -
Descrição: validação com uma pequena parcela do tráfego para reduzir o impacto das mudanças
-
Convenções semânticas do OpenTelemetry para IA generativa: atributos de modelo em requisições e respostas
- Link:
opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/ - Descrição: definições de gen_ai.request.model e gen_ai.response.model
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Entre em contato pela página inicial da APIYI. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com.