Nota do autor: equipes que usam OpenAI, Claude, Gemini e Qwen ao mesmo tempo podem, em uma única conta, separar tokens por projeto, definir para cada token cota, validade, lista de modelos permitidos e grupo, e conferir os gastos nos logs de tokens.
Líderes de desenvolvimento que integram vários modelos ao mesmo tempo costumam esbarrar em três tipos de problema. Primeiro, as chaves API ficam espalhadas nos painéis de cada fornecedor, e fica difícil saber quem está com qual chave. Segundo, no fim do mês a fatura não bate com os projetos, e não dá para saber quanto cada projeto gastou. Terceiro, quando uma única chave é compartilhada por várias pessoas, para suspender apenas uma delas é preciso invalidar a chave inteira. Este artigo apresenta uma conta APIYI + tokens separados por projeto como forma de gestão, trazendo a gestão empresarial de múltiplos modelos para etapas de configuração executáveis.
Este não é mais um artigo explicando “por que você precisa de um serviço proxy de API”. Cada item de configuração abaixo corresponde às explicações sobre tokens e grupos na documentação do APIYI apiyi.com. Todos os números relacionados a taxas de requisição e grupos serão indicados como provenientes do texto original da documentação.
Valor principal: depois de ler este artigo, você será capaz de criar um token independente para cada projeto, limitar quanto ele pode gastar, por quanto tempo pode ser usado, quais modelos pode invocar e por qual grupo deve passar, além de consultar o consumo de cada projeto no log de tokens.
Pontos-chave do gerenciamento multi-modelo corporativo: chaves, cotas e logs separados por projeto
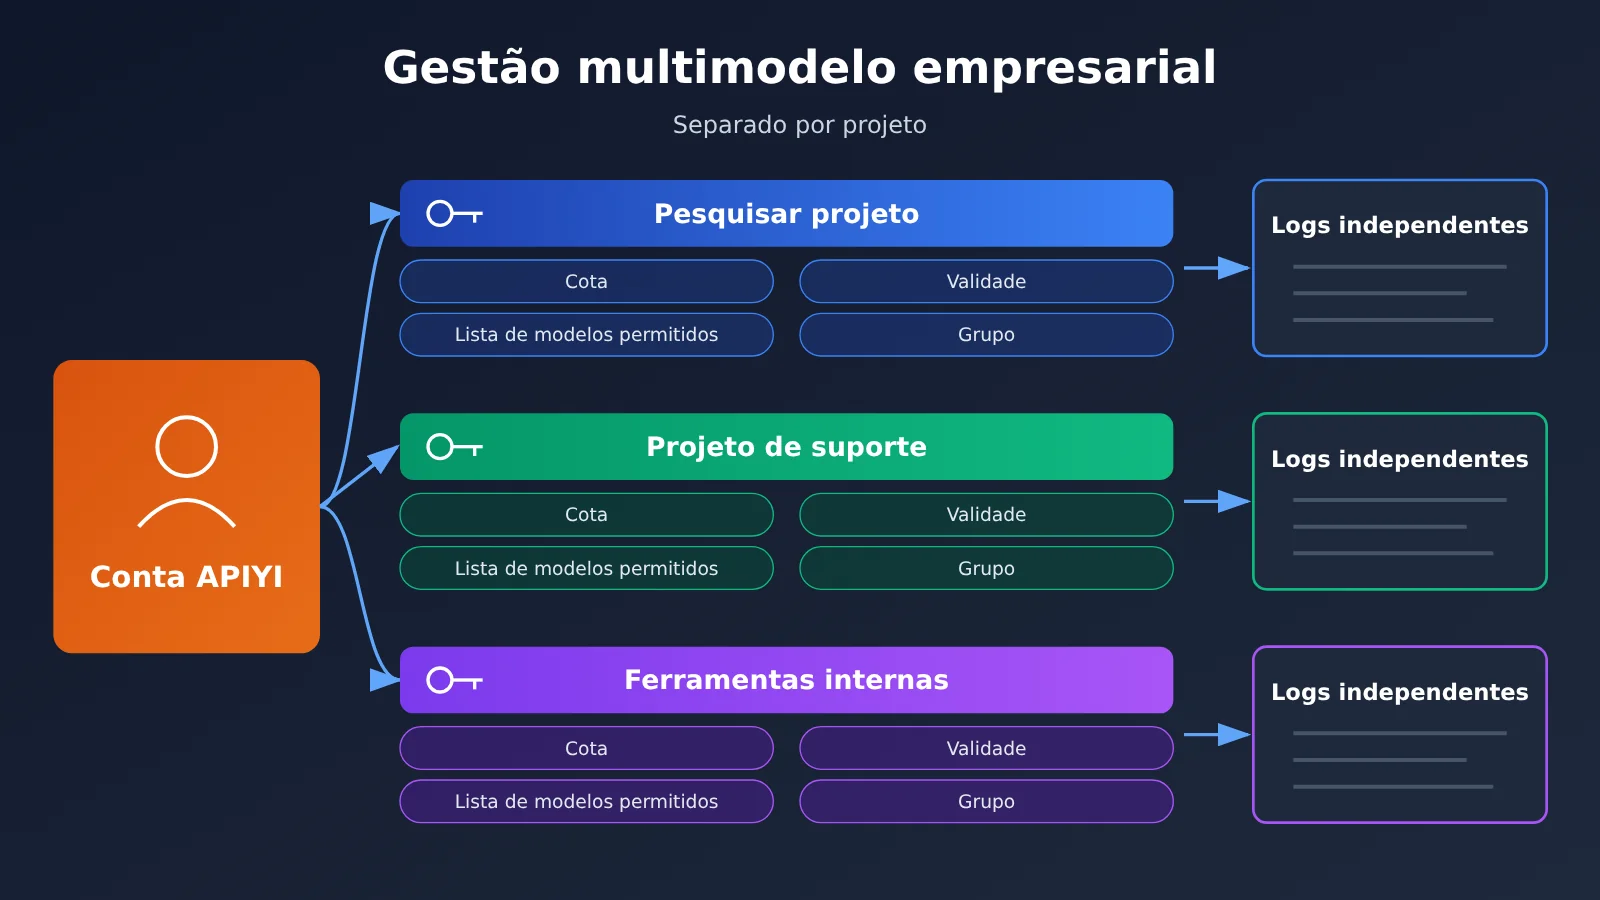
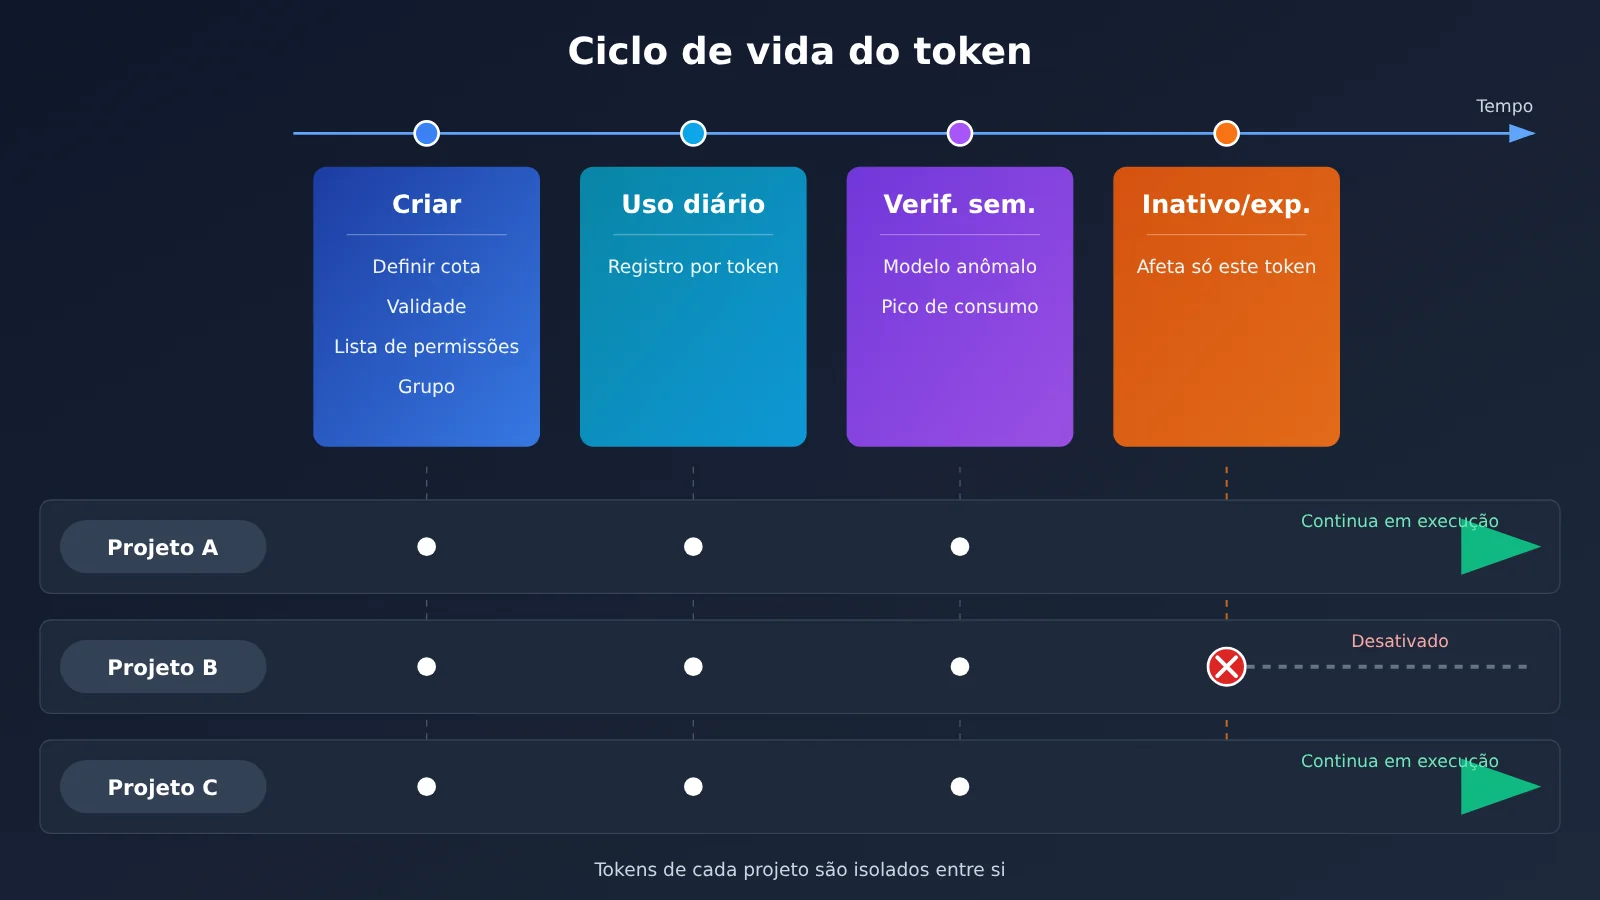
O segredo do gerenciamento multi-modelo corporativo é dividir as fronteiras de gestão, e não juntar tudo em uma chave mestra. No APIYI, o token é a chave API e começa com sk-. A documentação explica que cada token pode ter cota, tempo de expiração, modelos disponíveis e grupo definidos individualmente, e que consumo, cota restante e logs de chamadas também são registrados separadamente.
| Ponto | Descrição | Valor para o líder de P&D |
|---|---|---|
| Criar um token por projeto | Após o registro já vem um token padrão, e é possível criar outro para cada projeto ou membro | Ao desativar uma pessoa ou um projeto, as outras chamadas não são afetadas |
| Definir cota e validade separadamente | Cada token pode ter limite de cota e data de expiração | Estouro de orçamento e vencimento de terceirizados podem ser limitados de antemão |
| Lista de permissões de modelos | Sem lista configurada, dá para usar os mais de 200 modelos selecionados do site (texto da documentação); com lista, só os modelos indicados | Evita que o projeto mude por conta própria para um modelo caro |
| O grupo define canal e multiplicador | O grupo define o upstream, os modelos disponíveis e o multiplicador de cobrança | O mesmo modelo em grupos diferentes pode gerar faturas diferentes |
| Logs separados por token | Consumo e logs de chamadas de cada token são consultados individualmente | A conciliação de fim de mês pode ir direto ao projeto |
Por que separar tokens por projeto no gerenciamento multi-modelo corporativo
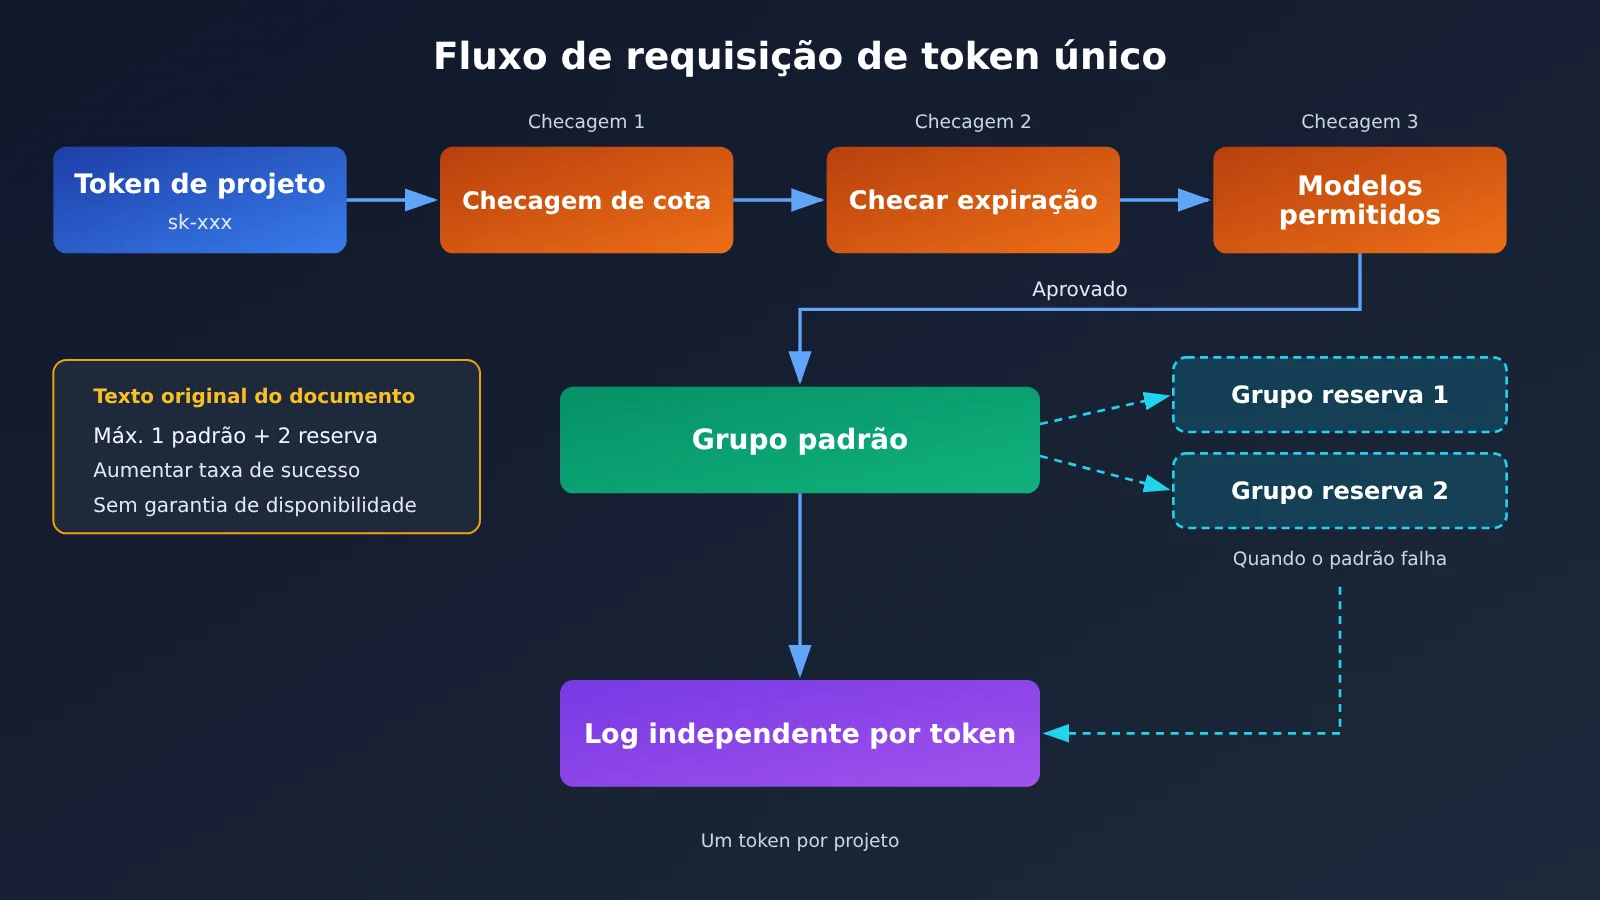
Um ponto da documentação precisa ficar claro desde o início: quando um token é usado por várias pessoas, o limite de taxa acompanha a conta, não a quantidade de tokens. O texto original da documentação diz que uma única conta geralmente fica tranquila dentro de 100 RPM e que o TPM não é avaliado. Isso é o que está escrito na documentação, não o resultado de um teste de estresse, e não constitui SLA.
Portanto, dividir tokens não serve para contornar o limite de taxa, e sim para criar isolamento de gestão. Um token corresponde a um projeto ou a um membro; se houver problema, dá para desativar só aquele token, e na hora de conferir as contas dá para olhar só ele. Se todos compartilharem o token padrão, o consumo nos logs fica todo misturado, sem como separar por projeto nem desligar com precisão um chamador específico.
Grupos e regras de fallback no gerenciamento multi-modelo corporativo
O grupo é o canal de recursos. Segundo o texto original da documentação, um token pode ter no máximo 1 grupo padrão e 2 grupos de fallback configurados. Fallback significa que, quando o grupo padrão não consegue atender à requisição, o sistema muda automaticamente para o grupo de fallback. A documentação descreve o fallback como algo que “aumenta a taxa de sucesso das chamadas”, e não como uma promessa de disponibilidade, então não dá para entender isso como “nunca falha”.
A grande maioria dos modelos de texto funciona bem com o grupo Default. Modelos dedicados, como os de vídeo, exigem outro grupo; se o token não tiver esse grupo, o modelo correspondente não pode ser chamado. Vale notar também que “200+ modelos” se refere ao total de modelos selecionados do site, e não significa que cada modelo esteja no grupo Default — vale o grupo indicado na página de cada modelo.
Guia rápido de gerenciamento de múltiplos modelos na empresa: 5 passos para criar tokens por projeto
A seguir, usamos como exemplo uma equipe com três projetos — projeto de busca aprimorada, projeto de chatbot de atendimento e ferramenta interna de escrita — para demonstrar o fluxo completo de configuração. O ponto de entrada é a página de tokens https://api.apiyi.com/token.
Passo 1: Planeje os tokens — um por projeto ou um por pessoa
Primeiro monte uma tabela de planejamento de tokens e só depois crie tudo no painel. Assim você evita ficar criando e alterando ao mesmo tempo e, no fim, voltar ao velho cenário de “uma chave só para todo mundo usar”.
| Nome do token | Quem usa | Lista de modelos permitidos | Grupo padrão | Grupo de fallback | Sugestão de cota e validade |
|---|---|---|---|---|---|
proj-search |
Serviço de busca aprimorada | gemini-3.8-flash, qwen3.8-max |
Default |
Configuração de grupos disponíveis na página do modelo | Cota definida pelo orçamento mensal, validade longa |
proj-support |
Chatbot de atendimento | claude-sonnet-5-5 |
Default |
Configuração de grupos disponíveis na página do modelo | Cota definida pelo orçamento mensal |
team-writing-zhang |
Ferramenta pessoal do membro | claude-opus-5-5 |
Default |
Não definir | Cota pequena, com data de expiração |
vendor-outsource |
Equipe terceirizada | Somente os modelos necessários para a entrega | Default |
Não definir | Cota alinhada ao ciclo do contrato, expira automaticamente ao final |
As sugestões de gestão da tabela são o nosso julgamento. A quais grupos cada modelo pertence especificamente deve ser conferido na página daquele modelo — não copie esta tabela literalmente.
Etapa 2: Criar um token e definir quatro limites
Ao criar um novo token na página de tokens, preencha os quatro itens em sequência:
- Quota: preencha conforme o orçamento mensal do projeto. Quando a quota acaba, esse token para de gerar cobranças e os demais tokens não são afetados.
- Tempo de expiração: indispensável para freelancers e membros temporários — assim, quando o prazo vencer, não é preciso recolher o acesso manualmente.
- Modelos disponíveis (lista de permissões): marque apenas os modelos que o projeto realmente precisa. Deixar em branco equivale a abrir todos os modelos do site, o que não é recomendado.
- Grupo: escolha primeiro o grupo padrão e, se necessário, adicione no máximo 2 grupos de fallback.
Etapa 3: Coloque as chaves nas variáveis de ambiente, separando os nomes por projeto
Não deixe as chaves fixas no código ou no repositório. A recomendação é usar um nome de variável de ambiente independente para cada projeto, por exemplo, definir APIYI_KEY_SEARCH=sk-... e APIYI_KEY_SUPPORT=sk-... no ambiente de implantação, e cada serviço lê a variável correspondente. Assim, ao rotacionar a chave de um projeto, você só precisa alterar uma variável.
Passo 4: invocar pela interface compatível com OpenAI
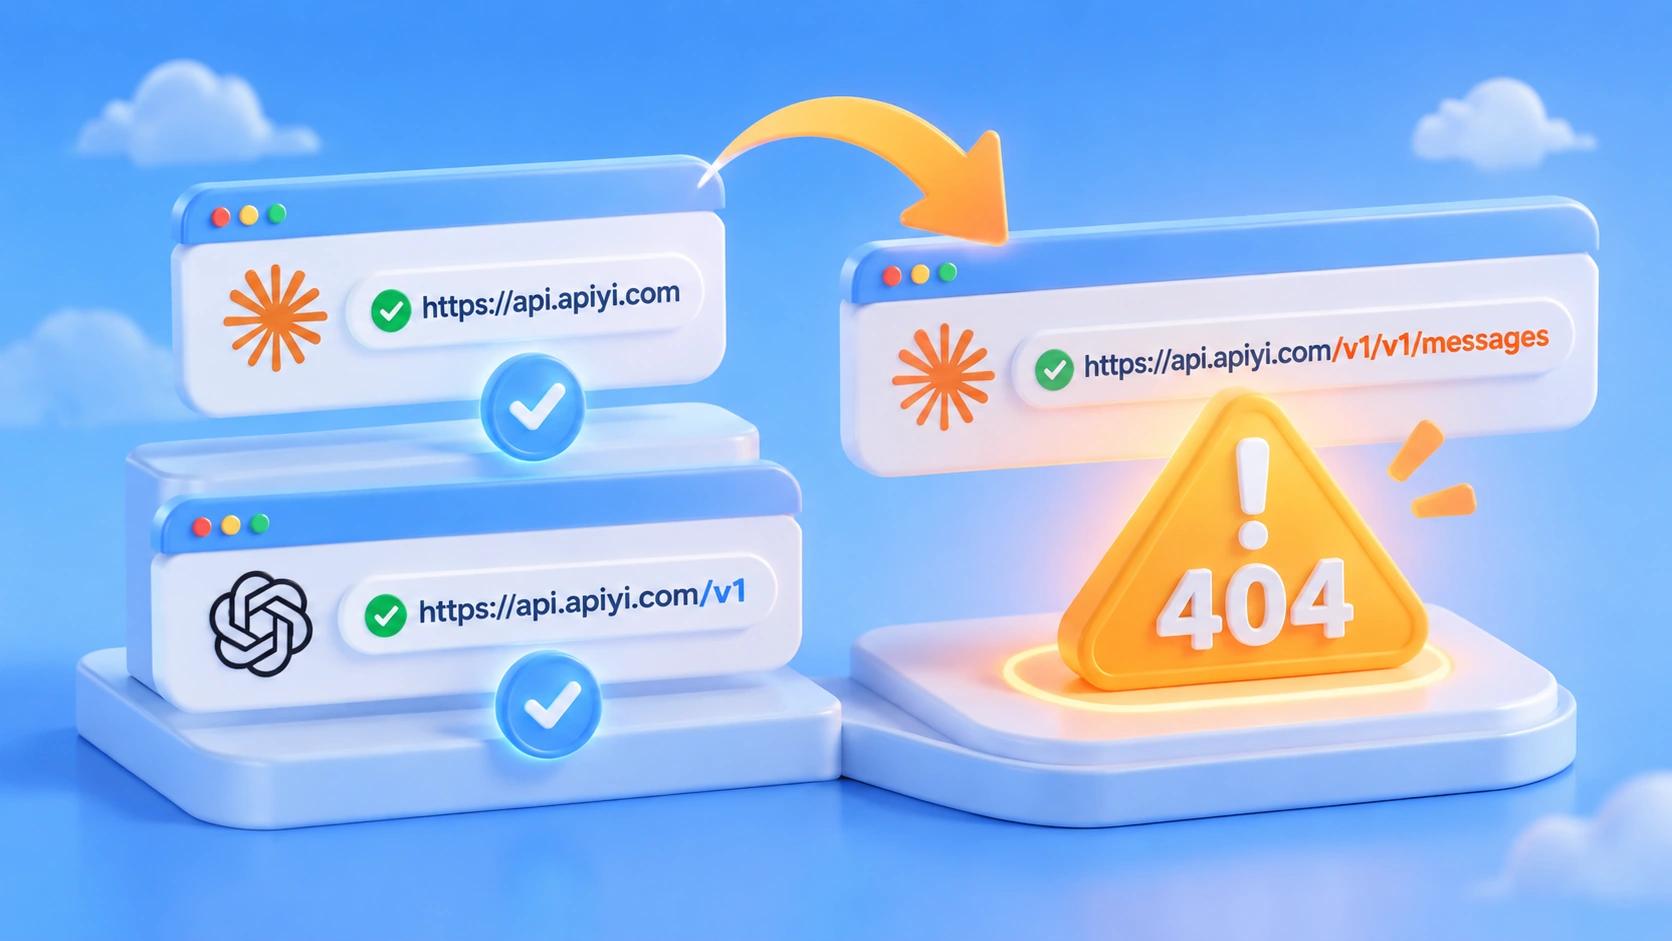
O APIYI oferece uma interface compatível com OpenAI, e para integrar basta alterar dois pontos:
- Defina
base_urlcomohttps://api.apiyi.com/v1 - Leia a
api_keya partir da variável de ambiente do próprio projeto, por exemploos.environ["APIYI_KEY_SEARCH"]
Ao usar o SDK oficial de Python, o essencial é uma única linha de inicialização: client = OpenAI(api_key=os.environ["APIYI_KEY_SEARCH"], base_url="https://api.apiyi.com/v1"). Depois, basta chamar client.chat.completions.create(model="gemini-3.8-flash", messages=[...]). Se você trocar o model por um modelo fora da lista de permissões, esse token não conseguirá fazer a chamada. É exatamente esse o efeito que a lista de permissões deve produzir.
Passo 5: revisar os logs de tokens toda semana e fazer a conciliação por token no fim do mês
O consumo, a cota restante e os logs de chamadas de cada token podem ser consultados individualmente. Recomendo olhar os logs de cada token uma vez por semana, verificando dois pontos principais: se apareceu algum modelo inesperado e se a curva de consumo deu um salto repentino. Ao consolidar por token no fim do mês, você obtém o custo separado por projeto.
🎯 Dica técnica: no primeiro rollout, sugiro desativar o token padrão ou deixá-lo apenas para o administrador e, em seguida, criar um a um os tokens na página de tokens do APIYI, apiyi.com, seguindo a tabela de planejamento acima. Assim, desde o primeiro dia, todas as chamadas poderão ser atribuídas a um projeto específico nos logs.
A conta da gestão de múltiplos modelos na empresa: trocar de modelo muda a conta
O ponto que equipes que trabalham com vários modelos mais costumam ignorar: mudar um modelo ou um grupo também altera a conta. Os preços abaixo vêm da tabela geral de modelos da APIYI, são os preços padrão por milhão de tokens e os dados foram atualizados em 2026-11-16 09:39 (UTC+8).
| ID do modelo | Preço de entrada | Preço de saída | Leitura de cache | Endpoint / grupo indicado na documentação | Plataformas disponíveis |
|---|---|---|---|---|---|
claude-opus-5-5 |
$4 | $20 | $0.2 | endpoints chat e messages | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | conforme a página do modelo | APIYI |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | endpoints chat e messages; grupos ClaudeCode, Default, SVIP | APIYI |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse com multiplicador de 0.5×; Default e SVIP com 1× | APIYI |
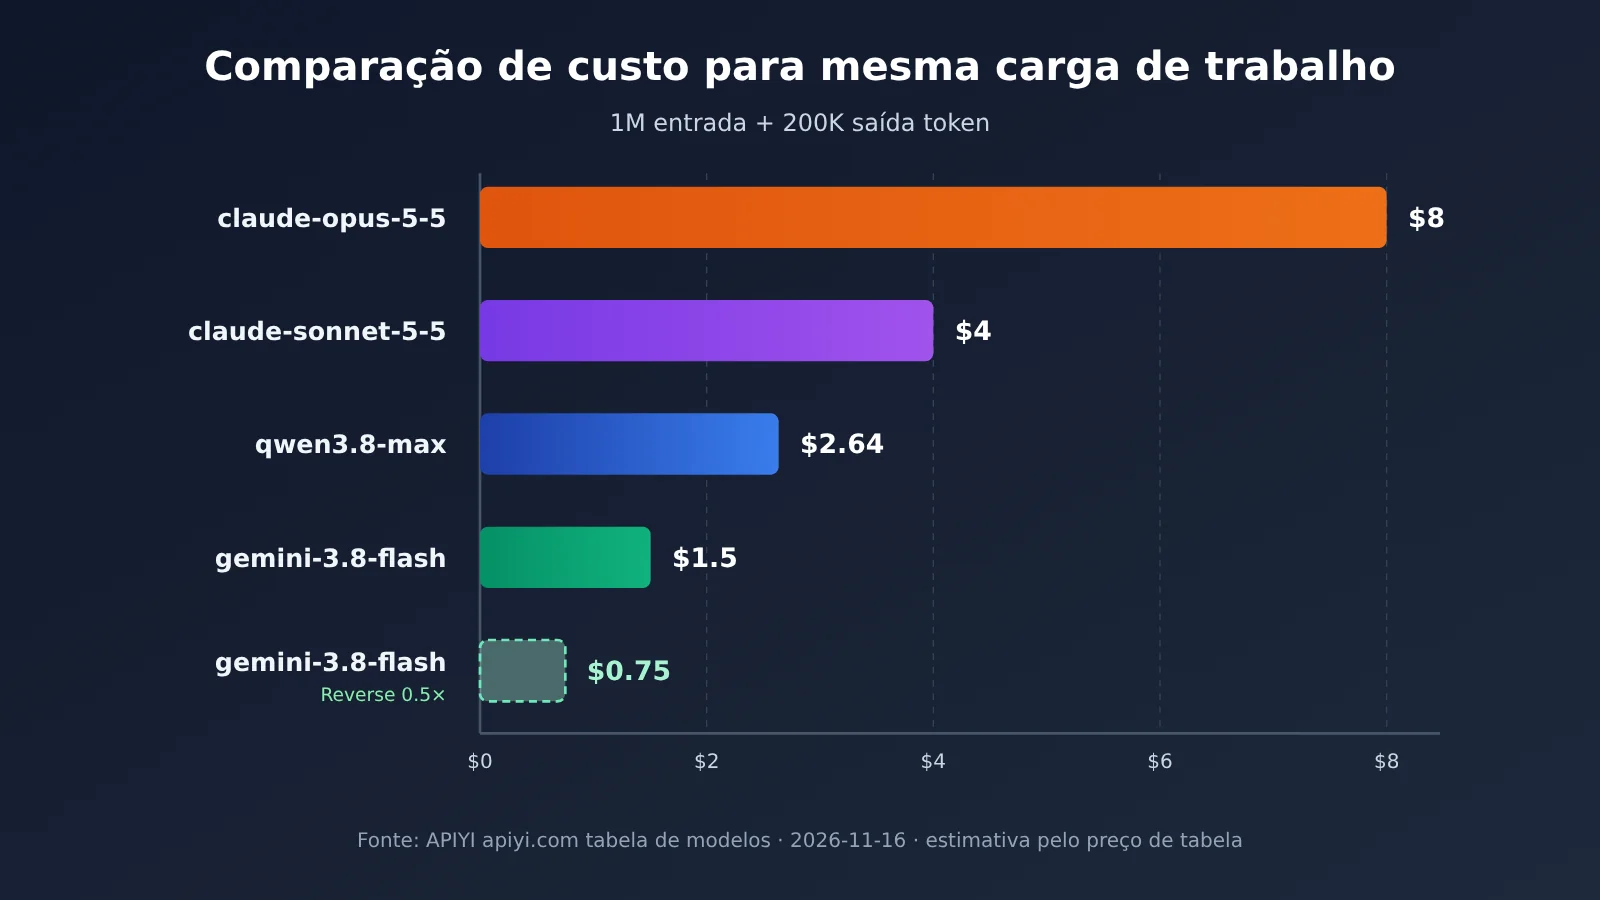
Segundo a documentação, o cálculo da cobrança por uso é: tokens de entrada × preço de entrada + tokens de saída × preço de saída. Suponha que um projeto consuma 1 milhão de tokens de entrada e 200 mil tokens de saída por mês. Pela tabela de preços, a estimativa fica assim:
claude-opus-5-5: 4 + 0,2 × 20 = $8claude-sonnet-5-5: 2 + 0,2 × 10 = $4qwen3.8-max: 1,65 + 0,2 × 4,95 = $2,64gemini-3.8-flash(Default, 1×): 0,75 + 0,2 × 3,75 = $1,5; se usar Gemini_Reverse (0,5×), convertendo pelo multiplicador, fica em cerca de $0,75
Dá para ver que, para a mesma carga de trabalho, trocar de modelo faz o custo variar várias vezes, e trocar de grupo também altera diretamente o valor efetivamente cobrado. Por isso, definir uma allowlist e um grupo para o token é, na prática, definir um teto para o preço unitário do projeto. Ao consultar modelos e preços, use como referência a lista de modelos da APIYI apiyi.com. Depois de confirmar em quais grupos um modelo está disponível e qual é o multiplicador, adicione-o ao token correspondente. O endereço de chamada é sempre https://api.apiyi.com/v1; para trocar de modelo, basta alterar o parâmetro model, sem mudar o base_url.
Se a equipe estiver avaliando um modelo recém-lançado, como o qwen4-max, lançado pela Alibaba Cloud em 2026-11-16, é preciso observar que ele ainda não está na tabela geral e também não aparece na interface de preços da plataforma. Ele ainda não foi disponibilizado no catálogo; vamos disponibilizá-lo o mais breve possível. Modelos e preços devem ser conferidos na lista de modelos da plataforma. Antes de o modelo estar disponível, não o inclua no planejamento da allowlist de nenhum token.
Modelos de cobrança na gestão de múltiplos modelos na empresa: não misture cobrança por consumo com cobrança por requisição
A documentação recomenda “prioridade ao consumo” para modelos de texto. A cobrança por requisição tem preço fixo a cada chamada e é usada principalmente para imagem e vídeo. Se o mesmo token rodar tanto texto quanto geração de imagens, o log vai mostrar os dois tipos de registro ao mesmo tempo — cobrança por token e cobrança por requisição —, com unidades diferentes que não podem ser somadas diretamente.
O caminho mais seguro é criar tokens separados para projetos de texto e para projetos de imagem/vídeo. Modelos exclusivos como os de vídeo já exigem um grupo próprio de qualquer forma; depois da separação, tanto a configuração de grupo quanto a unidade de cobrança ficam muito mais claras.
| Forma de cobrança | Como é calculada (texto da documentação) | Uso típico | Recomendação de divisão de tokens |
|---|---|---|---|
| Por consumo | tokens de entrada × preço de entrada + tokens de saída × preço de saída | conversa de texto, código, resumos | um token dedicado ao projeto de texto; a documentação recomenda prioridade ao consumo |
| Por requisição | preço fixo por chamada | geração de imagens, vídeo | um token dedicado a imagem/vídeo, com o grupo exclusivo correspondente configurado |
Sobre a liquidação, a documentação informa que a recarga é liquidada a uma taxa de câmbio fixa de 1:7, que pode ser acumulada com os descontos de recarga; a cobrança efetiva é a que aparece no console. Processos de compra, contratos e notas fiscais estão fora do escopo deste artigo — se precisar, confirme diretamente com a plataforma.
💡 Sugestão de escolha: crie um token separado, de limite baixo, para modelos caros (como
claude-opus-5-5) e distribua só para quem realmente precisa. Já o token das tarefas em lote do dia a dia deve conter apenas modelos de preço baixo. No APIYI apiyi.com, confira a lista de modelos e verifique grupos e multiplicadores antes de distribuir — assim você evita surpresas na fatura no fim do mês.
Perguntas frequentes sobre problemas comuns na gestão multi-modelo empresarial
Q1: O que é a gestão multi-modelo empresarial com tokens divididos por projeto?
Trata-se de criar, dentro de uma única conta, uma chave API (token) independente para cada projeto ou membro, com cota, tempo de expiração, lista de modelos permitidos (whitelist) e grupo configurados em cada token. O consumo e os logs de chamadas são registrados separadamente por token, então tanto a suspensão quanto a conciliação podem ser feitas com precisão por projeto.
Q2: Se eu criar muitos tokens, a limitação de taxa vai dobrar?
Não. A documentação deixa claro que a limitação de taxa acompanha a conta e não tem relação com o número de tokens. O texto original diz que uma única conta geralmente fica sem problemas dentro de 100 RPM, e o TPM não é avaliado. Isso é apenas o que diz a documentação, não é um SLA. Dividir tokens serve para isolar a gestão, não para aumentar a cota.
Q3: Se eu configurar um grupo de fallback, então não haverá falhas?
Não. Segundo a documentação original, um token pode ter no máximo 1 grupo padrão mais 2 grupos de fallback; o fallback é acionado automaticamente quando o grupo padrão não consegue atender à requisição, e sua função é aumentar a taxa de sucesso das chamadas. Do lado do negócio, ainda é preciso manter a lógica de retry e degradação.
Q4: O que acontece se eu não definir a whitelist de modelos?
Texto original da documentação: sem definir a whitelist, o token pode usar os mais de 200 modelos selecionados do site. Isso é bastante arriscado para a gestão, pois o projeto pode acabar trocando sem querer para modelos de alto custo. Em cenários empresariais, recomenda-se colocar em cada token apenas os modelos de que o projeto realmente precisa.
Q5: Já tenho código com o SDK da OpenAI, como faço para mudar para chamadas por token de projeto?
Basta alterar dois pontos: definir `base_url` como `https://api.apiyi.com/v1` e mudar `api_key` para ler de uma variável de ambiente própria do projeto. O token é criado na página de tokens da APIYI apiyi.com; para trocar de modelo, basta alterar o parâmetro `model`.
Q6: Por que não consigo chamar certo modelo de vídeo no meu token?
Modelos exclusivos, como os de vídeo, exigem um grupo separado. Se esse grupo não estiver configurado no token, o modelo fica indisponível. Consulte na página do modelo a qual grupo ele pertence e adicione-o às configurações de grupo do token; também é possível criar um token dedicado ao negócio de vídeo.
Q7: Por que o mesmo modelo tem cobranças diferentes entre projetos?
Normalmente isso é causado pela diferença no multiplicador do grupo. Por exemplo, a página do modelo `gemini-3.8-flash` indica que o grupo Gemini_Reverse tem multiplicador de 0.5×, enquanto Default e SVIP têm 1×. Na conciliação, é preciso verificar o modelo e o grupo em conjunto, não apenas o preço de tabela.
Q8: Quais são as limitações dessa abordagem?
A divisão de tokens resolve o problema de isolamento de chaves, cotas e logs, mas não aumenta a limitação de taxa da conta nem substitui o retry e o monitoramento do lado do negócio. Os modelos recém-lançados precisam aguardar a listagem na plataforma antes de poderem ser adicionados à whitelist. Os preços e grupos específicos ficam sujeitos à lista de modelos da APIYI apiyi.com.
Pontos-chave da gestão de múltiplos modelos na empresa
- Token é a chave: começa com
sk-, crie um para cada projeto ou membro, assim fica fácil desativar individualmente - Configure as quatro restrições juntas: cota, data de expiração, lista de modelos permitidos e grupo — se faltar uma, sobra uma brecha na gestão
- O limite de taxa segue a conta: a documentação original diz que até 100 RPM em geral não há problema e que TPM não é cobrado; dividir em tokens não aumenta a cota
- Fallback não é garantia: no máximo 1 grupo padrão + 2 grupos de fallback (conforme a documentação), o papel é aumentar a taxa de sucesso
- Trocar de modelo muda a fatura: o preço unitário do modelo e o multiplicador do grupo definem juntos a cobrança real; só com conciliação por token dá para enxergar com clareza
- Texto e geração de imagens separados: as unidades diferem (por volume vs. por chamada), então gerenciar com tokens separados facilita a conciliação
- Entrada unificada: todos os projetos passam por
https://api.apiyi.com/v1, e a distinção de permissões e cobrança fica só por conta dos tokens
Resumo
A gestão de múltiplos modelos em uma empresa não precisa de uma chave mestra capaz de abrir o painel de todos os fornecedores; o que ela precisa é separar as permissões por projeto:
- Chaves separadas por projeto: um token para cada projeto ou cada pessoa; desativação e rotação não se afetam mutuamente.
- Defina tetos de cota e de modelos: use a cota para controlar o gasto total e a lista de modelos permitidos e os grupos para controlar o preço unitário.
- Conciliação dos logs por token: verifique anomalias toda semana e consolide os custos por token no fim do mês.
A sugestão é começar desenhando a tabela de planejamento de tokens conforme o primeiro passo deste artigo e depois ir criando um por um na página de tokens do APIYI apiyi.com. Ao conferir modelos, preços e grupos, use como referência a lista de modelos da plataforma — assim, em uma única implementação, você organiza com clareza a fatura de múltiplos modelos.
📚 Materiais de referência
-
Central de documentação da APIYI: tokens e grupos, modos de cobrança, tabela geral de modelos
- Link:
docs.apiyi.com - Descrição: corresponde aos caminhos
/faq/token-and-groups.md,/faq/token-billing-modes.md,/models.mde/models/gemini-3-8-flash.md; as informações de tokens, grupos e preços deste artigo têm esta documentação como referência.
- Link:
-
Especificações do Qwen4-Max no Alibaba Cloud Bailian: informações de lançamento do fabricante
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Descrição: esse modelo foi lançado pelo fabricante em 2026-11-16; o status de disponibilidade na plataforma deve ser verificado na lista de modelos.
- Link:
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para falar conosco pela página inicial do site da APIYI. Mais detalhes sobre a configuração de tokens e grupos podem ser consultados na central de documentação.