
작성자 주석: OpenAI Signals v3.0에서 공개한 165개 업무 활동 유형의 ChatGPT 사용 데이터를 해석하고, 통계 기준을 명확히 하며, 개발자와 기업의 AI 애플리케이션에 어떤 참고 가치가 있는지 분석합니다.
2026년 10월 26일, OpenAI 경제 연구팀은 《ChatGPT’s expanding world of work》(중문 공식 제목 《ChatGPT 不断拓展的工作版图》)를 발표하며, 근 100개 국가와 지역, 165개 업무 활동 유형, 연속 7개 분기에 걸친 ChatGPT 사용 데이터를 공개했어요. 이 데이터는 OpenAI Signals v3.0 계획의 일부로, CC BY 4.0 라이선스로 무료 공개되어 연구자들이 CSV를 직접 내려받아 2차 분석에 활용할 수 있어요.
이번 발표는 새로운 모델이나 신규 기능 출시가 아니에요, 연구자들을 위한 경제적 사용 데이터 세트랍니다. 공식 공지, 데이터 사전, 그리고 원본 CSV에 대한 제3자 미디어의 검증이 동시에 나왔고, 수치 기준은 서로 교차 검증이 가능해요. 이 글에서는 공식 결론과 제3자 계산을 명확히 구분해서, “메시지 비중”을 “직무 대체”로 오해하지 않도록 할게요.
핵심 가치: 몇 분 만에 OpenAI의 165개 업무 활동 데이터가 정확히 무엇을 통계화했고 무엇을 발견했는지, 그리고 AI 애플리케이션 개발자에게 어떤 실질적인 참고 의미가 있는지 파악할 수 있어요.
OpenAI 165개 업무 활동 데이터 핵심 정보 한눈에 보기
먼저 표 하나로 이번 ChatGPT 사용 데이터 공개의 기본 사실을 정리해 볼게요.
| 정보 항목 | 상세 내용 |
|---|---|
| 공개 시점 | 2026년 10월 26일 |
| 공개 주체 | OpenAI 경제 연구팀(OpenAI Signals v3.0) |
| 분류 체계 | 미국 O*NET 중간 수준 업무 활동(IWA) |
| 적용 범위 | 약 100개 국가 및 지역, 165개 업무 활동 |
| 시간 범위 | 2025년 1분기부터 2026년 3분기까지, 총 7개 분기 |
| 표본 출처 | Free, Go, Plus, Pro 개인 계정, 만 18세 이상으로 신고된 사용자 |
| 제외 범위 | ChatGPT Enterprise, Codex, 삭제된 계정, 학습에 사용이 허용되지 않은 표본 |
| 데이터 라이선스 | CC BY 4.0, 무료 열람 및 CSV 다운로드, 출처 표시 필요 |
165개 업무 활동은 165개 직업이 아니에요
OpenAI 데이터를 해석할 때 가장 자주 틀리는 지점이 바로 여기예요. O*NET은 미국 정부가 공식 지원하는 직업 정보 데이터베이스인데, 여기서는 ‘직업’을 여러 층위의 ‘업무 활동’으로 쪼개 놓았어요. 예를 들어 ‘서면 자료 편집’이라는 활동은 편집자 일에서도 나타나지만, 교사, 변호사, 엔지니어, 재무 담당자의 일상에서도 똑같이 등장하죠.
그래서 OpenAI가 집계한 것은 ‘어떤 직업의 사람들이 ChatGPT를 쓰는가’가 아니라 ‘사람들이 ChatGPT로 무엇을 하는가’예요. IWA(Intermediate Work Activities, 중간 수준 업무 활동)는 넓은 범위의 작업 행동과 아주 구체적인 태스크 사이에 위치하는 개념이고, O*NET 참조 체계에는 모두 332개 IWA 항목이 있어요.
OpenAI는 이 가운데 빈도가 높고 표본 기준을 충족하는 활동만 따로 보고했고, 저빈도 활동은 하나로 합쳤어요. PPC Land가 원본 CSV를 검증한 내용에 따르면, 공개된 표는 실제로 164개의 개별 명명 범주에 ‘Other IWA’ 통합 범주 1개를 더한, 총 165개 분류 결과예요. 따라서 OpenAI가 332개 IWA 전체를 완전히 집계했다고 말할 수는 없어요.
데이터는 어떻게 수집하고 분류했을까
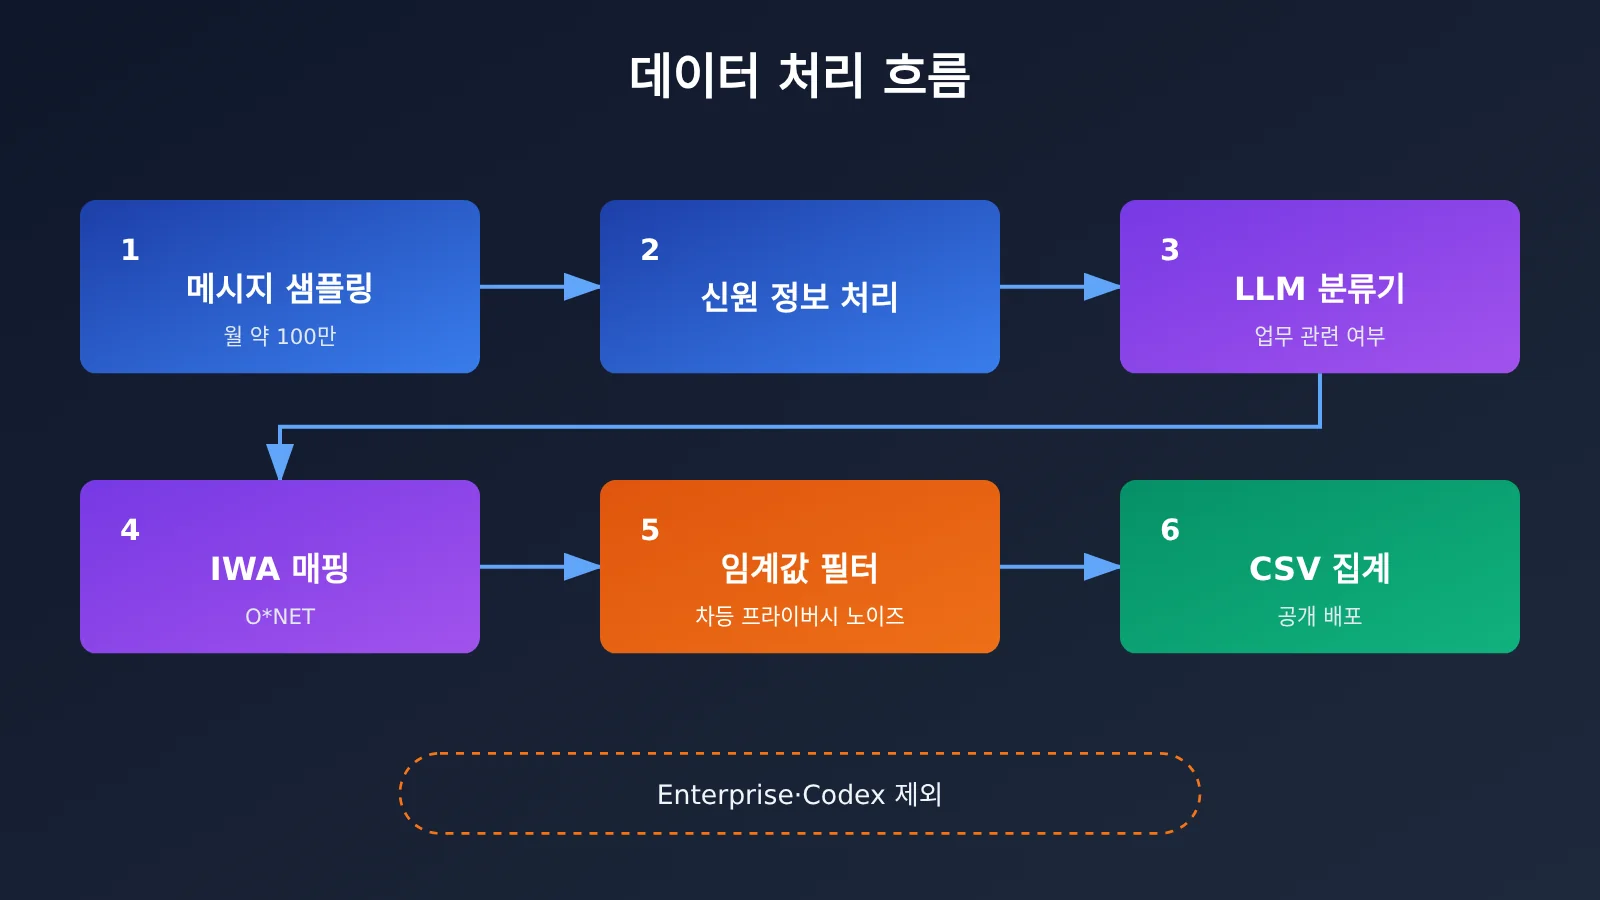
Signals v3.0은 매달 약 100만 건의 ChatGPT 메시지를 표본으로 뽑고, 전체 기간은 2024년 7월부터 2026년 9월까지 27개월로 약 2,700만 건의 분류 표본을 아우른다고 해요. 여기서 짚어 둘 점은 2,700만 건이 각 달의 표본 수를 단순 합산한 값이라는 거예요. 독립 사용자 수와 같지도 않고, 그 전부가 업무 관련 메시지라는 뜻도 아니에요.
분류는 자동화된 언어 모델 분류기가 맡아요. 먼저 메시지가 업무와 관련 있는지 판단하고, 그다음 O*NET 업무 활동에 매핑하면서 주제, 의도, 시간, 지역 같은 차원을 함께 태깅하죠. 프라이버시 측면에서 OpenAI는 연구자가 원본 대화를 직접 읽지 않는다고 밝혔어요. 분류 전에 신원 정보를 처리하고, 집계 결과만 공개하며, 소규모 표본은 가리고 차등 프라이버시 노이즈를 더해요. 국가별·분기별 업무 활동 분포는 유효 메시지가 최소 1,000건 이상일 때만 공개된다는 조건도 붙어요.
ChatGPT 사용 데이터의 핵심 발견: 업무 용도가 더 분산되고 있어요
OpenAI가 공식적으로 내놓은 핵심 결론은 개인 사용자가 ChatGPT로 처리하는 업무 유형이 점점 더 다양해지고 있다는 거예요. 7개 분기 모두 완전한 기록이 있는 74개 국가와 지역에서, 각국에서 가장 흔한 상위 10개 업무 활동이 해당 국가의 분류된 업무 메시지에서 차지하는 평균 비중이 눈에 띄게 줄었어요.
| 시기 | 각국 상위 10개 업무 활동 평균 비중 |
|---|---|
| 2025년 1분기 | 56.0% |
| 2026년 3분기 | 51.1% |
| 변화 | -4.9%p |
여기서 두 가지 기준을 분명히 짚어야 해요. 첫째, 51.1%는 전 세계 공통 상위 10개 목록의 비중이 아니라, 각 국가의 상위 10개를 먼저 계산한 뒤 74개국 평균을 낸 값이에요. 국가별 상위 10개 항목은 서로 다를 수 있어요. 둘째, 비중이 줄었다고 해서 메시지 수가 줄었다는 뜻은 아니에요. 전체 사용량이 늘고 있다면 상위 활동의 절대 요청 수는 오히려 증가할 수 있어요.
다시 말해, 더 많은 ‘롱테일’ 업무 활동이 더 큰 몫을 가져간 거예요. 이 74개국과 약 100개국은 서로 다른 표본 범위이므로, 인용할 때 둘을 혼용해서는 안 돼요.
어떤 구체적인 업무 활동이 가장 흔할까요
PPC Land는 2026년 10월 27일 전체 공개 CSV를 바탕으로 독립 계산을 했고, 74개국을 각각 집계한 뒤 평균을 냈어요. 아래는 2026년 3분기에 가장 흔했던 여섯 가지 명시적 업무 활동이에요(제3자 계산이며, OpenAI 공지에 직접 나열된 내용은 아니에요).
| 순위 | 업무 활동 | 74개국 평균 메시지 비중 |
|---|---|---|
| 1 | 서면 자료 또는 문서 편집 | 15.0% |
| 2 | 시각 디자인 또는 프레젠테이션 콘텐츠 제작 | 7.9% |
| 3 | 마케팅 또는 홍보 자료 개발 | 5.1% |
| 4 | 언어 또는 문화 정보 설명 | 4.0% |
| 5 | 정보 또는 교육 자료 준비 | 3.2% |
| 6 | 컴퓨터 시스템 또는 생산 설비 프로그래밍 | 3.1% |
문서 편집은 여전히 가장 보편적인 업무 용도이고, 시각 디자인은 2위로 올라섰어요. 마케팅 콘텐츠, 교육 자료, 언어 간 이해에 대한 수요도 뚜렷해요. 프로그래밍은 중요하지만, 이 개인 계정 표본에서는 가장 큰 비중을 차지하지는 않았어요.
시각 디자인 비중은 오르고, 프로그래밍 비중은 내려갔어요
PPC Land의 계산에 따르면, “시각 디자인 또는 프레젠테이션 콘텐츠 제작”의 74개국 평균 비중은 2025년 1분기 3.1%에서 2026년 3분기 7.9%로 올라 4.8%포인트 증가했어요. 165개 카테고리 가운데 증가 폭이 가장 큰 구체적 활동이에요. 같은 기간 미국은 2.4%에서 7.6%로 올랐고, 2026년 3분기 기준 브라질은 11.2%, 인도는 8.7%를 기록했어요.
반대로 “컴퓨터 시스템 또는 생산 장비 프로그래밍”은 7.8%에서 3.1%로 떨어졌어요. 미국은 6.7%에서 2.4%로 줄었고, 인도는 2026년 3분기에도 5.8%를 유지했어요. 컴퓨터 문제 해결, 기술 설계 연구 같은 관련 활동도 함께 감소했어요. 개발자들이 Codex 같은 전용 프로그래밍 에이전트로 옮겨 갔다는 가설은 그럴듯하지만, 데이터 자체가 그런 이동을 증명하지는 않아요. 더 신중하게 표현하자면 이렇습니다. Codex와 기업 계정을 제외한 이 데이터에서 프로그래밍 관련 업무 메시지의 비중이 뚜렷하게 줄었다, 정도로 말하는 게 안전해요.
마케팅은 또 하나 주목할 만한 신호예요. “마케팅 또는 프로모션 자료 제작”의 평균 비중은 5.2%에서 5.1%로 거의 그대로였어요. 아르헨티나, 파키스탄, 나이지리아 등은 2026년 3분기에 9% 안팎까지 올라갔고요. 일반 글쓰기 비중은 줄고 있지만, 마케팅 특화 콘텐츠 수요는 여전히 탄탄하다는 뜻이에요.
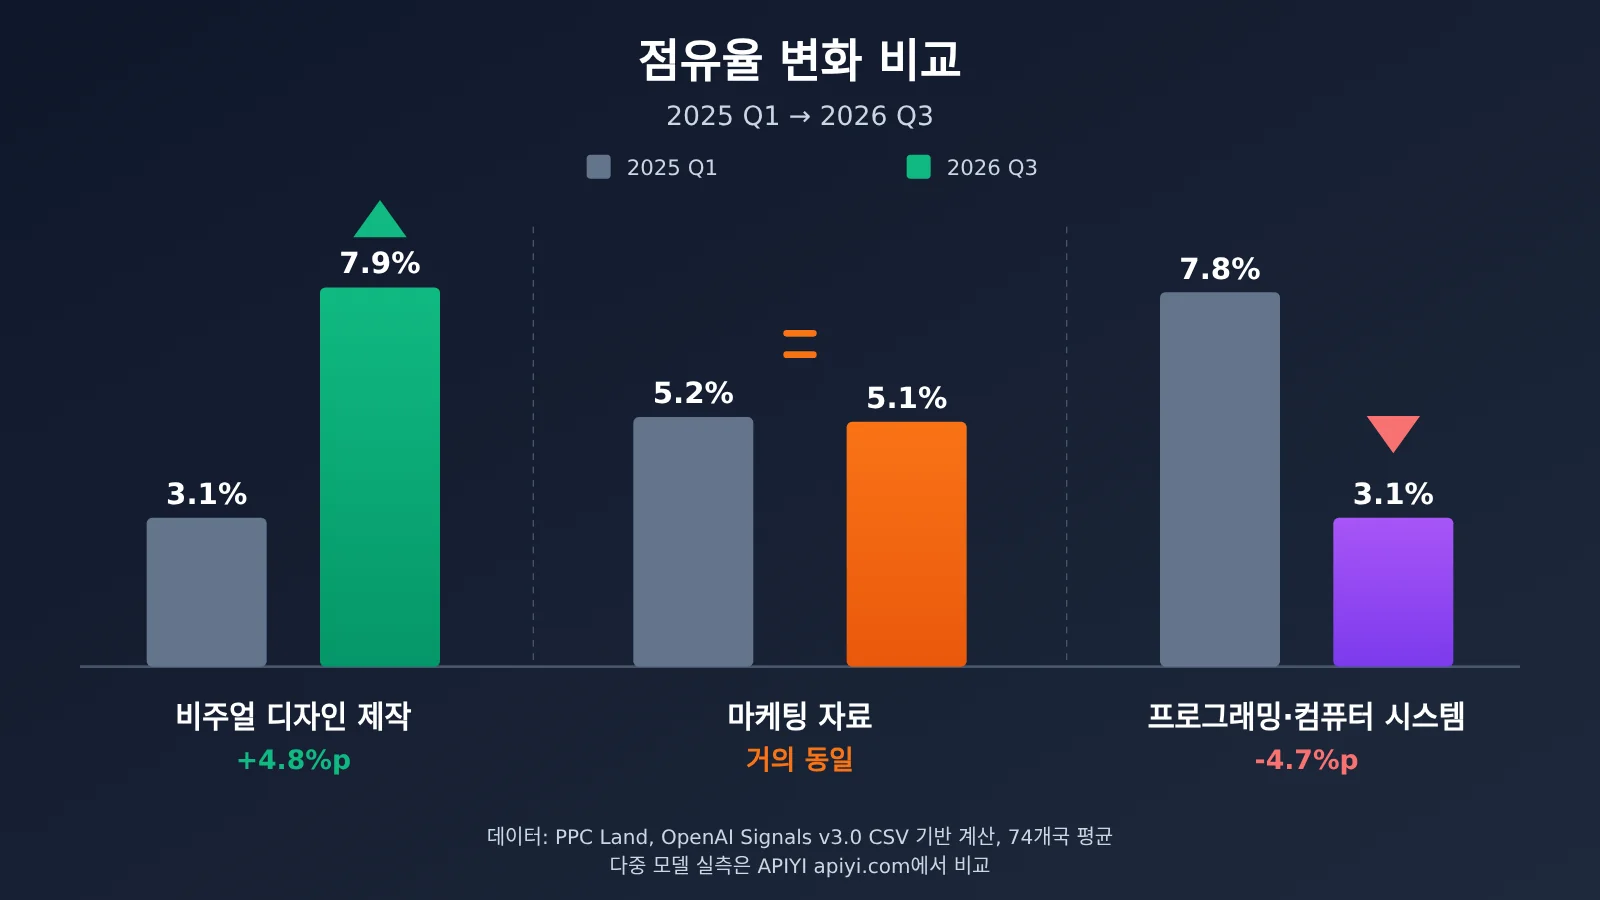
📊 차트 설명: 위 차트의 데이터는 PPC Land가 OpenAI 공개 CSV를 다시 계산한 결과예요. 여러분의 업무에서 “디자인형, 카피형, 프로그래밍형” 요청이 각각 어떤 모델에 더 잘 맞는지 확인하고 싶다면, APIYI apiyi.com에서 하나의 API 키로 OpenAI, Claude, Gemini 등 모델을 바꿔가며 소규모 비교 테스트를 해볼 수 있어요.
미국과 독일의 ChatGPT 업무 구조 비교
PPC Land는 또한 OpenAI 인터랙티브 차트에서 더 넓은 범위의 Generalized Work Activities를 항목별로 읽어냈어요(위의 IWA와는 같은 계층이 아니므로 혼용해서 배열하면 안 됩니다). 통계 기준은 각국 업무 관련 메시지의 비중이에요:
| 광범위한 업무 활동 | 미국 Q1 2025 | 미국 Q1 2026 | 독일 Q1 2025 | 독일 Q1 2026 |
|---|---|---|---|---|
| 의사 결정과 문제 해결 | 22.8% | 21.6% | 22.0% | 19.4% |
| 창의적 사고 | 11.8% | 15.6% | 11.3% | 13.1% |
| 정보 기록 | 10.6% | 11.8% | 10.3% | 11.4% |
| 컴퓨터 사용 | 11.7% | 6.7% | 12.7% | 8.4% |
| 상담과 조언 제공 | 5.5% | 9.0% | 7.1% | 11.7% |
| 타인을 위한 정보 설명 | 5.1% | 4.0% | 9.5% | 8.6% |
두 나라 모두 “의사 결정과 문제 해결”이 중요한 용도로 나타났고, “창의적 사고”와 “상담 및 조언”의 비중이 뚜렷하게 상승했어요. 이는 사용자 요청 유형을 설명하는 것이지, ChatGPT가 이미 독립적으로 비즈니스 의사 결정을 내렸다거나 검증된 전문가급 상담을 제공했다는 뜻은 아니에요.
국가 간 비교에서는 PPC Land가 읽어낸 초국가 분포 차이 지표(총 변동 거리)가 약 22.2%에서 약 23.0%로 소폭 상승했어요. OpenAI도 이러한 차이가 업무 구조, 언어와 문화, 도구 가용성, 사용 습관에서 비롯될 수 있다고 인정했으며, 이번 데이터만으로는 인과 관계를 증명하기에 충분하지 않다고 밝혔어요.
165개 업무 활동 데이터가 개발자에게 미치는 영향 분석
AI 애플리케이션 개발자에게 미치는 영향
- 수요가 넓어지고 있어요: 사용자들은 이제 ChatGPT로 문서만 수정하지 않아요. 시각 디자인, 마케팅, 교육 자료, 컨설팅 제안 같은 분야도 상당한 비중을 차지하고 있어서, 단일 기능 AI 도구라도 멀티태스킹 시나리오를 고려해야 해요.
- 멀티모달이 더 중요해졌어요: 시각 디자인은 증가폭이 가장 큰 활동이고, 같은 기간 전체 개인 메시지에서 ‘멀티미디어’ 주제도 2.0%에서 8.8%로 올랐어요(PPC Land 계산 기준). 이미지 역량을 제품 기획에 포함할 만한 이유예요.
- 코딩 시나리오는 전문화되고 있어요: 범용 채팅에서 코딩 메시지 비중은 줄고 있지만, 개발 관련 수요는 전용 에이전트나 기업 환경에서 더 많이 발생할 가능성이 커요. 전용 코드 모델과 워크플로우로 대응하기에 적합한 상황이에요.
- 재사용 가능한 분류 방법: OpenAI는 LLM 분류기로 메시지를 표준 작업 체계에 매핑했어요. 이 접근법은 여러분의 제품 로그 분석에도 그대로 활용할 수 있어요.
기업 AI 도입에 미치는 영향
개인 계정 데이터가 기업 사용을 대변할 수는 없어요. OpenAI의 또 다른 Enterprise Signals 데이터에 따르면, 2026년 6월 기준으로 분석된 기업 고객 가운데 Codex가 ChatGPT와 Codex 합산 출력 토큰의 64%를 차지했어요. 이는 기업 측 사용 구조가 개인 계정과 크게 다를 수 있다는 걸 보여줘요. 따라서 내부 AI 방안을 평가할 때는 Signals의 개인 데이터를 그대로 적용하기보다 자사의 작업 로그를 기반으로 삼아야 해요.
🚀 빠른 시작: OpenAI처럼 자사 비즈니스 요청에 ‘업무 활동’ 라벨을 붙이고 싶다면 APIYI apiyi.com을 통해 빠르게 프로토타입을 구축해 보세요. 플랫폼은 OpenAI 호환 인터페이스를 제공하며, 신규 사용자는 무료 테스트 크레딧을 받을 수 있어 몇 분 만에 아래 예제를 실행해 볼 수 있어요.
API로 ‘업무 활동 분류’ 사고방식 재현하기
아래는 대규모 언어 모델을 이용해 사용자 요청 한 건을 소수의 업무 활동 라벨로 분류하는 아주 간단한 예제예요. 원리는 OpenAI의 분류기와 동일해요(라벨은 단순화한 예시이며, O*NET 전체 체계는 아니에요).
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

labels = "문서 편집, 시각 디자인, 마케팅 홍보, 언어 해설, 교육 자료, 프로그래밍, 의사결정 분석, 기타"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"다음 업무 요청을 설명하는 라벨을 [{labels}] 중에서 하나 골라줘. 라벨만 출력해: 신제품 출시 웨이신 푸시 글 좀 작성해줘"}]
)
print(resp.choices[0].message.content)
배치 분류와 비중 통계의 전체 코드 보기
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 하나의 Key로 여러 모델 전환 가능
)

LABELS = ["문서 편집", "시각 디자인", "마케팅 홍보", "언어 해설",
          "교육 자료", "프로그래밍", "의사결정 분석", "비업무", "기타"]

SYSTEM = (
    "너는 업무 활동 분류기야. 먼저 요청이 업무와 관련 있는지 판단하고, "
    f"그다음 다음 라벨 중 하나를 골라: {', '.join(LABELS)}. 라벨 자체만 출력해."
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "기타"
    except Exception as e:
        print(f"Error: {e}")
        return "기타"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "비업무"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "이번 분기 보고서 좀 다듬어줘",
        "이벤트 포스터 세트의 구도 제안 좀 해줘",
        "이 Python 코드는 왜 데이터를 못 읽어?",
        "주말에 어디로 캠핑 가면 좋을까",
    ]
    print(activity_share(logs))
OpenAI의 방법과 마찬가지로 이런 자동 분류에는 오분류가 있을 수 있고, 하나의 작업이 여러 메시지로 쪼개질 수도 있어요. 그래서 집계된 ‘메시지 비중’이 곧 작업량이나 비즈니스 가치와 같다고 보기는 어려워요.
다양한 업무 활동별 모델 선택 참고
데이터에서 비중이 높은 활동을 결합해 작업 유형별로 초기 선택을 할 수 있어요. 구체적인 효과는 여전히 자신의 데이터에서 직접 테스트해야 합니다:
| 업무 활동 | 역량 중점 | 선택 기준 | 사용 가능한 플랫폼 |
|---|---|---|---|
| 문서 편집 | 텍스트 이해 및 재작성 | 가성비 높은 범용 대화 모델 | APIYI apiyi.com, 공식 API |
| 시각 디자인 및 프레젠테이션 | 이미지 생성 및 이해 | 멀티모달 / 이미지 모델 | APIYI apiyi.com, 공식 API |
| 마케팅 홍보 자료 | 창의성 및 스타일 제어 | 글쓰기 스타일이 안정적인 플래그십 모델 | APIYI apiyi.com, 공식 API |
| 프로그래밍 및 디버깅 | 코드 추론 | 코드 능력이 강한 모델 또는 전용 에이전트 | APIYI apiyi.com, 공식 API |
| 의사결정 및 컨설팅 | 장문 컨텍스트 추론 | 추론형 모델, 사람의 검토 병행 | APIYI apiyi.com, 공식 API |
OpenAI 165개 업무 활동 데이터의 한계
이 데이터는 매우 가치 있지만 경계도 명확해요. 인용할 때 가장 주의해야 할 점은 다음과 같습니다:
- 샘플은 성인 개인 계정만 포함: Enterprise와 Codex를 제외했기 때문에 OpenAI 기업 제품의 전체 업무 활용을 대표할 수 없어요.
- 분류는 자동으로 이루어짐: LLM 분류기가 의도를 잘못 읽을 수 있어요. 예를 들어 “행사 홍보方案 디자인”은 실제 마케팅 업무일 수도 있고 개인 취미일 수도 있죠.
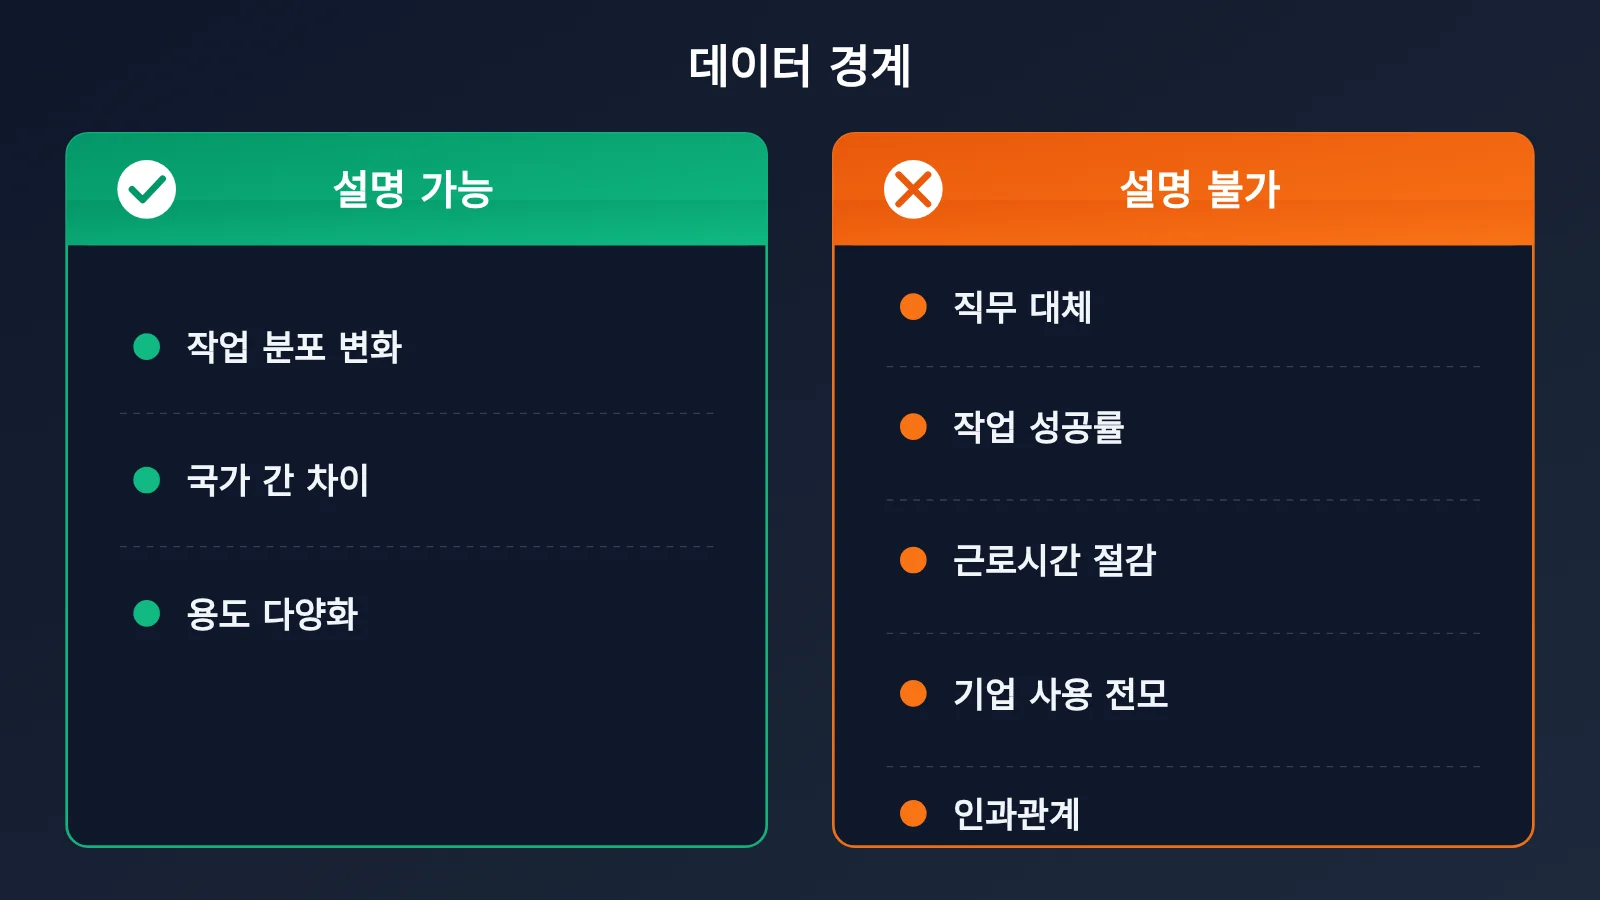
- 메시지 비중은 생산량과 다름: 작업 수, 근무 시간, 사용자 수, 절감된 시간, 성공률을 의미하지 않아요.
- 프라이버시 노이즈와 샘플 임계값 존재: 소규모 샘플 결과는 숨겨지고 차분 프라이버시 노이즈가 추가되었어요.
- 실제 경제와 일대일 대응 아님: 취업자 수로 가중하면 미국의 약 43% 실제 업무 활동이 “Other IWA” 카테고리에 속해요. 이는 43%의 업무가 AI로 완료될 수 없다는 뜻도 아니고, 나머지 57%가 이미 ChatGPT로 커버되었다는 뜻도 아니에요.
또한 PPC Land의 계산에 따르면 전체 개인 메시지 중 업무 관련으로 분류된 비율이 2024년 7월 약 51.6%에서 2026년 9월 약 32.2%로 감소했어요. 이는 비업무 사용자가 대거 유입되고 일부 전문 업무가 기업 계정과 전용 Agent로 이동한 결과일 가능성이 높아요. 이를 근거로 ChatGPT가 직장에서 덜 중요해졌다고 판단할 수는 없어요.
자주 묻는 질문 FAQ
Q1: OpenAI가 공개한 165개 작업 활동 데이터는 무엇인가요?
OpenAI Signals v3.0 계획에서 공개한 집계 데이터 세트로, 개인 ChatGPT 사용자의 업무 관련 메시지를 O*NET의 165개 중간 계층 작업 활동에 매핑한 것이에요. 약 100개 국가 및 지역, 2025년 1분기부터 2026년 3분기까지 총 7개 분기를 포괄하며, CSV 파일로 무료 다운로드할 수 있어요.
Q2: 165개 작업 활동과 165개 직업은 어떻게 다른가요?
작업 활동은 “무슨 일을 하는가”이고, 직업은 “어떤 직책인가”예요. 같은 활동(예: 문서 편집)이 여러 직업에 등장할 수 있기 때문에, 이 데이터는 ChatGPT가 어떤 유형의 업무를 수행하는 데 쓰이는지를 설명하는 것이지 각 직업의 사용률을 보여주는 게 아니에요. 어떤 직업이 대체될지 추론하는 것은 더더욱 무리한 해석이에요.
Q3: 이 데이터는 언제 공개됐고, 앞으로 업데이트되나요?
OpenAI는 2026년 10월 26일에 공개했고, 데이터는 2026년 3분기까지 포함해요. 공식적으로 분기 단위로 변화를 추적하며, 이후 계속 업데이트될지는 OpenAI Signals 데이터 페이지의 공지로 확인해야 해요. 이 글에서는 추측하지 않겠습니다.
Q4: 프로그래밍 관련 메시지 비중이 줄었다면, AI 코딩 수요가 줄고 있다는 뜻인가요?
그렇게 단정할 수는 없어요. 이 데이터는 Codex와 기업 계정을 제외하고 있는데, Enterprise Signals에서는 기업 측 Codex의 출력 토큰 비중이 상당히 높게 나타나요. 코딩 수요가 전용 에이전트로 옮겨갔을 수도 있고, 사용자 구성 변화와 관련됐을 수도 있는데, 데이터 자체만으로는 구분할 수 없어요.
Q5: API로 비슷한 작업 활동 분류 분석을 재현하려면 어떻게 하나요?
이 글의 예시 코드를 참고해서 대규모 언어 모델로 여러분의 사용자 요청에 라벨을 붙이고, 다시 비중을 집계하면 돼요:
1. APIYI apiyi.com에 접속해 계정을 등록하고 API 키를 발급받아요
2. 신규 사용자 무료 테스트 크레딧을 받아요
3. 코드의 base_url을 `https://api.apiyi.com/v1`로 설정하면 여러 모델을 전환하며 분류 성능을 비교할 수 있어요
Q6: 디자인, 카피라이팅, 코딩 작업에서 여러 모델의 성능을 비교하는 간단한 방법이 있나요?
가장 간편한 방법은 통합 인터페이스로 여러 모델을 호출하고, 같은 프롬프트 세트를 한 번씩 돌린 뒤 직접 평가하는 거예요. APIYI apiyi.com을 통하면 키 하나로 OpenAI, Claude, Gemini 등의 모델을 호출할 수 있고 사용량 기반으로 과금되니, 이런 소규모 비교 실험에 딱 맞아요.
OpenAI 165개 업무 활동 데이터 핵심 요약
- 통계 대상은 직업이 아니라 활동이에요: 165개 범주는 O*NET 업무 활동을 가리키며, ‘기타’ 통합 범주 1개를 포함해요.
- 용도가 더 분산되고 있어요: 74개국 상위 10개 활동의 평균 비중이 56.0%에서 51.1%로 낮아졌어요.
- 시각 디자인 증가 폭이 가장 커요: 제3자 계산에 따르면 3.1%에서 7.9%로 올랐어요.
- 프로그래밍 비중은 줄었지만 신중하게 해석해야 해요: 표본에서 Codex와 기업 계정을 제외했기 때문이에요.
- 마케팅 수요는 안정적이에요: 마케팅·홍보 자료 비중은 대체로 5% 안팎을 유지했어요.
- 메시지 비중은 산출량과 같지 않아요: 직무 대체, 근무 시간 절감, 성공률로 이어졌다고 추론할 수는 없어요.
- 분류 방법은 재사용할 수 있어요: APIYI apiyi.com의 멀티모델 인터페이스를 활용하면 나만의 작업 분류 분석을 빠르게 만들 수 있어요.
정리
OpenAI 165개 업무 활동 ChatGPT 사용 데이터의 핵심 정보는 다음과 같아요.
- 데이터 성격: 무료로 공개되고 분기별로 추적되는 연구 데이터예요. 개인 계정에서 ‘ChatGPT로 어떤 업무 활동을 하는지’를 집계해요.
- 주요 발견: 업무 용도가 더 분산되고 있어요. 시각 디자인, 컨설팅·조언, 창의적 사고는 늘었고 일반 프로그래밍 메시지 비중은 줄었어요.
- 해석의 경계: 데이터에 기업 계정과 Codex가 포함되지 않아요. 메시지 비중은 업무량, 직무 영향, 경제적 가치와 동일하게 볼 수 없어요.
이 데이터가 진짜 보여주는 것은 어떤 165개 직업이 곧 사라질지가 아니라, AI가 더 세밀하고 다양한 방식으로 서로 다른 업무 흐름에 들어가고 있으며 국가와 작업 유형에 따라 양상이 달라진다는 점이에요. 개발자라면 ‘AI가 누구를 대체할까’를 캐묻기보다 사용자가 실제로 AI로 어떤 활동을 완수하는지 살펴보고, 그 활동에 맞는 모델과 워크플로를 고르는 편이 좋아요.
APIYI apiyi.com을 통해 다양한 모델이 내 비즈니스 시나리오에서 어떤 성과를 내는지 빠르게 검증해 보세요. 플랫폼은 무료 테스트 크레딧과 멀티모델 통합 인터페이스를 제공해요.
📚 참고 자료
- OpenAI 공식 발표: ChatGPT’s expanding world of work: 이번 발표의 핵심 출처
- 링크:
openai.com/index/chatgpt-expanding-world-of-work -
설명: 165개 활동 유형, 약 100개국, 56.0%에서 51.1%로의 변화 등 공식 결론
-
OpenAI Signals 데이터 다운로드 및 방법론 안내: 원본 CSV와 데이터 사전 입구
- 링크:
openai.com/signals/data-download -
설명: 표본 범위, 개인정보 처리, CC BY 4.0 라이선스 안내
-
PPC Land: Writing drops from 34% to 21% of ChatGPT requests since July 2024: 서드파티 CSV 분석
- 링크:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
설명: 구체적인 활동 순위, 시각 디자인과 프로그래밍 비중 변화
-
PPC Land: Americans use ChatGPT at work most to make decisions: 미국·독일 상호작용 차트 해석
- 링크:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
설명: 광범위한 업무 활동의 국가별 비교 데이터
-
O*NET 공식 웹사이트: 업무 활동 및 직업 분류 체계
- 링크:
onetcenter.org -
설명: IWA 정의와 332개 참조 항목 이해
-
OpenAI Enterprise Signals: 기업 계정 사용 데이터
- 링크:
openai.com/signals/enterprise-data - 설명: 개인 데이터와 기업 데이터 기준을 구분하는 데 활용
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈페이지에서 저희에게 연락 주시면 됩니다. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.




