작성자 주: 환경 점검부터 스킬 선택, 설치, 의존성 보완, 호출 테스트까지 K-Dense-AI의 177개 연구용 Agent Skills를 단계별로 살펴봐요. 문제 해결 방법과 위험 요소도 따로 짚어볼게요.
K-Dense-AI가 오픈소스로 공개한 Scientific Agent Skills는 Claude Code, Cursor 같은 코딩 에이전트를 위한 연구용 스킬 패키지예요. 총 177개 스킬에 단일 세포 분석, 화학정보학, 문헌 리뷰, 데이터베이스 검색 등의 절차가 에이전트가 이해할 수 있는 매뉴얼로 담겨 있어요. 매번 QC 절차를 처음부터 작성하거나 API 문서를 뒤지고 DOI를 확인할 필요가 없죠. 다만 한꺼번에 전부 설치하는 건 권장하지 않아요. 스킬을 통해 에이전트가 코드를 실행하고, 패키지를 설치하고, 인터넷에 접속할 수 있기 때문이에요. 스킬 파일을 설치해도 Python 의존성이 함께 설치되지는 않고요.
이 글은 “설치만 하면 만능”이라는 홍보 글이 아니에요. 5단계를 따라가며 각 단계의 결과를 확인할 수 있는 도입 가이드예요.
이 글에서 얻을 수 있는 것: 자신의 연구 분야에 필요한 스킬 5~10개를 골라 올바른 디렉터리에 설치하고 의존성을 갖춘 뒤, 에이전트가 실제로 스킬을 호출하게 할 수 있어요. 결과물과 수치도 하나씩 검증할 수 있고요.
연구용 스킬 177개에는 무엇이 들어 있을까?
저장소 주소는 K-Dense-AI/scientific-agent-skills이며, MIT 라이선스를 사용해요. 2026년 10월 28일 기준 스타 54,959개, 포크 4,846개를 기록했고, 현재 버전은 2.72.0이에요. skills/ 디렉터리에는 하위 디렉터리 177개가 있어요. README의 “과학자 250,000명 이상 사용”, “과학 분야 1위 에이전트 스킬 라이브러리”라는 문구는 모두 저장소 측이 자체적으로 밝힌 수치이며, 제3자 통계는 아니에요. 관련 논문은 arXiv:2609.00065예요.
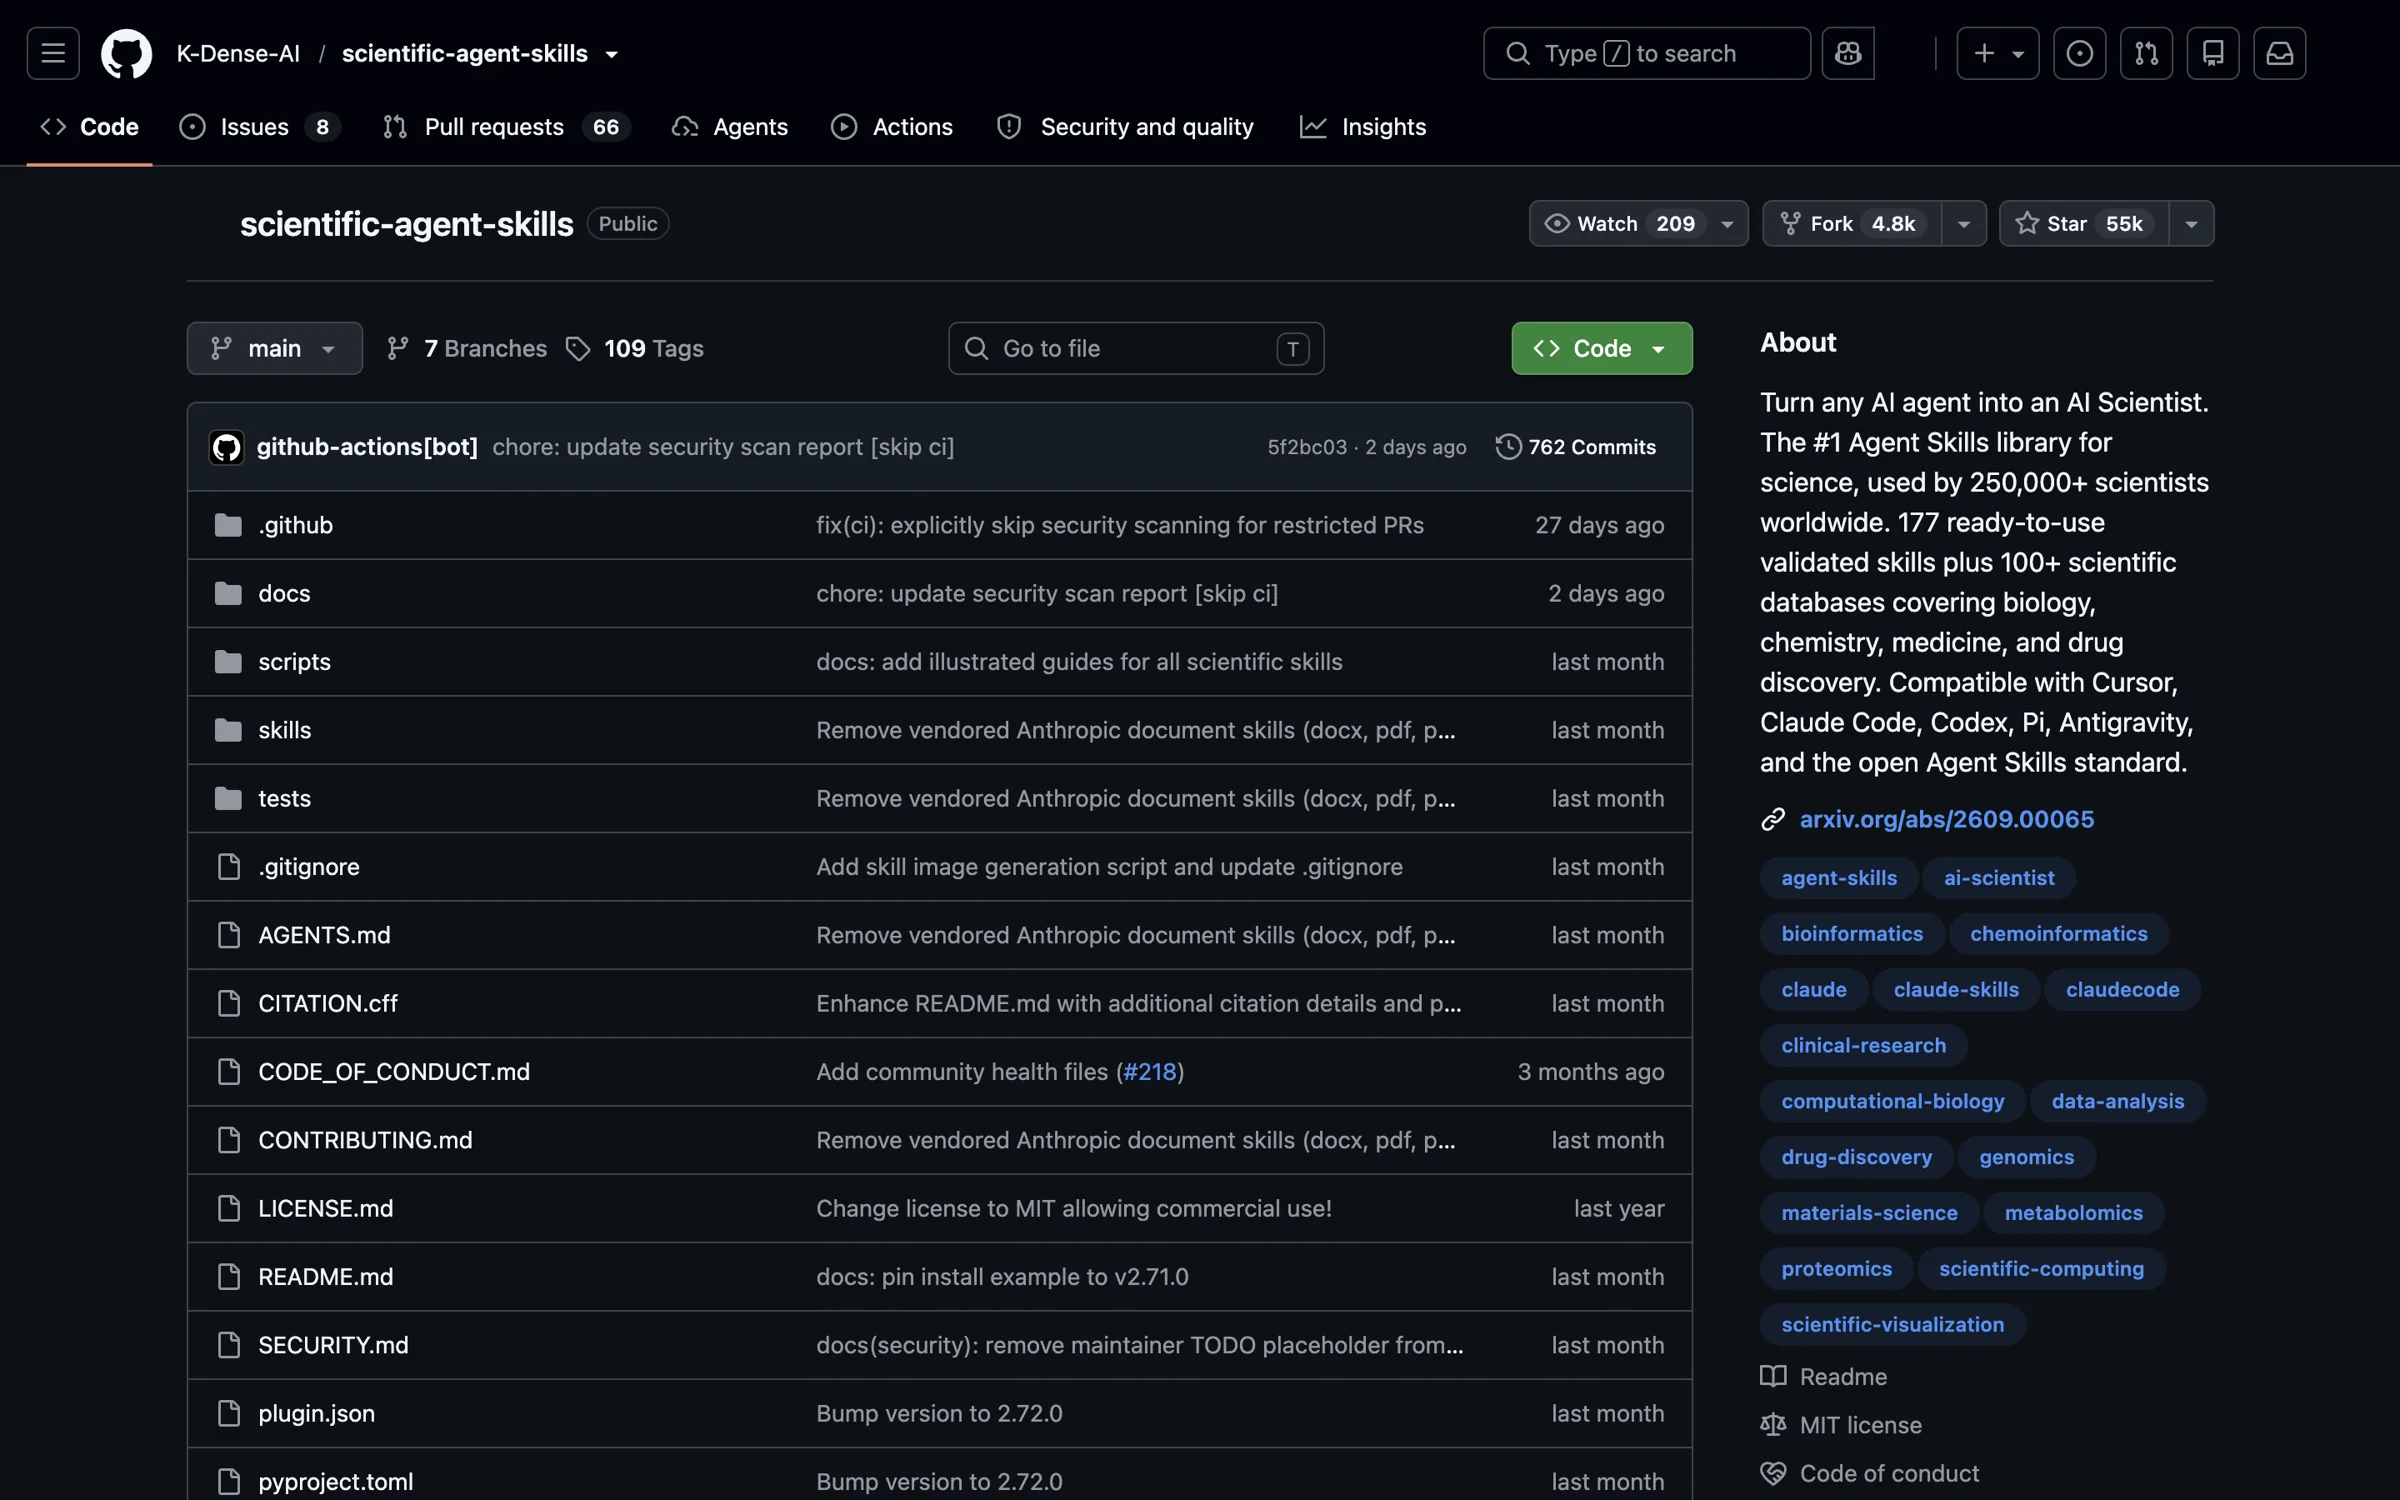
그림 1: 저장소 홈 화면(2026년 10월 28일 캡처). 스타 55k, 포크 4.8k이며 About 항목에 스킬 177개와 데이터베이스 100개 이상이 명시되어 있어요.
왜 177개일까요? 2.71.0 버전에는 스킬이 181개 있었어요. 2.72.0부터 docx, pdf, pptx, xlsx 등 문서 관련 스킬 4개가 저장소에서 빠졌기 때문이에요. 필요하다면 Anthropic 저장소에서 별도로 설치해야 해요.
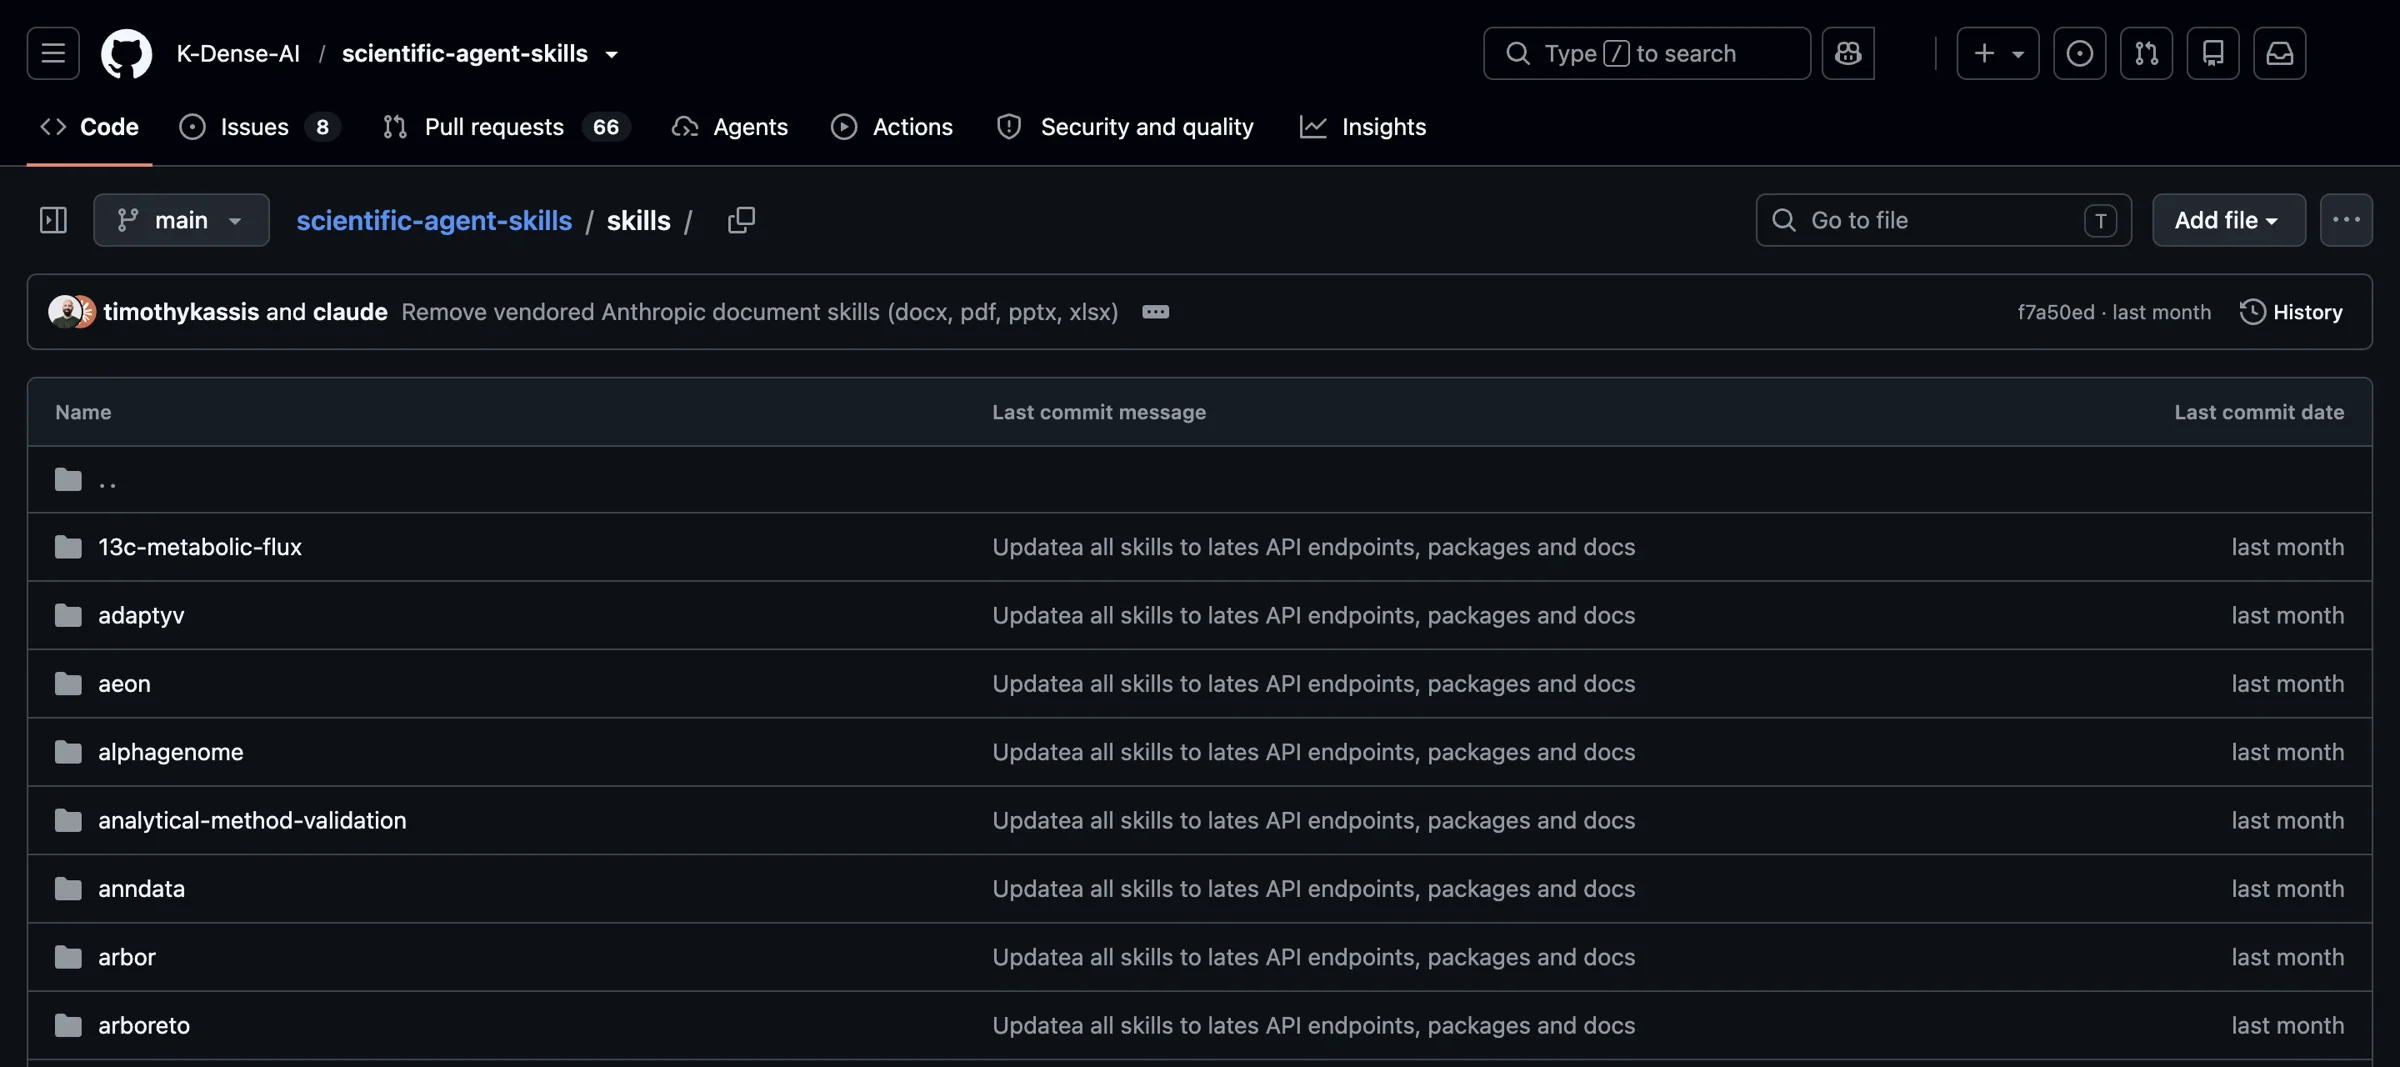
그림 2: skills/ 디렉터리에는 한 화면에 수십 개의 스킬 폴더가 보여요. 가장 최근 커밋의 설명인 “Remove vendored Anthropic document skills”가 스킬 수를 181개에서 177개로 줄인 변경 사항이에요.
README는 전체 스킬을 22개 대분류로 나눠요. 아래 표에서는 이를 분야별로 묶어 대표적인 스킬과 패키지만 소개해요.
| 분야(README 대분류) | 대표 스킬 / 패키지 | 주요 용도 |
|---|---|---|
| 생물정보학, 멀티오믹스, 단백질체학 및 질량분석 | scanpy, pydeseq2, pyopenms, nextflow, scVelo 등 패키지 스킬 |
단일세포 품질 관리와 클러스터링, 차등 발현 분석, 질량분석 데이터 처리, 워크플로 오케스트레이션 |
| 화학정보학과 신약 개발, 재료과학 | rdkit, pymatgen |
분자 필터링과 기술자 계산, 결정 구조 및 재료 계산 |
| 물리학과 천문학, 공학과 시뮬레이션 | qiskit, QuTiP 등 패키지 스킬 |
양자 회로, 양자 시스템 시뮬레이션 |
| 임상 연구, 의료 AI, 규제와 표준 | clinical-reports, pydicom 등 패키지 스킬 |
임상 보고서 초안 작성, 의료 영상 읽기 |
| 데이터 분석과 시각화, 머신러닝, 지리공간 | scientific-visualization, timesfm-forecasting, scikit-learn, PyTorch Lightning, GeoPandas 등 패키지 스킬 |
출판 수준의 차트, 시계열 예측, 모델링, 공간 데이터 분석 |
| 과학 커뮤니케이션, 연구 방법론 | literature-review, scientific-writing, paper-lookup, paperzilla, scientific-slides, research-grants, peer-review, generate-image |
체계적 문헌고찰, 논문 작성, 연구실 미팅 슬라이드, 연구비 신청, 심사 의견 작성 |
| 데이터베이스 검색 | database-lookup, DepMap, Imaging Data Commons, PrimeKG, NCATS ARAX, AlphaGenome 등 전용 스킬 |
공개·등록·인가 기반 데이터 소스 통합 조회 |
이 가운데 database-lookup 스킬 하나에만 데이터 소스 80개가 정리되어 있어요. 전용 스킬과 여러 데이터베이스를 다루는 패키지까지 합쳐 README에서는 데이터베이스 100개 이상을 지원한다고 설명해요. Python 패키지 관련 스킬도 70개가 넘어요. RDKit, Scanpy, scikit-learn, PyTorch Lightning, pydicom, QuTiP, GeoPandas, pymatgen, Qiskit, scVelo, TimesFM 등이 포함되며, 각 스킬에는 지원하는 패키지 버전과 사용법이 명시되어 있어요.
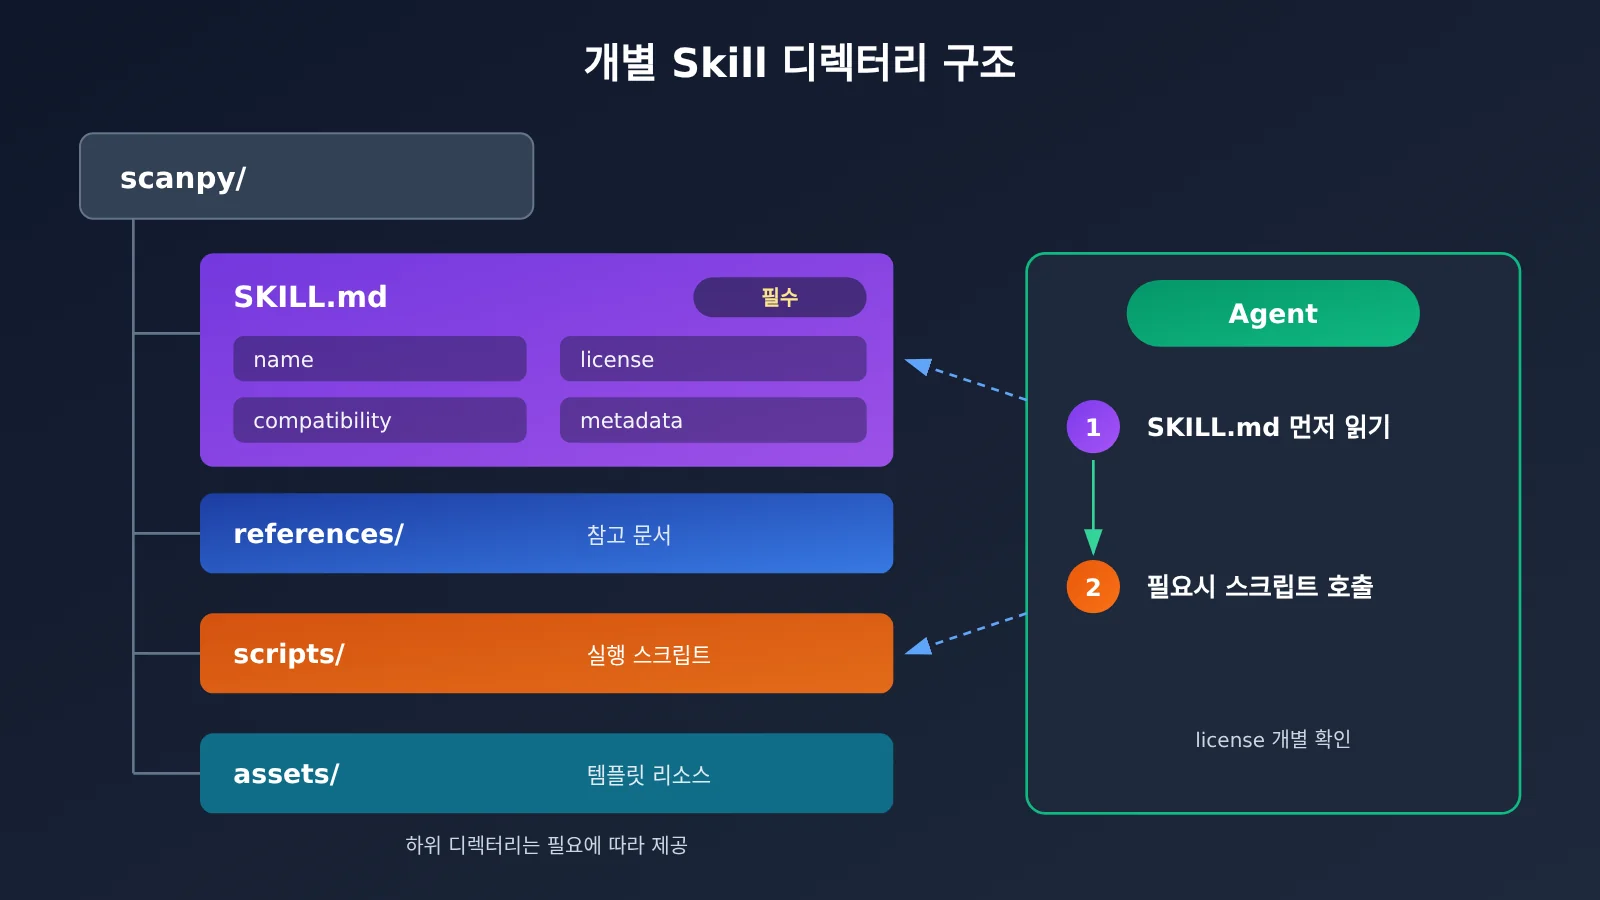
연구용 Skills의 개별 스킬 디렉터리 구조
각 스킬은 하나의 폴더로 구성돼요. SKILL.md는 반드시 있어야 하고, references/, scripts/, assets/는 필요에 따라 제공돼요. 예를 들어 scanpy의 frontmatter에는 license가 BSD-3-Clause, Python 버전이 3.12+, metadata.version이 1.8, last-reviewed가 2026-10-01로 명시돼 있어요.
놓치기 쉬운 점이 하나 있어요. 저장소 전체의 라이선스는 MIT지만, 각 스킬의 SKILL.md에 있는 license 필드에는 해당 스킬의 라이선스가 명시돼 있어 저장소 라이선스와 다를 수 있어요. 상업적으로 이용하거나 재배포할 계획이라면 하나씩 확인하세요.
연구용 Skills 연동 5단계
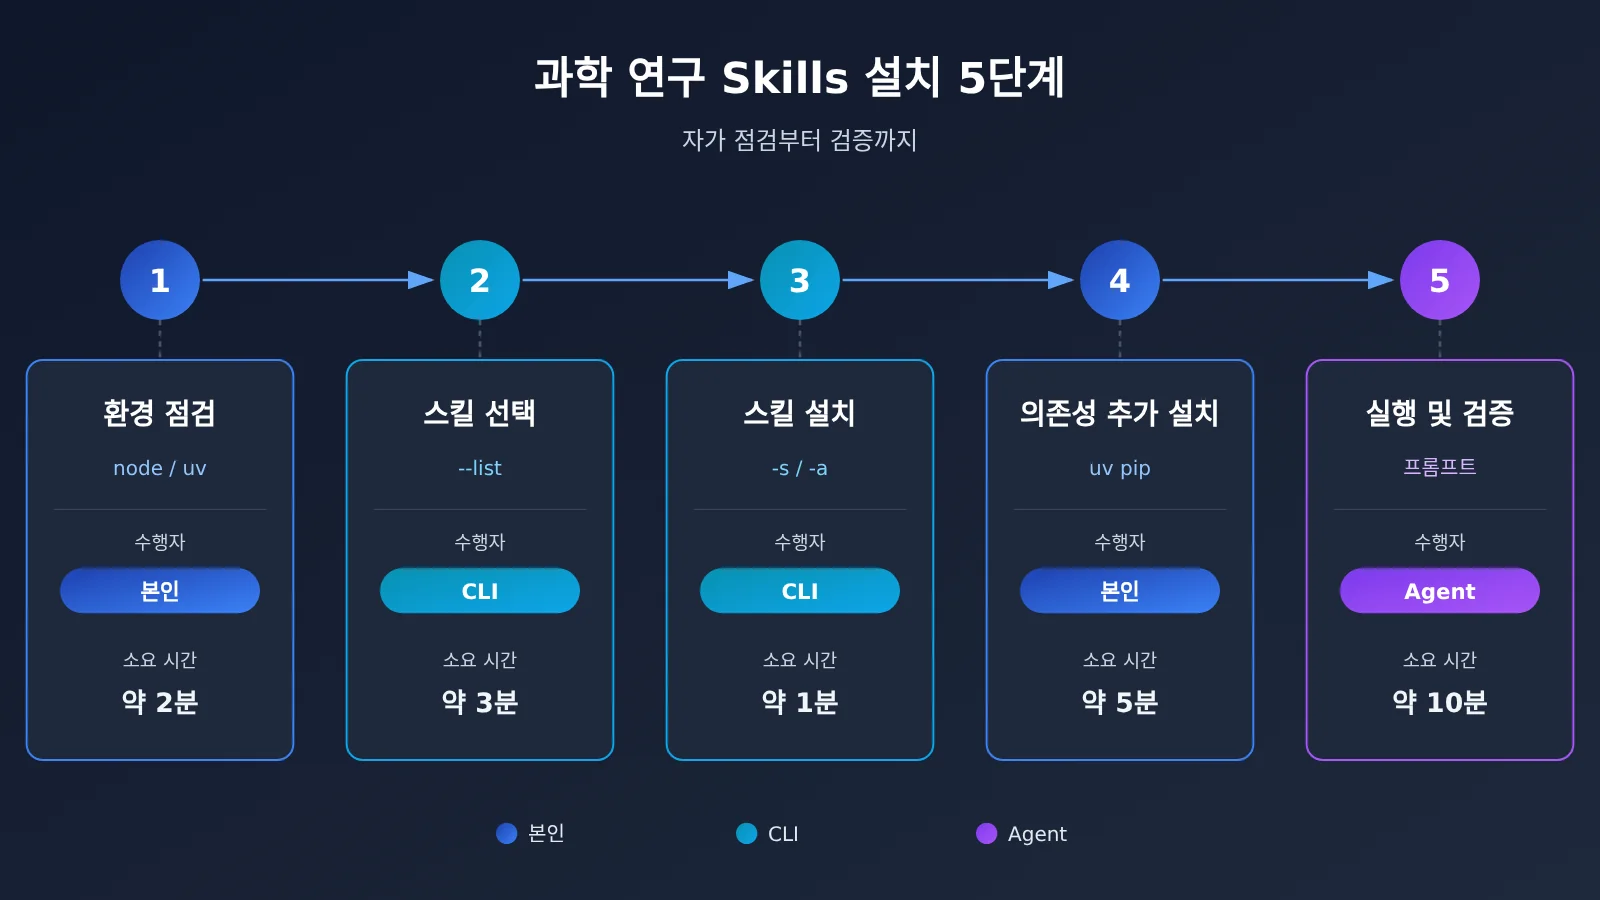
연동 과정은 환경 점검 → 목록에서 스킬 선택 → 필요한 스킬만 설치 → 의존성과 인증 정보 준비 → 실행 및 검증의 다섯 단계로 나뉘어요. 각 단계에서는 여러분이 직접 명령을 입력하는지, 명령줄 도구가 실행하는지, 아니면 Agent가 실행하는지 표시해요.
1단계: 연구용 Skills의 설치 방식과 사전 요구사항 확인하기
소요 시간: 약 5분 사전 요구사항: 터미널을 열 수 있어야 해요 난이도: 낮음(환경이 갖춰져 있다면 건너뛰어도 돼요)
할 일: 아래 점검 명령어를 직접 하나씩 실행해 “바로 설치 가능”, “도구를 먼저 설치해야 함”, “호스트가 지원되지 않음” 중 어디에 해당하는지 확인해요.
node -v: 설치 도구npx skills에는 Node.js 22.20 이상이 필요해요.python3 --version: 저장소에 포함된 도구 체인에는 Python 3.13 이상이 필요해요. 개별 스킬의 의존성 범위는 각 스킬의 compatibility를 확인하세요.uv --version: uv는 스킬 의존성을 설치하는 데 사용해요.gh --version: GitHub CLI로 설치할 때만 필요하며, 버전은 2.90.0 이상이어야 해요.- 운영체제: macOS, Linux 또는 Windows + WSL2
확인할 내용: 각 명령어를 실행하면 버전 번호가 출력돼요. command not found가 표시되면 해당 도구가 아직 설치되지 않은 거예요.
완료 기준: Node는 v22.20 이상, Python은 3.13 이상이어야 하고, uv의 버전 번호가 정상적으로 출력되어야 해요. 또한 사용 중인 호스트가 Agent Skills 표준을 지원해야 해요. 설치 도구 skills(npm 패키지, vercel-labs/skills, MIT, 최신 버전 1.7.4)는 Claude Code, Cursor, Codex, Gemini CLI, Antigravity, OpenClaw 등 70개 이상의 호스트를 공식 지원해요. 스킬은 특정 모델에 종속되지 않으므로 호스트에서 사용할 모델은 직접 선택할 수 있어요. 5단계에서 모델을 APIYI에 연결하는 구체적인 방법을 알아볼게요.
2단계: 연구용 Skills 목록을 확인한 뒤 설치할 항목 고르기
소요 시간: 약 10분 사전 조건: 1단계 통과 난이도: 낮음(건너뛰지 않는 것을 권장)
할 일: 직접 “설치하지 않고 목록만 확인하는” 명령을 실행하세요. 명령줄 도구가 저장소를 내려받아 모든 스킬의 이름과 설명을 읽지만, 로컬에 스킬을 설치하지는 않아요.
npx skills add K-Dense-AI/scientific-agent-skills --list
확인할 내용: 터미널에 177개 스킬의 이름과 간단한 설명이 표시돼요.
실제 사용 시 주의사항: 이 단계에서는 먼저 전체 저장소를 로컬에 clone하는데, 크기가 400MB가 넘어요. 네트워크가 느리면 터미널이 Cloning repository…에서 오래 멈춰 있을 수 있고, 300초가 지나면 Clone timed out 오류가 발생해요. 제한 시간을 늘리려면 SKILLS_CLONE_TIMEOUT_MS=600000(10분)을 설정하고 다시 실행하세요. 또는 직접 git clone으로 저장소를 내려받은 뒤 로컬 디렉터리에서 skills add를 실행해도 돼요.
완료 기준: 후보 스킬 5~10개를 골라 목록을 만드세요. README에도 “Do not install everything at once”라고 적혀 있듯이, 공식 문서에서도 한 번에 전부 설치하는 것을 권장하지 않아요. 스킬이 많을수록 에이전트가 적절한 스킬을 선택하기 어려워지고, 직접 검토해야 할 코드도 늘어나요.
분야별로 다음처럼 골라볼 수 있어요.
- 생물정보학:
scanpy,pydeseq2,database-lookup. 질량 분석을 한다면pyopenms도 추가 - 화학정보학:
rdkit,database-lookup. 재료 분야라면pymatgen도 추가 - 문헌 조사와 글쓰기:
literature-review,paper-lookup,scientific-writing,peer-review - 데이터 시각화:
scientific-visualization. 시계열 데이터를 다룬다면timesfm-forecasting도 추가 - 실험실 자동화: 이 분야의 구체적인 스킬 이름은
--list출력에서 확인하세요. 워크플로 오케스트레이션은nextflow부터 살펴보면 좋아요.
3단계: 필요한 연구용 Skills만 설치하기
소요 시간: 약 5분 사전 조건: 후보 목록 준비 난이도: 중
할 일: 직접 설치 명령을 실행하세요. 명령줄 도구가 호스트의 스킬 디렉터리에 스킬을 설치해 줘요. 제목에서 말한 ‘명령어 한 줄’은 바로 npx skills add K-Dense-AI/scientific-agent-skills예요. 이 명령을 실행하면 대화형 모드에서 스킬과 호스트를 선택할 수 있어요. 여기서 전체를 선택하면 모든 스킬이 설치되므로 권장하지 않아요.
옵션 설명:
-s/--skill: 스킬 이름 지정,'*'는 전체를 의미-a/--agent: 호스트 지정, 예:claude-code,codex-g: 사용자 디렉터리에 설치(전역), 생략하면 현재 프로젝트에 설치--copy: 파일 복사. 기본값은 심볼릭 링크(Symlink)로, 로컬에 사본 하나만 유지하므로 업데이트가 더 편리함-y: 확인 단계 건너뛰기. 스크립트나 CI에 적합
바로 복사해서 쓸 수 있는 비대화형 명령어예요. Claude Code에 프로젝트 단위로 설치하는 예시이며, 각 줄마다 스킬 하나를 설치해요.
npx skills add K-Dense-AI/scientific-agent-skills -s scanpy -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s database-lookup -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s pydeseq2 -a claude-code -y
전역으로 설치하려면 명령어 끝에 -g를 추가하세요. 심볼릭 링크 대신 파일을 복사하려면 --copy를 추가하면 돼요. 여러 스킬을 한 번에 설치하는 방법은 npx skills add --help의 설명을 참고하세요.
| 호스트 | 프로젝트 디렉터리 | 전역 디렉터리 |
|---|---|---|
| Claude Code | .claude/skills/ |
~/.claude/skills/ |
| Cursor | .agents/skills/ |
~/.cursor/skills/ |
| Codex | .agents/skills/ |
~/.agents/skills/ |
| Gemini CLI | .agents/skills/ |
~/.gemini/skills/ |
| Antigravity | .agents/skills/ |
~/.gemini/antigravity/skills/ |
| OpenClaw | skills/ |
~/.openclaw/skills/ |
프로젝트 단위와 전역 설치 중 선택하는 방법: 특정 과제에만 필요한 스킬은 프로젝트 단위로 설치하세요. 예를 들어 특정 분석 프로젝트에서 쓰는 pydeseq2를 프로젝트 단위로 설치하면 프로젝트와 함께 팀원들에게 공유하기 편해요. 문헌 검색이나 글쓰기처럼 매일 사용하는 스킬은 전역으로 설치하면 돼요.
실행 결과: 설치 프로그램이 각 스킬의 설치 성공 메시지와 대상 경로를 표시해요.
확인 기준: 직접 npx skills list 또는 ls .claude/skills/를 실행해 방금 설치한 스킬 디렉터리가 모두 있는지, 각 디렉터리에 SKILL.md가 있는지 확인하세요.
다음 두 가지 설치 방법도 있어요.
gh skill install K-Dense-AI/scientific-agent-skills --agent claude-code --pin v2.71.0:--pin으로 특정 버전이나 커밋 SHA에 고정해, 결과 재현이 필요한 과제에 적합git clone으로~/.agents/skills/scientific-agent-skills(사용자 단위) 또는.agents/skills/scientific-agent-skills(프로젝트 단위)에 복제
4단계: 연구용 Skills의 Python 의존성과 인증 정보 설정하기
소요 시간: 10~30분(패키지 크기에 따라 다름) 사전 조건: 스킬 설치 완료 난이도: 중(건너뛸 수 없음)
할 일: 이 단계에서 문제가 가장 많이 발생하므로 다시 강조할게요. 스킬 파일 설치 ≠ 의존성 설치입니다. 각 스킬의 SKILL.md를 직접 열어 compatibility 필드를 확인한 다음, uv로 의존성을 설치하세요. uv sync는 저장소 자체의 개발 및 검증 도구만 설치하며, 모든 과학 계산 패키지를 설치하지는 않아요.
cat .claude/skills/scanpy/SKILL.md: compatibility 확인. scanpy 스킬에는 “Python 3.13 + Scanpy 1.12.4 + AnnData 0.13.4에서 테스트됨”이라고 적혀 있어요.uv venv .venv-scrna --python 3.13: 워크플로마다 별도 환경을 만들어 단일세포 분석과 화학정보학 패키지 간의 충돌을 방지해요.source .venv-scrna/bin/activateuv pip install "scanpy[leiden]"
일부 스킬에는 별도의 키가 필요해요. 예를 들어 generate-image는 OpenRouter의 이미지 API를 사용하므로 export OPENROUTER_API_KEY=你的Key로 설정해야 하며, 사용 건당 요금이 부과돼요. 모델 목록을 조회하거나 --dry-run을 추가하면 요금이 청구되지 않으니, 먼저 이 두 가지 방법으로 테스트해 보세요. literature-review는 DOI 검증을 위해 인터넷 연결이 필요하고, PDF로 내보내려면 Pandoc과 XeLaTeX도 별도로 설치해야 해요.
이미 APIYI를 사용하고 있다면 이미지 생성을 위해 OpenRouter 계정을 따로 만들 필요는 없어요. APIYI 문서에는 커뮤니티가 기여한 두 가지 Skills가 소개되어 있어요. apiyi-gpt-image-2-gen(공식 API 경유 gpt-image-2, 토큰 기준 과금, 4K 및 사용자 지정 크기 지원)과 apiyi-gpt-image-2-all-gen(리버스 엔지니어링 방식, 건당 $0.025, 대화형 이미지 수정)이에요. Cursor, Codex CLI, Gemini CLI, OpenCode, GitHub Copilot 또는 Amp에 설치한 뒤 “apiyi-gpt-image-2-gen으로 3840×2160 이미지 한 장 생성해 줘”라고 말하면 돼요. 키는 환경 변수 APIYI_API_KEY로 통일해서 사용해요.
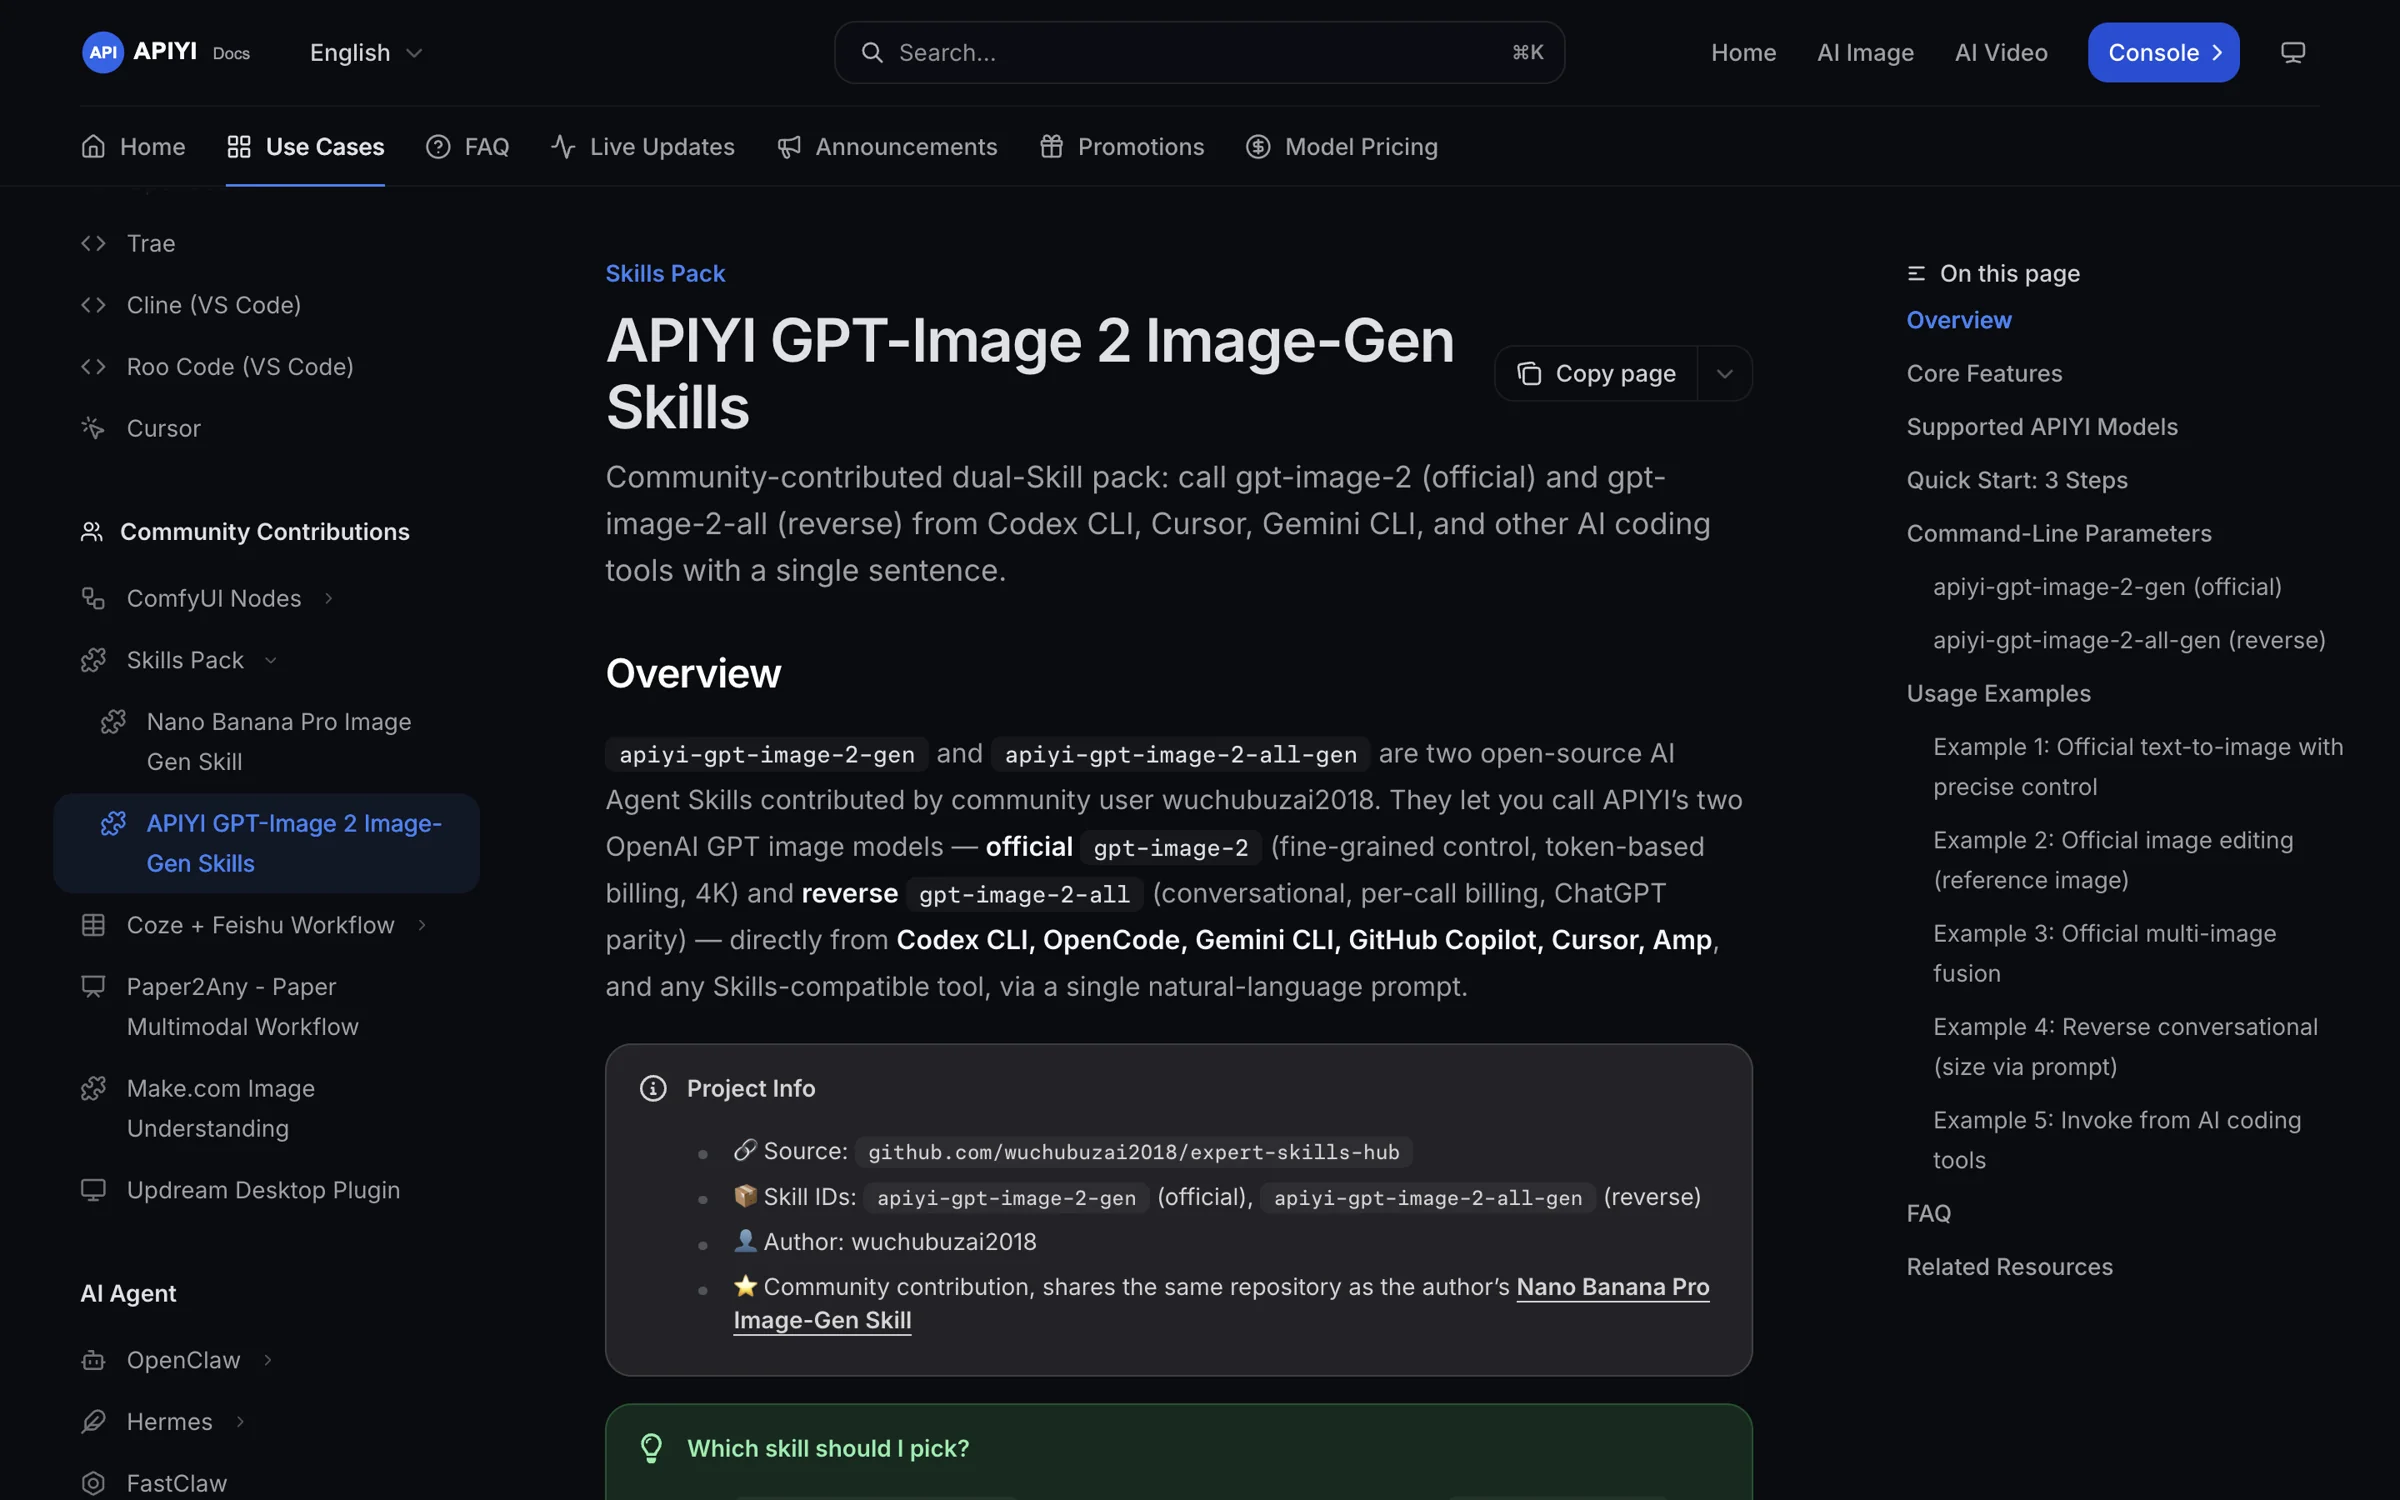
그림 3: APIYI 문서의 Skills 모음 페이지. 두 이미지 생성 스킬의 모델 식별자, 과금 방식, 설치 오류 확인 방법이 안내되어 있어요.
확인할 내용: uv가 의존성을 분석하고 설치한 패키지 목록을 출력해요.
완료 기준: python -c "import scanpy, anndata; print(scanpy.__version__, anndata.__version__)"을 직접 실행했을 때 출력된 버전이 compatibility 필드와 일치해야 해요. 키가 필요한 스킬은 echo $OPENROUTER_API_KEY | head -c 6으로 환경 변수가 적용됐는지 확인하세요.
5단계: 연구용 Skills를 실행하고 결과 확인하기
소요 시간: 약 10분 사전 조건: 의존성 설치 완료 난이도: 낮음
할 일: 호스트를 재시작해 스킬 디렉터리를 다시 스캔하게 해요. 그런 다음 대화창에 프롬프트를 직접 입력하면 Agent가 SKILL.md를 읽고, 스크립트를 실행해 결과물을 생성해요. 프롬프트는 “공통 시작 문장 + 스킬 지정” 형태를 추천해요.
- 첫 문장으로
Use available skills you have access to whenever possible.를 입력해요. - 이어서 “literature-review 스킬을 사용해 체계적 문헌 고찰을 해줘”처럼 스킬을 지정해요.
확인할 내용: Agent가 응답에서 어떤 스킬을 읽었는지 설명하고, 실행할 명령을 제시해요.
검수 기준(세 가지 모두 확인하세요):
- Agent가 어떤 스킬을 사용했는지 명확히 밝혔나요? 언급하지 않았다면 “어떤 skill을 사용했어?”라고 물어보세요.
- 결과물이 어느 디렉터리에 저장됐나요?
ls로 파일이 실제로 존재하는지 직접 확인하세요. - 결과의 수치가 출처와 일치하나요? DOI가 열리는지, 데이터베이스 항목의 ID를 조회할 수 있는지 확인하세요.
직접 실행하는 일상적인 관리 명령: npx skills check는 업데이트 확인, npx skills update는 업데이트 실행, npx skills remove는 제거에 사용해요. 설치 프로그램은 기본적으로 익명 사용 데이터를 수집하며, DISABLE_TELEMETRY=1 또는 DO_NOT_TRACK=1을 추가하면 수집을 끌 수 있어요.
🎯 실행에 성공한 뒤 비용을 따져보세요: 스킬 자체는 무료 오픈소스지만, 스킬을 실행할 때 모델 호출 비용이 들어요. 단일세포 분석의 전체 과정을 한 번 실행하려면 문서를 읽고, 코드를 작성하고, 오류를 수정하는 작업을 여러 차례 반복하므로 토큰 소모가 적지 않아요. 호스트가 사용자 지정 OpenAI 호환 엔드포인트를 지원한다면
base_url을https://api.apiyi.com/v1로 설정하고, APIYI apiyi.com에서 하나의 키로 Claude, GPT, Gemini 등의 모델을 바꿔 가며 같은 스킬의 성능과 비용을 비교할 수 있어요. Claude Code에서는 환경 변수 두 줄만 설정하면 돼요.ANTHROPIC_BASE_URL에https://api.apiyi.com을,ANTHROPIC_AUTH_TOKEN에 키를 입력하세요. 설정 후에도 이 스킬들을 Claude Code에서 그대로 사용할 수 있어요.
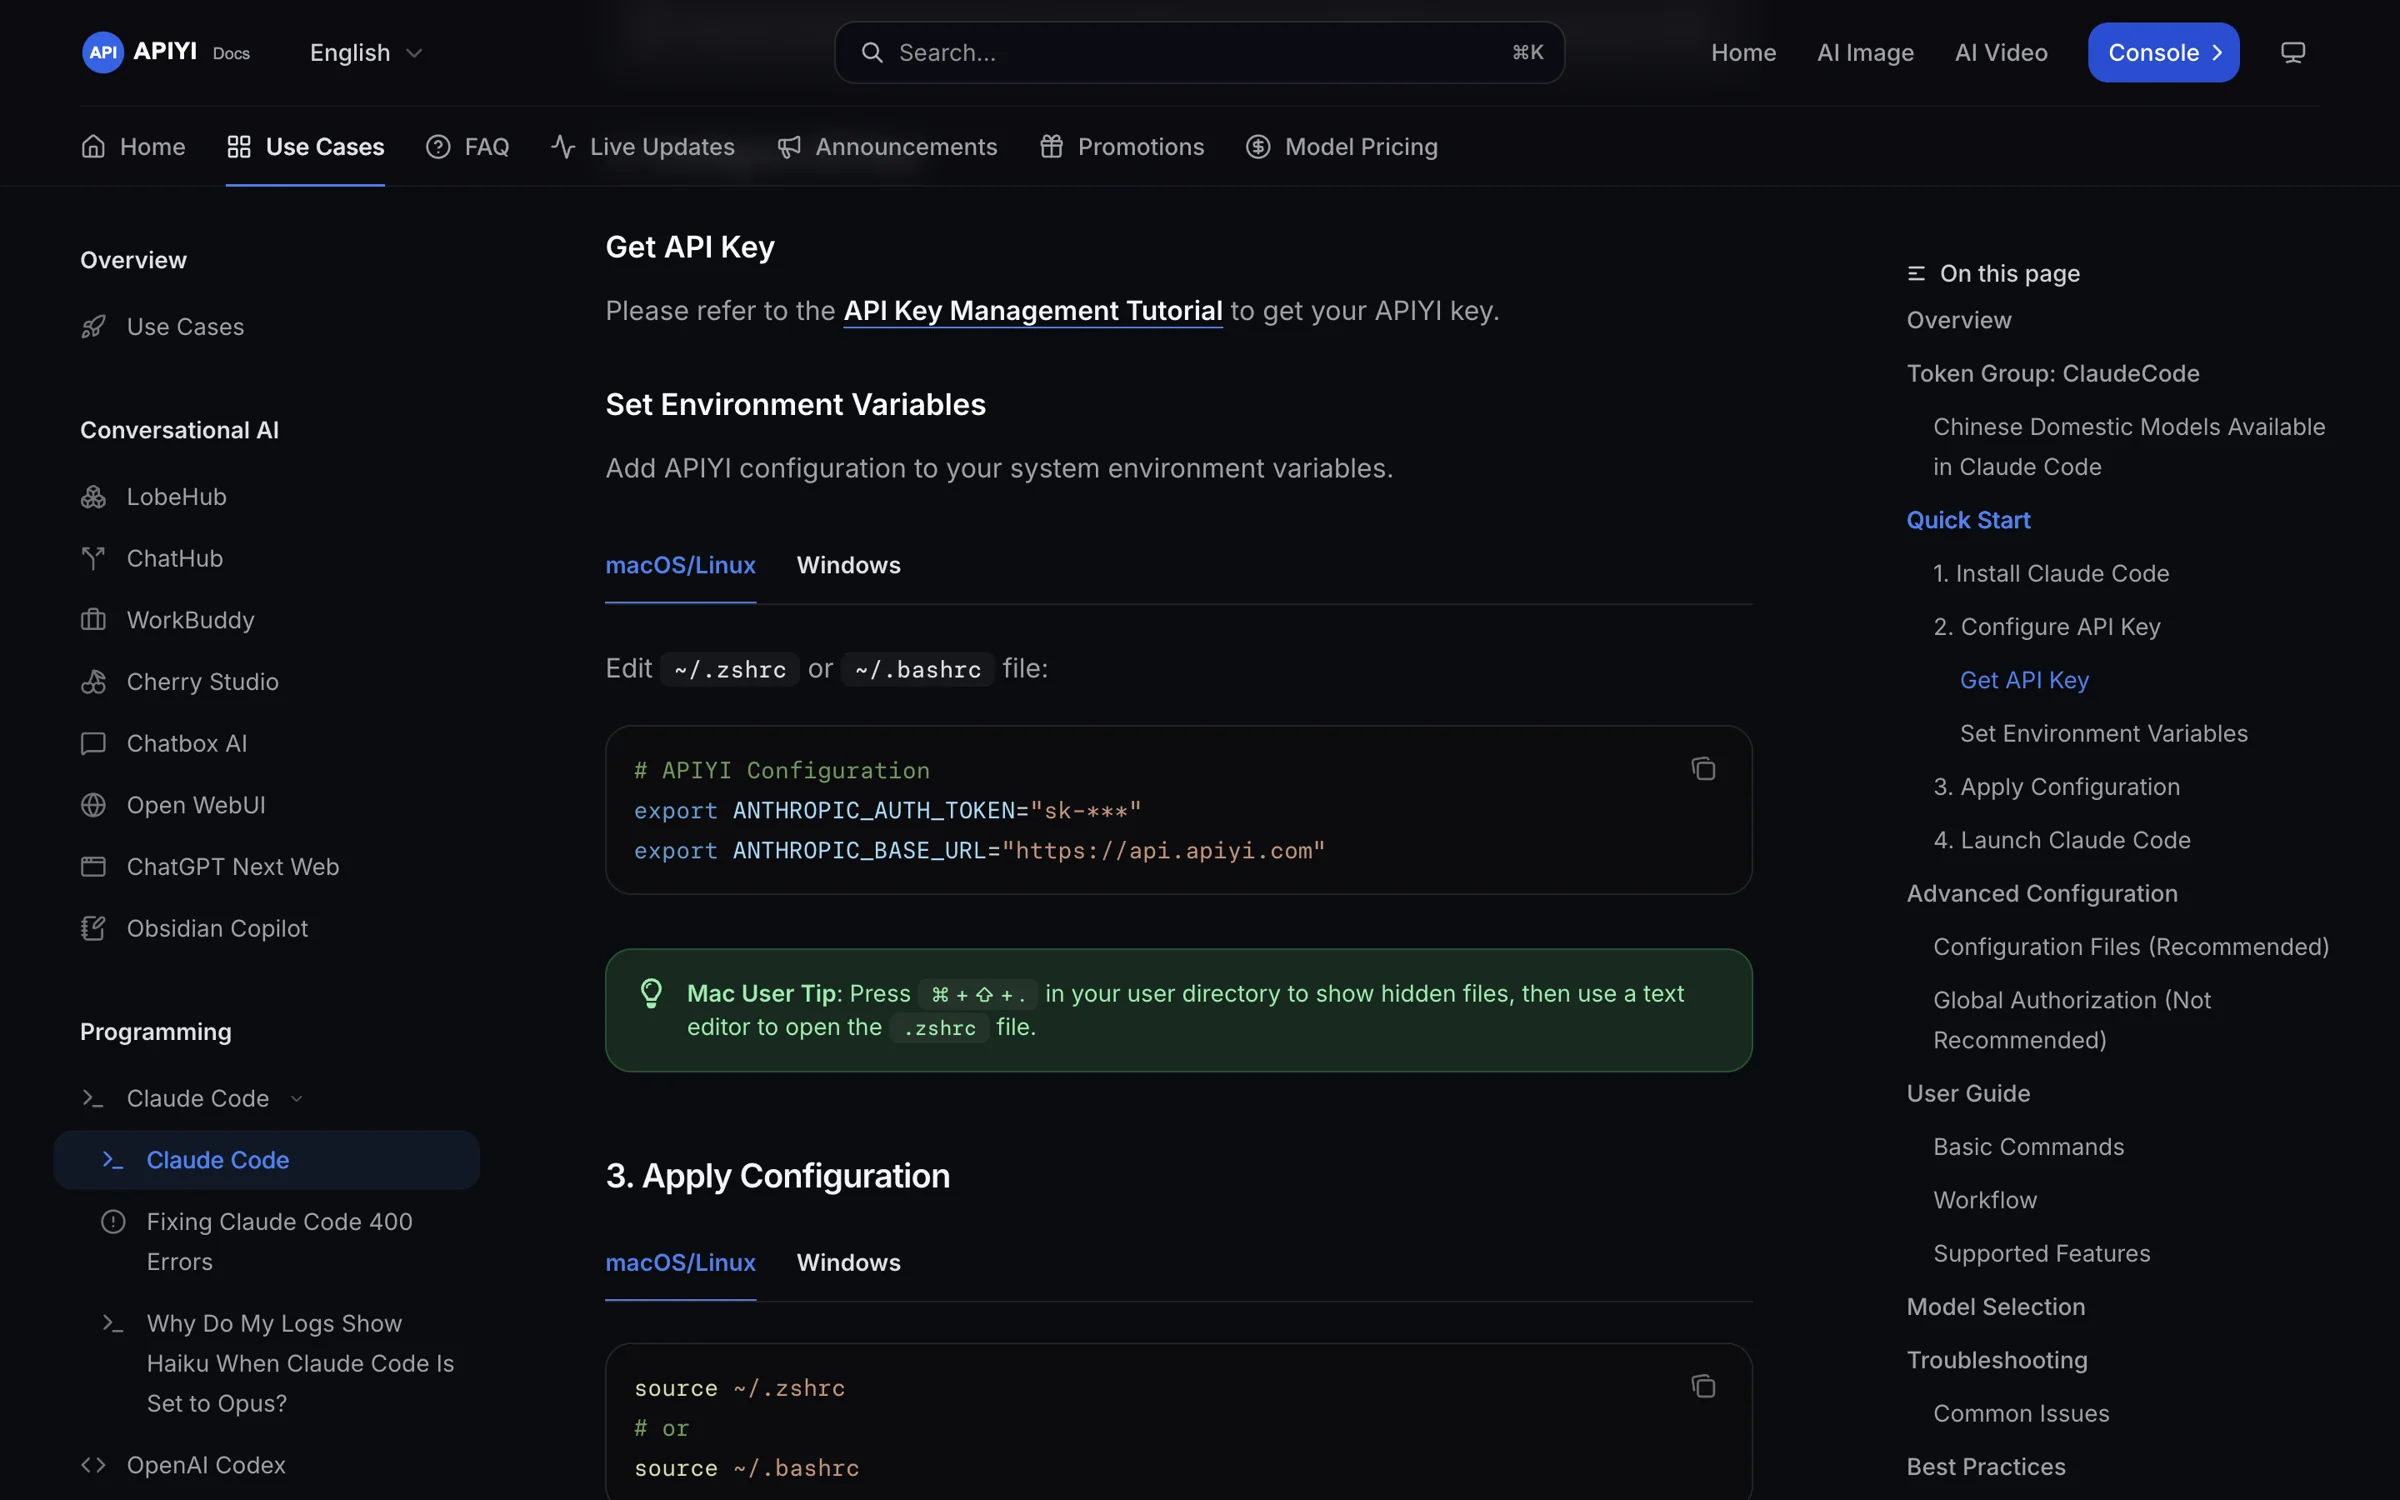
그림 4: APIYI 문서의 Claude Code 설정. 환경 변수 두 줄만 있으면 돼요(스크린샷의 키는 가려져 있어요).
| 모델 | 입력 | 출력 | 캐시 읽기 | 사용 가능 플랫폼 |
|---|---|---|---|---|
| claude-opus-5-5 | $4 / 100만 토큰 | $20 / 100만 토큰 | $0.2 / 100만 토큰 | APIYI apiyi.com |
모델과 가격은 플랫폼의 모델 목록을 기준으로 확인하세요. 연구용 스킬의 프롬프트에는 같은 SKILL.md가 반복해서 포함돼요. 캐시 읽기 단가는 입력 단가의 20분의 1이므로 긴 대화에서 비용을 꽤 절약할 수 있어요.
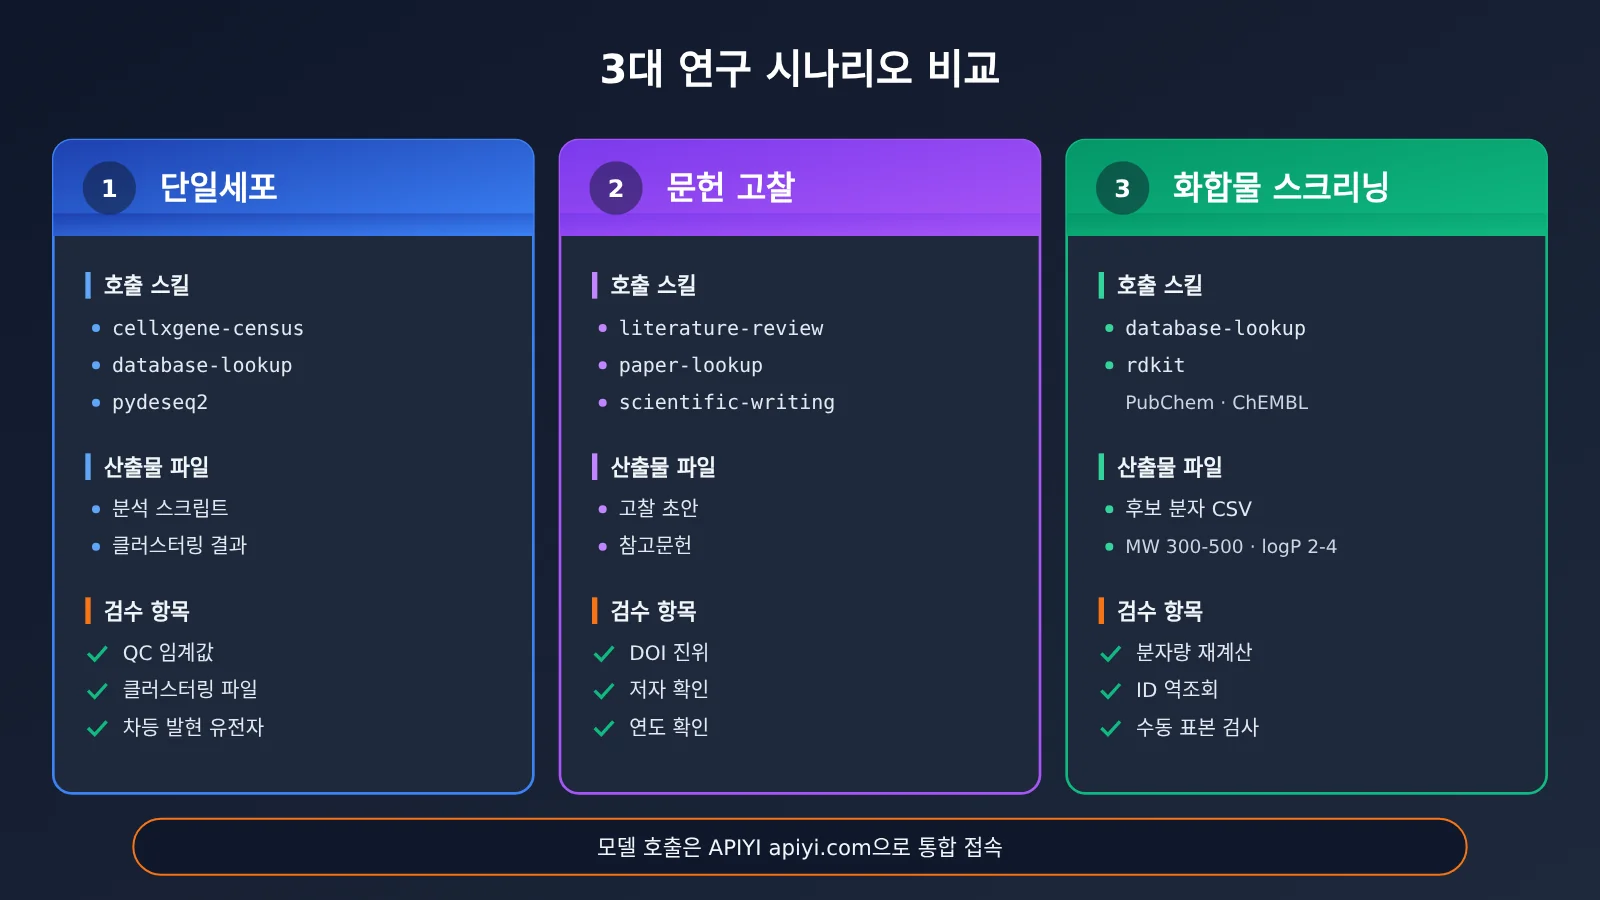
세 가지 연구용 Skills를 처음 실행해 본 실제 시나리오
시나리오 1: 단일 세포 분석
프롬프트에 Use available skills you have access to whenever possible.를 입력한 뒤, “scanpy로 QC, 정규화, 차원 축소 및 클러스터링을 수행하고, cellxgene-census를 세포 유형 참조에 활용하고, database-lookup으로 마커 유전자를 검색하고, pydeseq2로 차등 발현을 분석해 줘”라고 이어서 작성해요. 그러면 에이전트가 해당 스킬을 차례로 읽고 분석 스크립트를 생성해 실행해요.
결과를 확인할 때는 세 가지를 중점적으로 살펴보세요. QC 임곗값이 명시되어 있는지, 클러스터링 결과 파일이 있는지, 차등 발현 유전자를 database-lookup이 반환한 데이터 소스에서 찾을 수 있는지 확인해요.
시나리오 2: 문헌 고찰
프롬프트: “literature-review 스킬을 사용해 특정 주제를 체계적으로 고찰하고, paper-lookup으로 문헌을 보완한 뒤, scientific-writing으로 초안을 정리해 줘.” 이 스킬은 온라인에서 DOI를 검증하므로, DOI를 하나씩 열어 문헌이 실제로 존재하고 저자와 연도가 정확한지 확인하세요.
시나리오 3: 화합물 스크리닝
프롬프트: “database-lookup으로 PubChem과 ChEMBL에서 후보 분자를 가져오고, rdkit으로 분자량 300~500, logP 2~4인 분자를 필터링해 CSV로 출력해 줘.” 결과를 확인할 때는 몇 가지를 직접 표본 검사해 보세요. RDKit으로 분자량을 다시 계산해 CSV의 값과 일치하는지 확인하고, 화합물 ID로 PubChem을 검색해 해당 화합물이 맞는지도 확인해요.
연구용 Skills 문제 해결표
| 현상 | 흔한 원인 | 해결 방법 |
|---|---|---|
| 스킬이 로드되지 않음 | 디렉터리 위치가 잘못됐거나 스킬 디렉터리에 SKILL.md가 없음 |
3단계의 디렉터리 표와 비교해 확인하세요. 수정 후 IDE를 재시작하고, Cursor의 Settings → Rules에서 스킬이 인식됐는지 확인하세요. |
| Python 의존성이 없음 | 스킬 파일만 설치하고 의존성은 설치하지 않음 | SKILL.md의 compatibility 항목에 따라 uv pip install로 설치하고, 해당 환경이 활성화돼 있는지 확인하세요. |
| 데이터베이스 요청 제한 | 대량 요청을 너무 빠르게 보냈거나 무료 할당량을 초과함 | 해당 데이터베이스 문서를 확인하고, 캐시를 추가하거나 요청을 나눠 보내고 동시 요청 수를 줄이세요. |
| 인증 오류 | 키가 설정되지 않았거나 만료됐거나 권한이 부족함 | echo로 환경 변수를 확인하고, 해당 서비스 관리 화면에서 권한을 확인하세요. |
기존 경로 scientific-skills/에서 404 반환 |
v2.43.0부터 스킬 경로가 skills/로 변경됨 |
로컬 스크립트와 북마크의 경로를 수정하거나 다시 설치하세요. |
| 삭제 후 재설치하고 싶음 | 버전이 뒤섞였거나 심볼릭 링크가 작동하지 않음 | npx skills remove로 삭제한 후 npx skills add로 다시 설치하세요. 버전을 고정하려면 gh skill install --pin을 사용하세요. |
Cloning repository…에서 멈춘 뒤 Clone timed out 오류 발생 |
저장소 크기가 400MB 이상이라 300초로는 부족함 | SKILLS_CLONE_TIMEOUT_MS=600000을 설정해 다시 실행하거나, 먼저 git clone으로 로컬에 복제한 뒤 로컬 경로에서 설치하세요. |
연구용 Skills의 위험과 면책 사항
이 섹션은 꼭 끝까지 읽어주세요. Scientific Agent Skills는 커뮤니티 오픈소스 프로젝트이며, 어떤 플랫폼의 공식 API도 아니에요. 저희는 사용을 추천할 뿐, 프로젝트를 보증하지는 않아요.
스킬은 작업을 실행할 수 있어요. 스킬은 Agent에게 임의의 코드를 실행하거나, 패키지를 설치하고, 네트워크 요청을 보내고, 로컬 파일을 수정하도록 지시할 수 있어요. 악의적이거나 잘못 작성된 스킬은 Agent가 의도와 다르게 동작하게 할 수 있어요. 다음과 같이 확인하는 것을 권장해요.
- 설치 전에
SKILL.md를 읽고 어떤 패키지를 사용하고 어떤 외부 서비스에 연결하는지 확인하세요. - 기여 이력을 확인하세요. K-Dense-AI가 작성한 스킬은 내부 검토를 거쳤지만, 커뮤니티가 기여한 스킬은 가능한 범위에서만 검토해요.
- 직접 한 번 더 검사하세요. 먼저
uv pip install cisco-ai-skill-scanner를 실행한 다음,skill-scanner scan <path> --use-behavioral을 실행하세요.<path>는 스킬 디렉터리로 바꾸면 돼요. 프로젝트 측은 매주 증분 검사를 하고, 최소 30일마다 전체를 다시 검사해요. 결과는docs/security-report.md에 공개되어 있어요.
서드파티 서비스 제약. 일부 스킬은 서드파티 데이터베이스에 가입하거나 직접 발급받은 키를 사용해야 해요. 이때 해당 서비스의 약관과 사용량 제한을 준수해야 해요. 대량으로 데이터를 수집하면 요청이 제한되거나 계정이 차단될 수 있으므로, 먼저 보조 계정이나 격리된 환경에서 테스트하는 것이 좋아요.
임상 및 규제 관련 주의사항. 임상, 의료, 규제 관련 스킬은 연구와 초안 작성에만 사용할 수 있어요. 진단이나 출고 승인, 인증 결정을 대신할 수 없어요.
책임 소재. 이 스킬을 사용하면서 발생하는 모든 결과는 사용자가 직접 판단하고 책임져야 하며, 본 플랫폼과 이 글의 작성자는 책임을 지지 않아요.
자주 묻는 질문 FAQ
Q1: Scientific Agent Skills는 정확히 무엇인가요?
K-Dense-AI가 관리하는 연구용 스킬 라이브러리예요. Agent Skills 표준을 따르는 177개의 스킬 폴더로 구성되어 있으며, 연구 절차를 어떻게 수행하고 어떤 패키지와 데이터베이스를 사용해야 하는지 Agent에 알려줘요. 모델이나 API 서비스는 아니에요.
Q2: 명령어 하나로 연구용 Skills 177개를 모두 설치하는 건 왜 권장하지 않나요?
우선 공식 README에서 한꺼번에 모두 설치하지 말라고 명시하고 있어요. 스킬이 많을수록 Agent가 적절한 스킬을 고르기 어려워지고, 각 스킬이 코드를 실행할 수 있어 검토할 내용도 늘어나요. 연구 분야에 맞춰 5~10개만 골라도 충분해요.
Q3: 스킬이 181개가 아니라 177개인 이유는 무엇인가요?
2.72.0 버전부터 docx, pdf, pptx, xlsx 문서 스킬 4개가 저장소에서 더 이상 배포되지 않아요. 필요하다면 Anthropic의 skills 저장소에서 별도로 설치하세요.
Q4: 스킬은 무료라면 주로 어떤 비용이 드나요?
주로 스킬을 실행할 때 발생하는 모델 호출 비용이 들어요. 일부 스킬은 서드파티 서비스 비용도 발생해요. 예를 들어 `generate-image`는 OpenRouter를 통해 호출 건당 요금이 부과돼요. 모델은 APIYI apiyi.com에서 고정 월 요금 없이 사용량에 따라 호출할 수 있어요. 작은 작업으로 토큰 사용량을 먼저 확인한 뒤 장기적으로 사용할 모델을 결정해 보세요.
Q5: Cursor에 설치했는데 Agent가 스킬을 호출하지 않으면 어떻게 하나요?
먼저 Settings → Rules에서 스킬이 인식되었는지 확인하세요. 그런 다음 프롬프트 앞에 `Use available skills you have access to whenever possible.`를 추가하고 스킬 이름을 직접 지정해 보세요. 그래도 호출하지 않으면 다른 모델로 비교해 볼 수 있어요. APIYI apiyi.com에서는 키 하나로 여러 모델을 전환할 수 있어 문제를 확인하기 편해요.
Q6: 연구 결과의 재현성을 어떻게 확보하나요?
`gh skill install –pin`을 사용해 스킬을 특정 버전이나 커밋으로 고정하세요. Python 의존성도 별도의 uv 환경에서 버전을 고정하고, `SKILL.md`의 metadata.version과 last-reviewed 날짜를 함께 기록하세요.
Q7: 이 스킬들은 모두 MIT 라이선스인가요?
반드시 그렇지는 않아요. 저장소 전체의 라이선스는 MIT지만, 각 스킬에는 별도의 license 필드가 있어요. 예를 들어 `scanpy`는 BSD-3-Clause예요. 상업적으로 사용하기 전에 하나씩 확인하세요.
연구용 Skills 핵심 요약
- 무엇인가요?: README에 나열된 22개 대분류를 아우르는 오픈소스 연구용 스킬 177개예요.
- 어떻게 설치하나요?: 먼저
--list로 목록을 확인한 다음,-s와-a로 필요한 스킬만 설치해요. - 사전 요구사항: Node.js 22.20+, Python 3.13+, uv, 그리고 Agent Skills 표준을 지원하는 호스트가 필요해요.
- 가장 흔한 실수: 스킬 파일을 설치했다고 의존성까지 설치되는 건 아니에요. 워크플로마다 별도의 uv 환경을 만드세요.
- 어떻게 검증하나요?: 어떤 스킬을 썼는지, 결과물이 어느 디렉터리에 있는지, 수치가 출처와 일치하는지 확인해요.
- 보안: 설치 전에
SKILL.md를 읽고 Cisco 스캐너로 검사하세요. - 비용: 스킬은 무료이며, 모델 호출은 APIYI apiyi.com을 통해 통합하고 비교할 수 있어요.
정리
이 연구용 Skills 177개는 유용하지만, 한꺼번에 많이 설치하기보다 순서대로 진행하는 게 좋아요.
- 환경 확인 후 설치: 환경 버전과 호스트 지원 여부를 확인하고,
--list로 스킬 5~10개를 골라요. - 스킬과 의존성은 따로 설치: 스킬 파일은
npx skills add로, Python 의존성은 uv로 설치해요. 두 단계 모두 필요해요. - 결과를 검증할 수 있어야 해요: 실행할 때마다 어떤 스킬을 썼는지, 결과물이 어디에 있는지, 수치의 출처는 무엇인지 확인해요.
먼저 가장 익숙한 작은 작업을 처음부터 끝까지 진행해 보세요. 예를 들어 작은 데이터셋을 scanpy로 클러스터링한 다음, 스킬을 하나씩 추가하면 돼요. 모델은 APIYI apiyi.com에서 사용량 기반 요금제로 먼저 실행해 보고, 토큰 사용량에 따라 장기적으로 사용할 모델을 결정하는 것을 추천해요.
📚 참고 자료
- Scientific Agent Skills 저장소: 스킬 소스 코드, README 및 보안 보고서
- 링크:
github.com/K-Dense-AI/scientific-agent-skills -
설명: 177개 스킬, 설치 방법, 문제 해결 안내 및
docs/security-report.md를 확인할 수 있어요. -
skills 설치 도구: npx skills 명령어와 매개변수 안내
- 링크:
github.com/vercel-labs/skills -
설명: add / list / check / update / remove 등의 명령어와 70개 이상 호스트의 디렉터리 대응표를 확인할 수 있어요.
-
Anthropic Skills 저장소: docx, pdf, pptx, xlsx 문서 스킬
- 링크:
github.com/anthropics/skills -
설명: 2.72.0 이후에는 이 네 가지 문서 스킬을 여기서 별도로 설치해야 해요.
-
관련 논문: Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents
- 링크:
arxiv.org/abs/2609.00065 -
설명: 스킬 라이브러리의 설계 방향을 살펴볼 수 있어요.
-
APIYI 문서 · Claude Code 연동: 환경 변수, 그룹 및 문제 해결
- 링크:
docs.apiyi.com/scenarios/programming/claude-code -
설명: 두 개의 환경 변수로 Claude Code를 APIYI에 연결할 수 있어요. 스킬을 설치한 후 이 안내에 따라 모델을 실행해 보세요.
-
APIYI 문서 · GPT-Image 2 이미지 생성 Skills: 커뮤니티에서 기여한 두 가지 이미지 생성 스킬
- 링크:
docs.apiyi.com/scenarios/ecosystem/apiyi-gpt-image-skills -
설명:
apiyi-gpt-image-2-gen과apiyi-gpt-image-2-all-gen의 매개변수, 과금 방식, 자주 발생하는 오류를 확인할 수 있어요. -
APIYI 모델 가격표: 모델명, 유형, 과금 방식 및 단가
- 링크:
docs.apiyi.com/models - 설명: 이 글에서 인용한 claude-opus-5-5 단가는 이 표를 기준으로 해요. 가격은 변동될 수 있으니 사용 전에 다시 확인하세요.
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈에서 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.