작성자 주석: 원리, 실측 방법, 지연 지표, 비즈니스 시나리오라는 네 가지 관점에서 GPT-6 Luna Decisions API를 평가해, ‘의사결정형 호출’이 일반 모델 호출보다 실제로 더 빠르고 여러분의 비즈니스에 더 적합한지 판단하도록 도와드립니다.
GPT-6 Luna의 Decisions API가 정식 출시된 뒤, 개발자들이 가장 많이 나누는 이야기는 “일반 모델 호출보다 대체 얼마나 빠른가”, “어떤 비즈니스가 전환할 가치가 있는가”입니다. 이 글은 실제 연동 관점에서 GPT-6 Luna Decisions API의 핵심 역량, 속도 향상 원리, 테스트 방법, 적용 시나리오를 평가합니다.
이 글은 공식 홍보 문구를 그대로 옮긴 것이 아닙니다. 계정, 지역, 동시성, 프롬프트에 따라 지연 차이는 얼마든지 크게 벌어질 수 있어요. 그래서 이 글에서는 오해를 부를 수 있는 “고정 배수”를 제시하는 대신, 재현 가능한 평가 스크립트와 판단 기준을 제공합니다. 여러분의 비즈니스 데이터로 직접 실제 결론을 뽑아내 보세요.
핵심 가치: 이 글을 다 읽고 나면 하나의 Python 스크립트로 GPT-6 Luna Decisions API와 일반 호출의 지연 차이를 수치화하고, 분류·라우팅·검수·리스크 관리 같은 의사결정형 비즈니스에 이 API가 적합한지 판단할 수 있습니다.
🎯 평가 안내: 이 글의 모든 코드는 OpenAI 호환 인터페이스 기반으로 작성되었으며, APIYI(apiyi.com)를 통해 바로 실행할 수 있습니다. 구체적인 모델 ID, 인터페이스 파라미터, 과금은 공식 문서와 플랫폼 콘솔을 기준으로 하세요.
GPT-6 Luna Decisions API 핵심 기능
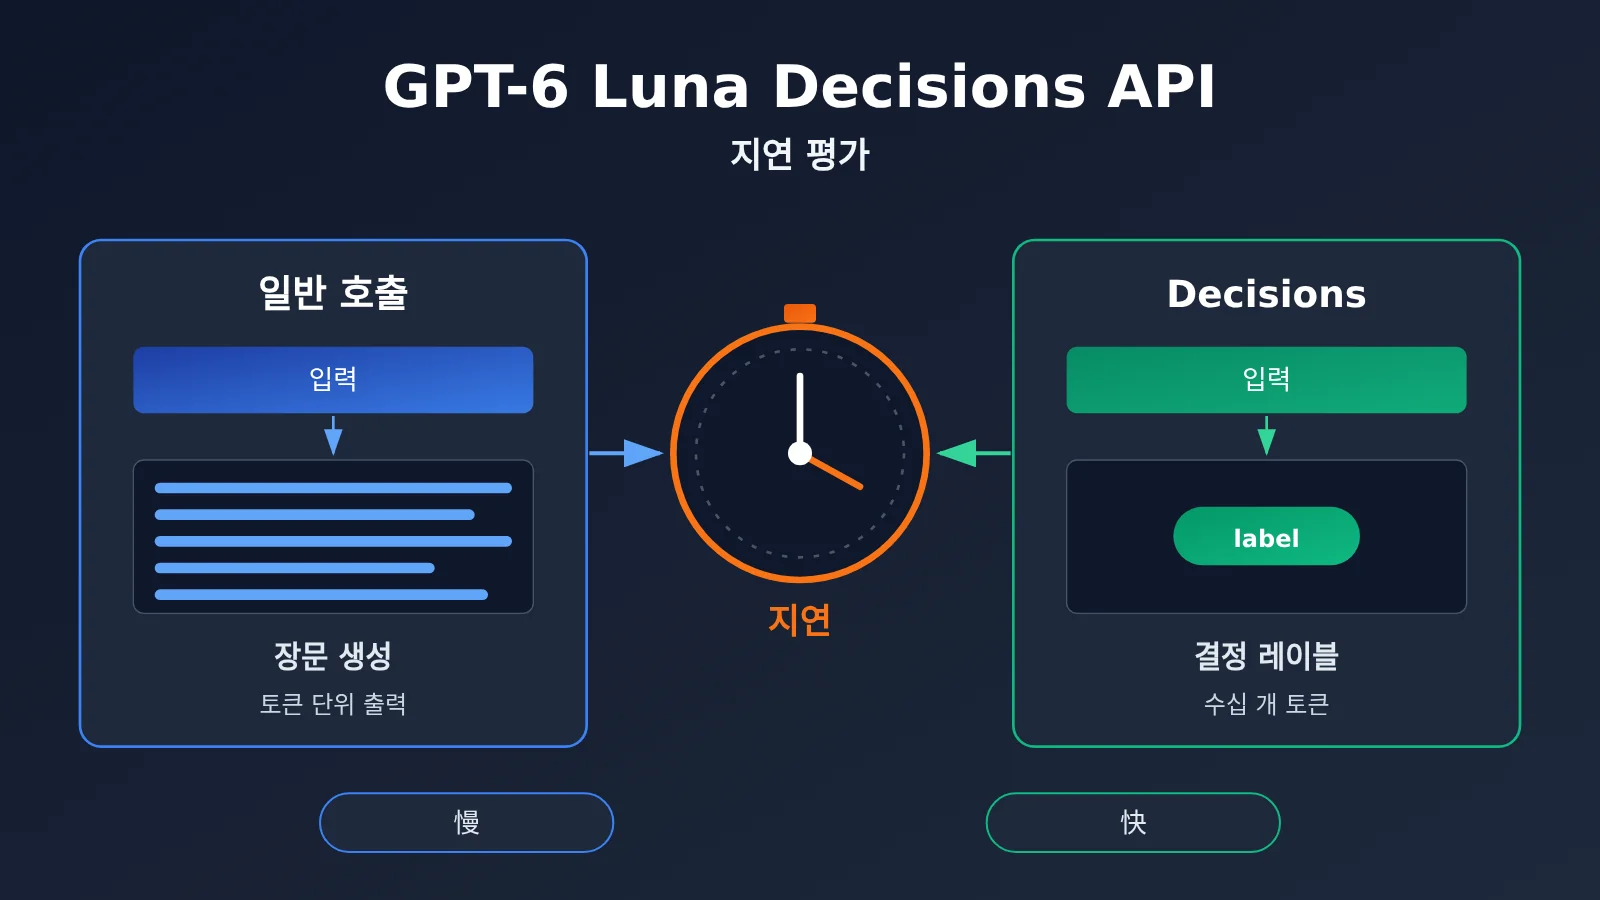
Decisions API를 이해하기 전에, 먼저 이것이 일반 대화 호출과 어떤 위치적 차이가 있는지 짚어볼게요. 일반 호출의 목표는 ‘콘텐츠 한 조각을 생성하는 것’이고, 의사결정형 호출의 목표는 ‘제한된 선택지 안에서 판단을 내리는 것’이에요. 이 두 작업은 출력 길이, 형식 제약, 지연 시간 구성이 완전히 달라요.
| 핵심 포인트 | 설명 | 개발자에게 주는 가치 |
|---|---|---|
| 의사결정형 출력 | 출력이 라벨, 선택지, 점수 같은 구조화된 결과에 집중되고 긴 텍스트가 아니에요 | 결과를 프로그램이 바로 소비할 수 있어 2차 파싱이 필요 없어요 |
| 짧은 출력 길이 | 일반적인 의사결정 결과는 수십 개의 토큰에 불과해 일반 생성 작업보다 훨씬 짧아요 | 전체 응답 시간이 주로 첫 토큰과 입력 처리에 달려 있어요 |
| 형식 제약 가능 | JSON Schema 같은 구조화된 출력 제약과 함께 쓸 수 있어요 | 형식 오류율을 낮추고 재시도를 줄여요 |
| 고빈도 호출에 적합 | 라우팅, 분류, 모더레이션 같은 요청은 보통 양이 많고 건당 처리가 단순해요 | 지연 시간과 비용 최적화 효과가 더 크게 드러나요 |
Decisions API와 일반 호출의 차이
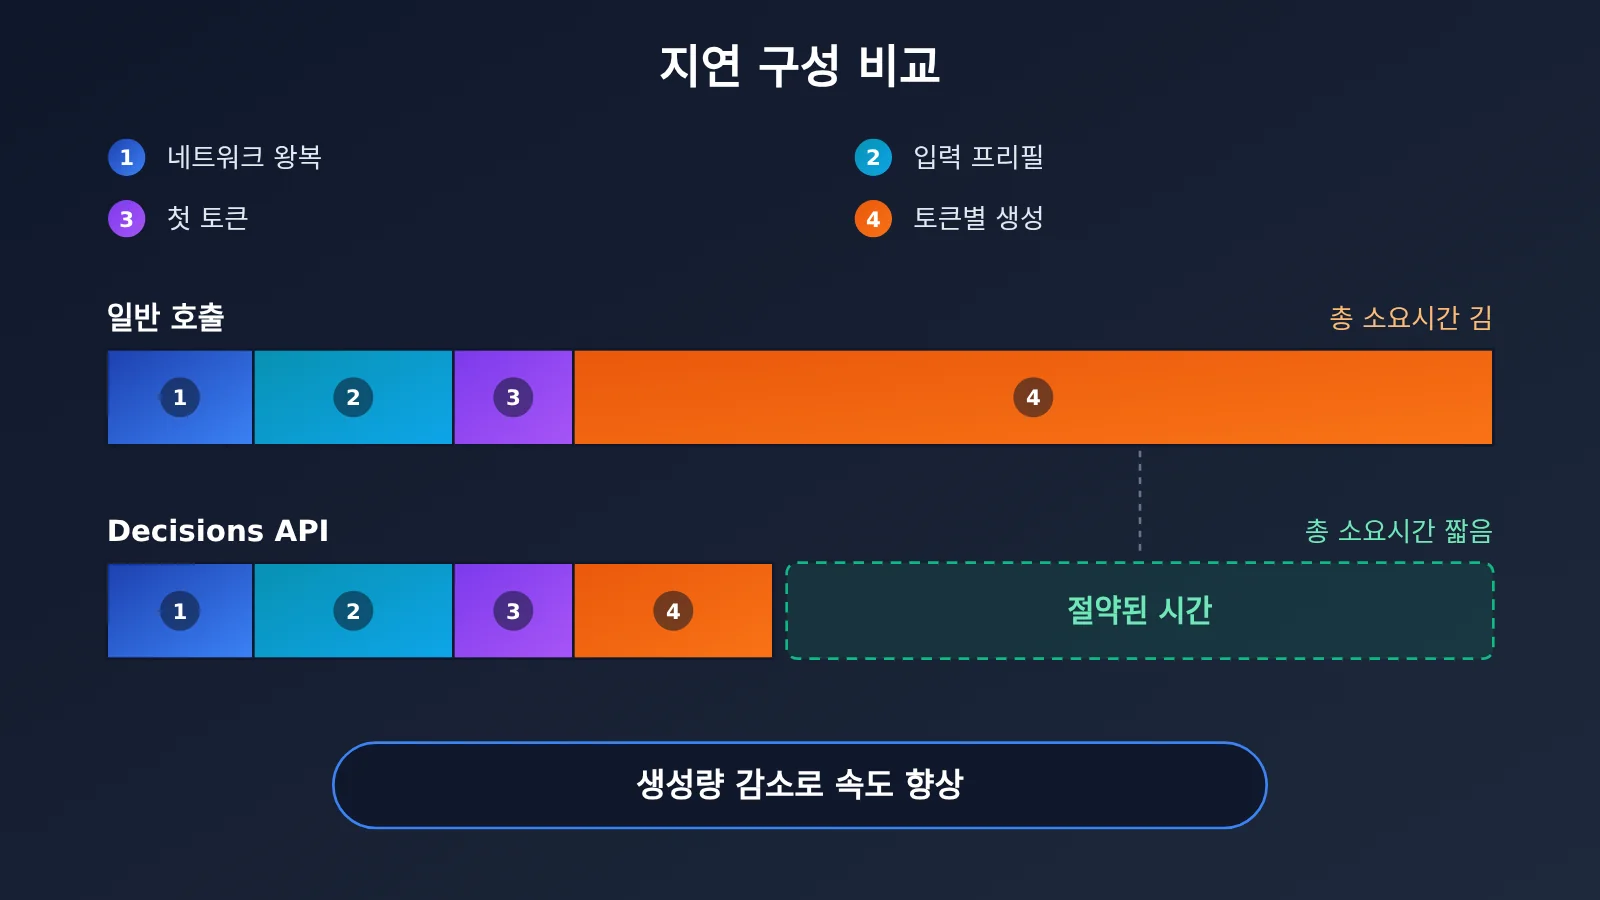
엔지니어링 관점에서 보면, 일반 모델 호출의 총 소요 시간은 대략 세 부분으로 나뉘어요. 네트워크 왕복, 입력 처리(프리필), 토큰 단위 생성이에요. 생성형 작업에서는 세 번째 부분이 보통 큰 비중을 차지하고, 출력이 길수록 느려져요.
의사결정형 호출은 출력을 구조화된 결과 하나로 압축해서, 생성 단계의 소요 시간이 크게 줄어요. 이 말은 GPT-6 Luna Decisions API의 속도 향상이 주로 ‘더 빠르게 생성하기’가 아니라 ‘덜 생성하기’에서 나온다는 뜻이에요. 만약 당신의 비즈니스가 원래 긴 텍스트를 필요로 한다면, 이 인터페이스는 당신을 위한 게 아니에요.
Decisions API의 속도 향상 원천
의사결정형 인터페이스는 보통 두 가지 측면에서 추가 이점을 가져와요. 첫째는 형식이 확정적이라는 점이에요. 프로그램이 정규식으로 자연어에서 답을 긁어낼 필요가 없어서 실패 후 재시도 확률이 더 낮아요. 둘째는 추론 과정이 제어 가능하다는 점이에요. 모델이 추론 강도 조절을 지원한다면, 의사결정 시나리오에서는 긴 사고 체인이 보통 필요 없어서 대기 시간을 더 줄일 수 있어요.
강조하고 싶은 건, 이 모든 게 메커니즘 수준의 분석이라는 점이에요. 실제 속도 향상 폭은 기존 출력 길이에 달려 있어요. 원래 모델이 한 단어만 답하게 했다면 전환 후 이점은 매우 제한적이고, 원래 모델이 ‘먼저 설명하고 결론을 내게’ 했다면 이점이 아주 뚜렷하게 나타날 거예요.
GPT-6 Luna Decisions API 빠른 시작 가이드
최소 예제
다음은 구조화된 출력으로 의사결정 호출을 한 번 수행하는 가장 간단한 예제예요. 모델명은 플랫폼 콘솔에서 확인한 GPT-6 Luna의 실제 모델 ID로 바꿔 주세요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # 콘솔 모델 목록에 있는 실제 이름을 기준으로
    messages=[{"role": "user", "content": "티켓 내용: 제 인보이스가 잘못 발행되었습니다. 담당 부서를 판단해 주세요."}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
이 코드의 핵심은 max_tokens와 response_format이에요. 전자는 출력 상한을 제한하고, 후자는 결과를 프로그램이 파싱할 수 있도록 보장하죠. 이 두 파라미터가 바로 의사결정형 호출 속도 향상의 핵심이에요.
전체 평가 스크립트 보기(일반 호출과 의사결정 호출의 지연 비교)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스를 통해 호출
)

MODEL = "gpt-6-luna"  # 콘솔의 실제 모델 ID를 기준으로; 별도의 Decisions 모델/인터페이스가 있다면 이 부분을 교체

SAMPLES = [
    "제 인보이스가 잘못 발행됐는데, 재발행할 수 있나요?",
    "App 로그인 시 계속 인증 코드 오류가 뜹니다",
    "요금제를 월결제에서 연결제로 변경하고 싶어요",
    "주문이 배송 완료로 표시됐는데 받지 못했습니다",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """첫 토큰 시간, 총 소요 시간, 출력 길이를 반환"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"다음 티켓을 분석하고 어느 부서에서 처리해야 하는지 이유와 함께 설명해 주세요: {prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"티켓: {prompt}. 부서 판단만 출력하세요."}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
스크립트는 스트리밍 출력을 사용하기 때문에 첫 토큰 시간(TTFT)과 총 소요 시간을 동시에 얻을 수 있어요. 각 모드를 최소 20회 이상 실행하고, 같은 시간대에 번갈아 실행해서 네트워크 변동으로 인한 편차를 피하는 것을 권장해요.
🚀 빠른 시작: 공식적으로 권장하는 방법은 먼저 APIYI apiyi.com에서 신규 사용자 무료 테스트 크레딧을 받아, 위 스크립트로 자신의 실제 티켓 샘플을 한 라운드 돌려본 뒤, GPT-6 Luna Decisions API를 프로덕션 환경에 연동할지 결정하는 거예요.
GPT-6 Luna Decisions API 실측 데이터
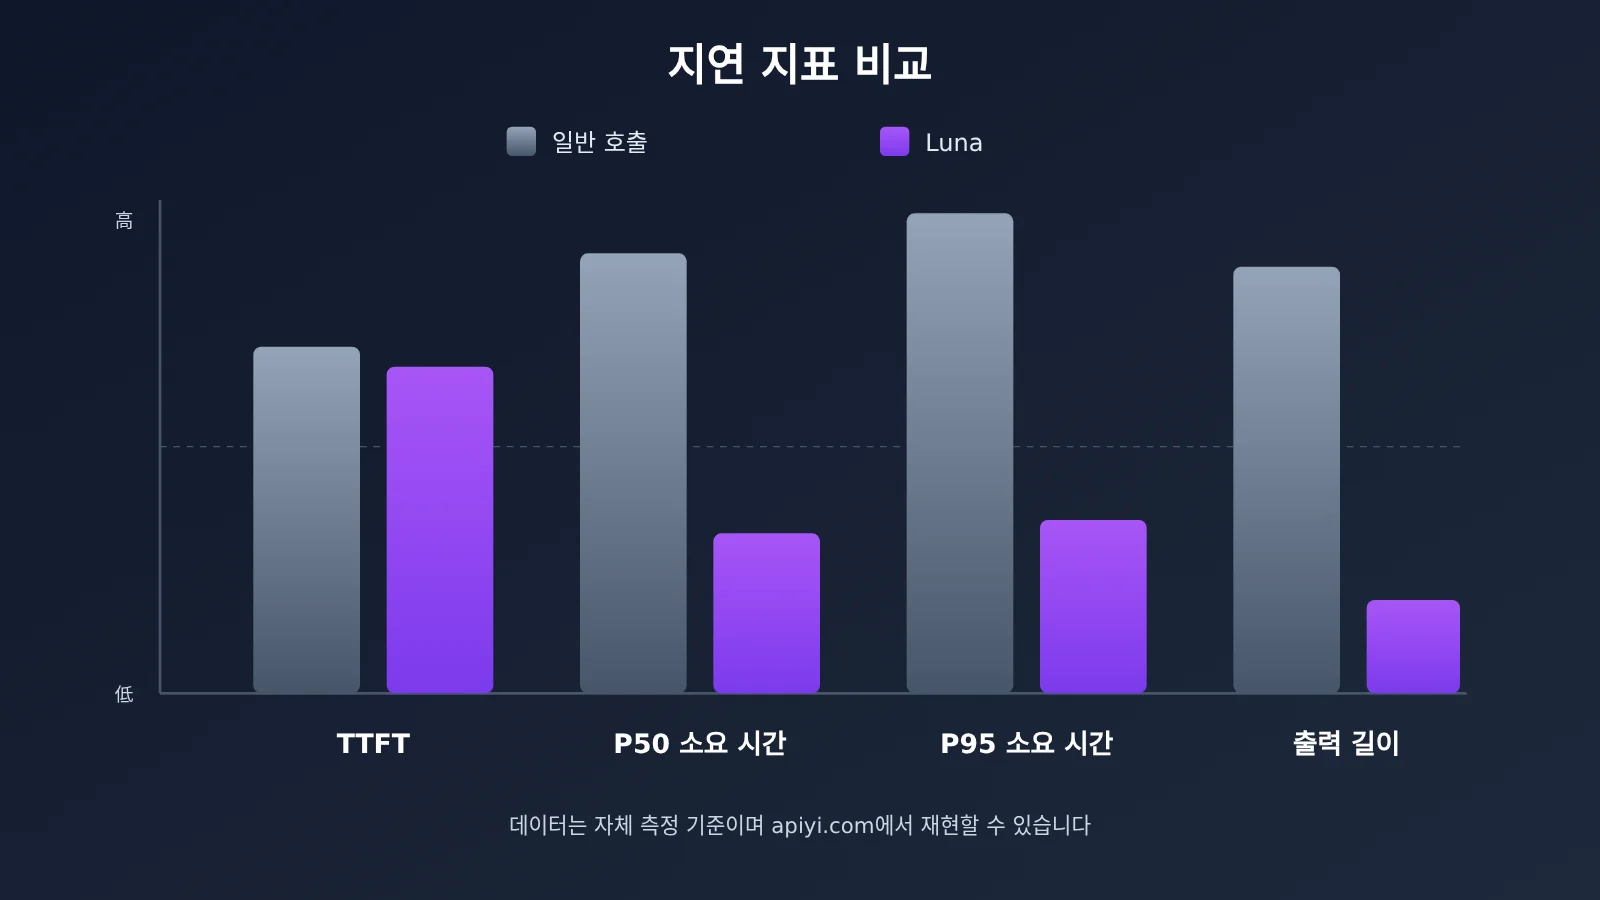
“일반 호출보다 얼마나 빠른가”에는 정답이 하나로 정해져 있지 않아요. 그래서 이 섹션에서는 재현 가능한 평가 프레임워크를 제시할게요. 아래 환경과 지표대로 실행해야 여러분이 얻은 숫자가 실제 비즈니스 의사결정을 이끌 수 있어요.
테스트 환경 구성
| 구성 항목 | 권장 설정 | 설명 |
|---|---|---|
| 호출 진입점 | OpenAI 호환 인터페이스 (base_url을 통합 게이트웨이로 지정) | 두 모드가 동일한 네트워크 경로를 타도록 보장 |
| 샘플 데이터 | 실제 비즈니스 요청 20~100건 | 합성 데이터로 측정한 지연은 대체로 낙관적으로 나오기 마련 |
| 호출 방식 | stream=True |
첫 토큰 시간을 측정하려면 필수 |
| 동시성 | 먼저 단일 동시성, 이후 비즈니스 피크까지 단계적으로 상향 | 고동시성 환경에서의 지연 변동 관찰 |
| 시간대 | 평일 피크와 비피크 각각 한 라운드 | 시간대별 부하 차이 배제 |
핵심 지연 지표
| 지표 | 의미 | 평가 기준 |
|---|---|---|
| TTFT 첫 토큰 시간 | 요청을 보낸 뒤 첫 글자를 받을 때까지 | 두 모드는 대체로 비슷하며, 주로 입력 길이의 영향을 받음 |
| P50 총 소요 시간 | 절반의 요청이 완료되는 데 걸리는 시간 | 결정 모드의 핵심 우위 지표, 격차가 클수록 전환할 가치가 큼 |
| P95 총 소요 시간 | 롱테일 요청의 소요 시간 | 사용자 경험의 하한을 결정하므로, 온라인 서비스라면 반드시 확인 |
| 평균 출력 길이 | 매번 반환되는 문자 또는 토큰 수 | 속도 향상의 원인을 설명하고 비용과도 직결 |
| 형식 성공률 | 반환 결과를 바로 파싱할 수 있는 비율 | 실패 후 재시도가 절약한 시간을 잡아먹음 |
Decisions API 평가 결과 해석하기
두 모드의 TTFT는 거의 같은데 P50 총 소요 시간 격차가 뚜렷하다면, 속도 향상이 실제로 “덜 생성”하는 데서 비롯된 것이며 가장 기대에 부합하는 결과예요. 이때는 평균 출력 길이를 추가로 비교해 보세요. 차이가 클수록 절약되는 시간과 출력 비용도 커진답니다.
P50 격차는 크지 않은데 P95 격차가 뚜렷하다면, 일반 호출의 롱테일이 간헐적으로 발생하는 장문 출력 때문이라는 뜻이에요. 이런 경우에는 평균값이 눈에 띄게 개선되지 않더라도 GPT-6 Luna Decisions API로 전환하는 것만으로 온라인 서비스의 안정성이 크게 좋아질 수 있어요.
또 하나의 경우는 두 모드에 거의 차이가 없는 상황인데, 이는 보통 기존 프롬프트가 이미 충분히 절제되어 있었다는 의미예요. 이때 전환의 가치는 속도가 아니라 형식 신뢰성에 있어요.
💡 검증 팁: 같은 배치의 샘플은 같은 게이트웨이에서 번갈아 테스트하는 걸 권장해요. 서로 다른 네트워크 출구 때문에 결과가 왜곡되는 걸 피하려면 APIYI apiyi.com의 통합 인터페이스에서 직접 비교 테스트를 하는 걸 추천합니다.
GPT-6 Luna Decisions API는 어떤 업무에 적합할까
의사결정형 인터페이스의 가치는 단일 호출이 몇백 밀리초 빨라지는 데 있지 않아요. 고빈도이고 단순하며 프로그램이 결과를 직접 소비해야 하는 시나리오에서는, 그 몇백 밀리초가 수천 수만 건의 요청을 거치며 증폭되거든요. 아래 표는 다섯 가지 대표 업무의 적합도를 정리한 것입니다.
| 업무 시나리오 | 대표 출력 | 적합도 | 설명 |
|---|---|---|---|
| 고객센터 티켓 라우팅 | 부서 태그 + 신뢰도 | 높음 | 요청량이 많고 옵션이 고정되어 있어 속도와 형식 측면의 이득이 모두 뚜렷해요 |
| 콘텐츠 안전 심사 | 통과 / 거부 / 수동 검토 | 높음 | P95 지연에 민감하고, 결과가 곧바로 프로세스를 구동해야 해요 |
| Agent 도구 선택 | 어떤 도구를 어떤 파라미터로 호출할지 | 높음 | 다단계 Agent에서는 매 단계마다 시간이 절약되어 전체 이득이 누적돼요 |
| 리스크 관리·이상거래 1차 스크리닝 | 위험 등급 | 중간 | 1차 필터로는 적합하지만, 핵심 판단은 여전히 규칙이나 사람이 최종 보완해야 해요 |
| 장문 작성 / 보고서 생성 | 긴 자연어 문단 | 낮음 | 자체적으로 긴 출력이 필요한 작업이라 의사결정형 인터페이스의 목표 시나리오가 아니에요 |
방안 비교: Decisions API와 다른 의사결정 방식
의사결정类 작업에 대규모 언어 모델만 있는 건 아니에요. 아래 표는 GPT-6 Luna Decisions API를 몇 가지 일반적인 방안과 나란히 비교한 것입니다.
| 방안 | 핵심 특징 | 적용 시나리오 | 지연 수준 | 사용 가능 플랫폼 |
|---|---|---|---|---|
| GPT-6 Luna Decisions API | 대규모 언어 모델의 이해력 + 구조화된 짧은 출력 | 의미가 복잡하고 옵션이 명확한 의사결정 | 낮음 (자체 측정 기준) | APIYI apiyi.com, 공식 API |
| 일반 생성형 호출 | 유연하고 설명을 덧붙일 수 있음 | 이유 설명이 필요한 저빈도 의사결정 | 중간~높음, 출력이 길어질수록 상승 | 주요 대규모 언어 모델 플랫폼 |
| 경량 소형 모델 분류 | 저렴하고 빠르지만 이해력에는 한계 | 의미가 단순하고 라벨이 충분한 분류 | 낮음 | 주요 대규모 언어 모델 플랫폼 또는 자체 배포 |
| 규칙 엔진 | 밀리초 수준, 완전한 제어 가능 | 조건이 명확하고 거의 변하지 않는 규칙 | 매우 낮음 | 자체 구축 |
비교 분석: 규칙 엔진은 속도와 제어 가능성에서 여전히 우위를 지켜요. 다만 구어체이고 표현이 다양한 입력을 만나면 규칙 유지보수 비용이 급격히 치솟는다는 게 문제죠. 경량 소형 모델은 비용 우위가 뚜렷하지만, 모호한 의미나 긴 컨텍스트를 이해하는 데는 부족해요. 그에 비해 GPT-6 Luna Decisions API는 “의미는 복잡하지만 답의 공간은 제한적인” 시나리오에 더 잘 맞고, 규칙과 일반 대규모 언어 모델 호출 사이의 절충안이라고 볼 수 있어요.
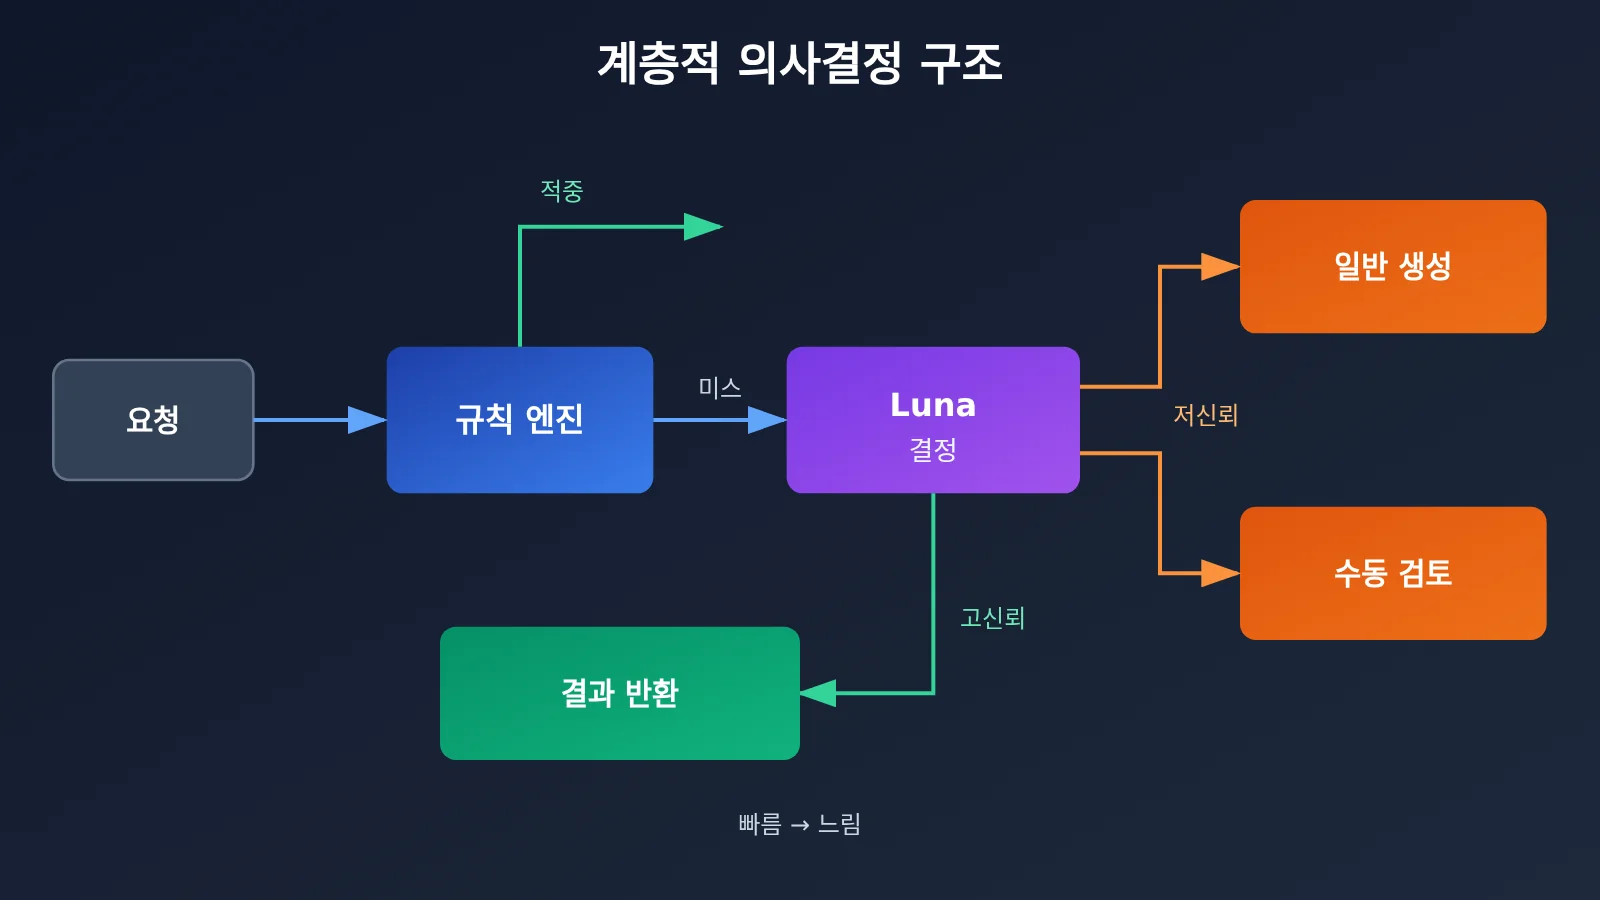
실무에서 더 흔한 방식은 계층형 아키텍처예요. 규칙 엔진이 명확한 조건을 처리하고, 규칙에 걸리지 않는 요청은 GPT-6 Luna Decisions API로 넘기며, 신뢰도가 낮은 결과만 일반 생성 호출이나 수동 검토로 되돌리는 구조죠.
GPT-6 Luna Decisions API 장단점 분석
장점
- 전체 소요 시간을 더 예측하기 쉬움: 출력이 구조화된 결과로 압축돼서 생성 단계의 소요 시간이 눈에 띄게 줄고, 롱테일 레이턴시도 더 안정적이에요.
- 결과를 바로 활용 가능: JSON Schema와 함께 쓰면 반환값을 별도 가공 없이 업무 흐름에 바로 넣을 수 있어서, 파싱 코드와 실패 재시도를 줄일 수 있어요.
- 비용 구조가 더 유리함: 출력 토큰이 줄어들면 출력 비용도 함께 내려가며, 호출 빈도가 높은 시나리오에서 특히 효과가 커요.
- 도입 장벽이 낮음: OpenAI 호환 프로토콜을 기반으로 하기 때문에, 기존 코드에서는 보통 모델 이름과 출력 제약만 조정하면 전환할 수 있어요.
한계
- 설명에는 약함: 의사결정 결과 자체에는 이유가 포함되지 않아요. 감사가 필요할 때는 신뢰도가 낮은 샘플에 대해 일반 호출을 한 번 더 실행해 설명을 보완할 수 있어요.
- 속도 개선 폭은 시나리오마다 다름: 기존 호출이 이미 라벨 하나만 출력하고 있었다면 전환 효과는 제한적이에요. 먼저 평가 스크립트로 정량화한 뒤 마이그레이션하는 걸 권장해요.
- 입력 길이는 여전히 병목: 의사결정형 API가 최적화하는 건 출력 쪽이라서, 초장문 컨텍스트의 프리필 시간이 사라지는 건 아니에요. 필요하면 먼저 입력을 잘라내거나 검색 결과를 압축해야 해요.
- 옵션 설계 품질에 의존: 열거형 값이 명확하지 않으면 모델이 비슷한 옵션 사이에서 흔들릴 수 있어요. Schema에 명확하고 상호 배타적인 옵션을 제시해야 해요.
자주 묻는 질문 FAQ
Q1: GPT-6 Luna Decisions API란 무엇인가요?
의사결정 유형 작업을 위한 호출 방식이고, 핵심은 모델이 주어진 선택지 안에서 짧고 구조화된 판단 결과를 출력하도록 하는 데 있어요. 긴 텍스트를 생성하는 방식이 아니죠. 분류, 라우팅, 검수, 도구 선택 같은 시나리오에 잘 맞습니다. 구체적인 파라미터는 공식 문서를 기준으로 확인하세요.
Q2: Decisions API는 일반 모델 호출보다 얼마나 빠른가요?
일률적으로 적용되는 배수는 없어요. 속도 향상은 주로 출력 길이가 짧아진 데서 나오기 때문에, 원래 출력이 길수록 전환 후 얻는 이득이 커집니다. 본문에 있는 평가 스크립트를 활용해 여러분의 실제 샘플에서 P50과 P95 총 소요 시간을 비교해 보시고, 우리 비즈니스에 맞는 결론을 직접 도출하시길 권해요.
Q3: GPT-6 Luna Decisions API와 일반 호출에 JSON 출력을 더한 것의 차이는 무엇인가요?
일반 호출에 JSON 제약을 붙여도 비슷한 효과를 낼 수 있어요. 두 방식의 격차는 공식 쪽에서 의사결정 시나리오를 위해 별도 최적화를 했는지에 달려 있습니다. 추론 강도, 출력 제약, 서비스 스케줄링 같은 부분이 해당되죠. 가장 신뢰할 수 있는 판단 기준은 역시 동일 조건에서의 실측 비교예요.
Q4: 어떤 업무를 우선적으로 전환하면 좋을까요?
요청량이 많고, 정답의 공간이 고정되어 있으며, 지연에 민감한 업무를 먼저 고려하세요. 고객센터 티켓 라우팅, 콘텐츠 검수, Agent 도구 선택 같은 경우입니다. 반면 장문 작성이나 보고서 생성처럼 자체적으로 긴 출력이 필요한 업무는 전환을 권하지 않아요.
Q5: API로 GPT-6 Luna Decisions API를 빠르게 호출하려면 어떻게 하나요?
다음 순서대로 진행하시길 권합니다:
1. APIYI(apiyi.com)에 접속해 계정을 등록하고 API 키를 발급받습니다
2. 콘솔의 모델 목록에서 GPT-6 Luna의 실제 모델 ID를 확인합니다
3. 본문 코드의 base_url을 `https://api.apiyi.com/v1`로 설정하고 모델명을 바꿔 실행합니다
플랫폼이 OpenAI 호환 인터페이스를 제공하기 때문에, 키 하나로 다른 주요 모델도 함께 호출해 대조 테스트를 할 수 있어요.
Q6: Decisions API 호출 비용은 어떻게 관리하나요?
의사결정형 출력은 그 자체로 출력 토큰을 아껴줍니다. 여기서 더 최적화하려면 세 가지 방향으로 접근해 보세요. 불필요한 컨텍스트를 잘라내고, 명확한 요청은 규칙 엔진으로 걸러내며, 저신뢰도 샘플에만 2차 호출을 하는 방식이에요. APIYI(apiyi.com) 콘솔에서는 모델별 사용량 상세를 확인할 수 있어서 비용이 큰 부분을 찾기 수월합니다.
Q7: GPT-6 Luna Decisions API에 알려진 제한은 무엇인가요?
주요 제한은 세 가지예요. 의사결정 근거를 제공하지 않고, 속도 향상이 기존 출력 길이에 의존하며, 초장문 입력의 프리필 소요 시간은 줄일 수 없습니다. 금융이나 의료처럼 리스크가 큰 의사결정에서는 보조 판단 수단으로 활용하고, 사람이 검토하는 절차를 꼭 남겨 두시길 권해요.
GPT-6 Luna Decisions API 핵심 요점 Key Takeaways
- 명확한 포지셔닝: Decisions API가 해결하는 것은 “제한된 옵션에서 빠르게 판단하기”이지, 긴 텍스트 생성이 아니에요.
- 속도 향상의 원천: 주로 출력이 짧아진 데서 비롯되며, 기존 출력이 길수록 전환 효과가 더 뚜렷해요.
- 핵심 지표: P50과 P95 총 소요 시간을 중점적으로 보세요. TTFT는 두 모드에서 보통 비슷해요.
- 최적 시나리오: 티켓 라우팅, 콘텐츠 검수, Agent 도구 선택 같은 고빈도 의사결정 작업이에요.
- 권장 아키텍처: 규칙 엔진 + Decisions API + 일반 호출로 구성된 계층적 폴백 방식이에요.
- 시작 방법: 통합된 OpenAI 호환 인터페이스로 비교 스크립트를 실행하고, 자체 테스트 데이터를 기준으로 마이그레이션하세요.
요약
GPT-6 Luna Decisions API의 핵심 요점은 다음과 같아요.
- 적게 생성해서 빠르다: 속도 우위는 주로 구조화된 짧은 출력에서 나오며, 단일 토큰 생성 속도가 향상된 것이 아니에요.
- 가치는 시나리오에 달려 있다: 고빈도이고 옵션이 고정되어 있으며 지연에 민감한 비즈니스에서 이득이 가장 커요. 긴 텍스트 시나리오에는 적합하지 않아요.
- 결론은 실측으로: 프롬프트와 샘플에 따라 속도 향상 폭의 차이가 매우 크니, 반드시 실제 데이터로 P50과 P95를 뽑아내세요.
고객센터 라우팅, 콘텐츠 검수, Agent 오케스트레이션을 하고 있다면 GPT-6 Luna Decisions API를 진지하게 평가해 볼 만해요. 먼저 기존 호출을 대조군으로 유지하고, 일부 트래픽을 그레이스케일로 전환한 뒤, 지연과 형식 성공률에 따라 전면 마이그레이션할지 결정하는 것을 권장해요.
APIYI apiyi.com에서 무료 크레딧을 받고, 이 글의 스크립트로 비즈니스 시나리오에서의 실제 속도 향상 효과를 빠르게 검증해 보세요.
📚 참고 자료
- OpenAI API 공식 문서: 모델 호출, 스트리밍 출력 및 구조화된 출력 설명
- 링크:
platform.openai.com/docs -
설명: GPT-6 Luna 및 Decisions 관련 파라미터의 권위 있는 출처 확인
-
OpenAI Python SDK: 공식 Python 클라이언트
- 링크:
github.com/openai/openai-python -
설명: 이 글의 테스트 스크립트에서 사용한 SDK로, 스트리밍 호출 예제 포함
-
JSON Schema 규격: 구조화된 출력 제약 조건의 정의 표준
- 링크:
json-schema.org - 설명: 의사결정 옵션과 열거형 값을 설계할 때 참고하는 규격
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 첫 페이지에서 저희에게 연락해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.