저자 주: 청구서 비용에 관한 한 가지 의문을 짚고 넘어가려 합니다. 최근 몇 달간 모델의 공식 표기 가격은 빠르게 떨어졌지만, 코딩 에이전트는 여전히 청구서에서 만만찮은 자리를 차지하고 있죠. 본문의 가격은 2026-10-26 기준 공식 가격표와 APIYI 모델 가격 페이지를 교차 검증한 결과입니다. 96%라는 수치는 외부 필자의 자체 추정치이며, 본문에서 직접 실측한 수치는 아닙니다.
2026-06-26부터 2026-09-29까지 약 4개월 동안 OpenAI와 Anthropic은 앞다투어 가격을 조정했습니다. Max Woolf는 2026-10-25 minimaxir.com/2026/10/cheap-llms에 이 타임라인을 정리하며, 최대 80%까지 인하되었다는 제목을 달았죠. 그는 글에서 코딩 에이전트의 경우 캐시 읽기(cache read)가 전체 토큰 비용의 96%–99%를 차지한다고 분석했습니다. 매 턴마다 이전 대화 내용을 캐시에서 다시 읽어오기 때문인데요. 적중률은 추론 서비스 제공업체에 따라 다르지만 대략 90%–100% 수준입니다. 원문에는 재검증 가능한 요청 로그가 첨부되지 않았으므로, 본문에서는 이를 외부 참고 의견으로만 다루며 여러분의 실제 사용량을 대신할 수는 없다는 점을 감안해 주세요.
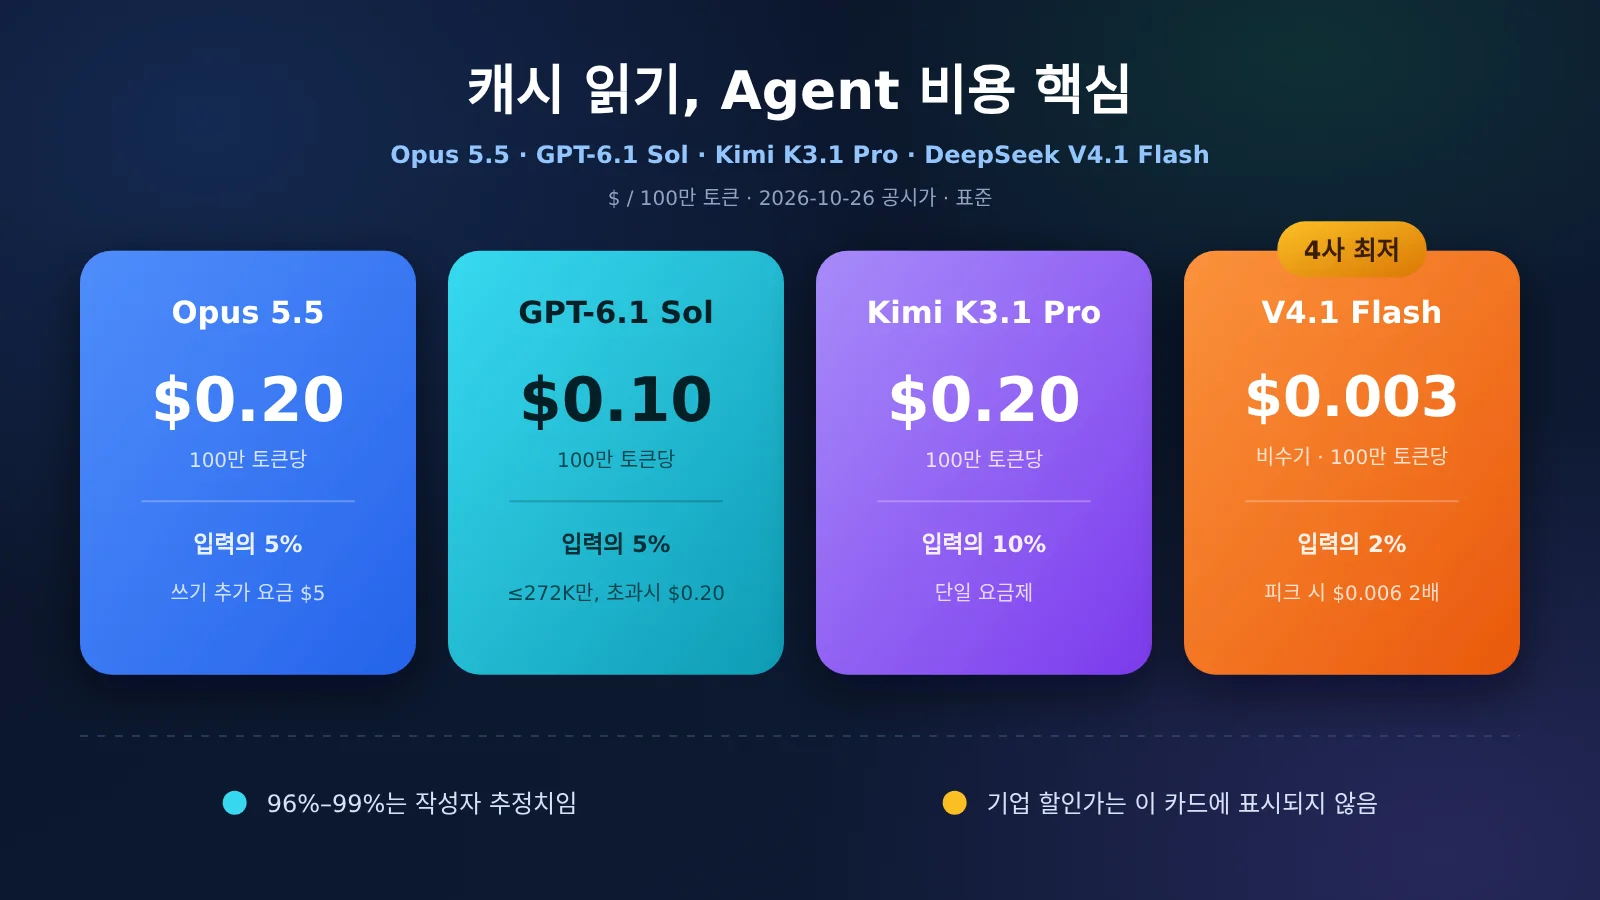
같은 기간 동안 공식 가격표와 대조해 확인된 캐시 읽기 요금은 다음과 같습니다. Claude Opus 5.5는 $0.20, GPT-6.1 Sol은 입력이 272K 이하일 때 $0.10, Kimi K3.1 Pro는 $0.20, DeepSeek V4.1 Flash는 오프피크 $0.003, 피크 $0.006입니다. 단위는 모두 100만 토큰당 달러(USD/1M tokens) 기준입니다.
이 표는 각자 장단점이 골고루 나뉜 평범한 절충안이 아닙니다. 프리픽스가 안정적이고 입력 토큰이 대체로 272K 미만인 코딩 루프 환경이라면, 폐쇄형 3사 중에서는 먼저 GPT-6.1 Sol의 캐시 읽기 요금을 살펴보는 것이 좋습니다. 여기서 한 자릿수 더 낮은 비용을 원한다면 DeepSeek의 오프피크 캐시 읽기를 눈여겨보세요. Opus 5.5와 Kimi의 캐시 읽기 단가는 동일하지만, 캐시 미스 입력, 출력, 캐시 쓰기 할증 요금에서 차이가 납니다.
핵심 포인트: 이 글을 읽고 나면 단순 입력 단가가 아니라 캐시 적중률을 기준으로 모델을 선택할 수 있게 되며, 기사에서 다루는 엔터프라이즈 할인이 왜 소규모 팀의 청구서에는 체감되지 않는지 이해할 수 있습니다.
💡 선택 가이드: 네 모델 모두 APIYI apiyi.com에서 단 하나의 API 키로 모델명만 바꿔가며 바로 테스트해 볼 수 있습니다. 신규 계정에는 무료 테스트 크레딧도 제공돼요. 먼저 프롬프트 프리픽스를 고정한 다음, 실제 사용량 내역에서 캐시 읽기 비중을 확인해 보세요. 짧은 대화 한 번만으로 섣불리 결론을 내리지 않는 것을 추천합니다.
4개 사의 캐시 읽기 요금, 어디서 차이가 날까요?
먼저 캐시 읽기(Cache Read) 요금을 살펴본 뒤, 캐시 미적중 입력 요금 대비 비율을 함께 따져봐야 해요. 이 비율이 길게 이어지는 대화에서 캐시가 얼마나 “저렴한지”를 결정하기 때문이죠. Opus 5.5와 GPT-6.1 Sol(짧은 컨텍스트 기준)은 기본 입력 요금의 5% 수준이고, Kimi K3.1 Pro는 10%, DeepSeek V4.1 Flash는 단 2%에 불과합니다. 실제 체감되는 절대적인 가격 차이는 비율보다 훨씬 더 큽니다. 오프피크 시간대의 DeepSeek Flash 요금($0.003)은 Sol 짧은 컨텍스트($0.10)의 1/33, $0.20 구간과 비교하면 무려 1/67 수준이거든요.
| 모델 | 캐시 읽기 | 미적중 입력 대비 | 미적중 입력 | 출력 |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol, 입력 ≤272K | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol, 입력 >272K | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash (오프피크) | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash (피크) | $0.006 | 2% | $0.30 | $1.20 |
단위는 모두 100만 토큰당 달러(USD) 기준이며, Batch나 Fast, 리전별 추가 할증이 없는 표준 요금제 기준이에요. Opus 5.5는 Anthropic 공식 요금표 기준으로 캐시 적중 시 기본 입력 요금의 0.05배가 청구됩니다. GPT-6.1 Sol은 OpenAI 표준 요금 기준인데요. 여기서 ‘짧은 컨텍스트’는 입력 토큰이 272K 이하인 경우를 말하며, 이를 초과하면 캐시 읽기, 입력, 출력 요금이 모두 한 단계씩 올라갑니다(출력은 $20이 아닌 $15로 적용). Kimi는 Moonshot 공식 안내 기준이며 컨텍스트 길이에 따른 요금 분기 구분이 없습니다. DeepSeek는 공식 가격 책정 페이지 기준이며 모델명은 deepseek-flash, 버전은 DeepSeek-V4.1-Flash-1017입니다. 피크 시간대는 월요일부터 금요일까지 UTC 01:00–04:00 및 06:00–10:00(한국 시간 기준 10:00–13:00 및 15:00–19:00, 중국 법정 공휴일 제외)에 해당합니다. 두 피크 구간 사이의 시간(한국 시간 13:00–15:00)은 여전히 오프피크 요금이 적용되며, 주말과 중국 법정 공휴일은 종일 오프피크 요금으로 계산됩니다.
APIYI 모델 가격 안내 페이지(docs.apiyi.com/models)의 2026-10-25 기준 카탈로그를 살펴보면, claude-opus-5-5는 $4 / $20 / $0.20으로 책정되어 있고, gpt-6.1-sol은 $2 / $10 / $0.10(272,000 토큰 초과 시 입력 요금 $4로 변경 명시), kimi-k3.1-pro는 $2 / $10 / $0.20으로 등록되어 있습니다. DeepSeek의 경우 두 줄로 나누어져 있는데요. deepseek-v4.1-flash 및 deepseek-flash는 공식 피크 요금과 동일한 $0.30 / $1.20 / $0.006으로, deepseek-v4-1-flash-260910은 공식 오프피크 요금과 동일한 $0.15 / $0.60 / $0.003으로 분리되어 있습니다. 공식 서비스에서는 요청 도달 시간에 따라 피크/오프피크가 자동 전환되지만, 카탈로그에서는 이 두 요금 체계를 서로 다른 모델 항목으로 구분해 둔 것이죠. 실제 모델 호출 전 콘솔에 표시된 모델명을 꼭 확인해 보세요.
캐시 읽기 비용은 전체 청구 요금의 절반에 불과해요. 프리픽스(접두사) 캐시가 만료되었을 때 추가 프리미엄 요금을 내야 하는지는 ‘캐시 쓰기(Cache Write)’ 요금이 결정하거든요. 아래 표에서 짧은 유지 시간과 긴 유지 시간을 단순 분 단위로 1:1 비교해서는 안 됩니다. OpenAI의 기본 짧은 구간은 이미 30분인 반면, Anthropic과 Kimi의 짧은 구간은 5분 기준이기 때문이에요.
| 모델 | 단기 캐시 쓰기 | 장기 캐시 쓰기 | 프리픽스 캐시 저장 방식 |
|---|---|---|---|
| Opus 5.5 | 5분, $5 (입력가의 1.25배) | 1시간, $8 (입력가의 2배) | 요청에 cache_control 포함 필요 |
| GPT-6.1 Sol, ≤272K | 30분, $2.50 (입력가의 1.25배) | 12시간, $5 (입력가의 2.5배) | 가격표에 쓰기 비용 별도 표기, 프리픽스가 고정되어야 함 |
| Kimi K3.1 Pro | 5분, $2 (입력가와 동일) | 1시간, $4 (2배 기준 추산) | 기본 5분 자동 적용, 더 긴 주기는 1시간으로 별도 지정 필요 |
| V4.1 Flash | 별도 쓰기 비용 없음 | 없음 | 첫 요청은 캐시 미적중으로 처리, 이후 캐시 읽기 요율 적용 |
Kimi 공식 홈페이지 안내 카드에 표기된 캐시 쓰기 비용은 $2이며, 이는 기본 5분 구간 기준이에요. 1시간 구간의 $4는 APIYI Kimi 문서에 안내된 설정 가격인데, 해당 페이지에는 캐시 구간별 실제 정산 검증이 아직 완료되지 않았다고 명시되어 있어요. 이전 세대인 Kimi K3 공식 안내에서는 1시간 쓰기 비용이 5분 기준의 2배였기 때문에, K3.1 Pro 역시 동일한 배율을 적용하면 $4로 계산돼요. 만약 콘솔의 내용과 차이가 있다면 콘솔을 기준으로 확인해 주세요. 고속 버전인 kimi-k3.1-pro-highspeed는 입력과 출력 단가가 2배이지만 캐시 읽기는 여전히 $0.20로 동일해요. 프리픽스 캐시 적중률이 높을수록 두 구간 사이의 실질적인 비용 차이는 점차 줄어들게 됩니다.
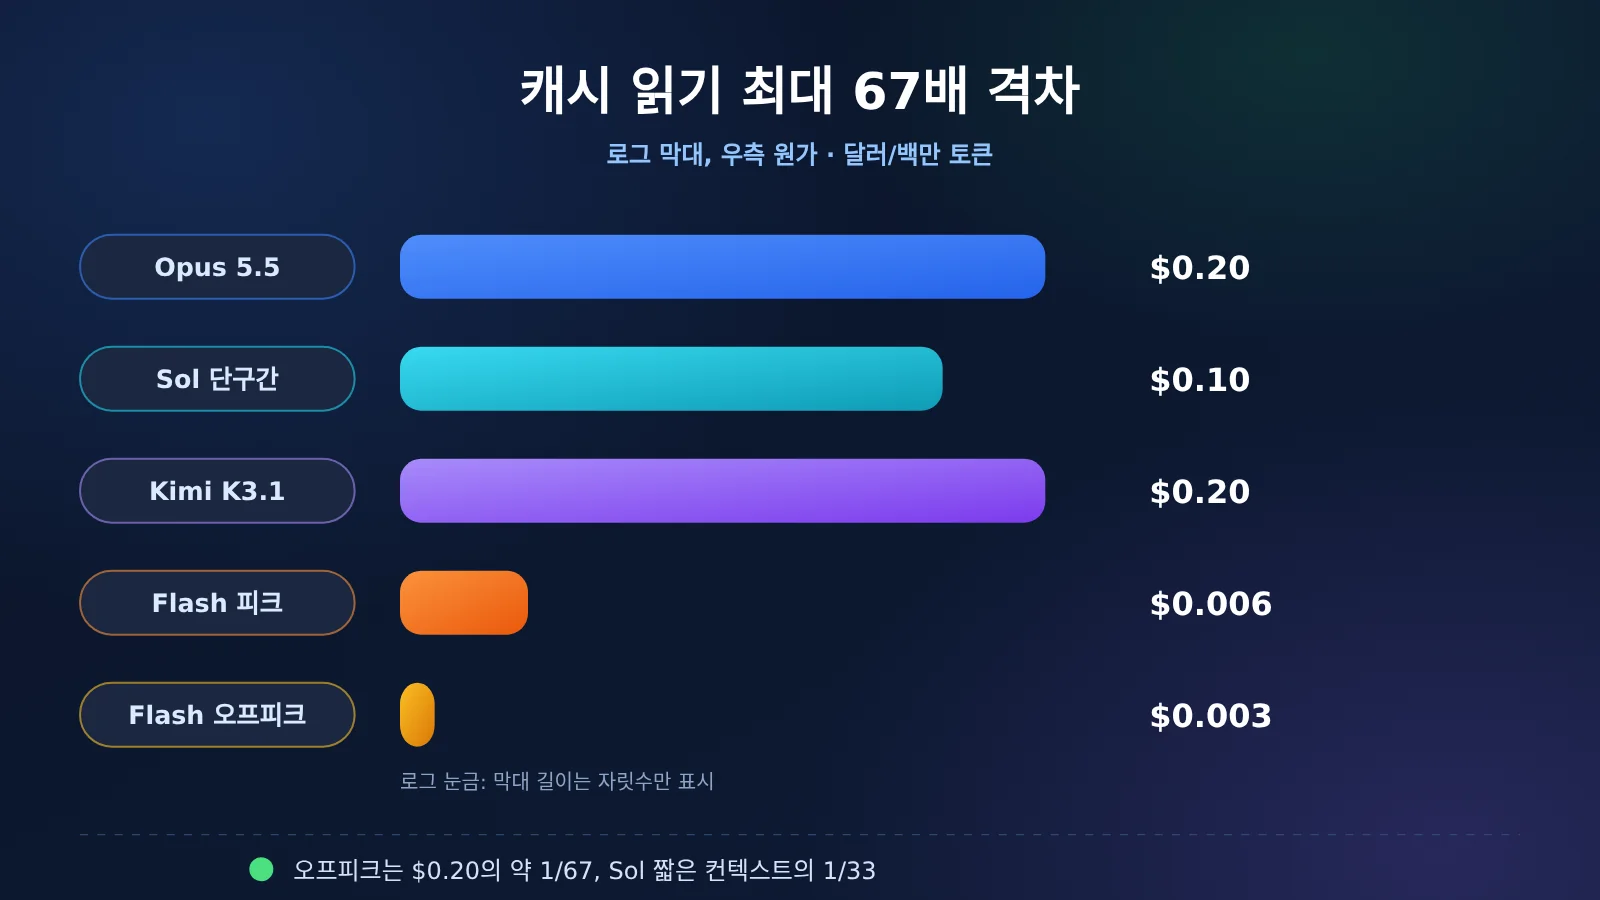
차트의 막대 길이는 대략적인 비용 규모(오더 오브 매그니튜드)를 한눈에 파악하기 위한 참고용이에요. 실제 결제 금액은 원래 단가에 토큰 수를 곱해 청구됩니다. 동일한 API 키로 모델을 변경해 호출할 때는 APIYI 콘솔의 캐시 읽기 항목을 기준으로 확인하시고, 차트 막대 길이만으로 최종 금액을 추정하지 않도록 주의해 주세요.
코딩 에이전트 청구서에서 캐시 읽기 비용을 따로 떼어 봐야 하는 이유
에이전트는 매 턴마다 시스템 프롬프트, 도구(tool) 정의, 그리고 이전 대화 내역을 모델에 다시 전송합니다. 이때 접두사(prefix)가 바뀌지 않은 부분은 캐시 읽기(Cache Read) 요금으로 청구될 수 있죠. 반면 접두사가 변경되면 변경된 지점부터는 캐시 미스(Cache Miss)로 처리되며, 일부 제공업체에서는 캐시 쓰기(Cache Write) 비용까지 추가로 청구합니다. 따라서 일반 입력 토큰 단가가 20% 내려갔다고 해서 코딩 한 세션의 청구 금액이 곧바로 20% 줄어드는 것은 아닙니다. 전체 토큰 중 캐시 읽기가 가장 큰 비중을 차지하고 있다면, 정작 눈여겨봐야 할 항목은 바로 캐시 읽기 단가입니다.
Max Woolf가 언급한 96%~99%는 ‘전체 토큰 소비량’을 뜻합니다. 영어의 ‘expenditure’는 비용(금액)으로 해석할 수도 있고 토큰 소모량으로 볼 수도 있는데, 원문에서는 분모가 무엇인지 명확히 밝히지 않았습니다. 반면 다른 서드파티 벤치마크는 기준을 명확하게 제시하고 있습니다. WorkloadBench의 2026-10-16 업데이트에 따르면, 장시간 진행되는 코딩 작업에서 프롬프트 토큰의 89%~96%가 캐시에서 발생한다고 합니다. GPT-6.1 Sol과 Claude Opus 5.5 모두 중앙값이 95%였으며, 범위는 각각 91%~98%와 94%~99%였습니다(출처: workloadbench.brenhq.com/cache). 이는 어디까지나 프롬프트 토큰 내의 비율일 뿐, 분모에 출력 토큰은 포함되지 않았으며 실제 달러 기준 청구 금액 비율은 더더욱 아닙니다. 따라서 이 두 자료를 합쳐서 “청구서 금액의 96%”라고 단정 지을 수는 없습니다.
실제 달러 기준 비율은 이보다 훨씬 낮은 경우가 일반적입니다. 출력 토큰 단가가 캐시 읽기보다 수십 배에서 수백 배까지 비싸기 때문입니다. 비용 구조를 명확히 살펴보기 위해 구체적인 가정을 세워 다시 계산해 보겠습니다. (원작자의 실제 데이터나 직접 실행한 로그가 아니라, 구조 이해를 돕기 위한 예시입니다.)
40턴 대화를 기준으로, 매 턴 캐시 읽기 120,000 토큰, 신규 캐시 미스 1,500 토큰, 출력 800 토큰이 발생한다고 가정해 보겠습니다. 세션 시작 시에는 40,000 토큰이 1회 캐시 쓰기로 발생합니다(이 40,000 토큰은 캐시 미스로 중복 계산하지 않으며, DeepSeek처럼 별도의 쓰기 비용이 없는 모델은 캐시 미스로 처리). 매 턴 입력은 약 12만 토큰으로, Sol의 짧은 컨텍스트 구간에 해당합니다.
전체 토큰은 총 4,932,000개이며, 이 중 캐시 읽기가 4,800,000개로 약 97%를 차지합니다. 즉 ‘접두사가 길고, 턴 수가 많으며, 턴당 출력이 짧은’ 환경에서는 토큰 수 기준 점유율이 원작자가 언급한 범위에 근접할 수 있음을 보여줍니다.
| 모델 | 캐시 읽기 | 캐시 미스 | 출력 | 쓰기 또는 최초 미스 | 합계 | 캐시 읽기 금액 비중 |
|---|---|---|---|---|---|---|
| Opus 5.5 (5분 쓰기) | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | 약 47% |
| GPT-6.1 Sol (≤272K, 30분 쓰기) | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | 약 47% |
| Kimi K3.1 Pro (5분 쓰기) | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | 약 65% |
| V4.1 Flash (비혼잡 시간대) | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | 약 30% |
| V4.1 Flash (혼잡 시간대) | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | 약 30% |
Opus와 Sol은 짧은 컨텍스트 기준으로 4가지 단가가 정확히 2배 차이 나기 때문에 비율이 동일하며, 합계 금액도 정확히 절반입니다. Kimi는 캐시 읽기 단가가 일반 입력의 5%가 아닌 10% 수준이기 때문에, 동일한 토큰 구조에서 캐시 읽기 비중이 약 65%($1.48)까지 올라가 두 모델의 중간 정도에 위치합니다. Flash의 경우 비혼잡 시간대 합계는 약 $0.049이며, 혼잡 시간대에는 2배가 됩니다. Flash는 캐시 읽기 단가가 캐시 미스의 2%에 불과하므로, 이 가정에서는 출력 비용이 약 40%로 가장 큰 비중을 차지하고 캐시 읽기는 약 30%를 차지합니다.
플래그십 모델 3종의 경우, 이 예시 청구서에서도 캐시 읽기가 여전히 가장 큰 지출 항목입니다. 반면 Flash 모델의 강점은 청구서 전체의 비용 단위(오더 오브 매그니튜드) 자체를 대폭 낮춰준다는 점에 있지, 96%라는 토큰 비율 구조 그대로 금액이 절감되는 것은 아닙니다.
프리픽스(Prefix)가 매 턴마다 바뀐다면 앞서 살펴본 단가표는 무용지물이 됩니다. 타임스탬프, 무작위로 섞이는 툴 목록, 시스템 프롬프트 중간에 불쑥 들어간 사용자 이름 같은 것들이 모두 캐시 히트를 깨뜨리는 주범이거든요.
캐시가 깨지기 시작하면 비교해야 할 대상은 ‘캐시 미스(Uncached) 단가’와 ‘캐시 쓰기(Write) 단가’입니다. Opus의 5분 TTL 쓰기 비용은 기본 입력 단가의 1.25배이고, Sol의 30분 쓰기 역시 1.25배, 12시간 쓰기는 2.5배에 달합니다. 반면 Kimi의 5분 쓰기 비용은 기본 입력 단가와 같아서 단기 구간 할증이 없죠. DeepSeek는 첫 호출 시 일반 캐시 미스 단가가 그대로 적용됩니다.
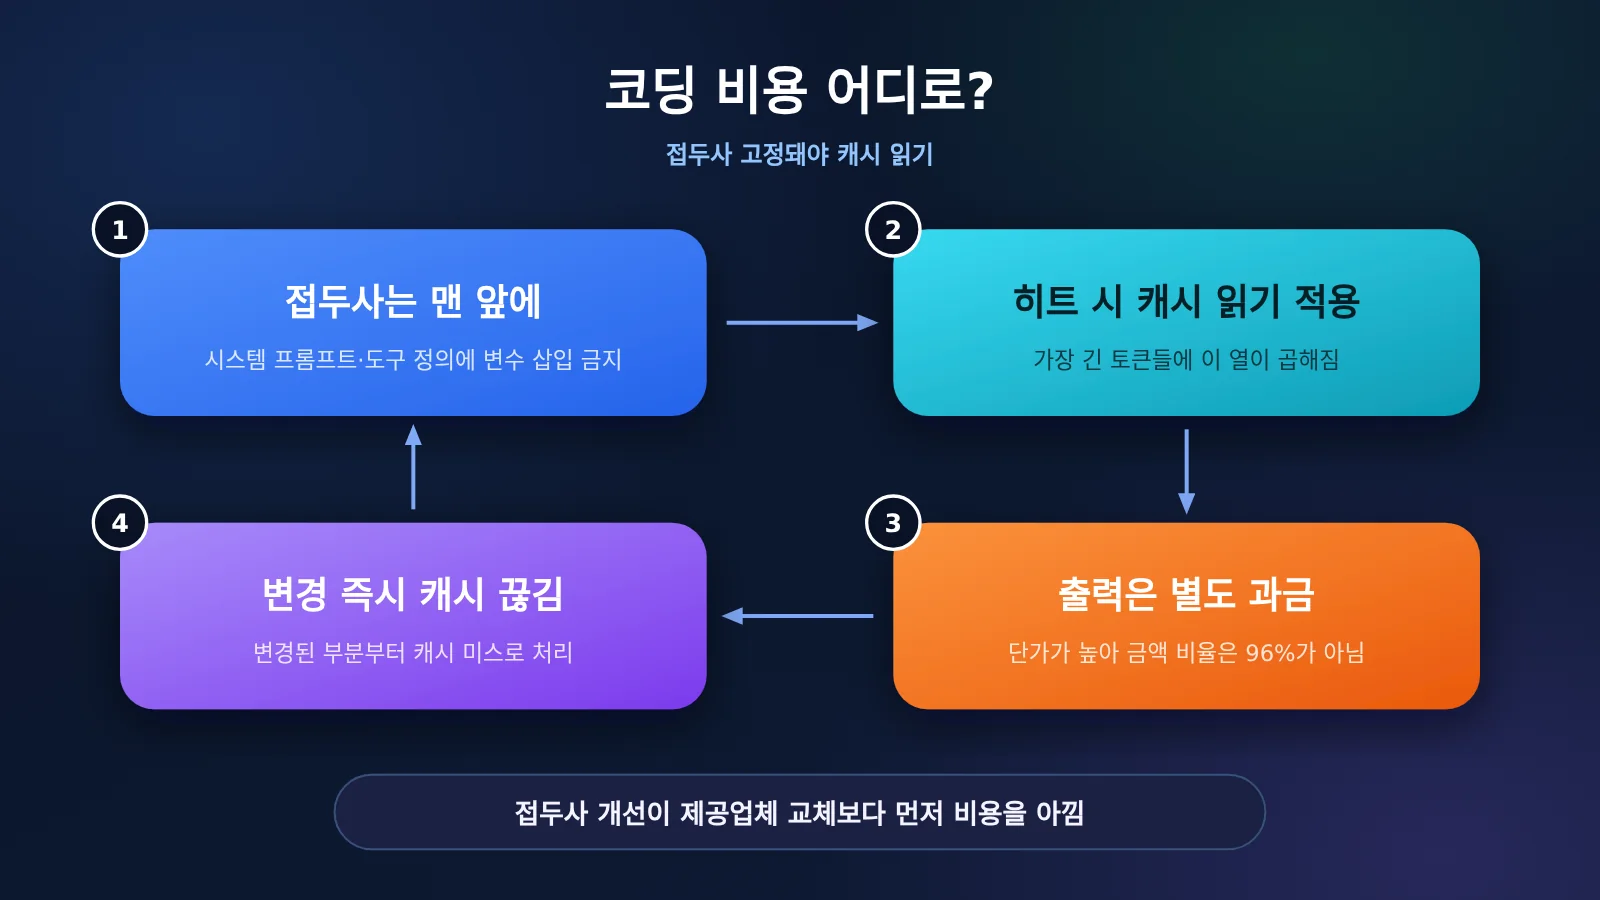
모델 제공업체를 바꾸는 것보다 프리픽스 구조를 다듬는 것이 훨씬 빠르게 비용을 아끼는 길입니다. 툴 목록 순서를 항상 고정하고, 가변적인 동적 콘텐츠는 메시지 맨 끝으로 배치하며, 동일 세션의 호출 간격이 짧은 구간의 TTL을 넘기지 않도록 관리해 보세요. 이 작업들을 먼저 끝내고 난 뒤 캐시 읽기 단가를 따져보며 모델을 선택해도 늦지 않습니다.
지난 4개월간의 가격 인하 타임라인이 시사하는 점은?
“최대 80% 인하”라는 말에 부합하는 사례는 두 가지가 있지만, 모든 모델이 일괄적으로 80% 할인되었다고 이해하시면 안 됩니다. 첫 번째는 맥스 울프(Max Woolf)가 기록한 내용인데요. 2026년 7월 30일, OpenAI가 GPT-5.6 Luna의 가격을 $1 / $6 / $0.10에서 $0.20 / $1.20 / $0.02로 인하하면서 입력과 캐시 읽기 비용이 약 80% 낮아졌습니다. 두 번째는 Sol 라인업의 캐시 읽기 비용입니다. 2026년 6월 26일 출시된 GPT-5.6 Sol의 $0.50에서, 2026년 9월 29일 GPT-6.1 Sol의 $0.10로 내려가며 역시 80% 인하를 기록했죠. 다만 모델 자체가 5.6에서 6.1로 세대교체된 것이지, 동일한 SKU에 80% 할인 딱지를 붙인 것은 아닙니다.
| 날짜 | 변동 내역 (기록 기준) | 입력 / 출력 / 캐시 읽기 |
|---|---|---|
| 2026-06-26 | OpenAI, GPT-5.6 Sol 및 Luna 출시 | Sol $5 / $30 / $0.50 |
| 2026-06-30 | Anthropic, Sonnet 5 출시 (당시 출시가는 임시 프로모션가라고 명시) | $2 / $10 / $0.20 |
| 2026-07-24 | Anthropic, Opus 5 출시 | $5 / $25 / $0.50 |
| 2026-07-30 | GPT-5.6 Luna 가격 인하 | $0.20 / $1.20 / $0.02 |
| 2026-08-21 | GPT-5.6 Sol, 3개월간 약 20% 한시적 인하 | $4 / $20 / $0.40 |
| 2026-09-01 | Fable 5.1 출시, 6월의 Fable 5보다 캐시 읽기 비용 인하 | $10 / $50 / $0.25 |
| 2026-09-22 | 같은 날 GPT-6 Sol 및 Opus 5.5 동시 출시 | Sol $2 / $10 / $0.20; Opus 5.5 $4 / $20 / $0.20 |
| 2026-09-29 | GPT-6.1 Sol 출시, 캐시 읽기 비용 추가 절반 인하 | $2 / $10 / $0.10 |
위 표는 맥스 울프가 정리한 내용이며, 가격 열의 순서는 모두 ‘입력 / 출력 / 캐시 읽기’ 기준입니다. 제가 직접 공식 정보와 대조해 본 것은 마지막 두 줄의 현재 가격인데요. Opus 5.5의 $4 / $20 / $0.20는 Anthropic의 공식 가격표와 일치하며, GPT-6.1 Sol의 $2 / $10 / $0.10 역시 OpenAI의 표준 티어, 짧은 컨텍스트 기준과 일치합니다. 그 이전 내역은 공식 공지를 일일이 재확인하지 않았으므로, 인용하실 때는 원문을 참고하시기 바랍니다.
그는 Opus 5.5의 총비용이 40%~60% 절감되었다고도 덧붙였습니다. 공식 가격표에서 확인 가능한 세 가지 단가를 살펴보면, 기존 Opus 5 대비 입력과 출력이 각각 20% 인하($5 → $4, $25 → $20)되었고, 캐시 읽기는 $0.50에서 $0.20로 60% 인하되었습니다. 따라서 40%~60%라는 수치는 일반적인 사용 구조를 바탕으로 추정한 구간일 뿐, 공식적으로 제시된 일괄 할인율은 아닙니다. Anthropic 측은 “Opus 5.5의 추론 연산량이 Opus 5보다 적어졌으며, 이번 가격 책정은 이를 반영한 것”이라고 밝혔는데, 이는 제조사의 자체적인 설명입니다.
또한 그는 DeepSeek V4.1 Flash의 공식 API 기준 요금이 약 $0.15 / $0.60 / $0.003라고 언급했습니다. 이 수치는 공식 비수기(오프피크) 요금과 일치하며, 피크 시간대에는 두 배로 책정됩니다. Kimi K3.1 Pro의 경우 $2 / $10 / $0.20로 기재했는데, 이는 공식 웹사이트 안내와 같습니다. 본문에 언급된 Artificial Analysis 점수(Kimi 55점, Opus 5.5 58점, Flash 45점)는 서드파티 벤치마크 지수일 뿐, 실전 코딩 테스트 결과가 아니므로 모델을 도입할 때 단지 이 3점 차이에만 얽매이지는 마시길 권합니다.
기업 할인을 못 받는 소규모 팀은 모델을 어떻게 선택해야 할까요?
공식 가격표 외에도 대규모 고객에게만 주어지는 숨겨진 할인 혜택이 존재합니다. 2026년 10월 24일 자 AI Weekly가 The Information을 인용한 보도에 따르면, OpenAI가 30% 이상의 파격적인 할인을 제시하며 연간 1억 달러가 넘는 계약을 성사시켰고, 이에 따라 Replit은 대부분의 AI 지출을 Anthropic에서 OpenAI로 이전했다고 합니다. 보도에 따르면 Anthropic이 이전에 Replit에 제공하던 할인을 연장하지 않았다고 하네요. 물론 세 회사의 공식 확인이 담긴 내용은 아닙니다. Replit의 CEO인 Amjad Masad는 TechCrunch Disrupt에서 이번 결정이 비용, 파트너십, 성능에 기반한 것이라고 밝혔습니다. 같은 보도에서는 Claude 모델도 여전히 선택할 수 있지만, Agent의 기본 모델은 OpenAI가 되었다고 전했습니다. 아울러 Rippling의 코딩 관련 사용량 역시 Anthropic에서 OpenAI로 넘어갔으며, 그 이유를 비용 문제로 돌렸다고 언급했죠. 다만 이는 언론 보도일 뿐, 세 회사가 공동으로 공식 발표한 정규 가격표는 아닙니다.
소규모 팀은 이런 대형 계약을 맺을 수가 없습니다. 연간 1억 달러 수준의 약정이 없다면 보도에 나오는 30% 할인을 받아낼 방법이 없죠. 설령 30% 할인을 Opus의 캐시 읽기(Cache Read) 비용에 단순 적용해 $0.20에서 $0.14로 낮춘다 해도, 여전히 GPT-6.1 Sol의 짧은 컨텍스트 공개 가격인 $0.10보다 비쌉니다. 보도에서는 할인이 캐시 읽기, 캐시 미스, 혹은 총액 중 어디에 적용되었는지 명시하지 않았지만, 이 비교는 비용 체급의 차이를 분명하게 보여줍니다. 즉, 공개된 캐시 읽기 가격표만으로도 소규모 팀이 1차 선별을 진행하기엔 충분하다는 뜻입니다.
| 세션 특성 | 우선 고려할 모델 | 선정 이유 |
|---|---|---|
| 프롬프트 접두사(Prefix)가 안정적이고, 입력이 대개 272K 미만이며 폐쇄형 코딩 모델이 필요한 경우 | GPT-6.1 Sol | 캐시 읽기 $0.10로 세 모델 중 가장 저렴 |
| 단일 입력이 272K를 초과하는 경우 | $0.10 기준을 그대로 적용하지 말 것 | Sol 캐시 읽기 단가가 $0.20로 상승, 출력 단가도 $15로 상승 |
| 캐시 읽기 예산이 Opus와 동일하지만, 캐시 미스 및 출력 비용을 더 낮추고 싶은 경우 | Kimi K3.1 Pro | 캐시 읽기는 동일하게 $0.20이나, 입력/출력이 $2 / $10이며 구간별 할증이 없음 |
| 캐시 적중률이 높고, 피크 시간대를 피할 수 있는 작업인 경우 | DeepSeek V4.1 Flash (비피크 시간대) | 캐시 읽기 $0.003로, 청구 비용이 자릿수 단위로 절감됨 |
| 평일 베이징 시간 기준 9시~12시, 14시~18시(한국 시간 10시~13시, 15시~19시)에 반드시 실행해야 하는 경우 | Flash 피크 요금으로 재계산 | 캐시 읽기 $0.006로 상승하며, 나머지 단가도 2배 적용 |
| 매 턴마다 접두사가 계속 바뀌는 경우 | 접두사 구조부터 개선 | 캐시 읽기 단가 혜택을 전혀 활용할 수 없음 |
위 표에서는 모델의 성능 순위를 따로 매기지 않았습니다. Max Woolf는 더 비싼 Fable 5.1보다 Opus 5.5가 더 뛰어나다고 평가했는데, 이는 그의 주관적인 사용 경험에 따른 판단입니다. DeepSeek 공식 문서에 따르면 현재 deepseek-flash는 DeepSeek-V4.1-Flash-1017이 담당하고 있으며, 기존의 deepseek-v4-flash라는 이름도 여전히 유효하고 Flash 요금으로 청구됩니다. 한편 deepseek-v4-pro는 여전히 별도로 판매되고 있죠. 공식적으로 Flash와 Pro 사이의 성능 서열을 명시하지는 않았습니다. 작업 실패로 인한 비용이 토큰 가격 차이보다 크다면 고가의 검증된 모델을 쓰세요. 반대로 실패 비용이 가격 차이보다 작다면 저렴한 Flash 모델을 활용해 루프를 돌리는 편이 현명합니다.
💰 비용 최적화 팁: 카탈로그 가격은 기본 정가입니다. APIYI apiyi.com 콘솔에서는 소속 그룹에 따라 할인된 가격이 표시되며, 충전 프로모션 혜택은 별도로 적용됩니다. 세부 규정은 가격 페이지에 안내되어 있습니다. 이는 영업 담당자와 협상해야 하는 연간 계약이 아니라 누구나 확인하고 이용할 수 있는 공개 규칙입니다. 실제 차감 금액은 콘솔 표시 기준을 따릅니다.
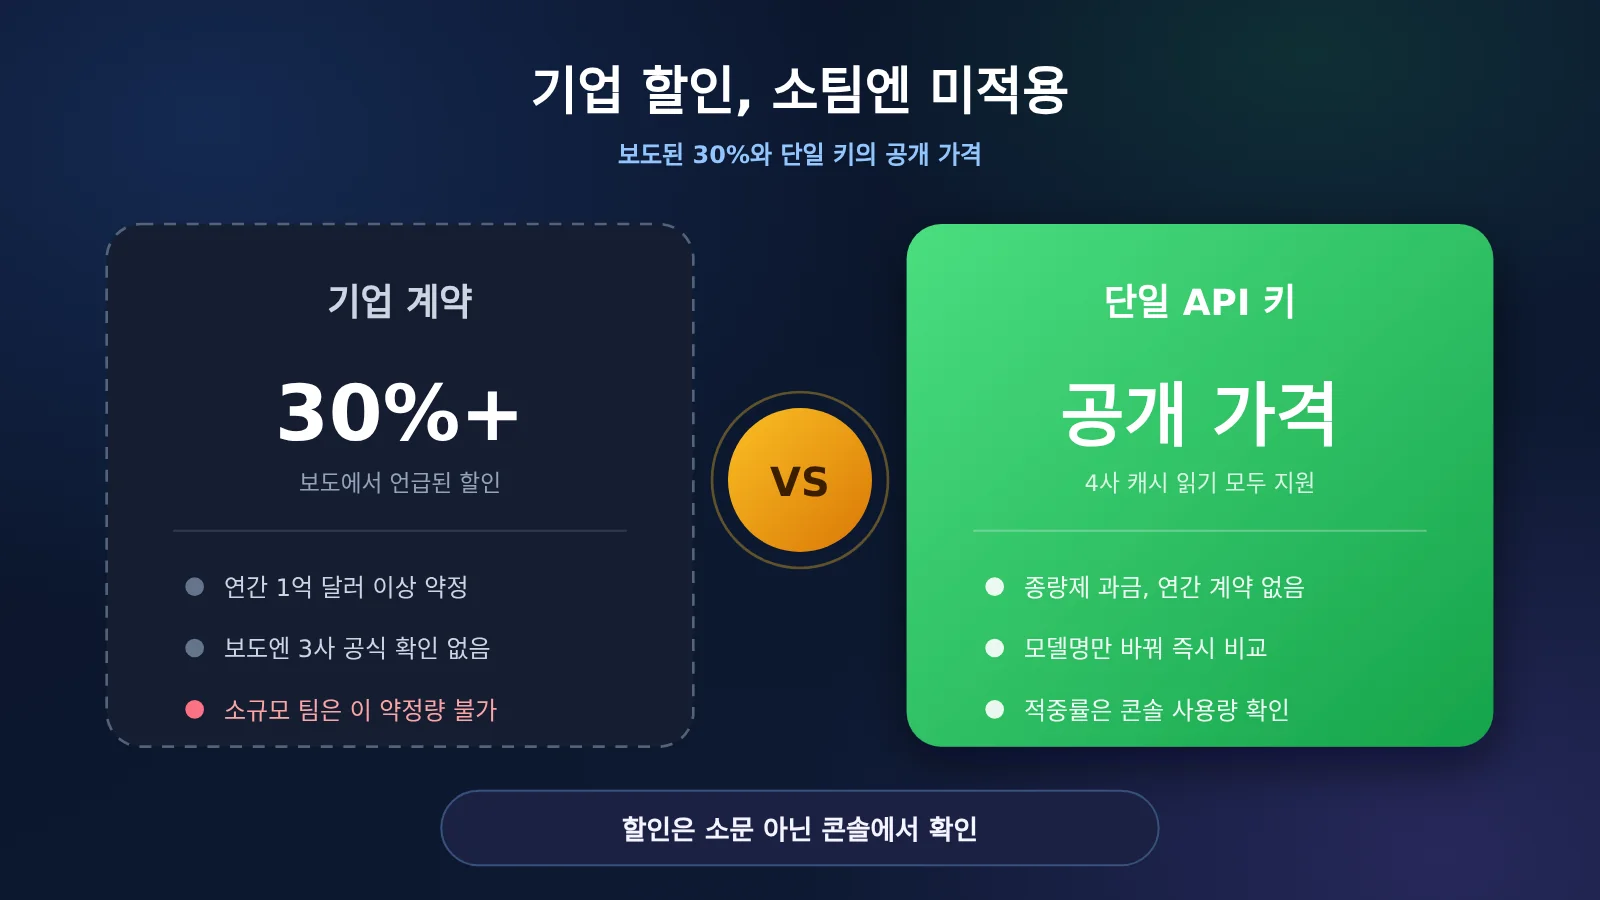
왼쪽의 30% 할인과 1억 달러 규모는 언론 보도에 나오는 이야기일 뿐, 우리가 실제로 결제할 수 있는 가격이 아닙니다. 오른쪽 경로야말로 소규모 팀이 현실적으로 실행할 수 있는 최적의 선택지입니다.
API 키 하나로 4개 사의 캐시 읽기를 확인하는 방법
가격 안내 페이지에서는 GPT-5 이후 모델의 경우 멀티턴 캐시 적중률을 높이기 위해 /v1/responses 엔드포인트를 우선 사용하는 것을 권장해요. 물론 Chat Completions도 여전히 사용할 수 있습니다. 아래 예제에서는 gpt-6.1-sol, kimi-k3.1-pro, deepseek-flash 호출 시 모델명만 바꿔서 바로 테스트할 수 있도록 Chat Completions 방식을 사용했어요.
다만 Opus 5.5의 캐싱은 이 경로에서 기본적으로 활성화되지 않아요. 현재 Anthropic 방식은 요청 최상위 레벨에 cache_control을 두거나 콘텐츠 블록에 중단점(breakpoint)을 설정해야 하거든요. APIYI는 claude-opus-5-5에 대해 chat과 messages 엔드포인트를 모두 제공해요. 캐시 할인가를 적용받으려면 messages 엔드포인트를 사용하고 cache_control을 함께 전달해야 합니다. Chat Completions만 사용하는 경우 가격표에 적힌 $0.20 할인가가 이미 적용되었다고 생각하시면 안 돼요.
- 기본 패키지 설치: 아직 SDK를 설치하지 않았다면 먼저
pip install openai를 실행해 주세요. 코드 시작 부분에는import os와from openai import OpenAI를 선언합니다. API 키는 코드 저장소에 커밋하지 말고 환경변수APIYI_API_KEY에 넣어두는 것이 안전해요. - 클라이언트 생성:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")한 줄이면 끝납니다. 기본 주소(base_url)는 여기 한 곳만 지정하면 돼요. - 고정 접두사 설정:
STABLE_PREFIX에는 시스템 프롬프트와 도구 정의처럼 글자 하나도 바뀌지 않는 고정 내용을 담고,user_turn에는 이번 턴에서 새로 추가된 동적 콘텐츠를 넣어 항상 마지막 메시지에 배치합니다. - 요청 전송:
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}])형태로 요청을 보냅니다. 여기서model값만kimi-k3.1-pro나deepseek-flash로 바꿔주면 다른 두 모델도 손쉽게 호출할 수 있어요. - 사용량 확인: 먼저
details = resp.usage.prompt_tokens_details를 가져온 뒤,cached = getattr(details, "cached_tokens", 0) or 0으로 캐시 토큰을 읽어옵니다. 마지막으로print(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens)를 실행하면 프롬프트 토큰, 캐시 적중 토큰, 출력 토큰 수를 순서대로 확인할 수 있어요.
여러 턴을 연속으로 실행한 다음, 캐시 적중 토큰 수를 전체 프롬프트 토큰 수로 나누면 여러분 환경의 실제 적중률이 나옵니다. 여기에 각 제공사의 캐시 읽기 단가를 곱해야 실제 비용이 정확히 계산돼요. Kimi 문서를 보면 캐시 요금은 환경 설정 기준 가격이며 실제 정산은 콘솔을 기준으로 한다고 안내되어 있습니다. DeepSeek의 할인 시간대(오프피크) 요금을 적용받고 싶다면, 모델명을 카탈로그에서 확인하여 deepseek-v4-1-flash-260910처럼 지정해야 해요. 일반 deepseek-flash가 시간에 맞춰 자동으로 단가를 낮춰줄 것이라 생각하면 안 됩니다.
API 키는 깃 저장소에 올리지 말고 반드시 APIYI_API_KEY 환경변수로 관리하세요. 제공되는 무료 테스트 크레딧은 동일한 접두사 프롬프트를 4개 모델에 각각 몇 번씩 돌려보며 토큰 사용량 구조를 가볍게 비교해보기에 딱 좋습니다. 세부 성능 검증이 더 필요할 때 점진적으로 호출 횟수를 늘리는 방식을 추천하며, 처음부터 방대한 양의 데이터를 4개 모델 전체에 무리해서 넣을 필요는 없어요.
캐시 읽기 비교 시 자주 묻는 질문 (FAQ)
Q1: 96%라는 수치는 캐시 읽기가 전체 청구 금액의 96%를 차지한다는 뜻인가요?
이 글의 결론은 그렇지 않습니다. Max Woolf가 작성한 글에서 캐시 읽기가 전체 토큰 소모의 96%–99%를 차지한다고 언급했지만, 명확한 기준 분모를 공개하지 않은 서드파티 추정치입니다. WorkloadBench에서 측정한 결과는 출력을 제외한 프롬프트 토큰의 89%–96% 수준이었습니다. 본문의 예시 가정을 기준으로 계산해 보면 토큰 비중은 약 97%이지만, 실제 금액 비중은 Opus와 Sol에서 약 47%, Kimi에서 약 65%, Flash에서는 약 30% 수준입니다.
Q2: Sol의 캐시 읽기 비용이 어떨 때는 $0.10이고, 어떨 때는 $0.20인 이유는 무엇인가요?
단일 요청의 입력 길이에 따라 달라집니다. 272K 토큰 이하일 때 OpenAI 표준 요금 기준 캐시 읽기는 $0.10입니다. 272K 토큰을 초과하면 $0.20로 올라가며, 동시에 캐시 미스 입력은 $4, 출력은 $15로 변경됩니다. APIYI 카탈로그에는 짧은 컨텍스트 기준인 $2 / $10 / $0.10로 표기되어 있으며, 272,000 토큰 초과 시 입력 비용이 $4로 변경된다는 점이 명시되어 있습니다. 긴 컨텍스트의 출력 및 캐시 읽기 요금은 OpenAI 표준 기준을 따르며, 콘솔에 구간별로 표시되는 경우 콘솔 화면을 기준으로 확인해 주세요.
Q3: DeepSeek은 왜 캐시 읽기 요금이 두 가지인가요?
공식 정책상 피크 시간대와 오프피크 시간대로 나누어 요금을 부과하며, 오프피크 요금은 피크 시간대의 절반 수준입니다. 오프피크 캐시 읽기는 $0.003, 피크 시간대는 $0.006입니다. 피크 시간대는 평일 베이징 시간 기준 09:00–12:00 및 14:00–18:00이며(공식 UTC 기준에서 환산, 중국 법정 공휴일 제외), 주말과 공휴일은 종일 오프피크가 적용됩니다. APIYI 카탈로그에서는 두 개의 모델 항목으로 나누어 각각의 요금을 안내하고 있습니다.
Q4: 기업 고객에게 제공되는 30% 할인은 소규모 팀도 신청할 수 있나요?
보도에 언급된 할인은 연간 1억 달러 이상의 대규모 계약에 묶여 있는 조건이며, 해당 3개 사의 공식적인 확인도 없는 상태입니다. 소규모 팀은 이러한 약정 규모를 맞추기 어렵죠. 따라서 공개된 캐시 읽기 단가를 비교하는 것만으로도 충분히 1차 모델 선정을 진행할 수 있습니다. 그룹별 할인 가격과 충전 프로모션 혜택은 APIYI 콘솔 기준을 따르며, 이를 대기업 할인 조건과 동일하게 볼 수는 없습니다.
Q5: API 키 하나로 4개 사 모델을 모두 연동하려면 어떻게 해야 하나요?
APIYI apiyi.com에서 API 키를 하나 발급받은 뒤, 엔드포인트 기본 주소를 `https://api.apiyi.com/v1`로 설정하면 됩니다. `gpt-6.1-sol`, `kimi-k3.1-pro`, `deepseek-flash`는 Chat Completions 형식을 지원하므로 모델명만 바꿔 호출하시면 됩니다. `claude-opus-5-5`에서 캐시 요금을 적용받으려면 `cache_control`을 포함한 `messages` 형식을 사용해야 합니다. GPT-5 이후 버전에서 멀티턴 캐시 적중률을 더 높이고 싶다면, 가격 가이드에 따라 `/v1/responses` 엔드포인트로 전환하는 것을 권장합니다.
Q6: 캐시 읽기가 저렴하다면 기본 모델을 무조건 Flash로 바꿔야 할까요?
실패로 인한 재시도 비용이 모델 간 가격 차이보다 적을 때만 권장합니다. 오프피크 기준 청구 금액은 Sol의 약 20분의 1 수준($0.0486 대 $1.02), 피크 시간대에는 약 10분의 1 수준입니다. 하지만 Flash가 동일한 작업을 완료하기 위해 여러 번의 턴을 추가로 돌아야 한다면, 늘어난 턴 수로 인해 절감한 비용이 상쇄될 수 있습니다. 먼저 무료 크레딧을 활용해 동일한 접두사(프롬프트) 환경에서 작업 완료 턴 수를 비교해 본 뒤 기본 모델을 결정해 보세요.
Q7: 캐시 쓰기 비용이 캐시 읽기보다 더 비싸질 수도 있나요?
접두사 캐시가 자주 만료되거나 캐시 적중 횟수가 매우 적다면 그럴 수 있습니다. Opus와 Sol의 단기 보관 쓰기 비용은 일반 입력 비용의 1.25배이며, Sol의 12시간 보관 구간은 2.5배에 달합니다. Kimi의 5분 보관 쓰기 비용은 일반 입력 요금과 같습니다. 보통 2~3턴 이상 캐시가 적중해야 비로소 캐시 읽기가 전체 비용 절감의 핵심 항목이 됩니다. 호출 간격이 불규칙한 작업이라면 먼저 적절한 TTL(유효 기간)을 선택한 뒤 캐시 읽기 비용을 비교하는 것이 좋습니다.
캐시 읽기 비교의 핵심 포인트
- 96%는 서드파티 추정치예요: Max Woolf는 원본 로그를 공개하지 않았습니다. 실제 달러 기준 비중은 단가를 직접 곱해서 계산해 보아야 해요.
- 캐시 읽기 단가를 먼저 보고, 구간 변동 여부를 확인하세요: Sol은 272K를 초과하면 캐시 읽기 비용이 $0.10에서 $0.20로 올라갑니다.
- Opus와 Kimi의 캐시 읽기 비용은 모두 $0.20로 동일해요: 다만 Kimi는 캐시 미스와 출력 단가가 더 저렴하며, 짧은 컨텍스트 구간에서 쓰기 할증이 없습니다.
- Flash의 강점은 자릿수가 다른 가격대입니다: 비피크 시간대 $0.003, 피크 시간대 $0.006 수준이라 전체 비용 구조를 캐시 읽기가 독점하지 않아요.
- 기업용 30% 할인은 소규모 팀에 해당하지 않습니다: 보도된 수치는 연간 계약 기준이에요. 공개된 정가만으로도 1차 모델 선택을 내리기에는 충분합니다.
- API 키 하나로 4개 모델을 모두 연결할 수 있어요: APIYI(apiyi.com)에서 모델 이름만 변경해 테스트해 보세요. 실제 캐시 히트율은 콘솔 사용량을 기준으로 확인하시는 것이 가장 정확합니다.
요약
최근 4개월간 공개 인하율은 최대 80%에 달했으며, 주로 Luna의 정가 인하와 Sol 라인업의 캐시 읽기 단가가 $0.50에서 $0.10로 내려간 것이 핵심이었습니다. 코딩 에이전트를 구축할 때는 여전히 캐시 읽기 비용을 별도로 떼어놓고 계산해야 해요. 2026-10-26 공식 가격 기준, 짧은 컨텍스트에서 GPT-6.1 Sol의 캐시 읽기 비용은 $0.10, Opus 5.5와 Kimi K3.1 Pro는 $0.20, DeepSeek V4.1 Flash는 비피크 시간대 $0.003, 피크 시간대 $0.006입니다. 96%~99%라는 수치는 Max Woolf의 견해로만 참고하는 것이 좋습니다. 예시 청구서에서 토큰 비율은 이 범위에 근접할 수 있지만, 실제 달러 기준 비용 절감 폭은 그보다 낮게 나타납니다.
언론에 보도된 기업 할인율은 연간 약정이 필요하므로 소규모 팀에서는 적용받기 어렵습니다. 30% 할인 계약을 기다리기보다는 단일 API 키에 4개사를 연동한 뒤, 자체 히트율에 공개 캐시 읽기 단가를 곱해 계산하는 방식이 훨씬 현실적이에요. APIYI(apiyi.com)에서 동일한 고정 접두사를 먼저 테스트해 본 뒤 기본 모델을 결정해 보시는 것을 추천합니다.
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지를 통해 언제든 문의해 주세요. 모델별 상세 단가는 docs.apiyi.com 문서 센터의 모델 가격 페이지를 기준으로 적용됩니다.
참고 자료
- Max Woolf, 가격 인하 타임라인과 96%~99% 추정치
- 링크:
minimaxir.com/2026/10/cheap-llms -
설명: 2026-10-25. 96%~99% 수치는 원작자의 자체 주장이며, 본문에서 직접 실측한 값은 아닙니다.
-
Anthropic 모델 가격 정책
- 링크:
platform.claude.com/docs/en/about-claude/pricing -
설명: Opus 5.5의 입력, 출력, 캐시 읽기 및 2단계 캐시 쓰기 비용입니다.
-
OpenAI 모델 가격 정책
- 링크:
developers.openai.com/api/docs/pricing -
설명: GPT-6.1 Sol의 짧은 컨텍스트, 긴 컨텍스트, 캐시 읽기 및 쓰기 비용입니다. 272K 토큰이 공식적인 짧은/긴 컨텍스트의 구분 기준입니다.
-
DeepSeek 모델 가격 정책
- 링크:
api-docs.deepseek.com/quick_start/pricing -
설명:
deepseek-flash의 피크/오프피크 시간대 캐시 히트, 미스 및 출력 비용입니다. -
Kimi API
- 링크:
platform.kimi.ai -
설명: Kimi K3.1 Pro의 입력, 출력, 캐시 히트 및 기본 쓰기 비용입니다.
-
AI Weekly의 Replit 계약 관련 보도
- 링크:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
설명: 30% 이상의 할인 및 연간 1억 달러 이상의 지출 규모는 The Information의 보도를 인용한 내용이며, 세부 조항은 관련 3사가 공식적으로 확인해 주지 않았습니다.
-
WorkloadBench의 캐시 토큰 비중
- 링크:
workloadbench.brenhq.com/cache - 설명: 2026-10-16. 프롬프트 토큰 중 캐시에서 불러온 비율 기준이며, 금액(달러) 기준 비중이 아닙니다.