작성자 주: 이 글은 2026-10-24에 확인한 공식 가격표를 바탕으로 Kimi K3.1 Pro의 5개 가격 구간과 캐시 요금, 요청 제한 등급을 분석하고, 실제 요청 비용을 계산해 볼 수 있는 예시 3가지를 소개해요.
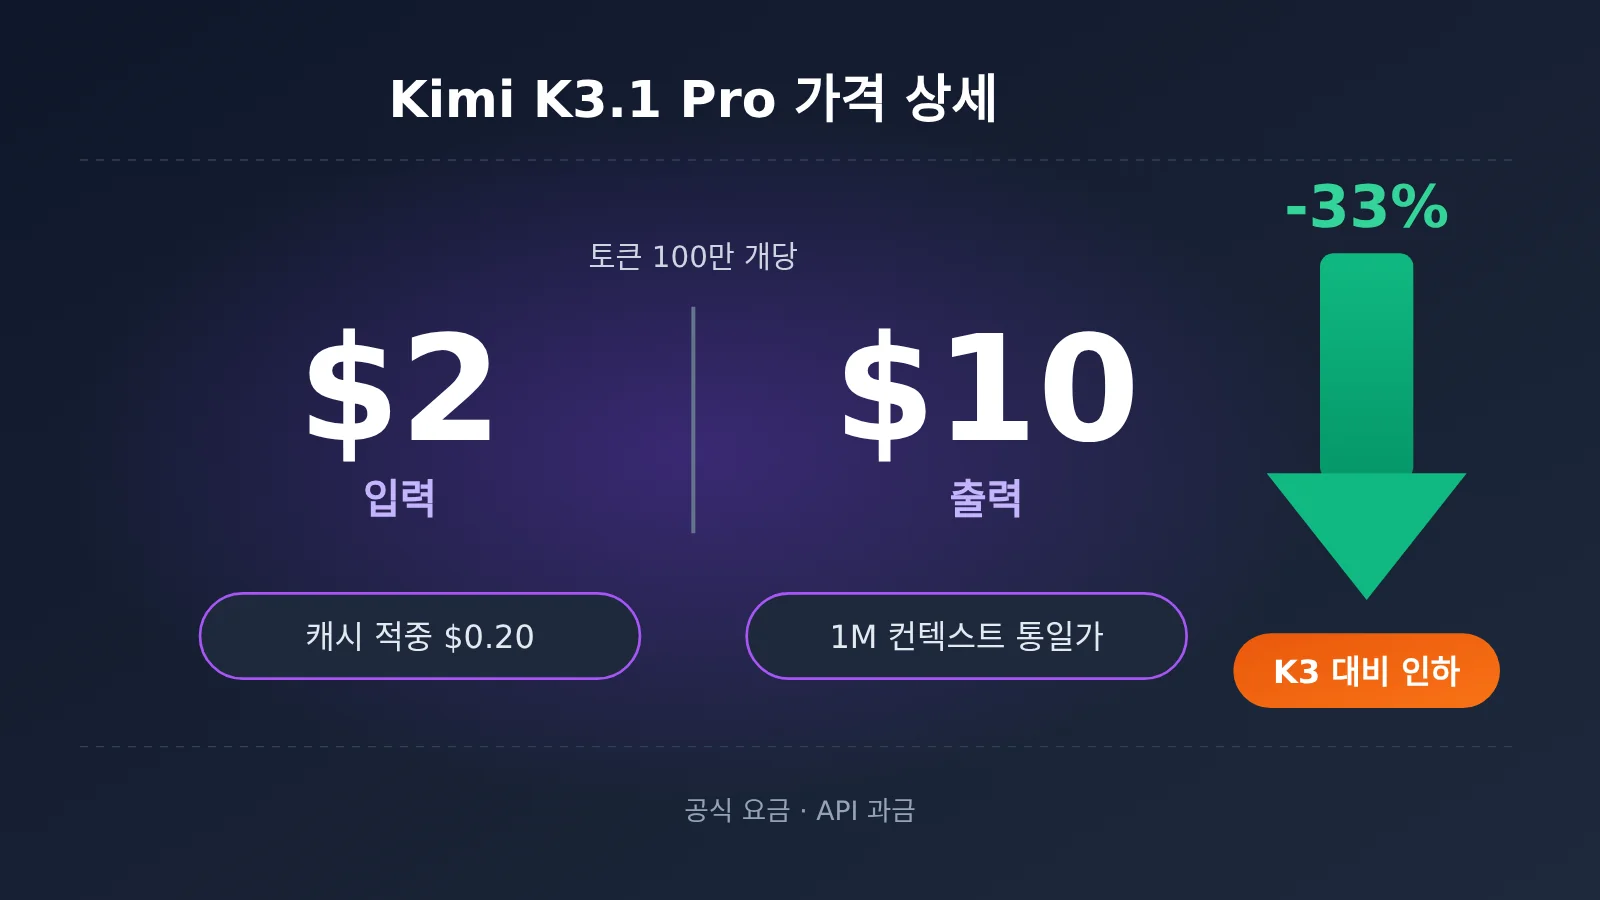
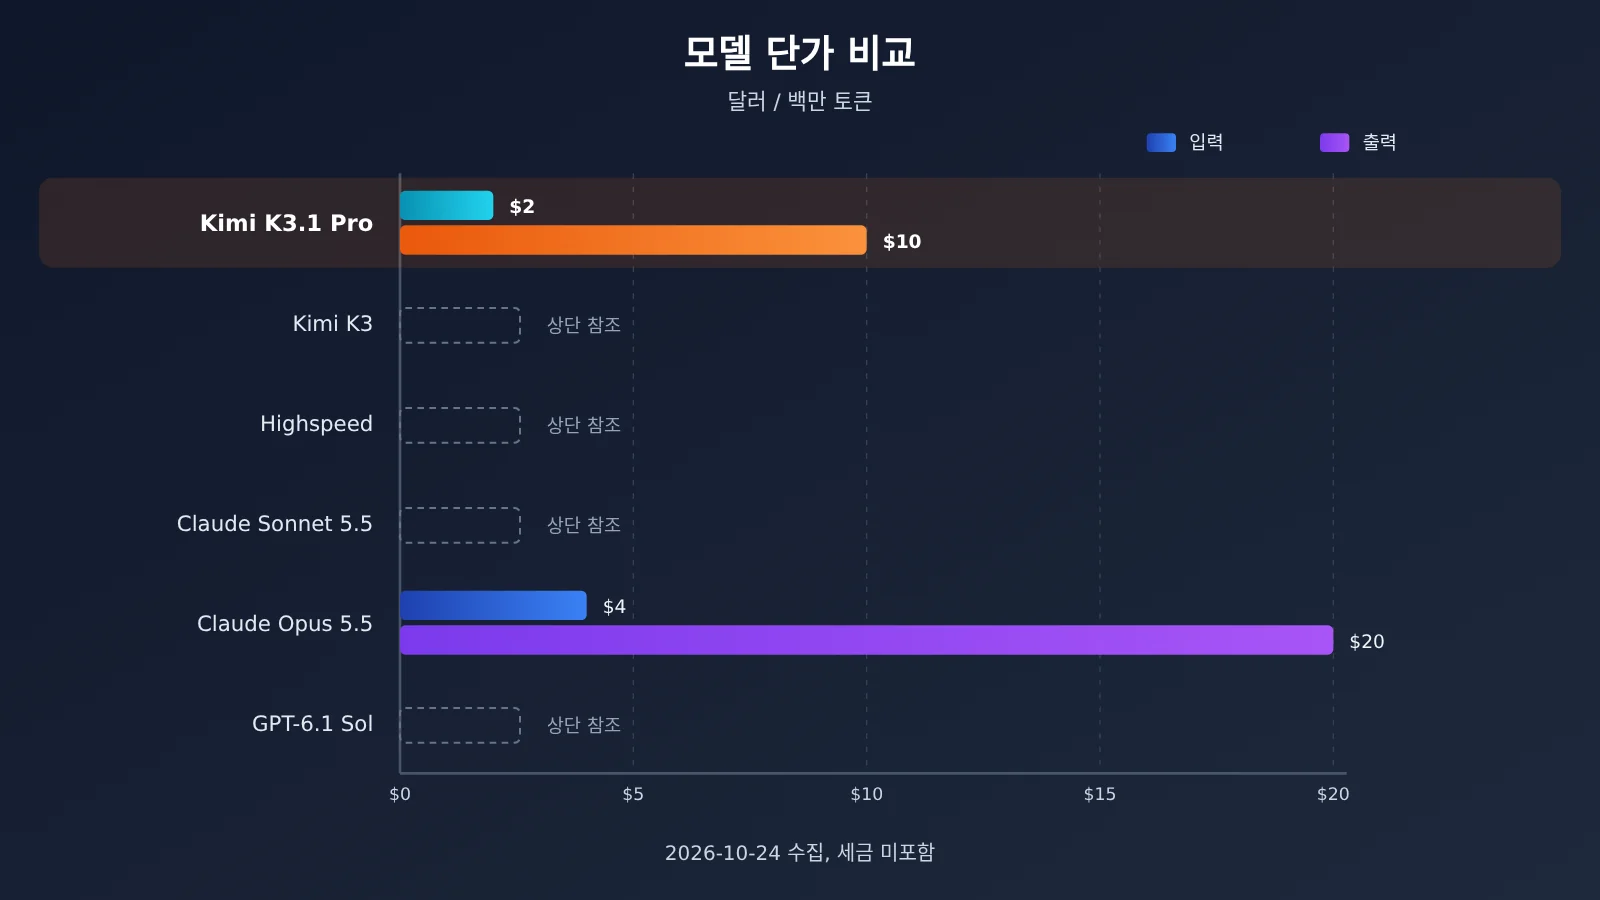
Kimi K3.1 Pro의 공식 가격은 입력 $2, 출력 $10, 캐시 적중 시 $0.20이에요(단위: 토큰 100만 개당, 달러). 이전 세대인 Kimi K3보다 33% 저렴한 가격이에요. Claude Sonnet 5.5, GPT-6.1 Sol과 가격이 같고, Claude Opus 5.5의 절반 수준이에요.
이 결론은 Moonshot 공식 가격 페이지(platform.kimi.ai의 pricing 문서)와 외부 기관 Artificial Analysis의 비용 계산 데이터를 바탕으로 내렸어요. 글에 나오는 모든 수치에는 출처 등급을 표시해요. ‘공식’은 Moonshot 블로그나 공식 문서에서 직접 밝힌 수치, ‘제3자’는 Artificial Analysis 등 외부 기관의 추정치를 뜻해요. 신뢰할 만한 출처를 찾지 못한 경우에는 ‘미확인’으로 표시해요.
단순히 가격표만 옮겨 적은 글이 아니에요. 단가가 33% 낮아졌다고 해서 청구 금액도 반드시 33% 줄어드는 건 아니에요. 비용이 절약되는 경우와 그렇지 않은 경우를 모두 살펴볼게요.
핵심 내용: 이 글을 읽고 나면 Kimi K3.1 Pro 요청 1회의 비용을 직접 계산하고, 어떤 상황에서 캐시를 켜야 하는지, 언제 요청 제한 등급을 미리 올려야 하는지 알 수 있어요. 국내 개발자의 결제 및 연동 방법도 함께 알아봐요.
1. Kimi K3.1 Pro 가격 핵심 요점
먼저 가장 자주 묻는 내용을 표로 정리하고, 각 항목은 뒤에서 자세히 살펴볼게요.
| 핵심 항목 | 설명 | 출처 | 의미 |
|---|---|---|---|
| 기본 단가 | 입력 $2 / 출력 $10 / 캐시 적중 $0.20 | 공식 | Sonnet 5.5, GPT-6.1 Sol과 같은 가격대예요 |
| 이전 세대와 비교 | 세 항목 모두 K3보다 33% 저렴해요 | 공식 / 제3자 | 단가가 눈에 띄게 낮아졌어요 |
| 컨텍스트 | 1,048,576 tokens, 구간별 차등 없이 단일 단가 적용 | 공식 | 문서가 길어져도 길이 때문에 가격이 오르지 않아요 |
| 작업당 비용 | 약 $1.98(게시물 작성) / $2.11(모델 페이지) | 제3자 | K3와 거의 비슷해, 단가 인하율만큼 줄지는 않았어요 |
| 시작 조건 | 최소 $1 충전, Tier 0은 분당 요청 3회(RPM) | 공식 | 본격적으로 사용량을 늘리기 전에 먼저 등급을 올려야 해요 |
뒤에서 반복해서 나오는 두 가지 용어를 먼저 설명할게요. 토큰(token)은 모델 과금의 최소 단위로, ‘단어 조각’이라고 생각하면 돼요. 공식 안내에 따르면 영어는 대략 3~4자당 토큰 1개로 계산돼요. 백만 토큰(MTok)은 토큰 1,000,000개를 뜻해요. 요금표의 $2는 입력 토큰 백만 개를 처리할 때 $2가 든다는 의미예요.
1.1 Kimi K3.1 Pro의 과금 항목은 무엇인가요?
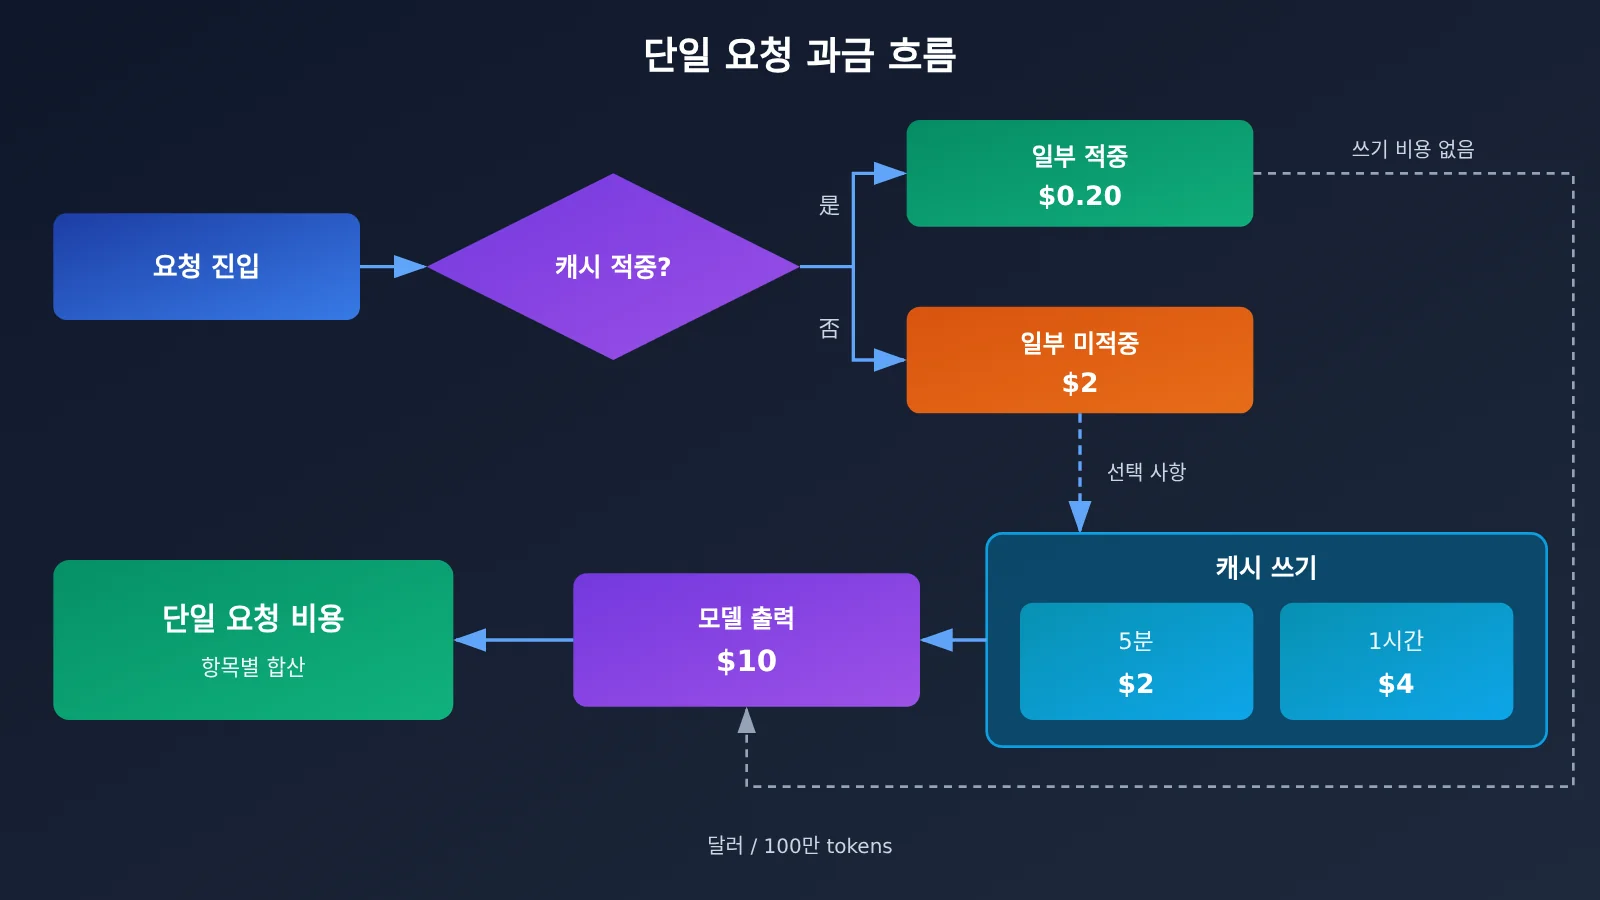
공식 문서에서 안내하는 과금 항목은 총 세 가지예요. 캐시 쓰기(5분 및 1시간 두 가지), 입력(캐시 적중 및 미적중), 출력이에요. 이를 나누면 요금표의 가격 항목 다섯 가지가 되고, 요청 한 번의 비용은 각 항목의 토큰 수에 해당 단가를 곱해 모두 더한 금액이에요.
이번 가격 정책에서 특히 주목할 부분은 컨텍스트 캐시예요. 연속된 여러 요청의 앞부분이 완전히 같으면(예: 긴 시스템 프롬프트가 동일한 경우), 플랫폼이 해당 내용을 저장해 다음 요청에서 재사용해요. 재사용된 부분에는 훨씬 저렴한 ‘캐시 적중 단가’가 적용돼요. 공식 안내에 따르면 Kimi API는 반복되는 요청 접두부에 캐시 과금을 자동으로 적용하며, 기본 TTL은 5분이에요. TTL은 ‘캐시가 얼마나 오래 유지되는지’를 뜻해요.
공식 문서에 나와 있지만 놓치기 쉬운 규칙도 있어요. K3 시리즈는 캐시 적중 시 적중 단가만 과금하고, 별도의 캐시 쓰기 요금은 부과하지 않아요. 파일 관련 API(문서 내용 추출, 파일 저장)는 현재 무료지만, 추출한 내용을 모델에 입력하면 토큰 기준으로 과금돼요. 요금표는 세금 별도이며, 최종 결제 금액은 결제 지역의 규정에 따라 정해져요.
2. Kimi K3.1 Pro 전체 가격표: 다섯 가지 요금 한눈에 보기
아래 표에서 현재 Kimi의 주요 모델 다섯 가지 요금을 한눈에 비교할 수 있어요. ‘미기재’는 공식 가격 페이지에 해당 항목의 가격이 없다는 뜻이며, 무료라는 의미는 아니에요.
| 모델 | 입력(캐시 미적중) | 출력 | 캐시 적중 입력 | 캐시 쓰기 5분 | 캐시 쓰기 1시간 |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3(이전 세대) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | 미기재 | 미기재 |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | 미기재 | 미기재 |
참고: 2026-10-24에 수집한 데이터이며, 단위는 토큰 100만 개당 달러입니다. 가격에는 세금이 포함되지 않습니다. 출처: 공식 가격 페이지.
표에서 몇 가지 특징을 확인할 수 있어요. 첫째, K3.1 Pro의 5분 캐시 쓰기 요금은 일반 입력 요금과 같은 $2이므로, 5분 캐시를 사용해도 추가 비용이 거의 없어요. 1시간 캐시 쓰기 요금은 $4로 입력 요금의 2배예요. 둘째, Highspeed 버전은 캐시 적중 요금이 $0.20으로 동일한 점을 제외하면 모든 항목의 요금이 표준 버전의 2배예요. 따라서 긴 프롬프트를 재사용하는 경우 두 버전의 비용 차이가 줄어들어요. 셋째, K2.7 Code와 K2.6의 단가는 K3.1 Pro의 절반에도 못 미쳐요. 최고 수준의 추론 능력이 필요하지 않은 작업이라면 여전히 더 저렴한 선택지예요.
2.1 Kimi K3.1 Pro와 동급 모델 비교
같은 기준(백만 토큰당 달러)으로 주요 모델의 가격을 비교하면 K3.1 Pro의 위치가 더 분명해져요.
| 모델 | 입력 / 출력 | 캐시 적중 입력 | 캐시 쓰기 · 단기 | 캐시 쓰기 · 장기 | 출처 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2(5분) | $4(1시간) | 공식 |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4(5분) | $8(1시간) | 공식 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50(5분) | $4(1시간) | 공식 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5(5분) | $8(1시간) | 공식 |
| GPT-6.1 Sol(입력 ≤272K) | $2 / $10 | $0.10 | $2.50(30분) | $5(12시간) | 공식 |
| GPT-6.1 Sol(입력 >272K) | $4 / $15 | $0.20 | $5(30분) | $10(12시간) | 공식 |
| GPT-6 Astra(입력 ≤272K) | $10 / $50 | $1.00 | $12.50(30분) | $25(12시간) | 공식 |
| GPT-6 Astra(입력 >272K) | $20 / $75 | $2.00 | $25(30분) | $50(12시간) | 공식 |
표의 데이터는 각 업체의 공식 가격 페이지를 기준으로 2026-10-24에 수집했으며, 단위는 백만 토큰당 달러이고 세금은 포함하지 않아요. 업체별 캐시 보관 시간은 달라요. Kimi와 Claude는 5분 / 1시간, OpenAI는 30분 / 12시간이며, 캐시 쓰기 가격은 미캐시 입력 가격의 각각 1.25배와 2.5배예요. 캐시 읽기 가격은 대부분 입력 가격의 10%이고, GPT-6.1 Sol만 5%예요. OpenAI는 입력 길이에 따라서도 가격을 구분해요. 272K 토큰 이하는 단문맥 가격이 적용되고, 272K 토큰을 초과하면 장문맥 가격이 적용돼요. 표에는 표준 요금제만 담았어요. OpenAI의 반값 Batch 요금과 더 비싼 Fast(기존 Priority), UltraFast 요금은 제외했어요.
비교해 보면 Claude Sonnet 5.5와 GPT-6.1 Sol은 캐시 적중 가격이 더 낮아요(둘 다 $0.10). 긴 프리픽스를 자주 재사용하는 상황에서는 두 모델이 더 유리하죠. 다만 Sonnet 5.5의 5분 캐시 쓰기 가격은 $2.50으로, K3.1 Pro의 $2보다 조금 높아요. 반면 K3.1 Pro는 ‘저렴한 캐시 쓰기’와 ‘일관된 컨텍스트 단가’가 장점이라, 큰 문서를 한 번에 입력하는 작업에 더 적합해요. Claude Opus 5.5는 입력과 출력 가격이 모두 K3.1 Pro의 두 배예요. 따라서 이 모델을 선택하는 이유는 가격보다 필요한 성능이어야 해요. GPT-6.1 Sol은 캐시 쓰기 가격이 상대적으로 높다는 점이 아쉬워요. 30분 캐시 쓰기 가격이 $2.50으로 K3.1 Pro의 5분 요금인 $2보다 비싸고, 입력 길이에 따라 요금도 달라져요. 272K 토큰을 초과하면 입력은 $4, 출력은 $15로 올라가므로 긴 문서 작업에는 장문맥 요금을 기준으로 계산해야 해요.
선택 가이드: 동급 모델의 실제 성능 차이는 작업에 따라 달라요. 같은 프롬프트를 사용해 각 모델을 테스트한 뒤 선택하는 것을 권장해요. APIYI(apiyi.com)의 모델 목록에는 claude-sonnet-5-5, claude-opus-5-5, kimi-k3 등의 모델이 있어 하나의 API 키로 비교 테스트를 진행할 수 있어요. K3.1 Pro의 정확한 모델명과 가격은 플랫폼의 모델 목록을 확인해 주세요. 해당 모델은 가능한 한 빨리 제공할 예정이에요.
3. Kimi K3.1 Pro 요청 1회 비용은 얼마일까요? 계산 예시 3가지
가격표를 이해하고 나면 가장 궁금한 건 “이번 호출에 얼마가 들까?”일 거예요. 아래 예시는 짧은 대화, 긴 프롬프트 재사용, 긴 문서 읽기라는 세 가지 일반적인 상황을 다뤄요. 계산식도 함께 적어 두었으니, 실제 token 수를 대입해 보세요. 기본 공식은 다음과 같아요. 비용 = token 수 × 단가 ÷ 1,000,000.
3.1 예시 1: Kimi K3.1 Pro 짧은 요청 비용
상황: 일반적인 질의응답으로, 입력은 2,000 tokens(캐시에 적중하지 않음), 출력은 500 tokens예요.
- 입력:
2000 × 2 ÷ 1000000 = $0.004 - 출력:
500 × 10 ÷ 1000000 = $0.005 - 합계:
$0.004 + $0.005 = $0.009
이 정도의 짧은 대화는 한 번 요청하는 데 1센트도 들지 않아요. 다만 출력 단가는 입력의 5배예요. 짧은 요청에서는 출력이 전체 비용의 절반 이상을 차지하는 경우가 많으므로, 입력을 줄이기보다 출력 길이를 조절하는 편이 더 효과적이에요.
3.2 예시 2: Kimi K3.1 Pro 긴 프롬프트 재사용과 캐시
상황: 시스템 프롬프트가 20,000 tokens이고, 5분 안에 질문 10개를 연속으로 하며 매번 새 입력 1,000 tokens와 출력 800 tokens가 추가돼요.
캐시를 사용하지 않으면 매 요청마다 프롬프트 전체에 정가를 내야 해요.
- 1회 요청:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - 10회 요청:
$0.05 × 10 = $0.50
캐시를 사용하면 첫 번째 요청에서 시스템 프롬프트를 캐시에 기록하고, 이후 9회는 캐시를 바로 적중해요.
- 첫 번째 요청: 기록 비용
20000 × 2 ÷ 1000000 = $0.04에 새 입력$0.002, 출력$0.008을 더해 총$0.05 - 2~10회 요청: 매회 캐시 적중 비용
20000 × 0.2 ÷ 1000000 = $0.004에$0.002 + $0.008을 더해 총$0.014 - 이후 9회 합계:
$0.014 × 9 = $0.126 - 전체 합계:
$0.05 + $0.126 ≈ $0.18
같은 대화를 10번 해도 비용은 $0.50에서 약 $0.18로 줄어들어, 약 60%를 절약할 수 있어요. 고정된 긴 프롬프트에 여러 차례 질문을 이어가는 방식은 고객 지원 챗봇, 코드 어시스턴트, 에이전트 프레임워크에서 흔히 볼 수 있어요. 캐시의 효과가 가장 큰 유형이기도 해요.
3.3 예시 3: Kimi K3.1 Pro 긴 문서 읽기
상황: 300,000 tokens 분량의 문서를 한 번 읽고, 3,000 tokens 분량의 요약을 출력해요.
- 입력:
300000 × 2 ÷ 1000000 = $0.60 - 출력:
3000 × 10 ÷ 1000000 = $0.03 - 합계: 약
$0.63
5분 안에 같은 문서에 관해 질문을 하나 더 하면 문서 부분은 캐시에 적중해요. 입력 비용은 300000 × 0.2 ÷ 1000000 = $0.06만 들고, 여기에 이번 출력 비용을 더하면 돼요. 같은 계약서, 재무 보고서, 코드베이스에 관해 여러 번 질문하는 경우라면 캐시 유효 시간 안에 질문을 모아서 하면 비용을 크게 줄일 수 있어요.
4. Kimi K3.1 Pro의 1M 컨텍스트 단일 요금: 요금 구간이 없다는 건 무슨 의미일까요?
컨텍스트는 “모델이 한 번에 볼 수 있는 전체 내용”이라고 이해하면 돼요. 프롬프트, 이전 대화, 업로드한 문서가 모두 포함됩니다. 공식 문서에 따르면 K3 시리즈는 모두 1,048,576토큰 컨텍스트를 지원하며, K3.1 Pro는 컨텍스트 길이에 따라 요금 구간을 나누지 않고 사용량에 따라 단일 요금을 적용해요.
공식 FAQ의 설명을 요약하면, K3.1 Pro는 1M 컨텍스트를 지원하고 사용량에 따라 단일 요금을 적용해요. 캐시 쓰기, 입력(캐시 적중·미적중), 출력 모두 같은 단가로 계산됩니다. 즉, 2,000토큰을 보내든 800,000토큰을 보내든 100만 토큰당 요금은 동일한 2달러예요. 요청이 길어진다고 더 비싼 요금이 적용되지는 않습니다.
비교할 때 이 점이 중요한 이유는 모든 업체가 같은 방식으로 요금을 계산하는 건 아니기 때문이에요. OpenAI의 GPT-6 시리즈는 입력 길이에 따라 요금 구간을 나눕니다. 272K토큰 이하는 짧은 컨텍스트 요금이 적용되고, 272K토큰을 넘으면 곧바로 더 비싼 긴 컨텍스트 요금이 적용돼요. 예를 들어 GPT-6 Astra는 입력 요금이 10달러에서 20달러로, 출력 요금은 50달러에서 75달러로 오르고, 캐시 적중 요금도 1달러에서 2달러로 올라갑니다. Claude는 다른 방식을 사용해요. 공식 요금 페이지에 따르면 Claude Haiku 5.5를 제외한 Claude 4.6 이후 모델은 1M 컨텍스트 전체에 표준 요금을 적용합니다. 따라서 90만 토큰 요청과 9천 토큰 요청의 단가가 같아요. Claude Haiku 5.5만 프롬프트가 10만 토큰을 넘으면 요금이 올라갑니다. 그러니 K3.1 Pro의 ‘요금 구간 없음’이 특별한 사례는 아니에요. Claude Sonnet 5.5와 Opus 5.5도 길이에 따라 추가 요금을 부과하지 않고, 실제로 요금 구간이 바뀌는 모델은 GPT-6 시리즈입니다.
개발자에게 단일 요금은 두 가지 직접적인 이점을 제공합니다.
- 예산을 선형적으로 추산할 수 있어요: 토큰 수가 두 배가 되면 비용도 두 배가 됩니다. 특정 길이를 넘었다고 요금이 갑자기 뛰지 않으니, 예시 3의 30만 토큰 문서도 단가를 곱해 간단히 계산할 수 있어요.
- 문서를 일부러 나눌 필요가 없어요: 요금 구간을 나누는 모델에서는 비싼 구간을 피하려고 긴 문서를 여러 부분으로 나누기도 해요. 하지만 K3.1 Pro에서는 그렇게 해도 비용을 아낄 수 없고, 오히려 컨텍스트가 끊겨 결과가 나빠질 수 있습니다.
5. Kimi K3.1 Pro는 어디서 비용을 아끼고, 어디서는 그렇지 않을까요?
이번에는 비용을 조금 더 현실적으로 따져볼게요. 단가는 실제로 낮아졌지만, 실제 작업 비용은 출력 길이에도 영향을 받아요.
| 항목 | 구체적인 내용 | 출처 | 비용 영향 |
|---|---|---|---|
| 단가 인하 | 입력, 출력, 캐시 적중 가격이 모두 K3보다 33% 낮음 | 공식 / 제3자 | 비용 절감 |
| 캐시 적중 가격 | $0.20으로, 입력 가격의 1/10 | 공식 | 긴 프롬프트를 재사용하는 상황에서 큰 폭으로 절감 |
| 1시간 캐시 쓰기 | $4로, 입력 가격의 2배 | 공식 | 호출 간격이 긴 작업에는 더 유리하고, 짧은 작업에는 불필요 |
| 항상 추론 | 추론을 끌 수 없으며, 평균 출력은 55K tokens로 K3보다 14% 많음 | 공식 / 제3자 | 단가 인하 효과 일부 상쇄 |
| 작업당 비용 | $1.98(게시된 글 기준) / $2.11(모델 페이지의 가중 평균 기준) | 제3자 | K3와 거의 비슷 |
5.1 Kimi K3.1 Pro로 비용을 아낄 수 있는 세 가지 이유
첫째, 단가가 33% 낮아졌어요. K3의 $3/$15에서 $2/$10으로 내려갔고, 캐시 적중 가격도 $0.30에서 $0.20으로 낮아졌어요. 이 수치는 공식 가격표와 Artificial Analysis의 데이터가 일치해요. 둘째, 캐시 적중 가격은 입력 가격의 1/10에 불과해요. 예시 2에서 계산해 봤듯이, 고정된 긴 프롬프트를 사용하는 멀티턴 대화에서는 약 60%를 절약할 수 있어요. 셋째, 1시간 캐시 쓰기는 가격이 2배지만 캐시를 더 오래 유지할 수 있어요. 두 번의 호출 간격이 5분을 넘는 작업, 예를 들어 10여 분 간격으로 실행되는 예약형 에이전트나 사용자가 잠시 생각한 뒤 추가 질문을 하는 장문 문서 질의응답에 적합해요. 1시간 안에 두 번 이상 캐시가 적중하면, 추가로 지불한 쓰기 비용을 대개 회수할 수 있어요.
5.2 Kimi K3.1 Pro로 비용을 아끼기 어려운 부분
추론은 모델이 답변을 내놓기 전에 내부적으로 먼저 검토하는 과정이에요. 이 과정에서 생성되는 내용도 출력으로 계산되어 요금이 부과돼요. 공식 문서에 따르면 K3.1 Pro는 추론을 끌 수 없고, reasoning_effort를 low로 설정해 추론량을 줄이는 방법만 사용할 수 있어요.
Artificial Analysis의 측정 결과에 따르면 K3.1 Pro는 Intelligence Index의 작업당 평균 출력량이 약 55K tokens로, K3의 48K보다 14% 많아요. 출력 단가는 가장 비싼 항목이라 추가된 토큰이 단가 인하 효과를 일부 상쇄해요. 그 결과 제3자가 계산한 작업당 비용은 약 $1.98(게시된 글 기준)이고, 모델 페이지에 표시된 가중 작업당 비용은 $2.11(캐시 할인율 90% 적용 기준)로, K3와 거의 비슷해요.
결론적으로 긴 입력과 멀티턴 재사용이 많은 업무라면 K3.1 Pro의 가격 인하가 청구서에 뚜렷하게 반영돼요. 반면 복잡한 추론이나 출력이 긴 작업이 대부분이라면 작업당 비용이 K3보다 낮지 않을 수도 있어요. 먼저 실제 작업으로 소규모 테스트를 진행한 뒤, 실제 청구 금액을 확인해 보세요.
6. Kimi K3.1 Pro 충전 기준과 요청 제한 등급
공식 요금은 사용량에 따라 부과되며, 구독 요금제는 없어요. Kimi API와 Kimi 멤버십, Kimi Code는 서로 별도의 과금 체계로 운영되므로 멤버십으로 API 비용을 결제할 수는 없어요. API를 호출하려면 계정에 최소 $1을 충전해야 해요. 누적 충전액이 $5에 도달하면 $5 상당의 쿠폰을 받을 수 있지만, 이 쿠폰은 누적 충전액에 포함되지 않아요(공식 안내).
요청 제한 등급은 누적 충전액에 따라 달라져요. 먼저 몇 가지 약어를 설명할게요. 동시 요청 수는 같은 시점에 동시에 처리할 수 있는 요청 수이고, RPM은 분당 최대 요청 수, TPM은 분당 최대 처리 토큰 수, TPD는 하루 최대 처리 토큰 수예요.
| 등급 | 누적 충전액 | 동시 요청 수 | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 50만 | 150만 |
| Tier1 | $10 | 15 | 100 | 200만 | 제한 없음 |
| Tier2 | $20 | 40 | 100 | 300만 | 제한 없음 |
| Tier3 | $100 | 50 | 200 | 300만 | 제한 없음 |
| Tier4 | $1000 | 60 | 200 | 400만 | 제한 없음 |
| Tier5 | $3000 | 100 | 300 | 500만 | 제한 없음 |
참고: 공식 요청 제한 문서(platform.kimi.ai의 pricing/limits 페이지)를 출처로 하며, 2026-10-24에 확인했어요.
Tier0의 제한은 상당히 엄격해요. 분당 요청은 3회, 하루 총 처리량은 150만 토큰이에요. 예시 3의 30만 토큰 문서를 기준으로 하면 하루에 5번 읽는 것만으로 한도에 도달해요. 게다가 TPM이 50만이라 1분 안에 이 정도 분량의 문서 두 개를 처리할 수도 없어요. 대량 처리에 사용하거나 실제 사용자에게 서비스를 제공하려면 테스트 단계부터 누적 충전액을 Tier1 이상으로 올리는 것을 권장해요.
한 가지 더 주의할 점이 있어요. 공식 안내에 따르면 위험 관리에 따른 요청 제한이 발동되면 해제할 수 없어요. 서비스 출시 전에 클라이언트에서 요청 속도 제어와 재시도 간격 늘리기를 적용하고, 동시 요청 스크립트로 한도를 시험하지 마세요.
7. Kimi K3.1 Pro 중국 내 결제 및 연동 방법
공식 채널은 달러로 가격을 책정하고 결제 지역별 규정에 따라 정산해요. 중국 내에서도 직접 결제할 수 있지만, 중국 개발자들은 해외 결제 수단, 세금계산서 발급, 여러 업체의 API 키를 각각 관리해야 하는 점을 주로 고민해요. 대안으로는 API 통합 플랫폼을 이용해 하나의 계정과 API 키로 여러 모델을 호출하는 방법이 있어요.
APIYI(apiyi.com)는 AI 대규모 언어 모델 API 통합 플랫폼이에요. API 키 하나로 OpenAI, Claude, Gemini 등 주요 모델을 호출할 수 있고, OpenAI 형식과 호환되는 인터페이스를 제공해요. 사용량에 따라 요금이 부과되며, 신규 사용자에게는 무료 테스트 크레딧이 제공돼요. 2026-10-24 기준으로 플랫폼의 모델 목록(docs.apiyi.com/models)을 확인한 결과, 현재 등록된 Kimi 시리즈 모델은 다음과 같아요.
kimi-k3: 입력 $3 / 출력 $15 / 캐시 읽기 $0.3kimi-k2.7-code: 입력 $0.95 / 출력 $3.99 / 캐시 읽기 $0.19kimi-k2.6: 입력 $0.6 / 출력 $2.4 / 캐시 읽기 $0.1kimi-k2.5: 입력 $0.6 / 출력 $3.15 / 캐시 읽기 $0.1
확인 당일에는 kimi-k3.1-pro가 APIYI 모델 목록에 아직 등록되지 않아, 이 글에서는 플랫폼 이용 요금을 안내하지 않아요. K3.1 Pro의 모델명, 가격, 등록 시점은 플랫폼 콘솔의 모델 목록을 확인해 주세요. 이 모델은 최대한 빠르게 제공할 예정이에요. 그전에는 kimi-k3로 먼저 연동을 테스트해 볼 수 있어요. 모델이 등록된 뒤에는 모델명만 바꾸면 돼요.
7.1 Kimi K3.1 Pro 빠르게 시작하기
공식 채널과 통합 플랫폼 모두 연동 방법은 대체로 비슷해요. OpenAI 호환 방식으로 연동하는 경우를 예로 들면 다음과 같아요.
- 가입한 뒤 API 키를 발급받아요. 공식 채널을 이용한다면 먼저 최소 $1을 충전해야 해요.
- 사용하는 OpenAI SDK나 클라이언트에서 APIYI를 이용할 경우
base_url을https://api.apiyi.com/v1로 설정해요. 프로젝트에서 Anthropic 형식을 사용한다면 기본 주소를https://api.apiyi.com으로 설정하세요. api_key에는 발급받은 API 키를,model에는 플랫폼 모델 목록에 표시된 이름을 입력해요. 현재 사용할 수 있는 모델은kimi-k3예요. K3.1 Pro가 등록되면 목록에 표시된 이름을 입력하세요.- 추론으로 인한 출력 비용을 줄이고 싶다면 요청 매개변수에
reasoning_effort를 추가하고 값을low로 설정해요. 공식 안내에 따르면 K3.1 Pro는 추론 수준을 낮출 수는 있지만, 추론을 완전히 끌 수는 없어요. - 고정된 긴 시스템 프롬프트는 메시지 앞부분에 두고 변경하지 마세요. 반복되는 접두사가 캐시에 자동으로 적중할 수 있어요.
- 호출 후 청구 내역이나 응답의 사용량 필드에서 입력, 캐시 적중, 출력 토큰 수를 확인한 다음, 3절의 공식으로 다시 계산해 보세요.
빠른 시작 팁: 먼저 APIYI apiyi.com의 무료 테스트 크레딧으로 3절의 예제 2를 실행해 보세요. 고정 접두사를 설정했을 때와 설정하지 않았을 때의 사용량을 비교하면 캐시가 적용됐는지 가장 빠르게 확인할 수 있어요. APIYI에서 제공하는 K3.1 Pro의 모델명과 가격은 모델 목록을 확인해 주세요. 이 모델은 최대한 빠르게 제공할 예정이에요.
자주 묻는 질문(FAQ)
Q1: Kimi K3.1 Pro의 정확한 가격은 얼마인가요?
공식 가격은 입력 $2, 출력 $10, 캐시 적중 $0.20, 5분 캐시 쓰기 $2, 1시간 캐시 쓰기 $4입니다. 단위는 백만 토큰당 달러이며 세금은 별도입니다. 2026-10-24 기준으로 확인한 가격입니다.
Q2: Kimi K3.1 Pro는 K3보다 얼마나 저렴한가요? 실제 청구 금액도 33% 줄어드나요?
공식 단가는 세 항목 모두 33% 낮습니다. 하지만 K3.1 Pro는 항상 추론을 수행해 평균 출력 토큰이 14% 더 많습니다. 제3자 기관인 Artificial Analysis의 측정에 따르면 작업당 비용은 약 $1.98에서 $2.11로, K3와 거의 비슷합니다. 입력이 길거나 여러 차례 호출에서 내용을 재사용하는 경우에는 비용 절감 폭이 더 커집니다.
Q3: Kimi K3.1 Pro와 Claude Sonnet 5.5 중 어느 쪽이 더 저렴한가요?
두 모델의 입력·출력 단가는 모두 $2/$10입니다. Sonnet 5.5는 캐시 적중 가격이 더 저렴하고($0.10), K3.1 Pro는 5분 캐시 쓰기 가격이 더 저렴합니다($2 대 $2.50). 또한 K3.1 Pro는 1M 컨텍스트에서도 단가가 동일합니다. 짧은 프리픽스를 자주 재사용한다면 Sonnet이, 대용량 문서를 한 번에 입력한다면 K3.1 Pro가 유리할 수 있습니다. 실제 작업으로 비교해 보는 것이 가장 좋습니다.
Q4: Kimi K3.1 Pro의 1시간 캐시를 사용하는 게 좋을까요?
1시간 캐시 쓰기 가격은 $4로, 5분 캐시보다 $2 비쌉니다. 같은 프리픽스를 5분이 지난 뒤부터 1시간 이내에 두 번 이상 다시 사용한다면 대체로 이용할 가치가 있습니다. 호출이 몇 분 안에 집중된다면 기본 5분 캐시를 사용하면 됩니다.
Q5: 국내 개발자는 API로 Kimi K3.1 Pro를 어떻게 호출할 수 있나요?
공식 채널을 이용하거나, APIYI apiyi.com에서 OpenAI 호환 인터페이스로 연결할 수 있습니다. `base_url`에는 `https://api.apiyi.com/v1`을 입력하세요. 현재 플랫폼에는 `kimi-k3`, `kimi-k2.7-code` 등의 모델이 제공됩니다. K3.1 Pro의 모델명과 가격은 플랫폼의 모델 목록을 확인해 주세요. 해당 모델도 빠른 시일 내에 제공할 예정입니다.
Q6: Kimi 멤버십으로 API 비용을 결제할 수 있나요?
아니요. 공식 안내에 따르면 Kimi API는 사용량에 따라 요금이 부과되며 구독제는 없습니다. Kimi 멤버십과 Kimi Code는 별도의 요금 체계를 사용합니다.
Q7: Kimi K3.1 Pro의 요금과 관련해 주의할 점은 무엇인가요?
– 추론을 끌 수 없어 출력 토큰이 많아질 수 있습니다. `reasoning_effort`를 `low`로 설정하면 완화할 수 있습니다.
– Tier0은 분당 요청 3회(RPM), 일일 토큰 150만 개(TPD)만 지원하므로 사용량이 많다면 미리 등급을 올려야 합니다.
– 위험 관리 시스템에 의해 요청 제한이 적용되면 해제할 수 없습니다.
– 파일 추출은 무료지만, 추출한 내용을 모델에 입력하면 입력 요금이 부과됩니다.
Q8: 아직 K3.1 Pro를 제공하지 않는 플랫폼에서 미리 준비할 수 있는 것은 무엇인가요?
먼저 APIYI apiyi.com에서 `kimi-k3`를 사용해 호출 흐름, 캐시 구조, 사용량 통계를 설정해 둘 수 있습니다. K3.1 Pro가 제공되면 모델명만 바꾸면 됩니다. 구체적인 모델명과 가격은 플랫폼의 모델 목록을 확인해 주세요. 해당 모델도 빠른 시일 내에 제공할 예정입니다.
Kimi K3.1 Pro 가격 핵심 요약
- 기본 가격: 입력 $2 / 출력 $10 / 캐시 적중 $0.20. 세금은 별도인 공식 가격이에요.
- 5개 요금 구간: 5분 캐시 쓰기 $2, 1시간 캐시 쓰기 $4로, 캐시 쓰기 비용이 저렴해요.
- 가격대 비교: Sonnet 5.5, GPT-6.1 Sol과 가격이 같고, Opus 5.5의 절반이에요.
- 단일 요금: 1M 컨텍스트도 길이에 따라 요금이 달라지지 않아 예산을 선형적으로 추산할 수 있어요.
- 실제 비용: 항상 사고 모드를 사용하고 출력량이 14% 늘어나면, 작업당 비용은 K3와 거의 비슷해요(서드파티 기준).
- 최소 시작 금액: $1부터 충전할 수 있지만, Tier 0은 3 RPM으로 제한돼요. 위험 제어에 따른 속도 제한은 해제할 수 없어요.
- 국내 연동: APIYI를 통해 OpenAI 호환 인터페이스로 연동할 수 있어요. K3.1 Pro의 모델명과 가격은 플랫폼 목록을 확인해 주세요. 이 모델은 최대한 빨리 출시할 예정이에요.
정리
Kimi K3.1 Pro 가격의 핵심은 다음과 같아요.
- 요금: 입력 $2 / 출력 $10 / 캐시 적중 $0.20으로, K3보다 33% 저렴해요. 1M 컨텍스트에도 단일 요금이 적용돼요.
- 비용 절감의 핵심: 길고 고정된 접두부를 앞에 배치하고 캐시를 활용하면, 여러 차례 대화할 때 입력 비용을 약 60% 줄일 수 있어요.
- 비용 예상: 항상 사고 모드를 사용하면 출력이 길어져요. 복잡한 추론 작업의 작업당 비용은 K3와 비슷하므로, 비용이 33% 줄어들 것으로 예상해 예산을 세우지는 마세요.
- 출시 전 준비: 미리 속도 제한 등급을 높이고 요청 속도를 조절해, 해제할 수 없는 위험 제어 속도 제한이 걸리지 않도록 하세요.
먼저 3절의 공식을 사용해 실제 토큰 분포를 바탕으로 비용을 추산한 뒤, 실제 작업 몇 건으로 검증해 보세요. 국내에서 하나의 API 키로 Kimi, Claude, GPT 등 여러 모델을 비교해 보고 싶다면 APIYI apiyi.com에서 무료 한도를 받아 테스트할 수 있어요. K3.1 Pro의 모델명과 가격은 플랫폼 모델 목록을 확인해 주세요. 이 모델은 최대한 빨리 출시할 예정이에요.
참고 자료
- Kimi 오픈 플랫폼 – 모델 요금: K3.1 Pro 및 각 모델의 5단계 요금과 과금 규칙
- 링크:
platform.kimi.ai/docs/pricing/chat -
설명: 본문 요금표와 1M 컨텍스트 통합 과금 안내의 공식 출처
-
Kimi 오픈 플랫폼 – 충전 및 요청 제한: Tier0부터 Tier5까지의 등급 및 위험 관리 안내
- 링크:
platform.kimi.ai/docs/pricing/limits -
설명: 충전 기준과 RPM/TPM/TPD 제한에 관한 공식 출처
-
Artificial Analysis – Kimi K3.1 Pro: 타사 기준 단일 작업 비용 및 출력 토큰 측정
- 링크:
artificialanalysis.ai -
설명: 본문의 단일 작업 비용 $1.98 / $2.11 및 출력 토큰 55K 데이터 출처
-
APIYI 모델 목록: 플랫폼에서 현재 제공하는 모델과 가격
- 링크:
docs.apiyi.com/models - 설명: Kimi, Claude 등의 모델을 플랫폼에서 실제로 이용할 수 있는지 확인할 수 있어요
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈페이지에서 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.