gemini-4-argon은 2026년 10월 13일에 출시됐어요. 많은 개발자가 연동 직후 429 오류를 겪었습니다. 동시 요청을 조금만 늘려도 오류가 발생하고, 때로는 단일 요청도 실패했죠. 많은 사람이 처음에는 “AI Studio의 동시 요청 한도가 너무 낮다”고 생각하지만, 대개는 잘못된 판단입니다. 이 글에서는 AI Studio에서 gemini-4-argon에 실제로 적용되는 제한 방식을 살펴보고, 바로 적용할 수 있는 429 해결 방법을 소개할게요.
이 글은 “재시도만 추가하면 된다”는 식의 뻔한 튜토리얼이 아닙니다. 먼저 중요한 사실부터 짚고 넘어갈게요. Google은 현재 gemini-4-argon의 통일된 고정 동시 요청 한도를 공개하지 않았습니다. 따라서 온라인에 떠도는 “동시 요청 10개”, “동시 요청 50개” 같은 수치는 근거가 부족합니다.
핵심 내용: 이 글을 읽고 나면 RPM, TPM, 소비 속도, 상위 시스템 용량 등 네 가지 429 발생 원인을 구분하고, 지수 백오프와 요청 속도 제한을 적용하는 방법을 익힐 수 있어요. 또한 APIYI apiyi.com의 대규모 동시 요청 채널을 통해 AI Studio 단일 프로젝트 할당량의 병목을 우회하는 방법도 알아봅니다.
gemini-4-argon 핵심 요점
먼저 표로 전체 내용을 요약하고, 뒤에서 각 항목을 자세히 살펴볼게요.
| 요점 | 설명 | 효과 |
|---|---|---|
| 공개된 고정 동시 요청 한도는 없음 | Google은 gemini-4-argon의 통일된 동시 요청 한도를 공개하지 않았으며, RPM, TPM, RPD 등의 지표를 기준으로 요청을 제한합니다. | 잘못된 수치를 바탕으로 용량을 계획하지 않게 됩니다. |
| RPM은 동시 요청 수와 다름 | 처리 중인 요청 수는 분당 요청 수뿐 아니라 요청의 평균 처리 시간에 따라 달라집니다. | 필요한 동시 요청 규모를 정확하게 추정할 수 있습니다. |
| 제한은 프로젝트 단위로 적용 | 같은 프로젝트에서 API 키를 여러 개 만들어도 할당량이 배로 늘어나지 않습니다. | API 키를 번갈아 쓰느라 시간을 낭비하지 않아도 됩니다. |
| 10분 소비 한도 | Tier 1은 $10, Tier 2는 $50, Tier 3은 $200입니다. | “RPM을 넘지 않았는데도 429가 발생하는” 현상을 설명합니다. |
| 429는 단계별로 처리해야 함 | 먼저 원본 응답을 확인하고, 이후 속도 제한, 백오프, 채널 전환, 할당량 상향을 차례로 적용합니다. | 우선순위에 따라 문제를 단계적으로 해결할 수 있습니다. |
| APIYI 대규모 동시 요청 채널 | APIYI apiyi.com은 gemini-4-argon의 대규모 동시 요청을 지원하며, RPM 500 이하라면 속도 제한을 걱정할 필요가 없습니다. | 중소 규모 서비스에서 바로 사용할 수 있습니다. |
429가 꼭 동시 요청 한도 초과를 뜻하지는 않는 이유
많은 개발자가 429를 “동시 요청이 너무 많다”는 뜻으로 받아들이지만, Google의 요청 제한 체계에서 동시 요청 수는 독립적인 지표가 아닙니다. 실제로 429 RESOURCE_EXHAUSTED가 발생하는 원인은 분당 요청 수, 분당 입력 토큰 수, 일일 요청 수, 10분 단위의 이동 소비 금액일 수 있습니다. 새 모델이 출시된 초기라면 상위 시스템 용량 부족이 원인일 수도 있죠.
gemini-4-argon은 출시된 지 일주일도 되지 않아 상위 시스템의 리소스가 아직 확충되는 중입니다. 할당량이 충분하더라도 용량이 빠듯하면 일시적으로 요청이 거부될 수 있어요. 따라서 429를 해결할 때는 무작정 동시 요청 수를 낮추기보다, 먼저 어떤 유형의 제한에 걸렸는지 확인해야 합니다.
gemini-4-argon의 AI Studio 동시 처리량은 얼마인가요?
정답부터 말씀드리면, 공개된 고정값은 없습니다. AI Studio에서는 프로젝트마다 gemini-4-argon에 적용되는 RPM, TPM, RPD 할당량이 다릅니다. 구체적인 수치는 Tier 등급과 프로젝트 상태에 따라 달라지므로 콘솔에서 확인해야 해요.
AI Studio의 다섯 가지 제한 지표
Google의 공식 제한 정책은 다음과 같이 정리할 수 있어요. 이 중 어느 하나라도 한도에 도달하면 429 오류가 반환될 수 있습니다.
| 제한 지표 | 의미 | 429 오류 발생 여부 |
|---|---|---|
| RPM | 분당 요청 수 | 발생할 수 있음 |
| TPM | 분당 입력 토큰 수 | 발생할 수 있음 |
| RPD | 일일 요청 수 | 발생할 수 있음 |
| 소비 속도 | 10분 이동 창 내 API 사용 금액 | 발생할 수 있음 |
| 실제 서비스 용량 | Google 상위 시스템에서 사용 가능한 리소스 | 발생할 수 있음 |
마지막 항목에 유의하세요. 용량 부족은 매개변수를 조정해 해결할 수 없는 경우예요. 트래픽을 줄이거나, 재시도 시점을 늦추거나, 다른 채널로 전환해 완화할 수 있습니다.
RPM과 동시 처리량의 관계
RPM은 “1분 동안 처리한 전체 요청 수”를 뜻하고, 동시 처리량은 “같은 시점에 처리 중인 요청 수”를 뜻해요. 두 값은 요청 처리 시간에 따라 달라집니다. 예를 들어 프로젝트의 한도가 60 RPM이라고 가정해 볼게요. (계산을 위한 예시일 뿐, Argon의 실제 할당량을 의미하지는 않습니다.)
- 요청당 평균 처리 시간이 5초라면 이론상 평균 처리 중인 요청은 약 5개예요.
- 요청당 평균 처리 시간이 30초라면 이론상 평균 처리 중인 요청은 약 30개예요.
- 요청 60개를 한꺼번에 보내면 1분간 전체 요청 수가 한도를 넘지 않더라도 순간적인 제한이나 용량 문제에 부딪힐 수 있어요.
세 번째 경우는 놓치기 쉽습니다. 부하 테스트 스크립트에서 요청을 “한꺼번에 동시에 보내는” 경우가 많은데, 이런 순간적인 트래픽 급증은 일정한 속도로 요청을 보내는 것보다 제한을 더 쉽게 유발해요. 전체 요청량이 한도 내에 있더라도 마찬가지입니다.
콘솔에서 gemini-4-argon의 실제 할당량 확인하기
Google AI Studio의 Rate Limits 페이지(aistudio.google.com/usage)를 열고 rate-limit 탭으로 이동하세요. 공식 속도 제한 문서(ai.google.dev/gemini-api/docs/rate-limits)에서도 해당 페이지로 이동할 수 있습니다. 프로젝트와 gemini-4-argon을 선택하면 적용 중인 RPM, TPM, RPD와 현재 Tier 등급을 확인할 수 있어요.
Google은 제한이 API 키가 아니라 프로젝트 단위로 적용된다고 명확히 안내하고 있습니다. 따라서 같은 프로젝트에서 API 키를 아무리 많이 만들어도 할당량이 늘어나지 않아요. AI Studio에서는 ‘여러 키를 번갈아 사용하는 방식’으로 용량을 확장할 수 없습니다.
gemini-4-argon에서 429가 자주 발생하는 5가지 원인
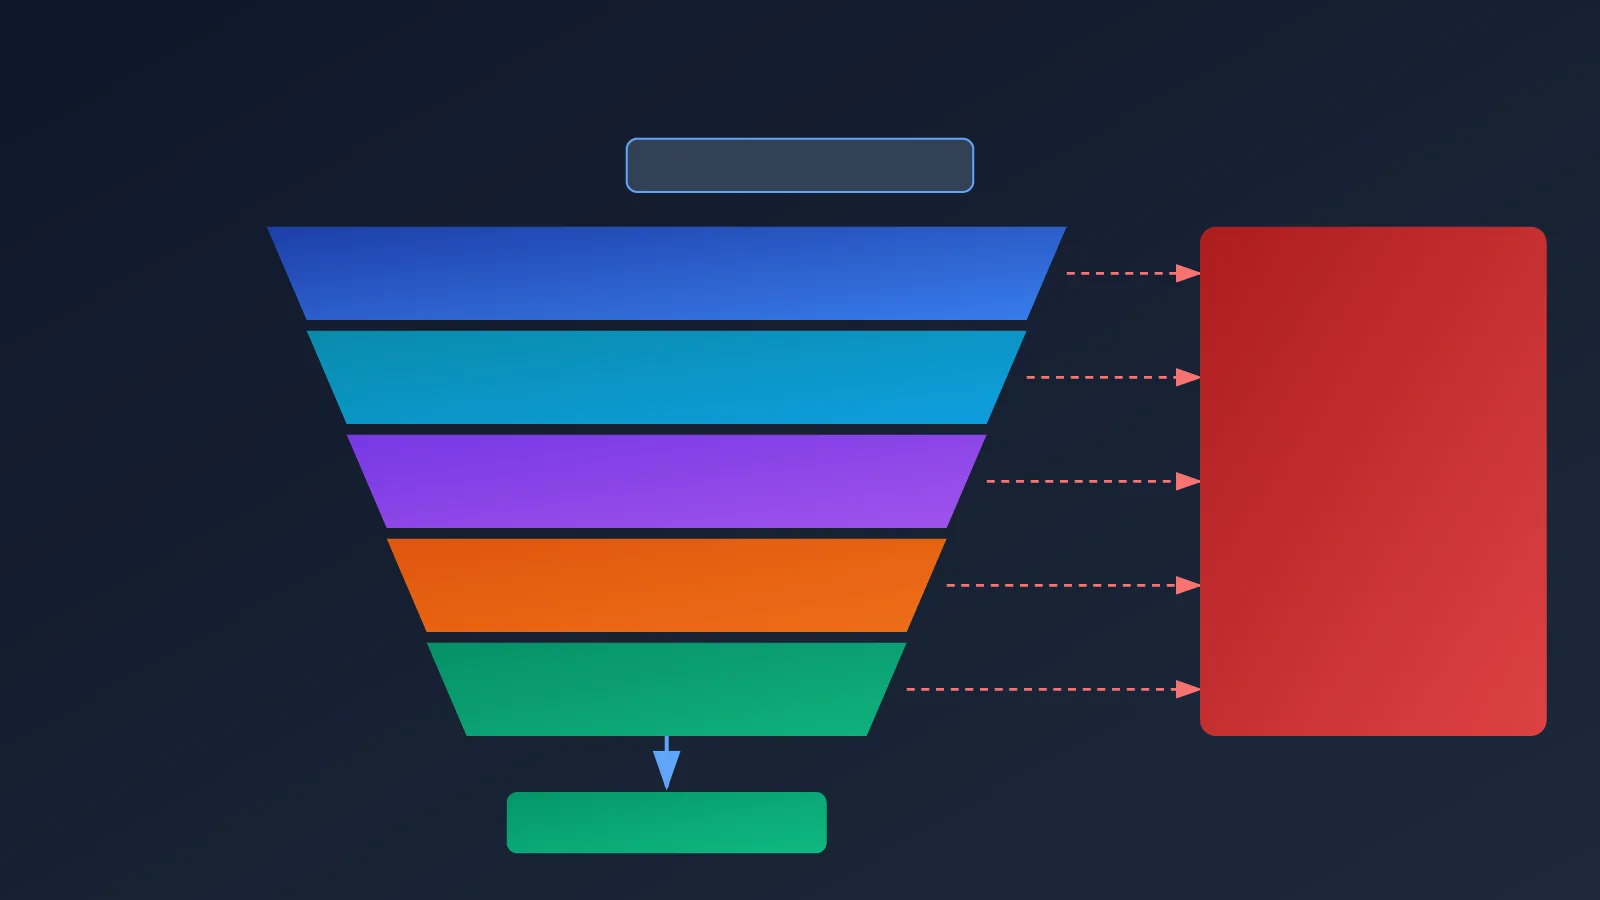
제한 지표를 이해했다면, 실제로 문제가 발생하는 상황을 살펴볼게요. 다음 다섯 가지 원인이 gemini-4-argon의 429 오류 사례 대부분을 차지합니다.
- 순간 요청 속도가 너무 빠름: 대량 작업이나 부하 테스트 스크립트에서 요청을 한꺼번에 보내면 순간적으로 트래픽이 치솟아 RPM의 순간 처리량을 초과할 수 있어요.
- TPM 한도 초과: 컨텍스트가 길거나 입력 문서가 크면 토큰이 빠르게 소모돼요. 요청 수가 많지 않아도 TPM 한도에 먼저 도달할 수 있습니다.
- 10분 소비 한도 초과: 가장 간과하기 쉬운 항목이에요. 아래에서 따로 설명할게요.
- 일일 RPD 소진: 일정 시간 실행한 뒤에야 429가 발생한다면, 일일 할당량을 모두 사용했을 가능성이 높아요.
- 상위 서비스 용량 부족: 새 모델이 출시된 초기에는 리소스가 부족할 수 있어요. 할당량이 충분해도 요청이 거부될 수 있습니다.
놓치기 쉬운 원인: 10분 소비 한도
Google 공식 문서는 2026년 10월 15일 업데이트를 기준으로, 계정 등급마다 10분 롤링 윈도우 내 소비 한도가 있다고 안내합니다.
| 계정 등급 | 10분당 소비 한도 |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
예를 들어 Tier 1 계정이 10분 동안 누적 소비액 $10에 도달하면 RPM과 TPM을 초과하지 않았더라도 429 RESOURCE_EXHAUSTED가 반환될 수 있어요. 차세대 모델인 gemini-4-argon은 한 번 호출할 때 드는 비용이 이전 모델보다 높을 수 있습니다. 특히 컨텍스트가 긴 요청은 소비량이 급격히 늘어나기 쉬운데, 이것이 “요청량은 많지 않은데도 제한에 걸리는” 흔한 원인입니다.
또 한 가지 주의할 점은 Google 문서에 나오는 Argon Batch API 할당량이 배치 처리 대기열의 토큰 할당량이라는 거예요. 이를 실시간 API의 동시 요청 할당량으로 간주하면 안 됩니다.
gemini-4-argon의 429가 어디서 발생하는지 확인하는 방법
증상에 따라 근본 원인이 달라요. 무작정 매개변수를 조정하기보다 증상에 맞춰 점검하는 편이 훨씬 효율적입니다.
| 증상 | 우선 점검할 항목 | 대응 방법 |
|---|---|---|
| 동시 요청을 늘리자마자 429가 자주 발생함 | 순간 요청 속도, RPM, 상위 서비스 용량 | 요청을 고르게 보내는 단계별 부하 테스트를 진행하세요. 동시 요청 수가 일정해도 RPM까지 일정한 것은 아닙니다. |
| 한동안 실행한 뒤 429가 발생하기 시작함 | 10분 소비 한도, RPD, TPM 누적량 | 소비 추이와 일일 할당량 사용량을 확인하세요. |
| 단일 요청이나 아주 낮은 동시성에서도 429가 발생함 | 상위 서비스 용량 부족, 계정 또는 프로젝트 제한 | 원본 응답을 확인하고 다른 채널로 전환하는 방법을 고려하세요. |
| 여러 API 키에서 동시에 429가 발생함 | 여러 키가 같은 프로젝트에 속해 할당량을 공유하는지 확인 | 프로젝트 전체 트래픽을 줄이거나 별도의 할당량을 제공하는 채널을 사용하세요. |
문제를 진단할 때 가장 중요한 정보는 두 가지예요. 첫째, AI Studio 계정이 Tier 1, 2, 3 중 어느 등급인지 확인하세요. 둘째, 429 오류의 원본 내용을 살펴보세요. 특히 error.message, error.details, 응답 헤더의 Retry-After가 중요합니다. 이 정보를 확인하면 계정 할당량이 부족한지, 요청량이 너무 많은지, 아니면 Google Argon 신모델의 공급이 부족한지 대체로 구분할 수 있어요. 세 가지 원인은 해결 방법도 서로 다릅니다.
gemini-4-argon 429 해결을 위한 6단계 방안
아래는 실제 대응 우선순위에 따라 정리한 조치예요. P0는 먼저 해야 하는 필수 조치이고, P2는 장기 계획에 해당해요.
| 우선순위 | 해결 방법 | 효과 |
|---|---|---|
| P0 | 429 원본 응답과 Retry-After 확인 |
구체적인 속도 제한 원인 파악 |
| P0 | 프로젝트별 RPM, TPM, 사용 속도 제한 설정 | 할당량이 계속 초과되는 상황 방지 |
| P0 | 429 발생 시 지수 백오프 재시도 및 무작위 지터 추가 | 갑작스러운 속도 제한 완화 |
| P1 | 429 발생 시 별도 할당량을 사용하는 정상 채널로 자동 전환 | 성공률 향상 |
| P1 | Tier 업그레이드 또는 Google에 한도 상향 신청 | 장기적으로 용량 확대 |
| P2 | Vertex AI 또는 다른 정식 승인 채널 검토 | 리소스 공급 확대 |
1단계: 429 원본 응답 확인하기
상태 코드만 확인하고 바로 재시도하지 마세요. 먼저 오류 본문과 응답 헤더 전체를 출력하고, 특히 error.message, error.details, Retry-After를 살펴보세요. 상위 서비스에서 대기 시간을 알려줬다면 임의로 간격을 정하지 말고 우선 해당 시간을 따르는 게 좋아요.
2단계: 클라이언트에서 미리 속도 제한하기
백엔드에서 확인할 수 있는 한도의 70~80% 수준으로 RPM을 설정하고, TPM도 별도로 관리하세요. 10분 단위 사용 금액도 함께 모니터링해야 해요. 여유분을 두면 트래픽 급증이나 상위 서비스의 변동을 완충할 수 있어요. 많은 팀이 요청 수만 제한하고 토큰과 사용 금액은 놓치는데, 그러면 “RPM은 분명 초과하지 않았는데” 요청이 거부되는 일이 생겨요.
3단계: 지수 백오프와 무작위 지터 적용하기
Google은 429 응답에 지수 백오프를 적용할 것을 권장해요. 예를 들어 1초, 2초, 4초, 8초씩 기다리되 무작위 지터도 추가하세요. 많은 요청이 한꺼번에 재시도해 혼잡이 더 심해지는 상황을 막을 수 있어요. 재시도는 최대 2~3회로 제한하고, 상위 서비스가 반환한 재시도 대기 시간이 있다면 우선 적용하세요.
4단계: 429가 계속되면 채널 전환하기
같은 프로젝트에서 429 응답이 계속 발생한다면 해당 프로젝트로 재시도하지 마세요. 속도 제한만 더 심해질 수 있어요. 대신 트래픽을 줄이거나, 별도 할당량을 사용하는 정상 채널로 전환하세요. 집계 서비스는 바로 이런 상황에 유용해요. APIYI apiyi.com을 통해 호출하면 요청을 여러 개의 독립적인 할당량 채널로 분산할 수 있어 단일 AI Studio 프로젝트에 모든 부하를 집중하지 않아도 돼요.
5단계: Tier 업그레이드 또는 한도 상향 신청하기
장기적으로 용량 부족을 해결하려면 계정 등급을 높이거나 Google에 한도 상향을 신청해야 해요. Tier가 올라가면 RPM과 TPM뿐 아니라 10분 사용 한도도 $10에서 $50, 나아가 $200까지 늘어나요. 다만 한도 상향에는 시간과 사용 기록이 필요하므로, 보통 서비스 출시 일정에 맞추기 어려워요.
6단계: 다른 정식 승인 채널 검토하기
서비스 규모가 계속 커진다면 Vertex AI나 다른 정식 승인 채널을 검토해 리소스 공급을 늘려 보세요. 여러 채널을 함께 운영하면 단일 장애 지점의 위험도 줄일 수 있어요.
새 채널 연결 시 부하 테스트 권장 사항
Argon을 새 채널에 연결할 때는 먼저 동시 실행 수를 5~10으로 설정해 부하 테스트를 진행하는 게 좋아요. 이 수치는 초기 테스트를 위한 설정일 뿐, 공식 동시 실행 한도는 아니에요. 이후 단계별로 요청량을 늘리되, 각 단계에서 요청을 고르게 전송하세요. 공급업체, Google 프로젝트, 모델별로 429 비율, 실제 RPM, TPM, 10분 사용량, 요청 소요 시간을 각각 집계하고 안정성을 확인한 뒤 다음 단계로 넘어가세요.
gemini-4-argon 빠른 시작: APIYI로 호출하기
이론은 여기까지 살펴봤으니, 이제 코드를 확인해 볼게요. APIYI는 OpenAI 호환 인터페이스를 제공하므로 base_url만 바꾸면 gemini-4-argon을 호출할 수 있어요.
최소 예제
아래 10여 줄의 코드로 호출을 한 번 실행할 수 있어요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스 사용
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
전체 코드 보기: 지수 백오프, 무작위 지터, Retry-After를 적용한 동시 호출
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스 사용
)

MAX_RETRIES = 3       # 재시도는 최대 2~3회
BASE_DELAY = 1.0      # 지수 백오프 시작값: 1, 2, 4, 8초


def call_argon(prompt: str) -> str:
    """gemini-4-argon을 호출하고, 429 발생 시 지수 백오프를 적용하되 Retry-After를 우선 준수"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 상위 서비스가 반환한 Retry-After를 우선 사용
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 무작위 지터를 추가해 동시 재시도 방지
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 동시 실행 수 5부터 부하 테스트를 시작합니다. 공식 한도가 아닙니다.
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
빠른 시작: APIYI apiyi.com에 가입해 API 키를 발급받으면 위 코드로 gemini-4-argon 호출을 바로 확인할 수 있어요. 플랫폼에서 OpenAI 호환 통합 인터페이스를 제공하므로 Google 프로젝트를 여러 개 직접 신청하고 관리할 필요가 없어요.
클라이언트 속도 제한 간단히 구현하기
재시도만큼 중요한 건 “한도에 부딪히지 않도록 요청을 줄이는 것”이에요. 아래는 토큰 버킷 방식에 기반한 최소한의 속도 제한기예요. 요청 간격을 일정하게 유지해 갑작스러운 트래픽 급증을 방지할 수 있어요.
import threading
import time


class RateLimiter:
    """목표 RPM에 맞춰 요청을 일정한 속도로 허용해 순간적인 트래픽 급증을 방지"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 백엔드 한도의 70~80% 수준으로 설정

# 매번 호출하기 전에 실행:
# limiter.wait()
속도 제한기를 호출 함수의 진입점에 두고 앞서 설명한 백오프 재시도를 함께 적용하면, “사전 속도 제한과 사후 백오프”로 구성된 이중 보호 체계를 만들 수 있어요.
APIYI의 gemini-4-argon 대규모 동시 요청 채널
AI Studio에 직접 연결할 때 가장 큰 제약은 프로젝트 하나에 할당된 할당량이 고정되어 있다는 점이에요. Tier 1 계정은 10분 동안 소비할 수 있는 금액도 $10로 제한됩니다. 반면 통합 서비스는 트래픽을 서로 다른 할당량을 가진 여러 채널로 분산하고, 특정 채널에서 429 오류가 계속 발생하면 정상 채널로 자동 전환할 수 있어요.
APIYI apiyi.com은 현재 대규모 동시 요청을 지원하는 gemini-4-argon을 제공하고 있어요. RPM 500 이하에서는 속도 제한을 걱정하지 않고 사용할 수 있습니다. 대부분의 중소 규모 애플리케이션과 내부 도구, 자동화 워크플로, 테스트 및 부하 테스트에는 이 정도면 일상적인 요구를 충분히 충족해요. Tier 등급이나 프로젝트 할당량, 10분 소비 한도에 신경 쓰지 않아도 됩니다.
| 비교 항목 | AI Studio 직접 연결 | APIYI를 통한 호출 |
|---|---|---|
| 할당량 관리 | 프로젝트 하나의 할당량을 여러 API 키가 공유 | 서로 독립된 여러 채널의 할당량을 플랫폼이 관리 |
| 429 오류 처리 | 직접 재시도 간격 조정 및 채널 전환을 구현해야 함 | 플랫폼이 우선 정상 채널로 전환하므로 클라이언트에서는 기본 재시도만 설정하면 됨 |
| 소비 한도 제약 | Tier의 10분 소비 한도 적용 | Google 계정 등급을 직접 관리할 필요 없음 |
| 연동 방식 | 프로젝트를 신청하고 Tier를 설정해야 함 | OpenAI 호환 인터페이스를 사용해 base_url만 바꾸면 됨 |
| 적합한 규모 | 트래픽이 적거나 높은 Tier로 업그레이드한 경우 | RPM 500 이하라면 속도 제한을 걱정할 필요 없음 |
🎯 기술 제안: 서비스의 피크 트래픽이 RPM 500 이내라면 APIYI apiyi.com을 통해 gemini-4-argon을 바로 호출하고, 비즈니스 로직에 집중해도 좋아요. 예상 트래픽이 이 범위를 넘는다면 단계별 부하 테스트를 진행하고, 플랫폼과 미리 용량 계획을 논의하는 것을 권장합니다.
대규모 동시 요청 채널을 사용하더라도 클라이언트에서 지수 백오프와 적절한 타임아웃을 설정해 두는 것이 좋습니다. 네트워크가 불안정하거나 상위 서비스에 일시적인 문제가 생길 수 있으므로, 재시도 로직을 잘 구성하면 극한 상황에서도 서비스를 안정적으로 운영할 수 있어요.
자주 묻는 질문 FAQ
Q1: AI Studio에서 gemini-4-argon의 동시 요청 수는 정확히 얼마인가요?
Google은 고정된 동시 요청 수를 공식적으로 공개하지 않았어요. 실제 제한은 프로젝트의 RPM, TPM, RPD와 10분 사용 한도에 따라 달라지므로, AI Studio의 Rate Limits 페이지에서 해당 프로젝트와 모델을 선택해 확인해야 해요. 온라인에 떠도는 구체적인 동시 요청 수는 공식 근거가 없으니 용량 계획의 기준으로 삼지 않는 편이 좋아요.
Q2: API 키를 여러 개 만들면 gemini-4-argon의 할당량이 늘어나나요?
아니요. Google은 제한이 API 키가 아닌 프로젝트 단위로 적용된다고 명확히 안내하고 있어요. 같은 프로젝트에 속한 여러 API 키는 하나의 할당량을 공유해요. 별도의 할당량을 확보하려면 Google 프로젝트를 따로 만들거나 APIYI apiyi.com 같은 멀티채널 통합 서비스를 이용해야 해요.
Q3: RPM과 TPM을 초과하지 않았는데도 왜 429 오류가 발생하나요?
가장 흔한 원인은 10분 사용 한도에 도달한 경우예요. Tier 1은 $10, Tier 2는 $50, Tier 3는 $200으로 제한돼요. 새 모델이 출시된 초기에는 상위 서비스의 용량 부족으로 할당량 내 요청도 거부될 수 있어요. 원인을 확인하려면 원본 오류 응답의 `error.details`도 함께 살펴보세요.
Q4: 429 오류가 발생하면 어떻게 재시도해야 하나요?
1초, 2초, 4초, 8초처럼 대기 시간을 늘리는 지수 백오프를 적용하고, 여기에 무작위 지연을 추가하세요. 재시도는 최대 2~3회로 제한하고, 응답 헤더에 `Retry-After`가 있으면 해당 값을 우선 따르는 것이 좋아요. 같은 프로젝트에서 429 오류가 계속 발생한다면 재시도를 반복하기보다 트래픽을 줄이거나 별도 할당량을 사용하는 채널로 전환하세요.
Q5: APIYI를 통해 gemini-4-argon을 빠르게 호출하려면 어떻게 하나요?
1. APIYI apiyi.com에 접속해 가입한 후 API 키를 발급받으세요.
2. 코드에서 `base_url`을 `https://api.apiyi.com/v1`로 설정하세요.
3. 모델 이름을 `gemini-4-argon`으로 지정하면 이 글의 예제 코드를 실행할 수 있어요.
APIYI는 gemini-4-argon의 대규모 동시 호출을 지원해요. RPM 500 이하라면 레이트 리밋을 크게 걱정하지 않아도 되므로 빠른 검증이나 중소 규모 서비스 출시에도 적합해요.
Q6: APIYI를 사용해도 429 오류가 발생할 수 있나요?
일반적으로 RPM 500 이하로 사용하는 범위에서는 레이트 리밋을 크게 걱정하지 않아도 돼요. 다만 모든 상위 서비스에서 일시적인 변동이 발생할 수 있으므로 기본적인 지수 백오프 재시도 로직은 유지하는 것이 좋아요. 서비스 트래픽이 이 범위를 넘을 것으로 예상된다면 단계별 부하 테스트를 먼저 진행하고, APIYI apiyi.com을 통해 플랫폼과 용량을 확인하세요.
Q7: Batch API 할당량을 실시간 동시 요청 할당량의 기준으로 봐도 되나요?
아니요. Google 문서에 기재된 Argon Batch API 할당량은 오프라인 일괄 작업을 위한 배치 큐의 토큰 할당량이에요. 실시간 API의 동시 요청 및 RPM 제한과는 별개의 체계이므로 서로 대입해 판단할 수 없어요.
gemini-4-argon 429 오류 핵심 요점
- 고정된 동시 요청 수는 없어요: Google은 gemini-4-argon의 통일된 동시 요청 상한을 공개하지 않았어요. 실제 할당량은 콘솔에서 확인해야 해요.
- RPM이 동시 요청 수와 같지는 않아요: 동시 요청 수는 요청 처리 시간에 따라 달라져요. 일정한 트래픽보다 순간적으로 몰리는 트래픽에서 레이트 리밋이 더 쉽게 발생해요.
- 제한은 프로젝트 단위로 적용돼요: API 키를 여러 개 만들어도 용량이 늘어나지 않으며, 같은 프로젝트의 키는 할당량을 공유해요.
- 10분 사용 한도에 유의하세요: Tier 1부터 Tier 3까지 한도는 각각 $10, $50, $200이에요. RPM을 초과하지 않아도 429 오류가 발생할 수 있어요.
- 백오프와 속도 제한, 채널 전환을 활용하세요: 무작위 지연을 더한 지수 백오프를 적용하고, 429 오류가 계속되면 별도 할당량을 사용하는 채널로 전환하세요.
- 대규모 동시 호출도 부담을 줄일 수 있어요: APIYI apiyi.com은 gemini-4-argon의 대규모 동시 호출을 지원해요. RPM 500 이하에서는 레이트 리밋을 크게 걱정하지 않아도 돼요.
요약
gemini-4-argon에서 AI Studio의 429 오류가 자주 발생하는 핵심 원인은 ‘동시 요청 수가 너무 적어서’가 아니에요. RPM, TPM, RPD, 10분 단위 사용량 제한, 신규 모델의 업스트림 용량 제한이 복합적으로 작용한 결과예요. 해결 방법도 단계별로 접근해야 해요. 먼저 원본 응답을 확인하고, 요청 속도를 직접 제한한 다음 지수 백오프와 무작위 지터를 적용하세요. 429 오류가 계속되면 채널을 전환하고, 장기적으로는 Tier를 업그레이드하거나 승인된 채널을 늘려 용량을 확보해야 해요.
쿼터 문제를 줄이고 싶은 개발자라면 여러 채널을 통합한 서비스를 이용하는 것도 현실적인 선택이에요. APIYI apiyi.com에서 빠르게 테스트해 보세요. 이 플랫폼은 gemini-4-argon의 대규모 동시 호출을 지원하며, RPM 500 이하에서는 안심하고 사용할 수 있어요. 직접 테스트해 보세요.
참고 자료
- Google AI Studio 사용량 및 속도 제한 페이지: 프로젝트별 RPM, TPM, RPD 및 Tier 확인
- 링크:
aistudio.google.com/usage -
설명: 프로젝트와 gemini-4-argon을 선택하면 실제 쿼터를 확인할 수 있어요.
-
Gemini API 속도 제한 문서: 공식 속도 제한 방식과 429 오류 처리 방법
- 링크:
ai.google.dev/gemini-api/docs/rate-limits - 설명: 10분 단위 사용량 제한과 지수 백오프 권장 사항이 안내되어 있어요.
작성자: APIYI Team
기술 문의: 댓글로 gemini-4-argon의 429 오류를 해결한 경험을 공유해 주세요. 더 많은 연동 자료는 APIYI docs.apiyi.com 문서 센터에서 확인할 수 있어요.