최근에 한 고객님이 그룹 채팅에서 아주 전형적인 질문을 남기셨어요. “저희 같은 images2로 이커머스 이미지 세트를 생성할 수 있나요?” 답은 ‘가능하다’예요. 다만 한 번의 호출로 이미지 세트 전체가 툭 튀어나오는 건 아니에요. gpt-image-2의 API는 ‘하나의 프롬프트가 한 번의 생성에 대응’하는 구조라서, 메인 이미지·셀링 포인트 이미지·연출 컷·상세 페이지처럼 내용이 각각 다른 한 세트를 만들려면 호출 방식에 약간의 설계가 필요해요.
이 글에서는 gpt-image-2 이커머스 이미지 세트를 두 가지 루트로 나눠 볼게요. 하나는 한 장의 이미지에 여러 차원의 정보를 담는 방식으로 상세 페이지 롱 이미지에 잘 맞아요. 다른 하나는 텍스트 모델로 요구사항을 먼저 분해해 각 이미지의 프롬프트를 만들고, gpt-image-2를 병렬로 호출하는 방식으로, 진짜 ‘다중 이미지 세트’에 어울리죠. 끝까지 읽으면 전체 흐름 설계, 실행 가능한 코드, 그리고 세트 전체의 스타일을 통일하는 핵심 팁까지 얻어 가실 수 있어요.
gpt-image-2 이커머스 이미지 세트의 핵심 제약: 한 번의 호출은 하나의 프롬프트에만 대응
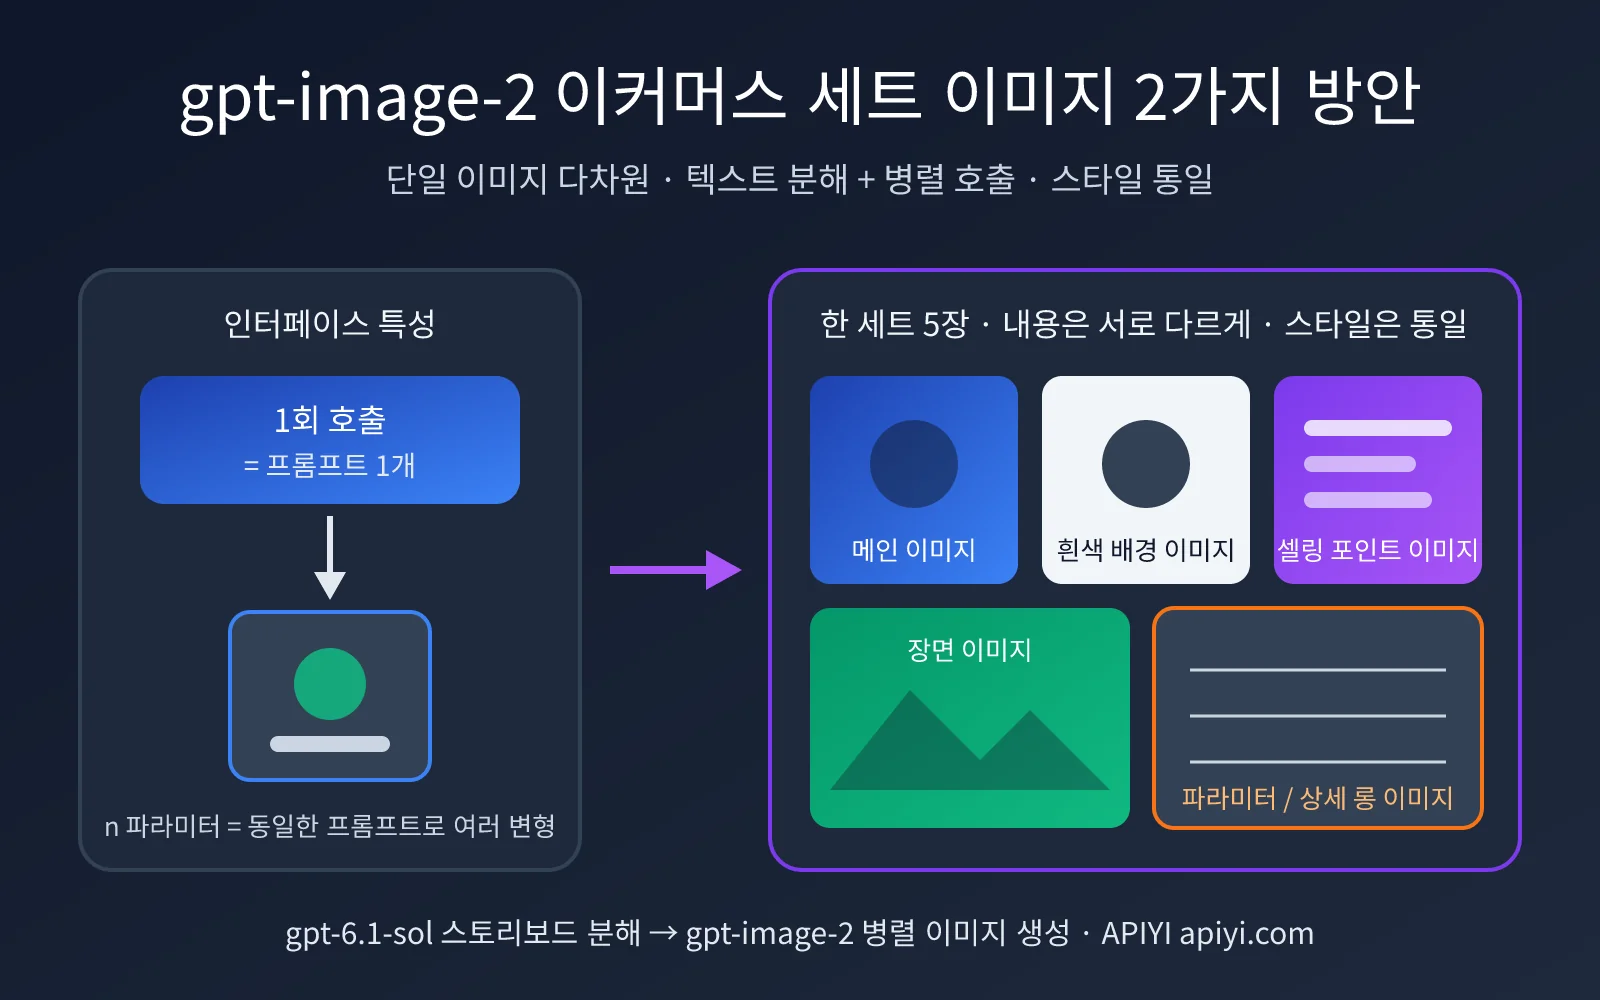
먼저 API 동작 방식을 명확히 짚고 갈게요. 뒤에 나오는 설계는 모두 이 전제 위에 세워집니다. gpt-image-2의 /v1/images/generations와 /v1/images/edits는 요청 한 번에 프롬프트 하나만 받아요. 공식 gpt-image-2와 2.5 시리즈는 모두 n 파라미터를 지원하고 APIYI도 이를 완전히 지원하지만, n의 의미는 “같은 프롬프트로 n장의 변형을 생성“이지 “n개의 프롬프트로 각각 1장씩 생성”이 아니에요.
그래서 n=5로 받는 건 같은 화면의 5가지 버전이에요. “몇 장 더 뽑아서 제일 나은 걸 고르기”에는 맞지만 세트를 만드는 용도로는 적합하지 않죠. 이커머스 이미지 세트의 본질은 내용은 다르되 스타일이 통일된 여러 장의 이미지예요. 메인 이미지는 제품을 부각해야 하고, 셀링 포인트 이미지에는 카피가 붙어야 하고, 연출 컷에는 사용 환경이 보여야 하고, 파라미터 이미지에는 치수 표기가 들어가야 하죠. 이미지마다 프롬프트가 다르니 자연스럽게 여러 번 호출할 수밖에 없어요.
gpt-image-2 이커머스 이미지 세트의 진짜 난관 3가지
제약을 명확히 이해하고 나면, 세트 제작의 어려움은 사실 “여러 장 뽑기”가 아니라 아래 세 가지에 있다는 걸 알게 돼요.
- 주체 일관성: 5장의 이미지에 나오는 제품이 반드시 같은 제품이어야 해요. 색상, 로고, 구조가 이미지마다 달라지면 안 되죠.
- 스타일 일관성: 색조, 조명, 배경 질감, 폰트 스타일이 마치 한 디자이너의 손에서 나온 것처럼 보여야 해요.
- 정보 분담: 이미지마다 서로 다른 마케팅 역할을 맡아야 해요. 5장 모두 같은 셀링 포인트만 이야기하면 안 되죠.
이 세 가지 때문에 세트 제작은 “문장 하나를 모델에 던지는” 방식으로는 해결되지 않아요. 호출 전에 먼저 기획이 필요하죠. 아래 표는 흔한 이커머스 플랫폼의 세트 구성 표준으로, 기획의 출발점으로 삼을 수 있어요.
| 세트 내 위치 | 주요 용도 | 권장 비율 | 정보 밀도 | 텍스트 필요 여부 |
|---|---|---|---|---|
| 메인 이미지(썸네일) | 검색 결과 클릭률 | 1:1 | 낮음, 제품 부각 | 선택, 소량 |
| 화이트 배경 이미지 | 플랫폼 규격, 광고 집행 | 1:1 | 매우 낮음 | 불필요 |
| 셀링 포인트 이미지 | 핵심 셀링 포인트 2~3개 전달 | 1:1 또는 3:4 | 중간 | 필요 |
| 연출 컷 | 사용 분위기 연출 | 1:1 또는 4:5 | 중간 | 선택 |
| 치수/파라미터 이미지 | 문의와 반품 감소 | 1:1 | 높음 | 필요 |
| 상세 페이지 롱 이미지 | 제품 완전 설명 | 9:16 또는 그 이상 | 매우 높음 | 필요 |
🎯 기획 팁: 코드를 작성하기 전에 위 표를 기준으로 플랫폼에 몇 장이 필요한지, 각 이미지가 어떤 역할을 맡을지 먼저 정하세요. APIYI(apiyi.com)에서 gpt-image-2로 단일 이미지를 2~3장 먼저 직접 실행해 보고, 제품 재현도와 텍스트 렌더링 품질이 기대에 맞는지 확인한 뒤 배치 세트 제작으로 넘어가시는 걸 권장해요.
방안 1: gpt-image-2 단일 이미지로 다차원 정보 담기 (상세페이지 롱 이미지)
첫 번째 방법은 “이미지 한 장으로 필요한 이야기를 전부 끝내는” 방식이에요. gpt-image-2는 중국어 텍스트 렌더링과 레이아웃 이해 능력이 뛰어나서, 세로형 큰 이미지 안에 메인 비주얼, 셀링 포인트, 스펙 표를 구역별로 배치하는 게 충분히 가능해요. 상세페이지 롱 이미지, 셀링 포인트 모음 이미지, 인포그래픽 같은 요구사항이라면 한 번의 호출로 정보량이 많은 완성본을 얻을 수 있어요.
이 방법의 가장 큰 장점은 일관성 문제가 애초에 발생하지 않는다는 점이에요. 모든 내용이 같은 이미지 안에서 모델에 의해 한 번에 생성되니까 색감과 스타일이 자연스럽게 통일되고, 별도의 오케스트레이션 코드도 필요 없어요. 단점은 이미지 한 장의 여백이 한정적이라 내용이 너무 많아지면 글자가 작아지고 빽빽해지며, 개별 메인 이미지로 분리해서 광고에 투입할 수 없다는 거예요.
gpt-image-2 상세 롱 이미지의 구역별 프롬프트 작성법
단일 이미지에 다차원 정보를 담는 핵심은 구역별 설명이에요. 한 덩어리로 뒤섞인 설명을 쓰지 말고, 위에서 아래로 이어지는 레이아웃 순서대로 각 영역에 무엇을 넣을지 모델에게 알려주세요. 아래는 보온 텀블러 상세 롱 이미지의 프롬프트 구조 예시예요:
竖版 9:16 电商详情页长图,整体风格:简约北欧风,米白色背景,柔和自然光。
【顶部区域】产品主视觉:一只哑光墨绿色保温杯斜 45 度放置,标题文字“24 小时长效保温”。
【中部区域】三栏卖点,每栏一个线性图标加短文案:“316 不锈钢内胆”“一键弹盖单手开”“500ml 大容量”。
【底部区域】参数表格:容量 500ml、重量 320g、高度 22cm、材质 316 不锈钢。
所有文字使用清晰的无衬线中文字体,不要出现多余文字。
사이즈는 롱 이미지라면 9:16 세로형을 권장해요. 예를 들어 2K 등급의 1152x2048을 쓰면 돼요. 더 고화질인 최종 소재가 필요하다면 4K 등급의 2160x3840을 사용하면 돼요.
단일 이미지 방식은 호출 1회면 끝나서 비용이 가장 낮고 스타일도 자연스럽게 통일돼요. 대신 정보 용량이 한정적이라 블록이 5개를 넘으면 텍스트가 빽빽해지기 쉽고, 따로 떼어내 검색 메인 이미지로 광고할 수도 없어요. 가전, 디지털 액세서리, 생활용품처럼 스펙 중심의 표준 제품 상세페이지나 셀링 포인트 모음에 가장 잘 맞아요.
💡 실전 팁: 구역이 5개를 넘으면 텍스트 렌더링 오류율이 눈에 띄게 올라가요. 롱 이미지를 2~3장의 “하프 스크린 이미지”로 쪼개서 각각 생성한 뒤 상세페이지에서 세로로 이어 붙이는 걸 권장해요. 이 하프 스크린 이미지들은 그 자체로 작은 세트를 이루기 때문에 자연스럽게 방안 2로 넘어가게 돼요.
방안 2: 텍스트 모델로 분해 + gpt-image-2를 여러 번 호출해 이커머스 이미지 세트 생성
정말로 여러 장이 각각 독립된 세트(메인 이미지, 셀링 포인트 이미지, 연출 이미지)를 원한다면 작은 파이프라인이 필요해요. 발상은 “요구사항 이해와 샷 구성”은 텍스트 모델에 맡기고, “이미지 생성”은 gpt-image-2에 맡기되, 둘을 구조화된 JSON으로 연결하는 거예요.
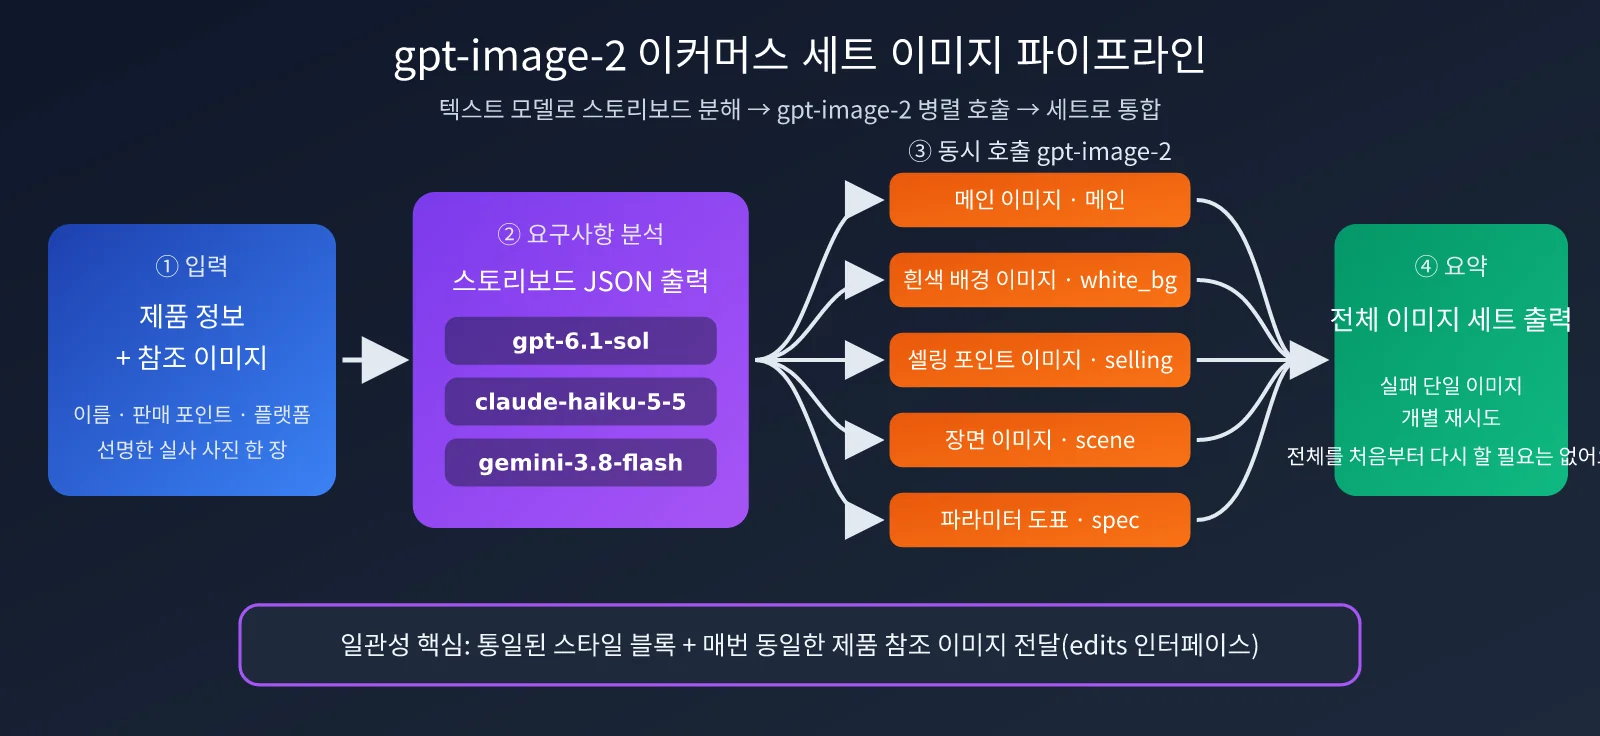
전체 흐름은 4단계예요:
- 입력: 판매자가 제품명, 셀링 포인트, 타깃 플랫폼, 그리고 최소 한 장의 선명한 제품 실사진을 제공해요.
- 요구사항 분석: 텍스트 모델이 입력을 바탕으로 JSON 배열을 출력해요. 각 요소가 이미지 한 장의 샷 구성이며, 용도, 프롬프트, 사이즈, 카피를 포함해요.
- 동시 생성: 프로그램이 샷 배열을 순회하면서 각 샷마다 gpt-image-2를 한 번씩 호출하고, 동일한 제품 참조 이미지를 함께 넘겨요.
- 취합 및 검증: 모든 결과를 모으고, 실패한 이미지는 개별적으로 재시도한 뒤 마지막에 순서대로 세트 전체를 출력해요.
텍스트 모델 선택 기준: gpt-image-2 이미지 세트의 ‘두뇌’
요구사항 분석 단계에서 텍스트 모델에 요구되는 역량은 이커머스 마케팅 논리를 이해하고, JSON을 안정적으로 출력하며, 화면 감각이 살아 있는 프롬프트를 쓸 수 있는 것이에요. 현재 APIYI에서 제공하는 최신 모델 몇 가지 모두 이 조건을 만족해요:
| 모델 | 포지션 | 적합한 상황 | 선택 이유 |
|---|---|---|---|
| gpt-6.1-sol | 플래그십 추천 | 고가 상품, 복잡한 셀링 포인트 정리 | 마케팅 카피와 샷 구성 품질이 가장 좋음 |
| claude-haiku-5-5 | 저가·고속 | 대량 SKU, 표준화된 카테고리 | 지시 준수가 안정적이고 JSON 출력이 정돈됨 |
| gemini-3.8-flash | 저가·고속 | 대량 배치, 다국어 크로스보더 상품 | 빠르고 저렴하며 다국어 카피가 자연스러움 |
요구사항 분석은 세트당 한 번만 호출하니 토큰 소모가 아주 적고, 비용은 대부분 이미지 생성에서 발생해요. 먼저 gpt-6.1-sol로 프롬프트 템플릿을 만족스러울 때까지 다듬고, 대량으로 돌릴 때 claude-haiku-5-5나 gemini-3.8-flash로 바꿔 비용을 낮추는 걸 권장해요. 세 모델 모두 APIYI apiyi.com에서 OpenAI 호환 인터페이스로 제공되기 때문에 전환할 때는 model 파라미터만 바꾸면 돼요.
gpt-image-2 이커머스 이미지 세트의 샷 JSON 설계
텍스트 모델이 고정된 구조의 JSON을 출력하게 만드는 것이 파이프라인이 안정적으로 돌아가는 핵심이에요. 아래는 권장 필드 설계예요:
| 필드 | 타입 | 설명 | 예시 |
|---|---|---|---|
scene |
string | 세트 내 위치 식별자 | main / white_bg / selling |
purpose |
string | 이 이미지의 마케팅 역할 | 제품 외관 부각, 클릭률 향상 |
prompt |
string | gpt-image-2에 전달할 전체 프롬프트 | 무광 다크그린 텀블러를 원목 테이블 위에… |
size |
string | 출력 사이즈 | 2048x2048 |
text_overlay |
string | 이미지에 렌더링할 텍스트 | 24시간 장시간 보온 |
gpt-image-2 이미지 세트 최소 코드
아래는 최소 실행 버전이에요. 먼저 텍스트 모델에게 샷 구성을 만들게 하고, 그다음 각 항목을 gpt-image-2의 edits 인터페이스(제품 참조 이미지 포함)로 호출해요.
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "为墨绿色 316 保温杯规划 5 张淘宝套图,输出 {\"shots\": [...]},"
               "每项含 scene/purpose/prompt/size/text_overlay,统一风格:北欧简约、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
이 코드는 순차 실행이라 5장을 차례로 기다려야 해요. 다음 절에서 동시 실행 버전으로 바꿀게요.
gpt-image-2 이커머스 세트의 스타일을 일관되게 유지하는 방법
여러 번 호출할 때 가장 자주 터지는 문제는 5장의 이미지가 마치 서로 다른 5개 매장에서 만든 것처럼 보이는 거예요. 아래 몇 가지 기법을 조합하면 일관성을 상용 수준까지 끌어올릴 수 있어요:
- style block 통일: 색감, 조명, 배경, 카메라 언어를 한 단락의 고정 문장으로 작성해 모든 샷 프롬프트 끝에 붙이세요. 텍스트 모델이 매번 스타일 설명을 자유롭게 쓰게 두면 안 돼요.
- 제품 참조 이미지 고정: 매 호출마다 edits 인터페이스로 동일한 제품 실사진을 넘기고, 프롬프트에 “참조 이미지 속 제품의 색상, 로고, 구조를 그대로 유지”한다고 명시하세요. 피사체 일관성을 지키는 가장 효과적인 수단이에요.
- 파라미터 고정: 같은 세트는 동일한
quality등급을 사용하고, 사이즈는 꼭 필요할 때만 바꾸세요(예: 롱 이미지는 세로형). - n 파라미터로择优(우수작 선별): 메인 이미지처럼 가장 중요한 위치는
n=2나n=3으로 여러 변형을 생성한 뒤 사람이 가장 좋은 한 장을 고르세요. 이게 바로 n 파라미터의 올바른 사용법이에요.
🎯 일관성 제안: style block은 세트 전체의 ‘브랜드 규격’이에요. 매장마다 고정 템플릿을 하나씩 정리해두길 권장해요. APIYI apiyi.com으로 gpt-image-2를 호출할 때 style block을 설정 파일에 넣어두고 모든 SKU가 공유하게 하면, 시즌이 바뀔 때 한 번에 갱신하면 끝이에요.
gpt-image-2 이커머스 세트 이미지 병렬 호출: 속도 높이기와 물량 확대 전략
5장짜리 세트 이미지를 직렬로 생성하면 대기 시간은 각 이미지 소요 시간의 합이 돼요. 이미지가 많을수록 느려지죠. 그런데 각 컷은 서로 의존하지 않기 때문에 얼마든지 병렬로 호출할 수 있어요. 그러면 세트 전체 소요 시간이 ‘가장 느린 한 장’의 시간에 가까워져요.
APIYI는 gpt-image-2 호출에 동시 호출 상한을 두지 않았어요. 500 RPM 이하라면 별도 신청 없이 바로 사용할 수 있어요. 대다수 판매자에게는 수십 개 SKU의 세트 이미지를 동시에 돌려도 이 수준에 훨씬 못 미쳐요.
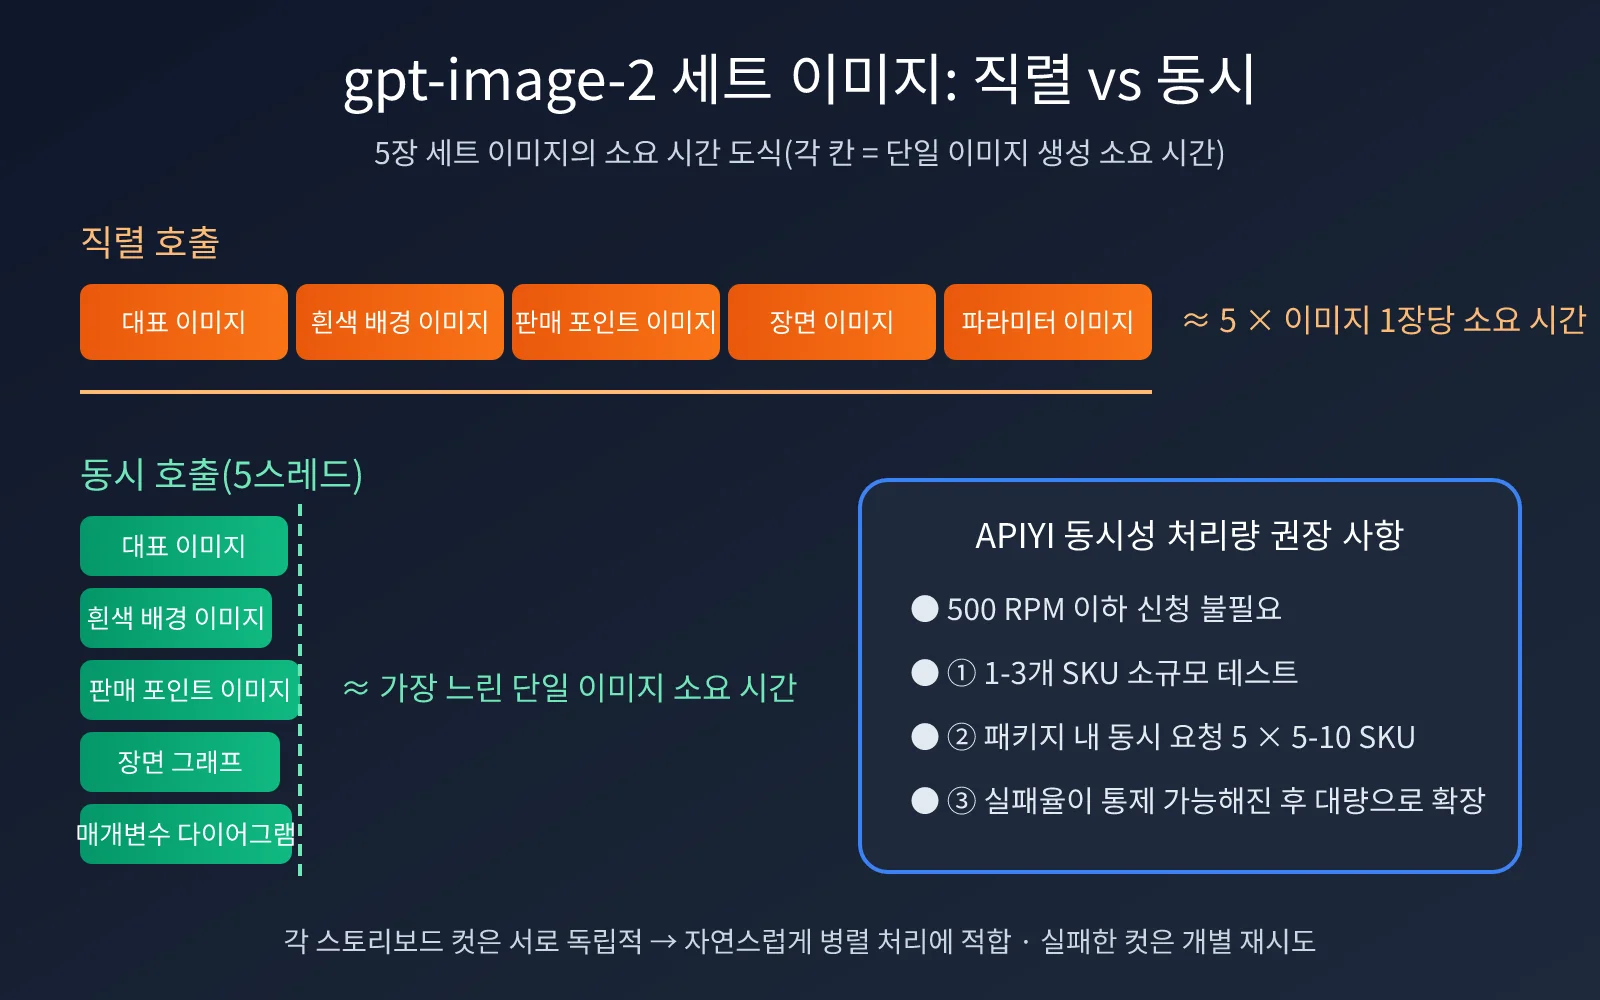
gpt-image-2 세트 이미지 병렬 코드
위의 직렬 루프를 스레드 풀로 바꾸면 병렬로 이미지를 생성할 수 있어요. 여기에 실패 재시도를 더하면 한 장이 실패해서 세트 전체를 처음부터 다시 돌리는 일도 막을 수 있죠.
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
전체 코드 보기 (style block, 다중 SKU 배치, 실패 재생성, 결과 저장 포함)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。전체 스타일: 북유럽 미니멀, 아이보리 배경, 부드러운 자연광, 저채도 컬러, "
    "참조 이미지에 있는 제품의 색상과 로고, 구조를 그대로 유지하고, 텍스트는 명확한 산세리프 한글 폰트를 사용."
)

PLAN_PROMPT = """당신은 이커머스 비주얼 기획 전문가예요. 아래 상품 정보를 바탕으로 {count}장짜리 {platform} 세트 이미지를 기획하세요.
상품 정보: {product}
JSON 출력: {{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
요구사항: 각 이미지는 서로 다른 마케팅 역할을 담당할 것, prompt에는 화면 내용만 서술하고 전체 스타일은 서술하지 말 것,
텍스트가 필요하면 원문 텍스트를 prompt에 그대로 쓰고 따옴표로 감쌀 것."""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """텍스트 모델로 컷을 분해해요. 배치 처리 시 claude-haiku-5-5 / gemini-3.8-flash로 교체 가능"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """단일 이미지 생성, 실패 시 지수 백오프로 재시도"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] {attempt + 1}번째 실패: {e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # 실패한 단일 이미지 한 차례 재생성
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: 성공 {sum(1 for v in results.values() if v)}/{len(shots)}장")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="진한 녹색 316 스테인리스 보온병, 500ml, 24시간 보온, 원터치 뚜껑",
        ref_image="cup.png",
    )
병렬 처리 물량 확대의 3단계
동시 호출 상한이 없다고 해도 단계적으로 물량을 늘리는 걸 권해요. 먼저 결과를 검증하고 나서 규모를 키워야 수백 장의 불합격 이미지가 한 번에 쏟아지는 일을 막을 수 있어요.
- 소규모 테스트: SKU 1~3개를 골라 직렬 또는 낮은 병렬로 끝까지 돌려보고, 제품 재현도와 텍스트 정확도, 스타일 통일성을 사람이 직접 확인해요.
- 중간 병렬: 결과가 안정되면 세트당 5개 병렬, 동시에 5~10개 SKU로 늘려 실패율과 평균 소요 시간을 지켜봐요.
- 배치 확대: 실패율이 관리 가능한 수준임을 확인한 뒤에는 업무량에 맞춰 병렬을 계속 올려요. 500 RPM 이내라면 바로 돌려도 돼요.
| 호출 방식 | 세트 5장 소요 시간 | 안정성 | 적합한 단계 |
|---|---|---|---|
| 직렬 호출 | 단일 소요의 약 5배 | 가장 안정적, 디버깅에 유리 | 프롬프트 튜닝 단계 |
| 세트 내 병렬 (5 스레드) | 가장 느린 한 장과 비슷 | 안정적 | 일상 신상품 등록 |
| 다중 SKU + 세트 내 병렬 | 단일 세트와 비슷 | 재시도 병행 필요 | 대형 프로모션 배치 등록 |
🚀 물량 확대 제안: 대형 프로모션을 앞두고 신상품을 몰아 올리는 상황이라면, APIYI apiyi.com을 통해 ‘다중 SKU + 세트 내 병렬’ 방식을 쓰는 걸 추천해요. 플랫폼은 500 RPM 이하에서 별도 신청이 필요 없고, 실패 건 재생성 메커니즘을 함께 쓰면 수십 개 SKU의 세트 이미지를 아주 짧은 시간에 모두 완성할 수 있어요.
gpt-image-2 전자상거래 이미지 세트, 어떤 방안을 선택할까
두 가지 방안은 서로 배타적이지 않아요. 실제 비즈니스에서는 자주 조합해서 사용한답니다. 아래에 주요 플랫폼과 상황별로 추천을 정리했어요:
| 플랫폼/상황 | 추천 방안 | 권장 장수 | 설명 |
|---|---|---|---|
| 타오바오/티몰 메인 이미지 | 방안 2 | 5장 | 메인, 흰 배경, 셀링 포인트, 연출, 파라미터 각 1장 |
| 타오바오/핀둬둬 상세 페이지 | 방안 1 + 방안 2 | 3-6장 반 화면 이미지 | 구간별로 생성한 뒤 세로로 이어 붙이기 |
| 아마존 리스팅 | 방안 2 | 7장 | 첫 이미지는 흰 배경으로 엄격하게 규정 준수, 나머지는 셀링 포인트와 연출 |
| 독립몰 상품 페이지 | 방안 2 | 4-6장 | 연출 이미지 비중이 더 높고, 브랜드 개성 강조 |
| 샤오홍슈 시딩 | 방안 2 | 3-6장 | 3:4 세로 비율, 생활감 있는 연출 위주 |
| 이벤트 포스터/셀링 포인트 모음 | 방안 1 | 1장 | 단일 이미지에 정보를 집중, 전파 효율이 높음 |
선택의 핵심 원칙은 아주 간단해요. 독립적으로 노출되고 따로 배치되어야 하는 이미지는 방안 2를, 한 페이지 안에서 연속으로 읽히는 내용은 방안 1을 사용하세요. 판단이 어렵다면 우선 방안 2로 메인 이미지와 연출 이미지를 뽑고, 그다음 방안 1로 셀링 포인트 모음 롱 이미지를 하나 만들면 커버 범위가 가장 넓어요.
💡 조합 제안: 두 방안 모두 같은 gpt-image-2 모델과 같은 API 키를 사용해요. 두 흐름을 하나의 서비스로 묶어서 상품 유형에 따라 자동으로 방안을 선택하게 하면, 판매자는 상품 사진 한 장과 셀링 포인트 몇 줄만 업로드하면 끝이에요.
자주 묻는 질문
gpt-image-2의 n 파라미터로 전자상거래 이미지 세트를 바로 생성할 수 있나요?
안 돼요. 공식 gpt-image-2와 2.5 시리즈 모두 n 파라미터를 지원하고 APIYI도 지원하지만, 이건 같은 프롬프트로 n개의 변형을 생성하는 거예요. 이미지 세트는 각 이미지의 내용이 다르기 때문에 서로 다른 프롬프트가 필요하고, 그래서 여러 번 호출해야 해요. n은 메인 이미지처럼 중요한 위치에서 최적의 한 장을 고르는 용도로 쓰는 게 더 적합해요.
생성된 여러 이미지에서 상품이 다르게 보이면 어떻게 하나요?
이건 이미지 세트에서 가장 흔한 문제예요. 가장 효과적인 방법은 매번 호출할 때 edits 인터페이스로 동일한 상품 실사진을 전달하고, 프롬프트에 “참조 이미지 속 상품의 색상, 로고, 구조를 그대로 유지”라고 명시하는 거예요. 동시에 스타일 설명을 고정된 style block으로 만들어서 텍스트 모델이 자유롭게 변형하지 않도록 하세요. 참조 이미지는 배경이 깔끔하고 조명이 균일한 실사진을 쓰는 게 복원 효과가 가장 좋아요.
이미지 속 한자 텍스트가 잘못 렌더링되면 어떻게 처리하나요?
gpt-image-2의 한자 렌더링 능력은 이미 상당히 뛰어나지만, 텍스트가 많을수록 오류 확률이 높아져요. 이미지당 텍스트는 2-3개의 짧은 문장 이내로 제한하고, 프롬프트에서 텍스트 원문을 따옴표로 표시하는 걸 권장해요. 특정 이미지에서 텍스트가 잘못 나왔다면 그 이미지만 다시 생성하면 되고, 세트 전체를 다시 만들 필요는 없어요.
텍스트 분해에는 어떤 모델이 가장 경제적일까요?
프롬프트 템플릿을 디버깅할 때는 gpt-6.1-sol을 쓰면 기획 품질이 가장 좋아요. 템플릿이 안정화된 뒤 대량으로 돌릴 때는 claude-haiku-5-5나 gemini-3.8-flash로 전환하면 비용이 더 낮고 속도도 더 빨라요. 이 단계는 이미지 세트당 한 번만 호출하니까, 이미지 생성 자체보다 비용이 훨씬 적게 들어요. 세 모델 모두 APIYI apiyi.com에서 같은 API 키로 호출할 수 있어요.
동시 호출에 할당량을 신청해야 하나요?
그럴 필요 없어요. APIYI는 gpt-image-2에 대해 동시 호출 상한을 두지 않아서, 500 RPM 이하라면 바로 사용하면 돼요. 우선 1-3개의 SKU로 소규모 테스트를 해보고, 효과를 확인한 뒤 점차 동시 호출 수를 높여서 대량으로 확장하는 걸 권장해요.
정리
gpt-image-2로 이커머스 세트 이미지를 만들 때 핵심은 “한 번의 호출이 하나의 프롬프트에 대응한다”는 인터페이스 특성을 이해하는 거예요. n 파라미터는 여러 장 중에서 가장 좋은 결과를 고르는 문제를 해결하지만, 세트 이미지에는 서로 다른 여러 프롬프트로 여러 번 호출하는 방식이 필요해요. 이런 전제 아래에서 상세 페이지나 셀링 포인트 모음처럼 이어서 읽는 콘텐츠는 단일 이미지 다차원 방안으로 한 번에 생성할 수 있어요. 반면 메인 이미지나 장면 이미지처럼 개별적으로 보여줘야 하는 세트 이미지는 텍스트 모델 분해 + 동시 호출 파이프라인으로 대량 처리하면 돼요.
두 접근법의 공통된 핵심은 일관성 제어예요. 고정된 style block에 동일한 제품 참조 이미지를 더하는 것이, 여러 이미지가 한 디자인 팀에서 나온 것처럼 보이게 하는 열쇠예요. 동시 처리 측면에서는 500 RPM 이하라면 바로 물량을 늘려도 되고, “소규모 테스트 → 중간 수준 동시성 → 대량 확장”의 세 단계로 가는 게 가장 안정적이에요.
저희는 APIYI apiyi.com을 통해 전 과정을 원스톱으로 처리하는 걸 권장해요. gpt-6.1-sol, claude-haiku-5-5, gemini-3.8-flash가 요구사항 분해를 맡고, gpt-image-2가 이미지 생성을 맡으며, 하나의 API 키로 모든 단계를 연결하니 나만의 이커머스 세트 이미지 생성 서비스를 빠르게 구축할 수 있어요.
작성자: APIYI Team | AI 대규모 언어 모델 API 기술 공유에 집중하고 있으며, 더 많은 모델 연동 튜토리얼은 APIYI apiyi.com에서 확인하세요