작성자 메모: Qwen4-Max는 아직 프리뷰 단계라서 공개된 벤치마크 점수, 컨텍스트 윈도우 길이, 토큰당 단가가 없어요. 이 세 가지는 Qwen3.8-Max와 억지로 비교할 수 없고, 지금 사용한 만큼 과금되는 방식으로 호출할 수 있는 모델은 여전히 qwen3.8-max예요.
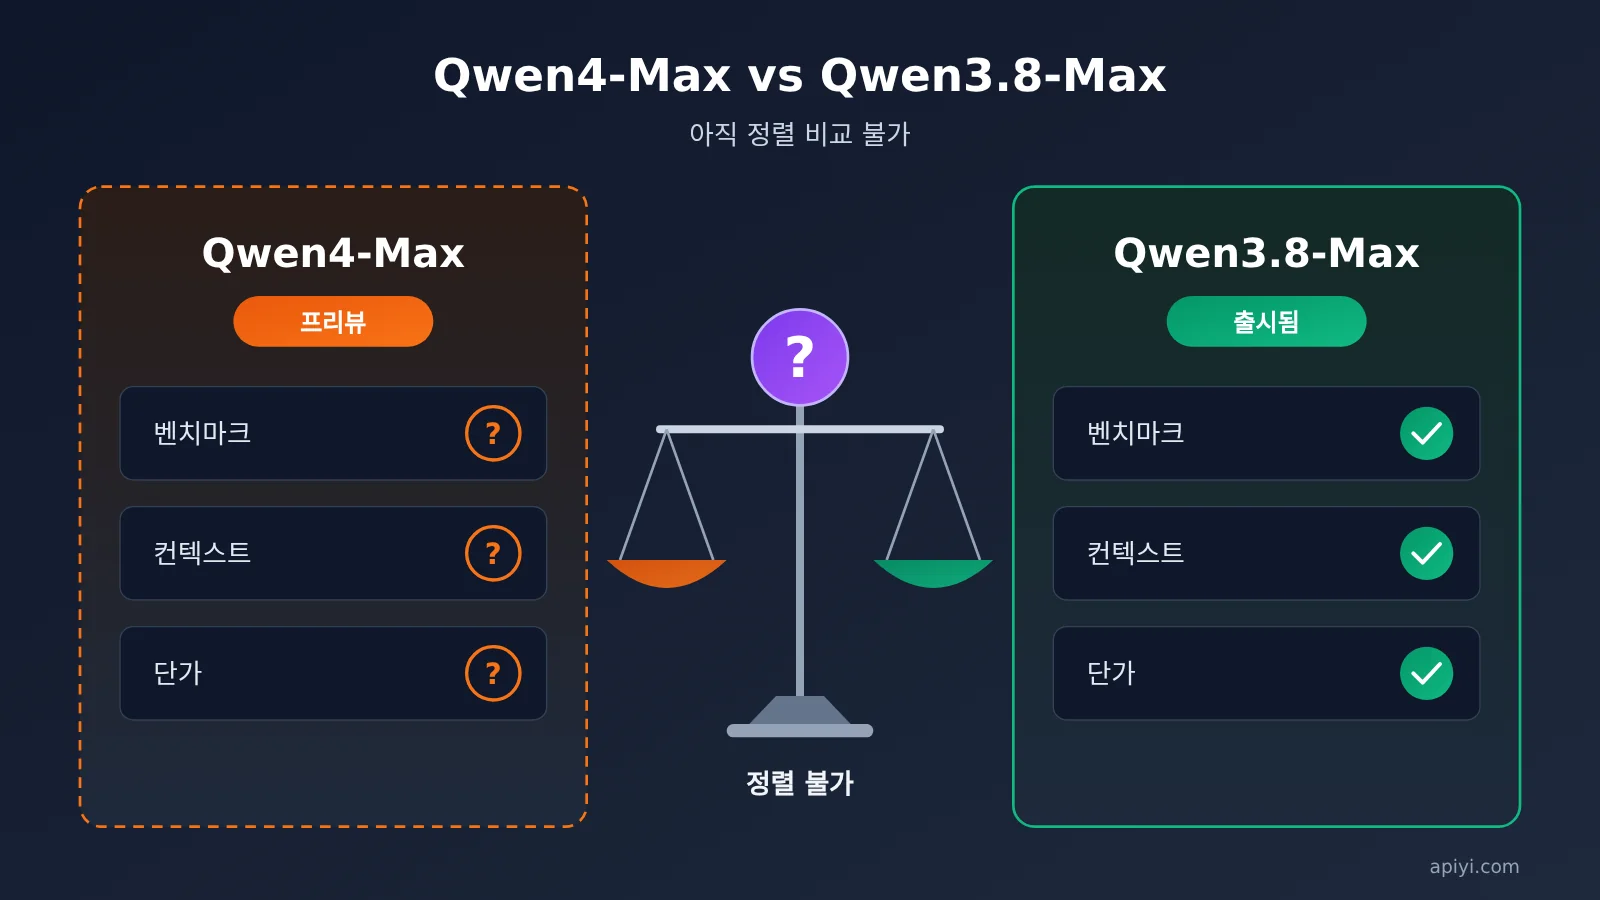
Qwen4-Max 프리뷰가 공개되자 Qwen을 쓰고 있는 개발자들이 가장 먼저 묻는 건 대개 이래요. 바꿔야 할까? Qwen3.8-Max보다 얼마나 더 좋을까? 얼마나 더 비쌀까? 이런 질문에는 아직 기준을 맞춰 비교할 수 있는 답이 없어요. 프리뷰 단계라서 비교에 꼭 필요한 공개 정보 세 가지가 빠져 있거든요.
Qwen4-Max를 깎아내리려는 글은 아니에요. 성능이 좋은지 나쁜지는 여기서 판단하지 않고, 사실 하나만 짚을게요. 2026-11-12 기준으로 Qwen4-Max 프리뷰에는 공개된 벤치마크 점수, 컨텍스트 윈도우 길이, 토큰당 단가가 없어요. 반면 Qwen3.8-Max는 이미 출시되어 사용량 기준으로 호출할 수 있고요. 2026-11-12 APIYI(apiyi.com)의 모델 목록 기준으로, 지금 바로 연동할 수 있는 모델은 qwen3.8-max예요.
핵심 가치: 3분이면 Qwen4-Max 프리뷰와 Qwen3.8-Max 사이에서 지금 비교할 수 없는 항목이 무엇인지, 그리고 공식 정보가 나오기 전까지 진행 중인 프로젝트를 어떻게 운영하면 좋을지 파악할 수 있어요.
Qwen4-Max와 Qwen3.8 핵심 정보 한눈에 보기
먼저 두 모델에 대해 현재 확인할 수 있는 정보를 한곳에 모았어요. 아래 표에는 참고 자료로 확인되는 내용만 담았고, 공개되지 않은 항목은 추측하지 않고 “미공개”로 표시했어요.
| 정보 항목 | Qwen4-Max(프리뷰) | Qwen3.8-Max |
|---|---|---|
| 출시 상태 | 프리뷰 단계 | 정식 출시 모델 |
| 공개 벤치마크 점수 | 미공개 | 정식 출시 모델이라 공식 자료에서 확인 가능 |
| 컨텍스트 길이 | 미공개 | 공식 문서와 모델 설명 기준 |
| 토큰당 단가 | 미공개 | 입력 $1.65 / 출력 $4.95 / 캐시 읽기 $0.20625 (1M tokens당) |
| 종량제 호출 | 2026-11-12 기준 모델 목록에 아직 없음 | 호출 가능, 모델 ID qwen3.8-max |
| 이용 가능 플랫폼 | 이후 공식 공지 기준 | APIYI 등 플랫폼 |
표에서 “미공개”는 벤치마크 점수, 컨텍스트 길이, 단가 이렇게 세 번 나와요. 이 세 가지는 모델을 고를 때 가장 자주 비교하는 기준이라서, 하나라도 빠지면 항목별 비교가 성립하지 않아요. 프리뷰 공개 현황은 이미 다른 글에서 소개했으니, 이 글에서는 이 세 항목을 왜 억지로 비교하면 안 되는지만 다룰게요.
Qwen4-Max 프리뷰에서 빠진 세 가지 정보가 미치는 영향
벤치마크 점수는 성능 판단의 근거가 돼요. 공식 벤치마크 점수가 없으면 추론, 코드, 장문 처리 같은 작업에서 Qwen4-Max가 Qwen3.8-Max보다 나은지 못한지 같은 기준으로 가늠할 수 없어요. 커뮤니티에 올라온 캡처나 개별 대화 체험은 테스트셋, 프롬프트, 샘플링 파라미터가 제각각이라 정식 벤치마크를 대신할 수 없어요.
컨텍스트 길이는 아키텍처 설계를 좌우해요. RAG의 청크 크기, 대화 기록을 자르는 전략, 긴 문서를 한 번에 넣을지 나눠서 처리할지는 모두 확정된 컨텍스트 윈도우 상한을 전제로 해요. 이 숫자가 정해지지 않으면 마이그레이션 후 기존의 분할 로직을 없애도 되는지, 입력이 너무 길어서 오류가 나지는 않는지 판단할 수 없어요.
토큰당 단가는 비용 모델의 기초예요. 예산, 가격 책정, 속도 제한 정책은 모두 단가를 바탕으로 세워요. 프리뷰 단계에서 써볼 수 있다고 해서 비용 표에 넣을 수 있는 가격이 정해졌다는 뜻은 아니에요. 확정되지 않은 가격을 qwen3.8-max의 현행 단가와 비교하면 의미 있는 결론이 나오지 않아요.
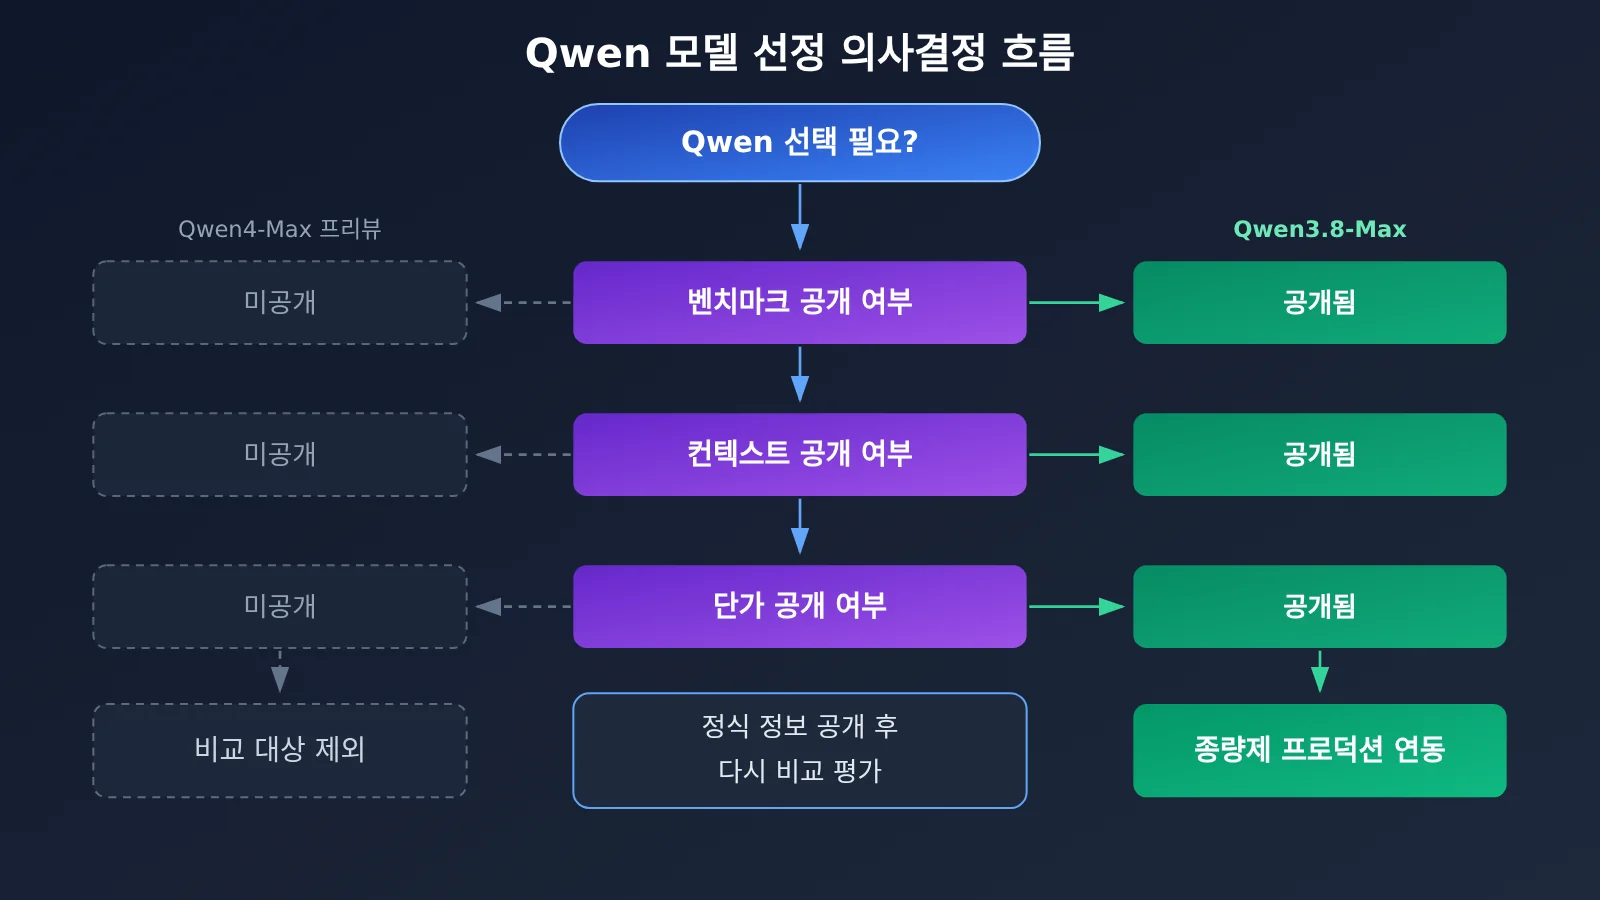
Qwen3.8-Max 지금 종량제로 호출할 수 있는 가격과 연동 방법
비교할 조건이 아직 갖춰지지 않았으니, 진행 중인 프로젝트는 이미 출시된 모델을 기준으로 잡는 게 좋아요. 아래 표는 2026-11-12 모델 목록에 나온 qwen3.8-max의 가격이에요. 단위는 1M 토큰당 가격이고요.
| 과금 항목 | 단가 (1M tokens당) | 설명 |
|---|---|---|
| 입력 | $1.65 | 캐시에 적중하지 않은 프롬프트 부분 |
| 출력 | $4.95 | 모델이 생성한 내용, 단가는 입력의 3배 |
| 캐시 읽기 | $0.20625 | 캐시에 적중한 입력 부분, 단가는 입력의 1/8 |
구조를 보면 출력 단가는 입력의 3배이고, 캐시 읽기는 입력의 12.5%밖에 안 돼요. 그래서 출력 길이를 조절하고 캐시 적중률을 높이는 것이 qwen3.8-max 비용을 줄이는 가장 직접적인 두 가지 방법이에요. 시스템 프롬프트가 길거나 멀티턴 대화의 앞부분(prefix)이 일정하게 유지되는 상황이라면 캐시의 효과가 더 크게 나타나요.
Qwen3.8-Max 비용 추정 예시
위 단가로 대표적인 요청 몇 가지의 비용을 계산해 봤어요. 아래 숫자는 모두 공개된 단가를 그대로 계산한 값이라서, 여러분의 서비스 호출량에 그대로 대입해 볼 수 있어요.
| 시나리오 | 입력 tokens | 이 중 캐시 적중 | 출력 tokens | 1회 비용 |
|---|---|---|---|---|
| 일반적인 단일 요청 | 10,000 | 0 | 2,000 | $0.0264 |
| 같은 요청, 프리픽스 캐시 적중 | 10,000 | 8,000 | 2,000 | $0.01485 |
| 입력 1M 일괄 처리 | 1,000,000 | 0 | 200,000 | $2.64 |
두 번째 행은 첫 번째 행과 입력·출력 총량이 같아요. 다만 입력 토큰 8,000개가 캐시에 적중하면서 1회 비용이 $0.0264에서 약 $0.0149로 내려가, 40% 넘게 줄어들어요. Qwen4-Max 프리뷰는 아직 단가가 공개되지 않아서 이런 계산을 할 수 없어요.
qwen3.8-max 연동 방법
APIYI는 OpenAI 호환 인터페이스를 제공해요. OpenAI SDK든 호환 클라이언트든 그대로 연동할 수 있고, 바꿔야 할 파라미터는 세 가지뿐이에요.
base_url:https://api.apiyi.com/v1(APIYI 통합 인터페이스 사용)api_key: APIYI 콘솔에서 생성한 API 키model:qwen3.8-max
호출 방식은 Chat Completions와 같아서, messages 배열을 system, user, assistant 역할 순서로 구성하면 돼요. 기존 프로젝트가 OpenAI 호환 엔드포인트와 연동되어 있다면, 보통 base_url과 모델 ID만 바꾸면 되고 비즈니스 코드는 손대지 않아도 돼요.
🚀 빠른 시작: APIYI(apiyi.com)에 가입하면 무료 테스트 크레딧을 받을 수 있어요. 먼저
qwen3.8-max로 여러분의 실제 업무용 프롬프트를 돌려 보고, 실제 입력·출력 토큰과 캐시 적중 비율을 기록해 두세요. 나중에 Qwen4-Max가 정식으로 공개되면 바로 비교할 수 있는 데이터가 준비되어 있을 거예요.
Qwen4-Max 프리뷰가 기존 Qwen 프로젝트에 미치는 영향 분석
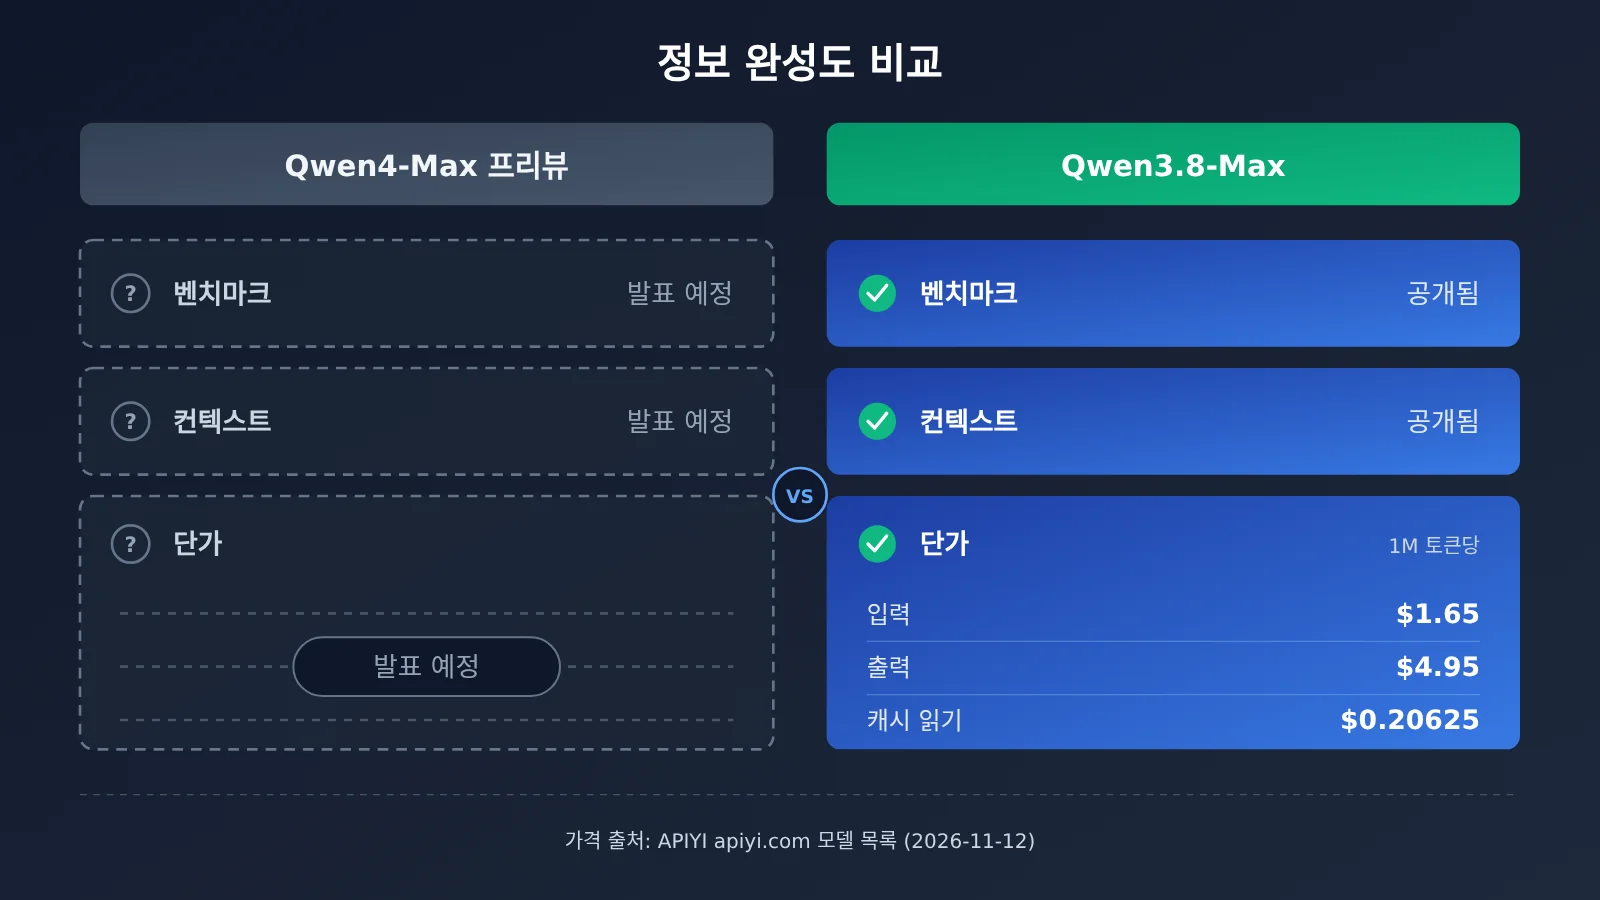
위 그림은 양쪽의 정보 완성도를 나란히 보여줘요. 한쪽은 공개 예정인 빈칸이 세 개이고, 다른 한쪽은 바로 확인할 수 있는 데이터예요. 이런 상태에서 비교하면 “얼마나 더 강하다”, “얼마나 더 비싸다” 같은 결론은 근거가 부족해요. 가격 데이터는 APIYI apiyi.com의 모델 목록에서 확인할 수 있어요.
현재 Qwen을 사용 중인 개발자에게 미치는 영향
- 프로덕션 환경은 건드릴 필요가 없어요: Qwen4-Max 프리뷰는 qwen3.8-max의 사용 가능 여부와 가격을 바꾸지 않아요. 기존 호출은 그대로 동작해요.
- 평가 작업은 미리 준비할 수 있어요: 자기 서비스를 대표하는 평가용 프롬프트와 채점 기준을 정리해 두면, 정식 정보가 공개된 직후 두 모델을 바로 비교할 수 있어요.
- 비용 예산은 계속 qwen3.8-max 기준으로 짜세요: 프리뷰 단계에서는 단가가 없으니 Qwen4-Max를 다음 단계의 예산이나 견적에 넣지 않는 게 좋아요.
- 컨텍스트 관련 개선은 일단 보류하세요: Qwen4-Max의 컨텍스트 길이가 공개되기 전에는 이 모델을 위해 청크 분할이나 잘라내기 로직을 바꾸지 않는 걸 권해요.
역할별 대응 제안
| 역할 | 지금 할 수 있는 일 | 정식 정보 공개 후에 할 일 |
|---|---|---|
| 애플리케이션 개발자 | 계속 qwen3.8-max를 사용하고 업무용 평가 세트를 쌓아 두기 |
같은 평가 세트로 두 모델 비교하기 |
| 아키텍처 책임자 | qwen3.8-max의 실제 한도에 맞춰 컨텍스트 전략 설계하기 | Qwen4-Max의 컨텍스트 길이를 보고 청크 분할을 단순화할지 평가하기 |
| 비용 책임자 | 입력 $1.65, 출력 $4.95 (1M 토큰당) 기준으로 예산 편성하기 | Qwen4-Max 단가를 확인한 뒤 마이그레이션 비용 다시 계산하기 |
| 프로덕트 매니저 | 대외 설명은 이미 출시된 모델의 능력을 기준으로 유지하기 | 공개된 벤치마크 점수를 보고 업그레이드를 홍보할지 결정하기 |
모델 선택 프로세스에 주는 시사점
프리뷰 버전이 가장 쉽게 불러오는 문제는 “새로워 보이는 것”을 “이미 더 좋아진 것”으로 착각하는 거예요. 제대로 된 모델 선택 프로세스에는 최소한 세 가지 공개 근거가 필요해요. 바로 성능(벤치마크 점수), 용량(컨텍스트), 비용(단가)이에요. 이 세 가지가 갖춰지기 전까지 새 모델은 관찰 목록에 넣어 두는 게 맞고, 프로덕션 계획에 넣기에는 일러요.
통합 인터페이스로 모델 호출을 관리하면 장점이 하나 더 있어요. 나중에 Qwen4-Max가 종량제 호출로 정식 개방되면 model 파라미터만 바꿔서 A/B 비교를 할 수 있고, SDK를 새로 연동할 필요도 없어요.
💡 선택 제안: Qwen4-Max의 핵심 정보 세 가지가 공개되기 전까지는 qwen3.8-max를 프로덕션의 주력으로 쓰는 걸 권해요. APIYI apiyi.com의 통합 인터페이스로 연동해 두면, 이후 새 모델이 출시됐을 때 같은 코드에서 빠르게 전환해 비교해 볼 수 있어요.
자주 묻는 질문 FAQ
Q1:Qwen4-Max 프리뷰를 지금 Qwen3.8-Max와 비교할 수 있나요?
벤치마크 점수, 컨텍스트 길이, 토큰당 단가 이 세 가지는 아직 비교할 수 없어요. Qwen4-Max는 아직 프리뷰 단계라 세 항목 모두 공개되지 않았고, 통일된 비교 기준도 없어요. 확실하게 말할 수 있는 건 출시 상태뿐이에요. Qwen3.8-Max는 이미 출시되어 사용량 기반으로 호출할 수 있고, Qwen4-Max는 아직 프리뷰 중이에요.
Q2:Qwen4-Max가 이미 Qwen3.8-Max를 전면적으로 앞섰나요?
현재로서는 이 결론을 뒷받침하는 공개 데이터가 없어요. 새 세대 모델의 버전 번호가 더 크다고 해서 모든 작업에서 더 뛰어나다는 뜻은 아니고, 가격이 더 합리적이라는 뜻도 아니에요. 앞서는지, 어떤 작업에서 앞서는지는 공식 벤치마크가 공개된 뒤에 판단하는 게 좋아요. 가능하면 자사 업무 평가 세트로도 직접 검증해 보세요.
Q3:Qwen3.8-Max의 현재 호출 가격은 얼마인가요?
2026-11-12 기준 모델 목록에서 qwen3.8-max는 1M 토큰당 입력 $1.65, 출력 $4.95, 캐시 읽기 $0.20625예요. 캐시 읽기 단가는 입력의 1/8 수준이라, 프롬프트 접두부가 안정적인 환경에서는 비용을 눈에 띄게 줄일 수 있어요.
Q4:API로 Qwen3.8-Max를 빠르게 호출하려면 어떻게 하나요?
여러 모델을 지원하는 API 통합 플랫폼을 쓰는 걸 추천해요.
1. APIYI(apiyi.com)에서 계정을 만들고 API 키와 무료 테스트 크레딧을 받으세요.
2. base_url을 `https://api.apiyi.com/v1`로 설정하세요.
3. 모델 ID에 `qwen3.8-max`를 입력하고, OpenAI 호환 Chat Completions 형식으로 호출하세요.
Q5:Qwen4-Max가 정식으로 공개되면 마이그레이션 비용이 큰가요?
인터페이스 측면의 마이그레이션 비용은 연동 방식에 따라 달라요. OpenAI 호환 인터페이스로 통합 관리하고 있다면 보통 모델 ID만 바꾸면 돼요. 실제로 따져봐야 할 건 성능과 비용 차이예요. 지금부터 APIYI(apiyi.com)에서 qwen3.8-max로 평가 데이터를 쌓아 두면, 나중에 바로 비교해 볼 수 있어요.
Q6:프리뷰 단계에서 주의해야 할 제약이 있나요?
프리뷰 단계에서는 핵심 파라미터가 언제든 바뀔 수 있어요. 벤치마크가 공개되지 않아 성능의 한계를 판단할 수 없고, 컨텍스트 길이가 공개되지 않아 긴 텍스트 처리 방안을 확정할 수 없으며, 단가가 공개되지 않아 예산에도 반영할 수 없어요. 그래서 안정성과 비용 요건이 있는 프로덕션 서비스에는 프리뷰 모델을 쓰지 않는 게 좋아요.
Qwen4-Max와 Qwen3.8 핵심 요약 Key Takeaways
- 출시 상태가 달라요: Qwen4-Max는 아직 프리뷰 단계이고, Qwen3.8-Max는 이미 출시되어 사용량 기반으로 호출할 수 있는 모델이에요.
- 세 가지 항목은 억지로 비교할 수 없어요: Qwen4-Max의 벤치마크 점수, 컨텍스트 길이, 토큰당 단가는 모두 공개되지 않았어요.
- 섣불리 결론을 내리지 마세요: 공개된 데이터가 없는 상태에서는 Qwen4-Max가 Qwen3.8-Max를 전반적으로 앞선다고 단정할 수 없어요.
- 현재 가격은 확인할 수 있어요: qwen3.8-max는 1M 토큰당 입력 $1.65, 출력 $4.95, 캐시 읽기 $0.20625예요.
- 캐시가 비용 절감의 핵심이에요: 캐시 읽기 단가는 입력 단가의 1/8에 불과해서, 프리픽스가 안정적인 시나리오에서 효과가 확실해요.
- 프로덕션에서는 qwen3.8-max를 기준으로 하세요: APIYI 통합 인터페이스로 연동하면 이후 모델을 바꿀 때 모델 ID만 수정하면 돼요.
정리
Qwen4-Max 프리뷰와 Qwen3.8-Max의 관계를 핵심만 정리하면 다음과 같아요.
- 비교할 조건이 아직 갖춰지지 않았어요: Qwen4-Max 프리뷰는 공개 벤치마크 점수, 컨텍스트 길이, 토큰당 단가가 없어서 세 항목 모두 Qwen3.8-Max와 억지로 비교할 수 없어요.
- 지금 쓸 수 있는 모델은 qwen3.8-max예요: 가격이 명확하게 공개되어 있고, 1M 토큰당 입력 $1.65, 출력 $4.95, 캐시 읽기 $0.20625예요.
- 지금은 준비하고, 정식 공개 후에 비교하세요: 먼저 업무용 평가 세트와 비용 데이터를 쌓아 두고, 정보가 충분히 갖춰진 뒤에 마이그레이션 여부를 판단하세요.
Qwen4-Max의 정식 정보가 공개되기 전까지는 qwen3.8-max로 서비스를 계속 운영하면서, 평가와 비용 기준선을 미리 마련해 두는 것이 안전해요. qwen3.8-max는 APIYI(apiyi.com)를 통해 연동하는 것을 추천해요. 이 플랫폼은 OpenAI 호환 통합 인터페이스와 무료 테스트 크레딧을 제공하기 때문에, 새 모델이 출시되면 같은 코드에서 바로 비교해 볼 수 있어요.
📚 참고 자료
- APIYI 모델 및 가격 목록: 2026-11-12 호출 가능 모델 확인
- 링크:
api.apiyi.com/api/pricing -
설명: 현재 종량제로 호출할 수 있는 Qwen 모델을 확인하는 데 사용했어요
-
APIYI 모델 문서: qwen3.8-max 과금 안내
- 링크:
docs.apiyi.com/models - 설명: qwen3.8-max의 입력, 출력, 캐시 읽기 단가가 나와 있어요
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 첫 화면에서 언제든 문의해 주세요. 더 많은 모델 연동 자료는 APIYI 문서 센터에서 확인하실 수 있어요