Anthropic이 2026년 11월 9일 Claude Fable 5.2를 공개하면서 내부 실험 결과를 밝혔어요. Fable 5.2는 빈 폴더에서 시작해 1000개가 넘는 하위 에이전트를 조율하고, 8일 동안 쉬지 않고 작업해 노트북에서 실행할 수 있는 운영체제 프로토타입을 만들었어요.
핵심 가치: 이 글을 읽으면 Claude Fable 5.2의 멀티 에이전트 워크플로 비용이 어떤 항목으로 구성되는지, 어떤 과금 규칙을 오해하기 쉬운지, 모델 선택과 호출 관리를 통해 총비용을 어떻게 제어할 수 있는지 알 수 있어요.
Claude Fable 5.2 운영체제 실험: 1000개 에이전트의 청구서는 왜 알 수 없을까요?
먼저 공식적으로 공개된 핵심 정보를 살펴볼게요. 이 실험은 모델의 코딩 능력뿐 아니라 대규모 소프트웨어 엔지니어링을 조직하고, 수많은 하위 에이전트를 조율하며, 장기간 작업을 이어 가고, 코드를 지속적으로 검증하는 능력도 보여 줘요.
| 정보 항목 | 세부 내용 |
|---|---|
| 공개일 | 2026년 11월 9일 |
| 공개 주체 | Anthropic |
| 실험 시작점 | 빈 폴더. 프로토타입 운영체제를 설계하고 구현하는 것이 과제였어요. |
| 에이전트 규모 | 하위 에이전트 1000개 이상 |
| 실행 기간 | 8일 동안 쉬지 않고 코드 작성, 테스트, 검토, 수정 진행 |
| 최종 결과물 | 실제 노트북에서 부팅할 수 있는 운영체제 프로토타입. 커널, 디스크·키보드·네트워크 드라이버, 파일 저장소, 윈도 시스템, 로그인 화면, 설치 프로그램, 내장 Claude 기능을 포함해요. |
| 공개되지 않은 정보 | 총 Token 사용량, 실험 총비용, 에이전트 분업 구조, 통신 프로토콜, 코드 규모 등 |
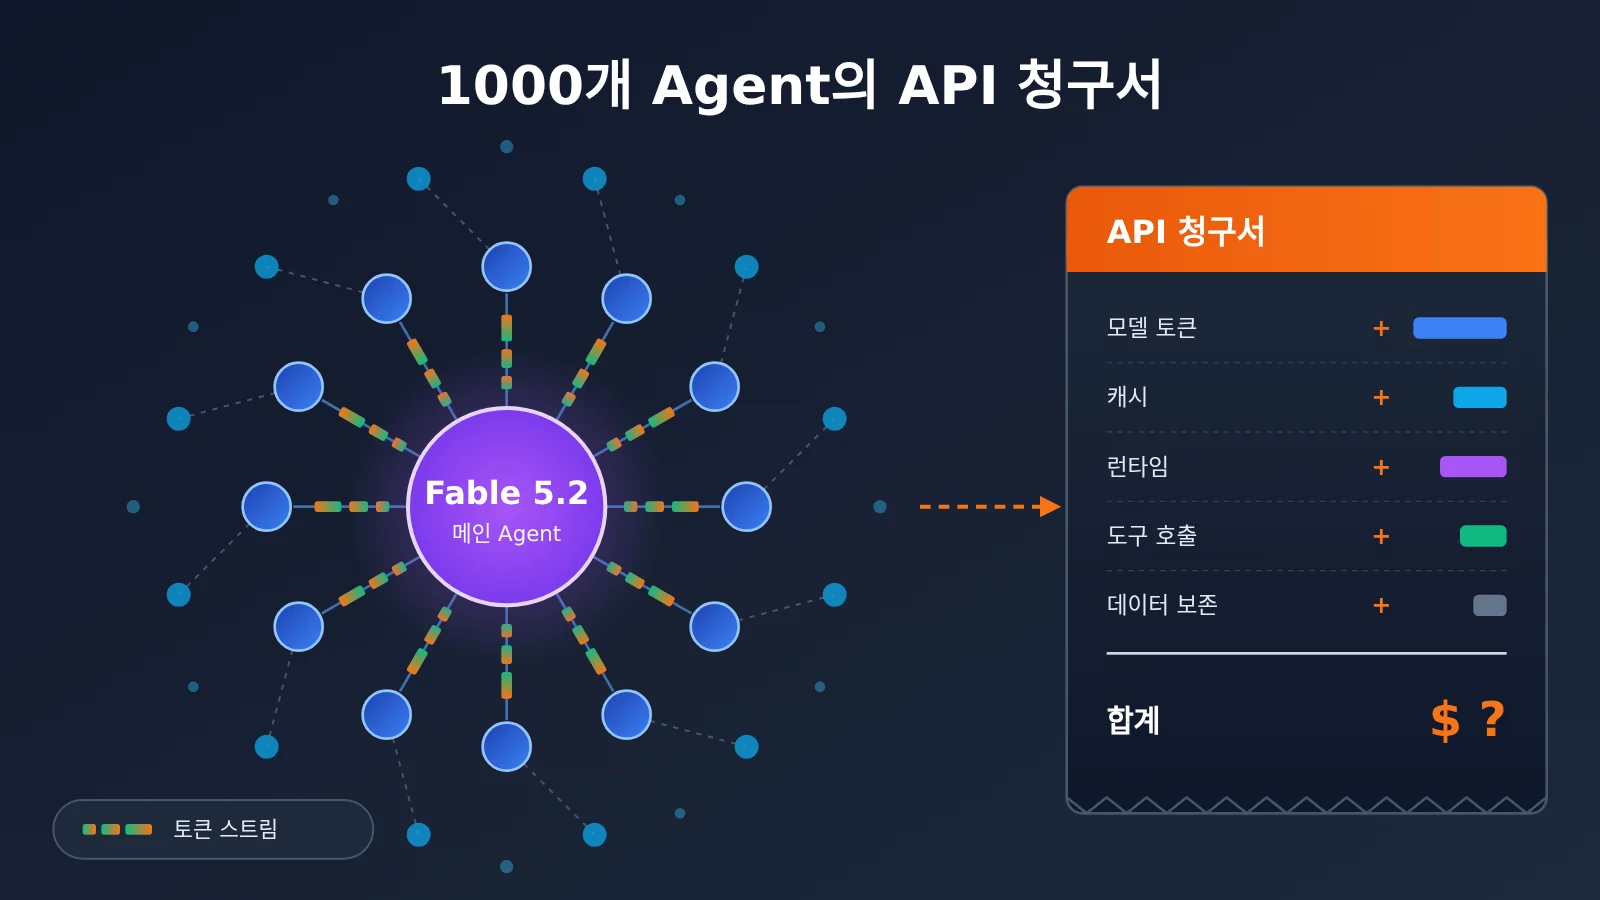
공식 발표에서 작동하는 운영체제 프로토타입이라고 표현했지만, 이것이 완성된 상용 운영체제라는 뜻은 아니에요. 또한 Anthropic은 이번 실험의 실제 청구서를 공개하지 않았기 때문에, “이 운영체제 개발에 얼마가 들었을까?”라는 질문에 대한 금액은 모두 추측일 수밖에 없어요.
에이전트 팀은 API 호출을 몇 단계나 만들까요?
실제 청구서를 몰라도 멀티 에이전트의 비용 부담이 어떻게 생기는지는 구조적으로 이해할 수 있어요. 메인 에이전트는 목표를 파악하고, 작업을 나눠 하위 에이전트에 배정한 뒤, 결과를 모아 요약하고 검증해야 해요. 하위 에이전트도 각자 프로젝트 배경과 도구 설명, 관련 코드를 읽고 추론과 결과 생성을 수행해요.
즉, ‘작업 완료’ 이면에는 여러 단계의 모델 호출이 겹쳐 있어요. 계획 수립, 실행, 결과 전달, 검증 호출이 필요하고, 실패하면 재시도 호출도 발생해요. 에이전트 수가 늘고 작업이 며칠씩 이어지면 Token 비용과 동시 호출, 장시간 실행이 모두 청구서에 영향을 주는 변수가 돼요.
Claude Fable 5.2 API 가격: 멀티 에이전트 비용의 출발점
멀티 에이전트 비용을 논하려면 먼저 단가부터 살펴봐야 해요. 아래 가격은 모두 Anthropic이 공개한 정가이며, 단위는 백만 토큰(MTok)당 달러예요.
| 모델 | 입력 가격 | 출력 가격 | 용도 |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | 복잡하고 개방적이며 장시간 실행되는 작업 |
| Claude Opus 5.5 | $4 | $20 | 공식적으로 권장하는 대부분의 프로그래밍 및 지식 작업의 출발점 |
| Claude Sonnet 5.5 | $2 | $10 | 중간 난이도의 하위 작업, 자료 처리 |
| Claude Haiku 5.5 | $0.10 | $0.50 | 단순하고 빈도가 높은 하위 작업(입력 100K 토큰 이하) |
Haiku 5.5는 입력이 100K 토큰을 초과하면 입력 가격이 $0.50/MTok, 출력 가격이 $2.50/MTok으로 바뀌어요. Fable 5.1의 기존 가격은 입력 $10, 출력 $50이었으므로, Fable 5.2의 표준 토큰 단가는 20% 낮아졌어요.
💡 선택 팁: 모델마다 성능이 같아 서로 대체할 수 있는 건 아니에요. 최종 선택은 작업 난이도와 품질 요구 사항에 따라 달라져요. APIYI apiyi.com에서 동일한 OpenAI 호환 인터페이스로 여러 Claude 모델의 실제 출력과 토큰 사용량을 비교한 뒤, 각 하위 작업에 어떤 모델을 배정할지 결정할 수 있어요. 구체적으로 사용할 수 있는 모델은 플랫폼의 모델 목록을 확인하세요.
Claude Fable 5.2 사양 및 Fast Mode
Fable 5.2의 API Model ID는 claude-fable-5-2예요. 컨텍스트 윈도우는 1M 토큰, 최대 출력은 128K 토큰이며, 지식 기준일은 2026년 6월이에요. Adaptive Thinking은 항상 활성화되어 있고, 기본 Effort는 High예요. Low, Medium, High, Xhigh, Max를 선택할 수도 있어요. Effort는 답변 스타일을 조정하는 매개변수가 아니에요. 사고의 깊이와 실행 시간, 토큰 사용량에 직접 영향을 줘요.
| 과금 항목 | 가격(달러/MTok) | 설명 |
|---|---|---|
| 일반 입력 / 출력 | $8 / $40 | 표준 모드 |
| Fast Mode 입력 / 출력 | $16 / $80 | 가격은 2배이며, 출력 속도는 일반 모드의 최대 2.5배 |
| Batch API 입력 / 출력 | $4 / $20 | 비동기 일괄 요청에 50% 할인이 적용되며, Fast Mode와 함께 사용할 수 없음 |
| 5분 캐시 쓰기 | $10 | 이후 재사용할 입력 접두부 저장 |
| 1시간 캐시 쓰기 | $16 | 더 긴 유효 기간 |
| 캐시 읽기 | $0.20 | 일반 입력 가격의 2.5%에 불과 |
이 표에서 알 수 있는 핵심은 가장 강력한 모델이 모든 하위 작업을 맡아야 하는 건 아니라는 점이에요. Fable 5.2로 형식 정리나 간단한 분류 같은 작업을 처리하면 단가가 Sonnet 5.5의 4배, Haiku 5.5의 80배예요. 하지만 추가 추론 능력으로 얻는 이점은 거의 없어요.
멀티 에이전트 비용은 어떻게 누적될까: Claude Fable 5.2 워크플로 분석
멀티 에이전트 시스템에서는 메인 에이전트가 계획과 취합을 맡고, 하위 에이전트가 구체적인 작업을 수행해요. 작업을 여러 에이전트에 ‘분담’하는 것처럼 보여도 Token이 사라지는 건 아니에요. 오히려 여러 단계에서 사용량이 늘어날 수 있어요.
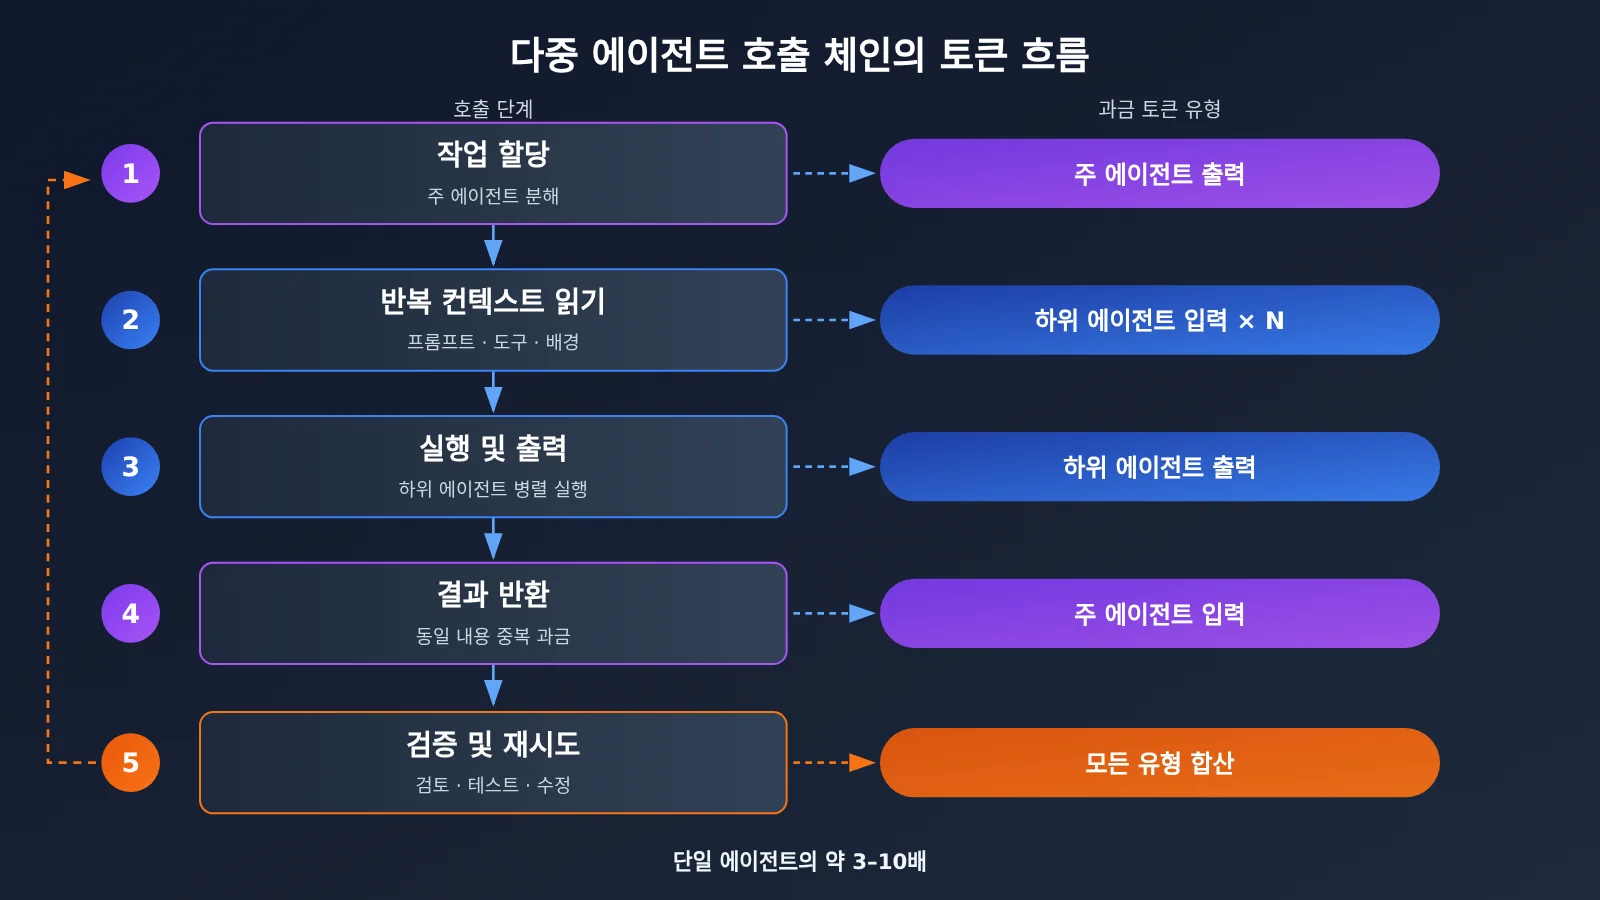
- 작업 할당: 메인 에이전트가 생성한 작업 설명은 출력 Token이며, 메인 에이전트가 사용하는 모델의 요금으로 계산돼요.
- 컨텍스트 반복 입력: 각 하위 에이전트는 System Prompt, 도구 설명, 프로젝트 배경을 새로 입력받아요. 같은 내용이 여러 번 요금에 반영돼요.
- 결과 반환: 하위 에이전트의 출력이 메인 에이전트의 입력이 되므로, 같은 내용에 두 번 요금이 부과되는 셈이에요.
- 여러 차례의 검증: 검토하고 테스트한 뒤 문제를 발견해 수정 작업을 다시 할당하면, 매번 새로운 호출이 발생해요.
- 실패 후 재시도: 호출이 실패하거나 결과가 기준에 미치지 못하면 다시 실행해요. 이때 Token 사용량이 그대로 추가돼요.
Anthropic의 2026년 멀티 에이전트 엔지니어링 가이드에 따르면, 같은 작업을 수행할 때 멀티 에이전트 시스템은 단일 에이전트보다 보통 3~10배 많은 Token을 사용해요. 이는 동일한 작업을 기준으로 한 일반적인 비교 범위이지, 고정된 배수가 아니에요. 간단한 예를 들어 볼게요. 단일 에이전트 작업의 Token 비용이 $1.60이라고 가정하고 모델과 입력·출력 비율이 같다면, 사용량이 3배일 때 비용은 $4.80, 10배일 때는 $16이에요.
이 때문에 병렬 실행이 전체 비용 절감을 뜻하지는 않아요. 병렬화로 줄어드는 건 실제 경과 시간이고, 각 에이전트가 사용하는 Token은 줄지 않아요. 조정 비용도 추가로 발생하죠. 실제로 관리해야 할 것은 에이전트 수 자체가 아니라, 각 에이전트의 Token 사용량이에요.
Claude Fable 5.2 멀티 에이전트 가정 시뮬레이션: 워크플로 하나에 드는 비용
다음은 가상의 워크플로예요. Fable 5.2 메인 에이전트 1개가 계획과 종합을 담당하고, Sonnet 5.5 하위 에이전트 10개가 각각 독립적인 자료 처리 작업을 맡습니다. 모든 토큰 사용량은 가정한 수치이며, Anthropic의 운영 실험에서 발생한 실제 청구액이나 같은 품질의 작업을 대상으로 한 모델 비교 테스트가 아닙니다.
메인 에이전트(Fable 5.2): 입력 토큰 100,000개, 출력 토큰 10,000개라고 가정합니다.
- 입력: 100,000 × $8 / 1,000,000 = $0.80
- 출력: 10,000 × $40 / 1,000,000 = $0.40
- 소계: $1.20
하위 에이전트 10개(Sonnet 5.5): 각 에이전트의 입력 토큰은 100,000개, 출력 토큰은 20,000개라고 가정합니다. 입력은 총 1,000,000개, 출력은 총 200,000개입니다.
- 입력: 1,000,000 × $2 / 1,000,000 = $2.00
- 출력: 200,000 × $10 / 1,000,000 = $2.00
- 소계: $4.00
| 구성 | 입력 비용 | 출력 비용 | 합계 |
|---|---|---|---|
| Fable 5.2 메인 에이전트 | $0.80 | $0.40 | $1.20 |
| Sonnet 5.5 하위 에이전트 10개 | $2.00 | $2.00 | $4.00 |
| 토큰 비용 합계 | $2.80 | $2.40 | $5.20 |
| Session Runtime(세션 1개가 정확히 8시간 동안 running 상태라고 가정) | — | — | $0.64 |
| 예시 총액(도구 비용 제외) | — | — | $5.84 |
Managed Agents의 Session Runtime은 어떻게 과금될까요?
Claude Managed Agents를 사용하면 Session Runtime 비용이 추가됩니다. 요금은 세션당 시간당 $0.08이에요. 세션이 running 상태인 시간만 과금 대상이며, idle 상태이거나 사용자의 확인을 기다리는 시간, 종료된 세션은 과금되지 않습니다. 하위 에이전트의 토큰 비용은 각 모델의 요금에 따라 별도로 계산합니다.
위 표의 $0.64는 “세션 하나가 정확히 8시간 동안 실행된다”는 가정에 따른 금액이에요. 8 × $0.08 = $0.64입니다. Runtime 비용은 에이전트 수에 시간당 요금을 곱하는 방식이 아니라, 세션 실행 시간에 따라 과금됩니다. 시스템에서 여러 세션이 실행됐다면 각 세션의 실제 running 시간을 따로 계산한 뒤 합산해야 해요. 따라서 $0.64를 멀티 에이전트 시스템의 실행 비용으로 고정해서 볼 수는 없습니다.
캐시, Batch, 도구 호출은 총비용을 어떻게 바꿀까요?
그 밖에도 몇 가지 과금 항목에 따라 같은 워크플로의 실제 청구액은 $5.84와 달라질 수 있어요.
- Prompt Caching: 하위 에이전트가 공유하는 System Prompt와 프로젝트 배경 정보가 캐시에 적중하면, 읽기 비용은 MTok당 $0.20입니다. 다만 첫 쓰기 비용은 일반 입력보다 비싸므로 적중 횟수가 너무 적으면 오히려 손해일 수 있어요.
- Batch API: 비동기 일괄 요청의 토큰 비용을 50% 할인받을 수 있어요. 하지만 Managed Agents는 상태를 유지하는 대화형 세션이므로 Messages API의 Batch 할인을 적용할 수 없습니다. 세션 비용에 50% 할인을 적용해서는 안 돼요.
- 도구 호출: Managed Agents의 Web Search는 1,000회당 $10입니다. 검색을 많이 사용하는 에이전트라면 비용을 별도로 계산해야 해요.
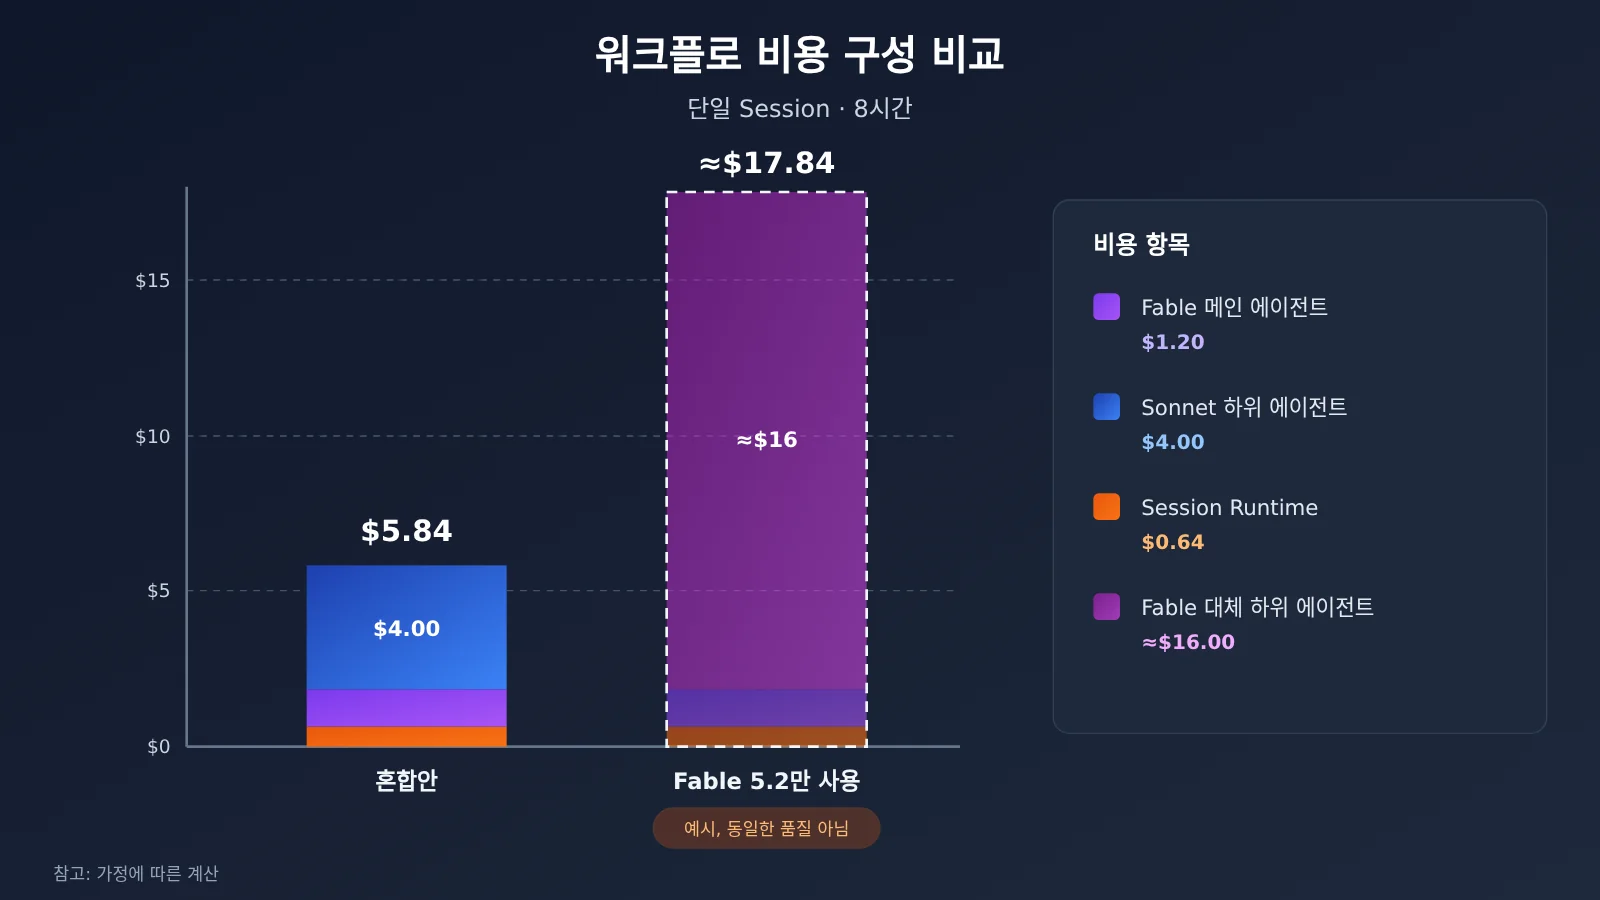
📊 이미지 설명: 위 데이터는 공개 가격을 바탕으로 계산한 가정치예요. 자신의 워크플로 비용을 추산하고 싶다면 APIYI apiyi.com을 통해 실제 요청을 몇 건 보내고, 응답의 usage 필드에서 실제 토큰 수를 확인한 뒤 가격표에 대입해 계산해 보세요.
Claude Fable 5.2 멀티 에이전트 시스템 비용 절감 방법
아래의 간단한 예제에서는 응답에서 사용량을 읽고 가격표를 기준으로 호출 1회당 비용을 추정하는 방법을 보여드려요. 모델 이름은 플랫폼에서 실제로 사용할 수 있는 모델 ID로 바꿔 주세요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="claude-sonnet-model-id",  # 플랫폼의 모델 목록에 있는 실제 ID로 바꾸세요
    messages=[{"role": "user", "content": "总结这段需求文档的要点"}]
)
u = resp.usage
cost = u.prompt_tokens * 2 / 1e6 + u.completion_tokens * 10 / 1e6  # Sonnet 5.5 공개 가격
print(resp.choices[0].message.content, f"估算费用: ${cost:.4f}")
전체 구현 코드 보기: 모델 등급별 호출 및 예산 누적
import openai

# 단위: 달러 / 백만 토큰, Anthropic 공개 가격 기준
PRICES = {
    "planner": {"model": "claude-fable-model-id", "in": 8, "out": 40},
    "worker":  {"model": "claude-sonnet-model-id", "in": 2, "out": 10},
    "simple":  {"model": "claude-haiku-model-id", "in": 0.10, "out": 0.50},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

class BudgetTracker:
    def __init__(self, limit_usd: float):
        self.limit = limit_usd
        self.spent = 0.0

    def add(self, tier: str, usage) -> float:
        p = PRICES[tier]
        cost = usage.prompt_tokens * p["in"] / 1e6 + usage.completion_tokens * p["out"] / 1e6
        self.spent += cost
        if self.spent > self.limit:
            raise RuntimeError(f"预算超限:已花费 ${self.spent:.2f}")
        return cost

def run(tier: str, prompt: str, tracker: BudgetTracker) -> str:
    resp = client.chat.completions.create(
        model=PRICES[tier]["model"],
        messages=[{"role": "user", "content": prompt}],
    )
    cost = tracker.add(tier, resp.usage)
    print(f"[{tier}] 本次 ${cost:.4f},累计 ${tracker.spent:.4f}")
    return resp.choices[0].message.content

tracker = BudgetTracker(limit_usd=10.0)
plan = run("planner", "把资料整理任务拆成 3 个独立子任务,每行一个", tracker)
results = [run("worker", f"执行子任务:{t}", tracker) for t in plan.splitlines() if t.strip()]
summary = run("planner", "汇总以下结果:\n" + "\n".join(results), tracker)
print(summary)
🚀 빠른 시작 팁: 먼저 APIYI apiyi.com에서 신규 사용자 무료 테스트 크레딧을 받아 보세요. 위 예산 추적 스크립트로 ‘계획—실행—요약’의 최소 흐름을 테스트하고, 실제 토큰 사용량을 확인한 다음 에이전트 규모를 늘리는 것을 추천해요.
위의 과금 규칙을 바탕으로 비용을 관리하는 방법은 다섯 가지로 정리할 수 있어요.
| 방법 | 실행 방법 | 적용 시 유의점 |
|---|---|---|
| 난이도에 따라 모델 선택 | 계획 수립과 복잡한 추론에는 Fable 5.2 또는 Opus 5.5 사용 | 공식 권장 사항은 대부분의 작업을 Opus 5.5부터 시작하는 것입니다 |
| 간단한 하위 작업은 낮은 등급 모델로 전환 | 분류, 형식 변환, 정보 추출에는 Sonnet 5.5 또는 Haiku 5.5 사용 | 저렴한 모델의 품질이 기준을 충족하는지 먼저 확인해야 합니다 |
| Prompt Caching 활성화 | 공유 System Prompt, 도구 설명, 긴 문서를 캐싱 | 절감 폭은 캐시 적중 횟수와 컨텍스트의 일관성에 따라 달라집니다 |
| 필요할 때만 Fast Mode 활성화 | 지연 시간에 민감한 대화형 요청에만 사용 | 가격이 두 배라 오프라인 작업에는 비효율적입니다 |
| 예산 및 모니터링 | 모델, 에이전트, 작업별 사용량을 집계하고 상한 설정 | 일찍 도입할수록 비정상적인 사용량을 더 빨리 발견할 수 있습니다 |
Batch API의 한계도 짚고 넘어가야 해요. 대량 문서 분류, 오프라인 콘텐츠 생성, 실시간 처리가 필요하지 않은 데이터 분석처럼 비동기 처리를 허용하는 작업에 적합하지만, 장시간 실행되는 모든 Agent Session에 적합한 것은 아니에요.
Claude Fable 5.2 멀티 Agent 시대의 API 게이트웨이 역할
Vercel은 2026년 11월 9일 Claude Fable 5.2를 AI Gateway에 추가했다고 발표했어요. 모델 ID는 anthropic/claude-fable-5.2예요. 다중 모델 게이트웨이를 살펴볼 수 있는 실제 사례로 볼 수 있죠. AI SDK, OpenAI Chat Completions, OpenAI Responses, Anthropic Messages 등의 인터페이스를 지원하므로 개발자는 통합된 단일 진입점을 통해 모델을 호출할 수 있어요.
라우팅 단계에서는 같은 모델을 Anthropic, AWS Bedrock, Google Vertex AI 등 여러 공급자 중에서 선택할 수 있고, 가격, 첫 토큰 지연 시간, 처리량을 기준으로 우선순위를 정할 수도 있어요. Vercel이 제공한 Fallback 예시에서는 먼저 Fable 5.2를 호출하고, 안전 분류기에 의해 거부되면 Opus 5.5와 Sonnet 5.5를 차례로 호출해요. 사용량 보고서, 비용 통계, API 키 예산, 재시도(Retry), 장애 전환(Failover) 기능도 제공해요.
간단한 채팅보다 멀티 Agent 시스템에서 이런 인프라가 더 필요한 이유는 무엇일까요? 채팅은 한 번 실패해도 사용자가 다시 요청하면 되지만, 며칠 동안 이어지는 Agent 워크플로에서는 호출 한 번의 실패로 전체 작업 흐름이 멈출 수 있어요. 재시도하면 토큰 사용량도 늘어나죠. 멀티 Agent 환경에서는 모델 선택, 호출 관리, 장애 전환, 비용 통계가 있으면 좋은 기능에서 필수 요소로 바뀌어요.
🎯 기술 제안: 국내 개발자라면 APIYI apiyi.com에서 비슷한 방식의 멀티 모델 연동 계층을 이용할 수 있어요. API 키 하나로 OpenAI, Claude, Gemini 등 주요 모델을 호출할 수 있고, OpenAI 호환 인터페이스를 통해 공급자마다 다른 인터페이스를 사용하는 번거로움을 줄일 수 있어요. 사용량 기반 과금으로 Agent와 작업별 비용을 나눠 계산하기도 편리해요.
Claude Fable 5.2 데이터 보존: 기업 멀티 에이전트 애플리케이션의 컴플라이언스 문제
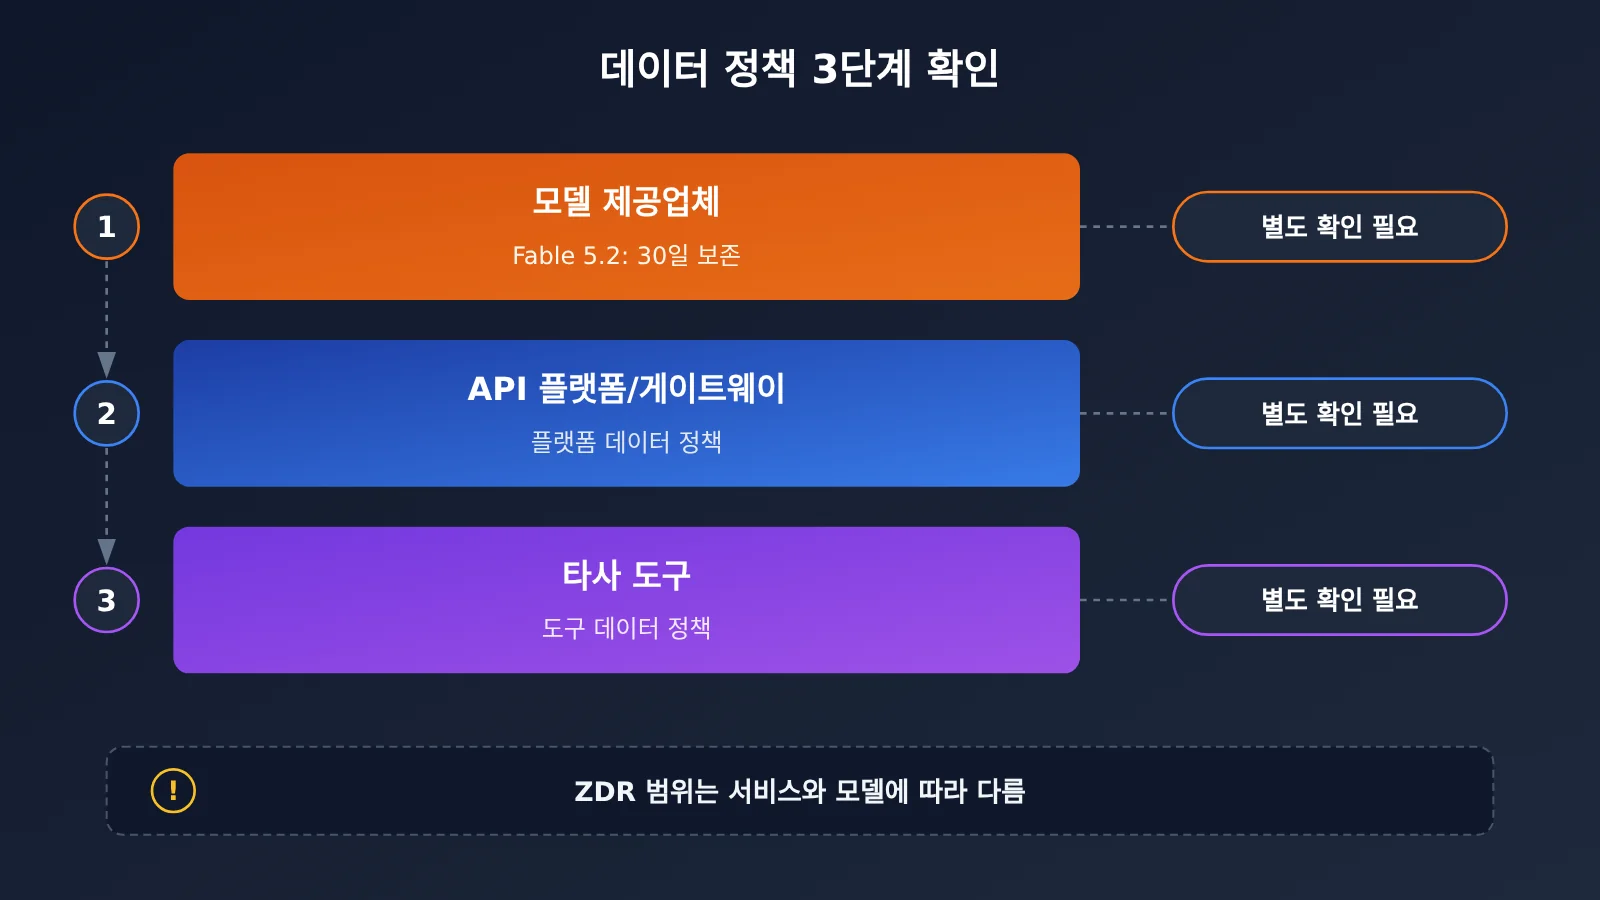
비용뿐 아니라 기업 개발자는 데이터 컴플라이언스에도 주의를 기울여야 해요. Anthropic의 공식 데이터 보존 문서에 따르면 Fable 5.2는 데이터를 30일간 보존해야 하는 Covered Model에 해당하며, 기본적으로 제로 데이터 보존(ZDR)을 지원하지 않아요.
구체적인 규칙은 다음과 같아요. 기본적으로 조직은 Anthropic의 명시적인 승인을 받지 않는 한 ZDR 조건으로 이 모델을 호출할 수 없어요. 프롬프트와 모델 출력은 적용되는 정책에 따라 30일간 보존돼요. 보존된 데이터는 명시적인 허가 없이 모델 학습에 사용되지 않아요. ZDR 요건을 충족하는 조직은 특정 워크스페이스에서 30일 데이터 보존을 활성화해 이 모델을 사용할 수 있어요. Vercel의 연동 공지에서도 이 요건을 명확히 안내하고 있어요.
혼동하기 쉬운 점이 하나 있어요. 모델 제공업체의 데이터 정책과 서드파티 API 게이트웨이의 데이터 정책은 서로 달라요. 어떤 API 플랫폼이 자체적으로 ZDR 기능을 제공하더라도, 해당 플랫폼에 연동된 모든 모델이 ZDR을 충족한다는 뜻은 아니에요. 민감한 업무 데이터를 처리하는 기업은 모델 단가만 비교할 게 아니라 모델 제공업체, API 플랫폼, 서드파티 도구 각각의 데이터 처리 정책을 확인해야 해요.
자주 묻는 질문 FAQ
Q1: Claude Fable 5.2의 1,000개 에이전트 운영체제 실험에는 비용이 얼마나 들었나요?
Anthropic은 공개하지 않았어요. 실험에 사용된 총 토큰 수, 컴퓨팅 비용, 총비용은 공식적으로 공개되지 않았으며, 온라인에 떠도는 구체적인 수치는 공식 자료가 아니에요.
Q2: 멀티 에이전트는 싱글 에이전트보다 항상 3~10배 비싼가요?
그렇지는 않아요. 이는 Anthropic이 동일한 작업을 기준으로 제시한 일반적인 비교 범위일 뿐, 고정된 배수가 아니에요. 실제 배수는 컨텍스트 중복 정도, 작업 인계 횟수, 모델 선택, 캐시 적중률에 따라 달라져요.
Q3: Session Runtime은 에이전트마다 요금을 부과하나요?
아니요. Managed Agents는 각 Session이 `running` 상태인 시간에 따라 요금을 부과해요. Session 시간당 $0.08이며, `idle` 상태, 확인 대기 시간, 종료된 이후의 시간은 과금되지 않아요. 여러 Session을 사용하면 각 Session의 실제 실행 시간을 따로 계산한 뒤 합산해야 해요.
Q4: Batch API의 50% 할인은 Managed Agents에도 적용되나요?
아니요. Batch 할인은 Messages API의 비동기 일괄 요청에 적용돼요. Managed Agents는 상태를 유지하는 대화형 Session이므로 할인을 받을 수 없어요. Fast Mode도 Batch API와 동시에 사용할 수 없어요.
Q5: 여러 모델에 작업을 분배할 때 실제 비용을 빠르게 테스트하려면 어떻게 해야 하나요?
다음 세 단계를 추천해요.
1. APIYI apiyi.com에 가입해 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 코드에서 `base_url`을 `https://api.apiyi.com/v1`로 설정하고, 플랫폼에서 사용할 수 있는 모델 ID로 바꾸세요.
3. 예산 추적 스크립트로 소규모 작업을 실행하고, 계층별 모델의 실제 토큰 사용량을 기록하세요.
Q6: Claude Fable 5.2를 사용할 때 주의할 제한 사항은 무엇인가요?
첫째, 출력 요금이 $40/MTok로 높은 편이라 모든 하위 작업을 맡기기에는 적합하지 않아요. 둘째, Fast Mode를 사용하면 요금이 두 배가 돼요. 셋째, 데이터 보존 기간이 30일로 설정되어 있어 기본적으로 ZDR 조건에서는 호출할 수 없어요. 민감한 데이터를 처리하기 전에 규정 준수 요건을 반드시 확인하세요.
Claude Fable 5.2 멀티 에이전트 비용 핵심 요약
- 실제 청구액은 미공개: Anthropic은 에이전트 1,000개를 사용한 운영체제 실험의 실제 비용을 공개하지 않았어요.
- 단가는 20% 인하: Fable 5.2의 표준 요금은 토큰 100만 개당 입력 $8, 출력 $40예요.
- 비용이 크게 늘어날 수 있어요: 같은 작업에서 멀티 에이전트는 일반적으로 단일 에이전트보다 토큰을 3~10배 더 사용해요.
- Runtime은 Session 기준: 세션 시간당 $0.08이며, 실행 중인 시간만 계산하고 에이전트 수는 기준으로 삼지 않아요.
- 할인 적용에는 제한이 있어요: Batch 50% 할인은 Managed Agents에 적용되지 않으며, 캐시로 비용을 절감하려면 적중률이 충분히 높아야 해요.
- 컴플라이언스도 확인하세요: Fable 5.2는 30일간 데이터 보존을 요구하며, ZDR을 이용하려면 별도 승인이 필요해요.
- 확대하기 전에 먼저 테스트하세요: APIYI apiyi.com의 통합 인터페이스를 활용하면 여러 모델의 역할 분담에 따른 실제 토큰 사용량을 확인할 수 있어요.
정리
Claude Fable 5.2의 에이전트 1,000개 실험은 개발자가 비용을 바라보는 관점을 ‘호출 1회당 비용’에서 ‘전체 워크플로에서 발생하는 총비용’으로 바꿔 놓았어요. 핵심은 다음과 같아요.
- 비용은 여러 항목이 합산돼요: 주 에이전트와 하위 에이전트, 반복되는 컨텍스트, 검증과 재시도, Session Runtime, 도구 호출이 모두 청구액에 반영돼요.
- 모델 역할 분담이 비용의 큰 부분을 좌우해요: 가장 강력한 모델은 계획과 핵심 추론에만 사용하고, 실행 중심의 하위 작업은 더 저렴한 모델에 맡기세요.
- 과금 규칙을 정확히 확인하세요: Runtime은 Session 실행 시간 기준이고, Batch 할인은 Managed Agents에 적용되지 않아요. 캐시도 충분히 적중해야 비용 절감 효과가 있어요.
- 컴플라이언스도 가격만큼 중요해요: 30일 데이터 보존과 ZDR 제한을 모델을 선택하는 단계부터 고려해야 해요.
멀티 에이전트 애플리케이션이 복잡해질수록 안정적인 모델 연결, 명확한 사용량 통계, 신뢰할 수 있는 장애 전환이 더욱 중요해져요. APIYI apiyi.com의 통합 인터페이스로 여러 모델의 역할 분담 방안을 빠르게 검증하고, 실제 토큰 사용량을 바탕으로 예산을 세운 다음 에이전트 규모를 단계적으로 늘려 보세요.
📚 참고 자료
- Anthropic 공식 발표: Claude Fable 5.2 and Mythos 5.2
- 링크:
anthropic.com/claude-fable-and-mythos-5-2 -
설명: 1000개 에이전트 운영체제 실험에 관한 공식 공개 자료
-
Claude Platform 모델 사양 및 가격: Fable 5.2 Overview
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview -
설명: 가격, 컨텍스트 윈도우, Effort 등의 사양
-
Claude Managed Agents 가격: Session Runtime 과금 규칙
- 링크:
platform.claude.com/docs/en/about-claude/pricing -
설명: Runtime, Web Search 및 전체 API 가격
-
Prompt Caching 문서: 캐시 쓰기 및 읽기 안내
- 링크:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
설명: 자동 캐싱 및 명시적 캐시 구분점
-
API 데이터 보존 정책: Covered Model 및 ZDR
- 링크:
platform.claude.com/docs/en/manage-claude/api-and-data-retention -
설명: 30일 데이터 보존 요건의 공식 근거
-
Vercel AI Gateway 연동 발표: Fable 5.2 출시 안내
- 링크:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway - 설명: 여러 공급업체로 라우팅하고 대체 경로 및 비용을 관리하는 사례
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지에서 문의해 주세요. 자세한 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.