작성자 주: 이 글에서는 DeepSeek Super-agent의 이벤트 기반 아키텍처가 작동하는 핵심 원리를 살펴봐요. 오픈소스로 공개된 프로토타입 기능과 DeepSeek 내부 사례, 향후 아키텍처 구상을 구분하고, 능동형 에이전트의 제품 가치와 엔지니어링 트레이드오프도 짚어봅니다.
한 개발팀의 단체 채팅방을 떠올려 보세요. 누군가 “Safari에서 로그인 페이지가 또 안 열리네요”라고 말했어요. 봇을 @멘션한 사람도, 이슈를 등록한 사람도 없었죠. 잠시 후 채팅방에 짧은 알림이 도착합니다. 문제를 재현하고 원인을 파악했으며, 수정 PR을 준비해 검토를 기다리고 있다는 내용이에요. DeepSeek 공식 기술 문서에 따르면 이런 “조용히 재현하고 수정하기”는 이미 DeepSeek 내부 Harness 단체 채팅방에서 활용하는 작업 방식 중 하나예요.
이것은 “AI가 제멋대로 행동하기 시작했다”는 이야기가 아닙니다. DeepSeek Super-agent의 핵심 변화는 시스템이 외부 이벤트를 지속적으로 감지하고, 명확한 권한과 규칙에 따라 할 일을 파악해 미리 준비한 뒤 적절한 시점에 결과를 전달할 수 있다는 점이에요. 권한 제어와 능동적인 실행은 함께 설계됐으며, 어느 하나도 빠질 수 없어요.
핵심 내용: 이 글을 읽으면 Super-agent 이벤트 기반 아키텍처의 핵심 메커니즘 5가지를 이해할 수 있어요. 오픈소스 프로토타입에 구현된 기능과 내부 사례 또는 아키텍처 구상을 구분하고, 이 아이디어를 활용해 사용자를 덜 방해하면서도 통제 가능한 능동형 에이전트를 설계하는 방법도 알아봅니다.
DeepSeek Super-agent 핵심 정보 한눈에 보기
세부 내용을 살펴보기 전에 Super-agent의 공개 정보를 표로 정리해 볼게요. 이 프로젝트를 이해하려면 ‘이미 구현된 기능’과 ‘구상 단계인 기능’을 구분하는 것이 중요해요.
| 정보 항목 | 내용 | 상태 설명 |
|---|---|---|
| 프로젝트 방향 | 수동적 응답에서 능동적 에이전트로의 전환을 모색하는 이벤트 기반 아키텍처 | 공식 기술 문서 및 오픈소스 프로토타입 문서 |
| 이벤트 소스(Trigger) | 메신저, GitHub Issue, PR 댓글, 코드 리뷰, CI, 이메일, 일정, 프로젝트 협업 이벤트 | 공개 프로토타입은 주로 GitHub를 지원하며, Feishu는 선택적으로 연동할 수 있어요. 이메일과 캘린더는 더 넓은 아키텍처 구상에 해당해요 |
| 작업 수락 모드 | off, observe, auto |
오픈소스 권한 부여 문서에 명시되어 있으며, 기본값은 observe예요 |
| 권한 부여 메커니즘 | Mandate를 통해 작업 출처, 권한 수준, 범위, 정책 버전 기록 | 오픈소스 권한 부여 문서에 명시되어 있어요 |
| 비동기 작업 | 작업 시작 후 Started를 반환하고, 대화를 막지 않은 채 백그라운드에서 실행 | DeepSeek Harness에 구현되어 있지만 아직 기본 활성화되지는 않았어요 |
| 내부 사례 | 그룹 채팅에서 버그를 ‘조용히 재현하고 수정’ | DeepSeek 내부 운영 사례로, 제3자의 독립 검증을 거치지는 않았어요 |
| 커뮤니티 사례 | 2026년 11월 1일 한 사용자가 Issue → PR 프로세스 실행에 성공했다고 보고 | 배포 과정에서 여러 설정 문제가 발생했어요 |
DeepSeek Super-agent의 이벤트 기반 아키텍처란?
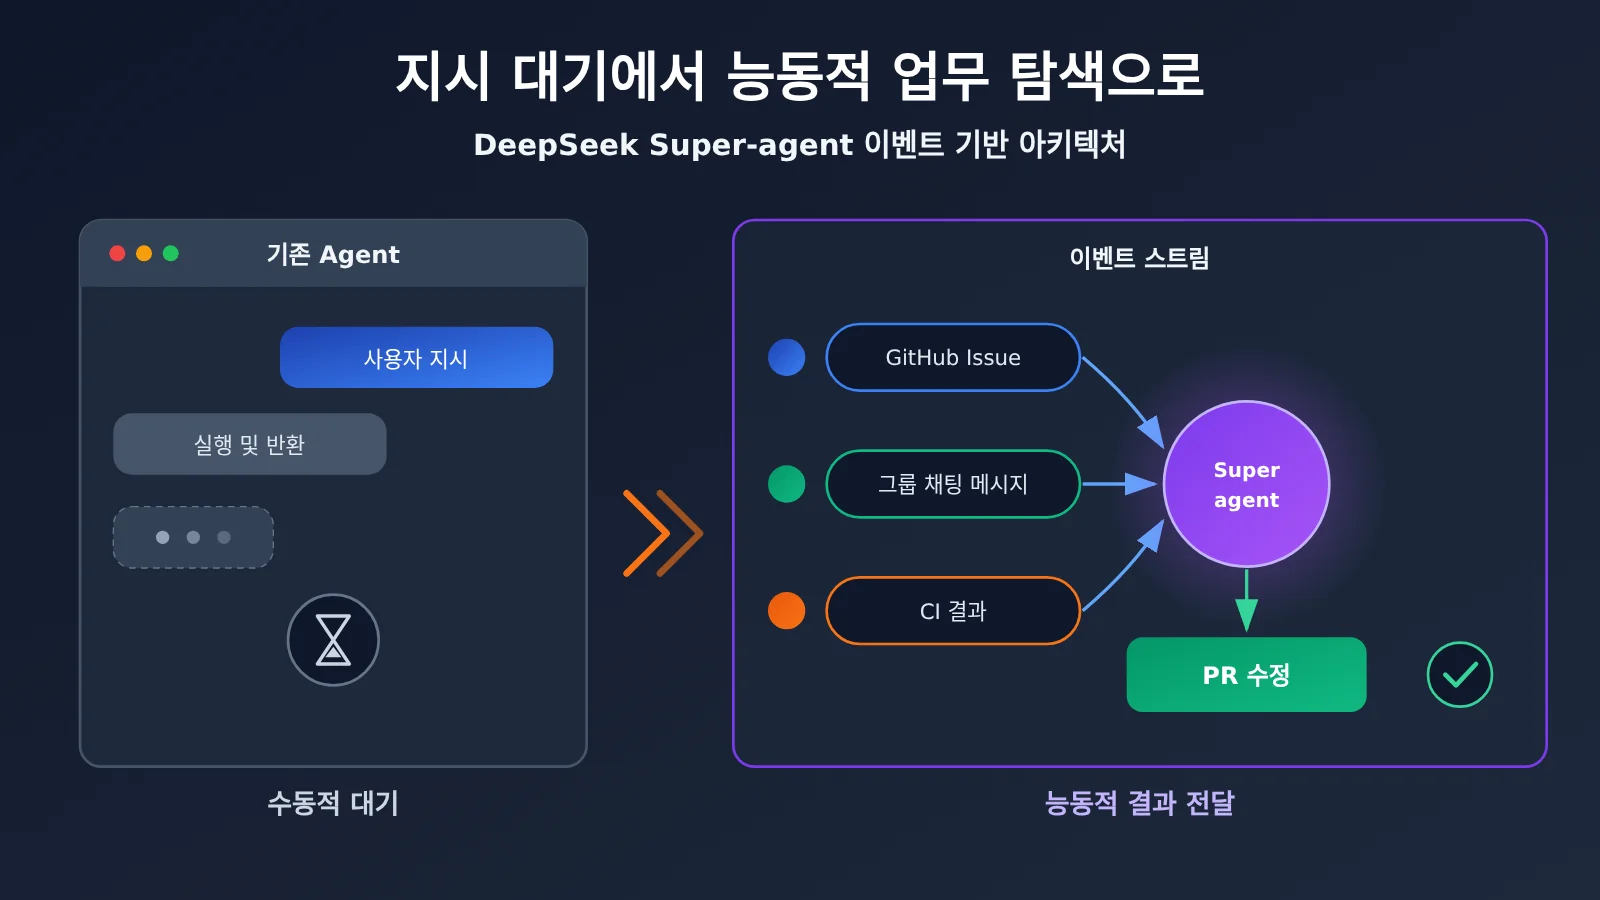
기존 대화형 Agent는 사용자가 지시하면 실행하고, 결과를 반환한 뒤 다음 지시를 기다리는 방식으로 작동해요. Agent가 아무리 똑똑해도 작업의 출발점은 사용자가 먼저 시작한 대화예요. 사용자는 문제를 발견하고, 명확하게 설명하고, 나중에 결과를 확인하는 것까지 직접 챙겨야 하죠.
DeepSeek Super-agent는 이 흐름을 뒤집어요. 시스템이 환경 이벤트를 지속적으로 받아 처리할 만한 작업이 있는지 판단하고, 권한에 따라 작업을 생성해 백그라운드에서 실행한 뒤 적절한 시점에 사람에게 알려줘요. 즉, 작업 환경 자체가 Agent의 입력 소스가 되고, 채팅창은 더 이상 유일한 진입점이 아니에요.
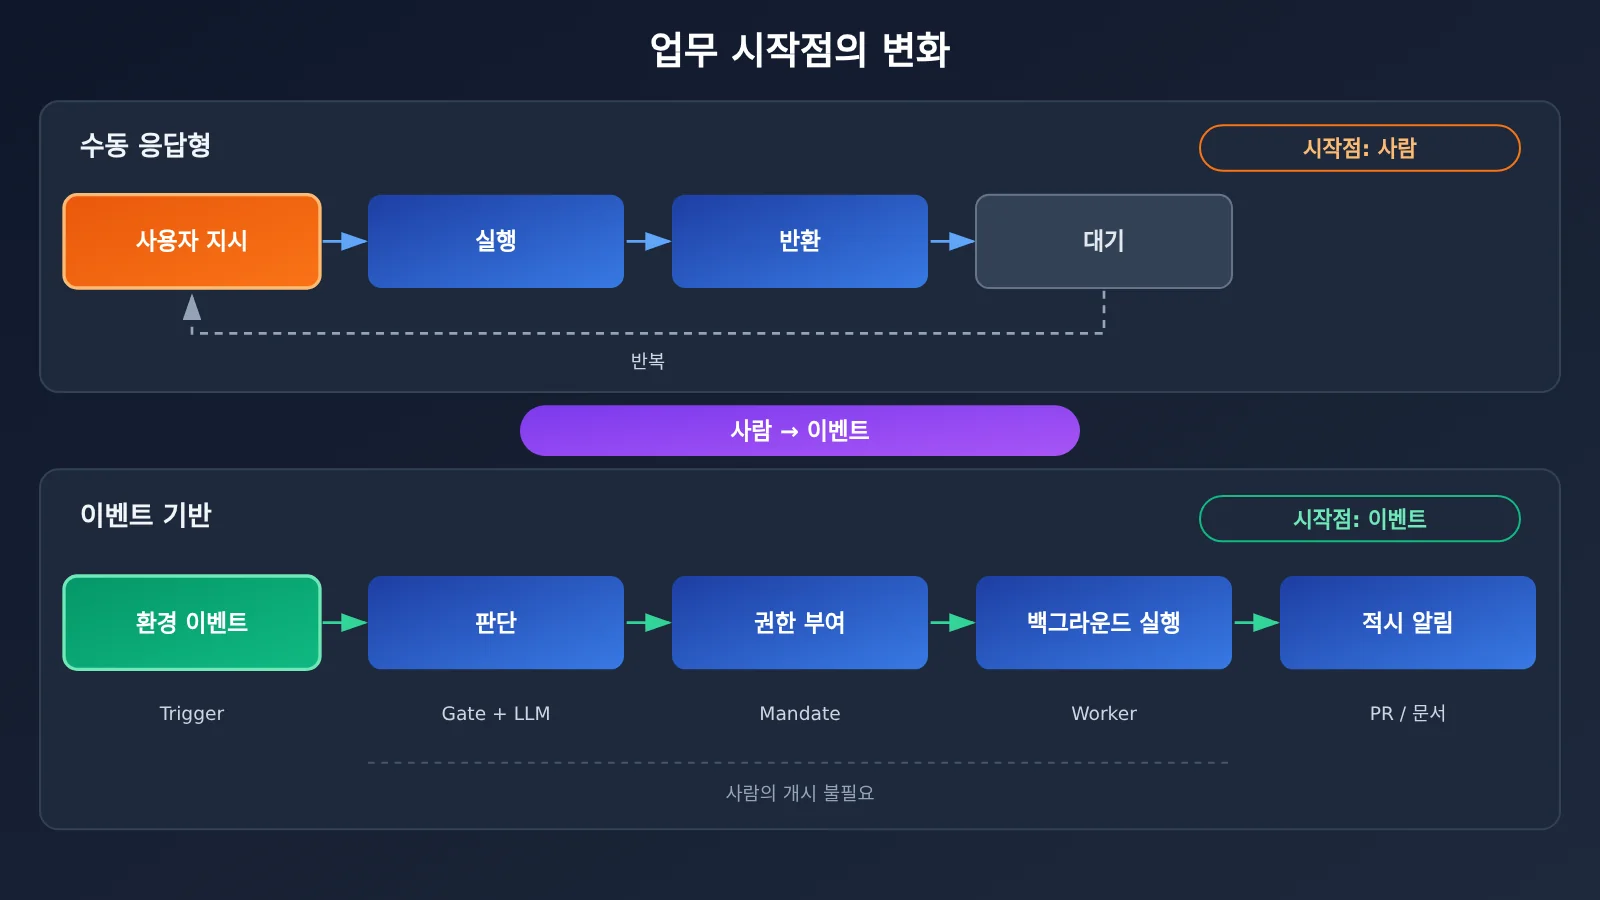
| 구분 | 수동 응답형 Agent | 이벤트 기반 Super-agent |
|---|---|---|
| 작업 출발점 | 사용자가 먼저 대화 시작 | 외부 환경 이벤트(Trigger) |
| 작업 발견 | 사람이 문제를 발견하고 설명 | 시스템이 작업 단서를 식별하고, 사람은 승인과 결과 검수 담당 |
| 실행 방식 | 보통 동기 방식으로 결과 대기 | 백그라운드에서 비동기 실행, 미리 작업 준비 가능 |
| 결과 전달 | 대화에서 단계적으로 출력 | 간결한 알림 또는 구조화된 결과물(PR, 문서) |
| 제어 방식 | 각 단계에서 사용자 지시에 의존 | 작업 수락 모드, Mandate 권한 범위와 승인 규칙 |
| 주요 위험 | 수동 관리 부담이 큼 | 잘못된 트리거, 작업 폭주, 권한 범위 이탈, 인젝션 공격 |
Super-agent에서 Trigger의 역할
DeepSeek는 외부 환경 이벤트를 통틀어 Trigger라고 불러요. 그룹 채팅 메시지, 새 Issue, CI 빌드 실패 등이 모두 Trigger가 될 수 있어요. 중요한 점은 Trigger가 어디까지나 ‘단서’일 뿐 ‘작업’과 같지는 않다는 거예요. 실제 행동 여부는 이후의 필터링, 평가, 승인 단계를 거쳐 결정돼요.
Super-agent의 이벤트 필터링: 프로그램 Gate와 LLM Assessment
실제 업무 환경에서는 수많은 잡음이 발생해요. 개발자 그룹에는 매일 잡담, 이모지, 중복 메시지가 쏟아질 수 있어요. 모든 메시지를 대규모 언어 모델에 판단하게 하면 토큰 비용과 응답 지연이 빠르게 늘어나죠. DeepSeek는 2단계 필터링으로 이 문제를 해결해요. 먼저 저렴한 결정론적 규칙으로 관련 없는 이벤트 대부분을 걸러낸 뒤, 소수의 후보 이벤트를 모델에 넘겨 의미를 판단해요.
| 필터링 단계 | 판단 기준 | 대규모 언어 모델 호출 여부 | 주요 역할 |
|---|---|---|---|
| 1단계: 프로그램 Gate | 이벤트 출처, 허용된 사용자인지 여부, 모니터링 대상 그룹이나 저장소에 속하는지 여부, Agent를 명시적으로 언급했는지 여부, 설정된 이벤트 범위에 포함되는지 여부 | 최대한 호출하지 않음 | 관련 없거나 권한이 없는 이벤트를 저비용으로 차단 |
| 2단계: LLM Assessment | 후보 이벤트의 의미와 맥락 | 호출 | 장애 징후처럼 처리할 만한 업무인지 판단 |
예를 들어 “Safari에서 로그인 페이지가 또 안 열려요”라는 메시지가 권한이 있는 프로젝트 논의 스레드에서 나왔다면, 모델은 이를 장애 징후로 인식할 수 있어요. 반면 관련 없는 잡담이라면 시스템이 아무 조치도 취하지 않을 수 있죠. 이처럼 저비용 규칙과 고비용 의미 이해를 결합하는 2단계 구조는 이벤트 기반 Agent의 비용 관리에 핵심적인 역할을 해요.
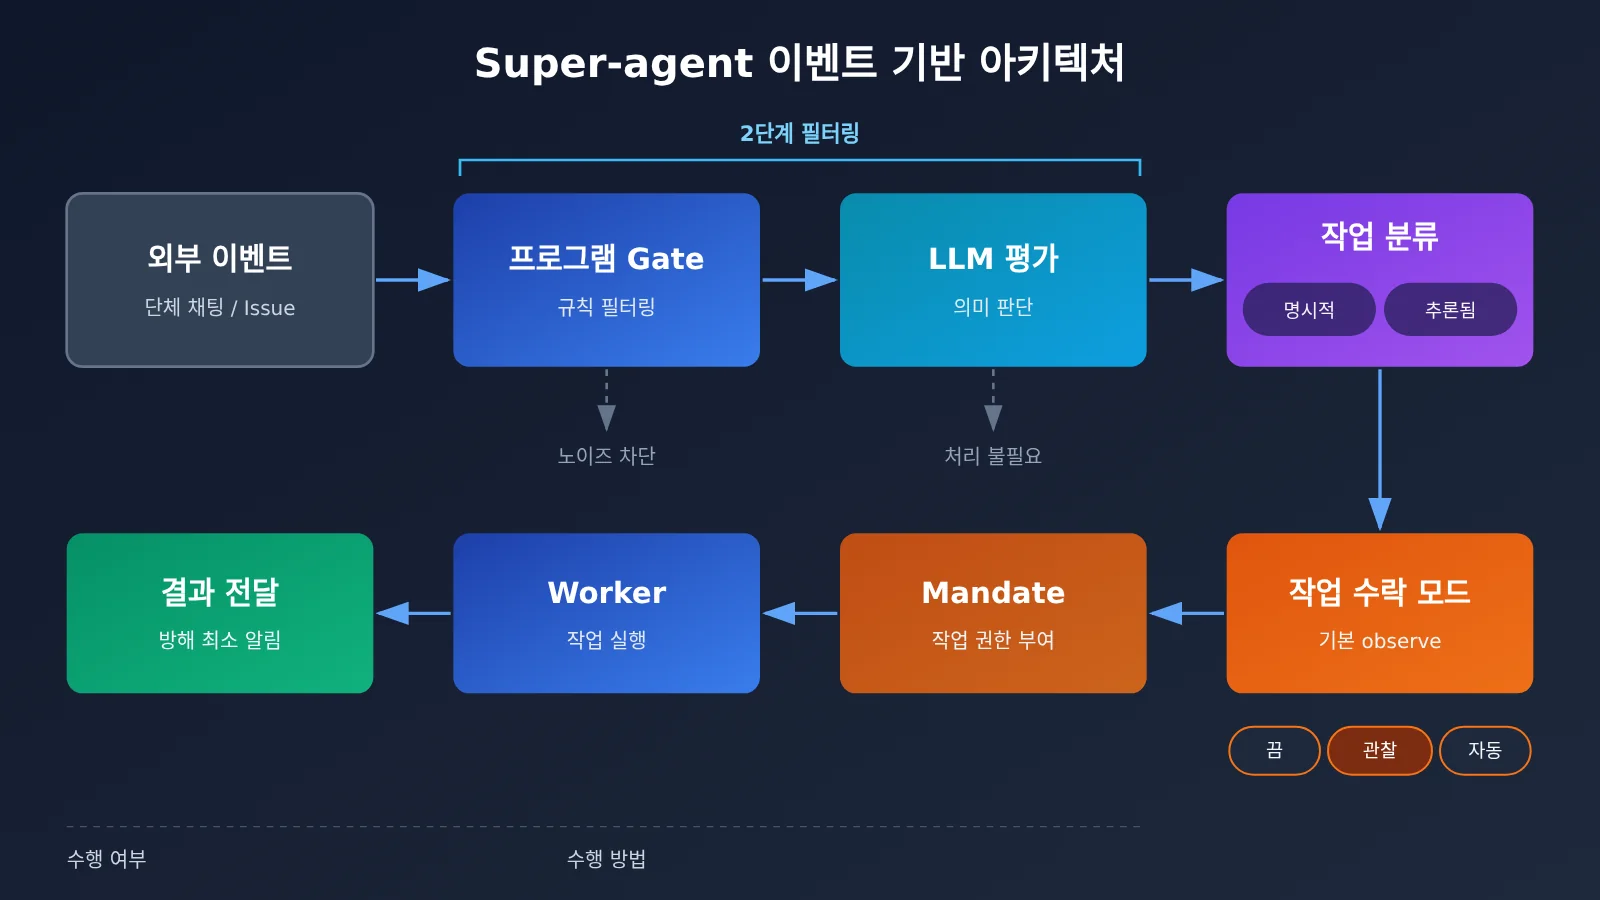
위 그림에서 의미 판단과 작업 실행 단계는 모두 모델 API에 의존해요. 비슷한 아키텍처를 구현할 때는 APIYI apiyi.com 같은 OpenAI 호환 인터페이스를 통해 여러 모델을 통합해 연결하면 단계별 설정과 비교가 편리해요.
Explicit와 Inferred: 명시적 요청과 추론된 작업의 차이
DeepSeek 공식 승인 문서는 작업을 두 가지로 나눠요. Explicit는 승인된 개발자가 Issue에서 Agent에 특정 버그 수정을 직접 요청하는 것처럼 명시적으로 승인된 요청이에요. Inferred는 시스템이 대화에서 조사할 만한 단서를 발견해 추론한 작업이에요. 예를 들어 누군가 “최근 빌드가 가끔 실패해요”라고 언급했지만 정식으로 수정을 요청하지 않은 경우가 여기에 해당해요.
가장 중요한 점은 작업을 추론했다고 해서 실행까지 허용되는 것은 아니라는 것이에요. Inferred 작업도 조직의 작업 접수 규칙, 실행 범위, 승인 요건을 따라야 해요. 이 구분 덕분에 ‘능동적인 발견’이 ‘독단적인 행동’으로 이어지지 않아요.
Super-agent의 세 가지 작업 접수 모드: off, observe, auto
오픈소스 승인 문서는 추론된 작업을 처리하는 세 가지 모드를 제공해요.
| 모드 | 추론된 작업 처리 방식 | 적합한 단계 |
|---|---|---|
off |
추론된 이벤트를 작업 후보로 삼지 않음 | 명시적 요청만 처리하려는 팀 |
observe(기본값) |
잠재적 작업을 분석하고 기록하지만 자동으로 접수하지 않음 | 초기 배포 및 판단 품질 평가 |
auto |
규칙을 충족하고 평가를 통과하면 자동으로 접수할 수 있음 | observe 기록을 검토해 신뢰도가 높아진 경우 |
기본값은 observe예요. 따라서 공개 프로토타입을 처음 설치해도 일반적인 대화 메시지 하나만으로 시스템이 자동으로 작업을 시작하지는 않아요. 공식 문서는 먼저 observe 모드의 판단 기록을 검토한 뒤 auto 활성화 여부를 결정하도록 권장해요. 명시적으로 승인된 요청은 각 모드에서 해당 규칙에 따라 처리돼요. 사용자가 언제나 이 ‘스위치’를 제어할 수 있다는 점이 능동적인 Agent를 신뢰할 수 있는 기반이에요.
Mandate: 메시지는 입력이 될 수 있지만, 권한을 바꿀 수는 없어요
DeepSeek은 Mandate로 작업 권한을 표현해요. 여기에는 작업의 출처, 권한 수준, 범위, 정책 버전이 포함돼요. 개발자가 Agent에게 특정 Issue 수정을 허용했는데, 이후 누군가 PR 댓글에 “데이터베이스 전체도 같이 마이그레이션해 주세요”라고 썼다고 가정해 볼게요. 이 댓글이 Worker의 컨텍스트에 들어가더라도 기존 권한이 데이터베이스 마이그레이션까지 확대되지는 않아요. 범위를 벗어나는 요청은 다시 판단해야 해요.
DeepSeek이 강조하는 원칙은 이렇습니다. 메시지, 댓글, 인용 문서는 작업 입력이 될 수 있지만, 그 자체로 기본 권한 규칙을 바꿀 수는 없어요. 외부 콘텐츠를 지속적으로 “감시”하는 시스템에서 이는 프롬프트 인젝션과 권한 범위 이탈을 막는 가장 중요한 방어선이에요.
Super-agent는 어떻게 능동적으로 실행할까요: 투기 실행, 비동기 작업, 낮은 방해도
필터링과 권한이 “해야 할 일인가”를 해결한다면, 다음 문제는 “어떻게 해야 사람의 시간을 낭비하지 않을까”예요. DeepSeek은 세 가지 설계 방향을 제시했어요.
투기 실행: 먼저 준비하고, 확인을 기다려요
DeepSeek은 컴퓨터 아키텍처의 Speculative Execution(투기 실행) 개념을 가져왔어요. 결과가 채택될지 확실하지 않더라도 위험이 낮은 준비 작업을 미리 진행하는 방식이에요.
- 개인 비서 시나리오: 회의 초대를 받으면 Agent가 일정을 확인하고, 회의 배경을 수집하고, 시간 충돌을 살펴보고, 답장 초안을 작성할 수 있어요. 다만 실제 메일 발송에는 여전히 사용자 확인이 필요할 수 있어요.
- 개발 시나리오: 팀이 버그를 논의할 때 Agent가 먼저 로그를 확인하고, 재현을 시도하고, 관련 코드를 찾고, 패치 후보를 준비할 수 있어요. 이후 권한 규칙을 충족하면 결과를 제출해요.
이 방식은 최종적으로 채택되지 않을 작업에 컴퓨팅 자원을 쓸 수 있다는 비용이 있어요. DeepSeek은 절약한 사람의 대기·작업 비용이 추가 컴퓨팅 비용보다 클 때만 투기 실행에 가치가 있다고 봐요. 이는 엔지니어링상의 트레이드오프이며, 모든 작업을 미리 실행할 필요는 없어요.
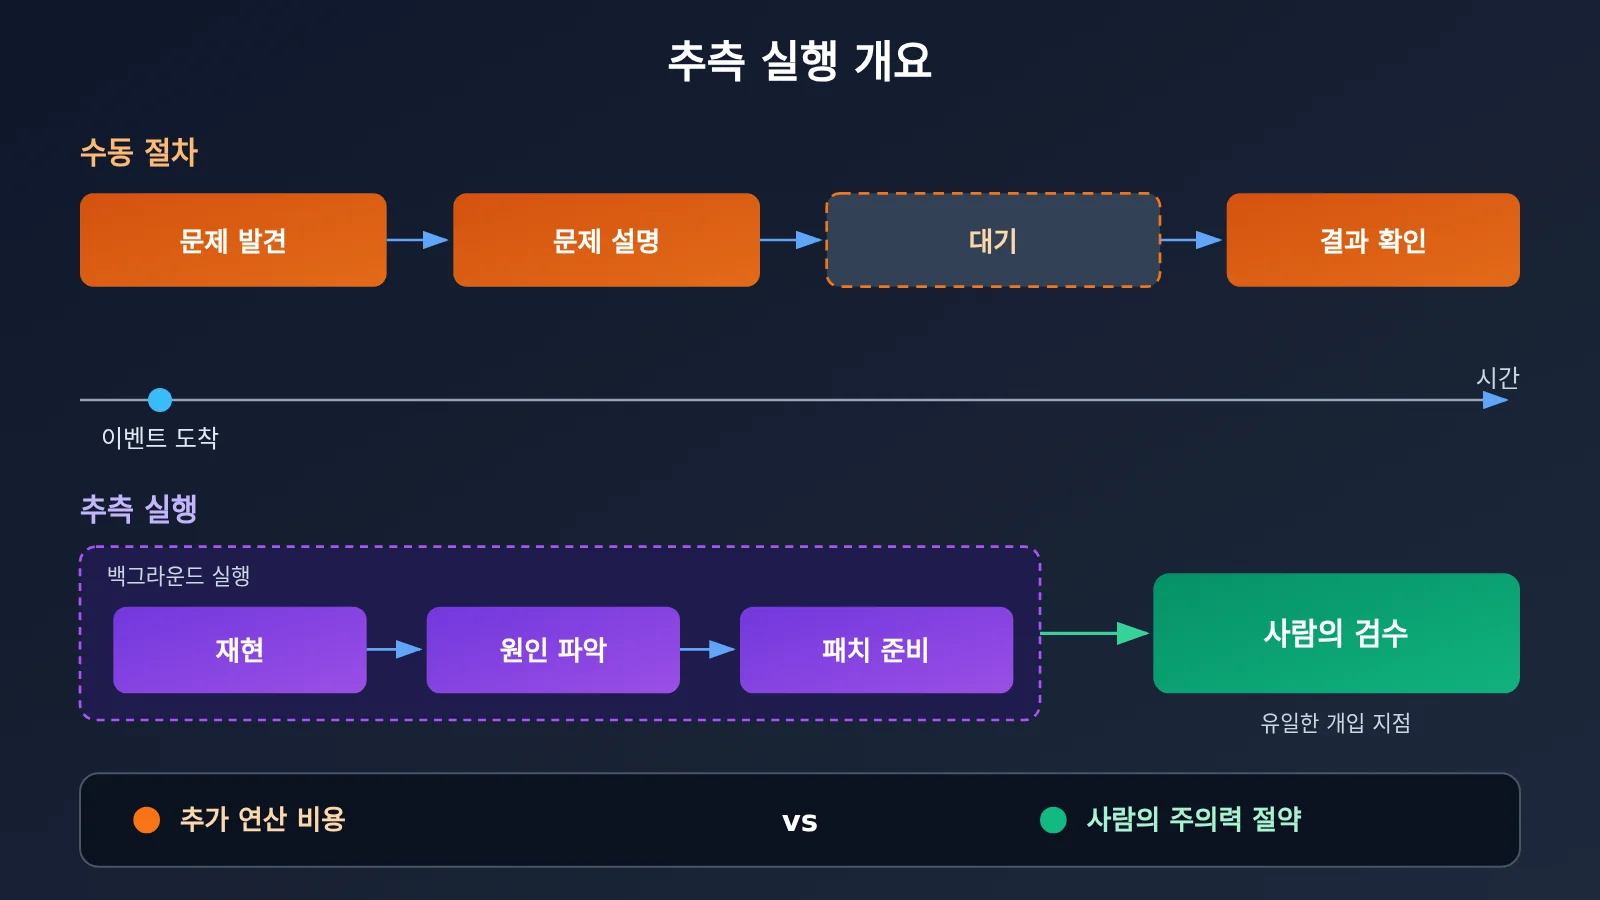
비동기 ReAct Loop: 백그라운드 작업이 대화를 막지 않아요
기존 동기식 실행에서는 Agent가 시간이 오래 걸리는 명령을 시작하면 도구가 결과를 반환할 때까지 새 메시지를 처리할 수 없어요. DeepSeek의 비동기 설계에서는 작업을 시작한 직후 Started 상태를 반환해요. 백그라운드 실행이 이후 대화를 막지 않고, 실행 결과는 새 이벤트로 시스템에 다시 들어와요. 사용자는 작업이 진행되는 동안 다른 질문을 할 수 있고, 시스템은 더 이상 필요하지 않은 백그라운드 작업을 중지할 수도 있어요.
다만 경계할 점이 있어요. DeepSeek 공식 설명에 따르면 이 비동기 작업 메커니즘은 DeepSeek Harness에 구현되어 있지만, 아직 기본 활성화되지는 않았어요. 공개 프로토타입에도 자체 백그라운드 Worker 메커니즘이 있지만, 구상 중인 전체 비동기 아키텍처를 기본 기능으로 받아들여서는 안 돼요.
낮은 방해도: 능동적이라고 존재감을 드러낼 필요는 없어요
DeepSeek의 제품 철학 문서는 사람의 주의력 소모를 최소화하면서 최대한 많은 실질적 가치를 만들어야 한다고 제안해요. 구체적으로는 도구 호출 단계를 일일이 보고하거나 단체 채팅에 메시지를 쏟아내지 않고, 모든 중간 사고 과정을 드러내지 않아요. 의사결정이나 검수가 필요할 때 우선 소통하고, 가치가 제한적인 메시지에는 조용히 대응해요.
출력 채널에 따라서도 방식이 달라요. 메신저에서는 간결하게 알리고, GitHub, 이메일, 문서에는 문제 배경, 변경 설명, 검증 결과를 포함해 구조화된 결과물을 전달해요. 제품 관점에서 능동성과 알림 빈도는 서로 다른 지표예요. 자주 보고하는 Agent가 반드시 유용한 Agent인 것은 아니에요.
Super-agent의 실제 근거: 내부 사례와 커뮤니티 테스트
새로운 아키텍처를 평가할 때는 ‘잠재력’과 ‘현재 상태’를 구분해야 해요. 현재 확인할 수 있는 근거는 두 가지이며, 각각 신뢰도와 의미가 달라요.
DeepSeek 내부 사례는 아키텍처의 잠재력을 보여줘요. DeepSeek Harness 내부 그룹 채팅에 문제 제보가 올라오면 Agent가 메시지를 받고 조사할 가치가 있는지 판단해요. 이후 백그라운드에서 문제 재현과 해결 방법을 시도해요. 문제가 확인되고 간단한 해결책을 찾으면 PR을 준비하거나 제출하고, 유의미한 결과를 찾지 못하면 팀에 알리지 않아요. 이는 공식적으로 공개한 내부 운영 방식이지, 공개 프로토타입의 기본 설정에 대한 제3자의 독립적인 검증 결과는 아니에요.
GitHub 커뮤니티 테스트는 프로토타입의 현재 상태를 보여줘요. 2026년 11월 1일, 한 사용자는 Ubuntu 환경에서 SETUP.md에 따라 오픈소스 프로토타입을 배포하고, Issue 요청이 처리 과정을 거쳐 최종적으로 Pull Request로 만들어졌다고 보고했어요. 다만 GitHub 알림이 전달되지 않거나 시스템 상태는 정상으로 표시되는데 작업 요청을 받지 못하는 문제도 겪었어요. Source의 Issue 및 댓글 관찰 설정을 조정해야 했고, 시스템 언어와 GitHub 계정 설정으로 인한 호환성 문제도 발생했어요.
이 보고서는 ‘이벤트에서 작업까지’ 이어지는 흐름이 실제로 작동한다는 것을 보여줘요. 하지만 이를 근거로 프로젝트가 24시간 안정적으로 Bug를 자동 발견한다고 볼 수는 없어요. PR을 생성할 수 있다는 것도 변경 사항이 사람의 검토를 통과해 병합됐다는 뜻은 아니에요.
모델 API로 이벤트 기반 Agent의 판단 계층 구축하기
Super-agent의 아이디어를 활용하고 싶다면 “프로그램 Gate + LLM Assessment” 계층부터 구현하는 것이 가장 쉬워요. 아래 예제는 이벤트 판단 로직만 보여주며, Super-agent의 공식 구현이나 완전한 Agent 제품은 아니에요.
최소 예제
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 호환 인터페이스
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 모델명은 플랫폼의 모델 목록을 기준으로 함
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
전체 구현 코드 보기(Gate + Assessment + 작업 수락 모드)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 프로그램 계층 Gate 설정: LLM을 호출하지 않는 결정적 규칙
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """1단계: 저비용 규칙 필터링"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """2단계: 모델의 의미 판단으로 explicit / inferred 구분"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # 권한 범위는 별도로 확인해야 함
    # 추론된 작업은 작업 수락 모드에 따라 처리
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 빠른 시작 팁: 이벤트 판단 계층을 검증할 때 APIYI apiyi.com에서 무료 테스트 크레딧을 받아 보세요. 같은 코드에서 모델을 바꿔 가며 분류 정확도와 토큰 사용량을 비교한 뒤 각 계층의 모델을 정하면 돼요.
계층별 모델 스케줄링 전략
Super-agent의 구조는 외부 이벤트 → 프로그램 필터링 → 모델의 의미 판단 → 권한 결정 → Agent 실행 → 결과 전달로 요약할 수 있어요. 모든 계층에서 같은 모델을 사용할 필요는 없어요.
| 계층 | 작업 특성 | 모델 선택 방향 |
|---|---|---|
| 프로그램 Gate | 출처, 사용자, 범위 일치 여부 확인 | LLM을 사용하지 않음 |
| 이벤트 분류 | 높은 빈도, 짧은 텍스트, 구조화된 출력 | 저비용·저지연 모델 고려 |
| 복잡한 작업 실행 | 코드 재현, 수정, 긴 컨텍스트 추론 | 성능이 더 뛰어난 모델 |
| 결과 요약 및 알림 | 요약, 구조화된 결과 전달 | 독립적으로 구성 가능 |
💡 선택 가이드: 계층별 스케줄링이 실제로 비용을 절감하는지는 실제 로그와 비즈니스 테스트로 검증해야 해요. 여러 모델을 조합하면 무조건 비용이 줄어든다고 가정해서는 안 돼요. APIYI apiyi.com의 통합 인터페이스를 이용하면 비즈니스 코드를 수정하지 않고 각 계층의 모델을 빠르게 교체해 A/B 비교를 할 수 있어요.
Super-agent 이벤트 기반 아키텍처의 영향 분석
연구개발 및 자동화 개발자에게 미치는 영향
- 진입점이 채팅창에서 워크플로로 이동해요: Issue, PR 댓글, CI 결과, 그룹 채팅 메시지가 Agent의 자연스러운 입력이 돼요. 개발자는 프롬프트 작성뿐 아니라 이벤트 수신과 필터링도 설계해야 해요.
- 권한 설계가 핵심 역량이 돼요: Explicit/Inferred 구분, 작업 수락 방식, Mandate 범위에 따라 실제 팀에서 Agent를 받아들일 수 있는지가 결정돼요.
- 평가 방식이 달라져야 해요: 능동형 Agent는 ‘얼마나 많은 작업을 수행했는지’뿐 아니라 작업 발견 품질, 재작업 비율, 불필요한 알림 수를 함께 살펴봐야 해요.
기업 AI 애플리케이션 팀에 미치는 영향
능동형 Agent는 연구개발 협업, 장애 해결, 기업 프로세스 자동화 등 여러 분야에서 활용 가능성이 있지만, 비용 구조도 달라져요. 이벤트 평가에는 지속적으로 토큰이 소비되고, 선제적 실행으로 수행한 작업이 채택되지 않을 수도 있어요. 복잡한 작업에는 사람의 검토도 필요해요. 아래는 공식 아키텍처를 바탕으로 정리한 평가 프레임워크이며, DeepSeek이 발표한 공식 성능 지표는 아니에요.
| 평가 영역 | 주목할 지표 |
|---|---|
| 작업 발견 품질 | 가치 있는 이벤트 식별률, 잘못된 트리거 비율, 중복 작업 비율 |
| 실행 품질 | 작업 완료 비율, 사람의 재작업 비율, 결과물 검토 통과 비율 |
| 사용자 경험 | 유효한 작업당 사람의 개입 횟수, 불필요한 알림 수, 문제 발생부터 검수 가능한 결과가 나오기까지 걸린 시간 |
| 운영 비용 | 이벤트 한 건을 평가하는 데 드는 토큰, 성공한 작업 한 건의 모델 비용, 채택되지 않은 선제적 작업의 비용 |
| 보안 거버넌스 | 권한이 없는 작업의 차단 비율, 주요 단계의 승인 절차 작동 여부, 민감 정보가 허용된 범위 내에 있는지 여부 |
반드시 고려해야 할 위험
능동형 Agent에는 잘못된 트리거, 작업 폭주, 권한 범위 초과, Prompt Injection, 자원 낭비, 정보 유출 등의 위험이 있어요. DeepSeek도 기술 문서에서 복잡한 조직 내부의 컨텍스트 격리, 장기 기억, 안전한 통신, 개인정보 보호 문제가 아직 해결되지 않았다고 인정했어요. 비공개 저장소와 로컬 자격 증명에 접근할 수 있는 Agent라면, 민감 정보가 모델 컨텍스트나 외부 채널로 유입되지 않도록 배포 전부터 설계에 반영해야 해요.
자주 묻는 질문 FAQ
Q1: DeepSeek Super-agent의 이벤트 기반 아키텍처란 무엇인가요?
Agent가 외부 환경의 이벤트(Trigger)를 지속적으로 수신하고, 프로그램 필터링과 모델 판단을 거쳐 허용된 범위에서 작업을 생성·실행한 뒤 적절한 시점에 사람에게 알리는 구조예요. 작업의 출발점은 ‘사용자 지시’에서 ‘환경 이벤트’로 바뀌지만, 권한 부여와 승인은 여전히 사람이 통제해요.
Q2: 작업을 능동적으로 추론하면 사용자가 통제권을 잃게 되나요?
아니요. 추론 작업(Inferred)은 진입 규칙, 실행 범위, 승인 요건을 따라야 해요. 공개 프로토타입은 기본적으로 `observe` 모드를 사용해 잠재 작업만 기록하고 자동으로 접수하지 않아요. 사용자는 `off`로 추론 작업을 완전히 끄거나, 기록을 검토한 뒤 `auto`를 켤 수 있어요. Mandate 메커니즘은 댓글 등의 메시지가 권한 범위를 직접 확대하지 못하도록 보장해요.
Q3: 오픈소스 프로토타입은 현재 어디까지 가능한가요?
공개 프로토타입은 주로 GitHub를 지원하며, 선택적으로 Feishu와 연동할 수 있어요. 세 가지 작업 접수 모드와 Mandate 권한 부여 메커니즘도 제공해요. 커뮤니티에서 Issue → PR 과정을 성공적으로 수행했다는 보고가 있지만, 배포 시 알림 미전달이나 설정 호환성 문제도 발생해요. 이메일·캘린더 등의 이벤트 소스와 기본 활성화된 완전한 비동기 아키텍처는 아직 더 넓은 구상이나 내부 구현에 해당해요.
Q4: 능동형 Agent의 Token 비용은 어떻게 관리하나요?
핵심은 2단계 필터링이에요. 먼저 LLM을 호출하지 않는 프로그램 Gate로 관련 없는 이벤트 대부분을 걸러내고, 소수의 후보만 모델에 전달해 판단해요. 또한 예측 실행은 신중하게 사용해 이점이 뚜렷한 작업만 미리 준비해요. 실제 개발에서는 APIYI apiyi.com의 사용량 통계로 이벤트당 평가 비용과 성공한 작업당 모델 비용을 살펴보고, 그에 맞춰 필터링 규칙과 모델 설정을 조정할 수 있어요.
Q5: 모델 API로 비슷한 이벤트 판단 계층을 구축하려면 어떻게 하나요?
이 글의 예제를 참고하면 돼요. 프로그램 Gate가 규칙에 따라 필터링하고, LLM Assessment가 구조화된 판단 결과를 출력한 뒤 작업 접수 모드에 따라 추론 작업을 처리하는 방식이에요. 모델 호출에는 OpenAI 호환 인터페이스를 사용하면 돼요. APIYI apiyi.com에 가입해 API 키와 테스트 크레딧을 발급받고, 예제의 base_url을 이 글에 나온 주소 그대로 유지하면 실행할 수 있어요. 다만 이는 아키텍처 아이디어를 참고한 예제일 뿐이에요. APIYI는 모델 API를 제공하며, 완성된 Super-agent 서비스를 제공하는 것은 아니에요.
Q6: Super-agent의 현재 알려진 한계는 무엇인가요?
공개 프로토타입의 이벤트 소스가 제한적이고 배포 설정에 호환성 문제가 있어요. 내부의 ‘자동 수정’ 사례는 아직 제3자의 독립적인 검증을 거치지 않았어요. ‘백그라운드 실행’이 24시간 안정적인 운영을 보장하는 것은 아니며, 생성된 PR도 사람이 검토해야 해요. 조직 내부의 컨텍스트 격리, 장기 기억, 개인정보 보호 문제도 해결이 필요하다고 공식적으로 인정하고 있어요.
DeepSeek Super-agent 핵심 요점 Key Takeaways
- 핵심 변화: Agent의 작업 시작점이 사용자 지시에서 환경 이벤트로 바뀌어요. 채팅창이 더 이상 유일한 진입점이 아니에요.
- 2단계 필터링: 프로그램 Gate가 저비용으로 노이즈를 걸러내고, LLM Assessment가 의미를 판단해 비용과 정확도를 함께 고려해요.
- 권한 우선: Explicit와 Inferred를 구분하고, 기본값은
observe로 설정해요. Mandate는 메시지에 의해 권한이 바뀌는 일을 막아요. - 능동적 실행: 추측 실행과 비동기 작업으로 사람의 대기 시간을 줄이되, 연산 비용과 실제 이점을 비교해야 해요.
- 방해를 최소화하는 전달: 결정이나 결과 확인이 필요할 때만 소통해요. 능동적이라는 뜻이 알림을 자주 보내는 것은 아니에요.
- 현재 수준은 신중하게 평가: 내부 사례는 잠재력을 보여주고, 오픈소스 프로토타입은 Issue → PR 흐름을 구현했지만 아직 성숙도는 제한적이에요.
- 활용 방법: 모델 API로 이벤트 판단 계층을 먼저 구축하고, APIYI apiyi.com에서 모델별 분류 성능과 비용을 비교해 볼 수 있어요.
정리
DeepSeek Super-agent의 이벤트 기반 아키텍처가 답하려는 질문은 “AI가 스스로 결정할 수 있는가”가 아니라 “Agent가 규칙과 권한 범위 안에서 어떻게 능동적으로 일을 맡을 수 있는가”예요. 핵심 메커니즘은 세 가지로 정리할 수 있어요.
- 감지와 필터링: Trigger가 작업 환경을 입력으로 활용하고, 2단계 필터링으로 노이즈와 토큰 비용을 관리해요.
- 권한과 제어: Explicit/Inferred 구분, 세 가지 작업 수락 모드, Mandate 범위를 통해 능동성이 권한 초과로 이어지지 않도록 해요.
- 실행과 전달: 추측 실행, 비동기 작업, 방해를 최소화하는 알림을 통해 사람의 역할을 ‘작업 관리’에서 ‘의사결정과 결과 확인’으로 바꿔요.
능동형 Agent의 가치는 얼마나 많은 동작을 실행했느냐보다 사람의 관리 업무를 얼마나 줄이고 신뢰할 수 있는 결과를 얼마나 전달했느냐에 있어요. 현재 오픈소스 프로토타입은 아직 초기 단계이므로 observe 모드에서 판단 기록을 쌓으며 점진적으로 신뢰를 구축하는 것이 좋아요. 비슷한 이벤트 판단 및 작업 실행 흐름을 설계한다면 APIYI apiyi.com에서 각 단계의 모델 성능을 빠르게 검증한 뒤, 실제 비즈니스 데이터를 바탕으로 선택해 보세요.
📚 참고 자료
- DeepSeek Super-agent 아키텍처 연구: 이벤트 기반 및 능동형 Agent 설계 분석
- 링크:
blog2.eimoon.com/p/deepseek-super-agent-design/ -
설명: Trigger, 추측 실행, 비동기 작업과 내부 사례를 다뤄요
-
DeepSeek 권한 부여 메커니즘 문서: Explicit/Inferred, 작업 수락 모드와 Mandate
- 링크:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
설명:
off,observe,auto세 가지 모드를 이해하기 위한 공식 문서예요 -
DeepSeek 제품 설계 철학: 방해를 최소화하고 사용자의 주의를 존중하는 원칙
- 링크:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
설명: 능동형 Agent가 왜 자주 존재감을 드러내지 않아야 하는지 설명해요
-
DeepSeek Domain Model: 핵심 도메인 개념 정의
- 링크:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
설명: 작업, Worker, 이벤트의 관계를 깊이 이해하는 데 도움이 돼요
-
DeepSeek Setup 배포 안내: 오픈소스 프로토타입 설치 가이드
- 링크:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
설명: 직접 배포하기 전에 꼭 읽어야 할 문서예요
-
GitHub 커뮤니티 사용 보고서: Issue → PR 실측과 배포 문제
- 링크:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - 설명: 현재 프로토타입의 실제 작동 상태와 한계를 확인할 수 있어요
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 홈페이지에서 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.