
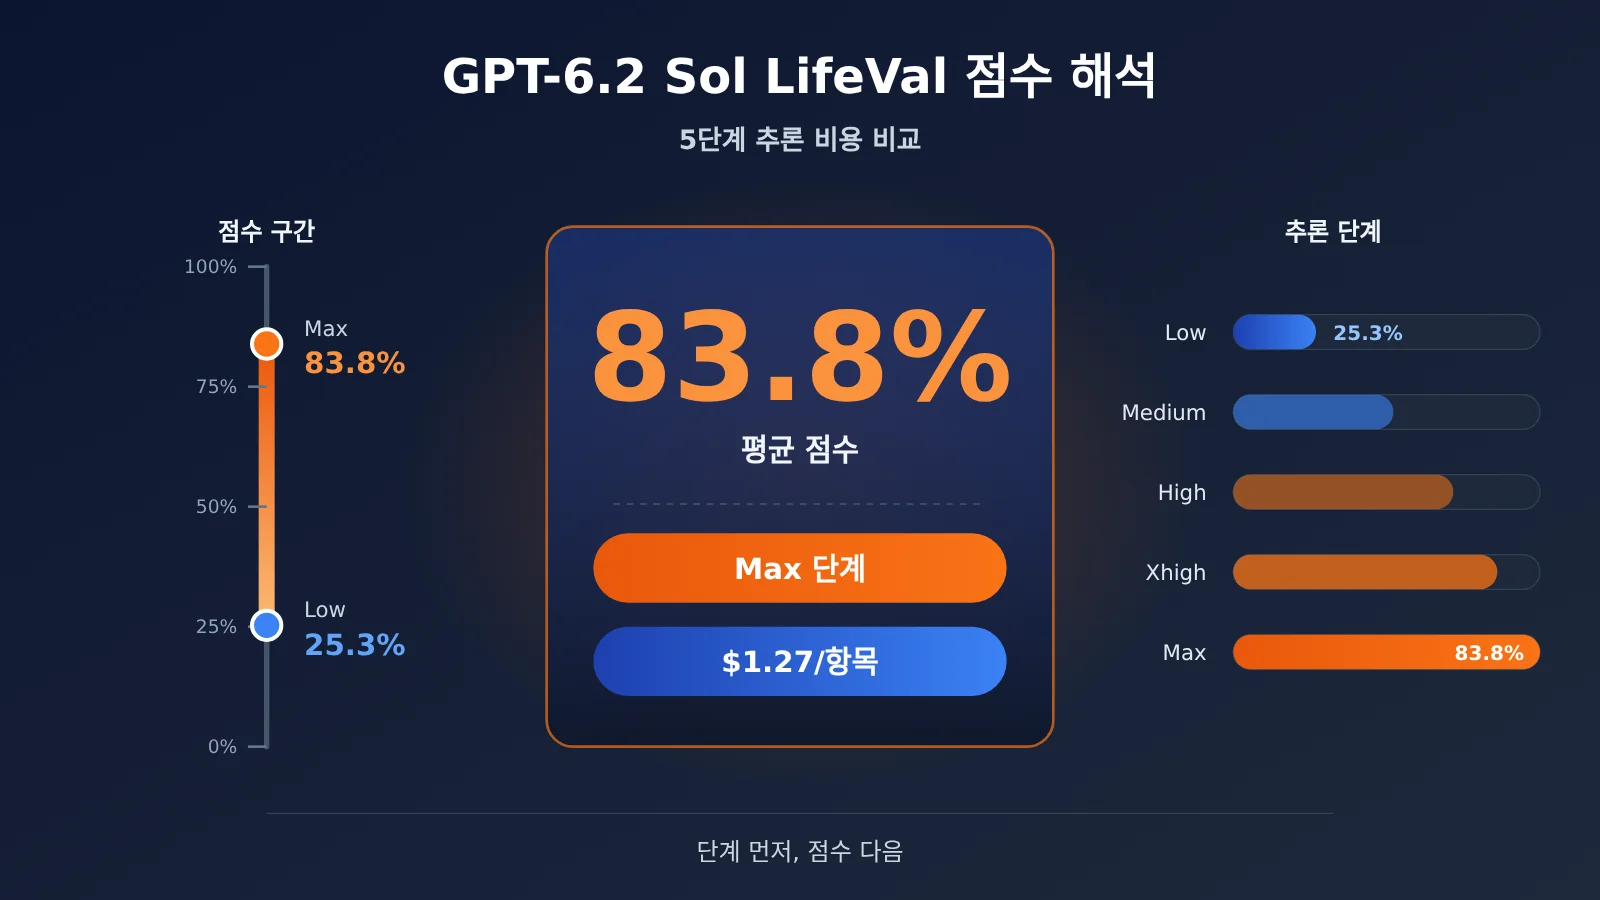
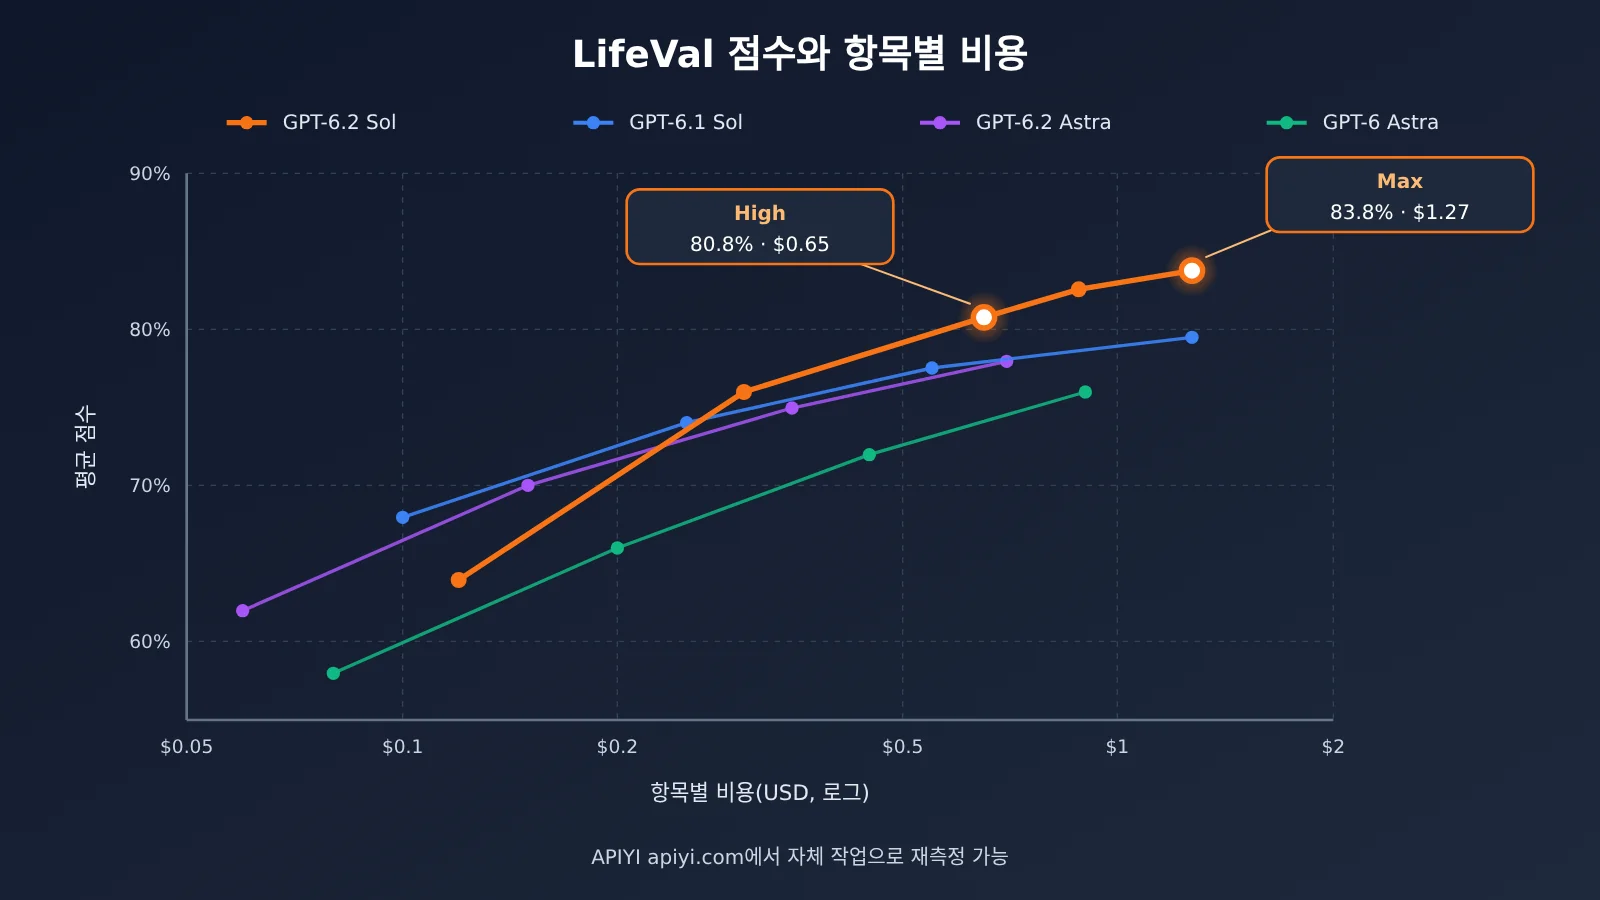
83.8%는 “전체 작업의 83.8%가 완료됐다”는 뜻이 아니라, GPT-6.2 Sol이 Max 추론 단계에서 기록한 LifeVal 평균 점수입니다. 이 점수는 각 작업의 채점 기준에 따라 항목별로 점수를 매긴 뒤 합산한 값이며, 이에 해당하는 항목당 평균 비용은 $1.27입니다. 같은 모델을 Low 단계로 바꾸면 평균 점수는 25.3%에 그쳤고, High 단계에서는 평균 80.8%, 항목당 비용 $0.65를 기록했습니다. 따라서 GPT-6.2 Sol의 LifeVal 성과를 이야기할 때는 어느 단계인지부터 밝혀야 합니다.
결론은 이렇습니다. 공식 리더보드가 제시하는 것은 “특정 작업과 특정 환경에서의 점수·비용 조합”이지, 여러분의 제품에 그대로 옮겨 붙일 수 있는 종합 순위가 아닙니다. LifeVal 데이터에서는 High 단계가 우선 테스트해 볼 만한 출발점입니다. 최종적으로 어느 단계를 쓸지는 여전히 여러분의 작업과 산출물, 실제 상태를 기준으로 검수해야 합니다.
이 글을 읽고 무엇을 알 수 있나요?
- LifeVal이 측정하는 작업이 무엇인지, 83.8%를 어떻게 표현해야 올바른지.
- GPT-6.2 Sol의 다섯 추론 단계별 점수와 비용, 그리고 GPT-6.1 Sol, GPT-6 Astra, GPT-6.2 Astra와의 동일 단계 비교.
- 공식이 말한 “비용 약 7분의 1″과 “Low 단계의 큰 하락”이 왜 동시에 성립하는지.
- LifeVal의 검수 방법을 참고해 자신의 일상 비서를 위한 재측정 가능한 평가 작업을 설계하는 방법.
목차: To Know 표에서는 뒤에서 필요한 평가 용어를 먼저 설명하고, 영향 요약에서는 일반 사용자와 개발자가 각각 무엇에 주목해야 하는지 나눠 설명합니다. 객관적 사실 부분에서는 LifeVal의 작업 출처와 채점 방식, 그리고 11월 17일 공개 이미지의 단계별 데이터를 차례로 설명합니다. 분석과 판단 부분에서는 먼저 여러 비교의 분모를 뜯어보고, 바로 고쳐 쓸 수 있는 경로·일정 비서 검수 예시를 제시한 뒤 전이 경계를 설명합니다.
알아두기: GPT-6.2 Sol LifeVal 점수의 핵심 개념 이해
| 개념 | 간단한 설명 |
|---|---|
| LifeVal | OpenAI가 AI 어시스턴트의 개인화된 일상 디지털 작업 수행 성능을 측정하는 벤치마크 |
| 개인화 컨텍스트 | 사용자 선호, 이전 자료, 작업별 조건 등 ‘적합한 답’을 바꾸는 정보 |
| 채점 기준 | 한 작업의 완료도를 여러 항목별 검증 요구로 나눈 것 |
| 통제 환경 | 앱, 데이터, 초기 상태를 미리 설정한 평가 환경으로, 동작 결과를 확인하기 쉽게 함 |
| 백엔드 상태 차이 | 테스트 전후 기록한 앱 상태 변화로 도구 작업이 실제로 적용됐는지 확인 |
| 평균 보상값 | 각 작업을 채점 기준에 따라 점수화한 뒤 집계한 지표. 발표 그래프의 퍼센트가 이런 ‘평균 점수’ |
| 추론 강도 | 모델 추론 투입을 제어하는 단계. 이 글은 Low, Medium, High, Xhigh, Max를 비교 |
| 단일 항목 비용 | 평가 그래프의 작업당 평균 비용으로, 모델 사용량과 요금에 따라 변동 |
GPT-6.2 Sol LifeVal 영향 한눈에 보기
- 일반 사용자: ‘83.8%’를 보면 성공률이 아니라 ‘미국 영어 사용자 집단의 일상 작업에서의 평균 점수’로 이해하세요. 같은 모델도 추론 단계에 따라 차이가 크기 때문에, 제품 경험은 앱 제공자가 어느 단계를 선택했는지에 달려 있어요.
- 프로덕트 매니저: Low 단계는 가격이 가장 낮지만, 이번 LifeVal에서는 이전 세대 Sol의 Low 단계보다 점수가 크게 뒤졌어요. 이전 버전의 단계 구성을 그대로 두고 업그레이드하면 ‘새 모델로 바꿨는데 오히려 나빠졌다’는 상황이 생길 수 있어요.
- API 개발자: LifeVal의 검증 설계를 참고할 만해요. 즉, 결과물, 환경 상태, 답변을 각각 채점하는 방식이에요. 자체 작업 세트로 Low, Medium, High 단계를 가로 비교하는 편이 리더보드 숫자를 그대로 인용하는 것보다 더 신뢰할 수 있어요.
객관적 사실: GPT-6.2 Sol은 LifeVal에서 어떤 작업으로 모델을 평가했을까
LifeVal의 기원과 공개 타임라인
LifeVal은 OpenAI가 개인화된 일상 에이전트 작업을 측정하기 위해 만든 평가예요. OpenAI 연구 페이지 날짜는 2026년 11월 2일이고, 함께 공개된 논문 날짜는 11월 3일이에요.
11월 17일, OpenAI는 GPT-6.2 Astra와 GPT-6.2 Sol을 공개하면서 발표 페이지에 새 모델의 등급별 점수가 담긴 LifeVal 차트를 첨부했어요(차트 식별자 lifeval-v2).
논문의 작업 분포는 미국과 여러 국가의 시간 사용 연구에서 나왔고, 미국 인구를 대상으로 한 지불 의향 조사도 참고해 일상 활동을 최종적으로 148개 유형으로 정리했어요. 논문 실험에서는 169개 작업을 사용했어요. 참고로, 논문 자체에서 평가한 모델은 GPT-6 Astra까지이며, GPT-6.2 시리즈의 등급별 수치는 이후 공식 발표 이미지에만 등장해요.
공식 포지셔닝에 따르면 Sol은 빈도 높은 일상 업무와 일반적인 코딩, 규모화 가능한 다단계 에이전트를 겨냥하고, Astra는 더 어려운 추론과 전문적인 결과물 전달을 겨냥해요. 이런 포지셔닝은 LifeVal이 측정하는 “일상 비서 작업”과 잘 맞아떨어져요.
LifeVal의 작업 설계: 같은 요구에도 사람마다 다른 합격 답안
LifeVal의 특징은 ‘개인화’예요. 이사를 간 뒤 학교를 비교하는 상황을 예로 들어 보면, 자녀 나이, 통근 경로, 학군 선호가 다른 사용자에게는 합격 답안도 달라져요. 예산과 통근 시간 사이에서 집을 고르는 경우에도 예산 상한과 감당할 수 있는 통근 시간이 어떤 매물을 합격 결과로 볼지 직접 결정해요.
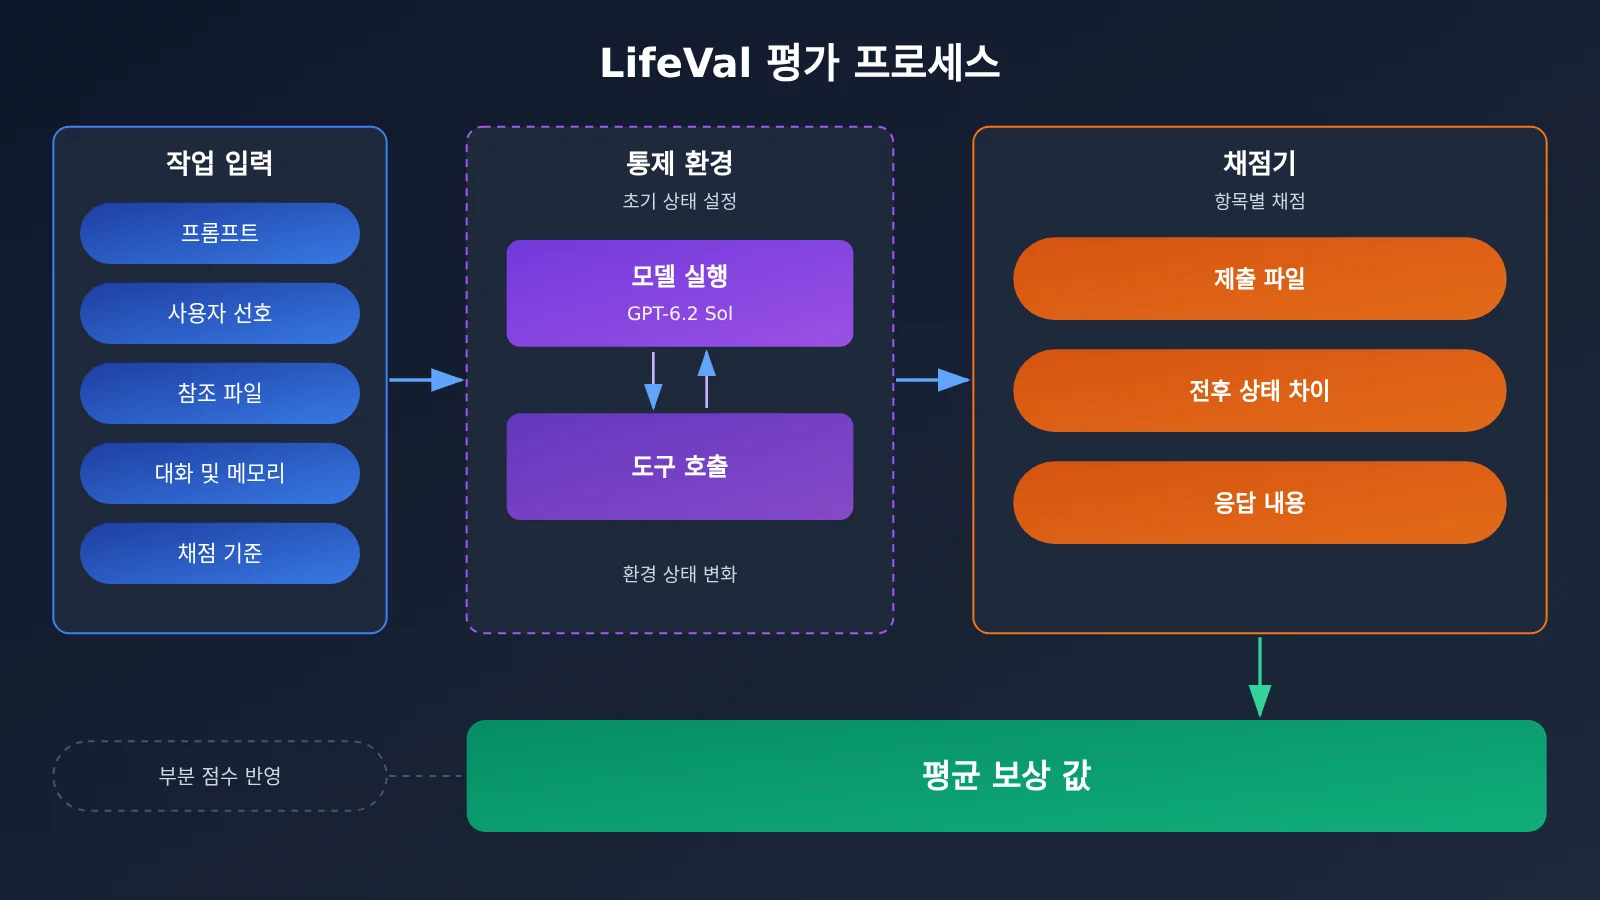
논문 기준으로 각 작업에는 프롬프트, 사용자 선호, 참조 파일, 관련 세션과 메모리, 채점 기준, 그리고 미리 상태가 설정된 통제 환경이 붙어 있어요. 실행이 끝나면 평가자는 세 가지를 확인할 수 있어요. 모델이 제출한 파일, 도구가 조작한 환경의 실행 전후 상태, 모델의 답변이 그것이고, 이후 작업의 각 요구 사항에 따라 따로 점수를 매겨요.
왜 83.8%는 ‘평균 점수’라고만 말할 수 있나
논문 결과 그림의 세로축은 평균 보상값이에요. 따라서 83.8%는 ‘평균 점수’로 표현해야 하고, ‘83.8%의 작업이 완전히 성공적으로 수행됐다’라고 쓰면 안 돼요. 어떤 작업이 일부 채점 항목만 충족해도 부분 점수를 기여해요.
논문은 몇 가지 한계도 밝혀요. 오프라인 환경과 캐시된 웹페이지에는 시간이 지나며 달라지는 정보가 일부 남아 있고, 표본 인구는 미국을 대상으로 영어를 사용하는 사용자 중심이에요. 즉 이 점수를 다른 지역, 다른 언어, 다른 애플리케이션 생태계로 바로 일반화할 수는 없어요.
GPT-6.2 Sol LifeVal 공개 차트: 5단계 점수와 항목당 비용
아래 표는 2026년 11월 17일 OpenAI 공개 페이지의 LifeVal 인터랙티브 차트에서 공개된 데이터를 읽은 것입니다. 각 셀은 “평균 점수 / 평균 작업당 비용(USD)”이며, OpenAI가 자체 보고한 공개 평가 데이터이지 독립 기관의 실측은 아닙니다.
| 모델 | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
공개 발표문 본문의 설명은 이렇습니다. LifeVal에서 Sol의 점수는 GPT-6 Astra보다 높고, 비용은 약 7분의 1 수준입니다. 여기서 비교 대상은 이전 세대 플래그십인 GPT-6 Astra이며, 같은 시기의 GPT-6.2 Astra가 아닙니다. 발표문에서 FrontierCode 2.0을 비교한 또 다른 부분에서야 GPT-6.2 Astra가 사용되므로, 읽을 때 두 결론을 섞지 않아야 합니다.
📌 데이터 기준 안내: 표의 “항목당 비용”은 공식 평가 차트의 평균값으로, 해당 평가의 입력 길이, 출력 길이, 도구 사용에 영향을 받습니다. 여러분의 작업 비용은 실제 요청으로 다시 측정해야 하며, APIYI apiyi.com에서 동일한 Key로 Sol의 여러 단계를 순차 실행해 과금 내역을 직접 비교할 수 있습니다.
GPT-6.2 Sol API 접속 정보
API 모델 ID는 gpt-6.2-sol이며, Responses와 Chat Completions를 통해 호출할 수 있어요. 함수 호출과 내장 도구는 Responses 경로를 사용하고, 두 엔드포인트 모두 none 추론 등급을 허용하지 않아요. 공식 단기 컨텍스트 Standard 표준 가격은 입력 $2.00, 출력 $10.00(USD / 백만 token 기준이며, 출력에는 추론 token이 포함됨)으로 GPT-6.1 Sol과 동일해요.
2026년 11월 20일 기준, APIYI 공개 모델 총표와 가격 책정 인터페이스 모두에 gpt-6.2-sol이 등재되어 있고, responses와 chat 진입점이 표기되어 있어요. 단기 등급 가격은 공식과 일치하며, 실제 사용 가능한 그룹, 파라미터 범위 및 청구는 APIYI apiyi.com의 현재 설정과 청구서를 기준으로 해요.
분석 판단: GPT-6.2 Sol LifeVal에서 ‘7분의 1 비용’과 Low 하락은 어떻게 동시에 성립하는가
먼저 비교 대상과 분모를 맞춰야 해요
같은 그림에서 “큰 폭의 진전”과 “뚜렷한 퇴보”라는 두 가지 인상을 모두 읽어낼 수 있는 근본 이유는, 비교 대상과 비교 기준(등급)이 서로 다르기 때문이에요. 아래 표의 차이값과 비율은 모두 공식 공시 값을 기준으로 계산했어요.
| 비교 그룹 | 양측 수치 | 점수 차 | 비용 관계 |
|---|---|---|---|
| 6.2 Sol Max vs 이전 세대 플래그십 GPT-6 Astra Max | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0%p | 약 14.0%, 즉 “약 7분의 1” |
| 6.2 Sol Max vs 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3%p | 비용 동일 |
| 6.2 Sol Low vs 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5%p | 비용은 더 낮지만 점수는 크게 하락 |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2%p | 비용 약 절반 |
| 6.2 Sol High vs 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3%p | 약 절반 |
| 6.2 Sol Max vs 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3%p | 약 30% |
이 수치들에서 “퍼센트 포인트(%p)”는 평균 점수의 차이를, “비용 비율”은 평균 단일 항목 비용의 비를 나타내요. 두 값은 서로 환산할 수 없어요. “7분의 1″은 오직 “6.2 Sol Max 대 GPT-6 Astra Max”라는 이 한 조합에서만 성립해요. 같은 시기의 GPT-6.2 Astra로 바꾸면, Sol은 오히려 Max 등급에서 2.3퍼센트 포인트 낮아요.
💡 모델 선택 팁: 같은 모델이라도 등급 간 차이가 서로 다른 모델 간 차이보다 클 수 있어요. 우선 APIYI apiyi.com에서 고정된 작업 세트로 등급별 비교를 한 차례 실행해 본 뒤 기본 등급을 결정하는 걸 권장해요. 기존 모델의 등급 설정을 그대로 이어 쓰지 마세요.
Low 티어의 신호: 업그레이드는 “무작정 교체”가 아니에요
6.2 Sol의 Low 티어는 LifeVal에서 25.3%에 불과한데, 6.1 Sol Low보다 41.5%포인트 낮아요. 공식 발표 자료에서는 Sol이 여러 작업에서 소비하는 출력 토큰이 더 적다고 언급했고, Low 티어의 평균 작업당 비용도 $0.089에 불과해요. 여기서 합리적인 추측 하나는 개인화된 다단계 작업에서는 낮은 추론 투입이 선호 제약과 도구 조작을 커버하기에 부족하다는 것이에요. 다만 이건 어디까지나 추측이고, 공식에서는 Low 티어 하락에 대한 설명을 내놓지 않았어요.
프로덕트 팀 입장에서 영향은 직접적이에요. 만약 여러분의 애플리케이션이 그동안 6.1 Sol에서 비용을 아끼려고 Low 티어를 썼다면, 티어 조정 없이 모델 ID만 바꾸는 경우 복잡한 일상 작업의 품질이 눈에 띄게 떨어질 수 있어요. 반대로 Max 티어는 같은 작업당 비용에서 이전 세대 Sol보다 4.3%포인트 높아서, 새 모델의 상한이 실제로 올라갔다는 걸 보여줘요.
왜 High가 이 평가에서 우선 테스트해볼 만한 티어인가
6.2 Sol은 High에서 Xhigh로, 다시 Max로 갈 때 인접 구간 상승폭이 각각 1.8%포인트, 1.2%포인트에 그친 반면, 평균 작업당 비용은 $0.23, $0.39씩 올라가요. High 티어는 $0.65로 80.8%를 기록해서, 이미 6.1 Sol의 Max 티어와 GPT-6 Astra의 Max 티어보다 높아요. LifeVal만 놓고 보면 High가 “품질과 비용이 비교적 균형 잡힌” 출발점이에요.
다만 이 판단에는 세 가지 전제가 있어요. 작업 분포가 LifeVal에 가깝고, 언어와 애플리케이션 환경이 미국 영어 사용자 시나리오에 가깝고, 비용 구조가 이 평가의 입력·출력 비율에 가까워야 한다는 것이죠. 어느 하나라도 충족되지 않으면 결론이 달라질 수 있어요. 실무에서 더 안전한 방법은 High에서 시작해서, 자체 작업의 기준 달성률에 따라 Medium으로 내려갈지, 아니면 Xhigh나 Max로 올릴지 결정하는 것이에요.
분석 판단: LifeVal 접근법으로 나만의 GPT-6.2 Sol 어시스턴트 검증하기
저위험 가족 일정 작업 구성하기
LifeVal에서 가장 배울 만한 점은 점수 자체가 아니라 “산출물과 상태에 따라 검증한다”는 방법이에요. 아래는 가족 일정 예시입니다. 어시스턴트에게 세 가지 하드 제약, 즉 출발지와 목적지, 무장애 이동 조건, 예산 상한을 미리 주고, 검증 가능한 경로가 포함된 후보안과 편집 가능한 일정 초안을 제출하도록 요구해요.
| 평가 항목 | 확인 방법 | 자동화 가능 여부 |
|---|---|---|
| 장소 제약 충족 여부 | 후보안의 출발지·목적지가 입력과 일치하는지 | 자동 확인 가능 |
| 무장애 조건 충족 여부 | 경로 설명이 무장애 요구를 명확히 다루는지 | 일부 자동, 사람이 표본 확인 필요 |
| 예산 초과 여부 | 후보안의 금액을 파싱해 상한과 비교 | 자동 확인 가능 |
| 링크가 정보를 뒷받침하는지 | 링크에 접속 가능하고 내용이 후보안과 일치하는지 | 사람이 직접 확인 필요 |
| 일정 초안 파일 존재 여부 | 출력 파일 또는 캘린더 항목의 전후 상태 확인 | 자동 확인 가능 |
| 핵심 정보 누락 시 질문 여부 | 날짜 등 정보를 일부러 생략해 보고 먼저 되묻는지 확인 | 사람의 판단 필요 |
이 평가 항목은 LifeVal의 세 가지 검증 경로에 대응해요: 산출물(일정 초안), 상태 변화(파일이나 항목이 실제로 기록되었는지), 그리고 응답 품질(제약 충족과 먼저 되묻기)이에요. 같은 작업 묶음을 Low, Medium, High에서 각각 실행한 뒤 달성률과 비용을 함께 보고 초기 등급을 정하면 돼요.
초간단 예시: GPT-6.2 Sol 호출하고 추론 사용량 기록하기
아래 예시는 Responses 인터페이스로 gpt-6.2-sol을 호출하면서 출력 토큰과 그 안에 포함된 추론 토큰을 함께 읽어와요. 나중에 항목별 비용을 계산할 때 요긴하게 쓸 수 있죠.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
단계별 비교 스크립트 보기 (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Key 하나로 여러 단계를 비교할 수 있어요
)

# 짧은 컨텍스트 Standard 정가, USD / 100만 토큰 (출력에 추론 토큰 포함)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # 의도적으로 날짜를 빼서, 먼저 되묻는지 확인해요
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """채점 기준에 따라 항목별로 점수를 매기고, 0~1 사이의 점수를 반환합니다"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
스크립트에 들어 있는 자동 검사는 ‘기계가 확인할 수 있는’ 채점 항목만 다뤄요. 링크가 실제로 유효한지, 되묻는 질문의 품질은 어떤지는 여전히 사람이 표본 점검을 해야 하죠. 추론 단계의 파라미터 값, 특히 Xhigh와 Max에 대응하는 문자열은 공식 최신 문서와 사용 중인 채널의 파라미터 설명을 기준으로 확인하세요.
🚀 빠른 시작: APIYI apiyi.com에서 가입하면 무료 테스트 크레딧을 받을 수 있어요. 플랫폼이 OpenAI 호환 인터페이스를 제공하기 때문에 위 스크립트는 Key만 바꾸면 바로 돌아가요. 정식으로 단계를 고르기 전에 소규모 샘플로 한 차례 검증해보기에 딱 알맞답니다.
GPT-6.2 Sol LifeVal 결론의 적용 경계
LifeVal의 결론을 자사 제품으로 옮길 때는 최소한 세 가지 차이를 고려해야 해요. 첫째는 언어와 지역이에요. 논문 표본은 미국 영어 사용자 중심이라, 중국어 환경에서는 지도, 결제, 캘린더 앱 생태계가 완전히 달라요. 둘째는 환경이에요. LifeVal은 통제된 환경과 캐시된 웹페이지에서 실행되지만, 실제 제품에서는 네트워크 변동, 도구 권한 부여 실패, 계정 상태 차이를 마주하게 돼요. 셋째는 비용 구조예요. 공식 개별 항목 비용은 해당 평가의 입력·출력 비율을 전제로 한 값이라, 긴 컨텍스트 요청이 272K 입력을 넘으면 요청 전체가 더 높은 요율로 전환돼서 개별 항목 비용이 차트와 크게 벌어질 수 있어요.
따라서 비교적 합리적인 사용법은 공식 차트를 “후보 범위를 좁히는” 근거로 삼고, 자체 작업 세트를 “최종 결정”의 근거로 삼는 거예요. 복잡한 일상 어시스턴트라면 먼저 High 티어로 기준선을 세운 뒤, Medium이 핵심 하드 제약을 지키는지, Xhigh나 Max가 수동 재작업을 확실히 줄여 주는지 각각 테스트하고, 실제 기준 충족률과 비용 청구 내역으로 판단하면 돼요.
작업 세트, 채점 기준, 환경 점검까지 준비되면 모델 업그레이드는 더 이상 “순위표를 보고 모델을 바꾸는” 일이 아니라, 매번 다시 측정할 수 있는 엔지니어링 프로세스가 돼요. 여러 모델과 티어를 반복 비교해야 할 때는 APIYI apiyi.com의 통합 인터페이스를 활용해 GPT-6.2 Sol, GPT-6.2 Astra 등을 동일한 검수 스크립트 안에서 실행할 수 있어요.
참고 자료
-
OpenAI GPT-6.2 Astra 및 Sol 출시 공지(LifeVal 구간 차트 포함)
- 링크:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - 설명: 2026-11-17에 발표되었으며, 이 글의 구간별 데이터 출처예요
- 링크:
-
LifeVal 연구 페이지 및 논문
- 링크:
openai.com/index/lifeval,cdn.openai.com/pdf/lifeval.pdf - 설명: 과제 출처, 채점 방식 및 제약 설명(논문 §3–§5)
- 링크:
-
GPT-6.2 Sol 모델 카드 및 공식 가격
- 링크:
developers.openai.com/api/docs/models/gpt-6.2-sol - 설명: 컨텍스트 규격, 장단 컨텍스트 과금 규칙 및 한도
- 링크:
-
APIYI 모델 총람
- 링크:
docs.apiyi.com/models.md - 설명: 공개 등록 모델, 접속 경로 및 가격 정보
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI 공식 웹사이트 apiyi.com에서 저희에게 연락해 주시면 됩니다. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요









