작성자 노트: 하나의 Responses usage에서 시작해 GPT-6.2 Sol의 일반 입력, 캐시 읽기와 쓰기, 추론 출력을 항목별로 다시 계산하고, 이어서 캐시 수명과 요청 상태가 같은 워크플로의 청구서를 어떻게 바꾸는지 설명해요.
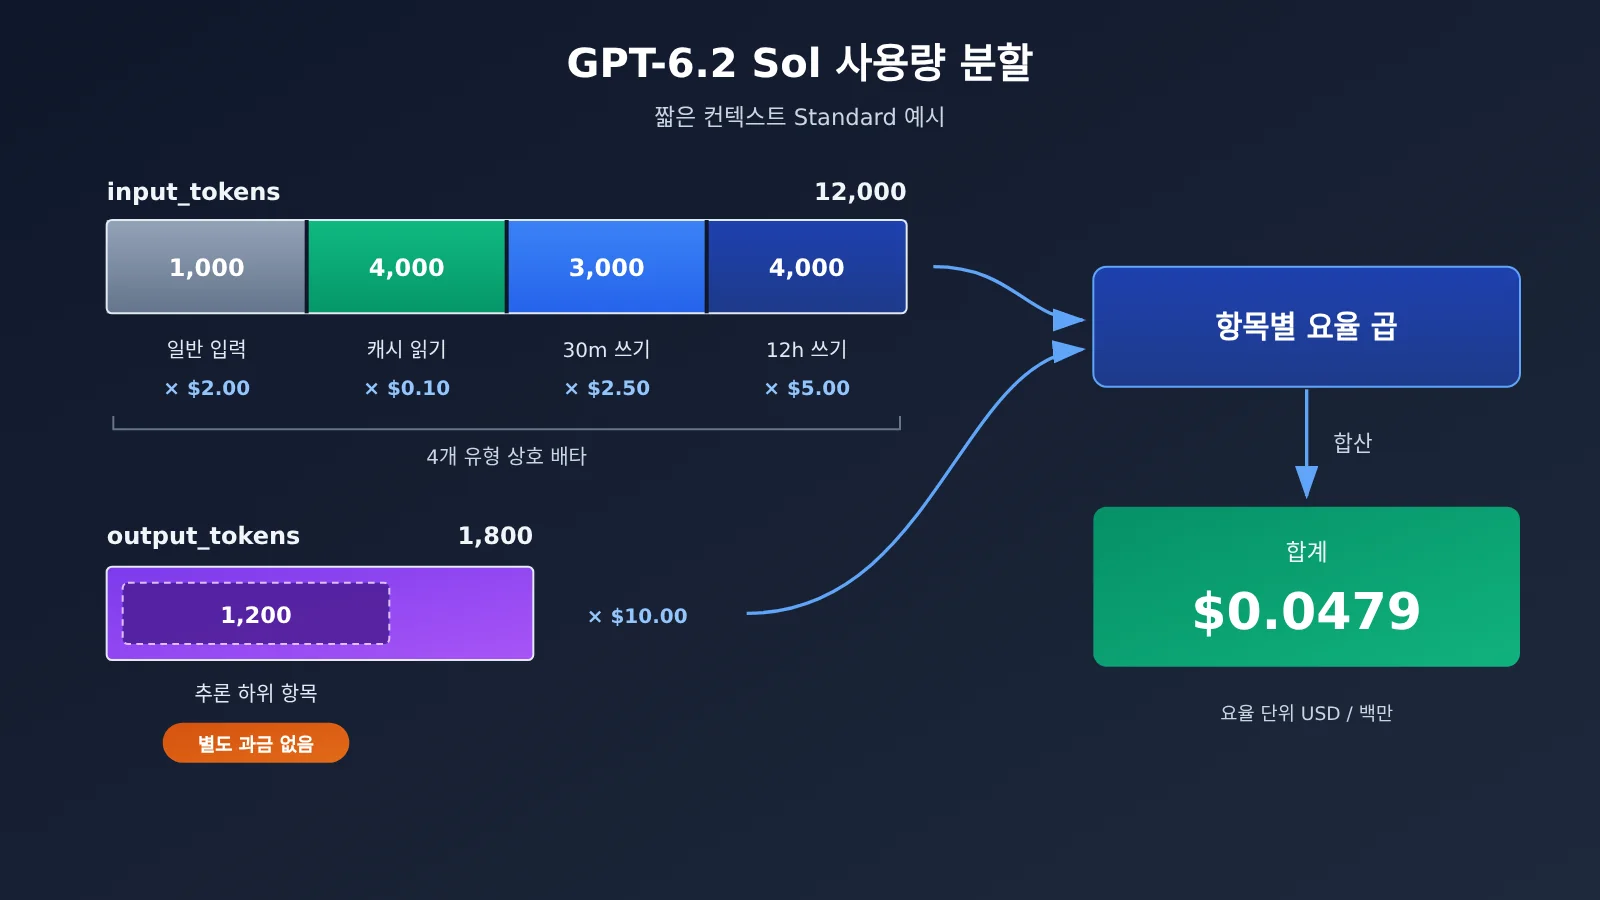
GPT-6.2 Sol의 청구서는 정해진 방식으로 다시 계산할 수 있어요. 요청 기록의 usage는 입력을 일반 입력, 캐시 읽기, 30분 캐시 쓰기, 12시간 캐시 쓰기 네 가지로 나누며, 이 네 가지는 서로 배타적이에요. 출력은 별도 범주이고 추론 토큰은 이미 그 안에 포함돼요. 각 범주의 토큰 수에 해당 요율을 곱한 뒤 더하면 그 요청의 모델 비용이 돼요. 도구 비용은 따로 계산해요.
세 가지 조건이 결과를 바꿔요. 첫째, 단일 요청의 총입력량이 272K를 넘는지 여부예요. 넘으면 해당 요청 전체가 긴 컨텍스트 요율로 바뀌어요. 둘째, 캐시 수명과 실제 적중 횟수예요. 같은 프리픽스를 30분 캐시로 쓰느냐 12시간 캐시로 쓰느냐에 따라 손익분기점이 달라져요. 셋째, 요청 상태예요. incomplete, 재시도, 백그라운드 작업은 모두 워크플로 전체 청구서에 영향을 줘요.
OpenAI는 2026년 11월 17일 GPT-6.2 Sol을 발표했고, API 모델 ID는 gpt-6.2-sol이며 Responses와 Chat Completions로 호출할 수 있어요. 함수 호출과 내장 도구는 Responses 경로를 사용해요. 이 글은 OpenAI 공식 직결의 달러 표시 가격을 기준으로 하면서, 동시에 APIYI apiyi.com의 공개 가격 API에서 이 모델에 대해 공시하는 기준도 설명해요. 이 글의 계산 예시는 모두 합성 사용량을 기반으로 했으며 실제 측정한 청구서가 아니에요.
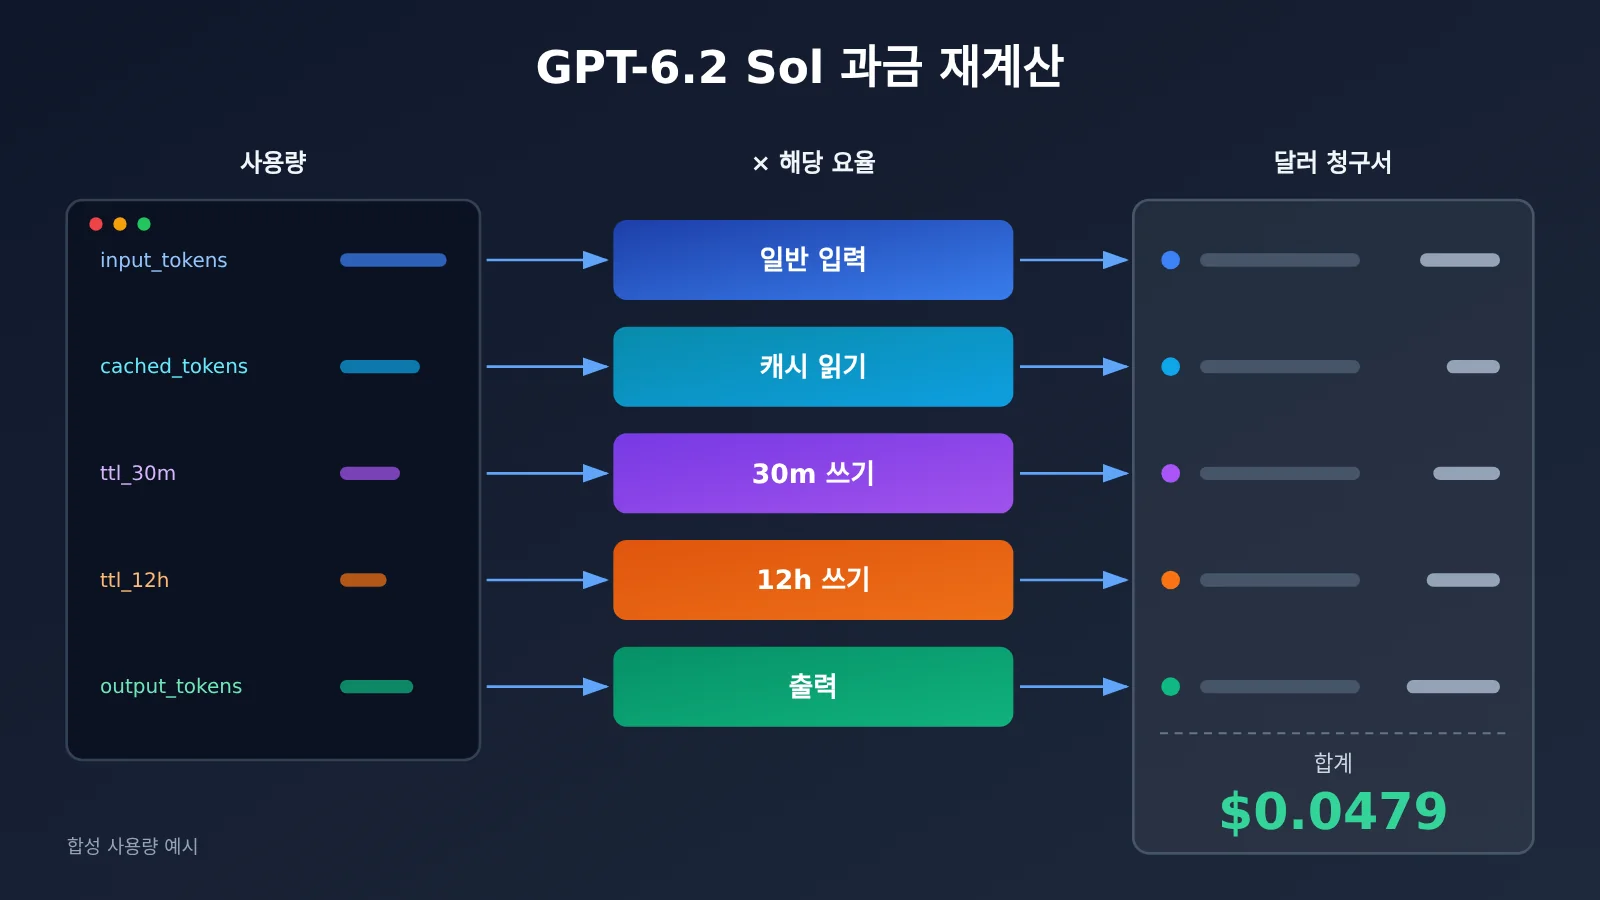
GPT-6.2 Sol 과금 지식 지도와 읽기 순서
글 전체는 ‘필드 → 금액 → 캐시 결정 → 워크플로 정산’ 순서로 이어져요. 각 단계의 출력은 다음 단계의 입력이 되죠. 먼저 usage에 어떤 항목이 있는지 파악하고, 그다음 이 항목들을 달러로 환산한 뒤, 이 알고리즘으로 캐시 방식을 비교하고, 마지막으로 개별 요청을 워크플로 비용으로 합산해요.
Responses usage
 ├─ 입력 총량 input_tokens
 │   ├─ 캐시 읽기 cached_tokens ──────────┐
 │   ├─ 30m 쓰기 ttl_30m_tokens ─────────┤
 │   ├─ 12h 쓰기 ttl_12h_tokens ─────────┼─→ ×해당 요율 → 단일 요청 모델 비용(2절)
 │   └─ 일반 입력 = 총량 − 읽기 − 전체 쓰기 ┤
 └─ 출력 output_tokens(reasoning_tokens 포함)┘
                                          ↓
         캐시 수명 선택(3절) ← 동일 프리픽스 다중 요청 총가격 비교
                                          ↓
         워크플로 정산(4절) ← 도구 비용 + 재시도 + incomplete + 비용 내보내기
| 번호 | 답하는 질문 | 이전 절에 대한 의존 | 읽고 나서 할 수 있는 일 |
|---|---|---|---|
| 1 | usage에서 어떤 숫자가 과금에 포함되나요 | — | 하나의 응답에서 과금 대상 사용량 다섯 가지를 분리해요 |
| 2 | 이 사용량은 얼마인가요 | 1절의 다섯 가지 사용량 | 로그 숫자를 달러로 바꾸고, 장단기 구간을 판단해요 |
| 3 | 캐시 쓰기를 30분으로 할지, 12시간으로 할지 | 2절의 단가 알고리즘 | 호출 간격과 적중 횟수에 따라 캐시 수명을 선택해요 |
| 4 | 한 작업에 결국 얼마가 들었나요 | 2·3절의 단일 요청 정산 | 최소 로그 테이블을 만들고, 청구서 차액을 추적해요 |
단일 비용 차이만 설명하려는 독자라면 1·2절만 읽어도 충분해요. 캐시 전략이나 비용 장부를 담당하는 독자라면 네 절을 순서대로 모두 읽는 것을 권해요.
GPT-6.2 Sol 과금 용어 알아보기
| 용어 | 설명 |
|---|---|
| usage | API 응답에서 현재 요청의 토큰 사용량을 요약한 필드 |
| 일반 입력 | 총 입력에서 과금 대상 캐시 읽기와 모든 캐시 쓰기를 뺀 나머지 사용량 |
| 캐시 읽기 | 현재 요청에서 재사용 가격으로 과금되는 입력 부분 |
| 캐시 브레이크포인트 | 캐시가 입력 접두사를 저장하거나 재사용할 수 있는 경계 |
| TTL | 캐시의 최소 과금 적용 시간을 설정하는 값으로, Sol은 30분과 12시간 두 가지 쓰기를 지원 |
| 추론 토큰 | 모델이 사고 단계에서 생성하며 과금 대상 출력 총량에 포함되는 토큰 |
| 응답 ID | 대사 로그, 백그라운드 폴링, 해당 모델 응답을 연결하는 식별자 |
| 도구 비용 | 특정 호스팅 도구를 사용할 때 발생하는 별도 비용 |
1 Responses usage에서 GPT-6.2 Sol의 다섯 가지 과금 사용량 찾기
1.1 네 가지 입력과 한 가지 출력
Responses의 usage 객체는 한 번의 요청에서 입력과 출력을 분리해 기록합니다. 입력 쪽에는 총량과 몇 가지 세부 항목이, 출력 쪽에는 총량과 추론 하위 항목이 제공됩니다. 재계산할 때 찾아야 할 필드는 다음과 같습니다.
| 과금 분류 | 읽는 필드 | 설명 |
|---|---|---|
| 입력 총량 | usage.input_tokens |
네 가지 입력의 합계이며, 그 자체로 요율을 바로 곱하지는 않습니다 |
| 캐시 읽기 | input_tokens_details.cached_tokens |
청구 기준의 읽기량 |
| 캐시 쓰기 합계 | cache_write_tokens |
두 TTL 쓰기의 합계 |
| 30분 쓰기 | cache_write_tokens_details.ttl_30m_tokens |
TTL 상세 정보가 반환될 때 사용합니다 |
| 12시간 쓰기 | cache_write_tokens_details.ttl_12h_tokens |
TTL 상세 정보가 반환될 때 사용합니다 |
| 출력 | usage.output_tokens |
추론 토큰이 이미 포함되어 있습니다 |
| 추론 하위 항목 | output_tokens_details.reasoning_tokens |
출력 구성을 이해하는 데 사용하며, 별도로 가격을 더하지는 않습니다 |
1.2 일반 입력 계산 공식
일반 입력은 usage에 별도 필드가 없으므로 빼기로 구해야 합니다.
일반 입력 = input_tokens − cached_tokens − cache_write_tokens
여기서 빼는 것은 모든 쓰기, 즉 30분과 12시간 두 가지의 합계입니다. 두 가지 쓰기, 읽기, 일반 입력 네 가지는 서로 배타적이며, 같은 토큰은 오직 한 범주에만 속합니다. 캐시에 쓰인 토큰은 쓰기 요율로 과금되고 일반 입력 가격이 다시 중복 적용되지 않습니다. 이 부분이 가장 틀리기 쉬운데, 쓰기량을 일반 입력에 남겨 두고 쓰기 요금을 따로 계산하면 총액이 높아집니다.
출력 쪽의 추론 토큰도 중복 계산하기 쉽습니다. reasoning_tokens는 output_tokens의 하위 집합이므로, 재계산할 때는 output_tokens에 출력 요율만 곱하면 됩니다. 추론 하위 항목은 ‘이번 출력이 왜 이렇게 많았는지’를 분석하는 데 적합하고, 별도의 과금 항목으로 삼기에는 적합하지 않습니다.
1.3 재계산에는 과금 필드, 진단 필드는 문제 확인용으로만
Prompt Caching의 진단 정보에는 ‘재사용 가능량’, ‘미스 추정량’ 같은 숫자도 나타납니다. 이런 숫자는 접두사가 바뀌었거나 길이가 부족한 경우처럼 캐시가 왜 미스되었는지 설명해 주지만, 실제 청구를 의미하지는 않습니다. 청구서를 재계산할 때는 usage의 실제 과금 필드만 사용해야 합니다.
특정 채널이 TTL 상세 정보를 반환하지 않거나 cache_write_tokens가 빠져 있다면, 누락된 필드로 청구서를 추정해서는 안 됩니다. 이 경우에는 해당 채널 자체의 청구 기록을 기준으로 삼아야 합니다. 다음 절의 계산 예시는 합성 usage를 사용하며 모든 필드가 갖춰져 있어 전체 알고리즘을 보여 주기에 좋습니다.
2 GPT-6.2 Sol 로그의 숫자를 달러로 환산하기
2.1 공식 Standard 요금표
아래 표는 OpenAI 공식 직접 연결 기준이고, 단위는 USD / 백만 토큰이에요. 단/장 컨텍스트 구간은 요청당 입력 총량으로 판단하며, 272K를 넘으면 요청 전체가 장 컨텍스트 요금제로 전환돼요. 입력 및 각종 캐시 요금은 ×2, 출력은 ×1.5가 적용돼요.
| Standard 과금 항목 | 단 컨텍스트(≤272K) | 장 컨텍스트(>272K) |
|---|---|---|
| 일반 입력 | $2.00 | $4.00 |
| 캐시 읽기 | $0.10 | $0.20 |
| 30분 캐시 쓰기 | $2.50 | $5.00 |
| 12시간 캐시 쓰기 | $5.00 | $10.00 |
| 출력(추론 토큰 포함) | $10.00 | $15.00 |
단 컨텍스트의 기본 정가는 GPT-6.1 Sol과 같아요. 또한 모델 카드에 제시된 컨텍스트 윈도우는 1,050,000 token, 최대 입력은 922,000 token, 최대 출력은 128,000 token이에요. ‘최대 얼마나 입력할 수 있는가’와 ‘어디서부터 장 컨텍스트로 과금되는가’는 서로 독립적인 숫자예요. 300K를 입력하는 요청도 충분히 유효하지만, 요금은 전체가 장 컨텍스트 기준으로 계산돼요.
2.2 합성 usage의 전체 재계산
짧은 컨텍스트 Standard 요청 한 번이 다음과 같은 사용량을 반환했다고 가정해 봐요. 도구 사용도 없고 추가 비용도 없습니다: 입력 총량 12,000, 캐시 읽기 4,000, 30분 쓰기 3,000, 12시간 쓰기 4,000, 출력 1,800(그중 추론 1,200).
먼저 일반 입력을 구해요: 12,000 − 4,000 − 3,000 − 4,000 = 1,000. 그런 다음 항목별로 요율을 곱합니다:
| 청구 항목 | token 수 | 요율(USD/백만) | 금액(USD) |
|---|---|---|---|
| 일반 입력 | 1,000 | 2.00 | 0.0020 |
| 캐시 읽기 | 4,000 | 0.10 | 0.0004 |
| 30분 쓰기 | 3,000 | 2.50 | 0.0075 |
| 12시간 쓰기 | 4,000 | 5.00 | 0.0200 |
| 출력(추론 1,200 포함) | 1,800 | 10.00 | 0.0180 |
| 합계 | — | — | 0.0479 |
이 계산에서 12시간 쓰기는 4,000 token만 차지했는데도 금액의 40% 이상을 차지했어요. 이유는 단가가 일반 입력의 2.5배이기 때문이고, 쓰기 당시에는 비용만 발생할 뿐 보상은 이후 적중이 일어나야 실현됩니다. 3절에서 이 점을 따로 다룰게요.
비용 장부에는 총액 하나만 저장하지 말고 청구 항목별로 token 수와 요율을 각각 기록하는 게 좋아요. 이렇게 하면 비용 차이가 발생할 때 로그의 실제 값을 위 표에 그대로 대입해 행별로 차이의 원인을 찾아낼 수 있습니다.
2.3 긴 컨텍스트는 요율표를 먼저 바꾸고, 동일한 공식을 적용한다
입력 총량이 272K를 넘으면 알고리즘은 그대로예요. 위 표의 요율 열 전체를 긴 컨텍스트 값으로 바꾸기만 하면 돼요. 주의할 점은 이 전환이 요청 전체에 적용된다는 거예요. 캐시 읽기와 쓰기도 함께 두 배가 되고, 출력은 1.5배로 계산해요. 그래서 장단 구간 판정은 항목별 곱셈보다 먼저 끝내야 해요.
서드파티 채널을 통해 호출할 때는 요율을 해당 채널의 기준으로 바꿔야 해요. APIYI apiyi.com을 예로 들면, 2026-11-20에 공개 가격 인터페이스를 다시 조회했을 때 gpt-6.2-sol의 billing_expr 역시 272,000 입력 토큰을 기준으로 구간을 나눴어요. 단거리 구간은 일반 입력 $2, 캐시 읽기 $0.10, 캐시 쓰기 $2.50, 출력 $10이고, 장거리 구간은 각각 $3, $0.15, $3.75, $11.25예요(USD / 백만 토큰). 보시면 장거리 구간 배율이 공식 직결과 다르고, 인터페이스 표현식에는 캐시 쓰기 가격이 한 구간만 표시된다는 것도 알 수 있어요. 실제 프로젝트의 그룹, 기능, 과금은 플랫폼의 현재 설정과 청구서를 기준으로 해요.
아래 코드는 APIYI의 OpenAI 호환 인터페이스로 Responses 요청을 한 번 보내고, usage를 그대로 출력해서 이후 재계산에 쓸 수 있게 해요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "固定规则与公共资料(放在前部便于缓存复用)"},
        {"role": "user", "content": "本次请求的具体问题"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
usage를 받은 뒤에는 하나의 함수로 다섯 가지 사용량을 금액으로 환산해요. 요율표를 파라미터로 만들어 두면 공식 기준이든 채널 기준이든 전환할 때 설정만 바꾸면 돼요:
전체 재계산 함수 보기
LONG_THRESHOLD = 272_000

# OpenAI 공식 Standard 기준, USD / 백만 토큰
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # 쓰기 필드의 위치는 실제 반환 구조를 기준으로 하므로, 여기서는 두 곳 모두 확인
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("缺少 cache_write_tokens,改用渠道出账记录,不要推定")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("缺少写入寿命明细,无法区分 30m/12h 费率")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# 2.2절의 합성 usage로 검증
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
함수는 필드가 빠졌을 때 0으로 처리하는 대신 곧바로 오류를 내요. 이렇게 하는 이유는 쓰기 내역이 빠진 요청을 ‘전부 일반 입력’으로 잘못 계산하는 일을 막기 위해서예요.
🎯 기술 제안: 비용 장부를 만들 때는 먼저 합성 usage로 재계산 함수를 검증한 뒤 실제 로그에 연결하는 걸 권장해요. APIYI apiyi.com을 통해 동일한 API 키로 소량 테스트 요청을 보내고, 반환된 usage를 플랫폼 청구서와 항목별로 대조해 필드 기준을 확인한 다음 통계를 실제 운영에 적용하세요.
3 호출 주기에 맞춰 GPT-6.2 Sol의 캐시 수명 선택하기
3.1 동일 프리픽스에 2회, 3회 접근할 때의 계산
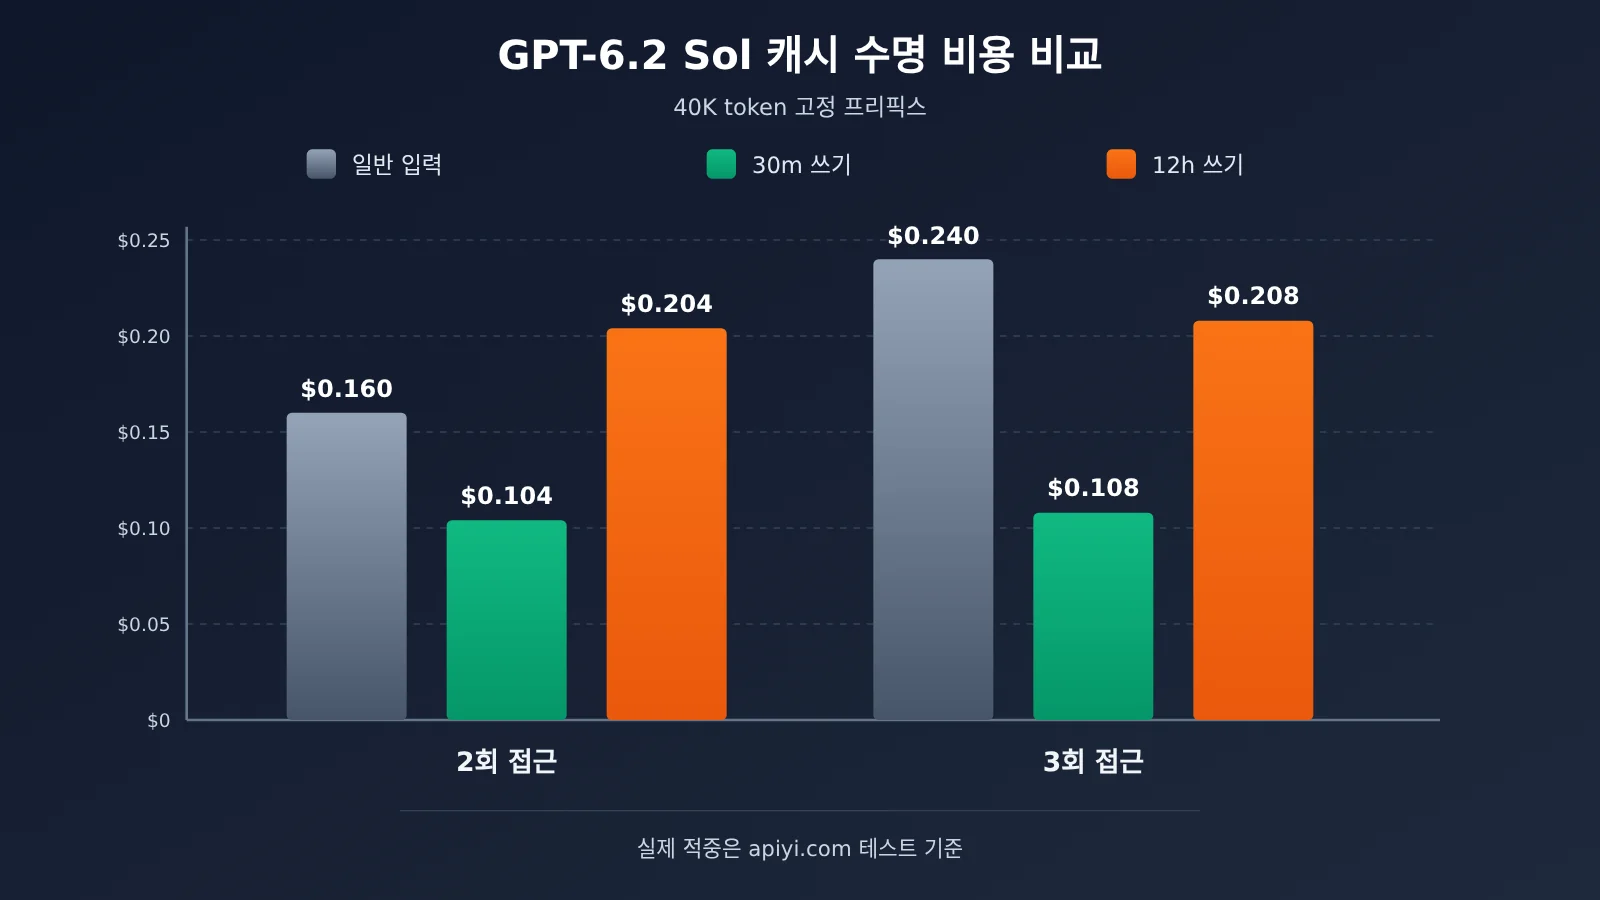
40,000 token짜리 고정 프리픽스(시스템 규칙과 공통 자료)가 있다고 가정하고, 짧은 컨텍스트 Standard 기준으로 가격을 매겨 보겠습니다. 1회당 각 비용은 이렇게 나옵니다. 일반 입력으로 처리하면 $0.08, 첫 30분 캐시 쓰기는 $0.10, 첫 12시간 캐시 쓰기는 $0.20, 완전 캐시 히트 읽기는 $0.004예요. 아래 표는 고정 프리픽스 부분만 비교한 것이고, 요청마다 달라지는 내용과 출력은 포함하지 않았습니다.
| 접근 패턴 | 일반 입력 | 30m 쓰기 방식 | 12h 쓰기 방식 |
|---|---|---|---|
| 총 2회 (1회 쓰기 + 1회 읽기) | $0.160 | $0.104 | $0.204 |
| 총 3회 (1회 쓰기 + 2회 읽기, 모두 윈도우 내) | $0.240 | $0.108 | $0.208 |
두 번 접근하는 경우에는 12시간 쓰기 방식이 캐시를 전혀 쓰지 않는 것보다 $0.044 더 비쌉니다. 세 번 접근하면 두 캐시 방식 모두 일반 입력보다 싸지지만, 30분 방식은 여전히 12시간 방식의 절반 정도에 불과해요. 물론 이 접근들이 모두 30분 윈도우 안에 들어와야 한다는 조건이 붙습니다.
3.2 손익분기점: 몇 번 적중해야 본전인가
위 숫자를 다른 각도에서 보면 더 직관적이에요(아래는 M3 요율 기준 추산). 완전 적중 한 번이면 일반 입력보다 $0.076을 아껴요. 30분 쓰기는 일반 입력보다 $0.02를 더 내지만, 한 번만 적중하면 본전이에요. 12시간 쓰기는 $0.12를 더 내므로, 윈도우 안에서 최소 두 번은 적중해야 본전이 돼요.
그래서 12시간 쓰기의 가치는 “같은 윈도우 안에서 더 많이 적중하는 것”이 아니라 호출 간격이 30분을 넘어도 적중할 수 있다는 것에 있어요. 같은 프리픽스를 쓰는 인접 요청 간격이 보통 몇 분 이내라면 30분 쓰기로 충분하고, 12시간을 고르면 쓰기 비용만 더 내는 셈이에요. 요청이 한두 시간마다 한 번씩 온다면 30분 캐시는 이미 만료돼서 매번 다시 써야 하고, 이때는 12시간 쓰기와 여러 번의 적중이 있어야 더 아낄 수 있어요.
판단을 바꾸는 점이 두 가지 더 있어요. TTL은 최소 과금 커버 시간일 뿐, 캐시가 반드시 그만큼 살아 있다는 뜻은 아니에요. 결국은 usage의 실제 읽기량을 봐야 해요. 30분 쓰기는 읽기 시점에 갱신 규칙이 있어서, 고빈도 상황에서는 실제 커버 시간이 명목상 30분보다 길 수 있어요. 그래서 선택한 뒤에는 설정만 보지 말고 실제 적중 기록으로 되돌아봐야 해요.
3.3 브레이크포인트 배치: 안정적인 내용을 앞에 두기
캐시는 프리픽스에만 적용되고, 최소 캐시 가능 프리픽스는 1,024개의 가시 입력 토큰이에요. 실무에서는 재사용 주기에 따라 계층을 나눠 브레이크포인트를 설정할 수 있어요.
- 장기 공통 자료, 예를 들어 제품 매뉴얼이나 코드베이스 요약: 맨 앞에 두고 12시간 쓰기를 고려해요.
- 단기 세션 기록, 예를 들어 이번 대화 이력: 그 뒤에 두고 30분 쓰기를 고려해요.
- 매번 바뀌는 즉시 지시: 맨 뒤에 두고 캐시에 넣지 않아요.
GPT-6.2에는 쉽게 놓치는 위치 디테일이 하나 있어요. 최상위 instructions는 캐시 가능 브레이크포인트 뒤에 있어요. 고정 규칙을 instructions에 적으면 이 부분은 재사용할 수 없어요. 고정 규칙은 input 앞부분의 developer 메시지에 넣고, instructions는 요청마다 조정될 수 있는 내용에 남겨 두는 편이 더 적합해요.
💡 선택 가이드: 캐시 수명은 실제 트래픽에 맞춰 정해야 해요. 먼저 APIYI apiyi.com에서 같은 프리픽스로 실제 리듬에 맞춰 몇 라운드 요청을 보내고,
cached_tokens의 적중 상황을 집계한 뒤에 어느 계층을 30분으로, 어느 계층을 12시간으로 할지 결정하는 걸 권해요. 채널마다 캐시 쓰기 과금이 다를 수 있으니 플랫폼 청구서를 기준으로 삼아요.
4 워크플로 단위로 GPT-6.2 Sol 비용 집계 및 차액 추적
4.1 청구서가 예상과 어긋나게 만드는 세 가지 요청 상태
요청 1건을 맞게 계산했는데도 워크플로 전체 합계는 여전히 안 맞을 수 있어요. 흔한 원인은 요청 상태에서 비롯돼요:
- incomplete: 출력이
max_output_tokens에 도달하면 응답이incomplete상태로 끝날 수 있어요. 이때 아직 보이는 텍스트가 하나도 없더라도 입력과 추론 토큰은 이미 발생해 과금됐을 수 있어요. “성공적으로 내용을 반환한” 요청만 집계하면 이 비용이 빠져요. - 백그라운드 작업: 이미 응답 ID가 있는 백그라운드 작업은 폴링할 때 같은 ID로 추적해야 하며, 매번 폴링을 새 요청으로 간주해 중복 기록하면 안 돼요.
- 재시도: 타임아웃이나
incomplete때문에 새로 시작한 독립 호출은 새 응답을 생성하므로 별도로 기록해야 해요. 재시도가 많을수록 같은 작업의 입력 비용을 중복 지불하는 횟수가 늘어나요.
4.2 도구 비용과 도구가 불러오는 후속 토큰
Responses는 파일 검색, 웹 검색, 코드 인터프리터, 이미지 생성 등의 도구를 지원해요. 이미지 생성을 사용할 때 Sol은 흐름 중에 도구 호출을 시작하고, 이미지는 별도의 이미지 도구가 완성하며 비용도 도구 규칙에 따라 계산돼요. 도구 비용은 실제 유형에 맞춰 확인해야 하는데, 예를 들어 웹 검색은 $10/천 회로 계산하고, 검색이 반환한 내용 토큰은 별도로 모델 요율에 따라 과금돼요.
재계산할 때는 usage가 어떤 토큰을 포함하는지 확인해야 해요. 도구 결과가 다음 라운드 모델 요청으로 되돌아 들어가면 후속 요청의 입력량이 늘어난 것으로 나타나고, 이 비용은 도구 호출 자체가 아니라 후속 요청에 붙어요. 검색이 포함된 워크플로의 청구서는 보통 “도구 호출 횟수 요금 + 여러 라운드의 모델 요청 요금” 두 부분으로 구성돼요.
4.3 최소 로그 항목
워크플로를 대사(對査)할 수 있게 하려면 모델 응답마다 최소한 다음 필드를 기록해야 해요:
| 로그 항목 | 역할 |
|---|---|
| 워크플로 ID | 여러 요청을 같은 작업으로 묶음 |
| 응답 ID | 백그라운드 폴링 연결, 재시도와 동일 요청 구분 |
| 모델 | 요율표 확정, 예: gpt-6.2-sol |
| 서비스 등급 | Standard 기준인지 확인 |
| 최종 상태 | completed, incomplete 등 식별 |
| 사용량 항목 | 일반 입력, 읽기, 30m 쓰기, 12h 쓰기, 출력, 추론 |
| 도구 | 도구 유형과 호출 횟수 |
| 비용 | 항목별 재계산 금액과 장단기 등급 표시 |
이 표가 있으면 워크플로 ID로 그룹핑해 합산하면 작업 1회 비용을 얻을 수 있어요. 차액 조사에도 순서가 생기는데, 먼저 incomplete와 재시도가 있는지 보고, 다음으로 캐시 읽기가 예상보다 적은지 확인하고, 마지막으로 도구 횟수를 대조하면 돼요.
4.4 요청별 추정과 공식 내보내기 상호 검증
요청별 추정은 실시간 예산 통제에 적합하지만, 다단계 도구 호출, 재시도, 사용량 필드 누락 시 편차가 쉽게 생겨요. 정기적으로 추정 합계를 공식 사용량이나 비용 내보내기와 대조하고, 차액이 설정한 임계값을 넘으면 로그로 돌아가 한 줄씩 확인하는 걸 권장해요. 서드파티 중계 채널을 통해 호출할 때는 대조 대상을 해당 채널의 청구 필드와 요율로 바꿔야 해요.
💰 비용 제안: 팀에서 여러 모델을 동시에 사용 중이라면 APIYI apiyi.com을 통해 하나의 API 키로 통합 호출하고, 이 글의 최소 로그 항목에 따라 DB에 적재할 수 있어요. 단일 진입점을 쓰면 워크플로 ID와 비용 기준이 일관되게 유지되고, 월말 대사 때 채널 환산 단계를 하나 줄일 수 있어요.
GPT-6.2 Sol 청구서 검증 방법
임의의 Sol 요청 기록 하나를 받으면, 다음 순서로 청구서를 검증할 수 있어요. 먼저 입력 총량이 272K를 초과하는지 확인하고 요율 열을 선택해요. 그다음 input_tokens에서 읽기와 모든 쓰기를 빼서 일반 입력을 구해요. 이어서 다섯 항목을 각각 요율에 곱해 더한 뒤 청구서와 비교해요. 단일 요청은 일치하는데 워크플로 총액이 일치하지 않는다면, 로그에서 incomplete, 재시도, 도구 호출을 찾아보세요.
캐시가 이득인지는 결국 usage에 담긴 실제 읽기량과 호출 간격으로 판단해요. 30분 쓰기는 한 번만 적중하면 본전을 회복하고, 12시간 쓰기는 윈도우 내에서 최소 두 번 적중해야 하며, 호출 간격이 30분을 넘을 때에만 우위가 드러나요.
실제 트래픽으로 이 결론을 검증해야 할 때는 APIYI apiyi.com에서 무료 테스트 한도를 신청하고, 본문의 재계산 함수로 플랫폼 청구서와 하나씩 대조할 수 있어요.
📚 참고 자료
-
OpenAI GPT-6.2 Astra 및 Sol 발표 공고: 출시 시기와 제품 포지셔닝
- 링크:
openai.com/index/introducing-gpt-6-2-astra-sol - 설명: 일상 작업과 다단계 Agent를 겨냥한 Sol의 포지셔닝 이해
- 링크:
-
GPT-6.2 Sol 모델 카드: 컨텍스트 사양, 요율 및 장문 컨텍스트 배율
- 링크:
developers.openai.com/api/docs/models/gpt-6.2-sol - 설명: 본문 요율표와 272K 구간 분할 규칙의 출처
- 링크:
-
Prompt Caching 가이드와 캐시 진단: 캐시 필드, TTL 및 중단점 규칙
- 링크:
developers.openai.com/api/docs/guides/prompt-caching - 설명: cached_tokens, 쓰기 수명, 최소 캐시 가능 프리픽스 설명
- 링크:
-
Reasoning 가이드: 추론 token과 incomplete 상태
- 링크:
developers.openai.com/api/docs/guides/reasoning - 설명: 추론 사용량이 출력에 어떻게 반영되는지 이해
- 링크:
-
단일 워크플로 비용 제어 가이드: 워크플로별 Responses 비용 집계
- 링크:
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - 설명: 워크플로 수준 예산 제어의 참조 구현
- 링크:
-
APIYI 모델 총표: 채널 등록 및 진입 정보
- 링크:
docs.apiyi.com/models.md - 설명: gpt-6.2-sol의 사용 가능한 진입점과 그룹 확인
- 링크:
작성자: APIYI 기술 팀
기술 교류: APIYI apiyi.com 홈페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.