글쓴이 주: 이 글은 Gemini 4 Neon의 컨텍스트, 네 단계 사고 강도, 가격을 소개하고, APIYI에서 네이티브와 호환 두 엔드포인트를 설정하는 방법, 그리고 동일한 최소 요청 하나로 흔한 연동 오류를 짚어내는 방법을 설명해요.
한 줄 요약: Gemini 4 Neon은 Google이 2026년 11월 18일에 공개했고, APIYI는 11월 20일 default/svip 그룹에 출시했어요. 모델 ID는 gemini-4-neon이고, 백만 토큰당 가격은 입력 $3, 출력 $15, 캐시 읽기 $0.15로 책정되어 있어요. 네이티브 사고 단계 제어가 필요하다면 Gemini 네이티브 엔드포인트를 우선 사용하고, 기존 OpenAI 클라이언트에서 모델만 바꾸고 싶다면 호환 엔드포인트가 더 간편해요. 다만 두 경로 모두 가장 짧은 요청으로 먼저 정상 동작을 확인한 뒤, 스트리밍, 도구 호출, 더 높은 사고 단계를 하나씩 켜는 게 좋아요.
이 글은 보도자료를 그대로 옮긴 뉴스가 아니에요. 아래의 사양, 가격, 벤치마크 점수, 문제 해결 경로는 각각 출처와 적용 조건을 함께 밝혀 두었고, 코드 예시는 공식 문서를 기준으로 구성했어요. APIYI의 출시 안내에 따르면 출시 전에는 가격 인터페이스만 확인했을 뿐 실제 호출은 하지 않았어요. 그래서 이 글에서는 두 엔드포인트나 도구 호출을 “실제 테스트로 검증 완료”라고 쓰지 않을게요.
핵심 가치: 이 글을 읽고 나면 Neon의 사양과 과금 기준을 확인하고, 네이티브와 호환 두 경로의 최소 요청을 작성하며, 테스트 결과에 따라 사고 단계를 고르고, 오류 증상에 맞춰 문제를 빠르게 짚어낼 수 있어요.
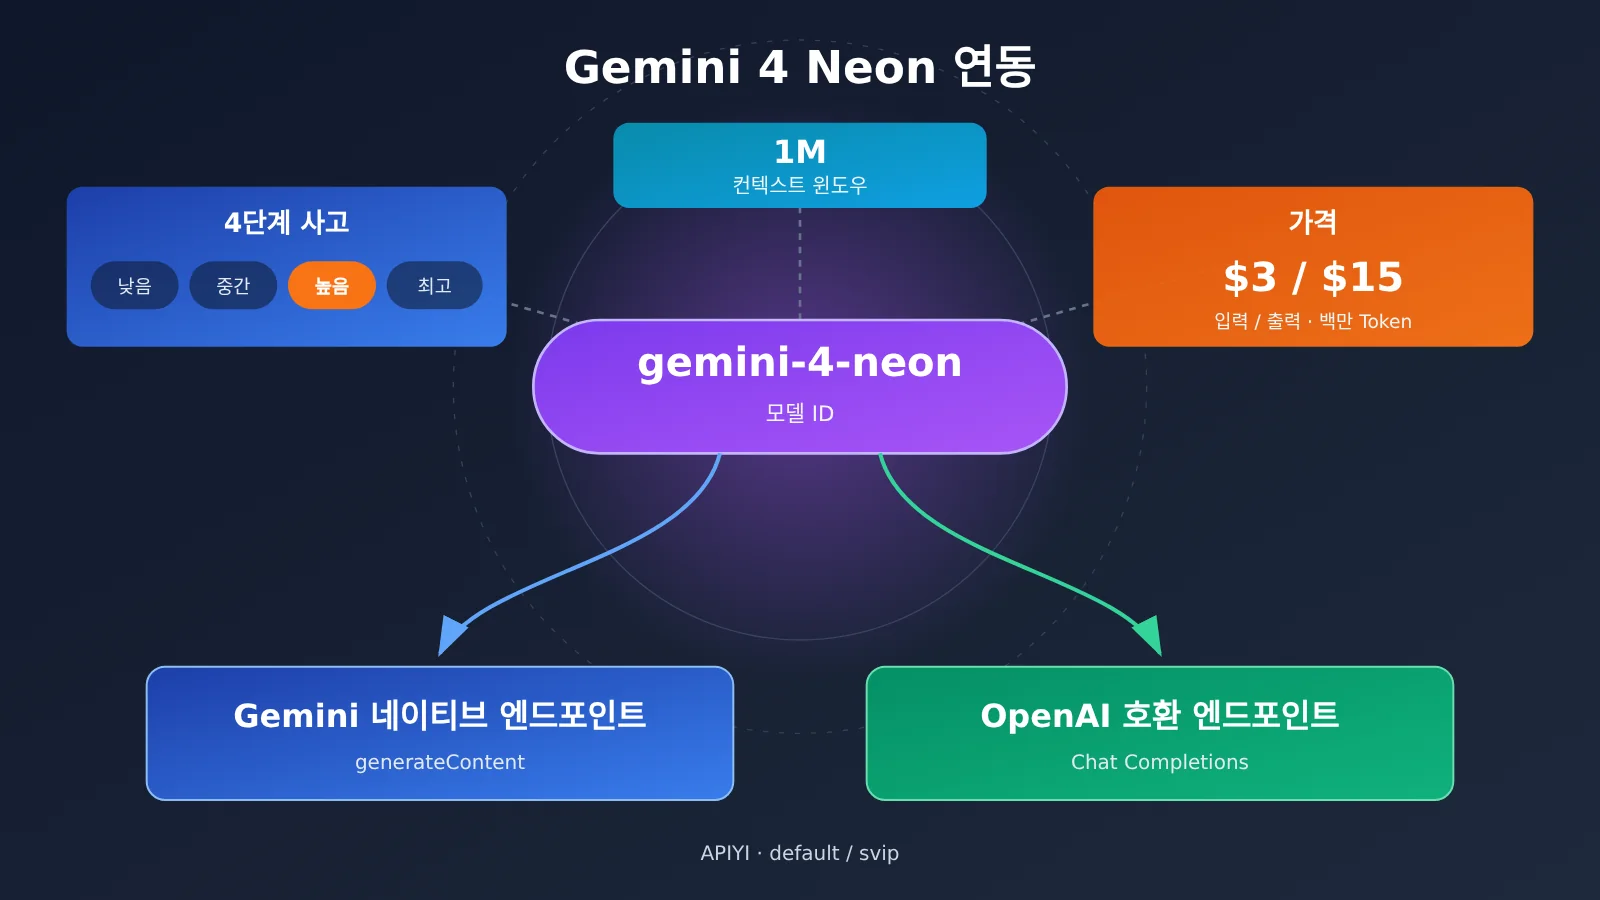
Gemini 4 Neon 연결 전에 알아두면 좋은 용어
아래 개념들은 뒤에서 계속 등장해요. 먼저 용어를 통일해두면 문제를 추적할 때 헷갈리지 않아요.
- 모델 ID: 요청에서 모델을 지정할 때 쓰는 전체 문자열이고, 이 글에서는
gemini-4-neon이에요. 대소문자와 하이픈을 그대로 복사해야 하고, 임의로 줄여 쓰면 안 돼요. - Base URL: 클라이언트가 요청 경로를 이어 붙이는 루트 주소예요.
/v1같은 버전 접두사를 붙이는지는 사용하는 SDK에 따라 다르고, 이걸 잘못 설정하면 404가 자주 발생해요. - Gemini 네이티브 엔드포인트:
generateContent프로토콜을 받는 방식이라, 네이티브 사고 파라미터를 써야 하는 상황에 적합해요. - OpenAI 호환 엔드포인트: Chat Completions 형식을 사용하므로, 이미 OpenAI 클라이언트를 쓰고 있다면 기본 메시지 구조를 그대로 재사용할 수 있어요.
- 사고 단계: 모델 추론 강도를 나타내는 열거형 값이에요. Neon은
low,medium,high,xhigh를 네이티브로 지원하고, APIYI에 출시되면서 기본 단계는high로 동적 표기돼요. - 사고 서명
thoughtSignature: 모델이 반환하는 컨텍스트 표시예요. 다중 턴 도구 호출 시에는 원래 프로토콜대로 보존해서 다시 전송해야 해요. - 컨텍스트 윈도우: 입력, 사고, 출력이 함께 쓰는 총 예산이에요. 한 번의 동기 생성에서 실제로 얼마나 출력할 수 있는지는 상한을 따로 확인해야 해요.
- 캐시 읽기 가격: 조건에 맞는 기존 입력을 재사용할 때 적용되는 과금 단가로, 표준 입력 가격보다 훨씬 낮아요.
Gemini 4 Neon 핵심 포인트: 파라미터, 가격, 그룹
APIYI 출시 동향에 따르면, Neon은 Gemini 4 시리즈의 중간 등급으로, 가장 어려운 작업을 겨냥한 Carbon과 일상적인 실행을 겨냥한 Hydrogen 사이에 자리해요. Google은 11월 18일 발표하고 같은 날 GA를 진행했으며, APIYI는 11월 20일 연동했어요.
| 항목 | 내용 | 출처 및 조건 |
|---|---|---|
| 모델 ID | gemini-4-neon |
APIYI 모델 레지스트리(2026-11-20 생성) |
| 사용 가능 그룹 | default, svip |
APIYI 출시 동향(2026-11-20) |
| 연동 엔드포인트 | Gemini 네이티브 + OpenAI 호환 | APIYI 출시 동향, 출시 전 실제 호출은 없음 |
| 컨텍스트 윈도우 | 1M, 입력/사고/출력이 공유 | Google 공지와 Artificial Analysis 모두 1M로 표기 |
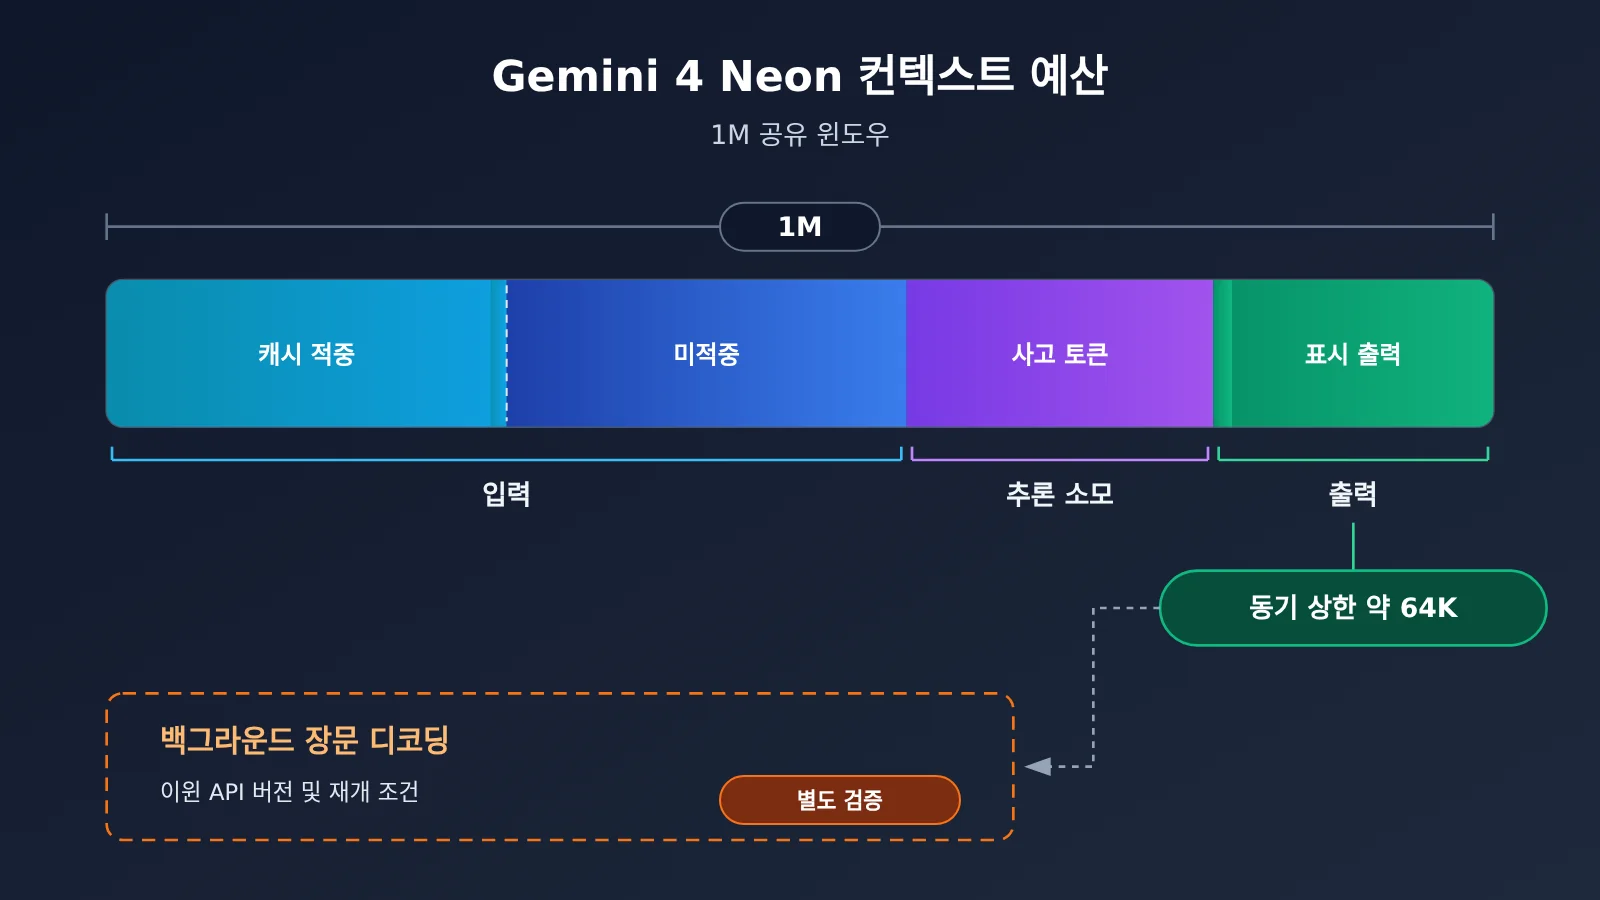
| 동기 생성 상한 | 약 64K 토큰 | APIYI 출시 문서 |
| 사고 등급 | low/medium/high/xhigh, 기본값 high | APIYI 출시 동향 |
| 정가(백만 토큰당) | 입력 $3, 출력 $15, 캐시 읽기 $0.15 | APIYI 레지스트리, 공지에서는 공식 사이트와 항목별로 일치하며 만료일 없음 |
Gemini 4 Neon 컨텍스트와 출력 상한의 관계
1M 컨텍스트는 흔히 “한 번에 1M을 출력할 수 있다”로 잘못 읽히곤 해요. 실제로 이 1M은 입력, 사고, 출력이 함께 쓰는 윈도우예요. APIYI 출시 문서에 따르면 동기 호출의 생성 상한은 약 64K 토큰이에요. 즉 긴 입력은 문제없지만, 한 번의 동기 요청에서 이 수준을 넘는 출력을 기대하기는 어려워요.
Google Cloud 문서에는 최대 1M까지 가능한 백그라운드 장문 디코딩 기능이 언급돼 있어요. 다만 이 기능은 특정 클라우드 인터페이스 버전과 이어받기(재개) 조건에 의존하기 때문에 일반적인 동기 호출과는 다른 이야기예요. APIYI와 호환되는 Chat Completions 엔드포인트에서는 현재 검증할 수 있는 장문 디코딩 실제 호출 결과가 없어요. 업무상 초장문 출력이 필요하다면 우선 분할 생성 방식으로 설계한 뒤, 장문 디코딩은 별도로 검증하는 걸 권해요.
Gemini 4 Neon 가격은 어떻게 추산할까
아래는 정가를 기준으로 계산한 예시이며, 실제 청구서를 의미하지 않아요. 한 번의 요청에 입력 100K 토큰, 가시 출력 5K 토큰이 있다고 가정해 볼게요. 입력 비용은 약 $0.30, 출력은 약 $0.075로 합계 약 $0.375예요. 이 가운데 80K 입력이 캐시에 적중했다면 이 부분은 $0.15 기준으로 약 $0.012, 나머지 20K는 $3 기준으로 약 $0.06이 되어 입력 비용이 눈에 띄게 줄어들어요.
사고 과정에서 소모된 토큰이 어떻게 집계되는지, 캐시가 어떤 조건에서 적용되는지는 모두 실제 청구서를 기준으로 봐야 해요. APIYI 출시 동향에서는 또 12월 1일부터 Carbon/Argon의 한정 가격이 만료되어 $4/$20으로 복귀한다는 점도 언급했는데, 그 시점에 Neon의 정가는 이들보다 25% 낮아요. 이건 플랫폼 공지에 담긴 가격 비교일 뿐, 성능 비교와는 무관해요.
Gemini 4 Neon 빠른 시작: 네이티브와 호환, 두 가지 최소 요청
두 경로 각각에서 가장 짧은 요청을 하나씩 보내 보는 걸 권장해요. 모델 ID, 그룹, 라우팅이 모두 올바른지 확인한 다음에 다른 기능을 추가하세요. 아래 예시는 Google GenAI SDK와 OpenAI SDK 공식 문서를 기준으로 구성했고, Key는 전부 플레이스홀더를 사용했어요.
| 비교 항목 | Gemini 네이티브 엔드포인트 | OpenAI 호환 엔드포인트 |
|---|---|---|
| 권장 SDK | Google GenAI SDK | OpenAI SDK |
| Base URL 표기 | 플랫폼 루트 주소, 별도로 api_version="v1beta" 설정 |
루트 주소에 /v1 포함 |
| 요청 구조 | contents[].parts[] |
messages[] |
| 사고 레벨 설정 | generationConfig.thinkingConfig.thinkingLevel |
엔드포인트 간 파라미터 매핑은 별도 검증 필요 |
| 추천 사용 사례 | 사고 제어를 정밀하게 다뤄야 할 때, 멀티턴 도구 호출 | 기존 OpenAI 코드의 빠른 전환 |
Gemini 4 Neon 네이티브 엔드포인트 예시
네이티브 엔드포인트는 플랫폼 루트 주소를 쓰고, 버전 접두사는 SDK의 api_version에 맡겨요. Base URL에 v1beta를 다시 적지 마세요. 그렇지 않으면 경로가 중복으로 이어져요.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # APIYI 플랫폼 루트 주소, 버전은 api_version으로 지정
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
SDK의 snake_case 네이밍은 최종적으로 REST 요청 바디의 camelCase 필드에 대응돼요. HTTP 요청을 직접 보낸다면 요청 바디 구조는 대략 아래와 같고, 특히 두 계층을 눈여겨보세요.
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
주의할 점이 두 가지 있어요. 첫째, 예전 버전의 thinkingBudget과 minimal 레벨은 Gemini 4에 적용되지 않으니 코드를 마이그레이션할 때 삭제해야 해요. 둘째, Google 문서에 따르면 Gemini 4는 temperature와 topP를 무시하므로, 이 두 파라미터를 조정해도 효과가 안 보이는 건 예상된 동작이에요.
Gemini 4 Neon 호환 엔드포인트 예시
호환 엔드포인트는 이미 OpenAI SDK를 사용 중인 프로젝트에 잘 맞아요. 아래에서는 가장 기본적인 messages만 사용해서, 먼저 라우팅과 그룹이 정상적으로 동작하는지 확인합니다.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI OpenAI 호환 엔드포인트
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "用三句话解释什么是上下文窗口"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
응답에서는 본문 외에도 finish_reason을 함께 기록하는 걸 권장해요. 본문이 비어 있을 때 이 값이 첫 번째 단서가 됩니다. 네이티브 엔드포인트에서는 후보 결과의 종료 이유와 안전 등급 필드에 해당하니, 문제를 진단할 때도 똑같이 보관해야 해요.
진단 정보가 포함된 래핑 코드 보기
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # 위에서 설명한 호환 엔드포인트 주소를 입력
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """gemini-4-neon을 호출하고 종료 이유와 사용량을 출력해 문제 진단을 돕습니다"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("正文为空:检查结束原因、安全状态与输出预算")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # 레이트 리밋과 일시적 사용 불가에만 재시도하고, 나머지 오류는 바로 발생시킵니다
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("列出三个适合用长上下文的任务"))
🚀 빠른 시작: APIYI apiyi.com 콘솔에서 토큰을 만들 때 토큰 그룹이
default또는svip에 속하는지 확인하세요. 신규 사용자는 무료 테스트 크레딧으로 위의 두 가지 최소 요청을 각각 한 번씩 실행해 볼 수 있어요. 네이티브와 호환 엔드포인트는 같은 Key를 공유하므로, 엔드포인트를 전환할 때는 Base URL과 요청 구조만 조정하면 됩니다.
Gemini 4 Neon 사고 단계, 어떻게 고를까
단계가 높을수록 추론이 더 충분히 이루어지지만, 그만큼 시간과 비용도 늘어나요. Artificial Analysis(AA)는 Intelligence Index v5.0.1에서 Neon의 네 단계를 각각 따로 테스트했고, 결과는 다음과 같아요.
| 사고 단계 | AA 지능 지수 | 작업당 평균 소요 시간 | 설명 |
|---|---|---|---|
low |
44 | 약 3.7분 | 속도 우선 |
medium |
55 | 약 8.3분 | low보다 11점 높음 |
high(기본값) |
60 | 약 14.8분 | medium보다 5점 높음 |
xhigh |
61 | 약 21.5분 | 가중 비용 약 $6.44/평가 작업 |
이 데이터를 보면 medium에서 high로 갈 때는 여전히 향상 폭이 뚜렷하지만, high에서 xhigh로는 지수 1점만 오르는 대신 작업당 평균 약 6.7분이 더 들어요. 이 수치는 AA의 평가 파이프라인에서 나온 것이고, 작업 비용은 아홉 개 테스트의 가중치로 계산했어요. 문서 읽기나 대화형 질의응답 같은 상황에서의 소요 시간과 청구 금액은 직접 측정해야 하고, APIYI의 엔드투엔드 지연, 성공률, 실제 청구서도 따로 측정해야 해요.
단계는 이렇게 정하면 돼요. 지연에 민감한 질의응답형 작업은 low나 medium에서 시작하고, 여러 단계를 거치는 추론이 필요할 때는 기본값인 high를 유지하세요. 내 고정 테스트 세트에서 xhigh가 의미 있는 향상을 준다는 걸 확인했을 때만, 그만큼의 시간과 비용을 더 투자하세요.
Gemini 4 Neon과 같은 포지션 모델 비교
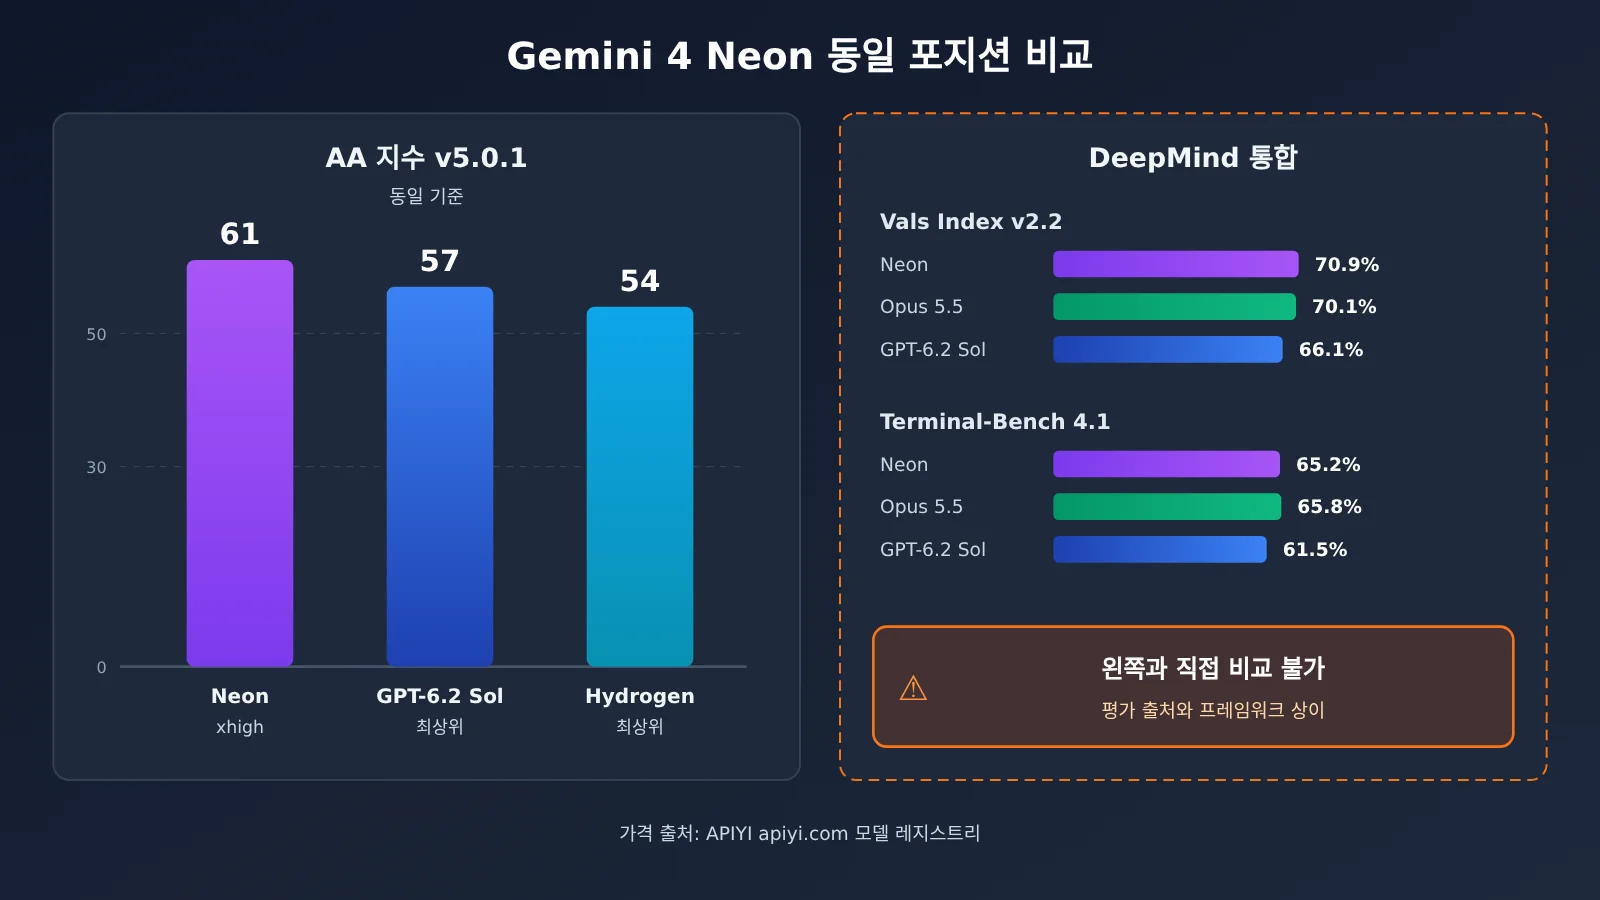
모델 간 비교는 가능하면 동일한 기준과 비교 가능한 설정을 사용해야 해요. 아래 표의 처음 두 열은 AA 동일 버전에서 가져왔고, 가격은 APIYI 레지스트리 기준이에요.
| 모델 | AA 지수 v5.0.1(최고 설정) | 표준 입력/출력(백만 Token당) | 사용 가능 플랫폼 |
|---|---|---|---|
| Gemini 4 Neon | 61(xhigh) | $3/$15 | APIYI apiyi.com 등 |
| GPT-6.2 Sol | 57 | $2/$10 | APIYI 등 |
| Gemini 4 Hydrogen | 54 | 레지스트리 기준 | APIYI 등 |
GPT-6.2 Sol은 표기 가격이 더 낮아서 입력과 출력 모두 Neon보다 3분의 1 정도 저렴해요. 하지만 AA 동일 기준에서 Neon xhigh의 점수는 Sol 최고 설정보다 4점 높아요. 점수 차이를 곧바로 비즈니스 정확도 차이로 환산할 수는 없다는 점에 주의해야 해요. 두 모델의 지연 시간과 실제 Token 소비량도 각각 측정해야 합니다.
또 다른 참고 자료는 Google DeepMind가 공개한 평가 집계예요. Vals Index v2.2에서 Neon은 70.9%, Claude Opus 5.5는 70.1%, GPT-6.2 Sol은 66.1%였고, Terminal-Bench 4.1 조정 후 정확도는 순서대로 65.2%, 65.8%, 61.5%였어요. 이 집계는 평가 출처와 실행 프레임워크가 분명히 다르며, Terminal-Bench에서는 Opus 5.5가 Neon보다 오히려 조금 높았어요. 방향성을 참고하는 용도로는 쓸 수 있지만, 모델 선택은 여러분의 도구 체인에서 같은 배치의 작업을 기준으로 해야 해요.
💡 선택 제안: 실제 비즈니스를 대표하는 고정 테스트 문항 20~50개를 준비하고, APIYI apiyi.com에서 동일한 Key로 Neon의 각 설정과 후보 모델을 차례로 호출한 뒤 정확도, 소요 시간, 청구서를 기록하고 나서 결정하는 걸 권장해요.
Gemini 4 Neon 자주 발생하는 연동 오류 점검
문제가 생기면 먼저 위에서 설명한 가장 짧은 요청으로 돌아가 비교해 보세요. 기본 연결 경로가 정상인지 확인한 다음, 새로 추가한 기능을 항목별로 점검하면 됩니다.
| 증상 | 우선 확인할 항목 | 해결 방향 |
|---|---|---|
| 404 / 모델 사용 불가 | 모델 ID, 토큰 그룹, 라우팅, 버전 접두사 | gemini-4-neon을 그대로 복사하세요. OpenAI SDK는 /v1이 포함된 호환 엔드포인트를 사용하고, GenAI SDK는 루트 주소에 v1beta를 붙여 사용하세요. 버전 접두사를 중복으로 이어 붙이지 마세요 |
| 400 / 레벨 전환 후 동작 불일치 | 네이티브 사고 파라미터, 호환 요청 본문 필드 | 네이티브 엔드포인트에서 thinkingLevel로 레벨이 실제로 적용되는지 확인하세요. thinkingBudget, minimal은 삭제하세요. 두 프로토콜의 필드를 섞어 쓰지 마세요 |
| 200이지만 본문이 비어 있음 | 종료 이유, 안전 상태, 출력 예산 | 출력 예산이 사고와 가시 출력을 동시에 담을 수 있는지 확인하세요. 안전 필터 정보를 확인하세요 |
| 도구 호출 2번째 라운드 실패 | thoughtSignature, 도구 호출과 응답의 짝 맞추기 |
사고 시그니처를 그대로 되돌려 보내고, 각 도구 응답이 올바른 호출에 대응하도록 하세요 |
| 429 / 업스트림 일시적 503 | 오류 본문, 토큰 한도, 동시성 제약 | 짧은 시간 동안 속도 제한이나 사용 불가가 발생하면 횟수를 제한하고 지터를 넣은 지수 백오프를 사용하세요. 잔액이나 권한 문제는 설정을 수정한 후 다시 요청하세요 |
Gemini 4 Neon: 404와 400의 구분
404는 보통 요청이 이 모델로 라우팅되지 않았다는 뜻이에요. 문제는 “찾을 수 없다”는 쪽에 있어요. ID를 잘못 적었거나, 토큰 그룹에 해당 모델이 없거나, URL이 /v1/v1/..., /v1beta/v1beta/...처럼 경로가 중복된 형태로 만들어진 경우죠. 400은 요청은 이미 도달했지만 요청 본문이 프로토콜에 맞지 않다는 뜻이에요. 가장 흔한 건 네이티브 필드를 호환 요청에 그대로 넣은 경우, 또는 Gemini 2.x 시절의 구 파라미터를 그대로 이어 쓴 경우예요.
엔드포인트를 넘나드는 파라미터 매핑은 따로 검증해야 해요. 호환 엔드포인트에서 사고 강도를 제어하려 했는데 기대한 효과가 나오지 않는다면, 먼저 네이티브 엔드포인트로 돌아가서 해당 단계 설정이 실제로 적용되는지 확인한 뒤, 파라미터 문제인지 매핑 문제인지 판단하세요.
Gemini 4 Neon: 빈 본문과 도구 호출 실패
HTTP 200인데 본문을 받지 못할 때는 먼저 종료 이유를 확인하세요. 길이 제한으로 잘린 경우라면 사고 과정이 이미 출력 예산을 차지해서 보이는 텍스트에 공간이 남지 않았다는 뜻이에요. 안전 사유라면 입력 내용을 조정해야 하죠. 사고 단계가 높을수록 첫 번째 상황이 더 자주 나타나요.
멀티턴 도구 호출이 실패하는 경우는 대부분 thoughtSignature와 관련이 있어요. Google의 Thought signatures 문서에 따르면, 모델이 반환한 서명은 이후 턴에서 원래 프로토콜에 따라 그대로 되돌려 보내야 하고, 각 도구 호출마다 일대일로 대응하는 도구 응답이 있어야 해요. 디버깅할 때는 우선 도구를 빼고 가장 짧은 무도구 요청으로 대조한 다음, 도구를 하나씩 다시 추가해 보세요.
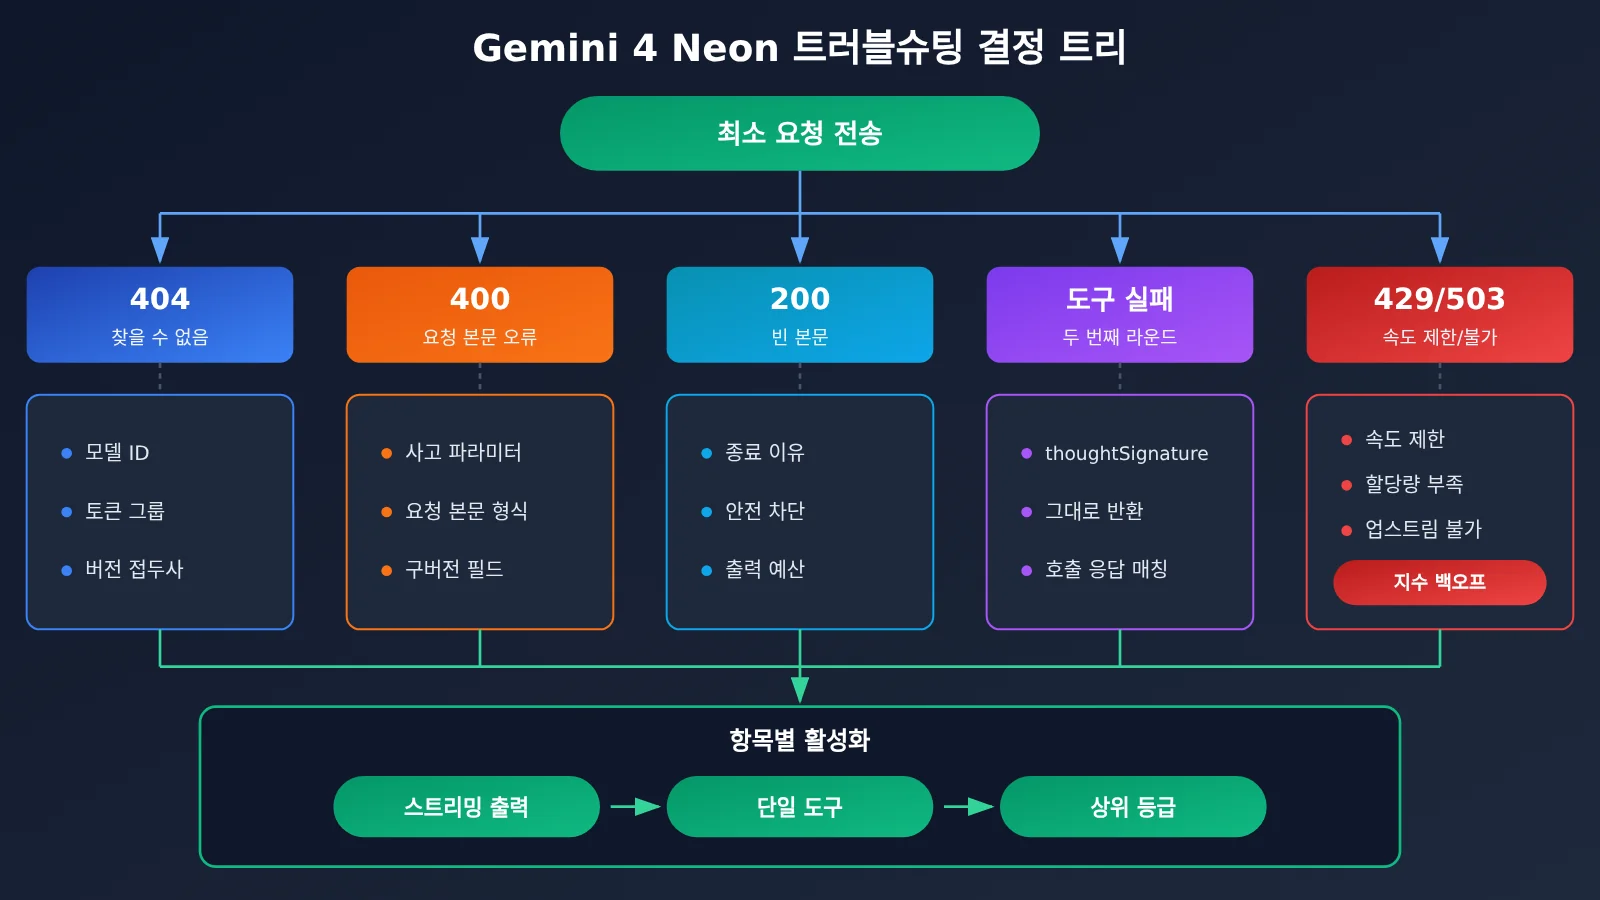
Gemini 4 Neon 권장 검증 순서
최소 요청이 성공한 뒤에는 아래 순서대로 기능을 하나씩 켜 나가면서, 각 단계마다 결과를 따로 확인해 보는 것을 권장합니다.
- 비스트리밍, 도구 없음, 기본 등급의 순수 텍스트 요청으로 ID, 그룹, 라우팅이 정상인지 확인합니다.
- 스트리밍 출력을 켜고, 청크 병합과 종료 이유 읽기가 올바른지 확인합니다.
- 도구 하나를 추가해 “호출 → 결과 반환 → 최종 답변”의 전체 두 라운드를 돌려 보고,
thoughtSignature가 유지되는지 점검합니다. - 네이티브 엔드포인트에서
low/medium/xhigh를 전환하면서 고정 테스트 세트로 효과, 소요 시간, 과금을 비교합니다. - 마지막으로 긴 입력, 캐시 재사용 등 비용과 관련된 최적화를 추가합니다.
자주 묻는 질문 FAQ
Q1: Gemini 4 Neon이란 무엇인가요?
Gemini 4 Neon은 Google이 2026년 11월 18일 출시와 동시에 GA를 진행한 Gemini 4 중간 등급 모델로, Carbon과 Hydrogen 사이에 위치합니다. 1M 공유 컨텍스트와 네 단계의 사고 강도를 제공하며, 모델 ID는 `gemini-4-neon`입니다.
Q2: Gemini 4 Neon과 GPT-6.2 Sol, 어떻게 선택해야 하나요?
AA Intelligence Index v5.0.1 동일 기준에서 Neon `xhigh`는 61점, Sol 최고 등급은 57점입니다. 다만 Sol의 정가는 $2/$10으로 Neon의 $3/$15보다 낮습니다. 점수 차이가 곧 비즈니스 정확도 차이는 아니므로, 자체 테스트 세트에서 효과, 지연 시간, 실제 Token 소비를 비교한 뒤 결정하는 것이 좋습니다.
Q3: Gemini 4 Neon은 언제 APIYI에서 사용할 수 있나요?
APIYI는 2026년 11월 20일에 이 모델을 출시했고, `default`와 `svip` 두 그룹을 오픈했습니다. 출시 공지에 따르면 표준 가격은 만료일이 없습니다.
Q4: Gemini 4 Neon은 어떤 시나리오에 적합한가요?
– **장문 문서 분석**: 1M 윈도우로 대량의 자료를 한 번에 넣을 수 있지만, 단일 동기 출력 상한은 약 64K입니다.
– **다단계 추론과 Agent 작업**: 기본 `high` 등급이 효과와 소요 시간을 모두 고려하며, 도구 호출은 네이티브 엔드포인트를 사용하는 것을 권장합니다.
– **비용을 제어할 수 있는 배치 처리**: `low`/`medium`에 캐시 재사용을 더해 1회 비용을 낮춥니다.
Q5: API를 통해 Gemini 4 Neon을 빠르게 호출하는 방법은?
1. APIYI apiyi.com에서 가입하고 무료 테스트 크레딧을 받습니다.
2. `default` 또는 `svip` 그룹에 속한 토큰을 생성합니다.
3. 기존 OpenAI 코드는 호환 엔드포인트를 사용하고, 사고 등급 제어가 필요하면 Google GenAI SDK로 네이티브 엔드포인트에 연결합니다.
두 경로 모두 먼저 이 글의 최소 요청을 실행해 연결이 정상인지 확인한 뒤 기능을 추가하는 것을 권장합니다.
Q6: Gemini 4 Neon에 알려진 제한 사항은 무엇인가요?
– **출력 상한**: 1M은 공유 윈도우이며, 동기 생성 상한은 약 64K입니다. 긴 디코딩은 특정 클라우드 인터페이스와 이어받기 조건에 의존합니다.
– **매개변수 변화**: `thinkingBudget`, `minimal`은 더 이상 적용되지 않으며, `temperature`, `topP`는 무시됩니다.
– **검증 상태**: APIYI 출시 전에는 가격 인터페이스만 확인했으며, 두 엔드포인트와 도구 호출은 APIYI apiyi.com에서 자체 요청으로 먼저 검증해 보는 것을 권장합니다.
Gemini 4 Neon 핵심 요약(Key Takeaways)
- 모델 정체성:
gemini-4-neon, Gemini 4의 중간 등급으로 Google이 11월 18일 출시했어요. - 사양 경계: 1M 공유 컨텍스트, 동기 생성 상한은 약 64K이며 긴 디코딩은 별도 검증이 필요해요.
- 과금 표기가: 백만 Token당 입력 $3, 출력 $15, 캐시 읽기 $0.15이며 실제 청구서를 기준으로 삼아야 해요.
- 등급 선택: AA 테스트에서
high→xhigh는 1점 더 높을 뿐, 작업당 소요 시간은 약 6.7분 더 길어요. - 엔드포인트 선택: 사고 등급을 제어하려면 네이티브 엔드포인트를, 기존 코드를 재사용하려면 호환 엔드포인트를 사용해요.
- 문제 해결 순서: 최소 요청에서 시작해 스트리밍, 도구, 더 높은 등급 순으로 하나씩 켜 나가요.
요약
Gemini 4 Neon 연동의 핵심은 세 가지로 정리할 수 있어요:
- 먼저 사양 확인: 1M은 공유 윈도우, 동기 출력은 약 64K, 표기가 $3/$15, 캐시 읽기 $0.15예요.
- 두 엔드포인트를 각각 한 번씩 실행: 네이티브 엔드포인트는 루트 주소에
v1beta를 붙이고, 호환 엔드포인트는/v1이 포함된 주소를 사용해요. 필드는 혼용하지 마세요. - 데이터로 등급 선택: AA 점수는 참고일 뿐, 최종적으로는 자신의 고정 테스트 세트에서의 효과, 소요 시간, 청구서를 기준으로 판단해야 해요.
연동 방식을 확인한 뒤에는 APIYI apiyi.com에서 동일한 Key로 Neon 각 등급과 다른 후보 모델을 비교해 보는 것을 권장해요. 그다음 프로덕션 환경의 기본 설정을 결정하세요.
📚 참고 자료
-
APIYI Gemini 4 Neon 출시 소식: 그룹, 엔드포인트, 가격과 출력 상한
- 링크:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - 설명: 2026-11-20 발표. 4단계 사고(thinking)와 기본 단계 정보를 포함해요.
- 링크:
-
Google Gemini 4 Neon 발표 공지: 공식 발표 정보
- 링크:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - 설명: 2026-11-18 발표. 컨텍스트와 포지셔닝 설명을 포함해요.
- 링크:
-
Artificial Analysis Gemini 4 Neon 모델 페이지: 네 단계별 독립 평가
- 링크:
artificialanalysis.ai/models/gemini-4-neon - 설명: Intelligence Index v5.0.1 점수와 소요 시간을 제공하며, 지표는 동적으로 업데이트돼요.
- 링크:
-
Google Gemini API 트러블슈팅과 Thought signatures: 문제 해결 및 사고 서명 문서
- 링크:
aistudio.google.com/docs/troubleshooting,aistudio.google.com/docs/thought-signatures - 설명: 오류 코드의 의미와 멀티턴 도구 호출 시 서명을 다시 전달하는 규칙을 다뤄요.
- 링크:
-
Gemini 4 Neon Model Evaluation: DeepMind 평가 요약
- 링크:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - 설명: 여러 출처와 프레임워크의 평가 결과를 담고 있으며, 인용할 때 설정을 명시해야 해요.
- 링크:
작성자: APIYI 기술팀
기술 교류: 연동 과정에서 문제가 발생하면 APIYI 공식 웹사이트를 통해 문의해 주세요. 더 많은 API 설명은 docs.apiyi.com 문서 센터에서 확인할 수 있어요.