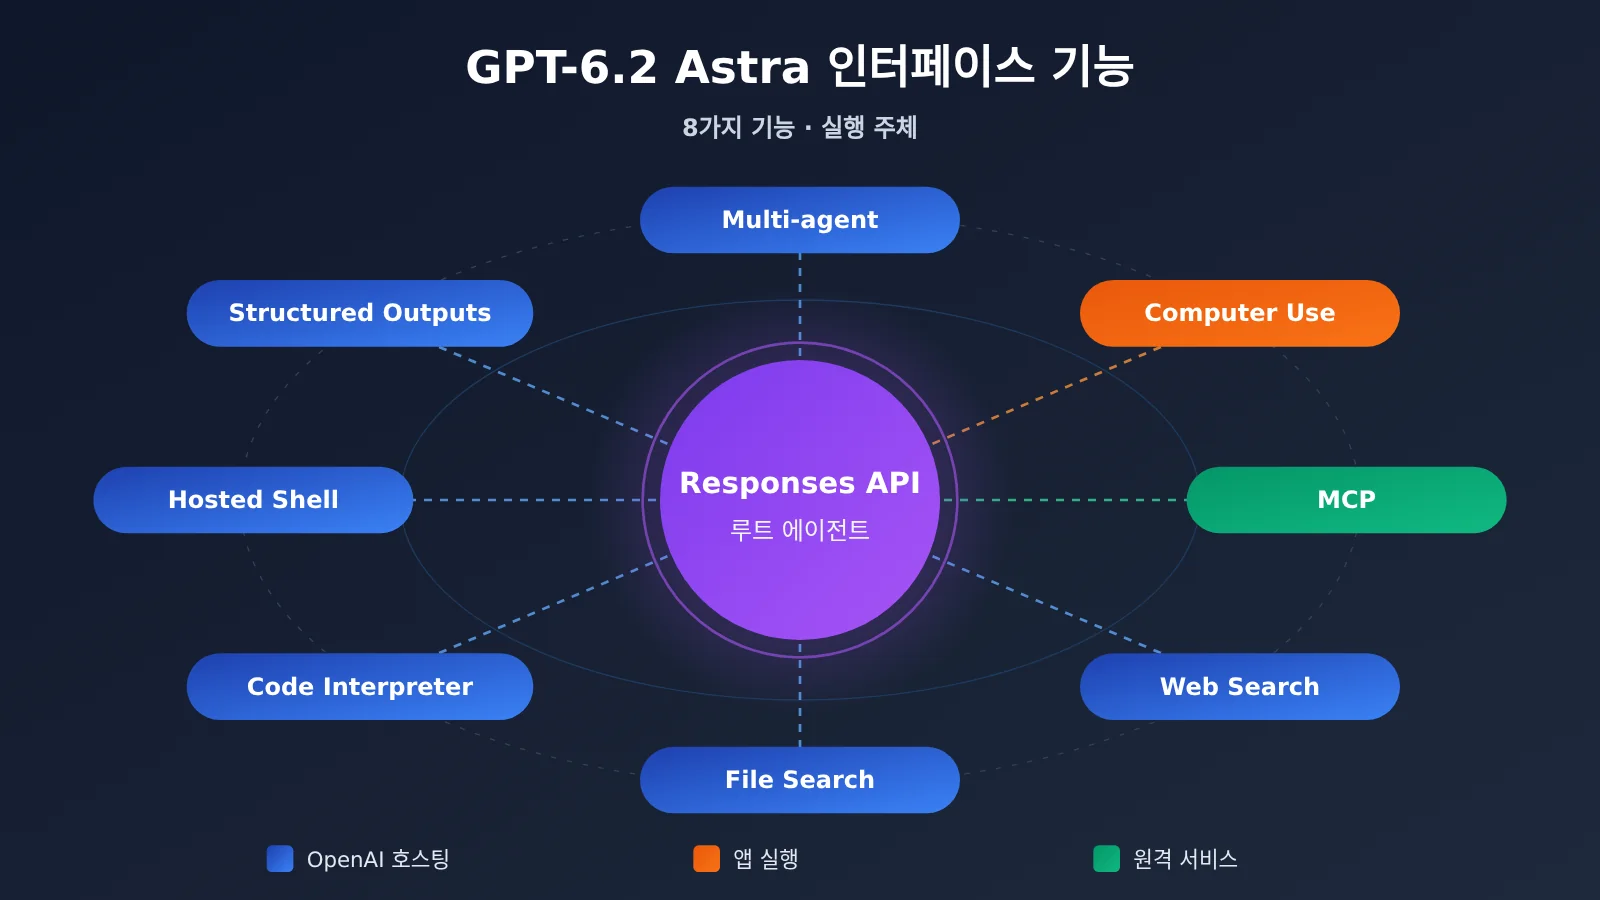
직접 답변: GPT-6.2 Astra는 Responses API에서 하위 작업을 병렬로 위임할 수 있고(Multi-agent), 스크린샷을 활용해 브라우저나 데스크톱 UI를 조작할 수 있으며(Computer Use), 원격 MCP 서비스에 연결해 팀의 업무 도구를 호출할 수도 있습니다. 다만 이 세 가지 기능은 실행 주체가 각기 다릅니다. 위임은 API가 호스팅하고, UI 조작의 실행 환경은 여러분의 애플리케이션이 제공하며, MCP 호출의 대상은 여러분이 구성한 원격 서비스입니다.
핵심 결론: 엔지니어링에서 어려운 점은 모델 자체의 능력보다 오케스트레이션에 있습니다. 실제로 현업에 적용할 수 있는 비즈니스 에이전트는 다음 세 가지를 미리 분명히 해야 합니다. 각 도구를 누가 실행하는지, 데이터 권한을 어디까지 부여하는지, 최종 결과를 누가 검증하는지입니다.
이 글을 읽고 나면 무엇을 알 수 있나요?
- GPT-6.2 Astra가 Responses API에서 지원하는 6가지 유형의 내장 도구와 Structured Outputs, 그리고 각 항목의 실행 주체와 사용 전제 조건
- Multi-agent 베타의 활성화 방법과 기본 동시 실행 수, 그리고 어떤 작업이 병렬 처리에 적합하고 어떤 작업이 반드시 순차 실행되어야 하는지
- Computer Use와 원격 MCP 두 실행 경로의 차이. 여기에는 승인, 권한 범위, 책임 분담이 포함됩니다.
- 검색, 계산, 구조화 출력을 어떻게 연결해 검증 가능한 조달 검증 결과물을 내놓는지
글의 흐름: 본문에서는 먼저 OpenAI가 11월 17일 공개한 모델 식별 정보, 사양, 가격을 정리합니다. 이어서 8가지 기능의 실행 주체를 한 표로 비교한 뒤, ‘읽기 전용 조달 검증’이라는 설계 예시를 따라 Multi-agent의 병렬 경계, Computer Use와 MCP의 실행 경로, 검색에서 구조화 출력으로 이어지는 인계 방식을 차례로 설명합니다. 글 마지막 분석 파트에서는 개발자와 제품 책임자가 지금 먼저 무엇을 해야 하는지 답합니다.
GPT-6.2 Astra 알아보기: 개념 설명
| 개념 | 간단 설명 |
|---|---|
| Responses API | OpenAI가 모델 응답과 도구 호출에 사용하는 인터페이스이며, 이 글에서 다루는 내장 도구와 Multi-agent는 모두 이 API를 기준으로 해요 |
| Multi-agent | 지원되는 Responses 요청 한 번에서 여러 협업 에이전트를 활성화하는 베타 기능 |
| 서브 에이전트 | 독립된 컨텍스트에서 위임된 작업을 처리하고, 완료되면 루트 에이전트에 보고하는 작업 단위 |
| Computer Use | 모델이 스크린샷을 바탕으로 UI 요소를 찾고 브라우저 또는 데스크톱 작업 실행을 요청하는 기능 |
| MCP | 모델 클라이언트가 외부 서비스 도구를 발견하고 호출하는 방식을 규정한 프로토콜 |
| Web Search | 공개 인터넷에서 자료를 검색하고 응답에 출처 표시를 반환할 수 있는 도구 |
| File Search | 지정된 벡터 저장소에서 업로드된 파일을 검색하는 도구 |
| Code Interpreter | Python을 실행해 데이터를 분석하고 파일을 생성하는 호스팅 샌드박스 |
| Hosted Shell | OpenAI가 호스팅하며 터미널 명령을 실행할 수 있는 격리 환경 |
| Structured Outputs | JSON Schema로 응답 형식을 제한하는 출력 기능 |
| 도구 호출 ID | 특정 호출 요청과 그 실행 결과를 연결하는 식별자(예: call_id) |
GPT-6.2 Astra 영향 한눈에 보기
- 비즈니스 에이전트 엔지니어: 한 번의 요청에서 위임, 검색, 원격 도구, 구조화된 출력을 조합할 수 있어 오케스트레이션 코드가 줄어들어요. 하지만 함수 결과 반환, Computer Use 실행 환경, MCP 승인 같은 부분은 여전히 애플리케이션 측에서 구현해야 해요.
- 제품 책임자: “에이전트가 스스로 운영 체제를 조작할 수 있다”는 점이 공식 인터페이스로 뒷받침돼요. 권한 범위, 쓰기 확인, 사람의 검토 책임은 제품 설계 단계부터 프로세스에 포함해야 해요.
- 비용에 민감한 팀: 공식 단가가 이전 세대보다 인하됐어요. 하지만 Multi-agent 병렬 처리는 토큰 사용량을 늘릴 수 있으니, 예산은 작업 구조에 맞춰 다시 산정해야 해요.
GPT-6.2 Astra 객관적 사실: 출시, 사양 및 도구 목록
GPT-6.2 Astra의 출시와 모델 정체성
OpenAI는 2026년 11월 17일 GPT-6.2 Astra와 GPT-6.2 Sol을 동시에 출시했어요. 공식적으로 Astra는 복잡한 추론, 코딩, 전문 작업을 위한 모델로 포지셔닝되었고, API 모델 ID는 gpt-6.2-astra이며, 전 세대는 GPT-6 Astra(gpt-6-astra)예요. API 변경 로그에는 같은 날짜에 모델 출시와 백그라운드 완료 윈도우 관련 항목이 기록되었어요.
모델 카드에 나열된 사양은 다음과 같아요. 컨텍스트 1,050,000 token, 최대 입력 922,000 token, 최대 출력 128,000 token. 모델은 텍스트와 이미지 입력을 받고 텍스트를 출력하며, Responses API와 Chat Completions API를 모두 지원해요. 특히 주의할 점은 모델 카드에 reasoning.effort를 none으로 설정한 요청은 거부된다고 명시되어 있으니, 기존 코드를 마이그레이션할 때 이 파라미터를 꼭 확인해야 해요.
가격 측면에서 OpenAI가 공시한 표준 단문맥 순수 텍스트 단가는 백만 token당: 일반 입력 $8, 캐시 적중 입력 $0.40, 출력 $40이에요. 전 세대와 비교하면 공식 발표 기준 일반 입력과 출력 단가가 20% 인하되고, 캐시 적중 입력 단가가 60% 인하되었어요. 이 수치들은 공식 직결 API의 추정치에만 적용되며, 서드파티 평가에서 사용하는 문항당 비용은 다른 가격 기준을 사용하기 때문에 직접 비교할 수 없어요.
🚀 빠른 시작: GPT-6.2 Astra가 자신의 업무 데이터에서 어떤 성능을 보이는지 먼저 검증하고 싶다면, APIYI apiyi.com을 통해 하나의 API 키로 OpenAI 호환 호출을 시작할 수 있어요. 신규 사용자에게는 무료 테스트 크레딧이 제공되어 정식 연동 전 소규모 검증에 적합해요. beta 도구의 사용 가능 범위는 플랫폼의 실제 지원 여부를 기준으로 해요.
GPT-6.2 Astra 인터페이스 기능 총표
모델 카드에서는 Web Search, File Search, Code Interpreter, Hosted Shell, Computer Use, MCP를 Responses API에서 Astra가 지원하는 도구로 정리하고 있어요. Structured Outputs는 출력 기능으로, Multi-agent는 Responses의 베타 기능으로 분류됩니다. 개발자가 요청에 사용할 도구를 선언하면, 모델이 작업에 따라 호출을 시작할지 스스로 판단해요. 응답에는 도구 요청, 승인 요청, 실행 결과 또는 최종 텍스트가 담길 수 있고, 클라이언트가 어떤 출력 항목을 처리해야 하는지는 각 도구의 실행 주체에 따라 달라집니다.
| 기능 | 실행 주체 | 전제 / 설정 | 적합한 작업 |
|---|---|---|---|
| Multi-agent | Responses 호스팅 위임 | 베타 기능을 명시적으로 활성화 | 독립적인 하위 작업을 병렬로 처리하고 결과를 모아 요약 |
| Computer Use | 애플리케이션이 제공하는 브라우저 또는 데스크톱 | 앱이 환경과 로그인 상태를 관리 | 상호작용이 필요한 화면을 조회하거나 조작 |
| MCP | OpenAI가 사용자가 설정한 원격 서비스를 호출 | 서비스 주소, 인증, allowed_tools | 업무 시스템을 조회하거나 쓰기를 요청 |
| Web Search | OpenAI 호스팅 | 도구를 선언하면 사용 가능 | 공개되어 있고 변화가 빠른 자료를 조회 |
| File Search | OpenAI 호스팅 | 미리 업로드해 벡터 저장소에 인덱싱 | 내부 문서를 의미와 키워드로 검색 |
| Code Interpreter | OpenAI가 관리하는 Python 컨테이너 | 파일 입력과 회수 관리 | 대사 확인, 통계, 차트 생성 |
| Hosted Shell | OpenAI가 관리하는 터미널 컨테이너 | container_auto로 설정 가능 | 여러 단계의 명령줄 작업과 다중 파일 처리 |
| Structured Outputs | 응답 형식 제약 | text.format에 JSON Schema를 선언 | 검증 가능한 업무 데이터 산출 |
GPT-6.2 Astra 멀티 에이전트의 활성화 방식과 공유 범위
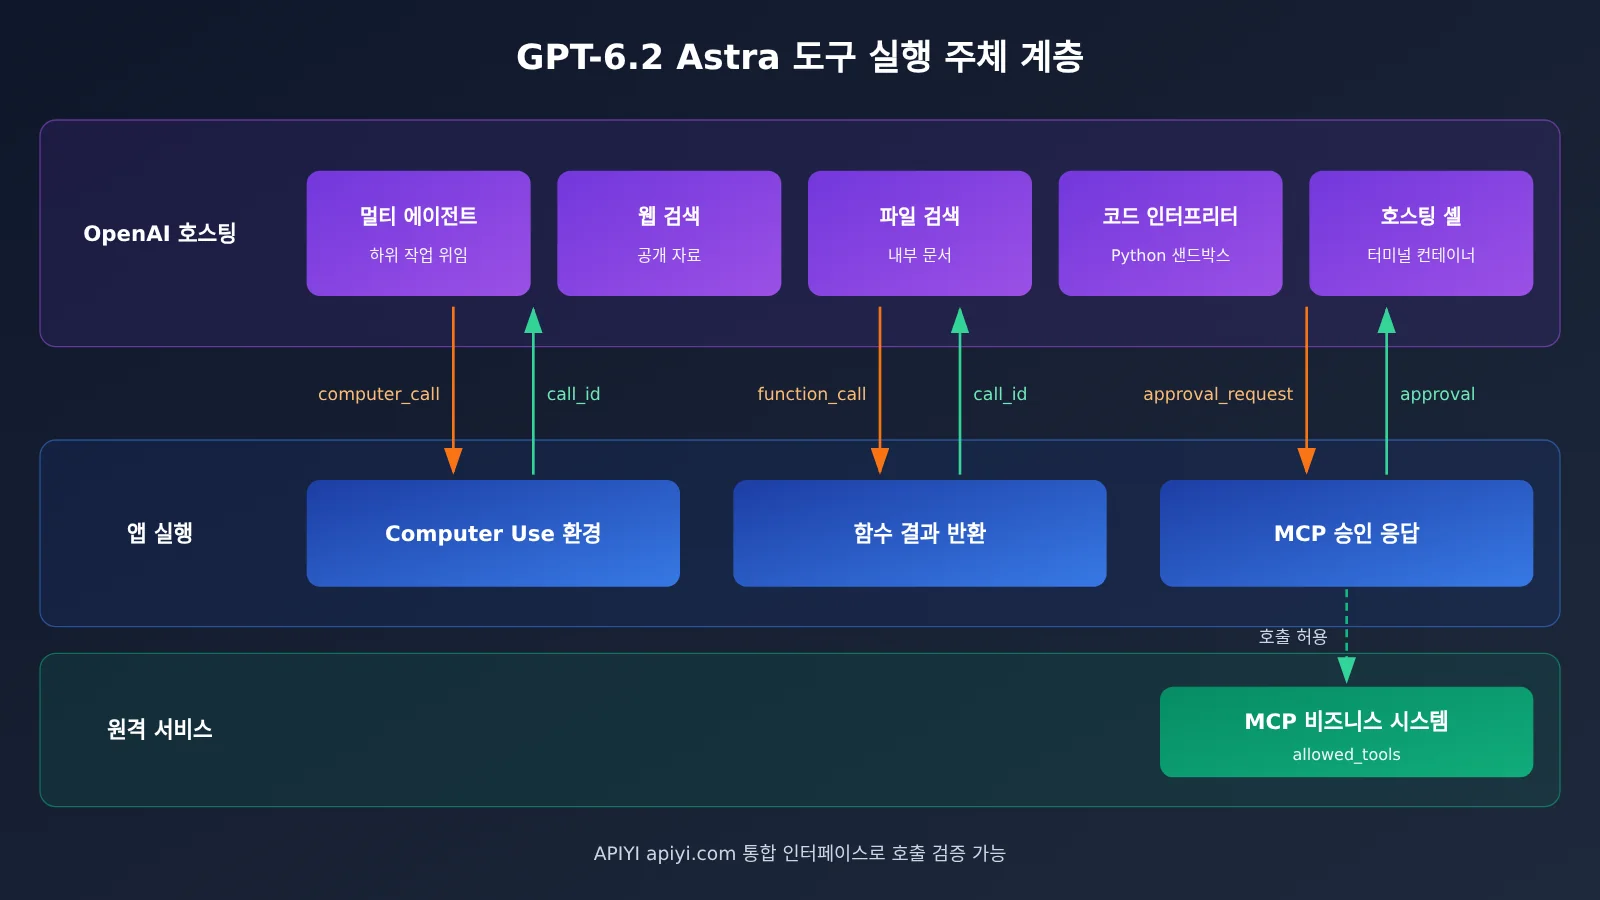
멀티 에이전트를 활성화하려면 Responses 요청에 multi_agent.enabled를 설정해야 해요. HTTP나 WebSocket을 직접 사용한다면 요청 헤더 OpenAI-Beta: responses_multi_agent=v1도 함께 보내야 하고, SDK를 쓴다면 해당 베타 인터페이스를 호출하면 됩니다. 루트 에이전트는 하위 에이전트를 만들고, 이들과 소통하고, 완료될 때까지 기다린 뒤 최종 결과를 종합하는 역할을 맡아요.
각 하위 에이전트는 자체 컨텍스트를 갖지만, 해당 요청의 모델과 사용 가능한 도구는 공유해요. max_concurrent_subagents의 기본값은 3이고, 이 값은 전체 에이전트 트리에서 동시에 활성 상태인 하위 에이전트 턴 수를 제한해요. 위임 동작 multi_agent_call은 API가 호스팅합니다. 하위 에이전트가 개발자가 정의한 함수를 호출하면, 애플리케이션은 해당 호출 ID에 맞춰 실행 결과를 반환해야 해요. 공식 문서에서는 병렬 처리가 서로 독립적인 조사 작업에 적합하지만 토큰 사용량이 늘어날 수 있다고 알려요. 선행 결과에 의존하는 단계와 공유 쓰기 작업은 실행 순서를 직접 정해야 합니다.
GPT-6.2 Astra Computer Use와 MCP의 실행 경계
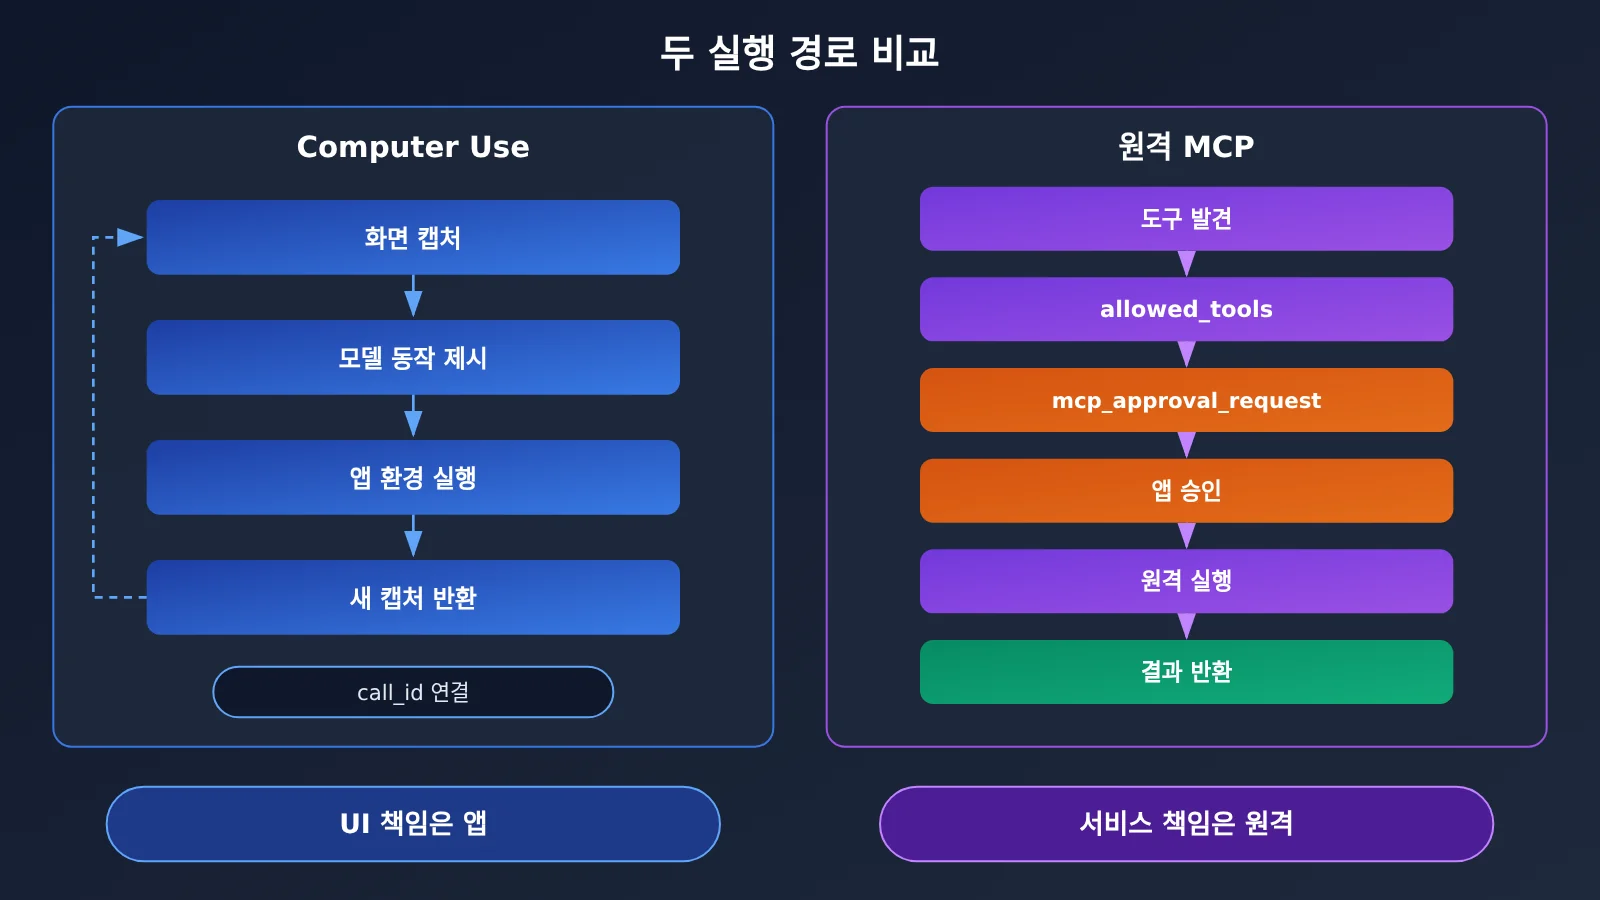
Computer Use의 실행 환경은 애플리케이션이 제공해요. 네이티브 computer 도구를 사용할 때 모델은 computer_call을 보내고, 여러분의 실행 환경이 그 안의 클릭, 입력 등의 동작을 수행한 뒤 새로운 화면 캡처를 computer_call_output과 해당 call_id로 모델에 돌려주는 식으로 작업이 끝날 때까지 반복해요. 공식 가이드에는 또 다른 연결 방식도 있어요. 모델이 스크립트를 생성하면 애플리케이션이 격리된 환경에서 실행하는 방식이죠. 어떤 방식을 택하든 환경 자체, 로그인 상태, 접근 가능한 페이지, 그리고 중요한 쓰기 전 확인은 모두 애플리케이션의 책임이에요.
원격 MCP는 실행 방식이 달라요. API가 여러분이 지정한 서비스 주소에 연결하고, 서버가 노출한 도구를 가져와 허용된 호출을 실행해요. 원격 인증은 서비스 요구 사항에 맞춰 구성하고, allowed_tools로 가져올 도구를 제한할 수 있어요. 기본적으로 커넥터나 원격 서비스로 데이터를 보내기 전에 먼저 승인을 요청해요. 애플리케이션은 mcp_approval_request에 담긴 도구 이름과 파라미터를 읽은 뒤 mcp_approval_response를 건별로 돌려보낼 수 있습니다.
GPT-6.2 Astra 검색, 계산 및 구조화 출력의 규칙
Web Search는 공개 인터넷을 대상으로 하며, 애플리케이션은 url_citation을 활용해 결론과 출처를 연결할 수 있어요. File Search는 지정된 벡터 저장소에서 업로드된 파일을 검색하며, 이미 아카이브된 내부 자료에 적합해요. Code Interpreter는 Python 샌드박스를 제공하고 파일을 생성할 수 있어요. Hosted Shell은 container_auto를 통해 클라우드 터미널을 구성할 수 있고, Shell 가이드에서는 애플리케이션이 런타임을 자체 호스팅하는 방식도 소개해요. 두 컴퓨팅 환경의 파일은 모두 사용 시점에 적극적으로 관리하고 가져와야 해요.
Structured Outputs는 text.format으로 JSON Schema를 선언하며, 완료되었고 거부되지 않은 응답을 제약해요. 공식 문서에서는 수신 측이 여전히 거부, 미완료, API 오류, 그리고 스키마로 표현할 수 없는 비즈니스 규칙을 처리해야 한다고 분명히 밝히고 있어요.
GPT-6.2 Astra 분석 판단: 한 번의 구매 검증으로 모든 기능 연결하기
다음 흐름은 설계 예시로, 참고 자료의 기능 조합에서 도출한 것이며 공식 사례는 아니에요. 요청마다 상황에 맞게 도구를 구성해야 하고, 최종적으로 어떤 조합을 활성화할 수 있는지는 계정, 도구 설정, 실행 환경에 따라 달라져요.
GPT-6.2 Astra 멀티 에이전트, 언제 병렬 실행이 적합할까
작업 목표는 계약서에 명시된 약정 내용, 조달 시스템의 주문 기록, 공급업체 공식 사이트의 공개 정보, 이 세 가지가 서로 일치하는지 확인하는 것이며, 전 과정은 읽기 전용이에요. 이 세 쿼리 사이에는 의존 관계가 없어서 기본 동시 실행 수인 3과 정확히 맞아떨어져요. 계약 그룹은 File Search로 조항을 조회하고, 조달 그룹은 읽기 전용 MCP로 주문을 조회하며, 웹 그룹은 Web Search로 공개 정보를 조회해요. 루트 에이전트는 세 그룹이 모두 보고한 뒤에 병합 작업을 진행해요.
병렬 실행 가능 여부는 한 가지 기준으로 판단할 수 있어요. 바로 서브 태스크의 입력에 다른 서브 태스크의 출력이 필요한가예요. 예를 들어 “먼저 주문 번호를 받고, 그 주문 번호로 인보이스를 조회한다” 같은 경우는 반드시 순차 실행해야 해요. 억지로 병렬로 나누면 서브 에이전트들이 각자 추측만 하게 되어 결과를 대조하기가 더 어려워져요. 또 주의할 점이 있어요. 위임 동작은 API가 호스팅하지만, 서브 에이전트가 여러분이 정의한 함수를 호출했다면 함수 결과는 여전히 애플리케이션이 호출 ID를 기준으로 되돌려 보내야 해요. 이 단계를 빠뜨리면 에이전트 트리 전체가 대기 상태에 멈춰버려요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

# 예시 코드: 파라미터 구조는 OpenAI 최신 가이드를 기준으로 하세요
resp = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "medium"},  # none으로 설정하면 거부됩니다
    input="只读核验:合同 C-102 条款、订单 PO-881 记录、供应商官网公示信息是否一致",
    tools=[
        {"type": "file_search", "vector_store_ids": ["vs_contracts"]},
        {"type": "web_search"},
        {
            "type": "mcp",
            "server_label": "procurement",
            "server_url": "https://mcp.example.com/procurement",
            "allowed_tools": ["get_purchase_order"],  # 읽기 전용 도구 하나만 개방
            "require_approval": "always",
        },
    ],
    extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
    extra_body={"multi_agent": {"enabled": True, "max_concurrent_subagents": 3}},
)
💡 선택 제안: 병렬 위임은 토큰 소모를 늘려요. 먼저 작은 샘플로 1회 검증의 실제 사용량을 측정한 뒤 동시 실행 수를 결정하는 걸 권장해요. APIYI apiyi.com에서 종량제로 호출하면 여러 동시 실행 설정 간의 비용을 빠르게 비교할 수 있어요.
GPT-6.2 Astra Computer Use와 MCP의 역할 구분 기준
공급업체官网의 자격 유효 기간이 특정 “자격 인증서” 팝업을 열어야만 표시되고 Web Search로는 이 필드를 수집할 수 없다고 가정해 봐요. 이럴 때 Computer Use가 필요하죠. 흐름은 세 단계예요. 애플리케이션이 격리된 브라우저에서 페이지를 열고 스크린샷을 찍습니다. 그다음 모델이 클릭 좌표나 조작 지시를 반환해요. 애플리케이션이 이를 실행한 뒤 새 스크린샷과 call_id를 모델에 되돌려 보냅니다. 로그인 상태와 접근 범위가 모두 애플리케이션에 달려 있으므로, 읽기 전용 작업은 환경 차원에서 폼 제출을 원천 금지하는 게 좋아요. 프롬프트 제약에만 의존하지 마세요.
주문 조회는 MCP로 처리해요. 도구 발견 단계에서는 allowed_tools를 통해 get_purchase_order라는 읽기 전용 도구 하나만 가져옵니다. 인증은 최소 권한의 읽기 전용 자격 증명을 사용해요. 호출할 때마다 애플리케이션이 mcp_approval_request의 파라미터를 읽어 주문 번호가 이번 검증 범위에 있는지 확인한 뒤 승인을 반환하죠. 두 경로의 책임은 이렇게 나눌 수 있어요. 화면에서 무엇이 일어났는지는 애플리케이션이, 원격 시스템이 무엇을 반환했는지는 서비스 제공자가, 모델은 그저 요청을 제안할 뿐이에요.
| 차원 | Computer Use | 원격 생성 MCP |
|---|---|---|
| 실행 환경 | 애플리케이션이 제공하는 브라우저 / 바탕화면 | 당신이 구성한 원격 서비스 |
| 연결 식별자 | computer_call과 call_id | mcp_approval_request / response |
| 권한 통제 지점 | 환경 격리, 로그인 상태, 페이지 화이트리스트 | 서비스 인증, allowed_tools, 호출별 승인 |
| 적합한 필드 | 상호작용이 있어야 표시되는 공개 정보 | 업무 시스템의 구조화된 기록 |
| 주요 리스크 | 오클릭, 페이지 개편 | 권한 초과 호출, 파라미터 범위 초과 |
GPT-6.2 Astra, 자료 수집에서 쓸 수 있는 출력까지
검색 도구는 문서가 어디에 있는지에 따라 골라요. 공개되어 있고 자주 바뀌는 정보는 Web Search를 쓰고 url_citation을 남겨두세요. 이미 아카이브된 계약서라면 File Search를 사용해요. 컴퓨팅 환경은 작업 형태로 정해요. 금액 대조나 집계 같은 작업은 Code Interpreter의 Python 샌드박스로 충분해요. 여러 파일을 한꺼번에 압축 해제하거나 변환해야 하고, CLI 도구를 이어 붙여야 할 때는 Hosted Shell을 고려하세요. 그리고 흐름 안에 파일을 다시 가져오는 단계도 꼭 넣어두는 걸 잊지 마세요.
루트 에이전트가 병합을 마친 뒤에는, 애플리케이션이 보내는 후속 Responses 요청에서 구조화된 결과를 따로 생성하는 걸 권장해요. 검색과 같은 요청에 섞지 마세요. 이렇게 하면 schema가 더 단순해지고, 실패했을 때 재시도하기도 쉬워요.
승인 응답과 구조화 출력 예시 코드 보기
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

ALLOWED_PO = {"PO-881"}

def handle_approvals(resp):
    """MCP 호출을 건별로 승인 처리: 이번 검증 범위의 주문 번호만 통과시킴"""
    replies = []
    for item in resp.output:
        if item.type == "mcp_approval_request":
            ok = item.name == "get_purchase_order" and \
                 item.arguments and any(po in item.arguments for po in ALLOWED_PO)
            replies.append({
                "type": "mcp_approval_response",
                "approval_request_id": item.id,
                "approve": bool(ok),
            })
    return replies

schema = {
    "type": "object",
    "properties": {
        "records": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "record_id": {"type": "string"},
                    "evidence": {"type": "array", "items": {"type": "string"}},
                    "status": {"type": "string",
                               "enum": ["match", "mismatch", "needs_review"]},
                },
                "required": ["record_id", "evidence", "status"],
                "additionalProperties": False,
            },
        }
    },
    "required": ["records"],
    "additionalProperties": False,
}

def to_structured(prev_id):
    final = client.responses.create(
        model="gpt-6.2-astra",
        previous_response_id=prev_id,
        input="把核验结论整理为结构化记录,evidence 只写可追溯来源",
        text={"format": {"type": "json_schema", "name": "procurement_check",
                         "schema": schema, "strict": True}},
    )
    if final.status != "completed":
        raise RuntimeError(f"未完成:{final.status}")  # 거부되거나 미완료면 별도 처리 필요
    return final.output_text
형식 제약은 첫 번째 방어선일 뿐이고, 필드 로직은 프로그램과 사람이 함께 확인해야 해요. 아래는 출력 예시와 각 필드의 검증 책임이에요.
| 필드 | 예시 값 | 형식 보장 | 추가로 확인할 내용 | 책임 주체 |
|---|---|---|---|---|
| record_id | PO-881 | schema에서 문자열로 제한 | 구매 시스템에 실제로 존재하는지 | 프로그램 재조회 |
| evidence | 계약서 제5.2조, 공식 사이트 자격 페이지 | 반드시 배열 | 출처를 열 수 있는지, 인용이 맞는지 | 프로그램 + 표본 검사 |
| status | mismatch | 열거형 값만 허용 | 판정이 업무 기준에 맞는지 | 사람 검토 |
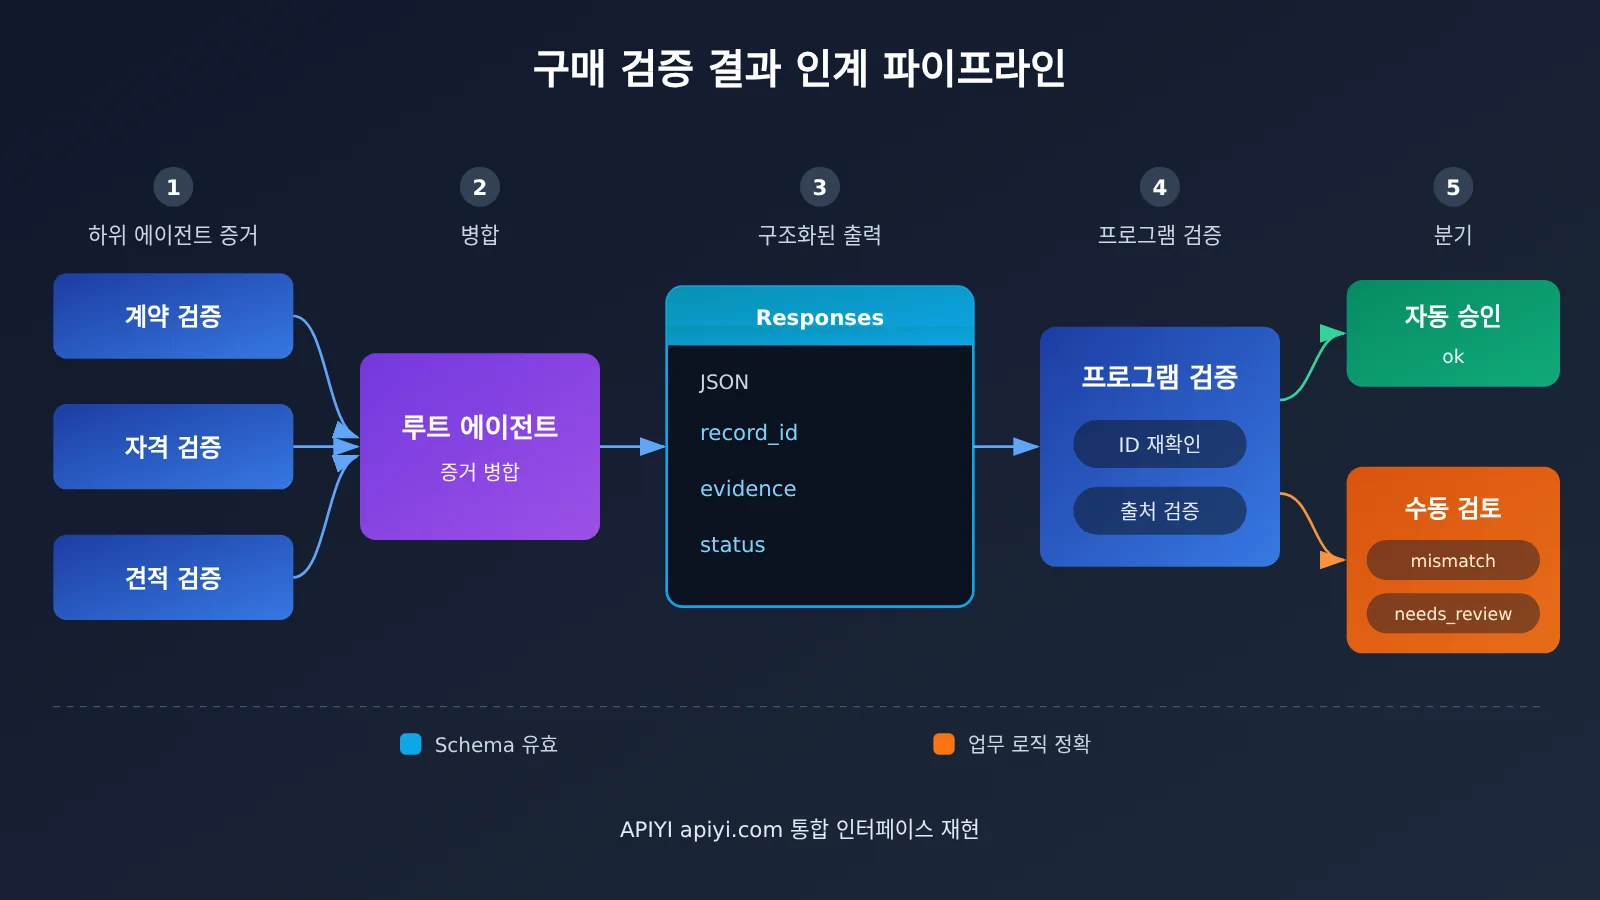
🎯 기술 제안: “schema가 유효한지”와 “업무적으로 맞는지”를 두 개의 독립적인 검사 단계로 나누고,
status가mismatch이거나needs_review인 레코드는 모두 사람 검토 대기열로 보내는 게 좋아요. 출시 전에 APIYI apiyi.com에서 과거 구매 주문서로 전체 흐름을 다시 돌려보고 오판율을 집계한 다음, 어떤 상태를 자동 통과시킬지 결정하세요.
GPT-6.2 Astra 적용 순서 판단
위의 사실을 바탕으로, 저희가 내린 적용 순서 판단은 이렇습니다: 먼저 Structured Outputs와 File Search를 연결하고, 그다음 읽기 전용 MCP를 붙인 뒤, 마지막에 Multi-agent와 Computer Use를 도입한다는 것입니다. 앞의 두 항목은 OpenAI가 호스팅하므로 오류 발생 확률이 가장 낮아요. MCP의 승인 콜백은 별도로 테스트해야 하는 상태 머신이고, Multi-agent는 아직 beta이며 Computer Use의 안정성은 직접 구축한 환경의 품질에 달려 있기 때문에, 이 두 항목은 메인 흐름이 안정된 뒤에 얹는 게 적합해요.
이 판단이 성립하는 전제는 두 가지입니다. beta 인터페이스가 최근에 파괴적인 변경을 일으키지 않는다는 것, 그리고 여러분의 계정에서 해당 도구를 활성화할 수 있다는 것이죠. 두 가지 모두 OpenAI의 API 업데이트 로그를 계속 주시해야 합니다. 덧붙여, 예시에서의 “읽기 전용”은 하나의 설계 제약이에요. 업무상 쓰기 작업이 필요해지는 순간, 승인 정책과 쓰기 순서, 롤백 방안을 모두 새로 설계해야 하며, 이 글의 설정을 그대로 이어 쓸 수는 없습니다.
💰 비용 최적화: 긴 계약서를 반복 검색할 때, 캐시 적중 입력의 단가는 일반 입력보다 훨씬 낮습니다. 고정된 시스템 지시문과 schema를 요청 앞부분에 배치하면 캐시 적중률을 높이는 데 도움이 돼요. 중소 규모 팀도 APIYI apiyi.com에서 사용량 기반으로 호출하여 검증 범위를 점진적으로 확대할 수 있습니다.
도구 목록은 점점 길어지지만, 에이전트가 실제로 프로덕션에 투입될 수 있는지를 결정하는 것은 결국 몇 가지 소박한 경계입니다. 누가 실행하는가, 누가 권한을 부여하는가, 누가 재검증하는가. 루유(陸游)가 《동야독서시자율(冬夜讀書示子聿)》에서 쓴 것처럼요:
종이에서 얻은 것은 얕고, 이 일을 철저히 알려면 반드시 직접 해봐야 한다네.
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 웹사이트 첫 페이지에서 저희에게 연락해 주시면 GPT-6.2 Astra 적용에 관한 더 많은 실무 자료를 받으실 수 있습니다.