작성자 주석: Gemini 4 Neon과 GPT-6.2 Sol의 코딩, 차트, 롱 컨텍스트 세 항목을 나눠 비교하고, 작업당 비용, 소요 시간, 공식 단가와 APIYI 판매가를 확인하며, 모든 수치에 출처를 표기합니다.
많은 팀이 GPT-6.2 Sol을 더 저렴한 등급으로 여깁니다. Gemini 4 Neon은 2026-11-18에 출시되었고, Artificial Analysis 모델 페이지가 제시한 지능 점수는 61, Sol은 57입니다. 이 4점이 어떤 작업에 분포하느냐가, 그것이 여러분의 워크로드에서 얼마만큼의 가치를 갖는지를 결정합니다. 이 글에서는 코딩, 차트, 롱 컨텍스트 세 가지를 따로 살펴보고, 작업당 비용과 단가를 두 개의 장부로 나눠 봅니다.
이 글의 모든 수치에는 출처 태그가 붙어 있습니다: 공식 자체 발표, 모델 카드, Artificial Analysis 모델 페이지, Artificial Analysis 아티클, APIYI 총표, 가격 API. 두 기준이 서로 맞지 않는 수치는 나란히 그대로 남겨 두고, 평균을 내지도, 새로운 수치를 합성하지도 않습니다.
핵심 가치: 이 글을 읽고 나면 Neon이 더 높은 점수를 받은 항목이 어디인지, Sol이 오히려 더 높은 항목은 무엇인지, 두 모델의 작업당 비용과 소요 시간 차이가 얼마인지, 그리고 APIYI에서 이미 상架된 gpt-6.2-sol을 어떻게 호출하는지 설명할 수 있게 됩니다.
Gemini 4 Neon과 GPT-6.2 Sol의 핵심 차이 한눈에 보기
가장 중요한 일곱 행을 먼저 나란히 놓아볼게요. 여기서 티어를 주의해야 해요. Artificial Analysis 모델 페이지에서 Neon의 61점은 xhigh 티어에서, Sol의 57점은 max 티어에서 가져온 값이에요. 둘 다 각 페이지의 최고 티어지만 티어 이름과 의미는 달라요.
| 비교 항목 | Gemini 4 Neon | GPT-6.2 Sol | 출처 |
|---|---|---|---|
| 종합 지능 점수 | 61(xhigh) | 57(max) | Artificial Analysis 모델 페이지 |
| 코딩: Terminal-bench 4.1(치팅 보정 후 정확도) | 65.2% | 61.5% | 모델 카드 |
| 차트: Chartography | 73.5% | 75.1% | 모델 카드 |
| 긴 컨텍스트: GraphWalks(256k부터 1M까지, BFS의 F1) | 95.2% | 80.1% | 모델 카드 |
| 작업당 비용 | 6.44달러 | 1.01달러 | Artificial Analysis 모델 페이지 |
| 작업당 시간 | 21.5분 | 8.5분 | Artificial Analysis 모델 페이지 |
| 정가(입력/출력, 백만 토큰당) | 3 / 15달러 | 2 / 10달러 | 공식 자체 보고 / Artificial Analysis 모델 페이지 |
Gemini 4 Neon과 GPT-6.2 Sol 비교표를 읽기 전에 알아둘 세 가지 기준
첫째는 모델 카드의 성격이에요. DeepMind 모델 카드의 비교표에는 Gemini 4 Neon, Claude Opus 5.5, GPT-6.2 Sol 세 열만 있고, 함께 제공되는 평가 설명 PDF에는 Gemini가 아닌 결과는 기본적으로 각 사의 자체 보고에서 온다고 적혀 있어요. 그래서 모델 카드의 Sol 열은 Google이 취합한 공식 숫자이고, 같은 연구소가 같은 날 다시 측정한 값은 아니에요.
둘째는 지능 점수의 일관성이에요. 61이라는 숫자는 Google 블로그(공식 자체 보고), 모델 카드(AA Index v5.0.1 행에 61 / 59 / 57로 표기), Artificial Analysis 모델 페이지에서 모두 같고, Sol의 57도 모델 카드와 Artificial Analysis 모델 페이지에서 같아요. 코딩 계열 지표는 이렇게 딱 떨어지지 않아서 아래에서 따로 나눠서 쓸게요.
셋째는 비용 산정 기준이에요. Artificial Analysis의 작업당 비용은 전체 지수 세트를 실행한 뒤 작업별로 배분한 금액이라, 단가와 출력 토큰 수에 동시에 영향을 받아요. 이 숫자와 플랫폼이 토큰 단위로 과금하는 1회 호출 가격은 별개의 계산이라서 서로 대신할 수 없어요.
Gemini 4 Neon과 GPT-6.2 Sol 코딩 능력 비교
코딩 부분에서 모델 카드가 제시한 다섯 개 하위 항목 가운데 Neon은 데이터가 있는 항목 모두에서 Sol보다 높았지만, 항목별 차이는 크게 달랐어요. 아래 표는 모두 모델 카드에서 가져왔고, Sol의 수치는 평가 설명에 따라 OpenAI 자체 보고에 해당해요.
| 코딩 항목(모델 카드) | Gemini 4 Neon | GPT-6.2 Sol | 차이 |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 데이터 없음 | 비교 불가 |
| Terminal-bench 4.1(부정행위 보정 후) | 65.2% | 61.5% | 3.7%포인트 |
| FrontierCode 2.0 | 46.2% | 43.8% | 2.4%포인트 |
| SWE-sweep(벤더 harness) | 39.0% | 8.3% | 30.7%포인트 |
| SWE-sweep(mini-SWE harness) | 12.8% | 11.6% | 1.2%포인트 |
SWE-sweep의 두 harness는 나눠서 읽어야 해요
SWE-sweep은 가장 오해하기 쉬운 행이에요. Neon의 39.0%는 Google Antigravity라는 벤더 harness에서 나온 값이고, 통일된 mini-SWE harness로 바꾸면 12.8%예요. Google 블로그(공식 자체 보고)는 12.8에서 39.0으로 오르는 격차를 harness가 열어준 것이라고 설명해요. 그래서 이 숫자들은 ‘모델+툴체인’ 조합의 효과를 보여줘요.
동일한 mini-SWE harness에서는 Neon이 12.8%, Sol이 11.6%로 1.2%포인트 차이예요. Sol은 자사 벤더 harness에서 8.3%로, 오히려 자기 mini-SWE 성적보다 낮아요. 코딩 에이전트가 Antigravity에서 실행되지 않는다면 mini-SWE 행이 여러분이 재현 가능한 조건에 더 가까워요.
Coding Agent Index의 두 숫자
Google 블로그(공식 자체 보고)에서는 Neon의 Artificial Analysis Coding Agent Index를 58.6으로 적고 전체 1위라고 밝혀요. Artificial Analysis 글에서는 Antigravity CLI에서 Neon xhigh가 59라고 적었어요. 두 수치는 출처가 다르기 때문에 이 글에서는 둘 다 남기고 하나로 합치지 않아요. 참고 자료에는 이 지수에서 Sol의 점수가 없어서 이 항목에서는 두 모델을 비교할 수 없어요. 또한 FrontierCode 2.0의 46.2%는 공식 자체 보고 기준으로 기본 high 설정에서 측정됐어요.
Gemini 4 Neon과 GPT-6.2 Sol의 차트 성능 비교
차트는 세 항목 중 Sol이 더 높은 항목이에요. 모델 카드의 Chartography 행을 보면 Neon 73.5%, Sol 75.1%로 Sol이 1.6%포인트 높아요. Google 블로그(공식 자체 보고)에서 제시한 Neon 수치도 73.5%로 같아요.
같은 멀티모달 이해 항목인 LVBench는 모델 카드에 Neon 89.0%, Sol 87.6%로 적혀 있고, 이 항목에서는 Neon이 1.4%포인트 높아요. 두 항목의 방향이 서로 반대이고 격차도 크지 않아서 “차트와 비전 작업 중 어느 쪽이 더 강한가”를 한 문장으로 정리하기는 어려워요. 과제가 차트 읽기에 가까운지, 긴 영상 보기에 가까운지에 따라 달라져요.
입력 모달리티 측면에서 모델 카드는 Neon이 텍스트, 이미지, 오디오, 비디오를 받는다고 명시해요. 참고 자료에는 Sol의 입력 모달리티 목록이 없어서, 워크플로가 오디오나 비디오 입력에 의존한다면 먼저 OpenAI 공식 문서에서 Sol의 지원 여부를 확인해야 해요.
Gemini 4 Neon과 GPT-6.2 Sol의 긴 컨텍스트 비교
긴 컨텍스트 항목에서는 이 글에서 모델 카드의 GraphWalks 데이터만 사용해요. 256k에서 1M token 구간에서 BFS 순회를 했을 때 F1 점수는 Neon 95.2%, Sol 80.1%로 15.1%포인트 차이가 났어요. 세 항목 중 격차가 가장 큰 항목이에요.
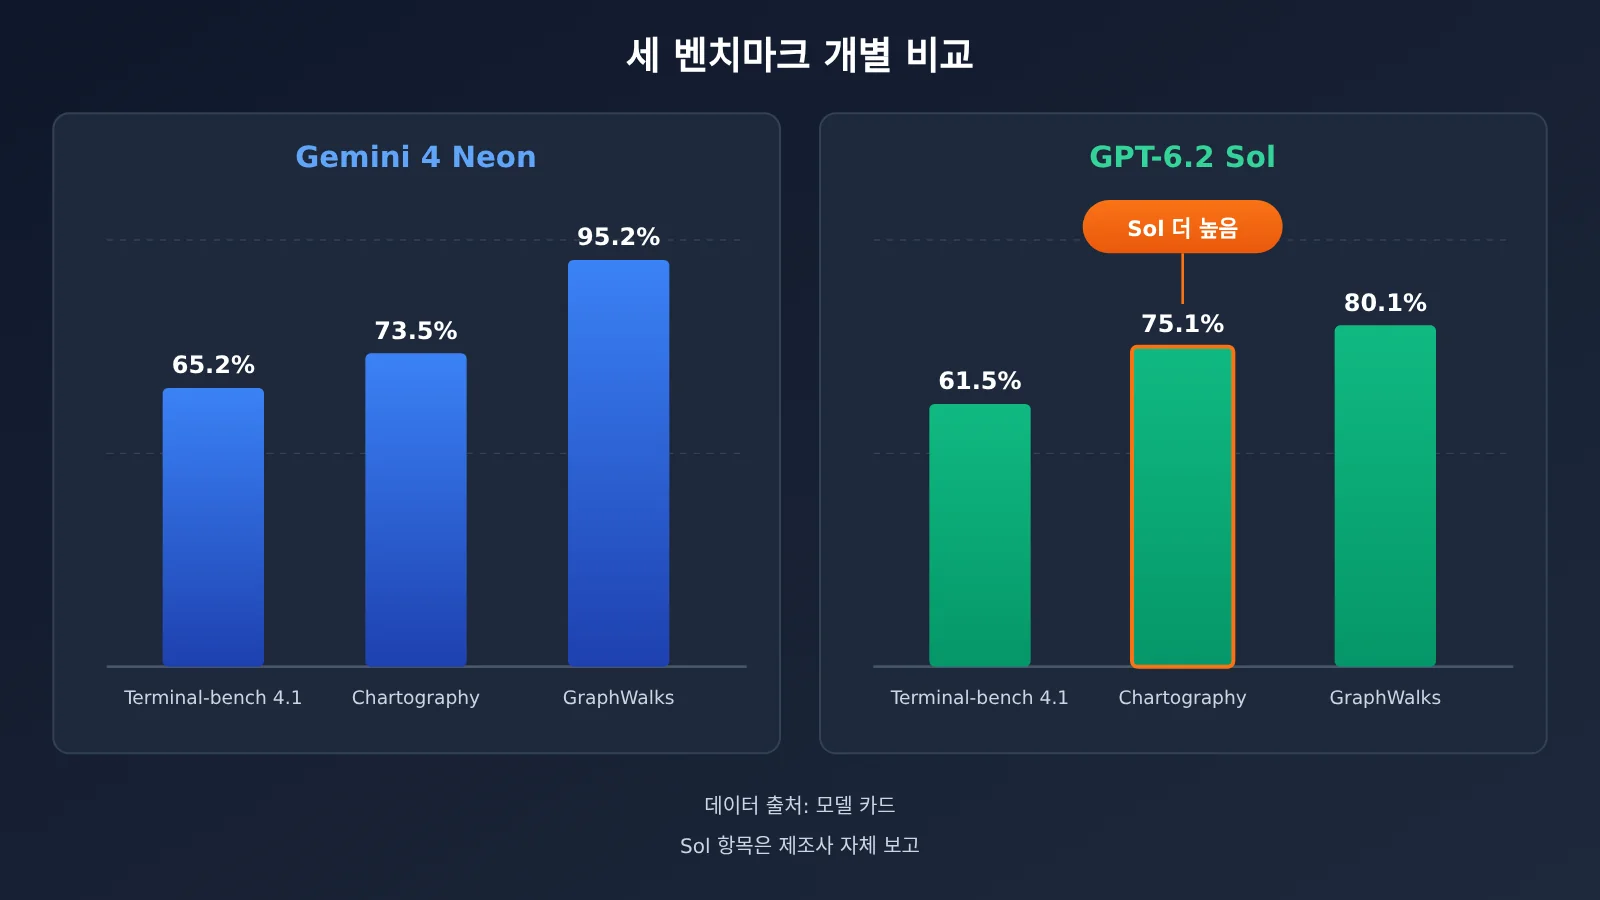
📊 차트 설명: 위 그림의 수치는 모두 모델 카드에서 왔고, Sol 열은 평가 설명에 따라 벤더 자체 보고예요. 긴 문서에서 Sol의 성능을 직접 검증해 보고 싶다면 APIYI apiyi.com을 통해 같은 API 키로
gpt-6.2-sol요청을 바로 보낼 수 있어요.
Gemini 4 Neon의 긴 컨텍스트 파라미터
Neon 쪽 윈도우 사양은 문서가 잘 갖춰져 있어요. 모델 카드에는 통합 윈도우가 최대 100만 token, 기본 동기 출력이 최대 6.4만 token, 백그라운드 장문 디코딩이 최대 100만 token이라고 적혀 있어요. Google Cloud 개발자 가이드는 정확한 값을 제시해요: 통합 상한은 1048576 token이고 입력과 출력을 함께 포함하며, 출력에는 사고 과정, 함수 호출, 최종 응답이 다시 포함돼요. 한 세그먼트당 기본 최대는 65536이고, 장문 디코딩은 1048576에서 입력을 뺀 값까지 가능해요.
캐시 측면에서 개발자 가이드는 Neon이 명시적 컨텍스트 캐시를 지원하지 않는다고 명시해요. 암시적 캐시는 4096 token 이상의 공유 프리픽스에 자동 적용되고, 영구 캐시는 기본으로 켜져 있어요. 긴 문서에 반복해서 질문하는 상황이라면 공유 프리픽스를 안정적으로 유지해야 AI Studio 가격 페이지에 적힌 0.15달러 캐시 가격을 적용받을 수 있어요.
GPT-6.2 Sol의 긴 컨텍스트 정보
참고 자료에는 Sol의 컨텍스트 윈도우 상한이 없어서 이 글에서는 윈도우 크기를 비교하지 않아요. 확인할 수 있는 것은 과금이에요: APIYI 요약표에 따르면 gpt-6.2-sol은 입력이 272000 token을 넘으면 가격 구간이 바뀌고, 아래 가격 부분에서 자세히 다룰게요. 긴 컨텍스트 작업에서는 이 임계값이 청구서 구조에 직접 영향을 줘요.
Gemini 4 Neon과 GPT-6.2 Sol의 비용 및 소요 시간 비교
작업당 비용의 차이는 단가 차이보다 훨씬 큽니다. Artificial Analysis 모델 페이지를 보면 Neon xhigh는 작업당 6.44달러, Sol max는 작업당 1.01달러로, 전자가 후자의 약 6.4배예요. 반면 두 모델의 입력 정가 비율은 3 대 2, 출력 정가 비율은 15 대 10으로 모두 1.5배입니다.
차이가 더 벌어지는 이유는 출력량에 있어요. 같은 페이지에서 Neon xhigh는 인덱스 실행 시 2억 8300만 토큰을 출력했고, Sol max는 6090만 토큰을 출력해 전자가 후자의 약 4.6배입니다. 단가가 1.5배 높고 출력량이 몇 배 더 많은, 이 두 가지가 겹쳐져야 6.44 대 1.01이라는 결과가 나옵니다.
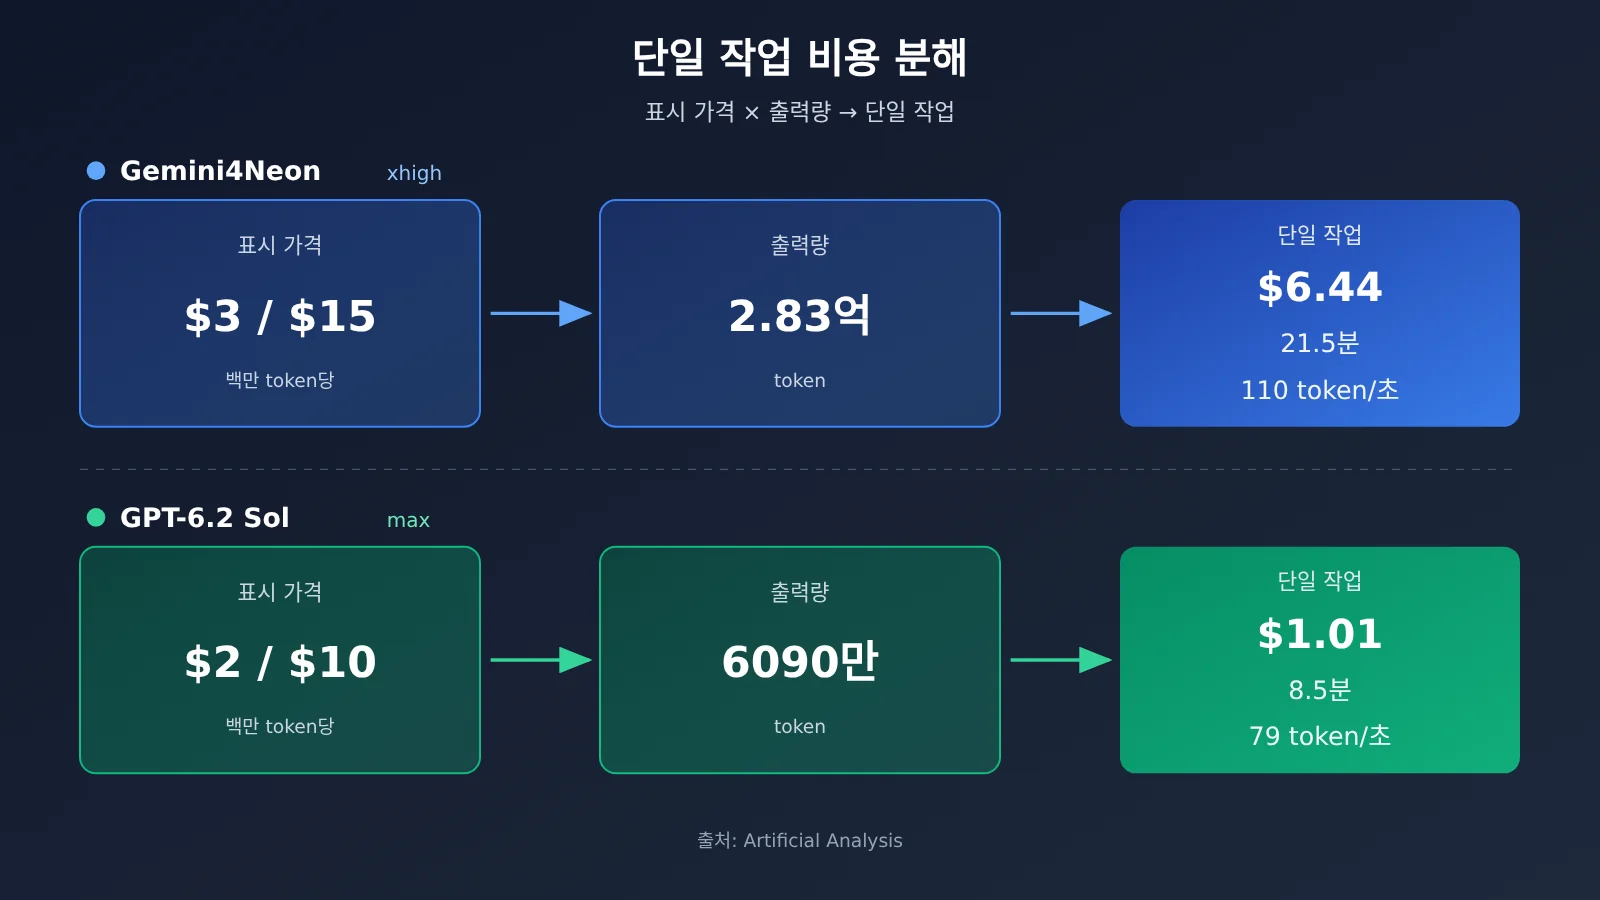
소요 시간도 마찬가지예요. Neon xhigh의 출력 속도는 약 110 token/초로 Sol max의 79 token/초보다 빠르지만, 출력량이 더 많아 작업당 시간은 21.5분 대 8.5분입니다. 첫 답변 토큰까지 걸리는 시간은 Neon xhigh가 56.51초, Sol max가 75.06초로 이 항목에서는 Neon이 더 빨라요.
등급별 지능 점수와 작업당 시간
두 모델 모두 여러 개의 사고(thinking) 등급을 제공합니다. 아래 표는 Artificial Analysis 모델 페이지에서 가져왔어요. 작업당 비용은 최고 등급 행에만 수치가 있고, 나머지 등급은 페이지에 점수와 시간, 속도만 제공됩니다.
| 등급 | Neon 지능 점수 | Neon 작업당 시간 | Neon 출력 속도 | Sol 지능 점수 | Sol 작업당 시간 | Sol 출력 속도 |
|---|---|---|---|---|---|---|
| max | 해당 등급 없음 | — | — | 57 | 8.5분 | 79 token/초 |
| xhigh | 61 | 21.5분 | 110 token/초 | 56 | 5.3분 | 76 token/초 |
| high | 60 | 14.8분 | 101 token/초 | 55 | 4.6분 | 73 token/초 |
| medium | 55 | 8.3분 | 101 token/초 | 53 | 3.2분 | 70 token/초 |
| low | 44 | 3.7분 | 97 token/초 | 41 | 1.5분 | 65 token/초 |
이 표는 두 가지 방식으로 읽을 수 있어요. 같은 이름의 등급끼리 비교하면 high 등급에서 Neon은 60점, Sol은 55점이고, 소요 시간은 14.8분 대 4.6분입니다. 시간 기준으로 보면 Neon medium의 8.3분과 Sol max의 8.5분이 비슷한데, 점수는 55 대 57이에요. Neon의 기본 등급은 high입니다(개발자 가이드와 AI Studio 최신 모델 페이지 모두 그렇게 명시하고 있어요). 이는 많은 통합에서 기본값으로 설정되는 행이기도 합니다. Neon의 하위 세 등급 첫 토큰 시간은 모델 페이지 FAQ에 별도로 기록되어 있는데, high 40.64초, medium 20.14초, low 13.93초예요. 이 수치들은 요약 표와 같은 열에 있지 않습니다.
Gemini 4 Neon과 GPT-6.2 Sol 가격 비교: 공식 단가와 APIYI 가격표
가격은 크게 두 층으로 나눠 볼게요. 모델 제공사나 제3자 페이지에 표시된 정가, 그리고 APIYI(apiyi.com)의 가격표 가격이에요.
| 항목 | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| 입력 표시 가격 (100만 토큰당) | 3.00달러 (공식 표기 / AI Studio 가격 페이지) | 2.00달러 (Artificial Analysis 모델 페이지) |
| 출력 표시 가격 (100만 토큰당) | 15.00달러, 사고 토큰 포함 | 10.00달러 |
| 캐시 | 0.15달러, 암시적 캐시만 | 캐시 할인 95% (Artificial Analysis 모델 페이지) |
| 무료 티어 | 없음 (AI Studio 가격 페이지) | 참고 자료에 언급 없음 |
| APIYI 모델 ID | 아직 미등록 | gpt-6.2-sol |
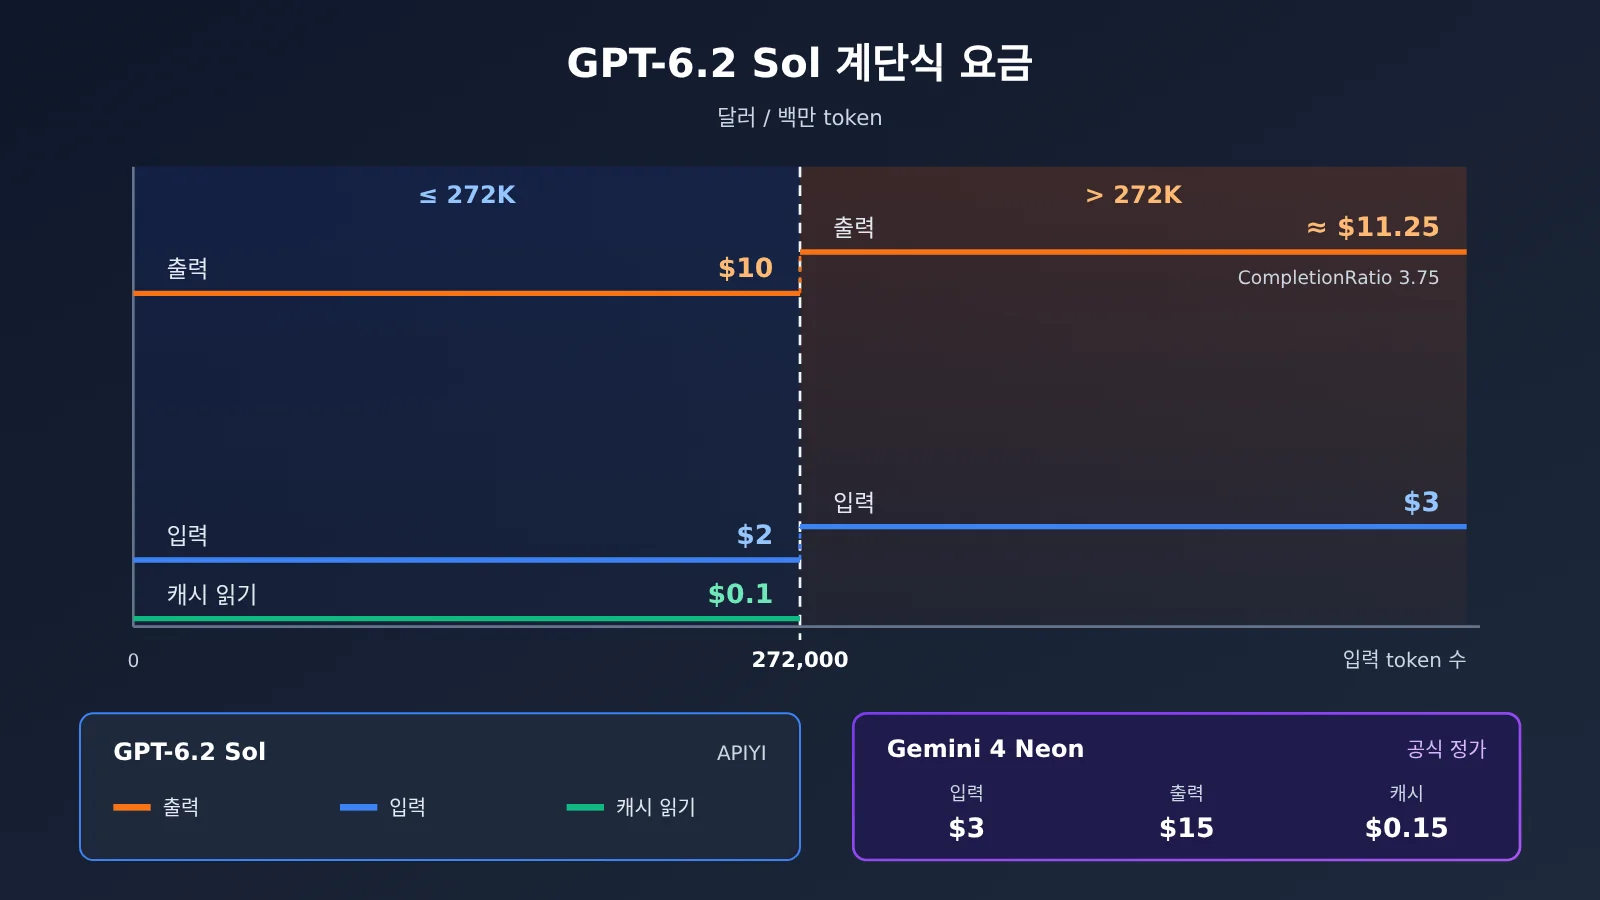
| APIYI 1차 구간 (입력 토큰 0 ~ 272000개) | — | 입력 2 / 캐시 읽기 0.1 / 출력 10달러 |
| APIYI 상위 구간 (입력 토큰 272000개 초과) | — | 입력 3달러, 가격 API 출력 약 11.25달러 |
| APIYI 엔드포인트 | — | responses(권장), chat |
| 사용 가능 플랫폼 | Google AI Studio의 Gemini API 등 공식 채널 | APIYI apiyi.com 등 |
gemini-4-neon은 APIYI 통합표와 가격 API 모두에 아직 없어서 미등록 상태예요. 최대한 빨리 이 모델을 올릴 예정이며, 모델명과 가격은 플랫폼의 모델 목록을 기준으로 해주세요.
APIYI에서 gpt-6.2-sol의 가격 구간 변동 상세
APIYI 통합표(페이지에 2026-11-16 09:39, UTC+8 기준 업데이트 표기)에는 gpt-6.2-sol의 1차 구간이 입력 2달러, 캐시 읽기 0.1달러, 출력 10달러로 적혀 있어요. Artificial Analysis 모델 페이지의 2/10 표시와 일치하죠. 입력 토큰 272000개를 초과할 때 통합표 본문에는 입력이 2달러에서 3달러로 오른다는 것만 적혀 있어요.
2026-11-19에 조회한 가격 API(버전 shell-api-modelmak-v1, 총 285개 모델)는 더 완전한 정보를 보여줘요. API에서 model_ratio가 1이면 입력 100만 토큰당 2달러에 해당하고, completion_ratio가 5면 출력이 입력의 5배라는 뜻이에요. 입력 토큰 272000개를 넘으면 CompletionRatio가 5에서 3.75로 바뀌어서, 입력 3달러 기준으로 환산하면 출력은 100만 토큰당 약 11.25달러예요. 계속 10달러로 계산되는 건 아니에요.
그룹 이름은 두 곳에서 표기가 조금 달라요. 통합표에는 CodexResponses, Codex_Reverse, Default, SVIP로 적혀 있고, 가격 API에는 CodexResponses, CodexReverse, default, svip로 나와 있어요. 그리고 다시 한 번 강조하자면, Artificial Analysis의 1.01달러는 인덱스를 돌릴 때 각 작업에 할당된 비용이에요. 플랫폼에서 한 번 호출할 때 실제로 발생하는 토큰 비용과는 다른 얘기예요.
Gemini 4 Neon과 GPT-6.2 Sol 시나리오 대조
아래에서는 작업 유형별로 가장 관련성이 높은 수치를 나열해서, 여러분의 평가와 실제 워크로드를 서로 맞춰볼 수 있도록 도와드릴게요. 어느 쪽이 더 적합한지는 여러분의 작업 분포와 예산에 달려 있고, 여기서는 대조만 할 뿐 결론을 내리지는 않아요.
코딩 에이전트와 관련된 수치
- Google Antigravity 안에서 실행: SWE-sweep의 벤더 harness 행을 보세요. Neon 39.0%, Sol 8.3%이고, 동시에 Google이 이 차이를 harness 때문이라고 자체적으로 설명했다는 점도 기억해 두세요.
- 범용 harness에서 실행: mini-SWE 행에서 12.8% 대 11.6%, 그리고 Terminal-bench 4.1에서 65.2% 대 61.5%를 보세요.
- 빈번한 소규모 수정: 단일 작업 시간이 더 중요하니, 티어 표에서 같은 점수대의 소요 시간을 대조해 보면 좋아요.
차트와 긴 문서와 관련된 수치
- 실적 보고서 차트, 대시보드 스크린샷 질의응답: Chartography는 Sol 75.1%, Neon 73.5%인데, 이 항목은 방향이 종합 점수와 반대예요.
- 수십만 token 규모의 그래프 구조나 문서 순회: GraphWalks는 Neon 95.2%, Sol 80.1%이고, 동시에 Sol이 APIYI에서 272000 token을 초과할 때 적용되는 가격 구간 상향을 비용에 반영해 계산해야 해요.
- 긴 영상 이해: LVBench는 Neon 89.0%, Sol 87.6%이며, 모델 카드에 Neon이 비디오 입력을 지원한다고 명시되어 있어요.
Gemini 4 Neon과 GPT-6.2 Sol 선택 가이드: 먼저 확인하고 고르세요
모델을 고르기 전에 61 대 57이라는 점수만 보고 바로 결정하기보다는, 아래 순서대로 내 상황을 먼저 확인하는 걸 권해요.
- 내 작업에서 코딩, 차트, 긴 컨텍스트가 각각 얼마의 비중을 차지하는지 집계한 뒤, 앞서 정리한 세 가지 항목별 표와 각각 비교해 보세요.
- 작업당 평균 출력량을 추정해 보세요. Artificial Analysis 데이터에 따르면 두 모델의 작업당 비용 격차는 주로 출력량에서 발생해요. 작업 출력이 길수록 이 격차는 더 뚜렷해집니다.
- 입력 길이가 272000 token을 넘는지 확인하세요. 넘으면 APIYI에서
gpt-6.2-sol의 입력 및 출력 단가가 모두 바뀝니다. - 사고(추론) 수준을 확인하세요. Neon은 low, medium, high, xhigh 네 단계만 지원하며,
thinking_budget또는MINIMAL을 전달하면 HTTP400이 반환돼요(개발자 가이드). - 내 샘플 세트에서 소규모 대조 테스트를 실행하고 점수, 소요 시간, token 사용량을 기록하세요.
💡 선택 제안: 두 모델은 항목별로 우위가 갈리기 때문에 최종 선택은 작업 분포와 예산에 달려 있어요. 먼저 APIYI apiyi.com에서 이미 출시된
gpt-6.2-sol을 연결해 내 샘플에서 token 사용량과 소요 시간을 기록하고, Neon 출시 후 같은 스크립트로 대조 테스트를 돌려 보세요.
APIYI로 GPT-6.2 Sol 빠르게 호출하는 방법
APIYI가 gpt-6.2-sol에 권장하는 엔드포인트는 responses이고, OpenAI 호환 base_url은 https://api.apiyi.com/v1이에요. 연동은 딱 네 단계면 끝나요:
- 키 준비: 플랫폼 콘솔에서 API Key를 생성한 뒤 환경 변수
APIYI_API_KEY에 넣어두세요. 코드에서는 환경 변수에서만 읽고, 평문으로 직접 쓰지 마세요. - 요청 주소 확인: Responses 엔드포인트는
POST https://api.apiyi.com/v1/responses이고, 요청 헤더에는Authorization: Bearer $APIYI_API_KEY와Content-Type: application/json을 담아요. - 요청 본문 구성: 최소 요청 본문은
{"model": "gpt-6.2-sol", "input": "이번 분기 보고서에 있는 세 개의 차트를 요약해 주세요"}예요. - OpenAI SDK로 호출:
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"])로 초기화한 다음client.responses.create(model="gpt-6.2-sol", input=...)를 호출하고, 반환 객체의output_text에서 결과를 읽어요.
기존 코드가 Chat Completions 기반이라면 같은 모델 ID를 chat 엔드포인트, 경로 /v1/chat/completions로 보내도 돼요. Gemini 네이티브 프로토콜은 https://api.apiyi.com에 v1beta 버전을 붙여 사용하며, 플랫폼에 이미 등록된 Gemini 모델에 적용돼요.
긴 컨텍스트 테스트를 할 때는 로그에 요청마다의 입력 토큰 수를 함께 기록해 두는 걸 권장해요. 272000이라는 단계 구간을 넘었는지 판단하기 편하거든요. 사고 단계(thinking) 파라미터의 구체적인 값은 OpenAI 공식 문서와 플랫폼 모델 페이지를 기준으로 확인하세요.
🚀 빠른 시작: 신규 사용자는 APIYI apiyi.com에서 무료 테스트 크레딧을 받을 수 있어요. 하나의 Key로 OpenAI, Claude, Gemini 등 이미 등록된 모델을 동시에 호출할 수 있으니, 먼저
gpt-6.2-sol의 responses 경로를 끝까지 돌려보고 이후에는model필드만 바꿔서 모델을 전환하면 돼요.
자주 묻는 질문 FAQ
Q1: Gemini 4 Neon과 GPT-6.2 Sol은 각각 어떤 포지셔닝인가요?
Neon은 Gemini 4 Carbon을 개조해 만든 모델입니다(모델 카드). Google 개발자 가이드는 이를 Hydrogen(일상적 단기 반복 주기)과 Carbon(복잡한 장기 과제) 사이에 위치시켰어요. GPT-6.2 Sol은 Artificial Analysis 모델 페이지에 2/10달러로 가격이 표기되어 있고, 최고 등급인 max에서 지능 점수 57을 기록했어요.
Q2: Neon이 Sol보다 높은 4점은 주로 어디에서 나오나요?
모델 카드의 세부 항목을 보면 격차가 가장 큰 부분은 긴 컨텍스트 GraphWalks(95.2% 대 80.1%)와 벤더 하네스 기준 SWE-sweep(39.0% 대 8.3%)예요. 차트 작성(Chartography) 항목은 오히려 Sol이 더 높습니다(75.1% 대 73.5%).
Q3: Gemini 4 Neon은 언제 출시되며, 어떤 채널에서 사용할 수 있나요?
Google 블로그의 게시일은 2026-11-18이에요. Sundar Pichai의 출시 게시물에 따르면 같은 날 Google AI Studio의 Gemini API, Gemini for business, 유료 Google AI Pro와 Ultra의 Google Antigravity, 그리고 Pro와 Ultra의 Gemini App에서 선보였고, 모델 ID는 `gemini-4-neon`입니다.
Q4: Sol의 작업당 1.01달러를 호출 예산으로 삼아도 되나요?
이 수치는 Artificial Analysis가 전체 지수 세트를 실행한 뒤 작업 하나당 비용으로 나눈 값이며, Sol max는 해당 테스트에서 6090만 토큰을 출력했어요. 실제 비용은 여러분의 입력·출력 토큰 수와 요금 등급에 따라 달라지니, APIYI 종합 요금표의 첫 구간 2 / 0.1 / 10달러를 기준으로 직접 계산해 보시고 272000토큰을 넘으면 요금 구간이 올라간다는 점도 유의하세요.
Q5: 두 모델을 API로 빠르게 호출하려면 어떻게 하나요?
`gpt-6.2-sol`은 이미 APIYI에 등록되어 있어요. apiyi.com에서 가입하고 테스트 크레딧을 받은 뒤 base_url을 `https://api.apiyi.com/v1`로 설정하고 `responses` 엔드포인트를 호출하면 됩니다. `gemini-4-neon`은 현재 종합 요금표와 가격 조회 API 어디에도 없어서 아직 등록되지 않았고, 곧 이 모델을 등록할 예정입니다. 모델명과 가격은 플랫폼의 모델 목록을 기준으로 확인해 주세요.
Q6: 이 비교 데이터에는 어떤 한계가 있나요?
주로 세 가지예요:
– **기준**: 모델 카드에 있는 Sol의 점수는 평가 설명에 따르면 벤더 자체 보고 값이며, 같은 날 재측정한 결과가 아니에요.
– **등급**: Artificial Analysis에서 Neon의 최고 등급은 xhigh, Sol은 max라서 등급이 완전히 대등하지 않아요.
– **수치 불일치**: Coding Agent Index는 Google 블로그에서는 58.6, Artificial Analysis 글에서는 59이고, WebExploitBench v1.2는 블로그에 51.26%, 모델 카드에 51.3%로 적혀 있어요. 본문에서는 모두 원문 그대로 유지했습니다.
Gemini 4 Neon과 GPT-6.2 Sol 핵심 요약
- 종합 점수: Artificial Analysis 모델 페이지에서 Neon xhigh 61점, Sol max 57점이에요.
- 코딩: 모델 카드의 Terminal-bench 4.1은 65.2% 대 61.5%이고, SWE-sweep 격차는 harness별로 따로 봐야 해요.
- 차트: Chartography는 Sol이 더 높아요. 75.1% 대 73.5%예요.
- 긴 컨텍스트: GraphWalks 256k~1M 구간의 F1이 95.2% 대 80.1%로, 격차가 가장 커요.
- 비용과 소요 시간: 단일 태스크 기준 6.44달러 대 1.01달러, 21.5분 대 8.5분이고, 주된 원인은 출력량이 몇 배 차이 나기 때문이에요.
- 단가: Neon은 3/15달러, Sol은 2/10달러예요. APIYI에서
gpt-6.2-sol은 입력 토큰 272000개를 넘으면 가격 구간이 올라가요.
정리
Gemini 4 Neon과 GPT-6.2 Sol의 차이는 항목별로 뜯어보면 종합 점수보다 훨씬 명확해요.
- 코딩: Neon은 모델 카드에 데이터가 있는 세부 항목에서 더 높지만, 같은 mini-SWE harness에서는 1.2%포인트 차이에 그쳐요.
- 차트: Chartography 항목은 Sol이 더 높고, LVBench는 Neon이 조금 앞서요.
- 긴 컨텍스트: GraphWalks에서 Neon이 15.1%포인트 앞서며, 세 항목 중 격차가 가장 뚜렷해요.
- 비용: 단가 차이는 1.5배인데 단일 태스크 비용은 약 6.4배 차이 나고, 이 증폭은 출력 토큰 수에서 비롯돼요.
어느 쪽을 고를지는 결국 내 작업의 태스크 분포와 출력 길이로 돌아가야 해요. 먼저 APIYI apiyi.com을 통해 gpt-6.2-sol을 연결하고, 실제 샘플에서 사용량과 소요 시간을 기록해 두길 권해요. Neon이 출시된 뒤에는 같은 절차로 대조군을 채우면 되고요.
📚 참고 자료
-
Google 블로그 Introducing Gemini 4 Neon: 공식 발표 및 자체 보고 평가
- 링크:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 설명: 종합, 코딩, 과학, 가격 포지셔닝 모두 공식 자체 보고 수치예요
- 링크:
-
DeepMind Gemini 4 Neon 모델 카드: 3열 대조표 출처
- 링크:
deepmind.google/models/model-cards/gemini-4-neon - 설명: Chartography, GraphWalks, SWE-sweep 등의 세부 데이터
- 링크:
-
Google Cloud Gemini 4 Neon 개발자 가이드: 컨텍스트 윈도우, 사고 등급과 캐싱 규칙
- 링크:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 설명: 1048576 token 통합 상한, HTTP 400 규칙, 암시적 캐싱 설명
- 링크:
-
Google AI Studio 가격 페이지: Neon 공식 단가
- 링크:
aistudio.google.com/docs/pricing - 설명: 입력 3, 출력 15, 캐싱 0.15달러/백만 token
- 링크:
-
Artificial Analysis 모델 페이지: Neon과 Sol의 등급별 데이터
- 링크:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-sol - 설명: 지능 점수, 작업당 비용, 시간, 출력 속도
- 링크:
-
Artificial Analysis 아티클: Neon 제3자 측정 해석
- 링크:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 설명: Coding Agent Index 59 등 데이터
- 링크:
-
APIYI 종합표와 가격 인터페이스: 등록된 모델과 단계별 가격
- 링크:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - 설명:
gpt-6.2-sol첫 구간과 272000 token 구간 전환 규칙
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 홈페이지에서 문의해 주세요. 더 많은 모델과 연동 설명은 docs.apiyi.com 문서 센터에서 확인할 수 있어요