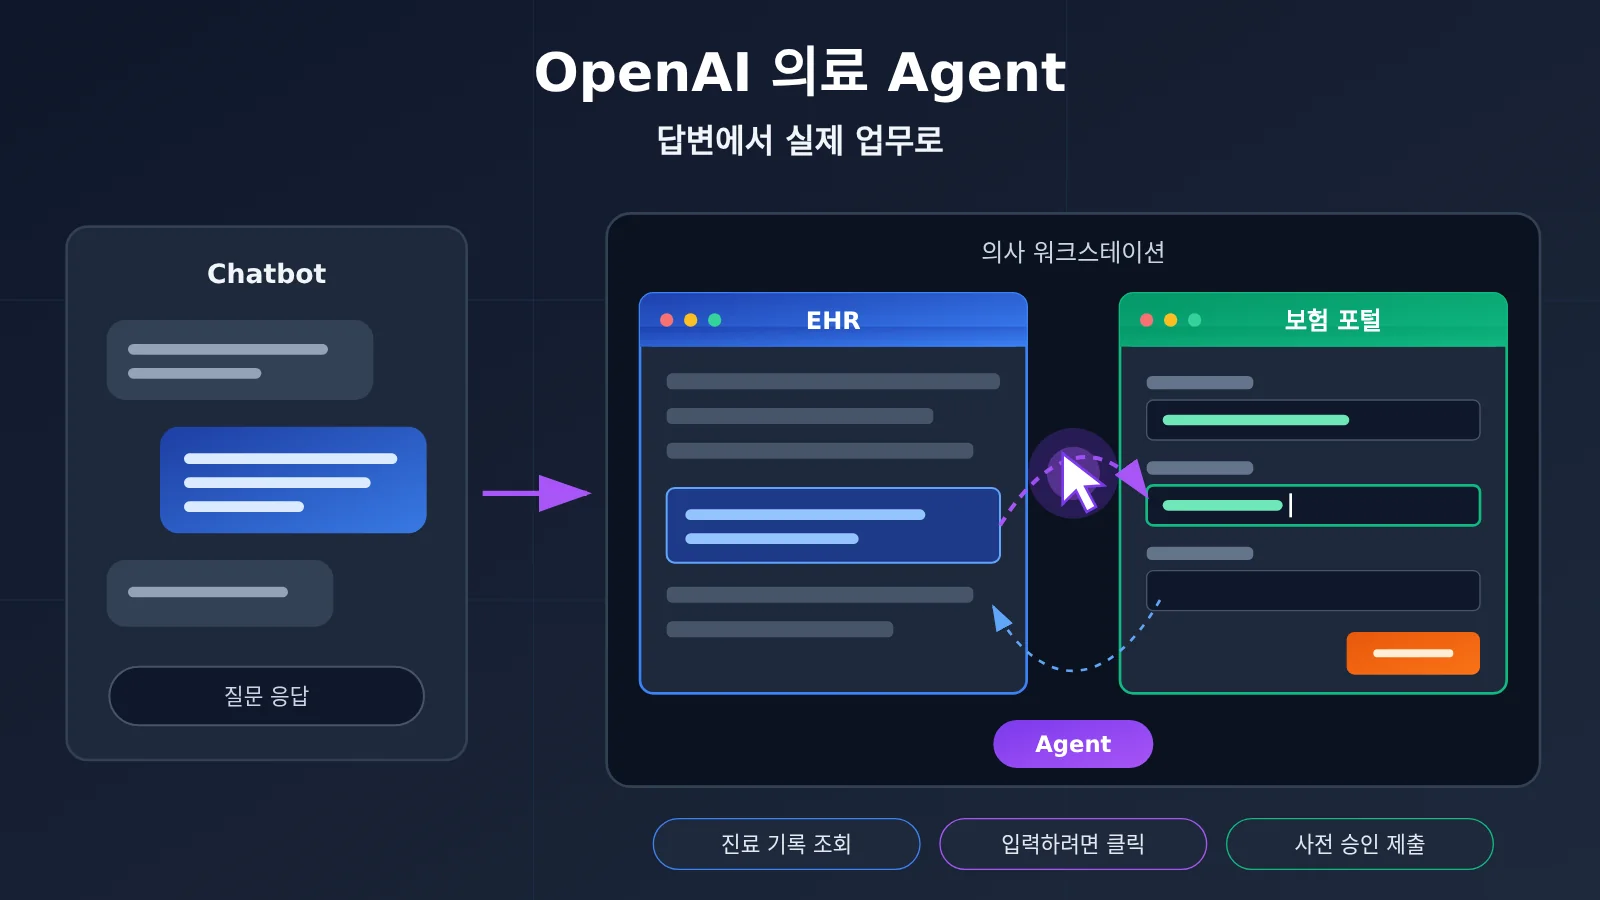
OpenAI 의료 Computer-use Agent의 핵심 진전은, 의료 기관이 이미 사용하고 있는 소프트웨어 시스템에 들어가서 환자의 경시적(longitudinal) 진료 기록 정보를 읽고, 이를 바탕으로 의료 기록, 처방 지시 초안, 환자 답변, 보험 사전 승인 자료를 준비할 수 있다는 점이에요. AI의 가치는 전문적인 질문에 답하는 데서 실제 업무 프로세스를 실행하는 쪽으로 확장되고 있어요. 의료 AI의 경쟁 초점도 이에 따라 달라지고 있는데, 더 이상 의학 지식 문답에 머무르지 않고 임상·행정 워크플로 자체로 들어가고 있죠. 한 가지 강조할 점은, 이런 자료들이 데모든 공개 사례든 모두 의사나 직원의 검토를 거쳐야 하며, AI가 독자적으로 처방권이나 의료 결정권을 갖지는 않는다는 것이에요.
이 글을 읽고 무엇을 알 수 있을까요?
- MRI 데모에서 Agent가 진료 기록을 읽는 것부터 사전 승인 신청서를 준비하는 것까지 이어지는 전체 작업 체인.
- 안전성 99%, 의사 93%의 높은 평가, 94.3% 루브릭 포인트라는 세 가지 수치가 각각 어떤 평가 기준을 갖는지, 그리고 그것이 스탠퍼드 HealthAdminBench 논문 성적과 어떻게 다른지.
- CVS Health, Cigna, Abridge, Ambience가 각각 합성 데모 단계인지, 실제 운영 배포 단계인지, 개발 단계인지.
- 임상 승인권과 Agent 실행권을 어떻게 분리하는지, 그리고 개발자가 Agent의 전체 비용을 어떻게 산정해야 하는지.
목차
객관적 사실 부분은 다음 순서로 전개돼요. 먼저 OpenAI가 이번에 AI로 무엇을 하게 했는지 되짚고, 이어서 Chatbot과 Computer-use Agent의 차이를 비교한 뒤, 평가 성적의 의미를 뜯어보고, 다음으로 CVS, Cigna, Abridge, Ambience 등 기업의 도입 방식을 정리해요. 마지막으로 의료 Agent의 리스크 통제 메커니즘을 소개할게요. 분석 판단 부분에서는 의료 업계가 왜 이런 능력을 특히 필요로 하는지, 개발자와 의료 기관이 어떻게 취사선택해야 하는지, 그리고 Computer Use가 AI 애플리케이션 산업 전체에 어떤 의미를 갖는지를 다룰게요.
알아두기: 의료 Agent 관련 개념 빠른 조회
| 개념 | 간단한 설명 |
|---|---|
| Computer Use | 화면을 관찰하고 소프트웨어 인터페이스를 조작(스크린샷, 클릭, 입력)하여 작업을 완료하는 능력 |
| EHR | 전자 건강 기록 시스템으로, 병원이 환자의 진료, 투약, 영상 등의 정보를 보관하는 핵심 소프트웨어 |
| Payer Portal | 보험 지급자 포털로, 의료기관이 여기서 사전 승인을 제출하고 보험 자격을 확인 |
| Prior Authorization | 사전 승인으로, 일부 검사나 치료는 시행 전에 보험 측의 승인을 먼저 받아야 함 |
| MCP | 외부 도구를 발견하고 호출하기 위한 표준 프로토콜 |
| RPA | 사전에 구성된 규칙이나 스크립트를 통해 반복적인 프로세스를 실행하는 자동화 방식 |
| Rubric points | 평가 규칙에 따라 분할된 채점 포인트로, 부분 요구사항의 달성 정도를 측정 |
| 엔드투엔드 성공률 | 전체 작업이 모든 성공 조건을 충족하는 비율 |
| Trace | 실행 과정, 조작 동작 및 인터페이스 상태를 기록한 궤적 증거 |
| BAA | 비즈니스 파트너 협약으로, 서비스 제공자의 보호 건강 정보(PHI) 처리 책임을 명확히 함 |
| RBAC | 역할 기반 접근 제어로, 직무에 따라 접근 가능한 데이터와 작업을 할당 |
의료 Agent 영향 빠른 조회
- 개발자와 기술 리더: 이제 핵심은 모델이 의학적 질문에 정답을 맞힐 수 있는지가 아니라, 구체적인 작업에 따라 실행 메커니즘, 엔드투엔드 완료율, 전체 비용을 검증하는 것입니다. 스크린샷은 이미지 입력에 해당하며, 다중 턴 호출, 도구, 실행 환경 모두 과금되므로 텍스트 토큰 단가만 볼 수는 없어요.
- 의료기관과 워크플로 책임자: 어떤 것이 합성 데이터 데모인지, 벤더 평가인지, 기업 파일럿인지, 실제 운영 사례인지를 구분해야 합니다. 실제 출시 시에는 수동 승인, 권한 설정, 감사 로그를 반드시 적용해야 하며, 데모 효과를 그대로 구매 근거로 삼아서는 안 됩니다.
- 임상 인력: 단기적으로는 행정 부담 감소를 더 체감할 가능성이 높아요. 예를 들어 사전 승인 자료 준비나 시스템 간 정보 조회 같은 부분이죠. 다만 임상적 판단과 서명 책임은 여전히 의사에게 있습니다.
객관적 사실: OpenAI 의료 Agent가 이번에 공개한 것
OpenAI 의료 Agent는 이번에 AI로 무엇을 했나요?
2026년 11월 16일, OpenAI는 의료 팀을 위한 컴퓨터 조작 Agent의 새 진전을 공개하고, 임상 및 행정 워크플로 평가 결과와 CVS Health, Abridge, Ambience, Cigna Healthcare 등 기업과의 협업 사례를 함께 밝혔어요. HLTH 2026 기간에는 OpenAI Health AI 책임자 Karan Singhal도 관련 진전을 소개했어요.
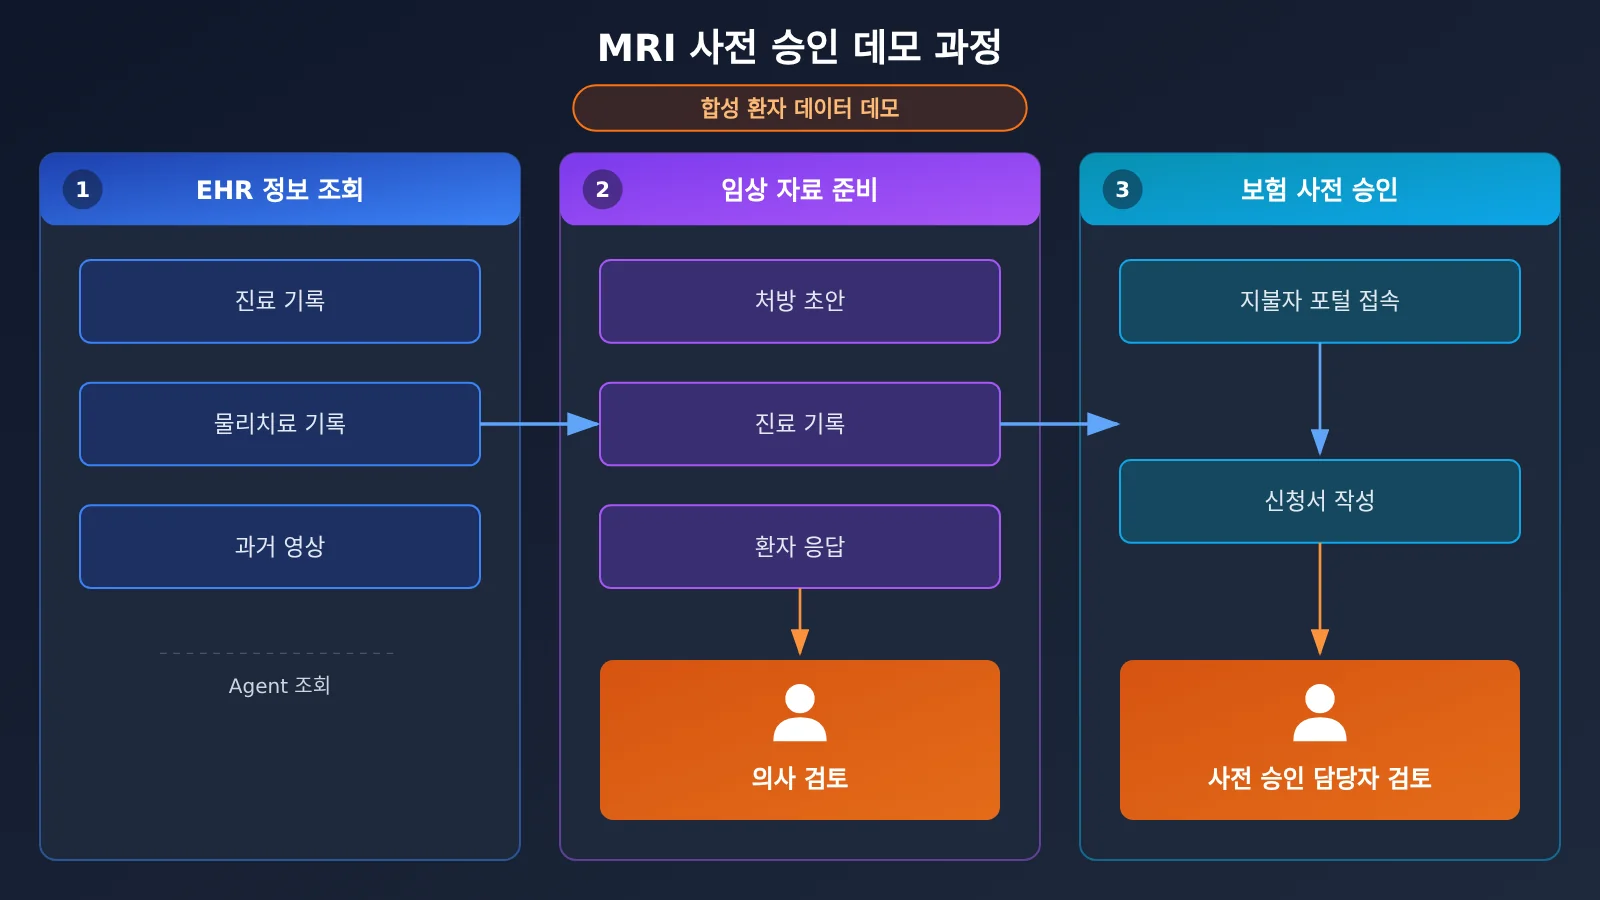
이번 변화를 가장 잘 보여주는 것은 공식적으로 시연한 MRI 워크플로예요. 한 환자가 허리 아래 부위 통증으로 의사에게 메시지를 보냈고, 의사는 MRI 검사를 고려했어요. 이어 Agent는 EHR과 보험 포털 사이에서 세 단계 작업을 완료했어요.
- EHR 정보 읽기: 환자의 진료 기록, 물리치료 기록, 과거 영상 자료를 확인해요.
- 임상 자료 준비: MRI 검사 오더, 이번 진료 기록, 환자에게 보낼 회신 초안을 작성하고, 모두 의사 검토를 위해 남겨둬요.
- 보험 사전 승인: 같은 환자 기록을 이어서 사용해 보험 지급자 포털에 들어가 MRI 사전 승인 신청을 준비하고, 사전 승인 담당자의 검토를 맡겨요.
분명히 말씀드리면, 이 데모는 합성 환자 데이터(Synthetic Patient Data)를 사용했고 실제 환자에 대한 운영 작업이 아니에요. 이는 능력의 연결 경로를 보여줄 뿐, 어떤 병원이 이미 이 절차대로 실제 사례를 처리했다는 뜻은 아니에요.
공식 측은 또한 어린이가 골절된 뒤의 약물 상담 사례도 보여줬어요. 가족이 어린이 이부프로펜 용량을 물었고, Agent는 진료 기록과 영상 자료를 확인한 뒤, 병력에 기록된 체중과 클리닉 투여 용량을 읽고 이를 근거로 약물 복용 설명, 깁스 관리 설명, 그리고 즉시 진료를 받아야 하는 경고 증상을 작성했어요. 의료 기록은 서명되지 않은 상태로, 가족에게 보내는 회신은 발송되지 않은 초안으로 저장했고, 최종적으로 의사가 승인했어요. Elevated PSA와 Digoxin refill(디곡신 재처방)도 EHR Inbox의 작업 유형으로 제시됐지만, 공식 측은 이 두 작업 유형의 전체 운영 기록과 독립 평가 점수를 공개하지 않았어요.
Chatbot에서 Computer-use 의료 에이전트로, 무엇이 달라졌나요?
전통적인 의료 질의응답은 일반적인 지식을 답변하고, 의료 문서 생성은 초안을 작성할 수 있지만 내용은 여전히 사람이 시스템에 복사해 넣어야 해요. Computer-use 에이전트의 차이는 “스크린샷 관찰 → 계획 → 클릭 또는 입력 → 다시 스크린샷으로 검증”의 반복을 통해 기존 소프트웨어에 직접 들어가, 여러 애플리케이션에 걸친 다단계 작업을 완료하고 소프트웨어의 업무 상태까지 바꿀 수 있다는 점이에요.
| 능력 형태 | 주요 출력 | 업무 시스템 접촉 여부 | 대표 의료 시나리오 | 주요 위험 요인 |
|---|---|---|---|---|
| 의료 질의응답 Chatbot | 텍스트 응답 | 아니요 | 의학 지식 조회, 근거 검색 | 내용 정확성 |
| 의료 문서 생성 | 기록, 편지 초안 | 간접적, 수동 입력 필요 | 퇴원 설명, 사전 승인 편지 | 내용과 의무기록 불일치 |
| Computer-use 에이전트 | 인터페이스 조작 및 시스템 상태 변경 | 예, EHR와 포털 직접 조작 | 사전 승인 작성, 의뢰 상태 업데이트, 시스템 간 데이터 조회 | 잘못된 클릭, 환자 혼동, 오류 전파 |
OpenAI API에서 Computer Use는 주로 Responses API를 통해 구현되며, click, type, scroll, keypress, drag, screenshot 등의 동작을 지원해요. 공식 문서는 두 가지 경로를 소개합니다. 하나는 Computer Tool로, 모델이 구조화된 마우스·키보드 동작을 반환하고 애플리케이션이 이를 실행하는 방식이에요. 다른 하나는 Code Execution으로, 모델이 Playwright, PyAutoGUI 같은 도구를 호출하는 코드를 생성하는 방식이에요. GPT-6 Astra의 경우 현재 공식 문서는 Code Execution 방식을 권장해요. 문서는 또한 모델이 작업 지시를 생성한 것이 작업이 이미 성공했다는 뜻은 아니며, 애플리케이션이 반드시 동작을 실행한 뒤 새 스크린샷 등을 통해 결과를 확인해야 한다고 특히 강조합니다.
OpenAI 의료 Agent의 평가 성적은 무엇을 말해주나요?
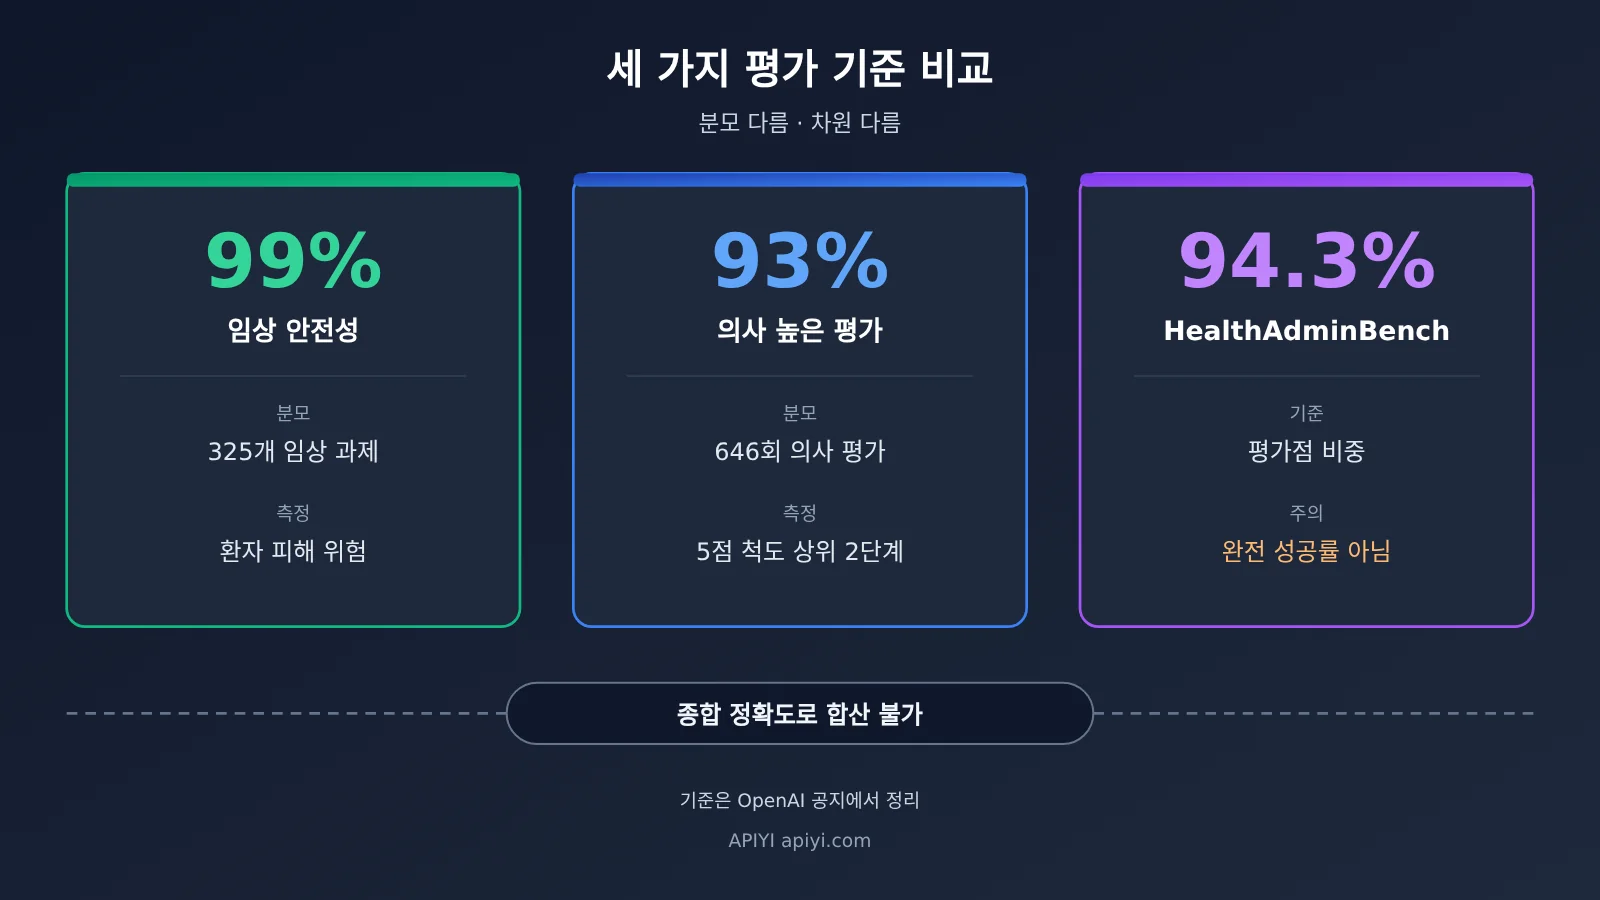
OpenAI가 세 가지 핵심 데이터를 공개했어요. 각각 분모와 평가 차원이 모두 달라서 하나의 “종합 정확도”로 합칠 수 없고, 어느 것도 의학 진단 정확도가 아니에요.
| 지표 | 수치 | 평가 대상 | 분모 / 기준 | 이렇게 해석하면 안 됨 |
|---|---|---|---|---|
| 임상 작업 안전성 | 99% | GPT-6 Astra | 325개 검토된 작업, 오류·누락·조치가 환자 피해를 초래할 수 있는지 평가 | 진단 정확도, 오류 제로 |
| 의사 높은 평가 | 93% | GPT-6 Astra | 의사 평가 646회, 5점 척도에서 Very / Extremely Helpful 합산 비율 | 작업 성공률, 의사 646명 |
| HealthAdminBench | 94.3% | GPT-6 Astra | rubric points 비율, maximum reasoning effort | 전체 작업 성공률 |
| HealthAdminBench | 91.8% | GPT-6 Luna | rubric points 비율, maximum reasoning effort | 전체 작업 성공률 |
| 작업당 비용 | $0.085 | GPT-6 Luna | 특정 평가 조건, Astra보다 98% 낮음 | 프로덕션 배포 가격 |
임상 검토는 마지막에 생성된 텍스트만 보지 않고, Agent가 실제로 실행한 작업, 생성한 의료 기록, 의사 지시, 환자 메시지까지 확인해요. 즉, 평가가 콘텐츠 품질과 소프트웨어 조작 과정을 함께 포괄하는 거죠. 하지만 공식 발표에서는 646회 평가에 대응하는 독립 의사 수를 공개하지 않았고, 공고 본문에도 신뢰 구간, 작업별 결과, 전체 실패 사례가 없었어요.
HealthAdminBench는 스탠퍼드 Shah Lab이 제안한 의료 행정 Agent 벤치마크예요. 논문 2604.09937v1에 따르면 이 벤치마크는 135개 작업과 1698개 하위 작업으로 구성되며, 그중 1177개 하위 작업은 결정론적 판정을, 521개는 모델 심사를 사용해요. 논문에서 전체 작업 성공률이 가장 높은 것은 Claude Opus 4.6 CUA로 36.3%였고, 하위 작업 성공률이 가장 높은 것은 GPT-5.4 CUA로 82.8%였어요. 초기 Shah Lab 웹 버전은 70개 작업, 947개 채점 포인트였고, 당시 보고된 전체 작업 성공률 최고치는 22.9%였어요. 이는 역사적 대조로 활용할 수 있어요.
이 숫자들은 서로 다른 버전, 모델, 날짜, 실행 조건, 지표에 속해서 하나의 순위표로 묶을 수 없어요. OpenAI의 94.3%는 rubric points 기준이고, 논문의 36.3%는 엔드투엔드 전체 작업 성공률이에요. 두 수치의 격차 자체가 보여주는 것은, 의료 Agent에서 “일부 단계를 맞히는 것”과 “일을 끝까지 완료하는 것”이 크게 다를 수 있다는 점이에요.
CVS, Cigna, Abridge, Ambience는 의료 Agent를 어떻게 도입했을까?
기업 사례마다 성숙도 차이가 아주 큽니다. 아래는 공개적으로 공개된 상태를 기준으로 분류한 것입니다. 여기 나오는 수치는 주로 기업과 OpenAI가 공개한 자료에서 나온 것이고, 언론 보도는 교차 확인 역할을 할 뿐 제3자 감사 결과와 같지는 않아요.
| 기업 | 시나리오 | 공개 상태 | 핵심 사실 |
|---|---|---|---|
| CVS Health | 임상 시스템 간 문서 전송, 의뢰, 전문의 협진 | 프로덕션 워크플로 | 한 주말 동안 몇 달간 쌓인 문서 적체를 정리했고, 또 다른 Agent는 매일 수만 건의 협진 관련 시스템 조작 단계를 처리 |
| Cigna Healthcare | 케어 관리 전의 시스템 간 정보 통합 | 배포 완료 | 케어 담당자는 원래 10개 이상의 시스템을 살펴야 했는데, 개념 정리에서 배포까지 8주가 채 걸리지 않았음 |
| Abridge | 퇴원 장애 요인 조정 | 개발 중 | 의사가 Abridge Assistant를 통해 Agent에 약물 확보와 재가 간호를 병행 조정해 달라고 요청 |
| Ambience Healthcare | 보험 사전 승인 신청 | 거버넌스 방안 시연 | 의무 기록에 모호한 부분이 있으면 멈추고 의사에게 물어보고, 승인을 받은 뒤에만 제출 |
| Assort | 의뢰 클로즈드 루프 | 공식 사례 | API가 의뢰 정보를 기록하고, Computer Use가 Athena 인터페이스에서 상태 업데이트를 마무리 |
CVS가 말한 “수만 번”은 시스템 조작 단계와 관련된 작업량을 가리키는 것이지, 수만 건의 임상 결정을 AI가 혼자 내렸다는 뜻은 아니에요. CVS는 CUA Agent Kit(Apache-2.0 라이선스)도 오픈소스로 공개했는데, 두 단계 아키텍처를 사용합니다. 먼저 Computer-use Agent가 자연어에 따라 워크플로를 탐색하면서 스크린샷, 동작, 목표 위치 같은 Trace 근거를 기록해요. 그다음 Codex Skill이 성공한 경로를 결정론적 코드로 고정하고, 엔지니어 검토를 거쳐 반복 실행합니다. README에 따르면 결정론적 실행 단계에서는 모델 API 키가 필요 없어요.
Assort 사례는 Computer Use의 역할을 잘 보여줍니다. Assort는 이미 Athena API를 통해 의뢰 정보를 의무 기록에 기록할 수 있었지만, 완전한 클로즈드 루프까지는 인터페이스 조작 한 단계가 남아 있었어요. Agent가 Athena 인터페이스에서 직접 의뢰 의사를 선택하고 상세 정보를 입력한 뒤 상태를 Visit Scheduled로 업데이트하면, 이 의뢰는 곧바로 직원의 후속 조치 목록에서 사라집니다. API는 구조화된 작업을 담당하고, Computer Use는 API가 다루지 못한 부분을 채우는 거예요.
의료 Agent는 어떻게 위험을 통제할까요?
OpenAI가 공개한 거버넌스 기능에는 RBAC, 감사 로그, 앱 접근 범위 설정, 핵심 작업 전 인간 승인, 그리고 Agent를 지정된 워크플로 안에 제한하는 제어 메커니즘이 포함돼요. 의료 기관은 언제든지 Agent를 일시 중지하고 단계별 작업 로그를 확인할 수 있어요.
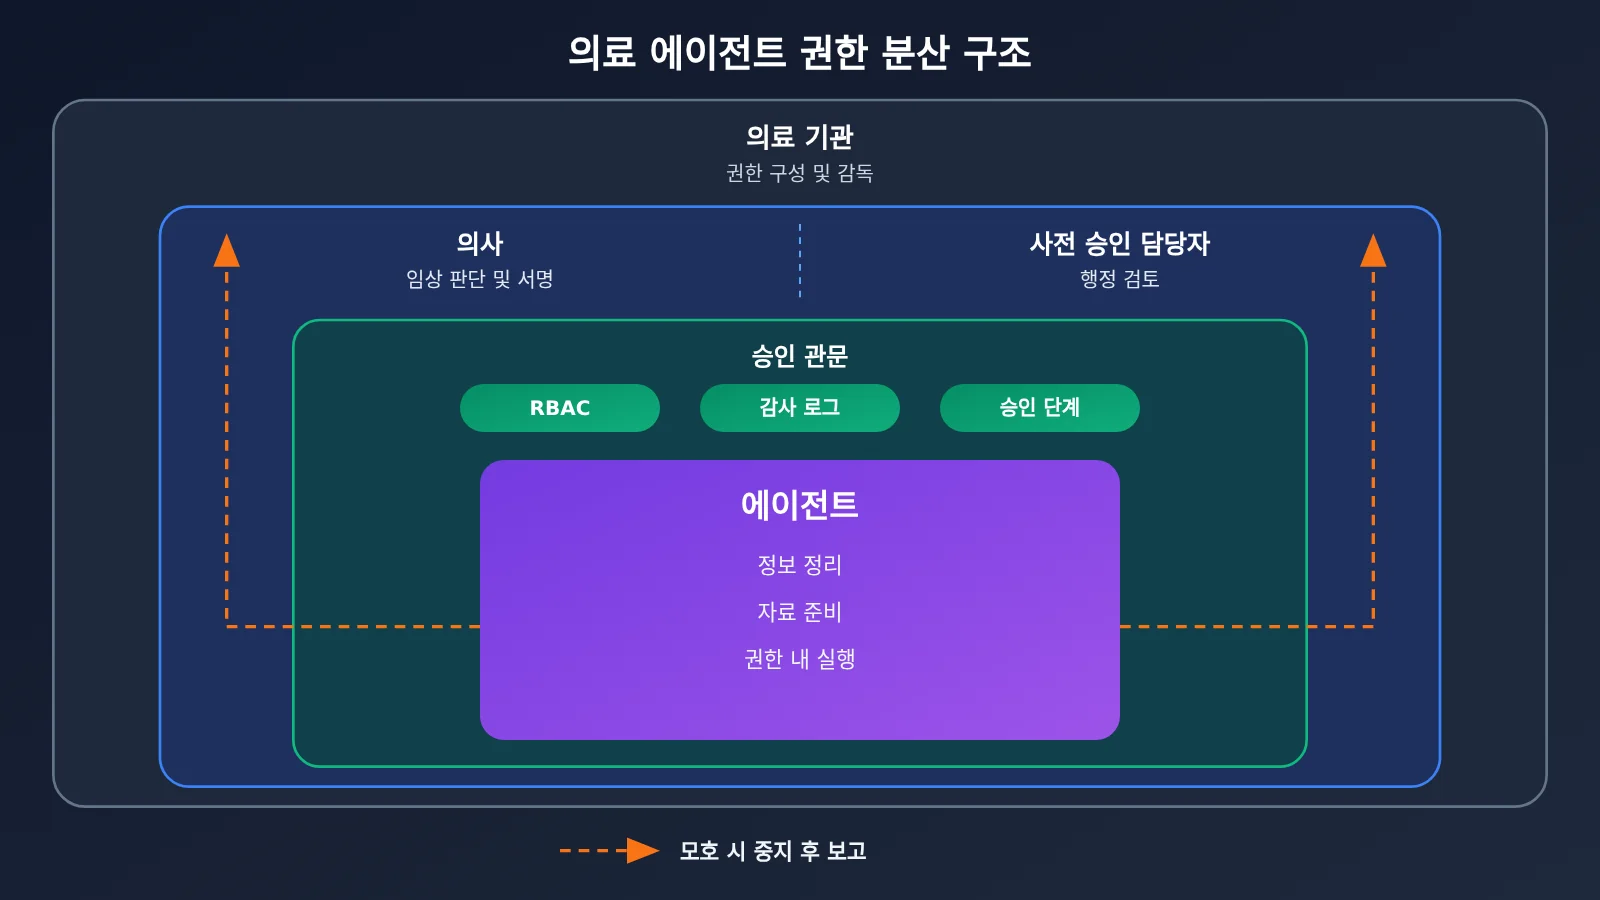
이것은 사실상 권한을 분산하는 설계예요. AI는 정보 정리, 자료 준비, 권한 범위 내 작업 수행을 맡고, 의사는 임상 판단을, 사전 승인 담당자는 행정 심사를, 의료 기관은 권한 설정과 감독 프로세스를 맡아요. Agent의 권한은 임상 책임의 경계와 반드시 일치해야 해요.
데이터 규정 준수 측면에서 OpenAI는 ChatGPT for Healthcare의 조직 데이터가 기반 모델 학습에 사용되지 않는다고 밝혔고, CVS도 관련 운영 데이터가 자사 인프라에 남아 있다고 설명했어요. 다만 PHI가 포함된 HIPAA 준수 워크플로를 지원하려면 의료 기관은 자격을 갖춘 서비스를 사용해야 하고, 해당 서비스가 OpenAI와 체결한 BAA의 적용을 받는지 확인해야 하며, 보안 설정과 데이터 보존 정책을 구성하고, 조직 권한을 통해 Agent가 접근할 수 있는 기록과 작업을 제한해야 해요. 따라서 “HIPAA 워크플로를 지원한다”는 것이 “모든 OpenAI API 호출이 자동으로 규정을 준수한다”는 뜻은 아니에요.
사용 가능한 채널 측면에서는 OpenAI API, ChatGPT for Healthcare, ChatGPT for Clinicians, ChatGPT Work, Codex를 통해 관련 기능을 사용할 수 있어요. 자격을 갖춘 미국 임상 인력은 ChatGPT for Clinicians를 무료로 신청할 수 있는데, 이 무료 정책에는 지역과 자격 제한이 있어요. ChatGPT for Healthcare는 공개된 통일된 고정 구독 가격이 없어요.
분석 판단: 의료 에이전트의 선택과 산업적 의미
왜 의료 업계는 특히 Computer Use형 에이전트가 필요할까요?
의료 서비스의 정보 파편화는 매우 전형적이에요. 한 번의 진료에 EHR, 영상 시스템, 처방 시스템, 보험 포털, 의뢰 시스템, 퇴원 관리 플랫폼이 동시에 관여할 수 있는데, 이런 시스템들은 대개 서로 다른 벤더에서 도입했고 인터페이스도 완전하지 않죠. MRI 사전 승인은 그 축소판이라 할 만해요. 의사는 임상 판단 하나만 했을 뿐인데, 직원은 진료 기록, 물리 치료 기록, 영상 자료, 보험 포털 사이를 오가며 반복해서 전환하고 복사하고 업로드해야 하거든요.
이런 관점에서 보면 Computer Use가 해결하는 것은 “AI가 의학을 이해하는가”가 아니라 “정보가 시스템 사이에서 흐를 수 있는가”예요. 필자의 판단으로는 의료 행정 자동화가 임상 진단 자동화보다 상업적 규모를 더 일찍 형성할 가능성이 커요. 이유는 행정 업무의 양이 많고 반복성이 높으며 경계가 명확해서, 결과를 양식과 시스템 상태로 검증할 수 있고 책임 리스크도 상대적으로 관리 가능하기 때문이죠. Cigna가 10여 개 시스템을 넘나드는 정보 조회를 수 초로 단축한 사례는 바로 이런 “먼저 부담을 덜고, 대체하지는 않는” 경로를 보여줘요.
하지만 스탠퍼드 벤치마크는 진짜 어려운 지점도 드러냈어요. 초기 연구에 따르면 앱 간 데이터 전송과 문서 처리가 에이전트 실패의 중요한 원인이었고, 환자 정보를 이해하더라도 파일 업로드, 필드 입력, 상태 업데이트 단계에서 오류가 날 수 있어요. 의료 현장에서는 한 시스템에서 발생한 오류가 여러 다운스트림 시스템으로 복제될 수도 있는데, 바로 이 때문에 사람의 승인과 작업 후 상태 검증을 생략할 수 없어요.
개발자는 의료 에이전트의 비용과 실현 가능성을 어떻게 평가해야 할까요?
개발자 입장에서 첫 단계가 꼭 Computer Use여야 하는 건 아니에요. 더 안전한 방법은 워크플로를 먼저 나누는 거예요. 정보 추출, 자료 초안 작성처럼 순수 텍스트 단계는 일반 모델 API로 품질을 먼저 검증하고, 인터페이스 조작 단계는 따로 성공률을 평가하세요. 아래 예시는 합성 자료로 “사전 승인에 필요한 필드 추출”이라는 텍스트 단계를 검증하는 기술 시연일 뿐이며, 어떤 진단·치료 권고도 구성하지 않아요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 플랫폼에서 실제로 사용 가능한 모델 목록을 기준으로 합니다
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
토큰 비용 통계가 포함된 전체 코드 보기
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 단가: 달러 / 100만 토큰, 실제 사용하는 모델에 맞게 입력하세요
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 빠른 검증 제안: 의료 시스템에 정식으로 연결하기 전에, APIYI apiyi.com에서 하나의 API 키로 여러 모델의 필드 추출, 자료 초안 작성 등 텍스트 단계 성능을 비교해 볼 수 있어요. 신규 사용자에게는 무료 테스트 쿼터가 있어서 평가 스크립트를 먼저 돌려 보고 작업 단위 데이터를 쌓기에 적합해요.
비용 측면에서, 2026년 11월 17일 기준으로 조회한 Standard 짧은 컨텍스트 가격(달러/백만 토큰)은 다음과 같아요. GPT-6 Astra 입력 10, 출력 50, 캐시 입력 1; GPT-6 Luna 입력 0.10, 출력 0.50, 캐시 입력 0.01이에요. 처리 속도, 컨텍스트 길이, 지역에 따라 실제 과금이 달라질 수 있어요. Luna가 작업당 0.085달러이고 “98% 더 저렴”이라는 비율로 역산하면 Astra는 작업당 약 4.25달러예요. 다만 이건 추정치이고 기준 조건에서의 비용일 뿐, 생산 견적가로 삼을 수는 없어요.
전체 원가 계산은 매 라운드의 비전·텍스트 입력과 과금 출력을 각각 집계하고, 여기에 도구 호출, 실행 환경, 엔지니어링 유지보수를 더해야 해요. 재시도로 발생한 토큰이 이미 총량에 누적됐다면 다시 더하지 마세요. 두 모델 등급 간 가격 차이가 거의 50배라는 점은 계층화 전략도 시사해요. 복잡한 추론은 고성능 모델에, 구조화되고 빈번한 단계는 저비용 모델에 맡기고, 이미 충분히 검증돼 안정된 흐름은 CVS처럼 결정적 코드로 고정하는 거죠.
💰 비용 최적화 팁: 모델 계층화를 할 때는 먼저 APIYI apiyi.com에서 동일한 OpenAI 호환 코드로 가격대가 다른 모델을 전환해 보며, 각 하위 작업 유형의 품질과 토큰 소비량을 측정한 뒤 어떤 단계에 고성능 모델을 쓸 만한지 결정할 수 있어요.
| 검증 단계 | 답해야 할 질문 | 권장 근거 | 참고 도구 |
|---|---|---|---|
| 텍스트 단계 | 추출 및 초안 작성 품질이 안정적인가 | 사람이 라벨링한 결과 대조, NEED_HUMAN 발생률 | APIYI apiyi.com 여러 모델 비교 |
| 인터페이스 조작 | 엔드투엔드 완료율은 얼마인가 | 스크린샷과 Trace, 조작 후 상태 검증 | OpenAI Computer Use 문서 및 샌드박스 환경 |
| 프로세스 고정화 | 어떤 단계를 결정론적 코드로 전환할 수 있는가 | 성공 트레이스 재현율 | CUA Agent Kit류의 2단계 아키텍처 |
| 운영 거버넌스 | 권한과 승인이 핵심 작업을 포괄하는가 | RBAC 구성, 감사 로그 표본 점검 | 기관 자체 권한 및 컴플라이언스 체계 |
의료 Agent와 RPA는 대체일까요, 융합일까요?
전통적인 RPA는 고정된 규칙과 UI 위치 지정에 의존하기 때문에 화면이 조금만 바뀌어도 스크립트가 작동하지 않을 수 있어요. Computer-use Agent는 자연어를 이해하고 현재 화면을 관찰하며 변화에 적응할 수 있지만, 매번 다시 추론하면서 비용과 결과 변동성이 생길 수 있죠. 두 기술을 비교한 연구(DOI: 10.1080/23311975.2026.2724760)에서는 P2, P3 두 프로세스에서 각 기술을 10회씩 실행했어요. P1 프로세스에서는 Agent의 실패 기록이 1건뿐이었고 이후 통계에 포함되지 않았기 때문에, 모든 작업이 10회씩 실행됐다고 일반화할 수는 없어요. 이 연구는 2025년 도구 구성을 사용했기 때문에 2026년 모델의 성과를 그대로 대표한다고 보기는 어려워요.
필자는 CVS의 “AI 탐색, 코드 고정화, 반복 실행”이 주류 엔지니어링 형태가 될 가능성이 더 크다고 생각해요. Agent는 낯선 프로세스를 발견하고 이해하는 역할을 맡고, 결정론적 코드는 이미 아는 프로세스를 안정적으로 반복하는 역할을 맡아요. API는 계속해서 빈도가 높고 구조화된 상호작용을 담당하며, 사람의 승인은 핵심 지점을 지켜요. API, Computer Use, 결정론적 코드, 사람의 승인을 함께 조합하는 것이 어느 한 기술에만 올인하는 것보다 현실적이에요.
의료 Agent가 AI 산업 전체에 의미하는 것
의료는 문턱이 높은 시험장일 뿐이에요. 시스템 파편화, 규제 요건, 책임 경계가 일반 기업보다 훨씬 엄격하죠. 만약 실행형 Agent가 이곳에서 감사 가능하고, 일시 중지가 가능하며, 권한이 정렬된 운영 방식을 확립할 수 있다면, 이 방법론은 보험·금융·공공 행정처럼 똑같이 낡은 시스템에 의존하는 산업으로 이전할 수 있어요.
이는 산업 경쟁의 축이 바뀌고 있다는 뜻이기도 해요. 과거에는 모델이 좋은 콘텐츠를 쓸 수 있는지를 비교했다면, 앞으로는 실제 시스템에서 일을 끝낼 수 있는지, 오류가 났을 때 제때 멈출 수 있는지, 모든 단계를 흔적 없이 추적할 수 있는지를 더 비교하게 될 거예요. 소프트웨어 벤더 입장에서 Computer Use는 AI 기업이 하위 소프트웨어를 완전히 통제하지 않고도 워크플로에 참여할 수 있게 해줘서 통합 문턱을 낮춰주죠. 동시에 “벤더가 인터페이스를 열어주기만 기다린다”는 옛 방식에도 압박을 가해요. 다만 높은 신뢰성과 잦은 상호작용에는 여전히 API가 더 적합하고, Computer Use는 대체자가 아니라 보완자에 가까워요.
앞으로 주목할 만한 몇 가지가 있어요. OpenAI가 작업별 평가 데이터와 전체 실험 구성을 공개할지, HealthAdminBench 논문 버전이 각 사가 통일적으로 비교할 수 있는 기준이 될 수 있을지, Abridge의 퇴원 조정 방안이 개발 단계에서 실제 배포로 넘어갈 수 있을지, 그리고 더 많은 병원의 프로덕션 데이터가 엔드투엔드 완료율이 실제로 쓸 만하다는 것을 입증할 수 있을지요. 이런 증거가 나오기 전까지 데모와 점수는 결론이 아니라 출발점일 뿐이에요.
의료 Agent는 이미 스스로 “행동”할 수 있다는 걸 증명했어요. 하지만 정말로 임상과 행정 부담을 덜어줄 수 있을지는 실제 워크플로에서의 엔드투엔드 완료율, 오류 시 정지 능력, 장기 비용에 달려 있어요. 영어 속담 하나가 딱 들어맞죠. The proof of the pudding is in the eating.(실제 효과는 실천으로 검증해야 한다.)
참고 자료
- OpenAI 공식 공지: Advancing computer-use agents for healthcare teams
- 링크:
openai.com/index/advancing-computer-use-for-healthcare-teams
- 링크:
- ChatGPT for Healthcare 도움말 문서: 제품 기능, BAA 및 플러그인 설명
- 링크:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- 링크:
- OpenAI Computer Use 개발 문서: Computer Tool 및 Code Execution 경로
- 링크:
developers.openai.com/api/docs/guides/tools-computer-use
- 링크:
- HealthAdminBench 논문: 2604.09937v1 버전의 과제 및 지표
- 링크:
arxiv.org/html/2604.09937v1
- 링크:
- CVS Health CUA Agent Kit: 2단계 탐색 및 고정 아키텍처
- 링크:
github.com/cvs-health/cua-agent-kit
- 링크:
- Fierce Healthcare 보도: HLTH26 협력사 및 적용 시나리오
- 링크:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- 링크:
- Cambridge Dictionary: 속담 원문 확인
- 링크:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- 링크:
작성자: APIYI 기술팀
기술 교류: 여러 대규모 언어 모델의 Agent 텍스트 단계 성능을 비교해 보고 싶다면 APIYI apiyi.com을 방문해 테스트 크레딧을 받아 보세요. 더 많은 연동 안내는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.