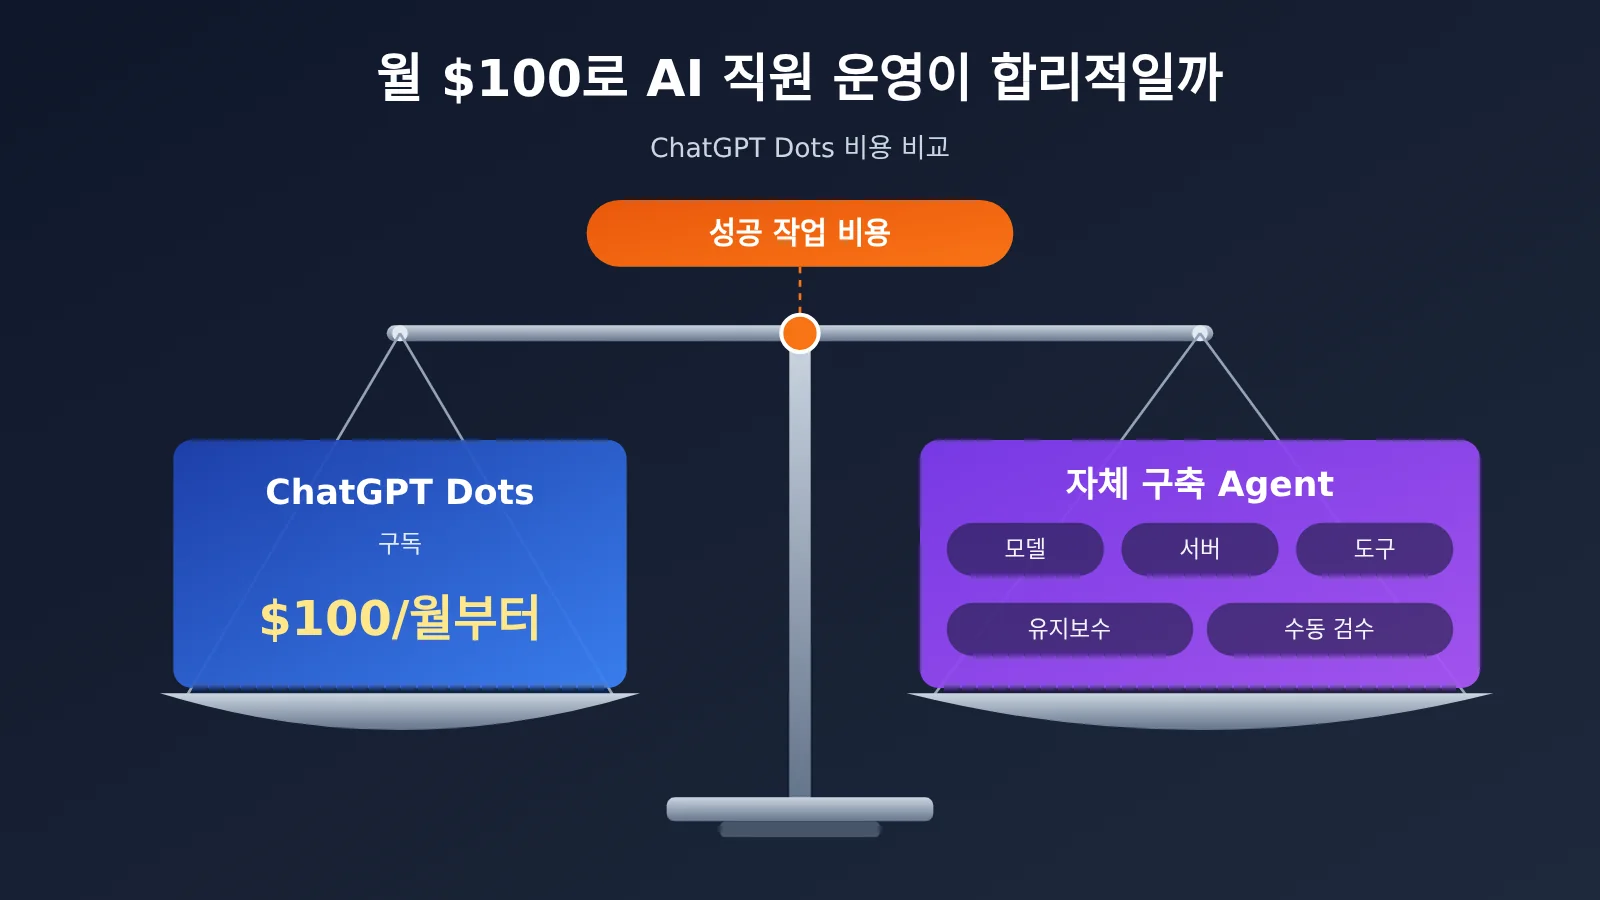
작성자 주: 동일한 결과물 기준에서의 성공 태스크 비용을 가지고, ChatGPT Dots 구독과 자체 구축 Agent가 모델, 인프라, 유지보수, 인적 검토에 쓰는 비용을 비교합니다.
핵심 결론: ‘매달 100달러를 들여 AI 직원 한 명을 운영하는 것’이 합리적인지는 같은 결과물 기준 아래에서 적격 태스크 하나를 완료하는 총비용을 봐야 알 수 있으며, 월 구독료와 Token 단가는 그 일부일 뿐입니다. 2026년 11월 16일 공식 자료에 따르면, 개인 사용자가 ChatGPT Dots를 쓰는 진입 기준은 Pro 100($100/월)이며, 구독에는 클라우드 컴퓨터, 장기 컨텍스트, 태스크 조정, 앱 연결이 묶여 있습니다. 하나의 가정 표본에서 자체 구축 Agent가 월 300회 태스크를 처리할 때 모델 비용은 약 $33~$66이지만, 여기에는 서버, 도구, 개발·유지보수, 실패 재시도, 인적 검토가 아직 포함되지 않았습니다. 어느 경로가 더 저렴한지는 같은 묶음의 태스크로 실측한 뒤에야 결론을 낼 수 있습니다.
이 글에서는 먼저 Dots 구독의 가격 산정 기준과 기능 범위를 뜯어보고, 자체 구축 Agent 비용을 모델, 인프라, 도구, 개발, 유지보수 다섯 가지로 나눈 다음, APIYI의 Claude 가격으로 단일 태스크 Token 비용 계산법을 보여 드립니다. 이어서 Dots, 단일 모델 Agent, 다중 모델 Agent를 여섯 가지 차원으로 비교하고 ‘성공 태스크 비용’을 핵심으로 하는 대조 실험 방법을 제시합니다. 마지막으로 개인 사용자, 헤비 개발자, 기업 세 가지 요구에 맞춘 선택 제안을 드리고, 구독과 API를 혼합 사용하는 비용 관리 방식을 소개합니다.
To Know: AI 직원 비용을 이해하는 8가지 용어
| 용어 | 설명 |
|---|---|
| Pro 구독 | 월 단위로 결제하는 ChatGPT 요금제로, 해당 권한과 사용 할당량을 포함하며 Pro 100, Pro 200, Pro 500 모두 Dots를 사용할 수 있어요 |
| Dot | ChatGPT Dots의 상주형 개인 Agent로, 자체 클라우드 컴퓨터와 브라우저를 갖고 있어 위임된 작업을 지속적으로 진행할 수 있어요 |
| Token | 모델이 입력과 출력 콘텐츠를 측정하는 단위로, API는 백만 Token당 가격을 책정해요 |
| 캐시 읽기 | 요청에서 반복되는 프리픽스 콘텐츠(예: 시스템 프롬프트, 도구 정의)가 기존 처리 결과를 재사용하며, 단가는 일반 입력보다 훨씬 낮아요 |
| 캐시 쓰기 | 재사용 가능한 프리픽스를 처음 저장해 이후 요청에서 읽을 수 있게 하며, 과금 규칙은 플랫폼 콘솔을 기준으로 해요 |
| 인프라 비용 | 자체 Agent를 구축하는 데 필요한 서버, 컨테이너, 데이터베이스, 스토리지, 실행 환경 비용이에요 |
| 작업 성공률 | 통일된 검수 기준에 따라 한 번 또는 여러 번 실행한 뒤 합격으로 인도된 작업의 비율이에요 |
| 성공 작업 비용 | 전체 실행(실패 재시도 포함), 인프라, 인적 검토의 총지출을 합격으로 인도된 작업 수로 나눈 값이에요 |
1 매월 100달러짜리 ChatGPT Dots로 무엇을 얻을 수 있을까
1.1 ChatGPT Dots의 개인 Pro 및 기업 가격 기준
ChatGPT Dots는 2026년 9월 29일 OpenAI가 정식 출시했어요. 상시 상주형 개인 AI 에이전트를 지향하며, 사용자가 목표를 위임하면 Dot은 사용자가 자리를 비우거나 컴퓨터가 꺼져 있는 동안에도 클라우드에서 작업을 계속 진행하고, 의사결정이 필요할 때 다시 사용자에게 작업을 넘겨요.
Dots 가격을 이야기할 때는 개인 Pro와 기업용 Dot을 반드시 나눠서 봐야 해요. 아래 표는 OpenAI 공식 도움말 문서를 바탕으로 정리한 것이며, 검색 기준일은 2026년 11월 16일이에요.
| 적용 대상 | 비용 기준 | 적용 조건 | 별도 과금 부분 |
|---|---|---|---|
| ChatGPT Pro 100 | 월 $100 | 만 18세 이상, 유럽경제지역·영국·스위스 제외, 순차 출시 | 위임된 Work/Codex 작업은 해당 제품의 할당량을 소모 |
| ChatGPT Pro 200 | 월 $200 | 위와 동일 | 위와 동일 |
| ChatGPT Pro 500 | 월 $500 | 위와 동일 | 위와 동일 |
| Enterprise 워크스페이스 | 작업 유형별 고정 요금 또는 사용량 기준 과금, 금액은 워크스페이스 계약 또는 견적 기준 | 2026-11-04~11-18은 무료 관리자 프리뷰 기간이며, 11-18부터 활성화된 Dot에 과금 시작, 멤버당 개인 Dot 1개 생성 가능 | Work 또는 Codex로 위임된 작업은 해당 기준에 따라 별도 청구 |
개인 Pro의 Dots 안내에는 별도의 월간 Dot 구독료가 명시되어 있지 않으며, Pro 월 요금이 곧 사용을 위한 최소 조건이에요. OpenAI는 Dot을 통해 위임한 ChatGPT Work 또는 Codex 작업이 해당 제품의 할당량 규칙에 따라 계산된다고 설명했어요. 소모량은 모델, 컨텍스트, 추론, 도구 호출, 검색 등의 요소에 따라 달라져요. 따라서 월 $100은 일정한 한도가 있는 사용 할당량에 해당하며, 공식 자료에서도 개인 Pro의 Dot 심층 작업이 몇 개의 작업에 해당하는지는 공개하지 않았어요.
1.2 Dots 구독에 포함된 AI 직원 역량
Dots와 API 호출을 나란히 놓고 비교하면 ‘모델’ 하나만 쳐다보기 쉬워요. 실제로 구독에는 실행 환경 전체가 패키징되어 있어서, 직접 구축할 때는 이 모든 걸 스스로 구현해야 하죠.
- 클라우드 컴퓨터와 브라우저: 각 Dot은 자신만의 클라우드 컴퓨터를 갖고 있어 웹사이트를 열고, 문서를 정리하고, 보고서를 만들 수 있으며, 사용자는 언제든지 확인하고 조작을 넘겨받을 수 있어요.
- 장기 컨텍스트: ChatGPT Memory, Dot 자체 노트, 현재 작업 자료, 그리고 이미 권한을 부여한 앱의 데이터를 결합해요.
- 다중 프로젝트 조정: 복잡한 작업을 분할하고, 백그라운드 연구 Agent를 병렬로 실행하며, 결과를 종합하고, 막힐 때 사용자 개입을 요청해요.
- 지속 작업 모드: 정기 작업과 이벤트 모니터링을 지원해요. 예를 들어 매주 경쟁사를 점검하거나 Slack에 올라오는 새 버그를 감시하는 식이죠.
- 능동 연구: 새 메시지가 없을 때 권한을 부여한 데이터 소스를 연구하는데, 이 과정은 읽기 전용이며 후속 행동은 정상적인 승인 절차를 거쳐야 해요.
- 앱 연결과 커뮤니케이션 채널: 출시 당시 공식 설명에 따르면 연결 가능한 플러그인 생태계가 4,000개 이상의 앱을 포함하며, ChatGPT, Slack, Microsoft Teams 등의 채널로 연락할 수 있어요.
- 권한과 보안 메커니즘: Custom Rules로 실행 경계를 설정하고, Auto-review가 이메일 발송 같은 작업 전에 점검하며, 비밀번호 변경이나 자금 이체 같은 작업은 반드시 사용자가 직접 넘겨받아야 해요.
제3자 실측은 역량의 경계를 가늠할 참고점을 줬어요. Axios가 2026년 10월 20일 진행한 테스트에서 Dots는 38페이지 분량의 WNBA 기념 프로그램 책자를 만들었고, 47초 만에 12페이지의 사진 기념 앨범을 생성했어요. 하지만 프로그램 책자에는 의심스러운 통계 수치가 등장했고, 쇼핑 단계 역시 사용자가 Target 앱으로 직접 이동해 완료해야 했어요. 저자의 결론은 이렇습니다. 이런 Agent는 연구와 준비 작업을 맡기에 적합하지만, 결과물은 여전히 사람이 편집하고 팩트 체크해야 한다는 거예요. 이 결론은 뒤에서 다룰 비용 모델에 인간 검토가 반드시 포함되어야 한다는 점을 곧바로 결정지어요.
2 자체 구축 AI 직원 Agent의 전체 비용
2.1 자체 구축 Agent의 다섯 가지 비용
API로 지속적으로 일하는 Agent를 만들면 청구서가 모델 호출에서 끝나지 않아요. 비용은 다섯 가지로 나눠볼 수 있어요.
- 모델 비용: 입력, 출력, 캐시 읽기/쓰기, 추론 소비에 들어가는 비용으로, 작업량에 따라 선형으로 변해요.
- 인프라 비용: 클라우드 서버, 컨테이너, 데이터베이스, 스토리지처럼 일부는 고정 월 요금이고 일부는 부하에 따라 달라지는 비용이에요.
- 도구 비용: 검색 API, 헤드리스 브라우저, 서드파티 데이터 인터페이스 등 보통 호출 횟수로 과금되는 비용이에요.
- 개발 비용: 최초 개발, 시스템 통합, 권한 설계처럼 초기에 집중되는 투자예요.
- 유지보수 비용: 모니터링과 알림, 장애 대응, 모델 업그레이드 후의 회귀 테스트처럼 계속 발생하는 비용이에요.
이를 공식으로 쓰면 이렇게 돼요.
$$C_{self}=C_{API}+C_{infra}+C_{tools}+C_{dev}+C_{maintenance}$$
구독 경로의 비용 구조는 이래요.
$$C_{subscription}=C_{plan}+C_{extra\ usage}+C_{human\ review}$$
두 경로 모두 사람의 시간을 반드시 포함해야 해요. 자체 구축 경로에서는 개발, 유지보수, 검토에 사람의 시간이 분산되고, 구독 경로에서는 주로 작업 위임, 결과 확인, 승인에 사람의 시간이 들어가요.
2.2 자체 구축 AI 직원 Agent의 설계안
아래는 비용 산정에 쓰는 설계안이에요. 자체 구축 Agent에 어떤 구성 요소가 필요한지 설명하기 위한 것이고, 각 구성 요소의 비용은 실제로 선택한 클라우드 서비스 견적을 넣어 주세요. 이 글에서는 이 설계안을 실제로 배포해 검증하지는 않았어요.
- 스케줄링 계층: 정기 트리거나 메시지 큐로, “매일 아침 8시에 정보를 생성한다” 같은 주기 작업을 담당해요.
- 오케스트레이션 계층: Agent 프레임워크가 단계를 계획하고 도구를 호출하며 중간 상태를 저장해요(예: LangGraph의 Checkpointer나 OpenAI Agents SDK의 워크플로).
- 모델 계층: OpenAI 호환 인터페이스로 모델을 호출하고, 작업 난이도에 따라 서로 다른 모델로 라우팅해요.
- 도구 계층: 검색, 웹 페이지 수집, 헤드리스 브라우저, 파일 생성이에요.
- 상태 계층: 데이터베이스에 작업 기록, 장기 노트, 중복 제거 정보를 저장해요.
- 승인 계층: 외부 발송, 결제, 삭제와 관련된 작업은 사람의 승인 대기열로 들어가요.
- 관측 계층: 매 호출의 Token, 소요 시간, 실패 원인을 기록해 비용 산정의 데이터 소스로 삼아요.
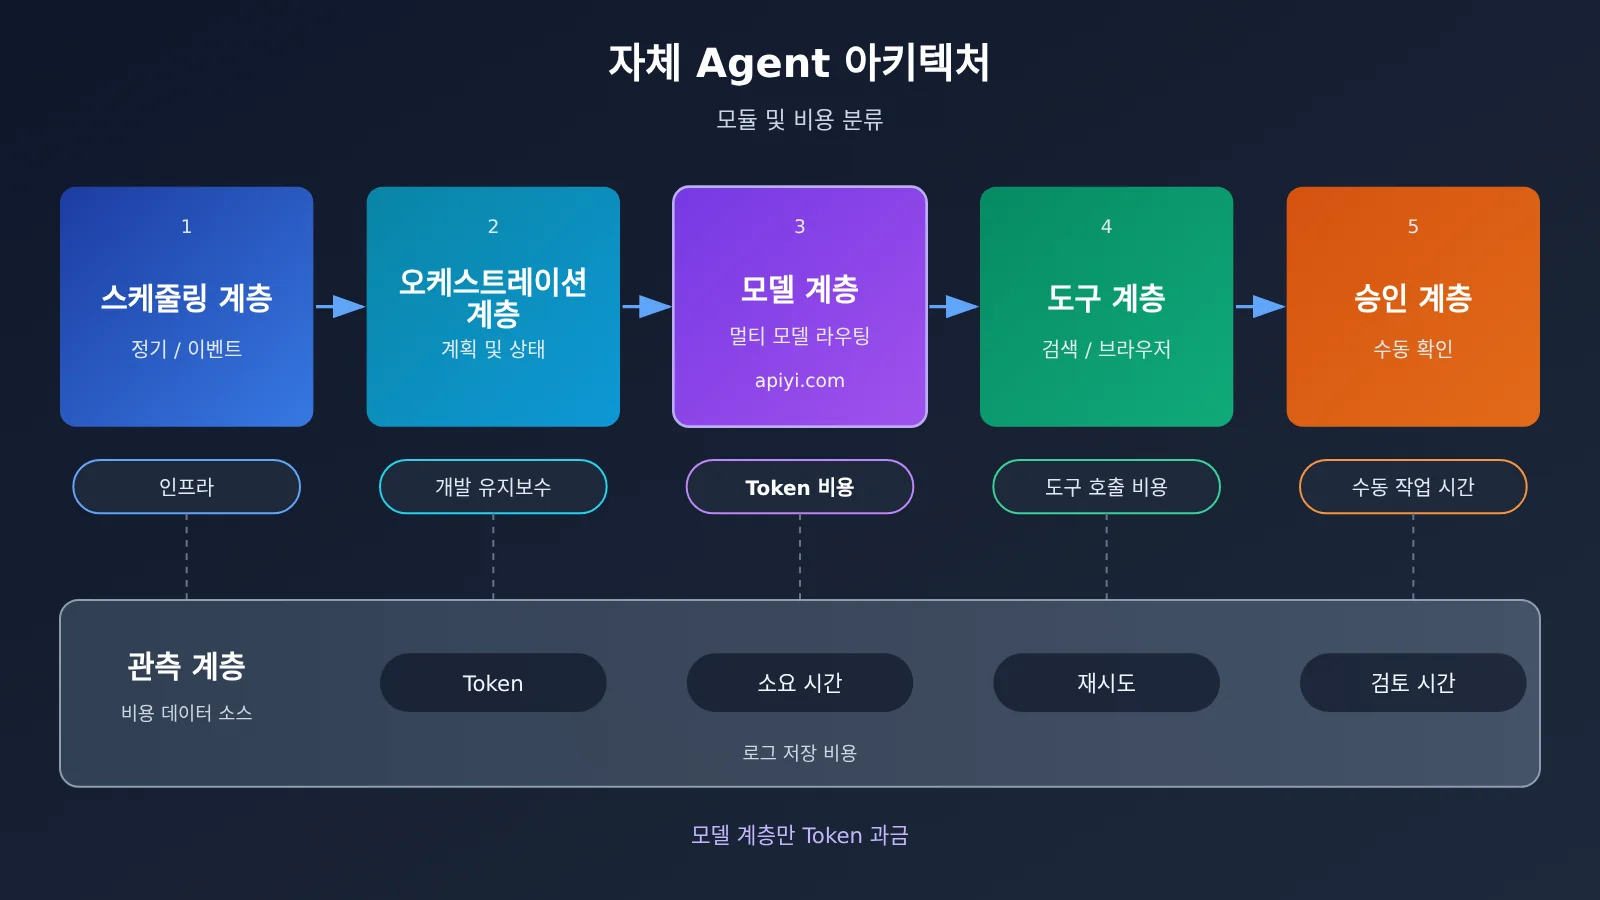
이 그림에 해당하는 일곱 가지 구성 요소 가운데 모델 계층의 비용만 Token 가격으로 바로 계산할 수 있어요. 나머지 구성 요소의 비용은 아키텍처 선택과 팀 역량에 달려 있어요. 그래서 Token 비용이 자체 구축 비용의 일부만 나타낼 수밖에 없는 거예요.
3 AI 직원 작업 하나에 Token은 얼마나 소모될까
3.1 입력, 출력, 캐시의 과금 차이
Agent의 한 작업은 보통 여러 차례의 모델 호출로 구성돼요. 계획을 한 번 세우고, 도구를 호출할 때마다 다시 추론하고, 마지막에 결과를 정리하죠. 매 차례마다 시스템 프롬프트, 도구 정의, 이전 단계의 기록을 다시 입력으로 보내기 때문에, Agent의 입력 Token은 출력 Token보다 훨씬 큰 경우가 많아요.
바로 이 지점에서 캐시가 힘을 발휘해요. 시스템 프롬프트와 도구 정의는 여러 차례 호출되는 동안 변하지 않기 때문에, 캐시에 적중하면 캐시 읽기 가격으로 과금되고, 단가는 일반 입력의 약 1/20 수준이에요. 캐시 쓰기는 프리픽스를 처음 저장할 때 발생하며, 그 가격은 플랫폼 콘솔 기준을 따르고, 이 글의 예시에서는 계산에 포함하지 않았어요.
3.2 APIYI 가격으로 단일 작업 모델 비용 계산하기
아래 가격은 APIYI가 2026년 11월 13일에 공개한 Claude 모델 가격이며, 실제로는 호출 시점의 콘솔과 모델 목록을 기준으로 해요. 작업 사용량은 알고리즘을 시연하기 위한 가상 샘플이에요. 각 작업은 입력 30,000 Token, 출력 5,000 Token이고, 월 300개 작업을 가정했어요. 이 샘플은 Dots나 어떤 플랫폼의 실제 평균 사용량과도 무관해요.
| 계산 항목 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| 입력 가격 / 출력 가격 / 캐시 읽기 가격 (백만 Token당) | $4 / $20 / $0.20 | $2 / $10 / $0.10 |
| 단일 작업 비용(캐시 없음) | 30,000×$4/10⁶ + 5,000×$20/10⁶ = $0.22 | 30,000×$2/10⁶ + 5,000×$10/10⁶ = $0.11 |
| 300개 작업 월 비용(캐시 없음) | $66 | $33 |
| 단일 작업 비용(입력 Token 20,000개가 캐시 읽기에 적중한다고 가정) | $0.04 + $0.004 + $0.10 = $0.144 | $0.02 + $0.002 + $0.05 = $0.072 |
| 300개 작업 월 비용(캐시 읽기 가정 포함) | $43.2 | $21.6 |
| 사용 가능 플랫폼 | APIYI, 공식 API | APIYI, 공식 API |
이 가정에서는 순수 모델 비용이 Pro 100의 월 $100 요금보다 낮아요. 이 결과는 모델 계층이 저렴하다는 것만 보여줄 뿐, 인프라, 도구, 개발·유지보수, 인적 검토를 포함하지 않았고, 실패로 인한 재실행도 고려하지 않았어요.
3.3 코드로 AI 직원 작업의 실제 토큰 사용량 기록하기
비용 산정에서는 가정값을 실제 사용량으로 대체해야 해요. 아래의 아주 간단한 예제는 모델을 한 번 호출하고, 반환된 usage 필드를 읽어 와요:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="claude-sonnet-5.5",  # APIYI 모델 목록에 있는 실제 이름을 기준으로 합니다
    messages=[{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}]
)
print(resp.usage)  # 입력·출력 토큰 수, 비용 산정에 사용
전체 구현 보기: 매 실행을 기록하고 성공 과제 비용 계산하기
import time
import openai
from dataclasses import dataclass, field

# 백만 토큰당 가격(달러), 호출 시점의 콘솔 기준
PRICES = {
    "claude-opus-5.5":   {"input": 4.0, "output": 20.0, "cache_read": 0.20},
    "claude-sonnet-5.5": {"input": 2.0, "output": 10.0, "cache_read": 0.10},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class RunRecord:
    task_id: str
    model: str
    input_tokens: int
    output_tokens: int
    cached_tokens: int
    seconds: float
    cost: float
    passed: bool = False          # 통일된 검수 기준에 따라 수동 판정
    review_minutes: float = 0.0   # 수동 검토 및 수정 시간

@dataclass
class Ledger:
    runs: list = field(default_factory=list)

    def call(self, task_id: str, model: str, messages: list) -> str:
        start = time.time()
        resp = client.chat.completions.create(model=model, messages=messages)
        usage = resp.usage
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        p = PRICES[model]
        uncached_input = usage.prompt_tokens - cached
        cost = (uncached_input * p["input"]
                + cached * p["cache_read"]
                + usage.completion_tokens * p["output"]) / 1_000_000
        self.runs.append(RunRecord(task_id, model, usage.prompt_tokens,
                                   usage.completion_tokens, cached,
                                   time.time() - start, cost))
        return resp.choices[0].message.content

    def cost_per_success(self, hourly_rate: float, fixed_cost: float = 0.0) -> float:
        """(전체 실행 비용 + 고정 비용 + 검토 인건비) / 합격 과제 수"""
        api = sum(r.cost for r in self.runs)
        review = sum(r.review_minutes for r in self.runs) / 60 * hourly_rate
        passed_tasks = {r.task_id for r in self.runs if r.passed}
        if not passed_tasks:
            return float("inf")
        return (api + fixed_cost + review) / len(passed_tasks)

ledger = Ledger()
text = ledger.call("news-1116", "claude-sonnet-5.5",
                   [{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}])
ledger.runs[-1].passed = True
ledger.runs[-1].review_minutes = 8
print(ledger.cost_per_success(hourly_rate=30, fixed_cost=0))
🚀 빠른 시작 팁: 비용 비교 실험을 할 때는 먼저 APIYI apiyi.com에서 같은 API 키로 Opus와 Sonnet을 각각 호출해 보세요. 위의 Ledger를 여러분의 Agent에 연결하고 일주일 동안 실제 작업을 돌린 다음 장부를 확인하면 돼요. 플랫폼은 사용량 기반 과금이고 신규 사용자에게는 무료 테스트 크레딧이 제공되니, 개발에 투입되기 전에 실제 토큰 데이터를 먼저 확보하기에 좋아요.
4. AI 직원 비용은 왜 모델에 따라 격차가 벌어질까
3절의 가정 샘플을 보면, Opus 5.5의 작업당 모델 비용은 Sonnet 5.5의 두 배였죠. 이 열만 놓고 보면 Sonnet이 매달 $33을 아낄 수 있어요. 하지만 Agent 작업의 최종 비용은 성공률과 사람의 검수에도 좌우돼요. 아래에서는 가정 파라미터 한 세트로 그 영향을 짚어볼게요.
Opus의 한 번 실행 합격률이 90%, Sonnet이 60%라고 가정하고, 합격하지 못한 작업은 합격할 때까지 다시 돌린다고 해봐요. 기댓값으로 계산하면 합격 작업 하나당 모델 비용은 각각 $0.22÷0.9 ≈ $0.24, $0.11÷0.6 ≈ $0.18 정도예요. 성공률 격차가 이미 단가 우위의 상당 부분을 잡아먹은 셈이죠.
사람의 시간이 미치는 영향은 더 커요. 검수 인력의 시급을 $30으로 환산하면 1분당 인건비가 약 $0.5라고 가정해볼게요. Sonnet의 출력이 작업당 평균 1분만 더 수정이 필요해도, 늘어난 $0.5가 두 모델의 단가 차이 전체를 넘어서요. 데이터를 하나하나 대조해야 하는 정보나 보고서류 작업은 검수 시간이 분 단위로 늘어나기 마련이라, 이럴 때는 더 안정적인 모델을 택하는 게 오히려 총비용을 낮춰줘요.
반대로 형식이 고정돼 있고 자동 검증이 쉬운 단순 작업(분류, 요약, 필드 추출 등)은 저가 모델의 성공률이 고가 모델과 비슷할 수 있어요. 이런 작업에는 Sonnet이나 더 저렴한 모델을 쓰는 편이 합리적이죠. 다만 두 방향 모두 실제 작업으로 성공률을 측정해 본 뒤에야 판단이 굳어져요.
5 Dots, 단일 모델 Agent, 멀티 모델 Agent의 AI 직원 6차원 비교
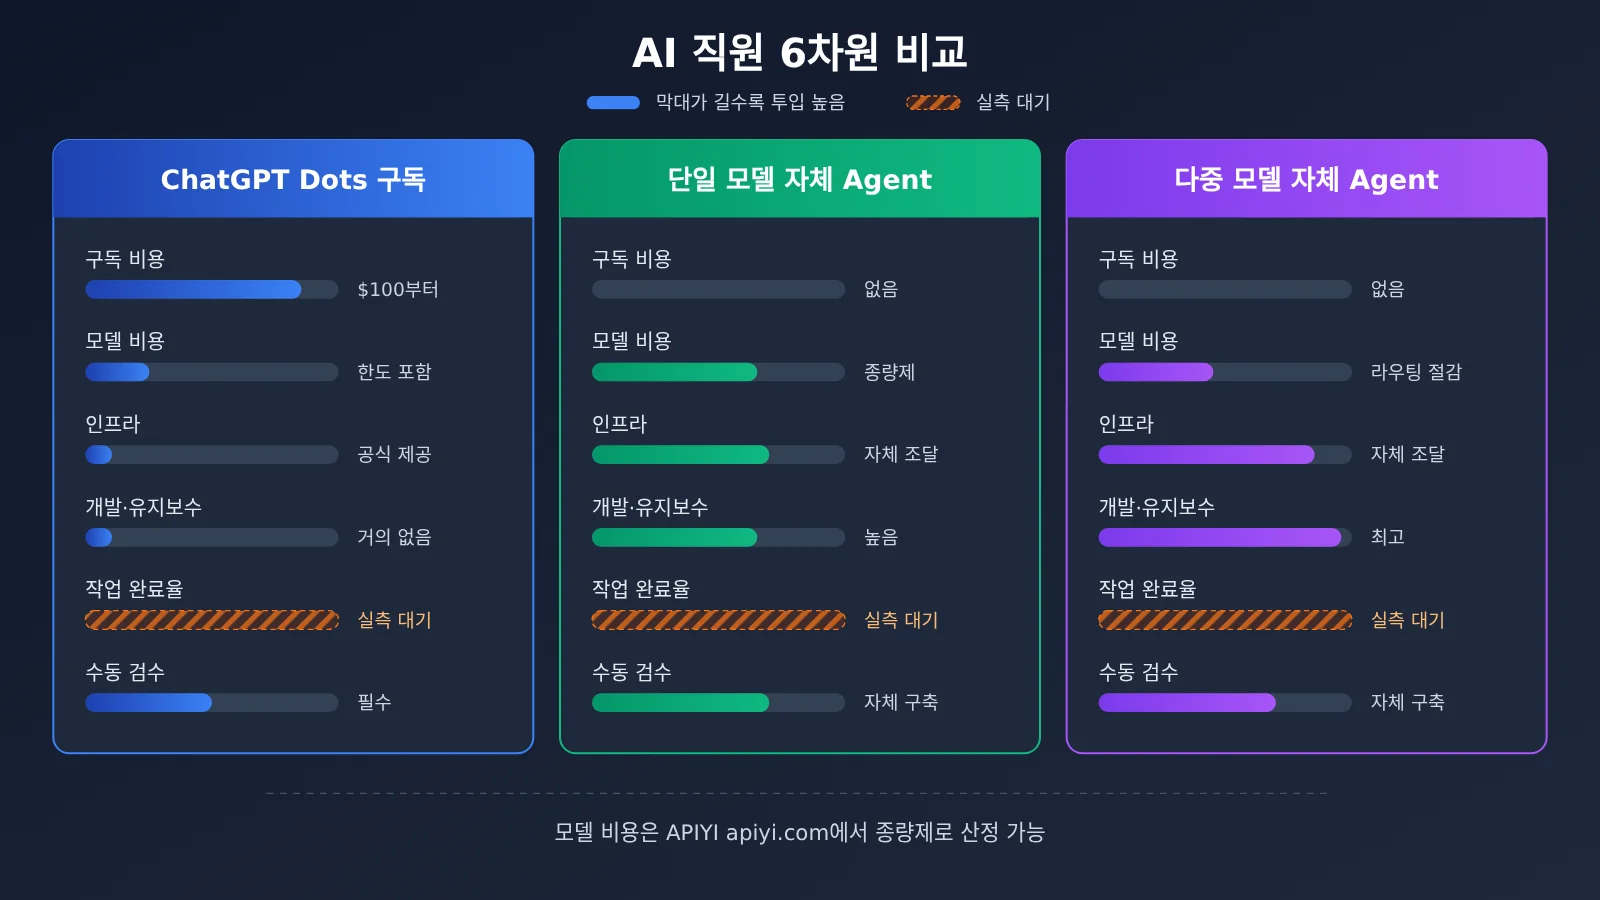
| 차원 | ChatGPT Dots | 단일 모델 Agent(자체 구축) | 멀티 모델 Agent(자체 구축) |
|---|---|---|---|
| 구독 비용 | 개인 Pro 월 $100부터, 기업은 계약 기준 | 없음 | 없음 |
| 모델 비용 | 구독 할당량에 포함되며, Work/Codex에 위임하면 별도 할당량으로 계산 | Token 기준 과금, 작업량에 따라 선형 증가 | Token 기준 과금, 난이도 라우팅으로 평균 단가를 낮출 수 있음 |
| 인프라 | 공식적으로 클라우드 컴퓨터와 브라우저 제공 | 서버, 데이터베이스, 브라우저 환경 자체 준비 | 단일 모델과 동일하나 라우팅 및 평가 로직 추가 필요 |
| 개발 및 유지보수 | 거의 개발 없이 규칙과 권한 설정 중심 | 초기 개발 투자 높음, 지속 유지보수 필요 | 개발 및 유지보수 복잡도 최고 |
| 작업 완료율 | 자체 작업으로 실측 필요, 서드파티 테스트 결과 여전히 사람 검토 필요 | 모델과 엔지니어링 품질에 따라 달라, 실측 필요 | 라우팅 전략에 따라 달라, 실측 필요 |
| 사람 검토 | 필수, Auto-review 및 승인 메커니즘 보조 | 필수, 승인 흐름 자체 구축 필요 | 필수, 승인 흐름 자체 구축 필요 |
| 모델 연동 | OpenAI 제품에 내장 | APIYI 통합 인터페이스로 연결 가능 | APIYI 하나의 Key로 여러 모델 호출 가능 |
Dots 비교 분석: Dots는 별도 설정 없이 바로 사용할 수 있는 점, 앱 간 협업, 장기 컨텍스트에서 뚜렷한 강점을 보여요. 클라우드 컴퓨터, 4,000+ 앱 생태계, 다채널 커뮤니케이션 모두 개발이 필요 없죠. 한계는 할당량 규칙이 작업 횟수 수준까지 투명하게 공개되지 않고, 실행 로직을 깊이 커스터마이징할 수 없으며, 개인 Pro는 지역 및 연령 제한도 적용된다는 점이에요.
단일 모델 Agent 비교 분석: 비용 구조가 가장 명확하고, 호출할 때마다 Token과 비용을 정확히 기록할 수 있으며, 실행 로직을 완전히 통제할 수 있어요. 대신 브라우저, 스케줄링, 상태, 승인을 직접 구축해야 하고, 작업 완료율은 전적으로 팀의 엔지니어링 역량에 달려 있어요.
멀티 모델 Agent 비교 분석: 간단한 단계는 저가 모델에, 핵심 추론은 강한 모델에 맡겨서 작업량이 많을 때 성공한 작업당 비용을 낮출 기회가 가장 커요. 평가 체계에 대한 요구가 가장 높아서, 각 모델이 각 단계 유형에서 보이는 성공률을 지속적으로 모니터링해야 해요.
6 성공 작업 비용으로 AI 직원의 가성비 따져보기
6.1 성공 작업 비용과 ROI 공식
측정 기준을 하나로 통일하면 다음과 같아요:
$$C_{successful\ task}=\frac{C_{all\ runs}+C_{infrastructure}+C_{review}}{N_{successfully\ completed\ tasks}}$$
분자에는 모든 실행(실패와 재시도 포함), 해당 주기에 배분된 인프라 비용, 사람의 검수 비용이 들어가고, 분모는 오직 ‘합격’으로 인도된 작업만 셉니다. Dots의 경우 분자의 ‘실행 비용’을 구독 월 요금과 추가 사용량으로 바꿔 넣으면 돼요.
이를 바탕으로 투입 대비 산출 비율(ROI)도 계산할 수 있어요:
$$ROI=\frac{V_{time\ saved}-C_{total}}{C_{total}}$$
시간 절감은 사람이 원래 그 작업을 완료하는 데 걸리던 실제 시간에 합리적인 인건비를 곱해서 구해야 해요. 모델이 몇십 초 만에 문서 한 부를 만들어 내는 건 어디까지나 생성 속도일 뿐이고, 절감된 인적 시간에서는 검토하고 수정하는 부분을 빼야 해요.
6.2 세 가지 작업 유형으로 AI 직원 비용 비교 실험
대표적인 상시 작업 세 가지를 골라 보는 걸 권해요: 매일 AI 뉴스 정보 수집, 매주 경쟁사 모니터링, 매월 자료 분석 보고서요. 동일한 입력 자료와 동일한 인도 기준으로 각각 ChatGPT Dots, APIYI + 단일 모델 Agent, APIYI + 다중 모델 Agent에 맡겨 실행하고, 매 실행마다 아래 항목을 기록해요:
| 기록 항목 | 기록 방법 | 용도 |
|---|---|---|
| 시작 및 완료 시간 | 작업 로그 타임스탬프 | 실제 인도 주기 계산 |
| 모델 호출 횟수 | 오케스트레이션 계층 카운트 | 루프와 과도한 호출 식별 |
| 입력 / 출력 / 캐시 토큰 | API가 반환하는 usage 필드 | 모델 비용과 캐시 이익 계산 |
| 도구 호출 횟수 | 도구 계층 카운트 | 검색, 브라우저 등 비용 계산 |
| 실패 및 재시도 | 실패 원인 분류 | 추가 소모 계산 |
| 사람 수정 시간 | 검수 인력 타이머 | 실제 인적 투입 계산 |
| 최종 검수 결과 | 사전 정의된 체크리스트로 합격/불합격 판정 | 작업 성공률과 분모 계산 |
Dots 쪽은 토큰 상세 내역을 받을 수 없으니 구독료, 할당량 소모 현황, 완료 시간, 사람 수정 시간, 검수 결과를 기록하고, 세 경로 모두 최종적으로 ‘합격 작업 하나당 비용은 얼마고 인적 시간은 몇 분이 들었는가’로 환산해요. 실험 주기는 최소 한 번의 완전한 월간 보고서 주기를 포함하도록 잡는 걸 권하고, 샘플 수가 너무 적으면 개별 실패가 결과를 크게 왜곡할 수 있어요.
7 Dots 구독을 선택할 때와 AI 직원 Agent를 직접 구축할 때
7.1 개인 사용자: Dots 구독을 우선 고려하세요
- 일상 업무 위임: 일정 정리, 회의 준비, 이메일 분류, 여행 계획처럼 여러 앱을 넘나드는 작업은 Dots의 앱 연결과 클라우드 컴퓨터로 바로 처리할 수 있어요.
- 시스템 유지 부담 없음: AI 에이전트를 직접 구축하면 장애 대응과 업그레이드를 계속 처리해야 하므로, 개인 사용자의 시간 비용은 보통 구독료보다 커요.
- 전제 조건: 연령 및 지역 요건을 충족하고 Pro 할당량 규칙을 받아들여야 해요. 월 작업량이 매우 적다면 $100라는 기준을 실제 사용 빈도와 비교해 평가해야 해요.
7.2 헤비 개발자: 직접 구축 또는 하이브리드가 적합해요
- 맞춤 실행 로직이 필요할 때: 고정 형식의 정보 수집, 특정 데이터 소스 모니터링, 내부 시스템과의 심층 통합.
- 정밀한 비용 제어가 필요할 때: 단계별 모델 선택, 캐시 활용, 호출 기록 기반 1센트 단위 비용 정산.
- 이미 기술 역량을 갖춘 경우: 스케줄링, 상태 관리, 승인을 직접 구축할 수 있어 개발 비용을 장기 작업에 분산할 수 있어요.
7.3 기업 팀: 계약 견적과 컴플라이언스 요구를 확인하세요
- 기존 Enterprise 워크스페이스 보유: Dots는 관리자가 일괄 구성할 수 있고, Business·Enterprise·Edu 워크스페이스 데이터는 기본적으로 모델 학습에 사용되지 않아요. 과금은 워크스페이스 견적으로 산정해야 해요.
- 내부 시스템 또는 사설 프로세스 연동 필요: 직접 구축한 Agent는 실행 환경, 데이터 흐름, 감사 로그 측면에서 통제성이 더 강해요.
- 대규모 표준화 작업: 작업량이 충분히 많고 프로세스가 충분히 안정적이라면, 멀티 모델로 직접 구축한 Agent가 단일 작업 비용을 낮출 가능성이 더 커요. 단, 반드시 대조 실험으로 검증해야 해요.
8 AI 직원의 하이브리드 전략: 구독과 API 종량 호출 조합
구독과 API는 작업 특성에 따라 역할을 나눠서, 각자 가장 잘하는 부분을 맡길 수 있어요:
- 일상적인 상호작용과 사람의 판단이 필요한 업무: Dots나 기존 ChatGPT 구독에 맡기고, 장기 컨텍스트와 사람의 승인 메커니즘을 활용해요.
- 안정적이고 자동 검증이 가능한 배치 작업: API 종량제로 비용을 지불하고, 저가 모델에 맡겨서 처리해요.
- 난도 높은 추론과 핵심 결론: 성능이 더 강한 모델을 호출해서, 더 높은 단가를 주는 대신 재작업률을 낮춰요.
- 업무 피크 시간대: 구독 한도가 빠듯할 때, 외부로 옮길 수 있는 작업은 종량 호출로 전환해요.
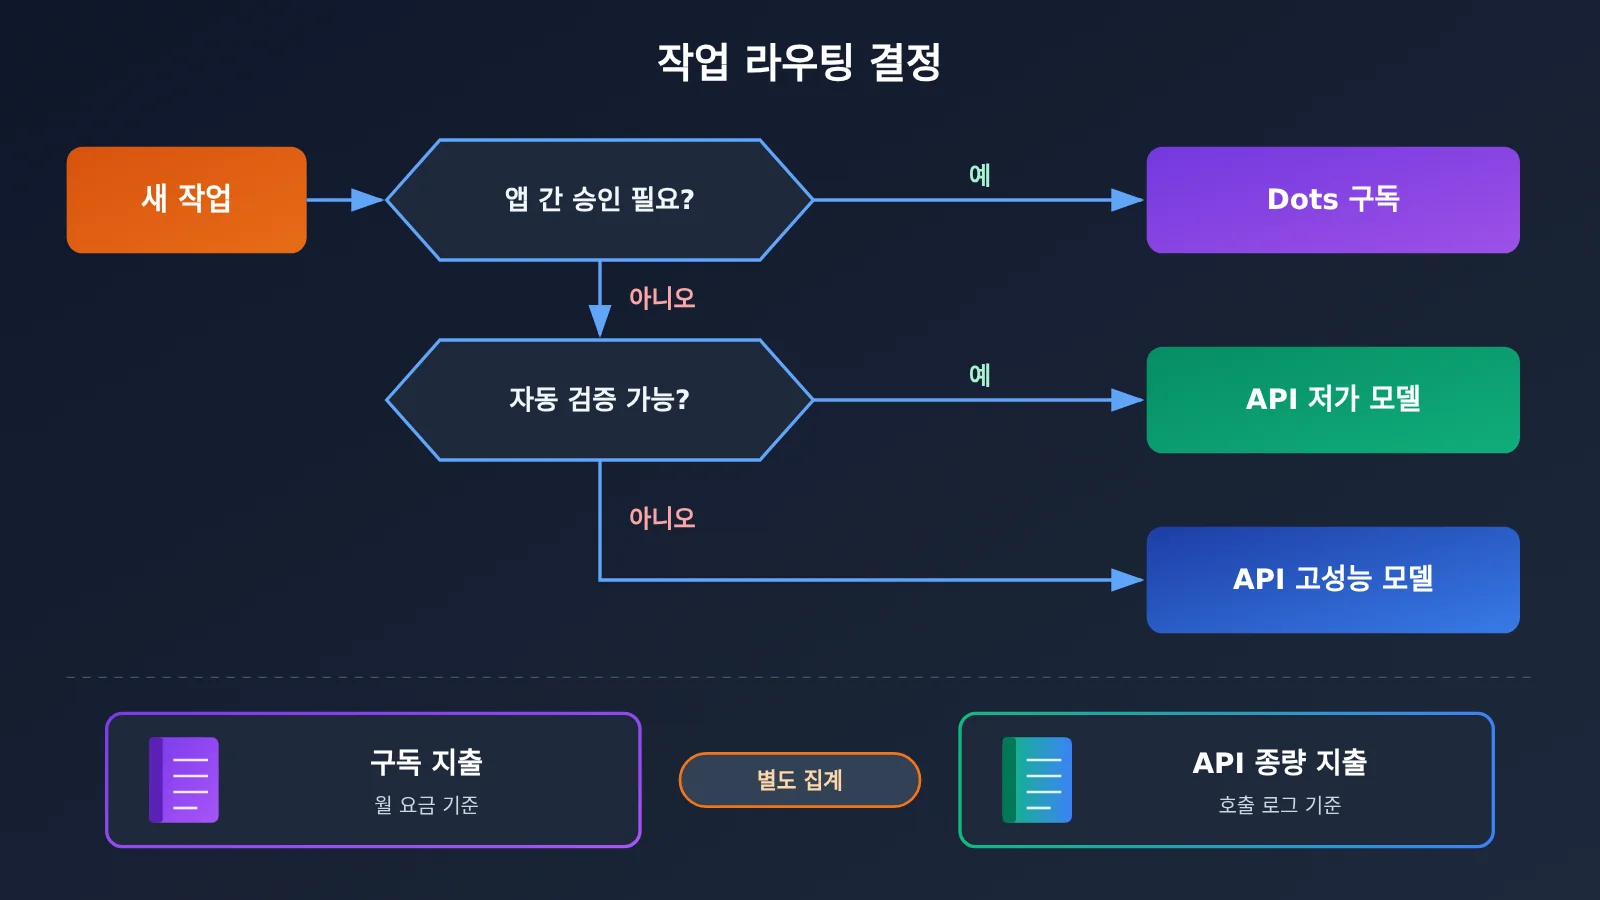
하이브리드 전략의 핵심은 장부를 분리하는 거예요. 구독 지출은 월 요금으로, API 지출은 호출 로그로 집계하고, 같은 작업은 실제로 수행한 경로 한 곳에만 계상해서 이중 계산을 피해요.
💡 의사결정 제안: 먼저 Dots나 기존 구독으로 일상 업무를 처리하면서, 표준화된 작업 1~2가지를 골라 APIYI apiyi.com을 통해 여러 모델에 연결해 비교 실험을 돌려보세요. 한 달간의 성공 작업 비용 데이터를 바탕으로 어떤 작업을 API로 옮기고 어떤 작업을 구독에 남길지 결정하는 편이, 처음부터 전체를 하나만 골라 가는 것보다 훨씬 안정적이에요.
자주 묻는 질문 FAQ
Q1: ChatGPT Dots는 무엇인가요?
ChatGPT Dots는 OpenAI가 2026년 9월 29일에 공개한 상시 대기형 개인 AI 에이전트예요. 자체 클라우드 컴퓨터와 브라우저를 갖추고 있어서 세션과 앱을 넘나들며 위임받은 작업을 계속 이어가고, 사용자의 판단이 필요할 때는 먼저 확인을 요청해요.
Q2: 개인이 Dots를 쓰려면 월 얼마를 내야 하나요?
2026년 11월 16일 기준으로 개인 사용자는 ChatGPT Pro를 구독해야 하고, Pro 100, Pro 200, Pro 500의 월 요금은 각각 $100, $200, $500이에요. 세 가지 플랜 모두 Dots를 쓸 수 있고, 공식적으로 Dot 월 요금을 따로 책정하지는 않았어요. Dot가 위임해서 실행하는 Work 또는 Codex 작업은 해당 제품의 사용량 한도로 계산돼요.
Q3: 기업용 Dots는 어떻게 과금되나요?
조건을 충족하는 기업 워크스페이스는 작업 유형별 고정 요율이나 사용량 기반 과금 중에서 선택할 수 있고, 구체적인 금액은 해당 워크스페이스에 적용되는 계약이나 견적을 기준으로 해요. 2026년 11월 4일부터 18일까지는 무료 관리자 프리뷰 기간이고, 11월 18일부터 활성화된 Dot에 과금이 시작되며, Work나 Codex로 위임된 작업은 별도로 청구돼요.
Q4: 자체 구축 에이전트의 모델 비용이 $100보다 낮으면 Dots보다 저렴한가요?
서버, 데이터베이스, 검색과 브라우저 도구, 개발 및 유지보수, 그리고 사람의 검수 비용까지 더해야 하고, 실패 후 재실행으로 생기는 손실도 빼야 해요. 같은 작업 묶음과 같은 검수 기준에서 성공한 작업의 비용을 비교해야만 어느 쪽이 더 저렴한지 결론을 낼 수 있어요.
Q5: API로 자체 구축 에이전트의 모델 비용을 빠르게 계산하려면 어떻게 해야 하나요?
다음 순서대로 해보면 돼요:
1. APIYI apiyi.com에서 가입하고 API 키를 발급받은 뒤, 신규 사용자 테스트 크레딧을 받으세요.
2. 이 글의 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정하고, Ledger를 붙여 호출할 때마다 토큰을 기록하세요.
3. 실제 작업으로 Opus 5.5와 Sonnet 5.5를 각각 호출하고, 검수 결과와 사람이 수정한 시간을 기록해서 성공한 작업의 비용을 계산하세요.
Q6: 캐시가 에이전트 비용에 얼마나 영향을 주나요?
에이전트가 여러 턴을 호출하는 과정에서 시스템 프롬프트와 도구 정의가 반복해서 전송되는데, 캐시에 적중하면 캐시 읽기 단가로 과금돼요. Claude 5.5 시리즈의 캐시 읽기 단가는 일반 입력의 약 20분의 1 수준이에요. 이 글에서 가정한 샘플에서는 입력의 3분의 2가 캐시에 적중할 때 작업 한 건당 모델 비용이 약 3분의 1 줄었어요. 캐시 쓰기 단가는 콘솔 기준으로 확인하세요.
Q7: Dots가 사람을 완전히 대체할 수 있나요?
공식 자료와 서드파티 실측 모두 Dots의 결과에는 사람이 확인해야 한다고 말해요. Axios 테스트에서 Dots가 만든 프로그램 책자에 의심스러운 데이터가 나왔고, 계정과 자금이 관련된 작업은 여전히 사용자가 직접 처리해야 하므로, 사람의 검수 비용은 항상 총비용에 포함해서 계산해야 해요.
Q8: Dots로 작업을 무한정 병렬 처리할 수 있나요?
Dots는 여러 프로젝트와 백그라운드 에이전트의 병렬 실행을 지원하지만, 실행 환경과 사용량 한도에는 경계가 있어요. 한 Reddit 사용자는 독립적인 작업을 시작할 때 실행 환경을 사용할 수 없는 상황을 겪었고, 로컬 Linux 컴퓨터에 연결한 뒤에야 계속할 수 있었다고 밝혔어요. 또한 각 실행 경로의 사용량 한도가 어떻게 계산되는지는 확인하지 못했다고 덧붙였어요.
AI 직원 비용 핵심 포인트 Key Takeaways
- 비교 기준: 동일한 결과물 기준에서 성공한 작업의 비용으로 측정해야 하며, 월 구독료와 Token 단가는 그중 하나일 뿐이에요.
- 개인과 기업은 따로 계산: 개인용 Pro는 월 $100부터 시작하고, 기업용 Dot은 작업 유형이나 사용량에 따라 과금되며 계약서를 기준으로 해요.
- 구독에는 환경이 포함되어 있어요: 클라우드 컴퓨터, 장기 컨텍스트, 앱 연결, 승인 메커니즘은 직접 구축할 때 추가로 메워야 하는 비용이에요.
- 모델 비용은 한 층일 뿐: 가정 샘플에서 월 300회 작업의 모델 비용은 $33–$66이며, 인프라와 인건비는 포함되지 않았어요.
- 성공률이 실제 비용을 결정: 사람이 1분만 더 수정해도 두 모델의 단가 차이 전체를 상쇄할 수 있어요.
- 혼합해서 쓰면 더 유연해요: 일상적인 위임은 구독으로, 표준화된 대량 작업은 APIYI를 통해 사용량 기반으로 호출하고 따로 기록해요.
정리
매달 100달러를 들여 AI 직원 하나를 키우는 것이 합리적인지는, 그 AI에게 맡기는 작업과 여러분의 검수 기준에 달려 있어요.
- Dots의 가치는 바로 쓸 수 있는 지속적 작업 능력에 있어요: 클라우드 컴퓨터, 앱 간 협업, 장기 컨텍스트 덕분에 개발과 유지보수를 아낄 수 있고, 개인 사용자와 유지보수 부담을 낮게 가져가려는 팀에 잘 맞아요.
- 자체 구축 Agent의 장점은 제어 가능성과 회계 가능성: 실행 로직을 맞춤화할 수 있고 호출마다 과금을 추적할 수 있어서, 안정적인 기술 역량을 갖추고 작업 표준화 수준이 높은 팀에 적합해요.
- 최종 판단은 대조 실험으로: 세 가지 실제 작업으로 Token, 재시도, 사람이 수정한 시간을 기록하고, 합격한 작업당 총비용을 비교하세요.
기존 구독은 일상 업무 처리에 유지하면서, 동시에 한 가지 표준화된 작업을 골라 API 대조 테스트를 해보길 권합니다. APIYI apiyi.com을 통해 하나의 API 키로 여러 모델을 연결하고, 사용량 기반으로 과금하며 실제 사용량을 기록해서 어떤 작업을 이전할 가치가 있는지 데이터로 결정해 보세요.
📚 참고 자료
-
OpenAI: Introducing dots: Dots 출시 공지, 제품 포지셔닝, 클라우드 컴퓨터 및 앱 생태계
- 링크:
openai.com/index/introducing-dots - 설명: 2026-09-29에 발표된 공식 1차 자료
- 링크:
-
ChatGPT Learn: Meet dots / Tasks and memory: 제품 개요, 구독 자격, 장기 작업 및 메모리 메커니즘
- 링크:
learn.chatgpt.com/docs/dots - 설명: 백그라운드 Agent, 능동형 리서치, 예약 작업을 이해하기 위한 공식 문서
- 링크:
-
ChatGPT Learn: Enterprise Dots 관리자 가이드: 기업 워크스페이스 개설 및 과금 방식
- 링크:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - 설명: 기업 정액제와 사용량 기반 과금에 관한 현행 안내
- 링크:
-
OpenAI 고객 지원 센터: About ChatGPT Pro tiers: Pro 100 / 200 / 500 가격 및 할당량 규칙
- 링크:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - 설명: 개인 구독 가격의 공식 근거
- 링크:
-
OpenAI 고객 지원 센터: Dots 개인정보, 보안, 안전 FAQ: 권한, 승인, Auto-review 및 데이터 정책
- 링크:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - 설명: 사람에 의한 검토와 보안 비용을 평가할 때 반드시 읽어야 할 자료
- 링크:
-
Axios: I tested Dots and Muse: Dots와 Meta Muse의 제3자 실측
- 링크:
axios.com/2026/10/20/battle-of-bots-openai-meta-ai-agents-test - 설명: 구체적인 작업 성능과 실패 사례
- 링크:
-
APIYI: Token 패키지 할당량은 직접 비교할 수 없다: 구독과 사용량 기반 과금의 5단계 산정 방법
- 링크:
help.apiyi.com/token-plan-quota-subscription-vs-pay-as-you-go.html - 설명: 작업당 등가 비용 계산 프레임워크
- 링크:
-
APIYI 모델 가격표: Claude 등 모델의 현행 가격
- 링크:
docs.apiyi.com/models - 설명: 실제 호출 전에는 이곳과 콘솔을 기준으로 확인하세요
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 홈페이지에서 저희에게 연락해 주세요. 더 많은 모델 연동 및 과금 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.