著者注:K-Dense-AI の177個の科研 Agent Skills を使い始めるまでの手順を、環境の事前確認からスキルの選定、インストール、依存関係の追加、動作確認まで丁寧に解説します。トラブルシューティングとリスクについても個別に取り上げます。
K-Dense-AI がオープンソースで公開している Scientific Agent Skills は、Claude Code や Cursor などのコーディング Agent 向けに作られた、177個の研究用スキルパッケージです。シングルセル解析、ケモインフォマティクス、文献レビュー、データベース検索といった作業手順が Agent の読める操作マニュアルにまとめられているため、毎回 QC(品質管理)の手順を一から書いたり、API ドキュメントを調べたり、DOI を照合したりする手間を減らせます。ただし、すべてを一度にインストールするのはおすすめしません。スキルを通じて Agent がコードの実行、パッケージのインストール、ネットワーク接続を行えるうえ、スキルファイルをインストールしても Python の依存パッケージは自動ではインストールされないからです。
この記事は「インストールすれば何でもできる」という宣伝ではありません。5つのステップを順に進めながら、各段階で結果を確認できる導入ガイドです。
この記事でできるようになること:自分の研究分野に必要な5〜10個の科研 Skills を選び、正しいディレクトリにインストールして依存関係を整え、Agent から実際に呼び出せるようになります。成果物や数値も一つずつ確認できます。
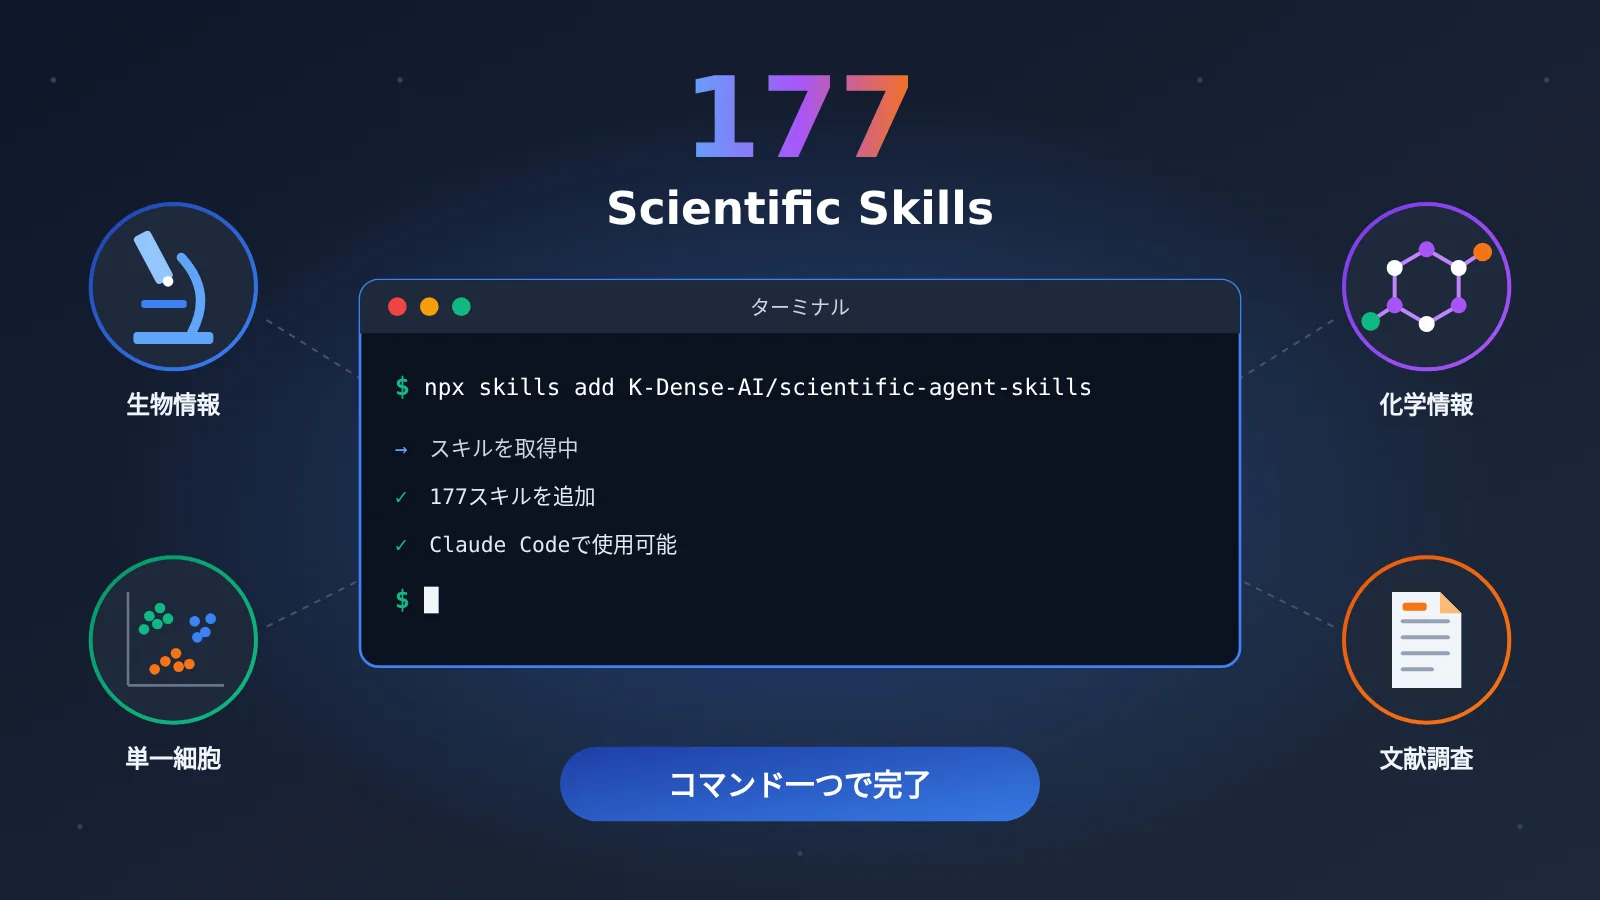
177個の研究向けSkillsには何が含まれている?
リポジトリは K-Dense-AI/scientific-agent-skills で、ライセンスはMITです。2026年10月28日時点でStarは54,959、Forkは4,846。現在のバージョンは2.72.0で、skills/ ディレクトリには177個のサブディレクトリがあります。READMEには「250,000人以上の科学者が利用」「科学分野でNo.1のAgent Skillsライブラリ」とありますが、いずれも公式の自己申告であり、第三者による統計ではありません。関連論文はarXiv:2609.00065です。
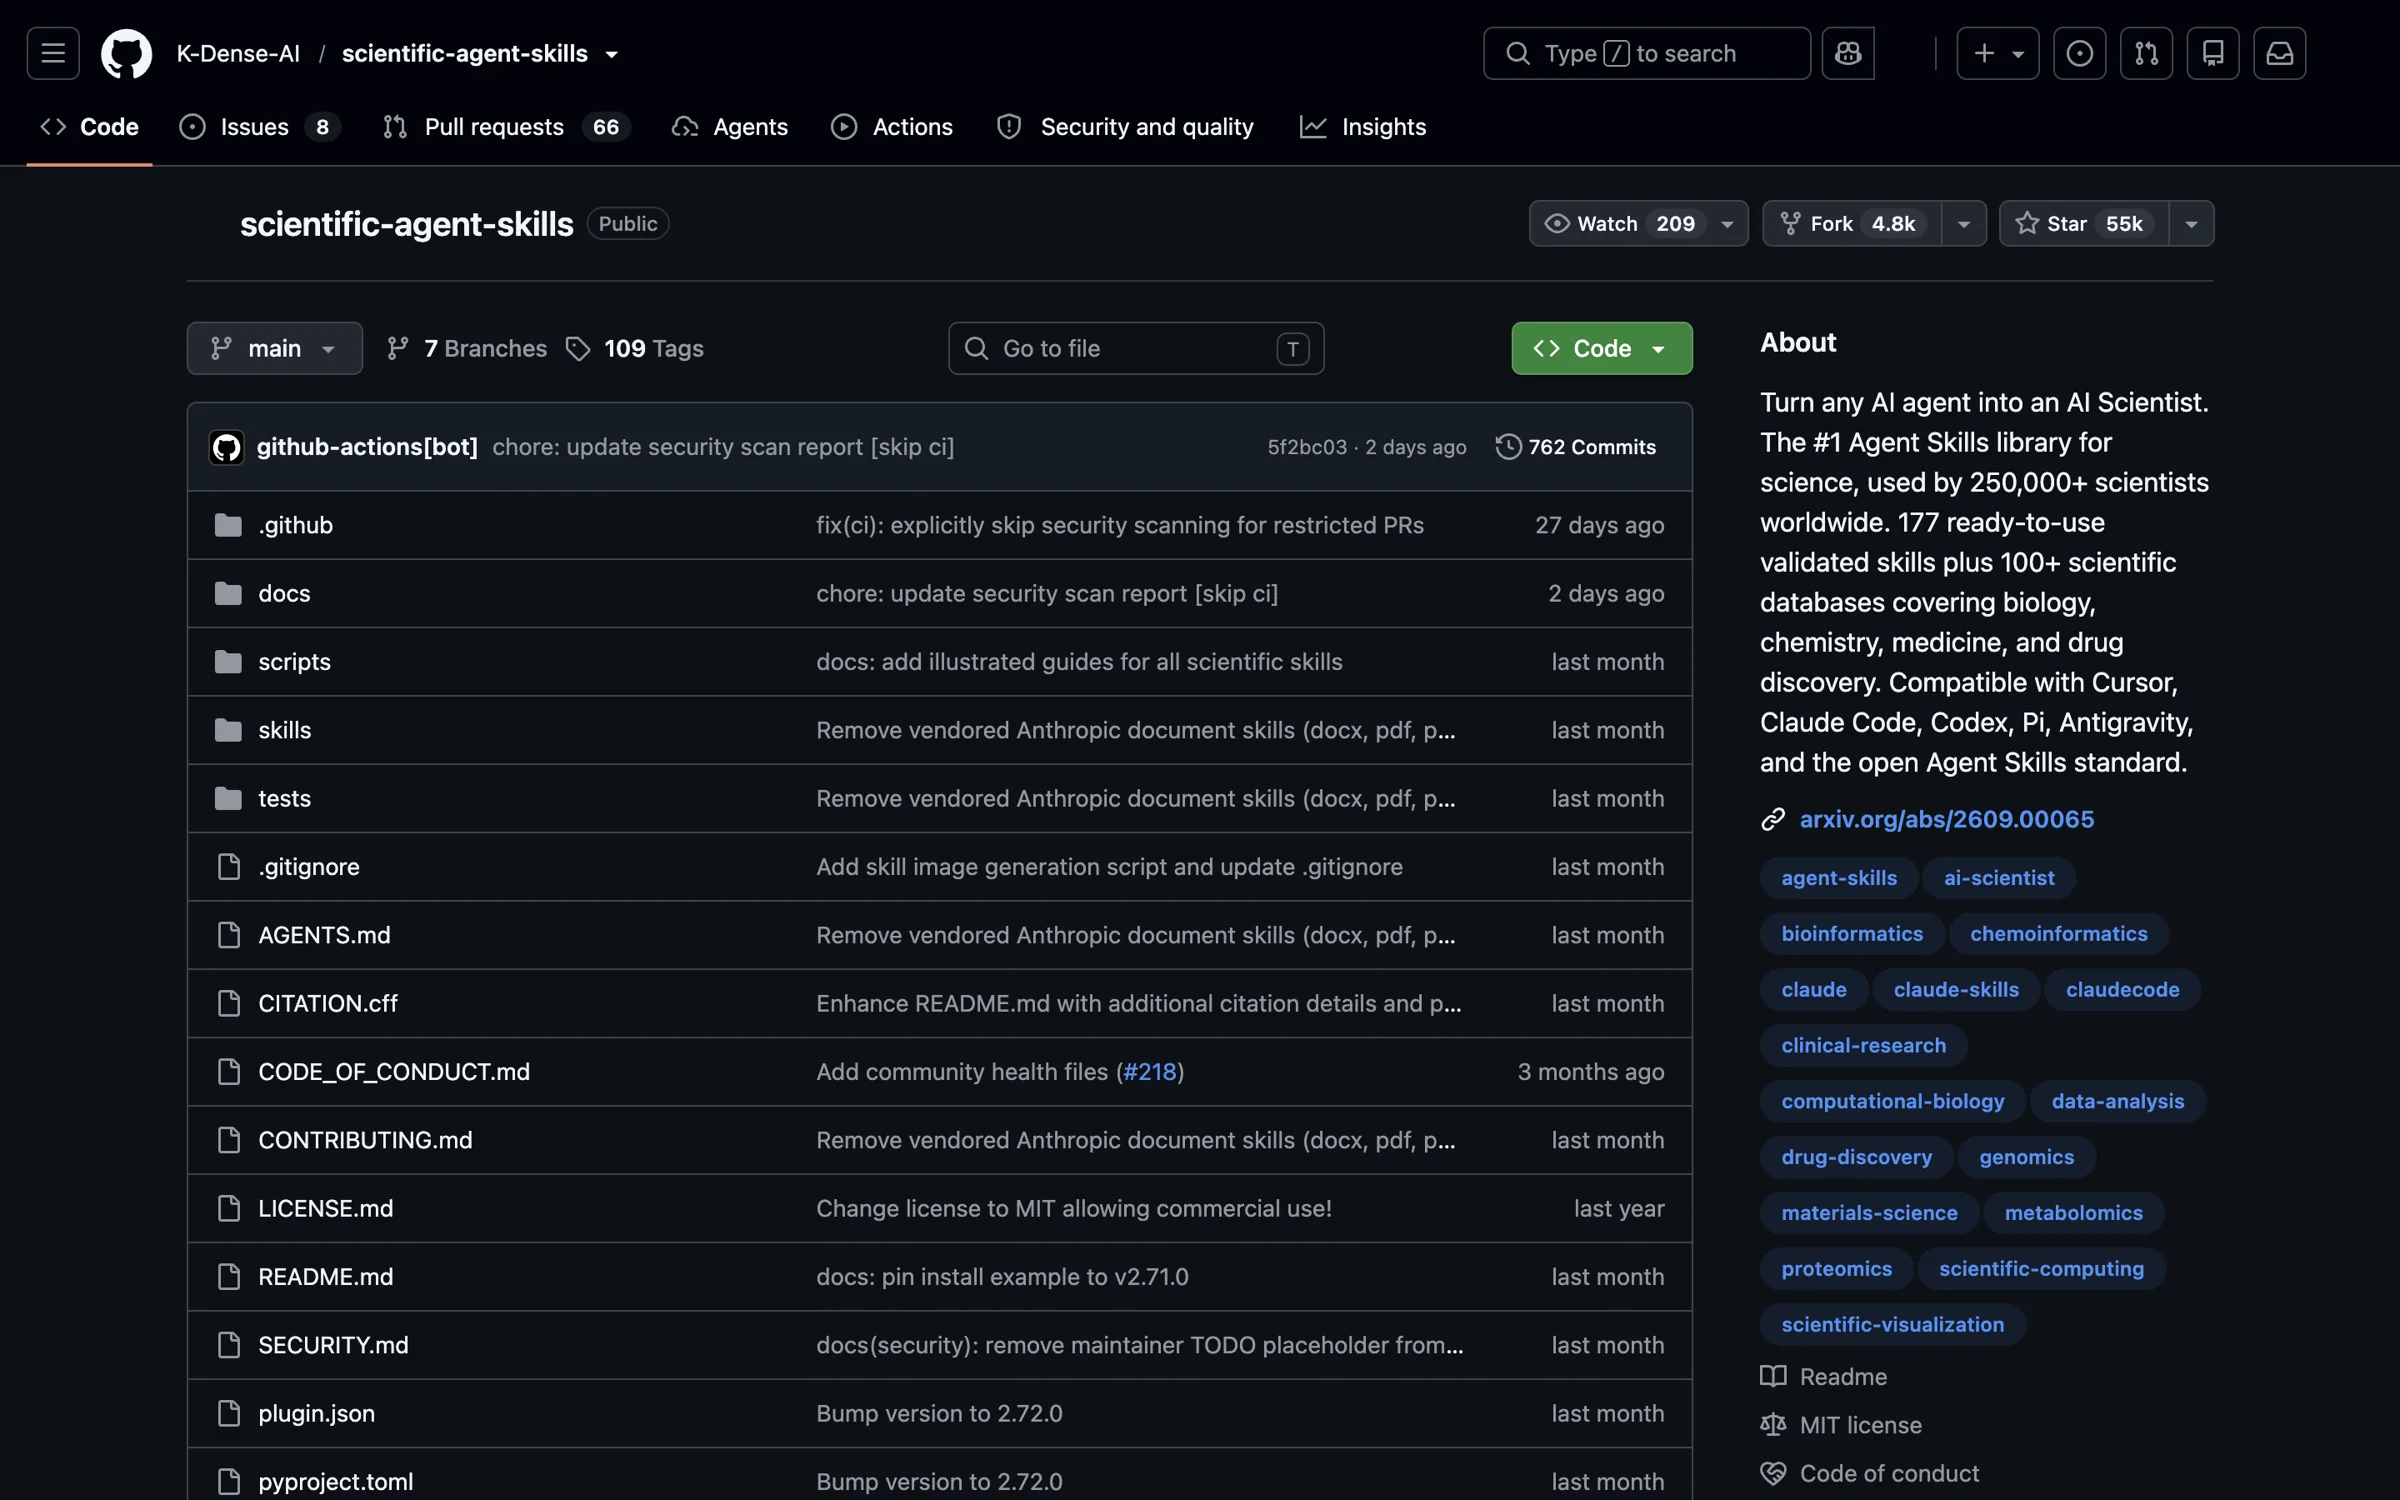
図1:リポジトリのトップページ(2026年10月28日のスクリーンショット)。Starは55k、Forkは4.8kで、About欄には177個のスキルと100以上のデータベースが明記されています。
なぜ177個なのでしょうか? バージョン2.71.0では、スキルは181個ありました。2.72.0以降、docx、pdf、pptx、xlsxの4つのドキュメント用スキルはリポジトリに同梱されなくなり、必要な場合はAnthropicのリポジトリから別途インストールする必要があります。
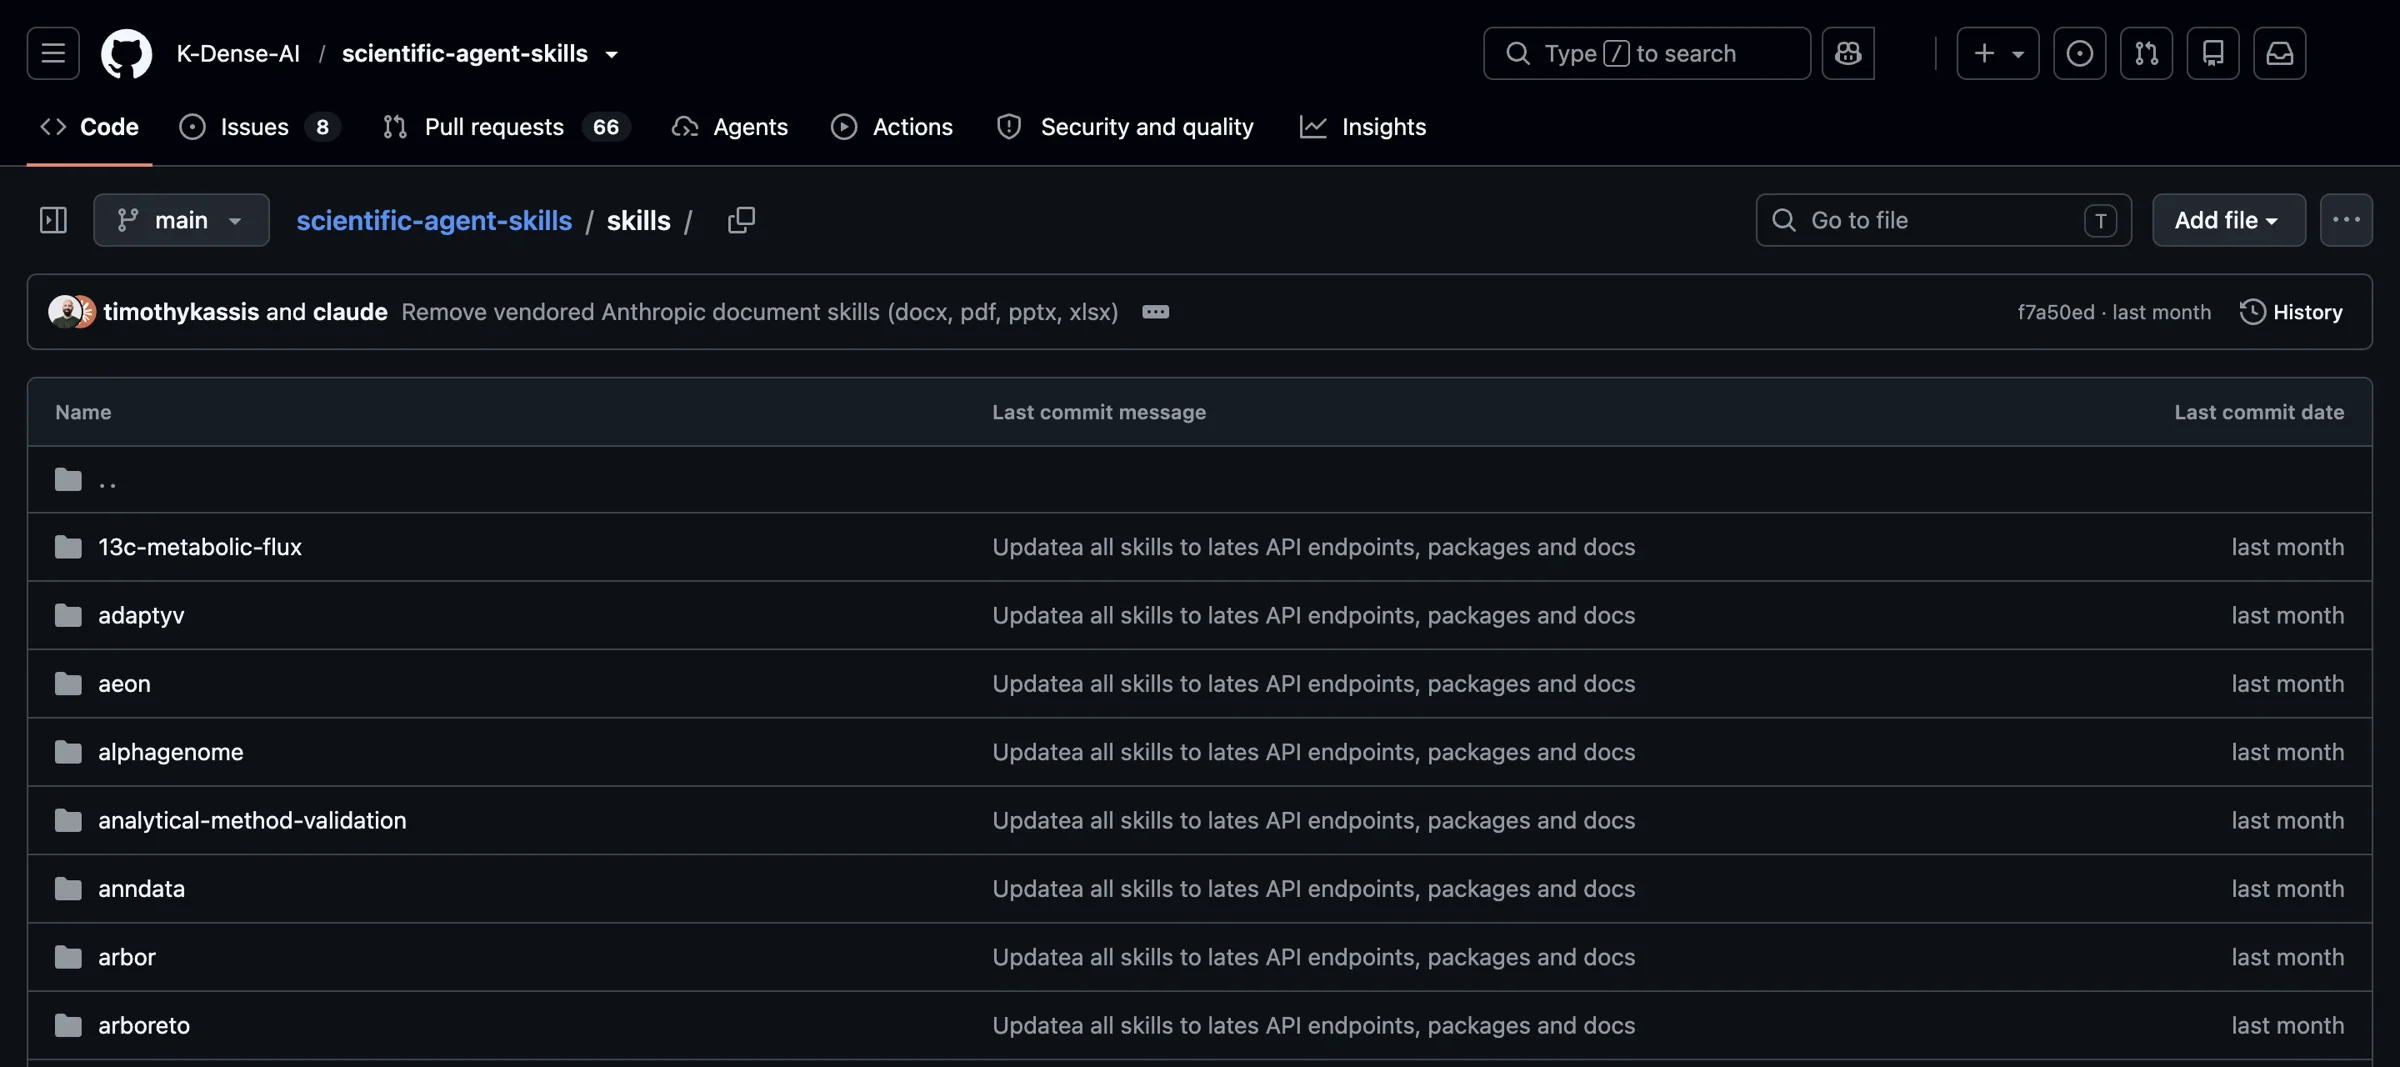
図2:skills/ ディレクトリには、1画面に数十個のスキルフォルダーが並んでいます。最新のコミットには「Remove vendored Anthropic document skills」とあり、これがスキル数が181から177に減った変更です。
READMEでは、すべてのスキルを22の大分類に分けています。以下の表では分野ごとにまとめ、代表的なスキルとパッケージのみを紹介します。
| 分野(READMEの大分類) | 代表的なスキル / パッケージ | 主な用途 |
|---|---|---|
| バイオインフォマティクス、マルチオミクス、プロテオミクスと質量分析 | scanpy、pydeseq2、pyopenms、nextflow、パッケージ用スキルとしてscVeloなど |
シングルセルの品質管理とクラスタリング、遺伝子発現の差次解析、質量分析データの処理、ワークフローの構築 |
| ケモインフォマティクスと創薬、材料科学 | rdkit、pymatgen |
分子のフィルタリングと記述子の算出、結晶構造と材料の計算 |
| 物理・天文学、工学とシミュレーション | qiskit、パッケージ用スキルとしてQuTiPなど |
量子回路、量子システムのシミュレーション |
| 臨床研究、医療AI、規制と標準 | clinical-reports、パッケージ用スキルとしてpydicomなど |
臨床レポートの下書き、医用画像の読み込み |
| データ分析と可視化、機械学習、地理空間 | scientific-visualization、timesfm-forecasting、パッケージ用スキルとしてscikit-learn、PyTorch Lightning、GeoPandasなど |
出版品質のグラフ、時系列予測、モデリング、空間データ分析 |
| 科学コミュニケーション、研究方法論 | literature-review、scientific-writing、paper-lookup、paperzilla、scientific-slides、research-grants、peer-review、generate-image |
システマティックレビュー、論文執筆、研究室のミーティング用スライド、研究助成金の申請、査読コメント |
| データベース検索 | database-lookup、専用スキルとしてDepMap、Imaging Data Commons、PrimeKG、NCATS ARAX、AlphaGenomeなど |
公開・登録・認可が必要なデータソースを統一的に検索 |
このうち database-lookup は、単独で80のデータソースをまとめています。専用スキルや複数のデータベースを扱うパッケージも含め、READMEでは100以上のデータベースに対応するとしています。Pythonパッケージ用のスキルは70以上あり、RDKit、Scanpy、scikit-learn、PyTorch Lightning、pydicom、QuTiP、GeoPandas、pymatgen、Qiskit、scVelo、TimesFMなどを網羅しています。各スキルには、対応するパッケージのバージョンと使い方が記載されています。
研究向け Skills の各スキルのディレクトリ構造
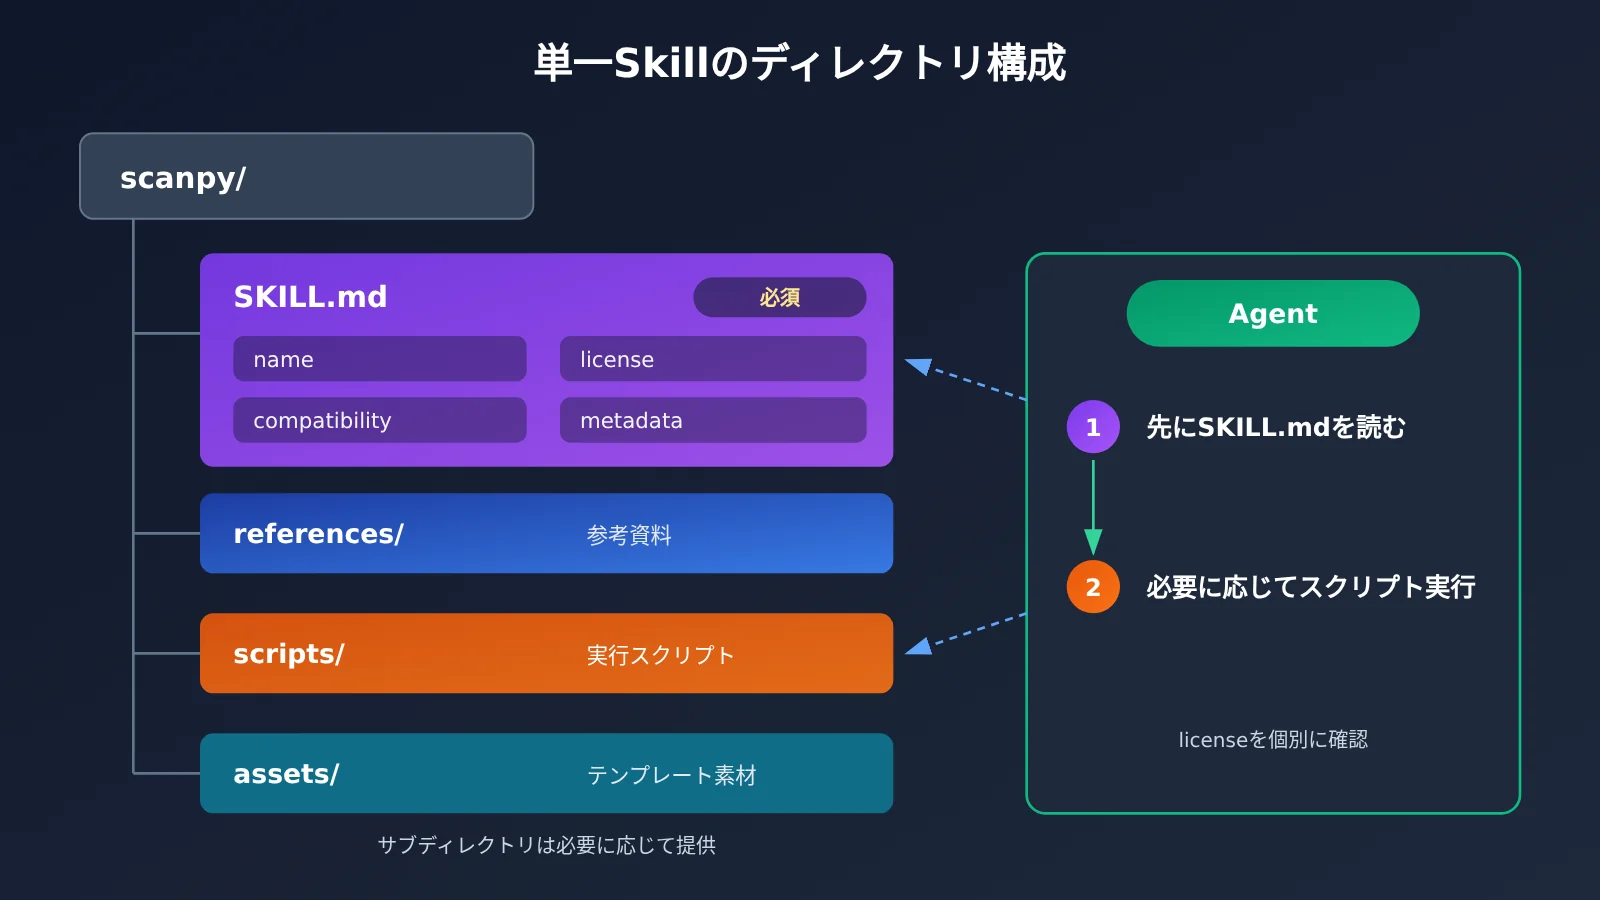
各スキルは1つのフォルダーで構成され、SKILL.md は必須です。references/、scripts/、assets/ は必要に応じて用意されます。例えば scanpy のフロントマターには、license が BSD-3-Clause、Python 3.12+、metadata.version が 1.8、last-reviewed が 2026-10-01 と記載されています。
見落としやすい点として、リポジトリ全体のライセンスは MIT ですが、各スキルの SKILL.md の license フィールドには、そのスキル固有のライセンスが記載されており、リポジトリ全体のものとは異なる場合があります。商用利用や再配布をする際は、スキルごとに確認してください。
研究向け Skills を導入する5つのステップ
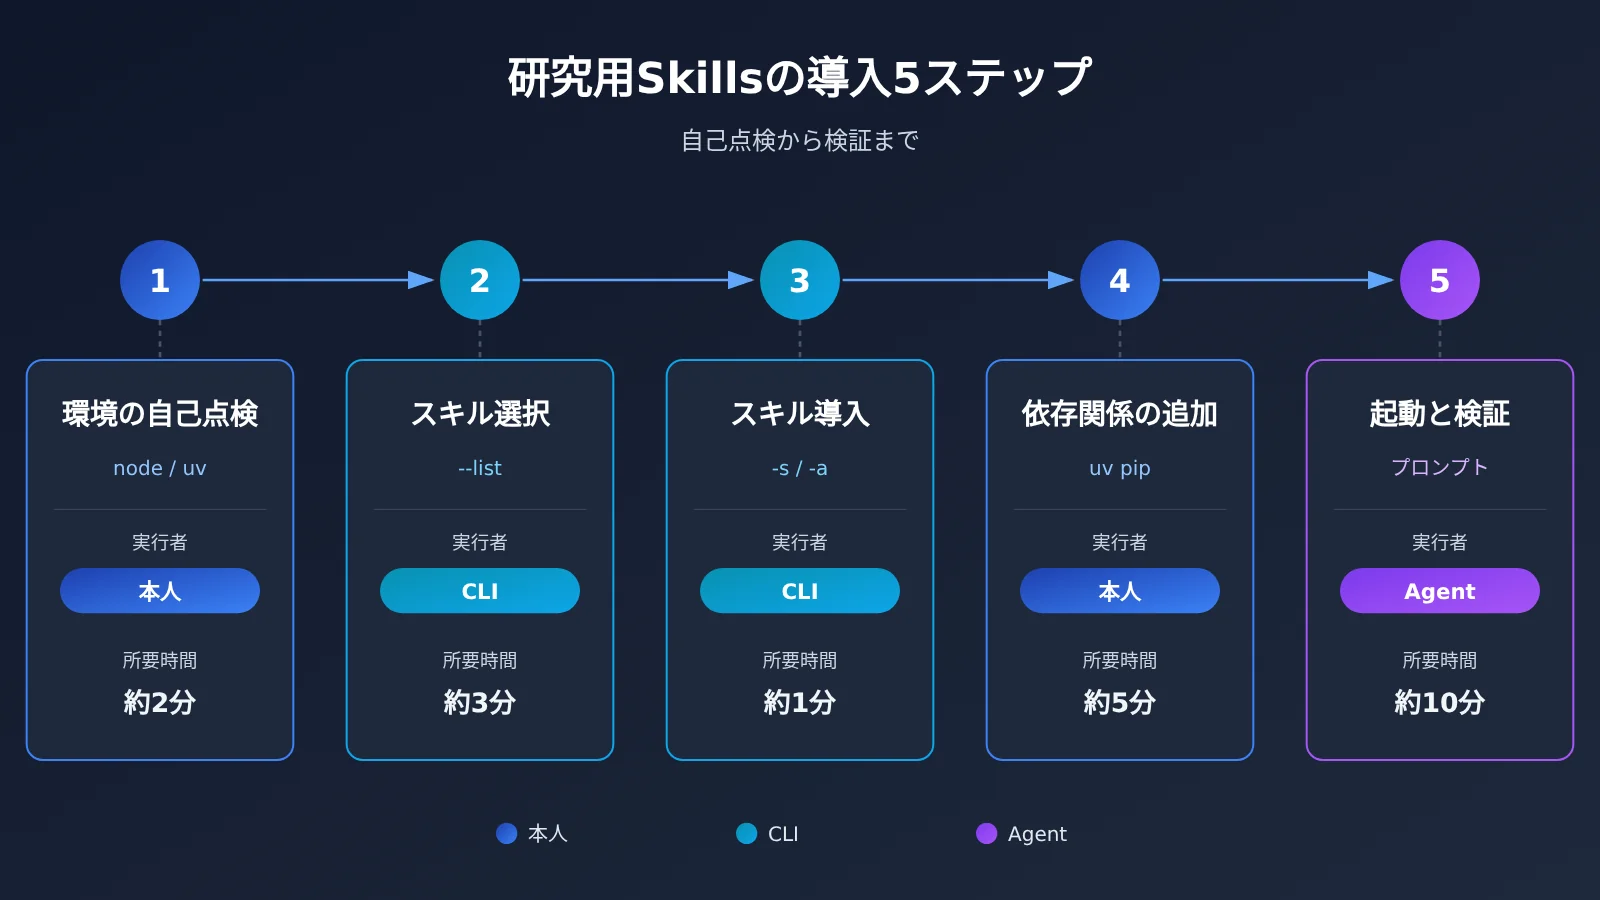
導入は、環境の事前確認 → 一覧からスキルを選択 → 必要なものだけをインストール → 依存関係と認証情報を用意 → スキルを実行して動作を確認、の5ステップです。各ステップでは、あなた自身がコマンドを入力するのか、コマンドラインツールが実行するのか、Agent が実行するのかを明記します。
ステップ 1:研究用 Skills のインストール方法と前提条件を確認する
所要時間:約 5 分 前提条件:ターミナルを開けること 難易度:低(環境が整っていればスキップできます)
やること:以下の確認コマンドをご自身で一つずつ実行し、「そのままインストールできる」「不足しているツールを先に用意する必要がある」「ホストが対応していない」のどれに当てはまるかを確認します。
node -v:インストーラーnpx skillsには Node.js 22.20 以降が必要ですpython3 --version:リポジトリ付属のツールチェーンには Python 3.13 以降が必要です(個々のスキルの依存要件は、それぞれの compatibility を確認してください)uv --version:uv はスキルの依存パッケージのインストールに使用しますgh --version:GitHub CLI でインストールする場合のみ必要です。バージョンは 2.90.0 より新しいものが必要です- OS:macOS、Linux、または Windows + WSL2
確認できること:各コマンドでバージョン番号が表示されます。command not found と表示された場合は、そのツールがまだインストールされていません。
完了の目安:Node のバージョンが v22.20 以降、Python が 3.13 以降で、uv のバージョン番号が正常に表示され、使用中のホストが Agent Skills 標準に対応していることを確認できれば完了です。インストーラーの skills(npm パッケージ、vercel-labs/skills、MIT、最新バージョン 1.7.4)は、70 以上のホストに公式対応しています。代表的なものには Claude Code、Cursor、Codex、Gemini CLI、Antigravity、OpenClaw があります。スキル自体は特定のモデルに依存しません。ホストで使用するモデルは自分で選べます。モデルを APIYI に接続する具体的な方法は、ステップ 5 で説明します。
ステップ2:まず研究用 Skills の一覧を確認し、インストールするものを選ぶ
所要時間:約10分 前提条件:ステップ1を完了していること 難易度:低(スキップ非推奨)
やること:「一覧表示のみで、インストールはしない」コマンドを自分で実行します。コマンドラインツールがリポジトリを取得し、すべてのスキルの名前と説明を読み込みますが、ローカル環境にはスキルをインストールしません。
npx skills add K-Dense-AI/scientific-agent-skills --list
表示される内容:ターミナルに177個のスキルが、それぞれ名前と簡単な説明付きで一覧表示されます。
実際に試した際の注意点:このステップでは、まずリポジトリ全体をローカルにクローンします。リポジトリのサイズは400MB以上あります。ネットワークが遅い場合、ターミナルが Cloning repository… のまま長時間止まり、300秒を超えると Clone timed out エラーが表示されます。制限時間を延ばすには、SKILLS_CLONE_TIMEOUT_MS=600000(10分)を指定して再実行してください。または、先に自分で git clone してから、ローカルディレクトリに対して skills add を実行する方法もあります。
完了の目安:5〜10個のスキルを候補としてリストアップできていること。README にも「Do not install everything at once(一度にすべてをインストールしないでください)」とあり、公式も一括インストールを推奨していません。スキルを多くインストールするほど、Agent が適切なスキルを選びにくくなり、確認が必要なコードも増えます。
分野に応じて、次のように選ぶとよいでしょう。
- バイオインフォマティクス:
scanpy、pydeseq2、database-lookup。質量分析を行う場合はpyopenmsも追加 - ケモインフォマティクス:
rdkit、database-lookup。材料分野ではpymatgenも追加 - 文献調査・執筆:
literature-review、paper-lookup、scientific-writing、peer-review - データ可視化:
scientific-visualization。時系列を扱う場合はtimesfm-forecastingも追加 - ラボ自動化:この分野の具体的なスキル名は
--listの出力で確認。ワークフローの構築には、まずnextflowをチェック
ステップ3:必要な研究用Skillsだけをインストールする
所要時間:約5分 前提条件:候補リストがあること 難易度:中
やること:インストールコマンドを自分で実行します。コマンドラインツールがホストのスキルディレクトリにスキルを書き込みます。タイトルにある「1つのコマンド」とは、npx skills add K-Dense-AI/scientific-agent-skills のことです。このまま実行すると対話モードになり、スキルとホストを選択できます。対話画面ですべてを選ぶと全スキルのインストールになるため、おすすめしません。
パラメータの意味:
-s/--skill:スキル名を指定します。'*'はすべてを意味します-a/--agent:claude-code、codexなどのホストを指定します-g:ユーザーディレクトリにインストールします(グローバル)。指定しない場合は現在のプロジェクトにインストールします--copy:ファイルをコピーします。デフォルトはシンボリックリンク(Symlink)で、ローカルには1つのコピーだけを保持するため、更新が簡単です-y:確認をスキップします。スクリプトやCIに適しています
そのままコピーできる非対話式コマンド(Claude Codeへのプロジェクト単位のインストール例。1行につき1つのスキルをインストールします):
npx skills add K-Dense-AI/scientific-agent-skills -s scanpy -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s database-lookup -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s pydeseq2 -a claude-code -y
グローバルにインストールする場合は、コマンドの末尾に -g を追加します。シンボリックリンクではなくコピーを使う場合は、--copy を追加します。複数のスキルを一度にインストールする方法については、npx skills add --help の説明を参照してください。
| ホスト | プロジェクト単位のディレクトリ | グローバルディレクトリ |
|---|---|---|
| Claude Code | .claude/skills/ |
~/.claude/skills/ |
| Cursor | .agents/skills/ |
~/.cursor/skills/ |
| Codex | .agents/skills/ |
~/.agents/skills/ |
| Gemini CLI | .agents/skills/ |
~/.gemini/skills/ |
| Antigravity | .agents/skills/ |
~/.gemini/antigravity/skills/ |
| OpenClaw | skills/ |
~/.openclaw/skills/ |
プロジェクト単位とグローバルの使い分け:特定の研究課題に関連するスキル(特定の解析プロジェクト専用の pydeseq2 など)はプロジェクト単位でインストールすると、プロジェクトと一緒に研究グループのメンバーへ共有しやすくなります。文献調査や執筆など、日常的に使うスキルはグローバルにインストールしましょう。
実行結果:インストーラーがスキルごとにインストールの成功を通知し、保存先のパスを表示します。
確認基準:自分で npx skills list を実行するか、ls .claude/skills/ を直接実行して、インストールしたスキルのディレクトリがすべて存在し、それぞれに SKILL.md があることを確認します。
ほかにも2つのインストール方法があります:
gh skill install K-Dense-AI/scientific-agent-skills --agent claude-code --pin v2.71.0:--pinでバージョンまたはコミットSHAを固定します。結果の再現が必要な研究課題に適しています~/.agents/skills/scientific-agent-skills(ユーザー単位)または.agents/skills/scientific-agent-skills(プロジェクト単位)にgit cloneします
ステップ4:研究用 Skills の Python 依存パッケージと認証情報を用意する
所要時間:10〜30分(パッケージのサイズによる) 前提条件:スキルのインストールが完了していること 難易度:中(スキップ不可)
やること:このステップは特につまずきやすいため、改めて強調します。スキルファイルのインストール ≠ 依存パッケージのインストールです。各スキルの SKILL.md を自分で開き、compatibility フィールドを確認してから、uv で依存パッケージをインストールします。uv sync でインストールされるのはリポジトリ自体の開発・検証ツールだけで、科学計算用パッケージがすべて入るわけではありません。
cat .claude/skills/scanpy/SKILL.md:compatibility を確認します。scanpy スキルには「Python 3.13 + Scanpy 1.12.4 + AnnData 0.13.4 でテスト済み」と記載されていますuv venv .venv-scrna --python 3.13:ワークフローごとに環境を作り、単一細胞解析と化学情報学のパッケージ間の競合を避けますsource .venv-scrna/bin/activateuv pip install "scanpy[leiden]"
一部のスキルには、各自のキーが必要です。たとえば generate-image は OpenRouter の画像 API を使うため、export OPENROUTER_API_KEY=あなたのキー を設定する必要があり、利用回数に応じて課金されます。モデルの一覧表示や --dry-run を付けた実行には料金がかからないので、まずはこの2つの方法で試してみましょう。literature-review は DOI の検証にインターネット接続が必要で、PDF を出力するには Pandoc と XeLaTeX を別途インストールする必要があります。
すでに APIYI を使っているなら、画像生成のために OpenRouter のアカウントを別途作る必要はありません:APIYI のドキュメントには、コミュニティが提供した2つの Skills が掲載されています。apiyi-gpt-image-2-gen(公式経由の gpt-image-2、トークン課金、4K とカスタムサイズに対応)と、apiyi-gpt-image-2-all-gen(非公式のリバースエンジニアリング経由、1回 $0.025、対話形式で画像を編集)です。Cursor、Codex CLI、Gemini CLI、OpenCode、GitHub Copilot、Amp のいずれかにインストールしたら、「apiyi-gpt-image-2-gen で 3840×2160 の画像を生成して」と伝えるだけで使えます。キーは共通の環境変数 APIYI_API_KEY で設定します。
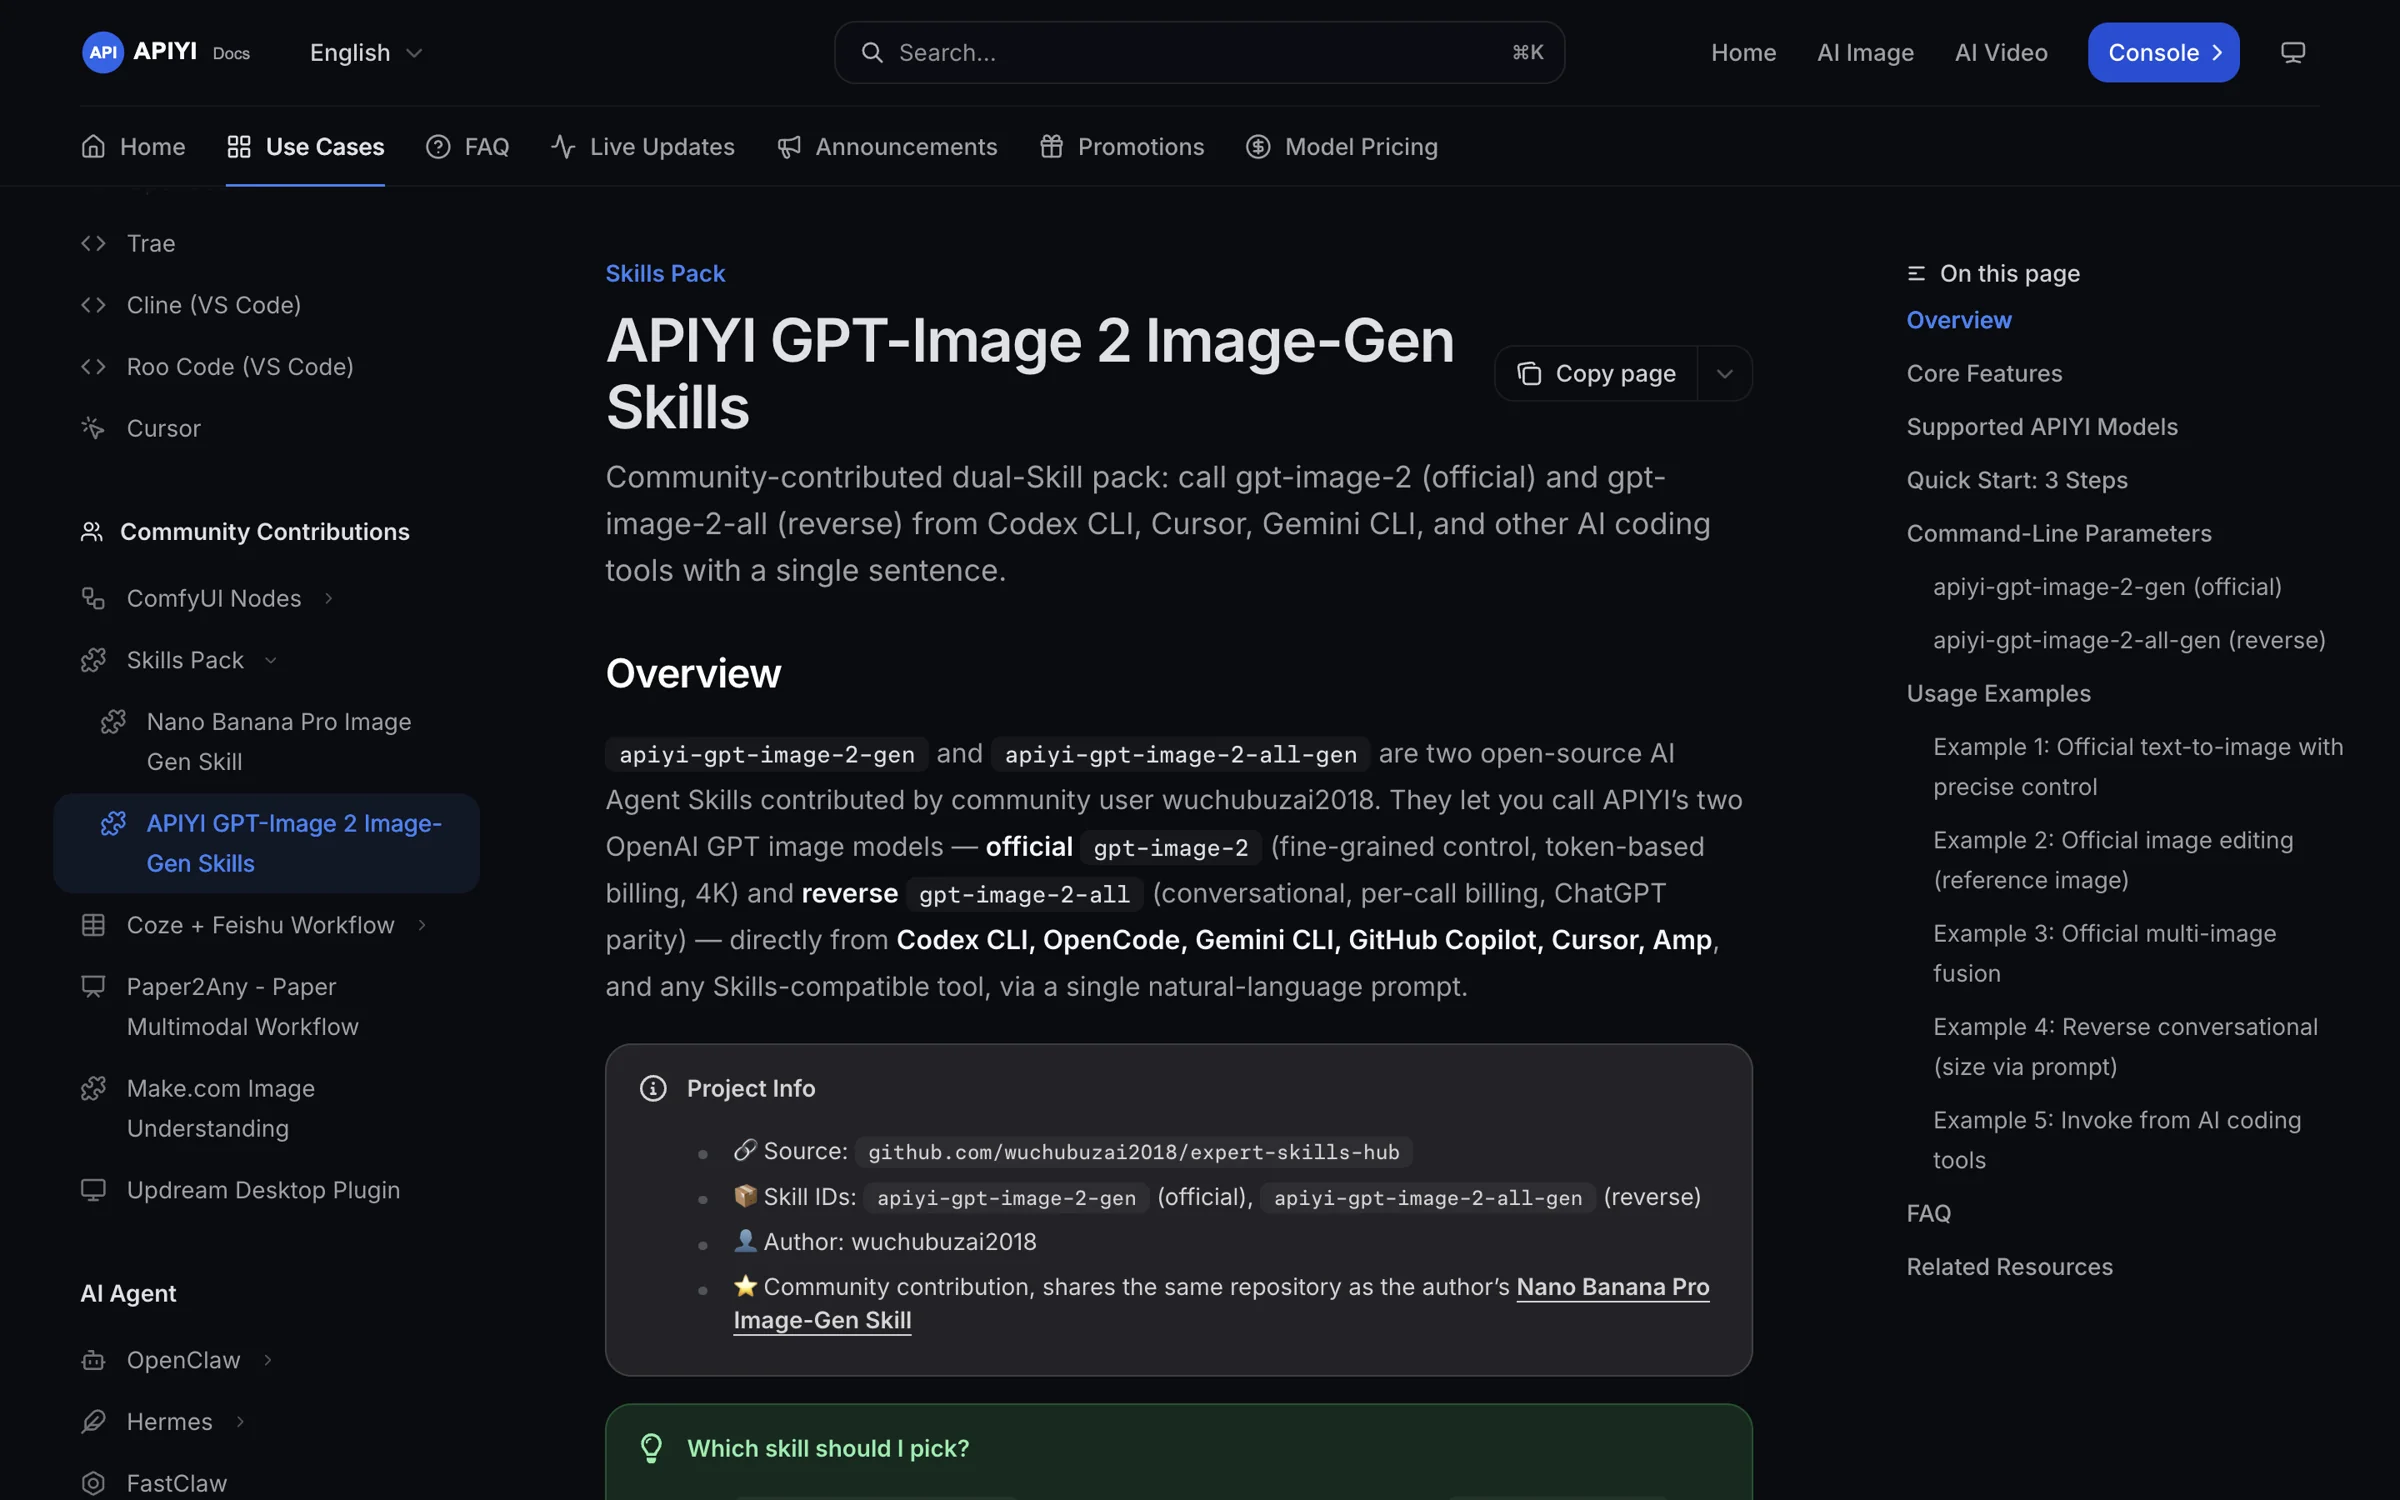
図3:APIYI ドキュメントの Skills 一覧ページ。2つの画像生成スキルについて、モデル ID、課金方式、インストールエラーの調査方法が記載されています
表示されるもの:uv が依存関係を解決し、インストールしたパッケージの一覧を表示します。
確認基準:python -c "import scanpy, anndata; print(scanpy.__version__, anndata.__version__)" を自分で実行し、出力されたバージョン番号が compatibility フィールドの記載と一致することを確認します。キーが必要なスキルでは、echo $OPENROUTER_API_KEY | head -c 6 を実行し、環境変数が設定されていることを確認します。
ステップ5:研究用Skillsを実行して結果を確認する
所要時間:約10分 前提条件:依存関係のインストールが完了していること 難易度:低
やること:ホストを再起動し、スキルディレクトリを再スキャンさせます。次に、あなた自身が対話画面にプロンプトを入力します。以降はAgentが SKILL.md の読み込み、スクリプトの実行、成果物の生成を行います。プロンプトは「共通の冒頭文+スキル名の指定」という書き方がおすすめです。
- 冒頭に
Use available skills you have access to whenever possible.と入力する - 続けて「literature-reviewスキルを使ってシステマティックレビューを行って」のようにスキルを指定する
確認できること:Agentの回答には、読み込んだスキルと実行するコマンドが示されます。
確認基準(3つすべてをチェック):
- Agentが使用したスキルを明示しているか。記載がなければ「どのskillを使った?」と聞き返す
- 成果物がどのディレクトリに保存され、ファイルが実際に存在するか。
lsを使って自分で確認する - 結果の数値が出典と一致するか。DOIを開けるか、データベースのエントリーIDを検索できるかを確認する
日常的なメンテナンスコマンド(自分で実行):npx skills check で更新を確認、npx skills update で更新、npx skills remove でアンインストールできます。インストーラーはデフォルトで匿名の使用データを収集しますが、DISABLE_TELEMETRY=1 または DO_NOT_TRACK=1 を設定すると無効にできます。
🎯 一通り動かしてからコストを確認:スキル自体は無料のオープンソースですが、スキル実行時のモデル呼び出しには費用がかかります。シングルセル解析の一連の作業では、ドキュメントの読み込み、コードの作成、エラー修正を何度も繰り返すことが多く、トークンの消費量も少なくありません。ホストがカスタムのOpenAI互換エンドポイントに対応している場合は、base_urlを
https://api.apiyi.com/v1に設定できます。APIYI apiyi.comを通じて1つのキーでClaude、GPT、Geminiなどのモデルを切り替え、同じスキルを実行したときの結果やコストを比較できます。Claude Codeの場合、接続に必要なのは2行の環境変数だけです。ANTHROPIC_BASE_URLにhttps://api.apiyi.comを指定し、ANTHROPIC_AUTH_TOKENに自分のキーを入力します。設定後も、これらのスキルをClaude Codeでそのまま使えます。
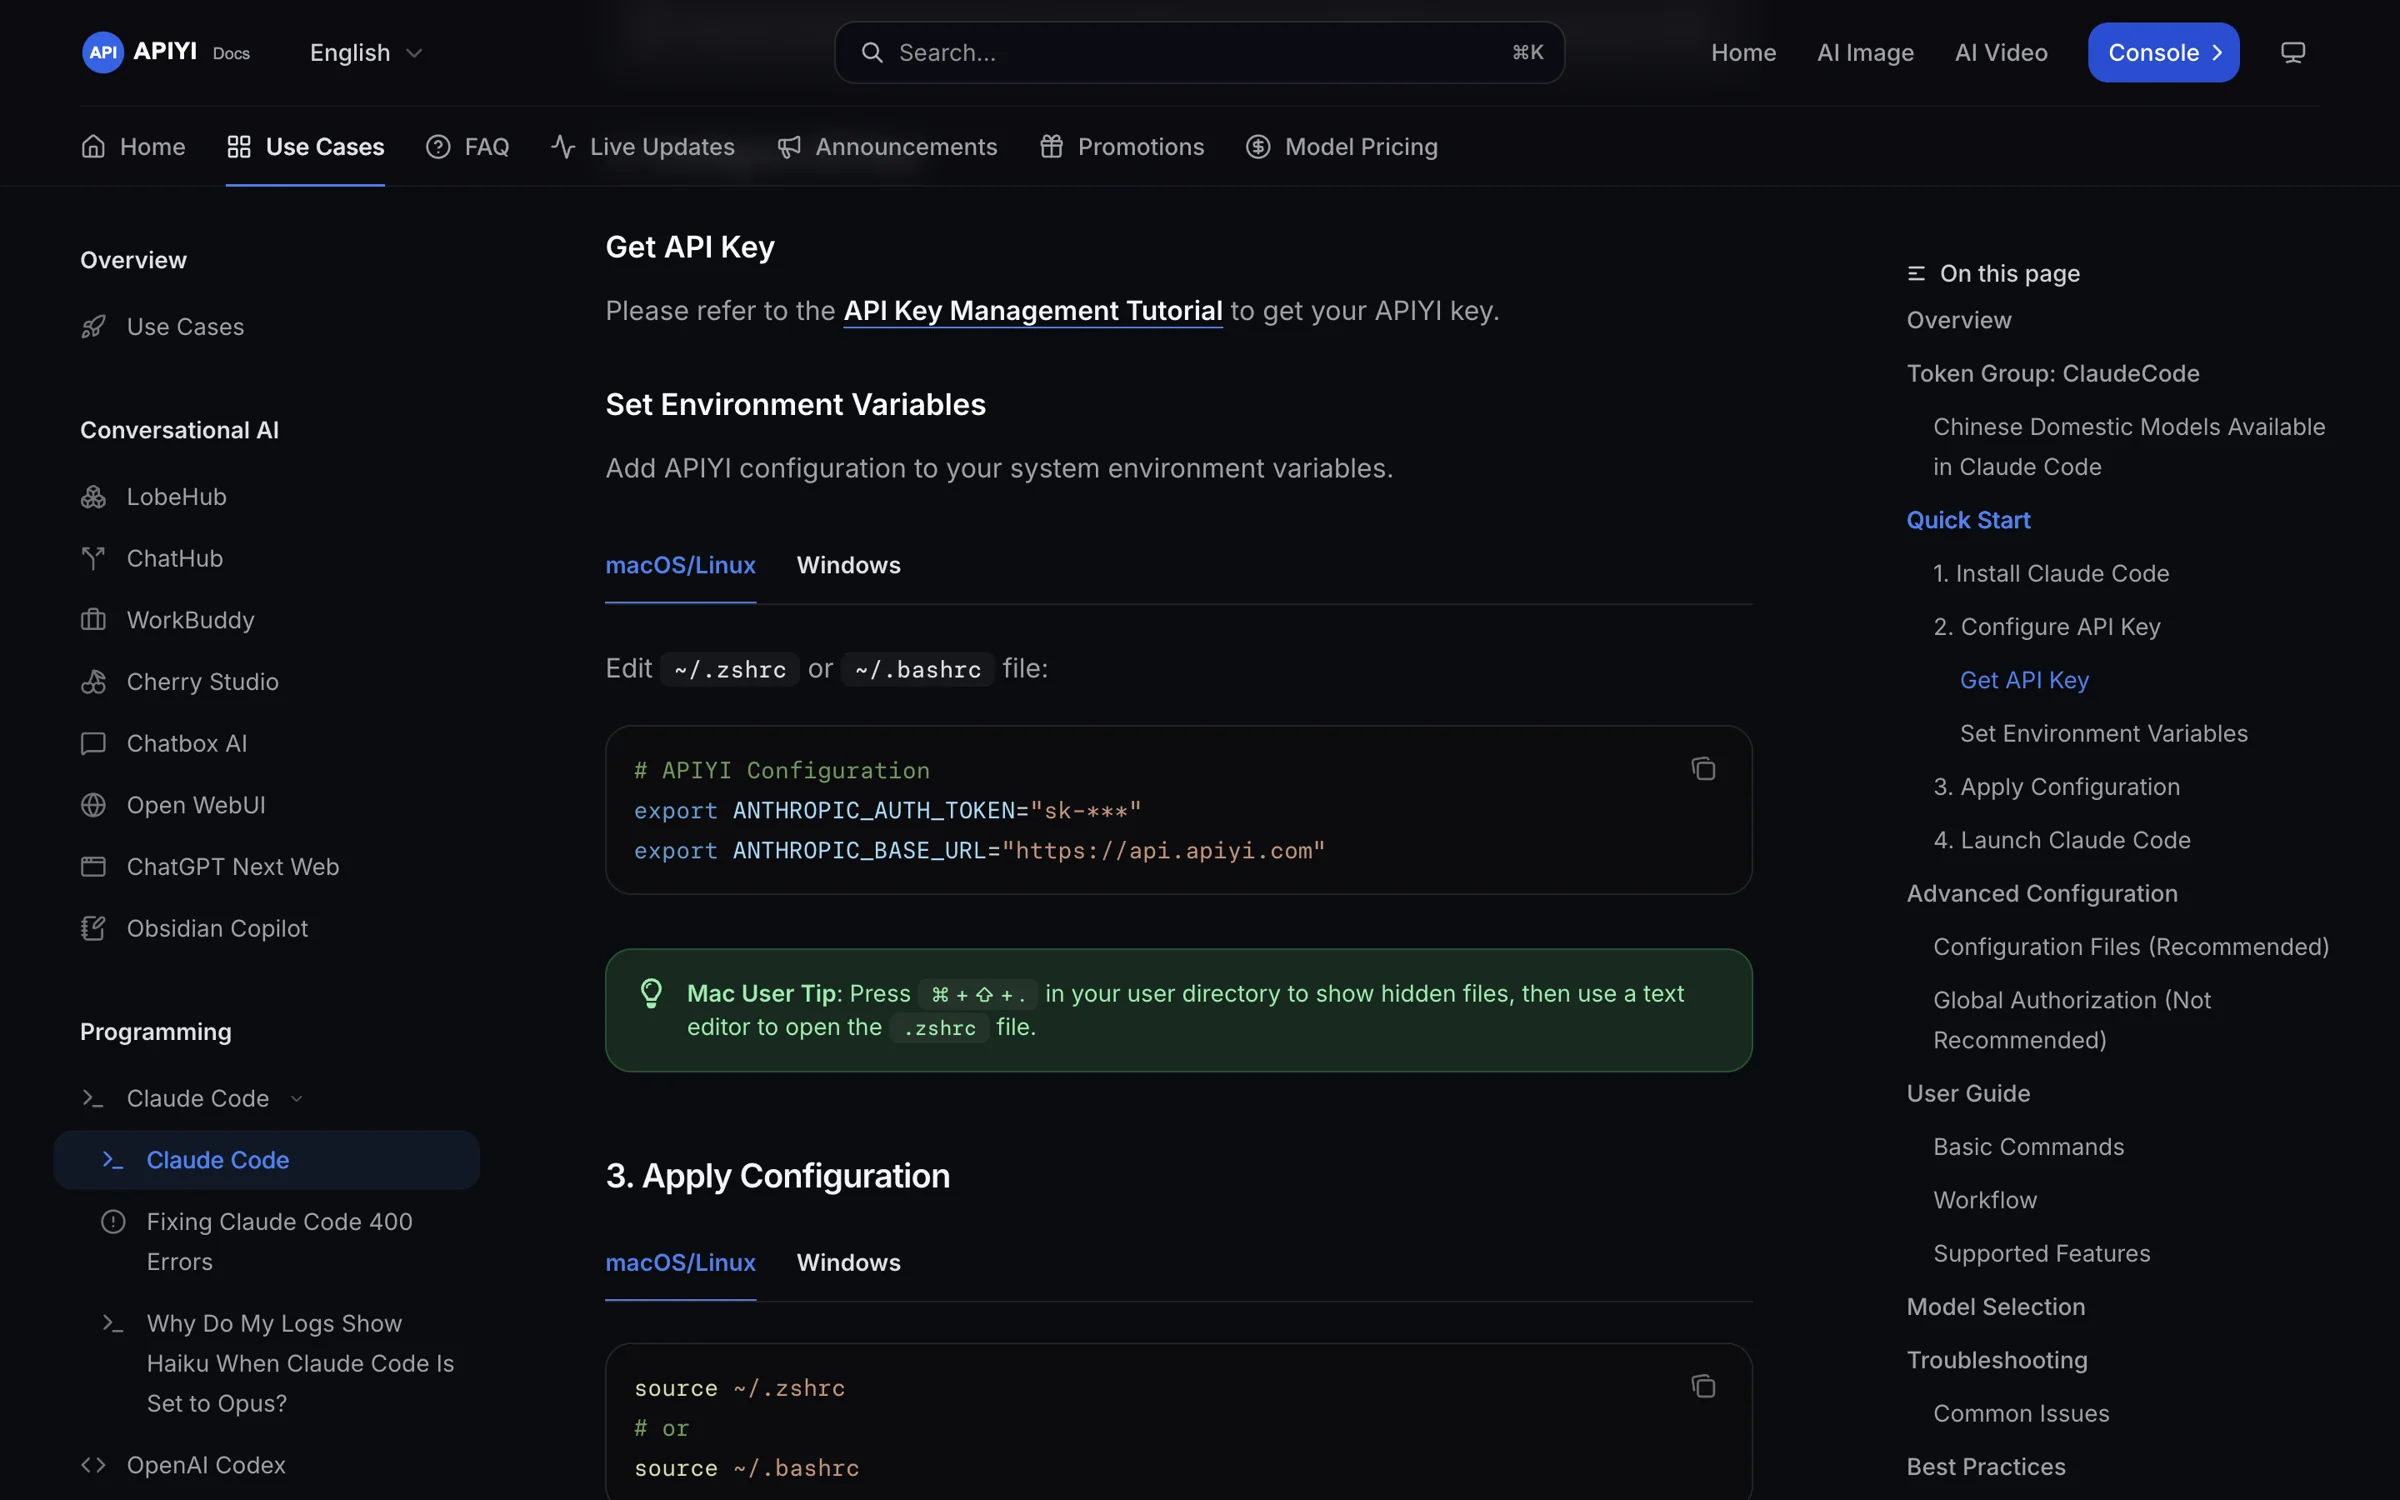
図4:APIYIのドキュメントにあるClaude Codeの設定。必要なのは2行の環境変数だけです(スクリーンショットのキーはマスク済み)
| モデル | 入力 | 出力 | キャッシュ読み取り | 利用可能なプラットフォーム |
|---|---|---|---|---|
| claude-opus-5-5 | $4 / 100万トークン | $20 / 100万トークン | $0.2 / 100万トークン | APIYI apiyi.com |
モデルと価格は、プラットフォームのモデル一覧で確認してください。研究用スキルのプロンプトには同じ SKILL.md が繰り返し含まれるため、キャッシュ読み取りの単価が入力の20分の1であれば、長いセッションではかなりの費用を節約できます。
3つの研究用Skillsを初めて動かす実践シナリオ
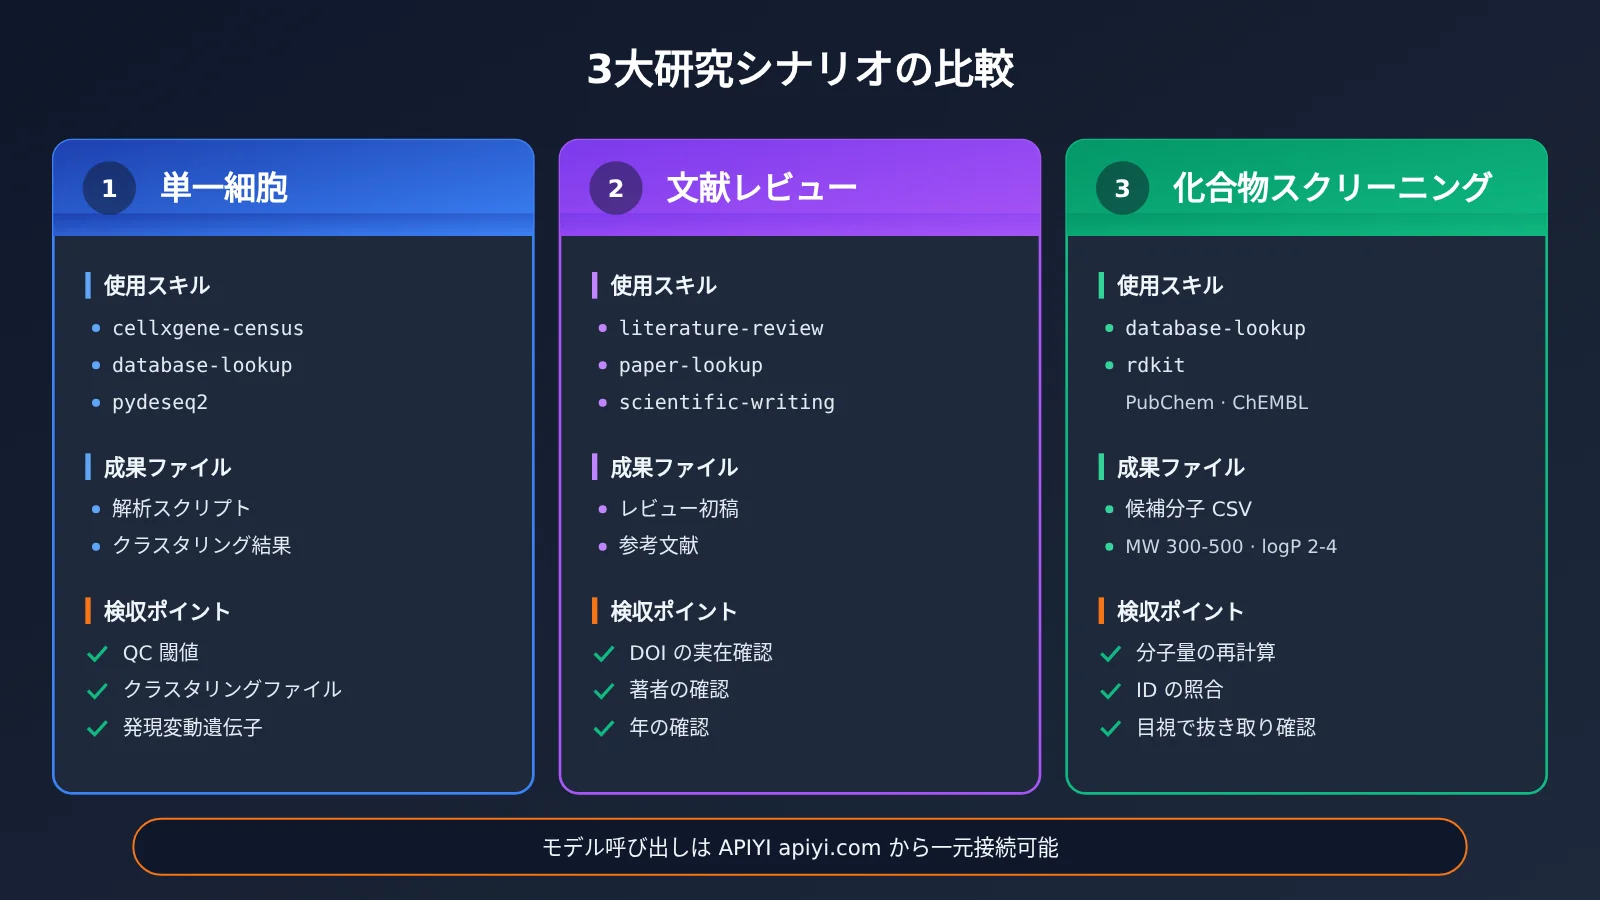
シナリオ1:シングルセル解析
プロンプトに Use available skills you have access to whenever possible. と書き、続けて「scanpyでQC、正規化、次元削減、クラスタリングを行い、cellxgene-censusで細胞型の参照情報を取得し、database-lookupでマーカー遺伝子を調べ、pydeseq2で差次的発現解析を行う」と指示します。エージェントはこれらのスキルを順に読み込み、解析スクリプトを生成して実行します。
結果を確認する際は、QCの閾値が明記されているか、クラスタリング結果のファイルが存在するか、差次的発現遺伝子が database-lookup の返したデータソースで見つかるかの3点を重点的にチェックします。
シナリオ2:文献レビュー
プロンプト:「literature-reviewスキルを使い、特定のテーマについてシステマティックレビューを行う。paper-lookupで文献情報を補い、最後にscientific-writingで初稿にまとめる」。このスキルはオンラインでDOIを検証します。各DOIを一つずつ開き、文献が実在すること、著者名と発行年に誤りがないことを確認しましょう。
シナリオ3:化合物スクリーニング
プロンプト:「database-lookupを使ってPubChemとChEMBLから候補分子を取得し、rdkitで分子量300〜500、logP 2〜4の条件でフィルタリングして、CSVを出力する」。結果を確認する際は、いくつかのデータを自分で抜き取り、RDKitで分子量を再計算してCSVの値と一致するか確認します。さらに、化合物IDをPubChemで検索し、対応する化合物が見つかるかもチェックしましょう。
科学研究向け Skills のトラブルシューティング
| 症状 | よくある原因 | 対処法 |
|---|---|---|
| スキルが読み込まれない | ディレクトリの配置が間違っている、またはスキルのディレクトリに SKILL.md がない |
ステップ3のディレクトリ表と照らし合わせて確認し、修正後にIDEを再起動します。Cursorの場合は Settings → Rules で認識されているか確認します |
| Pythonの依存パッケージが不足している | スキルのファイルだけをインストールし、依存パッケージをインストールしていない | SKILL.md の compatibility に従って uv pip install でインストールし、対応する環境が有効になっていることを確認します |
| データベースのレート制限にかかる | 一括リクエストが速すぎる、または無料枠を超えている | 対象データベースのドキュメントを確認し、キャッシュの追加、リクエストの分割、同時実行数の削減を行います |
| 認証エラーが発生する | キーが未設定、期限切れ、または権限不足 | echo で環境変数を確認し、対象サービスの管理画面で権限を確認します |
旧パス scientific-skills/ で404が返される |
v2.43.0以降、スキルのパスが skills/ に変更された |
ローカルスクリプトやブックマークのパスを更新するか、再インストールします |
| アンインストールして再インストールしたい | バージョンが混在している、またはシンボリックリンクが無効になっている | npx skills remove の後に npx skills add を実行します。バージョンを固定する場合は gh skill install --pin を使います |
Cloning repository… で止まり、Clone timed out が表示される |
リポジトリのサイズが400 MB以上あり、300秒では足りない | SKILLS_CLONE_TIMEOUT_MS=600000 を指定して再実行するか、先に git clone でローカルにクローンしてから、ローカルパスを使ってインストールします |
科学研究向け Skills のリスクと免責事項
このセクションは最後までお読みください。Scientific Agent Skills はコミュニティによるオープンソースプロジェクトであり、いかなるプラットフォームの公式 API でもありません。ここでは紹介するにとどまり、その安全性や品質を保証するものではありません。
スキルには実行能力があります。スキルは Agent に指示して、任意のコードの実行、パッケージのインストール、ネットワークリクエストの送信、ローカルファイルの変更ができます。悪意のあるスキルや不適切に書かれたスキルによって、Agent が意図しない動作をする可能性があります。以下の対策をおすすめします。
- インストール前に
SKILL.mdを読み、使用するパッケージや接続先の外部サービスを確認する - 貢献履歴を確認する。K-Dense-AI 名義のスキルは内部レビューを受けていますが、コミュニティから提供されたスキルは可能な範囲でのレビューにとどまります
- 自分でもスキャンする。まず
uv pip install cisco-ai-skill-scannerを実行し、次にskill-scanner scan <path> --use-behavioralを実行します。<path>はスキルのディレクトリに置き換えてください。プロジェクト側では毎週差分スキャンを行い、少なくとも 30 日ごとに全体を再スキャンしています。結果はdocs/security-report.mdで公開されています
第三者サービスの制約。一部のスキルでは、第三者のデータベースへの登録や、自分のキーの使用が必要です。その場合は、各サービスの利用規約や利用枠の制限を守ってください。大量のデータを一括取得すると、レート制限やアカウント停止の対象になる可能性があります。まずは別アカウントや隔離された環境でテストすることをおすすめします。
臨床・規制上の制約。臨床、医療、規制に関するスキルは、研究や文書の下書きにのみ使用できます。診断、出荷判定、認証に関する判断の代わりにはできません。
責任の所在。これらのスキルの使用に伴う結果については、利用者自身の判断と責任において対応してください。本プラットフォームおよび本記事の著者は責任を負いません。
よくある質問 FAQ
Q1:Scientific Agent Skills とは何ですか?
K-Dense-AI が管理する研究用スキルライブラリです。Agent Skills 標準に準拠した 177 個のスキルフォルダーで構成され、研究のワークフローの進め方や、使用するパッケージ、接続するデータベースを Agent に伝えます。モデルや API サービスではありません。
Q2:177 個の研究用 Skills を一つのコマンドでまとめてインストールしないほうがよいのはなぜですか?
まず、公式 README に一度にすべてをインストールしないよう明記されています。また、スキルが増えるほど Agent が適切なものを選びにくくなります。さらに、各スキルはコードを実行できるため、インストールする数が増えると、内容を確認する手間も増えます。研究分野に合わせて 5〜10 個選べば十分です。
Q3:なぜ現在は 181 個ではなく 177 個なのですか?
バージョン 2.72.0 以降、docx、pdf、pptx、xlsx の 4 つの文書関連スキルはリポジトリに含まれなくなりました。必要な場合は、Anthropic の skills リポジトリから別途インストールしてください。
Q4:スキルは無料とのことですが、主にどこで費用がかかりますか?
主な費用は、スキルの実行時に行われるモデル呼び出しです。スキルによってはサードパーティーのサービス料金も発生します。例えば、`generate-image` は OpenRouter を利用し、実行回数に応じて課金されます。モデルは APIYI apiyi.com を通じて従量課金で呼び出せ、固定月額料金はありません。まずは小さなワークフローでトークン消費量を確認し、長期的に使うモデルを決めるとよいでしょう。
Q5:Cursor にインストールしましたが、Agent がスキルを呼び出さない場合はどうすればよいですか?
まず Settings → Rules でスキルが認識されているか確認します。次に、プロンプトの冒頭に `Use available skills you have access to whenever possible.` を追加し、使いたいスキルを直接指定してください。それでも呼び出されない場合は、別のモデルに切り替えて比較してみましょう。APIYI apiyi.com なら、一つの APIキーで複数のモデルを切り替えられるため、原因を調べる際にも便利です。
Q6:研究結果の再現性を確保するにはどうすればよいですか?
`gh skill install –pin` を使ってスキルを特定のバージョンまたはコミットに固定し、Python の依存関係は独立した uv 環境内でバージョンを固定します。あわせて、`SKILL.md` の metadata.version と last-reviewed の日付を記録してください。
Q7:これらのスキルのライセンスはすべて MIT ですか?
必ずしもそうではありません。リポジトリ全体は MIT ですが、各スキルにはそれぞれ license フィールドがあります。例えば、`scanpy` は BSD-3-Clause です。商用利用する前に、一つずつ確認してください。
科学研究向け Skills の要点 Key Takeaways
- 何がある?:177個のオープンソース研究スキル。READMEに記載された22の大分類をカバー
- インストール方法:まず
--listで一覧を確認し、-sと-aで必要なものだけをインストール - 前提条件:Node.js 22.20以降、Python 3.13以降、uv、Agent Skills標準に対応したホスト
- よくある落とし穴:スキルファイルのインストールと依存関係のインストールは別。ワークフローごとにuv環境を作成する
- 確認すべきこと:どのスキルを使ったか、成果物はどのディレクトリにあるか、数値が出典と一致するか
- セキュリティ:インストール前に
SKILL.mdを読み、Ciscoのスキャナーでもチェックする - コスト:スキルは無料。モデル呼び出しはAPIYI apiyi.comからまとめて利用し、比較できる
まとめ
この177個の科学研究向けSkillsは便利ですが、一度にたくさん導入せず、順を追って進めましょう。
- 環境を確認してからインストール:環境のバージョンとホストの対応状況を確認し、
--listで5〜10個のスキルを選ぶ - スキルと依存関係は別々にインストール:スキルファイルは
npx skills add、Pythonの依存関係はuvでインストールする。どちらの手順も必要 - 結果を検証できるようにする:実行のたびに、使用したスキル、成果物の場所、数値の出典を確認する
まずは、よく知っている小さな作業(たとえば小規模なデータセットのscanpyクラスタリング)を最初から最後まで試し、徐々にスキルを追加するのがおすすめです。モデルについては、APIYI apiyi.comの従量課金でまず一通り試し、トークン消費量を見ながら長期的に使うモデルを選ぶとよいでしょう。
📚 参考資料
- Scientific Agent Skills リポジトリ:スキルのソースコード、README、セキュリティレポート
- リンク:
github.com/K-Dense-AI/scientific-agent-skills -
説明:177個のスキル、インストール方法、トラブルシューティング、
docs/security-report.mdを収録 -
skills インストーラー:npx skills のコマンドとパラメーター
- リンク:
github.com/vercel-labs/skills -
説明:add / list / check / update / remove などのコマンドや、70以上のホスト環境に対応するディレクトリを確認できます
-
Anthropic Skills リポジトリ:docx、pdf、pptx、xlsx のドキュメントスキル
- リンク:
github.com/anthropics/skills -
説明:2.72.0以降では、これら4つのドキュメントスキルを別途ここからインストールする必要があります
-
関連論文:Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents
- リンク:
arxiv.org/abs/2609.00065 -
説明:スキルライブラリの設計思想を理解できます
-
APIYI ドキュメント · Claude Code 接続:環境変数、グループ、トラブルシューティング
- リンク:
docs.apiyi.com/scenarios/programming/claude-code -
説明:2つの環境変数で Claude Code を APIYI に接続できます。スキルをインストールしたら、こちらを参考にモデルを動かしましょう
-
APIYI ドキュメント · GPT-Image 2 画像生成 Skills:コミュニティが提供する2つの画像生成スキル
- リンク:
docs.apiyi.com/scenarios/ecosystem/apiyi-gpt-image-skills -
説明:
apiyi-gpt-image-2-genとapiyi-gpt-image-2-all-genのパラメーター、料金体系、よくあるエラー -
APIYI モデル料金一覧:モデル名、種類、料金体系、単価
- リンク:
docs.apiyi.com/models - 説明:本記事で引用した claude-opus-5-5 の単価はこの一覧に基づいています。料金は変動するため、利用前に再度ご確認ください
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI サイトのトップページからお気軽にお問い合わせください。モデル接続に関するその他の資料は、docs.apiyi.com のドキュメントセンターをご覧ください