著者注:OpenAIの12時間 Prompt Cache が GPT-6 API のコストに与える影響を解説します。回収計算式と5つの判断基準を使って、キャッシュを有効にするとコスト削減につながるシーンと、効果が限定的なシーンを整理します。
OpenAI は Prompt Cache に12時間のキャッシュ保持機能を追加しました。GPT-6 API を呼び出しているチームにとって、コストを再計算する価値のある変化です。これまでのキャッシュは数分程度のアイドル時間しか有効ではなく、低頻度のリクエストでは割引をほとんど受けられませんでした。キャッシュウィンドウが長くなったことで、「数時間おきに戻ってくる」ようなリクエストにもヒットのチャンスが生まれます。
これは「キャッシュを有効にすれば自動的に半額になる」というマーケティング的な話ではありません。キャッシュがコストを削減できるかどうかは、プレフィックスが安定しているか、リクエスト間隔がどのくらいか、1回あたりのプレフィックスのサイズ、そしてキャッシュ書き込みに追加コストがかかるかどうかで決まります。本記事ではシンプルな回収計算式を使って、自分の業務で12時間キャッシュを有効にすべきかどうかを判断できるようにします。
本記事のポイント:5分で12時間 Prompt Cache の仕組みの変化をつかみ、5つの基準で GPT-6 API のキャッシュが本当にコストを削減できるのはどんなときかを見極められるようになります。
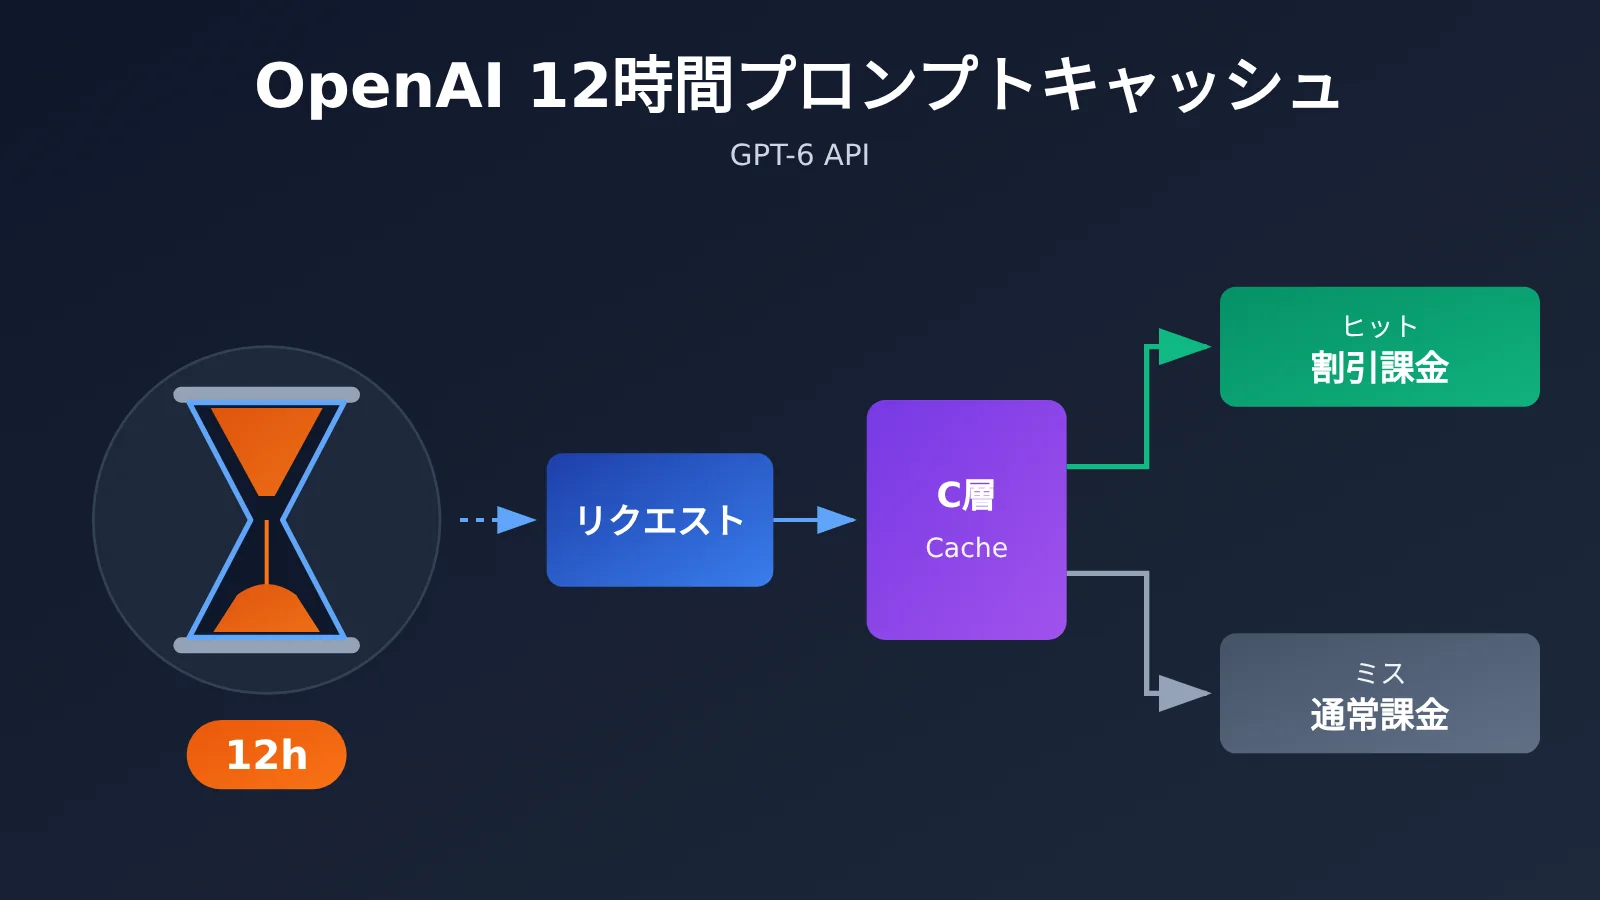
OpenAI 12時間プロンプトキャッシュの核心情報まとめ
まずは表で今回のアップデートの要点を整理しましょう。公式の価格やパラメータは随時調整されるため、課金比率に関する部分は OpenAI の公式ドキュメントおよび価格ページを参照してください。
| 項目 | 詳細 |
|---|---|
| アップデート内容 | プロンプトキャッシュに12時間の保持オプションを追加 |
| 発表元 | OpenAI |
| 対象モデル | GPT-6 API などプロンプトキャッシュに対応するモデル(公式のモデルリストに準拠) |
| 課金ロジック | キャッシュヒットした入力トークンは通常入力より低い単価で課金。具体的な割引率は公式価格ページを参照 |
| 主な変更点 | キャッシュが「数分のアイドルで失効」から最長12時間の保持に延長 |
| 影響範囲 | 長いシステムプロンプト、Agent のツール定義、RAG の固定ナレッジ、マルチターン対話などのシーン |
プロンプトキャッシュの仕組み
OpenAI のプロンプトキャッシュは「プレフィックスマッチング」に基づく仕組みです。リクエストの冒頭部分(システムプロンプト、ツール定義、固定ドキュメントなど)が直近のリクエストと完全に一致し、かつ公式が定める最小長のしきい値に達している場合、その部分のトークンはキャッシュヒットとして認識され、割引価格で課金されます。同時に、最初のトークンまでのレイテンシも大幅に短縮されます。
特に注意したいのは、キャッシュは「最初のトークンから連続して一致する」部分しか認識しないという点です。プレフィックスの途中にタイムスタンプやユーザー ID が1つでも挟まると、それ以降の内容はすべてヒットしなくなります。つまり「キャッシュを有効にするかどうか」よりも、プロンプトの構造設計のほうが重要です。静的コンテンツを前に、動的コンテンツを最後に配置しましょう。
12時間キャッシュと短期キャッシュの違い
従来の短期キャッシュは数分間アイドル状態になるとクリアされていたため、高頻度かつ連続的なリクエストでしか安定してヒットしませんでした。12時間保持では「ヒットウィンドウ」が数分単位から半日単位に拡大し、低頻度シーンのコスト構造を直接変えることになります。
| 比較軸 | デフォルトの短期キャッシュ | 12時間キャッシュ |
|---|---|---|
| 保持期間 | 数分のアイドル後に失効 | 最長約12時間 |
| 適したリクエスト頻度 | 高頻度・連続リクエスト | 中低頻度・断続的リクエスト |
| 典型的なメリットシーン | リアルタイム客服、バッチ連続呼び出し | 数時間後に会話へ戻るユーザー、日中の定期タスク |
| ヒット率の安定性 | トラフィック変動の影響が大きい | トラフィックの少ない時間帯に強い |
| 追加コスト | 通常は書き込み追加料金なし | 追加料金の有無は公式説明に準拠 |
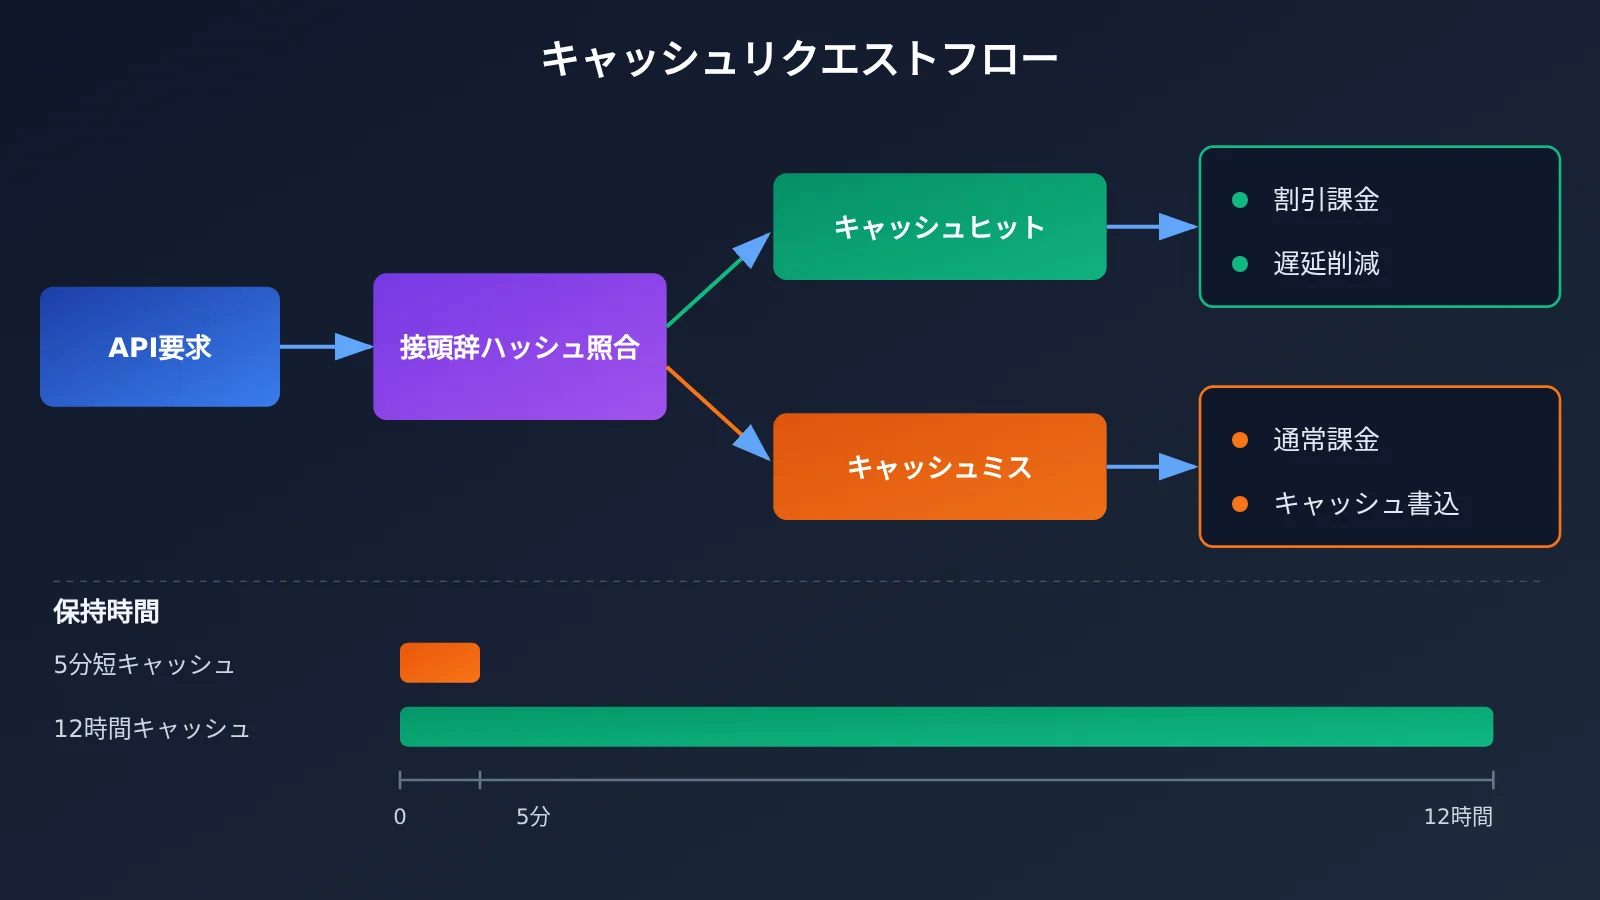
GPT-6 APIのキャッシュが本当にコストを削減するのはいつ?コスト回収の計算式
多くの記事は「キャッシュでコスト削減できる」とだけ述べていて、いくら削減できるのか、どんな条件で削減できるのかを説明していません。ここでは汎用的な計算式で問題を定量化します。自分のビジネスパラメータを代入するだけで済みます。
プロンプトキャッシュのコスト回収条件の導出
以下の変数を設定します:
L:キャッシュ可能なプレフィックスのトークン数P:通常入力の単価d:キャッシュヒット単価の通常単価に対する比率(0 < d < 1)w:初回書き込み時のキャッシュ追加コスト比率(追加料金なしの場合 w = 0)N:キャッシュ有効期間内に同じプレフィックスが呼び出される回数
キャッシュを使わない場合、プレフィックスの総コストは N × L × P です。キャッシュを使う場合、初回は書き込みコストで課金され、以降はヒット価格で課金されるため、総コストは L × P × (1 + w) + (N − 1) × L × P × d となります。
両者を差し引くと、非常にシンプルなコスト回収条件が得られます:N > 1 + w / (1 − d)。この式は2つのことを示しています。書き込みに追加料金がない場合(w = 0)、同じプレフィックスが有効期間内に1回でも再利用されればコスト削減が始まります。書き込みに追加料金がある場合、コスト回収には再利用回数がしきい値を超える必要があり、割引が大きいほど(dが小さいほど)回収が早くなります。
さまざまなシナリオでのコスト回収試算
以下では「仮のパラメータ」を使って試算を行います。これは計算式の使い方を示すためのものであり、OpenAIの実際の価格を表すものではありません。キャッシュヒット価格を通常価格の一定比率と仮定し、書き込み追加料金の有無それぞれで、コスト回収に必要な呼び出し回数を観察します。
| シナリオ仮定 | 書き込み追加料金 w | ヒット割引 d | 回収に必要な呼び出し回数 N | 結論 |
|---|---|---|---|---|
| 書き込み追加料金なし | 0 | 任意 | N > 1 | 1回の再利用でコスト削減 |
| 少額の書き込み追加料金 | 低い | 割引が大きい | 約2回 | ほとんどのシナリオでお得 |
| 高めの書き込み追加料金 | 高い | 割引が小さい | 3回以上 | 再利用頻度が高いシナリオのみお得 |
試算からわかるのは、12時間キャッシュの本当の価値は「割引そのもの」ではなく、Nを大きくできることにあるという点です。もともと数時間に1回しか来ないリクエストでは、短いキャッシュではNはほぼ1となり、コスト削減にはまったくつながりません。12時間に延ばすことで、同じプレフィックスが1日のうちに何度も再利用され、コスト削減効果が本当に現れます。
🚀 クイックスタート:実際のトラフィックでコスト回収条件を検証したい場合は、APIYI apiyi.com を通じて同じAPIキーで異なるモデルのキャッシュヒット状況を比較することをおすすめします。プラットフォームはOpenAI互換インターフェースを採用しており、新規ユーザーは無料テスト枠を受け取れます。
GPT-6 API でプロンプトキャッシュのヒットを検証する方法
キャッシュがコスト削減につながっているかどうかを判断する最も確実な方法は、レスポンスに含まれる usage フィールドを確認することです。OpenAI 互換インターフェースは usage.prompt_tokens_details.cached_tokens に今回キャッシュヒットしたトークン数を返すので、これをもとに実際のヒット率を計算できます。
最小構成のサンプル
以下のコードは、同じプレフィックスを持つリクエストを 2 回連続で送信し、2 回目の cached_tokens が 0 より大きくなるかどうかを確認するものです。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統合インターフェース、OpenAI 互換
)

SYSTEM_PROMPT = "あなたはベテランの技術アドバイザーです……(ここに最小キャッシュしきい値を超える固定の長いプロンプトを配置)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # プラットフォームのモデル一覧にある実際の名称に合わせてください
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"{i+1} 回目の質問:API のコストを最適化するには?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"{i+1} 回目のリクエスト、キャッシュヒットしたトークン数:{cached}")
完全な実装コードを見る(ヒット率の集計とキャッシュルーティングキーを含む)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """静的コンテンツを先頭に、動的コンテンツを末尾に置き、プレフィックスを安定させる"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key は、同じプレフィックスのリクエストを同じキャッシュにルーティングするのに役立つ
        # 12 時間の保持を有効にする場合は、OpenAI 公式ドキュメントに従って対応するパラメータを追加してください
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["キャッシュに優しいプロンプトはどう設計する?", "ツール定義はどこに置くべき?", "ヒット率はどう集計する?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"全体のキャッシュヒット率:{stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"リクエスト {idx}: prompt={p}, cached={c}")
アドバイス:まず小規模なトラフィックで 1 日ほど運用し、全体のヒット率とリクエスト間隔の分布を集計してから、本番環境で 12 時間キャッシュを全面有効化するかどうかを判断するとよいでしょう。APIYI apiyi.com でテスト用のクレジットを取得すれば、この種の検証は完了できます。複数の公式アカウントを個別に開設する必要はありません。
12時間プロンプトキャッシュの5つのコスト判断基準
回収の計算式を実際の業務に落とし込むと、次の5つの判断基準にまとめられます。当てはまる条件が多いほど、12時間キャッシュを有効にしたときの効果は大きくなります。
- プレフィックスが十分に長い:キャッシュ可能な固定部分が公式の最小しきい値に達している必要があり、長いほど割引総額も大きくなります。数百トークン程度の短いプロンプトでは、ヒットしても節約できる金額はごくわずかです。
- プレフィックスが十分に安定している:システムプロンプト、ツール定義、スキーマの順序が1日のうちに変わらないこと。プロンプトを頻繁に改版すると、キャッシュが繰り返し無効になります。
- リクエスト間隔が12時間以内に収まる:同じプレフィックスが数十分から数時間おきに呼ばれる場合、ここが12時間キャッシュが短時間キャッシュに対して生み出す最大の追加効果の領域です。
- 再利用回数が回収しきい値を超える:
N > 1 + w / (1 − d)で計算し、日中の再利用回数が安定的にしきい値を上回ることを確認します。 - 入力コストの比率が高い:請求額の大半が出力トークン由来の場合、キャッシュは入力側しか最適化しないため、全体の削減率は薄まってしまいます。
業務シーン別の12時間キャッシュ適性
| 業務シーン | リクエスト間隔の特徴 | 短時間キャッシュの効果 | 12時間キャッシュの追加価値 |
|---|---|---|---|
| リアルタイム顧客対応ボット | 高頻度で連続 | すでに良好 | ふつう。主にトラフィックの谷間を補う程度 |
| 企業ナレッジベースRAG | 中頻度、固定ドキュメントのプレフィックス | 変動が大きい | 明らか。日中に固定ナレッジを何度も再利用 |
| コーディングAgentのセッション | ユーザーが断続的にセッションへ戻る | 頻繁に無効化される | 非常に高い。長いコンテキストを数時間またいで再利用 |
| 日中定時バッチ処理 | 数時間ごとに1バッチ | ほぼ効果なし | 非常に高い。同じテンプレートを1日に複数バッチ |
| 一度きりの長文書分析 | 1回だけ呼び出し | 効果なし | ほぼなし。N = 1 では回収できない |
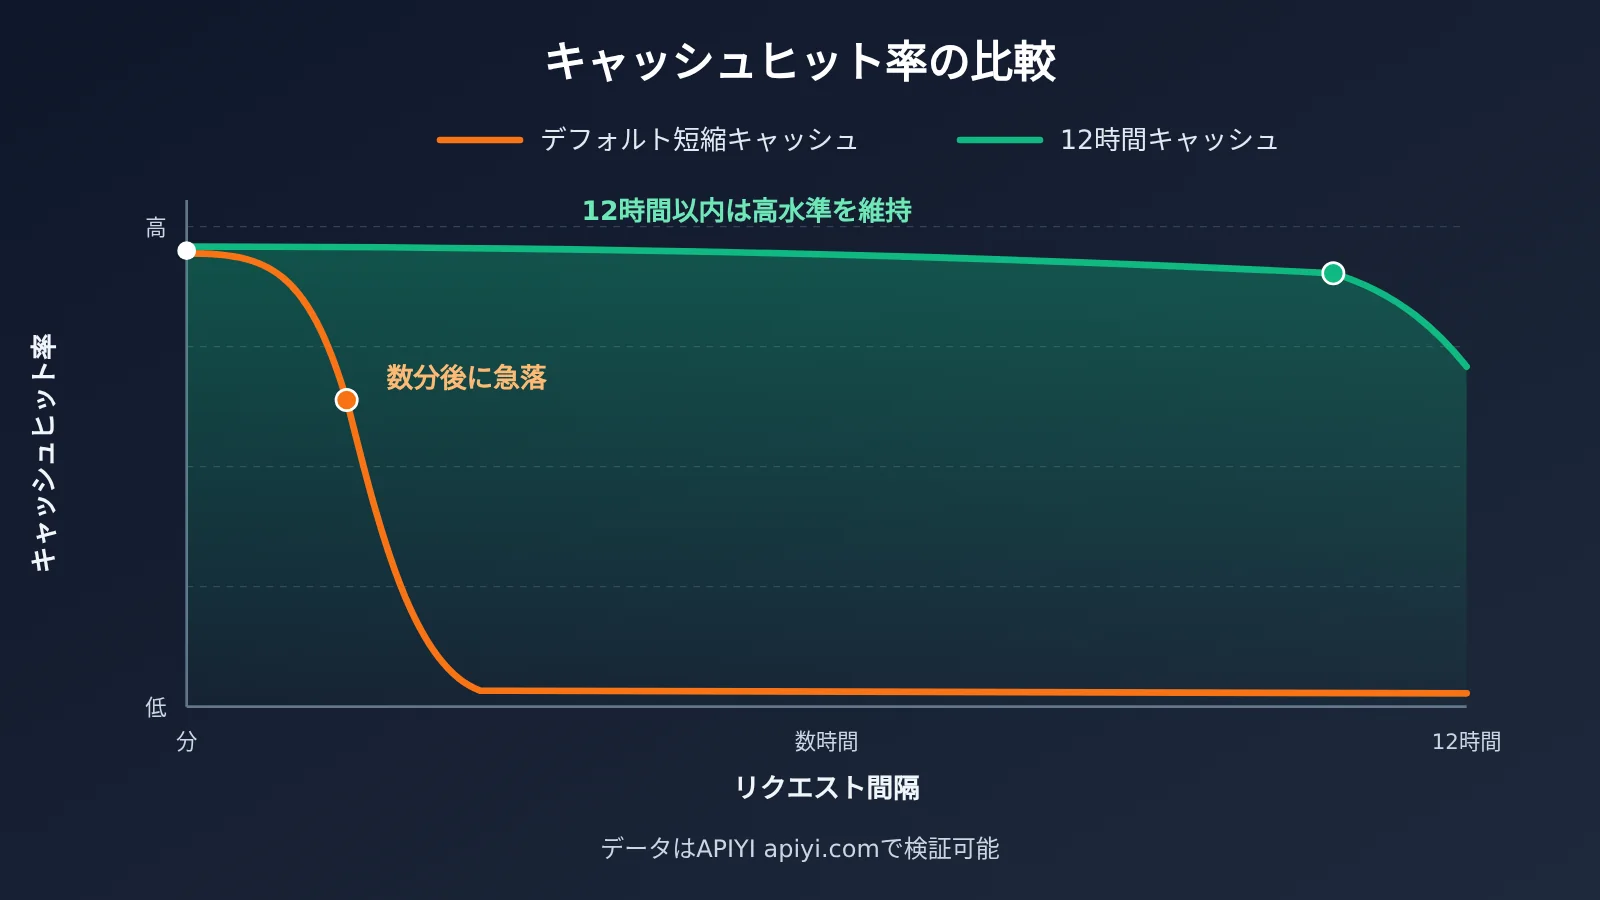
比較の説明:上の図は、リクエスト間隔が異なる場合の2つのキャッシュ戦略のヒット率の傾向差を示したものです。実際のヒット率はプレフィックスの安定性とトラフィック分布によって決まるため、ご自身の実際のリクエストログで比較することをおすすめします。
OpenAIの12時間プロンプトキャッシュがもたらす影響の分析
開発者への影響
- プロンプトエンジニアリングは「キャッシュエンジニアリング」へと進化が必要:システムプロンプト、ツール定義、固定ナレッジを安定したプレフィックスブロックとして整理し、バージョンを明示的に管理することで、ちょっとした変更がキャッシュ全体の失効を招く事態を避ける必要があります。
- コスト評価は「単価」から「実効単価」へ:同じGPT-6 APIでも、ヒット率の高いチームと低いチームでは、1,000リクエストあたりの実コストに明確な差が生まれる可能性があります。
cached_tokensの監視は、標準的な指標として定着していくでしょう。 - 長いコンテキストを扱うAgentがより現実的に:コーディングアシスタントやリサーチ型Agentはコンテキストが長くなりがちです。これまではユーザーが少し離席して戻ってくるだけで全額再計算が必要でしたが、時間をまたいだ再利用により、長いセッションの経済性は大きく改善します。
- レイテンシも同時に改善:キャッシュヒットしたリクエストは最初のトークンまでの遅延が短くなります。インタラクション体験が重要なプロダクトにとっては、うれしい副産物です。
業界への影響
- キャッシュがモデル価格競争の軸に:主要ベンダーはそれぞれ独自のプロンプトキャッシュ機能を提供しており、保持期間、割引率、書き込み料金の有無などが、開発者がモデルを選ぶ際の重要な判断材料になりつつあります。
- アグリゲーションプラットフォームのマルチモデル比較の価値が上昇:ベンダーごとにキャッシュのルールは大きく異なります。統一インターフェース上で実際の請求額を横並びで比較するほうが、公式の定価だけを見るよりも参考になります。
- RAGアーキテクチャは再評価される可能性:長いドキュメントのプレフィックスを半日ほど低コストで再利用できるようになると、中小規模のナレッジベースでは「検索してチャンク化」から「全文をコンテキストに入れてキャッシュ」へとシフトするケースが出てくるかもしれません。
マルチモデルのキャッシュ方式 選定リファレンス
| モデルの方向性 | キャッシュの特徴(各社公式ドキュメントに準拠) | 適した用途 | 利用可能なプラットフォーム |
|---|---|---|---|
| GPT-6 API | 自動プレフィックスキャッシュ、12時間保持オプションを追加 | 長いシステムプロンプト、Agentセッション | APIYI apiyi.com、OpenAI公式 |
| Claudeシリーズ | キャッシュのブレークポイントを明示的に指定する必要あり、保持期間を複数選択可能 | キャッシュ位置を細かく制御したいシーン | APIYI、Anthropic公式 |
| Geminiシリーズ | 暗黙的・明示的なコンテキストキャッシュに対応 | 非常に長いドキュメント、マルチモーダルなコンテキスト | APIYI、Google公式 |
💡 選定のヒント:モデルごとにキャッシュのルールは大きく異なります。同じ業務用プロンプトを複数のモデルで実際に試し、ヒット率と請求額を比較したうえで、出力品質も踏まえて判断することをおすすめします。
よくある質問 FAQ
Q1:OpenAI の 12 時間 Prompt Cache とは何ですか?
OpenAI の Prompt Caching メカニズムにおける、保持期間を延長したオプションです。同じプレフィックスを持つリクエストは、最長で約 12 時間のあいだキャッシュにヒットする可能性があり、ヒットした部分の入力トークンは割引価格で課金されます。また、最初のトークンまでのレイテンシも低減できます。
Q2:12 時間キャッシュとデフォルトの短時間キャッシュは何が違いますか?
デフォルトの短時間キャッシュは、数分間アイドル状態になると失効するため、高頻度で連続するリクエストにしか向いていません。一方、12 時間キャッシュは中・低頻度で断続的なリクエストをカバーします。リアルタイムのカスタマーサポートのような高頻度シナリオでは両者の差はほとんどありませんが、Agent のセッションや定時バッチ処理のように数時間の間隔が空くシナリオでは、12 時間キャッシュによる追加のメリットが明確に現れます。
Q3:12 時間キャッシュを有効にすれば必ずコストを削減できますか?
必ずしもそうではありません。キャッシュへの書き込みに追加料金がかからない場合、同じプレフィックスが有効期間内に一度でも再利用されればコスト削減が始まります。追加料金がかかる場合は、再利用回数が `1 + w / (1 − d)` を超えなければ元が取れません。一度きりの呼び出し、プレフィックスが頻繁に変わる場合、プレフィックスが非常に短い場合などは、メリットがごく限定的です。
Q4:GPT-6 API のキャッシュヒット率を高めるにはどうすればよいですか?
核心となる原則は「静的を前に、動的を後ろに」です:
– システムプロンプト、ツール定義、固定ドキュメントはメッセージの先頭に置き、順序を変えない
– タイムスタンプ、ユーザー ID、検索結果などの動的コンテンツは最後に置く
– 同じ種類のリクエストには固定のキャッシュルーティングキーを使い、同じキャッシュにルーティングされる確率を高める
– プロンプトの改版はまとめてリリースし、日中の頻繁な小修正を避ける
Q5:API を使って 12 時間キャッシュの効果を手軽にテストするにはどうすればよいですか?
複数モデルに対応した API アグリゲーションプラットフォームでのテストをおすすめします:
1. APIYI apiyi.com にアクセスしてアカウントを登録
2. APIキーと無料テスト枠を取得
3. 本記事のコード例を使用(base_url を `https://api.apiyi.com/v1` に置き換え)、`cached_tokens` を読み取ってヒット率を集計
APIYI は OpenAI 互換インターフェースを採用しているため、1 つのキーだけで GPT、Claude、Gemini のキャッシュ性能を比較できます。
Q6:Prompt Cache にはどのような既知の制限がありますか?
キャッシュは、最小長のしきい値に達した連続するプレフィックスに対してのみ有効で、最適化されるのは入力側のコストだけです。出力トークンは割引されません。キャッシュは「ベストエフォート」のメカニズムであり、高負荷時やトラフィックのルーティングが変化した場合にはヒットしないことがあります。ヒット率を 100% の保証として扱うべきではありません。12 時間保持の具体的な課金方式および対応モデルについては、OpenAI の公式ドキュメントを参照してください。
12時間 Prompt Cache の核心ポイント Key Takeaways
- メカニズムの本質: プレフィックスの完全一致に基づき、ヒットした入力トークン部分は割引価格で課金される
- 核心的な変化: 保持期間が分単位から約12時間に延長され、低頻度のリクエストもカバー
- 元が取れる計算式: 再利用回数 N > 1 + w / (1 − d) で初めてコスト削減になる
- 最も恩恵を受けるシナリオ: Agent の長時間セッション、ナレッジベース RAG、日中の定時バッチ処理
- 効果が限定的なシナリオ: 単発呼び出し、短いプレフィックス、頻繁に改版されるプロンプト
- 実装の鍵: 静的コンテンツを前方に配置し、cached_tokens でヒット率を継続的に監視
- 検証方法: APIYI apiyi.com を通じて実際のトラフィックで小規模テストしてから全体を有効化
まとめ
OpenAI 12時間 Prompt Cache が GPT-6 API のコストに与える核心的な影響:
- コスト削減の鍵は再利用回数: 12時間のウィンドウによって、中低頻度のリクエストでも同じプレフィックスを複数回再利用でき、N を1から引き上げることこそが本当の付加価値です。
- 書き込みコストが元を取るための閾値を決める: 書き込みに追加料金がなければほぼ確実に得になり、追加料金がある場合は回収計算式で試算する必要があります。
- Prompt の構造はスイッチよりも重要: 静的コンテンツの前方配置、バージョン管理、ヒット率の監視によってこそ、キャッシュ割引を実際の請求額に反映できます。
長いシステムプロンプトや Agent セッションのような高収益シナリオから始めて、1日実際のトラフィックを流してヒット率を確認してから、全面的な展開範囲を決めることをおすすめします。APIYI apiyi.com を通じて複数モデルのキャッシュ効果を素早く比較するのがおすすめです。プラットフォームは無料のテスト枠と統一された OpenAI 互換インターフェースを提供しています。
📚 参考資料
- OpenAI Prompt Caching 公式ガイド:キャッシュの仕組み、最小しきい値、usage フィールドの説明
- リンク:
platform.openai.com/docs/guides/prompt-caching -
説明:キャッシュヒットのルールと最新の保持期間パラメータを確認できる信頼性の高い情報源です
-
OpenAI API 料金ページ:各モデルの通常入力・キャッシュ入力・出力の単価
- リンク:
openai.com/api/pricing -
説明:コスト回収の計算式に当てはめるときは、このページのリアルタイム価格を基準にしてください
-
OpenAI API Reference:Chat Completions と Responses インターフェースのパラメータ説明
- リンク:
platform.openai.com/docs/api-reference - 説明:prompt_cache_key などキャッシュ関連パラメータの具体的な使い方を確認するときに便利です
作者: APIYI 技術チーム
技術交流: APIYI のウェブサイトトップページからぜひお問い合わせください。モデルの接続やコスト最適化のソリューションをさらにご提供します