著者注:MiniMax M3.1 Flashの重みは、10月23日に公開される予定です。この記事では、ローカルで運用する場合に必要なハードウェアの目安を紹介し、「自分でデプロイする場合」と「APIを直接利用する場合」のどちらが得かを4つの観点から比較します。
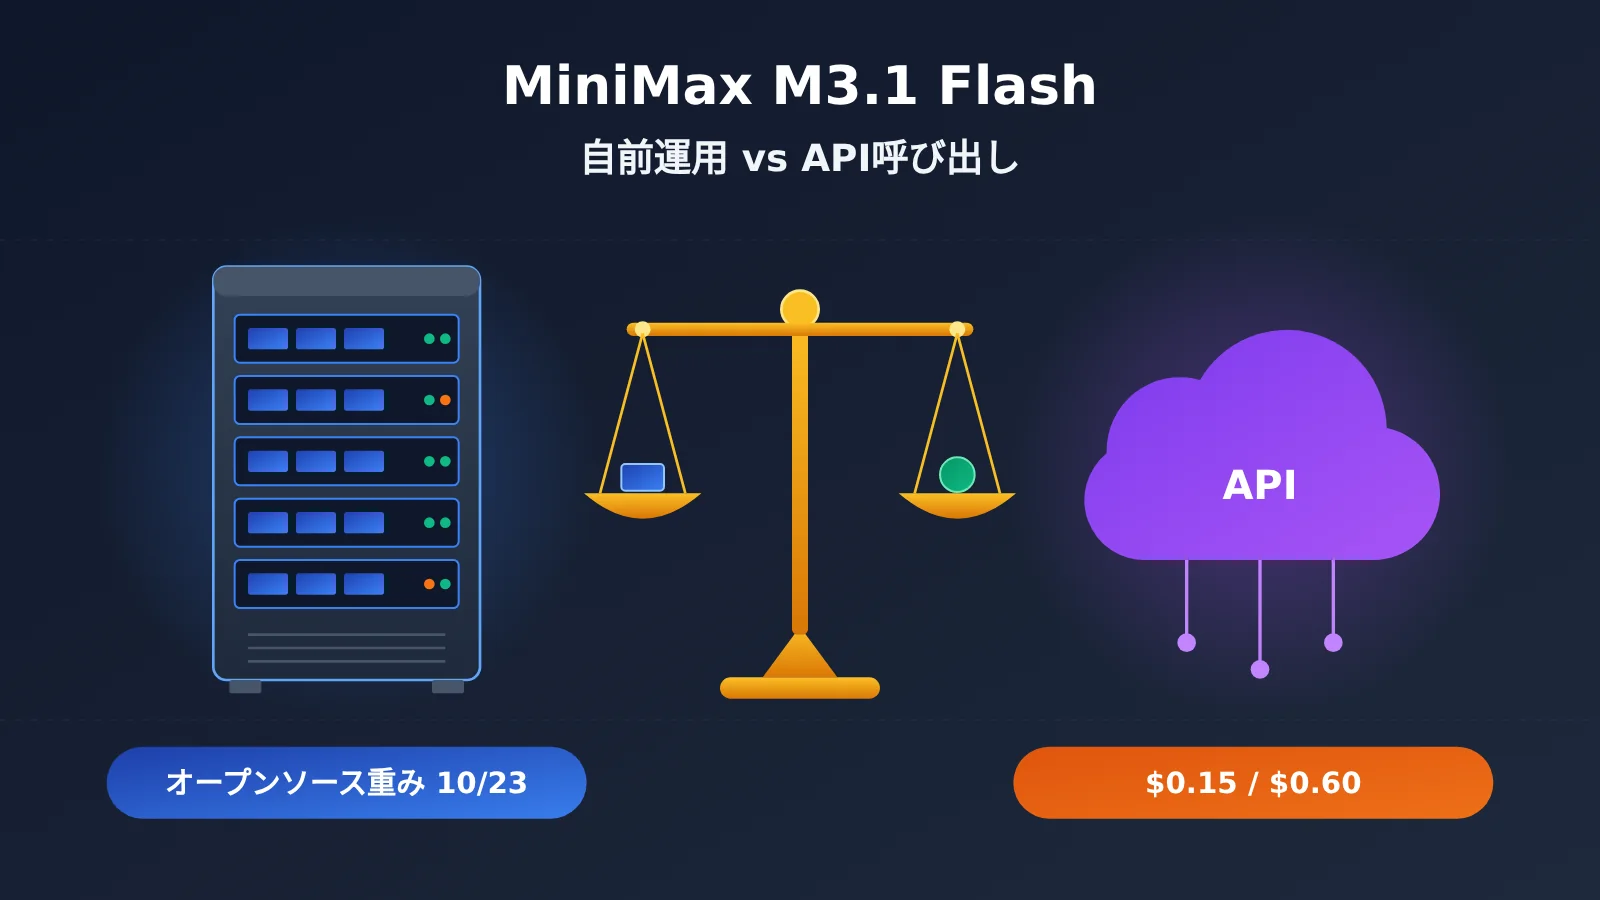
先に結論をお伝えすると、ほとんどの個人開発者や小規模チームにとっては、入力100万トークンあたり0.15ドル、出力100万トークンあたり0.60ドルのAPIを直接利用するほうが、自分でデプロイするよりも安く、手間もかかりません。 自前でのデプロイを検討する価値があるのは、次の3つのケースに限られます。規制上、データを社内ネットワークの外に出せない場合、マルチGPUサーバーを長時間フル稼働させられるほど呼び出し量が多い場合、あるいはモデル自体を変更・ファインチューニングしたい場合です。
この記事は、オープンソースを否定するものではありません。 オープンウェイトは業界にとって価値がありますが、「ダウンロードできる」ことと「自分で運用する価値がある」ことは別の話です。M3.1 Flashの発表については、すでに本サイトで別の記事を公開しています。この記事では発表内容を繰り返さず、「ローカルでの運用にどんな構成が必要か」「自前でデプロイするのとAPIを利用するのとでは、どちらが得か」という2つの疑問に絞って解説します。
この記事でわかること:読み終えるころには、公開予定の重みを待つべきかどうか、また公開後にまず何を確認すればよいかを判断できるようになります。
MiniMax M3.1 Flashのオープンウェイトの現状:確定していること、まだ発表されていないこと
まず、用語を説明します。オープンウェイトとは、学習済みモデルのパラメータファイルが公開され、自分のサーバーにダウンロードして実行できる状態を指します。「オープンソースコード」とは異なり、自由に商用利用できるという意味でもありません。利用条件はライセンスによって異なります。
記事執筆時点(2026年10月22日)で、M3.1 Flashのウェイトはまだ正式に公開されていません。MiniMax公式のX投稿には「Model weights will arrive on Oct 23」とあり、10月23日の公開を予定しています。公式ブログでは「後日公開」とのみ記載されています。また、上海ニューヨーク大学RITSの報道によると、10月20日時点でMiniMaxのHugging Face組織にはM3.1 Flashのリポジトリがありませんでした。
情報の確度を区別するため、この記事では事実を公式発表(MiniMaxが自ら発表)、第三者評価(Vals AIなど)、不明/未発表の3段階に分類します。
| 情報項目 | 現状 | 情報の区分 |
|---|---|---|
| ウェイトの公開時期 | 公式X投稿では10月23日の予定。公式ブログには「後日」とのみ記載 | 公式発表(予定、未実施) |
| モデル規模 | MoEアーキテクチャ。総パラメータ数は428B、アクティブパラメータ数は約23Bで、M3と同じ | 公式情報、メディア報道経由 |
| ライセンス | M3.1 Flashのライセンスは未発表 | 不明/未発表 |
| デプロイに必要なハードウェア | 公式デプロイガイドにM3.1 Flashの記載はまだない | 不明/未発表 |
| 技術レポート | FlashでM3から何が変更されたのかを説明する資料は未公開 | 不明/未発表 |
| 参考モデルのM3 | ウェイトは6月からHugging Faceで公開済み。コミュニティライセンスを採用 | 公式情報 |
⚠️ 注意:ウェイト公開後のライセンス条項、ファイルサイズ、推奨ハードウェアについては、Hugging Faceに掲載されるMiniMax公式モデルページを必ず確認してください。コミュニティによる転載や量子化版は公式の検証対象ではないため、公式の構成として扱わないでください。
MiniMax M3.1 Flashのローカルデプロイに必要な構成
公式からM3.1 Flashのハードウェア要件はまだ発表されていないため、ここではVRAM容量やGPUの枚数を推測しません。参考にできるのは、同規模の前世代モデルであるM3です。総パラメーター数(428B)とアクティブパラメーター数(約23B)が同じなので、必要なリソースの大まかな目安として参考にできます。
MiniMax M3.1 Flashの「総パラメーター数428B、アクティブパラメーター数23B」とは
MoE(混合エキスパート)は、モデルを複数の「エキスパート」サブネットワークで構成する仕組みです。推論のたびに、そのうち一部だけを呼び出します。「アクティブパラメーター数が約23B」とは、トークンを1つ生成する際に実際に計算に使われるパラメーターの数を指します。そのため、比較的高速に動作します。
ただし、誤解しやすい点があります。アクティブパラメーターが少なくても、必要なVRAMが少ないとは限りません。 どのエキスパートも必要に応じて呼び出せるよう、推論時には428BすべてのパラメーターをVRAM(GPU専用メモリ)に読み込んでおく必要があります。これが、MoEの大規模言語モデルをローカルで動かすハードルが高い主な理由です。
MiniMax公式が示すM3の参考デプロイ構成(規模の目安として)
まず、いくつかの用語を説明します。MXFP8は8ビット精度の保存形式で、モデルファイルのサイズとVRAM使用量を抑えられます。SGLangはオープンソースの推論フレームワークで、モデルをOpenAI互換形式のAPIサービスとして稼働させられます。TP(テンソル並列)は、モデルを複数のGPUに分割して連携させる方式です。
| モデル | 公式の参考構成 | 重みのサイズ | 状態 |
|---|---|---|---|
| MiniMax-M3 | B200 × 8、MXFP8精度、SGLangのOpenAI互換インターフェース | MXFP8版で約440 GB | Experimental(実験的) |
| MiniMax-M2.7 | 大容量VRAM搭載のNVIDIA GPU 4枚、TP 4 | 統一された最低VRAM容量は未公表 | Preview |
| MiniMax-M3.1 Flash | 公式のデプロイガイドでは未対応 | 未公表 | 不明/未公表 |
改めて強調しますが、上の表に記載したM3のデータは、M3.1 Flashの公式要件ではありません。 同規模モデルの公式参考構成がデータセンター向けGPU 8枚であり、MXFP8の重みだけでも約440 GBあることを示しています。これはコンシューマー向けGPUや一般的なワークステーションの範囲を大きく超えています。個人が自宅でゲーム用GPUを1〜2枚使ってフルモデルを動かすのは現実的ではありません。
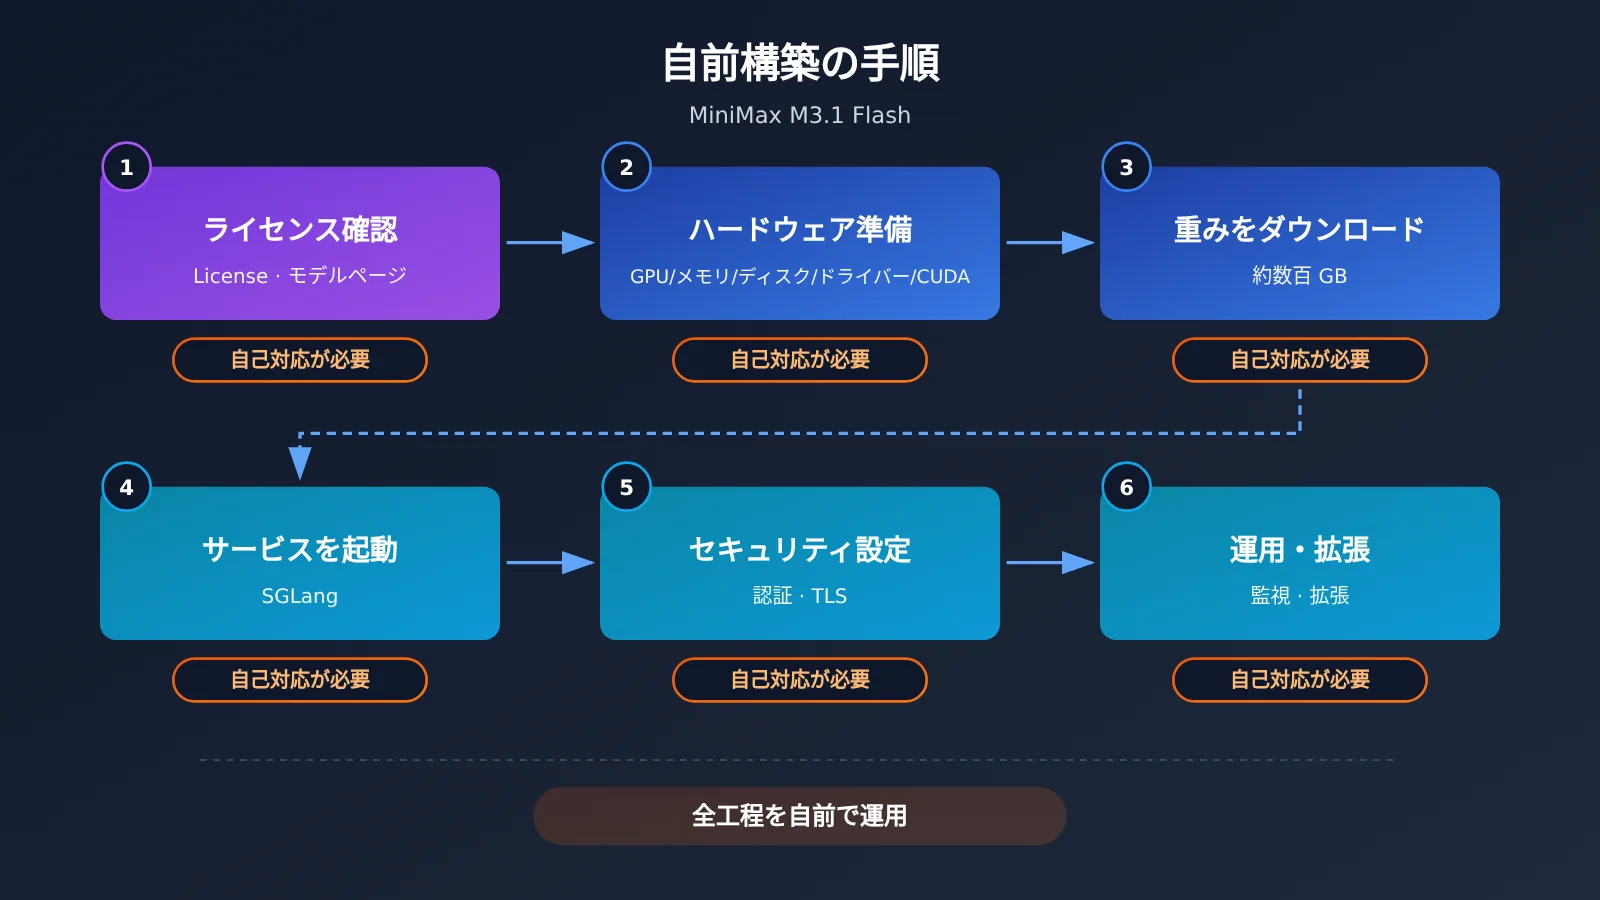
MiniMaxの公式デプロイ文書では、すべてのオープンソースモデルに共通する事前準備として、次の点も挙げられています。
- ライセンスと利用可能な範囲を確認する:自分の用途が許可されていることを確認します。
- モデルページを参考にハードウェアを準備する:GPU、メモリ、ディスク、ドライバー、CUDAのバージョンを確認します。
- バージョンを固定する:モデルと推論フレームワークのバージョンを固定し、main/latestブランチの更新に追従しないようにします。
- 国内ミラーはモデルページに記載された公式ソースのみを使う:改ざんされたファイルをダウンロードしないようにします。
MiniMax M3.1 Flashは自社でデプロイするべき?それともAPIを利用するべき?
この記事の中心となるテーマです。以下の4つの観点から、自分の状況に当てはめて判断してみましょう。
| 判断基準 | APIの利用が向いているケース | 自社でのデプロイが向いているケース |
|---|---|---|
| データのコンプライアンス要件 | データをクラウドサービス事業者に送信して処理できる | 法規制や契約により、データを社内ネットワークの外に出せない |
| 利用量 | 中小規模、または利用量の変動が大きい | 長期的に大規模利用し、複数GPU搭載サーバーを継続的にフル稼働できる |
| チームの運用能力 | GPU運用を専門に担当する人がいない | クラスターの管理、監視、オンコール対応を担う人がいる |
| モデルを変更する必要性 | 汎用的な機能で十分 | ファインチューニングや構造の変更、高度なカスタマイズが必要 |
最初の3項目のうち2つ以上が左側に当てはまるなら、APIを選べばまず間違いありません。
MiniMax M3.1 Flash APIの料金計算
公式料金は固定で、入力が$0.15、出力が$0.60、キャッシュ読み取りが$0.015です。いずれも100万tokensあたりの料金で、長いコンテキストによる追加料金はありません。tokenとは、モデルの料金計算に使われるテキストの単位です。公式の換算では、英単語約750語が約1000 tokensに相当します。キャッシュ読み取りとは、同じプレフィックスの内容を繰り返し送信した場合に、より低い料金で計算される仕組みです。
公式料金で計算した例を見てみましょう(実測値ではありません)。月間の入力が1億tokens、出力が2000万tokensの場合、料金は100 × $0.15 + 20 × $0.60 = $27です。個人や小規模チームの利用量としては、かなり多いほうですが、それでも月額は数十ドル程度です。
自前でデプロイする場合は、別の計算が必要です。M3の8 × B200構成を参考にすると、こうしたマシンは購入でもレンタルでも継続的に固定費がかかり、利用されていない間も費用が発生します。このコストを回収するには、マシンを長時間高負荷で稼働させるほどの呼び出し量が必要です。多くの個人や小規模チームでは、そこまでの利用量には届かないでしょう。
注意点として、M3.1 Flashでは思考プロセスを無効にできません。effort(思考の深さ)を指定しない場合、デフォルトでmaxに設定されます。思考内容も出力tokenとして計算されるため、実際の請求額は出力分が想定より多くなることがあります。費用を抑えたい場合は、effortをlowまたはmediumに設定しましょう。
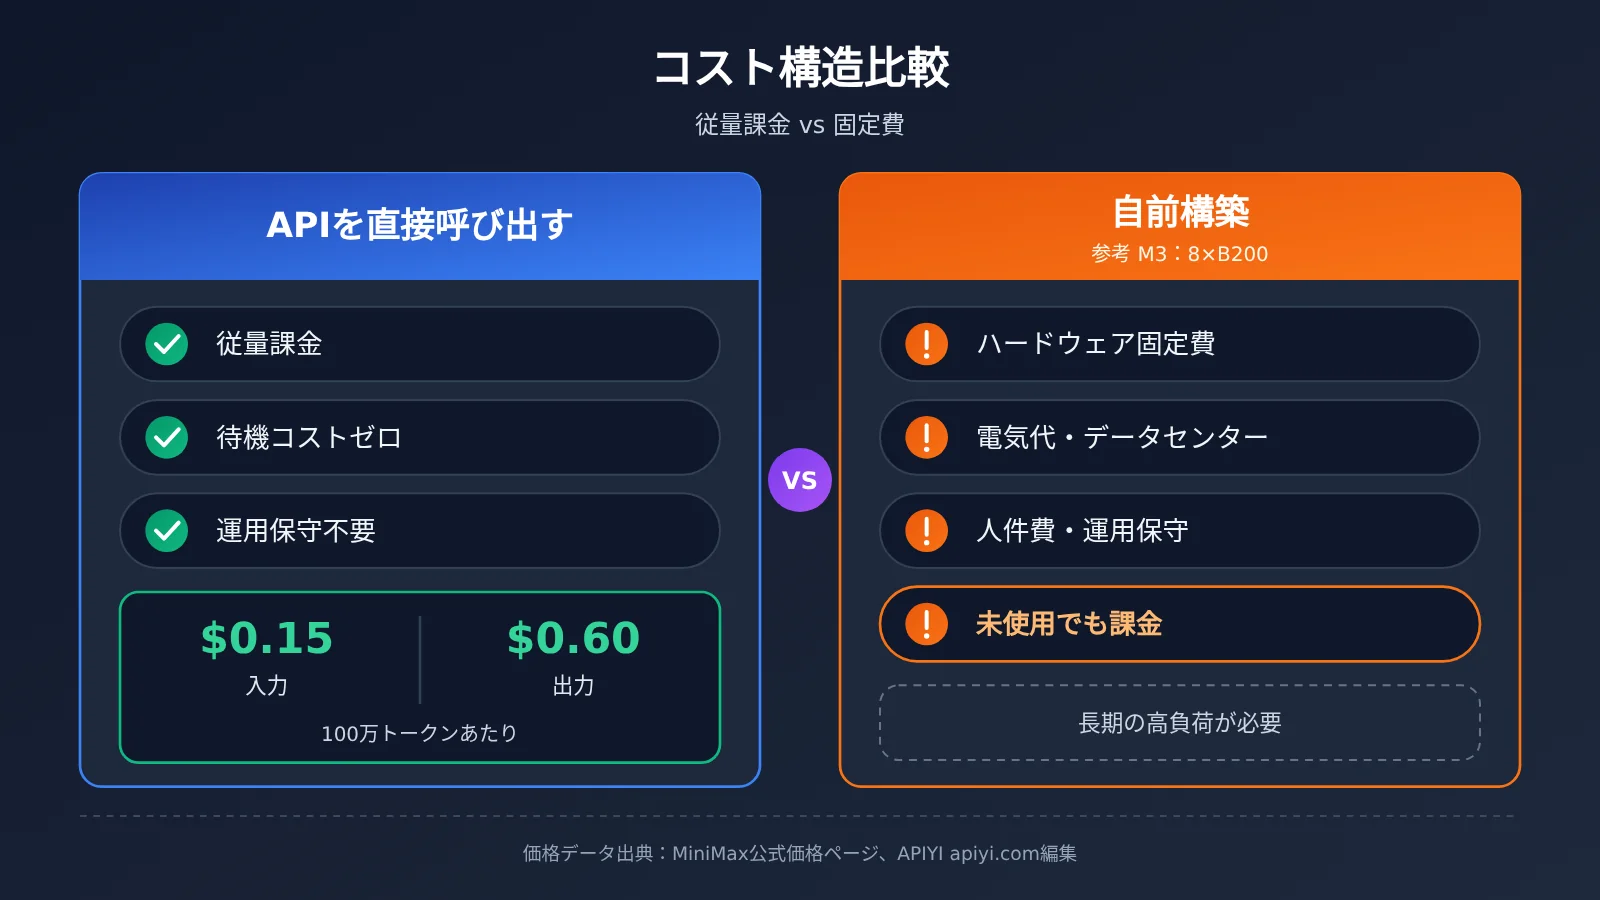
上図の料金はMiniMax公式料金ページに基づき、APIYI apiyi.comの技術チームがまとめたものです。以下の表では、比較対象としてよく挙げられるモデルの公式料金を紹介します。
| モデル | 入力料金(100万tokensあたり) | 出力料金(100万tokensあたり) | 利用可能なプラットフォーム |
|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | MiniMax公式API、M Plan。APIYIで利用できるかどうかは料金ページをご確認ください |
| MiniMax-M3(入力512K以下) | $0.30 | $1.20 | MiniMax公式API、APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | Anthropic公式、APIYI apiyi.com |
| claude-opus-5 | $5 | $25 | Anthropic公式、APIYI apiyi.com |
💰 コストに関するアドバイス:MiniMaxシリーズを今すぐ試したい場合は、まずAPIYI apiyi.comで利用できるMiniMax-M3を呼び出し、動作を確認してみましょう。M3.1 FlashがAPIYIで利用できるかどうかは、料金ページをご確認ください。こちらでも、できるだけ早く提供を開始する予定です。
MiniMax M3.1 Flashを自前でデプロイする場合に必要な対応
MiniMaxの公式ドキュメントには、オープンソースの重みには、プラットフォーム上のキャッシュやコンテンツセーフティなどの機能が含まれていないこと、またサービスはデフォルトでローカルからの接続のみを受け付けることが明記されています。自前でデプロイする前に、次の項目を担当する人がいるか確認しましょう。
- 認証:APIにアクセスキーを設定し、第三者が自由に呼び出せないようにする
- TLS暗号化:外部に公開する場合はHTTPSで通信を暗号化し、データの盗聴を防ぐ
- ネットワーク分離:推論サービスにアクセスできるマシンやネットワークセグメントを制限する
- 監視とアラート:GPU使用率、VRAM、レイテンシ、エラー率を継続的に監視する
- キャパシティ計画とスケールアウト:ピーク時にリクエストが滞留した場合に備え、拡張計画をあらかじめ用意する
- 障害復旧とアップグレード:マシンが停止した場合の復旧方法や、新バージョンを段階的に切り替える方法を決めておく
- コンテンツセーフティ:入出力コンテンツの審査機能を自分たちで追加する
- ライセンス遵守:デプロイ、再配布、商用利用の前に、ライセンス全文と利用ポリシーを確認する
このリストのどれか一つでも担当者がいなければ、自前でデプロイして節約したトークン料金が、運用コストで相殺されてしまう可能性があります。
MiniMax M3.1 Flashの性能をどう見るか:公式発表と第三者評価
自社環境にデプロイするかどうかを決める前に、まずはモデルの実力を確認しましょう。以下の表では、情報の出どころごとに指標をまとめています。
| 指標 | データ | 情報の出どころ |
|---|---|---|
| Automation-Bench v1.0.6 | 62.2、Claude Opus 5は50.3 | 公式発表 |
| BankerToolBench | 76.2、Claude Opus 5と同水準 | 公式発表 |
| Terminal Bench 4.0 | 38.1、Claude Opus 5は51.8 | 公式発表 |
| SWE Refactor Bench | 23.0、Claude Opus 5は31.0 | 公式発表 |
| 推論速度 | ブログでは日常利用で200+ TPS、P50で170+。製品ページでは約150 tokens/秒 | 公式発表(測定条件にばらつきあり) |
| Vals Index | 53.78%。全22モデル中15位、オープンウェイトモデル中5位 | 第三者評価 |
| Vals Terminal-Bench 4.0 | 25.25%。全51モデル中22位 | 第三者評価 |
| 「M3の1/3のコスト」 | タスク単位で算出。具体的な計算方法は非公開 | 不明/未公表 |
TPSは、1秒あたりに生成するトークン数です。数値が大きいほど、回答が速く生成されます。
Claudeとの比較については、前提を明確にしておく必要があります。MiniMaxの公式表に記載されている比較対象はClaude Opus 5であり、Opus 5.5ではありません。 Claude Opus 5.5は現在もAnthropicの最上位フラッグシップモデルですが、公式はM3.1 Flashとの項目別比較を公表していません。そのため、「Opus 5.5に追いついた、または上回った」と結論づけることはできません。
Opus 5との比較に限っても、M3.1 FlashはTerminal BenchやSWE Refactorのような、複数の工程を伴うコーディングやリファクタリングのタスクで明らかな差があります。Valsの第三者評価でも、複数の工程を伴うAgentタスクは苦手な傾向が示されています。
MiniMax M3.1 Flashを使わないほうがよいケースと、自前運用を急がないほうがよいケース
次のような場合は、まずは導入を見送りましょう。
- 複雑な計画立案や大規模なリファクタリング:公式の自己評価と第三者のベンチマーク結果を見る限り、長い工程を伴うタスクはやや苦手です。こうしたタスクには、Claude Opus 5.5のような最上位モデルを使うほうが安心です。
- 遅延を極端に抑えたい一方、深い推論は必要ない:思考機能はオフにできません。lowに設定しても、思考に伴うオーバーヘッドが発生します。
- M3の
<think>タグを解析する既存の連携がある:M3.1 Flashでは、思考内容が独立したフィールドで返されます。切り替える前に、既存の解析ロジックを修正する必要があります。 - ライセンスの内容をまだ確認できていない:重みの公開前にライセンスが発表されていないため、商用プロジェクトで自前運用を前提にした計画を早々に立てるのは避けましょう。
- 運用を担当する人がいない:前のセクションで紹介した運用チェックリストを担当する人がいないなら、自前のサービスに業務を載せるのは避けましょう。
- 一般向けGPUでフル版を動かしたい:M3と同程度の規模を参考にすると、現実的ではありません。公式のハードウェア要件が発表されるのを待ち、出所不明の量子化版を安易に信用しないようにしましょう。
APIYIでMiniMaxとClaude Opus 5.5を使い分ける
多くの開発者にとって、「自前運用とAPI利用のどちらがよいか」よりも、難易度の異なるタスクをどのモデルに割り当てるかのほうが実際的な課題です。
APIYIでは、1つのAPIキーでClaude、GPT、Geminiなどの海外モデルと、DeepSeek、MiniMaxなどの国内モデルを利用できます。現在、APIYIで直接利用できるモデルには、MiniMax-M3(OpenAIとAnthropicの両方のAPI形式に対応し、ClaudeCodeグループでも利用可能)、MiniMax-M2.7シリーズのほか、claude-opus-5-5、claude-opus-5があります。執筆時点では、APIYIの料金ページにMiniMax-M3.1-Flashは掲載されていません。利用できるかどうかは料金ページでご確認ください。
おすすめの使い分けは次のとおりです。
- 低コストで済む大量処理はMiniMaxに任せる:データクレンジング、大量の要約、フォーマット変換、簡単なコード補完など、件数が多く、1回あたりの難易度が低いタスクは、単価が低いほどお得です。
- 難しい計画立案やリファクタリングはClaude Opus 5.5に任せる:複数ファイルにまたがるリファクタリング、アーキテクチャ設計、複雑なAgentタスクの計画などは、1回あたりの費用は高くなりますが、失敗してやり直すコストも大きくなります。
- 同じAPIキーでモデルを切り替える:モデル名を変更するだけでよく、複数のアカウントやAPIエンドポイントを管理する必要はありません。
🎯 技術メモ:APIYI(apiyi.com)で同じAPIキーを使い、MiniMax-M3とclaude-opus-5-5をそれぞれ試してみましょう。実際のタスクで効果と料金を比較するほうが、どんなベンチマークスコアを見るよりも確実です。
よくある質問
Q1:MiniMax M3.1 Flash の重みはいつダウンロードできるようになりますか?
公式の X 投稿では、公開予定日は10月23日とされています。公式ブログでは「近日中」とだけ案内されています。記事の公開時点ではまだ公開されていないため、Hugging Face の MiniMax 公式モデルページで最新情報をご確認ください。
Q2:一般向けのGPU 1枚で MiniMax M3.1 Flash を実行できますか?
公式から M3.1 Flash のハードウェア要件は発表されていません。同規模の M3 について、公式が示している参考構成は B200 を8枚使用するもので、MXFP8形式の重みだけで約440 GBあります。完全版を一般向けのGPU 1枚で実行するのは、基本的に現実的ではありません。
Q3:MiniMax M3.1 Flash はオープンソース化後、商用利用できますか?
ライセンスはまだ発表されていません。公式は、オープンウェイトだからといって、すべてのモデルで同じライセンスが適用されるわけではないと注意を促しています。デプロイ、再配布、商用利用を行う前に、ライセンス全文を確認してください。
Q4:今すぐ低コストで MiniMax シリーズのモデルを試すには?
手軽なのは、APIを直接利用する方法です。M3.1 Flash は MiniMax 公式 API または M Plan のサブスクリプションで利用できます(月額料金は公式サイトをご確認ください)。1つのAPIキーで複数のモデルをまとめて管理したい場合は、まず APIYI apiyi.com で、すでに提供されている MiniMax-M3 を呼び出せます。M3.1 Flash を利用できるかどうかは、APIYI の料金ページをご確認ください。
Q5:MiniMax M3.1 Flash は Claude Opus 5.5 の代わりになりますか?
そのように考えるのはおすすめしません。公式が比較対象にしたのは Claude Opus 5 で、長い工程を伴うプログラミングタスクでは劣っています。用途に応じて使い分けるのが現実的です。大量のタスクには MiniMax、難しい計画立案やリファクタリングには Opus 5.5 を使います。APIYI なら、1つのAPIキーでこの組み合わせを利用できます。
MiniMax M3.1 Flashのオープンウェイトに関する重要ポイント
- ウェイトはまだ公開されていません:10月23日の公開を予定しています。最新情報はHugging Faceの公式モデルページで確認してください。
- ライセンスとハードウェア要件は未発表です:推測に基づいて、構成の調達や導入スケジュールを決めるのは避けましょう。
- 規模の目安はM3と同程度です:B200を8基、約440 GBのMXFP8ウェイトが必要とされ、データセンター向けの規模です。
- APIのほうが割安です:料金は$0.15/$0.60で、多くの個人や小規模チームにとって、自前で運用するより手軽で経済的です。
- 自社環境への導入が適するケースは限られます:厳格なコンプライアンス要件、非常に大きな呼び出し量、モデルの改変が必要な場合が主な対象です。
- 比較対象はOpus 5です:Opus 5.5は引き続きAnthropicの最上位モデルですが、公式は項目ごとの比較を発表していません。
- 組み合わせて使う:APIYI(apiyi.com)で1つのAPIキーを使い、MiniMaxとClaude Opus 5.5を併用できます。
まとめ
MiniMax M3.1 Flashのオープンウェイトに関する要点は次のとおりです。
- 現状:ウェイトは10月23日の公開予定で、ライセンスや導入に必要なハードウェア要件はまだ発表されていません。最新情報は公式モデルページで確認してください。
- 構成:同規模のM3を参考にすると、公式構成はB200クラスのGPUを8基搭載するもので、個人で用意できる環境ではありません。
- 判断基準:コンプライアンス、呼び出し量、運用体制、モデルを改変する必要性の4つの観点から検討しましょう。多くの場合、APIを利用するほうが経済的です。
ウェイトの公開後は、まずライセンスと公式のハードウェア要件を確認してから、自前での運用を検討しましょう。実際の業務では、タスクの難易度に応じてモデルを使い分けるのが現実的です。APIYI(apiyi.com)なら、1つのAPIキーでMiniMaxシリーズとclaude-opus-5-5の組み合わせを試せます。
📚 参考資料
- MiniMax公式リリースブログ:M3.1 Flashのリリース情報と公式発表のデータ
- リンク:
minimax.io/blog/minimax-m31f -
説明:価格、速度、重みについて「後日公開」とする公式発表
-
MiniMax公式価格ページ:各モデルの従量課金料金
- リンク:
platform.minimax.io/docs/guides/pricing -
説明:M3.1 FlashとM3の価格比較
-
MiniMax公式セルフホスティングガイド:オープンソースモデルのデプロイに関する参考構成
- リンク:
platform.minimax.io/docs/guides/local-deploy -
説明:M3の8 × B200参考構成とセルフホスティング時の注意点
-
Vals AI評価ページ:M3.1 Flashの第三者評価結果
- リンク:
vals.ai/models/minimax_MiniMax-M3.1-flash -
説明:Vals Indexの順位と各項目のスコア
-
Hugging Face – MiniMax-M3:M3の重みとコミュニティライセンス
- リンク:
huggingface.co/MiniMaxAI/MiniMax-M3 -
説明:M3.1 Flashの重みが公開された後は、同じ組織のページで確認できます
-
SGLangドキュメント – MiniMax-M3:推論フレームワークでのデプロイ方法
- リンク:
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - 説明:M3のMXFP8版のサイズと実行方法
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI公式サイトのトップページからお気軽にご連絡ください。詳しい資料は、ドキュメントセンター(docs.apiyi.com)をご覧ください。