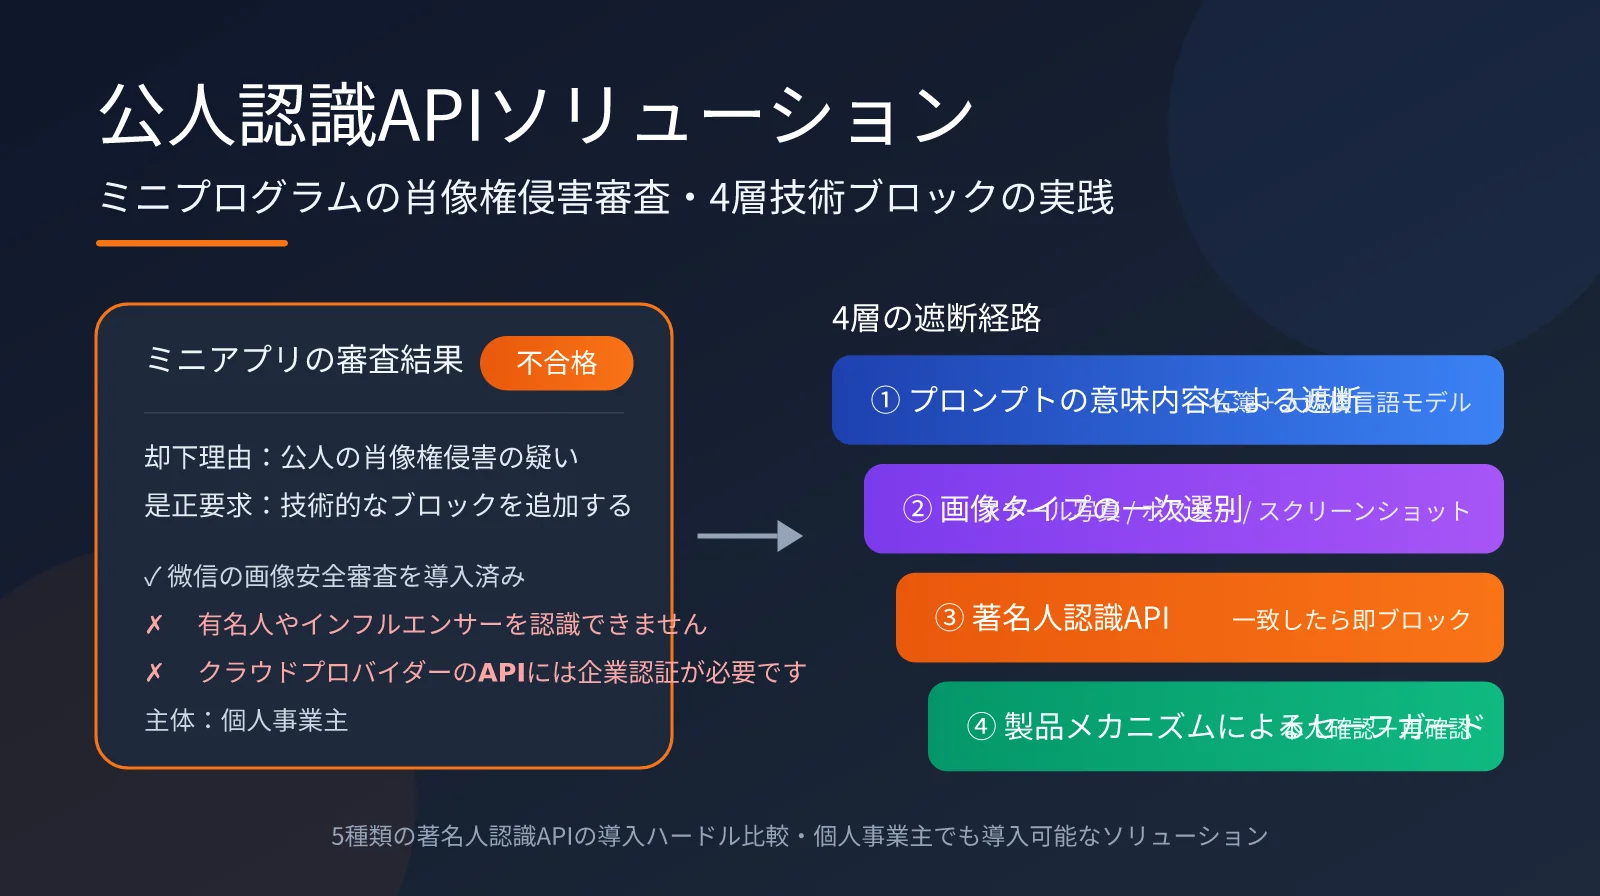
最近、AI画像生成ミニアプリを開発している方から、コミュニティで相談がありました。ミニアプリの審査で著名人の肖像権侵害が問題になり、WeChatから「技術的なブロック機能を追加するように」と求められたそうです。すでにWeChatの画像コンテンツ安全性審査は導入していましたが、このAPIでは芸能人やインフルエンサーを識別できません。Alibaba Cloudには著名人認識APIがありますが、企業認証が必要で、開発者は個人事業主でした。
こうした問題は、AIポートレート、顔の入れ替え、アバター生成、ポスターデザイン系のミニアプリでよく見られます。審査担当者が確認したいのは、「コンテンツ安全性APIを導入しているか」ではなく、「ユーザーがこのサービスを使って、著名人の肖像を生成・拡散できないようになっているか」です。ブロックの流れに一つでも抜けがあれば、審査で何度も差し戻される可能性があります。
この記事では著名人認識APIを取り上げ、まずWeChatのコンテンツ安全性APIでできることと、その限界を整理します。続いて、主要な著名人認識API 5種類の導入条件を比較し、最後に個人事業主でも実装できる4層の技術的なブロック対策を紹介します。
この記事でわかること:どの著名人認識APIを選ぶべきか、ブロックの仕組みをどう組み合わせるか、そして審査に提出する際に技術対策をどう説明すればよいかがわかります。
著名人認識APIがミニアプリ審査の必須要件になった理由
WeChatでは、AI生成系や画像編集系のミニアプリに対する審査がますます厳しくなっています。その背景には、明確な規制があります。2023年1月10日に施行された「インターネット情報サービス深度合成管理規定」では、顔や声などの生体認識情報を編集する機能を提供する事業者に対し、編集される本人への通知と、本人からの個別の同意取得を利用者に促すよう求めています。さらに、2025年9月1日施行の「人工知能生成合成コンテンツ表示方法」では、AI生成コンテンツへの明示的・暗示的な表示が義務づけられました。
こうした状況でプラットフォームが特に懸念しているのは、「著名人の顔」の悪用です。ユーザーが俳優の写真をアップロードしてAIポートレートを作成したり、インフルエンサーの写真を使って顔を入れ替えたり、著名人の名前を入力して「そっくり」の画像を生成したりする行為は、肖像権侵害にあたる可能性があります。ミニアプリの提供者には、こうした行為を技術的にブロックする義務があります。つまり、審査で「技術的なブロック機能を追加するように」と指摘された場合、ユーザーのアップロード時と画像の生成時の両方で、著名人を識別できる仕組みが求められているのです。
WeChatのコンテンツ安全性APIでできることと、その限界
多くの開発者がまず検討するのは、WeChat公式のコンテンツ安全性APIです。ただし、このAPIが解決するのは別の種類の問題です。下表では、WeChatのAPIで対応できる範囲と、肖像権侵害を防ぐために本当に必要な機能を比較しています。
| 検知項目 | WeChat msgSecCheck / mediaCheckAsync | 肖像権侵害のブロックに必要な機能 |
|---|---|---|
| 露骨な性的表現・低俗な内容 | ✅ 対応 | 必要 |
| 政治的にセンシティブな内容 | ✅ 対応(一部の政治関係者) | 必要 |
| 暴力・テロ、違法行為、侮辱表現 | ✅ 対応 | 必要 |
| 芸能人の識別 | ❌ 人物の身元は返さない | 必須 |
| インフルエンサー・配信者の識別 | ❌ 非対応 | 必須 |
| プロンプトに含まれる著名人の名前 | ⚠️ テキストの違反は判定するが、肖像を生成する意図は判定しない | 必須 |
WeChatのmsgSecCheckはテキスト検査に、mediaCheckAsyncは画像や音声の非同期検査に使われます。主な検知対象は、露骨な性的表現、政治的にセンシティブな内容、暴力・テロ、侮辱表現などです。「この画像に写っているのは誰か」までは判定しません。そのため、WeChatのAPIを導入しただけでは、審査担当者から見ると「一般的なコンテンツ安全対策」を済ませたにすぎず、「著名人の肖像をブロックする仕組み」は未対応のままです。
🎯 技術面のアドバイス:著名人認識APIはブロックの仕組みを構成する要素の一つにすぎません。プロンプトをチェックする仕組みは、多くの場合より重要で、コストも抑えられます。APIYI(apiyi.com)経由で大規模言語モデルを利用し、プロンプトの意味を審査する方法がおすすめです。OpenAI API形式に対応しており、個人開発者も登録してすぐに利用できるため、この層をすばやく補えます。
5種類の著名人識別 API を比較
情報の食い違いを避けるため、以下の内容は各社の英語版公式ドキュメントをもとに整理しています。まず知っておきたいのは、著名人の識別は顔認識に該当するため、大手各社のほとんどが利用に一定の条件を設けていることです。個人事業主が「使えるサービスがない」と感じるのも、こうした事情によります。
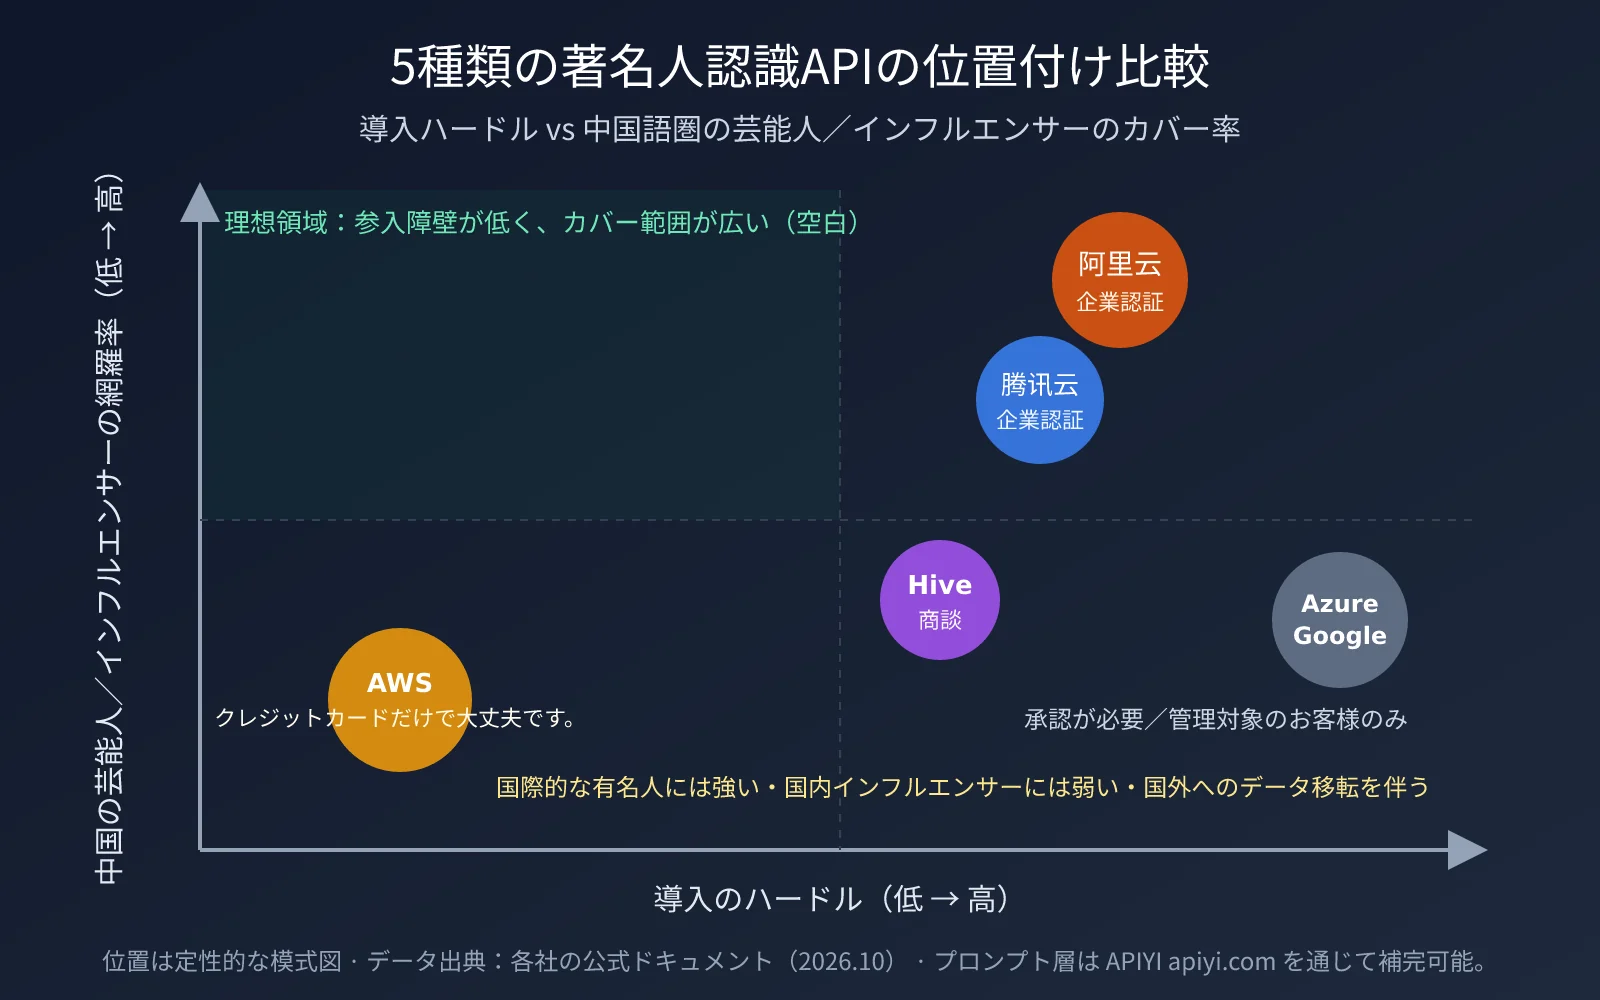
著名人識別 API の利用条件と機能一覧
| 方式 | API の機能 | 利用条件 | 中国語圏の芸能人・インフルエンサーのカバー範囲 | 料金の目安 |
|---|---|---|---|---|
| Alibaba Cloud 画像・ビデオ分析 / コンテンツセキュリティ | 著名人識別 DetectCelebrity。画像審査の拡張版では、infoType=publicFigure を指定すると著名人の名前と位置を返せる |
開発者の報告によると、企業実名認証が必要 | 高い | 呼び出し回数に応じて課金 |
| Tencent Cloud 画像コンテンツセキュリティ IMS | 違反ラベルとサブラベルを返す。一部のケースでは人物名も取得可能 | 企業認証が必要(個人事業主も営業許可証での認証を申請できる場合あり) | 中〜高 | 呼び出し回数に応じて課金 |
| AWS Rekognition | RecognizeCelebrities は1枚の画像で最大64人の著名人を識別し、名前、ID、信頼度、参照リンクを返す |
海外アカウントにクレジットカードを登録すれば利用可能。事前審査は不要 | 海外の著名人に強く、中国国内のインフルエンサーには弱い | 最初の100万枚は1枚あたり $0.001 |
| Hive Celebrity Recognition | 政治家、アスリート、宗教指導者、著名人など5万人以上をカバー | APIキーの申請が必要。法人向けの性格が強い | 中程度 | 公式サイトでは非公開 |
| Azure / Google Cloud Vision | 著名人識別 | Azure は2022年6月以降、審査済みの顧客のみ利用可能。Google は人手による審査を通過したメディア・エンターテインメント企業に限定 | 中程度 | 審査が必要 |
表からわかるとおり、利用条件が最も緩いのは AWS Rekognition です。ただし、著名人データベースは海外の映画・テレビ、スポーツ、政財界の人物が中心で、中国国内のインフルエンサーや配信者のカバー範囲は限られます。また、顔情報は中国の「個人情報保護法」における機微な個人情報にあたります。ユーザーがアップロードした写真を海外サービスに送信する場合は、データ越境に関するコンプライアンス上の問題も生じるため、審査資料を提出する際に考慮が必要です。
個人事業主が現実的に選べる方法
誤解されやすい点を先に説明します。中国国内の主要なクラウドサービスでは、営業許可証を持つ個人事業主も、通常は「企業認証」の手続きを利用できます。ただし、機微性の高い API では、追加の資格審査が求められることがあります。「個人事業主は企業ではない」と一概には言えないため、まず Alibaba Cloud または Tencent Cloud のサポートに問い合わせ、利用したい API の具体的な開通条件を確認してみてください。
利用できないことがわかった場合は、考え方を変える必要があります。「誰なのかを識別する」ことだけに頼らず、複数の段階でチェックし、著名人の肖像がそもそも生成フローに入らないようにする方法です。審査担当者が重視するのは、どの会社の著名人識別 API を使ったかではなく、リスクを防ぐ仕組みと、その運用が十分に整っているかどうかです。
著名人識別のための4層技術的ブロック構成
この構成では、「早い段階でブロックし、段階ごとに判定を厳しくする」ことを基本方針としています。前段のレイヤーほど低コストで高速、後段のレイヤーほど高精度で高コストです。リスクの高いリクエストの多くは、最初の2層でブロックできます。
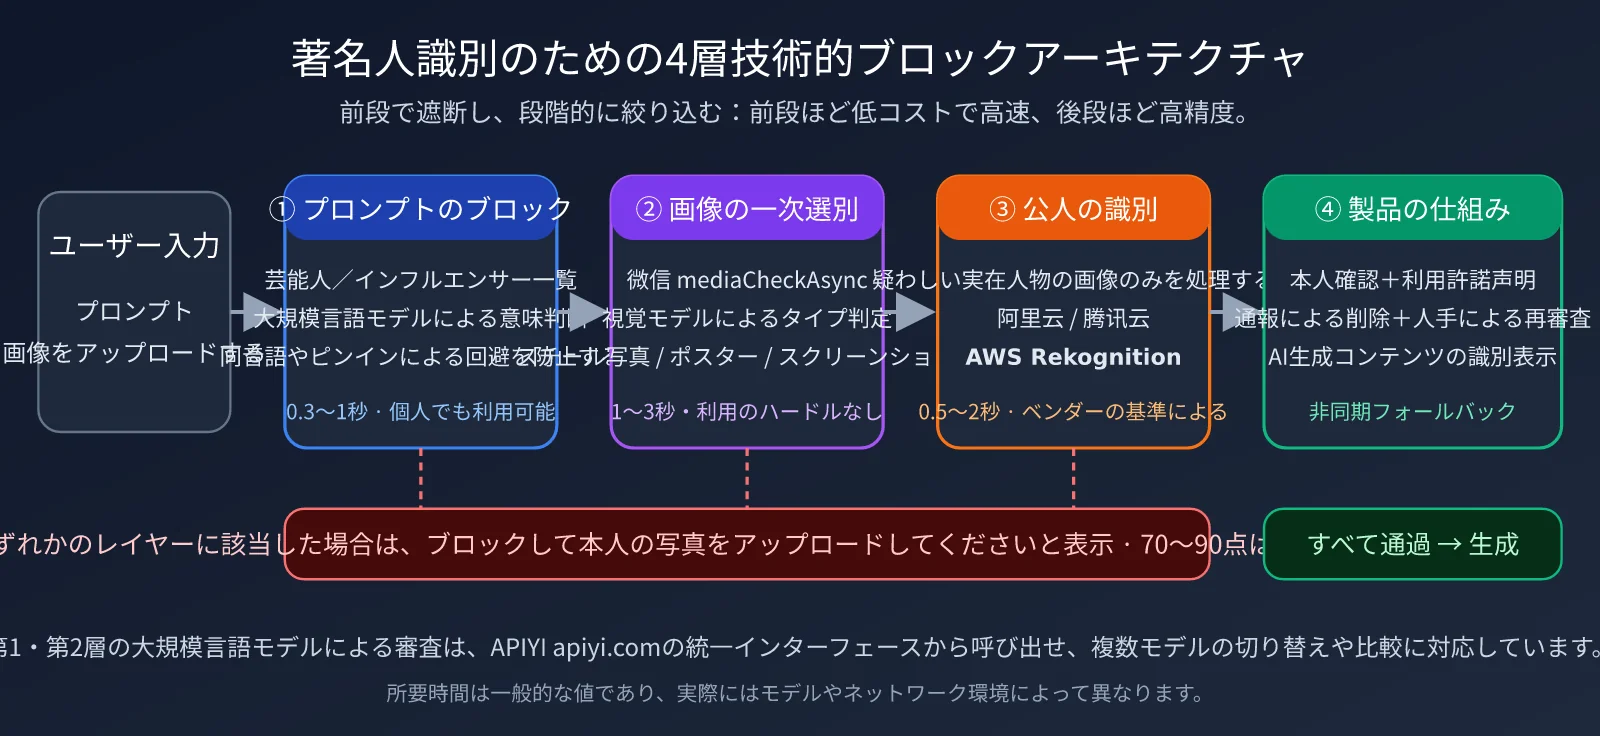
4層のブロック処理の役割
| 層 | ブロック対象 | 実装方法 | 目安の処理時間 | 利用条件 |
|---|---|---|---|---|
| 第1層:プロンプトによるブロック | 「特定の著名人の写真を生成」「特定のインフルエンサーの顔に差し替え」 | キーワードリスト + 大規模言語モデルによる意味判定 | 0.3〜1秒 | なし。個人でも利用可能 |
| 第2層:画像の一次スクリーニング | 映画・ドラマのスチル、ポスター、雑誌の表紙、ライブ配信のスクリーンショット | WeChat mediaCheckAsync + マルチモーダル大規模言語モデルによる画像タイプ判定 |
1〜3秒 | なし |
| 第3層:著名人識別 API | 実在する著名人の写真 | Alibaba Cloud / Tencent Cloud / AWS Rekognition | 0.5〜2秒 | サービス提供元による |
| 第4層:サービス側の仕組み | チェックをすり抜けたコンテンツや判断が難しいコンテンツ | 権利に関する申告、通報・削除、人手による再審査、AI生成の表示 | 非同期 | なし |
第1層は、費用対効果が最も高いレイヤーです。AI画像生成アプリでは、権利侵害につながるリクエストの多くがプロンプトに由来します。たとえば、著名人の名前をそのまま入力したり、「〇〇のような顔」と指定したりするケースです。キーワードリストだけでは、同音異字やピンイン、略称による回避を簡単に許してしまいます。大規模言語モデルで意味を判定すれば、検出率を大きく高められます。
第2層では、「誰なのか」ではなく「何の画像なのか」を判定します。マルチモーダル大規模言語モデルは、写真に写っている実在人物の身元を答えることを避ける傾向があります。OpenAI も GPT-4o による実在人物の識別能力を明確に制限しています。一方で、画像が「映画・ドラマのスチル、著名人のポスター、雑誌の表紙、テレビ局のロゴが入ったライブ配信のスクリーンショット」かどうかを判定することは、十分に可能です。こうした画像はそれ自体がリスクの高いシグナルとなるため、その場でブロックするか、第3層に回せます。
第1層:プロンプトの意味判定によるブロックのコード例
以下は、プロンプトが実在する著名人に関係しているかを大規模言語モデルで判定する、最小限のサンプルです。モデルは構造化 JSON を返し、バックエンドはその結果をもとにリクエストを許可するかブロックするかを決めます。
import json
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # APIYI 统一接口

def check_prompt(prompt: str) -> dict:
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": "判断用户提示词是否要求生成、模仿或替换真实公众人物(明星、网红、主播、政治人物、运动员)的肖像。"
             "只输出 JSON:{\"risk\": true/false, \"names\": [], \"reason\": \"\"}"},
            {"role": "user", "content": prompt},
        ],
    )
    return json.loads(resp.choices[0].message.content)

print(check_prompt("帮我生成一张和那个唱《青花瓷》的歌手同款的写真"))
この例では、プロンプトに人物名が直接書かれていないため、キーワードリストでは検出できません。しかし、大規模言語モデルなら意味から特定の歌手を指していると推測し、高リスクと判定できます。
📦 クリックして展開:プロンプトと画像の2層ブロックの完全版
import base64, json
import boto3
from openai import OpenAI

llm = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # APIYI 统一接口
rek = boto3.client("rekognition", region_name="ap-southeast-1")

BLOCK_NAMES = {"示例明星A", "示例网红B"}  # 本地名单,命中直接拦截

def llm_json(messages):
    resp = llm.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=messages,
    )
    return json.loads(resp.choices[0].message.content)

def layer1_prompt(prompt: str) -> bool:
    if any(n in prompt for n in BLOCK_NAMES):
        return True
    r = llm_json([
        {"role": "system", "content": "判断提示词是否涉及真实公众人物肖像,只输出 JSON:{\"risk\": bool}"},
        {"role": "user", "content": prompt},
    ])
    return r.get("risk", False)

def layer2_image(img_bytes: bytes) -> str:
    """不识别身份,只判断图片类型,返回 block / suspect / pass"""
    b64 = base64.b64encode(img_bytes).decode()
    r = llm_json([
        {"role": "system", "content": "不要识别人物身份。只判断图片类型,输出 JSON:"
         "{\"type\": \"selfie|film_still|poster|magazine|live_screenshot|non_human|other\", \"real_person\": bool}"},
        {"role": "user", "content": [
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{b64}"}},
        ]},
    ])
    if r.get("type") in {"film_still", "poster", "magazine", "live_screenshot"}:
        return "block"
    return "suspect" if r.get("real_person") else "pass"

def layer3_celebrity(img_bytes: bytes, threshold: float = 90.0) -> bool:
    res = rek.recognize_celebrities(Image={"Bytes": img_bytes})
    return any(c["MatchConfidence"] >= threshold for c in res["CelebrityFaces"])

def moderate(prompt: str, img_bytes: bytes | None) -> str:
    if layer1_prompt(prompt):
        return "blocked: prompt"
    if img_bytes:
        verdict = layer2_image(img_bytes)
        if verdict == "block":
            return "blocked: image_type"
        if verdict == "suspect" and layer3_celebrity(img_bytes):
            return "blocked: public_figure"
    return "pass"
完全版では、第2層が「実在人物の写真」と判定した画像に限って、第3層の処理を呼び出します。これにより、著名人識別 API のコストを抑えられるほか、外部に送信する顔データの量も減らせます。Alibaba Cloud や Tencent Cloud の API を利用できる場合は、layer3_celebrity を各社の SDK 呼び出しに置き換えてください。
🚀 すぐに試す:第1層と第2層では、どちらも大規模言語モデルを利用します。まずは APIYI(apiyi.com)でテスト利用枠を取得し、実際のユーザーのプロンプトと画像を100件ほど使って動作を試してみましょう。ブロック率と誤検知率を集計してから公開するのがおすすめです。同じコードで GPT、Gemini、Claude など複数のモデルを切り替え、結果を比較できます。
著名人の識別結果に対するしきい値と対応方針
識別結果は単純な「はい」「いいえ」ではありません。信頼度のしきい値によって、誤検知率と見逃し率が大きく変わります。Hiveの公式ドキュメントでは、実際の写真には0.85、AI生成コンテンツには0.9のしきい値が推奨されています。AWS Rekognitionが返すMatchConfidenceは0〜100の範囲なので、同じ考え方で設定できます。
| 信頼度の範囲 | 対応 | ユーザーへの案内 | 説明 |
|---|---|---|---|
| ≥ 90 | そのままブロック | 「画像に著名人の肖像が含まれている可能性があります。ご本人の写真をアップロードしてください」 | 信頼度の高い一致で、誤検知の可能性は低い |
| 70-90 | ブロックし、手動確認キューへ | 「画像を確認しています。しばらくお待ちください」 | 似た顔や角度・遮蔽による影響は、この範囲に収まることが多い |
| 顔を検出したが一致なし | 許可し、ログを保存 | なし | 一般ユーザーが撮影した通常の写真 |
| 顔を検出できない | 許可 | なし | 風景、ペット、物品など |
AI写真生成サービスでは、「本人確認」を組み合わせるとより安全です。まずユーザーに自撮り写真を基準画像としてアップロードしてもらい、その後にアップロードされた写真が基準画像の顔と十分に似ている場合にのみ、生成を許可します。こうすることで、著名人識別APIが知名度の低いインフルエンサーをカバーできなくても、仕組みとして「他人の顔を使う」ことを防げます。
💡 選定のポイント:国内のインフルエンサーや配信者が主なリスク対象であれば、海外の著名人識別APIだけではカバーしきれません。第1層のプロンプトによるブロックと、「本人確認」の仕組みに重点を置きましょう。第1層の大規模言語モデルの呼び出しは、APIYI(apiyi.com)経由で利用できます。通常、画像認識の数分の一のコストで済みます。
審査時に著名人のブロック対策を説明する方法
技術的な対策を実装したら、審査担当者に分かりやすく伝えることも大切です。審査時の備考欄や補足資料では、次の構成で説明するのがおすすめです。
- ブロックの流れ:プロンプト、画像アップロード、生成結果の各段階で、どのような検知機能を導入しているか説明します。
- 著名人の識別機能:使用している著名人識別API、または代替策と、一致した場合の対応を明記します。
- サービスの仕組み:利用規約の肖像利用許諾条項、アップロード前に表示する「本人の写真のみ使用」という確認画面、通報窓口、削除までの所要時間を説明します。
- AIコンテンツの表示:生成画像に「AI生成」という明示的な表示を加え、ファイルのメタデータにも識別情報を埋め込みます。
- テストの証拠:有名人の写真や、有名人名を含むプロンプトを使ってブロックを確認した際のスクリーンショットや録画を添付します。
特に5つ目は説得力があります。審査担当者が有名人の写真を使ってテストすることも少なくありません。「有名人の出演シーンの画像をアップロード → ブロック」「有名人の名前を入力 → ブロック」という流れを録画で示せれば、審査に通る可能性が大きく高まります。
著名人識別APIに関するよくある質問
Q1:大規模言語モデルだけで著名人識別APIを完全に代替できますか?
完全には代替できません。主要な視覚系大規模言語モデルは、プライバシーポリシー上、写真に写っている実在人物の身元を明かすことを拒否する傾向があります。また、仮に識別できても結果が安定しないため、確実な本人判定には適していません。大規模言語モデルは、プロンプトの意味に基づくブロックや画像の種類の判定に向いています。人物の識別には、専用の著名人識別APIを使うのがおすすめです。APIYI(apiyi.com)を通じて同じサンプルを複数のモデルでテストし、役割分担を決めることもできます。
Q2:AWS Rekognitionで国内の有名人を識別できますか?
知名度の高い中国語圏の映画・テレビ俳優やスポーツ選手であれば、一部を識別できます。ただし、国内のインフルエンサー、配信者、ショート動画のクリエイターはカバー範囲が明らかに限られます。また、AWS Rekognitionは海外のサービスです。顔などの機微な個人情報を扱うため、データの越境に関するコンプライアンスを評価する必要があります。第2層で抽出した疑わしい画像に限って呼び出し、プライバシーポリシーでも利用について正確に説明することをおすすめします。
Q3:個人事業主はアリババクラウドの有名人識別機能を利用できないのでしょうか?
必ずしもそうではありません。個人事業主でも、営業許可証があれば通常、クラウド事業者の法人認証を完了できます。ただし、APIによっては追加の資格審査が必要な場合があります。対象APIの利用条件について、まずは問い合わせ窓口に確認し、代替案としてテンセントクラウドも準備しておくとよいでしょう。
Q4:プロンプトをブロックするための大規模言語モデルの呼び出しは高コストですか?
コストはごくわずかです。プロンプトの審査1回で消費するトークンは通常数百程度で、軽量モデルを使えば、画像認識1回よりも大幅に安く済みます。APIYI(apiyi.com)経由なら従量課金で利用できるため、審査量の変動が大きいミニプログラムにも適しています。
Q5:ブロック対策を実施したのに審査に差し戻された場合は、どうすればよいですか?
まず、差し戻しの理由に「既存コンテンツ」の問題が含まれていないか確認しましょう。たとえば、ミニプログラム内のサンプル画像やテンプレート画像に、有名人の写真が使われていないかを確認します。技術的なブロック対策を済ませていても、トップページの使用例に有名人の画像が使われていたため、再び差し戻されるケースは少なくありません。該当する画像はすべて、自社で権利を保有する画像、またはAI生成の架空の人物画像に差し替える必要があります。
まとめ
ミニプログラムが著名人の肖像権侵害を理由に「技術的なブロック機能の追加」を求められた場合、重要なのは、万能な著名人識別APIを探すことではなく、ブロックまでの仕組みを一貫して整えることです。WeChatのコンテンツ安全APIが対応するのは一般的な違反コンテンツで、芸能人やインフルエンサーの識別には対応していません。Alibaba CloudとTencent Cloudの著名人識別機能は国内の利用シーンに最も適していますが、企業認証が必要です。AWS Rekognitionは利用開始のハードルが最も低い一方、国内インフルエンサーのカバー範囲には限りがあり、データの国外移転も伴います。AzureとGoogleは、一般の開発者には基本的に開放されていません。
個人事業主にとって最も現実的な進め方は、まず営業許可証でクラウド事業者の企業認証を受けられるか確認することです。同時に、プロンプトの意味的なチェックと画像の種類の一次判定を実装し、さらに本人確認、権利許諾の申告、人手による再確認の仕組みを組み合わせます。最後に、テスト時の画面録画を用意し、審査担当者にブロック機能が有効であることを示しましょう。
APIYI apiyi.com を利用すれば、第1層・第2層にあたる大規模言語モデルによる審査機能をすばやく構築できます。実際のサンプルでブロック率を検証してから、審査を申請するのがおすすめです。
著者:APIYI Team。AI大規模言語モデルAPIの活用・導入を専門としています。技術ソリューションやテスト用クレジットについては、APIYI apiyi.com をご覧ください。