著者注:OpenCode 上で誰も名乗り出ていない無料のステルスモデル「Iceman」を例に、公式声明・ディレクトリのパラメータ・未確認の手がかりという3層の情報を分解し、接続前の5項目チェックリストを示します。さらに、複数のidを統合して利用量ランキングを読み解く方法も解説します。
無料で、リクエスト回数の制限もなく、コンテキストウィンドウも非常に大きい。しかし、誰が作ったのかは誰も知らない。こうした無料のステルスモデルは最近、コーディングツールの中でよく見かけるようになり、多くの開発者がまず「とりあえずプロジェクトに接続して試してみよう」と考えます。本記事では、OpenCode 上の Iceman を事例に、「出所不明の無料モデルにコードや業務データを送る前に、何を確認すべきか」という具体的な問いに答えます。
これは「使うな」と諭す記事ではありません。無料のステルスモデルは、プロトタイプ検証や公開コードの実験にはまったく問題なく使えます。重要なのは、どの情報が利用判断の根拠になり、どれが単なる噂なのか、そして学習・保持に関する条項があなたのデータにどんな実際の影響を与えるのかを、きちんと見分けることです。
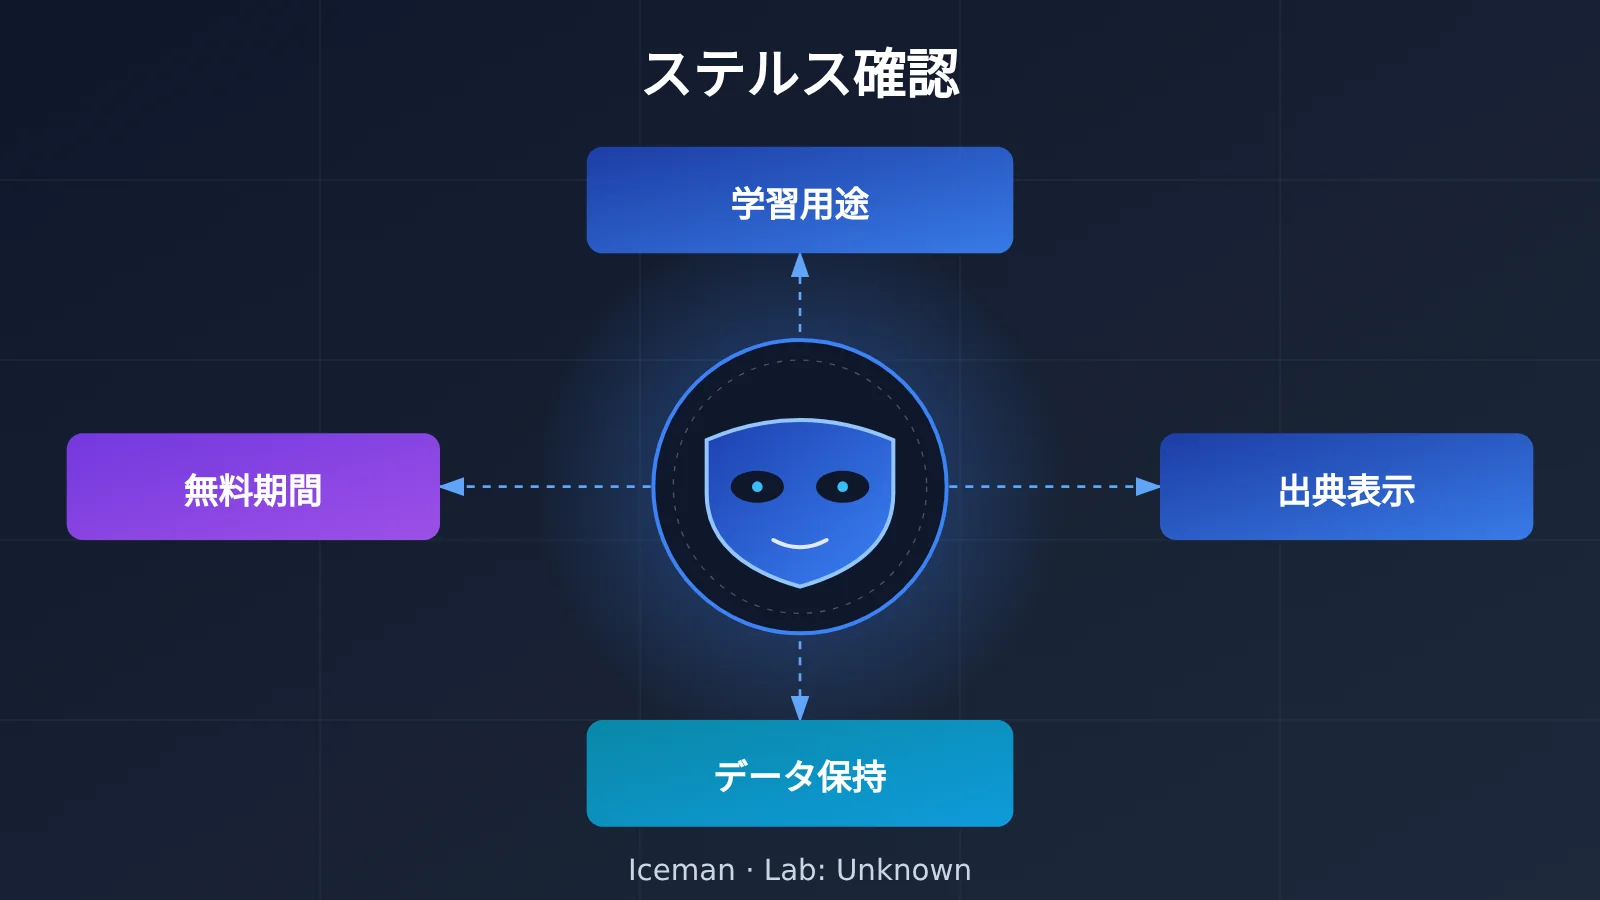
本記事の価値:読み終えると、ステルスモデルを確認するための再利用可能なチェックリストが手に入ります。データの学習利用、ゼロデータ保持、無料期間、出所の帰属という4つの軸をカバーしています。さらに、「idを差し替えることで生じる見かけ上の増加」といったランキングの誤読を見抜く力も身につきます。
無料のステルスモデル Iceman の核心ポイント
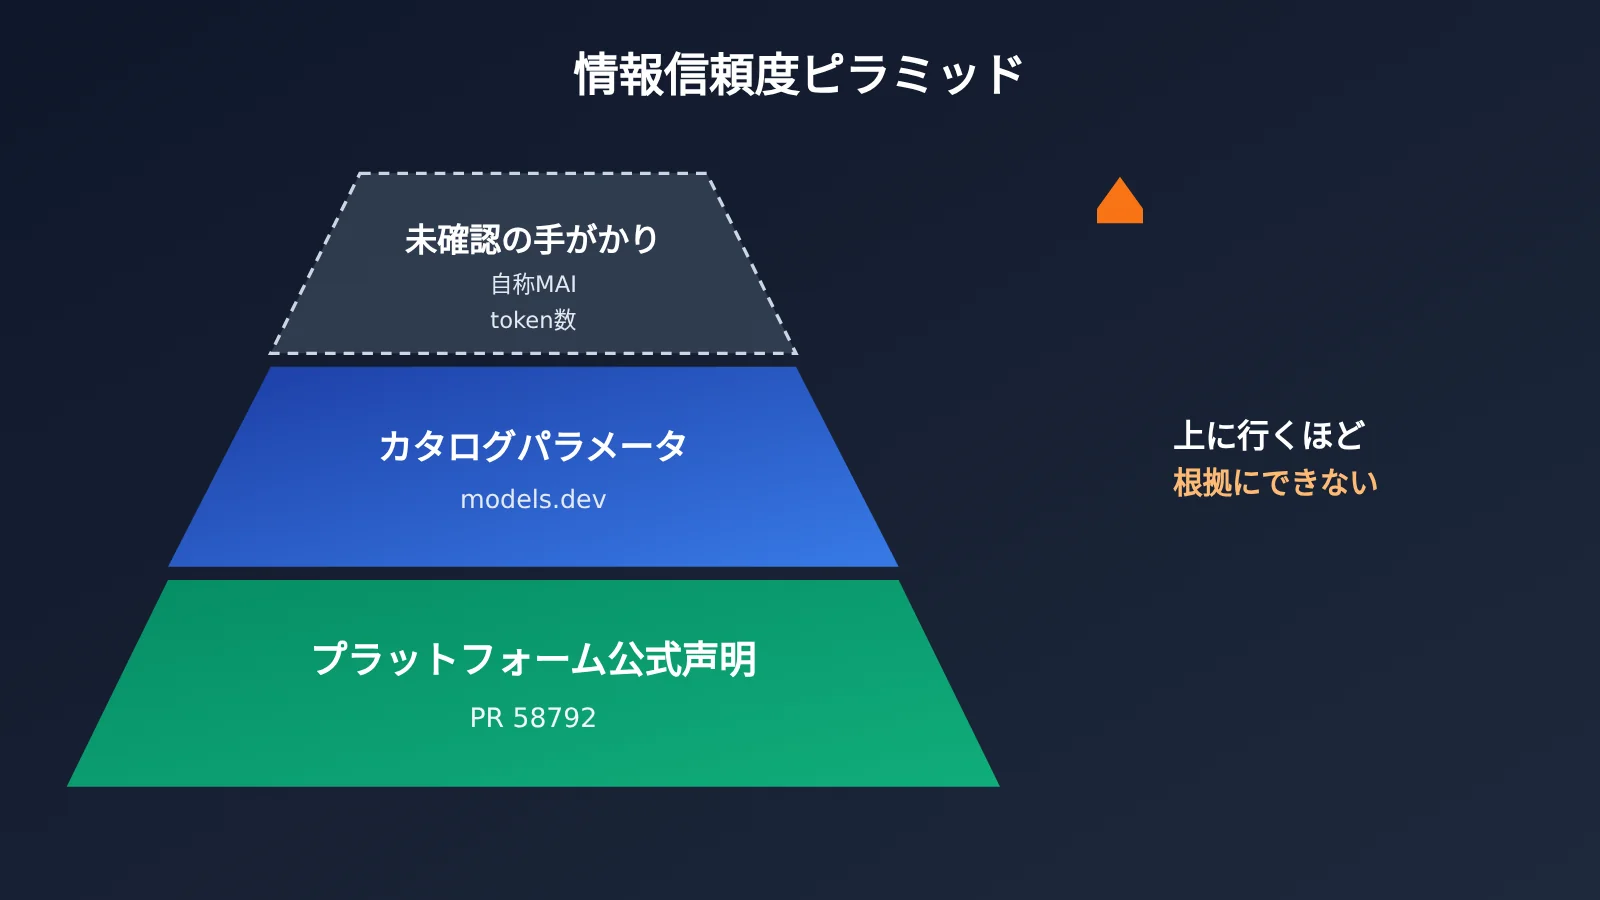
2026-11-04 18:31 UTC 時点で、Iceman はまだどの AI 研究所からも帰属が表明されていません。OpenCode の利用データによると、10 月 23 日から 2 つの id の下で累計約 3.37 兆トークンを処理しています。次の表では、まず Iceman に関する情報を信頼度に応じて 3 つの層に分けます。これが以降のすべての判断の基礎となります。
| 情報の層 | 具体的な内容 | 利用根拠として使えるか |
|---|---|---|
| プラットフォーム公式声明 | OpenCode がマージした PR 58792:期間限定無料、リクエスト制限なし、プロンプトが訓練に使用される、非ゼロデータ保持 | ✅ 可能、これは規約レベルの事実 |
| ディレクトリパラメータ | models.dev ディレクトリ:262,144 コンテキスト、最大 131,072 出力トークン、推論とツール呼び出しをサポート、テキスト入力テキスト出力 | ✅ 可能、技術選定に使用 |
| 未確認の手がかり | 第三者追跡によれば、自らを Microsoft MAI と名乗り、トークン数が MAI Thinking 1 と一致 | ❌ 不可、あくまで噂として扱う |
ステルスモデル Iceman の公式規約の詳細
OpenCode は 10 月 24 日、Iceman を月額 10 ドルの Go プランに追加しました。これはリポジトリの pull request 58792 に対応し、20:24 UTC にマージされています。モデル名は Iceman Contributor Free で、規約には「期間限定無料、リクエスト制限なし」と明記されています。同じ変更には同時に 2 つのことが記されています。Iceman に送信されたプロンプトは訓練に使用され、データ保持ポリシーはゼロデータ保持ではないということです。
この 2 点こそ開発者が最も注目すべき内容であり、コンテキストウィンドウや出力長よりも直接的に「どんなデータを送れるか」を決めます。さらに、この PR はこの id を OpenCode のステルスモデル一覧に追加したため、利用ページの研究所欄は Unknown と表示されます。つまり、プラットフォーム自身が「出所不明」とはっきり示しているのです。
ステルスモデル名における Contributor の本当の意味
多くの人は iceman-contributor の Contributor を、ある研究所や貢献者の名前と解釈しがちです。実際にはこれは OpenCode の一種の交換モードを指します。つまり訓練データと引き換えに無料アクセスを得るというものです。Meta の Muse Spark 1.3 と 1.2 にも Contributor バージョンがあり、これはプラットフォームレベルの汎用ラベルであって、モデルの出所を示す手がかりではないことを示しています。
したがって Contributor の文字を見たときの正しい解釈は「このチャネルのデータは訓練に入る」であり、「これはとある研究所の貢献バージョン」ではありません。この点は後述のチェックリストで最初の項目として確認します。
無料ステルスモデルのトレーニング条項がコードとプライバシーデータに与える影響
「プロンプトがトレーニングに使われる」と聞くと抽象的ですが、プロジェクトに落とし込むと非常に具体的な問題になります。あなたが送信したコンテキストの断片は、すべて他人のモデルのトレーニングサンプルになり得るのです。プログラミングツールの場面では、コンテキストは入力した質問だけにとどまりません。自動的に添付されるファイル内容、エラーログ、設定ファイル、さらには環境変数まで含まれることがあります。
非ゼロのデータ保持とは、リクエスト内容がサービス側に一定期間残ることを意味します。どのくらいの期間、どこに保存され、誰が処理するのかは、モデルの出所が不明な場合には確認できません。企業プロジェクトでは、これが契約上の秘密保持条項やデータコンプライアンス要件に直接抵触するのが通常です。次の表では、データ型ごとに実際のリスクを示します。
| データ型 | 典型的な来源 | トレーニング + 非ゼロ保持下のリスク | 推奨 |
|---|---|---|---|
| オープンソースまたは公開コード | 公開リポジトリ、サンプルプロジェクト | 低い。内容はすでに公開されている | 使用可能 |
| 企業の非公開業務コード | 社内リポジトリ、コアアルゴリズム | 高い。実装の詳細やアーキテクチャが漏れる可能性 | 送信しないことを推奨 |
| キーと設定 | .env、設定ファイル、CI スクリプト |
極めて高い。認証情報が保持され、トレーニングされる可能性 | 必ず除外 |
| ユーザーのプライバシーデータ | ログ、データベースサンプル、チケット | 極めて高い。個人情報保護に関わる | 送信禁止 |
| 合成またはマスキング済みデータ | テストフィクスチャ、モックデータ | 低〜中。マスキングの品質次第 | マスキング後に使用可能 |
ここでは、プログラミング系ツールの「暗黙的コンテキスト」問題に特に注意が必要です。多くのエージェントはワークスペースのファイルを自動的に読み取ります。あなたは関数の書き方だけを尋ねたつもりでも、実際にはディレクトリ構造全体や隣接ファイルがリクエストにまとめて含まれている可能性があります。トレーニング系のチャネルを使う場合、最も安全な方法は、公開データまたは合成データだけを含む独立したワークスペースで操作することです。
無料ステルスモデルをどう確認するか:導入前の5項目チェックリスト
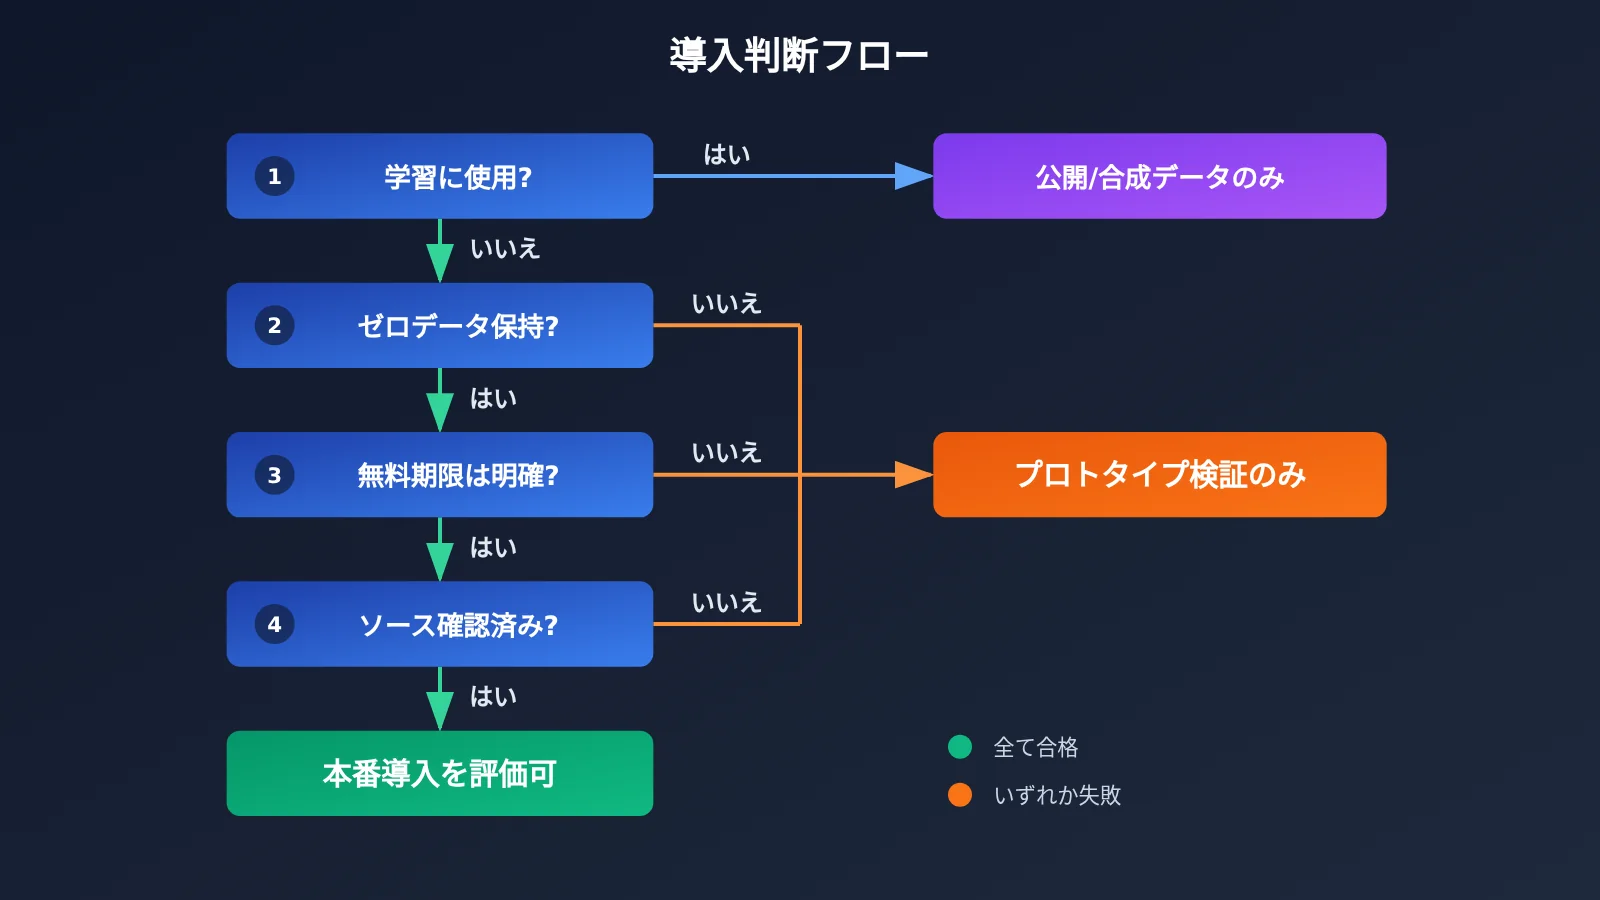
このチェックリストは Iceman だけを対象にしたものではありません。無料で、まだ提供元が名乗り出ていないモデル全般に使えます。最初の4項目は規約と帰属、5項目目はデータの読み解き方に関するものです。チーム内で固定のレビューフローにすることをおすすめします。
| 番号 | 確認項目 | 確認先 | Iceman の現状 |
|---|---|---|---|
| 1 | プロンプトはトレーニングに使用されるか | プラットフォーム規約、モデル設定の変更履歴 | はい、トレーニングに使用 |
| 2 | ゼロデータ保持か | プラットフォーム規約、プライバシー説明 | いいえ、ゼロデータ保持ではない |
| 3 | 無料期間はどのくらいか | プラットフォームのお知らせ、プラン説明 | 「期間限定」とのみ記載、期間は不明 |
| 4 | 出所の帰属は確認済みか | ラボの公式声明 | 未確認。ラボの表示は Unknown |
| 5 | 使用量データが id で分割されているか | 使用量ランキングの関連するすべての id | はい、iceman と iceman-contributor に分割 |
ステルスモデルの出所:なぜ手がかりだけでは確認にならないのか
Iceman の出所について、追跡サイト stealthmodels.com は、X アカウント @aitrackerbot が「Iceman は Microsoft の MAI だと自己紹介し、プロンプトトークンのカウント方法も MAI Thinking 1 と完全に一致する」と発見したと報じています。しかし同サイト自身のテストでは、Iceman は MAI Thinking 1 と一致する一方、OpenAI の GPT-6 シリーズとも同様に一致しました。つまり、トークンカウントだけではこれらのモデルを区別できないということです。
モデルが「自分は誰か」と名乗る情報も同様に信頼できません。モデルは学習データに含まれるアイデンティティ情報を復唱することがあり、システムプロンプトによって意図的に設定される可能性もあります。現時点で Microsoft は何の声明も出していません。したがって、この情報は「一つの手がかり」として位置づけるのが適切であり、技術選定ドキュメントに事実として書き込むべきではありません。
ステルスモデルで提供元が名乗り出た過去事例
OpenCode の過去のステルスモデルを見ると、提供元の名乗り出しは通常、リリース時または数週間以内に行われています。ox-alpha は Z.ai が GLM-5.3 Flash として名乗り出し、cat-jam は Reflection AI が Beam として、Space Bunny は初登場から26日後に MiniMax が M3.1 Flash として名乗り出しました。11月4日時点で、Iceman は公開から11日が経過していますが、まだ提供元は名乗り出ていません。
先例の価値は、予測ではなく見通しを与えてくれることにあります。提供元の名乗り出しには数週間かかる可能性があること、その間はモデルの規模、出所、無料期間がいずれも不明であることを示しています。あなたの計画は、これらの未知数に依存してはいけません。
無料ステルスモデルをすぐに使いこなす:複数の id を合算して利用量ランキングを読み解く
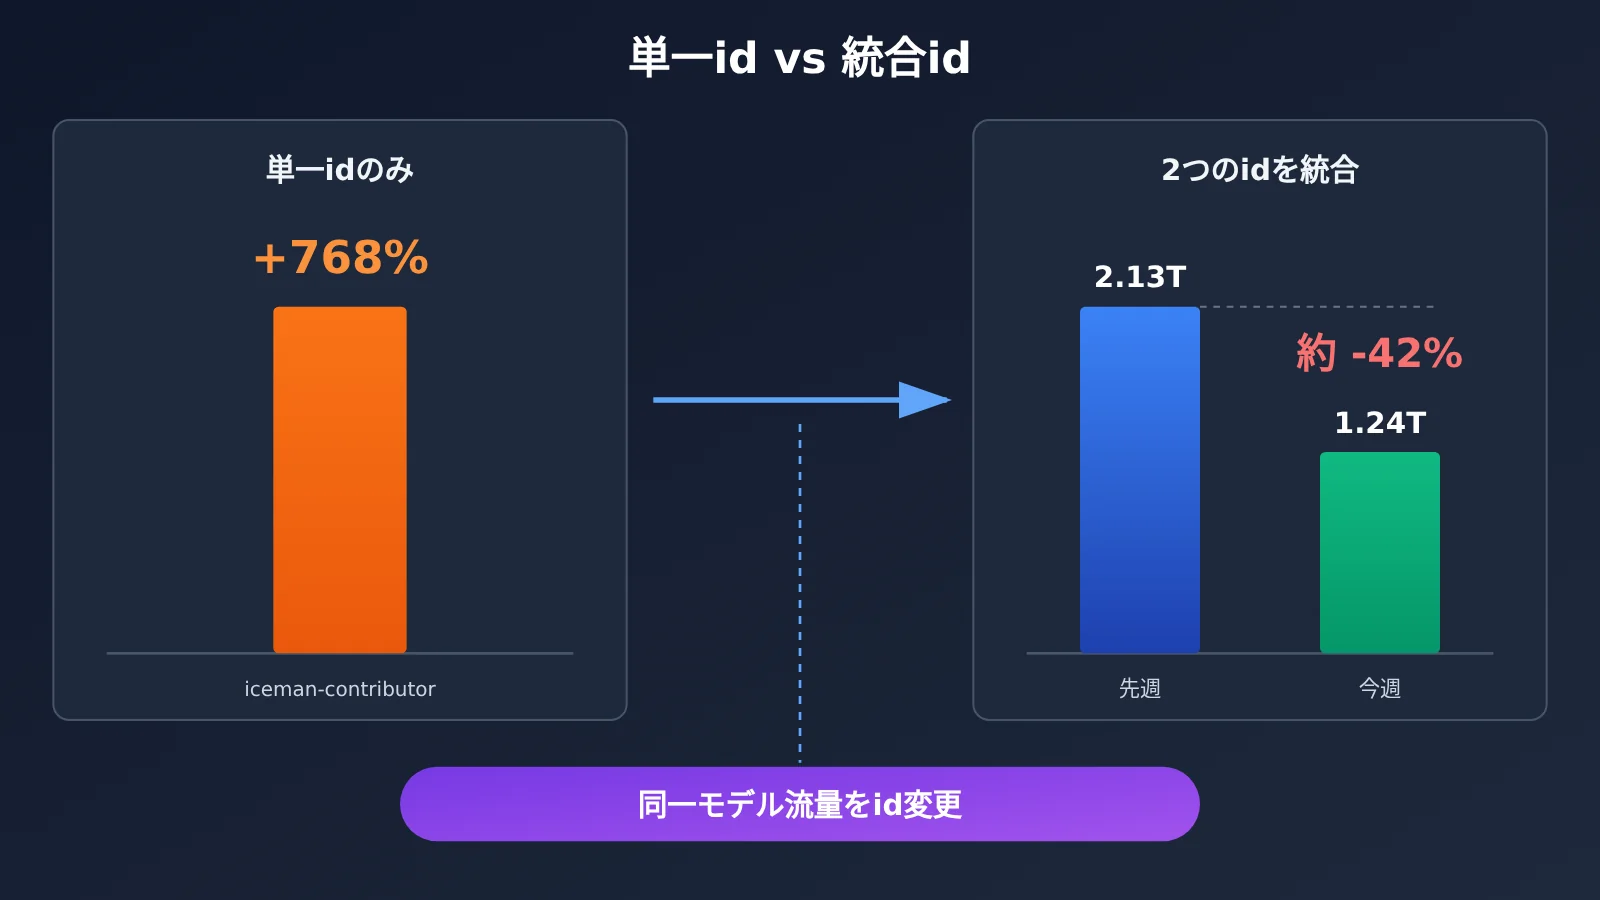
Iceman の OpenCode 週間ランキングでの動きは、ランキングの誤読の非常に典型的な事例です。単一の id だけを見れば「爆発的な成長」という結論になりますが、2 つの id を合算して見ると、結論はまったく逆になります。
| id | 週間ランキング | 今週の tokens | 前週比 |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| 合計 | — | 約 1.24T | 約 -42%(先週約 2.13T) |
+768% は成長ではなく、同じモデルのトラフィックが一方の id から別の id へ移っただけです。2 つの id を合計すると、過去 7 日間で約 1.24 兆 tokens が実行され、前週の約 2.13 兆から約 42% 減少しています。1 日の利用量は 10 月 28 日にピークの約 6,530 億 tokens に達し、10 月 29 日から 11 月 3 日までは毎日 1,620 億から 2,510 億の間で推移しました。
最小限の例:id を統合して実際の前期比を計算する
次の Python コードは統合ロジックを示したものです。データは前掲の公開数値を用いています。先週の各 id の値は、今週の値と前期比から逆算したものなので近似値になります。
# 同一モデルの複数 id、今週の tokens(単位:十億)と前期比の変化
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# 前期比から先週の値を逆算:last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本周合计:{this_total}B")
print(f"上周合计(反推):{last_total:.0f}B")
print(f"合并后环比:{(this_total / last_total - 1):.1%}")
実行すると、今週が約 1,237B、先週が約 2,100B 規模、統合後の前期比が約 -41% から -42% となり、報道で示された合計データとほぼ一致します。逆算には丸め誤差が含まれるため、実際の分析では各 id の元の週次データを直接読み取るべきです。
完全な実装を見る:接続前のモデルポリシーゲート
次のコードは、チェックリストをシンプルな「ポリシーゲート」として実装したものです。特定プラットフォームの API を呼び出すことはなく、手作業で確認して入力したメタデータだけに基づいて、ある種のデータを特定のモデルへ送信できるかどうかを判定します。自分のリクエストルーティング層の手前に置くとよいでしょう。
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # チェック項目 1
    zero_data_retention: bool        # チェック項目 2
    free_until: Optional[str]        # チェック項目 3、None は期限不明を表す
    lab_confirmed: bool              # チェック項目 4
    related_ids: tuple = ()          # チェック項目 5、統合統計に使用

# データ機密度:0 公開、1 匿名化/合成、2 プライベートコード、3 キーまたはプライバシー
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """モデルの規約に基づき、送信を許可する最大の機密度を返す"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # 学習利用または非ゼロ保持:公開データと合成データのみ許可
    if not p.lab_confirmed:
        return 1          # 出所が未確認:同じく低機密データのみ
    return 2              # 規約と帰属の両方が確認できて初めてプライベートコードを検討

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # キーやプライバシーデータは外部の無料チャネルへ決して送らない
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """本番接続を妨げる問題のリストを返す。空リストなら評価に進める"""
    issues = []
    if p.used_for_training:
        issues.append("提示词用于训练")
    if not p.zero_data_retention:
        issues.append("非零数据保留")
    if p.free_until is None:
        issues.append("免费期限未知,存在突然收费或下线风险")
    if not p.lab_confirmed:
        issues.append("来源未认领,无法评估模型规模与长期可用性")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允许' if can_send(iceman, kind) else '拒绝'}")

print("生产接入阻碍:", production_ready(iceman))
実務のヒント:上記のメタデータはチーム共有の設定として管理し、プラットフォームの規約やモデルのクレーム状況が変わるたびに一度更新してください。そうすれば、新しいメンバーが無料モデルを導入するときも、勘で判断するのではなく同じ基準をそのまま使い回せます。
よくある質問(FAQ)
Q1: 無料のステルスモデルとは何ですか?
ステルスモデル(stealth model)とは、プラットフォーム上でコードネームで公開され、開発ラボの素性がまだ明かされていないモデルを指します。プラットフォームの使用量ページでは、通常その提供元が Unknown と表示されます。Iceman は OpenCode のステルスモデル一覧のひとつで、2026-11-04 時点ではまだクレーム(提供元の名乗り)がありません。
Q2: Iceman と iceman-contributor は何が違うのですか?
公開データを見る限り、これらは OpenCode の使用量ランキングが同一モデルを追跡する際に使っている2つの id です。週間ランキングでは一方が急上昇し、もう一方が急落しますが、実態はトラフィックが2つの id の間を行き来しているだけです。Contributor という語は「訓練データと引き換えに無料アクセスを得る」というプラットフォームの交換モデルを指すもので、特定ラボの名称ではありません。
Q3: Iceman の無料期間はどれくらい続きますか?
現時点で公開された答えはありません。OpenCode の変更内容には「期間限定で無料、リクエスト数制限なし」と書かれているだけで、終了日は示されていません。モデルの規模、開発元、無料期間はいずれも現時点では不明な情報です。そのため、本番運用の設計で無料であることを前提にするのはおすすめしません。
Q4: 無料のステルスモデルはどんな場面に最も向いていますか?
利用規約に「訓練用途に使用」「ゼロではない保持(non-zero retention)」と明記されていることを前提に、比較的適しているのは次のような場面です。
– **オープンソースプロジェクトでの実験**:もともと公開されているコードを扱うケース。たとえばオープンソースライブラリのサンプルやテストを書く場合です。
– **能力の把握・評価**:合成した問題で推論やツール呼び出しの性能を試し、長いコンテキストでの振る舞いを確認します。
– **個人学習用のプロトタイプ**:実データを含まないデモを作り、インタラクションの流れが成立するかを検証します。
Q5: このステルスモデル確認チェックリストをチームでどう運用すればよいですか?
3つのステップをおすすめします。まず5つの確認項目をモデル導入基準のドキュメントに書き込み、次に前文の「ポリシーゲート」と同じようにルーティング層でデータの機密度に応じてブロックし、最後にコーディングツール用の独立したワークスペースを用意して、Agent が私有ファイルを勝手に持ち込まないようにします。規約が変わったときはメタデータを更新すれば済みます。
Q6: モデルが「自分は某社の製品だ」と言っている場合、信じてもよいですか?
そのまま信じることはできません。モデルの自己紹介は学習コーパスやシステムプロンプトに由来する可能性があり、また token の数え方が複数のモデルで完全に一致することもあります。Iceman を例にすると、第三者のテストではそのカウントが MAI Thinking 1 や GPT-6 シリーズとも一致しており、これで区別することはできません。帰属はラボによる公式のクレームによってのみ判断できます。
Q7: ステルスモデルがクレームされた後、それ以前に送信したデータはどうなりますか?
クレームは提供元の帰属情報を変えるだけで、データを送信した時点で適用されていた規約を変えるものではありません。その時点の規約に「訓練に使用」「ゼロではない保持」と書かれていれば、そのデータの扱いはすでに確定しています。だからこそ、確認は送信の前に済ませるべきで、クレームされてから後追いで行うものではありません。
無料ステルスモデルの要点 Key Takeaways
- まず規約、次にパラメータ:学習用途とデータ保持の有無が「何を送れるか」を決め、コンテキスト長は「どれだけ送れるか」しか決めない。
- Contributor は交換モード:学習データと引き換えに無料アクセスを得る仕組みであり、モデルの出所を示すものではない。
- 手がかりは確認ではない:モデルが自称する身元も token のカウントも、帰属を証明するものではない。
- 無料期限は不明として扱う:「期間限定」に終了日は示されておらず、計画の中で当てにしない。
- ランキングは id を合算して見る:Iceman の +768% は合算すると実質約 -42% になる。
- 機密データは一律に隔離:APIキー、プライバシーデータ、非公開のコアコードは学習系の経路に送らない。
まとめ
無料ステルスモデルをプロジェクトに組み込めるかどうかは、それが無料かどうかではなく、どんなデータを送るのかで決まります。Iceman を例にすると、根拠として使えるのはプラットフォームの規約とカタログ上のパラメータです。具体的には、学習への利用、ゼロではないデータ保持、期間限定の無料提供、262,144 のコンテキスト、推論とツール呼び出しへの対応といった点です。一方、根拠にできないのは開発元に関する各種の手がかりで、これらは公式に名乗り出るまではうわさにすぎません。
再利用できる方法論は、次の3点にまとめられます。
- 情報を階層で見る:プラットフォームの表明、カタログのパラメータ、未確認の手がかりを分け、判断には前の2層だけを使う。
- データの等級に応じて使い分ける:学習系の経路では公開データか合成データだけを扱い、非公開コードやプライバシーデータは別に扱う。
- 同じ基準でランキングを読む:同一モデルの複数 id は必ず合計してから成長率を計算し、id の切り替えによる見かけの成長に惑わされない。
今後 Iceman が誰によって名乗り出られても、この検証手順は次に現れるステルスモデルにも長く使い回せます。
📚 参考資料
- ArtificialWatch – Iceman の使用量と帰属分析:本記事の核心的な事実の出典
- リンク:
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
説明: Iceman のデュアル ID 使用量、規約の変更、帰属に関する手がかりをまとめたもの。2026-11-04 公開
-
OpenCode Data 使用量ページ:iceman と iceman-contributor の使用量データ
- リンク:
opencode.ai/data -
説明: 各 ID の週間ランキングとトークン使用量を直接確認できます
-
models.dev モデルカタログ:Iceman の技術パラメータ
- リンク:
models.dev -
説明: コンテキストウィンドウ、最大出力、推論、ツール呼び出しなどのカタログ情報を提供
-
stealthmodels.com ステルスモデル追跡:帰属の手がかりの報道元
- リンク:
stealthmodels.com - 説明: Iceman の自称アイデンティティとトークン計数に関するテストを記録したもので、あくまで手がかりとして参照
著者: APIYI 技術チーム
説明: 本記事の事実は 2026-11-04 時点のものです。Iceman の認領状態と無料期間は随時変更される可能性があるため、最新の規約はプラットフォームの最新情報をご確認ください。