著者注:本記事では、Agent の受け入れゲートを設計する方法を 5 つのステップで解説します。長時間実行されるエージェントに、明確な終点、信頼できるフィードバック、そして制御可能なコストをもたらします。
Agent が数時間、ときに数日間連続で動作したあと、返ってきた結果は一見完全に見えても、誰もそのままマージしようとはしません。これは多くの開発チームが直面する難題です。本記事では、Agent 受け入れゲートの 5 ステップ設計法 を紹介します。長いタスクを開始する前に、「完了」をマシンが繰り返しチェックできる基準として定義する手助けをします。
2026 年 10 月 27 日、CentOS の創設者の一人である Gregory Kurtzer 氏が Ginux プロジェクトを発表しました。伝えられるところによれば、同氏は 11 日間で主に継続実行中の Codex タスクに頼り、約 13 万 9000 行のコードを残し、この独立カーネルで Rocky Linux 10 を起動して systemd を動作させました。どのようにして暴走した Agent を軌道に戻したのかと問われると、彼の答えはシンプルでした。ゲートをたくさん設けることです。
これはまたプロンプトのテクニック集ではありません。本記事が注目するのは、長いタスクが本当に依存するエンジニアリング構造です。目標、ゲート、証拠、リグレッション、そして停止条件。
核心価値:本記事を読めば、自分のプロジェクト用に Agent 受け入れゲート一式を書き上げ、どの工程を機械に任せ、どの判断を人に残すべきかを判断できるようになります。
Agent 受け入れチェックポイントの要点
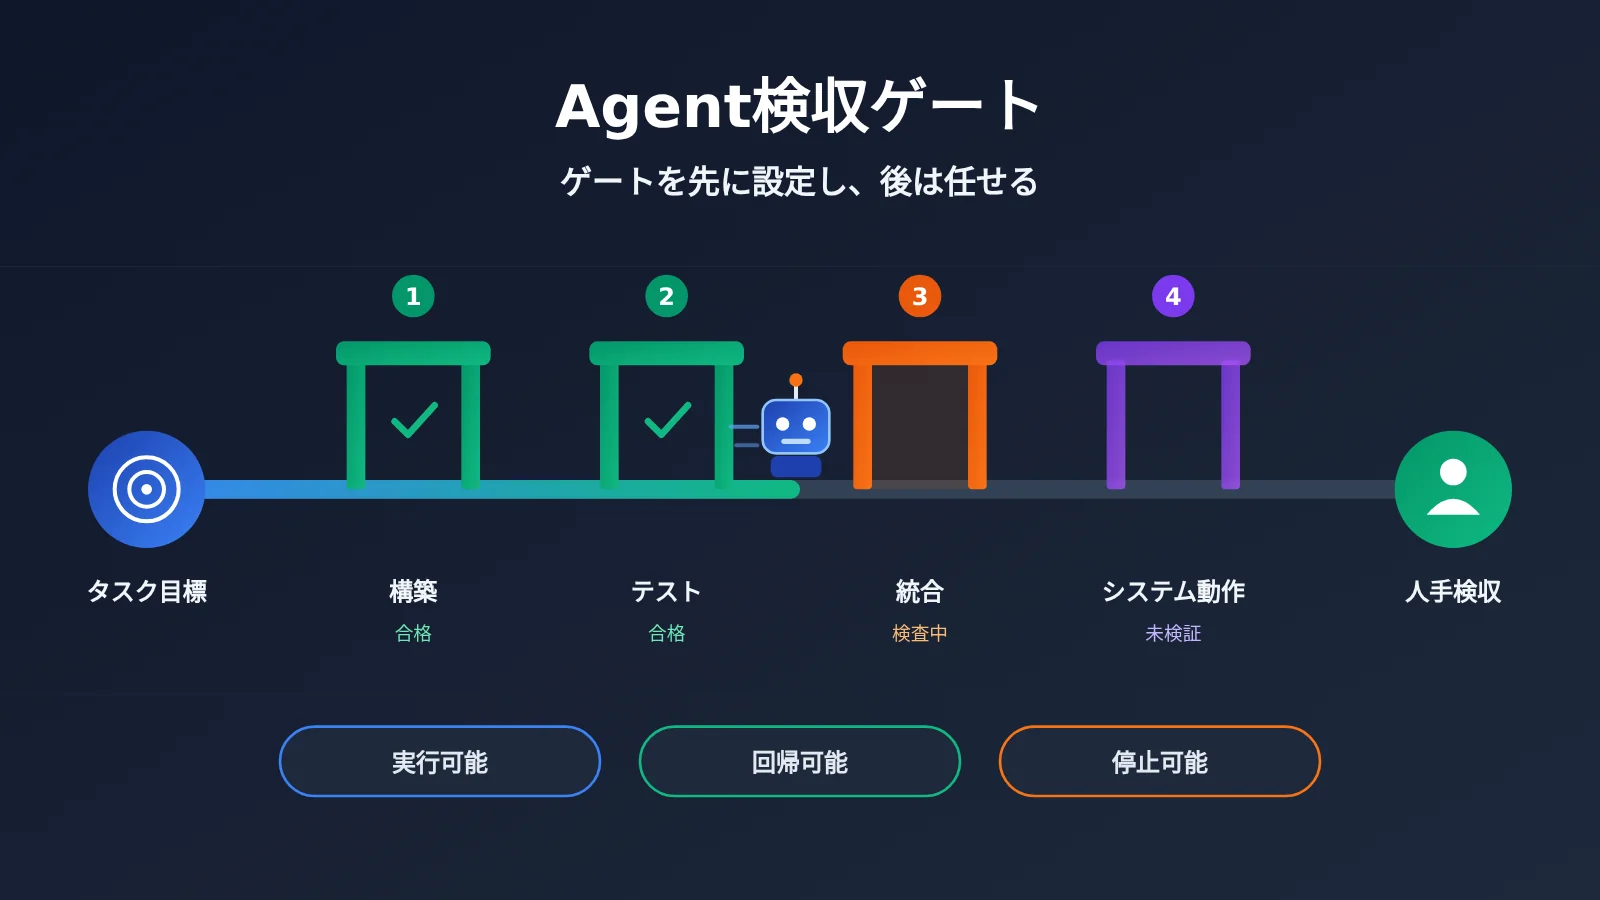
Agent の受け入れチェックポイントとは、あらかじめ定義された再実行可能な検査地点の集合です。これは Agent に対して現在の結果が基準を満たしているかどうかを伝えると同時に、人間に対してどの証拠をレビューすべきかを示します。
| 要点 | 説明 | 価値 |
|---|---|---|
| 受け入れ基準の事前定義 | 長いタスクを始める前に、ゴールと段階的な目標を明文化する | Agent が部分的な成功で全体の完了を置き換えてしまうのを減らす |
| チェックポイントが実行可能 | コマンド、スクリプト、CI、または実際の実行結果で判定する | Agent が人の判断を待たずに自ら反復できる |
| システムの振る舞いを検査する | プログラムが実際に動作しているときの挙動に注目する | 「もっともらしく見える」誤った出力を発見できる |
| 人と機械で役割を分ける | 人がアーキテクチャと受け入れを決め、Agent が実装と回帰を担う | 人がループの中で最も遅い部分ではなくなる |
| 予算を制御できる | 失敗回数、使用量、一時停止の条件をあらかじめ設定する | 長いタスクが誤った方向に消費し続けるのを防ぐ |
Ginux 事例における Agent 受け入れチェックポイント
Kurtzer は「カーネルを書く」というタスクをそのまま Agent に任せるのではなく、Linux のユーザー空間プログラムが動作するか、systemd が起動できるかといった厳格なチェックポイントを選びました。systemd は多数のシステムコンポーネントに依存し、システム全体を起動・運用する中核プロセスでもあるため、カーネルが本当に使えるかどうかを検証するのに適しています。
このプロジェクトは、互いに連携する2つのループで動いています。外側のループは人が主導し、ビジョン、アーキテクチャと制約、受け入れチェックポイントから、実際の振る舞いのレビュー、そして修正か受け入れかの判断までを担います。内側のループは Agent が担い、実装、ビルドと QEMU での実行、測定と障害分析、修正、回帰テストを繰り返します。
Kurtzer はまた、多くの障害はもっともらしい出力を生み出す一方で、実際にはセマンティクスや分離の要件、ライフサイクルの振る舞いに違反していると注意を促しています。チェックポイントがなければ、表面的には動作するものの構造が脆弱なコードに終わりやすくなります。
Agent 受け入れチェックポイントを自動実行する理由
Cursor のエンジニアである Lauren Tan も、Agent を使ううえで最も重要なスキルは検証だと考えています。彼女の言う検証には、Agent に実際にコードを走らせること、CPU トレースやヒープスナップショットを取得すること、iOS シミュレータを起動してユーザーと同じようにアプリを操作することが含まれます。
彼女は、毎月 4000 件の PR を本番環境にマージできると公言しています。仮に 1 件の PR を人が 5 分で確認するだけでも、合計で約 333 時間かかります。そのため、この規模でのチェックシステムは、人の介入なしに動作する必要があります。この極端な事例には議論も少なくありませんが、一般的なチームにも当てはまる道理を示しています。つまり、Agent が自分の出力を検査できてこそ継続的に作業できるのであり、検査できなければ diff を渡して止まるしかないのです。
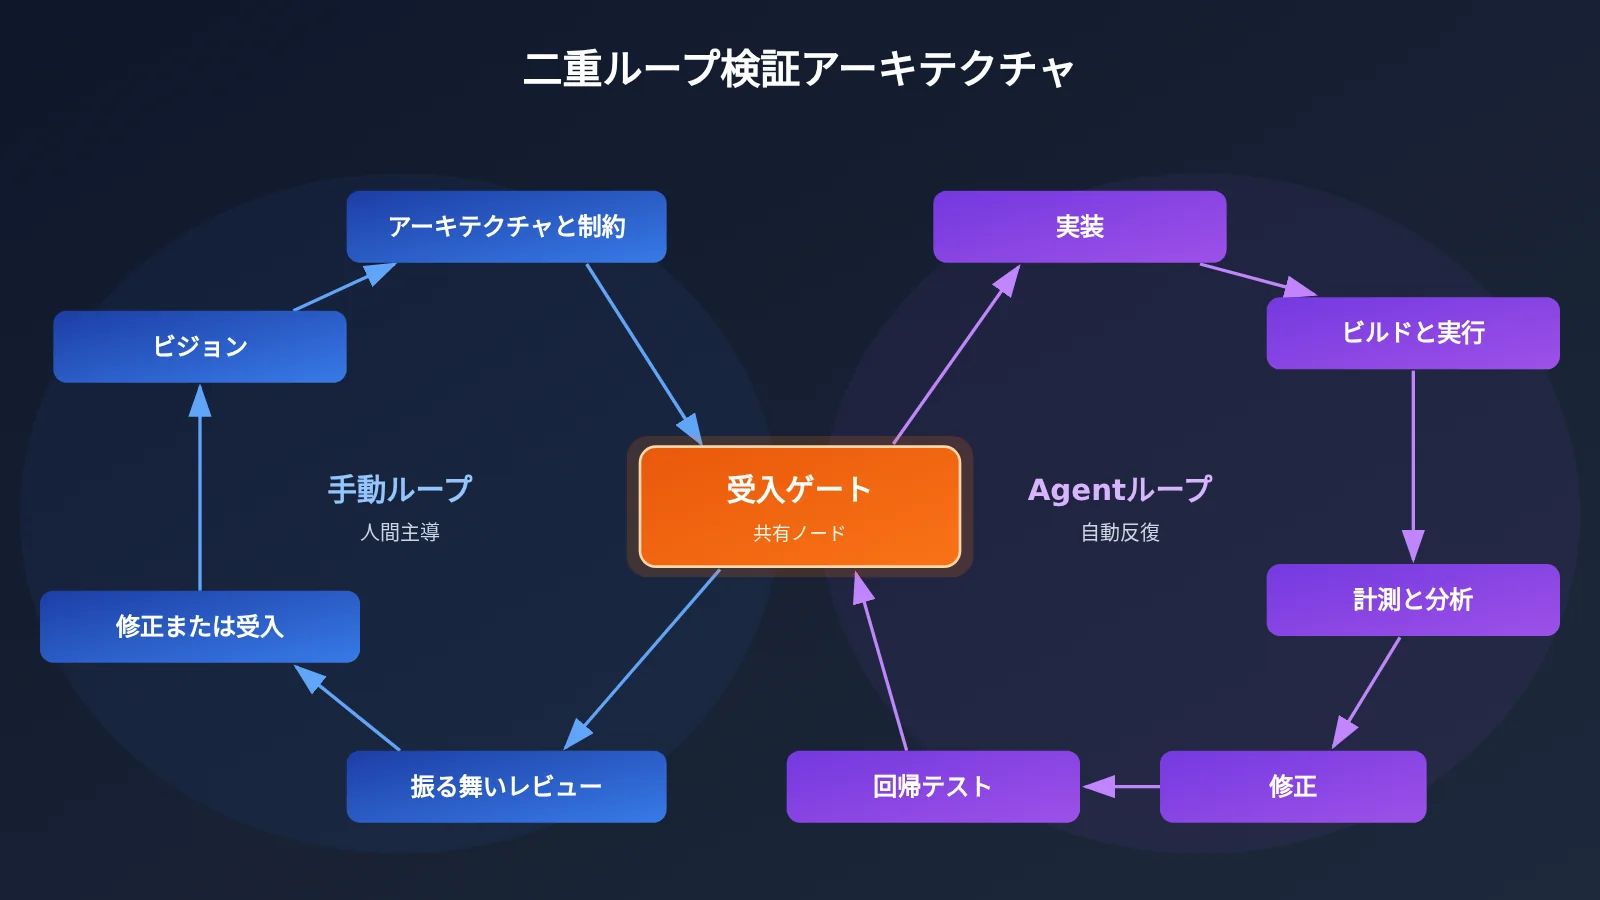
図中の二重ループは、そのまま日々のプロジェクトに持ち込めます。実装とレビューを別々のモデルに担当させたい場合は、APIYI(apiyi.com)経由で接続し、モデル呼び出しを内側のループに組み込むとよいでしょう。
Agent 受け入れゲートのクイックスタート:5ステップ設計法
ここでは、よくあるタスクを例に使います。Agent に旧版の REST サービスを新しいフレームワークへ移行させ、既存のクライアントに影響を与えないようにする、というものです。例に出てくるチェック項目は、自分のプロジェクトのビルド・テスト・デプロイの流れに置き換えて読んでください。
ステップ1:Agent 受け入れゲートのためにシステムレベルの終点を定義する
まず、タスクが終わったときにシステムがどうなっているべきかを、観察可能な一文で書き表します。「サービス移行を完了する」では曖昧すぎますが、「同じリプレイリクエスト群を使ったとき、新旧サービスのステータスコードと主要なレスポンスフィールドが一致している」なら検証できます。
よい終点は、実際の利用経路から生まれることがほとんどです。Ginux の終点は Rocky Linux 10 が systemd の multi-user.target まで起動することであり、Web アプリケーションの終点ならコアなユーザーフローが最後まで通り抜けられること、データタスクの終点なら出力結果がベンチマークデータセットと一致すること、といった具合です。
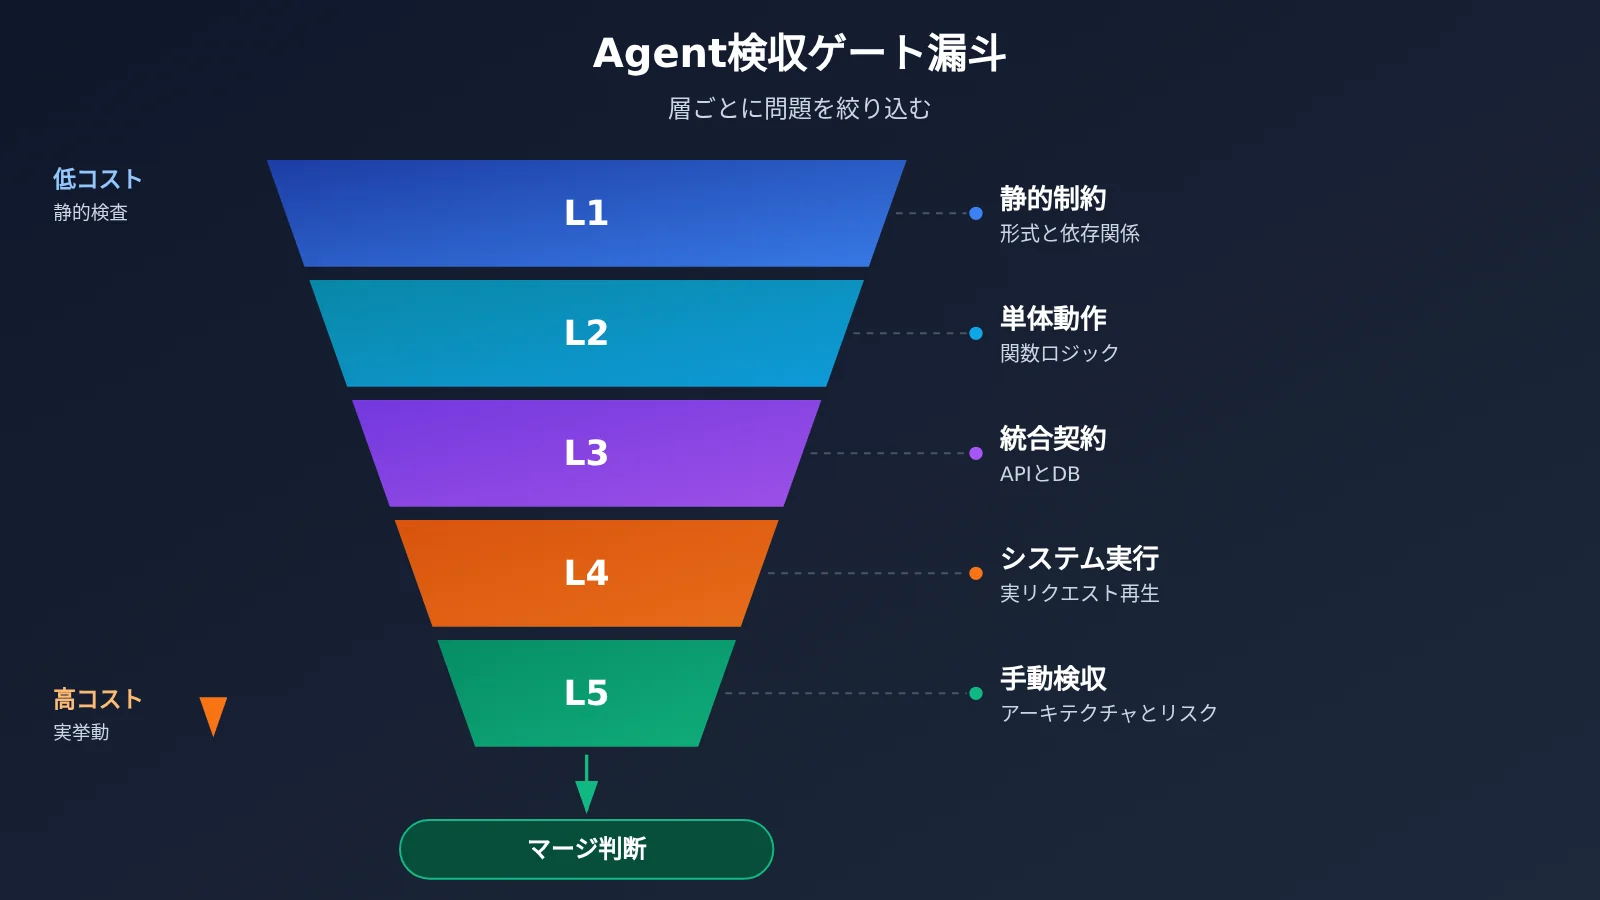
ステップ2:Agent の受け入れゲートを5つの層に分解する
単一の最終テストによるフィードバックは遅すぎるうえ、Agent が失敗したときに問題を特定するのも難しくなります。そこで、実行コストが低い順から高い順へとゲートを設定し、安価なチェックで明らかな誤りを先に止めることをおすすめします。
| ゲート階層 | チェック内容 | 例 | 失敗時のアクション |
|---|---|---|---|
| L1 静的制約 | フォーマット、型、依存関係の境界 | モジュール間の相互インポートを禁止 | Agent が即座に修正 |
| L2 単体動作 | 関数とモジュールのロジック | コアのユニットテスト | Agent が原因を特定して修正 |
| L3 統合契約 | インターフェース、データベース、外部依存 | インターフェース契約テスト | Agent が差分を比較して修正 |
| L4 システム実行 | 完全なサービスの実際の動作 | サービスを起動してリクエストをリプレイ | Agent がログとパフォーマンスデータを収集 |
| L5 人手による受け入れ | アーキテクチャ、リスク、ビジネス上のトレードオフ | エビデンスパッケージをレビューしてマージ可否を判断 | 人が新たな制約を与えるか、タスクを停止 |
Lauren Tan の Dune アーキテクチャは、L1 の極端な例を示しています。彼女は 600 以上の PR を通じてプロジェクトをリファクタリングし、CI で依存関係グラフを検証することで、Electron の main ディレクトリと renderer ディレクトリが相互にインポートしないことを保証すると同時に、useEffect の使用を無効化し、コメントの記述も禁止しました。これらのルールがあなたのコードベースに適しているとは限りませんが、チームの制約を自動チェックとして書き下すという手法は参考にする価値があります。
ステップ3:Agentの受け入れゲートを実行可能なカードとして書く
各ゲートには、Agentの起動時に読み込めるプロジェクトドキュメントに置く短いカードを用意します。カードを明確に書いておけば、Agentは「通過とは何か」を推測する必要がなくなり、人間もそれを根拠に証跡をたどれます。
| フィールド | 記入要件 | サービス移行の例 |
|---|---|---|
| ゲート名 | 振る舞いで命名する | リプレイリクエストの一貫性 |
| 実行環境 | バージョンと依存関係を固定する | 分離テスト環境、固定データスナップショットを使用 |
| 実行エントリ | 明確なコマンドを1つ用意する | make gate-replay(サンプルコマンド) |
| 通過判定基準 | 比較可能な結果を用いる | ステータスコードと主要フィールドがすべて一致 |
| 証跡成果物 | 再確認できるファイルを保存する | 差分レポート、サービスログ、パフォーマンス記録 |
| 保護ルール | 変更不可の内容を明記する | 受け入れサンプルと判定スクリプトは読み取り専用 |
| 失敗時の戦略 | 次のアクションを説明する | 同じエラーが3ラウンド連続で未解決なら一時停止 |
このうち、もっとも見落とされやすいのが保護ルールです。Agentは目の前でもっとも手軽な道を選びがちで、受け入れサンプルを書き換えたり判定スクリプトを緩めたりできてしまうと、テスト結果は意味を失います。この部分は保護ディレクトリに置き、CIで関連する変更をチェックすることをおすすめします。
ステップ4:Agent の受け入れゲートを自動回帰ループに組み込む
内部ループをタスク説明に書き込みます。まず小さな変更を1つ完了させ、現在の階層のゲートを実行し、失敗の証拠を読み取り、修正してから、すでに通過したゲートを再実行します。ここでの回帰が重要です。そうでなければ、Agent が1か所を直した後に、別の場所をひっそりと壊してしまう可能性があります。
各ラウンドの終了時に、Agent に変更内容、実行したゲート、結果、未解決の問題を記録させます。長いタスクではコンテキストが増え続けるため、この記録は後続のセッションが素早く状態を復元するのに役立ち、また人間がそれが着実に前進しているのか、その場で堂々巡りしているのかを判断しやすくなります。
受け入れゲートは「偽の通過」も防ぐ必要があります。以下のいくつかの状況は、長時間の実行で特によく見られます:
| 偽の通過の種類 | 典型的な症状 | 対応する防御線 |
|---|---|---|
| テストが改変される | 失敗ケースが削除されたり、判定基準が緩和されたりする | 受け入れファイルを読み取り専用にし、CI で変更をチェックする |
| ハッピーパスのみをテスト | 正常なリクエストは通るが、異常シナリオでクラッシュする | 障害注入と境界サンプルを追加する |
| モックで実際の依存関係を置き換える | Mock はすべてグリーンなのに、統合環境では失敗する | L4 では実際のサービスを必ず実行する |
| 出力は正しそうだが意味が違う | ログは完全なのに、ライフサイクルの動作が誤っている | 状態、タイミング、副作用を比較する |
| 部分的な成功がリスクを覆い隠す | 個別指標は向上するが、全体の安定性が低下する | 各マイルストーンで全量回帰を実行する |
ステップ5:エージェントの受け入れゲートに人手による意思決定ポイントと停止条件を設ける
人の作業は、エージェントが代替しにくい判断に集中させるべきです。Kurtzer はアーキテクチャ、Linux 互換性の目標、運用モデル、障害の解釈、停止判断を担当します。エージェントが生成したコードに満足できないときは、IDE を閉じてまで自分で修正したくなる衝動を抑え、代わりに新たな指示を与えることもあります。
少なくとも3種類の一時停止条件を設けることをおすすめします。同じゲートで複数回失敗した場合、エージェントが保護対象コンテンツを変更しようとした場合、タスク使用量が予算に近づいた場合です。一時停止後のレビューも、重点を証拠パッケージに前倒しし、まずシステムの挙動とリスクを確認してから、diff を深く読むかどうかを決めます。
クイックスタートの提案:まず1日で完了できる小さなマイルストーンを選び、ゲートカードを3〜5枚だけ書いてみましょう。APIYI apiyi.com は、本記事で扱う GPT、Claude などのシリーズモデルの API 呼び出しを提供しており、OpenAI と Anthropic のインターフェース形式にも互換性があります。既存ツールは通常、ドキュメントに従ってインターフェースのアドレスとキーを調整するだけで済みます。利用可能な具体的なモデルは APIYI の料金ページで確認できます。
エージェントの受け入れゲートが長時間タスクのコストをどう変えるか
長時間タスクのコストは「合計でどれだけ token を使ったか」だけで判断できません。記事では、Cursor のホームページで集計される token には少なくとも通常入力、モデル出力、キャッシュ書き込み、キャッシュ読み取りの4種類が含まれ、価格差が大きいと述べられています。コミュニティでは、同じ 1.5 兆 token の使用量を使って請求額を見積もったことがあり、異なる算出方法では結果が大きく異なりました。主な相違は課金の算定基準とキャッシュ比率から生じています。
| 課金項目 | 長時間タスクにおける主な発生源 | 制御方法 | 価格の算定基準 |
|---|---|---|---|
| 通常入力 | タスク説明、ログ、コード断片 | 失敗に関連する証拠だけを渡す | APIYI の料金ページの実データに準拠 |
| モデル出力 | コード、分析、修正計画 | 各ラウンドの出力範囲を限定する | APIYI の料金ページの実データに準拠 |
| キャッシュ書き込み | 新規または変化した安定コンテキスト | プロジェクトルールの構造を安定させる | APIYI の料金ページの実データに準拠 |
| キャッシュ読み取り | 複数ラウンドで再利用されるコンテキスト | ヒット状況を観察し、プレフィックスの頻繁な変更を避ける | APIYI の料金ページの実データに準拠 |
公開事例の総費用はプロジェクト規模を理解する用途には使えますが、そのまま単価に換算することはできません。Ginux の API 呼び出し費用は約 8000 ドルと報じられています。Nicholas Carlini が 16 個の並列 Claude エージェントで C コンパイラを構築した実験では、約 2 万ドルかかりました。これらの数字の背景にあるモデル、キャッシュ、タスク構造はそれぞれ異なるため、自分のプロジェクトは別途見積もる必要があります。
より確実な方法は、まず1つのマイルストーンを最後まで実行し、4種類の token 使用量とゲート失敗回数を記録してから、APIYI の料金ページ https://docs.apiyi.com/models の現在のデータに基づいて計算することです。こうして得られる予算は自分のタスク形態に基づくもので、他人の平均単価をそのまま当てはめるより信頼できます。
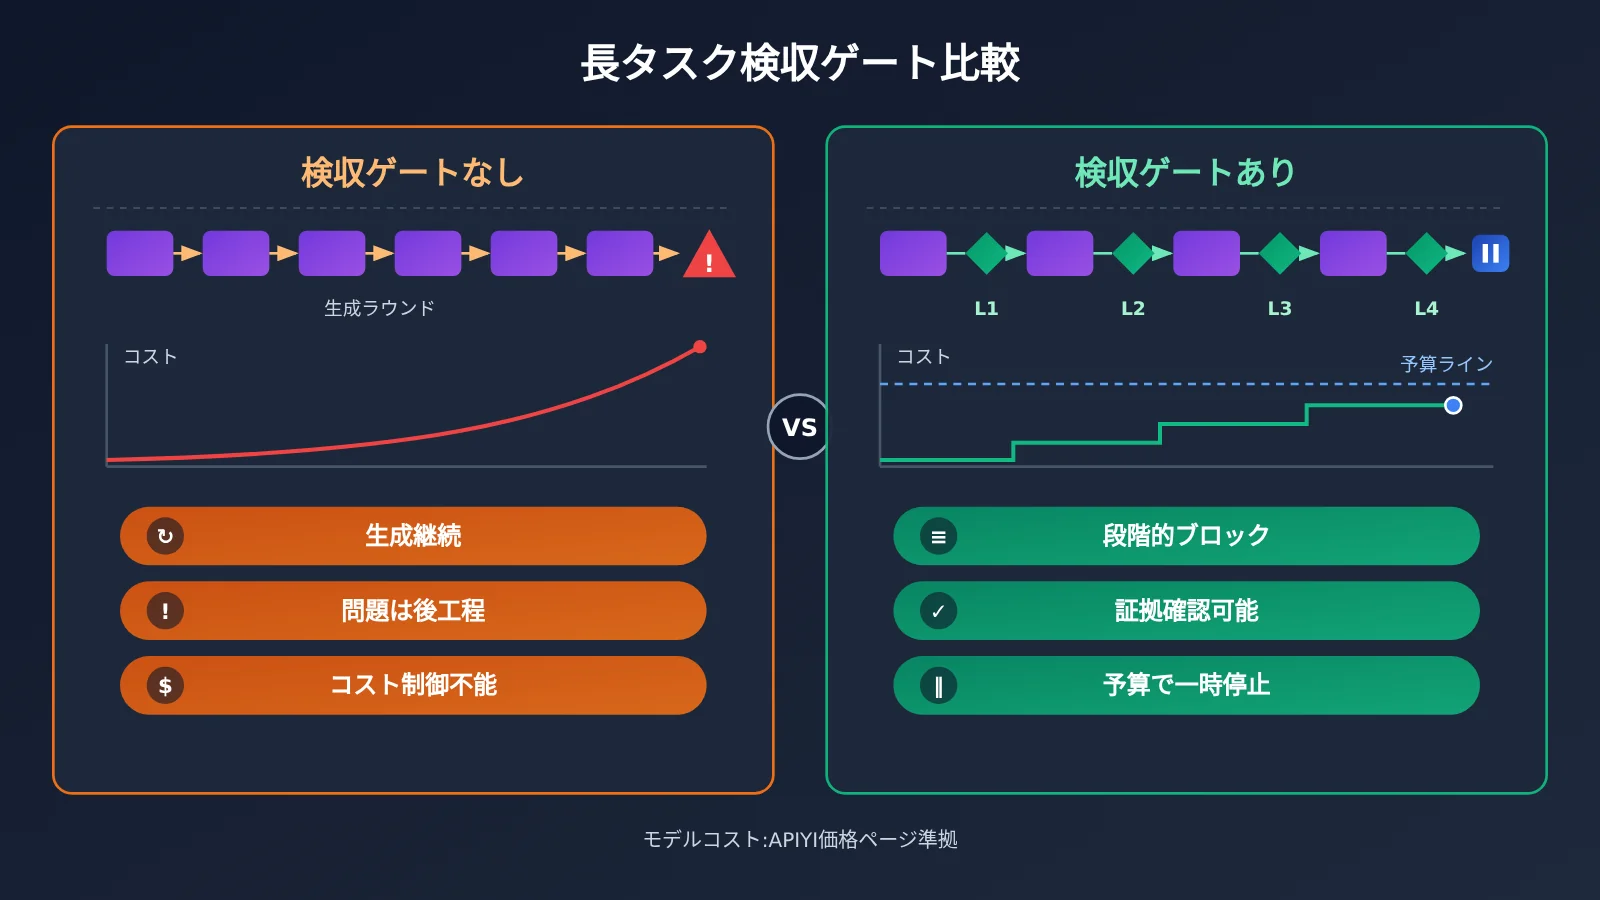
上の図で伝えたいのは、ゲート自体もリソースを消費するものの、失敗を早期に表面化できるという点です。一般的なチームにとっての目標は、すべての変更に最も高コストな完全検証を実行することを目指すのではなく、限られた予算で十分な信頼度を得ることです。
Agent 受け入れゲートに関するよくある質問
Q1:Agent 受け入れゲートとは何ですか?
事前に定義された実行可能なチェックポイントで、Agent の段階的な成果が基準を満たしているかを判断するために使います。完全なゲートには、実行環境、実行エントリポイント、合格判定基準、エビデンス成果物、失敗時の戦略が含まれます。
Q2:Agent 受け入れゲートと通常の CI は何が違うのですか?
CI はよくある実行の担い手であり、受け入れゲートはより完全なタスク制御の設計です。コードがテストを通るかどうかを判断するだけでなく、システムの振る舞い、エビデンス、回帰範囲、人間による意思決定ポイント、一時停止条件も定義します。
Q3:どんなときに Agent 受け入れゲートを設計する必要がありますか?
タスクが複数回の修正を必要とする場合、複数のモジュールにまたがる場合、実行時間が長い場合、あるいは誤った出力が目視では見つけにくい場合には、事前に設計しておくべきです。単発の小さなスクリプトなら簡略化してもかまいませんが、少なくとも実行可能な検証方法を1つは明確にしておきましょう。
Q4:Agent 受け入れゲートがあっても、人間によるコードレビューは必要ですか?
必要です。自動ゲートは既知の基準を判断するのに向いていますが、アーキテクチャの選択、リスクの取捨選択、最終的な受け入れは人間が担うべきです。Kurtzer も、結果が完全かどうか、部分的な成功がシステムレベルのリスクを招かないかを見極める場面では、経験が依然として極めて重要だと強調しています。
Q5:API 経由でモデルに接続し、このフローを実行するにはどうすればよいですか?
1. APIYI apiyi.com に登録し、APIキーを作成します。
2. ドキュメントセンター `docs.apiyi.com` を参照し、エンドポイントとリクエスト方法を確認します。
3. 利用するツールに合わせて OpenAI または Anthropic のインターフェース形式を選び、設定を完了します。
4. `https://docs.apiyi.com/models` でモデルの種類と価格を確認してから、小規模な試運転を開始します。
Q6:予算が限られている場合、Agent 受け入れゲートをどう簡素化すればよいですか?
低コストの L1 と L2 ゲートを優先的に残し、毎ラウンド実行させます。L3 と L4 は機能の完成時やマイルストーンのタイミングで実行しましょう。Jellyfish が1万2000人の開発者を対象に行った統計では、典型的なユーザーは月に約5100万トークンを使用しており、極端な事例とは大きな差があります。そのため、タスクのリスクに応じて検証の頻度を決めるべきです。モデル費用は APIYI の価格ページに記載された実際のデータを基準にしてください。
Q7:Agent 受け入れゲートにはどのような限界がありますか?
ゲートは定義したリスクしかカバーできず、テストがすべてグリーンでも、そのコードが長期的な保守に適しているとは限りません。Ginux は Rocky Linux 10 を起動できますが、本番レベルのカーネルまではまだ長い道のりがあります。ハードウェアのサポート、インターフェースの安定性、セキュリティレビュー、コミュニティによる保守は、一度の実行では証明できません。コミュニティから高頻度の PR パターンに対する批判が上がっていることも、コードの保守性に継続的に注目する必要があるという警鐘です。
エージェント受け入れゲートの核心ポイント Key Takeaways
- まず終点を定義する:タスク完了を観察可能なシステム動作で記述し、曖昧な目標を避けます。
- ゲートは階層化する:静的な制約から始め、実際の実行と人手による受け入れへと段階的に進めます。
- エビデンスを残す:実行のたびにログ、差分レポート、パフォーマンス記録を保存します。
- 判定は変更不可:受け入れサンプルとスクリプトを保護し、エージェントが抜け道を使わないようにします。
- 回帰を日常化する:新しい問題を修正したら、すでに通過した関連ゲートを再実行します。
- 意思決定は人間が握る:アーキテクチャ、リスク、停止、最終受け入れは責任者が判断します。
- コストはまず試験実行:APIYI(apiyi.com)で小規模に検証し、その後、料金ページに基づいて予算を試算します。
まとめ:エージェント受け入れゲートから自律ワークフローを構築する
エージェントが長時間自律的に作業できるかどうかは、明確な目標と信頼できるフィードバックを持っているかで決まります。エージェントの受け入れゲートを設計する際は、次の3点を意識するとよいでしょう。
- 「完了」を実行可能な基準にする:エージェントが実行結果に基づいて進捗を判断できるようにします。
- 頻度の高い検証は機械に任せる:階層化ゲート、自動回帰、エビデンスパッケージでフィードバックサイクルを短縮します。
- 重要な判断は人間に残す:アーキテクチャの方向性、リスクの境界、停止のタイミングは責任者が決めます。
次の中等規模タスクから始め、まずゲートカードを書いてからエージェントを起動することをおすすめします。異なるモデルをテストする必要がある場合は、APIYI(apiyi.com)を通じて OpenAI と Anthropic の形式に互換性のあるインターフェースで接続できます。設定方法はドキュメントセンター docs.apiyi.com をご覧ください。モデル料金と課金基準は https://docs.apiyi.com/models の実際のデータに準拠します。
📚 参考資料
- InfoQ – Ginux プロジェクトの報道:Codex が Linux 互換カーネルを構築した過程と検証方法
- リンク:
infoq.cn/article/OiyNEtFwV05opvsLTcvK -
説明:HDAE の二重ループ、プロジェクト規模、および限界の分析を含みます
-
InfoQ – Cursor エンジニアのトークン請求額に関する報道:高負荷な Agent ワークフローとコストをめぐる議論
- リンク:
infoq.cn/article/q9iebpvFozfy4bgCYUyE -
説明:検証のクローズドループ、Dune アーキテクチャ、コミュニティからの批判を含みます
-
Ginux 技術レポート:Gregory Kurtzer 氏が公開したプロジェクト技術レポート
- リンク:
zenodo.org/records/23682548 -
説明:研究目標、手法、結果の適用範囲を詳しく知りたい方に適しています
-
Ginux GitHub リポジトリ:プロジェクトのソースコード
- リンク:
github.com/gmkurtzer/ginux -
説明:プロジェクトのコードとオープンソースライセンス情報を確認できます
-
APIYI ドキュメントと料金ページ:API 設定とモデル料金の説明
- ドキュメントリンク:
docs.apiyi.com - 料金リンク:
https://docs.apiyi.com/models - 説明:モデルの型番、料金、課金基準は、ページに表示されている実際のデータを参照してください
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com にぜひアクセスして、Agent エンジニアリングの実践について交流しましょう。その他の接続資料は docs.apiyi.com のドキュメントセンターでご確認いただけます。