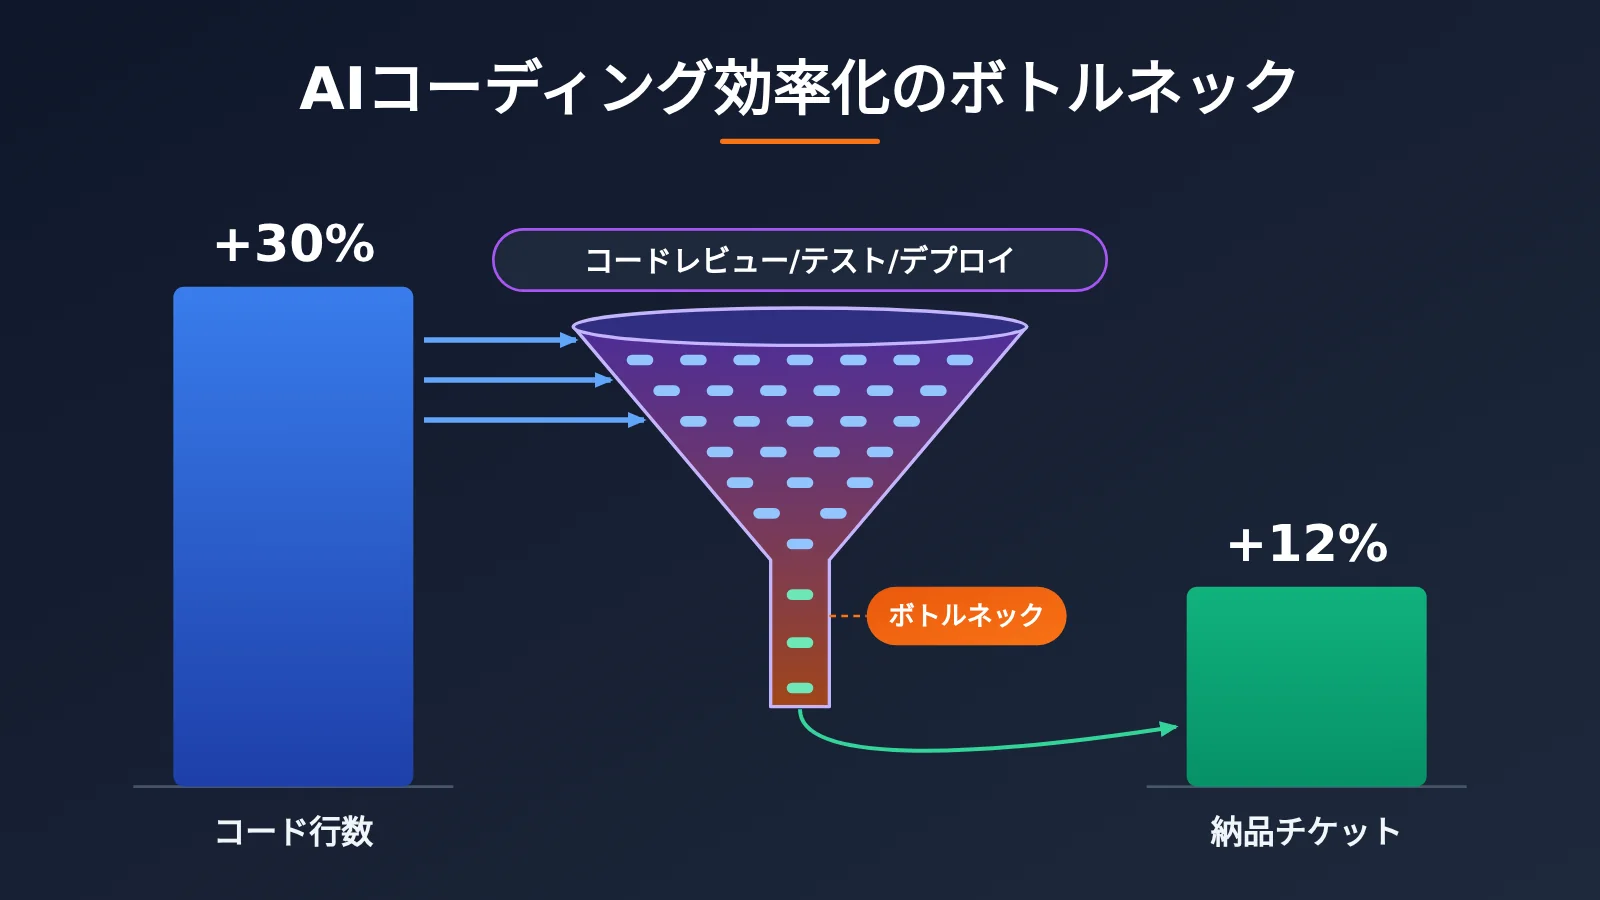
著者注:AI エージェントによってコード行数は30%増えたのに、デリバリーされたチケットは12%しか増えていません。本記事では研究データからボトルネックを特定し、チームがそのまま実践できる生産性向上の手順を示します。
多くのチームがAIエージェントを導入した結果、コミットは増え、マージリクエストも増えたものの、要件のデリバリーはほとんど速くなっていません。ハーバード大学が最近行った、Jellyfish プラットフォームを利用して718社を対象とした研究は、定量的な結論を示しています。コード量は30%増、デリバリーは12%増にとどまり、その差の大半はコードレビューなどの下流工程に吸い込まれている。
これはAIコーディングを悲観する記事では決してありません。研究の結論は明確です。AIエージェントがアウトプットの増加をもたらしたことは確かであり、問題はデリバリーパイプライン全体がそれに合わせて拡張されていないことにあります。本記事ではまずデータを分解し、そのうえで測定からプロセス改善までをカバーする5ステップの方法を紹介します。
本記事の価値:この記事を読めば、自チームのAIコーディング生産性向上がどの工程で詰まっているかを見極め、何から改善すべきか、改善が有効かどうかをどう測ればよいかがわかります。
AIコーディング効率化のボトルネック:押さえるべき核心ポイント
この調査のデータ期間は2021年1月から2026年3月までで、700社余り、70万人の従業員を対象とし、合計約3億件のワークイベントをカバーしています。データソースには人事情報、コードバージョン管理システム、チケットシステム、スケジュールツールに加え、GitHub Copilot、Cursor、Claude Codeなどの生成AIツールの利用記録が含まれており、サンプル規模は同種の研究の中でもかなり異例です。
| 要点 | 研究結果 | チームにとっての意味 |
|---|---|---|
| 生産量の増加 | AIエージェントによりコード行数 +30%、コミット +20%、マージリクエスト +23% | コーディング工程は確かに速くなった |
| デリバリーの増加 | 1人あたり月間で解決したチケットは12%増加するのみ | 生産量が同じ比率でデリバリーにはつながっていない |
| 時間配分 | エンジニアがコードを書いている時間は30%〜40%のみ | コーディングだけを最適化しても天井は低い |
| レビュー負荷 | レビュー時間 +49%、コメント数 +53%、手戻りが必要なマージリクエストの割合が倍増 | ボトルネックはレビュー工程へ移った |
| AIレビュー | AI支援レビューを導入しても、レビューに参加する人の割合は14%増加 | AIレビューツールを追加するだけでは解決しない |
AIアシスタントとAIエージェントの効率化効果の違い
研究では2種類のツールを区別しています。コーディングアシスタント(コード補完と対話が中心)による向上は小さく、コード行数 +12%、コミット +9%、マージリクエスト +5%で、このうち統計的に有意だったのはコミット記録の増加だけでした。さらに重要なのは、コーディングアシスタントでは解決済みチケット数が増えなかったことです。つまり、デリバリーへの測定可能な影響はほとんどありませんでした。
AIエージェント(複数ステップのタスクを自律的に完了できる)は、3つの生産量指標すべてで有意な増加をもたらし、チケットも12%増加させました。これは「AIに完全なタスクを任せる」方が「AIに数行を補完してもらう」よりも価値が高いことを示す一方、下流が受け取るコード量とレビュー負担も同時に拡大することを意味します。研究ではさらに、レビュー作業量の増加は単一のマージリクエストの規模が大きくなっただけでは説明できず、コード自体により多くの議論と修正が必要になっていることが問題だと特に指摘しています。
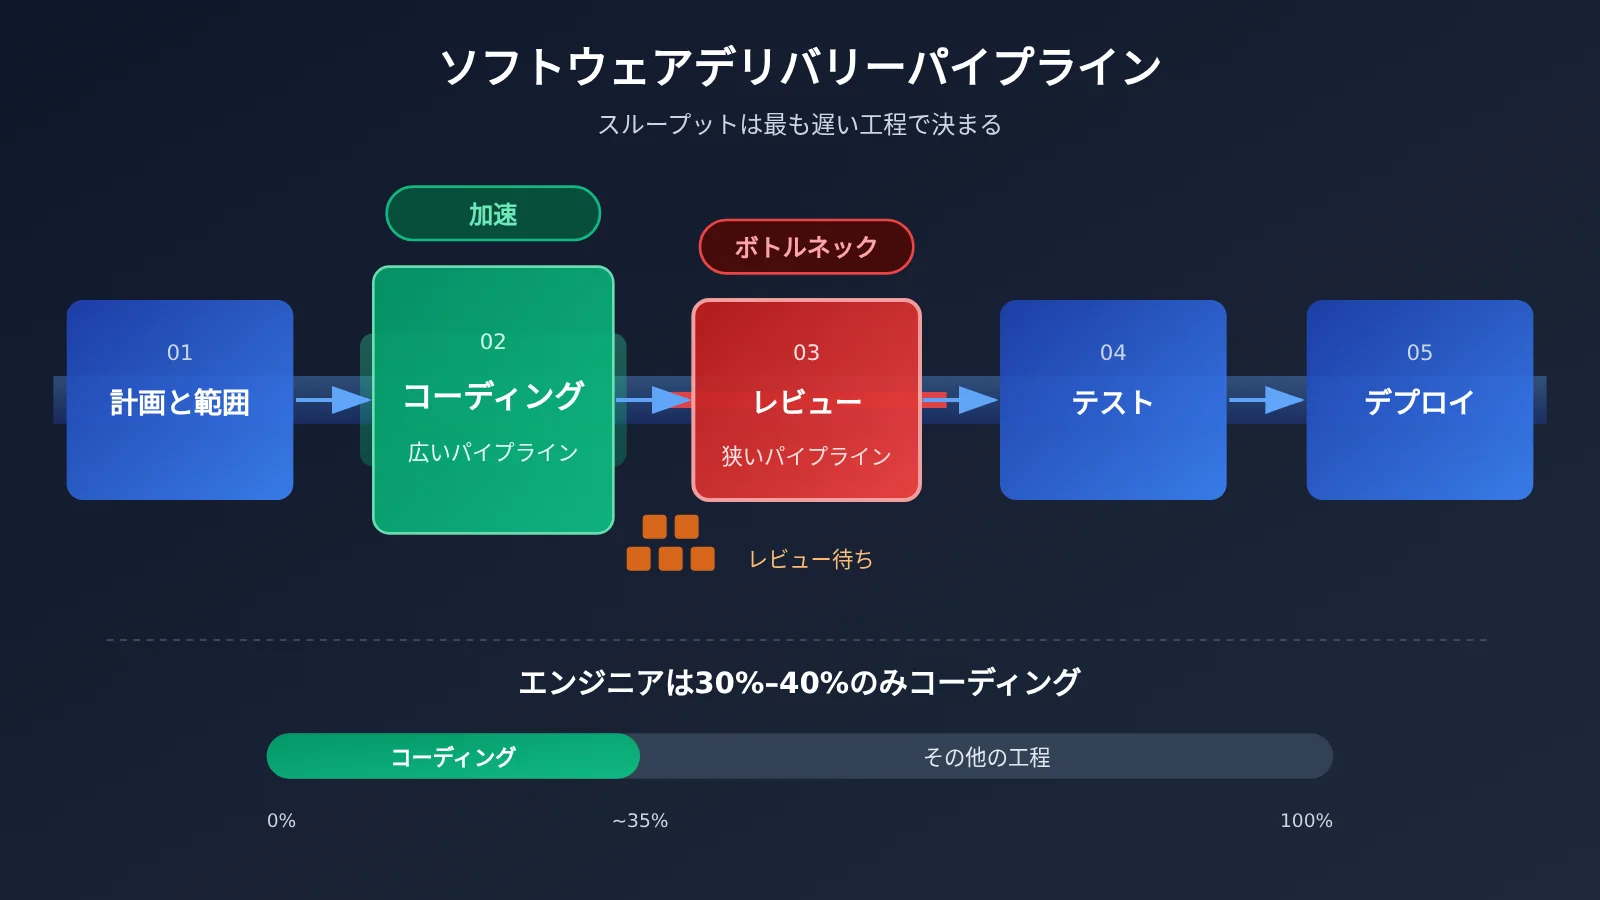
AIコーディング効率化のボトルネックはどこにあるのか:制約理論で読み解く
デリバリーパイプラインのスループットは、最も遅い工程によって決まります。コーディングがエンジニアの時間の30〜40%しか占めていないとしたら、コーディング速度を2倍にしても、全体のリードタイムはせいぜい3分の1ほどしか短縮できません。しかも現実には、加速されたコーディングはレビューやテストに未処理の作業を積み上げるだけに終わります。
研究で示されたいくつかの数字を並べると、因果の連鎖がはっきりと見えてきます。エージェントがより多くコードを書けば、マージリクエスト(MR)が増えます。1つのMRあたりのコメント数は53%増加しており、レビュアーがAIの書いたコードを理解し、疑問を投げかけるためにより多くの労力を割いていることがわかります。修正が必要なMRの割合は2倍になっており、最初の提出物の品質が低下していることを示しています。こうしたコストはすべて人間のレビュアーにのしかかります。そしてそのレビュアーこそ、チームで最も経験豊富であり、最も時間に余裕のない人たちなのです。
| 工程 | AIによる変化 | 典型的な症状 | 優先度 |
|---|---|---|---|
| 計画とスコープ | 要件が不明確だと、AIは「自信たっぷりに」間違った方向へ書いてしまう | 手戻り、MRが丸ごとひっくり返る | 高 |
| コーディング | 速度が明らかに向上 | コード量が激増し、個人の生産性は良く見える | 最適化済み |
| コードレビュー | レビュー待ちの件数と複雑さが同時に上昇 | レビューの順番待ち、コメントの往復 | 最優先 |
| テスト | カバレッジが新規コード量に追いつかない | リグレッションの増加 | 高 |
| デプロイと運用 | エンジニアのコード理解が浅くなる | 障害調査が遅くなる | 中長期 |
コミュニティの議論もこの点を裏付けています。「すべてのコード行は潜在的なリスクだ」とコメントする開発者もいれば、エージェントはあまり信頼できない協力者であり、タスクを完了するために突飛な操作をしてしまうことがあると指摘する人もいます。また、平均復旧時間(MTTR)がAIの影響を評価する重要な指標になるという見方もあります。自分が納品したコードへの理解が浅いほど、原因究明は難しくなるからです。
AIコーディングの効率化をすぐに始める:5つのステップで突破口を開く方法
以下の方法は、投入の小さいものから大きいものへと並べています。チームはこの順番で進めていくとよいでしょう。各ステップでは、できるだけ測定可能な指標を示し、「速くなった気がする」といった検証できない判断を避けるようにします。
ステップ1:AIコーディング効率化のデリバリーベースラインを確立する
まずツールを替える前に、計測の仕組みを整えましょう。先ほどの研究でギャップが見つかったのは、産出指標とデリバリー指標の両方に注目したからです。コード行数やコミット数だけを見ていると、多くのチームは効率化が大成功したと勘違いしてしまいます。
2つの指標グループを同時に追跡することをおすすめします。産出側ではコミット数とマージリクエスト数、デリバリー側では1人あたり月間のクローズ済みチケット数と、要件が開始からリリースまでのサイクルを見ます。さらにレビュー側の3つの指標(マージリクエストの平均レビュー時間、1つのマージリクエストあたりのコメント数、手戻りが必要な割合)も加えましょう。これらのデータは通常、GitプラットフォームやJiraなどのチケットシステムから直接エクスポートできます。
| 指標カテゴリ | 具体的な指標 | データソース | 注目ポイント |
|---|---|---|---|
| 産出 | コミット数、マージリクエスト数 | Gitプラットフォーム | 参考のみ、評価には使わない |
| デリバリー | 1人あたり月間クローズ済みチケット数、要件サイクル | チケットシステム | 中核目標指標 |
| レビュー | レビュー時間、コメント数、手戻り率 | Gitプラットフォーム | ボトルネックの予兆 |
| 品質 | 本番障害数、MTTR | 監視とインシデント記録 | 長期的な健全性 |
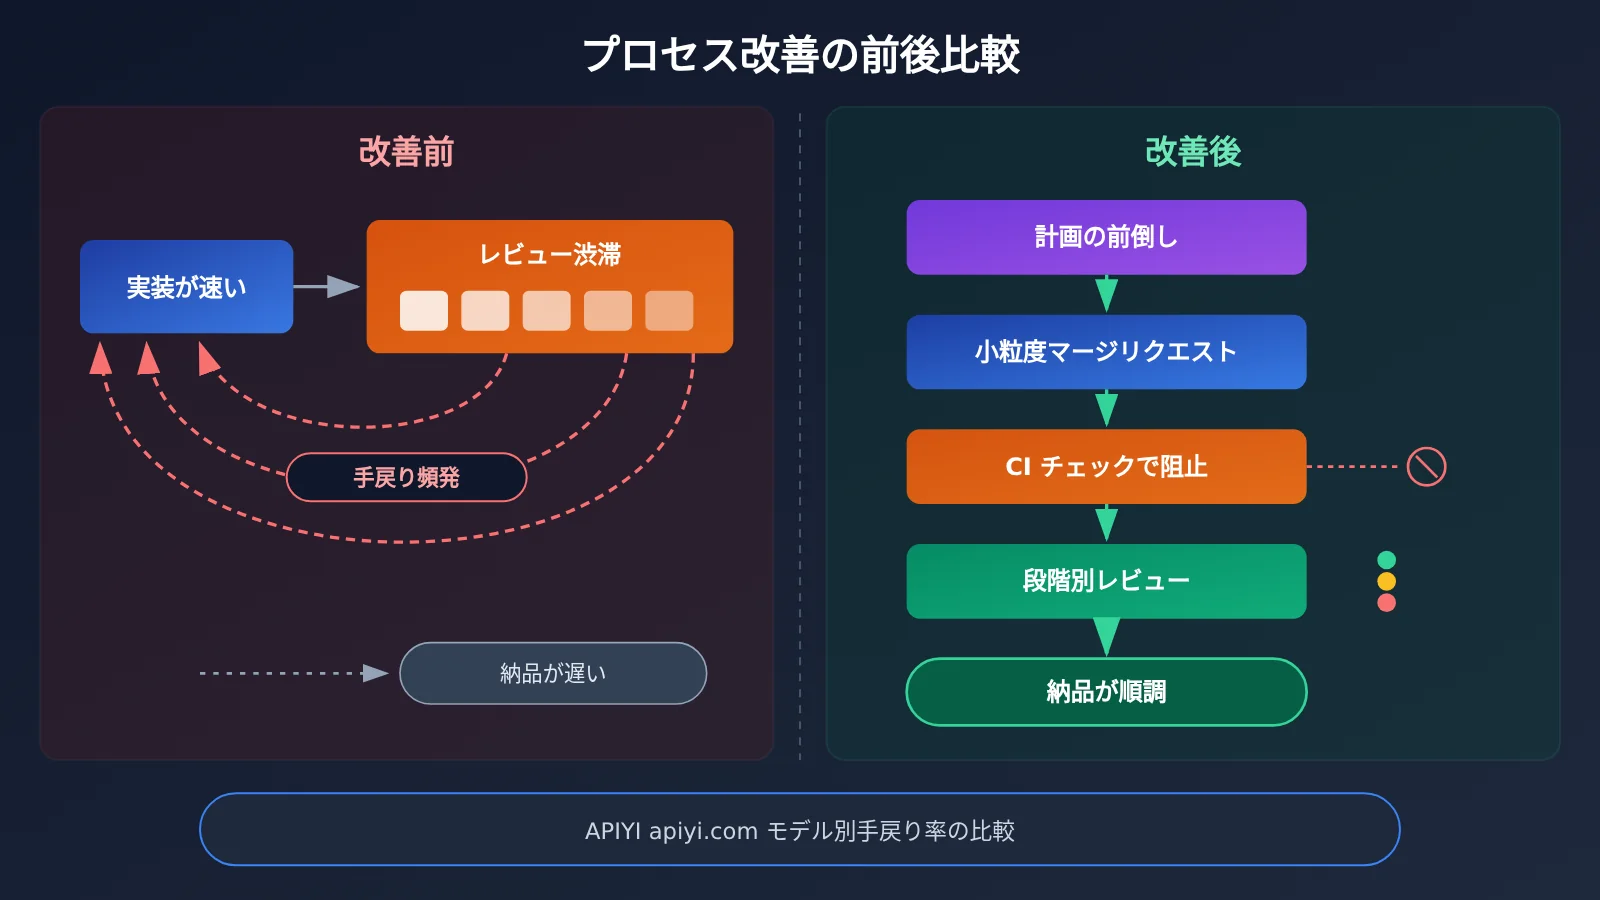
ステップ2:要件の計画をAIコーディングエージェントに先に渡す
要件が曖昧なときこそ、エージェントは「自信たっぷりに的外れな方向へ走る」ものです。レビュー段階でマージリクエストを丸ごと差し戻すよりも、着手前に10分かけてタスク説明を書き切るほうが効果的です。どのモジュールを変更するのか、どのインターフェースには手を触れてはいけないのか、受け入れ基準は何か、どのテストを追加する必要があるのかを明確にします。
実用的な方法は、エージェントにまず実施計画を出力させ、エンジニアが確認してからコーディングに進むという流れです。計画段階での修正コストはコード段階よりはるかに低く、レビュアーも変更範囲を事前に把握できます。この一手間は一見すると初期の時間を増やすように見えますが、「手戻りが必要なマージリクエストの割合が倍増する」といった問題を直接減らせます。
ステップ3:AI生成コードのマージリクエストの粒度をコントロールする
レビュアーの注意力は有限な資源です。研究が示すように、レビュー負担の上昇が単一マージリクエストの巨大化だけに起因するわけではないとしても、粒度のコントロールは認知負荷を下げる最も直接的な手段であることに変わりはありません。エージェントのタスクには明確な境界を設け、1つのマージリクエストでは1つの問題だけを解決し、リファクタリングと機能変更は別々に提出することをおすすめします。
同時に、エージェントにはマージリクエストの説明に変更の動機、影響範囲、自己テストの結果を明記させましょう。レビュアーは説明を読めばリスクを判断でき、数百行の差分から意図を逆算する必要がなくなるため、コメントの往復回数は明らかに減ります。
🎯 技術的な提案:モデルによってタスク分割や計画の質には明確な差があります。APIYI apiyi.com は Claude、GPT など本記事で扱う主要モデルのAPI呼び出しを提供し、OpenAI と Anthropic の2種類のインターフェース形式に同時に対応しています。チームは同じエージェントワークフローの中でモデルを切り替え、どのモデルが生成したマージリクエストの手戻り率が低いかを比較できます。接続方法は APIYI のドキュメント docs.apiyi.com を参照してください。
ステップ4:テストとセルフチェックはレビュアーではなくエージェントに任せる
研究によると、AI支援レビューを導入した後も、レビューに参加する人員の割合は14%増加しました。これは、レビュー工程にAIを1つ追加するだけでは不十分だということを示しています。より効果的なのは、品質のゲートを前倒しすることです。すなわち、エージェントがコミット前にユニットテストの追加、ローカルでのテスト実行、静的チェック、フォーマットを完了するようにします。
「テスト通過・チェック通過」をマージリクエスト提出の必須前提条件とし、CIで自動的にブロックする仕組みにできます。これによりレビュアーは、ヌルポインタや命名の問題を指摘するのではなく、設計の妥当性、境界条件、ビジネスロジックに集中できるようになります。AIレビューツールは最初のフィルタとして適していますが、最終判断はビジネスを理解している人が行うべきです。
ステップ5:段階的レビューとAIコーディングのリスク層別化
AIが生成したコードのすべてが同じ強度のレビューを必要とするわけではありません。変更をリスク別に階層化できます。ドキュメント、テスト、ボイラープレートコードは軽量レビュー、ビジネスロジックは通常レビュー、認証・決済・データ移行・並行処理に関わる変更は、シニアエンジニアによる深いレビューを必須とし、さらに作者が各変更点を説明できることを求めます。
| リスクレベル | 変更タイプ | レビュー方式 | 推奨レビュー人数 |
|---|---|---|---|
| 低 | ドキュメント、テストケース、ボイラープレートコード | AI一次レビュー + 迅速な人による確認 | 1名 |
| 中 | 通常のビジネスロジック | 人による完全レビュー | 1〜2名 |
| 高 | 認証、決済、データ移行、並行処理 | シニアエンジニアによる深いレビュー + 作者の解説 | 2名以上 |
最後に、MTTRを長期的な追跡指標に組み込みましょう。エンジニアのコード理解が浅くなっていけば、問題は本番障害として表面化します。定期的に作者へ自分がマージしたAIコードを説明させることは、「このコードを本当に理解している人が誰もいない」状態を防ぐ低コストな手段です。
🚀 クイックスタート:チーム内のコーディングエージェントを構築しているなら、まず APIYI(apiyi.com)でテスト枠を申請し、同じタスク説明を使って異なるモデルをそれぞれ呼び出してみましょう。マージリクエスト生成からレビュー完了までの時間と手戻り率を記録し、そのうえでメインモデルを決めるとよいですよ。
AIコーディングエージェントのモデル選定の参考
モデル選定だけではプロセスのボトルネックは解消できませんが、初回提出の品質に影響し、ひいてはレビュー負担にも影響します。次の表はワークフロー上の役割ごとに方向性を示すもので、実際の効果はチームでの実測を基準にしてください。
| ワークフロー上の役割 | 重視する能力 | 選定の考え方 | 利用可能なプラットフォーム |
|---|---|---|---|
| 実施計画の生成 | 長いコンテキストの理解、タスク分割 | 推論能力の高いフラッグシップモデルを選ぶ | APIYI apiyi.com、公式API |
| コード作成とリファクタリング | コード品質、制約の遵守 | プログラミング評価で好成績のモデルを選ぶ | APIYI apiyi.com、公式API |
| テスト追加とセルフチェック | 安定性、呼び出し回数の多さ | コストパフォーマンスの高いモデルを選ぶ | APIYI apiyi.com、公式API |
| AIによる一次レビュー | よくある欠陥の発見 | コード作成用モデルとは別のモデルを選び、同系統による盲点を避ける | APIYI apiyi.com、公式API |
💰 コストについて:エージェントワークフローは呼び出し量が多く、課金の基準(入力・出力・キャッシュヒットの単価)がコストを直接左右します。本記事では具体的な価格は記載しません。すべてのモデルの価格と課金方式は、APIYIの価格ページ docs.apiyi.com/models のリアルタイムデータを参照してください。
よくある質問 FAQ
Q1:AIコーディングで「コード量は30%増えても、納品は12%しか増えない」とはどういう意味ですか?
これはハーバード大学がJellyfishのデータを用いて導いた研究の結論です。AIエージェントを使うとコード行数は30%増えますが、エンジニア1人あたりが月に解決するチケットは12%しか増えません。この差は主に、コードレビューやテストといった下流工程が新たなボトルネックになっていることから生じています。
Q2:AIコーディングアシスタントとAIエージェントでは、効率化の差はどれくらいありますか?
コーディングアシスタントの生産性向上は小さく、コミット記録の9%増だけが統計的に有意で、チケット解決数は増えていません。一方、AIエージェントはコード行数、コミット、マージリクエストをそれぞれ30%、20%、23%増やし、さらに12%のチケット増加ももたらします。
Q3:このAIコーディング効率化研究のデータは信頼できますか?
データ期間は2021年1月から2026年3月で、700社以上、70万人の従業員、約3億件の作業イベントをカバーしています。工数の配分推計は100人のエンジニアを対象とした調査でも検証されており、サンプル規模とクロスバリデーションはかなり堅実です。
Q4:AIコードレビューツールを導入すれば、レビューのボトルネックは解消しますか?
それだけでは不十分です。研究によると、AI支援レビューを導入した後も、レビューに参加する人の割合は14%増えています。より効果的なのは、テストとセルフチェックをコミット前に前倒しし、段階的なレビューを組み合わせて、人間のレビューを高リスクな変更に集中させることです。
Q5:異なるモデルがレビュー負担に与える影響を、低コストで検証するにはどうすればよいですか?
同じ実際のタスク群で複数のモデルを比較することをおすすめします。
1. APIYI apiyi.com に登録してテスト用のクレジットを取得する
2. APIYIのドキュメント docs.apiyi.com の説明に従い、OpenAIまたはAnthropic互換形式で既存のエージェントに接続する
3. 各モデルが生成したマージリクエストのレビュー時間、コメント数、手戻り率を記録する
これにより、印象ではなくデータでモデルを選べます。
Q6:チームがAIコーディングエージェントを使う場合のコストはどう見積もればよいですか?
まず1タスクあたりの平均入力・出力Token数を集計し、モデルの単価と月間タスク数を掛けます。エージェントのタスクはコンテキストが長くなりがちで、キャッシュヒットがコストに大きく影響します。具体的な単価とキャッシュの課金基準は、APIYIの料金ページ docs.apiyi.com/models を参照してください。
Q7:AIコーディングの効率化には、どのような長期的リスクがありますか?
主なリスクは、エンジニアのコードへの理解が浅くなることです。コミュニティでは、コードベースが拡大し続ける一方で理解が不足すると、障害がより頻繁に発生し、調査も難しくなるという見方があります。障害の平均復旧時間を長期的に追跡し、マージしたAIコードについて作者がきちんと説明できるようにすることをおすすめします。
AIコーディング効率化の核心ポイント Key Takeaways
- アウトプットはデリバリーではない:AIエージェントでコード量は30%増えたが、デリバリーチケットは12%しか増えなかった
- コーディングは3〜4割の時間だけ:コードを書く作業だけを最適化しても、全体の効率化には限界がある
- レビューが最大のボトルネック:レビュー時間 +49%、コメント +53%、手戻り率は2倍
- AIレビューは万能薬ではない:導入後もレビュー参加者の割合は14%増加
- 品質ゲートを前倒しする:計画の前倒し、小さな粒度でのコミット、コミット前のセルフチェックが最も効果的
- MTTRを長期的に追跡する:チームがAIコードを「大量に書くが、理解は浅い」状態にならないようにする
- データでモデルを選ぶ:APIYI apiyi.comの統一インターフェースで各モデルの手戻り率を比較できます
まとめ
AIコーディングの効率化はどこで詰まるのか。研究はすでに答えを示しています:
- ボトルネックはすでに移っている:コーディングが速くなると、コードレビュー、テスト、計画が新たなボトルネックになります
- 指標はセットで見る:アウトプット指標は、デリバリー・レビュー・品質の指標と併せて追跡する必要があります
- ツールの変更よりプロセスの改善が重要:計画の前倒し、粒度の制御、セルフチェックの前倒し、段階的レビューを順番に進めます
本当の効率化とは、AIにより多くのコードを書かせることではなく、より少ないコードをより高い初回品質でレビューに通過させることです。まず1イテレーションでベースラインデータを計測し、その後、上記の5ステップの方法を段階的に実践することをおすすめします。
エージェントワークフローでさまざまなモデルの性能を比較したい場合は、APIYI apiyi.comで手早く検証するのがおすすめです。プラットフォームはOpenAIとAnthropicのAPIインターフェース形式に対応しており、価格はdocs.apiyi.com/modelsを参照してください。
📚 参考資料
- InfoQ 中国語版:AI生成コードは下流工程のボトルネックに制約される:研究報道の中国語版
- リンク:
infoq.cn/article/c3vTLNrRwfCzw8SAmz90 -
説明:研究方法、中核データ、コミュニティでの議論を収録
-
InfoQ 英語原文:Jellyfish AI Productivity:研究報道の英語版
- リンク:
infoq.com/news/2026/10/jellyfish-ai-productivity -
説明:英語の原表現を確認したい読者に最適
-
APIYI ドキュメントセンター:モデル接続とインターフェースの説明
- リンク:
docs.apiyi.com -
説明:OpenAI および Anthropic 互換フォーマットでの接続方法
-
APIYI モデル料金ページ:各モデルの課金基準
- リンク:
docs.apiyi.com/models - 説明:入力・出力・キャッシュの単価は、すべてこのページのリアルタイムデータを基準とします
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお気軽にお問い合わせください。接続に関する資料は docs.apiyi.com ドキュメントセンターでご覧いただけます