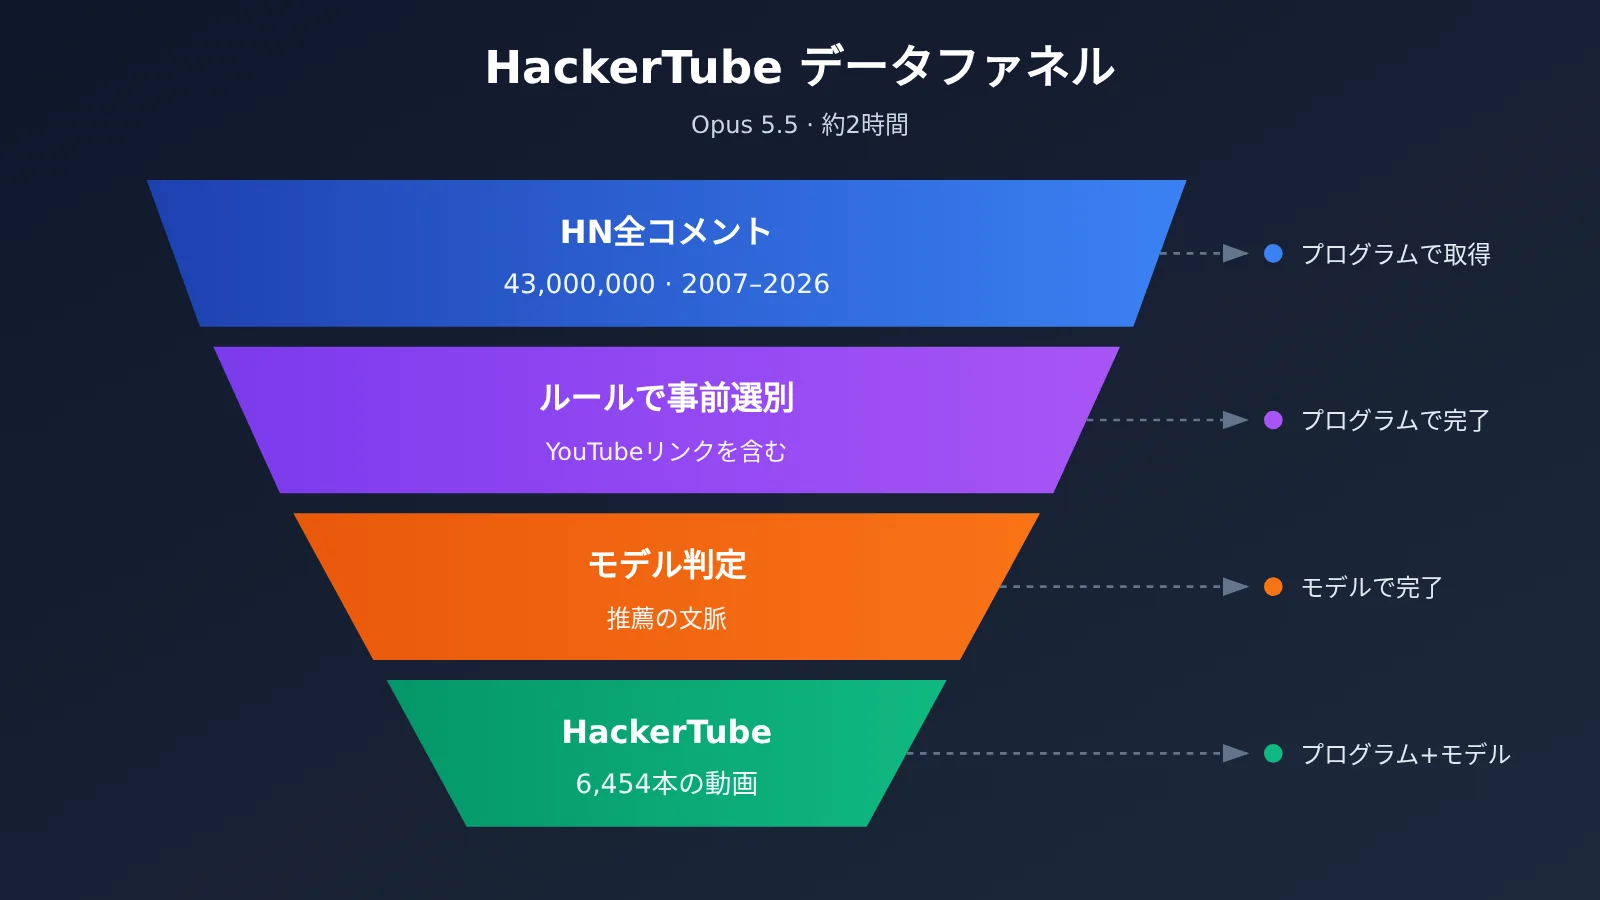
Andrej Karpathy は週末の約2時間で、動画サイト「HackerTube」を作りました。Hacker News の20年分、約4,300万件のコメントから、繰り返しおすすめされている YouTube 動画を Claude に選ばせたものです。選ばれた動画は6,454本で、作業の大半は Claude との対話を通じて進められました。Karpathy が X に投稿した原文(2026-11-01)は「~2 hours with Opus 5.5」です。
この記事では、Karpathy の元投稿、HackerTube のサイト、コミュニティによる公開情報をもとに、普通の開発者でも実践できる6つのステップに分解し、特につまずきやすい3つのポイントを紹介します。
この記事でわかること:「人・プログラム・モデル」の役割を明確にした6ステップの流れ、前提条件を示したコスト試算、そして APIYI apiyi.com を使って Claude Code を利用するための最短ルートがわかります。
Karpathy の HackerTube は何をしたのか
ひと言でいうと、Hacker News(HN)コミュニティが20年にわたって「この動画はぜひ見るべき」と推薦してきた動画を、ブラウズできる動画サイトにまとめたものです。
Karpathy が X に投稿した全文(2026-11-01 18:14 UTC)は次のとおりです。
「週末のハック:HackerTube。YouTube のおすすめにうんざりしたので、HN の20年分、4,300万件のコメントを Claude に絞り込ませ、繰り返し推薦されている6,454本の動画を選び出した。視聴体験は格段に良くなった。Opus 5.5 を使って約2時間」
サイト hackertube.org の説明は「Hacker News でユーザー同士が繰り返し勧め合っている YouTube 動画」です。つまり、中心にあるのは推薦アルゴリズムではなく、既存のコミュニティでの議論を意味に基づいて選別することです。
| ポイント | 公開情報 | 情報源 |
|---|---|---|
| データ規模 | HN の20年分、約4,300万件のコメントから、最終的に6,454本の動画を選出 | Karpathy の元投稿(2026-11-01) |
| 所要時間とモデル | 約2時間、Opus 5.5 を使用 | Karpathy の元投稿(2026-11-01) |
| ツール環境 | Claude Code デスクトップ版 | コミュニティでの伝聞 |
| 人が行った作業 | 手動で行ったのは、YouTube APIキーの取得、サーバーの準備、ドメインの購入の3つだけ | コミュニティでの伝聞 |
| サイトの構成 | 約150のトピック、対象期間は2007-2026年、ログイン不要 | コミュニティによる集計 |
HackerTube の仕組みを詳しく解説
コミュニティでの伝聞によると、Karpathy は「私は Claude と話すだけで、すべてをやってもらっている」と話したそうです。つまり、データのダウンロード、選別スクリプトの作成、モデルを呼び出しての判断、ページの生成といった作業の大半を Claude が Claude Code 内で担当し、人は主に要件を伝え、アカウントや支払いが必要な部分を処理しました。
これは「AI にウェブページのテンプレートを書かせる」のとは別の話です。本当に難しいのはデータの扱いです。4,300万件のコメントを一度にコンテキストへ詰め込むことはできませんし、「リンクが登場した」ことと「推薦された」ことも同じではありません。そのため、このプロジェクトはデータパイプラインに、シンプルなフロントエンドを載せたものに近いといえます。
Opus 5.5 で HackerTube を再現する6ステップ
まず結論から。再現のポイントは、先にプログラムでデータ量を絞り、文脈の理解が必要な判断だけをモデルに任せることです。以下の6ステップを実行順に紹介します。それぞれの担当者と、完了後の確認方法もまとめました。
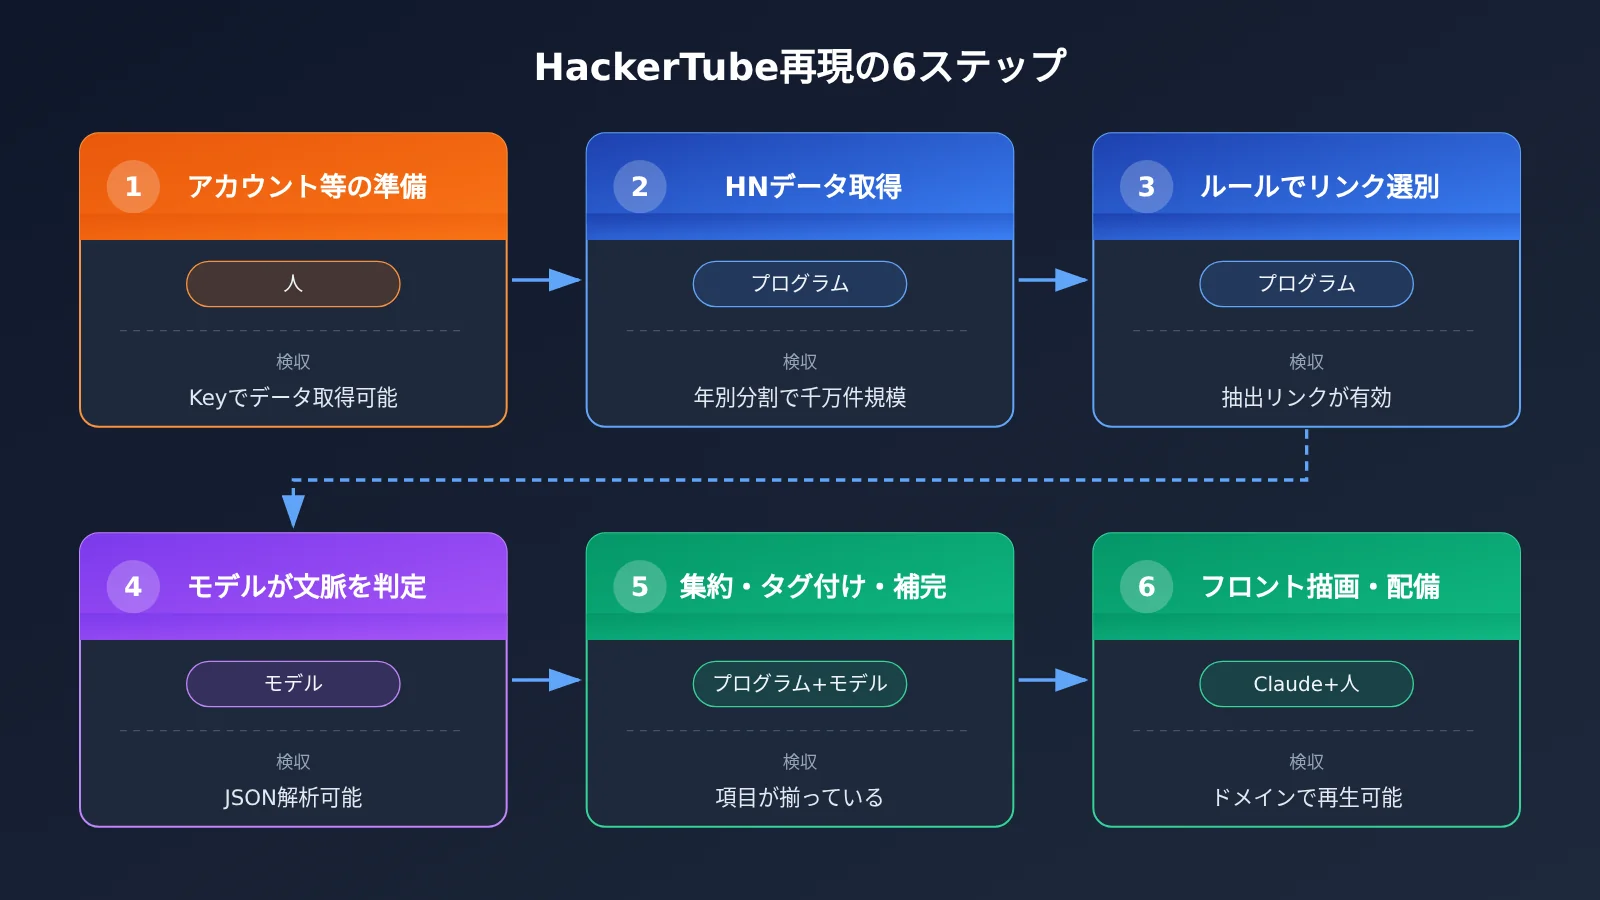
| ステップ | 作業内容 | 担当 | 完了後の確認方法 |
|---|---|---|---|
| 1 | YouTube APIキーの取得、サーバーの準備、ドメインの購入 | 人 | 3つすべてにログインでき、キーを使って動画情報を1件取得できる |
| 2 | HN の全コメントを取得 | プログラム(Claude が作成) | 年ごとに分けたファイルがローカルにあり、件数が想定どおりの規模になっている |
| 3 | 正規表現で YouTube リンクを含むコメントを抽出 | プログラム | 50件を抜き取り、すべてに有効な動画リンクが含まれていることを確認 |
| 4 | モデルにバッチ単位で推薦の文脈かどうかを判断させ、JSON を出力 | モデル | JSON をそのままパースでき、抜き取った結果の正誤を人が確認 |
| 5 | videoId ごとに件数を集計し、トピックタグを付け、タイトルとチャンネル情報を補完 | プログラム + モデル | 各動画に必要なフィールドがすべてそろい、トピック数が管理可能な範囲に収まっている |
| 6 | フロントエンドページを生成してデプロイ | Claude がコードを作成し、人がドメインを紐付け | ブラウザでドメインを開き、トピック別の閲覧と動画の再生ができる |
第 1-2 歩:リソースの準備と HN データの取得
第 1 歩は人が行います。 Google Cloud コンソールでプロジェクトを作成し、YouTube Data API を有効にして APIキーを発行します。サーバーは任意のクラウドホストや静的ホスティングサービスを利用でき、ドメインはレジストラで購入して用意しておきます。この 3 つはいずれもアカウントや支払いが必要で、コミュニティで伝えられた内容では Karpathy 自身が対応した部分です。
第 2 歩は Claude がプログラムを書いて行います。 HN データには 2 つの公開ソースがあります。公式の Firebase API では item ID を指定して 1 件ずつ取得でき、BigQuery の HN 公開データセットは SQL で直接クエリできます。全件をダウンロードするなら、まず BigQuery を検討し、年ごとにエクスポートするのがおすすめです。確認するポイントは、ファイルが時系列で分割されていることと、総件数が数千万件規模であることの 2 点です。
第 3-4 歩:ルールによる事前選別と Opus 5.5 による意味の判断
第 3 歩はコスト削減の鍵となる工程で、すべてプログラムに任せます。 youtube.com/watch や youtu.be/ などのリンク形式を正規表現で照合し、動画リンクを含むコメントだけを残します。その際、文脈としてコメント ID、日時、親投稿のタイトルも付けます。Claude Code に「YouTube リンクを含むコメントを抽出して JSONL として保存するスクリプトを書いて」のように、要件を直接伝えれば OK です。
第 4 歩で初めてモデルが判断します。 Opus 5.5 に数千件のコメントをまとめて渡し、videoId、おすすめかどうか、トピック、代表的なコメントの抜粋を含む構造化結果だけを出力するよう求めます。プロンプトには「この動画はひどい」「これは見ないほうがいい」はおすすめに該当せず、「見る価値がある」という趣旨のものだけをおすすめと判定する、と明記します。確認の際は、結果をランダムに抽出して人手で照合し、判断の誤りが許容範囲かどうかを見ます。
ステップ 5〜6:集計・タグ付けとフロントエンドのデプロイ
ステップ 5 では、まずルールを使い、次にモデルを使います。 プログラムで videoId ごとに推薦された回数を集計し、YouTube Data API を呼び出してタイトルとチャンネル名を補完します。トピックタグはモデルで統一・整理し、「機械学習」「ML」「ディープラーニング入門」のように細かく分かれすぎないようにします。コミュニティの集計によると、HackerTube のトピックは最終的に約 150 個で、粒度の参考になります。
ステップ 6 では、データとページを分離します。 最終的な成果物は JSON データファイルと、それを読み込む静的フロントエンドです。動画は YouTube の iframe で埋め込み、トピックと人気度に応じて並べます。データを更新するときは JSON を再生成するだけで、ページのコードを変更する必要はありません。静的ホスティングサービスや自分のサーバーにデプロイし、最後に人がドメインの DNS を設定します。
🚀 クイックスタート:ステップ 4 と 5 では、モデルを頻繁に呼び出す必要があります。APIYI apiyi.com を通じて Claude Code に接続すれば、同じキーで Opus と Sonnet を切り替えられます。まず少量のデータで一連の流れを確認し、本番のデータ処理にどちらのモデルを使うか決めましょう。
HackerTube の再現で本当につまずく3つのポイント
結論から言うと、つまずくのはほとんどがデータ処理で、Webページの作成ではありません。以下の3つを、直面する順に紹介します。
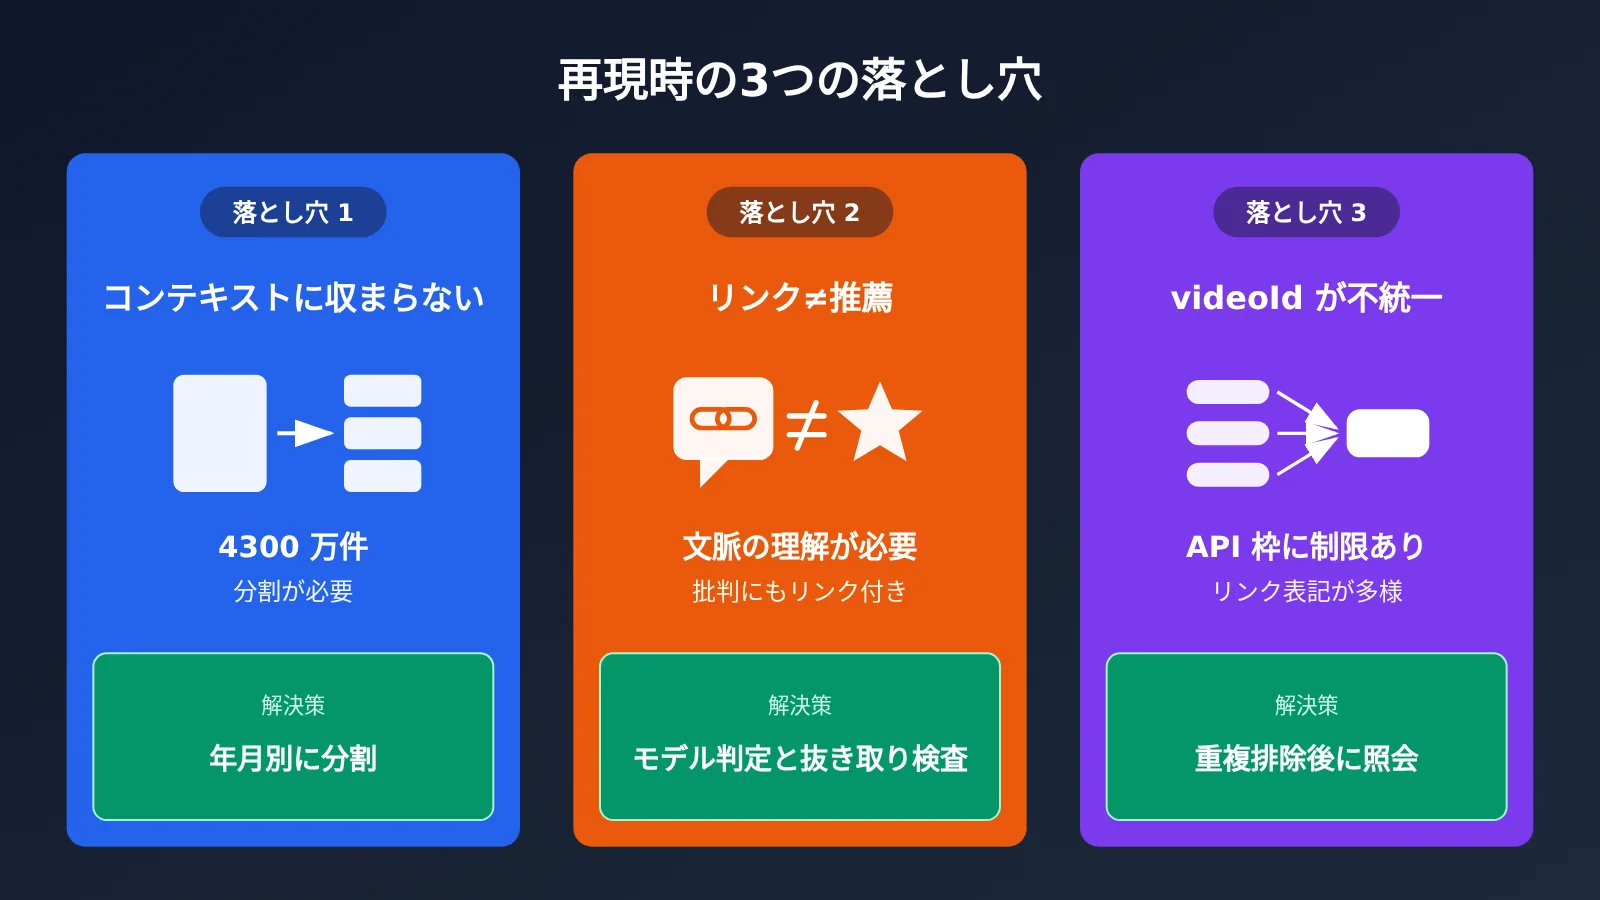
| 落とし穴 | よくある症状 | 解決策 |
|---|---|---|
| コンテキストに収まらない | モデルに「すべてのコメントを読んで」と指示すると、長すぎてエラーになるか、出力が途中で切れる | 年月ごとに分割し、1バッチを数千件に抑えて、構造化された JSON のみを出力する |
| リンク≠推薦 | 批判、皮肉、誤りの指摘に含まれるリンクが推薦として扱われる | モデルにコメントの文脈を読んで判断させ、人間が抜き取りチェックする |
| ID の不統一とクォータ | 同じ動画に複数のリンク形式がある、動画が削除されている、API の割り当てを使い切る | 先に videoId を統一してから集計し、メタデータは重複を除いた ID だけを照会する |
落とし穴 1:Opus 5.5 のコンテキストに4300万件のコメントは収まらない
初心者がよく犯すのは、「HN のすべてのコメントを読んで、推薦されている動画を探して」とそのまま指示することです。モデルのコンテキストがどれだけ大きくても、十数億トークンのテキストを一度に収めることはできません。正しくは、まず Claude に分割スクリプトを書かせ、年単位または月単位で分けて、1バッチを数千件に抑えます。そのうえで、説明文は付けず、JSON のみを返すようモデルに指示します。
途中から再開できる仕組みも必要です。バッチごとに結果を別々に保存し、処理済みのバッチ番号を記録しておきます。途中でエラーが発生しても、失敗したバッチだけを再実行すればよく、最初からやり直す必要はありません。
落とし穴 2:YouTube リンクがあるだけでは推薦とは限らない
HN のコメントにある YouTube リンクは、推薦の場合もあれば、反例や批判、あるいは「この動画の説明は間違っている」という指摘の場合もあります。URL だけを照合すると、大量のノイズが結果に混ざってしまいます。この段階ではモデルに文脈を読ませる必要があり、ここが一連の処理で大規模言語モデルを本当に必要とする部分です。
プロンプトには推薦に当たる例と当たらない例を示し、判断ごとに根拠となる一文を抜粋させることをおすすめします。人間が抜き取りチェックする際に分類の理由をすばやく確認できますし、フロントエンドでも、その抜粋を動画カードの「HN での評判」としてそのまま使えます。
落とし穴 3:videoId の不統一と YouTube API クォータ
同じ動画でも、youtube.com/watch?v=、youtu.be/、モバイル版リンク、タイムスタンプ付きリンクなど、さまざまな形式で現れます。先に11桁の videoId に正規化しないと、推薦回数が分散し、ランキングも正しくなくなります。また、20年の間に削除されたり、非公開になったりした動画も少なくないため、別途マークして除外する必要があります。
YouTube Data API には1日あたりのクォータ制限があります。先に重複を除いてからメタデータを一括で照会し、コメントごとに問い合わせるのは避けましょう。一括取得用の API では複数の ID を一度に照会できるため、消費量を大幅に減らせます。
HackerTube の再現にかかる費用は?(概算)
結論から言うと、全件を Opus 5.5 で処理すると数千ドル規模ですが、先にルールベースの事前選別を行えば、数十〜数百ドル規模に抑えられます。 以下はすべて概算であり、実際の請求額ではありません。
まずは単価を見てみましょう。下表は APIYI のモデル価格表に基づくもので、データの日時は 2026-10-27 14:50(UTC+8)、単位は米ドル / 100万 tokens です。
| モデル | 入力 | 出力 | キャッシュ読み取り | 利用可能なプラットフォーム |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | APIYI apiyi.com、公式 API |
| sonnet-5-5 | $2 | $10 | $0.1 | APIYI apiyi.com、公式 API |
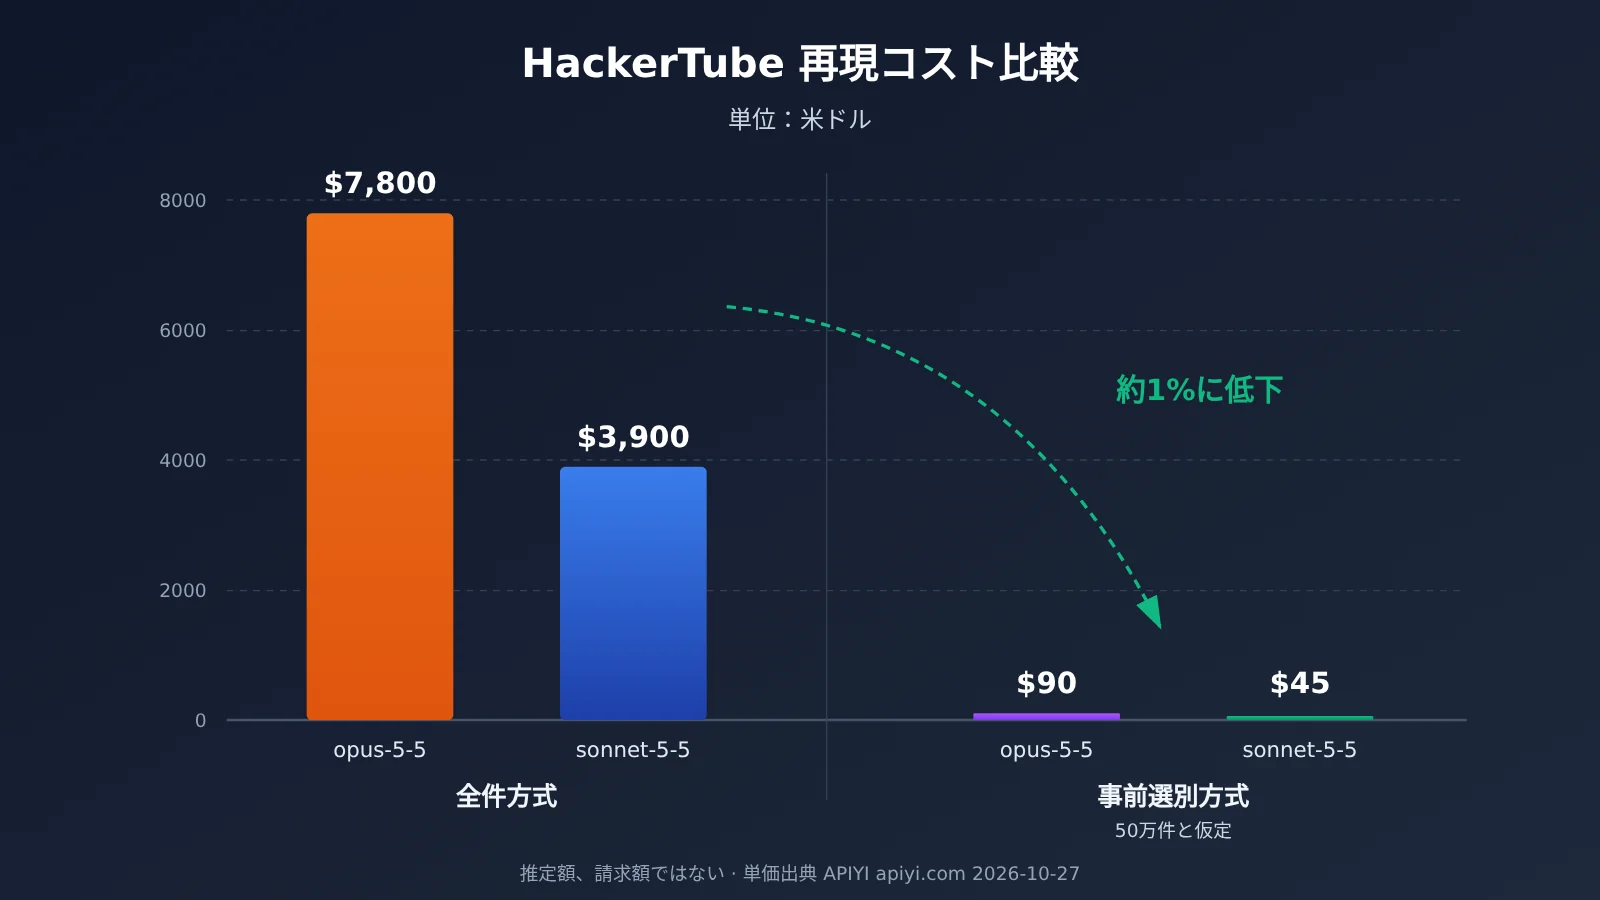
概算の前提は次のとおりです。コメントは4300万件、1件あたり平均30 tokens で、合計約13億 tokens。1バッチあたりの入力は5万 tokens、出力は5千 tokens で、合計約2.6万バッチです。事前選別プランの「残り50万件」は、計算方法を示すために設けた仮定であり、HN の実際の統計ではありません。実際の件数は、ステップ3を実行して初めてわかります。
| プラン | 入力 tokens | 出力 tokens | opus-5-5 の概算 | sonnet-5-5 の概算 |
|---|---|---|---|---|
| 全件を直接モデルに渡す | 約13億 | 約1.3億 | 約 $5,200 + $2,600 ≈ $7,800 | 約 $2,600 + $1,300 ≈ $3,900 |
| 先にルールベースで事前選別(残り50万件と仮定) | 約1500万 | 約150万 | 約 $60 + $30 ≈ $90 | 約 $30 + $15 ≈ $45 |
この表からわかるように、ステップ3のルールベースの事前選別が、プロジェクト全体のコスト規模を左右します。また、各バッチのリクエストに含まれるシステムプロンプトや正例・負例は繰り返し使用するため、キャッシュ読み取りを活用すれば、この部分の費用をさらに抑えられます。コミュニティにも参考事例があります。X ユーザーの @thisiskp_ 氏は、Opus 5.5 を使って約19分、約2ドルで Show HN の動画サイトのデモを作ったと述べています。ただし、これはあくまで1つの事例で、規模もデータ量も異なるため、直接比較することはできません。
💰 コスト面のアドバイス:本番で処理を実行する前に、まず1か月分のデータで一連の流れを試し、実際の token 消費量を記録しましょう。そのうえで月数を掛ければ、総量を見積もれます。APIYI apiyi.com は従量課金で固定の月額料金がないため、「まず少量で試し、それから規模を決める」という使い方に適しています。
APIYI経由でClaude Codeを使い、HackerTubeの処理を実行する
結論から言うと、環境変数を2つ設定するだけで、Claude CodeからAPIYI経由でOpus 5.5を呼び出せます。同じキーでopus-5-5とsonnet-5-5を切り替えることも可能です。
[スクリーンショット:APIYI Claude Code接続ドキュメント]
APIYIのClaude Code接続ドキュメント(docs.apiyi.com/scenarios/programming/claude-code)に従い、ターミナルで以下の2項目を設定します。
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 APIYI Key>
設定後、Claude Codeを起動し、モデルの選択画面でopus-5-5またはsonnet-5-5を選ぶだけです。実際の作業では、「高性能モデルで計画し、経済的なモデルで実行する」という役割分担がおすすめです。
- 計画とコード作成にはopus-5-5を使う:分割方式の設計、収集・事前選別スクリプトの作成、フロントエンドの生成を任せます。この段階はトークン量が比較的少ない一方、高い品質が求められます。
- 一括判定では2つのモデルを比較する:同じ数百件のサンプルをopus-5-5とsonnet-5-5のそれぞれで処理し、判定精度を人手で比較します。そのうえで、2.6万件のバッチまたは事前選別後のバッチに使うモデルを決めます。
- テーマの統合ではopus-5-5に戻す:約150件のテーマを統合するには全体を見渡す視点が必要です。呼び出し回数も少ないため、高性能モデルを使うほうが確実です。
🎯 技術的なアドバイス:APIYI(apiyi.com)のコンソールでキーを作成したら、このプロジェクト専用の利用上限を設定できます。バッチ処理スクリプトがループして呼び出しを繰り返した場合でも、費用が膨らむのを防げます。新規ユーザー向けの無料テスト枠があれば、1か月分のサンプルデータを一通り処理できます。
Karpathy の HackerTube 手法は、ほかにどんなデータに使える?
結論から言うと、「大量のコミュニティの議論の中に、特定のリソースへのおすすめが含まれている」データなら、同じパイプラインを応用できます。
- Reddit の技術系コミュニティ:繰り返しおすすめされている書籍、講座、オープンソースリポジトリを抽出します。パイプラインの構造はほぼ同じで、リンクを検出する正規表現を置き換えるだけです。
- GitHub Issues とディスカッション:何度も引用されているブログ記事や解決策へのリンクを抽出し、プロジェクトの「必読リスト」にまとめます。
- チーム内の IM やドキュメントのコメント:コンテンツチームが過去の議論から、同僚に繰り返し共有された参考資料を見つけられます。ただし、事前にデータの利用権限を確認する必要があります。
- ポッドキャストや論文のおすすめ:リンクを検出する正規表現を arXiv やポッドキャストプラットフォームの形式に変えれば、「コミュニティが本当におすすめする論文・番組」を抽出できます。
応用する際に調整が必要なのは、第3ステップの事前フィルタリングルールと、第4ステップのプロンプトに含める正例・負例の2点だけです。データパイプライン、バッチ処理による呼び出し、JSON 構造、静的フロントエンドはそのまま再利用できます。
よくある質問 FAQ
Q1:YouTube APIキーがなくても HackerTube のようなサイトは作れますか?
主要部分は作れます。videoId はコメント内のリンクから抽出し、再生には iframe 埋め込みを使うため、どちらも APIキーに依存しません。取得できないのはタイトルやチャンネルなどのメタデータです。まずは HN のコメントの文脈からモデルに説明を生成させ、後からキーを追加する方法もあります。
Q2:Hacker News のコメントデータはどうやって取得しますか?
方法は2つあります。HN 公式の Firebase API(github.com/HackerNews/API)では item ID を指定して取得でき、差分更新に適しています。BigQuery の HN 公開データセットは、全データを一括エクスポートするのに向いています。すべて再現するなら、まずは後者がおすすめです。
Q3:なぜレコメンドアルゴリズムを直接作らないのですか?
Karpathy の元の投稿は、YouTube のレコメンドへの不満が出発点でした。HackerTube は20年分のコミュニティの集合的な判断を活用するため、ユーザーの行動データが不要で、コールドスタート問題もありません。2時間以内に完成させることもできます。一方、レコメンドアルゴリズムには長期的なデータの蓄積と継続的な調整が必要です。
Q4:「2時間」ですべて自動的に完成したのですか?
完全自動ではありません。コミュニティで伝えられているところによると、Karpathy は YouTube APIキーの申請、サーバーの準備、ドメインの購入を手動で行い、残りの作業を Claude との対話で進めました。人間は引き続き、要件の提示、成果物の確認、アカウントが必要な手続きを担当します。自分で再現する場合は、プロンプトの調整や人手による抜き取りチェックの時間も確保しておきましょう。
Q5:この方法ではコストが膨らみすぎませんか?
事前フィルタリングを省いて全データを直接モデルに渡すと、推定コストは数千ドルに達し、膨らみすぎる可能性があります。コストを抑える方法は3つあります。まずルールによる事前フィルタリングを行い、次に1か月分のサンプルで試算し、最後に APIYI apiyi.com で APIキーの利用上限を設定します。モデルと価格は、プラットフォームのモデル一覧を確認してください。
まとめ
Karpathy の HackerTube が示したのは、Claude Code と Opus 5.5 を組み合わせれば、一人でも週末のうちに数千万件規模のコミュニティの議論を実用的なプロダクトにできるということです。ただし、成果を支えたのは「AI が自動でサイトを書いた」ことではなく、データパイプラインの設計でした。
- 流れ:リソースの準備 → データ取得 → ルールによる事前絞り込み → モデルによる判定 → 集計・タグ付け → デプロイ。人、プログラム、モデルの役割が明確に分かれています。
- 難所:文脈の切り出し、おすすめとして紹介されているかどうかの判断、videoId の正規化、API の利用枠。
- コスト:全件処理では数千ドル規模、事前に絞り込めば数十〜数百ドル規模まで下げられます。いずれも、自分で実行した小規模サンプルの結果を基準にしてください。
- 始め方:2つの環境変数を設定するだけで、Claude Code から APIYI 経由で opus-5-5 と sonnet-5-5 を呼び出せます。
この方法を自分のデータに応用するなら、まずは1か月分の小規模サンプルから始めるのがおすすめです。APIYI apiyi.com の無料枠で一連の流れを試してから、本格的な処理規模を決めましょう。
参考資料
- Karpathy の元投稿(2026-11-01):HackerTube の公開案内
- リンク:
x.com/karpathy/status/2116957135661945283 -
説明: データ規模、所要時間、モデル情報の一次情報
-
HackerTube サイト:完成したプロジェクト
- リンク:
hackertube.org -
説明: トピックの分類やページの構成を確認できます
-
APIYI Claude Code 接続ドキュメント:環境変数の設定
- リンク:
docs.apiyi.com/scenarios/programming/claude-code -
説明: Claude Code の接続手順
-
APIYI モデル価格一覧:モデルの単価
- リンク:
docs.apiyi.com/models -
説明: モデルと価格はこの一覧を参照してください
-
Hacker News 公式 API ドキュメント:データの取得
- リンク:
github.com/HackerNews/API - 説明: item の構造と取得方法