著者注:公開ベンチマークのスコアは、意図的な対策によって高くなっている可能性があります。この記事では、benchmaxing が起きる理由を解説し、信頼性を確かめる5つのチェック項目と、自社のタスクを使って非公開の評価問題を作る4つのステップを紹介します。
結論から言うと、ランキングのスコアは調査の出発点にはなりますが、そのままモデル選定の結論にすべきではありません。総合ランキングでは上位モデルの差がわずか数点ということも多く、その数点で首位が入れ替わる場合もあります。差が小さいだけに、評価問題への対策が順位を左右しやすくなります。このような現象を benchmaxing と呼びます。
モデル選定で本当に重要なのは、候補となるモデルが自社の業務タスクでどれだけの性能を発揮するかです。この記事では、モデルの順位付けや、どのモデルが「不正」をしているかの判断は行いません。スコアが実態以上に高くなっていないかを見極める方法、実際の業務チケットを使って小規模な非公開の評価問題を作る方法、そしてランキングでは重視する指標をカバーできないケースの3つに分けて解説します。
benchmaxing とは?ベンチマークのスコアが実力以上に高くなる3つの原因
MindStudio の2026年11月1日の記事によると、benchmaxing とは、モデルの訓練や調整において、汎用的な能力を高めるのではなく、既知のベンチマークテストで高得点を取ることを目標にする行為です。典型的な例としては、ランキングでは優秀なのに、同じ能力を試す新しい問題に直面すると、成績が大きく下がるケースが挙げられます。
| 原因 | どのように起こるか | 見分けるヒント |
|---|---|---|
| 問題が訓練データに混入 | ベンチマークの問題や、それによく似た問題が、意図的または偶然に訓練用データに混ざる | 元の問題では高得点だが、問題を書き換えるとスコアが下がる |
| 問題形式に合わせたファインチューニング | 特定のベンチマークで好まれる形式や推論パターンに特化して最適化する | 一つのランキングだけで突出し、ほかのランキングでは平凡な成績にとどまる |
| 公開問題の長期的な流通 | 問題がフォーラムやブログで議論され、最終的にウェブから収集されたデータに含まれる | 古くから公開されているベンチマークほど、スコアが上限に近づく |
benchmaxing は必ずしも悪意によるものではない
元の記事では、これらの3つのケースはいずれも、悪意がなくても起こりうると指摘しています。研究所は汎用的な推論能力を高めているつもりでも、実際にはいくつかの有名な問題形式に過学習している可能性があります。ベンチマークは公開期間が長くなるほど、能力を測るテストというより、モデルが事前に解いたことのある模擬試験に近づいていきます。
そのため、判断するときは動機ではなく、証拠に目を向けましょう。誰かが意図的に行ったのかを推測するよりも、そのスコアに見合う能力を新しい問題でも発揮できるかどうかが重要です。
なぜ benchmaxing が起きるのか:リリースの速さと比較評価の語り方
スコアは、研究開発ラボが投資家や開発者、一般の人々に進歩を示す最も簡単な手段です。全面的な独立監査を受ける必要もありません。「総合指数59点」のような数字はプレスリリースに載せやすく、競合の数字とも簡単に比較できます。数字がシンプルであるほど、それに合わせて最適化しようとするプレッシャーも大きくなります。
もう一つの要因は、リリースの速さです。MindStudio の同じ記事によると、Google Gemini シリーズのあるモデルが Artificial Analysis Index で50点を獲得し、約1か月後には同社の後継モデルが59点で首位に立ちました。このデータの出典は現時点ではこの記事のみで、本記事でも独自の検証は行っていません。原文が伝えようとしているのは、モデルの改良が週単位で進み、上位モデルの差が数点に収まるなかでは、差を広げられる手段は何であれ魅力的に映る、ということです。
ランキングを読む前に、情報の種類を確認する
スコアを引用する際は、まずそれがどの種類の情報に当たるかを確認しましょう。以下の表では、本記事で扱った事例を使って示します。
| 情報の種類 | 本記事の事例 | 信頼性の判断 |
|---|---|---|
| 公式の自己申告 / 口頭での予測 | マスク氏は、Grok 5 が Humanity’s Last Exam で「満点に近い」スコアを取る可能性があると発言。また、Grok 4 は同テストのテキスト部分で約52%だったと発言 | 予測と自己申告であり、独立したテスト結果ではない |
| 第三者による独立テスト | Artificial Analysis Index は推論、プログラミング、科学、数学などのテストを総合 | 参考指標にはなるが、引用日を明記する必要がある |
| 単一メディアの報道 | Grok 4.7 の指数スコア、Terminal-Bench の成績、Gemini の50点から59点への変化 | 出典は MindStudio のみで、独自の検証は行っていない |
| 不明 | Artificial Analysis が非公開問題に切り替えた具体的な時期と対象範囲 | 公式の説明を確認すべき事項であり、本記事では推測しない |
MindStudio によると、Grok 4.7 は独立した総合指数と Terminal-Bench のいずれでも上位モデルに後れを取っています。原文は、この「公に示された期待と独立テストの結果とのギャップ」を検討すべきシグナルとして取り上げる一方、xAI が他の企業より問題を抱えていることを意味するものではないと明記しています。本記事でも同じ位置づけで紹介するにとどめ、結論は下しません。
ランキングのスコアの信頼性を見極める5つのポイント
独立した評価機関の対策はシンプルです。問題を公開しないことです。問題が一度も公開されていなければ、誰もその問題を狙ってモデルを訓練できません。MindStudio によると、Artificial Analysis などの機関はすでに非公開の問題へ移行しています。同じ能力分野における公開問題のスコアと非公開の新問題のスコアの差は、benchmaxing を見抜くための最も率直な指標の一つと考えられています。
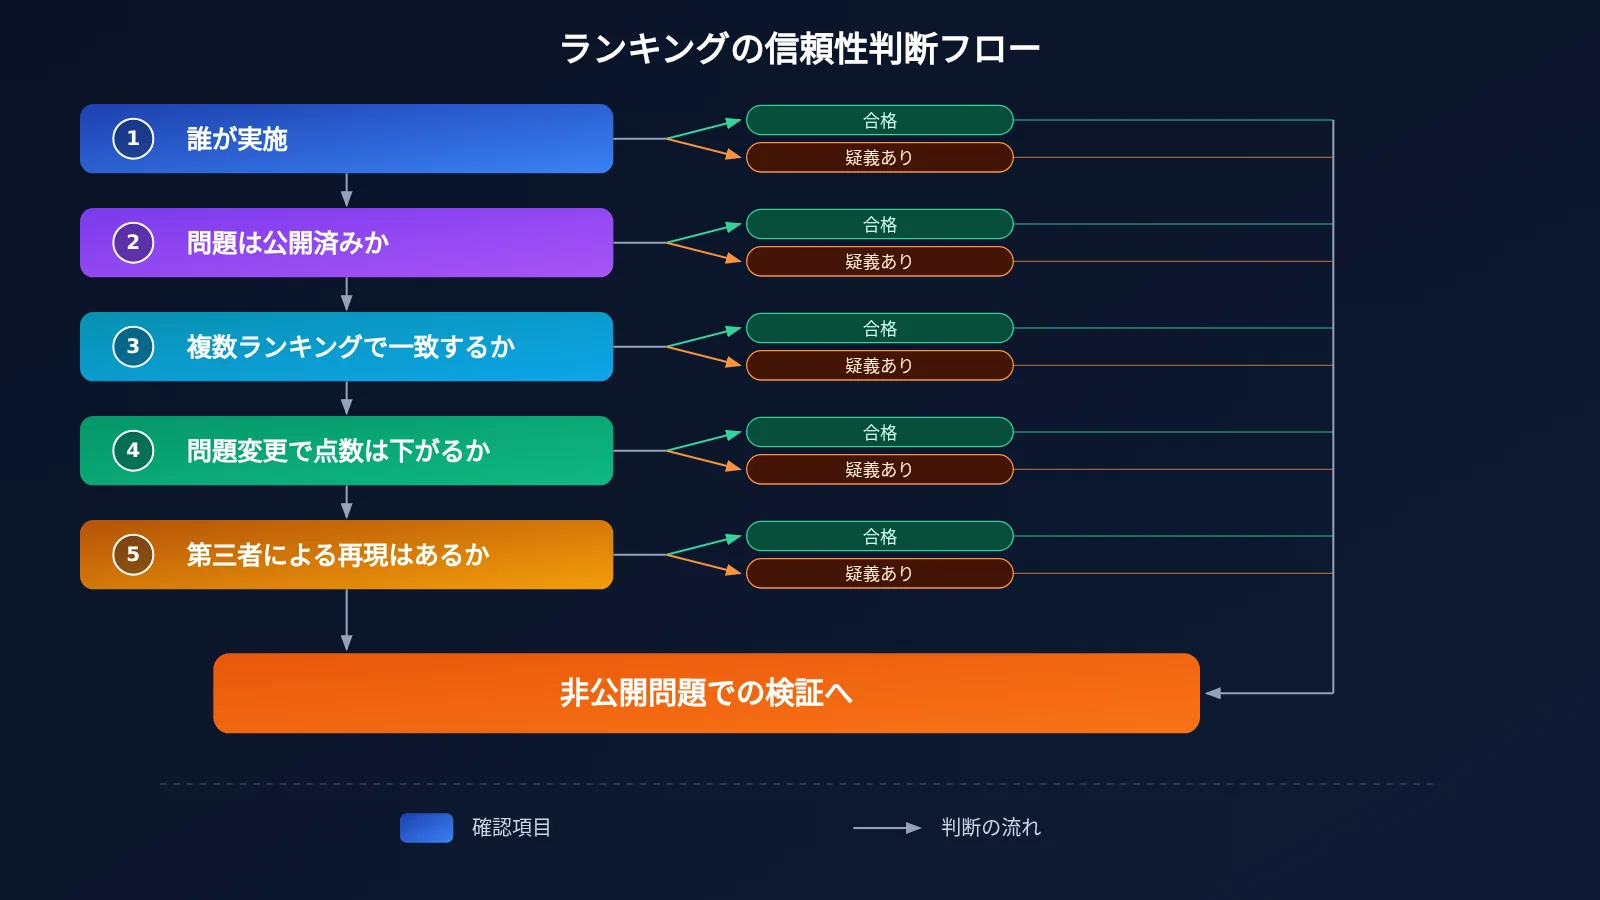
原文の提案を踏まえ、判断方法を5項目のチェックリストにまとめました。
| 番号 | チェック項目 | 調べ方 | 信頼できるサイン | 注意したいサイン |
|---|---|---|---|---|
| 1 | 誰が実施したか | 結果がメーカーの技術レポートと第三者の評価ページのどちらに掲載されているか確認する | 第三者が独立して実施 | メーカーの自己申告のみ |
| 2 | 問題は公開済みか | ベンチマークの公開日がモデルの訓練データの締め切り日より前か調べる | 非公開の問題、または訓練後に新しく公開された問題 | 何年も前から公開されている古い問題 |
| 3 | 複数のランキングで一貫しているか | 推論、プログラミング、数学など複数のベンチマークを比較する | 各ランキングの順位がおおむね一致 | 一つのランキングだけで突出 |
| 4 | 同じ能力を測る別の問題でスコアが下がらないか | 公開問題と非公開問題、元の問題と言い換えた問題を比較する | 問題を変えてもスコアの差が小さい | 問題を変えると大きく下がる |
| 5 | 第三者が再現できているか | 独立した再現レポートを探し、評価設定を確認する | 複数の機関が再現し、設定も透明 | 再現できない、または設定が非公開 |
総合指数のスコアを不正に高めるのが難しい理由
原文では、Artificial Analysis Index の価値は、複数種類のテストを一つのスコアにまとめている点にあるとしています。単一のテストに過剰適合することは可能でも、推論、プログラミング、科学、数学の複数のテストに同時に過剰適合するのは、はるかに困難です。しかも、その一部の問題は公開されていません。そのため、3項目目の「複数のランキングで一貫しているか」は、より重視するとよいでしょう。
自社のタスクで評価するプライベート問題セット:4ステップ
ランキングがどれだけ公正でも、評価に使われているのは他者の問題です。最終的なモデル選定には、自社独自のプライベート問題セットを使いましょう。どの研究機関も見たことがない問題で評価できるのが、その強みです。
| ステップ | 何をするか | 具体的な方法 | 成果物 |
|---|---|---|---|
| ① サンプリング | 実際の業務から問題を集める | 実際の問い合わせチケット、本番環境のログに残る失敗事例、ユーザーからの苦情を含む対話を収集。タスクの種類ごとに分け、各種類につき20〜50件から始める | ラベル付きの元問題セット |
| ② 合格基準の設定 | 何を「実用に十分」とするか先に決める | JSONフィールド、分類ラベル、単体テストの合否など、判定可能な出力を優先する。自由回答には採点基準を設け、一定の割合で人手による抜き取りチェックを行う | 採点スクリプト+採点基準 |
| ③ 複数モデルで実行 | 条件をそろえて横並びで比較する | 同じプロンプト、同じパラメータ、同じ採点者または採点ルールを使用。スコア、レイテンシ、トークン使用量を記録する | 比較結果表 |
| ④ 定期的な更新 | 問題セットが単なる模擬試験になるのを防ぐ | 毎月、新たな失敗事例を追加し、すべてのモデルが満点を取れる問題を除外する。パラメータ調整に使わないホールドアウトセットも一部残す | バージョン管理された問題セット |
社内テストセットの選び方と合格基準
テストケースを選ぶときは、成功例よりも失敗例のほうが参考になります。ログの中でも、ユーザーが聞き直した会話、担当者が対応を引き継いだ会話、低評価が付いた会話には、モデル間の差が表れやすいものです。合格基準はモデルを実行する前に決めておきましょう。結果を見てから基準を逆算してしまうのを防ぐためです。
「十分に使える」の定義は、数値で判断できるようにします。例えば「構造化抽出のフィールド正解率が所定の閾値に達する」「カスタマーサポートの回答を人が抜き取り検査し、事実誤認がない」といった基準です。抜き取り検査の割合はリスクに応じて決めます。高リスクの業務では検査を増やし、低リスクのタスクでは自動判定を中心にします。
複数モデルの比較で条件をそろえるには
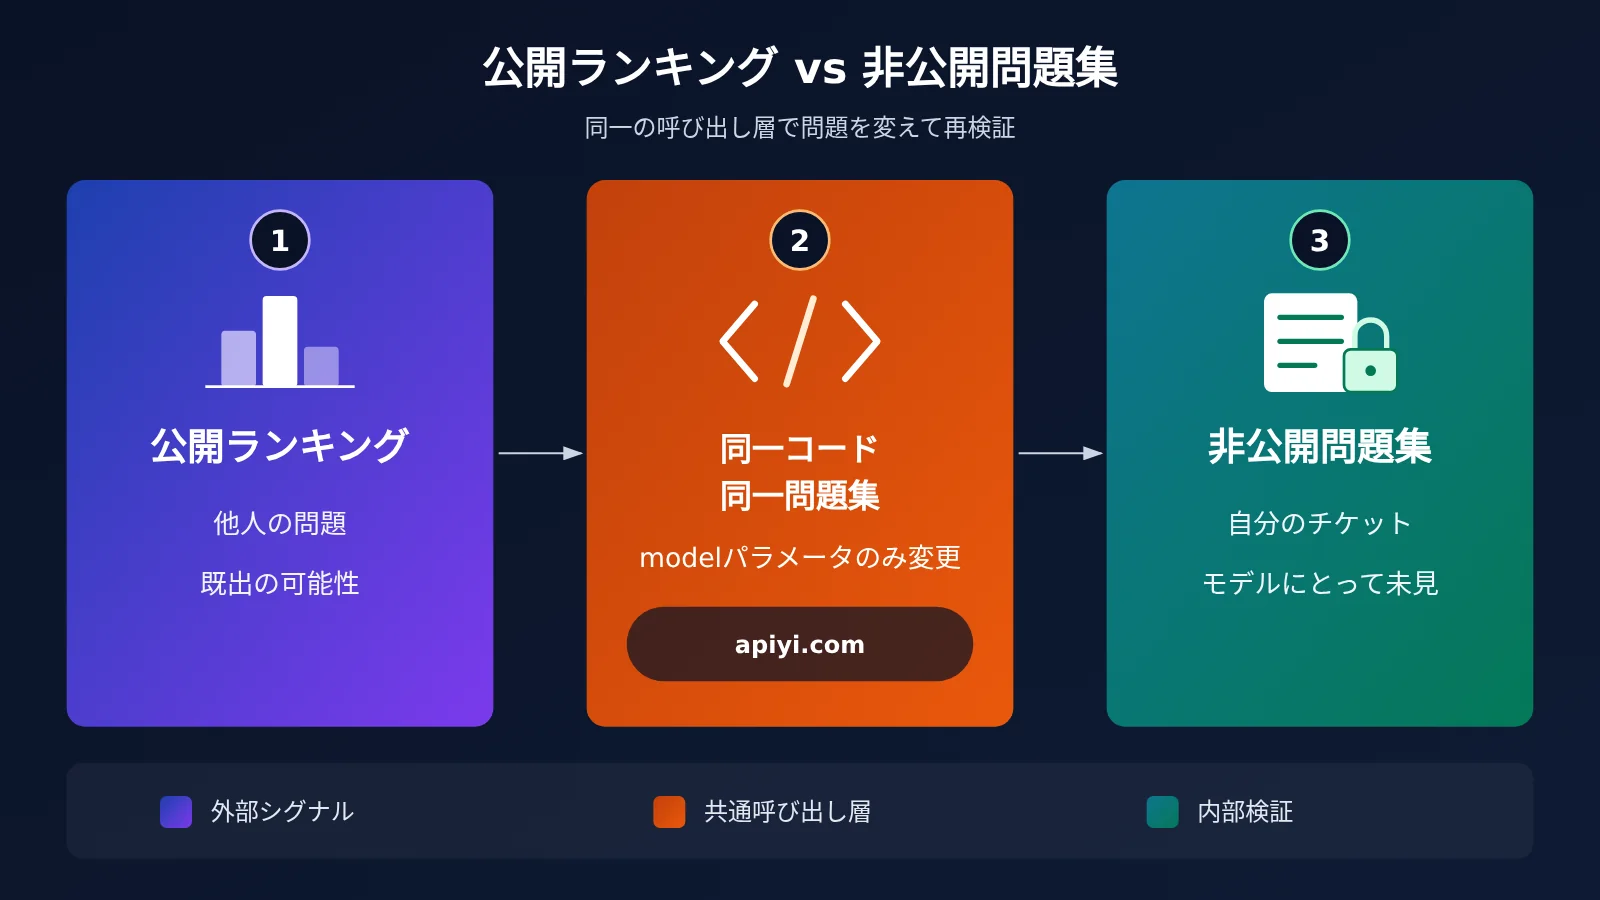
モデルを横並びで比較するときによくある問題は、条件がそろっていないことです。例えば、モデル A には入念に調整したプロンプトを使い、モデル B にはデフォルトの書き方を使うと、公平に比較できません。同じコードと同じテストセットを使い、モデル名だけを変更しましょう。
候補が複数のメーカーのモデルにまたがる場合、それぞれの SDK を管理するのは手間がかかります。APIYI は OpenAI 形式に対応しており、1つのトークンで複数メーカーのモデルを呼び出せます。切り替えるときは model パラメータを変更するだけなので、同じ評価スクリプトで同じテストセットを実行するのに便利です。設定方法は以下のとおりです。
- OpenAI 公式 Python SDK:クライアントの初期化時に
base_urlをhttps://api.apiyi.com/v1に設定し、api_keyにプラットフォームのトークンを指定 - 評価ループ内でのモデル切り替え:
modelフィールドだけを変更。モデル名は APIYI apiyi.com のモデル一覧を参照 - サンプリングパラメータの固定:すべてのモデルで
temperature=0と同じmax_tokensを設定し、ランダム性の影響を抑える - 使用量の記録:レスポンスの
usageフィールドを読み取り、テストセット全体での各モデルのトークン消費量を集計
🚀 クイックスタート:まずはランキング上位で、上記5項目のチェックを通過したモデルを3〜4個選びましょう。APIYI apiyi.com を通じて同じトークンで順番に呼び出せば、実際の問い合わせチケット50件を使った初回の比較結果を、半日ほどで得られます。
自分の評価問題セットへの過剰な調整も避ける
自分自身も、評価問題セットに対して benchmaxing をしてしまう可能性があります。あるモデルが50問で満点を取るまでプロンプトを繰り返し調整するのは、本質的にはベンダーがランキングの順位を狙って調整するのと変わりません。次のような対策が有効です。
- ホールドアウトセットを分ける:問題の約3割を取り分け、調整には開発セットだけを使い、最終判断はホールドアウトセットで行う
- プロンプトを固定する:正式な比較を始めたら、プロンプトをバージョン単位で固定し、変更した場合はすべてのモデルで再実行する
- 新しい問題を入れ替える:問題セットを更新するたびに直近の失敗事例を追加し、業務の変化に合わせる
ランキングのスコアだけを見るべきでない場面
ランキングのスコアが完全に信頼できるとしても、自分が重視する項目を測定できているとは限りません。次のような場面では、ランキングはあくまで参考情報にとどまります。
| 場面 | ランキングで測れない理由 | 追加すべき評価 |
|---|---|---|
| ニッチな専門分野のタスク | 業界用語、社内フォーマット、使用者の少ない言語は、汎用ベンチマークにはほとんど登場しない | 業務の実データで構成した独自の問題セット |
| ツール呼び出しとエージェント | 複数ステップの呼び出しの安定性や、パラメーター形式の正確さは、1往復の質疑応答では測れない | エンドツーエンドのタスク成功率、関数呼び出しの形式エラー率 |
| コストとレイテンシー | ランキングは能力だけを評価し、リクエストごとの費用や最初の文字が表示されるまでの遅延を考慮しない | 問題セットでの評価時に、トークン使用量と応答時間も記録する |
| 安定性 | 1回のスコアでは、本番環境での変動を把握できない | 同じ問題を複数回実行し、結果の一貫性を確認する |
実用的な判断基準は、能力が要件を満たしたら、費用対効果と安定性で比較することです。ランキングの1位と3位が、どちらも自分の問題セットで要件を満たすなら、レイテンシーが低く、コストを管理しやすいモデルのほうが適していることも多いでしょう。APIYI apiyi.com を通じて各モデルに統一的に接続すれば、同じ結果表で能力、所要時間、使用量を並べて比較できます。
よくある質問 FAQ
Q1:benchmaxing はモデルの不正と同じですか?
同じではありません。クローラーが意図せずテスト問題を学習データに取り込んだ可能性もあれば、チームが推論能力の向上につながると考えて問題の形式に合わせた最適化を行っている場合もあります。判断する際は、動機を決めつけず、「問題を変えてもスコアを維持できるか」に注目しましょう。
Q2:ランキングのスコアはどのような場合に信頼できますか?
問題が非公開、または学習データのカットオフ日以降に公開されたものであり、第三者が独立してテストを実施し、複数のランキングで結論が一致していて、さらに結果が再現されている場合、スコアは依然として有意義な指標です。複数種類のテストを総合した指数は、単一のベンチマークよりもスコアを意図的に引き上げるのが難しくなります。
Q3:非公開の問題セットには最低何問必要ですか?
統一された基準はありません。経験上、まずはタスクの種類ごとに20〜50件の実際のサンプルを用意すれば、明らかな差を見つけるには十分です。差がはっきりしない場合は問題数を増やし、あわせて検証用のホールドアウトセットも確保しておきましょう。
Q4:同じコードで複数社のモデルを比較するにはどうすればよいですか?
OpenAI互換インターフェースを使うのが最も手軽です。APIYI apiyi.com でトークンを取得したら、`base_url` にプラットフォームのアドレスを指定し、ループ内で `model` パラメータだけを切り替えます。これにより、同じ問題セットでモデルを横断的に比較できます。利用可能なモデルは、プラットフォームのモデル一覧をご確認ください。
Q5:Grok 5 は Humanity’s Last Exam で満点に近いスコアを獲得していますか?
本記事の執筆時点では、これはマスク氏が公表した予測であり、テスト結果ではありません。将来実際にそのスコアが出た場合も、5項目のチェックリストで確認することをおすすめします。特に、同じ能力を試す非公開の新しい問題での性能に注目し、APIYI apiyi.com で独自の問題セットを使って、自社の業務に適しているか検証しましょう。
benchmaxing と自社タスク評価の要点
- 定義:benchmaxing とは、既知の問題に合わせて最適化することで、実際の能力以上にランキングのスコアが高くなること
- 原因:問題の訓練データへの混入、問題形式に合わせたファインチューニング、公開問題の長期的な流通。いずれも悪意がなくても起こり得る
- 重要な兆候:同じ能力を問う新しい問題でスコアが下がることが、最も直接的な警告サイン
- 5つのチェック項目:誰が評価したか、問題は公開済みか、複数のランキングで結果が一致するか、問題を変えるとスコアが下がるか、第三者による再現結果があるか
- 評価セット作成の4ステップ:サンプルを選ぶ、合格基準を決める、複数のモデルで評価する、定期的に更新する。また、評価セット自体への過学習を防ぐために、ホールドアウトセットを確保する
- 統一された呼び出し方法:APIYI apiyi.com の OpenAI 互換インターフェースを使えば、
modelパラメータを変更するだけでモデルを切り替えられる
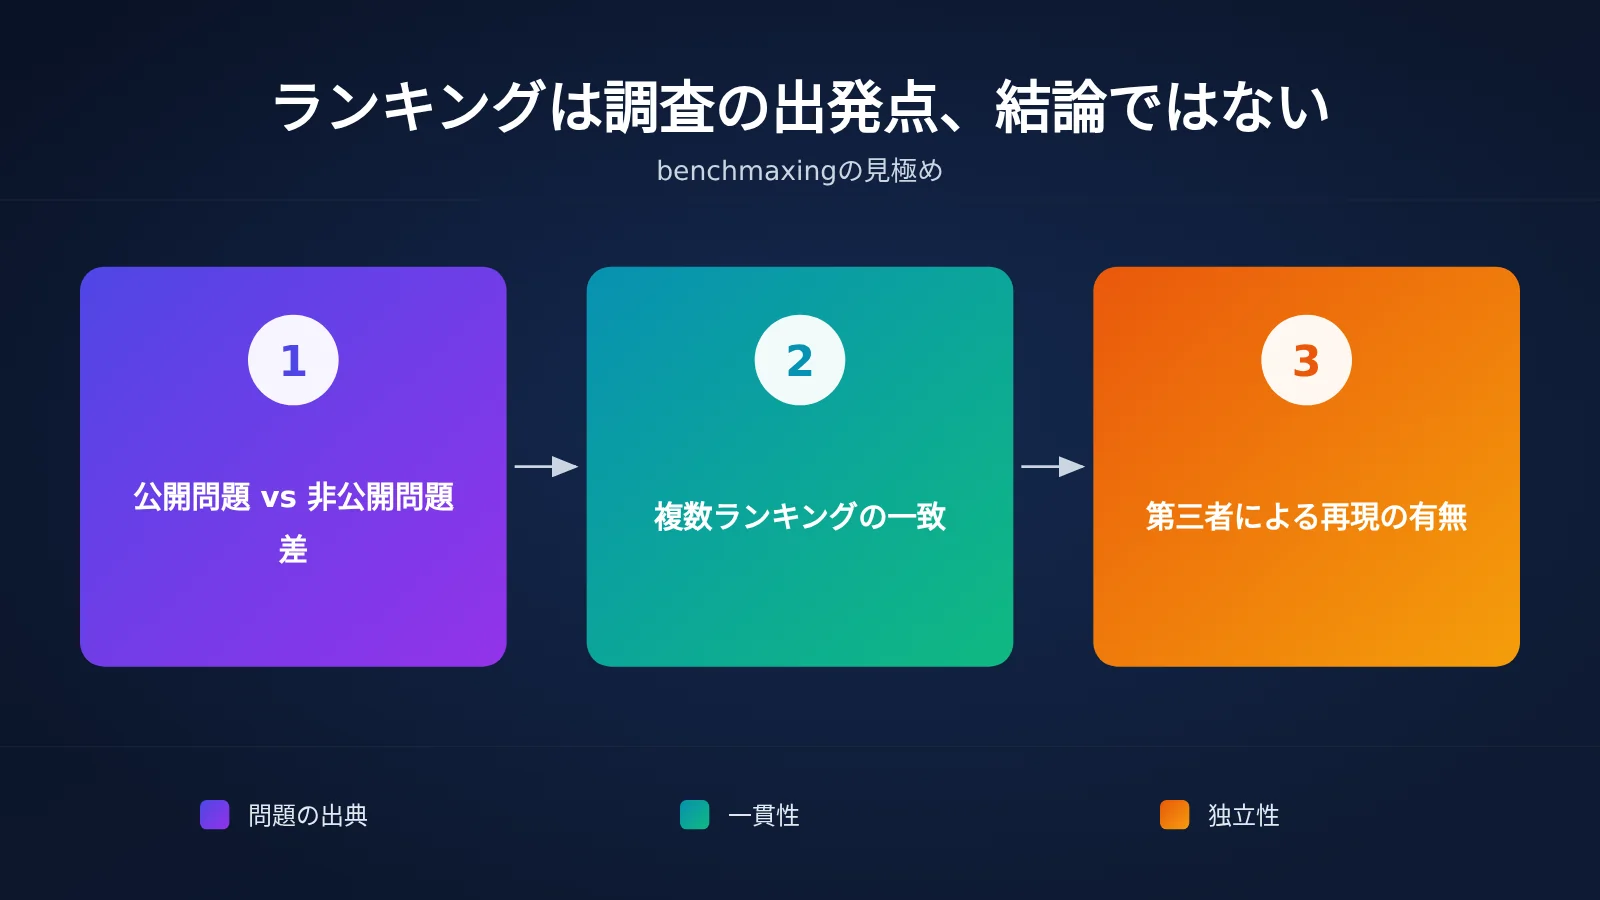
まとめ:ランキングは調査の出発点であり、結論ではない
今日からできることが3つあります。まず、注目しているランキングのスコアを5項目のチェックリストで一つずつ確認し、事実の種類と引用日を記録します。次に、直近1か月のログから失敗事例を50件選び、モデルを実行する前に合格基準を決めます。最後に、同じコードとパラメータを使って候補となる3〜4モデルを評価し、スコア、レイテンシ、使用量を記録します。
APIYI apiyi.com を使えば、1つのトークンで複数モデルを横断的に比較できます。評価セットは毎月更新するのがおすすめです。モデル選定の結論は、他人のテストではなく、自分たちの評価セットから導きましょう。
📚 参考資料
- MindStudio:What Is Benchmaxing? Why AI Labs Are Hiding Test Questions(2026-11-01)
- リンク:
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
概要:benchmaxing の定義と原因、非公開のテスト問題への移行傾向、記事中の Gemini・Grok に関するデータの唯一の出典
-
Artificial Analysis 公式サイト:独立したモデル評価と総合指数
- リンク:
artificialanalysis.ai - 概要:非公開のテスト問題への移行時期と対象範囲については、公式の説明をご確認ください
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI の apiyi.com トップページからお気軽にお問い合わせください。API の利用方法に関する資料は、docs.apiyi.com のドキュメントセンターをご覧ください。