著者注:1件の Responses usage から出発し、GPT-6.2 Sol の通常入力、キャッシュ読取/書込、推論出力を項目ごとに再計算し、さらにキャッシュ寿命とリクエスト状態が同じワークフローの請求額をどう変えるかを説明します。
GPT-6.2 Sol の請求額は固定の方法で再計算できます。リクエスト記録の usage は、入力を 通常入力、キャッシュ読取、30分キャッシュ書込、12時間キャッシュ書込 の4種類に分けます。この4種類は相互排他です。出力は別カテゴリで、推論トークンはすでにそこに含まれています。各カテゴリのトークン数に対応する料率を掛けて合計したものが、このリクエストのモデル料金です。ツール料金は別途計算します。
3つの条件が結果を変えます。1つ目は、1リクエストの入力総量が272Kを超えるかどうかです。超えるとリクエスト全体が長コンテキスト料率に切り替わります。2つ目はキャッシュ寿命と実際のヒット回数です。同じプレフィックスを30分キャッシュとして書き込むか12時間キャッシュとして書き込むかで、損益分岐点が異なります。3つ目はリクエスト状態で、incomplete、リトライ、バックグラウンドタスクはワークフロー全体の請求額に影響します。
OpenAIは2026年11月17日にGPT-6.2 Solを発表しました。APIモデルIDはgpt-6.2-solで、ResponsesとChat Completionsから呼び出せます。関数呼び出しと組み込みツールはResponses経路を使用します。本記事ではOpenAI公式直結の米ドル定価を基準にし、併せてAPIYI apiyi.comの公開価格APIにおけるこのモデルの表示価格基準を説明します。本記事の計算例はすべて合成使用量に基づくもので、実測請求額ではありません。
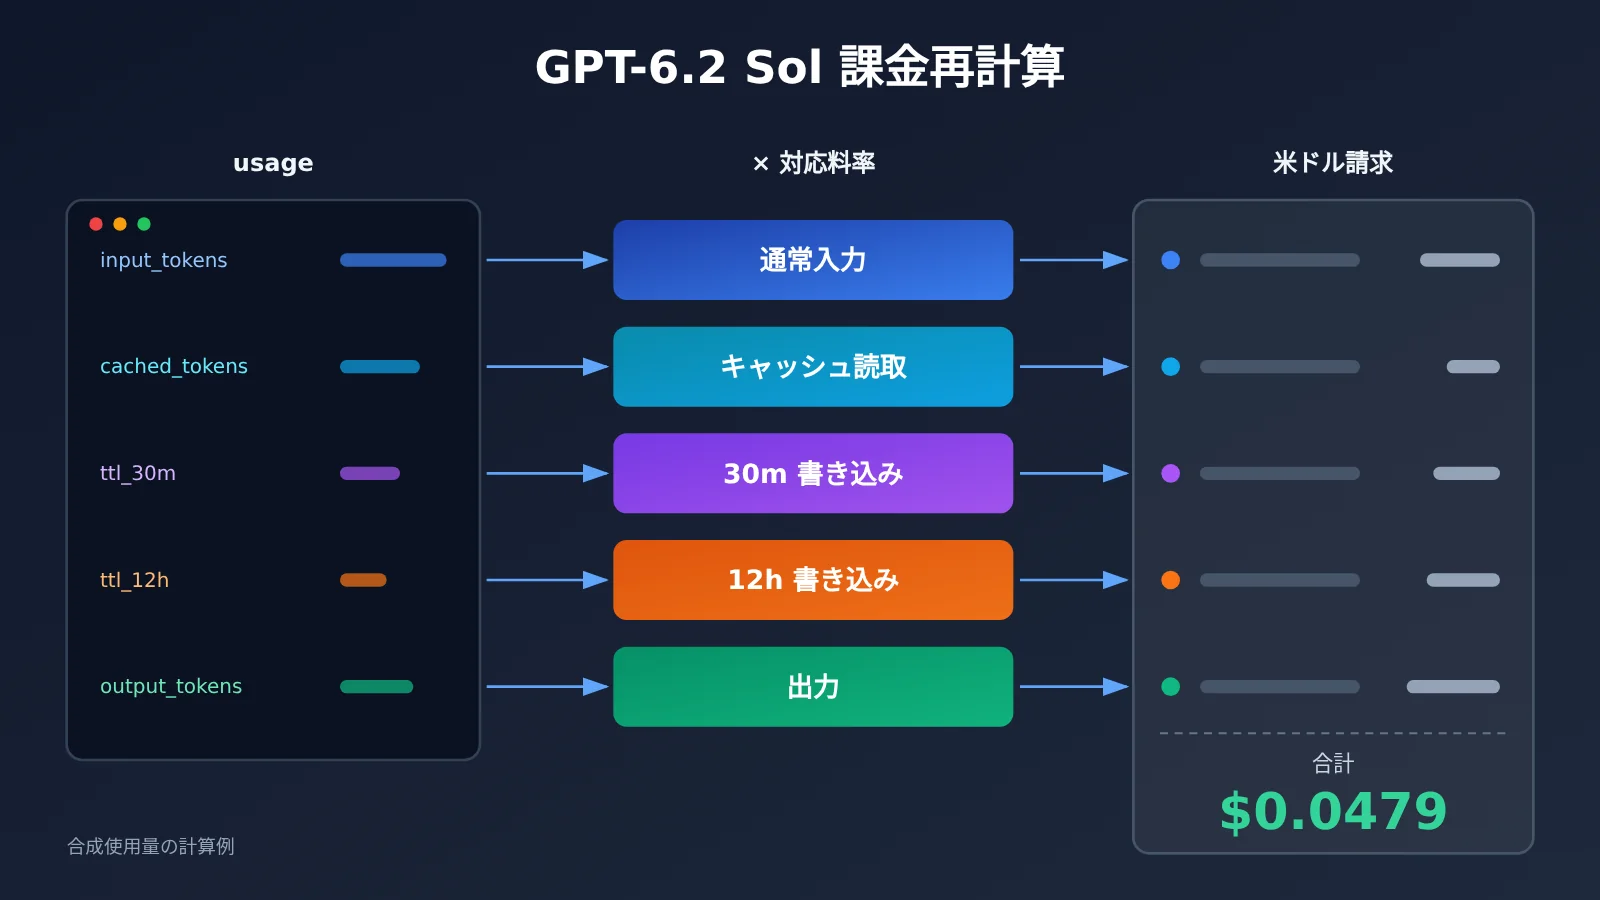
GPT-6.2 Sol の課金知識マップと読む順序
全文は「フィールド → 金額 → キャッシュ判断 → ワークフロー照合」の順で展開します。各ステップの出力が次のステップの入力になります。まず usage にどの項目があるかを把握し、それをドルに換算します。次にこの計算方法でキャッシュ案を比較し、最後に1回のリクエストをワークフローのコストへ集約します。
Responses usage
 ├─ 入力総量 input_tokens
 │   ├─ キャッシュ読み取り cached_tokens ──────────┐
 │   ├─ 30m 書き込み ttl_30m_tokens ───────────────┤
 │   ├─ 12h 書き込み ttl_12h_tokens ───────────────┼─→ ×対応料率 → 1回のリクエストのモデル料金(第2節)
 │   └─ 通常入力 = 総量 − 読み取り − 全書き込み ────┤
 └─ 出力 output_tokens(reasoning_tokens を含む)───┘
                                          ↓
         キャッシュ寿命の選択(第3節) ← 同一プレフィックスで複数回リクエストした場合の総額比較
                                          ↓
         ワークフロー照合(第4節) ← ツール料金 + リトライ + incomplete + コストのエクスポート
| 番号 | 答える問い | 前の節への依存 | 読後にできること |
|---|---|---|---|
| 1 | usage のどの数値が課金対象か | — | 1件のレスポンスから5項目の課金対象使用量を分解する |
| 2 | その使用量がいくらになるか | 第1節の5項目の使用量 | ログの数値をドルに換算し、短期・長期の区分を判断する |
| 3 | キャッシュを30分書き込むか12時間書き込むか | 第2節の単価計算 | 呼び出し間隔とヒット回数に応じてキャッシュ寿命を選ぶ |
| 4 | 1つのタスクで結局いくらかかったか | 第2・3節の1リクエストあたりの計算 | 最小限のログテーブルを作り、請求書の差額を追跡する |
1件の料金差を説明したいだけなら、第1・2節まで読めば十分です。キャッシュ戦略やコスト台帳を担当する方は、4節すべてを順番に読むことをおすすめします。
GPT-6.2 Sol の課金用語まとめ
| 用語 | 説明 |
|---|---|
| usage | API レスポンスで、現在のリクエストのトークン使用量を集計するフィールド |
| 通常入力 | 総入力から、課金対象のキャッシュ読み取りとすべてのキャッシュ書き込みを差し引いた残量 |
| キャッシュ読み取り | 現在のリクエストで再利用価格により課金される入力部分 |
| キャッシュチェックポイント | 入力プレフィックスのキャッシュ保存または再利用を許可する境界 |
| TTL | キャッシュの最低課金対象期間の設定。Sol は30分と12時間の2種類の書き込みに対応 |
| 推論トークン | モデルが思考フェーズで生成し、課金対象の出力総量に含まれるトークン |
| レスポンス ID | 照合ログ、バックグラウンドポーリング、対応するモデルレスポンスを紐付ける識別子 |
| ツール料金 | 特定のホスト型ツールを使用することで発生する独立した費用 |
1 Responses の usage から GPT-6.2 Sol の5つの課金用量を確認する
1.1 4種類の入力と1種類の出力
Responses の usage オブジェクトは、1回のリクエストにおける入力と出力を分けて記録します。入力側には総量といくつかの内訳、出力側には総量と推論サブ項目が記録されます。再計算時に確認するフィールドは次のとおりです。
| 課金カテゴリ | 読み取るフィールド | 説明 |
|---|---|---|
| 入力総量 | usage.input_tokens |
4種類の入力の合計。それ自体には直接料率を掛けない |
| キャッシュ読み取り | input_tokens_details.cached_tokens |
請求上の読み取り量 |
| キャッシュ書き込み合計 | cache_write_tokens |
2種類の寿命の書き込み合計 |
| 30分書き込み | cache_write_tokens_details.ttl_30m_tokens |
寿命内訳が返される場合に使用 |
| 12時間書き込み | cache_write_tokens_details.ttl_12h_tokens |
寿命内訳が返される場合に使用 |
| 出力 | usage.output_tokens |
推論トークンを含む |
| 推論サブ項目 | output_tokens_details.reasoning_tokens |
出力の構成を把握するためのもので、追加の料金は発生しない |
1.2 通常入力の計算式
通常入力は usage に専用フィールドがないため、減算で求めます:
通常入力 = input_tokens − cached_tokens − cache_write_tokens
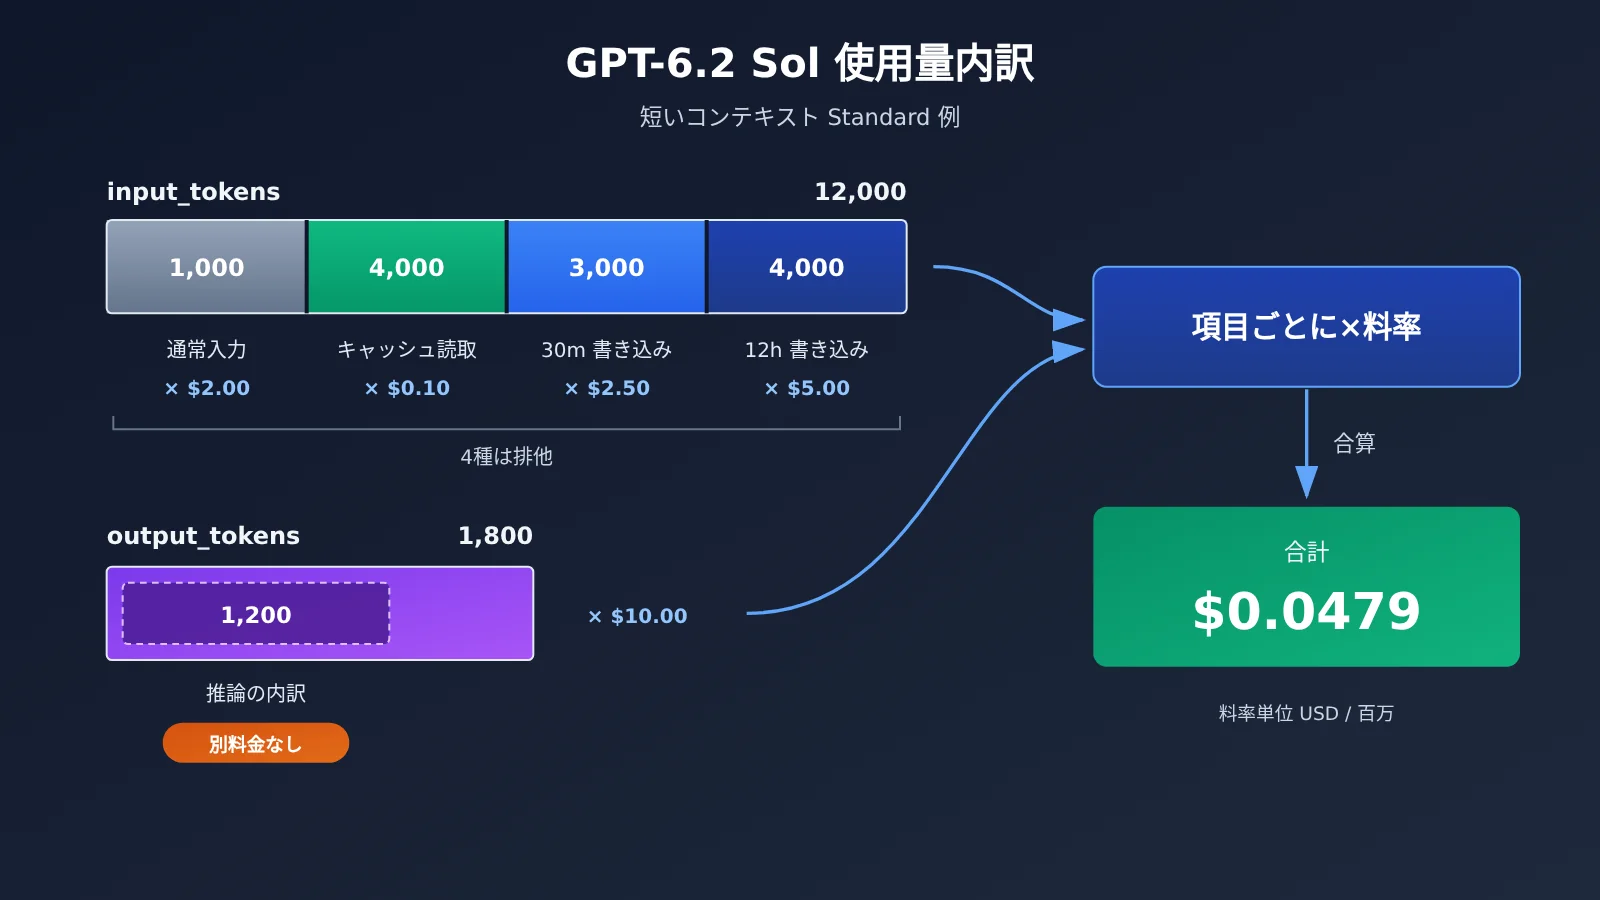
ここで差し引くのはすべての書き込み、つまり30分と12時間の2種類の合計です。2種類の書き込み、読み取り、通常入力の4つは相互排他的で、同じトークンはそのうち1つにしか属しません。キャッシュに書き込まれたトークンは書き込み料率で課金され、通常入力の料金が重ねて適用されることはありません。ここが最も間違えやすいポイントです。書き込み量を通常入力に残したまま書き込み料金を別途計上すると、合計が高くなってしまいます。
出力側の推論トークンも二重計上しやすい項目です。reasoning_tokens は output_tokens のサブセットなので、再計算時は output_tokens に出力料率を掛けるだけで済みます。推論サブ項目は「なぜ今回の出力がこれだけ多いのか」を分析するのには適していますが、追加の課金項目として扱うべきではありません。
1.3 再計算には課金フィールドを使い、診断フィールドは調査専用にする
Prompt Caching の診断情報には「再利用可能量」「未ヒット推定量」などの数値も表示されます。これらはキャッシュがなぜヒットしなかったか、たとえばプレフィックスが変わった、長さが足りないなどを説明するものであり、実際の請求額を表すものではありません。請求額を再計算する際は、usage 内の実際の課金フィールドのみを使用します。
一部のチャネルが寿命内訳を返さない場合、または cache_write_tokens が欠けている場合、欠落フィールドから請求額を推定してはいけません。その場合はそのチャネル自身の請求記録を基準にしてください。次の節の計算例では合成 usage を使用し、すべてのフィールドが揃っているため、完全な計算手順を示しやすい構成になっています。
2 GPT-6.2 Sol のログ数値を米ドルに換算する
2.1 公式 Standard 料金表
下表は OpenAI 公式の直結ベースの料金で、単位は USD / 100万トークンです。長短の区分はリクエストごとの入力総量で判定され、272K を超えるとそのリクエスト全体が長コンテキスト料金に切り替わります。入力および各種キャッシュ料金は ×2、出力は ×1.5 となります。
| Standard 課金カテゴリ | 短コンテキスト(≤272K) | 長コンテキスト(>272K) |
|---|---|---|
| 通常入力 | $2.00 | $4.00 |
| キャッシュ読み取り | $0.10 | $0.20 |
| 30分キャッシュ書き込み | $2.50 | $5.00 |
| 12時間キャッシュ書き込み | $5.00 | $10.00 |
| 出力(推論トークン含む) | $10.00 | $15.00 |
短コンテキストの基本料金は GPT-6.1 Sol と同じです。また、モデルカードに記載されているコンテキストウィンドウは 1,050,000 トークン、最大入力 922,000 トークン、最大出力 128,000 トークンです。「最大でどれだけ入力できるか」と「どこから長コンテキスト区分で課金されるか」は別々の数値であり、300K 入力のリクエストもまったく合法ですが、全体が長コンテキスト区分で課金されます。
2.2 合成 usage の完全な再計算
短いコンテキストの Standard リクエストが、ツールも追加料金もなしで、次のような使用量を返したとします。入力合計 12,000、キャッシュ読み取り 4,000、30分書き込み 3,000、12時間書き込み 4,000、出力 1,800(うち推論 1,200)です。
まず通常入力を求めます:12,000 − 4,000 − 3,000 − 4,000 = 1,000。次に、項目ごとにレートを掛けます。
| 課金項目 | token 数 | レート(USD/百万) | 金額(USD) |
|---|---|---|---|
| 通常入力 | 1,000 | 2.00 | 0.0020 |
| キャッシュ読み取り | 4,000 | 0.10 | 0.0004 |
| 30分書き込み | 3,000 | 2.50 | 0.0075 |
| 12時間書き込み | 4,000 | 5.00 | 0.0200 |
| 出力(推論 1,200 を含む) | 1,800 | 10.00 | 0.0180 |
| 合計 | — | — | 0.0479 |
この計算では、12時間書き込みはわずか 4,000 token しか占めていないのに、金額の四割以上を占めています。なぜなら、その単価は通常入力の 2.5 倍であり、書き込み時点ではコストだけが発生し、リターンは後続のキャッシュヒットを待って初めて実現するからです。この点は第 3 節で詳しく論じます。
コスト台帳では、総額だけを保存するのではなく、課金項目ごとに token 数とレートを記録することをおすすめします。そうすれば、料金の差が出たときに、ログの実際の値を上の表にそのまま当てはめて、行ごとに差額の発生源を特定できます。
2.3 長コンテキストではまず料率を切り替え、同じ計算式を適用する
入力の総量が 272K を超える場合、計算のアルゴリズムは変わりません。上の表の料率を丸ごと長コンテキスト用の値に置き換えるだけです。切り替えはリクエスト全体に適用されるため、キャッシュの読み取りと書き込みも同時に倍増し、出力は 1.5 倍で計算されます。そのため、長短どちらの区分に該当するかを、項目ごとの掛け算を行う前に必ず判定しておく必要があります。
サードパーティ経由で呼び出す場合は、料率をそのチャネルの基準に合わせて置き換えます。APIYI apiyi.com を例に、2026-11-20 に同社の公開価格 API を読み返したところ、gpt-6.2-sol の billing_expr も同様に 272,000 入力トークンで区分を切り替えていました。短コンテキスト区分では通常入力 $2、キャッシュ読み取り $0.10、キャッシュ書き込み $2.50、出力 $10。長コンテキスト区分ではそれぞれ $3、$0.15、$3.75、$11.25(USD / 100万トークン)です。長コンテキスト区分の倍率は公式直結とは異なり、API の式ではキャッシュ書き込み価格が 1 区分しか示されていないことも確認できます。実際のプロジェクトにおけるグループ、機能、請求内容は、プラットフォームの現在の設定と請求書を基準にしてください。
以下のコードは、APIYI の OpenAI 互換インターフェースを通じて Responses リクエストを 1 回送信し、usage をそのまま出力して、後続の再計算に使えるようにするものです。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "固定规则与公共资料(放在前部便于缓存复用)"},
        {"role": "user", "content": "本次请求的具体问题"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
usage を取得したら、5 項目の使用量を金額に換算する関数を使います。料率表はパラメータ化しておき、公式基準とチャネル基準を切り替えるときに設定だけを変更すればよいようにします。
完全な再計算関数を表示
LONG_THRESHOLD = 272_000

# OpenAI 公式 Standard 基準、USD / 100万トークン
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # 書き込みフィールドの位置は実際の返却構造に依存するため、ここでは両方を確認する
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("缺少 cache_write_tokens,改用渠道出账记录,不要推定")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("缺少写入寿命明细,无法区分 30m/12h 费率")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# 第2.2節の合成 usage で検証する
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
この関数は、フィールドが欠けている場合に 0 として処理するのではなく、直ちにエラーを返すようにしています。これは、書き込みの明細が欠けたリクエストを「すべて通常入力」として誤って計算してしまうのを防ぐためです。
🎯 技術アドバイス:コスト台帳を作る際は、まず合成 usage で再計算関数を動作確認し、そのうえで実際のログに接続することをおすすめします。APIYI apiyi.com を使えば、同じ APIキーで小規模なテストリクエストを送信でき、返却された usage をプラットフォームの請求額と1件ずつ突き合わせて、フィールドの扱いを確定してから統計を本番運用に移せます。
3 呼び出しペースに合わせて GPT-6.2 Sol のキャッシュ寿命を選ぶ
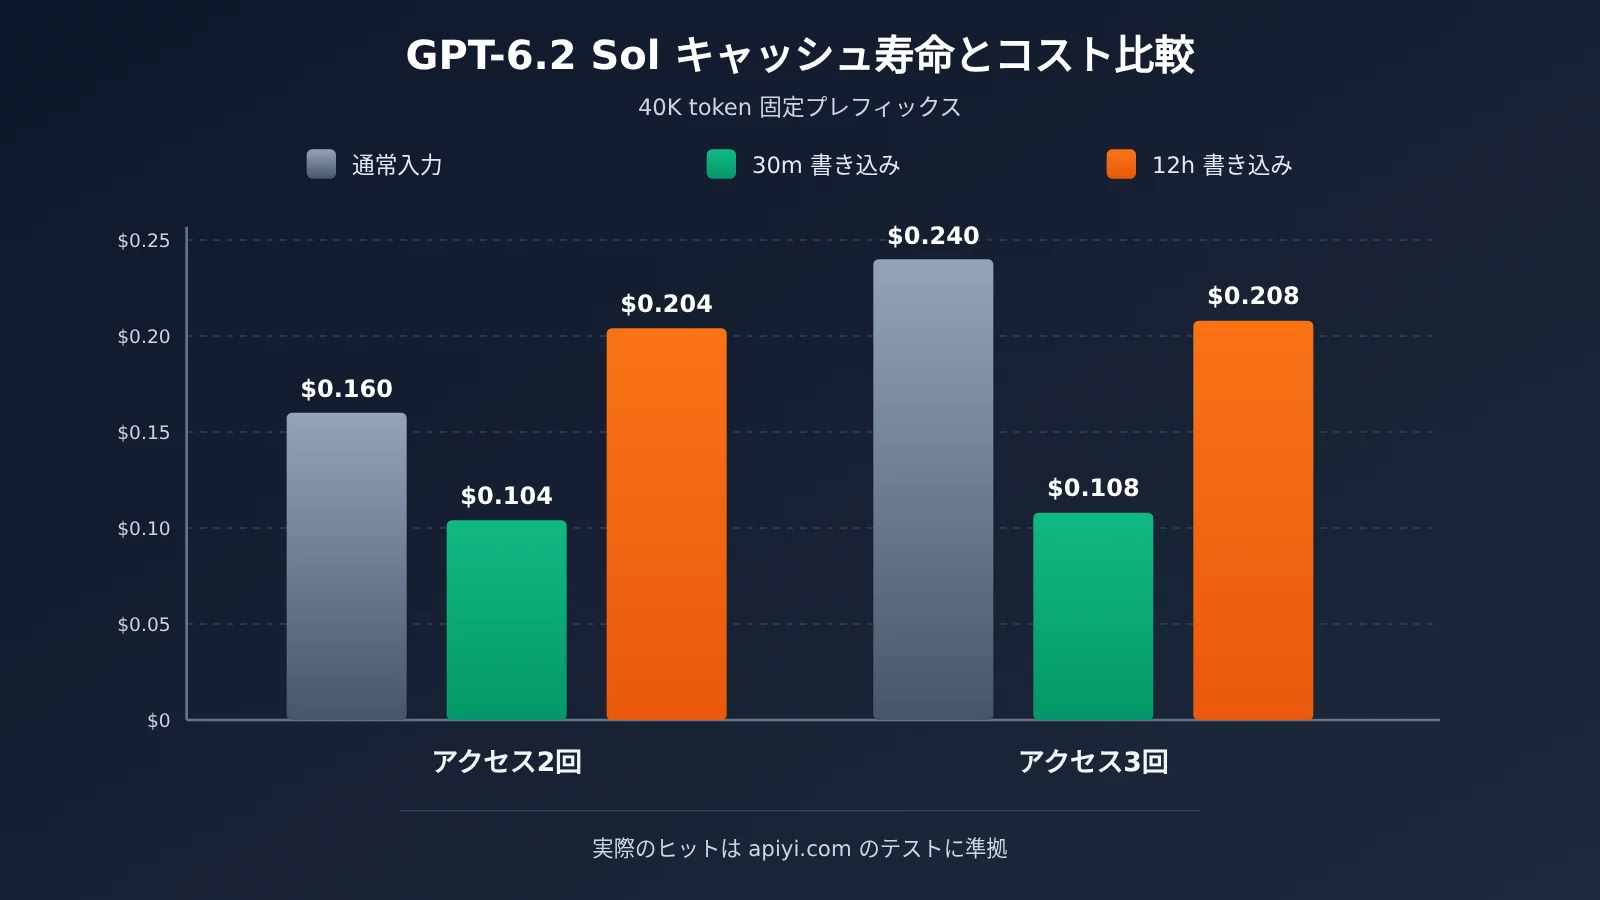
3.1 同一プレフィックスへの2回・3回アクセスのコスト計算
40,000 token の固定プレフィックス(システムルールと共通資料)があると仮定し、短いコンテキストの Standard 料金で試算します。1回あたりの各種コストは次のとおりです。通常入力では $0.08、初回の30分書き込みでは $0.10、初回の12時間書き込みでは $0.20、完全ヒット時の読み取りでは $0.004 です。以下の表は固定プレフィックス部分のみを比較したもので、各リクエストの変動内容と出力は含みません。
| アクセスパターン | 通常入力 | 30m 書き込みプラン | 12h 書き込みプラン |
|---|---|---|---|
| 合計2回(1回書き込み+1回読み取り) | $0.160 | $0.104 | $0.204 |
| 合計3回(1回書き込み+2回読み取り、いずれもウィンドウ内) | $0.240 | $0.108 | $0.208 |
2回アクセスの場合、12時間書き込みはキャッシュを使わない場合より $0.044 高くつきます。3回アクセスの場合、どちらのキャッシュも通常入力より安くなりますが、30分プランは依然として12時間プランの約半分です。ただし、これらのアクセスがすべて30分ウィンドウ内に収まることが前提です。
3.2 損益分岐点:何回ヒットすれば元が取れるか
上の数字を別の角度から見ると、より直感的に理解できます(以下は M3 の料金レートに基づく試算です)。完全ヒット1回あたり、通常入力より $0.076 節約できます。30分書き込みは通常入力より $0.02 多く支払いますが、1回ヒットすれば元が取れます。12時間書き込みは $0.12 多く支払うため、ウィンドウ内で少なくとも2回ヒットする必要があります。
つまり、12時間書き込みの価値は「同じウィンドウ内でより多くヒットする」ことではなく、呼び出し間隔が30分を超えてもヒットできる点にあります。同じプレフィックスを使うリクエストの間隔が通常数分以内であれば、30分書き込みで十分で、12時間を選ぶと書き込み料金を余計に支払うだけになります。リクエストが1〜2時間おきに来る場合、30分キャッシュはすでに期限切れで毎回書き込みし直す必要があり、そうしたケースでは12時間書き込みと複数回のヒットが組み合わさって初めてコスト削減が見込めます。
判断を変えるポイントが2つあります。TTL は最短の課金カバー時間であり、キャッシュが必ずその期間存続することを意味しません。最終的には usage の実際の読み取り量を見る必要があります。30分書き込みには読み取り時の更新ルールがあり、高頻度なシナリオでは実際のカバー時間が名目の30分より長くなる可能性があります。そのため、選定後は設定値だけを見るのではなく、実際のヒット記録で振り返ることが大切です。
3.3 ブレークポイントの配置:安定した内容を前に並べる
キャッシュはプレフィックスにのみ有効で、最小キャッシュ可能プレフィックスは 1,024 個の可視入力トークンです。実践では、再利用サイクルに応じて階層的にブレークポイントを設定できます。
- 長周期の共通資料(製品マニュアル、コードベースの要約など):先頭に置き、12時間書き込みを検討。
- 短周期の会話記録(今回の対話履歴など):その後に置き、30分書き込みを検討。
- 毎回変わる即時指示:最後に置き、キャッシュには含めない。
GPT-6.2 には見落としやすい位置の詳細があります。トップレベルの instructions はキャッシュ可能なブレークポイントの後ろに位置します。固定ルールを instructions に書くと、その部分は再利用できません。固定ルールはむしろ input の前段の developer メッセージに入れるのが適切で、instructions はリクエストごとに調整し得る内容のために残しておきましょう。
💡 選択のヒント:キャッシュ寿命は実際のトラフィックに合わせて決めましょう。まず APIYI apiyi.com で同じプレフィックスを使い、実際のペースで数ラウンドのリクエストを送り、
cached_tokensのヒット状況を集計したうえで、どの層に30分、どの層に12時間を使うかを決めるのがおすすめです。チャネルによってキャッシュ書き込みの課金が異なる場合があります。プラットフォームの請求書を基準にしてください。
4 ワークフロー単位で GPT-6.2 Sol のコストを集計し、差額を追跡する
4.1 請求額が想定と合わなくなる3つのリクエスト状態
単発のリクエスト計算が正しくても、ワークフロー全体の合計は合わないことがあります。よくある原因はリクエストの状態にあります。
- incomplete:出力が
max_output_tokensに達すると、レスポンスはincompleteで終了することがあります。この時点ではまだ可視テキストがまったくない場合もありますが、入力トークンと推論トークンはすでに生成され、課金されています。「内容が正常に返ったリクエスト」だけを集計すると、この部分のコストが漏れてしまいます。 - バックグラウンドタスク:レスポンス ID を持つバックグラウンドタスクは、ポーリング時も同じ ID で追跡し、ポーリングのたびに新規リクエストとして重複計上しないようにします。
- リトライ:タイムアウトや
incompleteによって新たに発行される独立した呼び出しは、新しいレスポンスを生成するため、別途記録する必要があります。リトライが増えるほど、同じタスクの入力コストを何度も支払うことになります。
4.2 ツール費用と、ツールが生む後続トークン
Responses はファイル検索、ウェブ検索、コードインタプリタ、画像生成などのツールをサポートしています。画像生成を使う場合、Sol はフローの中でツール呼び出しを行い、画像自体は別の画像ツールが生成し、料金もツールのルールに従って計算されます。ツール費用は実際の種類ごとに確認してください。たとえばウェブ検索は $10/1000回で、検索によって返された内容のトークンは別途モデルのレートで計算されます。
再計算の際は、usage がどのトークンをカバーしているかを確認します。ツールの結果が次のラウンドのモデルリクエストに戻されると、後続リクエストの入力量の増加として現れます。このコストはツール呼び出し自体ではなく、後続リクエスト側に乗ります。検索を伴うワークフローの請求額は通常、「ツール呼び出し回数の費用 + 複数ラウンドのモデルリクエスト費用」の2つで構成されます。
4.3 最小限のログ項目
ワークフローを照合可能にするには、モデルのレスポンスごとに少なくとも次のフィールドを記録します。
| ログ項目 | 役割 |
|---|---|
| ワークフロー ID | 複数のリクエストを同じタスクにまとめる |
| レスポンス ID | バックグラウンドのポーリングを関連付け、リトライと同一リクエストを区別する |
| モデル | 料率表を確定する。例:gpt-6.2-sol |
| サービス階層 | Standard の基準かどうかを確認する |
| 最終ステータス | completed、incomplete などを識別する |
| 用量の内訳 | 通常入力、読み取り、30m 書き込み、12h 書き込み、出力、推論 |
| ツール | ツールの種類と呼び出し回数 |
| 費用 | 内訳ごとに再計算した金額と、長短区分のフラグ |
この表があれば、ワークフロー ID でグループ化して合計するだけで、1タスクあたりのコストが求められます。差額の調査にも順序がつきます。まず incomplete やリトライがないかを見、次にキャッシュの読み取りが想定より少なくないかを確認し、最後にツールの回数を突き合わせます。
4.4 リクエスト単位の見積もりと公式エクスポートの相互検証
リクエスト単位の見積もりはリアルタイムの予算管理に向いていますが、多段のツール呼び出し、リトライ、用量フィールドの欠落などがあると誤差が生じやすくなります。定期的に、見積もりの集計と公式の用量・費用エクスポートを照合し、差額が設定したしきい値を超えたらログに戻って1行ずつ確認することをおすすめします。第三者チャネル経由で中継する場合、照合対象はそのチャネルの請求フィールドと料率に置き換えます。
💰 コストのヒント:チームで複数のモデルを併用している場合は、APIYI(apiyi.com)を使えば1つの API キーから統一的に呼び出せます。そのうえで本記事の最小ログ項目に沿ってデータベースへ保存するとよいでしょう。入口を統一することで、ワークフロー ID と費用の基準を揃えられ、月末の照合時にチャネル間の換算が1段減ります。
GPT-6.2 Sol 請求の検証方法
任意の Sol リクエスト記録を取得したら、次の順序で請求を検証できます。まず入力総量が 272K を超えているかを確認し、適用する料率の列を選びます。次に input_tokens から読み取り分とすべての書き込み分を差し引いて通常入力を求めます。そして5項目それぞれに料率を掛けて合計し、請求と比較します。単一リクエストは一致するのにワークフロー総額が一致しない場合は、ログで incomplete、リトライ、ツール呼び出しを探してください。
キャッシュが割に合うかどうかは、最終的には usage 内の実際の読み取り量と呼び出し間隔で決まります。30 分の書き込みは1回ヒットすれば元が取れ、12 時間の書き込みはウィンドウ内で少なくとも2回ヒットする必要があり、しかも呼び出し間隔が 30 分を超える場合にのみ優位性が現れます。
実際のトラフィックでこれらの結論を検証したい場合は、APIYI apiyi.com で無料のテスト枠を申請し、本記事の再計算関数を使ってプラットフォームの請求と1件ずつ突き合わせてください。
📚 参考資料
-
OpenAI GPT-6.2 Astra と Sol の発表:発表時期と製品の位置づけ
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol - 説明: Sol が日常業務やマルチステップ Agent 向けに位置づけられていることを理解するため
- リンク:
-
GPT-6.2 Sol モデルカード:コンテキスト仕様、料率、長コンテキスト倍率
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-sol - 説明: 本記事の料率表と 272K 切り替えルールの出典
- リンク:
-
Prompt Caching ガイドとキャッシュ診断:キャッシュフィールド、TTL、ブレークポイントのルール
- リンク:
developers.openai.com/api/docs/guides/prompt-caching - 説明: cached_tokens、書き込み寿命、最小キャッシュ可能プレフィックスを解説
- リンク:
-
Reasoning ガイド:推論トークンと incomplete 状態
- リンク:
developers.openai.com/api/docs/guides/reasoning - 説明: 推論使用量がどのように出力に計上されるかを理解するため
- リンク:
-
単一ワークフローのコスト制御ガイド:ワークフローごとに Responses のコストを集計
- リンク:
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - 説明: ワークフローレベルの予算管理の参考実装
- リンク:
-
APIYI モデル一覧:チャネル掲載とエントリ情報
- リンク:
docs.apiyi.com/models.md - 説明: gpt-6.2-sol の利用可能なエントリとグループを確認
- リンク:
著者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページでお気軽にお問い合わせください。より詳しい接続資料は docs.apiyi.com ドキュメントセンターをご覧ください