著者注:Gemini 4 Neon の「速さ」には、少なくとも3つの測り方があります。本記事では、最初の文字が出るまでの時間、毎秒あたりの出力、1問を解き終えるまでの時間を分けて整理し、各数値の出典を明記します。
Gemini 4 Neon は 2026-11-18 にリリースされました。Sundar Pichai の発表投稿では、複雑なソフトウェアエンジニアリング、知識労働、科学的ワークフローにおいて より速くタスクを完了できる と述べられており、多くの人がこの一文を「あらゆる面で最速」と受け取っています。実際には、速度測定には少なくとも3つの基準があり、それぞれが示す順位は一致しません。
本記事のすべての速度数値は Artificial Analysis のモデルページと Artificial Analysis の記事に由来し、ベンチマークスコアは公式の自己申告とモデルカードに由来します。いずれも私たち自身が実行したものではありません。 出典や基準が異なる数値は並べて示し、平均化も、新しい数値への合成も行いません。
本記事の価値:読み終えると、Gemini 4 Neon の最初の文字が出るまでの時間、毎秒出力、1タスクあたりの時間がそれぞれどれくらいかを区別でき、4段階の思考レベルが速度とスコアに与える影響が分かり、モデル選定時にどの指標を見るべきかも分かります。
Gemini 4 Neon 速度の要点
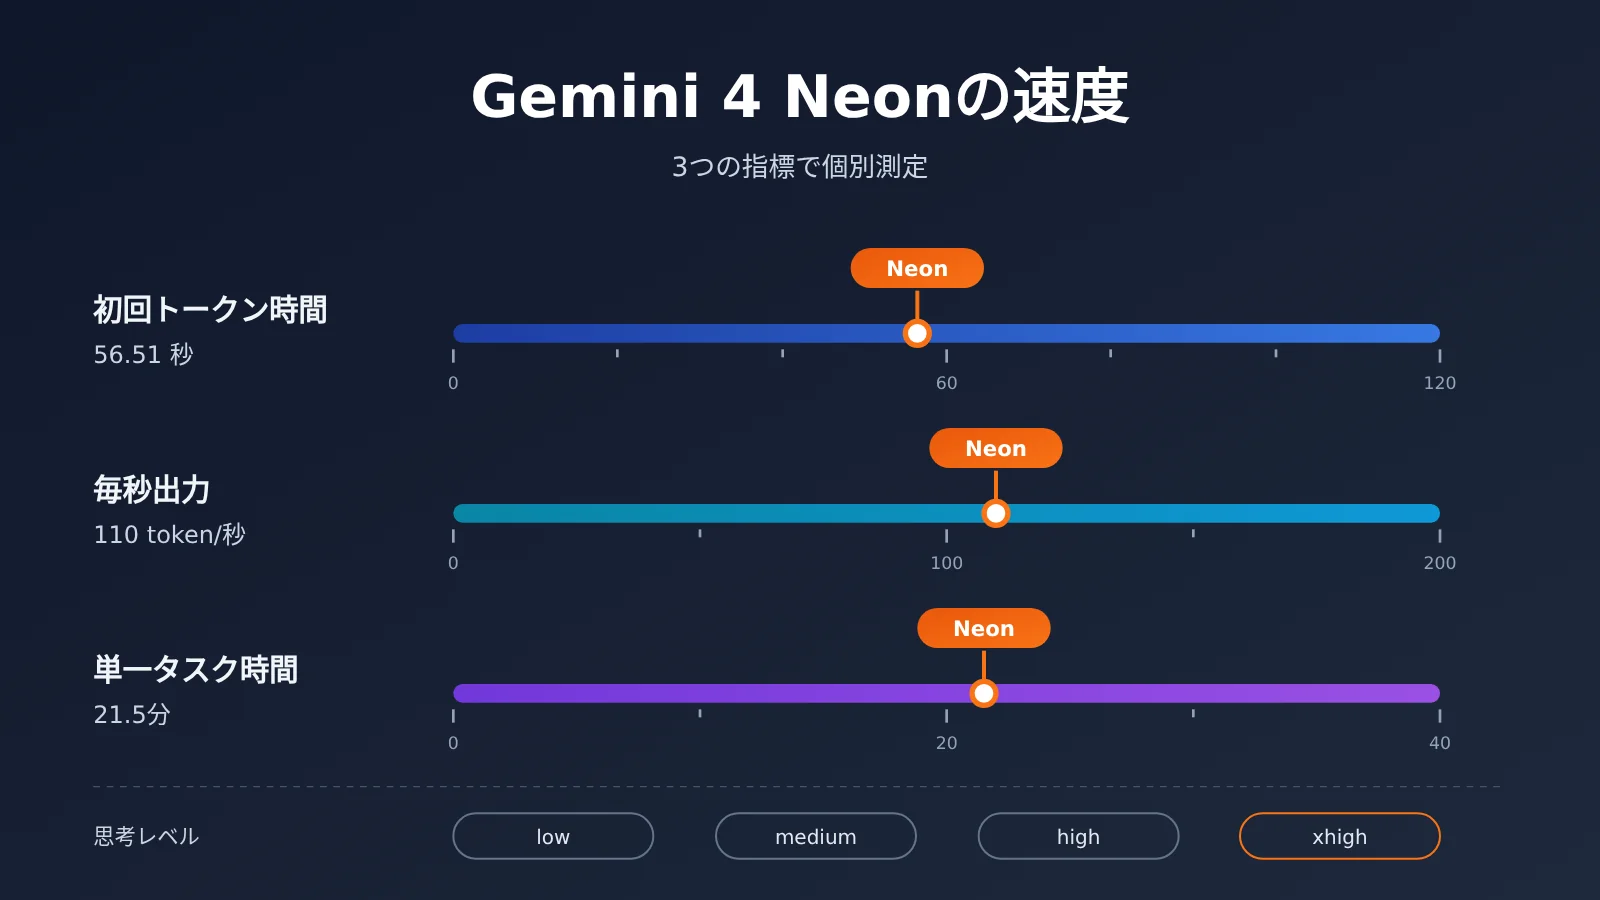
まず、混同しやすい3つの指標を切り分けます。下表の Neon の数値はいずれも xhigh 設定のもので、Artificial Analysis のモデルページから取得しています(2026-11-19 時点、インデックス v5.0.1)。
| 指標 | 意味 | Gemini 4 Neon xhigh の値 | ユーザーが受ける印象 |
|---|---|---|---|
| 初回トークンまでの時間 | リクエスト送信から最初の回答トークンが見えるまでの待ち時間 | 56.51 秒 | 対話時に「どれだけ待ってから文字が出始めるか」 |
| 毎秒出力 | 出力開始後に1秒あたり何トークン生成されるか | 110 トークン/秒 | ストリーミング出力が「どれくらい速く流れるか」 |
| タスクあたりの時間 | インデックス内の1問を解くのに平均どれくらいかかるか | 21.5 分 | 1つのタスクが「どれくらいで届くか」 |
| インデックス実行時の総出力トークン数 | インデックス全体を最後まで実行して合計何トークン出力するか | 2.83 億トークン | タスクあたりの時間を決めるもう一方の要因 |
Gemini 4 Neon の3つの速度指標を分けて見るべき理由
初回トークンまでの時間は、チャット系のインタラクションに最も大きく影響します。思考型モデルは最初の回答トークンを出す前に推論を一通り完了させる必要があるため、初回トークンまでの時間は秒単位、場合によっては分単位になり、思考レベルと強く相関します。
毎秒出力は「文字が出始めた後」のスループットだけを測るもので、モデルがどれだけ話すかとは関係ありません。タスクあたりの時間は、1秒あたり何トークン出力できるかと、その問題で合計何トークン出力するかの2つに同時に左右されます。毎秒出力が高いモデルでも、長い思考プロセスを書く習慣があれば、1問を解くのに時間がかかることはあります。後述する Neon と GPT-6.2 Sol、GPT-6.2 Astra の比較はまさにこのケースです。
Gemini 4 Neon の中核機能:ファミリー内の位置づけと4段階の思考
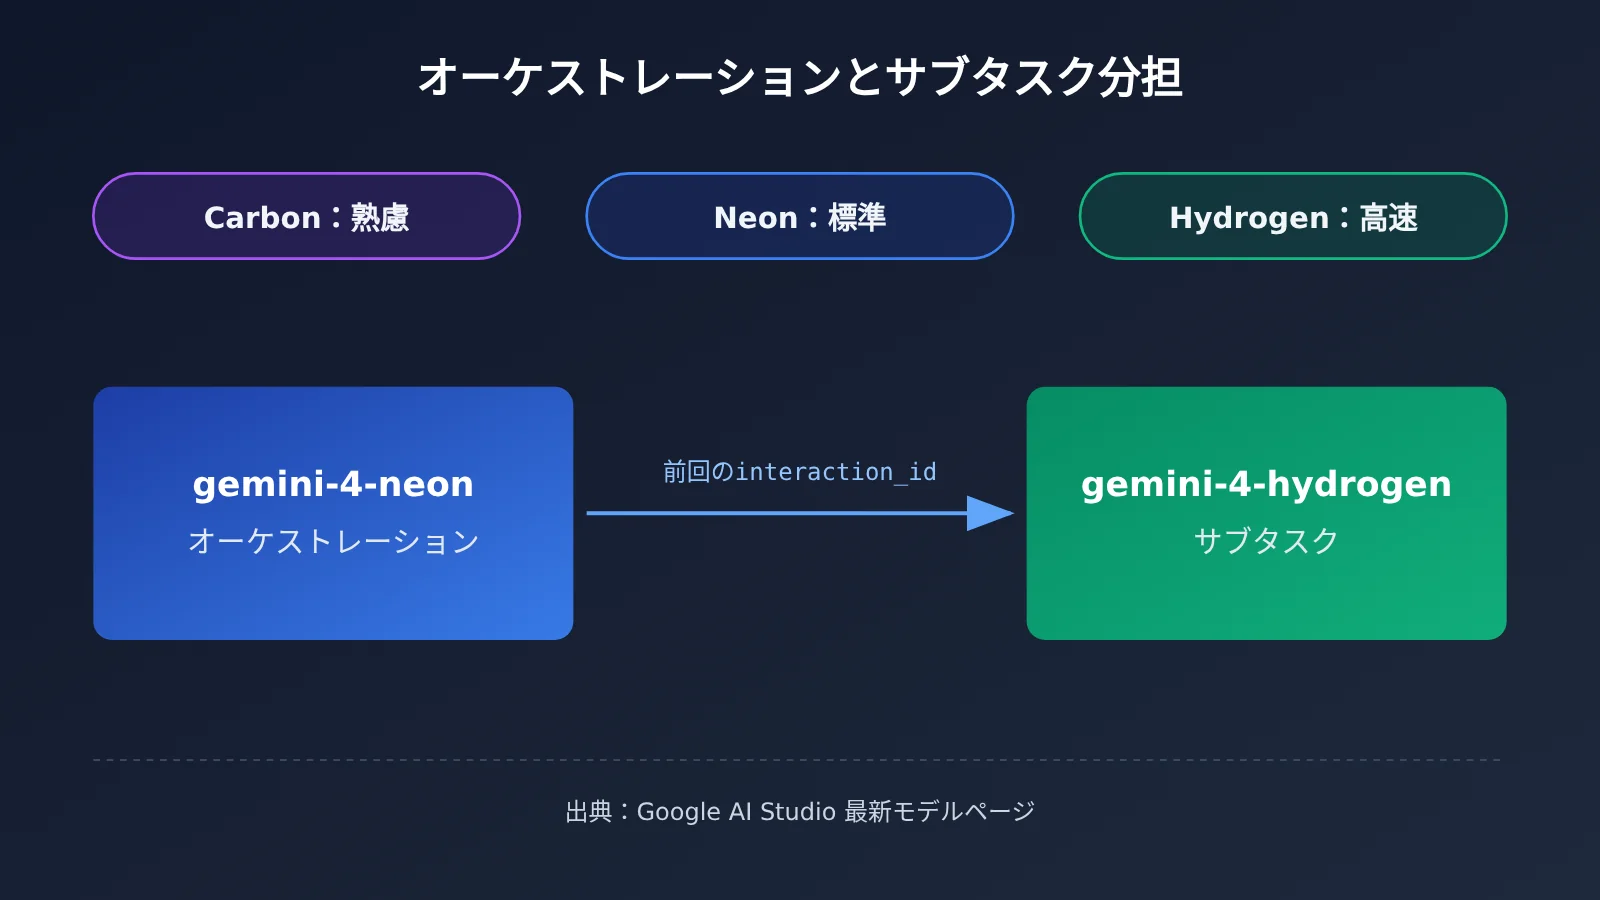
Google AI Studio の最新モデルページでは、3つの Gemini 4 モデルに速度の定性ラベルを付けています。Carbon は Deliberate、Neon は Moderate、Hydrogen は Fast です。つまり公式の定性では、Neon はファミリーの中で中央に位置し、Fast と表示されるのは Hydrogen のほうです。Google のブログも同様に、Carbon を最も難しい長距離タスク向け、Hydrogen を日常的な高速実行向け、Neon をその折衷として高頻度の複雑なワークフロー向けに位置づけています。
| モデル | AI Studio の速度定性 | 思考レベル | デフォルト | ファミリー内の位置づけ(Google ブログ / 開発者ガイド) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low、medium、high | medium | 複雑な長距離タスク |
| Gemini 4 Neon | Moderate | low、medium、high、xhigh | high | 折衷、高頻度の複雑なフロー |
| Gemini 4 Hydrogen | Fast | 資料に記載なし | 資料に記載なし | 日常の高速ループ |
Gemini 4 Neon の能力と仕様
モデルカードによると、Gemini 4 Neon は Gemini 4 Carbon を基に改変されたモデルで、知識カットオフは2026年3月、入力はテキスト・画像・音声・動画に対応し、統合ウィンドウは最大100万トークンです。デフォルトの同期出力は最大6.4万トークン、バックグラウンドの長文デコードは最大100万トークンです。Google Cloud の開発者ガイドに記載されたモデル ID は gemini-4-neon で、統合上限は1048576トークン(入力と出力を含む)となっており、出力には思考・関数呼び出し・最終応答が含まれます。
能力面では、公式が自ら報告した Artificial Analysis Intelligence Index は xhigh レベルで61、総合3位であり、ブログもより大きくより遅いモデルには劣ると認めています。モデルカードの比較表は Neon、Claude Opus 5.5、GPT-6.2 Sol の3列のみで、Gemini 以外の結果は各社の自己報告値をそのまま採用しているため、この表は公式による集約であり、同一ラボが同日に再測定したものではありません。表には Neon が劣る項目もあり、たとえば Terminal-bench 4.1 のチート調整後の正確率は Opus 5.5 が65.8%で、Neon の65.2%を上回っています。
開発者ガイドには、もう1つのオーケストレーションの使い方も示されています。gemini-4-neon を主制御役にして、previous_interaction_id を gemini-4-hydrogen に渡し、より高速なサブタスクを実行させるというものです。Neon が十分速くないと感じるなら、思考レベルを下げ続けるよりもこの方法のほうが検討に値します(これは私たちの判断であり、ガイドの原文ではありません)。
Gemini 4 Neon の速度データ:4つの思考モードを段階ごとに分析
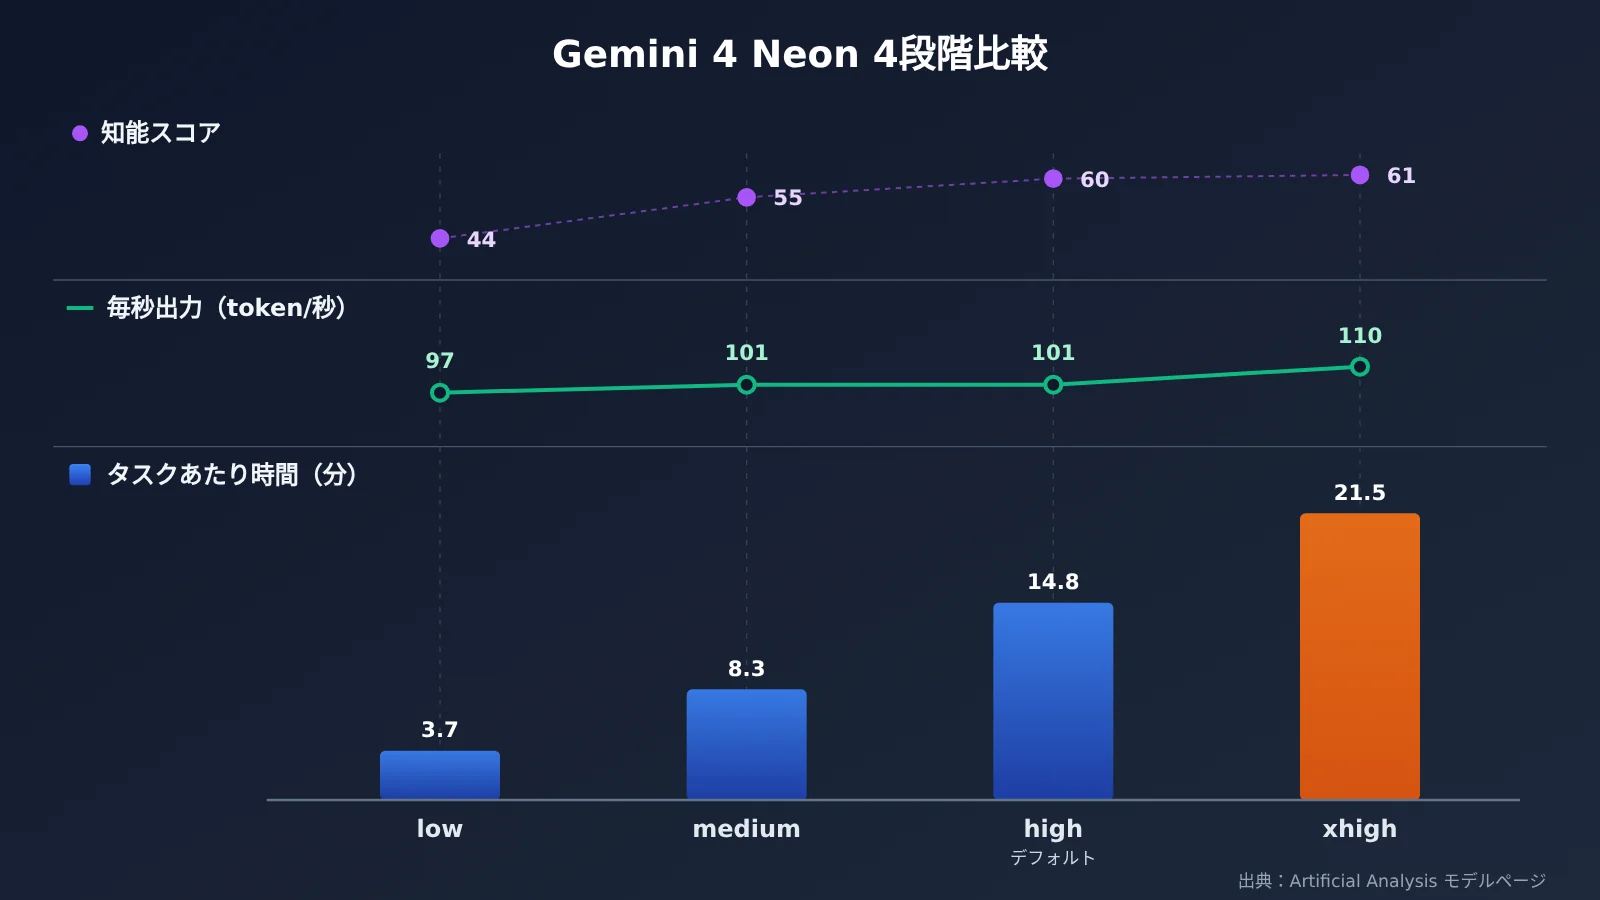
以下の表は Artificial Analysis のモデルページに基づいています。右端の列にある初回トークン時間については、補足が必要です。ページのサマリー表には xhigh の 56.51 秒だけが記載されており、high、medium、low の3モードの初回トークン時間は同じページの FAQ 欄に記載されています。サマリー表とは別の欄にあるため、引用する際はこの出典を明記してください。
| 思考モード | 知能スコア | タスクあたりの時間 | 1秒あたりの出力 | 初回トークン時間(モデルページ FAQ 欄) |
|---|---|---|---|---|
| xhigh | 61 | 21.5 分 | 110 token/秒 | 56.51 秒 |
| high(デフォルト) | 60 | 14.8 分 | 101 token/秒 | 40.64 秒 |
| medium | 55 | 8.3 分 | 101 token/秒 | 20.14 秒 |
| low | 44 | 3.7 分 | 97 token/秒 | 13.93 秒 |
この表から見ると、4つのモードはいずれも1秒あたりの出力が 97〜110 token/秒の範囲でしか変動しておらず、タスクあたりの時間は 3.7 分から 21.5 分まで大きく広がっています。モードを切り替えることで主に変わるのは「どれだけ考えるか」であり、「1秒あたりどれだけ速く書くか」への影響はほとんどありません。これは表の数値から導き出した推測であり、モデルページ自体にはこのような記述はありません。
スコア面のコストもはっきりしています。デフォルトの high の 60 点から medium に下げると 5 点だけ低下し、low まで下げると 44 点まで落ちます。xhigh は high より 1 点高いだけですが、タスクあたりの時間は 7 分近く長くなります。そこに価値があるかどうかは、あなたのタスク次第です。
Gemini 4 Neon は毎秒あたりの速度が速いのに、1タスクを終えるまで時間がかかることもあるのはなぜか
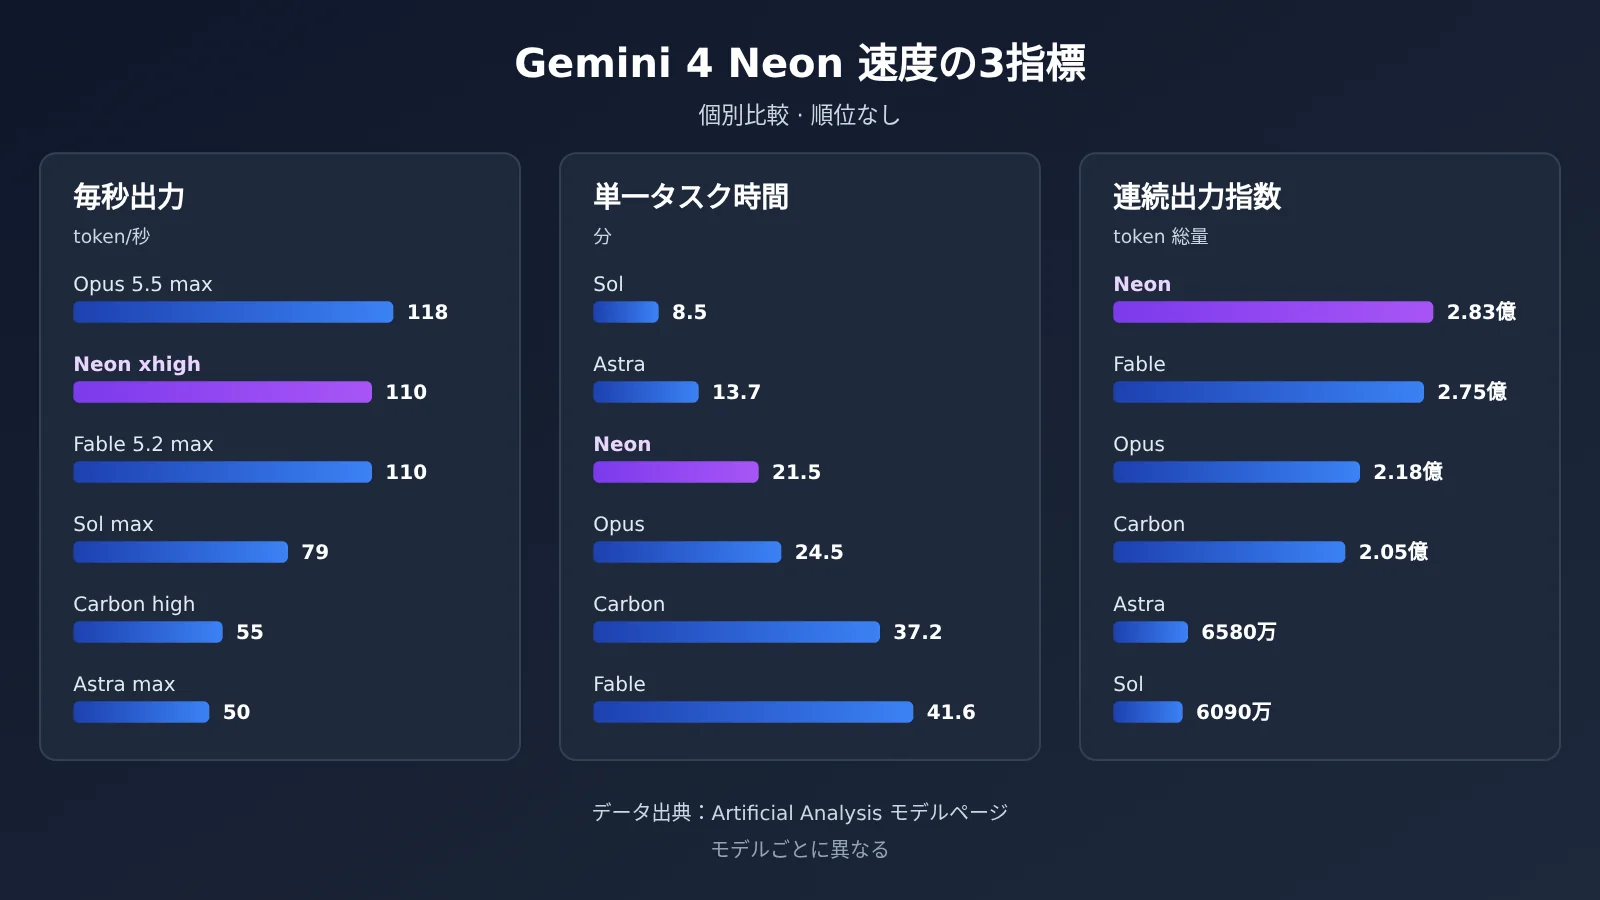
Artificial Analysis のモデルページでは、Neon xhigh がインデックスのフルセットを実行したとき、合計2.83億トークンを出力し、81.2億トークンを入力したと記録されています。出力トークンが多いほど、毎秒110トークンでも総所要時間は長くなります。GPT-6.2 Astra は max 設定で毎秒50トークンしか出ませんが、インデックス実行時の出力は6580万トークンにとどまり、1タスクの時間は13.7分です。GPT-6.2 Sol は max 設定で毎秒79トークン、出力は6090万トークンで、1タスクの時間は8.5分です。
したがって、「毎秒あたりの出力トークンが多い」ことと「タスクが早く終わる」ことは別問題です。Neon をこの2つの GPT と比べると、Neon は毎秒出力が高いのに1タスクの時間はむしろ長くなります。理由は、Neon の出力トークンがはるかに多いことです。
Gemini 4 Neon と対照モデルは分けて比較する
以下の表の数値はすべて Artificial Analysis のモデルページに由来します。各モデルの設定は異なり(Neon は xhigh、Carbon は high、その他は max)、同じ列内の相対関係を見るだけにとどめ、同一条件での比較とは見なせません。
| モデル(設定) | 知能スコア | 1タスク所要時間 | 毎秒出力 | 最初のトークンまでの時間 | インデックス実行時の出力トークン |
|---|---|---|---|---|---|
| Gemini 4 Neon(xhigh) | 61 | 21.5分 | 110 | 56.51秒 | 2.83億 |
| Gemini 4 Carbon(high) | 60 | 37.2分 | 55 | 73.04秒 | 2.05億 |
| Claude Opus 5.5(max) | 59 | 24.5分 | 118 | 335.85秒 | 2.18億 |
| Claude Fable 5.2(max) | 65 | 41.6分 | 110 | 247.46秒 | 2.75億 |
| GPT-6.2 Astra(max) | 62 | 13.7分 | 50 | 197.65秒 | 6580万 |
| GPT-6.2 Sol(max) | 57 | 8.5分 | 79 | 75.06秒 | 6090万 |
3つの指標を順に見てみましょう。
- 毎秒出力:Claude Opus 5.5 max は118トークン/秒で、Neon xhigh の110を上回ります。Claude Fable 5.2 max は Neon と同じ110です。
- 1タスク所要時間:GPT-6.2 Sol max の8.5分、GPT-6.2 Astra max の13.7分は、いずれも Neon xhigh の21.5分より短くなっています。
- 最初のトークンまでの時間:Neon xhigh の56.51秒はこの表では最小値ですが、各行の設定が異なるため、これを根拠に全面的に優れているとは言えません。
Neon の Carbon に対する速度向上には、2つの見方があります。Artificial Analysis のモデルページでは、Carbon high は毎秒55トークン、37.2分です。Artificial Analysis の記事では概算値として、Neon の1タスクは約21分で、Carbon の約36分より約40%短いとされています。速度向上の要因は、出力速度が約110対約57トークン/秒であることと、Neon の1タスクあたりの出力トークンが約15%多いことです。Carbon の2組の数値は基準が異なるため、ここでは差を求めません。
素早く使い始めるには:Gemini 4 Neon のティア選択と速度計測の方法
gemini-4-neon は現在、Google 公式チャネル経由で呼び出す必要があります。以下の手順は2つのパートに分かれています。まず Neon のティアの選び方を説明し、次に APIYI にすでに登録されている Gemini 4 モデルで計測フローを組み立て、Neon が登録されたらモデル名を差し替えるだけにします。
ステップ1:Neon の4段階の思考を理解する。 Google Cloud の開発者ガイドには、gemini-4-neon の思考ティアは low、medium、high、xhigh のみで、デフォルトは high と明記されています。thinking_budget や MINIMAL を渡すと HTTP 400 が返ります。旧版 Gemini から移行したコードが最も引っかかりやすいポイントです。
ステップ2:速度要件に応じてティアを下げる。 遅いと感じる場合は、デフォルトの high から medium や low に下げられます。Artificial Analysis のモデルページによると、1タスクあたりの時間は high の14.8分から8.3分または3.7分に短縮され、知能スコアは xhigh の61(デフォルトの high は60)から55または44に下がります。low のスコア低下は大きいため、ティアを下げる前に自分のタスクでサンプリングして確認するのがおすすめです。
ステップ3:APIYI アカウントとキーを準備する。 APIYI apiyi.com で登録して APIキーを取得し、キーを環境変数(例 APIYI_API_KEY)に入れます。コード側では環境変数を読むだけで、平文で書かないようにします。
ステップ4:呼び出し方式を選ぶ。 OpenAI 互換インターフェースの base_url には https://api.apiyi.com/v1 を、モデル名にはすでに登録済みの gemini-4-carbon または gemini-4-hydrogen を指定します。Gemini ネイティブプロトコルを使う場合は、アドレスに https://api.apiyi.com、API バージョンに v1beta を使います。
ステップ5:3つの指標を分けて記録する。 stream ストリーミング出力を有効にし、最初の回答トークンが届くまでの時間、出力開始後の token/秒、タスク全体が終了するまでの総所要時間をそれぞれ記録し、さらに今回の出力トークン総数も記録します。出力トークン数があれば、所要時間が長いのが「書くのが遅い」からなのか「たくさん書いた」からなのかを判断できます。
🚀 クイックスタートの提案:計測フローは、まずすでに登録済みの Gemini 4 モデルで動かしてみるのがよいでしょう。APIYI は1つのキーで Gemini、Claude、GPT シリーズをまとめてカバーできるので、3指標の記録スクリプトを一度書けば複数モデルを横並びで比較でき、Neon が登録されたらモデル ID を変更するだけです。
Gemini 4 Neon の価格と APIYI モデルの照合
Gemini 4 Neon の公式価格(Google AI Studio の料金ページ)は、入力が100万トークンあたり3ドル、出力が100万トークンあたり15ドルです。
APIYI では次の2か所を確認しました。APIYI のモデル一覧表(docs.apiyi.com/models.md、ページの更新日時は 2026-11-16 09:39 UTC+8)と、2026-11-19 に照会した料金API(api.apiyi.com/api/pricing、バージョン shell-api-modelmak-v1、全285モデル)です。両方で照合できる提供中のモデルは以下のとおりです。単位は100万トークンあたりの米ドルです。
| モデル ID | 入力 | キャッシュ読み取り | 出力 | エンドポイント | 備考(出典) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat、gemini | Google の 2026-11-30 までの紹介価格に対応(APIYI 一覧表) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat、gemini | APIYI 一覧表 |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat、messages | APIYI 一覧表 |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat、messages | APIYI 一覧表 |
gpt-6.2-sol |
2(272000 超で 3) | 0.1 | 10(料金APIの上位価格は約 11.25) | responses(推奨)、chat | 一覧表には入力の段階制のみ記載 |
gpt-6.2-astra |
8(272000 超で 16) | 0.4 | 40(料金APIの上位価格は約 60) | responses、chat | 一覧表には入力の段階制のみ記載 |
いくつか注意すべき点があります。gemini-4-carbon の掲載価格は Google の紹介価格と一致しており、その後の標準価格 4/20 とは異なります。グループ名の表記は2つのデータで完全には一致していません。Gemini モデルは一覧表では Default、SVIP、料金APIでは default、svip と表記されています。Claude モデルは一覧表では ClaudeCode、Claude_Reverse、Claude_Enterprise、Default、SVIP、料金APIでは ClaudeCode、ClaudeCodeReverse、ClaudeOfficial、default、svip と表記されています。GPT モデルの上位出力価格は料金APIにのみ反映されており、料金APIでは 272000 トークンを超えると CompletionRatio が 5 から 3.75 に変わります。
gemini-4-neon は APIYI の一覧表にも料金APIにも収録されておらず、現時点では未提供です。このモデルはできるだけ早く提供を開始する予定です。モデルと価格はプラットフォームのモデル一覧を基準とします。
Gemini 4 Neon の長所と短所の分析
強み
- 毎秒出力が同ファミリーの前作より高い:Artificial Analysis のモデルページには、Neon xhigh が 110 token/秒、Carbon high が 55 token/秒と表示されています。
- 最初のトークンまでの待ち時間が比較的短い:xhigh の最初のトークンは 56.51 秒で、上記の比較表の中では最も小さい値です(レベルが異なるため、参考程度にご覧ください)。
- 思考レベルの粒度が細かい:4 段階の思考があり、low の 3.7 分から xhigh の 21.5 分まで、タスクに応じて選べます。
- 仕様が網羅的:モデルカードにはテキスト・画像・音声・動画の入力と、100 万 token の統合ウィンドウが記載されています。開発者ガイドでは、4096 token 以上の共有プレフィックスに対して暗黙的キャッシュが自動的に有効になると説明されています。
制約
- 出力 token が多い:ベンチマークでは 2 億 8300 万の出力 token を消費するため、xhigh は 1 タスクあたりの時間が Sol や Astra より長くなります。対策としては、レベルを下げるか、サブタスクを Hydrogen に任せることです。
- 公式の位置づけはあくまで Moderate:AI Studio は Fast ラベルを Hydrogen に付与しています。最速のインタラクションを求めるシーンでは、まず Hydrogen を試すべきです。
- 一部の設定は非対応:開発者ガイドには、明示的コンテキストキャッシュが非対応であること、
thinking_budgetとMINIMALが400を返すことが記載されています。 - 無料枠がない:AI Studio の料金ページには、
gemini-4-neonに無料枠がないと明記されています。 - ベンチマークの測定基準が混在:Coding Agent Index は Google のブログでは 58.6、Artificial Analysis の記事では 59 です。SWE-sweep の 12.8% と 39.0% は、2 つの異なる harness に由来します。データを読む際は出典を確認する必要があります。
よくある質問 FAQ
Q1:Gemini 4 Neon は Gemini 4 ファミリーの中で最速ですか?
Google AI Studio の最新モデルページでの位置づけによると、Hydrogen は Fast、Neon は Moderate、Carbon は Deliberate です。公式が言う「より早く完了する」は、主に Carbon との比較を指しています。
Q2:Gemini 4 Neon は最初のトークンが出るまでどれくらい待つ必要がありますか?
Artificial Analysis のモデルページの集計表では、xhigh の最初のトークンまでが 56.51 秒とされています。同じページの FAQ 欄には high 40.64 秒、medium 20.14 秒、low 13.93 秒と別途記載があり、この3段階の数字は FAQ 欄が出典で、集計表とは同じ欄ではありません。
Q3:Gemini 4 Neon は毎秒 110 トークンを出力するのに、1タスクに 21.5 分もかかるのはなぜですか?
出力するトークン数が多いからです。Artificial Analysis のモデルページには、Neon xhigh が指数出力で 2 億 8300 万トークン、Sol max はわずか 6090 万、Astra max はわずか 6580 万と記録されています。そのため後者2つは毎秒の速度は遅いものの、1タスクあたりの時間は短くなります。
Q4:Gemini 4 Neon のデフォルトはどの段階ですか?もっと速くしたい場合はどう調整しますか?
開発者ガイドにはデフォルトは high と明記されています。より速くしたい場合は medium や low に下げられます。Artificial Analysis のモデルページによると、1タスクあたりの時間はそれぞれ 8.3 分と 3.7 分になり、知能スコアは xhigh の 61(high は 60)から 55 または 44 に下がります。
Q5:現在、APIYI 経由で Gemini 4 Neon を呼び出せますか?
2026-11-19 時点では、`gemini-4-neon` はまだ APIYI の一覧表や価格取得 API に登場しておらず、未上架です。できるだけ早く上架する予定です。現段階ではまず apiyi.com で登録し、すでに上架済みの `gemini-4-carbon` または `gemini-4-hydrogen` を使って速度測定のフローを組んでおくとよいでしょう。OpenAI 互換のエンドポイントは前述のクイックスタートと同じです。
Q6:Gemini 4 Neon は Carbon よりどれくらい安いですか?
ここには3つの異なる数字があります。Google のブログではデフォルトの high で1タスクあたりのコストが Carbon より 32% 低いとされ、Artificial Analysis の記事では Carbon の非割引価格より約 17% 少ないとされ、Artificial Analysis のモデルページでは紹介価格ベースで Carbon high の1タスクあたり 4.90 ドルと算出されています。3者は前提が異なるため、1つの数字にまとめることはできません。
Q7:Gemini 4 Neon のベンチマークスコアは、そのまま競合製品と比較できますか?
慎重に扱う必要があります。モデルカードには、Gemini 以外の結果はデフォルトで各社の自己申告によるもので、公式による集約であり同日の再測定ではないと注記されています。また Artificial Analysis の対照には段階の違い(xhigh、high、max が混在)があります。
Gemini 4 Neon の核心ポイント(Key Takeaways)
- 速度には3つの指標がある:初回トークンまでの時間、毎秒出力、1タスクあたりの時間はそれぞれ独立しており、順位づけが食い違うこともあります。
- 公式な位置づけは中程度:AI Studio では Neon を Moderate と表示しており、Fast なのは Hydrogen だけです。
- xhigh のデータ:Artificial Analysis のモデルページでは 61 点、21.5 分、110 token/秒、初回トークンまで 56.51 秒とされています。
- 出力量が所要時間を押し延ばす:2.83 億出力トークンにより、Neon の1タスクあたりの時間は Sol と Astra より長くなります。
- 毎秒出力は最高ではない:Opus 5.5 max の 118 token/秒は Neon の 110 token/秒を上回ります。
- ティアを下げると速度が上がる:medium は 8.3 分・55 点、low は 3.7 分・44 点で、デフォルトは high です。
- 提供状況:APIYI では Neon はまだ提供されていません。まずは提供済みの Gemini 4 モデルで速度測定フローを整えておくのがよいでしょう。
まとめ
Gemini 4 Neon の速度に関する主な結論:
- Carbon と比べると確かに速い:2 件の Artificial Analysis データはいずれも、Neon の毎秒出力が Carbon の約 2 倍で、1タスクあたりの時間が明らかに短いことを示しています。
- より広い範囲で見ると、すべてでリードしているわけではない:毎秒出力は Opus 5.5 max を下回り、1タスクあたりの時間は Sol max と Astra max より長くなっています。
- 主な調整要素はティア:毎秒出力は4つのティア間であまり変わらず、所要時間の差は主に思考トークンの量に由来します。
インタラクティブな場面ではまず初回トークンまでの時間、バッチ処理では1タスクあたりの時間、ストリーミング体験では毎秒出力を重視する、というのが私たちの見解です。Neon が「十分に速い」かどうかは、どの指標を気にするかによって変わります。まずは APIYI apiyi.com で既存の Gemini 4 モデルを使い、3つの指標を記録する流れを整えておくことをおすすめします。Neon が提供開始されたら、モデルを差し替えるだけで比較できます。
📚 参考資料
-
Sundar Pichai の投稿:Gemini 4 Neon のリリースと提供範囲
- リンク:
x.com/sundarpichai/status/2123167780988125621 - 説明:公開チャネルと「より速く完了する」という公式表現
- リンク:
-
Google ブログ「Introducing Gemini 4 Neon」:公式が自己申告したベンチマークスコア、価格、ファミリー内の位置づけ
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 説明:すべての数値は公式の自己申告によるもの
- リンク:
-
DeepMind のモデルカード:仕様と3列の比較表
- リンク:
deepmind.google/models/model-cards/gemini-4-neon/ - 説明:Gemini 以外の結果は、原則として各社の自己申告に基づく
- リンク:
-
Google Cloud 開発者ガイド:モデル ID、思考レベル、エラー説明
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 説明:思考レベルは4段階、デフォルトは high、HTTP 400 が発生する条件
- リンク:
-
Google AI Studio の料金ページと最新モデルページ:公式価格と速度に関する定性的な説明
- リンク:
aistudio.google.com/docs/pricing、aistudio.google.com/docs/latest-model - 説明:Deliberate、Moderate、Fast の3段階による定性的な位置づけ
- リンク:
-
Artificial Analysis の記事:Neon と Carbon のサードパーティ比較
- リンク:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 説明:約21分、約36分、約57トークン/秒といった概算値
- リンク:
-
Artificial Analysis のモデルページ:4段階の速度と比較モデルのデータ
- リンク:
artificialanalysis.ai/models/gemini-4-neon - 説明:2026-11-19 時点で閲覧、インデックス v5.0.1、FAQ 欄には各段階の最初のトークンまでの時間も記載
- リンク:
-
APIYI の一覧表:掲載済みモデルと価格
- リンク:
docs.apiyi.com/models.md - 説明:モデルと価格はプラットフォームのモデル一覧を基準とする
- リンク:
著者:APIYI 技術チーム
技術交流:Gemini 4 Neon の掲載状況やモデルに関するご質問は、APIYI(apiyi.com)のトップページからお気軽にお問い合わせください