著者注:名前に Flash が付いていても、入力モダリティ、エンドポイント、グループ倍率はそれぞれ異なります。本記事では「まずモデルページを見る → 次に価格を照らし合わせる → タスクで選ぶ」の順で、Flash モデルの選び方を整理します。
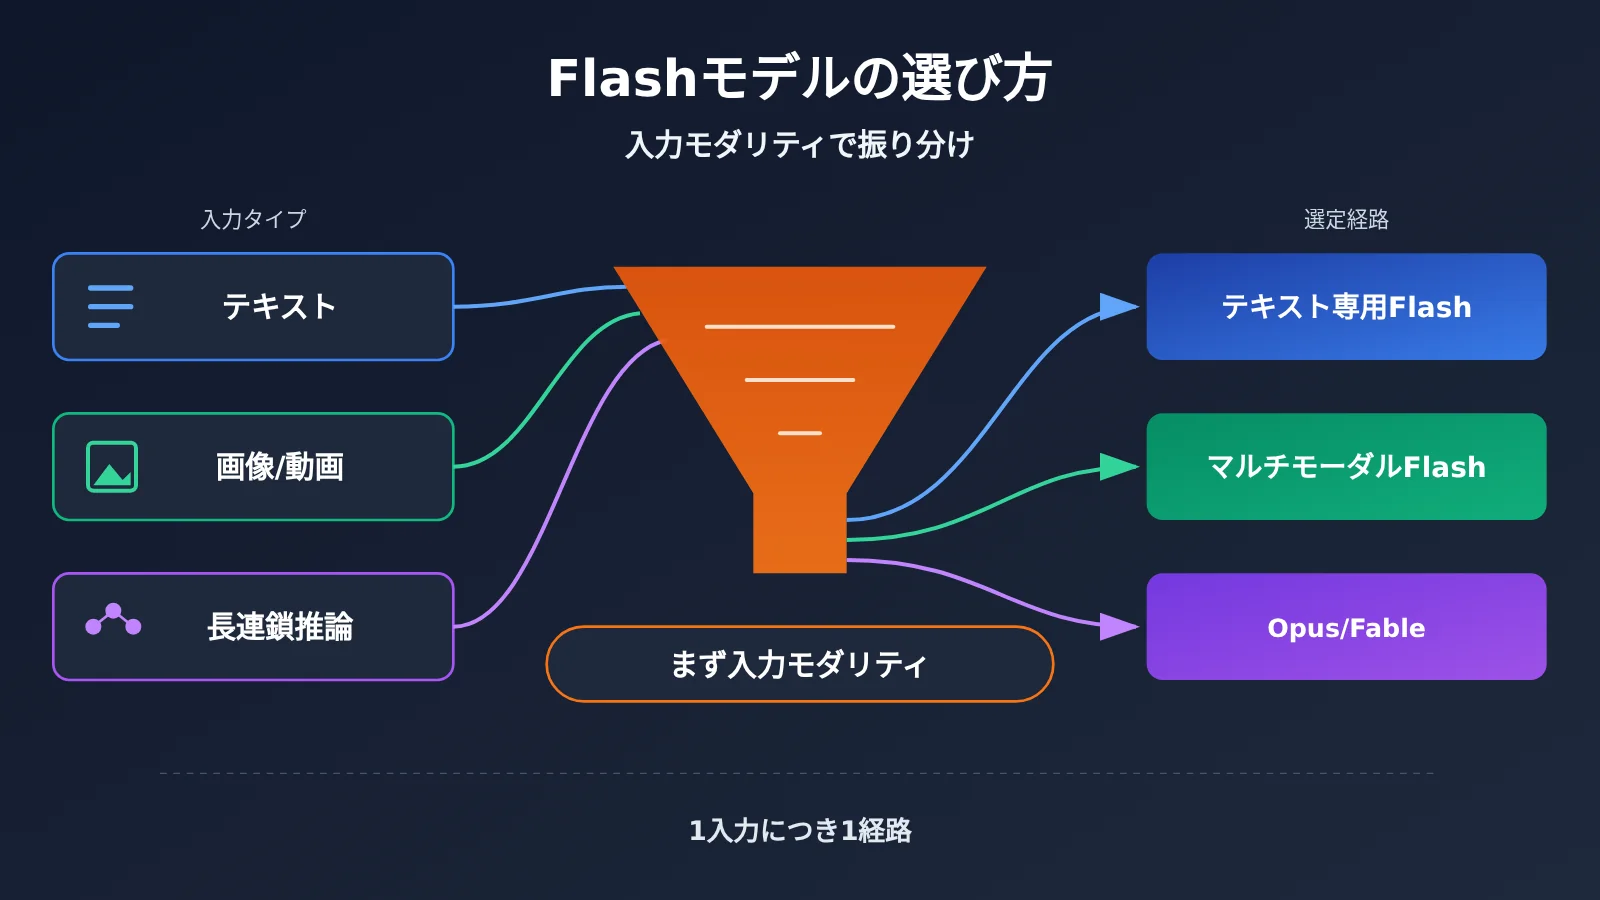
Flash クラスのモデルを選ぶとき、多くの人は「名前に Flash が入っているから速くて安い」と捉え、コーディング、画像認識、数式計算をすべて同じ1本に任せてしまいがちです。ここでの問題は、名前に Flash が入っていても、入力モダリティと利用できるエンドポイントは同じではないという点です。テキストしか受け付けないもの、画像や動画を読めるもの、さらに /v1/messages が通らないものもあります。
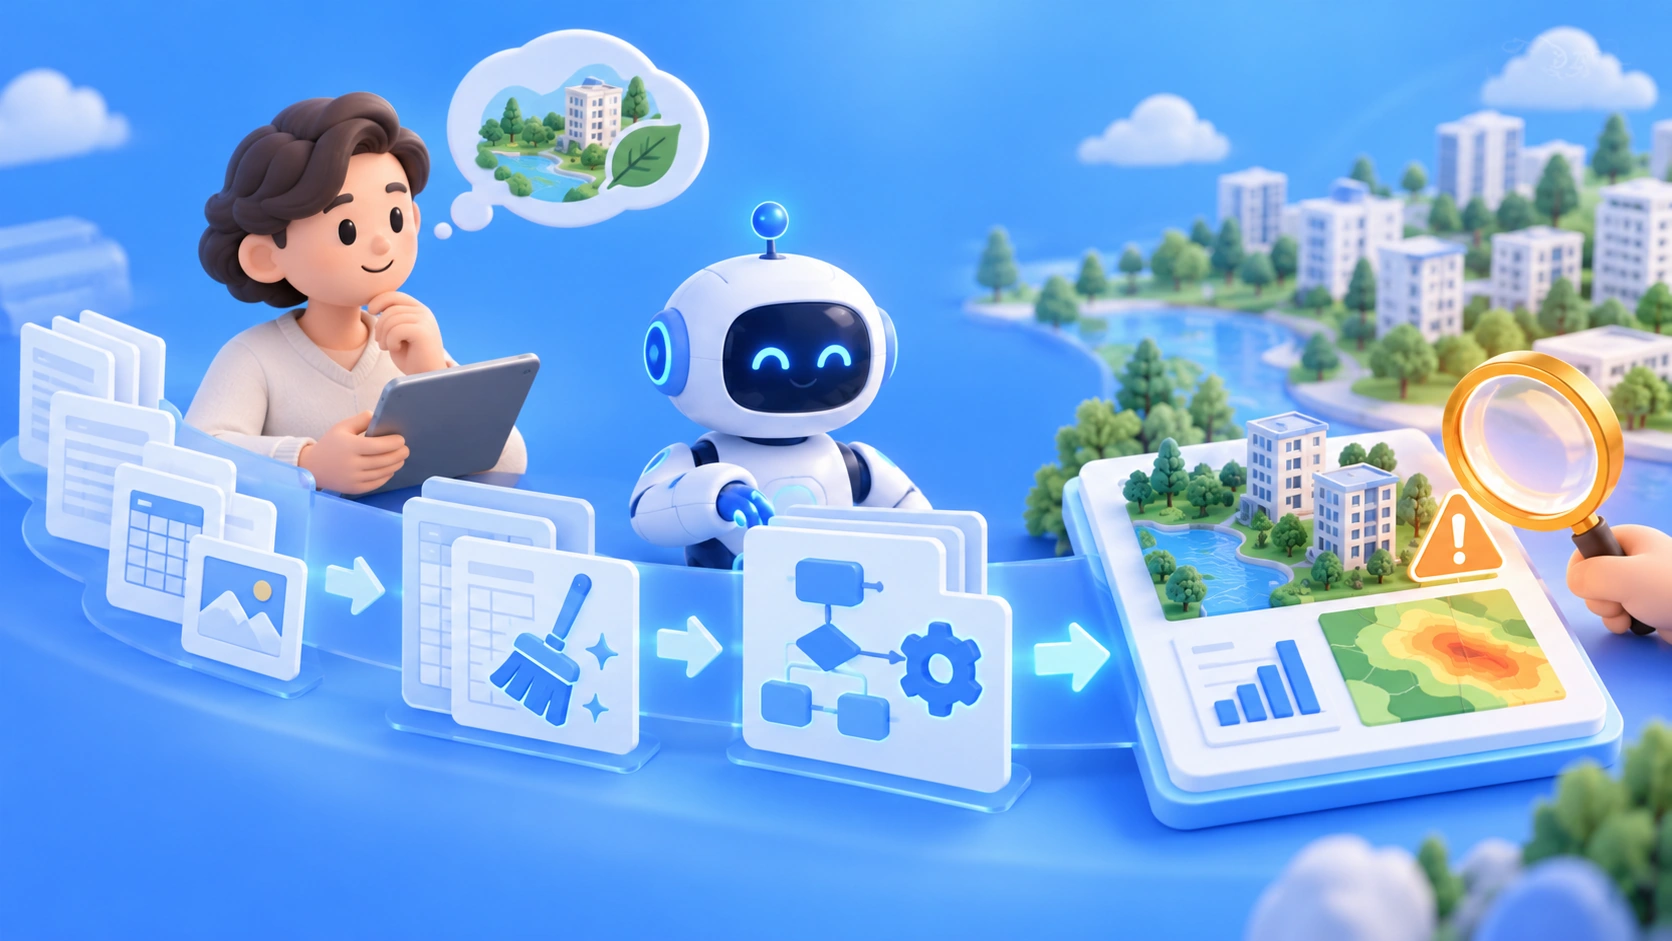
これは「どれが最強か」のランキングではありません。 本記事はどれが総合的に強い・安いと断定するのではなく、実行可能な Flash モデル選定の手順を提示します。まずモデルページに書かれた入力の種類と用途を確認し、次に入力価格・出力価格・キャッシュ読み取り価格を突き合わせ、最後にタスクに応じて具体的なモデルに落とし込みます。
核心的な価値:本記事を読み終えると、自分の入力タイプ(純粋なテキスト、グラフのスクリーンショット、長尺動画)に合わせて、モダリティが一致する Flash モデルを選べるようになります。また、どのような重い推論タスクをデフォルトで Flash に任せるべきでないかも分かります。
Flash モデル選定の要点
| 要点 | 説明 | 価値 |
|---|---|---|
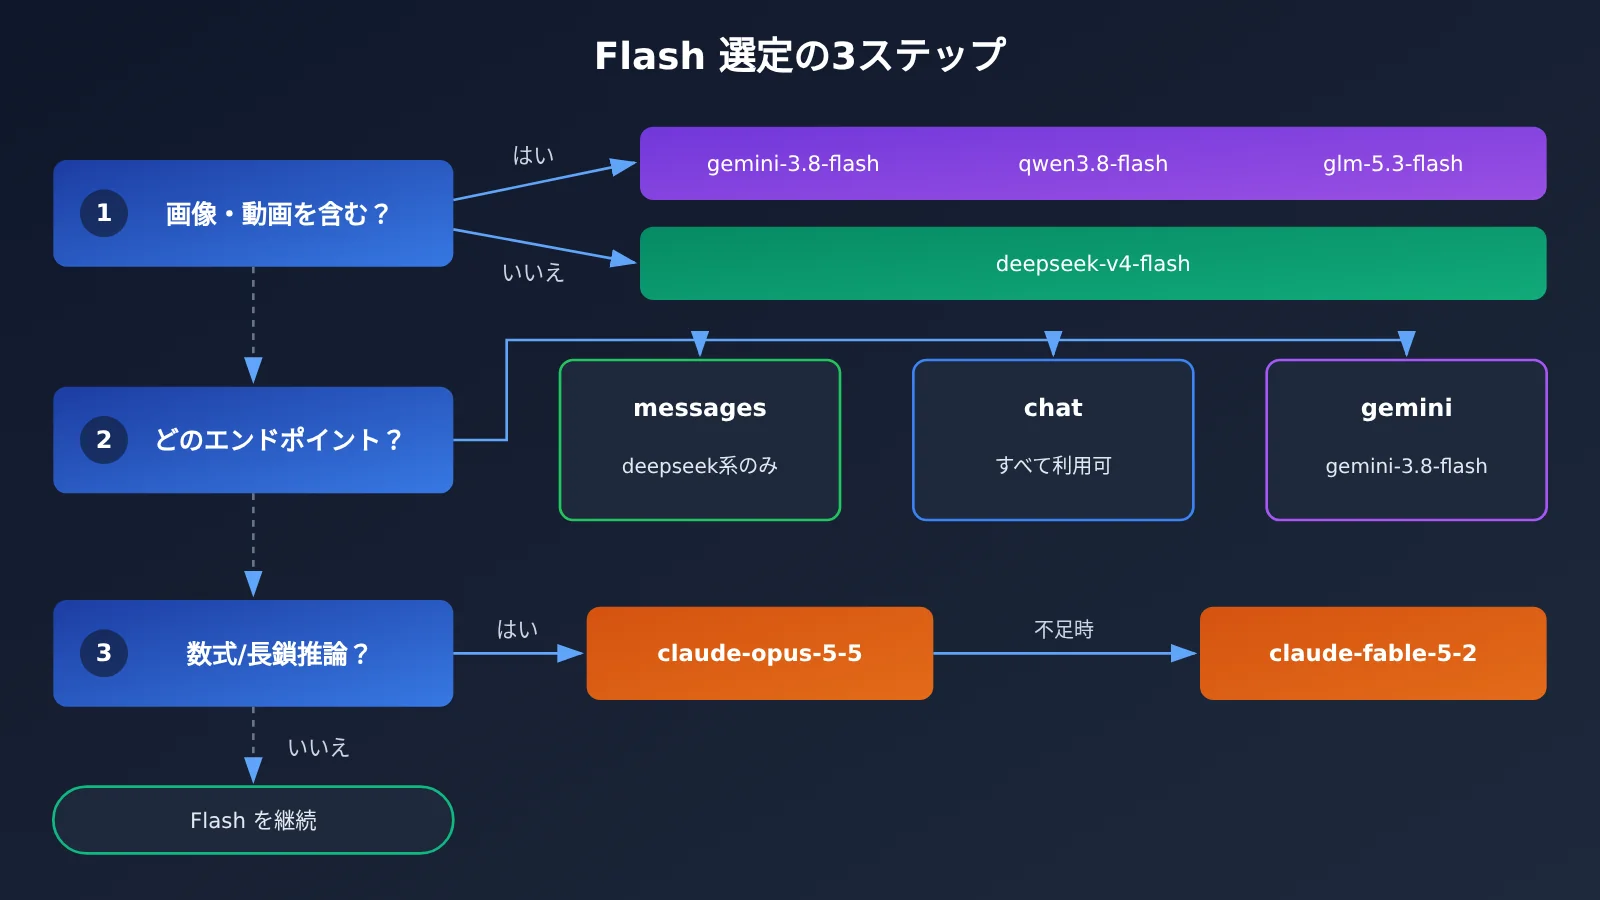
| まず入力モダリティを確認 | モデルページに記載された入力種別(テキスト/画像/動画/音声)が、あなたのデータを受け入れられるかを決めます | スクリーンショットをテキスト専用モデルに送ってしまう事態を避けられます |
| 次にエンドポイントを確認 | chat、messages、gemini エンドポイントはモデルごとに対応状況が異なります | モデルを切り替えたときにインターフェースがそのままエラーになるのを防げます |
| 3つの価格を突き合わせる | 入力価格・出力価格・キャッシュ読み取りをまとめて確認し、さらにグループ倍率を掛けます | 請求額の見積もりが実態に近づきます |
| タスクごとに振り分ける | グラフの読み取りや短いコードの修正には、モダリティが合う Flash を使います | 大量処理タスクのコストを抑えられます |
| 重い推論は別モデルを選ぶ | 数式や証明、長い連鎖を伴う技術的な作業は、デフォルトで Flash に任せません | 難しい問題はより上位のモデルに任せます |
Flash モデルを名前だけで一律に判断できない理由
「Flash」はあくまでベンダーが一つのモデル階層に付けた名前で、各社の定義は統一されていません。APIYI のモデルページ(docs.apiyi.com/models.md)を見ると、同じく Flash と呼ばれる複数のモデルで、入力モダリティが「テキストのみ」から「テキスト・画像・動画・音声」まで幅があります。エンドポイントも「chat と messages」から「chat のみ」までさまざまです。
そのため Flash モデルを選ぶとき、名前は「これは大量処理向けで低遅延のモデル階層だ」という範囲を絞る助けにしかなりません。実際に使えるかどうかを決めるのは、モデルページにある3つの情報です。入力種別、対応エンドポイント、グループ倍率です。以下のデータはすべてモデルページとモデル総合表から取得しています。確認日は 2026-11-17、総合表のデータ更新日時は 2026-11-16 09:39(UTC+8)で、価格の単位は100万トークンあたりのデフォルト定価です。
Flashモデルの入力モダリティとエンドポイント対照表
以下の表では、いくつかの Flash モデルについて入力モダリティとエンドポイントをまとめています。モデル選定の第一歩は、ここで「モダリティが合わない」型と「エンドポイントが合わない」型を除外することです。
| モデル ID | 入力モダリティ | 出力 | エンドポイント | モデルページのその他の説明 |
|---|---|---|---|---|
deepseek-v4-flash |
テキストのみ | テキスト | chat、messages | 構造化出力は非対応。ツール呼び出し、オプションの深い思考、プロンプトキャッシュに対応 |
deepseek-v4.1-flash |
個別のモデルページなし | — | chat、messages | 総合表に1行のみ。機能は今後の公式説明に従うものとします |
gemini-3.8-flash |
テキスト、画像、動画、音声 | テキスト | chat、gemini(messages なし) | 深い思考はデフォルトで有効、思考レベルは low/medium/high。公式仕様は未公開 |
qwen3.8-flash |
テキスト、画像、動画 | テキスト | chat のみ | コンテキスト 1,000,000、最大出力 131,072 |
glm-5.3-flash |
テキスト、画像、動画 | テキスト | chat のみ | コンテキスト 1,000,000、最大出力 128,000。深い思考はデフォルトで有効 |
特に注意すべき点が2つあります。第一に、deepseek-v4-flash の「テキストのみ」、コンテキスト 1,048,576、最大出力 393,216 はすべて v4 モデルページのデータであり、deepseek-v4.1-flash に当てはめることはできません。v4.1 は現時点では総合表に1行あるだけで、能力が明確に書かれていない以上、推測してはいけません。第二に、プロジェクトで Anthropic 形式の /v1/messages インターフェースを使っている場合、複数のマルチモーダル Flash はどれも利用できず、chat エンドポイントに切り替える必要があります。
Flashモデルの価格とグループの照合方法
モダリティとエンドポイントをクリアしたら、次は価格を照合します。モデルを替えると請求額は直接変わり、しかも表示価格は実際の課金額と一致しません。APIYI(apiyi.com)のトークンはグループごとに倍率が設定されているためです。下表に、デフォルトの表示価格とモデルページに記載されたグループを示します。
| モデルID | 入力価格 | 出力価格 | キャッシュ読取 | グループと倍率 |
|---|---|---|---|---|
deepseek-v4-flash |
$0.44 | $1.32 | $0.01408 | ClaudeCode 0.95×;CodexResponses、Default、SVIP 1× |
deepseek-v4.1-flash |
$0.3 | $1.2 | $0.006 | ClaudeCode、CodexResponses、Default、SVIP |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse 0.5×;Default、SVIP 1× |
qwen3.8-flash |
$0.114 | $0.3876 | $0.01425 | Default、SVIP 1× |
glm-5.3-flash |
$0.15 | $0.5 | $0.03 | CodexResponses、Default、SVIP |
claude-opus-5-5 |
$4 | $20 | $0.2 | モデル一覧表を参照 |
claude-fable-5-2 |
$8 | $40 | $0.2 | Claude_Reverseグループなし |
Flashモデル請求の3つの照合ポイント
本記事では「どちらが安いか」という結論は出しません。実際のコストは、入力と出力の比率やキャッシュヒット率によって変わるからです。次の3ステップで、ご自身で照合することをおすすめします。
- 入力と出力の比率を見る:画像を見る、文書を読むといったタスクは入力が大きく出力が小さいため、入力価格の比重が高くなります。長いコードや長いレポートを生成するタスクは、出力価格の比重が高くなります。
- キャッシュ読取を見る:システムプロンプトが固定で、繰り返し呼び出す場面では、キャッシュ読取価格が総請求額に大きく影響します。
- グループ倍率を掛ける:同じ
gemini-3.8-flashでも、Gemini_Reverseグループなら0.5×、Defaultなら1×で精算され、請求額は同じではありません。
💰 コストのヒント:トークンをどのグループに紐付けるかで、課金結果は直接変わります。モデルを切り替える前に、APIYI apiyi.com のコンソールで現在のトークンのグループを確認し、上表の表示価格に倍率を掛けて見積もってください。本番稼働後に請求額の変化に気づく事態を避けましょう。
タスク別に Flash モデルを選ぶ
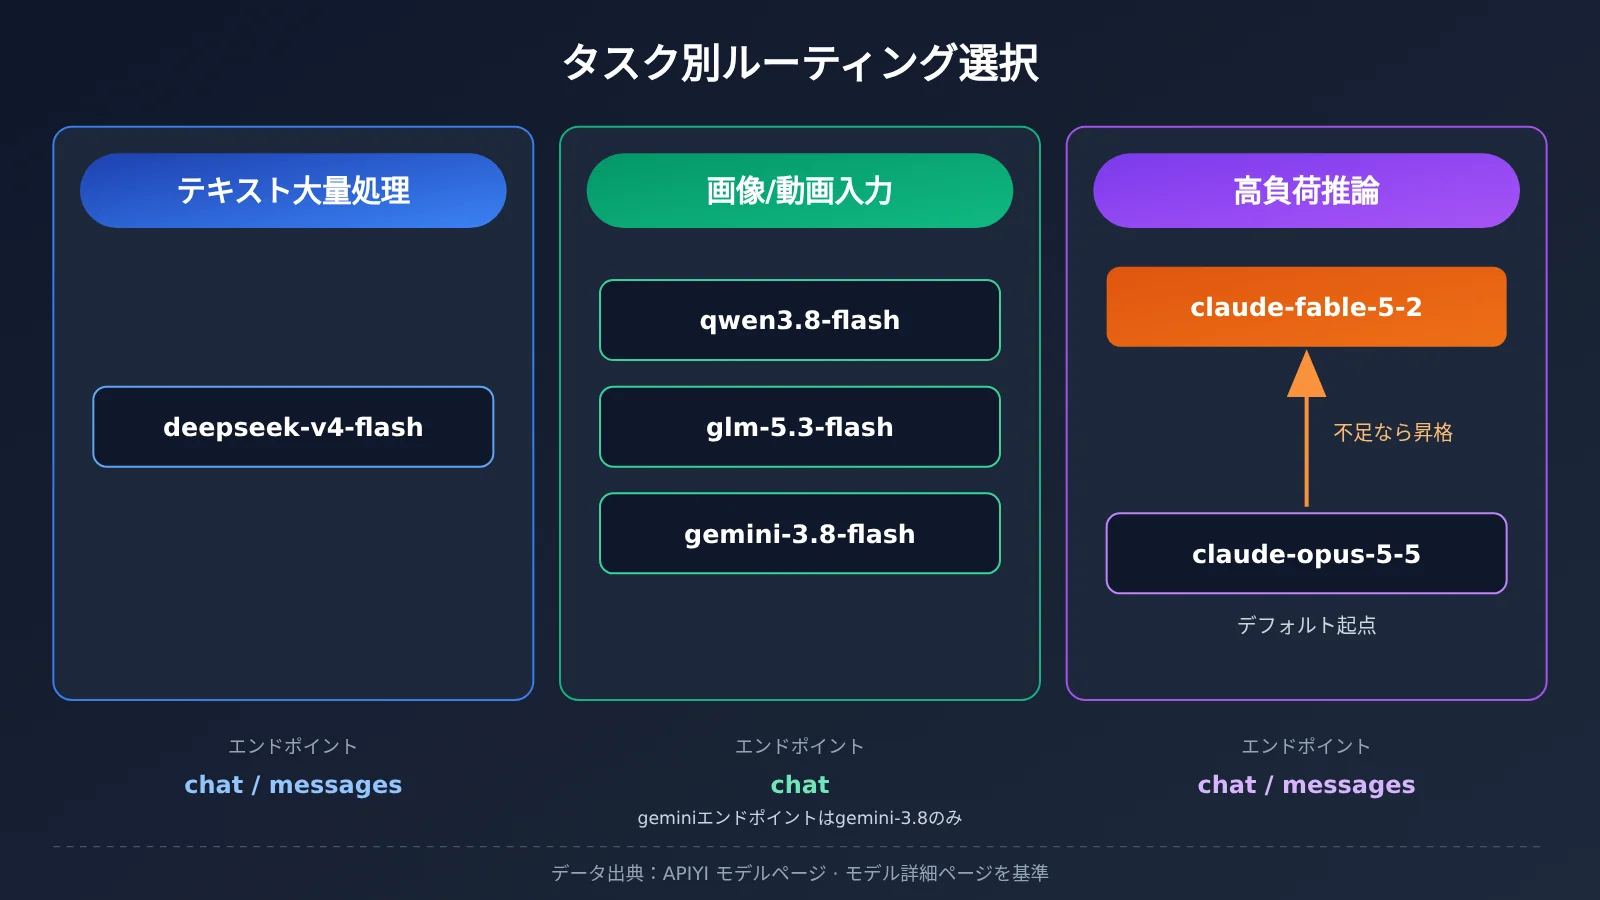
モダリティ、エンドポイント、価格を確認したら、あとはタスクごとに実際に使い分けるだけです。以下はタスク別の選定方針をまとめた表です。ここでの役割分担はモデルページの情報に基づく判断であり、具体的な能力は各モデルページを正とします。
| タスク種別 | 入力の特徴 | 候補モデル | 選定の根拠 |
|---|---|---|---|
| 短いコードの修正、高並列のテキスト処理 | テキストのみ | deepseek-v4-flash |
モデルページに「高並列・低遅延が主眼」と明記されており、messages エンドポイントに対応 |
| スクリーンショットを見てコードを修正、グラフを読む | テキスト + 画像 | qwen3.8-flash、glm-5.3-flash、gemini-3.8-flash |
入力モダリティに画像を含み、視覚的理解に対応 |
| ドキュメントと長尺動画の分析 | テキスト + 動画 | qwen3.8-flash、glm-5.3-flash、gemini-3.8-flash |
入力モダリティに動画を含む。qwen のモデルページでは、このような大量処理シナリオが名指しで挙げられている |
| 音声を含む入力 | テキスト + 音声 | gemini-3.8-flash |
数ある中で音声入力を明記しているのはこのモデルのページだけ |
| 数式、証明、長い思考連鎖を要する技術作業 | 重い推論 | claude-opus-5-5 → claude-fable-5-2 |
Flash モデル4種のページはいずれも科学計算を専門分野として明記していない |
コーディングタスクにおける Flash モデルの選択
入力がコードとテキストによる説明だけであれば、モダリティが合致するのは deepseek-v4-flash です。そのモデルページには「284B 総パラメータ、13B アクティベーションの MoE、高並列・低遅延が主眼」と記載されています。これはモデルページの記述であり、本記事での実測データではありません。chat と messages の両エンドポイントに対応しているため、Anthropic スタイルのクライアントに接続する際の変更が最小で済みます。なお、構造化出力の欄は「非対応」となっているため、JSON Schema で出力を制約したい場合は別途対応が必要です。
コーディングタスクにスクリーンショットが付く場合、たとえば「このデザインカンプどおりにフロントエンドを修正して」といったケースでは、マルチモーダルな Flash に切り替える必要があります。qwen3.8-flash のモデルページには「視覚的なコーディングやドキュメント、長尺動画の分析といった大量処理シナリオに適する」と記載されています。glm-5.3-flash のモデルページには、320B 総パラメータ、18B アクティベーション、Terminal-Bench 2.1 のスコア 84.3 と記載されています。これらの数値はいずれもモデルページの記述であり、本記事での実測ではなく、他モデルをあらゆる面で上回るという意味でもありません。
画像閲覧と長尺動画向けFlashモデルの選択
グラフの読み取り、PDFスクリーンショットの解析、長尺動画の分析——3つのマルチモーダルFlashはいずれも必要なモダリティに対応しています。違いは主にエンドポイントと機能欄にあります。gemini-3.8-flash は音声入力とコード実行を追加でサポートし、geminiエンドポイントも利用できます。一方、qwen3.8-flash と glm-5.3-flash はchatエンドポイントのみです。gemini-3.8-flash と glm-5.3-flash では深い思考がデフォルトで有効になっているため、レイテンシに敏感な大量処理タスクではこの点に注意してください。
重い推論タスクではFlashモデルをデフォルトにしない
ここで境界を明確にしておきます。Flashが計算をまったくできないわけではありません。ただし、4つのモデルページはいずれも科学計算・証明・物理を専門分野として明記していないため、こうしたタスクをデフォルトで任せるべきではありません。Anthropicは2026-11-09の発表で、Claude Fable 5.2を最も難易度の高い技術作業に位置づけ、多くのコーディングや知識タスクはOpus 5.5から始め、不足する場合にFableへ上げることを推奨しています。
2モデルはすでにAPIYIで提供されており、モデルIDはそれぞれ claude-opus-5-5 と claude-fable-5-2 です。これらの価格設定はFlashクラスより明らかに高いため、より合理的なのは振り分けです。大量処理タスクはFlash、数式の導出・証明・長い連鎖の技術分析のみ上位モデルに切り替えます。
Flash モデルのクイックスタート
モデルを決めたら、接続手順はとてもシンプルです。APIYI は OpenAI 互換のインターフェースを提供しており、1 つの APIキーで上記のすべてのモデルを呼び出せます。以下ではヘルプドキュメントの形式に沿って、設定の要点をまとめます。
ステップ 1:Flash モデルの base_url とエンドポイントを設定する
- クライアント側で base_url を
https://api.apiyi.com/v1に設定し、APIキーにはコンソールで作成したトークンを入力します。 - モデルに応じてパスを選択します。すべてのモデルは
/v1/chat/completionsを利用できます。deepseek-v4-flash(および総合表に記載のdeepseek-v4.1-flash)のみ/v1/messagesを利用できます。gemini-3.8-flashはさらに gemini エンドポイントも利用できます。 - リクエストボディの
modelフィールドにモデル ID を入力します。たとえばqwen3.8-flashです。
ステップ 2:入力モダリティに応じて Flash モデルのリクエストを組み立てる
- テキストのみ:
messagesにroleとテキストのcontentを入れるだけで、deepseek-v4-flashに利用できます。 - 画像付き:chat 形式では
contentを配列として書き、テキスト項目はtypeをtext、画像項目はtypeをimage_urlにします。画像入力に対応したモデルにのみ送信してください。 - ストリーミングを有効化:
streamをtrueに設定します。高い並行処理が求められ、最初のトークンを素早く返したいシナリオに適しています。
ステップ 3:Flash モデルを切り替える前のチェックリスト
- 新しいモデルは、現在使用しているエンドポイントに対応していますか?messages を使っているユーザーがマルチモーダル Flash に切り替える場合は、必ず chat に変更する必要があります。
- 新しいモデルは、依存している機能に対応していますか?たとえば構造化出力は
deepseek-v4-flashでは非対応と記載されています。 - 現在のトークングループでは、新しいモデルの倍率はいくつですか?
🚀 クイックスタート:まず APIYI apiyi.com の新規ユーザー向け無料テスト枠を利用し、同じ実際の入力データを 2〜3 の候補 Flash モデルにそれぞれ送信して、出力品質とトークン使用量を比較したうえで、正式な切り替えを判断することをおすすめします。
modelフィールドを変更するだけで、異なるモデル間を切り替えられます。
よくある質問 FAQ
Q1: Flash モデルとはどういう意味ですか?
Flash は、ベンダーが大量処理向け・低遅延向けのモデル階層に付けた名前であり、統一された標準ではありません。ベンダーごとに Flash の入力モダリティ、エンドポイント、機能サポートは大きく異なります。選定の際はモデルページを確認すべきで、名前だけで判断することはできません。
Q2: deepseek-v4-flash と deepseek-v4.1-flash は相互に置き換えできますか?
そのまま仮定することはできません。v4.1 は現時点では総表の 1 行のみで、入力 $0.3、出力 $1.2、キャッシュ読み取り $0.006、エンドポイントは chat と messages です。v4 のパラメータ数、コンテキスト、「テキストのみ」といった性質を v4.1 に当てはめることはできません。置き換える前に、総表および今後のモデル説明を基準にしてください。
Q3: なぜ私の Claude スタイルのクライアントで gemini-3.8-flash が呼び出せないのですか?
`gemini-3.8-flash` のエンドポイントは chat と gemini であり、messages はありません。`qwen3.8-flash` と `glm-5.3-flash` も chat のみです。messages エンドポイントが必要な場合、候補は deepseek 系の Flash だけになります。
Q4: 同じモデルなのに、なぜトークンごとに課金が異なるのですか?
グループ倍率が異なるためです。たとえば `gemini-3.8-flash` は Gemini_Reverse グループでは 0.5×、Default では 1× です。トークンとグループの関係については、APIYI のドキュメント docs.apiyi.com/faq/token-and-groups.md を参照してください。
Q5: これらの Flash モデルを API 経由で素早く呼び出すにはどうすればよいですか?
APIYI apiyi.com で登録してトークンを作成し、base_url を `https://api.apiyi.com/v1` に設定します。モデルに応じて chat または messages のパスを選び、`model` に対応する ID を入力すれば完了です。新規ユーザーには無料テスト枠があるので、まず小規模に検証できます。
Q6: Flash モデルは数学的推論や科学計算に使えますか?
一般的な計算は処理できますが、いくつかのモデルページでは科学計算・証明・物理を専門分野として明記していません。数式、証明、長い工程を伴う技術的な作業には `claude-opus-5-5` から始め、不足であれば `claude-fable-5-2` にアップグレードすることをお勧めします。
Q7: モデルページの Terminal-Bench スコアは、そのまま選定の根拠にできますか?
`glm-5.3-flash` のモデルページ原文には Terminal-Bench 2.1 で 84.3 点と記載されていますが、これはモデルページの原文であり、本記事での実測値ではありません。参考シグナルとしては活用できますが、そのモデルがすべてのタスクでより優れているわけではありません。最終的には自分の実際のデータで検証することをお勧めします。
Flashモデル選定の重要なポイント
- 名前は能力とイコールではない:Flashという名前を含むモデルでも、入力モダリティとエンドポイントはそれぞれ異なります。
- まずモダリティを確認:テキストのみなら
deepseek-v4-flash、画像や動画を扱うならマルチモーダルFlashを選びます。 - 次にエンドポイントを確認:
messagesは deepseek 系のみ対応しており、マルチモーダルFlashの多くはchatのみです。 - 最後に料金と照らし合わせる:入力価格・出力価格・キャッシュ読み込みをまとめて確認し、さらにグループ倍率を掛けて計算します。
- モデルページの数字は出典を明記:パラメータ数、Terminal-Bench、「視覚コーディングに適している」はいずれもモデルページの原文です。
- 重い推論ではFlashをデフォルトにしない:数式の証明は
claude-opus-5-5から始め、不足ならclaude-fable-5-2に上げます。 - 切り替え前に小ロットで検証:APIYI の無料枠で実際の入力を流し、それから本番切り替えを決めます。
まとめ
Flashモデルの選び方を一言でいえば、入力モダリティで合わせるのであって、名前で一律に決めるのではない、ということです。
- まずモデルページを見る:入力の種類、エンドポイント、機能サポートを確認し、条件が合わないモデルを除外します。
- 次に価格を突き合わせる:入力価格・出力価格・キャッシュ読み込みを、自分の呼び出し比率と組み合わせて見て、さらにトークングループ倍率を掛けます。
- タスク別に振り分ける:大量にこなすグラフ読み取りや短いコード修正は、モダリティが合うFlashに任せ、重い推論タスクは Claude Opus 5.5 または Fable 5.2 に任せます。
価格も能力も更新されるため、選定時はその日のモデルページを基準にしてください。APIYI apiyi.com で同じAPIキーを使い、候補となる数モデルを小ロットで比較したうえで、自分の請求額と出力品質を見て判断することをおすすめします。
📚 参考資料
-
Anthropic の発表 – Claude Fable と Mythos 5.2:Fable 5.2 の位置づけと、Opus 5.5 を起点とした利用のヒント
- リンク:
anthropic.com/claude-fable-and-mythos-5-2 - 説明: 高度な推論が求められるタスクにおけるモデル分担の根拠を理解するための資料
- リンク:
-
Claude モデル概要:Anthropic 公式のモデル一覧と使用方法の説明
- リンク:
platform.claude.com/docs/en/about-claude/models/overview - 説明: 発表内容と一致する Opus および Fable の利用方法のヒント
- リンク:
-
APIYI のモデル一覧と各モデルページ:料金、グループ、エンドポイント、入力モダリティ
- リンク: ドキュメントセンターの models.md および各モデルページ(deepseek-v4-flash、gemini-3-8-flash、qwen3-8-flash、glm-5-3-flash)
- 説明: 本記事で紹介するすべての料金・機能データの出典です。モデルを選ぶ際は最新版を基準にしてください
著者: APIYI 技術チーム
技術交流: APIYI のウェブサイトのトップページからお気軽にお問い合わせください。その他のモデルやグループの説明については、docs.apiyi.com のドキュメントセンターをご覧ください