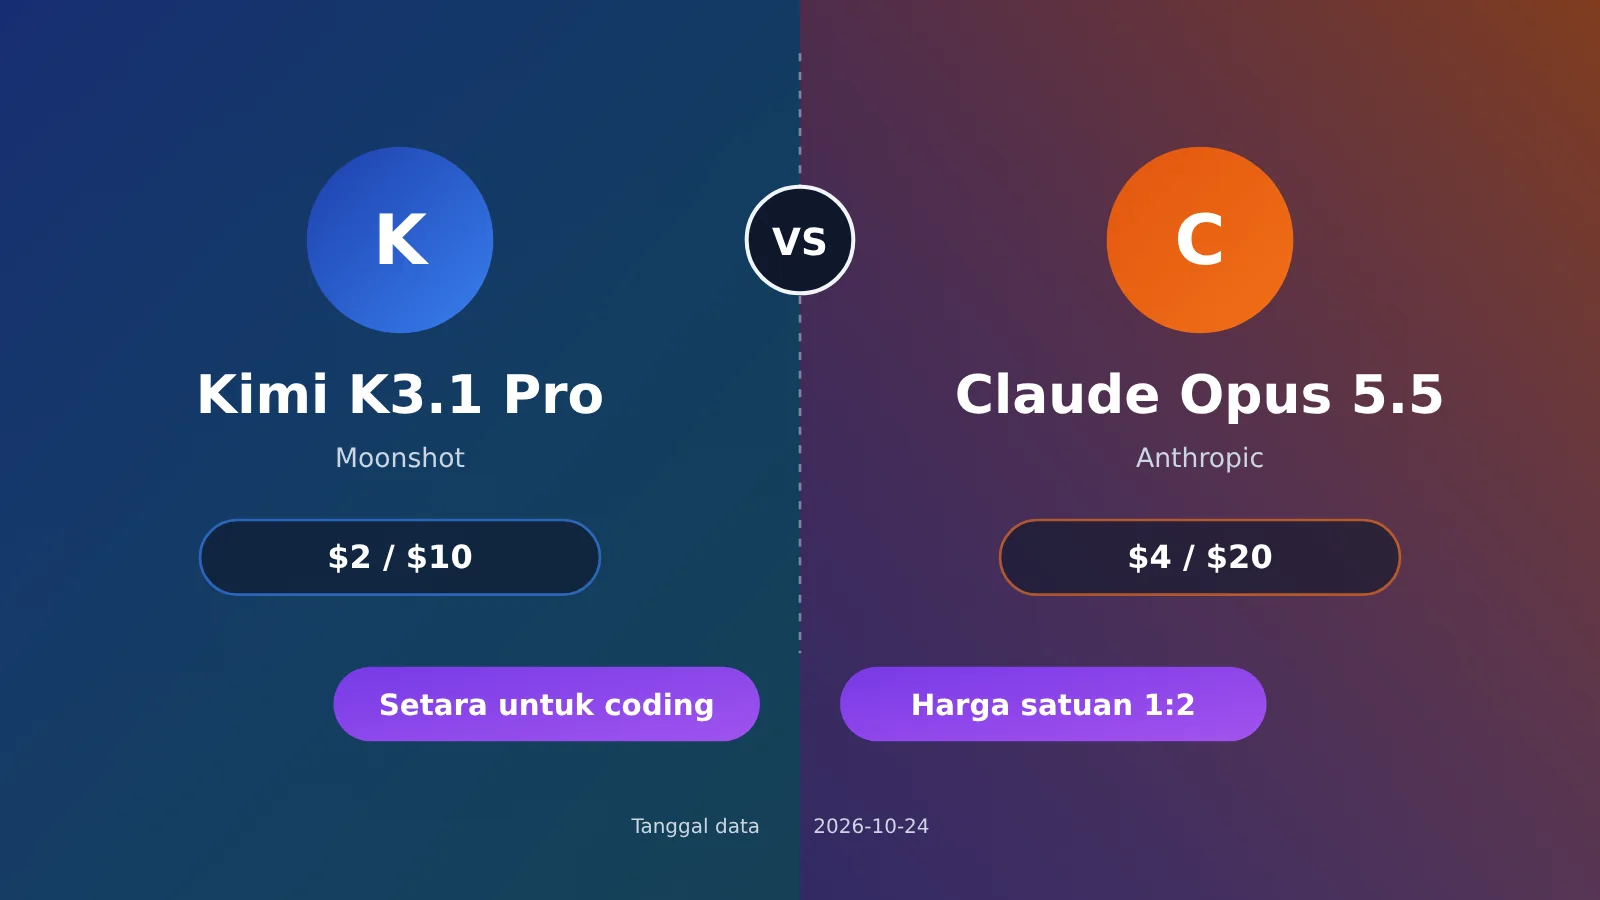
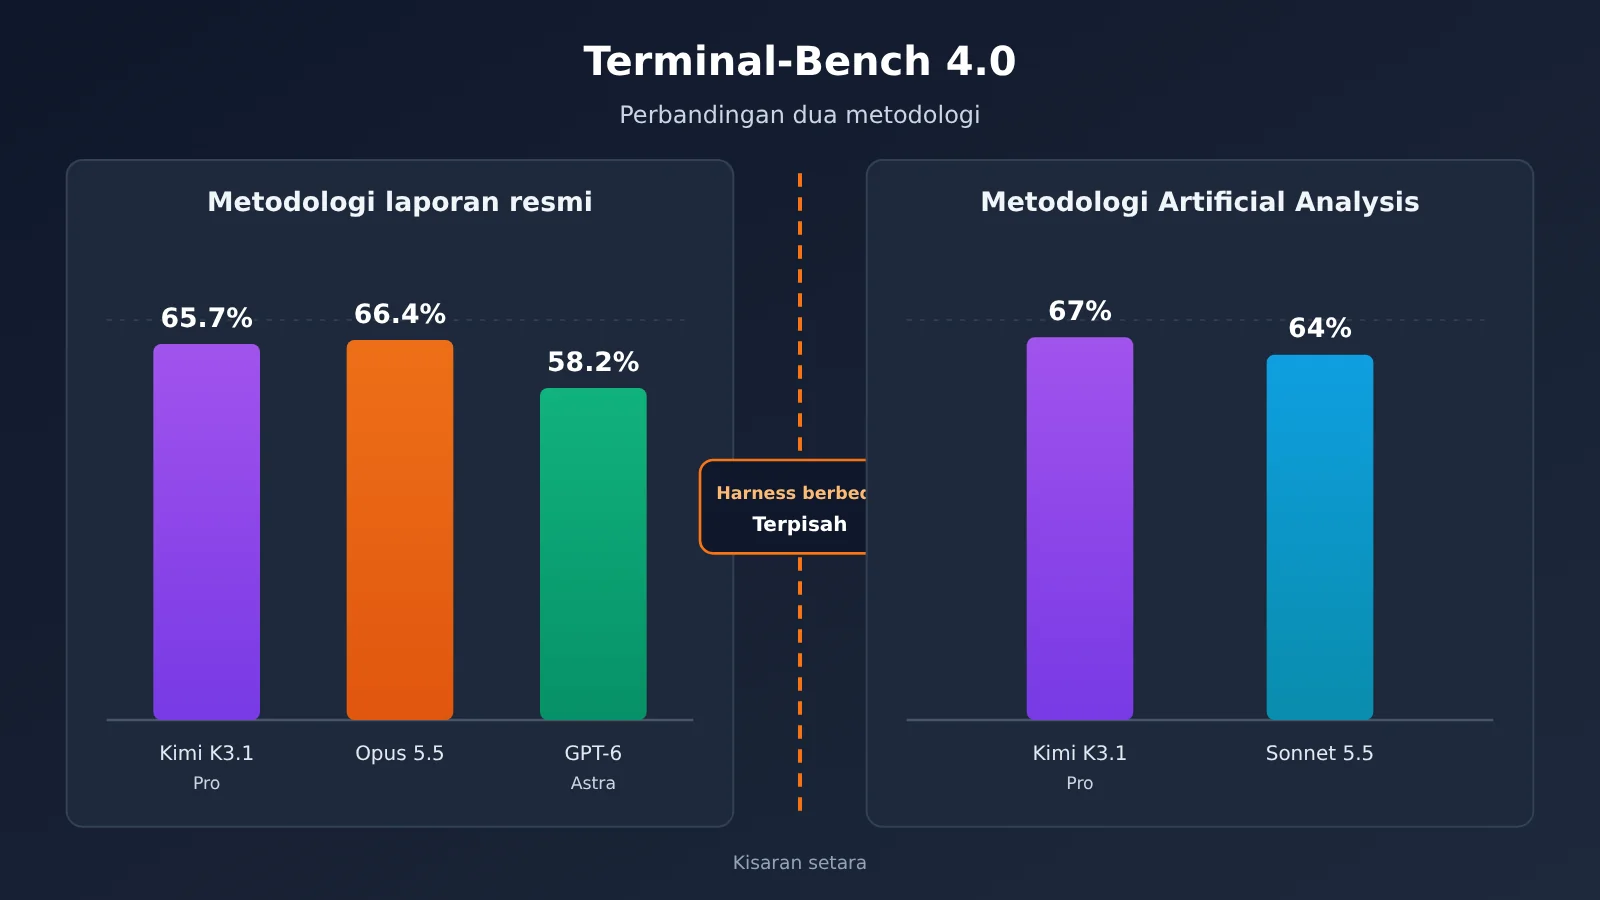
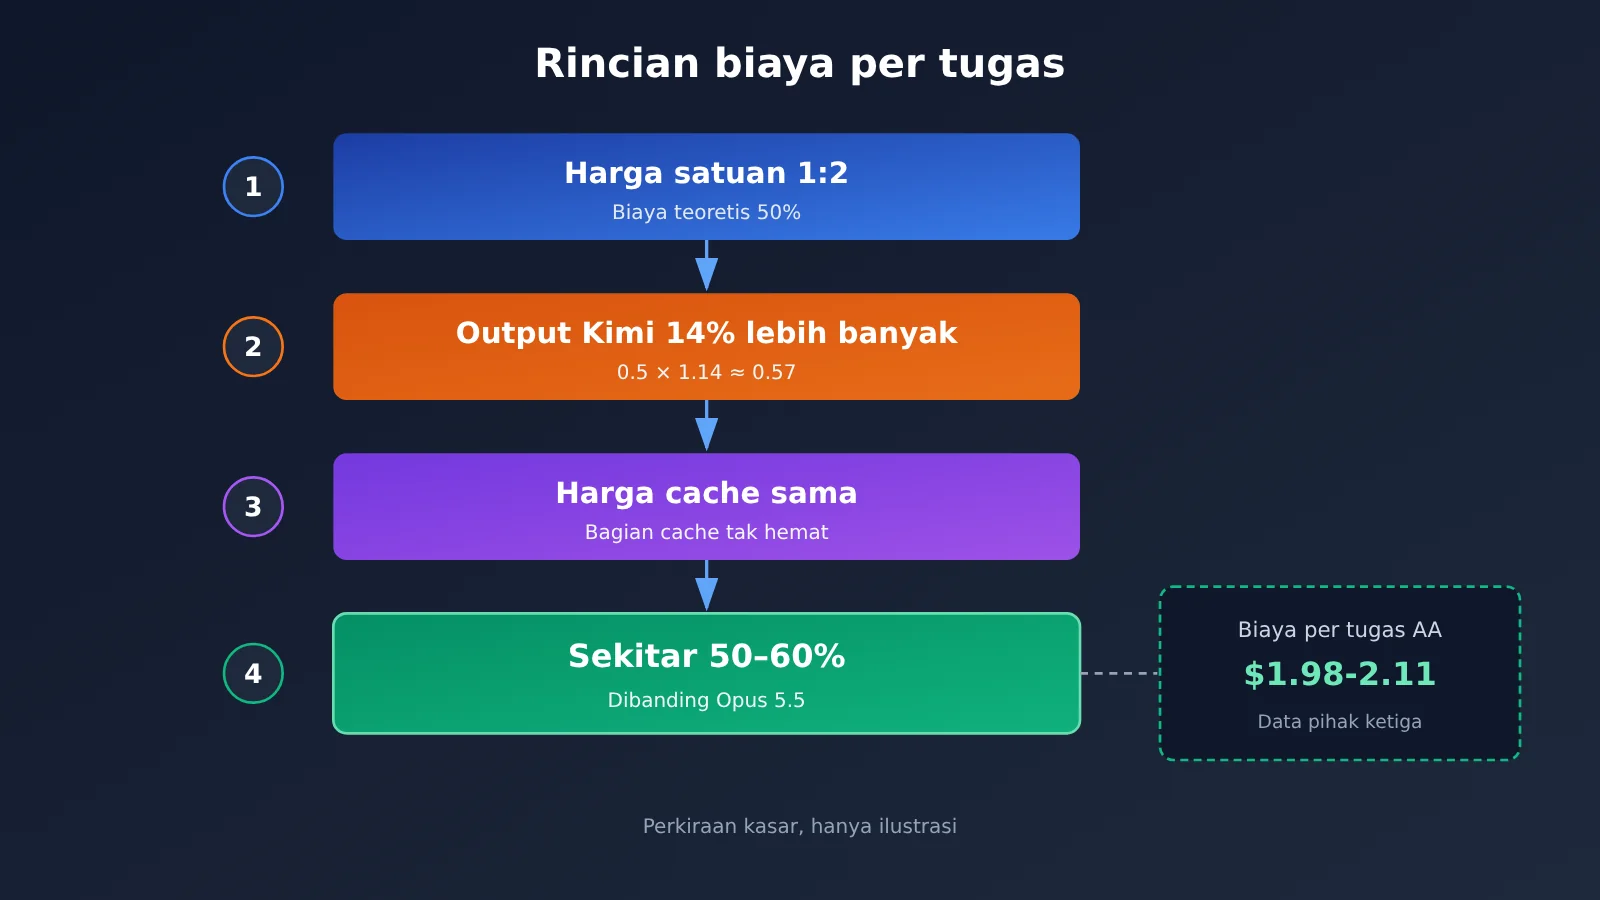
Kesimpulannya: kemampuan pemrograman Kimi K3.1 Pro dan Claude Opus 5.5 berada di kelas yang sama. Dalam hasil Terminal-Bench 4.0 yang dilaporkan sendiri oleh Moonshot, K3.1 Pro meraih 65,7%, sementara Opus 5.5 mencapai 66,4%. Artinya, K3.1 Pro tertinggal sekitar 0,7 poin persentase. Namun, jika hanya melihat Terminal-Bench 4.0 dari Artificial Analysis, K3.1 Pro justru mendapat skor tertinggi. Dari sisi harga, tarif input dan output K3.1 Pro tepat setengah dari Opus 5.5 ($2/$10 dibandingkan $4/$20), sedangkan harga saat cache hit sama. Meski begitu, proses penalaran K3.1 Pro lebih panjang. Menurut perhitungan pihak ketiga, biaya aktual per tugas tidak sampai setengah lebih murah.
Semua data di bawah ini disertai sumber dan dibagi menjadi tiga kategori: laporan resmi (blog Moonshot serta dokumentasi resmi Kimi dan Anthropic), pihak ketiga (Artificial Analysis, selanjutnya disebut AA), dan belum terverifikasi (belum ada data publik saat ini, jadi hanya bisa memberikan gambaran umum). Token bisa dipahami sebagai “satuan teks” yang digunakan model untuk menghitung biaya. Satu karakter Han kira-kira setara dengan sedikit lebih dari 1 token. Semua harga dihitung dalam dolar AS per satu juta token.
Artikel ini tidak akan menyimpulkan bahwa satu model mengalahkan yang lain telak. Kedua model punya kelebihan dan kekurangan masing-masing. Kami hanya akan menyajikan data dengan dasar pengukuran yang jelas, lalu memberikan rekomendasi sesuai skenario penggunaan.
Manfaat utama: Setelah membaca artikel ini, Anda bisa menentukan apakah tugas Anda lebih cocok dikerjakan dengan Kimi K3.1 Pro atau Claude Opus 5.5, sekaligus memahami seberapa besar perbedaan biaya sebenarnya.
1. Sekilas Perbedaan Utama Kimi K3.1 Pro vs Claude Opus 5.5
Kita mulai dengan tabel yang merangkum perbedaan paling penting. Bagian-bagian selanjutnya akan membahasnya satu per satu. Kolom “Tingkat sumber” menunjukkan asal setiap angka, sehingga Anda bisa memeriksanya sendiri.
| Aspek perbandingan | Kimi K3.1 Pro | Claude Opus 5.5 | Tingkat sumber |
|---|---|---|---|
| Terminal-Bench 4.0 (klaim resmi) | 65.7% | 66.4% | Dilaporkan oleh pihak resmi (blog Moonshot) |
| Terminal-Bench 4.0 (versi AA) | 67%, tertinggi di antara model yang diuji AA | Tidak tercantum dalam referensi | Pihak ketiga (AA) |
| Harga input / output | $2 / $10 | $4 / $20 | Harga resmi |
| Harga saat cache cocok | $0.20 | $0.20 | Harga resmi |
| Panjang konteks | 1,048,576 token | Hingga 1 juta (bervariasi menurut model) | Dokumentasi resmi |
| Apakah mode berpikir bisa dinonaktifkan? | Tidak, hanya intensitasnya yang bisa diatur | Mengacu pada dokumentasi Anthropic | Dokumentasi resmi / belum diverifikasi |
| Bobot terbuka | Berkomitmen untuk merilisnya sebelum 2026-11-04 | Tidak dibuka | Klaim resmi |
“Jendela konteks” adalah jumlah total konten yang bisa dibaca model dalam satu kali proses. Kedua model memiliki kapasitas sekitar satu juta token, sehingga hampir seluruh repositori kode berukuran menengah bisa dimasukkan sekaligus. Karena itu, aspek ini bukan perbedaan utama dalam menentukan pilihan.
2. Perbandingan Harga Kimi K3.1 Pro vs Claude Opus 5.5: Perbandingan 5 Tarif
Pertama, mari jelaskan dua istilah penagihan. Cache hit: jika Anda berulang kali mengirim bagian awal yang sama, seperti petunjuk sistem atau ringkasan repositori kode, penyedia model akan menyimpannya. Saat dibaca lagi, biayanya jauh lebih murah. Penulisan cache: biaya yang dikenakan saat konten tersebut pertama kali disimpan ke cache. Tarif penyimpanan selama 5 menit dan 1 jam berbeda.
| Model | Input | Output | Cache hit | Penulisan cache 5 menit | Penulisan cache 1 jam |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5 (pembanding) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
Keterangan harga: diambil pada 2026-10-24, dalam dolar AS per juta token, belum termasuk pajak. Sumber: daftar harga resmi Kimi dan Anthropic.
2.1 Selisih harga: input dan output 2 kali lipat, cache hit sama
Untuk input dan output, harga Opus 5.5 tepat 2 kali lipat harga K3.1 Pro. Harga cache hit kedua model sama-sama $0.20. Untuk penulisan cache, Kimi lebih murah: tarif 5 menit sebesar $2 dibandingkan $5, dan tarif 1 jam sebesar $4 dibandingkan $8.
Jika Claude Sonnet 5.5 dijadikan pembanding, harga input dan outputnya ternyata sama persis dengan K3.1 Pro, sementara harga cache hit-nya hanya separuhnya ($0.10). Jadi, jika Anda hanya mencari “model kelas flagship dengan harga lebih terjangkau”, pembanding langsung Kimi sebenarnya adalah Sonnet 5.5, bukan hanya Opus 5.5.
2.2 Kedua model punya versi berkecepatan tinggi
Keduanya menawarkan versi yang lebih cepat dengan harga lebih tinggi. Saat memilih model, pastikan Anda membandingkan versi yang tepat:
kimi-k3.1-pro-highspeed: $4 / $20, cache hit $0.20, penulisan cache 5 menit $4, penulisan cache 1 jam $8 (harga resmi)- Mode Claude Opus 5.5 Fast: $8 / $40, berlaku untuk seluruh panjang konteks, termasuk bagian yang melebihi 200k (harga resmi)
Terlihat bahwa harga input dan output Kimi versi berkecepatan tinggi sama dengan Opus 5.5 versi reguler, tetapi biaya penulisan cache 5 menitnya tetap lebih murah.
3. Skor pemrograman Kimi K3.1 Pro vs Claude Opus 5.5: dua metode pengukuran yang perlu dilihat terpisah
Terminal-Bench 4.0 adalah rangkaian pengujian untuk menyelesaikan tugas nyata melalui terminal, seperti memasang dependensi, memperbaiki bug, dan menjalankan skrip. Hanya hasil akhir yang benar yang dihitung lulus. Dua tabel di bawah ini berasal dari dua lembaga berbeda, jadi angkanya tidak bisa dibandingkan satu sama lain.
3.1 Metode pelaporan resmi (blog Moonshot)
| Item pengujian | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD (rekonstruksi 3D dari kode CAD yang dibuat berdasarkan beberapa tampilan) | 92.7% (dengan alat) | 96.2% | — |
Pengujian dilakukan dengan reasoning_effort disetel ke max (artinya, intensitas penalaran disetel ke tingkat tertinggi), dan K3.1 Pro dijalankan menggunakan harness Claude Code. Dalam blognya, Moonshot menyebut K3.1 Pro “sedikit tertinggal dari Claude Opus 5.5”.
3.2 Acuan pihak ketiga (Artificial Analysis, 2026-10-23)
| Item pengujian | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index (indeks kecerdasan keseluruhan) | 55 (peringkat 4) | 58 | 56 |
| Terminal-Bench 4.0 | 67% (tertinggi secara keseluruhan) | Tidak tercantum dalam referensi | 64% |
| GDPval-AA (Elo) | 1846 (peringkat 3) | 1866 | — |
| AA-Omniscience (keandalan pengetahuan) | Indeks 30, tingkat halusinasi 44% | Tidak tercantum dalam referensi | — |
Pengujian indeks keseluruhan Opus 5.5 menggunakan kondisi “max with fallback”. Muse Wonder Full yang berada di peringkat yang sama juga mendapat skor 56. Elo adalah sistem penilaian seperti yang digunakan dalam permainan catur, yang dihitung berdasarkan hasil menang atau kalah dalam perbandingan berpasangan. Semakin tinggi skornya, semakin baik. Tingkat halusinasi secara sederhana menunjukkan seberapa sering model mengarang jawaban ketika tidak tahu jawabannya. Tingkat 44% pada K3.1 Pro patut diperhatikan.
3.3 Mengapa hasil dari dua acuan ini tidak bisa digabungkan
Skor K3.1 Pro pada Terminal-Bench 4.0 adalah 65,7% menurut acuan resmi dan 67% menurut AA, tetapi keduanya menggunakan harness yang berbeda. Harness bisa dipahami sebagai “program pembungkus untuk menguji model” yang menentukan alat apa saja yang bisa digunakan model, bagaimana model membaca dan menulis file, serta berapa lama batas waktunya. Jika program pembungkusnya berbeda, skor model yang sama juga bisa berubah.
Jadi, kita tidak bisa mengatakan, “K3.1 Pro mendapat 67% di AA, lebih tinggi daripada 66,4% yang diberikan acuan resmi kepada Opus.” Cara membaca yang tepat: menurut acuan resmi, skor K3.1 Pro lebih rendah 0,7 poin persentase; menurut acuan AA, K3.1 Pro adalah model dengan skor tertinggi di antara model-model yang telah diuji lembaga tersebut. Kedua kesimpulan itu sama-sama valid. Jika dibandingkan, keduanya hanya menunjukkan bahwa kedua model berada di kisaran yang sama.
3.4 Apa arti selisih 1 poin dalam pengembangan sehari-hari?
Terminal-Bench 4.0 menggunakan penilaian ketat per tugas: hasilnya hanya lulus atau tidak lulus. Selisih 1 poin persentase kira-kira berarti satu soal lebih banyak atau lebih sedikit yang berhasil dijawab dari setiap seratus soal. Selisih ini biasanya muncul pada tugas-tugas langka, misalnya penggunaan toolchain yang jarang dipakai atau konfigurasi lingkungan khusus. Saat menulis endpoint, mengubah kode bisnis, atau menambahkan unit test dalam pekerjaan sehari-hari, selisih sekecil ini hampir tidak terasa.
Yang benar-benar memengaruhi pengalaman pengembangan adalah dua perbedaan “karakter”. Pertama, gaya berpikir: K3.1 Pro selalu menggunakan mode berpikir. AA mengamati bahwa keluarannya untuk setiap tugas lebih panjang (pihak ketiga). Kedua, kebiasaan menggunakan tool, misalnya seberapa sering model menjalankan perintah atau apakah model cenderung membaca file sebelum mengubahnya. Saat ini belum ada data perbandingan publik yang tepercaya untuk hal ini (belum terverifikasi), jadi sebaiknya uji beberapa tugas nyata di repositori Anda sendiri.
4. Kelebihan dan kekurangan Kimi K3.1 Pro dan Claude Opus 5.5
Kelebihan Kimi K3.1 Pro (dokumentasi resmi):
- Harga input dan output per token setengah dari Opus 5.5; biaya penulisan cache juga lebih murah
- Konteks 1.048.576 token, dengan nilai default
max_completion_tokenssebesar 131072 dan maksimum 1048576 - Kompatibel dengan format API OpenAI dan Anthropic. Dokumentasi resmi merekomendasikannya untuk agen pemrograman seperti Kimi Code, Codex, dan Claude Code
- Mendukung output terstruktur, pemanggilan tool, dan kelanjutan
partial. Pelanggan API dapat memilih retensi data nol, dan pihak resmi berkomitmen untuk merilis bobot lengkap sebelum 2026-11-04
Keterbatasan Kimi K3.1 Pro (dokumentasi resmi + pihak ketiga):
- Mode berpikir tidak bisa dinonaktifkan.
reasoning_efforthanya dapat diatur kelow/high/max, dengan nilai defaultmax temperatureselalu 1.0 dantop_pselalu 0.95; parameter ini tidak dapat diatur sendiri- Input gambar tidak mendukung URL publik. Gambar hanya bisa dikirim dalam bentuk enkode base64 (mengubah gambar menjadi rangkaian teks panjang) atau
ms://file-id - AA mengukur tingkat halusinasi sebesar 44%, dan keluaran per tugas cenderung panjang
Kelebihan Claude Opus 5.5: unggul dalam skor resmi dan indeks gabungan AA, memimpin BenchCAD sekitar 3,5 poin persentase, dan memperoleh skor GDPval-AA yang lebih tinggi. Model ini menyediakan cache selama 1 jam dan mode Fast, sehingga Anda bisa menyesuaikan kecepatan dan biaya sesuai kebutuhan. Keterbatasan utamanya adalah harga: biaya input dan outputnya 2 kali lipat K3.1 Pro, sedangkan mode Fast membuatnya 2 kali lipat lebih mahal lagi.
5. Rekomendasi Kimi K3.1 Pro vs Claude Opus 5.5 berdasarkan skenario: cara memilih untuk 6 jenis tugas
“Agent” adalah aplikasi model yang dapat merencanakan langkah sendiri, menggunakan alat, dan menjalankan tugas dalam beberapa putaran. Contohnya, asisten pemrograman yang otomatis mengubah kode lalu menjalankan pengujian.
| Jenis tugas | Rekomendasi | Kesimpulan singkat |
|---|---|---|
| Tugas offline dalam jumlah besar | Kimi K3.1 Pro | Harganya setengah lebih murah, dan biaya penulisan cache juga lebih rendah. Penghematan paling terasa saat menjalankan tugas secara batch |
| Agent pemrograman dengan banyak putaran | Keduanya bisa; sebaiknya uji langsung | Skor benchmark keduanya setara. Pilihan utama bergantung pada panjang proses berpikir dan kebiasaan penggunaan alat yang cocok untuk repositori Anda |
| Pembuatan kode 3D / CAD | Claude Opus 5.5 | Berdasarkan hasil BenchCAD yang dilaporkan sendiri oleh pihak resminya, skornya 96,2% dibanding 92,7%; Opus 5.5 lebih andal |
| Pemahaman gambar | Pilih berdasarkan cara integrasi | K3.1 Pro mendukung gambar, tetapi tidak bisa menerima URL publik secara langsung. Data dengan metode pengujian yang sebanding untuk kemampuan gambar keduanya masih belum tersedia (belum terverifikasi) |
| Skenario perusahaan yang menuntut stabilitas dan kepatuhan | Cenderung ke Claude Opus 5.5; Kimi bisa dipertimbangkan jika perlu mengendalikan data | Indeks keseluruhan Opus 5.5 lebih tinggi. Kimi menawarkan retensi data nol dan akan segera membuka bobot modelnya |
| Skenario latensi rendah yang perlu menonaktifkan proses berpikir | Pilih Claude | Proses berpikir K3.1 Pro tidak bisa dinonaktifkan. Untuk pengaturan proses berpikir Claude, ikuti dokumentasi Anthropic; Fast Mode juga bisa dipertimbangkan |
6. Perhitungan biaya Kimi K3.1 Pro vs Claude Opus 5.5: harga per token setengah bukan berarti biaya total juga setengah
Mari hitung sederhana: untuk satu permintaan yang sama, input 50 ribu token dan output 5 ribu token.
- Kimi K3.1 Pro: 50 ribu × $2 ÷ 1 juta + 5 ribu × $10 ÷ 1 juta = $0,10 + $0,05 = $0,15
- Claude Opus 5.5: 50 ribu × $4 ÷ 1 juta + 5 ribu × $20 ÷ 1 juta = $0,20 + $0,10 = $0,30
Berdasarkan harga per token, biayanya tepat setengah. Namun, perhitungan ini mengasumsikan output kedua model sama panjang. Kenyataannya tidak begitu. Data AA menunjukkan bahwa output Kimi untuk setiap tugas sekitar 14% lebih banyak tokennya, dengan rata-rata sekitar 55 ribu token output per tugas. Biaya per tugasnya sekitar $1,98 (di halaman model tercantum $2,11) (sumber pihak ketiga). Kesimpulan AA: meski harga per token Kimi hanya setengah dari Opus 5.5, proses berpikirnya lebih bertele-tele, sehingga biaya aktual per tugas tidak sampai setengahnya.
Perkiraan kasar (belum diverifikasi, hanya sebagai ilustrasi): biaya tugas coding Agent terutama berasal dari output. Jika output Kimi 14% lebih banyak, biaya bagian output kira-kira 1,14 × 0,5 ≈ 57% dari Opus 5.5. Artinya, penghematannya lebih dari 40%, bukan 50%. Penghematan lebih dari 40% tentu tetap besar, tetapi jangan gunakan angka 50% saat menyusun anggaran.
7. Cara menggunakan Kimi K3.1 Pro dan Claude Opus 5.5 di Indonesia
Developer di Indonesia yang terhubung langsung ke API resmi luar negeri sering menghadapi kendala pembayaran dan jaringan. APIYI (apiyi.com) adalah platform agregasi API yang memungkinkan Anda menggunakan berbagai model dengan satu kunci API. Format antarmukanya kompatibel dengan OpenAI dan biayanya dihitung berdasarkan pemakaian. Berdasarkan pengecekan pada 2026-10-24, harga claude-opus-5-5 di platform adalah $4 untuk input, $20 untuk output, dan $0.2 untuk pembacaan cache. Sementara itu, harga claude-sonnet-5-5 adalah $2 / $10 / $0.1. Keduanya sama dengan harga resmi Anthropic. Model Kimi yang saat ini sudah tersedia meliputi:
kimi-k3: $3 / $15, pembacaan cache $0.3kimi-k2.7-code: $0.95 / $3.99kimi-k2.6: $0.6 / $2.4kimi-k2.5: $0.6 / $3.15
Pada hari itu, kimi-k3.1-pro belum tersedia di daftar. Nama model dan harganya di APIYI dapat dilihat di daftar model platform. Kami akan segera menghadirkan model ini. Berikut cara menghubungkannya:
- Format kompatibel dengan OpenAI: isi
base_urldenganhttps://api.apiyi.com/v1 - Format Anthropic: isi alamat dasar dengan
https://api.apiyi.com - Agen pemrograman seperti Claude Code biasanya menggunakan format Anthropic, sedangkan SDK biasa menggunakan format OpenAI
Saran untuk memulai dengan cepat: Anda bisa mencoba kuota gratis untuk pengguna baru di APIYI apiyi.com. Jalankan beberapa tugas nyata di repositori Anda menggunakan
claude-opus-5-5danclaude-sonnet-5-5sebagai tolok ukur perbandingan. Nama dan harga model dapat dilihat di daftar model platform. Kami akan segera menghadirkan Kimi K3.1 Pro; setelah tersedia, Anda bisa langsung membandingkannya dengan mengganti nama model.
8. Rekomendasi memilih Kimi K3.1 Pro vs Claude Opus 5.5
Jika volume tugas Anda tinggi, anggaran terbatas, dan Anda tidak keberatan model terus berpikir, Kimi K3.1 Pro menawarkan nilai yang lebih baik. Jika Anda mengutamakan stabilitas secara keseluruhan, perlu membuat 3D/CAD, atau ingin menonaktifkan proses berpikir untuk mengurangi latensi, model dari Claude (Opus 5.5 atau Sonnet 5.5) lebih cocok. Untuk tugas seperti pemrograman dengan Agent dalam beberapa putaran, skor keduanya berada di kelas yang sama. Daripada terpaku pada peringkat, lebih baik uji langsung dengan basis kode Anda sendiri selama seminggu.
Ada juga opsi yang mudah terlewat: jika alasan utama Anda mempertimbangkan Kimi adalah harganya yang “setengah lebih murah”, harga input dan output Claude Sonnet 5.5 ternyata sama persis, harga saat cache digunakan lebih rendah, dan indeks keseluruhan AA juga sedikit lebih tinggi. Model ini layak dipertimbangkan sebagai pilihan.
Pertanyaan umum (FAQ)
Q1: Seberapa jauh perbedaan kemampuan pemrograman Kimi K3.1 Pro dan Claude Opus 5.5?
Menurut laporan Moonshot, pada Terminal-Bench 4.0, skor K3.1 Pro tertinggal 0,7 poin persentase (65,7% dibanding 66,4%). Namun, dalam pengujian pihak ketiga oleh AA, K3.1 Pro meraih skor tertinggi di antara semua model yang diuji pada Terminal-Bench 4.0. Keduanya berada di kelas yang sama, dengan selisih sekitar 1–3 poin persentase.
Q2: Berapa kali lipat perbedaan harganya?
Harga satuan input dan output berbeda 2 kali lipat, sedangkan harga saat cache digunakan sama (keduanya $0,20). Biaya penulisan cache Kimi lebih murah. Karena keluaran Kimi lebih panjang, biaya per tugas dalam praktiknya diperkirakan sekitar 50–60% dari biaya Opus 5.5.
Q3: Mengapa skor resmi 65,7% berbeda dari skor AA sebesar 67%?
Keduanya menggunakan harness pengujian yang berbeda. Pihak resmi menggunakan Claude Code harness. Skor dari metode pengujian yang berbeda hanya bisa dibandingkan dalam lingkup masing-masing, bukan langsung dibandingkan satu sama lain.
Q4: Bisakah proses berpikir Kimi K3.1 Pro dinonaktifkan?
Tidak bisa. Anda hanya dapat mengatur `reasoning_effort` ke `low`; nilai `temperature` dan `top_p` juga tetap. Untuk kebutuhan latensi yang sangat rendah, sebaiknya pertimbangkan model dari Claude.
Q5: Bagaimana cara menggunakan kedua model ini sekaligus untuk perbandingan di dalam negeri?
Anda dapat menggunakan APIYI apiyi.com untuk memanggil `claude-opus-5-5` dengan satu kunci yang sama. Cukup isi `base_url` dengan `https://api.apiyi.com/v1`. Nama model dan harga Kimi K3.1 Pro mengikuti daftar model di platform. Kami akan segera menyediakan model ini; sementara itu, Anda bisa menggunakan `kimi-k3` untuk perbandingan awal.
Q6: Model mana yang lebih hemat untuk pemula yang ingin mencoba?
Sebaiknya mulai dengan Claude Sonnet 5.5 sebagai patokan karena harga satuannya sama dengan K3.1 Pro. Setelah mendaftar di APIYI apiyi.com, Anda akan mendapatkan kuota uji coba gratis. Nama model dan harga terbaru dapat dilihat di daftar model platform. Kami akan segera menyediakan K3.1 Pro; setelah tersedia, Anda bisa langsung mengganti nama model untuk membandingkannya.
Poin Utama Kimi K3.1 Pro vs Claude Opus 5.5
- Kemampuan pemrograman setara: Menurut data resmi, skor K3.1 Pro lebih rendah 0,7 poin persentase. Menurut pengujian AA, K3.1 Pro meraih skor tertinggi di Terminal-Bench 4.0.
- Harga per token 1:2: $2/$10 dibandingkan $4/$20. Harga untuk token yang cocok dengan cache sama-sama $0,20.
- Biaya tidak turun setengah: Kimi menghasilkan sekitar 14% lebih banyak token output per tugas. AA mengukur biaya per tugas sebesar $1,98–2,11.
- Jangan campur metode pengujian: Skor resmi 65,7% dan skor AA 67% menggunakan harness yang berbeda.
- Keunggulan Opus: Unggul dalam indeks gabungan, BenchCAD, dan GDPval-AA.
- Batasan Kimi: Mode berpikir tidak bisa dimatikan, gambar tidak bisa dikirim melalui URL publik, dan tingkat halusinasinya 44%.
- Cara mencoba: Anda bisa menguji seri Claude terlebih dahulu di APIYI, apiyi.com. Model dan harga K3.1 Pro mengikuti daftar di platform; kami akan segera menghadirkannya.
Ringkasan
Perbandingan Kimi K3.1 Pro dan Claude Opus 5.5 bisa dirangkum dalam tiga poin:
- Kemampuan: Kemampuan pemrograman dan agen keduanya berada di level yang sama. Selisih skor masih dalam rentang galat pengujian dan perbedaan metode pengukuran.
- Harga: Harga per token tepat dua kali berbeda, tetapi karena proses berpikir Kimi lebih panjang, biaya aktualnya diperkirakan lebih hemat sekitar 40%.
- Pemilihan model: Kimi layak dipertimbangkan untuk tugas dalam jumlah besar dan skenario yang sensitif terhadap anggaran. Claude lebih cocok untuk 3D/CAD, latensi rendah, dan kebutuhan akan kestabilan menyeluruh.
Cara paling andal untuk menilai tetap dengan mengujinya pada tugas Anda sendiri. Anda bisa menjalankan seri Claude terlebih dahulu di APIYI, apiyi.com, untuk mendapatkan tolok ukur awal. Model dan harga mengikuti daftar model di platform. Kimi K3.1 Pro akan kami hadirkan sesegera mungkin; setelah tersedia, Anda cukup mengganti nama model untuk membandingkannya.
Referensi
- Blog resmi Moonshot dan dokumentasi API Kimi: skor benchmark, batas parameter, dan harga K3.1 Pro
- Tautan:
platform.moonshot.cn/docs -
Keterangan: Skor Terminal-Bench 4.0 dan BenchCAD serta penjelasan parameter yang dilaporkan secara resmi
-
Harga resmi Anthropic: lima tingkat harga Claude Opus 5.5 / Sonnet 5.5
- Tautan:
anthropic.com/pricing -
Keterangan: Mencakup mode Fast dan tingkat cache 1 jam
-
Artificial Analysis: indeks komprehensif pihak ketiga dan biaya per tugas
- Tautan:
artificialanalysis.ai -
Keterangan: Data per 2026-10-23, mencakup Terminal-Bench 4.0, GDPval-AA, dan AA-Omniscience
-
Daftar model APIYI: model dan harga di platform
- Tautan:
docs.apiyi.com/models - Keterangan: Diverifikasi pada 2026-10-24. Lihat daftar model terbaru di platform untuk informasi terkini
Penulis: Tim Teknologi APIYI
Diskusi teknis: Kunjungi pusat dokumentasi di docs.apiyi.com untuk informasi selengkapnya. Model dan harga mengikuti daftar model di platform. Kami akan menghadirkan model Kimi K3.1 Pro sesegera mungkin.