Catatan penulis: Artikel ini mengulas lima tingkatan harga Kimi K3.1 Pro, biaya penggunaan cache, dan tingkatan batas laju berdasarkan daftar harga resmi yang diambil pada 24 Oktober 2026. Tiga contoh perhitungan yang bisa langsung diterapkan juga akan menunjukkan biaya sebenarnya untuk satu permintaan.
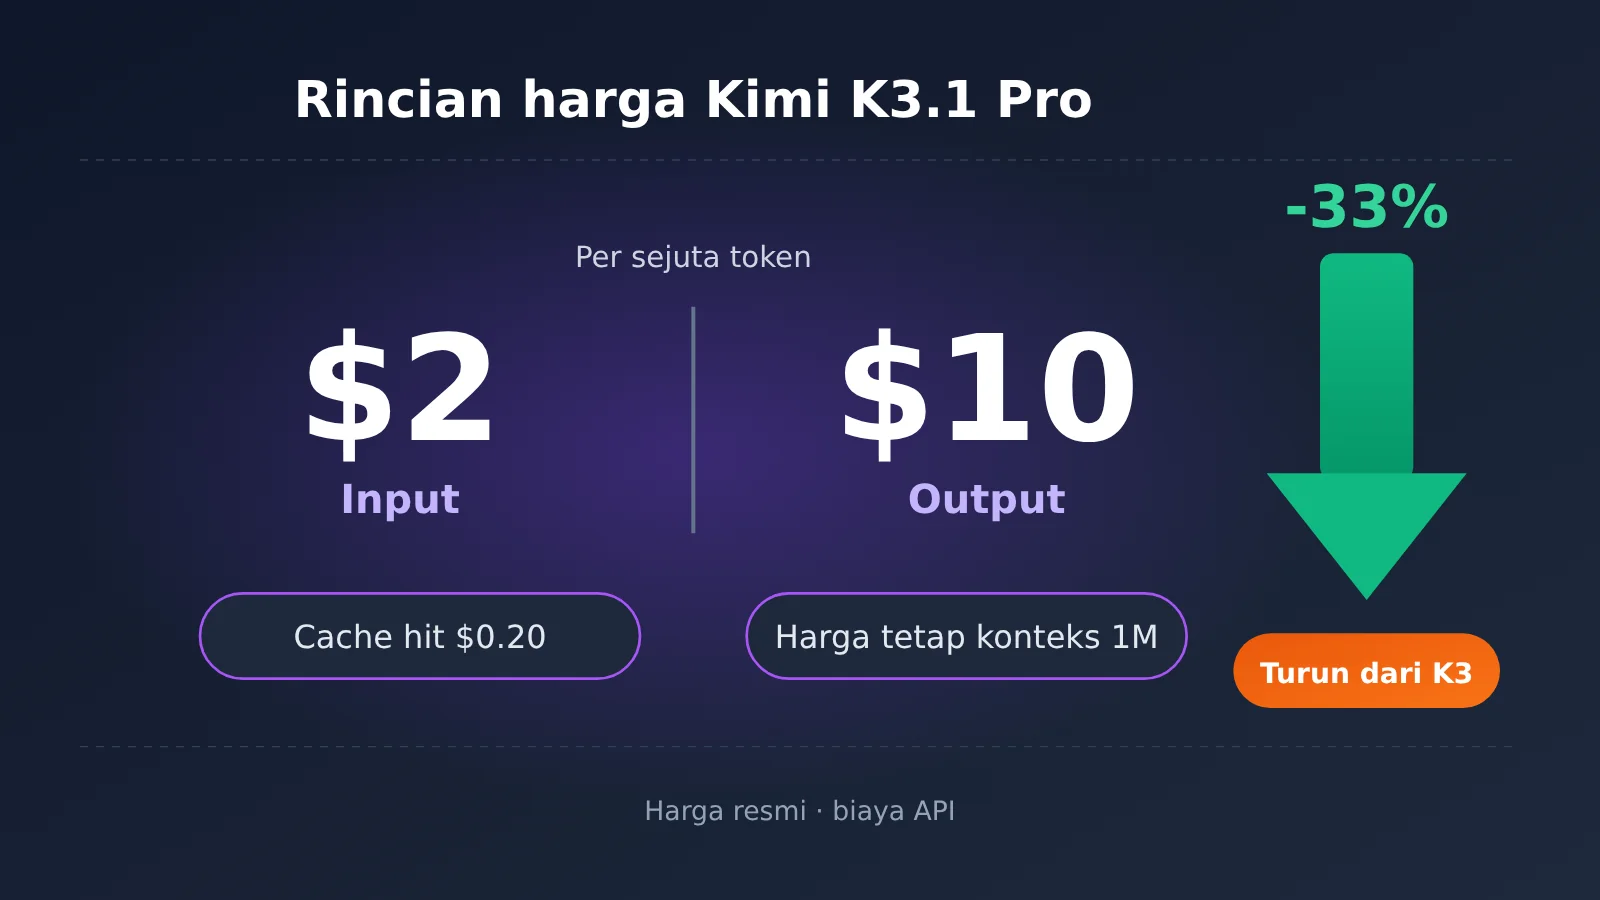
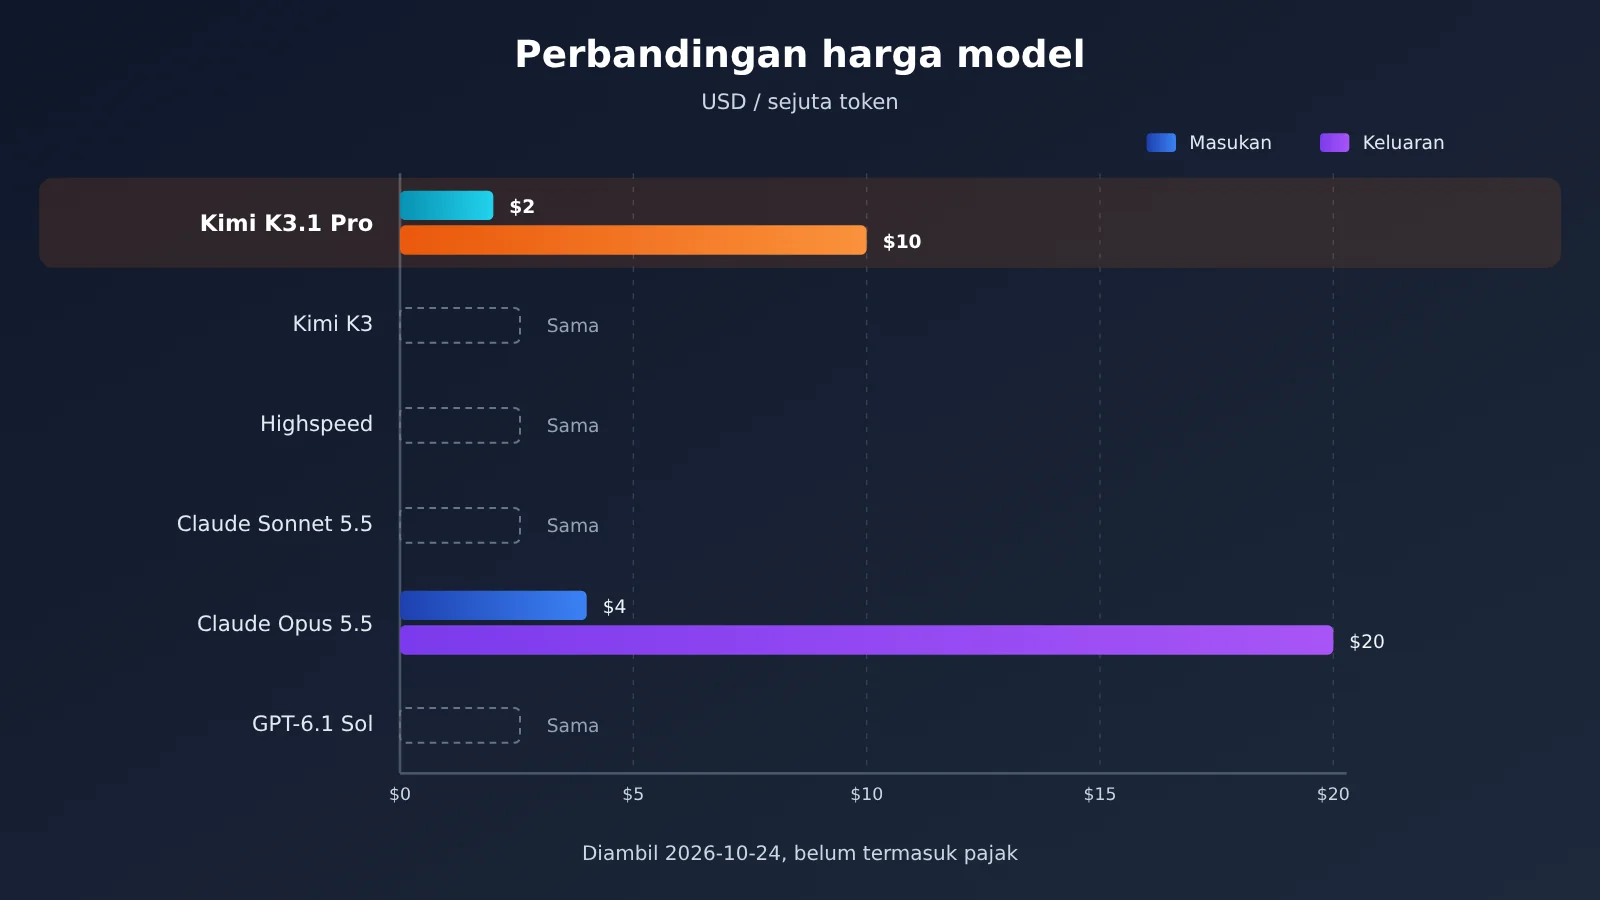
Harga resmi Kimi K3.1 Pro adalah $2 untuk input, $10 untuk output, dan hanya $0,20 untuk cache hit (dalam dolar AS per satu juta token). Harganya 33% lebih murah dibandingkan Kimi K3 generasi sebelumnya. Harganya sama dengan Claude Sonnet 5.5 dan GPT-6.1 Sol, serta setengah harga Claude Opus 5.5.
Kesimpulan ini mengacu pada halaman harga resmi Moonshot (dokumentasi pricing di platform.kimi.ai) dan data perhitungan dari lembaga pihak ketiga Artificial Analysis. Semua angka dalam artikel ini mencantumkan sumber: “resmi” berarti dilaporkan oleh blog atau dokumentasi resmi Moonshot, “pihak ketiga” berarti hasil perhitungan eksternal seperti Artificial Analysis, dan “belum terverifikasi” berarti tidak ditemukan sumber yang tepercaya.
Artikel ini bukan sekadar menyalin daftar harga. Penurunan harga satuan sebesar 33% bukan berarti tagihan Anda pasti turun 33%. Kita akan membahas dengan jelas bagian mana yang bisa menghemat biaya dan mana yang tidak.
Manfaat utama: Setelah membaca artikel ini, Anda bisa menghitung sendiri biaya satu permintaan Kimi K3.1 Pro, memahami kapan sebaiknya mengaktifkan cache, kapan perlu meningkatkan tingkat batas laju terlebih dahulu, serta cara membayar dan mengakses layanan ini sebagai developer di Tiongkok.
1. Poin Penting Harga Kimi K3.1 Pro
Kita bahas dulu beberapa hal yang paling sering ditanyakan dalam satu tabel. Penjelasan lebih lengkapnya ada di bagian berikutnya.
| Poin | Keterangan | Sumber | Artinya bagi Anda |
|---|---|---|---|
| Harga dasar | Input $2 / output $10 / cache hit $0.20 | Resmi | Seharga Sonnet 5.5 dan GPT-6.1 Sol |
| Dibandingkan generasi sebelumnya | Ketiga harga turun 33% dibandingkan K3 | Resmi / pihak ketiga | Harga per satuan turun cukup signifikan |
| Konteks | 1.048.576 token, harga satuan seragam tanpa tingkatan | Resmi | Dokumen panjang tidak membuat harga naik |
| Biaya per tugas | Sekitar $1.98 (artikel publikasi) / $2.11 (halaman model) | Pihak ketiga | Kurang lebih sama dengan K3, tidak ikut turun |
| Syarat awal | Minimal mengisi saldo $1, Tier0 hanya 3 RPM | Resmi | Perlu meningkatkan tier sebelum mulai menggunakannya dalam skala besar |
Sebelum lanjut, ada dua istilah yang akan sering muncul. Token adalah satuan terkecil yang digunakan model untuk menghitung biaya. Anggap saja sebagai “potongan kata”. Sebagai acuan, menurut informasi resmi, sekitar 3–4 karakter bahasa Inggris setara dengan 1 token. Juta token (MTok) berarti 1.000.000 token. Jadi, harga $2 pada daftar harga berarti biaya $2 untuk setiap satu juta token input yang diproses.
1.1 Apa saja komponen biaya Kimi K3.1 Pro?
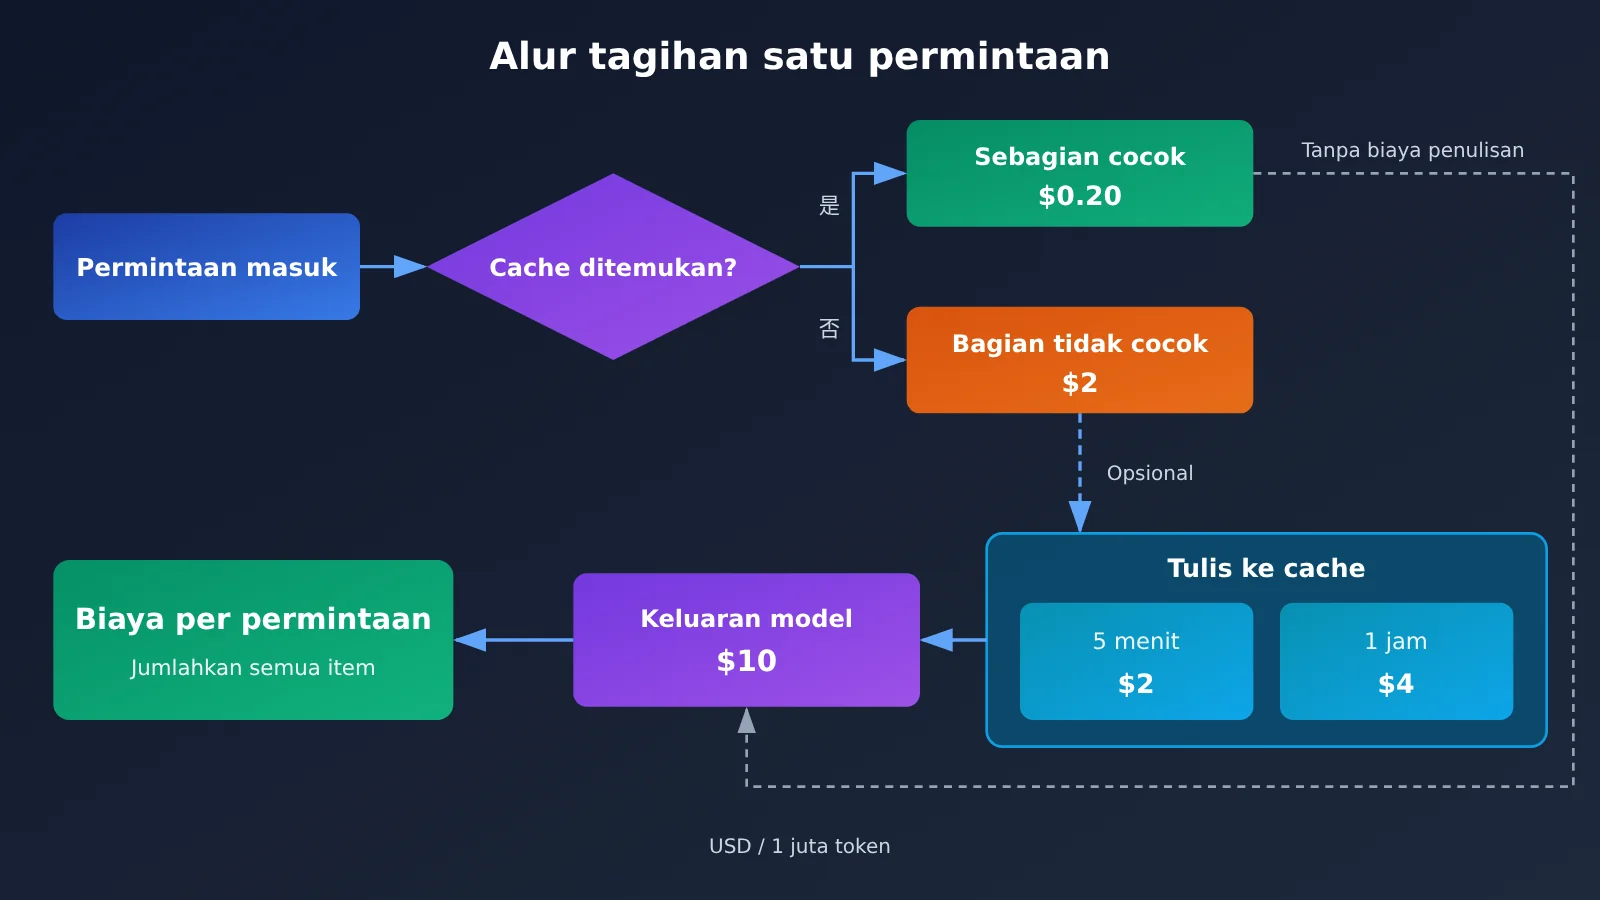
Dokumentasi resmi mencantumkan tiga jenis komponen yang dikenai biaya: penulisan cache (dengan opsi 5 menit dan 1 jam), input (cache hit dan cache miss), serta output. Jika dirinci, ketiganya menjadi lima harga pada daftar harga. Tagihan setiap permintaan merupakan penjumlahan biaya tersebut berdasarkan jumlah token.
Cache konteks adalah bagian yang paling menarik dari skema harga ini. Jika beberapa permintaan berturut-turut memiliki bagian awal yang sama persis—misalnya petunjuk sistem yang panjang—platform akan menyimpan bagian tersebut agar bisa digunakan kembali pada permintaan berikutnya. Bagian yang digunakan kembali dikenai “harga hit” yang jauh lebih murah. Menurut keterangan resmi, API Kimi otomatis menerapkan biaya cache pada prefiks permintaan yang berulang. TTL default-nya 5 menit. TTL adalah “lama waktu cache disimpan”.
Ada beberapa aturan lain dalam dokumentasi resmi yang mudah terlewat: cache hit untuk seri K3 hanya dikenai harga hit, tanpa biaya penulisan tambahan; API terkait file (ekstraksi isi dokumen dan penyimpanan file) untuk sementara gratis, tetapi konten yang diekstrak tetap dikenai biaya token saat dikirim ke model; harga pada daftar belum termasuk pajak, dan jumlah akhir mengikuti aturan wilayah pembayaran.
2. Daftar Harga Lengkap Kimi K3.1 Pro: Lima Tingkat Harga dalam Satu Tabel
Tabel berikut merangkum lima tingkat harga untuk model utama Kimi saat ini agar mudah dibandingkan. “Tidak dicantumkan” berarti harga untuk item tersebut tidak tersedia di halaman harga resmi, bukan berarti gratis.
| Model | Input (tidak terkena cache) | Output | Input saat cache cocok | Penulisan cache 5 menit | Penulisan cache 1 jam |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3 (generasi sebelumnya) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | Tidak dicantumkan | Tidak dicantumkan |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | Tidak dicantumkan | Tidak dicantumkan |
Catatan: Data diambil pada 2026-10-24. Harga dalam dolar AS per satu juta token, belum termasuk pajak. Sumber: halaman harga resmi.
Ada beberapa pola yang bisa dilihat dari tabel. Pertama, biaya penulisan cache 5 menit untuk K3.1 Pro sama dengan harga input biasa, yaitu $2. Artinya, mengaktifkan cache 5 menit hampir tidak menambah biaya. Penulisan cache 1 jam dikenakan biaya $4, atau dua kali harga input. Kedua, semua harga versi Highspeed adalah dua kali harga versi standar, kecuali biaya input saat cache cocok yang tetap $0.20. Jadi, selisih biaya kedua versi akan lebih kecil jika digunakan untuk skenario pemakaian ulang prefiks panjang. Ketiga, harga per token K2.7 Code dan K2.6 kurang dari setengah harga K3.1 Pro. Untuk tugas yang tidak membutuhkan kemampuan penalaran terbaik, keduanya tetap menjadi pilihan yang lebih murah.
2.1 Perbandingan Kimi K3.1 Pro dengan model lain di kisaran harga yang sama
Dengan membandingkan beberapa model populer menggunakan tolok ukur yang sama (USD per juta token), posisi K3.1 Pro jadi lebih jelas.
| Model | Input / output | Input dengan cache hit | Penulisan cache · durasi pendek | Penulisan cache · durasi panjang | Sumber |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2 (5 menit) | $4 (1 jam) | Resmi |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4 (5 menit) | $8 (1 jam) | Resmi |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50 (5 menit) | $4 (1 jam) | Resmi |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5 (5 menit) | $8 (1 jam) | Resmi |
| GPT-6.1 Sol (input ≤272K) | $2 / $10 | $0.10 | $2.50 (30 menit) | $5 (12 jam) | Resmi |
| GPT-6.1 Sol (input >272K) | $4 / $15 | $0.20 | $5 (30 menit) | $10 (12 jam) | Resmi |
| GPT-6 Astra (input ≤272K) | $10 / $50 | $1.00 | $12.50 (30 menit) | $25 (12 jam) | Resmi |
| GPT-6 Astra (input >272K) | $20 / $75 | $2.00 | $25 (30 menit) | $50 (12 jam) | Resmi |
Data dalam tabel diambil dari halaman harga resmi masing-masing penyedia pada 2026-10-24. Harga dalam USD per juta token, belum termasuk pajak. Ketiga penyedia menawarkan durasi cache yang berbeda: Kimi dan Claude menggunakan 5 menit / 1 jam, sedangkan OpenAI menggunakan 30 menit / 12 jam. Tarif penulisan cache masing-masing adalah 1,25 kali dan 2,5 kali harga input tanpa cache. Tarif pembacaan cache untuk sebagian besar model adalah 10% dari harga input, kecuali GPT-6.1 Sol yang sebesar 5%. OpenAI juga membedakan harga berdasarkan panjang input: ≤272K token menggunakan harga konteks pendek, sedangkan >272K token dikenai harga konteks panjang. Tabel hanya mencantumkan paket standar. Paket Batch OpenAI yang harganya setengah, serta Fast (sebelumnya Priority) dan UltraFast yang lebih mahal, tidak dicantumkan.
Dari perbandingan ini, harga input dengan cache hit Claude Sonnet 5.5 dan GPT-6.1 Sol lebih rendah (keduanya $0.10), sehingga lebih unggul untuk skenario yang sering menggunakan ulang prefiks panjang. Namun, tarif penulisan cache 5 menit Sonnet 5.5 adalah $2.50, sedikit lebih tinggi daripada K3.1 Pro yang $2. Sebaliknya, K3.1 Pro lebih cocok untuk tugas yang perlu memuat dokumen besar sekaligus karena menawarkan “penulisan cache yang lebih murah” dan “harga satuan konteks yang tetap”. Harga input dan output Claude Opus 5.5 masing-masing dua kali lipat K3.1 Pro, jadi alasan memilihnya sebaiknya karena kebutuhan kemampuan, bukan harga. Kekurangan GPT-6.1 Sol ada pada biaya penulisan cache: tarif durasi 30 menitnya $2.50, lebih mahal daripada tarif K3.1 Pro untuk 5 menit yang sebesar $2. Selain itu, harganya dibedakan berdasarkan panjang input. Untuk input lebih dari 272K token, harga input naik menjadi $4 dan output menjadi $15. Jadi, untuk tugas dengan dokumen panjang, gunakan harga pada baris konteks panjang.
Saran memilih: Perbedaan performa model di kisaran harga yang sama bergantung pada tugasnya. Sebaiknya uji kumpulan petunjuk yang sama pada setiap model sebelum menentukan pilihan. Katalog model APIYI (apiyi.com) juga menyediakan claude-sonnet-5-5, claude-opus-5-5, kimi-k3, dan model lainnya. Anda bisa membandingkannya menggunakan satu kunci API. Nama model spesifik dan harga K3.1 Pro mengikuti daftar model di platform. Kami akan segera menghadirkan model ini.
3. Berapa biaya satu permintaan ke Kimi K3.1 Pro? 3 contoh perhitungan
Setelah memahami daftar harganya, hal yang paling ingin diketahui tentu saja adalah “berapa biaya untuk satu kali pemanggilan?” Tiga contoh berikut mencakup percakapan singkat, penggunaan ulang petunjuk panjang, dan pembacaan dokumen panjang. Perhitungannya ditampilkan secara lengkap, jadi kamu bisa mengganti jumlah token dengan angka milikmu. Rumus umumnya: biaya = jumlah token × harga satuan ÷ 1.000.000.
3.1 Contoh 1: Biaya permintaan singkat Kimi K3.1 Pro
Skenario: satu sesi tanya jawab biasa dengan input 2.000 token (tidak masuk cache) dan output 500 token.
- Input:
2000 × 2 ÷ 1000000 = $0.004 - Output:
500 × 10 ÷ 1000000 = $0.005 - Total:
$0.004 + $0.005 = $0.009
Artinya, satu percakapan singkat seperti ini biayanya kurang dari satu sen. Perlu diperhatikan bahwa harga satuan output lima kali lipat harga input. Dalam permintaan singkat, output sering kali menyumbang lebih dari setengah total biaya. Jadi, membatasi panjang output lebih efektif daripada memangkas input.
3.2 Contoh 2: Penggunaan ulang dan cache untuk petunjuk panjang Kimi K3.1 Pro
Skenario: petunjuk sistem berisi 20.000 token. Dalam waktu 5 menit, ajukan 10 pertanyaan berturut-turut. Setiap kali, tambahkan 1.000 token input baru dan hasilkan 800 token output.
Tanpa cache, setiap permintaan dikenai harga penuh untuk seluruh petunjuk:
- Per permintaan:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - 10 kali:
$0.05 × 10 = $0.50
Dengan cache, petunjuk sistem perlu ditulis ke cache pada permintaan pertama. Sembilan permintaan berikutnya langsung menggunakan cache:
- Permintaan pertama: biaya penulisan
20000 × 2 ÷ 1000000 = $0.04, ditambah input baru$0.002dan output$0.008, total$0.05 - Permintaan ke-2 hingga ke-10: biaya cache
20000 × 0.2 ÷ 1000000 = $0.004per permintaan, ditambah$0.002 + $0.008, total$0.014 - Total 9 permintaan berikutnya:
$0.014 × 9 = $0.126 - Total keseluruhan:
$0.05 + $0.126 ≈ $0.18
Biaya untuk 10 percakapan yang sama turun dari $0.50 menjadi sekitar $0.18, atau hemat sekitar 60%. Pola “petunjuk panjang yang tetap + pertanyaan lanjutan berkali-kali” sangat umum pada bot layanan pelanggan, asisten coding, dan kerangka kerja Agent. Inilah jenis penggunaan yang paling diuntungkan dari cache.
3.3 Contoh 3: Membaca dokumen panjang dengan Kimi K3.1 Pro
Skenario: membaca dokumen berisi 300.000 token, lalu menghasilkan rangkuman sepanjang 3.000 token.
- Input:
300000 × 2 ÷ 1000000 = $0.60 - Output:
3000 × 10 ÷ 1000000 = $0.03 - Total: sekitar
$0.63
Jika dalam waktu 5 menit kamu mengajukan pertanyaan lain tentang dokumen yang sama, bagian dokumen akan menggunakan cache. Biaya inputnya hanya 300000 × 0.2 ÷ 1000000 = $0.06, ditambah biaya output untuk permintaan tersebut. Untuk kebutuhan seperti menanyakan hal yang sama berulang kali tentang kontrak, laporan keuangan, atau repositori kode, mengajukan pertanyaan dalam masa berlaku cache dapat mengurangi biaya secara signifikan.
4. Harga Satuan Seragam untuk Konteks 1M Kimi K3.1 Pro: Apa Arti Tanpa Tingkatan Harga?
Konteks bisa dipahami sebagai “total konten yang dapat dilihat model dalam satu waktu”, termasuk petunjuk, percakapan sebelumnya, dan dokumen yang diunggah. Dokumentasi resmi menyebutkan bahwa semua model seri K3 mendukung konteks 1.048.576 token, dan K3.1 Pro menerapkan tarif tetap berdasarkan pemakaian, tanpa tingkatan harga berdasarkan panjang konteks.
Inti FAQ resminya adalah K3.1 Pro menggunakan konteks 1M dengan tarif tetap berdasarkan pemakaian. Penulisan cache, input (cache hit maupun cache miss), dan output semuanya dikenai harga satuan yang sama. Dengan kata lain, baik Anda mengirim 2.000 token maupun 800.000 token, harga per satu juta token tetap sama, yaitu $2. Harganya tidak berubah menjadi lebih mahal saat permintaan Anda makin panjang.
Hal ini penting saat membandingkan model karena tidak semua penyedia menghitung biaya dengan cara yang sama. Seri GPT-6 dari OpenAI menerapkan tingkatan harga berdasarkan panjang input: ≤272K token dikenai harga konteks pendek, sedangkan jika melebihi 272K token, harganya langsung beralih ke tarif konteks panjang yang lebih mahal. Contohnya, pada GPT-6 Astra, harga input naik dari $10 menjadi $20, output dari $50 menjadi $75, dan cache hit dari $1.00 menjadi $2.00. Claude menggunakan pendekatan berbeda: halaman harga resminya menyebutkan bahwa model Claude 4.6 dan yang lebih baru (kecuali Claude Haiku 5.5) menggunakan harga standar untuk seluruh konteks 1M. Jadi, harga satuan untuk permintaan 900 ribu token sama dengan permintaan 9 ribu token. Hanya Claude Haiku 5.5 yang harganya naik ketika petunjuk melebihi 100 ribu token. Artinya, K3.1 Pro bukan satu-satunya model yang tidak menerapkan tingkatan harga: Claude Sonnet 5.5 dan Opus 5.5 juga tidak mengenakan biaya lebih tinggi berdasarkan panjang konteks. Model yang benar-benar beralih ke tingkatan harga lebih mahal adalah seri GPT-6.
Bagi developer, harga satuan seragam memberikan dua keuntungan langsung:
- Anggaran mudah diperkirakan secara linear: jumlah token bertambah dua kali lipat, biaya juga menjadi dua kali lipat. Tidak ada lonjakan harga mendadak pada panjang tertentu. Dokumen 300 ribu token seperti pada contoh 3 bisa dihitung langsung berdasarkan harga satuan.
- Dokumen tidak perlu sengaja dipecah-pecah: pada model dengan harga bertingkat, sebagian orang membagi dokumen panjang menjadi beberapa bagian untuk menghindari tarif yang lebih mahal. Di K3.1 Pro, cara ini tidak menghemat biaya dan justru bisa mengurangi kualitas hasil karena konteksnya terputus.
5. Mengapa Kimi K3.1 Pro Lebih Hemat, dan Kapan Tidak
Di bagian ini, kita akan menghitung biayanya dengan jujur. Harga per unit memang turun, tetapi biaya tugas sebenarnya juga dipengaruhi panjang output.
| Aspek | Detail | Sumber | Dampak pada biaya |
|---|---|---|---|
| Harga per unit turun | Harga input, output, dan cache hit semuanya 33% lebih rendah dibandingkan K3 | Resmi / pihak ketiga | Lebih hemat |
| Harga cache hit | $0.20, hanya 1/10 dari harga input | Resmi | Sangat hemat untuk penggunaan ulang prefiks panjang |
| Penulisan cache 1 jam | $4, dua kali harga input | Resmi | Lebih hemat untuk tugas dengan jeda panjang; tidak perlu untuk tugas singkat |
| Pemikiran selalu aktif | Pemikiran tidak bisa dinonaktifkan; rata-rata output 55K tokens, 14% lebih banyak daripada K3 | Resmi / pihak ketiga | Mengimbangi sebagian penurunan harga |
| Biaya per tugas | $1.98 (berdasarkan artikel yang dipublikasikan) / $2.11 (rata-rata berbobot di halaman model) | Pihak ketiga | Kurang lebih setara dengan K3 |
5.1 Tiga hal yang membuat Kimi K3.1 Pro lebih hemat
Pertama, harga per unit langsung turun 33%, dari $3/$15 pada K3 menjadi $2/$10. Harga cache hit juga turun dari $0.30 menjadi $0.20. Data ini sesuai dengan daftar harga resmi dan data dari Artificial Analysis. Kedua, cache hit hanya seharga 1/10 dari harga input. Seperti yang sudah dihitung pada Contoh 2, penggunaan ulang petunjuk panjang dalam percakapan multi-putaran dapat menghemat sekitar 60%. Ketiga, meski penulisan cache 1 jam harganya dua kali lipat, fitur ini membuat cache bertahan lebih lama. Fitur ini cocok untuk tugas dengan jeda lebih dari 5 menit di antara dua pemanggilan, misalnya Agent terjadwal yang dijalankan setiap beberapa belas menit, atau sesi tanya jawab dokumen panjang yang penggunanya berhenti sejenak untuk berpikir sebelum bertanya lagi. Jika cache digunakan lebih dari dua kali dalam satu jam, biaya tambahan untuk penulisan cache biasanya bisa terbayar.
5.2 Kapan Kimi K3.1 Pro tidak lebih hemat
Pemikiran adalah proses ketika model melakukan penalaran internal sebelum memberikan jawaban. Konten penalaran ini juga dihitung sebagai output dan dikenai biaya. Dokumentasi resmi menyebutkan bahwa pemikiran pada K3.1 Pro tidak bisa dinonaktifkan. Jumlahnya hanya bisa dikurangi dengan mengatur reasoning_effort ke low.
Menurut pengukuran Artificial Analysis (pihak ketiga), K3.1 Pro menghasilkan rata-rata sekitar 55K tokens untuk setiap tugas dalam Intelligence Index mereka, sementara K3 menghasilkan 48K—14% lebih sedikit. Harga output adalah komponen yang paling mahal, sehingga tambahan token ini menghabiskan sebagian penghematan dari penurunan harga. Pada akhirnya, biaya per tugas yang dihitung pihak ketiga sekitar $1.98 (berdasarkan artikel yang dipublikasikan), sedangkan halaman model mencantumkan biaya per tugas rata-rata berbobot sebesar $2.11 (dengan diskon cache dihitung sebesar 90%). Angkanya kurang lebih setara dengan K3.
Kesimpulannya, jika bisnis Anda lebih banyak menangani input panjang dan penggunaan ulang dalam banyak putaran, penurunan harga K3.1 Pro akan terlihat jelas pada tagihan. Namun, untuk tugas yang banyak membutuhkan penalaran kompleks dan menghasilkan output panjang, biaya per tugas belum tentu lebih rendah daripada K3. Sebaiknya uji dulu sejumlah kecil tugas nyata, lalu periksa tagihan aktualnya.
6. Ambang Pengisian Saldo dan Tingkat Batas Laju Kimi K3.1 Pro
Layanan resmi menggunakan sistem bayar sesuai pemakaian, tanpa paket berlangganan. Biaya Kimi API juga terpisah dari biaya keanggotaan Kimi dan Kimi Code, jadi keanggotaan tidak bisa digunakan untuk membayar API. Anda perlu mengisi saldo minimal $1 untuk mulai melakukan pemanggilan. Jika total pengisian saldo mencapai $5, Anda akan mendapat kupon senilai $5. Kupon ini tidak dihitung sebagai bagian dari total pengisian saldo (menurut informasi resmi).
Tingkat batas laju ditentukan oleh total pengisian saldo. Berikut penjelasan beberapa singkatan: konkurensi adalah jumlah permintaan yang bisa diproses secara bersamaan; RPM adalah jumlah maksimum permintaan per menit; TPM adalah jumlah maksimum token yang bisa diproses per menit; TPD adalah jumlah maksimum token yang bisa diproses per hari.
| Tingkat | Total pengisian saldo | Konkurensi | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500 ribu | 1,5 juta |
| Tier1 | $10 | 15 | 100 | 2 juta | Tanpa batas |
| Tier2 | $20 | 40 | 100 | 3 juta | Tanpa batas |
| Tier3 | $100 | 50 | 200 | 3 juta | Tanpa batas |
| Tier4 | $1000 | 60 | 200 | 4 juta | Tanpa batas |
| Tier5 | $3000 | 100 | 300 | 5 juta | Tanpa batas |
Catatan: Sumbernya adalah dokumen resmi tentang batas laju (halaman pricing/limits di platform.kimi.ai), diambil pada 2026-10-24.
Batasan Tier0 sangat ketat: Anda hanya bisa mengirim 3 permintaan per menit, dengan total 1,5 juta token per hari. Berdasarkan dokumen 300 ribu token pada Contoh 3, membaca dokumen tersebut 5 kali dalam sehari sudah mencapai batas. Selain itu, batas TPM sebesar 500 ribu berarti bahkan dua dokumen seperti itu tidak bisa diproses dalam satu menit. Jika Anda ingin melakukan pemrosesan massal atau meluncurkan layanan untuk pengguna, sebaiknya tingkatkan total pengisian saldo ke Tier1 atau lebih tinggi sejak tahap pengujian.
Ada satu hal lagi yang perlu diperhatikan: menurut keterangan resmi, pembatasan laju akibat pemicu mekanisme pengendalian risiko tidak bisa dicabut. Sebelum meluncurkan layanan, atur laju permintaan dan jeda bertahap saat mencoba ulang di sisi klien. Jangan gunakan skrip konkurensi untuk menguji batas maksimum.
7. Cara Membayar dan Menghubungkan Kimi K3.1 Pro di Tiongkok
Kanal resmi menetapkan harga dalam dolar AS dan melakukan penagihan sesuai aturan wilayah pembayaran. Meskipun pembayaran bisa dilakukan langsung dari Tiongkok, pengembang di sana biasanya khawatir soal metode pembayaran luar negeri, faktur, dan keharusan mengelola kunci API dari beberapa penyedia sekaligus. Alternatifnya, Anda bisa menggunakan platform agregasi API untuk mengakses berbagai model hanya dengan satu akun dan satu kunci API.
APIYI (apiyi.com) adalah platform agregasi API untuk Model Bahasa Besar. Dengan satu kunci API, Anda bisa mengakses berbagai model populer seperti OpenAI, Claude, dan Gemini. Antarmukanya kompatibel dengan format OpenAI, biaya dihitung sesuai pemakaian, dan pengguna baru mendapat kuota uji coba gratis. Berdasarkan pemeriksaan pada 2026-10-24 terhadap daftar model platform di docs.apiyi.com/models, model seri Kimi yang saat ini tersedia adalah:
kimi-k3: input $3 / output $15 / pembacaan cache $0.3kimi-k2.7-code: input $0.95 / output $3.99 / pembacaan cache $0.19kimi-k2.6: input $0.6 / output $2.4 / pembacaan cache $0.1kimi-k2.5: input $0.6 / output $3.15 / pembacaan cache $0.1
Pada tanggal pemeriksaan, kimi-k3.1-pro belum tercantum dalam daftar model APIYI. Karena itu, artikel ini tidak mencantumkan harganya di platform. Nama model, harga, dan waktu ketersediaan K3.1 Pro dapat dilihat di daftar model pada konsol platform. Kami akan segera menghadirkan model ini. Sementara itu, Anda bisa menggunakan kimi-k3 untuk mencoba alurnya. Setelah K3.1 Pro tersedia, Anda hanya perlu mengganti nama model.
7.1 Langkah Cepat Menghubungkan Kimi K3.1 Pro
Langkah integrasinya kurang lebih sama, baik menggunakan kanal resmi maupun platform agregasi. Berikut contoh dengan format yang kompatibel dengan OpenAI:
- Daftar dan dapatkan kunci API. Untuk kanal resmi, isi saldo minimal $1 terlebih dahulu.
- Di SDK atau klien OpenAI yang Anda gunakan, atur
base_urlkehttps://api.apiyi.com/v1jika menggunakan APIYI. Jika proyek Anda menggunakan format Anthropic, isi alamat dasar denganhttps://api.apiyi.com. - Atur
api_keyke kunci API Anda. Isimodeldengan nama model yang tercantum di daftar platform, misalnyakimi-k3yang saat ini tersedia. Setelah K3.1 Pro tersedia, gunakan nama yang tercantum di daftar tersebut. - Untuk menekan biaya output dari proses berpikir, tambahkan
reasoning_effortke parameter permintaan dan atur nilainya kelow. Menurut keterangan resmi, K3.1 Pro hanya mendukung pengurangan tingkat proses berpikir, bukan menonaktifkannya. - Letakkan petunjuk sistem panjang yang tetap di bagian awal pesan dan jangan mengubahnya agar awalan yang berulang bisa otomatis menggunakan cache.
- Setelah melakukan pemanggilan, periksa jumlah token input, cache hit, dan output pada tagihan atau kolom penggunaan di respons. Lalu hitung ulang menggunakan rumus di Bagian 3.
Saran untuk mulai mencoba: Gunakan kuota uji coba gratis APIYI di apiyi.com untuk menjalankan Contoh 2 di Bagian 3. Bandingkan penggunaan saat awalan tetap diaktifkan dan tidak diaktifkan. Ini cara tercepat untuk memastikan apakah cache berfungsi. Nama model dan harga K3.1 Pro di platform mengikuti daftar model. Kami akan segera menghadirkan model ini.
Pertanyaan Umum (FAQ)
Q1: Berapa harga Kimi K3.1 Pro?
Harga resmi per juta token adalah $2 untuk input, $10 untuk output, $0,20 untuk cache hit, $2 untuk penulisan cache 5 menit, dan $4 untuk penulisan cache 1 jam. Harga dalam dolar AS, belum termasuk pajak. Data diambil pada 2026-10-24.
Q2: Seberapa murah Kimi K3.1 Pro dibandingkan K3? Apakah tagihan sebenarnya akan turun 33%?
Ketiga tarif satuannya 33% lebih rendah (menurut harga resmi). Namun, K3.1 Pro selalu menggunakan mode berpikir dan rata-rata menghasilkan output 14% lebih banyak. Perhitungan pihak ketiga dari Artificial Analysis memperkirakan biaya per tugas sekitar $1,98 hingga $2,11, kurang lebih sama dengan K3. Penghematan akan lebih terasa untuk skenario dengan input panjang dan penggunaan ulang dalam beberapa putaran.
Q3: Mana yang lebih hemat, Kimi K3.1 Pro atau Claude Sonnet 5.5?
Tarif input dan output keduanya sama, yaitu $2/$10. Cache hit Sonnet 5.5 lebih murah ($0,10), sedangkan penulisan cache 5 menit K3.1 Pro lebih murah ($2 dibandingkan $2,50). Selain itu, tarif untuk jendela konteks 1 juta token tetap sama. Sonnet lebih cocok untuk penggunaan ulang awalan pendek yang sering, sedangkan K3.1 Pro lebih cocok untuk membaca dokumen besar sekaligus. Sebaiknya bandingkan keduanya menggunakan tugas yang sebenarnya.
Q4: Apakah cache 1 jam Kimi K3.1 Pro layak digunakan?
Biaya penulisan cache 1 jam adalah $4, atau $2 lebih mahal daripada penulisan cache 5 menit. Biasanya, opsi ini layak digunakan jika awalan yang sama dipakai kembali lebih dari sekali, setelah 5 menit tetapi sebelum 1 jam berlalu. Jika pemanggilan terkonsentrasi dalam beberapa menit, cukup gunakan cache 5 menit yang menjadi pengaturan default.
Q5: Bagaimana developer di Tiongkok dapat memanggil Kimi K3.1 Pro melalui API?
Anda bisa menggunakan saluran resmi atau mengaksesnya melalui APIYI apiyi.com dengan antarmuka yang kompatibel dengan OpenAI. Isi `base_url` dengan `https://api.apiyi.com/v1`. Saat ini, platform tersebut sudah menyediakan model seperti `kimi-k3` dan `kimi-k2.7-code`. Nama model dan harga K3.1 Pro mengikuti daftar model di platform. Kami akan segera menghadirkan model ini.
Q6: Bisakah biaya API dikurangi dengan keanggotaan Kimi?
Tidak bisa. Menurut keterangan resmi, API Kimi menggunakan sistem bayar sesuai pemakaian dan tidak memiliki paket berlangganan. Biaya API, keanggotaan Kimi, dan Kimi Code dihitung secara terpisah.
Q7: Apa saja hal yang perlu diperhatikan terkait biaya Kimi K3.1 Pro?
– Mode berpikir tidak dapat dimatikan, sehingga jumlah token output bisa lebih banyak. Anda dapat mengatur `reasoning_effort` ke `low` untuk menguranginya.
– Tier0 hanya menyediakan 3 RPM dan 1,5 juta TPD. Jika membutuhkan kapasitas lebih besar, ajukan peningkatan tier terlebih dahulu.
– Pembatasan laju akibat sistem pengendalian risiko tidak dapat dibatalkan.
– Ekstraksi file gratis, tetapi konten yang diekstrak tetap dikenai biaya input saat dikirim ke model.
Q8: Apa yang bisa dipersiapkan sekarang jika platform belum menyediakan K3.1 Pro?
Anda bisa mulai dengan menyiapkan alur pemanggilan, struktur cache, dan pencatatan penggunaan menggunakan `kimi-k3` di APIYI apiyi.com. Setelah K3.1 Pro tersedia, Anda hanya perlu mengganti nama model. Nama model dan harga mengikuti daftar model di platform. Kami akan segera menghadirkan model ini.
Poin Utama Harga Kimi K3.1 Pro
- Harga dasar: input $2 / output $10 / cache hit $0,20. Harga resmi, belum termasuk pajak.
- Tersedia lima tarif: biaya penulisan cache 5 menit $2 dan 1 jam $4, jadi biaya penulisannya sangat rendah.
- Posisi dibanding model lain: harganya sama dengan Sonnet 5.5 dan GPT-6.1 Sol, serta setengah harga Opus 5.5.
- Harga satuan tetap: konteks 1M tidak dibagi ke beberapa tarif berdasarkan panjangnya, sehingga anggaran bisa dihitung secara linear.
- Biaya aktual: karena model selalu berpikir dan menghasilkan output 14% lebih banyak, biaya per tugas pada dasarnya setara dengan K3 (berdasarkan pihak ketiga).
- Ambang awal: isi saldo mulai dari $1. Tier0 hanya menyediakan 3 RPM, dan pembatasan laju karena kontrol risiko tidak dapat dicabut.
- Akses dari Indonesia: Anda bisa mengaksesnya melalui APIYI dengan antarmuka yang kompatibel dengan OpenAI. Model dan harga K3.1 Pro mengikuti daftar model di platform; kami akan segera menghadirkan model ini.
Kesimpulan
Poin utama harga Kimi K3.1 Pro:
- Harga satuan: input $2 / output $10 / cache hit $0,20. Harganya 33% lebih rendah daripada K3, dengan harga satuan yang tetap untuk konteks 1M.
- Kunci menghemat biaya: letakkan prefiks panjang yang tetap di bagian awal dan manfaatkan cache dengan baik. Untuk percakapan beberapa putaran, biaya input bisa berkurang sekitar 60%.
- Ekspektasi biaya: mode berpikir yang selalu aktif menghasilkan output lebih panjang. Untuk tugas penalaran kompleks, biaya per tugas mendekati K3. Jangan menyusun anggaran dengan asumsi biaya turun 33%.
- Persiapan sebelum peluncuran: tingkatkan batas laju lebih awal dan atur kecepatan permintaan agar tidak terkena pembatasan laju kontrol risiko yang tidak dapat dicabut.
Sebaiknya gunakan rumus di bagian 3 dan distribusi token Anda sendiri untuk memperkirakan biaya, lalu uji dengan sejumlah kecil tugas nyata. Jika ingin membandingkan model seperti Kimi, Claude, dan GPT di Indonesia dengan satu kunci API, Anda bisa mencoba kuota gratis melalui APIYI di apiyi.com. Model dan harga K3.1 Pro di platform mengikuti daftar model; kami akan segera menghadirkan model ini.
Referensi
- Platform Terbuka Kimi – Harga Model: Harga lima tingkat untuk K3.1 Pro dan berbagai model, beserta aturan penagihannya
- Tautan:
platform.kimi.ai/docs/pricing/chat -
Keterangan: Sumber resmi untuk daftar harga dan penjelasan penagihan terpadu untuk konteks 1M dalam artikel ini
-
Platform Terbuka Kimi – Pengisian Saldo dan Pembatasan Laju: Penjelasan tingkat Tier0 hingga Tier5 dan kontrol risiko
- Tautan:
platform.kimi.ai/docs/pricing/limits -
Keterangan: Sumber resmi untuk persyaratan pengisian saldo dan batas RPM/TPM/TPD
-
Artificial Analysis – Kimi K3.1 Pro: Perkiraan biaya pihak ketiga per tugas dan jumlah token output
- Tautan:
artificialanalysis.ai -
Keterangan: Sumber data biaya per tugas sebesar $1.98 / $2.11 dan 55K token output dalam artikel ini
-
Daftar Model APIYI: Model yang saat ini tersedia di platform beserta harganya
- Tautan:
docs.apiyi.com/models - Keterangan: Informasi ketersediaan model seperti Kimi dan Claude di platform
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman beranda situs APIYI. Informasi lebih lanjut tersedia di pusat dokumentasidocs.apiyi.com