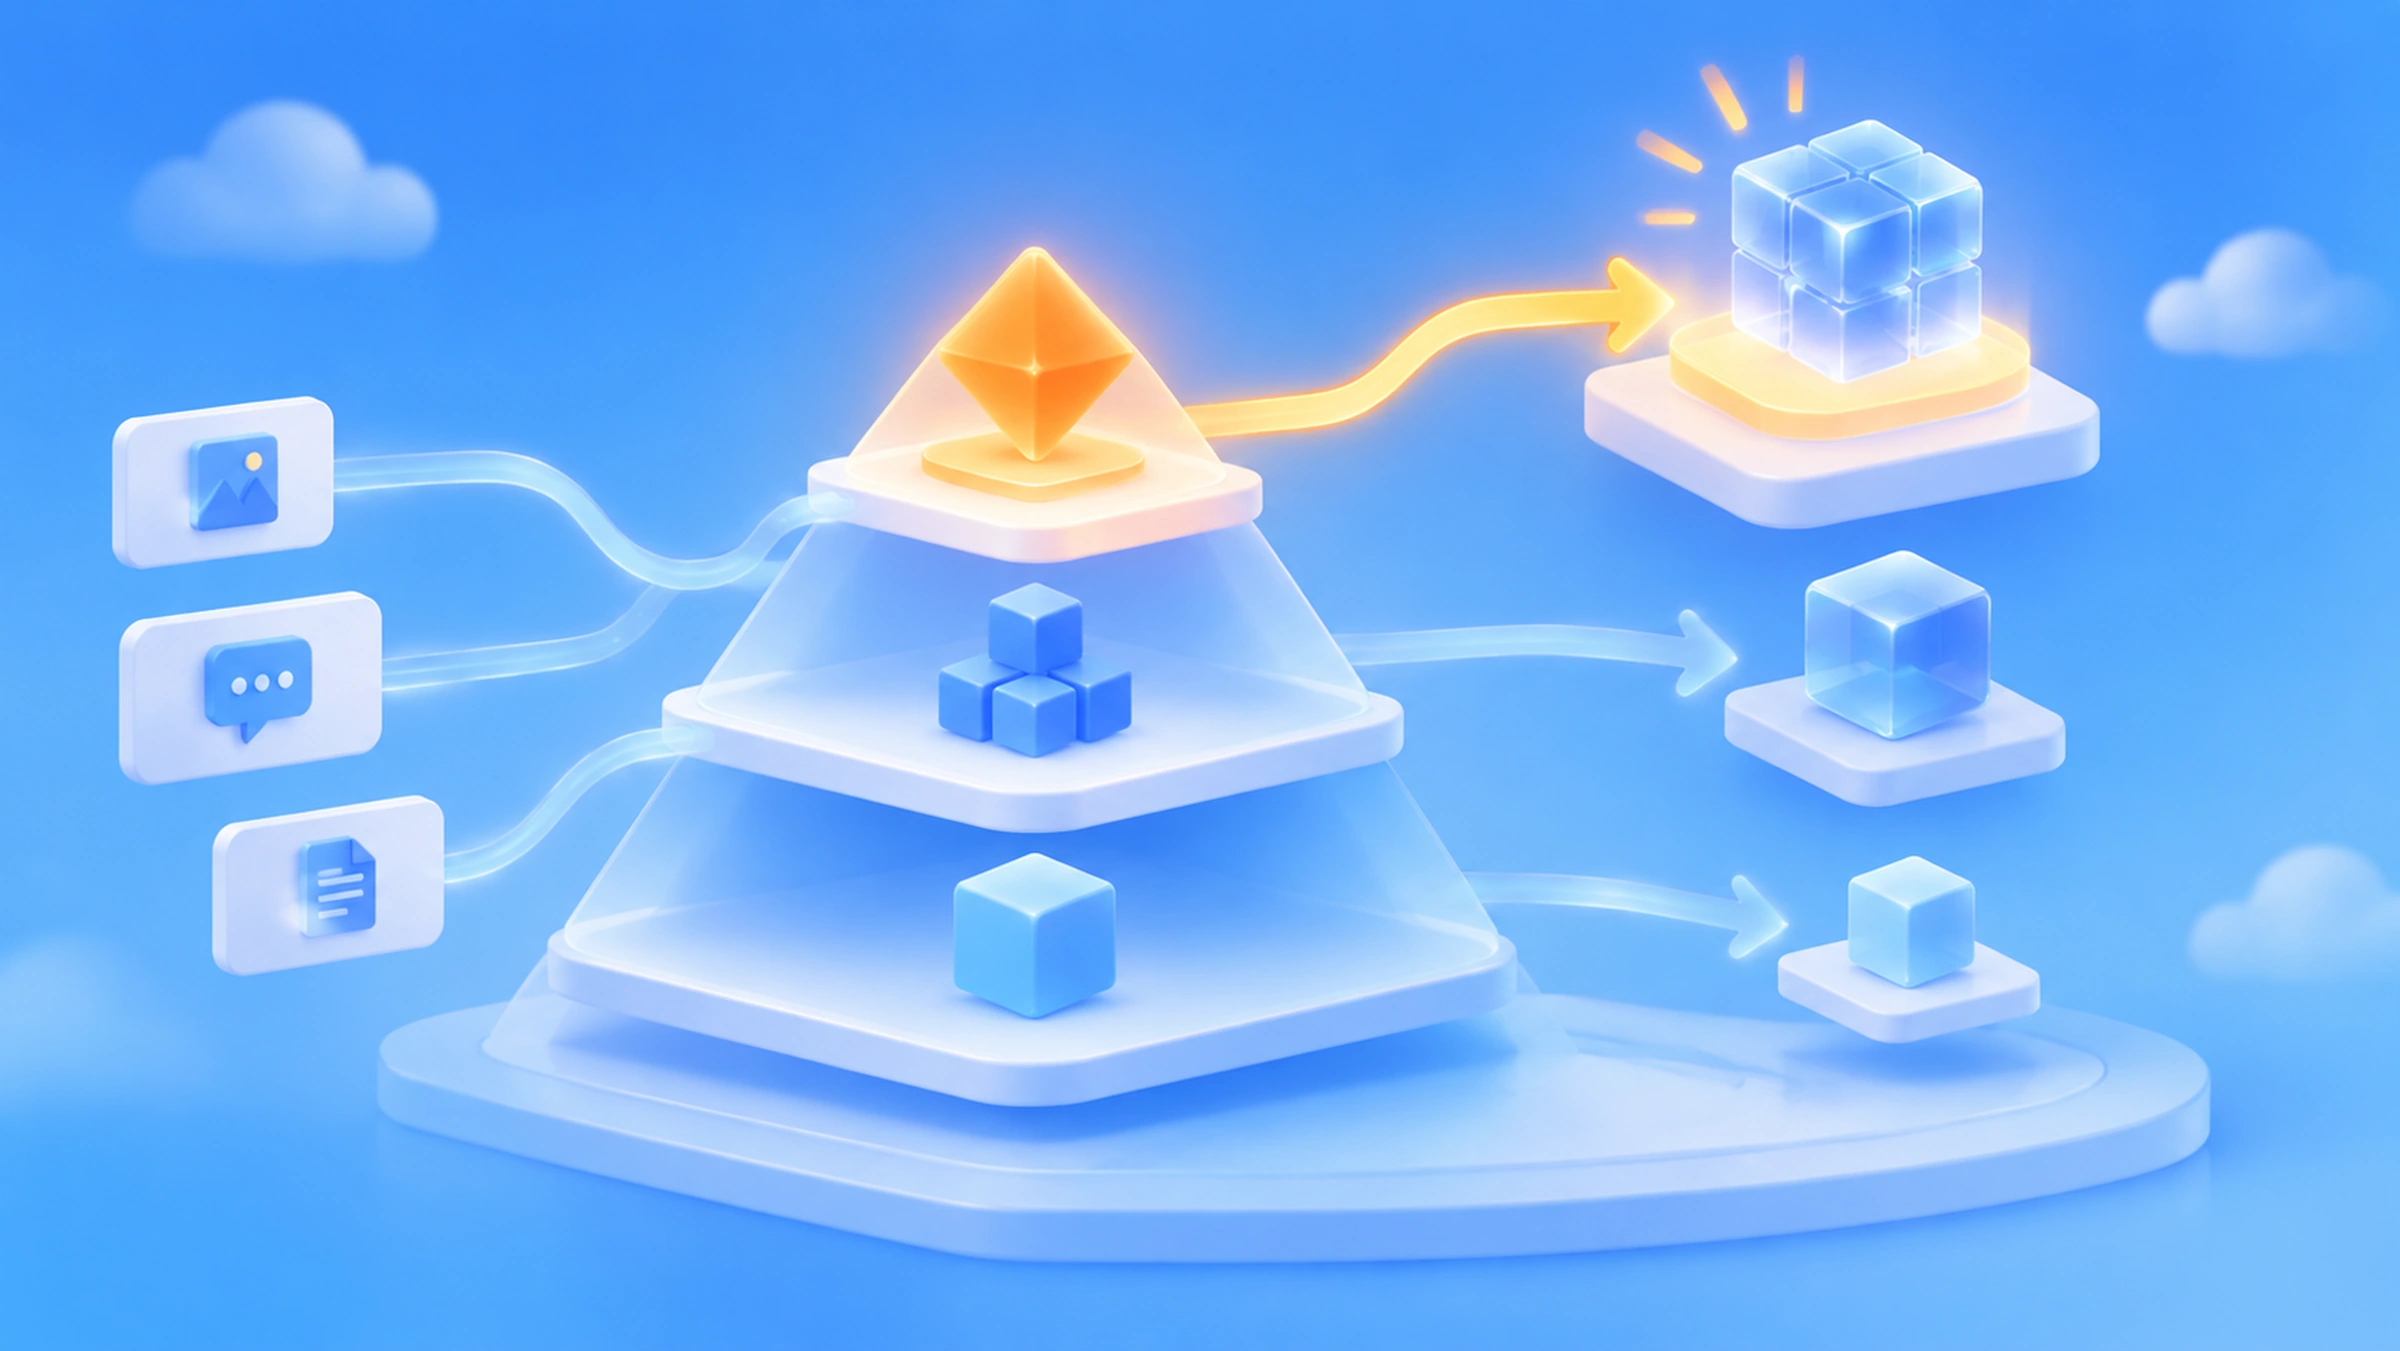
Catatan penulis: Artikel ini menjelaskan, dilihat dari tiga dimensi—tingkat kesulitan tugas, biaya kesalahan, dan skala konteks—bagaimana merutekan Model Bahasa Besar secara berlapis berdasarkan tugas, sehingga model unggulan hanya dialokasikan untuk permintaan yang benar-benar membutuhkannya.
Langkah pertama banyak tim saat mengintegrasikan Model Bahasa Besar adalah mengirim semua permintaan ke model unggulan terkuat yang tersedia saat itu. Di tahap prototipe, cara ini tidak masalah. Namun setelah volume permintaan meningkat, tagihan akan naik dengan cepat, padahal sebagian besar permintaan sebenarnya sudah bisa diselesaikan oleh model kecil dan menengah. Artikel ini membahas metode penerapan perutean Model Bahasa Besar berlapis berdasarkan tugas, untuk membantu Anda menilai permintaan mana yang benar-benar layak menggunakan model unggulan.
Ini bukan artikel yang menyorakkan “model murah sama bagusnya”. Model unggulan masih memiliki keunggulan jelas dalam penalaran kompleks, modifikasi kode dengan rantai panjang, dan output berisiko tinggi. Perutean berlapis bertujuan menyelesaikan masalah “menyerahkan permintaan yang tepat kepada model yang tepat”, bukan sekadar menekan biaya.
Nilai inti: Setelah membaca artikel ini, Anda akan menguasai satu set standar klasifikasi tugas 3 lapis, satu daftar periksa konfigurasi aturan perutean, serta cara mengkalibrasi strategi perutean menggunakan data setelah peluncuran.
Poin Inti Routing Model Bahasa Besar Berdasarkan Tugas
Sebelum membahas konfigurasi spesifik, mari kita taruh beberapa kriteria utama untuk routing berlapis. Kriteria ini menentukan sebuah permintaan harus jatuh ke lapisan mana, sekaligus menentukan apakah strategi routing dapat dirawat secara berkelanjutan.
| Poin Kunci | Penjelasan | Nilai |
|---|---|---|
| Lapisan berdasarkan tugas, bukan pengguna | Tingkat kesulitan permintaan dari pengguna yang sama bisa sangat berbeda; karakteristik tiap tugas harus menjadi dasar routing | Menghindari pemborosan akibat “semua pengguna VIP memakai model unggulan” |
| Biaya kesalahan lebih diutamakan daripada tingkat kesulitan tugas | Tugas sederhana tetapi berdampak serius jika salah bisa tetap memerlukan model unggulan atau validasi kedua | Mengendalikan risiko insiden di produksi |
| Default ke lapisan menengah, naik-turun kelas berdasarkan sinyal | Model utama menjadi penopang sebagian besar lalu lintas permintaan, lalu naik atau turun kelas saat kondisi tertentu terpenuhi | Aturan lebih sedikit, mudah dirawat, mudah di-rollback |
| Kegagalan dapat dinaikkan ke lapisan lebih tinggi | Saat output model lapisan bawah tidak lolos validasi, otomatis coba ulang ke lapisan yang lebih tinggi | Menukar sedikit biaya retry dengan kualitas keseluruhan |
| Kalibrasi dengan data | Catat tingkat keberhasilan, tingkat retry, dan biaya per tugas setiap lapisan, lalu sesuaikan ambang batas secara berkala | Strategi routing tetap efektif seiring iterasi model |
Penjelasan Rinci Routing Berlapis: Mengapa Tidak Semua Memakai Model Unggulan
Lanskap model pada 2026 membuat routing berlapis semakin diperlukan. Mengambil contoh dari informasi publik dalam bahan referensi, OpenAI merilis GPT-5.5 pada 24 April 2026 dengan konteks sejuta token; pada hari yang sama DeepSeek merilis seri V4 yang terbagi menjadi dua varian, Pro dan Flash, juga mendukung konteks 1M dan merilis bobot secara terbuka dengan lisensi Apache 2.0. Pada saat yang sama, model seperti seri Claude Opus, Gemini 3.1 Pro, dan Kimi K2.6 terus memperkecil jarak pada tugas pengodean dan penalaran.
Ketika skor model-model teratas pada benchmark umum semakin berdekatan, “biaya per tugas” menjadi indikator kunci untuk membedakan model. Ada artikel evaluasi pihak ketiga yang menyebutkan bahwa skor beberapa model pada benchmark pengodean sudah sangat berdekatan; yang benar-benar membedakan adalah biaya yang harus dikeluarkan untuk menyelesaikan setiap tugas. Ada pula artikel yang menganalisis bahwa dalam skenario agen coding seperti Claude Code, sebagian besar konsumsi token tidak perlu ditangani model paling atas. Semua ini adalah pandangan pihak ketiga; proporsi pastinya berbeda-beda tergantung bisnis, tetapi arahnya jelas: memakai model unggulan hanya pada titik yang paling berdampak lebih hemat daripada memakainya untuk semua hal.
Poin lain yang sering terlewat adalah latensi. Model unggulan biasanya bernalar lebih dalam dan menghasilkan output lebih panjang. Untuk tugas instan seperti klasifikasi, ekstraksi, dan penulisan ulang, waktu tunggu pengguna justru menjadi lebih lama. Bahan referensi menyebutkan bahwa setelah GPT-5.5 Instant menjadi model default ChatGPT, panjang jawaban menyusut secara signifikan dan tingkat halusinasi menurun. Ini menunjukkan bahwa versi ringan yang ditujukan untuk “tanya cepat, jawab cepat” sendiri merupakan arah produk yang diakui vendor.
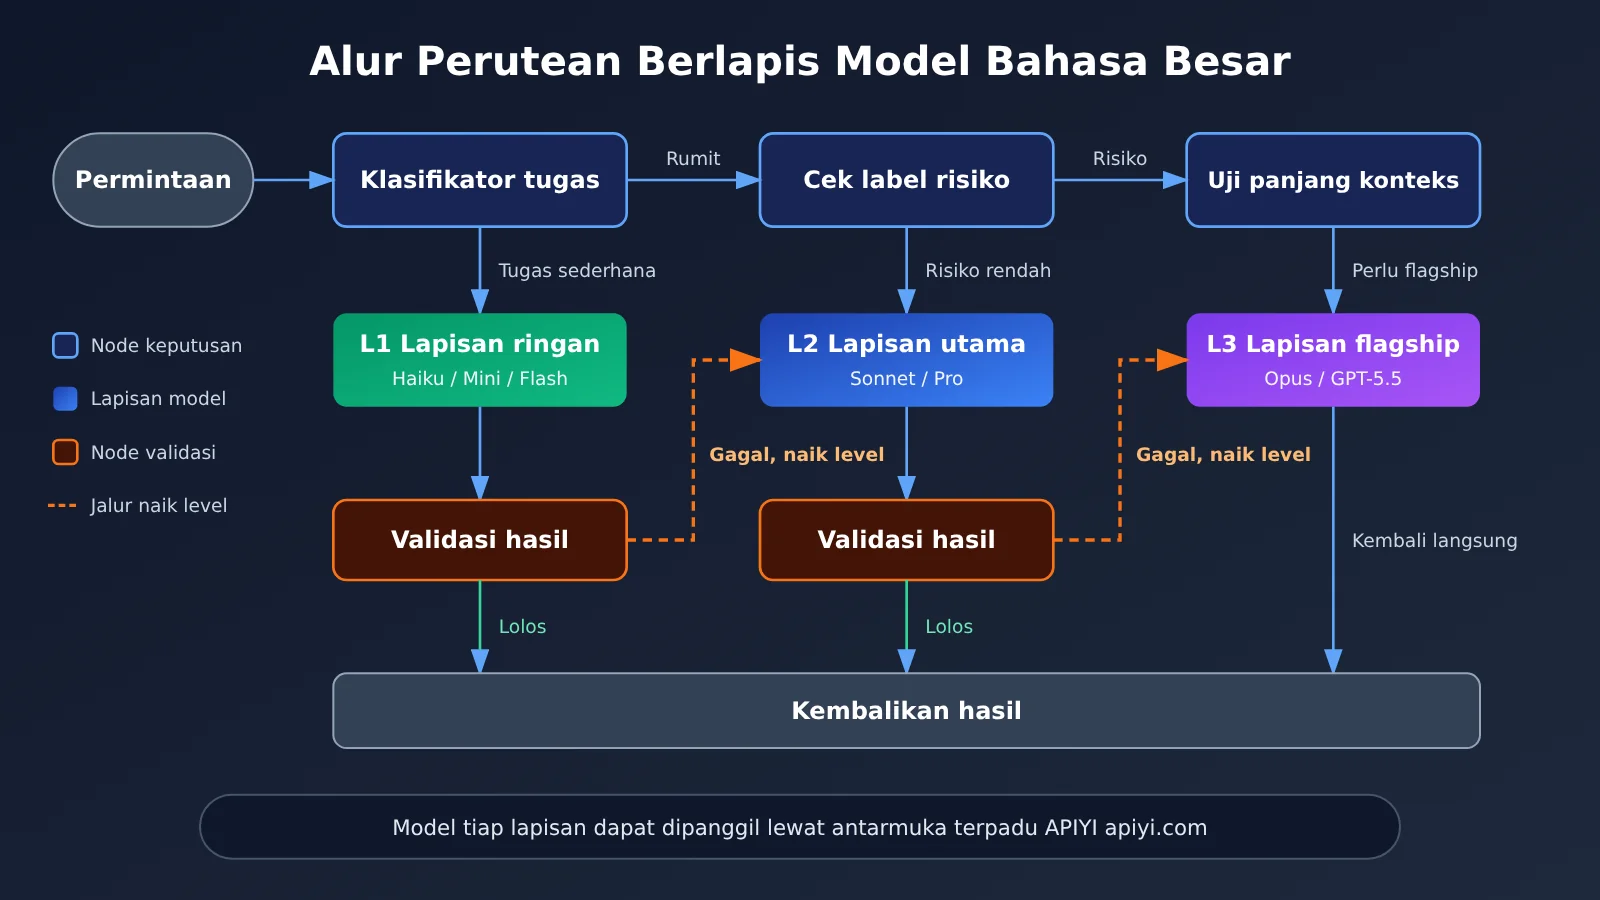
Cara Membagi 3 Tingkat Tugas dalam Perutean Berlapis Model Bahasa Besar
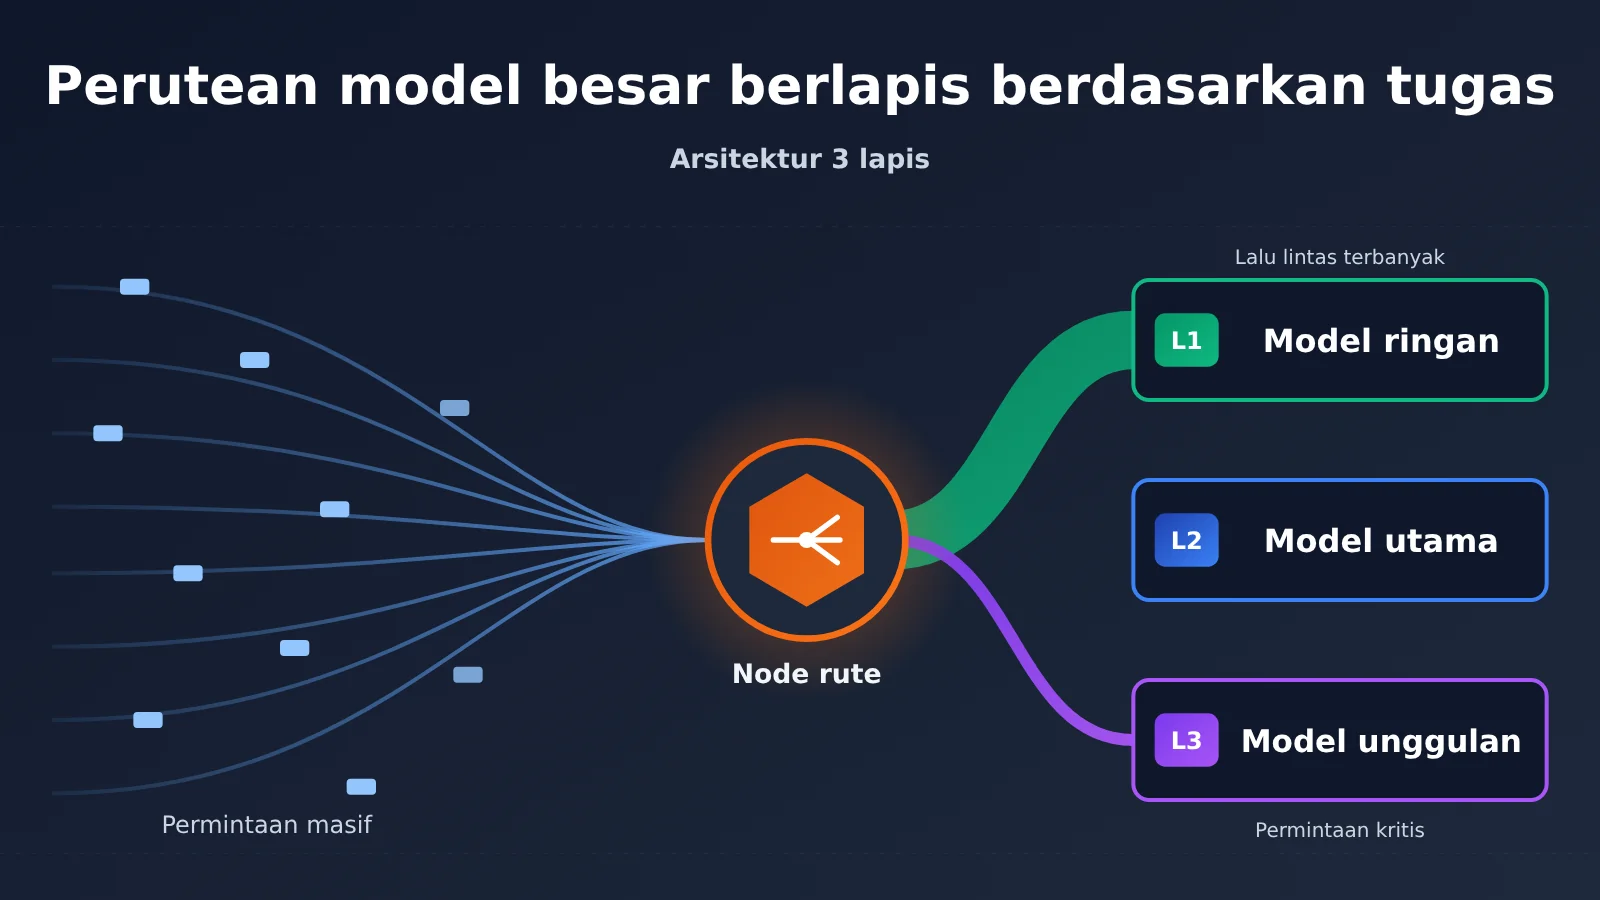
Inti dari perutean berlapis adalah menemukan model yang “cukup memadai” untuk setiap jenis tugas. Tabel berikut adalah cara pembagian umum yang kami rangkum dari beberapa proyek; Anda bisa menambah atau menghapusnya sesuai kebutuhan bisnis.
| Tingkat | Tugas tipikal | Sinyal penentu | Jenis model yang direkomendasikan |
|---|---|---|---|
| L1 Lapisan Ringan | Klasifikasi intent, ekstraksi kata kunci, konversi format, penulisan ulang teks pendek, tanya jawab sederhana | Input pendek, output berstruktur tetap, ada aturan validasi yang jelas | Model tingkat Haiku, Mini, dan Flash |
| L2 Lapisan Utama | Percakapan rutin, ringkasan dokumen, pembuatan kode dengan kompleksitas sedang, tanya jawab RAG | Memerlukan pemahaman dan pengorganisasian tertentu, tetapi kesalahan dapat ditemukan dan diperbaiki | Model tingkat Sonnet, model open-source berparameter besar, model umum tingkat Pro |
| L3 Lapisan Unggulan | Penalaran multi-langkah, refactoring kode lintas file, desain arsitektur, output berisiko tinggi seperti hukum atau keuangan | Dependensi multi-langkah, kesalahan tersembunyi dan mahal, analisis komprehensif atas konteks yang sangat panjang | Model unggulan tingkat Opus, GPT-5.5, dan sejenisnya |
Cara Menilai Tugas di Lapisan Ringan L1
Ciri kunci lapisan L1 adalah “output dapat diverifikasi oleh program”. Misalnya, klasifikasi intent hanya boleh memilih satu dari label tetap, ekstraksi JSON dapat divalidasi dengan schema, dan konversi format dapat dibandingkan kelengkapan field-nya. Selama aturan validasi ditulis cukup ketat, bagian yang salah dari model ringan dapat otomatis dicegat dan dieskalasi untuk ditangani di tingkat yang lebih tinggi.
Ada artikel perbandingan dalam referensi yang menunjukkan bahwa model kecil seperti Claude Haiku 4.5 dan GPT-5.4 Mini memiliki keunggulan masing-masing: yang pertama lebih baik dalam kualitas kode, sedangkan yang kedua lebih unggul dalam kecepatan. Model seperti ini cocok menangani trafik berfrekuensi tinggi dengan kompleksitas rendah dan menjadi sumber utama penghematan biaya dalam perutean berlapis.
Cara Menilai Tugas untuk Lapisan Utama L2
Lapisan L2 menangani sebagian besar permintaan yang “butuh berpikir tetapi tidak terlalu sulit”, dan juga menjadi target routing default yang direkomendasikan. Menetapkan nilai default di lapisan tengah punya dua keuntungan: pertama, menghindari salah klasifikasi yang membuat banyak permintaan kompleks turun ke lapisan ringan; kedua, membuat aturan naik dan turun lapisan tetap sederhana.
Performa model open-source di lapisan ini layak diperhatikan. Dalam materi referensi, ada penilaian pihak ketiga yang berpendapat bahwa DeepSeek V4 Flash tidak jauh berbeda dari V4 Pro pada tugas coding dengan batasan yang jelas, dan selisih Kimi K2.6 dengan Claude Opus 4.6 pada benchmark coding arus utama hanya beberapa poin. Artinya, banyak tugas coding yang biasanya diserahkan ke model flagship bisa dicoba dulu di lapisan utama.
Cara Menilai Tugas untuk Lapisan Flagship L3
Permintaan yang benar-benar layak memakai model flagship biasanya memenuhi setidaknya dua dari kondisi berikut:
- Rantai penalaran panjang: butuh perencanaan multi-langkah, verifikasi berulang atas kesimpulan antara, misalnya pelacakan bug yang kompleks, pembuktian matematika, penjadwalan dengan banyak batasan.
- Kesalahan tersembunyi dan berbiaya tinggi: output terlihat masuk akal tetapi kesalahan detailnya sulit ditemukan, misalnya analisis klausul kontrak, perhitungan standar keuangan, kode yang berkaitan dengan keamanan.
- Kesulitan sintesis konteks tinggi: perlu menghubungkan informasi lintas paragraf dalam materi ratusan ribu token, bukan sekadar mengambil satu fragmen.
- Lapisan bawah sudah gagal: output L2 tidak lolos validasi, atau pengguna secara eksplisit memberi tahu bahwa hasilnya tidak dapat digunakan.
🎯 Saran teknis: Routing berlapis mengharuskan Anda terhubung ke beberapa model sekaligus. Jika setiap model harus dikontrak dan diadaptasi ke SDK secara terpisah, biaya pemeliharaan akan menggerus manfaat routing. APIYI apiyi.com menyediakan pemanggilan API untuk model-model seperti GPT, Claude, Gemini, dan DeepSeek yang dibahas di artikel ini, sekaligus kompatibel dengan dua format antarmuka, OpenAI dan Anthropic. Saat berganti model, biasanya cukup mengubah parameter nama model.
Mulai Cepat Routing Berlapis Model Bahasa Besar
Berikut ini dijelaskan skema routing berlapis minimal yang bisa digunakan melalui daftar konfigurasi. Artikel ini tidak menyertakan potongan kode; semua item konfigurasi penting dijelaskan dalam tabel, dan Anda dapat menerapkannya sesuai framework yang Anda gunakan.
Langkah Pertama: Lapisan Akses Terpadu
Prasyarat routing berlapis adalah “ganti model tanpa ganti kode”. Sebaiknya semua permintaan model melewati satu fungsi pemanggilan terpadu. Fungsi ini hanya menerima jenis tugas, konten pesan, dan parameter override lapisan opsional; di dalamnya, aturan routing yang menentukan model mana yang benar-benar dipanggil.
Untuk cara integrasi, jika proyek Anda sudah menggunakan OpenAI SDK, Anda dapat langsung memakai antarmuka bergaya chat completions; jika menggunakan Anthropic SDK, Anda juga dapat memakai antarmuka bergaya messages. APIYI kompatibel dengan kedua format ini. Untuk alamat akses, metode autentikasi, dan daftar nama model yang spesifik, silakan mengacu pada penjelasan di pusat dokumentasi APIYI docs.apiyi.com.
Langkah Kedua: Menentukan Konfigurasi Aturan Routing
Tabel berikut mencantumkan item konfigurasi yang paling umum dalam satu set aturan routing. Sebaiknya ditulis sebagai file konfigurasi terpisah agar mudah disesuaikan tanpa memulai ulang layanan.
| Item Konfigurasi | Arti | Saran Penentuan Nilai |
|---|---|---|
task_type |
Label jenis tugas, seperti classify, extract, summarize, code, reason | Ditandai langsung dari titik masuk bisnis; lebih stabil daripada klasifikasi oleh model |
default_tier |
Lapisan yang digunakan saat tidak ada aturan yang cocok | Sebaiknya diatur ke L2, lapisan utama |
risk_level |
Label risiko bisnis: low, medium, high | high langsung dirutekan ke L3 atau ditambah langkah validasi |
context_threshold |
Ambang jumlah token input yang memicu eskalasi | Atur berdasarkan jendela konteks tiap model dan performa teks panjang |
validator |
Metode validasi output, seperti JSON schema, regex, unit test, peninjauan ulang oleh model kedua | Wajib dikonfigurasi pada lapisan L1, disarankan pada lapisan L2 |
max_escalation |
Jumlah maksimum eskalasi setelah validasi gagal | Umumnya 1 sampai 2 kali untuk mencegah percobaan ulang tanpa batas |
tier_model_map |
Nama model dan model cadangan untuk setiap lapisan | Nama model mengikuti daftar model pada dokumentasi APIYI |
Langkah Ketiga: Mengonfigurasi Logika Eskalasi dan Degradasi
Aturan routing sebaiknya dievaluasi dalam urutan berikut; aturan yang lebih atas memiliki prioritas lebih tinggi:
- Jika pemanggil secara eksplisit menentukan parameter override lapisan, gunakan lapisan tersebut langsung, untuk memudahkan debugging dan intervensi manual.
- Jika
risk_levelbernilai high, rutekan ke L3, lapisan flagship. - Jika panjang input melebihi
context_threshold, rutekan setidaknya ke L2, dan tentukan apakah perlu eskalasi ke L3 berdasarkan jenis tugas. - Cari berdasarkan
task_type; tugas klasifikasi, ekstraksi, dan konversi format dirutekan ke L1. - Jika tidak ada aturan yang cocok, gunakan
default_tier. - Jika output tidak lolos validasi
validator, naikkan satu lapisan dan coba lagi hingga batasmax_escalationtercapai.
Langkah Keempat: Mencatat Metrik Penting Setiap Lapisan
Setelah routing diterapkan, setidaknya catat lapisan, nama model, jumlah token input/output, apakah terjadi cache hit, apakah terjadi eskalasi dan percobaan ulang, serta apakah validasi lolos untuk setiap permintaan. Data ini adalah satu-satunya dasar untuk menyesuaikan ambang batas nanti; strategi routing tanpa log hanya bisa disesuaikan berdasarkan firasat.
🚀 Mulai Cepat: Sebaiknya jalankan dulu L1, L2, dan L3 di lingkungan pengujian menggunakan kumpulan permintaan nyata yang sama, lalu bandingkan tingkat kelulusan dan biaya per tugas. Dengan APIYI apiyi.com, Anda dapat beralih antar beberapa model menggunakan satu set antarmuka yang sama, sehingga eksperimen perbandingan semacam ini bisa diselesaikan lebih cepat.
Perbandingan model unggulan dan model utama dalam routing berlapis
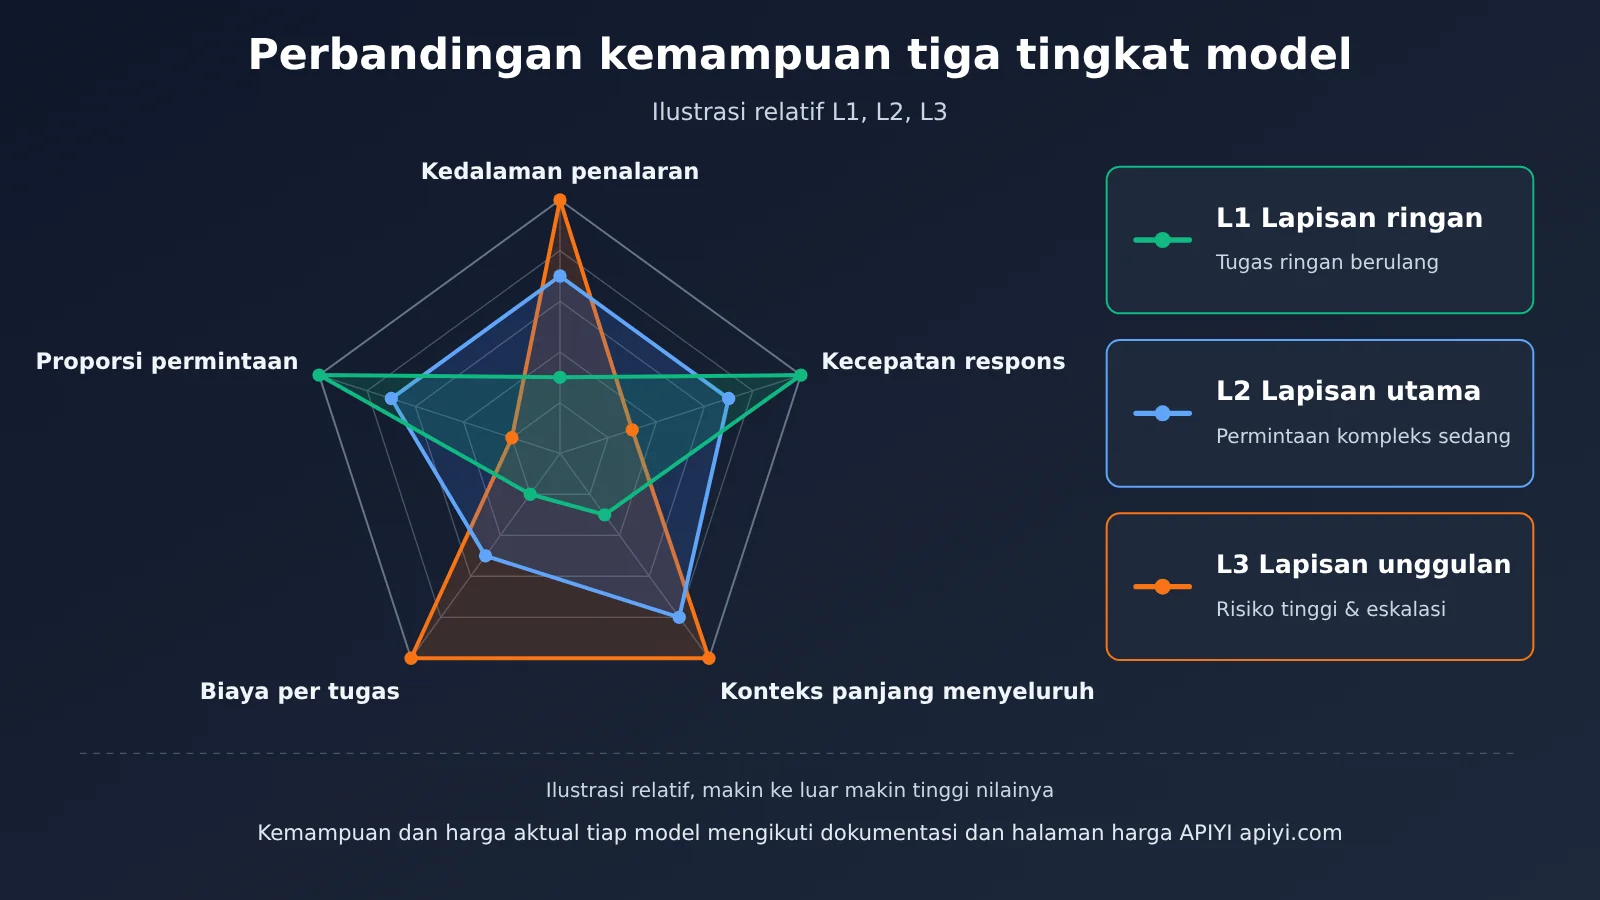
Tabel berikut mengelompokkan model-model populer yang disebutkan dalam referensi berdasarkan lapisan, sehingga memudahkan Anda memilih kandidat model untuk setiap lapisan. Posisi dalam tabel berasal dari sumber publik dan evaluasi pihak ketiga; performa aktual dapat berubah seiring pembaruan versi, jadi sebaiknya uji ulang dengan data bisnis Anda sendiri.
| Model | Posisi umum | Lapisan yang sesuai | Platform yang tersedia |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | Pengkodean kompleks dan penalaran multi-langkah | Lapisan unggulan L3 | APIYI apiyi.com, API resmi |
| GPT-5.5 | Unggulan serbaguna, konteks 1M | Lapisan unggulan L3 | APIYI apiyi.com, API resmi |
| Gemini 3.1 Pro | Penalaran dan konteks panjang, rasio harga-kinerja menonjol | L2 hingga L3 | APIYI apiyi.com, API resmi |
| DeepSeek V4 Pro | Open source dengan parameter besar, konteks 1M | Lapisan utama L2 | APIYI apiyi.com, API resmi |
| Kimi K2.6 | Kemampuan pengkodean mendekati unggulan | Lapisan utama L2 | APIYI apiyi.com, API resmi |
| DeepSeek V4 Flash | Biaya rendah, cocok untuk tugas dengan batas jelas | L1 hingga L2 | APIYI apiyi.com, API resmi |
| Claude Haiku 4.5 / GPT-5.4 Mini | Tugas ringan berfrekuensi tinggi | Lapisan ringan L1 | APIYI apiyi.com, API resmi |
Analisis pembandingan model unggulan dan model utama
Analisis pembandingan model unggulan: Model unggulan seperti Claude Opus dan GPT-5.5 tetap unggul dalam penalaran multi-langkah, modifikasi kode lintas file, dan identifikasi kesalahan tersembunyi. Namun harga per unit dan latensi responsnya jelas lebih tinggi; menggunakannya untuk tugas sederhana seperti klasifikasi dan penulisan ulang merupakan salah alokasi sumber daya yang nyata. Sebaliknya, model unggulan paling tepat ditempatkan di lapisan L3, hanya menangani permintaan berisiko tinggi dan permintaan eskalasi setelah kegagalan di lapisan bawah.
Analisis pembandingan model utama open source: DeepSeek V4 dan Kimi K2.6 tampil baik dalam pengkodean rutin dan pemrosesan dokumen; evaluasi pihak ketiga menunjukkan bahwa kesenjangan mereka dengan model unggulan sudah cukup kecil pada banyak tugas. Namun pada tugas yang membutuhkan penalaran rantai panjang dan memiliki banyak batasan implisit, kesenjangan masih ada. Untuk sebagian besar permintaan dengan kompleksitas menengah, model di lapisan utama tetap menjadi pilihan default yang lebih aman dan lebih ekonomis.
💡 Saran pemilihan: Model mana yang dipilih untuk setiap lapisan terutama bergantung pada distribusi tugas dan kebutuhan kualitas Anda. Sebaiknya lakukan pengujian lintas model terhadap kandidat menggunakan kumpulan sampel yang sama melalui APIYI apiyi.com, lalu tentukan model utama dan model cadangan untuk setiap lapisan.
Metode penghitungan biaya routing berlapis
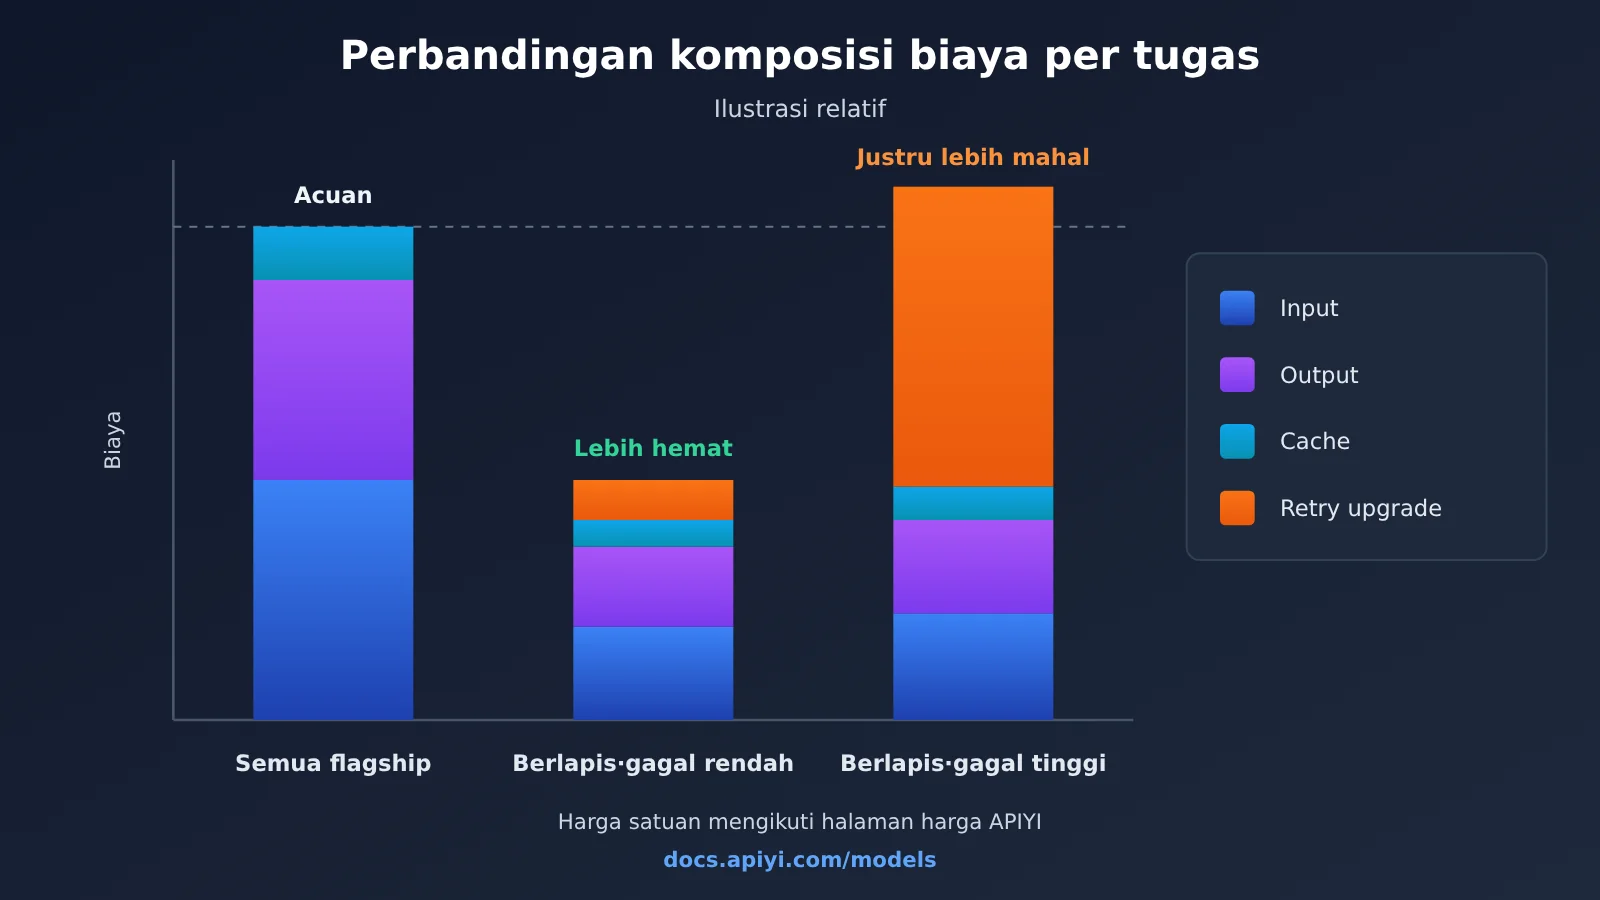
Apakah routing berlapis menghemat biaya tidak bisa dinilai hanya dari harga satuan, tetapi harus dilihat dari “total biaya per tugas”. Total biaya sebuah tugas biasanya terdiri dari beberapa komponen penagihan, dan kesalahan pada satu komponen saja bisa membuat kesimpulan menjadi keliru.
| Komponen penagihan | Keterangan | Dasar harga |
|---|---|---|
| Token masukan | Total petunjuk, konteks, dan pesan riwayat | Mengacu pada data aktual halaman harga APIYI docs.apiyi.com/models |
| Token keluaran | Konten yang dihasilkan model; model penalaran mungkin menyertakan token pemikiran | Mengacu pada data aktual halaman harga APIYI docs.apiyi.com/models |
| Pembacaan cache | Bagian masukan yang mengenai cache petunjuk | Mengacu pada data aktual halaman harga APIYI docs.apiyi.com/models |
| Penulisan cache | Bagian masukan yang pertama kali ditulis ke cache; beberapa model menagihnya secara terpisah | Mengacu pada data aktual halaman harga APIYI docs.apiyi.com/models |
| Eskalasi dan percobaan ulang | Seluruh biaya yang timbul saat mengeksekusi ulang di lapisan lebih tinggi setelah lapisan bawah gagal | Dihitung akumulatif sesuai lapisan pemanggilan aktual |
Kesalahan umum saat menghitung biaya per tugas pada routing berlapis
Kesalahan pertama adalah menghitung token cache dua kali. Ada artikel dalam materi referensi yang secara khusus mengingatkan bahwa saat menghitung biaya cache, pembacaan, penulisan, input biasa, output, dan percobaan ulang harus dihitung secara terpisah; jika tidak, token yang sama sangat mudah terhitung dua kali. Kesalahan kedua adalah mengabaikan biaya eskalasi dan percobaan ulang. Jika tingkat kegagalan validasi di lapisan L1 tinggi, maka “mencoba model murah terlebih dahulu” justru bisa lebih mahal daripada langsung menggunakan model utama.
Karena itu, disarankan menggunakan rumus sederhana untuk menilai apakah suatu jenis tugas cocok ditempatkan di lapisan bawah: biaya sekali jalan di lapisan bawah ditambah “tingkat kegagalan dikali biaya sekali jalan di lapisan atas”. Jika nilai ini jelas lebih rendah daripada biaya menggunakan lapisan atas secara langsung, dan kualitas akhirnya dapat diterima, maka jenis tugas tersebut cocok diturunkan ke lapisan bawah. Untuk harga satuan masing-masing model, harga cache, dan dasar penagihan, gunakan data real-time dari halaman harga APIYI docs.apiyi.com/models sebagai acuan tunggal; artikel ini tidak mencantumkan angka harga spesifik.
💰 Optimasi biaya: Saat melakukan estimasi biaya, sebaiknya baca harga satuan input, output, dan cache setiap model langsung dari halaman harga APIYI, lalu kombinasikan dengan data log Anda untuk menghitung biaya per tugas. Dalam platform yang sama, dasar penagihannya konsisten sehingga perbandingan antar-model lebih kecil kemungkinan salahnya.
FAQ: Pertanyaan yang Sering Diajukan
Q1: Apa yang dimaksud dengan routing berlapis Model Bahasa Besar berdasarkan tugas?
Ini berarti mengalokasikan setiap permintaan ke model dengan tingkat kemampuan dan biaya yang berbeda, berdasarkan jenis tugas, tingkat risiko, dan ukuran konteksnya. Tugas sederhana diserahkan ke model ringan, tugas rutin ke model utama, dan hanya tugas yang kompleks atau berisiko tinggi yang diserahkan ke model unggulan.
Q2: Apa bedanya routing berlapis dengan sekadar “turun ke model murah”?
Penurunan sederhana biasanya berupa penggantian global, sehingga kualitas turun secara menyeluruh. Routing berlapis memperlakukan setiap tugas secara berbeda, dilengkapi mekanisme validasi dan eskalasi otomatis. Permintaan yang gagal di lapisan bawah akan dikirim ke model yang lebih kuat untuk dikerjakan ulang, sehingga biaya tetap terkendali tanpa mengorbankan batas bawah kualitas.
Q3: Setelah model-model baru rilis pada 2026, apakah strategi routing perlu disesuaikan ulang?
Ya. Pada paruh pertama 2026, GPT-5.5, DeepSeek V4, versi baru Claude Opus, dan model lainnya rilis secara beruntun, sehingga batas kemampuan antar lapisan berubah dengan cepat. Sebaiknya setelah setiap pembaruan model utama, jalankan ulang tingkat kelulusan tiap lapisan dengan set uji tetap, lalu putuskan apakah pemetaan lapisan perlu disesuaikan.
Q4: Permintaan seperti apa yang paling layak memakai model unggulan?
Terutama beberapa kategori berikut:
– **Refaktor kode lintas file dan pelacakan bug yang kompleks**: perlu memahami dependensi antar banyak konteks.
– **Output di bidang berisiko tinggi**: seperti tinjauan kontrak, verifikasi standar keuangan, dan pembuatan kebijakan keamanan.
– **Tugas penalaran dengan banyak batasan**: seperti penjadwalan kompleks, pertimbangan trade-off antar opsi, dan penurunan matematis.
– **Permintaan yang sudah gagal di model lapisan bawah**: sebagai jaring pengaman melalui eskalasi.
Q5: Bagaimana cara cepat membangun lingkungan uji routing berlapis melalui API?
Disarankan menggunakan platform agregator API yang mendukung banyak model:
1. Kunjungi APIYI apiyi.com, daftar akun, dan dapatkan API Key.
2. Lihat alamat akses dan nama model yang tersedia di pusat dokumentasi APIYI docs.apiyi.com.
3. Sesuai daftar konfigurasi di artikel ini, pilih satu model untuk masing-masing L1, L2, dan L3, lalu bandingkan tingkat kelulusannya dengan sampel yang sama.
APIYI kompatibel dengan format antarmuka OpenAI dan Anthropic, sehingga proyek yang sudah ada biasanya tidak perlu banyak diubah untuk terhubung.
Q6: Kalau klasifikasi tugas sendiri dilakukan oleh model, apakah itu menambah biaya?
Akan ada sedikit biaya tambahan, karena itu sebaiknya prioritaskan penandaan langsung di pintu masuk bisnis. Misalnya, “pintu masuk tanya jawab layanan pelanggan” secara default sudah menandakan jenis tugas tertentu. Hanya jika pintu masuk tidak bisa membedakannya, gunakan model ringan L1 untuk klasifikasi. Biaya bagian ini biasanya jauh lebih kecil daripada pemborosan akibat salah memakai model unggulan.
Q7: Apa saja keterbatasan yang diketahui dari routing berlapis?
Ada tiga hal utama: pertama, aturan perlu dipelihara terus-menerus karena ambang batas bisa tidak berlaku setelah model diperbarui; kedua, percobaan ulang melalui eskalasi menambah latensi pada sebagian permintaan, sehingga skenario yang menuntut real-time tinggi perlu mempertimbangkannya; ketiga, gaya output antar model tidak konsisten, sehingga produk yang berhadapan langsung dengan pengguna mungkin perlu pasca-pemrosesan yang seragam. Jika masalah ini muncul, Anda bisa menaikkan lapisan default atau mengurangi jumlah lapisan.
Q8: Ke mana saya harus merujuk untuk harga routing berlapis?
Untuk harga input, output, dan cache semua model serta dasar penghitungan biayanya, silakan mengacu pada data aktual di halaman harga APIYI docs.apiyi.com/models. Harga di artikel pihak ketiga bisa berbeda dengan kanal yang Anda gunakan sebenarnya, jadi tidak disarankan langsung dipakai untuk penyusunan anggaran.
Poin-Poin Penting Routing Model Bahasa Besar Berdasarkan Lapisan Tugas
- Dasar lapisan adalah tugas, bukan pengguna: Tingkat kesulitan permintaan dari pengguna yang sama bisa sangat bervariasi, jadi harus dinilai per permintaan.
- Biaya kesalahan lebih penting daripada tingkat kesulitan: Tugas sederhana namun berisiko tinggi juga layak menggunakan model unggulan.
- Default ke lapisan utama adalah pilihan paling aman: Lapisan menengah sebagai cadangan, naik-turun kelas berdasarkan sinyal, aturan sederhana dan mudah dipelihara.
- Lapisan bawah wajib memiliki validasi: Hanya output yang dapat diverifikasi secara programatis yang cocok diserahkan ke model ringan.
- Biaya dilihat dari total per tugas: Input, output, cache, dan retry harus dihitung secara terpisah.
- Pembaruan model harus diuji ulang: Iterasi model di tahun 2026 cepat, pemetaan lapisan perlu dikalibrasi secara berkala.
- Antarmuka terpadu menurunkan biaya peralihan: Melalui APIYI apiyi.com dapat menggunakan satu set antarmuka untuk memanggil beberapa model.
Kesimpulan
Poin-poin penting routing model bahasa besar berdasarkan lapisan tugas:
- Pembagian tiga lapisan: L1 menangani tugas ringan yang dapat diverifikasi, L2 menanggung lalu lintas default, L3 hanya menerima permintaan kompleks, berisiko tinggi, dan eskalasi.
- Prioritas aturan: Override manual, label risiko, panjang konteks, jenis tugas, lapisan default dinilai secara berurutan, kegagalan otomatis dieskalasi.
- Berbasis data: Catat tingkat kelulusan, tingkat retry, dan biaya per tugas setiap lapisan, sesuaikan ambang batas dengan data nyata bukan perasaan.
Routing berlapis tidak bertujuan “semua menggunakan model termurah”, tetapi membuat kemampuan model unggulan digunakan di tempat yang benar-benar membutuhkannya. Disarankan mulai dari satu atau dua tugas frekuensi tinggi, jalankan rantai lengkap “klasifikasi, pemanggilan, validasi, eskalasi, pencatatan”, lalu secara bertahap perluas ke lebih banyak bisnis.
Direkomendasikan untuk memverifikasi solusi berlapis dengan cepat melalui APIYI apiyi.com, platform menyediakan antarmuka terpadu multi-model, petunjuk integrasi lihat docs.apiyi.com, harga mengacu pada docs.apiyi.com/models.
📚 Referensi
- Daftar artikel blog Ofox.ai (April–Mei 2026): Mencakup peluncuran dan perbandingan model seperti GPT-5.5, DeepSeek V4, dan Claude Opus
- Tautan:
ofox.ai/blog/page/35 -
Keterangan: Berisi analisis pihak ketiga seperti perutean model hibrida dan perhitungan biaya cache; artikel ini hanya mengutip informasi faktual di dalamnya
-
Daftar artikel blog Ofox.ai (peluncuran dan evaluasi model): Mencakup GPT-5.5 Instant, tolok ukur model utama, dan perbandingan biaya per tugas
- Tautan:
ofox.ai/blog/page/36 -
Keterangan: Cocok untuk memahami positioning publik model-model utama pada 2026
-
Daftar artikel blog Ofox.ai (model kecil dan model sumber terbuka): Mencakup model ringan dan sumber terbuka seperti Claude Haiku, GPT-5.4 Mini, dan Llama 4
- Tautan:
ofox.ai/blog/page/37 -
Keterangan: Cocok sebagai referensi saat memilih model kandidat untuk lapisan L1 dan L2
-
Pusat Dokumentasi APIYI: Alamat akses, format antarmuka, dan penjelasan nama model
- Tautan:
docs.apiyi.com -
Keterangan: Harap periksa terlebih dahulu sebelum mengintegrasikan antarmuka yang kompatibel dengan OpenAI atau Anthropic
-
Halaman Harga Model APIYI: Data penagihan input, output, dan cache untuk setiap model
- Tautan:
docs.apiyi.com/models - Keterangan: Semua perhitungan biaya dalam artikel ini mengacu pada data aktual di halaman ini
Penulis: Tim Teknis APIYI
Komunikasi Teknis: Silakan hubungi kami melalui halaman utama situs APIYI apiyi.com; materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com