Nota del autor: este artículo explica, desde tres dimensiones —dificultad de la tarea, costo del error y tamaño del contexto—, cómo enrutar modelos de lenguaje grandes por capas según la tarea y reservar el modelo insignia para las solicitudes que realmente lo necesitan.
Para muchas empresas, el primer paso al integrar modelos de lenguaje grandes es enviar todas las solicitudes al modelo insignia más potente del momento. En la fase de prototipo no hay problema, pero cuando aumenta el volumen de solicitudes la factura crece muy rápido, y la mayoría de esas solicitudes podrían resolverse con modelos medianos y pequeños. Este artículo presenta una forma práctica de implementar el enrutamiento por capas de modelos de lenguaje grandes según la tarea, para ayudarte a determinar qué solicitudes realmente merecen el modelo insignia.
Este no es un artículo que defienda la idea de que “un modelo barato funciona igual de bien”. El modelo insignia sigue teniendo ventajas claras en razonamiento complejo, modificaciones de código de varios pasos y salidas de alto riesgo. El enrutamiento por capas busca “darle a cada solicitud el modelo adecuado”, no reducir costos a toda costa.
Valor clave: al terminar de leer, contarás con un estándar de clasificación de tareas en 3 niveles, una lista de verificación para configurar las reglas de enrutamiento y un método para calibrar la estrategia de enrutamiento con datos después de la puesta en producción.
Aspectos clave del enrutamiento por capas de modelos de lenguaje grande según la tarea
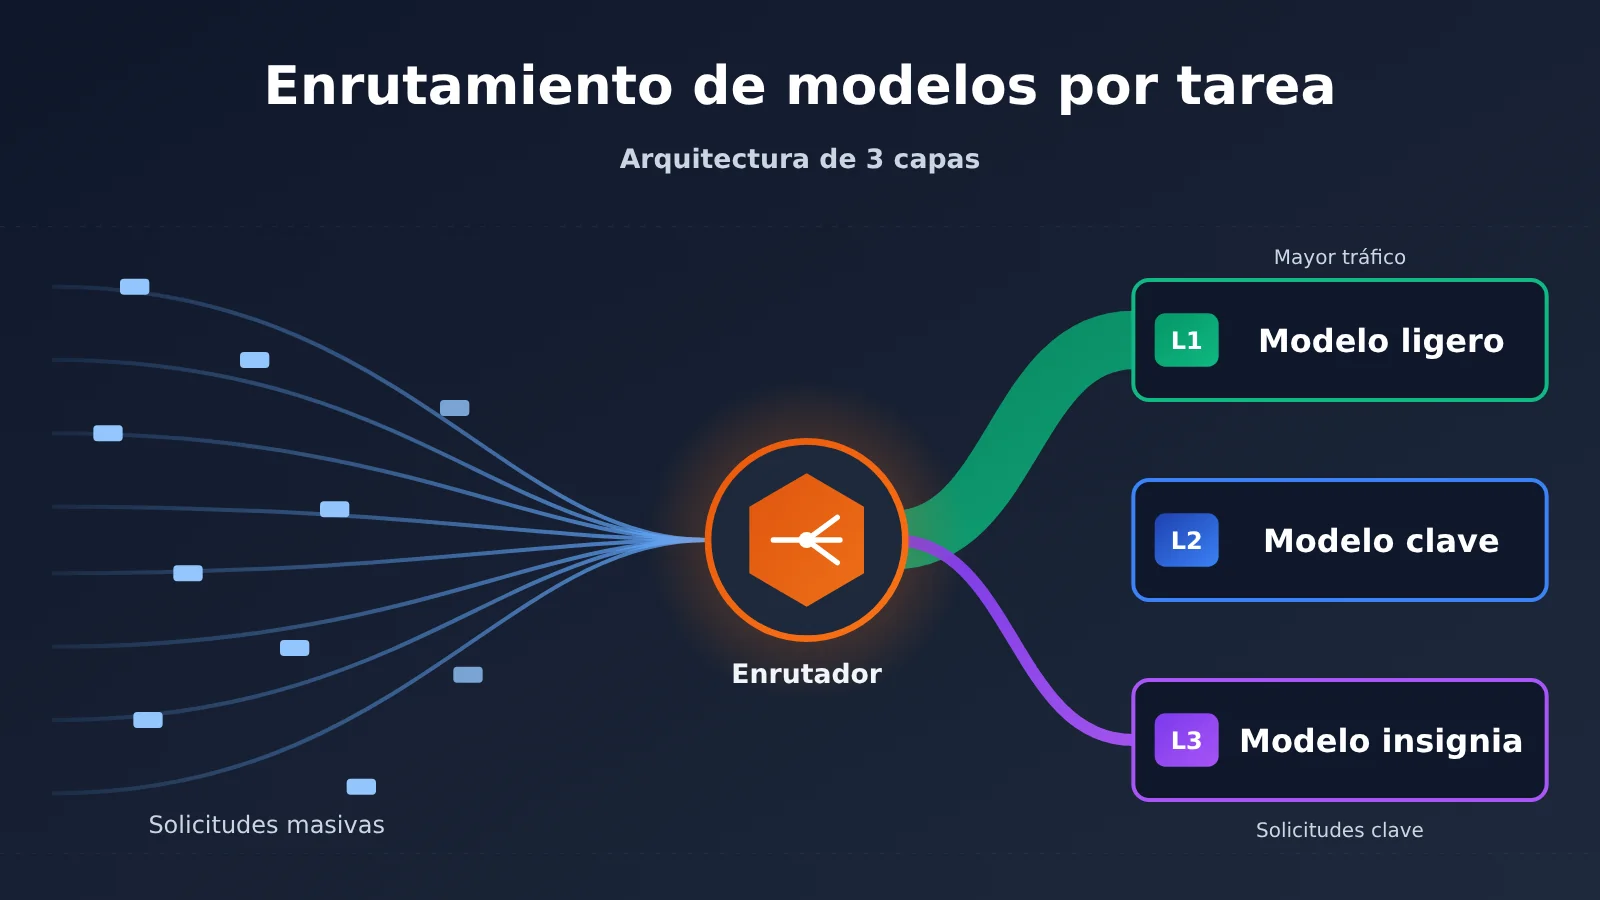
Antes de entrar en la configuración concreta, conviene dejar claros varios criterios centrales del enrutamiento por capas. Son los que determinan en qué capa debe ubicarse una solicitud y también si la estrategia de enrutamiento se puede mantener de forma sostenible.
| Punto clave | Descripción | Valor |
|---|---|---|
| Enrutar por tarea, no por usuario | Las solicitudes de un mismo usuario pueden tener niveles de dificultad muy distintos; conviene usar las características de cada tarea individual como base para el enrutamiento | Evita el desperdicio de enviar a todos los «usuarios VIP» al modelo insignia |
| El coste del error pesa más que la dificultad de la tarea | Una tarea sencilla pero con consecuencias graves si falla también puede requerir el modelo insignia o una validación secundaria | Controla el riesgo de incidentes en producción |
| Por defecto, usar la capa intermedia y subir o bajar según las señales | El modelo principal absorbe la mayor parte del tráfico y solo se asciende o desciende de nivel cuando se cumplen ciertas condiciones | Pocas reglas, fácil de mantener y de revertir |
| Si falla, se puede escalar | Cuando la salida de un modelo de capa inferior no pasa la validación, se reintenta automáticamente en una capa superior | Cambia un pequeño coste de reintentos por una mejor calidad global |
| Calibrar con datos | Registrar la tasa de éxito, la tasa de reintentos y el coste por tarea de cada capa, y ajustar los umbrales periódicamente | Mantiene la estrategia de enrutamiento vigente a medida que evolucionan los modelos |
Detalle clave del enrutamiento por capas: por qué no se puede usar siempre el modelo insignia
El panorama de modelos de 2026 hace que el enrutamiento por capas sea aún más necesario. Tomando como ejemplo la información pública citada en las referencias, OpenAI lanzó GPT-5.5 el 24 de abril de 2026, con contexto de un millón de tokens; ese mismo día, DeepSeek publicó la serie V4, dividida en dos variantes, Pro y Flash, que también admite un contexto de 1M y libera los pesos bajo licencia Apache 2.0. Al mismo tiempo, modelos como la serie Claude Opus, Gemini 3.1 Pro y Kimi K2.6 siguen acercándose en tareas de programación y razonamiento.
Cuando las puntuaciones de los modelos líderes en los benchmarks habituales se acercan cada vez más, el «coste por tarea» se convierte en el indicador clave para distinguirlos. Algunos artículos de evaluación de terceros señalan que las puntuaciones de varios modelos en benchmarks de programación ya son muy similares, y que lo que realmente marca la diferencia es el coste de completar cada tarea. Otros análisis sostienen que, en escenarios de agentes de programación como Claude Code, la mayor parte del consumo de tokens no necesita ser gestionada por el modelo más avanzado. Todas son opiniones de terceros y los porcentajes concretos varían según el negocio, pero la dirección es clara: usar el modelo insignia solo donde de verdad aporta resulta más rentable que usarlo para todo.
Otro punto que se suele pasar por alto es la latencia. Los modelos insignia suelen razonar con mayor profundidad y generar respuestas más largas; en tareas de respuesta inmediata como clasificación, extracción o reescritura, el tiempo de espera del usuario termina siendo mayor. Las referencias mencionan que, después de que GPT-5.5 Instant se convirtiera en el modelo predeterminado de ChatGPT, la longitud de las respuestas se redujo de forma notable y la tasa de alucinaciones bajó, lo que indica que una versión ligera orientada a «preguntas y respuestas rápidas» es en sí misma una dirección de producto que los proveedores consideran válida.
Cómo dividir los 3 niveles de tareas en el enrutamiento por capas de Modelos de Lenguaje Grande
La clave del enrutamiento por capas es encontrar, para cada tipo de tarea, el modelo que sea “justo lo suficientemente capaz”. La siguiente tabla es una forma general de división que hemos resumido en varios proyectos; puedes añadir o quitar según tu propio negocio.
| Nivel | Tareas típicas | Señal de decisión | Tipo de modelo recomendado |
|---|---|---|---|
| L1 Capa ligera | Clasificación de intenciones, extracción de palabras clave, conversión de formato, reescritura de textos cortos, preguntas y respuestas simples | Entrada corta, salida con estructura fija, reglas de validación claras | Modelos de nivel Haiku, nivel Mini, nivel Flash |
| L2 Capa principal | Conversación habitual, resumen de documentos, generación de código de complejidad media, preguntas y respuestas RAG | Requiere cierta capacidad de comprensión y organización, pero los errores se pueden detectar y corregir | Nivel Sonnet, modelos de código abierto con gran cantidad de parámetros, modelos generales de nivel Pro |
| L3 Capa insignia | Razonamiento de varios pasos, refactorización de código entre archivos, diseño de arquitectura, resultados de alto riesgo como legal o financiero | Dependencias de varios pasos, errores ocultos y costosos, análisis integral de contextos muy largos | Modelos insignia como nivel Opus, nivel GPT-5.5 |
Cómo identificar las tareas de la capa ligera L1
La característica clave de la capa L1 es que “su salida puede ser validada por un programa”. Por ejemplo, en la clasificación de intenciones solo se puede elegir una etiqueta de un conjunto fijo; en la extracción JSON se puede validar con un esquema; en la conversión de formato se puede comparar la integridad de los campos. Siempre que las reglas de validación sean lo bastante estrictas, los errores del modelo ligero se pueden interceptar automáticamente y escalar su procesamiento.
En los materiales de referencia hay artículos comparativos que señalan que modelos pequeños como Claude Haiku 4.5 y GPT-5.4 Mini tienen enfoques distintos: el primero rinde mejor en calidad de código, mientras que el segundo tiene ventaja en velocidad. Este tipo de modelos es adecuado para asumir tráfico de alta frecuencia y baja complejidad, y es una de las principales fuentes de ahorro de costos en el enrutamiento por capas.
Cómo identificar las tareas de la capa principal L2
La capa L2 asume la mayoría de las solicitudes que “requieren pensar, pero no son difíciles”, y también es el destino de enrutamiento predeterminado recomendado. Establecer el valor predeterminado en la capa intermedia tiene dos ventajas: por un lado, evita que un error de clasificación haga que muchas solicitudes complejas se degraden a la capa ligera; por otro, mantiene simples tanto las reglas de escalado como las de degradación.
El rendimiento de los modelos de código abierto en esta capa merece atención. En los materiales de referencia hay evaluaciones de terceros que consideran que DeepSeek V4 Flash no está muy lejos de V4 Pro en tareas de programación con límites claros, y que Kimi K2.6 solo se queda unos pocos puntos por detrás de Claude Opus 4.6 en los benchmarks de programación más comunes. Esto significa que muchas tareas de programación que antes se asignaban por defecto al modelo insignia pueden intentarse primero en la capa principal.
Cómo identificar tareas del nivel L3 (insignia)
Las solicitudes que realmente merecen un modelo insignia suelen cumplir al menos dos de las siguientes condiciones:
- Cadena de razonamiento larga: requieren planificación en varios pasos y verificación reiterada de conclusiones intermedias, por ejemplo, localización de bugs complejos, demostraciones matemáticas o programación con múltiples restricciones.
- Errores difíciles de detectar y con alto costo: la salida parece razonable, pero los errores en los detalles son muy difíciles de encontrar, por ejemplo, en análisis de cláusulas contractuales, cálculos con criterios financieros específicos o código relacionado con seguridad.
- Alta dificultad para sintetizar el contexto: se necesita relacionar información entre párrafos a lo largo de cientos de miles de tokens, no solo recuperar un fragmento concreto.
- Las capas inferiores ya fallaron: la salida de la capa L2 no pasó la validación o el usuario indicó claramente que el resultado no sirve.
🎯 Recomendación técnica: el enrutamiento por capas requiere integrar varios modelos a la vez. Si cada proveedor exige un contrato y una adaptación del SDK por separado, el costo de mantenimiento termina anulando los beneficios del enrutamiento. APIYI apiyi.com ofrece acceso vía API a las series de modelos GPT, Claude, Gemini, DeepSeek y otros mencionados en este artículo, y es compatible con los formatos de interfaz de OpenAI y Anthropic; al cambiar de modelo, normalmente solo hay que modificar el parámetro del nombre del modelo.
Inicio rápido del enrutamiento jerárquico de modelos de lenguaje grande
A continuación, una lista de configuración para explicar un esquema mínimo viable de enrutamiento por niveles. Este artículo no incluye fragmentos de código; todos los elementos clave de configuración se describen en tablas, y puedes implementarlos con el framework que uses.
Paso 1: capa de acceso unificada
La premisa del enrutamiento por niveles es «cambiar de modelo sin cambiar el código». Se recomienda que todas las solicitudes a modelos pasen por una función de llamada unificada. La función solo recibe el tipo de tarea, el contenido del mensaje y un parámetro opcional de sobrescritura de nivel; internamente, decide qué modelo invocar realmente según las reglas de enrutamiento.
En cuanto a la integración, si tu proyecto ya usa el SDK de OpenAI, puedes mantener la interfaz estilo chat completions; si usas el SDK de Anthropic, también puedes mantener la interfaz estilo messages. APIYI es compatible con ambos formatos. Para la dirección de acceso, el método de autenticación y la lista de nombres de modelos, consulta la información del centro de documentación de APIYI en docs.apiyi.com.
Paso 2: definir la configuración de las reglas de enrutamiento
La siguiente tabla muestra los elementos de configuración más habituales en un conjunto de reglas de enrutamiento. Se recomienda escribirlos en un archivo de configuración independiente para poder ajustarlos sin reiniciar el servicio.
| Elemento de configuración | Significado | Criterio de valor recomendado |
|---|---|---|
task_type |
Etiqueta del tipo de tarea, como classify, extract, summarize, code o reason | Se etiqueta directamente desde la entrada del negocio; es más estable que clasificar con un modelo |
default_tier |
Nivel que se usa cuando no coincide ninguna regla | Se recomienda configurarlo en L2, la capa principal |
risk_level |
Etiqueta de riesgo del negocio, dividida en low, medium y high | high se enruta directamente a L3 o se añaden pasos de validación |
context_threshold |
Umbral de tokens de entrada que activa una escalada | Se define según la ventana de contexto y el rendimiento con textos largos de cada modelo |
validator |
Método de validación de la salida, como JSON schema, expresiones regulares, pruebas unitarias o revisión por un segundo modelo | Obligatorio en L1; recomendable en L2 |
max_escalation |
Número máximo de escaladas tras un fallo de validación | Normalmente de 1 a 2 veces, para evitar reintentos infinitos |
tier_model_map |
Nombres de modelo y modelos de respaldo correspondientes a cada nivel | Los nombres de modelo se rigen por la lista de modelos de la documentación de APIYI |
Paso 3: configurar la lógica de escalada y degradación
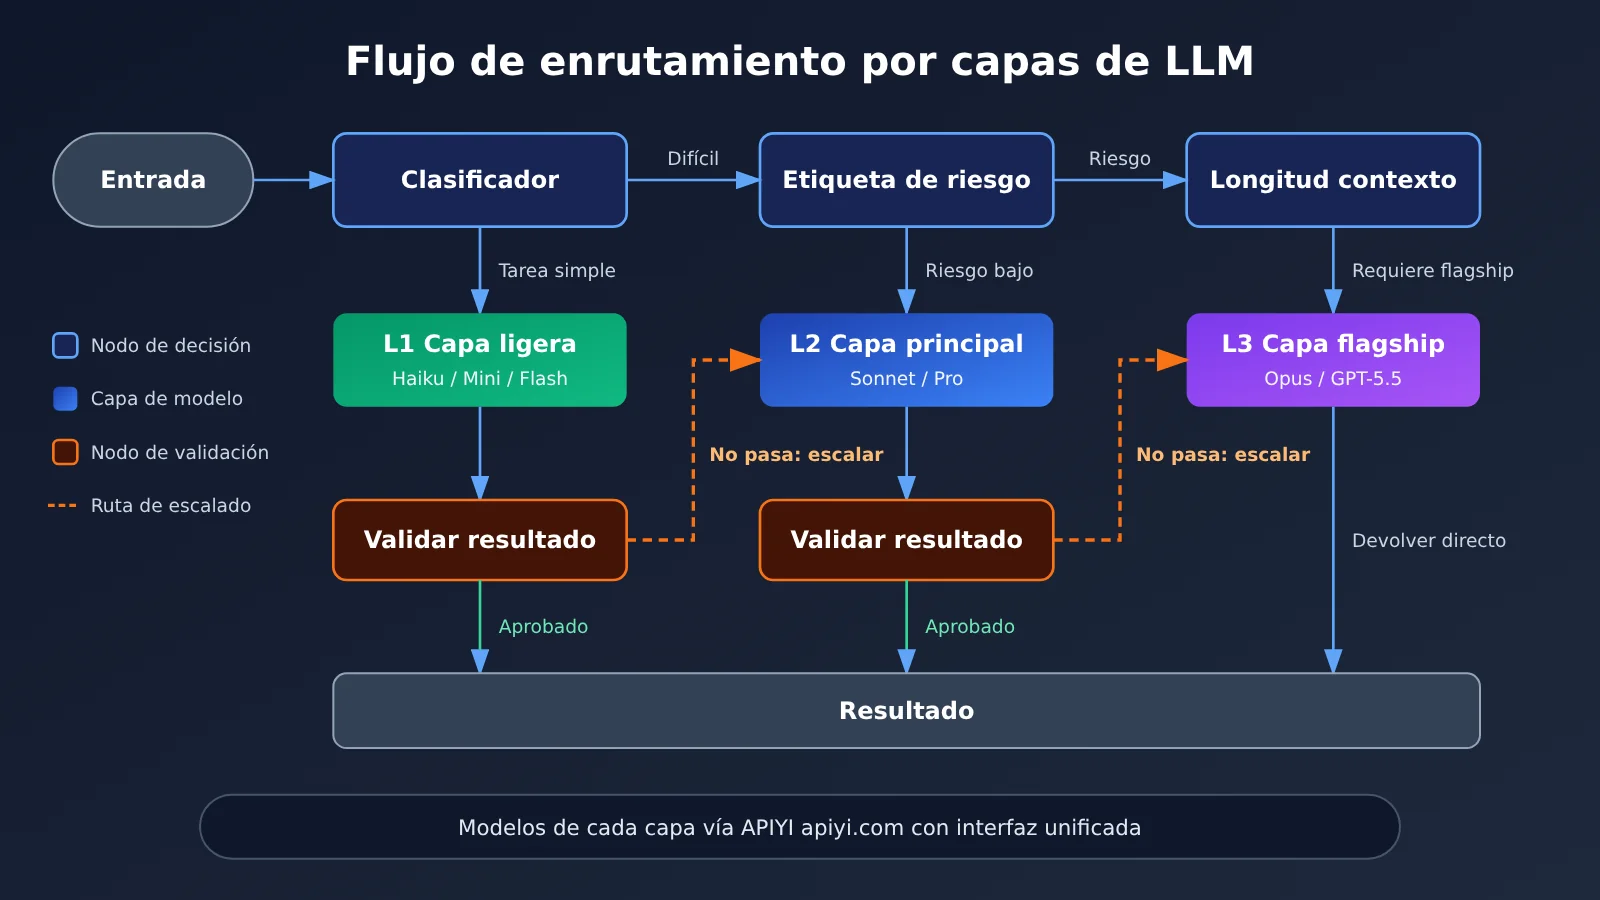
Se recomienda evaluar las reglas de enrutamiento en el siguiente orden; cuanto más arriba esté una regla, mayor prioridad tiene:
- Si el cliente especifica explícitamente un parámetro de sobrescritura de nivel, se usa directamente el nivel indicado; esto facilita la depuración y la intervención manual.
- Si
risk_leveles high, se enruta a L3, la capa insignia. - Si la longitud de la entrada supera
context_threshold, se enruta como mínimo a L2 y, según el tipo de tarea, se decide si se escala a L3. - Se consulta la tabla según
task_type: las tareas de clasificación, extracción y conversión de formato se enrutan a L1. - Si no se cumple ninguna de las reglas anteriores, se usa
default_tier. - Si la salida no pasa la validación de
validator, se escala un nivel y se reintenta hasta alcanzar el límite demax_escalation.
Paso 4: registrar las métricas clave de cada nivel
Una vez que el enrutamiento esté en producción, como mínimo hay que registrar para cada solicitud el nivel, el nombre del modelo, el número de tokens de entrada y salida, si hubo acierto en caché, si se produjo una escalada con reintento y si la validación se superó. Estos datos son la única base para ajustar los umbrales más adelante; una estrategia de enrutamiento sin logs solo se puede ajustar a ojo.
🚀 Inicio rápido: se recomienda ejecutar primero en el entorno de pruebas la misma tanda de solicitudes reales en los tres niveles L1, L2 y L3, y comparar la tasa de aprobación y el costo por tarea. A través de APIYI, en apiyi.com, puedes cambiar entre varios modelos con la misma interfaz, lo que facilita completar rápidamente este tipo de experimentos comparativos.
Comparación entre modelos insignia y modelos principales en el enrutamiento por capas
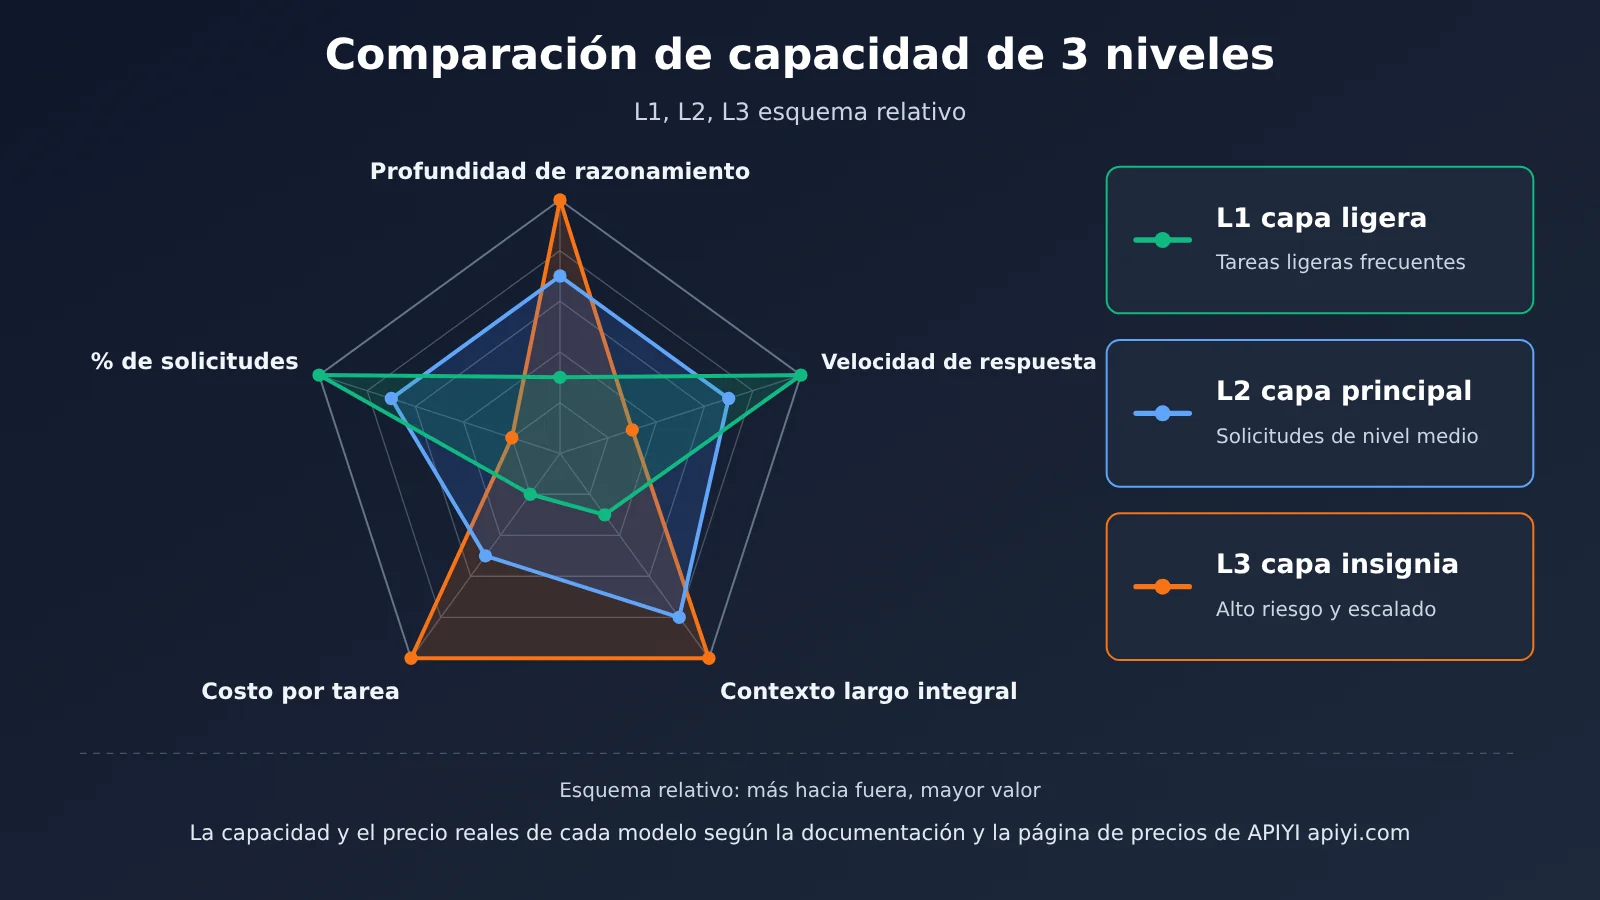
La siguiente tabla clasifica por capas los modelos más habituales mencionados en las referencias, para que puedas elegir candidatos para cada capa. El posicionamiento indicado proviene de información pública y evaluaciones de terceros; el rendimiento concreto varía con las actualizaciones de versión, así que conviene volver a medirlo con tus propios datos de negocio.
| Modelo | Posicionamiento habitual | Capa adecuada | Plataforma disponible |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | Codificación compleja y razonamiento de varios pasos | Capa insignia L3 | APIYI apiyi.com, API oficial |
| GPT-5.5 | Insignia general, contexto de 1M | Capa insignia L3 | APIYI apiyi.com, API oficial |
| Gemini 3.1 Pro | Razonamiento y contexto largo, con una relación calidad-precio destacada | L2 a L3 | APIYI apiyi.com, API oficial |
| DeepSeek V4 Pro | Código abierto de gran cantidad de parámetros, contexto de 1M | Capa principal L2 | APIYI apiyi.com, API oficial |
| Kimi K2.6 | Capacidad de codificación cercana a la insignia | Capa principal L2 | APIYI apiyi.com, API oficial |
| DeepSeek V4 Flash | Bajo costo, adecuado para tareas con límites claros | L1 a L2 | APIYI apiyi.com, API oficial |
| Claude Haiku 4.5 / GPT-5.4 Mini | Tareas ligeras de alta frecuencia | Capa ligera L1 | APIYI apiyi.com, API oficial |
Análisis comparativo entre modelos insignia y modelos principales
Análisis comparativo de los modelos insignia: modelos insignia como Claude Opus y GPT-5.5 mantienen el liderazgo en razonamiento de varios pasos, modificación de código entre archivos e identificación de errores sutiles. Pero su precio unitario y su latencia de respuesta son claramente más altos; usarlos para tareas simples como clasificación o reescritura es un desajuste evidente de recursos. En cambio, los modelos insignia encajan mejor en la capa L3, donde solo atienden solicitudes de alto riesgo y aquellas que se escalan tras un fallo en capas inferiores.
Análisis comparativo de los modelos principales de código abierto: DeepSeek V4 y Kimi K2.6 rinden muy bien en codificación habitual y procesamiento de documentos; evaluaciones de terceros muestran que su diferencia frente a los modelos insignia ya es pequeña en bastantes tareas. Sin embargo, en tareas que requieren cadenas largas de razonamiento y muchas restricciones implícitas, la brecha sigue existiendo. Para la mayoría de solicitudes de complejidad media, los modelos de la capa principal siguen siendo la opción predeterminada más segura y económica.
💡 Recomendación de elección: qué modelo elegir en cada capa depende sobre todo de la distribución de tus tareas y de tus requisitos de calidad. Te sugerimos usar APIYI apiyi.com para hacer una prueba comparativa de los modelos candidatos con el mismo lote de muestras y, después, decidir el modelo principal y el de respaldo de cada capa.
Método de cálculo de costes del enrutamiento por niveles
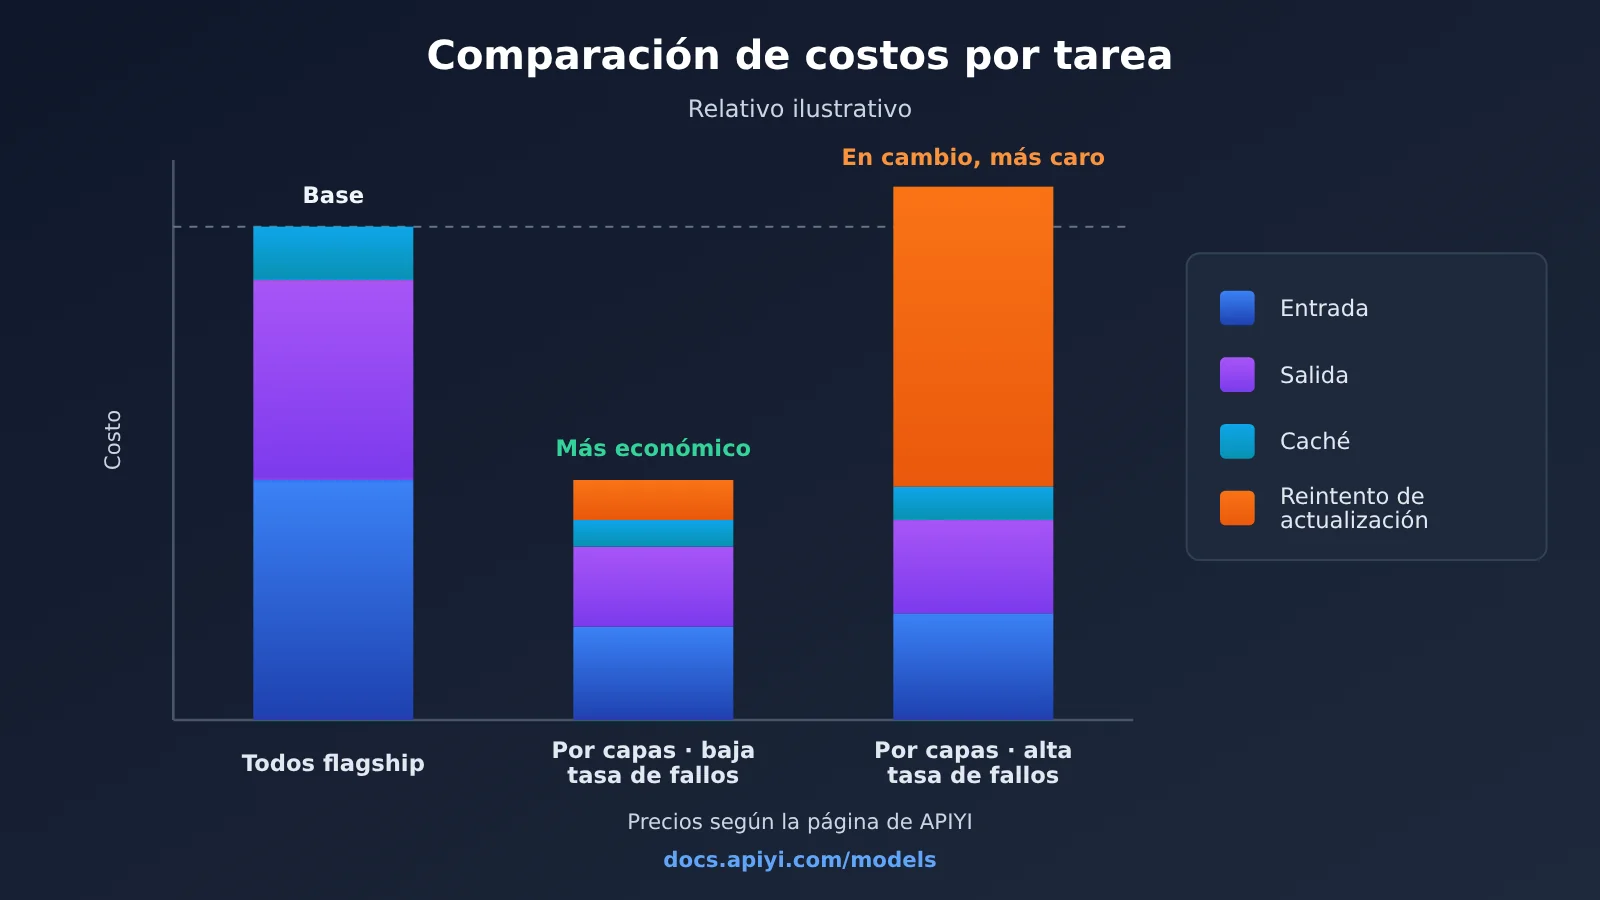
Que el enrutamiento por niveles ahorre dinero no depende solo del precio unitario, sino del «coste total por tarea». El coste total de una tarea suele estar formado por varios conceptos de facturación, y si uno solo se calcula mal, la conclusión queda distorsionada.
| Concepto de facturación | Descripción | Base del precio |
|---|---|---|
| Tokens de entrada | Volumen total de indicaciones, contexto e historial de mensajes | Según los datos reales de la página de precios de APIYI: docs.apiyi.com/models |
| Tokens de salida | Contenido generado por el modelo; en los modelos de razonamiento puede incluir tokens de pensamiento | Según los datos reales de la página de precios de APIYI: docs.apiyi.com/models |
| Lectura de caché | Parte de la entrada que acierta en la caché de indicaciones | Según los datos reales de la página de precios de APIYI: docs.apiyi.com/models |
| Escritura de caché | Parte de la entrada que se escribe en caché por primera vez; algunos modelos la facturan aparte | Según los datos reales de la página de precios de APIYI: docs.apiyi.com/models |
| Reintento por escalado | Todos los costes generados al reejecutar en un nivel superior tras un fallo en el nivel inferior | Se acumulan según el nivel de invocación realmente utilizado |
Errores habituales al calcular el coste por tarea del enrutamiento por niveles
El primer error es contar dos veces los tokens de caché. En el material de referencia hay artículos que advierten expresamente de que, al calcular el coste de caché, hay que separar la lectura, la escritura, la entrada normal, la salida y los reintentos; de lo contrario es muy fácil contar dos veces el mismo lote de tokens. El segundo error es ignorar el coste de los reintentos por escalado: si la tasa de fallo de validación en el nivel L1 es alta, «probar primero el modelo barato» puede salir más caro que usar directamente el modelo principal.
Por eso conviene usar una fórmula sencilla para evaluar si un tipo de tarea encaja en un nivel inferior: coste de una ejecución en el nivel inferior más «tasa de fallo multiplicada por el coste de una ejecución en el nivel superior». Si ese valor es claramente inferior al coste de usar directamente el nivel superior y, además, la calidad final es aceptable, entonces ese tipo de tarea es buen candidato para bajar de nivel. Para los precios unitarios concretos de cada modelo, los precios de caché y los criterios de facturación, tómense siempre como referencia los datos en tiempo real de la página de precios de APIYI en docs.apiyi.com/models; este artículo no ofrece cifras de precio concretas.
💰 Optimización de costes: al hacer estimaciones de coste, conviene leer directamente en la página de precios de APIYI los precios unitarios de entrada, salida y caché de cada modelo, y luego combinar esos datos con los registros propios para calcular el coste por tarea. Dentro de una misma plataforma los criterios de facturación son coherentes, así que al comparar entre modelos es menos probable equivocarse.
Preguntas frecuentes (FAQ)
P1: ¿Qué es el enrutamiento por capas de Modelos de Lenguaje Grande según la tarea?
Se refiere a asignar cada solicitud a modelos de distintos niveles de capacidad y coste en función del tipo de tarea, el nivel de riesgo y el tamaño del contexto. Las tareas simples se encomiendan a modelos ligeros, las tareas habituales al modelo principal y solo las tareas complejas o de alto riesgo llegan al modelo insignia.
P2: ¿Qué diferencia hay entre el enrutamiento por capas y una simple «degradación a un modelo más barato»?
Una degradación simple suele ser un reemplazo global, y la calidad cae en conjunto. El enrutamiento por capas, en cambio, trata cada tarea de forma diferenciada y cuenta con mecanismos de validación y escalado automático: las solicitudes que fallan en un nivel inferior se reenvían a un modelo más potente para rehacerlas, de modo que se mantiene la calidad mientras se controla el coste.
P3: Tras el lanzamiento de los nuevos modelos de 2026, ¿hay que reajustar la estrategia de enrutamiento?
Sí. En la primera mitad de 2026 se publican en rápida sucesión modelos como GPT-5.5, DeepSeek V4 y las nuevas versiones de Claude Opus, y los límites de capacidad entre niveles cambian muy rápido. Se recomienda que, tras cada actualización importante de modelos, se vuelva a ejecutar el conjunto de pruebas fijo para medir la tasa de aprobación de cada nivel y, a partir de ahí, decidir si conviene ajustar la asignación de niveles.
P4: ¿Qué solicitudes merecen más la pena usar el modelo insignia?
Principalmente estas categorías:
– **Refactorización de código entre archivos y localización de bugs complejos**: requieren comprender las dependencias entre una gran cantidad de contexto.
– **Salidas en ámbitos de alto riesgo**: como revisión de contratos, verificación de criterios financieros o generación de políticas de seguridad.
– **Tareas de razonamiento con múltiples restricciones**: como planificación compleja, sopesar alternativas o derivaciones matemáticas.
– **Solicitudes que ya fallaron en niveles inferiores**: como red de seguridad para el escalado.
P5: ¿Cómo montar rápidamente un entorno de pruebas de enrutamiento por capas mediante la API?
Se recomienda usar una plataforma agregadora de API compatible con varios modelos:
1. Entra en APIYI apiyi.com, registra una cuenta y obtén la clave API.
2. Consulta en el centro de documentación de APIYI, docs.apiyi.com, la dirección de acceso y los nombres de modelos disponibles.
3. Siguiendo la lista de configuración de este artículo, elige un modelo para L1, otro para L2 y otro para L3, y compara la tasa de aprobación con el mismo lote de muestras.
APIYI es compatible con los formatos de interfaz de OpenAI y Anthropic, así que los proyectos existentes normalmente pueden integrarse sin grandes cambios.
P6: Si la clasificación de tareas se hace con un modelo, ¿no aumenta el coste?
Sí, supone un pequeño coste adicional, por eso conviene priorizar el etiquetado directo en el punto de entrada del negocio; por ejemplo, la «entrada de preguntas y respuestas de atención al cliente» ya corresponde por defecto a cierto tipo de tarea. Solo cuando el punto de entrada no permita distinguirla se recurre a un modelo ligero de L1 para clasificar, y ese coste suele ser muy inferior al desperdicio de usar el modelo insignia por error.
P7: ¿Qué limitaciones conocidas tiene el enrutamiento por capas?
Básicamente tres: primero, las reglas requieren mantenimiento continuo y los umbrales pueden quedar obsoletos cuando se actualizan los modelos; segundo, el reintento con escalado añade latencia a parte de las solicitudes, algo que hay que sopesar en escenarios con requisitos de tiempo real muy estrictos; tercero, el estilo de salida de los distintos modelos no es uniforme, así que los productos orientados al usuario pueden necesitar un posprocesamiento que lo homogeneice. Cuando aparecen estos problemas, se puede subir un poco el nivel por defecto o reducir el número de niveles.
P8: ¿Dónde conviene consultar los precios del enrutamiento por capas?
Todos los precios unitarios de entrada, salida y caché de todos los modelos, así como los criterios de facturación, deben basarse en los datos reales de la página de precios de APIYI docs.apiyi.com/models. Los precios que aparecen en artículos de terceros pueden corresponder a canales distintos de los que usas realmente, así que no se recomienda tomarlos directamente para elaborar presupuestos.
Puntos clave del enrutamiento por capas de modelos de lenguaje grandes según la tarea
- La base de la clasificación es la tarea, no el usuario: las solicitudes de un mismo usuario varían mucho en dificultad y deben evaluarse una por una.
- El coste de un error importa más que la dificultad: una tarea sencilla pero de alto riesgo también merece un modelo insignia.
- Lo más seguro es usar la capa principal por defecto: la capa intermedia actúa como respaldo y se sube o baja de nivel según las señales; reglas simples y fáciles de mantener.
- La capa inferior debe llevar validación: solo las salidas que se pueden verificar mediante programas son aptas para delegarse a modelos ligeros.
- El coste se mira por el total de la tarea: entrada, salida, caché y reintentos deben calcularse por separado.
- Hay que volver a probar cuando cambian los modelos: en 2026 la iteración de modelos es rápida y el mapeo de capas debe recalibrarse periódicamente.
- Una interfaz unificada reduce el coste de cambio: a través de APIYI apiyi.com puedes invocar modelos de varios proveedores con el mismo conjunto de interfaces.
Resumen
Los puntos clave para enrutar modelos de lenguaje grandes por capas según la tarea:
- División en tres capas: L1 maneja tareas ligeras y verificables, L2 asume el tráfico predeterminado, L3 solo recibe solicitudes complejas, de alto riesgo y escaladas.
- Prioridad de reglas: La anulación manual, las etiquetas de riesgo, la longitud del contexto, el tipo de tarea y la capa predeterminada se evalúan en orden; si falla, se escala automáticamente.
- Basado en datos: Registra la tasa de aprobación, la tasa de reintentos y el costo por tarea de cada capa, y ajusta los umbrales con datos reales en lugar de con sensaciones.
El enrutamiento por capas no busca «usar siempre el modelo más barato», sino hacer que la capacidad del modelo insignia se gaste donde realmente se necesita. Se recomienda empezar con una o dos tareas de alta frecuencia, validar la cadena completa de «clasificación, invocación, verificación, escalado, registro» y luego expandirse gradualmente a más negocios.
Se recomienda usar APIYI apiyi.com para validar rápidamente el esquema de capas. La plataforma ofrece una interfaz unificada para múltiples modelos; las instrucciones de integración están en docs.apiyi.com y los precios se rigen según docs.apiyi.com/models.
📚 Referencias
- Lista de artículos del blog de Ofox.ai (abril a mayo de 2026): cubre el lanzamiento y la comparación de modelos como GPT-5.5, DeepSeek V4, Claude Opus, etc.
- Enlace:
ofox.ai/blog/page/35 -
Descripción: incluye análisis de terceros sobre enrutamiento de modelos híbridos, cálculo de costos de caché, etc.; este artículo solo cita la información fáctica contenida en ellos.
-
Lista de artículos del blog de Ofox.ai (lanzamiento y evaluación de modelos): cubre GPT-5.5 Instant, benchmarks de los modelos principales y comparación de costos por tarea.
- Enlace:
ofox.ai/blog/page/36 -
Descripción: adecuado para conocer el posicionamiento público de los modelos principales de 2026.
-
Lista de artículos del blog de Ofox.ai (modelos pequeños y de código abierto): cubre modelos ligeros y de código abierto como Claude Haiku, GPT-5.4 Mini, Llama 4, etc.
- Enlace:
ofox.ai/blog/page/37 -
Descripción: adecuado como referencia para seleccionar modelos candidatos para las capas L1 y L2.
-
Centro de documentación de APIYI: direcciones de integración, formato de interfaz y descripción de nombres de modelos.
- Enlace:
docs.apiyi.com -
Descripción: consulta antes de integrar interfaces compatibles con OpenAI o Anthropic.
-
Página de precios de modelos de APIYI: datos de facturación de entrada, salida y caché de cada modelo.
- Enlace:
docs.apiyi.com/models - Descripción: todos los cálculos de costos de este artículo se basan en los datos reales de esta página.
Autor: Equipo técnico de APIYI
Contacto técnico: No dudes en contactarnos a través de la página principal del sitio web de APIYI apiyi.com; puedes encontrar más materiales de integración en el centro de documentación docs.apiyi.com.