Claude Fable 5.2 dirilis pada 9 November 2026. Harga standar API-nya 20% lebih rendah dibandingkan versi 5.1.
Banyak tim kemudian bertanya: kalau harganya lebih murah, apakah kita bisa langsung memilih max?
Artikel ini membandingkan Fable 5.2 high dan Fable 5.2 max dalam kerangka yang sama, sekaligus melihat kualitas dan biaya per tugas.
Manfaat utama: Setelah membaca artikel ini, Anda akan tahu kapan sebaiknya menggunakan high atau max pada Fable 5.2. Anda juga akan mendapatkan daftar catatan yang bisa langsung digunakan untuk mengevaluasi peningkatan.
Daftar isi
- Yang perlu diketahui: istilah terkait pemilihan tingkat Fable 5.2
- 1 Fable 5.2 high dan max tidak mengubah harga satuan yang sama
- 2 Membandingkan kualitas dan biaya Fable 5.2 dalam satu tabel
- 3 Memeriksa tren tingkat Fable 5.2 menggunakan data dari lembaga independen
- 4 Memilih tingkat Fable 5.2 berdasarkan penggunaan tugas
- 5 Menentukan apakah Fable 5.2 perlu ditingkatkan ke max melalui evaluasi sendiri
- Pertanyaan umum (FAQ) / Poin penting / Kesimpulan
Yang perlu diketahui
| Istilah | Arti | Hal yang perlu diperhatikan saat membaca artikel ini |
|---|---|---|
| Effort | Pengaturan untuk mengontrol seberapa besar upaya berpikir yang dicurahkan model | Nilai default API Fable 5.2 adalah high |
| Adaptive thinking | Mekanisme yang memungkinkan model mengalokasikan upaya berpikir secara otomatis | Selalu aktif di Fable 5.2 |
| Harness | Lingkungan eksekusi yang menyediakan alat, sesi, dan aturan eksekusi untuk model | Harness Cursor dan AA berbeda |
| Intelligence Index | Indeks gabungan yang dihitung AA dengan memberi bobot pada beberapa evaluasi | Ini adalah indeks, bukan tingkat akurasi |
| Poin persentase | Selisih absolut yang diperoleh dengan mengurangkan dua persentase | Dari 56,9% ke 60,0% adalah 3,1 poin persentase |
| Biaya per tugas | Biaya model yang dialokasikan untuk satu tugas dalam kondisi pengujian tertentu | Tidak sama dengan tagihan API Anda |
| Ambang penerimaan | Persyaratan kualitas yang harus dipenuhi tugas | Penuhi ambangnya terlebih dahulu, baru bandingkan anggaran |
| Pengelompokan tugas | Mengelompokkan tugas berdasarkan tingkat kesulitan dan dampak kegagalan | Tingkat yang berbeda memerlukan opsi yang berbeda |
1 High dan max di Fable 5.2 tidak mengubah harga satuan yang sama
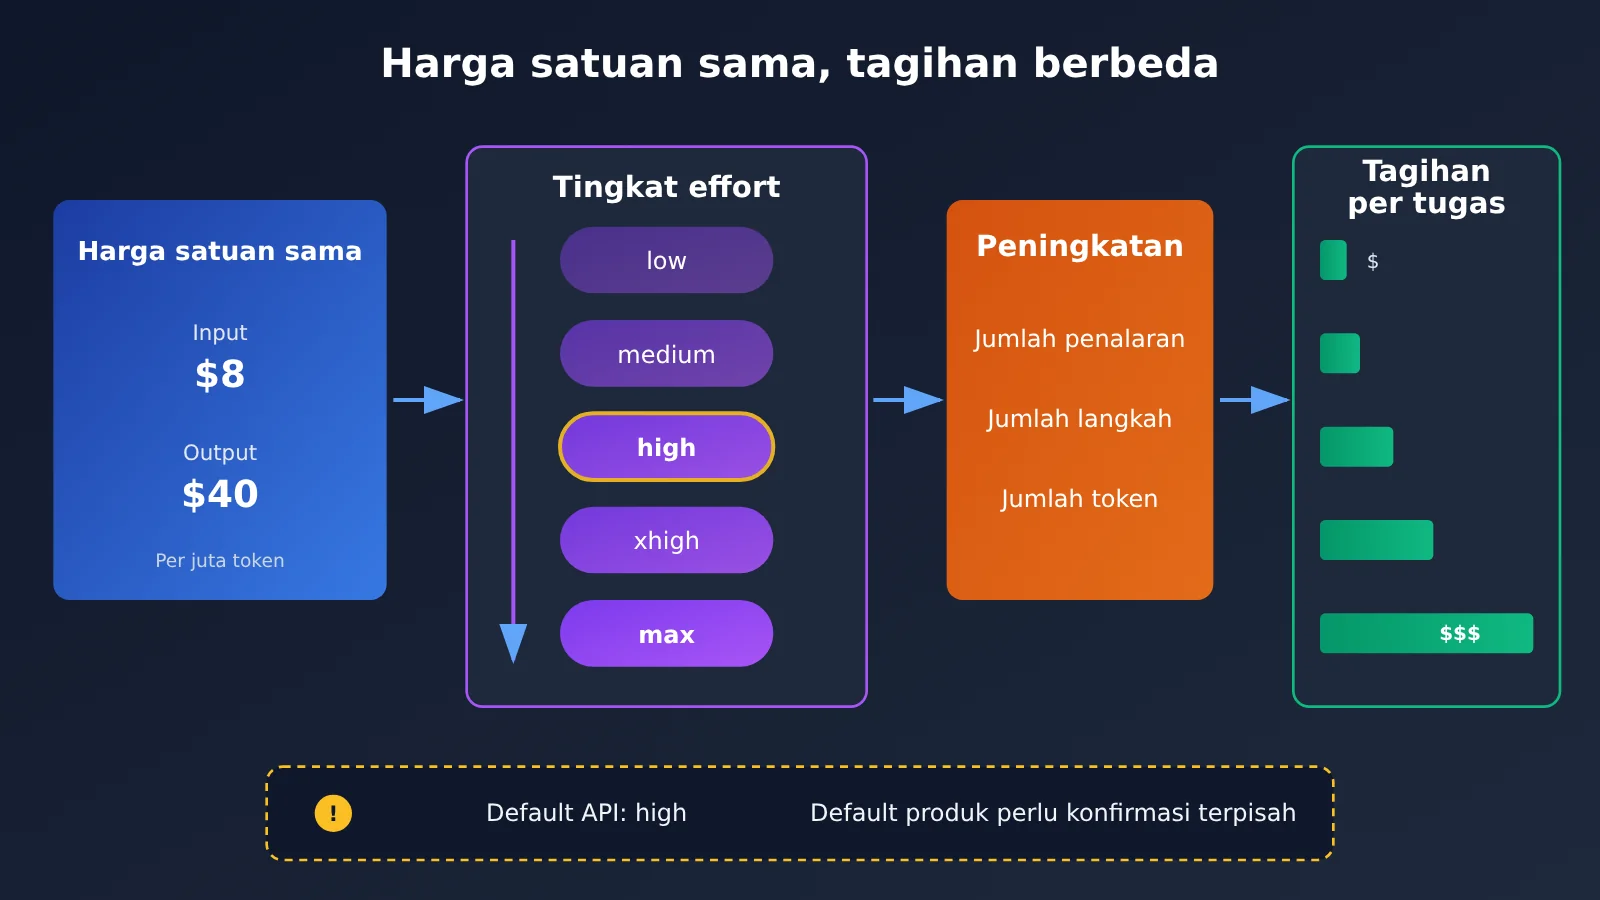
Banyak orang mengira bahwa semakin tinggi tingkatannya, semakin mahal harga satuannya. Padahal, menurut tarif standar resmi Anthropic, input Fable 5.2 dikenai biaya 8 dolar per sejuta token dan output 40 dolar per sejuta token. Harga satuan ini tidak berubah berdasarkan tingkatannya.
Effort menentukan seberapa besar upaya berpikir yang dicurahkan model untuk suatu tugas, berapa banyak langkah yang diambil, berapa lama waktu yang dibutuhkan, dan berapa banyak token yang digunakan. Jadi, harga satuannya sama, tetapi tagihan per tugas bisa berbeda beberapa kali lipat.
Bagaimana tingkat Fable 5.2 memengaruhi tagihan
Di Fable 5.2, adaptive thinking selalu aktif. Effort menentukan batas dan kecenderungan upaya berpikir model. Saat tingkatnya dinaikkan, model biasanya melakukan lebih banyak penalaran dan pemanggilan alat, sehingga token yang ditagihkan ikut bertambah.
Misalnya, dengan input yang sama sebanyak 100 ribu token, jika output meningkat dari 20 ribu menjadi 40 ribu token, biaya mode standar 5.2 akan naik dari 1,60 dolar menjadi 2,40 dolar—bahkan lebih tinggi daripada biaya 5.1 sebesar 2 dolar dengan penggunaan sebelumnya.
Selain itu, penting untuk membedakan dua jenis “nilai default”. Dokumentasi model resmi menyebutkan bahwa effort default API adalah high. Produk seperti Cursor memiliki lapisan konfigurasi sendiri. Misalnya, konteks default-nya adalah 300K, yang tidak berada pada lapisan yang sama dengan spesifikasi 1M dalam dokumentasi API.
Satu hal lagi: panduan petunjuk resmi mengingatkan bahwa tingkat dengan nama yang sama bisa menggunakan upaya berpikir yang berbeda di versi yang berbeda. Jadi, pengalaman menggunakan tingkat pada masa 5.1 tidak bisa begitu saja diterapkan ke 5.2.
2 Melihat kualitas dan biaya Fable 5.2 dalam satu tabel
CursorBench 4.0 adalah evaluasi yang dilakukan Cursor menggunakan tugas dan lingkungan alatnya sendiri. Evaluasi ini bukan pengujian ulang independen yang bersifat umum, tetapi membandingkan lima level dalam Harness yang sama sehingga cocok untuk mengamati perubahan relatif antarlevel. Data berikut diambil pada 10 November 2026.
| Level Fable 5.2 | Skor | Biaya per tugas (dolar) | tokens (kolom agregat) | Langkah |
|---|---|---|---|---|
| Low | 53.2% | 3.94 | 36,616 | 30 |
| Medium | 54.8% | 4.66 | 44,103 | 35 |
| High | 56.9% | 9.70 | 99,259 | 69 |
| Extra High | 56.3% | 15.48 | 161,251 | 108 |
| Max | 60.0% | 32.79 | 352,794 | 218 |
Catatan: Kolom tokens adalah kolom agregat pada halaman benchmark, bukan hanya jumlah token keluaran. Sumber: CursorBench 4.0.
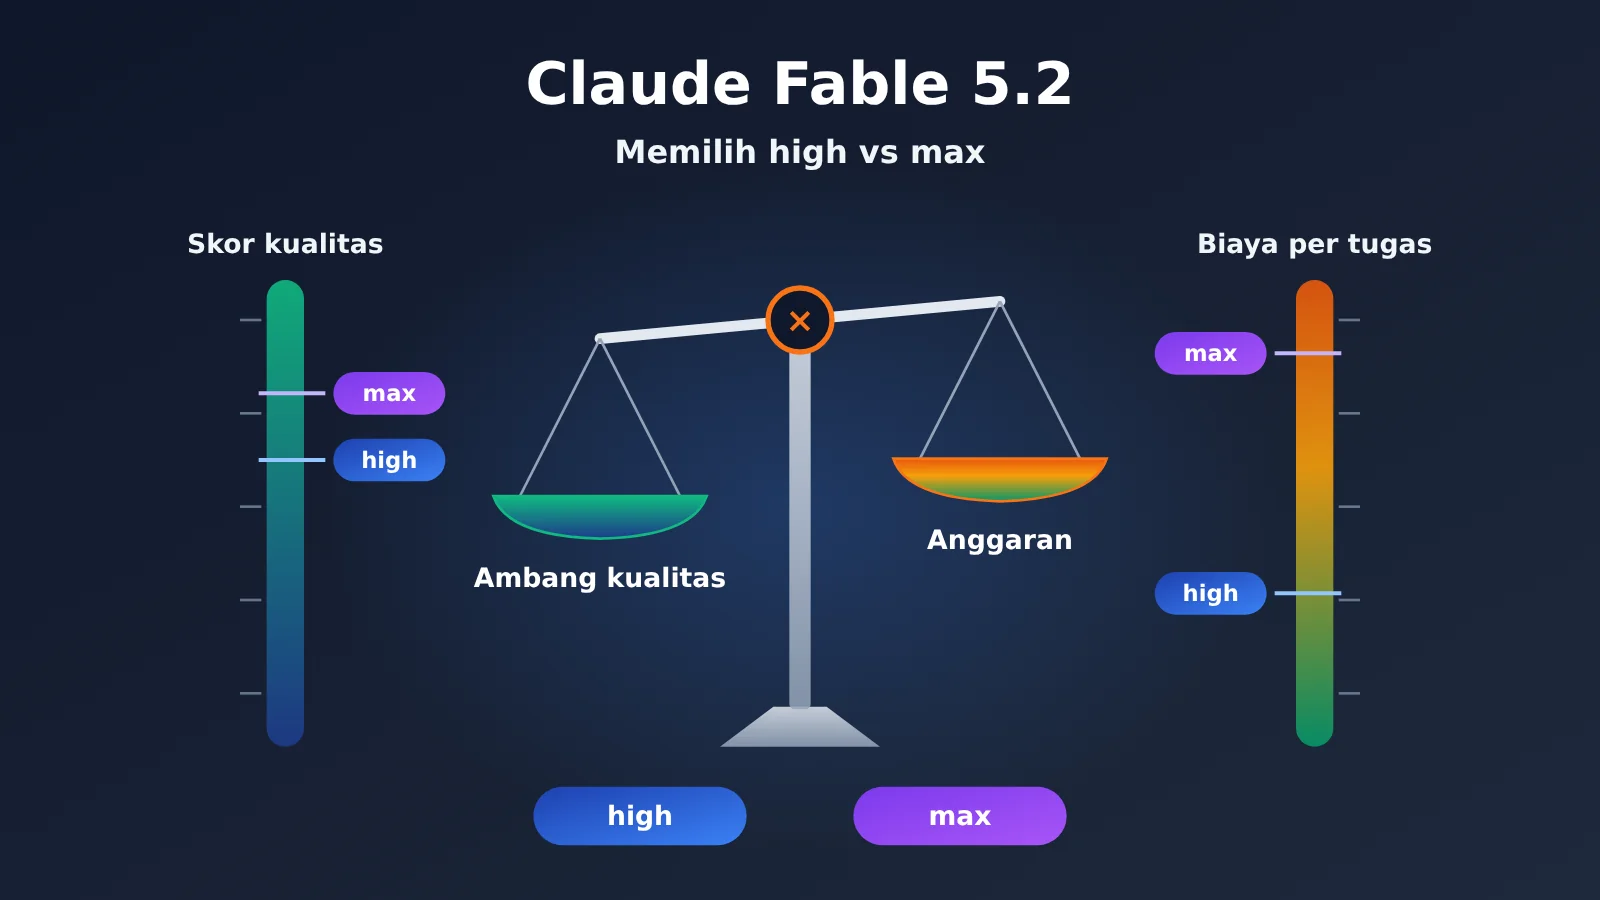
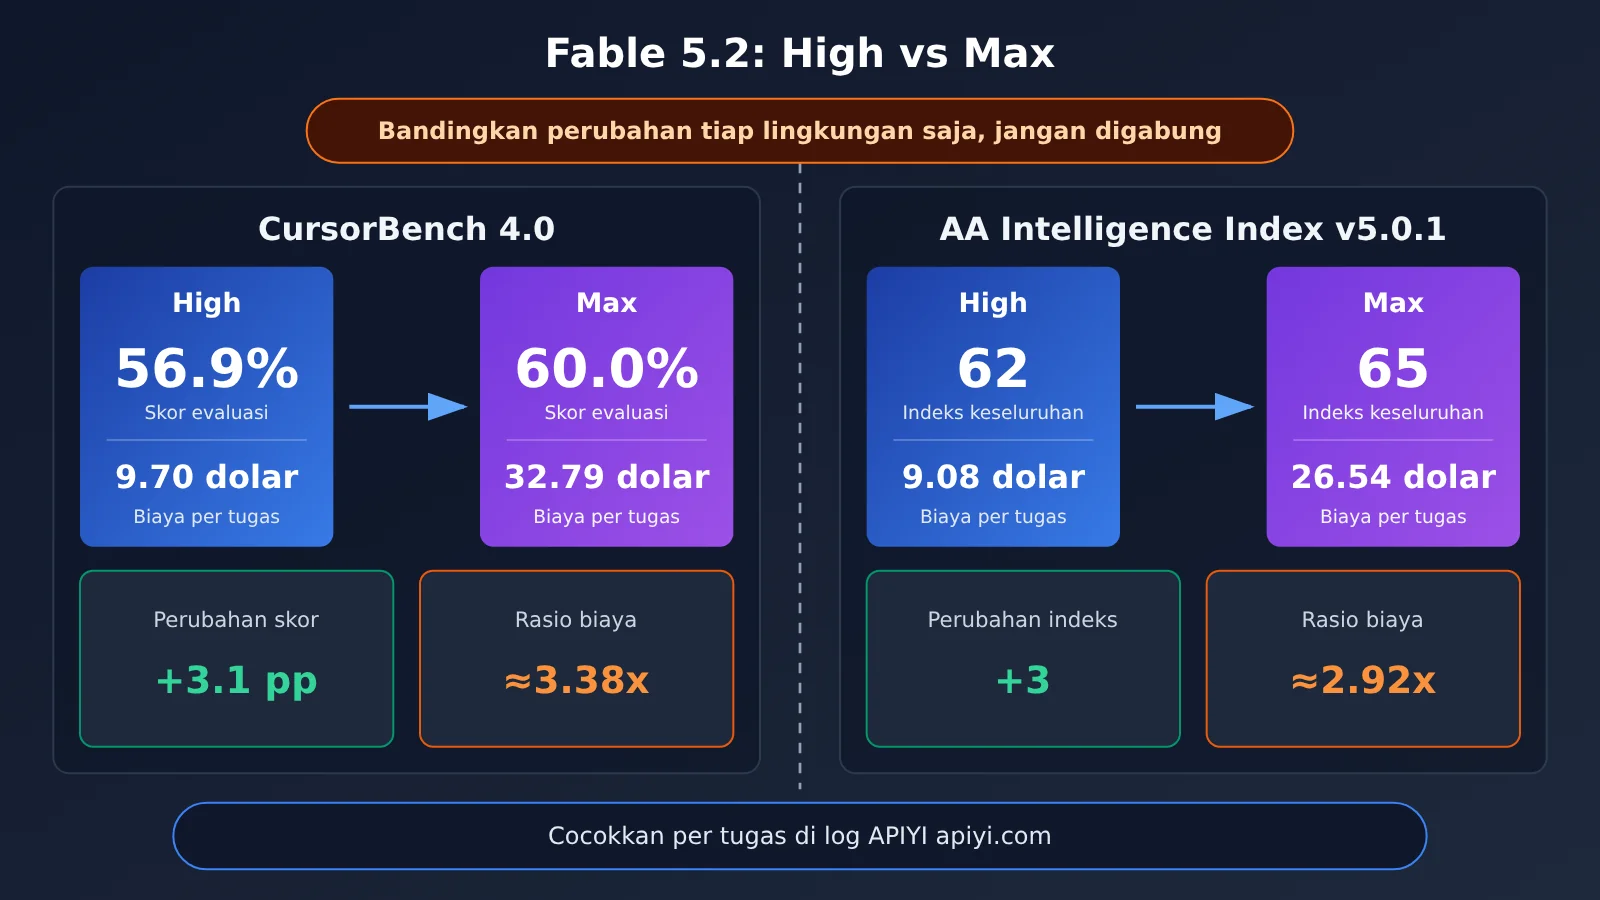
Fable 5.2 dari High ke Max: kenaikan 3,1 poin persentase dengan biaya sekitar 3,38 kali lipat
Dalam tabel ini, skor naik dari 56,9% pada High menjadi 60,0% pada Max, atau meningkat 3,1 poin persentase. Biaya per tugas naik dari 9,70 dolar menjadi 32,79 dolar, sekitar 3,38 kali lipat, atau meningkat sekitar 238%.
Berdasarkan perhitungan artikel ini, nilai pada kolom tokens meningkat sekitar 3,55 kali lipat, sedangkan jumlah langkah bertambah dari 69 menjadi 218, sekitar 3,16 kali lipat. Kenaikan biaya terutama berasal dari bertambahnya proses berpikir dan langkah eksekusi, bukan dari perubahan harga satuan.
Data ini hanya menunjukkan bahwa di lingkungan tersebut, skor yang lebih tinggi disertai biaya yang jauh lebih besar.
Cara memahami hasil Extra High yang tidak terduga
Ada hal lain yang patut diperhatikan dalam tabel ini: biaya Extra High sekitar 60% lebih tinggi daripada High, tetapi skornya justru lebih rendah 0,6 poin persentase.
💡 Saran pemilihan: Perbandingan hanya bisa dilakukan antarlevel dalam tabel yang sama; angka dari evaluasi yang berbeda tidak bisa digabungkan. Jika ingin mereplikasi perbandingan serupa pada tugas Anda sendiri, gunakan antarmuka terpadu dan log pemanggilan APIYI di apiyi.com untuk mencocokkan data. Pastikan terlebih dahulu ID model dan dukungan level yang tersedia di platform pada hari itu.
3 Periksa tren tier Fable 5.2 menggunakan data dari lembaga independen
Jika hanya melihat satu lingkungan evaluasi, kesimpulan bisa dipengaruhi oleh lingkungan itu sendiri. AA adalah lembaga evaluasi independen. Peringkatnya dapat digunakan untuk memeriksa apakah tren yang terlihat di Cursor juga muncul di lingkungan lain. Berikut cuplikan data per 10 November 2026, menggunakan versi metode Intelligence Index v5.0.1.
| Konfigurasi | Intelligence Index | Biaya per tugas (dolar AS) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65 bukan berarti akurasi 65%
Halaman metode AA menjelaskan bahwa indeks versi v5.0.1 terdiri dari 9 evaluasi, dengan bobot masing-masing 25% untuk empat kategori kemampuan. Jadi, 65 adalah skor indeks gabungan, bukan akurasi 65%. Di lingkungan AA, skor indeks naik 3 dari high ke max, sementara biaya per tugas sekitar 2,92 kali lipat. Skor high dan xhigh sama-sama 62. Artinya, skor gabungannya sama, bukan perilaku keduanya pada setiap tugas sepenuhnya sama.
Bandingkan kedua lingkungan secara terpisah
Kedua lingkungan sama-sama menunjukkan tren bahwa skor max lebih tinggi, dengan biaya sekitar 3 kali lipat dibandingkan high. Ini bisa menjadi konfirmasi silang atas tren tersebut. Namun, tugas, metode penilaian, dan perhitungan biaya AA dan Cursor berbeda. Skor 65 dari AA tidak bisa digabungkan dengan 60,0% dari Cursor menjadi satu angka akurasi.
4 Memilih Tingkat Fable 5.2 Sesuai Kegunaan Tugas
Panduan petunjuk resmi memberikan pendekatan awal: mulai dengan high untuk API, lalu naikkan atau turunkan berdasarkan hasil evaluasi Anda. medium lebih cocok untuk skenario interaktif; gunakan xhigh untuk tugas sulit dan panjang yang terbukti mendapat manfaat tambahan; sementara max digunakan untuk mengevaluasi batas kemampuan model atau untuk segelintir tugas yang tidak dibatasi waktu maupun token. Pada tingkat yang lebih rendah, perhatikan juga risiko tugas berakhir terlalu cepat.
Tabel Rekomendasi Skenario Fable 5.2
Tiga skenario berikut adalah contoh hipotetis untuk menjelaskan cara memilih tingkat.
| Skenario hipotetis | Tingkat awal yang disarankan | Kapan perlu mempertimbangkan peningkatan | Hal yang sebaiknya dihindari |
|---|---|---|---|
| Perubahan kebutuhan (mengubah field, menyesuaikan API, menambahkan pengujian) | Evaluasi dengan Medium, gunakan High jika perlu | Medium berakhir terlalu cepat atau melewatkan perubahan | Langsung menggunakan max secara default untuk perubahan kecil |
| Perbaikan kompleks (bug lintas modul, masalah konkurensi) | High | Tingkat kelulusan High belum memenuhi kriteria penerimaan | Langsung beralih ke xhigh tanpa verifikasi |
| Riset jangka panjang (pertanyaan terbuka, eksplorasi solusi) | Mulai dengan High | Nilai masalah tinggi, dampak kegagalan besar, dan evaluasi membuktikan max memberikan hasil lebih baik | Menetapkan max sebagai default untuk semua permintaan |
Kapan Memilih Fable 5.2 high
- Sebagian besar tugas API yang membutuhkan penalaran kuat dan memiliki kriteria penerimaan yang jelas;
- Tim belum memiliki sistem evaluasi tingkat, sehingga membutuhkan titik awal yang direkomendasikan secara resmi;
- Alur produksi dengan volume permintaan tinggi dan biaya per tugas yang sensitif.
Kapan Memilih Fable 5.2 max
- Mengevaluasi batas kemampuan model untuk jenis masalah tertentu;
- Segelintir pertanyaan terbuka yang biaya kegagalannya jauh lebih besar daripada biaya model;
- Sampel Anda sendiri telah membuktikan bahwa max dapat meningkatkan tingkat kelulusan hingga melewati ambang batas, sedangkan high tidak.
🎯 Saran teknis: Pilih tingkat berdasarkan kelompok tugas, tidak perlu menentukan tingkat untuk setiap permintaan satu per satu. Praktik terbaik yang direkomendasikan secara resmi adalah mulai dengan high untuk menguji sekumpulan tugas yang representatif. Jika ingin menggunakan APIYI apiyi.com sebagai akses terpadu melalui API, pastikan untuk memeriksa ID model, grup, endpoint, dan dukungan effort yang tersedia di platform pada hari penggunaan sebelum memulai secara resmi.
5 Tentukan sendiri apakah Fable 5.2 layak ditingkatkan ke max
Evaluasi publik hanya menunjukkan tren. Keputusan untuk meningkatkan model sebaiknya didasarkan pada hasil pengujian Anda sendiri. Daftar pencatatan berikut bisa langsung digunakan. Prinsip utamanya: ubah hanya satu variabel, yaitu tingkat effort.
| Item yang dicatat | Persyaratan |
|---|---|
| Tugas dan input | Gunakan kumpulan tugas yang sama, input yang sama, dan petunjuk sistem yang sama |
| Izin alat | Pastikan kumpulan alat dan izinnya sama persis |
| Model dan tingkat effort | Catat ID model dan effort; ubah tingkat effort saja pada setiap putaran |
| Kriteria kelulusan | Tetapkan ambang penerimaan sebelumnya, jangan mengubahnya setelah melihat hasil |
| usage | Catat input, penulisan/pembacaan cache, dan output secara terpisah |
| Durasi dan percobaan ulang | Catat total durasi, jumlah percobaan ulang, dan berapa kali proses berakhir lebih awal |
| Biaya aktual | Gunakan biaya aktual yang tercatat di log platform, bukan perkiraan berdasarkan tarif resmi |
| Kasus kegagalan | Simpan output asli dan analisis masalah apa saja yang berhasil diperbaiki oleh max |
Panduan cepat Fable 5.2: catat usage terlebih dahulu
Contoh singkat berikut hanya menunjukkan cara melakukan pemanggilan dan mencatat usage. Artikel ini tidak menyediakan cara meneruskan parameter effort. Pastikan Fable 5.2 sudah tersedia di platform dan effort didukung untuk diteruskan dengan merujuk pada dokumentasi platform terbaru.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Isi dengan ID model yang dikonfirmasi tersedia di platform hari ini
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # Catat usage untuk rekonsiliasi nanti
Lihat kode lengkap untuk pencatatan dan rekonsiliasi
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Tarif standar resmi Anthropic (dolar per sejuta token), hanya untuk estimasi dan bukan jumlah yang benar-benar ditagihkan
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """Jalankan satu tugas dan kembalikan satu catatan evaluasi. effort_label hanya digunakan sebagai label pencatatan."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # Fungsi evaluasi yang sudah ditulis sebelumnya
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # Nilai estimasi
        "seconds": round(time.time() - start, 1),
        "output": text,                     # Simpan teks asli kasus yang gagal
    }

def quota_to_usd(quota: int) -> float:
    """Dalam log platform, quota ÷ 500000 adalah jumlah dolar yang benar-benar ditagihkan."""
    return quota / 500000
Dokumentasi log APIYI mencantumkan kolom seperti model_name, prompt_tokens, completion_tokens, quota, duration_for_view, dan request_id. Nilai quota ÷ 500000 menunjukkan jumlah dolar yang benar-benar ditagihkan, sedangkan kolom other berisi informasi tambahan seperti pengali grup. Hubungkan catatan evaluasi dengan log menggunakan request_id. Dengan begitu, Anda bisa menghitung biaya aktual untuk “tugas yang lolos”, bukan hanya melihat biaya per permintaan.
🚀 Mulai cepat: Jika ingin menguji alur ini dengan sampel kecil terlebih dahulu, daftar di APIYI apiyi.com untuk menggunakan kuota uji coba gratis bagi pengguna baru. Jalankan metode pencatatan “tugas sama, satu variabel, catat biaya aktual”, lalu putuskan apakah perlu menambah jumlah sampel.
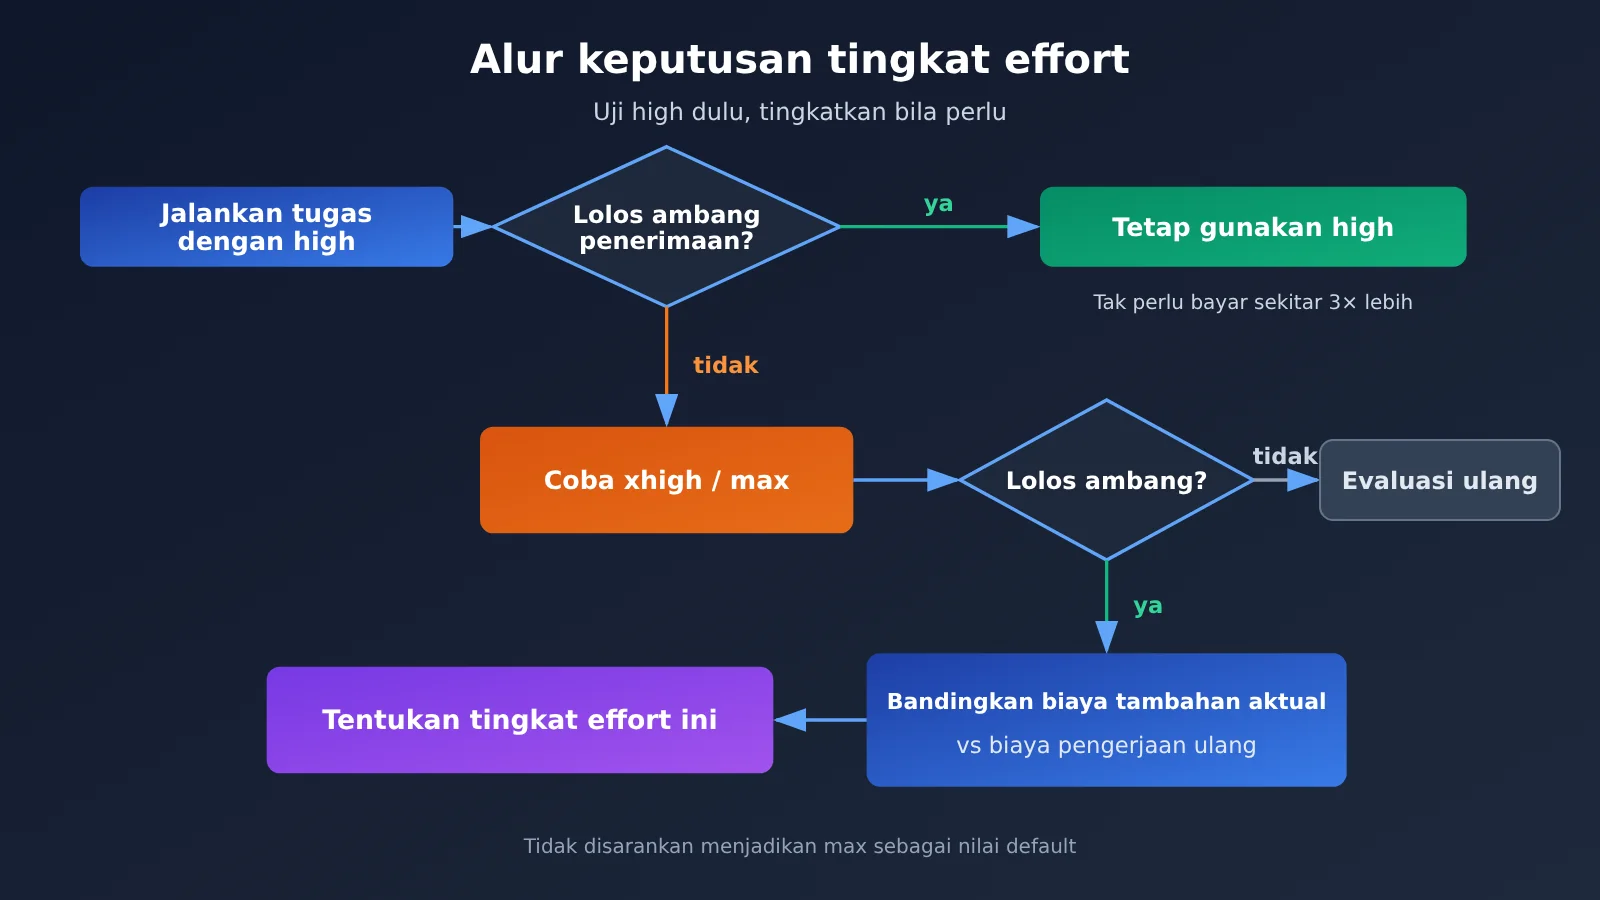
Prinsip pengambilan keputusan akhirnya adalah: pastikan dulu apakah high memenuhi ambang kualitas. Jika ya, tak perlu membayar biaya sekitar 3 kali lipat demi peningkatan beberapa persen saja. Jika high belum memenuhi ambang, tetapi max bisa memenuhinya, bandingkan biaya tambahan max dengan dampak kegagalan atau pengerjaan ulang. Sebaiknya jangan menjadikan max sebagai pengaturan default untuk semua permintaan.
FAQ
Q1: Apa saja tingkat effort Claude Fable 5.2?
Effort adalah pengaturan untuk mengontrol seberapa banyak upaya yang dicurahkan model untuk berpikir. Tingkat yang tersedia berkisar dari low hingga max. Pengaturan ini tidak mengubah harga per token, tetapi mengubah banyaknya proses berpikir, jumlah langkah, waktu yang dibutuhkan, dan penggunaan token. Karena itu, biaya untuk tugas yang sama bisa berbeda beberapa kali lipat pada tingkat yang berbeda. Tingkat default API adalah high.
Q2: Seberapa besar perbedaan Fable 5.2 high dan max?
Di CursorBench 4.0, high mencetak 56,9% dengan biaya $9,70, sedangkan max mencetak 60,0% dengan biaya $32,79. Selisih skornya 3,1 poin persentase, sementara biayanya sekitar 3,38 kali lipat. Di AA, high mencetak 62 dengan biaya $9,08, sedangkan max mencetak 65 dengan biaya $26,54. Biayanya sekitar 2,92 kali lipat. Kedua kelompok data ini hanya bisa dibandingkan di dalam lingkungan masing-masing.
Q3: Kapan data ini diambil? Apakah bisa berubah?
Fable 5.2 dirilis pada 9 November 2026. Data dalam artikel ini adalah cuplikan yang diambil pada 10 November. Halaman AA dan Cursor diperbarui secara dinamis, jadi angkanya bisa berubah seiring pembaruan versi, kumpulan tugas, atau algoritme biaya. Saat mengutip data ini, cantumkan tanggal pengambilannya.
Q4: Skor Extra High lebih rendah daripada High. Apakah sebaiknya tidak digunakan?
Ini hanya hasil dari satu pengujian CursorBench 4.0, jadi tidak bisa disimpulkan bahwa xhigh selalu lebih buruk untuk semua tugas. Rekomendasi resmi adalah menggunakan xhigh untuk tugas sulit dan panjang yang sudah terbukti mendapat manfaat dalam evaluasi Anda sendiri. Sebelum manfaatnya terbukti, Anda tidak perlu mengaktifkannya secara default.
Q5: Bagaimana cara membandingkan biaya berbagai tingkat Fable 5.2 melalui API?
Sebaiknya gunakan kumpulan tugas yang sama, ubah tingkatnya saja, lalu catat usage dan jumlah yang benar-benar dipotong oleh platform. Jika melakukan pemanggilan melalui antarmuka terpadu APIYI apiyi.com, Anda bisa menghitung jumlah potongan aktual dalam dolar dengan membagi quota di log dengan 500000. Sebelum menjalankan pengujian, pastikan ID model, grup, dan dukungan effort yang berlaku pada platform hari itu. Artikel ini tidak memberikan contoh penerusan parameter yang belum diverifikasi.
Q6: Apa saja keterbatasan data evaluasi yang dipublikasikan?
CursorBench adalah evaluasi yang dilakukan penyedia alat di lingkungan mereka sendiri, sedangkan indeks AA merupakan skor gabungan berbobot. Keduanya tidak sama dengan tingkat keberhasilan pada bisnis Anda. Selisih sekitar 3 poin persentase juga tidak cukup untuk menentukan apakah perbedaannya signifikan. Ulasan di platform sosial pada hari pertama hanya bisa dijadikan petunjuk; kesimpulan akhir sebaiknya didasarkan pada sampel penerimaan Anda sendiri.
Q7: Setelah harga API turun 20%, apakah menggunakan max jadi lebih hemat?
Belum tentu. Penurunan harga hanya menghasilkan penghematan dengan persentase yang sama jika penggunaan tetap. Penggunaan token dan jumlah langkah max bisa lebih dari 3 kali lipat dibandingkan high, sehingga kenaikan penggunaan dapat dengan mudah mengimbangi penurunan harga. Bandingkan “jumlah yang benar-benar dipotong untuk menyelesaikan satu tugas”, bukan hanya harga per token.
Poin Utama Fable 5.2 high dan max
- Harga per unit tetap, tagihan bisa berubah:
effortmengubah jumlah pemikiran dan langkah yang diperlukan. Pada harga yang sama, biaya tugas bisa berbeda hingga beberapa kali lipat. - Default API adalah high: Resmi disarankan untuk memulai dari high, lalu menaikkan atau menurunkannya berdasarkan hasil evaluasi sendiri.
- Perbandingan Cursor: Dari high ke max, skor naik 3,1 poin persentase, dengan biaya sekitar 3,38 kali lipat.
- Perbandingan AA: Indeks naik dari 62 menjadi 65, dengan biaya sekitar 2,92 kali lipat; angka 65 bukan tingkat akurasi.
- Jangan gabungkan lingkungan evaluasi: Kedua evaluasi hanya bisa dibandingkan dalam lingkungannya masing-masing dan tidak bisa digabung menjadi satu skor efektivitas biaya.
- Gunakan max untuk sedikit tugas saja: Cocok untuk mengukur batas kemampuan dan menangani pertanyaan terbuka yang bernilai tinggi.
- Verifikasi dengan biaya aktual: Gunakan tugas yang sama, ubah satu variabel saja, dan catat
usage. Anda juga bisa mencocokkan catatan transaksi melalui log APIYI apiyi.com.
Kesimpulan
Pemilihan antara Fable 5.2 high dan max bisa dirangkum dalam tiga poin:
- Bedakan harga per unit dan tagihan tugas: Tingkat model tidak mengubah harga per unit, tetapi mengubah jumlah sumber daya yang digunakan.
- Baca data dalam lingkungan yang sama: Cursor dan AA sama-sama menunjukkan bahwa skor max sedikit lebih tinggi, dengan biaya sekitar 3 kali lipat dari high. Namun, hasil keduanya tidak bisa digabungkan untuk dibandingkan.
- Jadikan ambang penerimaan sebagai patokan: Jika high sudah memenuhi ambang, tetap gunakan high. Bandingkan biaya tambahan dengan biaya pengerjaan ulang hanya jika high tidak memenuhi standar, tetapi max bisa memenuhinya.
Bagi kebanyakan tim, langkah yang lebih aman adalah memulai dengan high untuk menyusun kategori tugas dan catatan penerimaan, lalu memilih beberapa tugas bernilai tinggi untuk mengevaluasi max secara terpisah. Anda bisa menggunakan APIYI apiyi.com dengan antarmuka terpadu dan log pemanggilan untuk menguji sampel sendiri dengan cepat. Pastikan model dan tingkat yang dipilih didukung sebelum memperluas penggunaannya.
📚 Referensi
- Pengumuman peluncuran Anthropic: Cakupan peluncuran Fable dan Mythos 5.2 serta penilaian vendor
- Tautan:
anthropic.com/claude-fable-and-mythos-5-2 -
Keterangan: Tanggal peluncuran 2026-11-09; mencakup tolok ukur kecepatan dan tabel evaluasi
-
Harga Claude API: Tarif standar resmi
- Tautan:
platform.claude.com/docs/en/about-claude/pricing -
Keterangan: Harga input/output Fable 5.2 adalah 8 / 40 dolar per satu juta token
-
Spesifikasi model Fable 5.2: Konteks, batas output, dan effort default
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview -
Keterangan: Pemikiran adaptif selalu aktif; default API adalah high
-
Panduan petunjuk Fable 5.2: Rekomendasi resmi untuk memilih tingkat effort
- Tautan:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Keterangan: Skenario penggunaan untuk medium, high, xhigh, dan max
-
CursorBench 4.0: Evaluasi lima tingkat dalam lingkungan Cursor sendiri
- Tautan:
prod.cursor.com/evals -
Keterangan: Evaluasi milik penyedia alat, bukan pengujian ulang independen yang bersifat umum
-
Peringkat model Artificial Analysis: Peringkat dinamis dari lembaga independen
- Tautan:
artificialanalysis.ai/leaderboards/models -
Keterangan: Intelligence Index dan biaya per tugas
-
Metodologi evaluasi Artificial Analysis: Susunan Intelligence Index v5.0.1
- Tautan:
artificialanalysis.ai/methodology/intelligence-benchmarking -
Keterangan: 9 evaluasi; masing-masing dari empat kategori kemampuan berbobot 25%
-
Cara Cursor membandingkan kualitas model: Blog tentang metodologi benchmark versi lama
- Tautan:
prod.cursor.com/blog/cursorbench -
Keterangan: Hanya untuk memahami prinsip desain, bukan untuk menyimpulkan hasil statistik versi 4.0
-
API kueri log APIYI: Kolom log dan konversi biaya aktual
- Tautan:
docs.apiyi.com/api-capabilities/log-query - Keterangan: quota÷500000 adalah biaya aktual dalam dolar
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI apiyi.com. Materi lainnya tersedia di pusat dokumentasi docs.apiyi.com.