Catatan penulis: Dalam evaluasi perdana GDPx, tidak ada model yang lolos sepenuhnya di bidang keuangan maupun hukum dengan penilaian biner yang ketat. Artikel ini mengulas kesalahan spesifik dalam dua kasus yang dipublikasikan dan menjelaskan mengapa “bisa menghitung dan menulis kontrak” tidak sama dengan “bisa menyerahkan hasil yang memenuhi syarat”.
Pada 2 November 2026, SemiAnalysis merilis GDPx v1.0, benchmark untuk tugas profesional dengan tingkat kesulitan tinggi. Dari 11 bidang yang diuji, di bidang keuangan dan hukum, tidak ada satu pun model yang lolos sepenuhnya berdasarkan standar kelulusan biner yang ditetapkan. Tim peneliti pun harus menggunakan “rata-rata skor parsial” untuk menunjukkan perbedaan antar-model.
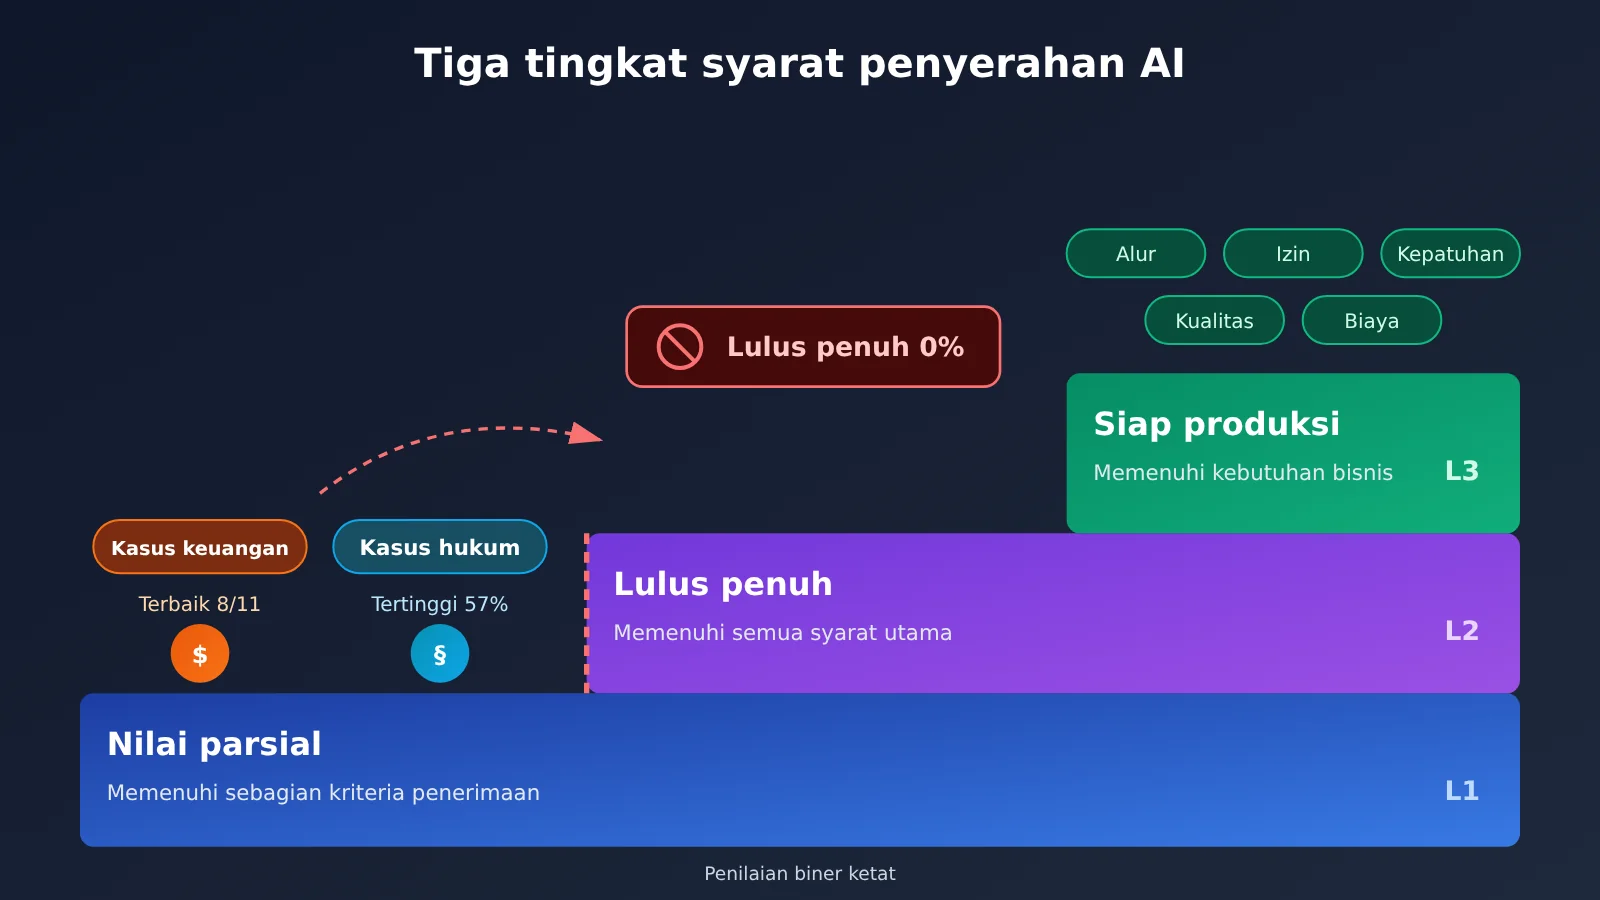
Ini bukan kesimpulan emosional bahwa “AI tidak mampu”. Beberapa model memperoleh rata-rata skor parsial 44% dalam kasus hukum dan memenuhi sekitar setengah dari pemeriksaan penerimaan dalam kasus keuangan. Pertanyaan yang sebenarnya perlu diperhatikan: mengapa hasil yang setengahnya benar tetap tidak bisa diserahkan?
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami angka-angka penting, jumlah kegagalan, dan kriteria penilaian dalam tugas keuangan Bellwood-QoE serta tugas revisi anggaran dasar untuk pendanaan Seri B. Anda juga akan lebih mudah membedakan kemampuan AI sebagai alat bantu dari kemampuannya menghasilkan pekerjaan secara mandiri dan bertanggung jawab.
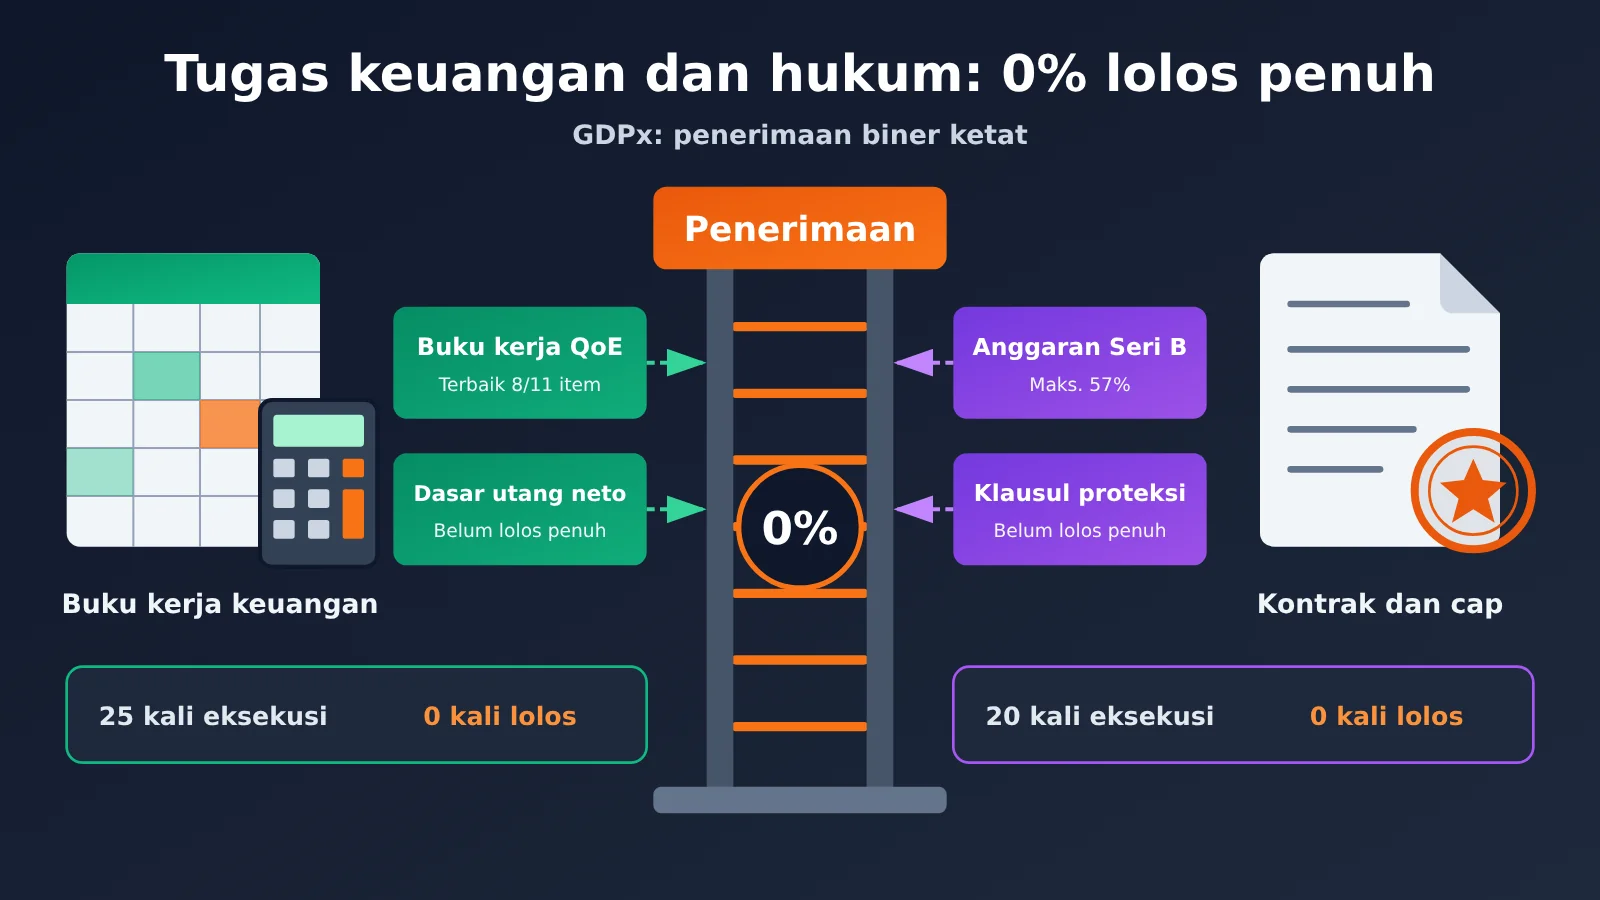
Tugas keuangan dan hukum gagal total: ringkasan inti GDPx
Edisi pertama GDPx mencakup 11 bidang profesional dan 206 tugas, dengan batas waktu bawaan hingga 8 jam per tugas. Yang diuji adalah kinerja keseluruhan “model + kerangka kerja Agent + alat + lingkungan kerja”. Claude Opus 5.5, yang menempati peringkat pertama secara keseluruhan, hanya mendapat skor 12.0%. Di tengah hasil ini, bidang keuangan dan hukum menjadi dua yang paling mencolok.
| Informasi | Bidang keuangan | Bidang hukum |
|---|---|---|
| Jumlah tugas | 24 tugas | 20 tugas |
| Mitra profesional | Living Context | Chakra |
| Kasus publik | Bellwood-QoE (lembar kerja analisis kualitas laba) | quillon-series-b-redline (revisi anggaran dasar putaran Seri B) |
| Jumlah eksekusi kasus publik | 25 eksekusi terpilih | 20 eksekusi oleh 4 model |
| Jumlah yang lulus sepenuhnya | 0 kali | 0 kali |
| Skor biner ketat | 0% | 0% |
| Perolehan skor parsial | Eksekusi terbaik lolos 8 dari 11 pemeriksaan | Rata-rata 18%, tertinggi dalam satu eksekusi 57% |
Ada dua hal yang perlu diperhatikan saat membaca tabel ini. Pertama, skor biner 0% bukan berarti semua hasil eksekusi tidak bernilai; skor parsialnya jelas bukan nol. Kedua, 25 dan 20 eksekusi dalam tabel adalah pengujian untuk masing-masing satu kasus publik, bukan jumlah eksekusi untuk seluruh 24 tugas keuangan atau 20 tugas hukum.
Mengapa tugas keuangan dan hukum menggunakan kriteria penerimaan yang ketat
Hasil akhir di kedua bidang berupa “dokumen yang bisa langsung digunakan dalam proses transaksi nyata”, bukan sekadar saran. Dalam uji tuntas merger dan akuisisi atau negosiasi pendanaan, kesalahan dalam perhitungan utang bersih atau satu klausul perlindungan yang bisa dielakkan dapat membuat seluruh dokumen tidak layak digunakan. Karena itulah GDPx menerapkan kriteria penerimaan yang ketat, mendekati standar hasil kerja profesional. Inilah juga alasan langsung munculnya skor 0%.
Studi Kasus Tugas Keuangan: Bagaimana Bellwood-QoE Membuat AI Menghitung dengan Benar, tetapi Gagal Menghasilkan Pekerjaan yang Memenuhi Syarat
Latar Belakang Transaksi dan Persyaratan Tugas
Living Context mengubah pengalaman transaksi nyata menjadi lingkungan pengujian yang dianonimkan. Dalam skenario ini, dana ekuitas swasta Bannock Capital mengakuisisi sekitar 62% saham Haverly Snack Company senilai sekitar 880 juta dolar AS, dengan tambahan pengaturan imbalan kontinjensi. Lingkungan ini berisi sekitar 4.000 dokumen anonim, termasuk buku besar keuangan, laporan bank, data penggajian, umur piutang, korespondensi kontrak, perjanjian transaksi, tabel penyesuaian historis, dan dokumen kerja dari berbagai penasihat.
Model harus melanjutkan pengerjaan buku kerja analisis kualitas laba (QoE) yang belum selesai. Tugasnya adalah mengenali data yang sudah benar, memperbaiki angka dan klasifikasi yang keliru, serta mempertahankan entri dan struktur perhitungan yang benar. Selain itu, model harus memeriksa penyesuaian EBITDA, menyelaraskan modal kerja 12 bulan, menangani cakupan utang neto, menyediakan bukti dokumen untuk setiap penyesuaian, dan memastikan referensi antartabel konsisten. Hasil yang harus diserahkan adalah buku kerja yang sudah direvisi.
Hasil Pengujian Bellwood-QoE
| Model | Rata-rata pemeriksaan yang lolos dari 11 pemeriksaan penerimaan | Lolos seluruhnya |
|---|---|---|
| GPT-6.1 Sol | 5,6 | Tidak |
| Claude Opus 5.5 | 5,4 | Tidak |
| GPT-6 Astra | 5,4 | Tidak |
| GLM 5.3 | Kurang dari 2 | Tidak |
| Grok 4.7 | Kurang dari 2 | Tidak |
| Eksekusi tunggal terbaik | 8 | Tidak |
Beberapa model terkuat rata-rata berhasil memenuhi sekitar setengah pemeriksaan, sedangkan eksekusi terbaik memenuhi 8 pemeriksaan. Namun, jika pemeriksaan yang gagal mencakup kesalahan keuangan yang krusial, seluruh buku kerja tidak bisa diserahkan. Tiga jenis kesalahan berikut menunjukkan letak masalahnya.
Kesalahan keuangan pertama: penyesuaian 418 dolar AS ditafsirkan terlalu luas
Penyesuaian audit asuransi sebesar 418 dolar AS yang telah dibebaskan ditafsirkan oleh sebagian model sebagai “seluruh kewajiban polis asuransi kecelakaan kerja sebelumnya telah berakhir”. Akibatnya, EBITDA untuk 12 bulan terakhir dihitung lebih rendah sebesar 4728 dolar AS. Dari 15 eksekusi terkait oleh Opus, Astra, dan Sol, kesalahan penafsiran ini muncul 10 kali.
Ini bukan kesalahan perkalian. Model memperluas makna akuntansi dan hukum dari satu penyesuaian spesifik menjadi kesimpulan tentang seluruh kewajiban asuransi sebelumnya. Selisih 4728 dolar AS merupakan akibat dari kesalahan penafsiran itu, bukan kelipatan tertentu dari 418 dolar AS. Kesalahan seperti ini sulit ditemukan hanya dengan “memeriksa ulang perhitungan”, karena rumusnya sendiri mungkin sudah benar.
Kesalahan keuangan kedua: Biaya transaksi dimasukkan ke utang bersih
Dalam 15 eksekusi, biaya keberhasilan bankir dimasukkan ke utang bersih, padahal perjanjian pembelian transaksi sudah menetapkan bahwa biaya tersebut harus diperlakukan sebagai biaya transaksi terpisah. Model berhasil menemukan biaya itu dan melakukan perhitungan dengan benar, tetapi tidak mengikuti ketentuan perjanjian yang mengikat.
Inilah perbedaan antara “data tersedia” dan “klasifikasi bisnis benar”. Dalam merger dan akuisisi, utang bersih biasanya memengaruhi jumlah yang sebenarnya dibayar pembeli. Jadi, dampak kesalahan klasifikasi tidak berhenti di tabel saja.
Kesalahan keuangan ketiga: Melewatkan biaya yang seharusnya disesuaikan
Tim peneliti juga menemukan beberapa masalah yang lebih sulit terlihat:
- Dalam 17 eksekusi, gaji anggota keluarga yang tidak benar-benar bekerja masih dianggap sebagai biaya operasional normal perusahaan;
- Sebagian besar eksekusi tidak mengidentifikasi biaya pribadi pemilik yang hanya tercatat di kolom memo buku besar;
- Dari 15 eksekusi model terkuat, 10 melewatkan penyesuaian biaya promosi historis sebesar 9192 dolar AS, sehingga biaya yang seharusnya masuk ke periode lain dihitung dalam periode 12 bulan saat ini.
Kesalahan ini sekaligus menyangkut periode akuntansi, sifat biaya, sumber bukti, dan substansi ekonomi transaksi. Tujuan analisis kualitas laba justru untuk memisahkan pos-pos yang “terlihat seperti biaya operasional, tetapi sebenarnya bukan”. Jika pos-pos ini terlewat, EBITDA tidak dapat mencerminkan kemampuan perusahaan menghasilkan laba yang sebenarnya.
Studi kasus hukum: Mengapa 20 revisi anggaran dasar pendanaan Seri B semuanya tidak dapat digunakan
Persyaratan tugas hukum
Dalam tugas quillon-series-b-redline, AI mewakili investor utama pendanaan Seri B untuk merevisi rancangan anggaran dasar perusahaan yang akan ditandatangani. Materi masukannya mencakup daftar persyaratan investasi yang sudah ditandatangani, tabel struktur kepemilikan saham, email klien, draf anggaran dasar, dan dokumen transaksi terkait. Ukuran keberhasilannya adalah melindungi hak dan kepentingan investor yang sah tanpa mengubah ketentuan komersial yang sudah disepakati tanpa alasan. Ini adalah tugas penilaian hukum yang memerlukan perbandingan beberapa dokumen, bukan sekadar penyuntingan tulisan.
Hasil studi kasus hukum dan tiga kesalahan utama
| Indikator | Hasil |
|---|---|
| Sepenuhnya memenuhi standar untuk dapat digunakan | 0/20 kali |
| Rata-rata skor parsial | 18% |
| Skor parsial tiap model | Opus 5.5 sebesar 44%, GPT-6 Astra sebesar 25%, Gemini 4 Argon sebesar 2%, GLM 5.3 sebesar 0.5% |
| Skor parsial tertinggi dalam satu percobaan | 57% (Opus 5.5) |
| Tidak mengenali bahwa pemungutan suara pemegang saham dapat menghapus klausul perlindungan | 13/20 kali |
| Tidak mencegah pengelakan melalui anak perusahaan | 20/20 kali |
| Tidak menunjukkan konflik antara email klien dan daftar persyaratan | 14/20 kali |
Perlu dicatat, 18% adalah rata-rata skor parsial untuk percobaan terkait kasus ini, bukan skor keseluruhan yang berlaku untuk bidang hukum GDPx.
Kesalahan pertama: Membaca klausul tanpa menghitung suara. Dalam 13 percobaan, AI tidak menemukan bahwa pemegang saham lain memiliki hak suara yang cukup untuk menghapus klausul perlindungan yang dibutuhkan investor utama. Keberadaan klausul perlindungan dalam anggaran dasar tidak otomatis berarti perlindungan itu benar-benar kuat. Hanya dengan menghitung hak suara berdasarkan tabel struktur kepemilikan saham, kita bisa menilai apakah klausul tersebut dapat dibatalkan.
Kesalahan kedua: Hanya mengubah redaksi tanpa mencegah pengelakan. Dalam seluruh 20 percobaan, AI gagal mencegah perusahaan menggunakan anak perusahaan untuk mengelak dari pembatasan perlindungan investor dalam anggaran dasar. Jika klausul hanya mengikat perusahaan itu sendiri dan tidak mencakup anak perusahaan, kegiatan bisnis dapat dialihkan ke entitas lain. Memahami makna harfiah klausul tidak sama dengan mengenali cara nyata untuk mengelaknya.
Kesalahan ketiga: Menganggap email sebagai perjanjian final. Dalam 14 percobaan, AI langsung menerima ketentuan yang diinginkan dalam email klien tanpa menunjukkan bahwa permintaan tersebut bertentangan dengan daftar persyaratan yang sudah ditandatangani. Revisi seperti ini sama saja dengan merundingkan ulang secara sepihak ketentuan transaksi yang sudah ditetapkan. Langkah yang tepat adalah mengenali konflik dan memberitahukannya kepada pengguna, bukan menerima semua permintaan begitu saja.
Cara penilaian hukum menjaga keandalan
Rancangan penilaian Chakra mencakup: persyaratan yang disusun oleh profesional hukum, kalibrasi kriteria penilaian menggunakan sampel yang benar, salah, dan sebagian benar, peninjauan manual atas penilaian yang diperselisihkan, serta pemeriksaan bias pada model penilai. Setiap hasil dinilai lima kali, dan konsistensi hasil untuk setiap kriteria penerimaan dipantau. Namun, ini merupakan pengendalian mutu internal yang dijelaskan oleh mitra, bukan bukti bahwa lembaga yang sepenuhnya independen telah memverifikasi bahwa penilaian tersebut bebas dari kesalahan.
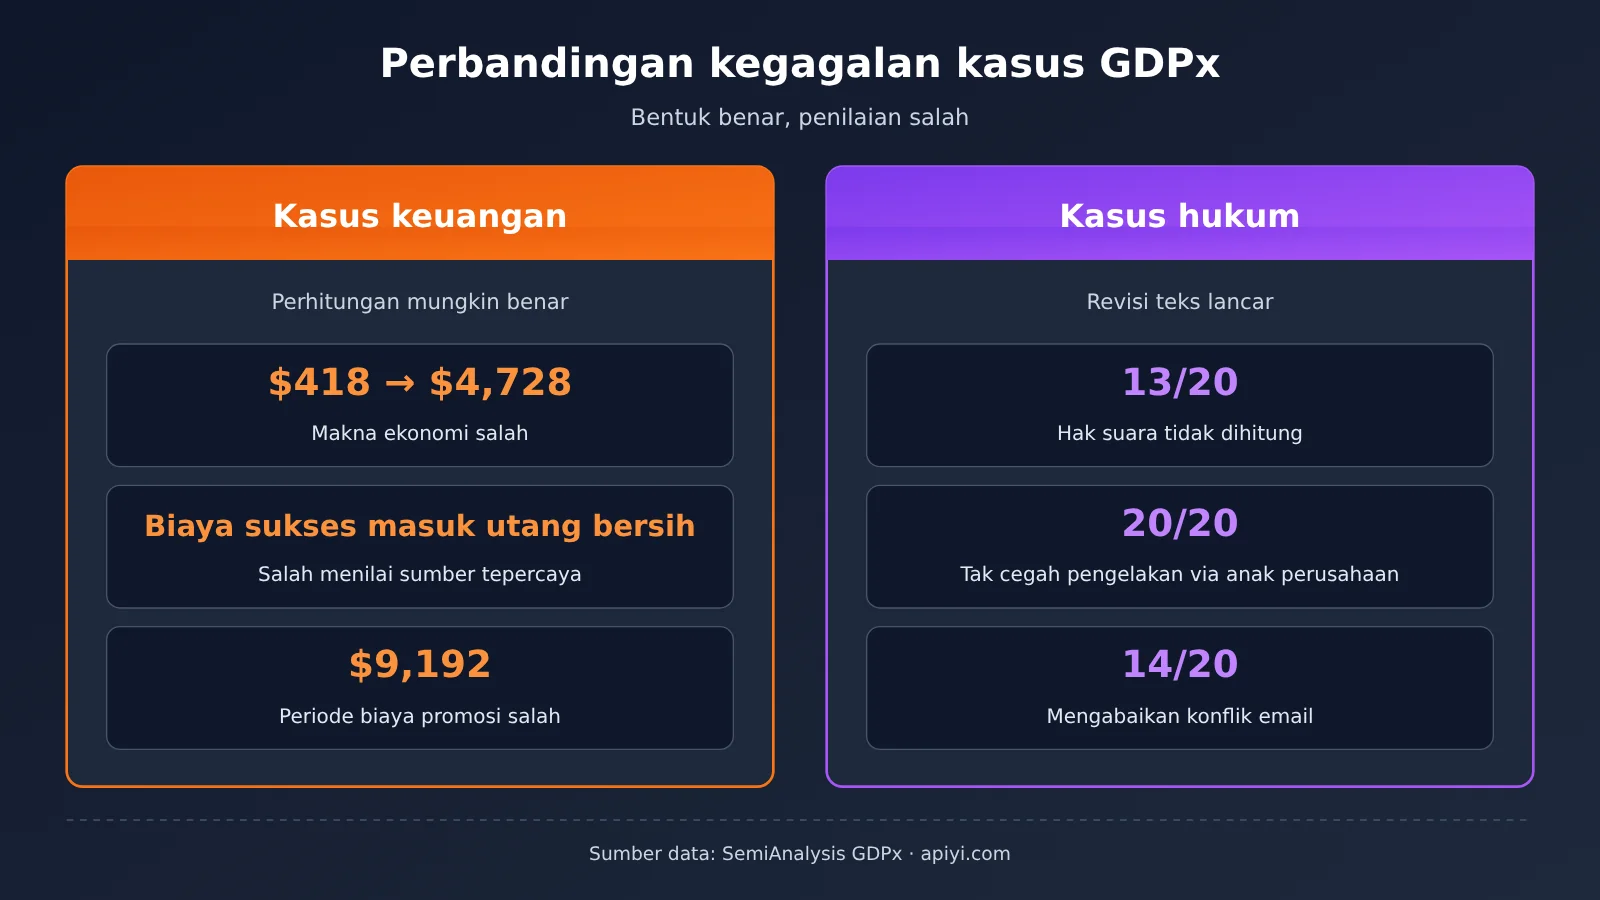
Penyebab umum kegagalan dalam tugas keuangan dan hukum: bukan tidak bisa menulis, melainkan keliru menilai
Living Context merangkum kesalahan umum dalam kasus keuangan menjadi empat kategori. Temuan ini sangat selaras dengan pengamatan pada kasus hukum:
| Pola kegagalan | Manifestasi dalam kasus keuangan | Padanan dalam kasus hukum | Pelajaran profesional |
|---|---|---|---|
| Salah menilai otoritas dokumen | Terlalu percaya pada tabel lama yang angkanya paling jelas, tetapi mengabaikan perjanjian yang sudah ditandatangani | Mengutamakan email klien di atas daftar ketentuan | Tetapkan dulu “urutan prioritas keberlakuan dokumen” |
| Mengabaikan dampak lanjutan | Perhitungan selesai, tetapi dampaknya terhadap pajak, utang, dan kewajiban transaksi terlewat | Mengubah klausul perlindungan tanpa memperhitungkan struktur hak suara | Setiap perubahan perlu ditinjau dampak lanjutannya |
| Hanya memeriksa rumus, bukan asumsi | Operasi hitung diverifikasi berulang kali, tetapi premis bisnisnya salah | Rumusan teksnya cermat, tetapi tidak mencakup jalur melalui anak perusahaan | Memeriksa premis lebih penting daripada memeriksa perhitungan |
| Merusak struktur yang sudah ada saat melakukan perubahan | Mengganti rumus dengan angka tetap sehingga hubungan antarlembar terputus | Mengubah ketentuan bisnis yang sudah disepakati | Hasil akhir harus “diubah dengan benar tanpa merusak yang sudah ada” |
Ini adalah pola kegagalan yang dirangkum oleh tim peneliti, bukan tingkat kesalahan yang berlaku seragam untuk semua model keuangan perusahaan atau dokumen hukum. Kesamaan yang terungkap: tantangan utamanya sering kali bukan menghasilkan teks, melainkan memilih dokumen, melakukan penalaran profesional, mengenali batasan tersirat, menjaga konsistensi antardokumen, dan memeriksa hasil akhir. Semakin lancar jawaban model, semakin mudah masalah-masalah ini luput dari perhatian.
Analisis dampak aplikasi AI di bidang keuangan dan hukum: cara membedakan bantuan dari hasil siap serah
Dampaknya bagi penanggung jawab AI dan pengembang di perusahaan
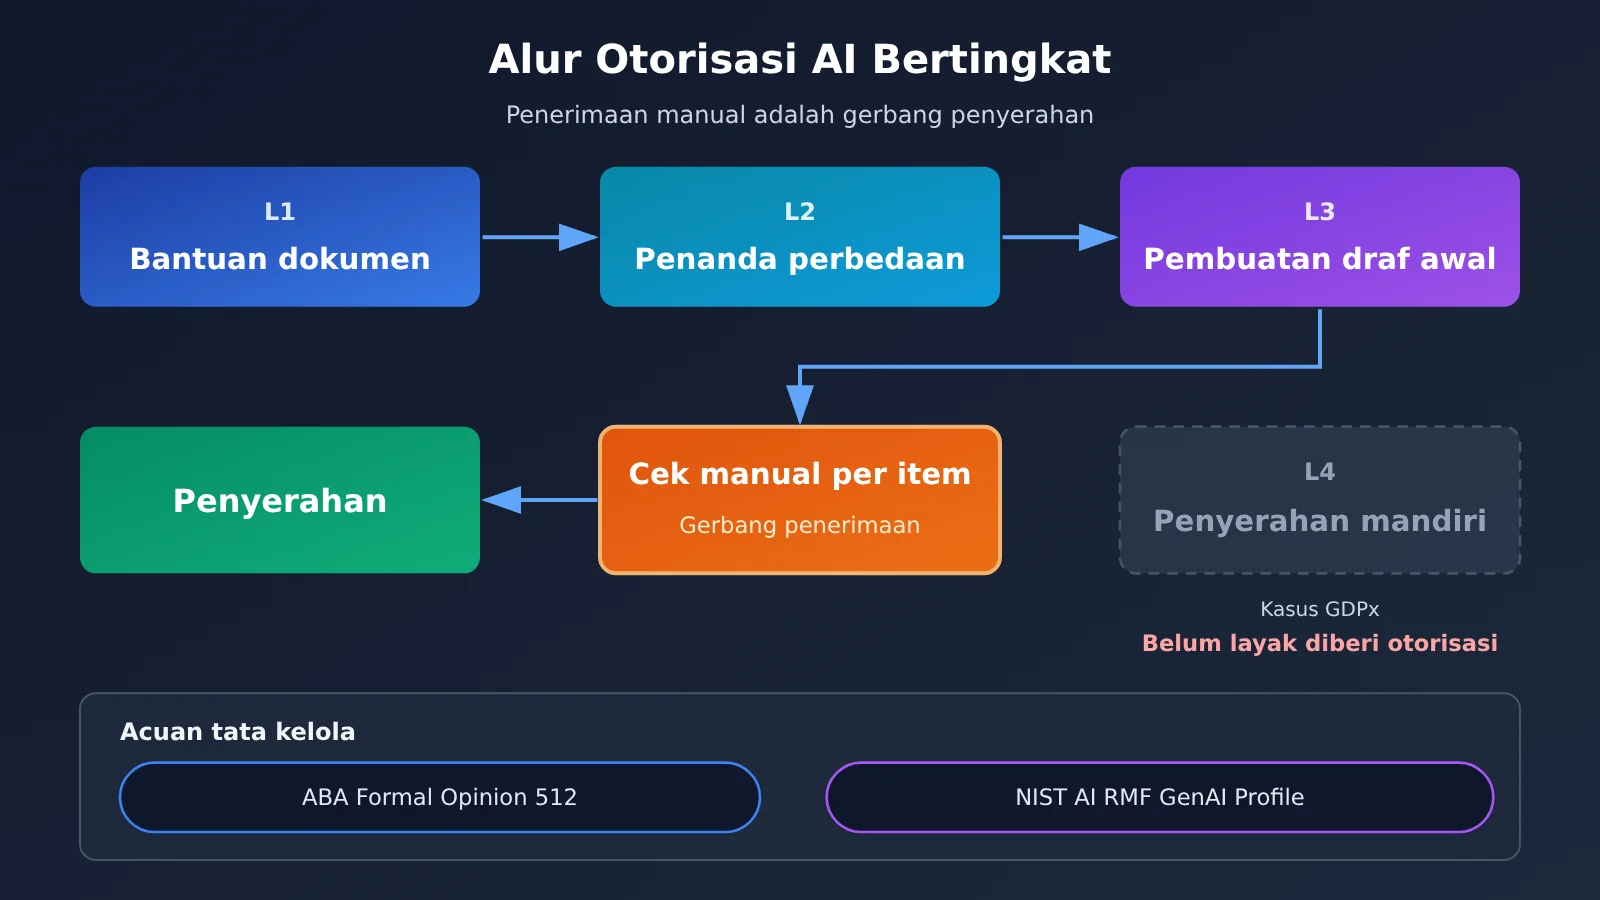
GDPx tidak menafikan nilai AI dalam membantu pekerjaan profesional. Skor parsial menunjukkan bahwa model sudah mampu memenuhi sebagian persyaratan penerimaan hasil. Namun, penelitian ini tidak memberikan dasar untuk menghitung penghematan waktu atau biaya ketika manusia ikut terlibat. Karena itu, kesimpulan dari kasus tersebut tidak sebaiknya langsung dikonversi menjadi ROI. Pendekatan yang lebih praktis adalah memberikan kewenangan berdasarkan tingkat risiko, seperti pada tabel berikut:
| Tingkat kewenangan | Penggunaan umum | Peran manusia | Cara penerimaan hasil |
|---|---|---|---|
| L1 Bantuan materi | Pengumpulan materi awal, pemeriksaan data anomali | Pemeriksaan sampel | Hasil hanya digunakan sebagai petunjuk |
| L2 Penanda perbedaan | Penanda perbedaan klausul dan data, daftar konflik | Konfirmasi satu per satu | Profesional menentukan keabsahannya |
| L3 Pembuatan draf awal | Draf awal revisi workbook, draf awal redline anggaran dasar | Peninjauan menyeluruh | Penerimaan berdasarkan setiap butir daftar periksa |
| L4 Penyerahan mandiri | Penandatanganan atau pengajuan langsung kepada pihak eksternal | — | Kasus GDPx menunjukkan bahwa kewenangan ini belum layak diberikan saat ini |
Tingkatan ini sejalan dengan arah pedoman eksternal. American Bar Association (ABA) menerbitkan Formal Opinion 512 pada 29 Juli 2024, yang menyatakan bahwa pengacara yang menggunakan AI generatif tetap harus memperhatikan tanggung jawab terkait kompetensi profesional, kerahasiaan informasi klien, komunikasi, pengawasan, dan biaya yang wajar. Mereka juga perlu memahami kemampuan dan keterbatasan alat tersebut, serta tidak boleh menggunakan hasilnya tanpa pemeriksaan.
AI RMF Generative AI Profile yang diterbitkan NIST Amerika Serikat pada 26 Juli 2024 juga menekankan bahwa organisasi perlu mengatur pengawasan manusia, evaluasi, pencatatan, dan tata kelola sesuai konteks penggunaan. Perlu dicatat, pendapat ABA merupakan panduan etika profesi pengacara di Amerika Serikat, sementara dokumen NIST juga bukan hasil pengujian GDPx. Keduanya hanya dapat digunakan sebagai referensi lintas bidang.
Membangun alur bantuan “peringatan konflik” dengan API
Salah satu kesalahan yang paling umum dalam kasus hukum GDPx adalah tidak menunjukkan konflik antara email klien dan ketentuan yang telah ditandatangani. Pekerjaan seperti “mencari perbedaan dan mengajukan pertanyaan” cocok untuk bantuan tingkat L2, asalkan hasilnya hanya digunakan sebagai petunjuk untuk dikonfirmasi manusia. Contoh berikut meminta model membandingkan dua teks, lalu mencantumkan konflik dan hal-hal yang perlu dikonfirmasi manusia:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
Lihat kode implementasi lengkap (petunjuk silang dari beberapa model + daftar periksa peninjauan manusia)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu kunci untuk memanggil model dari berbagai penyedia
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """Hasilkan petunjuk peninjauan secara terpisah dengan beberapa model agar mudah dibandingkan oleh manusia"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # Pengacara atau profesional keuangan menentukan apakah hasil diterima berdasarkan setiap butir daftar periksa
🚀 Saran untuk memulai: Saat membangun alur bantuan seperti ini, Anda bisa menggunakan satu kunci API melalui APIYI apiyi.com untuk mengakses beberapa model populer, lalu membandingkan kemampuan masing-masing dalam menemukan konflik pada sampel yang telah dianonimkan. Pengguna baru dapat memakai kredit uji coba gratis untuk validasi skala kecil sebelum memutuskan apakah akan melanjutkan ke uji coba alur kerja.
Dampak terhadap industri keuangan dan teknologi hukum
Hasil GDPx mengingatkan industri bahwa evaluasi produk AI profesional tidak cukup hanya melihat kelancaran demo percakapan, tetapi juga apakah hasil akhirnya lolos pemeriksaan profesional. Bagi penyedia, daya saing produk akan semakin ditentukan oleh detail teknis seperti “prioritas dokumen resmi”, “peringatan perbedaan”, “mempertahankan struktur rumus asli”, dan “penelusuran bukti”. Bagi pembeli, pengujian mandiri sebaiknya dilakukan dengan tugas yang mendekati kebutuhan bisnis mereka. GDPx sendiri baru memublikasikan sebagian tugas dan jejak pelaksanaannya, sehingga masih diperlukan lebih banyak pemeriksaan dan reproduksi hasil oleh pihak eksternal.
💡 Tips memilih model: Kinerja setiap model bisa sangat berbeda di tiap bidang, sehingga satu peringkat keseluruhan tidak selalu mencerminkan kebutuhan bisnis Anda. Melalui antarmuka terpadu APIYI apiyi.com, Anda dapat menguji beberapa model secara paralel pada tugas Anda sendiri. Catat juga skor parsial dan kelulusan pada aspek-aspek penting, bukan hanya skor rata-rata. Untuk ketersediaan model, periksa daftar terbaru di platform.
Pertanyaan Umum (FAQ)
Q1: Apakah “gagal total” dalam tugas keuangan dan hukum berarti AI tidak melakukan satu pun hal dengan benar?
Tidak. Angka 0% adalah hasil berdasarkan penilaian biner yang ketat: tidak ada satu pun pelaksanaan yang memenuhi semua persyaratan penting. Dalam kasus keuangan, pelaksanaan tunggal terbaik lolos 8 dari 11 pemeriksaan. Dalam kasus hukum, skor parsial rata-rata Opus 5.5 adalah 44%. Menyelesaikan sebagian tugas dan menghasilkan pekerjaan yang memenuhi syarat adalah dua standar yang berbeda.
Q2: Mengapa hasil AI masih bisa salah meskipun perhitungannya benar?
Karena kesalahan sering kali terletak pada asumsi bisnis, bukan pada rumusnya. Misalnya, penyesuaian pembebasan sebesar 418 dolar ditafsirkan terlalu luas sebagai berakhirnya kewajiban seluruh polis, sehingga EBITDA dihitung terlalu rendah sebesar 4728 dolar. Dalam kasus lain, jumlah *success fee* bankir sudah benar, tetapi dimasukkan ke dalam utang bersih. Pemeriksaan ulang perhitungan tidak dapat menemukan kesalahan seperti ini.
Q3: Apakah kesimpulan GDPx berlaku untuk semua aplikasi AI di bidang keuangan dan hukum?
Tidak. Hasil tersebut berasal dari tugas berkesulitan tinggi dan aturan penilaian tertentu. Penyebab kegagalan yang disimpulkan dari kasus-kasus tersebut juga tidak bisa digeneralisasi ke seluruh industri. Aplikasi dengan tingkat kesulitan lebih rendah atau yang melibatkan kolaborasi manusia perlu dievaluasi secara terpisah.
Q4: Pekerjaan keuangan dan hukum apa yang cocok ditangani AI saat ini?
Penggunaan yang cukup masuk akal meliputi pengorganisasian awal materi, penandaan perbedaan klausul dan data, pembuatan draf awal, pemeriksaan data yang tidak wajar, serta membantu menyusun daftar periksa peninjauan. Kecocokannya untuk kebutuhan bisnis tertentu perlu diuji secara terpisah berdasarkan tingkat risiko dan standar penilaian profesional.
Q5: Bagaimana cara menguji performa suatu model pada kebutuhan bisnis sendiri dengan biaya rendah?
Anda bisa mengikuti langkah-langkah berikut:
1. Siapkan beberapa sampel nyata yang telah dianonimkan, lalu buat daftar periksa penilaian terperinci untuk setiap sampel;
2. Daftar di APIYI apiyi.com dan dapatkan kunci API, lalu gunakan kuota pengujian gratis;
3. Atur base_url dalam kode artikel ini ke `https://api.apiyi.com/v1`, lalu panggil beberapa model secara paralel;
4. Catat skor parsial dan apakah setiap poin penting lolos, lalu minta tenaga profesional membuat penilaian akhir.
Q6: Apakah biaya tugas dalam laporan GDPx bisa dijadikan acuan harga API?
Tidak. Jumlah dalam dolar di GDPx adalah biaya rata-rata per tugas dalam kondisi pengujian tolok ukur, bukan tarif seragam untuk semua platform. Biaya sebenarnya bergantung pada harga terkini platform yang digunakan dan volume pemanggilan Anda. Rincian biaya berdasarkan penggunaan dapat dilihat di konsol APIYI apiyi.com.
Poin Utama Evaluasi AI untuk Tugas Keuangan dan Hukum
- Tidak ada yang lolos pemeriksaan ketat: Tidak ada model yang sepenuhnya lulus tugas GDPx di bidang keuangan dan hukum berdasarkan standar biner.
- Skor parsial tidak berarti nol: Hasil terbaik dalam satu percobaan kasus keuangan memenuhi 8 dari 11 pemeriksaan, sedangkan skor tertinggi dalam satu percobaan kasus hukum mencapai 57%.
- Kesalahan ada pada penilaian, bukan perhitungan: Penafsiran yang keliru atas penyesuaian sebesar 418 dolar AS menyebabkan EBITDA dihitung terlalu rendah sebesar 4.728 dolar AS.
- Prioritas otoritas dokumen sangat penting: Dalam 14 dari 20 percobaan, email klien diprioritaskan di atas daftar ketentuan yang sudah ditandatangani.
- Batasan tersirat paling sulit ditangani: Risiko pengelakan melalui anak perusahaan tidak berhasil dicegah dalam seluruh 20 percobaan.
- Tiga konsep tidak boleh disamakan: Skor parsial, kelulusan penuh, dan kesiapan untuk produksi perlu dinilai secara terpisah.
- Mulai dari bantuan, lalu uji coba: Gunakan antarmuka terpadu multimodel APIYI di apiyi.com untuk melakukan validasi bertahap pada sampel Anda sendiri.
Kesimpulan
Pelajaran utama dari tugas keuangan dan hukum GDPx dapat dirangkum dalam tiga poin:
- Hasil yang lancar belum tentu memenuhi standar: Perhitungan dalam tabel bisa benar dan klausul bisa ditulis dengan baik, tetapi kesalahan masih dapat muncul pada substansi ekonomi, struktur hak dan kepentingan, serta konflik antardokumen;
- Hasil kerja profesional bergantung pada penilaian: Otoritas sumber, dampak tingkat kedua, batasan tersirat, dan konsistensi antardokumen merupakan bagian tersulit dari pekerjaan profesional;
- Wewenang perlu diberikan bertahap dan kriteria penerimaan harus jelas: Mengacu pada pendekatan ABA dan NIST, pertahankan peninjauan manusia dan gunakan AI sebagai alat bantu serta penyusun draf awal.
AI sudah mampu menyelesaikan sebagian pekerjaan bernilai dalam tugas profesional yang kompleks, tetapi masih ada kesenjangan yang jelas sebelum AI dapat menghasilkan pekerjaan dan bertanggung jawab secara mandiri. Jika Anda sedang mengevaluasi solusi AI untuk bidang keuangan atau hukum, bandingkan skor parsial dan tingkat kelulusan pada pemeriksaan penting dari beberapa model menggunakan sampel bisnis Anda sendiri melalui APIYI di apiyi.com. Setelah itu, tentukan batas wewenangnya.
📚 Referensi
- Laporan asli SemiAnalysis GDPx: bagian keuangan dan hukum, studi kasus, serta pola kegagalan
- Tautan:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Keterangan: Sumber utama data kasus Bellwood-QoE dan quillon-series-b-redline
-
Penjelasan domain GDPx dan jejak eksekusi publik: jumlah tugas, mitra, dan jejak agen
- Tautan:
gdpx.semianalysis.com/domains、gdpx.semianalysis.com/rollouts -
Keterangan: Proses pelaksanaan beberapa tugas tersedia untuk dilihat publik
-
Pengumuman ABA Formal Opinion 512: panduan etika profesi bagi pengacara yang menggunakan AI generatif
- Tautan:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
Keterangan: Berlaku untuk profesi pengacara di Amerika Serikat dan dapat menjadi acuan untuk prinsip peninjauan manusia
-
Profil AI Generatif NIST AI RMF: kerangka kerja manajemen risiko AI generatif
- Tautan:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - Keterangan: Referensi lintas bidang tentang pengawasan manusia, evaluasi, dan langkah tata kelola
Penulis: Tim Teknologi APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs resmi APIYI. Untuk informasi integrasi lebih lanjut, kunjungi pusat dokumentasi di docs.apiyi.com