Catatan penulis: dengan contoh permintaan kontrol kualitas layanan pelanggan, kita bedah verifikasi output, pemeliharaan status sesi, dan pengambilan hasil latar belakang GPT-6.2 Sol di Responses API.
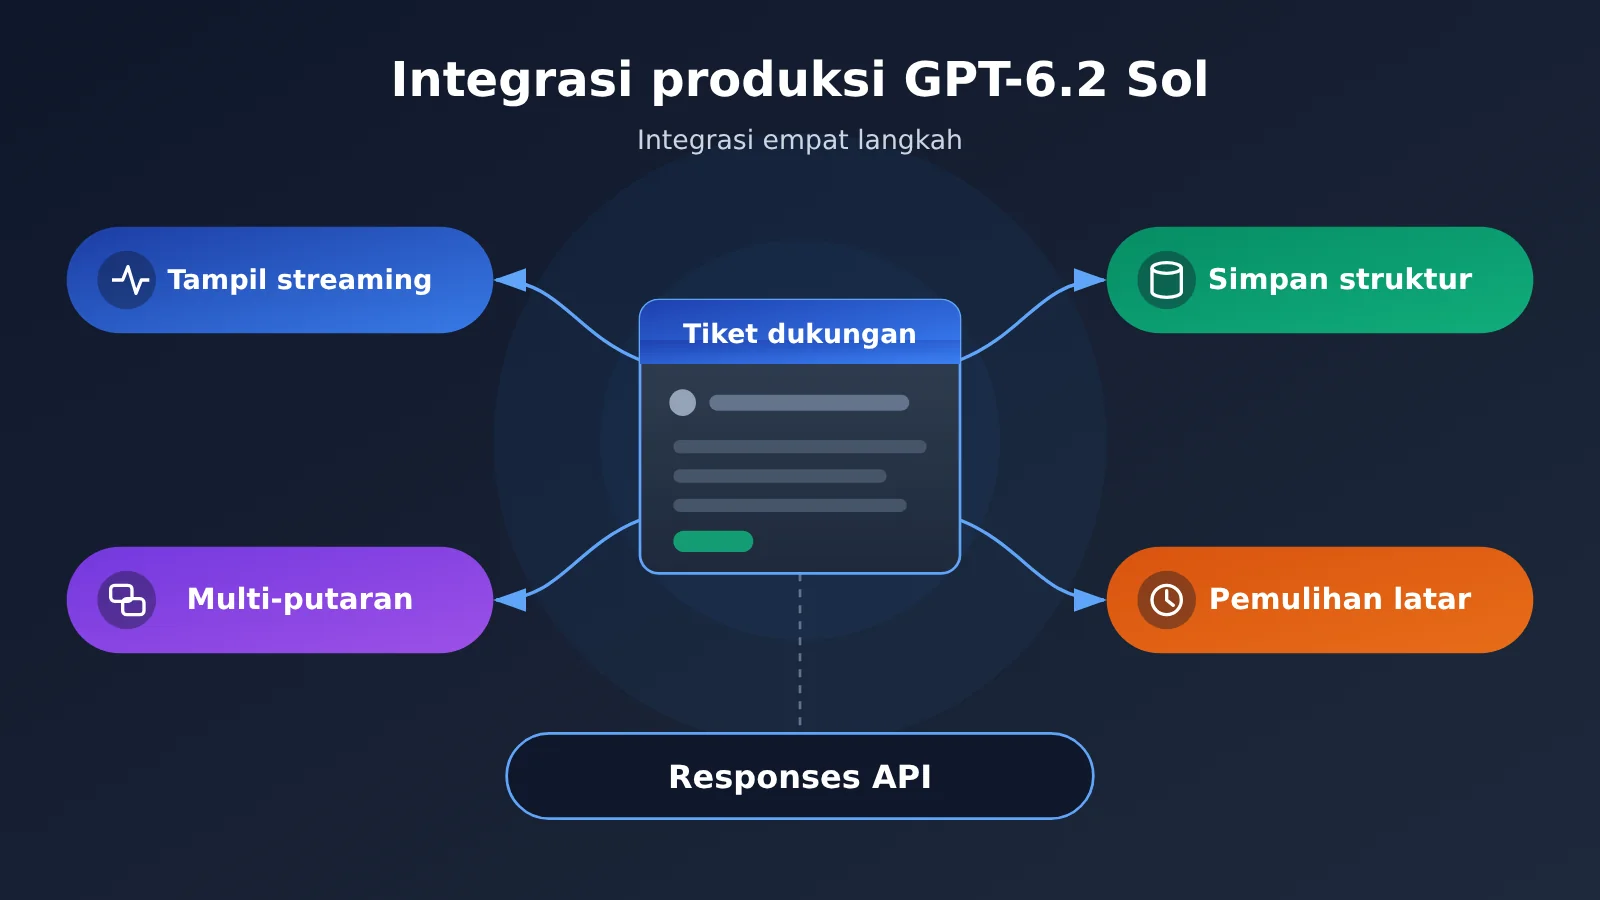
Kesimpulan lebih dulu: untuk menghubungkan GPT-6.2 Sol ke sistem produksi, satu tugas bisnis yang sama perlu dipecah menjadi empat perilaku, lalu masing-masing diberi standar verifikasi sendiri. Empat perilaku itu adalah umpan balik instan di antarmuka, hasil yang bisa dimasukkan ke basis data oleh mesin, konteks lintas giliran, dan status akhir. Peristiwa streaming hanya bertanggung jawab untuk tampilan; sebelum masuk ke basis data, respons lengkap wajib diperoleh dan harus lolos validasi Schema serta validasi bisnis. Untuk informasi lintas giliran, tentukan dulu siapa yang memegang status. Tugas latar belakang hanya mengenali ID respons dan status terminal; notifikasi bisa berulang, jadi penulisan harus idempoten.
Ada dua prasyarat untuk mencapai keempat hal itu. Pertama, bila butuh tool bawaan atau tool kustom, ikuti panduan migrasi GPT-6.2 dan pakai Responses API — artikel ini juga hanya membahas perilaku runtime Responses. Kedua, jika pemanggilan dilakukan lewat platform agregator, apakah mode latar belakang, Webhook, dan kemampuan sejenis tersedia atau tidak, mengacu pada konfigurasi platform saat itu. Di APIYI apiyi.com, gpt-6.2-sol sudah tercantum secara publik dengan dua entri, yaitu responses dan chat.
Peta Pengetahuan Integrasi Produksi GPT-6.2 Sol
Seluruh artikel ini mengikuti satu alur: mengirim permintaan → menampilkan → melanjutkan → membaca ulang → uji terima. Diagram alur di bawah ini menandai hasil dari setiap langkah beserta nomor bagian terkait di badan artikel.
Mengirim permintaan(model=gpt-6.2-sol,Responses API)
  │
  ├─▶ Tampilkan【Bagian 1】
  │     Event inkremental → halaman menampilkan opini pemeriksaan mutu secara real-time
  │     Event status akhir → hentikan pemuatan; respons lengkap → Schema + validasi bisnis → simpan ke database / tinjauan manual
  │
  ├─▶ Lanjutkan【Bagian 2】
  │     Riwayat yang dikelola sendiri / previous_response_id / Conversation
  │     Aturan tetap(developer) dipisahkan dari instruksi putaran berjalan(instructions)
  │
  ├─▶ Baca ulang【Bagian 3】
  │     kirim background → simpan ID respons → verifikasi tanda tangan & deduplikasi Webhook → baca ulang berdasarkan ID → simpan status akhir
  │
  └─▶ Uji terima【Bagian 4】
        sukses / tidak lengkap / notifikasi berulang / klien terputus / perubahan Schema
Indeks Integrasi GPT-6.2 Sol
| Bagian | Pertanyaan yang dijawab | Apa yang disumbangkan untuk bagian berikutnya | Yang bisa dilakukan setelah membaca |
|---|---|---|---|
| 1. Streaming dan terstruktur | Bagaimana halaman melihat aliran, bagaimana mesin menerima hasil | Menetapkan kriteria “selesai” dan “layak masuk database” | Membedakan jalur tampilan dan jalur penyimpanan ke database |
| 2. Status multi-putaran | Bagaimana permintaan putaran berikutnya menyambung ke putaran sebelumnya | Menentukan pihak pemegang status dan syarat penyimpanan | Hanya mengubah fokus putaran berjalan, tanpa merusak prefiks |
| 3. Tugas latar belakang | Bagaimana hasil masuk ke database setelah pengguna meninggalkan halaman | Keterkaitan antara ID respons, ID tugas, dan status akhir | Menerapkan verifikasi tanda tangan, deduplikasi, dan penulisan idempoten |
| 4. Uji terima peluncuran | Perilaku mana yang wajib diverifikasi lebih dulu | Merangkum kriteria penilaian dari tiga bagian sebelumnya | Menghasilkan catatan regresi yang dapat ditelusuri |
Bagian 1 sampai 3 masing-masing terkait dengan satu jalur operasional. Jika Anda hanya mengerjakan salah satunya, Anda bisa membacanya sesuai kebutuhan. Bagian 4 bergantung pada status yang didefinisikan di tiga bagian sebelumnya, sehingga cocok dibaca terakhir.
Istilah Terkait GPT-6.2 Sol yang Perlu Diketahui
| Istilah | Penjelasan |
|---|---|
| SSE | Protokol di mana server mendorong event secara berurutan ke klien melalui satu koneksi HTTP. |
| Structured Outputs | Fitur API yang mewajibkan konten terstruktur yang dikembalikan berhasil sesuai dengan JSON Schema yang didukung. |
| Respons penolakan | Item konten yang dikembalikan saat model secara eksplisit menolak menyelesaikan tugas, perlu diproses melalui alur terpisah. |
| Status sesi | Konteks seperti pesan dan hasil alat yang disimpan untuk permintaan berikutnya. |
| Item penalaran terenkripsi | Item respons terenkripsi yang digunakan untuk melanjutkan status penalaran, dapat dikirim balik bersama konteks. |
| Prefiks | Urutan konteks di bagian awal permintaan saat ini yang identik dengan putaran sebelumnya. |
| Jendela penyelesaian | Rentang waktu target penyelesaian yang ditetapkan untuk respons ini setelah layanan menerima permintaan latar belakang. |
| Webhook | Notifikasi bertanda tangan yang dikirim secara aktif oleh server ke URL yang ditentukan aplikasi. |
| Status akhir | Status final setelah tugas selesai, gagal, tidak lengkap, atau dibatalkan. |
| Idempoten | Efek bisnis yang hanya dihasilkan sekali meskipun callback atau tugas yang sama diproses berulang kali. |
1. Output Streaming dan Penerimaan Terstruktur GPT-6.2 Sol
1.1 Dua Jalur Output GPT-6.2 Sol
Mari kita lihat skenario pemeriksaan kualitas layanan pelanggan. Agen yang sedang bertugas membuka tiket, dan halaman harus segera menampilkan opini pengawasan yang diberikan model. Hasil analisis yang sama juga perlu ditulis ke basis data pemeriksaan kualitas untuk statistik akhir hari. Kedua kebutuhan ini memiliki definisi “selesai” yang berbeda, jadi harus ditangani melalui dua jalur.
| Jalur | Konsumen | Sinyal yang Diandalkan | Syarat untuk Menentukan “Selesai” | Tujuan saat Gagal |
|---|---|---|---|---|
| Jalur tampilan | Halaman agen | Event inkremental response.output_text.delta |
Menerima response.completed atau event status akhir jenis kegagalan |
Halaman menampilkan pemberitahuan dan mempertahankan konten yang sudah ditampilkan |
| Jalur penyimpanan | Basis data pemeriksaan kualitas | Objek respons lengkap | Validasi skema dan validasi bisnis keduanya lolos | Ditolak, tidak lengkap, dan kesalahan format masing-masing masuk ke peninjauan manual |
Setelah permintaan streaming diatur dengan stream=true, server akan mengirimkan event secara berurutan melalui HTTP SSE. Halaman hanya perlu menambahkan teks dari response.output_text.delta ke tampilan. Status pemuatan harus ditunggu hingga event status akhir tiba; berhentinya output teks bukan berarti tugas sudah selesai.
1.2 Contoh Tampilan Streaming GPT-6.2 Sol
Contoh di bawah ini hanya untuk keperluan tampilan. Contoh ini mengirimkan teks inkremental ke frontend dan menghentikan penantian saat status terminal tercapai:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Endpoint kompatibel OpenAI APIYI
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # Tambahkan ke halaman secara real-time
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # Akhiri pemuatan dengan status terminal
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # Tampilkan kegagalan dan ketidaklengkapan secara terpisah
push_to_page, finish_loading, dan fungsi sejenis adalah fungsi di sisi bisnis. Daftar lengkap event status terminal mengacu pada dokumentasi respons streaming resmi.
1.3 Urutan Validasi Output Terstruktur GPT-6.2 Sol
Dalam Responses API, output terstruktur dideklarasikan di text.format, bukan di dalam pesan. Setelah jalur penyimpanan menerima respons lengkap, lakukan penilaian dengan urutan berikut:
- Periksa status respons. Respons yang tidak lengkap (
statusbernilai incomplete) langsung masuk ke tinjauan manual; jangan mencoba mem-parsing JSON yang terpotong. - Periksa item konten. Jika ada item konten bertipe penolakan (refusal), jalankan alur penolakan dan jangan menganggapnya sebagai kesalahan format.
- Parse JSON dan lakukan validasi Schema.
- Lakukan validasi bisnis: tiket asli harus ada, item yang hilang harus terlihat jelas, dan tidak boleh diisi diam-diam.
Lihat kode lengkap penyimpanan terstruktur GPT-6.2 Sol
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
Perhatikan bahwa lolos validasi Schema hanya menunjukkan strukturnya benar, bukan isinya benar. Apakah nomor tiket ada dan apakah item yang hilang ditandai dengan jujur — semua pemeriksaan ini harus dilakukan di lapisan bisnis.
🎯 Saran teknis: Di lingkungan pengujian, Anda dapat mengirimkan permintaan streaming dan non-streaming secara bersamaan melalui APIYI apiyi.com, lalu membandingkan status terminal dan hasil penyimpanan untuk tiket yang sama pada kedua jalur. Dengan begitu, Anda bisa memastikan lebih awal bahwa logika pemuatan frontend dan cabang penyimpanan tidak saling mengganggu.
2. Kelanjutan Status Percakapan Multi-giliran GPT-6.2 Sol
2.1 Perbandingan Tiga Jalur Status GPT-6.2 Sol
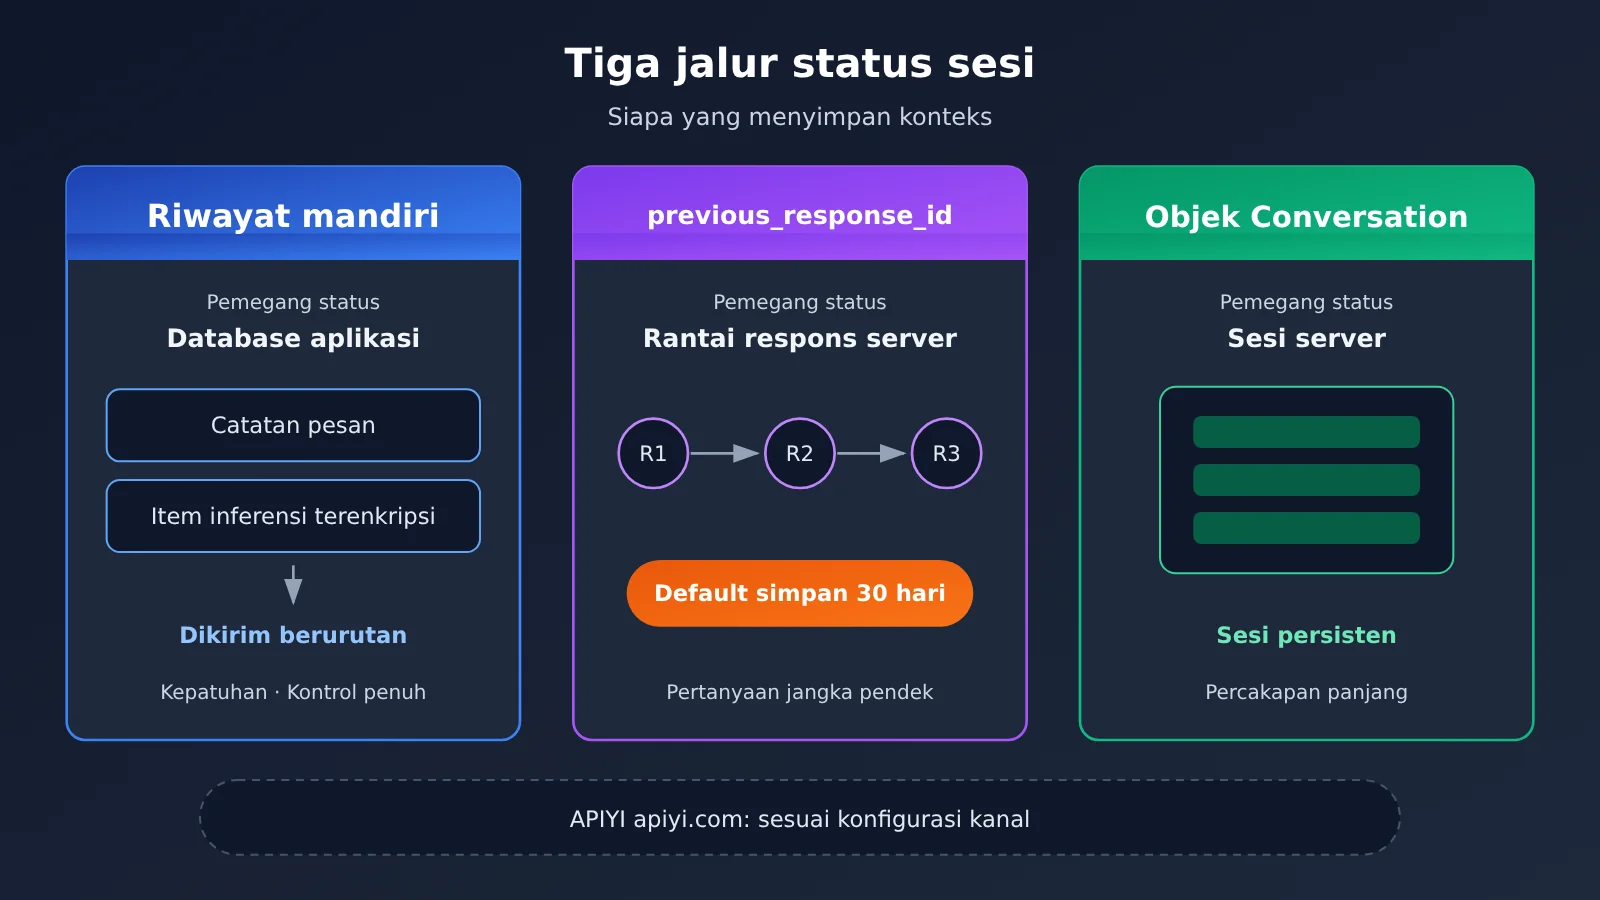
Agen menambahkan fakta baru pada tiket yang sama dan ingin model melanjutkan analisis dari putaran sebelumnya. Pertanyaan pertama yang harus dijawab adalah: siapa yang menyimpan konteks?
| Jalur | Pihak pemegang status | Ketentuan retensi | Skenario yang cocok | Platform yang tersedia |
|---|---|---|---|---|
| Riwayat yang dikelola sendiri | Aplikasi sendiri | Ditentukan oleh aplikasi; pesan serta item respons yang diperlukan harus dikirim kembali dalam urutan aslinya | Ada persyaratan kepatuhan, atau perlu kendali penuh atas konteks | API resmi, APIYI apiyi.com |
previous_response_id |
Rantai respons sisi server | Hanya dapat dilanjutkan selama respons masih tersedia; objek respons disimpan secara default selama 30 hari | Pertanyaan lanjutan jangka pendek | Mengikuti konfigurasi kanal saat ini |
| Objek Conversation | Objek sesi sisi server | Item yang dilampirkan pada Conversation diproses sesuai aturan retensi objek tersebut | Percakapan yang perlu disimpan lebih persisten | Mengikuti konfigurasi kanal saat ini |
Jika memilih riwayat yang dikelola sendiri sekaligus ingin penalaran tetap berkesinambungan, Anda tidak bisa hanya mengirim kembali teks. Item respons yang diperlukan harus dipertahankan dan diputar ulang sesuai urutan, termasuk item penalaran terenkripsi.
2.2 Cara Mengubah Hanya Fokus Audit dengan GPT-6.2 Sol
Misalkan pada putaran kedua Anda hanya ingin mengubah fokus audit dari “ketepatan waktu respons” menjadi “kepatuhan skrip”. Cara yang benar: aturan QC umum diletakkan pada pesan developer pertama dalam rantai, sedangkan fokus khusus putaran ini ditulis di instructions tingkat atas. instructions hanya berlaku untuk permintaan yang menyertakannya dan tidak mencemari putaran berikutnya.
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # Hanya berlaku untuk permintaan ini
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
Ada satu keuntungan lagi dari cara ini: aturan pertama tetap tidak berubah dan prefiksnya juga tetap stabil.
2.3 Risiko Perubahan Prefiks pada GPT-6.2 Sol
GPT-6.2 dapat menghapus item penalaran terkait dalam beberapa situasi: menulis ulang riwayat lama, melakukan peralihan model sebagian (misalnya downgrade), serta berganti pengguna atau organisasi. Untuk sesi agen tunggal Standard yang perlu dilanjutkan, jika Anda ingin menyesuaikan tingkat penalaran atau Schema output, tambahkan item configuration_update yang sesuai, bukan mengubah konfigurasi lama. Bidang spesifik untuk item tersebut mengikuti panduan migrasi GPT-6.2.
Saat aturan jangka panjang perlu diperbarui, tambahkan pesan developer baru di akhir konteks; jangan mengedit aturan lama, dan jangan mengubah konfigurasi alat serta Schema sebelumnya. Bahkan jika prefiks tetap stabil, kemungkinan cache hit tetap bergantung pada permintaan dan kondisi pemrosesan spesifik; jangan menganggapnya sebagai hasil yang pasti.
3. Penyimpanan Tugas Latar Belakang GPT-6.2 Sol
3.1 Pengiriman Latar Belakang dan Jendela Penyelesaian GPT-6.2 Sol
Ringkasan tiket yang menunggu peninjauan di akhir hari bisa memakan waktu cukup lama, dan agen tidak akan terus memantau halaman. Tugas seperti ini dikirim dengan background: true. Segera setelah pengiriman, simpan ID respons yang dikembalikan secara persisten, lalu petakan satu-ke-satu dengan ID tugas bisnis.
Jendela penyelesaian dipilih berdasarkan waktu tunggu yang dapat diterima, dengan nilai default soonest. 2h dan 8h adalah jendela diskon di tingkat Standard, saat ini masih berstatus fitur uji publik, dan streaming tidak boleh diaktifkan saat pengiriman. Nama parameter jendela penyelesaian dan persyaratan penyimpanan mengikuti dokumentasi mode latar belakang.
| Jendela penyelesaian | Peruntukan | Streaming | Tugas QC yang cocok |
|---|---|---|---|
soonest (default) |
Selesai secepat mungkin | Sesuai dokumentasi mode latar belakang | Peninjauan ulang yang perlu dilihat lagi dalam shift |
2h |
Jendela diskon Standard, uji publik | Tidak diaktifkan | Ringkasan setelah shift |
8h |
Jendela diskon Standard, uji publik | Tidak diaktifkan | Ringkasan batch akhir hari |
3.2 Verifikasi Tanda Tangan, Deduplikasi, dan Pembacaan Ulang Webhook GPT-6.2 Sol
Saat tugas berada dalam antrean atau sedang berjalan, cukup terus melakukan polling pada ID yang sama. Jika menerima event penyelesaian, proses dengan urutan berikut:
- Verifikasi tanda tangan. Jika verifikasi gagal, langsung buang.
- Deduplikasi menggunakan
webhook-id. Notifikasi yang sama bisa dikirim ulang. - Baca ulang respons lengkap berdasarkan
event.data.id. Notifikasi itu sendiri tidak dipakai sebagai hasil. - Tulis status akhir dan hasil secara idempoten berdasarkan ID tugas.
Lihat kode pengambilan tugas latar belakang GPT-6.2 Sol
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Kirim
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# Penanganan webhook
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # Verifikasi tanda tangan, lempar exception jika gagal
    if db.seen_webhook(headers["webhook-id"]):         # Deduplikasi
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # Baca ulang respons lengkap
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # Tulis idempoten berdasarkan ID tugas
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
Ketika pengguna menutup halaman lalu kembali lagi, frontend hanya perlu mengambil ID tugas bisnis dan menanyakannya ke database lokal. Jika status belum mencapai keadaan akhir, server melanjutkan polling menggunakan ID respons yang sudah disimpan.
Perlu perhatian khusus pada retensi data. Mode latar belakang menyimpan sementara data respons untuk mendukung pembacaan ulang. Ini tetap berlaku meskipun store: false diatur, atau organisasi mengaktifkan ZDR, jadi cocokkan dengan dokumentasi kontrol data untuk memastikan apakah hal ini dapat diterima.
💡 Saran integrasi: Alamat callback webhook dan mode latar belakang memerlukan dukungan dari sisi kanal. Sebelum melakukan integrasi melalui APIYI apiyi.com, sebaiknya konfirmasi terlebih dahulu apakah grup akun saat ini sudah membuka mode latar belakang dan kemampuan callback. Jika belum tersedia, Anda bisa lebih dulu menjalankan state machine dengan metode polling ID respons.
4. Daftar Periksa Peluncuran GPT-6.2 Sol
4.1 Tabel Uji Sintetis GPT-6.2 Sol
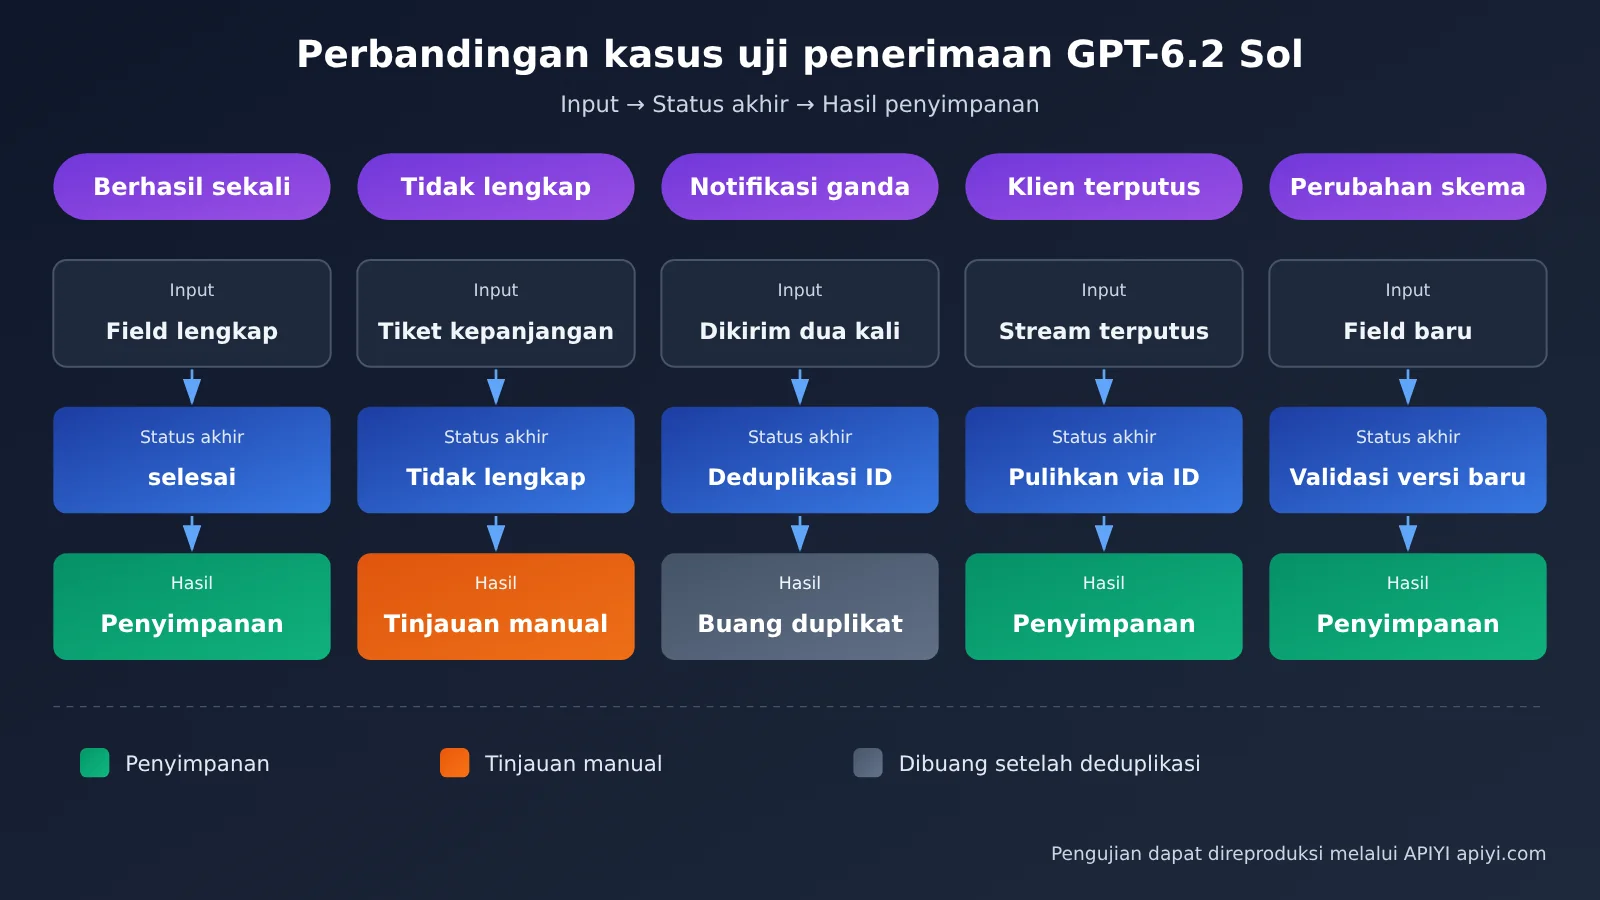
Tabel uji terima di bawah ini melanjutkan kasus sintetis QC layanan pelanggan, dan menerapkan satu per satu kondisi penilaian dari tiga bagian sebelumnya menjadi skenario yang bisa dijalankan.
| Skenario | Kondisi input | Status atau hasil yang diharapkan |
|---|---|---|
| Satu kali sukses | Tiket yang benar-benar ada, kolom lengkap | Status akhir completed; validasi Schema dan bisnis lolos; satu hasil ditulis berdasarkan ID tugas |
| Satu respons tidak lengkap | Sengaja menurunkan batas output, atau memakai tiket yang sangat panjang | Status incomplete; JSON tidak diurai; masuk ke peninjauan manual dan alasannya dicatat |
| Satu notifikasi duplikat | webhook-id yang sama dikirim dua kali |
Pengiriman kedua dideduplikasi; tabel hasil hanya berisi satu catatan |
| Satu klien terputus | Memutus koneksi browser saat streaming | Status dipulihkan lewat ID respons yang tersimpan; hasil di database tidak terpengaruh halaman |
| Satu perubahan Schema | Menambahkan satu kolom wajib di tengah sesi | Penyesuaian dilakukan lewat pembaruan konfigurasi tambahan, konfigurasi lama tidak ditulis ulang; hasil baru divalidasi dengan Schema baru |
Setiap skenario harus menyimpan empat informasi: ID model yang dipanggil (gpt-6.2-sol), parameter eksekusi, ID respons, dan versi konfigurasi di sisi aplikasi. Kalau muncul masalah, keempat hal ini sudah cukup untuk melacak permintaan mana yang bermasalah.
4.2 Standar Pencatatan Saat Regresi GPT-6.2 Sol
| Item | Isi yang dicatat | Keterangan |
|---|---|---|
| Model | gpt-6.2-sol |
Merujuk ID publik pada kartu model |
| Endpoint | Responses | Pemanggilan fungsi dan alat bawaan lewat jalur ini |
| Tingkat penalaran | Tingkat yang benar-benar dipakai | Baik Responses maupun Chat Completions tidak menerima none |
| Penggunaan | usage.output_tokens dan sub-item token penalaran di dalamnya |
Penagihan output sudah mencakup token penalaran |
| Pergantian tingkat penagihan | Apakah input satu permintaan melewati 272K | Antarmuka harga publik APIYI berganti tingkat pada 272.000 token input, tagihan sebenarnya mengikuti bill |
Saat memigrasikan sistem lama, endpoint, parameter permintaan, input multi-putaran, konteks penalaran, dan cache perlu diperiksa satu per satu. Setelah selesai, jalankan regresi pada permintaan contoh dan permintaan produksi sekaligus dengan batch skenario yang sama.
🚀 Saran uji terima: Kelima jenis skenario bisa ditulis ke dalam CI, dan dijalankan otomatis setiap kali Schema diubah atau channel diganti. Dengan Key terpadu dari APIYI apiyi.com, kamu bisa membandingkan perbedaan perilaku antar grup pada rangkaian skenario yang sama.
Kalau kelima skenario di tabel uji terima lolos semua dan masing-masing bisa dilacak lewat ID respons, berarti jalur QC ini sudah memenuhi syarat untuk diluncurkan.
Referensi
- Kartu Model GPT-6.2 Sol: ID model, konteks, dan aturan penagihan
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Tautan:
- Panduan Migrasi GPT-6.2: Pemilihan endpoint, perubahan prefix, dan pembaruan konfigurasi
- Tautan:
developers.openai.com/api/docs/guides/latest-model
- Tautan:
- Respons Streaming dan Output Terstruktur: Event SSE dan
text.format- Tautan:
developers.openai.com/api/docs/guides/streaming-responses
- Tautan:
- Status Sesi:
previous_response_iddan Conversations- Tautan:
developers.openai.com/api/docs/guides/conversation-state
- Tautan:
- Mode Latar Belakang dan Webhook: Jendela penyelesaian, verifikasi tanda tangan, dan deduplikasi
- Tautan:
developers.openai.com/api/docs/guides/background
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi Teknis: Silakan hubungi kami melalui halaman utama situs web APIYI, untuk materi akses lainnya kunjungi pusat dokumentasi docs.apiyi.com