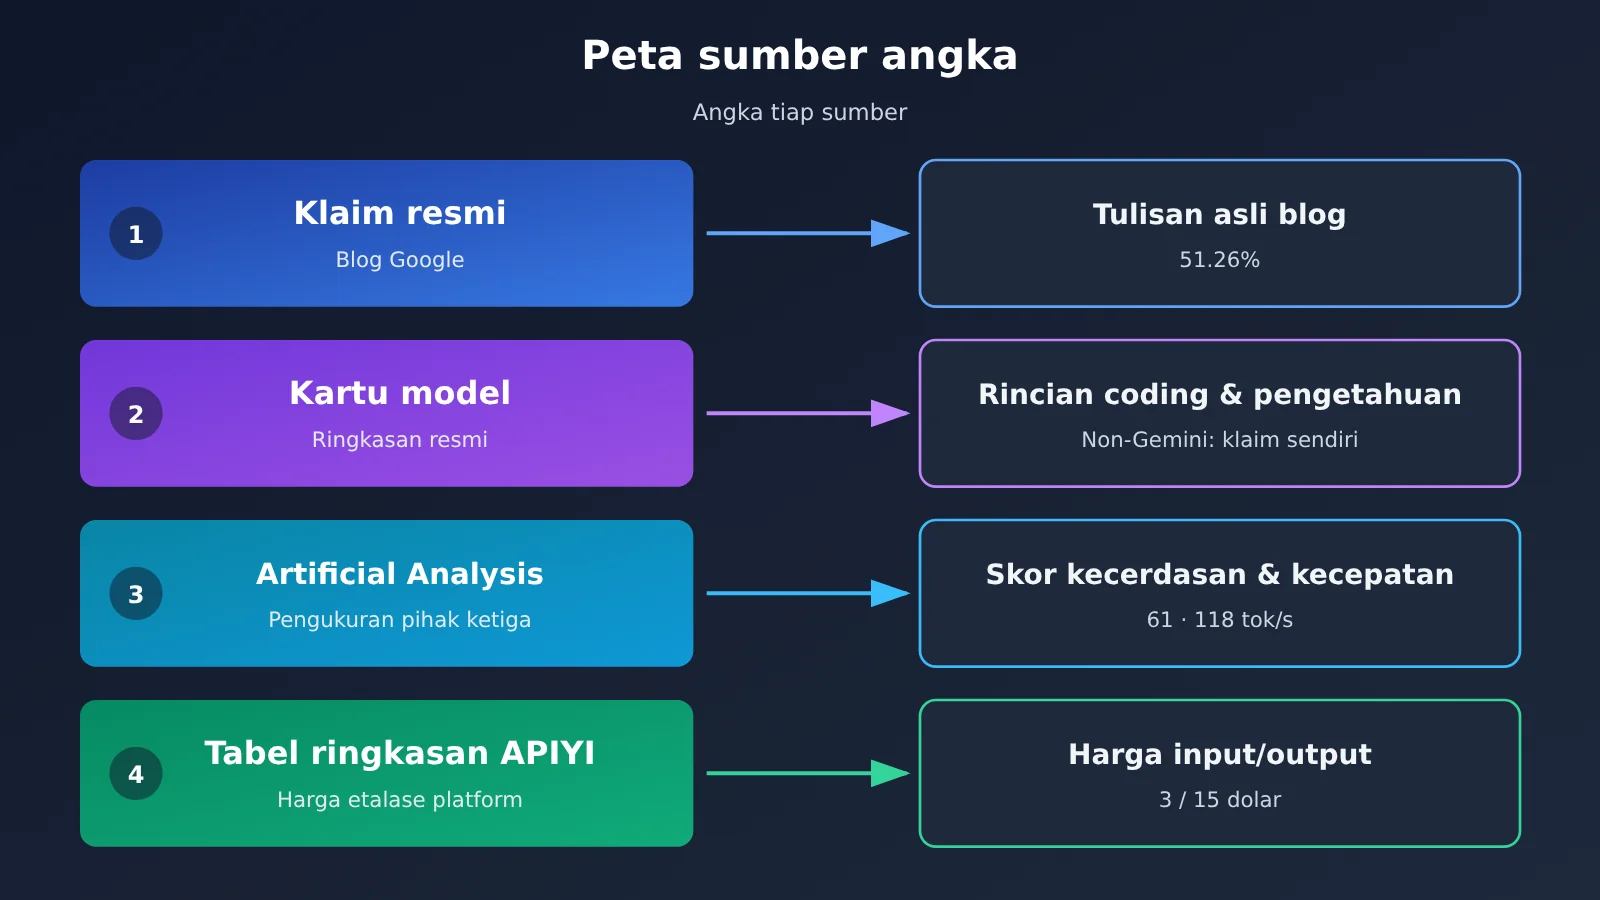
Catatan penulis: artikel ini membaca angka-angka publik Gemini 4 Neon dan Claude Opus 5.5 secara terpisah di dua jalur — coding dan pekerjaan pengetahuan — dan menandai satu per satu apakah angka tersebut berasal dari laporan resmi sendiri, model card, halaman model Artificial Analysis, artikel Artificial Analysis, tabel ringkasan APIYI, atau endpoint harga.
Kalau alur kerja Anda sudah terhubung ke Claude Opus 5.5, Gemini 4 Neon yang dirilis 2026-11-18 langsung memunculkan pertanyaan: pada proyek yang sama, siapa yang angkanya lebih tinggi, dan apakah angka-angka itu diukur dengan penggaris yang sama. Blog Google, model card DeepMind, dan Artificial Analysis semuanya merilis angka pada hari peluncuran, tetapi cakupan pengukuran, tier, dan kerangka pengujiannya tidak sama.
Tanggal verifikasi data dalam artikel ini adalah 2026-11-19, semua angka bersumber dari materi publik, dan setiap angka diberi keterangan sumbernya. Coding dan pekerjaan pengetahuan dibaca sebagai dua jalur terpisah, sedangkan model card dan Artificial Analysis ditulis dalam dua bagian masing-masing. Model mana yang lebih cocok untuk Anda bergantung pada baris mana yang Anda anggap penting.
Nilai inti: setelah membaca artikel ini, Anda akan tahu cara membaca tabel tiga kolom pada model card Gemini 4 Neon, apa yang sebenarnya diwakili oleh skor kecerdasan, biaya per tugas, waktu tempuh, dan kecepatan output di Artificial Analysis, serta bagaimana cara menemukan nama model dan harga resmi Claude Opus 5.5 di APIYI.
Poin-poin inti Gemini 4 Neon dan Claude Opus 5.5
Mari lihat tabel ringkasnya dulu. Setiap baris mencantumkan level pengaturan dan sumber; kondisi pengukuran dua angka dalam baris yang sama belum tentu sepenuhnya identik.
| Dimensi | Gemini 4 Neon | Claude Opus 5.5 | Sumber |
|---|---|---|---|
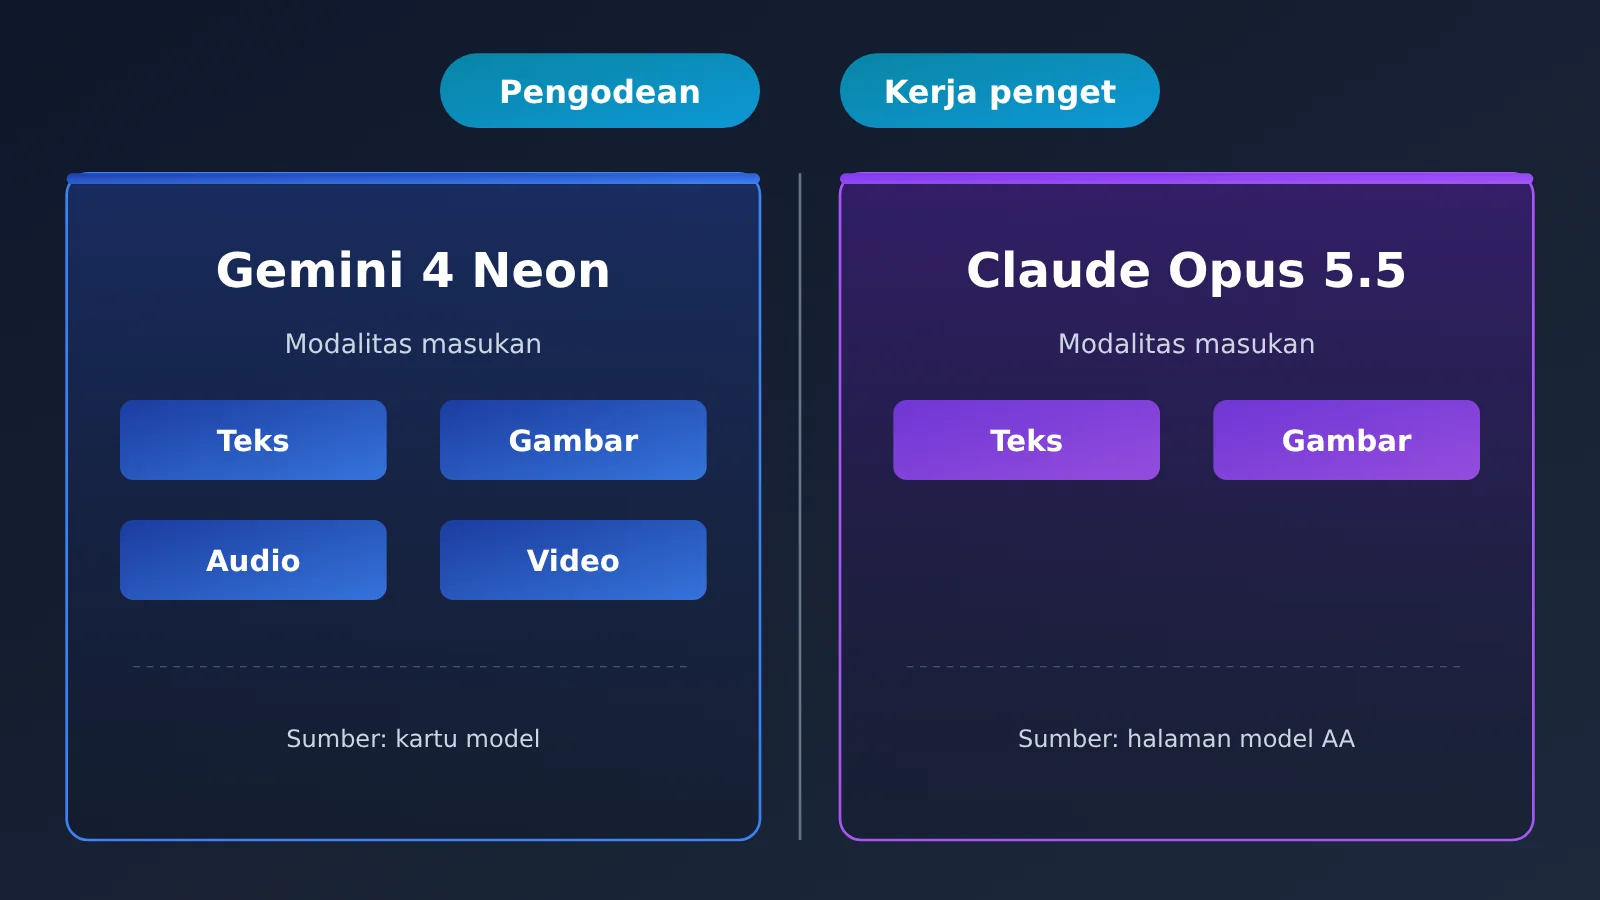
| Modalitas input | Teks, gambar, audio, video | Teks, gambar | Kartu model / halaman model Artificial Analysis |
| Skor kecerdasan (indeks v5.0.1) | 61 (xhigh) | 59 (max) | Halaman model Artificial Analysis |
| Terminal-bench 4.1 (disesuaikan terhadap kecurangan) | 65.2% | 65.8% | Kartu model (hasil non-Gemini dilaporkan sendiri oleh masing-masing penyedia) |
| FrontierCode 2.0 | 46.2% (default high) | 47.3% | Kartu model |
| Biaya per tugas | 6,44 dolar | 10,04 dolar | Halaman model Artificial Analysis |
| Kecepatan output | 110 token/detik | 118 token/detik | Halaman model Artificial Analysis |
| Harga terdaftar (input / output, per juta token) | 3 / 15 dolar | 4 / 20 dolar | Halaman harga Google AI Studio / halaman model Artificial Analysis |
Distribusi angka Gemini 4 Neon dan Claude Opus 5.5
Dalam tabel ini, ada baris-baris di mana masing-masing pihak lebih tinggi. Pada sebagian besar subskor di kartu model dan skor kecerdasan Artificial Analysis (61 vs 59), Gemini 4 Neon lebih tinggi. Pada Terminal-bench 4.1 (65.8% vs 65.2%), FrontierCode 2.0 (47.3% vs 46.2%), dan kecepatan output (118 vs 110 token/detik), Claude Opus 5.5 lebih tinggi.
Modalitas input perlu dijelaskan terpisah. Menurut kartu model, Gemini 4 Neon dapat menerima input teks, gambar, audio, dan video. Menurut halaman model Artificial Analysis, input Claude Opus 5.5 adalah teks dan gambar. Jika tugas Anda perlu memproses audio atau video secara langsung, poin ini akan menentukan pilihan model. Jika tugas hanya melibatkan teks dan tangkapan layar, poin ini tidak menjadi pembeda.
Gemini 4 Neon vs Claude Opus 5.5: Cara membaca tabel tiga kolom kartu model
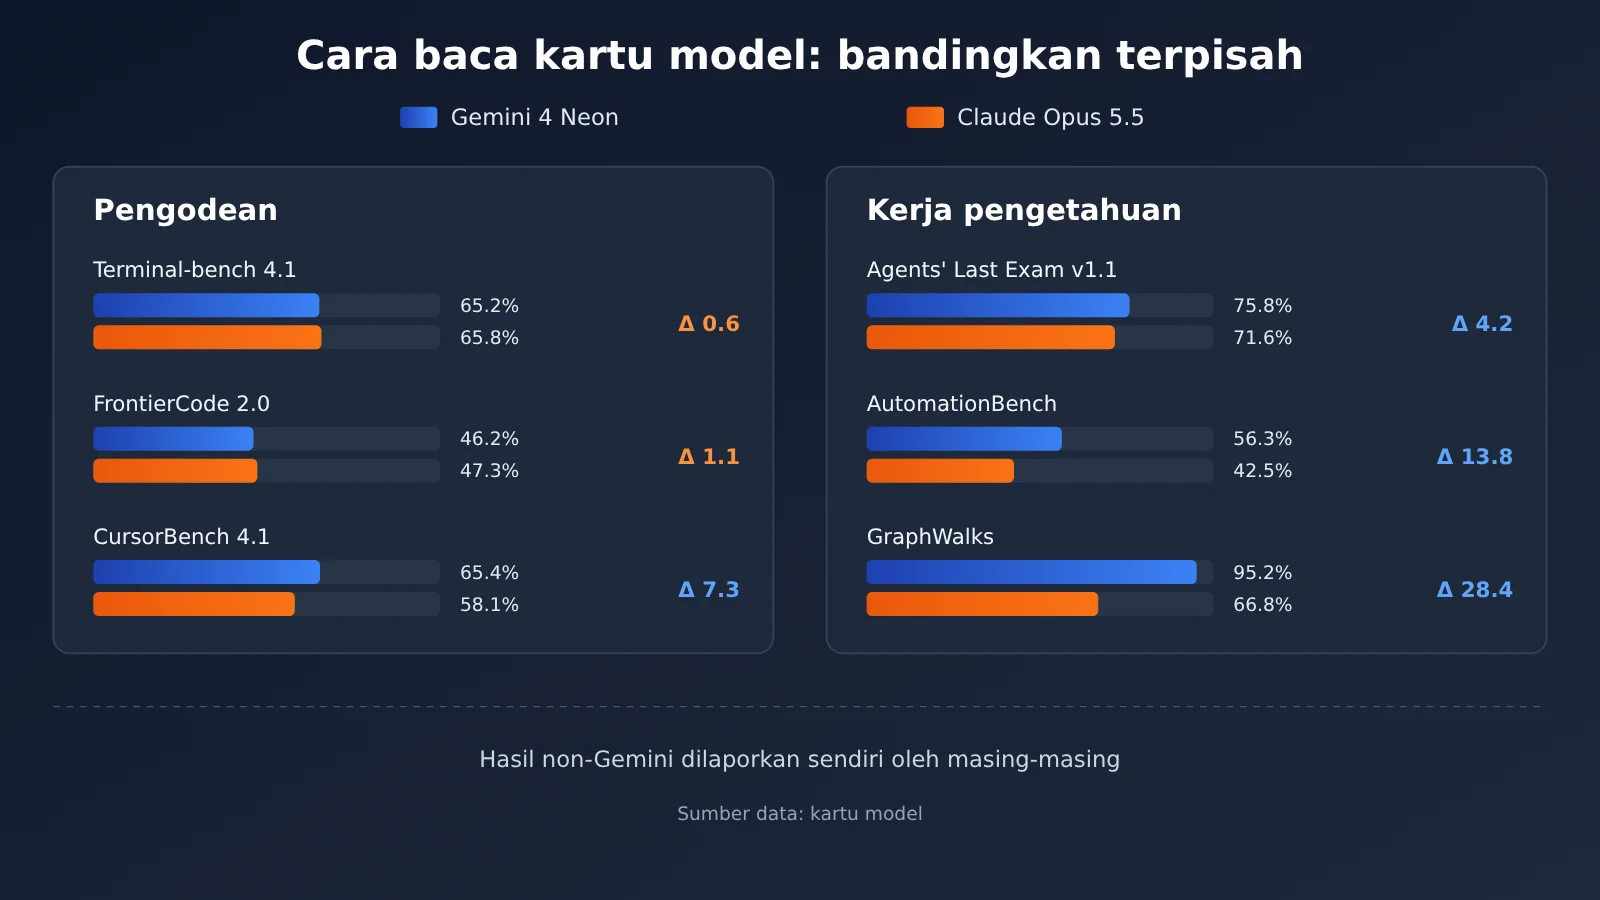
Tabel perbandingan kartu model DeepMind hanya memiliki tiga kolom, yaitu Gemini 4 Neon, Claude Opus 5.5, dan GPT-6.2 Sol. Artikel ini hanya membahas dua kolom pertama. PDF keterangan evaluasi menyatakan bahwa hasil non-Gemini secara default berasal dari laporan masing-masing penyedia. Jadi tabel ini adalah ringkasan resmi; setiap kolom bukan hasil pengujian ulang oleh laboratorium yang sama pada hari yang sama, sehingga saat membacanya, setiap sel harus dipandang sebagai pernyataan publik.
Subbagian coding Gemini 4 Neon dan Claude Opus 5.5
Berikut adalah baris-baris dalam kartu model yang terkait dengan coding dan pemrograman aman.
| Subbagian (kartu model) | Gemini 4 Neon | Claude Opus 5.5 | Yang lebih tinggi |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | Neon |
| Terminal-bench 4.1 (akurasi setelah penyesuaian kecurangan) | 65.2% | 65.8% | Opus |
| FrontierCode 2.0 | 46.2% (default high) | 47.3% | Opus |
| SWE-sweep harness vendor | 39.0% | 10.1% | Neon |
| SWE-sweep harness mini-SWE | 12.8% | 3.6% | Neon |
| CWE-Bench v2 | 70.7% | 67.1% | Neon |
| WebExploitBench v1.2 | 51.3% | 37.1% | Neon |
Ada tiga hal yang perlu diperhatikan saat membaca tabel ini.
- Dua subbagian yang lebih tinggi pada Opus termasuk coding lini utama. Terminal-bench 4.1 dan FrontierCode 2.0 sama-sama mengukur operasi terminal dan tugas kode, dengan selisih masing-masing 0.6 dan 1.1 poin persentase. Skor FrontierCode Neon ditandai sebagai tingkat default high.
- Dua baris SWE-sweep menggunakan dua jenis harness. Neon di Google Antigravity adalah 39.0%, sedangkan di harness mini-SWE adalah 12.8%. Blog Google mengaitkan selisih ini dengan kemampuan harness yang terbuka, jadi jangan diartikan bahwa model itu sendiri berbeda tiga kali lipat. Saat membandingkan kedua model, bandingkan dalam harness yang sama, yaitu 39.0% vs 10.1%, atau 12.8% vs 3.6%.
- Angka yang sama ditulis berbeda di sumber yang berbeda. WebExploitBench di kartu model adalah 51.3%, sedangkan di blog Google adalah 51.26%. Kedua penulisan dipertahankan apa adanya, tanpa memilih salah satu.
Subkategori Pengetahuan dan Sains Gemini 4 Neon vs Claude Opus 5.5
Subkategori untuk pekerjaan pengetahuan, penalaran sains, dan konteks panjang lebih banyak; di bagian ini Neon unggul di sebagian besar metrik.
| Subkategori (kartu model) | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| AA Index v5.0.1 | 61 | 59 |
| Vals Index v2.2 | 70,9% | 70,1% |
| AutomationBench | 56,3% | 42,5% |
| Agents’ Last Exam v1.1 | 75,8% | 71,6% |
| RiemannBench | 84,0% | 80,0% |
| Terminal-Bench-Science 0.1 | 70,5% | 63,3% |
| HLE-Diamond | 71,3% | 67,9% |
| MKA Climb WSR | 56,5% | 53,0% |
| Chartography | 73,5% | 66,3% |
| LVBench | 89,0% | 83,7% |
| GraphWalks (256k hingga 1M, F1 BFS) | 95,2% | 66,8% |
Besar selisih tiap baris berbeda-beda. Vals Index hanya berbeda 0,8 poin persentase, sedangkan GraphWalks berbeda 28,4 poin persentase; metrik terakhir mengukur penelusuran graf pada konteks sangat panjang dari 256k hingga 1M token. Jika pekerjaan pengetahuan Anda berfokus pada pencarian dan penalaran di dokumen panjang, baris GraphWalks sebaiknya menjadi perhatian utama. Jika yang Anda jalankan adalah otomatisasi bisnis, AutomationBench dengan 56,3% versus 42,5% lebih mendekati skenario penggunaan Anda.
Blog Google juga mencantumkan sejumlah peringkat dalam bentuk laporan resmi mereka sendiri, misalnya peringkat ke-1 pada Legal Research Bench dan Tax Agent Bench, serta sebagian besar peringkat ke-1 pada Surge untuk bidang keuangan, akuntansi, dan pemodelan spreadsheet. Blog tersebut tidak memberikan persentase untuk metrik-metrik ini dan juga tidak mencantumkan angka padanan dari Opus, jadi peringkat tersebut tidak bisa langsung dimasukkan ke tabel perbandingan kedua model.
Gemini 4 Neon vs Claude Opus 5.5: Cara Membaca Empat Angka Artificial Analysis
Artificial Analysis adalah pengukuran pihak ketiga dan berada di sistem yang berbeda dari model card. Halaman modelnya mencantumkan skor kecerdasan, biaya per tugas, waktu, dan kecepatan output untuk setiap tingkat berpikir. Perbandingan utama di bagian ini adalah Neon xhigh vs Opus max—keduanya adalah level tertinggi masing-masing di halaman model mereka, tetapi kedua level tersebut tidak setara.
| Metrik (halaman model Artificial Analysis, v5.0.1) | Gemini 4 Neon (xhigh) | Claude Opus 5.5 (max) |
|---|---|---|
| Skor kecerdasan | 61 | 59 |
| Biaya per tugas | 6.44 dolar AS | 10.04 dolar AS |
| Waktu per tugas | 21.5 menit | 24.5 menit |
| Kecepatan output | 110 token/detik | 118 token/detik |
| Waktu ke token jawaban pertama | 56.51 detik | 335.85 detik |
| Token output saat menjalankan indeks | 283 juta | 218 juta |
| Harga katalog (input / output) | 3.00 / 15.00 dolar AS | 4.00 / 20.00 dolar AS |
| Harga campuran | 2.21 dolar AS | 2.94 dolar AS |
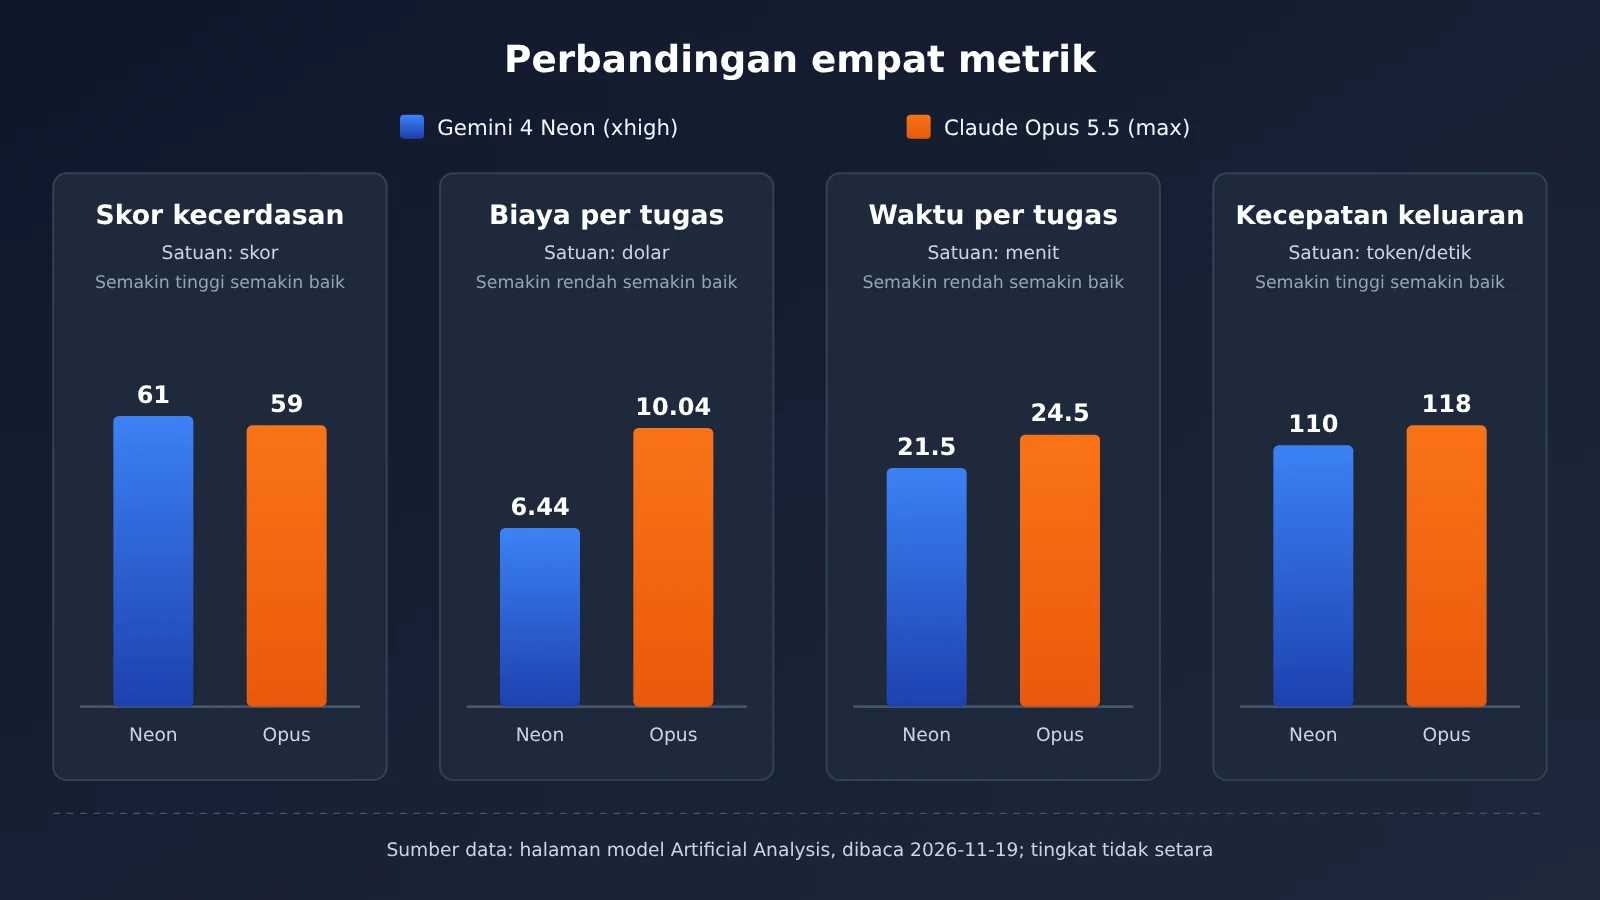
📊 Keterangan grafik: Angka pada grafik di atas berasal dari halaman model Artificial Analysis dan mencerminkan perhitungan biaya saat pihak ketiga menjalankan indeks. Saat memanggil Claude Opus 5.5 di APIYI apiyi.com, acuannya adalah daftar model dan harga yang tertera di platform.
Biaya per tugas: hitungan di papan peringkat
Biaya per tugas sebesar 6.44 dolar versus 10.04 dolar adalah biaya yang dihitung Artificial Analysis setelah menjalankan indeksnya; ini merupakan hitungan di papan peringkat, bukan tagihan Anda di APIYI. Angka ini bergantung pada harga satuan dan jumlah pemakaian. Menurut data halaman model, Neon menghasilkan 283 juta token saat menjalankan indeks, lebih banyak daripada 218 juta token Opus, tetapi harga satuannya 3/15 dolar, sedangkan Opus 4/20 dolar. Biaya aktual Anda bergantung pada panjang input, panjang output, dan tingkat cache hit tugas Anda.
Durasi, kecepatan output, dan waktu token pertama
Kecepatan output Opus lebih tinggi, 118 versus 110 token/detik. Namun durasi per tugas Neon lebih pendek, 21.5 versus 24.5 menit. Kedua angka tidak bertentangan karena durasi juga mencakup waktu tunggu token pertama dan total output. Menurut halaman model, token jawaban pertama Opus max adalah 335.85 detik, sedangkan Neon xhigh 56.51 detik. Untuk skenario interaktif, waktu token pertama lebih memengaruhi pengalaman dibandingkan throughput.
Perbandingan Tingkat Setara dan Skor Coding
Jika tingkatnya diturunkan, angka di halaman model juga akan berubah. Neon high memperoleh 60 poin, 14.8 menit, dan 101 token/detik; Opus xhigh 57 poin, 16.1 menit, dan 107 token/detik; Opus high 52 poin, 9.3 menit, dan 108 token/detik. Waktu token pertama untuk tiga tingkat Neon—high, medium, dan low—masing-masing 40.64 detik, 20.14 detik, dan 13.93 detik. Angka-angka ini berasal dari FAQ halaman model dan tidak berada di kolom yang sama dengan tabel ringkasan di atas.
Untuk coding, artikel Artificial Analysis memberikan Coding Agent Index: Neon xhigh di Antigravity CLI adalah 59, Opus 5.5 max di Claude Code adalah 58; keduanya berjalan di CLI yang berbeda. Blog Google menulis 58.6, yang merupakan angka laporan resmi dan berbeda dari 59 dalam artikel. Artikel yang sama juga memberikan biaya coding per tugas: Neon 6.86 dolar AS, Opus 5.5 max 12.61 dolar AS.
Rekomendasi Skenario untuk Gemini 4 Neon dan Claude Opus 5.5
Berikut adalah penilaian berdasarkan angka di atas. Ini merupakan rekomendasi, bukan fakta. Silakan verifikasi dengan sampel tugas Anda sendiri.
Skenario yang Cenderung Cocok untuk Gemini 4 Neon
- Audio dan video sebagai input langsung: Menurut kartu model, Neon mendukung audio dan video, sedangkan input Opus adalah teks dan gambar.
- Penalaran retrieval dengan konteks sangat panjang: GraphWalks 95.2% vs 66.8%; jendela terpadu Neon mencapai 1048576 token (Panduan Pengembang Google Cloud).
- Agen untuk otomatisasi bisnis dan pekerjaan pengetahuan: AutomationBench 56.3% vs 42.5%, Agents’ Last Exam v1.1 75.8% vs 71.6% (kartu model).
- Interaksi yang sensitif terhadap waktu tunggu token pertama: Menurut halaman model Artificial Analysis, waktu token pertama Neon xhigh adalah 56.51 detik, sedangkan Opus max 335.85 detik.
Skenario yang Cenderung Tetap Menggunakan Claude Opus 5.5
- Coding untuk operasi terminal: Terminal-bench 4.1 adalah 65.8% vs 65.2% (kartu model).
- Tugas kode seperti FrontierCode: 47.3% vs 46.2% (kartu model; Neon menggunakan high sebagai default).
- Throughput untuk output panjang: Kecepatan output 118 vs 110 token/detik (halaman model Artificial Analysis).
- Alur kerja yang sudah sangat terikat pada Claude Code atau endpoint messages: Biaya migrasi itu sendiri juga harus diperhitungkan.
Cara memanggil Claude Opus 5.5 di APIYI dan memeriksa status Gemini 4 Neon
Model dan harga Claude Opus 5.5 di APIYI
Pembaca yang sudah memakai Opus bisa memeriksa model dan harga dengan Key yang sama di APIYI (apiyi.com). Waktu pembaruan yang tercantum pada tabel utama APIYI docs.apiyi.com/models.md adalah 2026-11-16 09:39 (UTC+8). Antarmuka harga api.apiyi.com/api/pricing dibaca pada 2026-11-19, versinya shell-api-modelmak-v1, dengan total 285 model.
| ID Model | Input / baca cache / output (USD per juta token) | Endpoint | Grup (tabel utama APIYI) | ID grup (antarmuka harga) |
|---|---|---|---|---|
claude-opus-5-5 |
4 / 0.2 / 20 | chat, messages | ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
claude-opus-5-5-thinking |
4 / 0.2 / 20 | chat, messages | Sama seperti di atas | Sama seperti di atas |
gemini-4-neon |
Belum tersedia | — | — | — |
Kedua kumpulan nama grup tidak sepenuhnya sama, jadi keduanya tetap dicantumkan di tabel. Pada antarmuka harga, model_ratio bernilai 1 berarti input 2 USD per juta token, sedangkan completion_ratio bernilai 5 berarti harga output adalah 5 kali harga input; ini konsisten dengan penulisan tier pertama di tabel utama, jadi Anda bisa memakai aturan ini untuk memverifikasi sendiri harga pada tabel di atas.
gemini-4-neon tidak ada di tabel utama APIYI maupun di antarmuka harga, dan tidak ada halaman model khusus untuknya. Model ini belum tersedia; kami akan segera merilisnya, dan model serta harga mengikuti daftar model di platform. Sebagai referensi, halaman harga Google AI Studio mencantumkan harga berbayar Neon: input 3.00 USD, output 15.00 USD (termasuk token berpikir), cache 0.15 USD, dihitung per juta token, tanpa tier gratis, dan hanya mendukung cache implisit.
Langkah pemanggilan
- Simpan kunci ke variabel lingkungan, misalnya
APIYI_API_KEY; kode hanya membaca variabel lingkungan dan tidak menuliskan teks terbuka. - Jika memakai klien yang kompatibel dengan OpenAI, setel base_url ke
https://api.apiyi.com/v1. - Isi bidang
modeldenganclaude-opus-5-5atauclaude-opus-5-5-thinking; pilih endpoint chat atau messages sesuai kebutuhan. - Pilih grup sesuai kebutuhan bisnis. Nama grup mengikuti penulisan pada tabel utama dan antarmuka harga.
- Saat melakukan uji banding setelah Neon tersedia, perhatikan: panduan pengembang Google Cloud menyatakan tingkat berpikirnya hanya low, medium, high, xhigh, dengan default high. Mengirim
thinking_budgetatauMINIMALakan mengembalikan HTTP400. Model ini tidak mendukung cache konteks eksplisit; cache implisit otomatis berlaku untuk prefiks bersama di atas 4096 token.
🚀 Mulai cepat: jalankan dulu baseline dengan belasan tugas nyata Anda di Opus, catat token output dan waktu tempuh. Setelah Neon tersedia di APIYI apiyi.com, lakukan perbandingan dengan sampel yang sama dan tingkat berpikir yang sama, sehingga hasilnya adalah hitungan untuk bisnis Anda sendiri.
Rekomendasi Keputusan Gemini 4 Neon vs Claude Opus 5.5
💡 Saran pemilihan: Jika pekerjaan Anda mayoritas berupa tugas terminal dan kode, selisih yang ditunjukkan kartu model dan Artificial Analysis sangat kecil. Opus sedikit lebih tinggi pada Terminal-bench 4.1 dan FrontierCode 2.0, jadi tidak ada alasan jelas untuk beralih. Jika pekerjaan Anda lebih condong ke perapian pengetahuan, konteks panjang, dan input multimodal, sebagian besar subskor di kartu model lebih tinggi untuk Neon, sehingga layak diuji banding secepatnya setelah tersedia. Ini penilaian, bukan fakta.
Soal biaya, jangan langsung memakai angka 6,44 dan 10,04 dolar dari Artificial Analysis sebagai patokan anggaran. Jangan pula menerapkan kalimat di blog Google, “biaya default high per tugas 32% lebih rendah daripada Carbon”, pada Opus. Itu algoritme Google sendiri, dan objek pembandingnya juga bukan Opus.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa posisi Gemini 4 Neon?
Menurut blog Google (laporan resmi sendiri) dan panduan developer Google Cloud, Neon berada di antara Hydrogen (eksekusi cepat untuk penggunaan sehari-hari) dan Carbon (tugas kompleks berdurasi panjang), ditujukan untuk alur kerja kompleks dengan frekuensi tinggi. Kartu model menyatakan bahwa model ini diadaptasi dari Gemini 4 Carbon, dengan pengetahuan yang berakhir pada Maret 2026.
Q2: Antara Gemini 4 Neon dan Claude Opus 5.5, siapa yang angkanya lebih tinggi dalam coding?
Harus dilihat per item. Dalam kartu model, Opus lebih tinggi pada Terminal-bench 4.1 (65.8% vs 65.2%) dan FrontierCode 2.0 (47.3% vs 46.2%), sedangkan Neon lebih tinggi pada CursorBench 4.1 dan SWE-sweep. Coding Agent Index dalam artikel Artificial Analysis adalah 59 vs 58, tetapi keduanya dijalankan di CLI yang berbeda.
Q3: Apakah skor kecerdasan 61 vs 59 dibandingkan pada tingkat yang sama?
Bukan. Ini adalah Neon xhigh vs Opus max, masing-masing diambil dari tingkat tertinggi pada halaman model. Jika membandingkan Neon high (60) dan Opus xhigh (57), selisihnya akan berubah. Skor kecerdasan 61 konsisten di blog Google, kartu model, dan Artificial Analysis.
Q4: Apakah biaya per tugas 6.44 dolar vs 10.04 dolar bisa dianggap sebagai tagihan saya?
Tidak bisa. Ini adalah catatan papan peringkat saat Artificial Analysis menjalankan indeks, yang bergantung pada set tugas dan jumlah token output-nya. Tagihan sebenarnya dihitung berdasarkan input, output, dan penggunaan cache Anda sendiri, serta harga yang tertera di platform. Di APIYI apiyi.com, harga Opus adalah input 4 dolar, baca cache 0.2 dolar, output 20 dolar (per juta token).
Q5: Apakah Gemini 4 Neon sekarang bisa dipanggil di APIYI?
Tabel utama APIYI (diperbarui 2026-11-16) dan antarmuka harga (dibaca 2026-11-19) tidak memuat `gemini-4-neon`. Belum tersedia, kami akan segera menghadirkan model ini; model dan harga mengikuti daftar model di platform. Saat ini Anda bisa menjalankan sampel baseline dengan `claude-opus-5-5` di apiyi.com untuk persiapan perbandingan nanti.
Q6: Mengapa kecepatan output Opus lebih cepat, tetapi waktu per tugasnya lebih lama?
Waktu proses mencakup penantian token pertama. Menurut halaman model Artificial Analysis, token jawaban pertama Opus max adalah 335.85 detik, sedangkan Neon xhigh 56.51 detik. Kecepatan output hanya mencerminkan throughput setelah mulai mengeluarkan output.
Q7: Apa saja keterbatasan perbandingan ini?
Hasil non-Gemini dalam kartu model secara default berasal dari laporan masing-masing pihak. Coding Agent Index memiliki dua versi, 58.6 dan 59, MKA memiliki dua versi, 56.5% dan 56%, dan artikel ini mempertahankannya apa adanya. Angka 12.8% dan 39.0% pada SWE-sweep berasal dari dua harness. Peringkat dan angka keamanan dalam blog Google adalah laporan resmi sendiri, bukan hasil pengujian ulang pihak ketiga.
Poin Penting Gemini 4 Neon dan Claude Opus 5.5
- Angka masing-masing unggul di sisi berbeda: Neon lebih tinggi pada sebagian besar sub-skor di kartu model dan skor inteligensi, sedangkan Opus lebih tinggi pada dua skor coding serta kecepatan output.
- Kartu model adalah rangkuman resmi: hasil untuk model non-Gemini merupakan laporan masing-masing vendor, bukan pengujian ulang pada hari yang sama.
- Tingkat pengaturan harus ditulis jelas: perbandingan skor inteligensi adalah Neon xhigh versus Opus max.
- Biaya per tugas adalah angka di papan peringkat: 6.44 versus 10.04 dolar, tidak sama dengan tagihan platform.
- Modalitasnya berbeda: Neon dapat menerima input audio dan video, sedangkan Opus hanya teks dan gambar.
- Cara memulai: Opus sudah tersedia di APIYI, Neon belum tersedia, jadi patokan adalah daftar model di platform.
Ringkasan
Perbandingan Gemini 4 Neon dan Claude Opus 5.5 perlu dilihat secara terpisah antara jalur coding dan jalur kerja pengetahuan:
- Jalur coding: Opus sedikit lebih tinggi pada Terminal-bench 4.1 dan FrontierCode 2.0, sementara Neon lebih tinggi pada CursorBench 4.1 dan SWE-sweep dengan harness yang sama.
- Jalur kerja pengetahuan: sebagian besar sub-skor di kartu model lebih tinggi untuk Neon, dengan selisih paling jelas terlihat di GraphWalks dan AutomationBench.
- Empat angka Artificial Analysis: skor inteligensi 61 versus 59, biaya per tugas 6.44 versus 10.04 dolar, waktu 21.5 versus 24.5 menit, kecepatan output 110 versus 118 token/detik, dengan tingkat pengaturan Neon xhigh versus Opus max.
Disarankan untuk lebih dulu membangun baseline Opus menggunakan sampel tugas Anda sendiri, lalu setelah Neon tersedia lakukan perbandingan pada tingkat pengaturan yang sama. Anda dapat melihat harga dan pengelompokan claude-opus-5-5 serta claude-opus-5-5-thinking di APIYI apiyi.com, dan menggunakan kunci yang sama untuk melakukan pemanggilan maupun beralih model di kemudian hari.
📚 Referensi
-
Postingan Sundar Pichai: Saluran peluncuran Gemini 4 Neon
- Tautan:
x.com/sundarpichai/status/2123167780988125621 - Keterangan: Cakupan rilis yang dilaporkan sendiri oleh pihak resmi
- Tautan:
-
Blog Google “Introducing Gemini 4 Neon”: Angka benchmark, harga, dan keamanan yang dilaporkan sendiri oleh pihak resmi
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Keterangan: Coding Agent Index 58.6, penjelasan harness SWE-sweep
- Tautan:
-
Kartu Model DeepMind: Tabel perbandingan tiga kolom dan penjelasan evaluasi
- Tautan:
deepmind.google/models/model-cards/gemini-4-neon/ - Keterangan: Hasil non-Gemini secara default berasal dari laporan masing-masing pihak
- Tautan:
-
Panduan Pengembang Google Cloud: ID model, tingkat pemikiran, dan aturan cache
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Keterangan: Kondisi pemicu HTTP 400
- Tautan:
-
Halaman Harga Google AI Studio: Harga berbayar Neon
- Tautan:
aistudio.google.com/docs/pricing - Keterangan: Tidak ada tier gratis, hanya mendukung cache implisit
- Tautan:
-
Artikel Artificial Analysis: Skor kecerdasan Neon dan biaya per tugas coding
- Tautan:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Keterangan: Pengukuran pihak ketiga, Coding Agent Index 59
- Tautan:
-
Halaman Model Artificial Analysis: Data tier Neon dan Opus 5.5
- Tautan:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/claude-opus-5-5 - Keterangan: Dibaca pada 2026-11-19, indeks v5.0.1
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui beranda situs APIYI, model dan harga dapat dicek di pusat dokumentasi docs.apiyi.com