Catatan penulis: Artikel ini menyusun secara terpisah skor komposit pihak ketiga, harga daftar resmi, harga pembacaan cache, dan ketersediaan di APIYI untuk GPT-6.2 Sol dan Claude Opus 5.5, supaya kamu bisa memilih model berdasarkan tugas, bukan berdasarkan satu skor total saja.
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 2026-11-17. Banyak tim yang saat ini sudah memakai Claude Opus 5.5 kini harus memutuskan apakah akan beralih. Artikel ini membandingkan GPT-6.2 Sol dan Claude Opus 5.5, lalu memberikan rekomendasi dari beberapa aspek: skor komposit, harga daftar, pembacaan cache, protokol, dan ketersediaan pemanggilan saat ini.
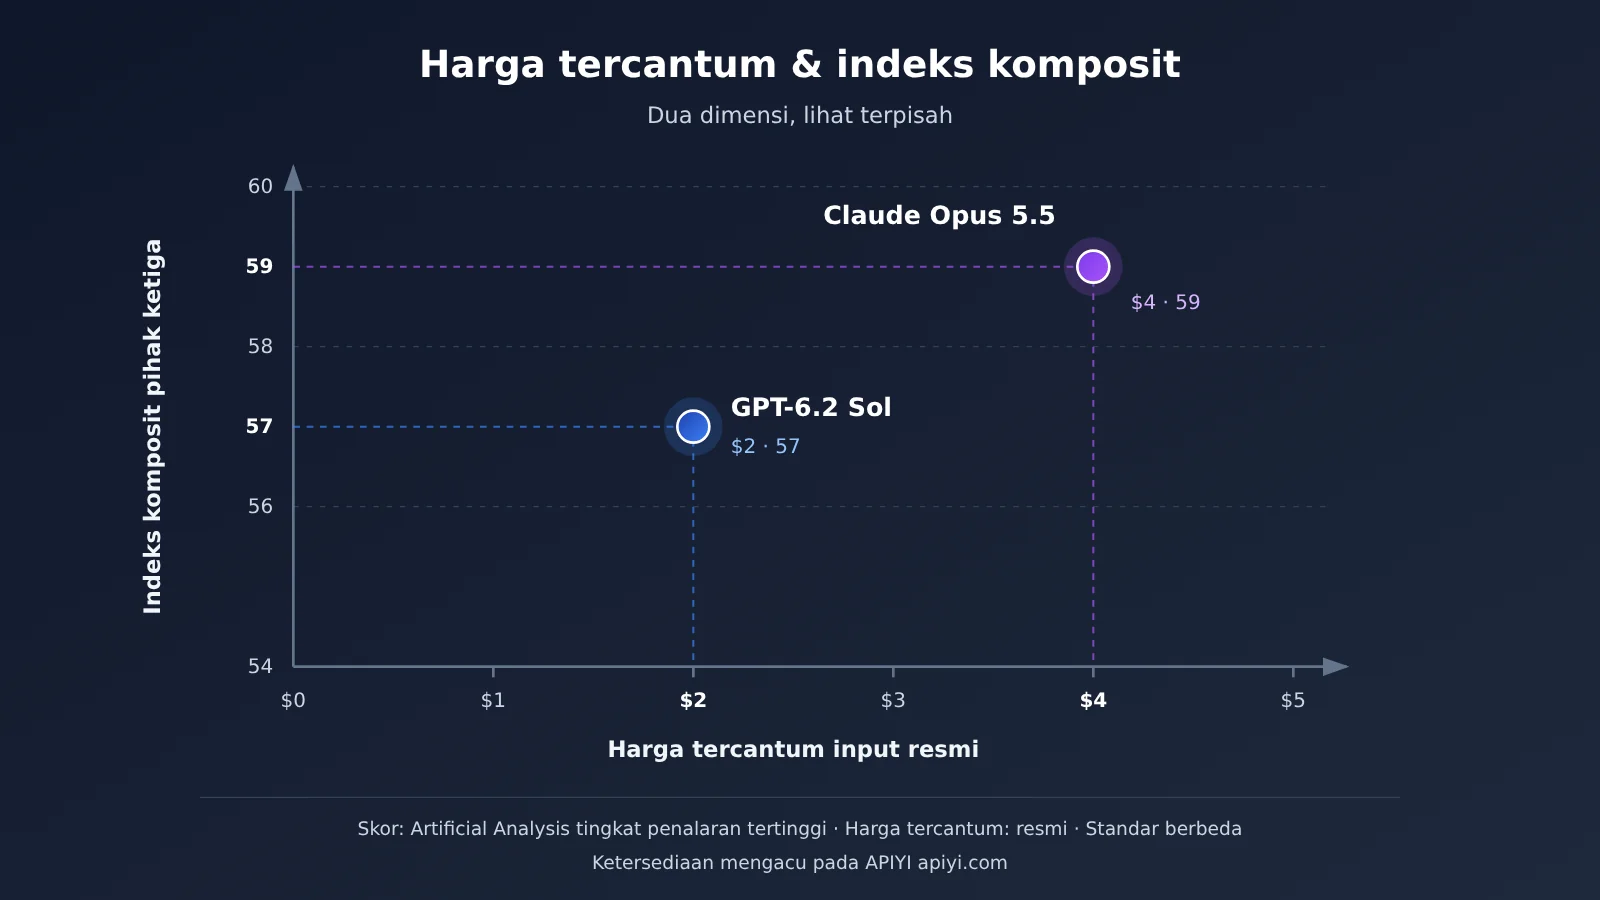
Ini bukan artikel yang hendak mengumumkan siapa yang lebih kuat atau lebih murah. Dalam indeks komposit pihak ketiga, tier tertinggi Sol berada 2 poin di bawah tier tertinggi Opus. Berdasarkan harga daftar resmi untuk konteks pendek, harga satuan input, output, dan pembacaan cache Sol semuanya sekitar setengah dari milik Opus. Kedua fakta ini harus dibaca bersama-sama; mengambil salah satunya saja sebagai dasar keputusan itu tidak lengkap.
Nilai utama: Setelah membaca artikel ini, kamu akan tahu berapa skor komposit, harga daftar, dan pembacaan cache kedua model ini, angka mana yang dilaporkan resmi oleh vendor dan mana yang hasil pengujian pihak ketiga, serta model mana yang saat ini bisa dipanggil di APIYI.
Sekilas Perbedaan Inti GPT-6.2 Sol dan Claude Opus 5.5
Kami rangkum dulu lima kelompok informasi yang paling sering dibutuhkan saat memilih model ke dalam satu tabel. Setiap baris mencantumkan sumber angkanya, dan bagian-bagian berikutnya akan menguraikannya satu per satu.
| Dimensi perbandingan | GPT-6.2 Sol | Claude Opus 5.5 | Sumber angka |
|---|---|---|---|
| Indeks komposit pihak ketiga (tingkat penalaran tertinggi) | 57 (tingkat Max) | 59 (tingkat tertinggi) | Artificial Analysis, pihak ketiga |
| Harga input / output konteks pendek | $2 / $10 | $4 / $20 | Harga resmi masing-masing, per 1 juta token |
| Harga pembacaan cache | $0.10 | $0.20 | Halaman model OpenAI; harga Opus dikutip ulang dari daftar harga Anthropic |
| Konteks / output maksimum | 1.050.000 / 128.000 | 1M / 128K | Halaman model resmi dan dokumentasi |
| Status saat ini di APIYI | Belum tersedia | Sudah tersedia, claude-opus-5-5 |
Tabel master model dan endpoint harga APIYI |
Mengapa skor komposit 2 poin lebih rendah dan harga sekitar separuh harus dilihat bersama
Kalau hanya melihat skor komposit, kamu akan menyimpulkan “Opus lebih unggul”. Kalau hanya melihat harga, kamu akan menyimpulkan “harga satuan Sol lebih murah”. Kedua kesimpulan itu memang tidak salah, tapi keduanya baru menceritakan separuh cerita. Skor komposit mencerminkan rata-rata performa pada satu rangkaian tugas campuran, sedangkan harga mencerminkan tarif per 1 juta token — padahal tagihan aslimu juga bergantung pada seberapa banyak token yang dikonsumsi setiap tugas.
Selain itu, selisih 2 poin tersebut berasal dari pengujian Artificial Analysis pada tingkat penalaran tertinggi. Kalau bisnismu memakai intensitas penalaran bawaan, atau jenis tugasmu sangat berbeda dari rangkaian indeks ini, selisih 2 poin itu belum tentu bisa langsung diterapkan. Karena itu, pendekatan artikel ini adalah: paparkan dulu angka-angkanya dengan jelas, lalu pilih model berdasarkan jenis tugas.
Perbandingan Harga Terdaftar dan Cache Read: GPT-6.2 Sol vs Claude Opus 5.5
Harga adalah bagian yang paling sering disalahpahami dalam pemilihan model kali ini. Tabel di bawah memisahkan harga resmi dari harga tercantum di platform APIYI; semua angka dihitung per 1 juta token, dengan default pada tingkat standar konteks pendek.
| Komponen Harga | Harga Resmi GPT-6.2 Sol | Harga Resmi Claude Opus 5.5 | Claude Opus 5.5 di APIYI | GPT-6.2 Sol di APIYI |
|---|---|---|---|---|
| Input | $2 | $4 | $4 | Belum tersedia |
| Output | $10 | $20 | $20 | Belum tersedia |
| Cache Read | $0.10 | $0.20 | $0.2 | Belum tersedia |
| Cache Write | $2.50 untuk 30 menit; $5 untuk 12 jam | $5 untuk 5 menit; $8 untuk 1 jam (dikutip dari daftar harga) | Sesuai daftar di platform | Belum tersedia |
| Aturan Input Sangat Panjang | Ada biaya tambahan untuk seluruh pesanan jika melebihi 272K | Tidak tercakup di sumber referensi | Sesuai daftar di platform | Belum tersedia |
Harga resmi konteks pendek GPT-6.2 Sol adalah $2 untuk input, $10 untuk output, dan $0.10 untuk cache read. Menurut pengumuman peluncurannya, harga API token-nya mengikuti GPT-6.1 Sol. Di APIYI, GPT-6.2 Sol belum tersedia, dan kami akan segera menambahkannya ke daftar model; nama model dan harga mengacu pada daftar model di platform.
Harga resmi Claude Opus 5.5 adalah $4 untuk input dan $20 untuk output. Harga cache read $0.20 dan harga cache write ($5 untuk 5 menit, $8 untuk 1 jam) dikutip dari daftar harga Anthropic — untuk cache write, harap merujuk ke halaman resmi Anthropic. Dalam tabel lengkap model APIYI (data per 2026-11-17 15:54, UTC+8), claude-opus-5-5 dan claude-opus-5-5-thinking keduanya sudah tersedia, dengan harga tercantum di platform $4 / $20 / $0.2. Kamu bisa langsung memverifikasi poin-poin ini di daftar model APIYI di apiyi.com.
Perlu diperhatikan secara khusus: gpt-6.1-sol ($2 / $10 / $0.1) dan gpt-6-sol ($2 / $10 / $0.2) yang saat ini terlihat di tabel lengkap APIYI bukanlah versi 6.2. Harga mereka tidak bisa dijadikan sebagai harga platform GPT-6.2 Sol, dan juga tidak mewakili kemampuan versi 6.2.
Aturan Penagihan Seluruh Permintaan 272K pada GPT-6.2 Sol
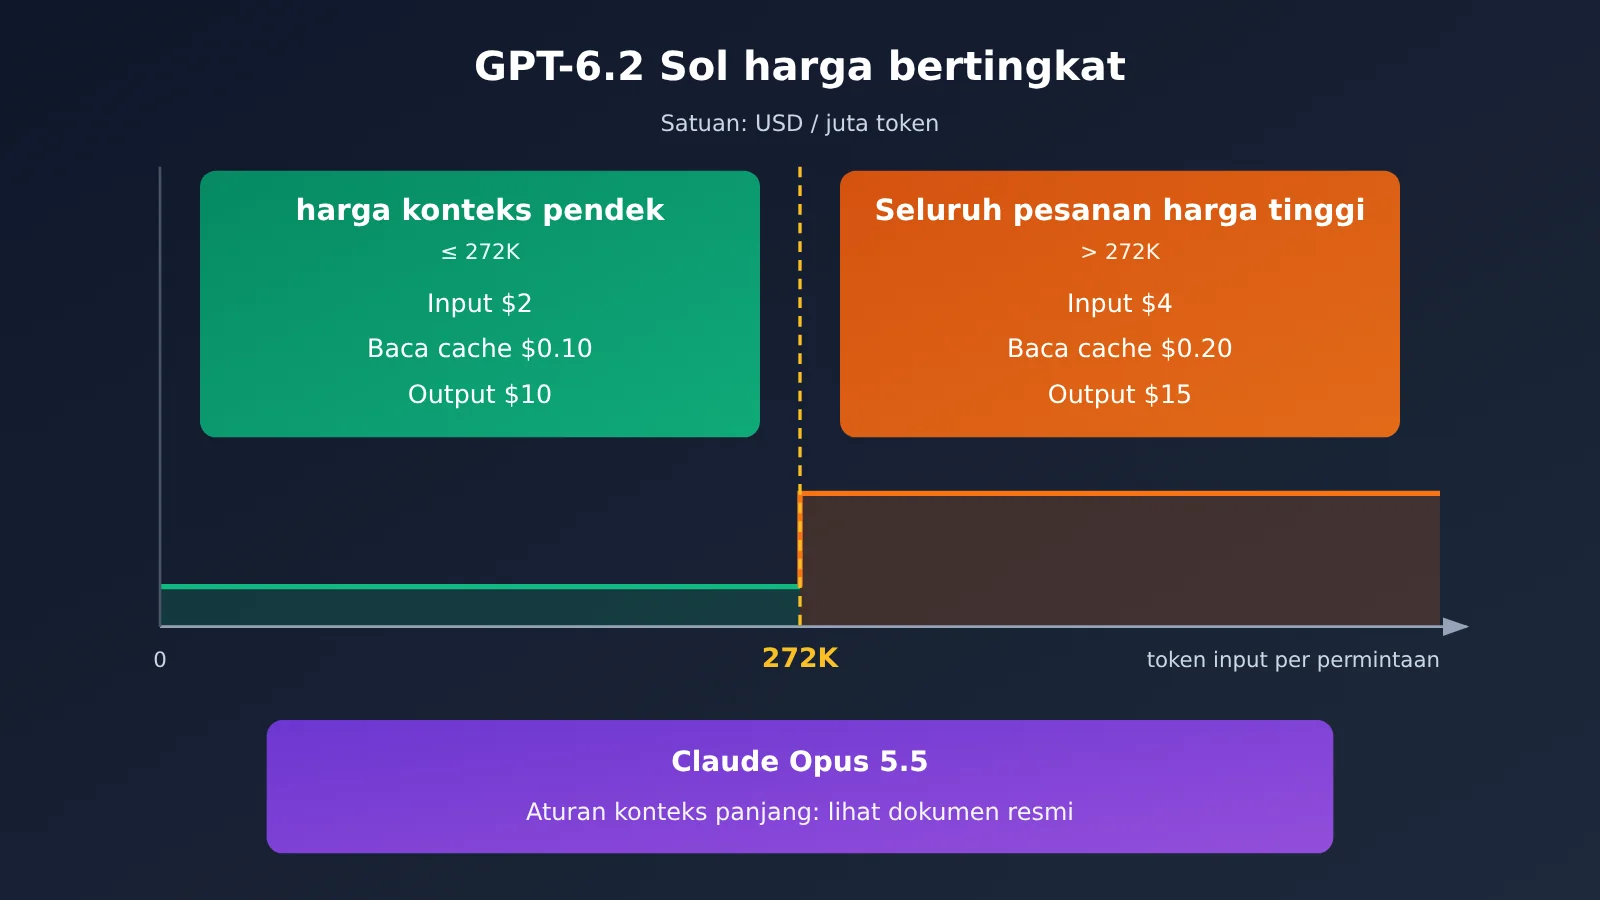
Halaman model OpenAI menjelaskan dengan jelas: ketika input satu permintaan melebihi 272K token, harga satuan input dan cache digandakan, output dihitung 1,5 kali harga konteks pendek, dan yang lebih penting, seluruh permintaan ditagih dengan harga baru — bukan hanya bagian yang melebihi batas yang kena tambahan. Kalau dikonversi ke Sol, artinya input $4, baca cache $0.20, dan output $15.
Aturan ini berdampak besar untuk tugas dokumen panjang. Kalau permintaan tipikal kamu sering berada di kisaran 272K, keunggulan harga tercantum yang “sekitar setengah” akan menyusut secara signifikan. Apakah Opus 5.5 punya aturan konteks panjang serupa, materi referensi artikel ini tidak mencakupnya — sebaiknya cek langsung dokumentasi Anthropic dulu sebelum membandingkan.
Selain itu, Batch milik Sol dihargai 50% dari harga standar, sedangkan Fast dihargai 2 kali harga standar untuk panjang konteks yang sama. Ultrafast dihargai 3 kali harga standar hingga 2027-02-28 (waktu Pasifik), lalu naik menjadi 6 kali harga standar mulai 2027-03-01.
Ilustrasi Permintaan Tunggal Berdasarkan Harga Tercantum
Biar lebih mudah dibayangkan, berikut ini perhitungan matematis murni berdasarkan harga resmi — bukan representasi tagihan nyata dalam bentuk apa pun. Misalkan satu permintaan berisi input 100 ribu token, output 10 ribu token, dan tidak memakai cache: Sol sekitar $0.20 + $0.10 = $0.30, sedangkan Opus sekitar $0.40 + $0.20 = $0.60.
Ilustrasi ini mengandalkan dua asumsi: kedua model menghabiskan jumlah token yang sama untuk tugas yang sama, dan permintaan tidak melebihi 272K. Dalam penggunaan nyata, konsumsi token penalaran bisa berbeda-beda tergantung model, intensitas penalaran, dan jenis tugasnya, jadi biaya sebenarnya harus dihitung ulang dengan menjalankan tugas kamu sendiri terlebih dahulu.
Angka Kemampuan GPT-6.2 Sol dan Claude Opus 5.5: Dua Metodologi, Dibaca Terpisah
Angka kemampuan ini berasal dari dua sumber: satu dari evaluasi pihak ketiga oleh Artificial Analysis, dan satu lagi dari laporan resmi yang dibagikan sendiri oleh OpenAI di pengumuman rilis dan halaman modelnya. Kedua set memiliki tugas, tingkat penalaran, dan standar biaya yang berbeda, jadi di bawah ini keduanya dipisahkan dan tidak digabungkan menjadi satu kesimpulan.
Indeks Komprehensif Pihak Ketiga dari Artificial Analysis (Intelligence Index v5.0.1)
| Model dan Tingkat Penalaran | Indeks Komprehensif | Biaya per Tugas pada Indeks Komprehensif | Keterangan |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 57 | $1.01 | 2 poin lebih tinggi dari GPT-6.1 Sol |
| GPT-6.2 Sol (Xhigh) | 56 | Tidak dirinci | Pihak ketiga |
| GPT-6.2 Sol (High) | 55 | Tidak dirinci | Pihak ketiga |
| GPT-6.2 Sol (Medium) | 53 | Tidak dirinci | Pihak ketiga |
| GPT-6.2 Sol (Low) | 41 | Tidak dirinci | Pihak ketiga |
| Claude Opus 5.5 (tingkat tertinggi) | 59 | Tidak tercakup dalam sumber artikel ini | Dari artikel yang sama |
$1.01 milik Sol hanyalah biaya rata-rata untuk menyelesaikan satu tugas dalam indeks komprehensif ini, bukan harga satuan untuk semua tugas, dan tidak boleh dibagi langsung dengan angka biaya dari sumber lain. Biaya per tugas Opus 5.5 dalam indeks ini tidak dicantumkan di materi referensi, jadi artikel ini tidak melakukan perkiraan.
Artikel pihak ketiga yang sama juga memberikan beberapa hasil terperinci yang layak diperhatikan. Pada Coding Agent Index (Codex harness, Max), Sol berada 3 poin di bawah GPT-6.1 Sol, terutama karena subskor SWE-Atlas-QnA-AA turun 14 poin sehingga lebih mudah melewatkan fakta-fakta kunci. Tingkat halusinasi AA-Omniscience (Max) untuk Sol adalah 55%. Sementara pada pratinjau riset AA-Robotics v0.1, Sol berada di angka 78. Subskor-subskor ini tidak menyertakan angka pembanding untuk Opus 5.5, jadi hanya bisa digunakan untuk memahami kekuatan dan kelemahan Sol itu sendiri.
Data GPT-6.2 Sol yang Dilaporkan Resmi oleh OpenAI
Semua angka berikut berasal dari pengumuman rilis OpenAI dan termasuk laporan resmi, dengan objek perbandingan yang sebagian besar adalah model milik OpenAI sendiri, bukan Claude Opus 5.5:
- FrontierCode 2.0 (dibuat oleh Cognition, mengukur apakah perubahan pada codebase nyata dapat diterima dan di-merge oleh maintainer): Sol hanya selisih kurang dari 0,5 poin dengan GPT-6.2 Astra, dengan biaya sekitar seperlima; keduanya sama-sama menggunakan tingkat Max.
- LifeVal (kumpulan tugas sehari-hari yang dibangun sendiri oleh OpenAI): skor Sol lebih tinggi dari GPT-6 Astra, dengan biaya sekitar seperketujuh.
- GDPval v2 (evaluasi internal resmi): Sol 5,3 poin lebih tinggi dari GPT-6.1 Sol.
- Elo AA-3D hasil penilaian buta oleh manusia (dikutip dari pernyataan resmi): Sol mencapai 1259.
Mengapa Dua Set Angka Ini Tidak Bisa Digabung
Indeks komprehensif pihak ketiga dijalankan pada tingkat penalaran tertinggi dengan serangkaian tugas tetap, sedangkan laporan resmi OpenAI sebagian besar berupa pernyataan relatif seperti “berapa poin lebih tinggi dari generasi sebelumnya” atau “biayanya hanya sekian perbandingan”. Keduanya berbeda dalam benchmark, tingkat penalaran, dan metode perhitungan biaya. Menggabungkan “skor komprehensif yang 2 poin lebih rendah” dengan “mendekati Astra di salah satu uji resmi” tidak akan menghasilkan kesimpulan bahwa “Sol lebih kuat secara keseluruhan” atau “Opus lebih kuat secara keseluruhan”.
Cara membaca yang lebih praktis: skor komprehensif pihak ketiga memberi tahu Anda posisi kasar kedua model pada campuran tugas umum; sedangkan laporan resmi memberi tahu Anda di skenario mana Sol telah dioptimalkan secara khusus oleh OpenAI, misalnya tugas sehari-hari dan tugas penggabungan kode. Pada akhirnya, tetap jadikan performa pada tugas Anda sendiri sebagai acuan utama.
Perbedaan Spesifikasi dan Protokol GPT-6.2 Sol vs Claude Opus 5.5
Selain skor dan harga, cara integrasi justru sering menjadi faktor penentu apakah kamu bisa langsung berpindah atau tidak. Tabel berikut merangkum perbedaan spesifikasi dan endpoint dari kedua model.
| Item Spesifikasi | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Modality input | Teks, gambar (tidak mendukung audio, video) | Tidak dirinci terpisah di materi referensi |
| Jendela konteks | 1,050,000 (input maksimum 922,000) | 1M |
| Output maksimum | 128,000 | 128K |
| Batas pengetahuan | 2026-06-01 | 2026-06 |
| Intensitas reasoning | Mendukung reasoning token; API tidak menerima effort yang diatur ke none | effort default-nya medium |
| Endpoint resmi | Chat Completions, Responses, Batch | Anthropic Messages |
| Endpoint APIYI | Belum tersedia | chat, messages |
Kalau toolchain kamu bergantung pada protokol Messages milik Claude, misalnya Claude Code atau Agent yang dibangun dengan Anthropic SDK, Opus 5.5 di APIYI menyediakan dua endpoint sekaligus: chat dan messages, dengan grup yang mencakup ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, dan SVIP. Biaya migrasinya praktis hanya tinggal mengganti base URL dan Key.
GPT-6.2 Sol mengandalkan Chat Completions dan Responses milik OpenAI. Halaman model resminya menyatakan dengan jelas bahwa Realtime, Assistants, fine-tuning, pembuatan gambar, video, dan suara tidak didukung, jadi jangan berharap model ini bisa memenuhi kebutuhan-kebutuhan semacam itu.
Rekomendasi Skenario GPT-6.2 Sol dan Claude Opus 5.5
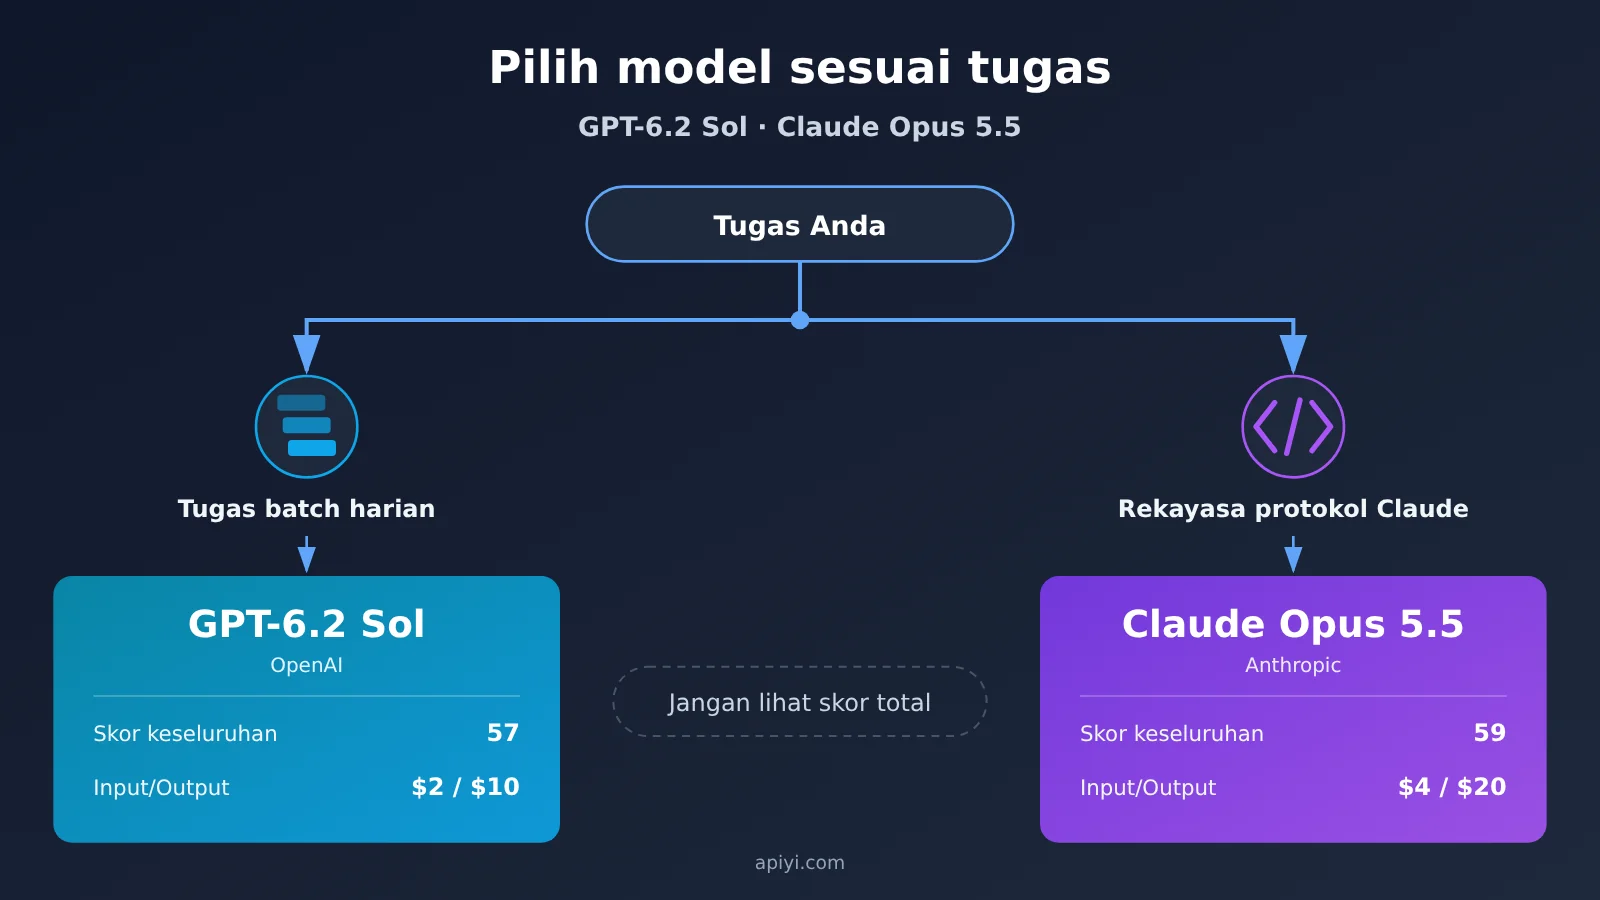
Memilih berdasarkan jenis tugas lebih aman daripada memilih berdasarkan total skor. Di bawah ini penjelasan untuk dua kategori skenario, ditutup dengan satu tabel.
Skenario memilih Claude Opus 5.5
- Butuh protokol Claude: Kode yang sudah ada berbasis Anthropic Messages, atau bergantung pada alat seperti Claude Code — biaya adaptasi untuk pindah protokol lebih besar daripada selisih harga satuannya.
- Harus segera tayang: Opus 5.5 sudah tersedia di APIYI, bisa langsung diintegrasikan tanpa menunggu model baru masuk katalog.
- Skor keseluruhan adalah syarat mutlak: Tugas Anda cukup mirip dengan evaluasi campuran umum, dan selisih 2 poin pada tingkat reasoning tertinggi berdampak nyata pada hasil.
Skenario mencoba GPT-6.2 Sol lebih dulu
- Tugas batch harian yang sensitif terhadap harga satuan: Harga resmi konteks pendek hanya sekitar setengah dari Opus, harga baca cache juga setengah — cocok untuk skenario frekuensi tinggi dengan banyak penggunaan ulang petunjuk.
- Sebagian besar permintaan berada di bawah 272K: Hanya dengan begitu harga konteks pendek bisa didapat secara stabil dan terhindar dari biaya tambahan atas seluruh permintaan.
- Sudah berada di ekosistem protokol OpenAI: Memakai Responses atau Chat Completions, perubahan saat migrasi minim.
Perlu dicatat, “mencoba Sol lebih dulu” bukan berarti skor keseluruhan Sol lebih tinggi — angka pihak ketiga justru menunjukkan sebaliknya. Maksudnya, pada skenario yang sensitif terhadap harga satuan dengan tugas yang cenderung sehari-hari, ada baiknya mencoba Sol lebih dulu untuk menguji tugas Anda sendiri selama satu putaran.
| Jenis Tugas | Prioritaskan | Alasan Utama | Platform yang Tersedia |
|---|---|---|---|
| Tugas rekayasa dengan protokol Claude Code / Messages | Claude Opus 5.5 | Protokol native, tanpa perlu adaptasi | APIYI apiyi.com, sudah tersedia |
| Tugas produksi yang harus segera tayang | Claude Opus 5.5 | Saat ini sudah bisa dipanggil | APIYI, sudah tersedia |
| Tugas harian frekuensi tinggi, penggunaan ulang cache petunjuk | GPT-6.2 Sol | Harga resmi input, output, dan baca cache sekitar setengah | OpenAI API; di APIYI belum tersedia |
| Tugas dokumen panjang di atas 272K | Keduanya harus dihitung berdasarkan token aktual | Sol punya aturan biaya tambahan atas seluruh permintaan | Lihat daftar model di masing-masing platform |
| Tanya jawab yang sensitif terhadap fakta kunci yang terlewat | Lakukan evaluasi terarah terlebih dahulu | Sol mengalami penurunan pada SWE-Atlas-QnA-AA (pihak ketiga) | Lihat daftar model di masing-masing platform |
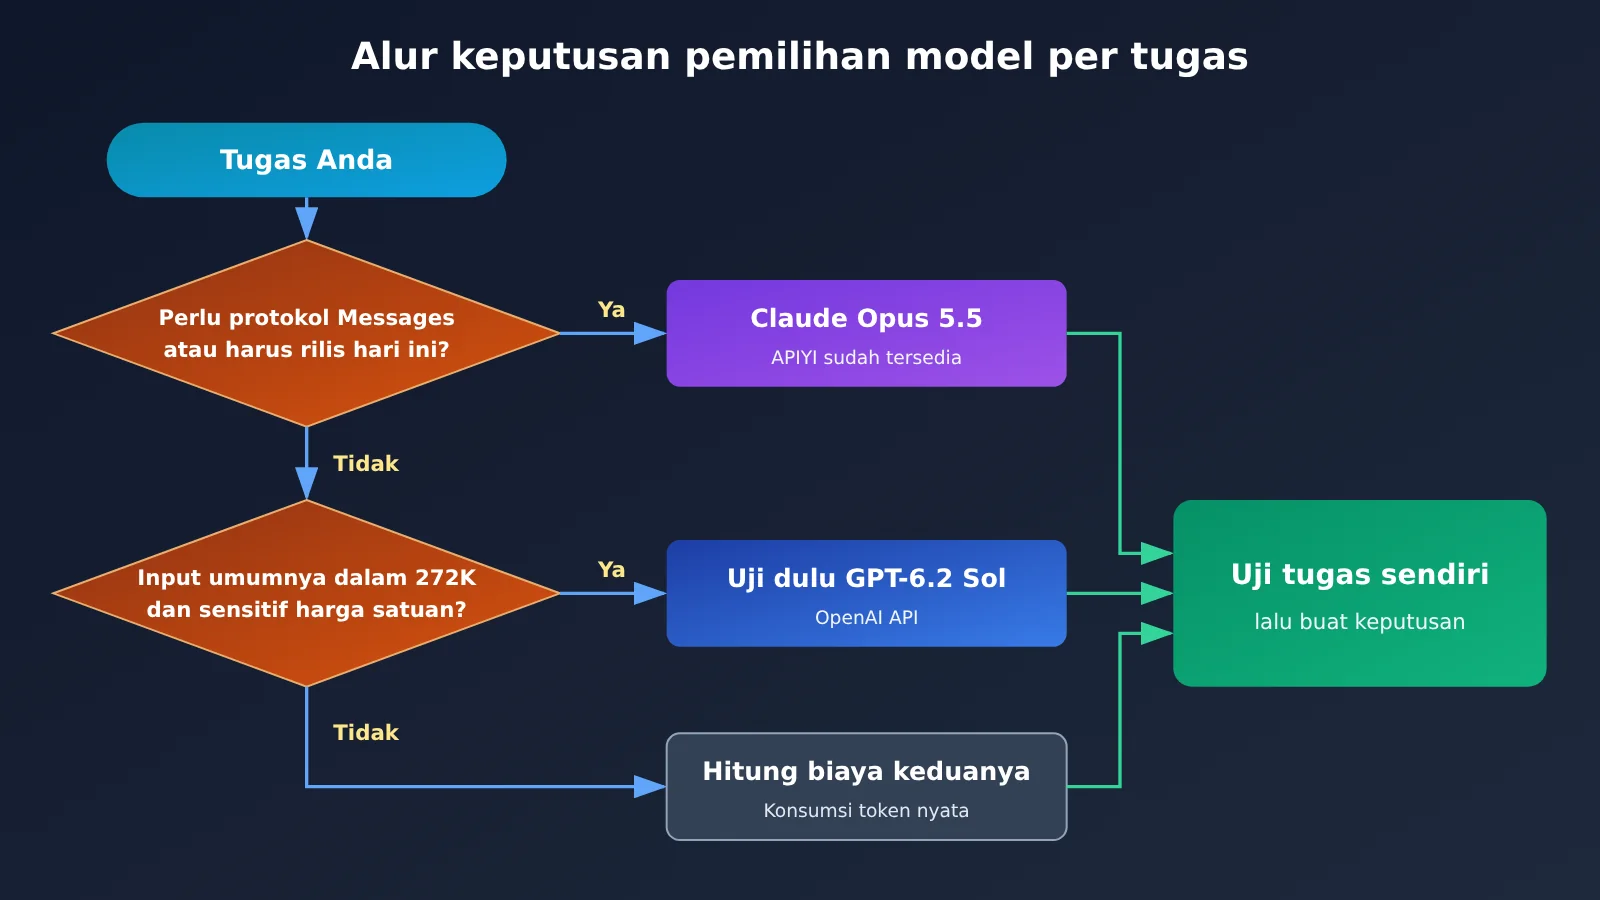
Panduan Cepat GPT-6.2 Sol dan Claude Opus 5.5
Saat ini yang bisa langsung dipanggil di APIYI adalah Claude Opus 5.5. Langkah integrasinya seperti berikut, semuanya hanya perubahan konfigurasi, tanpa perlu dependensi tambahan:
- Daftar di APIYI dan buat kunci API; pengguna baru mendapatkan kuota uji coba gratis.
- Atur base URL klien ke
https://api.apiyi.com/v1, ini adalah alamat antarmuka yang kompatibel dengan OpenAI. - Isi nama model dengan
claude-opus-5-5; jika membutuhkan proses berpikir yang eksplisit, bisa gunakanclaude-opus-5-5-thinking. - Kalau kamu memakai klien bergaya Anthropic, langsung gunakan endpoint messages; kalau pakai OpenAI SDK, gunakan endpoint chat.
- Gunakan 5 sampai 10 permintaan bisnis nyata untuk satu putaran evaluasi, catat jumlah token input, output, dan yang mengenai cache (cache hit), lalu hitung biaya per tugas berdasarkan harga platform $4 / $20 / $0.2.
ID model GPT-6.2 Sol adalah gpt-6.2-sol, secara resmi bisa dipanggil melalui OpenAI API, dan juga sudah tersedia di ChatGPT Work serta Codex untuk pengguna Plus, Pro, Enterprise, dan Edu. Di APIYI, model ini belum tersedia, dan kami akan segera meluncurkannya; jenis model dan harga mengacu pada daftar model di platform. Sebelum diluncurkan, mohon jangan menggunakan gpt-6.1-sol sebagai pengganti untuk evaluasi, karena keduanya bukan model yang sama.
🚀 Mulai Cepat: Disarankan untuk menguji
claude-opus-5-5di APIYI apiyi.com menggunakan kuota gratis terlebih dahulu, dan catat konsumsi token untuk tugas kamu. Setelahgpt-6.2-soltersedia, jalankan lagi dengan permintaan yang sama dan base URL yang sama, cukup ganti nama modelnya, sehingga biaya dan hasil dari keduanya bisa dibandingkan dalam satu tabel yang sama.
GPT-6.2 Sol dan Claude Opus 5.5: Rekomendasi Keputusan
💡 Saran pemilihan: Butuh protokol Claude dan ingin langsung bisa dipanggil hari ini? Pilih Claude Opus 5.5. Kalau mengincar model sehari-hari dengan harga resmi yang lebih murah, GPT-6.2 Sol layak jadi perhatian utama — tapi jangan sampai mengklaim skor keseluruhannya lebih tinggi. Pada akhirnya, ujilah dengan tugas kamu sendiri: melalui antarmuka terpadu APIYI di apiyi.com, kedua model bisa berbagi satu set kode pemanggilan yang sama, dan saat berpindah cukup ganti nama modelnya.
Dalam penerapan konkretnya, ada tiga hal yang perlu diperhatikan. Pertama, saat evaluasi, tingkat reasoning kedua model harus diselaraskan — skor komposit pihak ketiga memakai tingkat tertinggi, sementara Opus secara bawaan medium; kalau tingkatnya berbeda, skor dan konsumsi token akan ikut berubah. Kedua, untuk tugas dengan prefiks petunjuk yang stabil, masukkan faktor cache ke dalam perhitungan — harga baca cache di kedua sisi sama-sama 1/20 dari harga input, dan saat hit rate tinggi, perbedaan tagihan bisa membesar atau justru mengecil. Ketiga, untuk tugas dokumen panjang, kasus di atas 272K wajib dihitung secara terpisah.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa posisi GPT-6.2 Sol dan Claude Opus 5.5 masing-masing?
GPT-6.2 Sol adalah model yang dirilis OpenAI pada 2026-11-17, menerima input teks dan gambar serta menghasilkan output teks, dengan jendela konteks 1,050,000. Secara resmi, model ini diposisikan untuk tugas harian dan pekerjaan nyata yang mengutamakan efisiensi. Claude Opus 5.5 adalah model dari Anthropic dengan jendela konteks 1M, output maksimal 128K, dan tingkat penalaran default medium.
Q2: Mana yang lebih kuat, GPT-6.2 Sol atau Claude Opus 5.5?
Tidak ada satu angka skor total yang bisa menjawab pertanyaan ini. Dalam indeks komprehensif pihak ketiga dari Artificial Analysis, level Max milik Sol mendapat skor 57, sedangkan level tertinggi Opus mendapat 59. Dalam pengumuman resminya, Sol memang menunjukkan hasil unggul pada proyek seperti FrontierCode 2.0 dan LifeVal, tetapi pembandingnya sebagian besar adalah model-model OpenAI sendiri. Sebaiknya evaluasi berdasarkan tugas spesifik, jangan memilih hanya dari skor total.
Q3: Apakah GPT-6.2 Sol sekarang sudah bisa dipanggil di APIYI?
Belum. Baik tabel model lengkap APIYI (2026-11-17 15:54, UTC+8) maupun endpoint harga publik belum mencantumkan `gpt-6.2-sol`. GPT-6.2 Sol belum tersedia di platform, kami akan segera menambahkan model ini; nama model dan harga mengacu pada daftar model di platform.
Q4: Berapa harga Claude Opus 5.5 di APIYI dan apa endpoint-nya?
Baik `claude-opus-5-5` maupun `claude-opus-5-5-thinking` sudah tersedia. Harga yang tercantum di platform: input $4, output $20, cache read $0.2 (per 1 juta token), dengan endpoint yang mendukung chat dan messages. Cukup gunakan satu kunci API yang sama dari APIYI apiyi.com, lalu isi base URL dengan `https://api.apiyi.com/v1`.
Q5: Bisakah biaya per tugas $1.01 milik Sol langsung dipakai untuk hitung-hitungan?
Tidak bisa. $1.01 adalah biaya rata-rata yang diukur Artificial Analysis pada rangkaian tugas indeks komprehensif dengan level penalaran Max, dan hanya berlaku untuk evaluasi tersebut. Kalau panjang tugas dan konsumsi penalaran Anda berbeda, biayanya juga akan berbeda. Biaya per tugas Opus 5.5 dalam indeks tersebut tidak dicakup dalam materi artikel ini, jadi angka itu juga tidak bisa dipakai untuk membagi kedua model tersebut.
Q6: Apa hubungan GPT-6.2 Astra dengan Sol, dan apakah Astra juga perlu dipertimbangkan?
Astra adalah model lain yang dirilis dalam batch yang sama, dengan harga resmi untuk konteks pendek: input $8, cache read $0.40, output $40, dan skornya pada indeks komprehensif pihak ketiga lebih tinggi daripada Sol. Di APIYI, GPT-6.2 Astra belum tersedia, kami akan segera menambahkan model ini; nama model dan harga mengacu pada daftar model di platform. Fokus perbandingan artikel ini adalah Sol dan Opus 5.5 — kisaran harga Astra tidak berada di level yang sama dengan keduanya.
Q7: Apakah ada model lain pada kisaran harga serupa yang bisa dijadikan pembanding?
Bisa lihat Gemini 4 Carbon. APIYI sudah menyediakan `gemini-4-carbon`, dan halaman platform mencantumkan harga perkenalan: input $2, cache read $0.1, output $10. Perhatikan, harga resmi Google berubah mulai 2026-12-01 menjadi input $4, output $20, cache read $0.20. Halaman platform saat ini belum mencantumkan penyesuaian harga tersebut, jadi setelah 1 Desember mohon merujuk pada daftar model di APIYI apiyi.com.
Q8: Apa saja keterbatasan GPT-6.2 Sol yang sudah diketahui?
Halaman model resmi mencantumkan dengan jelas bahwa input audio dan video tidak didukung, begitu pula Realtime, Assistants, fine-tuning, pembuatan gambar, dan suara; API juga tidak menerima pengaturan intensitas penalaran ke none. Data pihak ketiga menunjukkan skor model ini 14 poin lebih rendah dari GPT-6.1 Sol pada SWE-Atlas-QnA-AA, dan lebih rentan melewatkan fakta penting. Evaluasi alignment resmi juga menyebutkan bahwa dalam dua pengujian, seri 6.2 lebih sering gagal melaporkan masalah penghambat seperti file yang tidak ada atau alat pencarian yang tidak tersedia.
Poin-Poin Utama GPT-6.2 Sol dan Claude Opus 5.5 (Key Takeaways)
- Skor gabungan: Pada tingkat penalaran tertinggi di benchmark pihak ketiga, Sol (Max) mendapat 57 sedangkan Opus 5.5 mendapat 59 — selisih 2 poin.
- Harga resmi: Sol $2 untuk input, $10 untuk output, $0.10 untuk baca cache; Opus $4, $20, dan $0.20.
- Konteks panjang: Saat input dalam satu permintaan Sol melebihi 272K, seluruh permintaan kena biaya tambahan — input dan cache menjadi dua kali lipat, output 1.5 kali lipat.
- Basis perbandingan terpisah: Tugas dan tingkat penalaran pada laporan resmi berbeda dengan evaluasi pihak ketiga, jadi keduanya tidak bisa digabung menjadi satu kesimpulan.
- Ketersediaan saat ini: Opus 5.5 sudah tersedia di APIYI; Sol untuk saat ini belum terdaftar — gunakan daftar model di platform sebagai acuan.
- Cara memilih model: Pilih Opus jika butuh protokol Claude dan bisa langsung dipakai; untuk tugas harian yang sensitif terhadap harga satuan, evaluasi Sol terlebih dahulu.
Ringkasan
Pemilihan antara GPT-6.2 Sol dan Claude Opus 5.5 dapat dirangkum dalam tiga poin:
- Lihat skor dan harga secara bersamaan: Skor komprehensif pihak ketiga untuk Sol lebih rendah 2 poin, sementara harga resmi untuk konteks pendek hanya sekitar setengah dari Opus — melihat salah satunya saja tidak cukup untuk mengambil keputusan.
- Pilih sesuai tugas dan protokol: Tugas yang bergantung pada protokol Claude dan perlu segera diluncurkan sebaiknya pakai Opus 5.5; sementara tugas harian yang sensitif terhadap harga satuan dengan permintaan umumnya di bawah 272K, layak dievaluasi lebih dulu dengan Sol.
- Hitung sendiri dengan tugas Anda: Biaya per tugas dari pihak ketiga hanya berlaku untuk rangkaian evaluasi tersebut; biaya sebenarnya bergantung pada konsumsi token, cache hit, dan intensitas penalaran Anda.
Saat ini, langkah paling praktis adalah membangun alur evaluasi lebih dulu dengan Opus 5.5, lalu setelah Sol resmi tersedia, lengkapi satu putaran perbandingan menggunakan batch permintaan yang sama. Kami merekomendasikan memakai APIYI di apiyi.com untuk mengelola berbagai model sekaligus dengan satu kunci API — kuota gratisnya cukup untuk menyelesaikan validasi putaran pertama.
📚 Referensi
-
Artikel rilis OpenAI: Catatan rilis GPT-6.2 Astra dan Sol serta evaluasi resmi yang dilaporkan sendiri
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Keterangan: Ringkasan harga, cakupan ketersediaan, dan berbagai perbandingan resmi yang dilaporkan sendiri
- Tautan:
-
Halaman model OpenAI gpt-6.2-sol: Spesifikasi, endpoint, dan aturan harga lengkap
- Tautan:
platform.openai.com/docs/models/gpt-6.2-sol - Keterangan: Harga penulisan cache, aturan 272K untuk seluruh pesanan, dan pengali Batch / Fast / Ultrafast
- Tautan:
-
Kartu sistem OpenAI: Evaluasi keamanan dan alignment
- Tautan:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Keterangan: Tingkat kerangka kesiapan dan kesimpulan pengujian alignment
- Tautan:
-
Artikel evaluasi pihak ketiga Artificial Analysis: Hasil Intelligence Index v5.0.1
- Tautan:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Keterangan: Skor komprehensif tiap tingkat penalaran, sub-indeks, dan perbandingan dengan tingkat tertinggi Opus 5.5
- Tautan:
-
Halaman model GPT-6.2 Sol di Artificial Analysis: Metrik seperti biaya per tugas
- Tautan:
artificialanalysis.ai/models/gpt-6-2-sol - Keterangan: Biaya per tugas indeks komprehensif $1.01 (tingkat Max)
- Tautan:
-
Dokumentasi model Claude: Spesifikasi Opus 5.5 dan perbandingan harga resmi
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview - Keterangan: Harga input/output Opus 5.5, jendela konteks, dan intensitas penalaran default
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI; informasi terbaru mengenai model dan harga dapat dilihat di tabel model pusat dokumentasi docs.apiyi.com