Jawaban langsung: petunjuk baru belum tentu lebih baik, dan “terlihat lebih baik” juga bukan bukti. Untuk menilai template artikel mana yang lebih baik antara yang lama dan yang baru, kita harus memakukan materi, model, dan pengaturan generasi, hanya mengubah template, lalu memeriksa struktur, urutan, dan kualitas konten secara berlapis menggunakan assertion Promptfoo. Hasilnya juga harus disajikan per dimensi, supaya skor gaya bahasa tidak menutupi kesalahan faktual. Artikel ini mengusulkan sebuah skema eksperimen, bukan menjalankan eksperimen A/B sungguhan, sehingga tidak memberikan angka kemenangan, skor, atau besaran penghematan apa pun.
Setelah membaca artikel ini, Anda akan memahami:
- Apa yang bisa diperiksa oleh assertion
contains, JavaScript, danllm-rubricdi Promptfoo, serta apa yang tidak bisa dibuktikannya. - Cara menjalankan file assertion secara terpisah terhadap output model yang sudah ada, sehingga saat hanya mengubah aturan penilaian kita tidak perlu melakukan generasi ulang.
- Sebuah desain eksperimen untuk membandingkan template artikel lama dan baru, termasuk kontrol variabel, pemeriksaan tiga lapis, dan penyajian per dimensi.
- Batas antara model juri dan assertion berbasis aturan, serta masalah biaya yang timbul dari model penilai berbayar.
Indeks: Pertama-tama kami jelaskan beberapa istilah kunci dalam evaluasi Promptfoo melalui tabel konsep, lalu menjelaskan dampaknya bagi tim konten, pengembang, dan penanggung jawab evaluasi. Bagian “fakta objektif” dalam teks utama hanya merangkum kemampuan assertion dan status pemeriksaan sebagaimana dijelaskan dalam dokumentasi. Bagian “analisis dan penilaian” memberikan saran desain eksperimen, contoh konfigurasi, dan diskusi keterbatasan, sambil menandai satu per satu mana yang merupakan saran dan bukan kesimpulan dari pengujian nyata.
Konsep yang perlu diketahui sebelum membandingkan template petunjuk dengan Promptfoo
Istilah-istilah berikut akan sering muncul di bagian selanjutnya. Sebagian besar berasal dari dokumentasi konfigurasi Promptfoo, dan beberapa merupakan istilah umum dalam eksperimen evaluasi.
| Konsep | Penjelasan singkat |
|---|---|
| Promptfoo | Alat sumber terbuka untuk mengevaluasi petunjuk dan output Model Bahasa Besar; test case dan asersi dapat didefinisikan melalui file konfigurasi |
| Asersi (Assertion) | Aturan pemeriksaan otomatis terhadap output model, untuk menentukan apakah output memenuhi suatu kondisi |
| contains | Memeriksa apakah teks tertentu muncul dalam output; termasuk pencocokan string deterministik |
| Asersi JavaScript | Menggunakan ekspresi atau fungsi JavaScript untuk menerapkan kondisi penilaian yang lebih kompleks |
| llm-rubric | Meminta sebuah model memberi nilai output berdasarkan rubrik kustom; termasuk asersi jenis “penilaian model” |
| Penyedia penilaian (Grading Provider) | Model yang menjalankan penilaian llm-rubric; dapat dikonfigurasi secara terpisah |
| Rubrik (Rubric) | Kriteria penilaian yang ditulis untuk model pemberi nilai, menjelaskan kondisi apa yang dianggap lulus dan kondisi apa yang dikurangi nilainya |
| Juri model (LLM-as-a-Judge) | Praktik menggunakan Model Bahasa Besar sebagai pengganti penilaian manusia terhadap kualitas output |
| Kontrol variabel | Dalam eksperimen, hanya mengubah satu faktor (di sini template), sementara faktor lain dijaga tetap |
Ringkasan dampak evaluasi template petunjuk lama vs baru
Nilai metode evaluasi semacam ini bukan terletak pada seberapa baru alatnya, melainkan pada kemampuannya mengubah “saya rasa template baru lebih baik” menjadi catatan pemeriksaan yang bisa ditinjau ulang. Setiap peran mendapat manfaat yang berbeda darinya.
| Kelompok | Dampak nyata |
|---|---|
| Tim konten dan editor | Revisi template kini punya dasar penerimaan yang bisa ditinjau ulang, mampu menemukan masalah seperti “strukturnya sudah benar tetapi paragraf faktual tercampur dugaan” |
| Engineer petunjuk dan developer | Dapat memecah persyaratan template menjadi asersi aturan dan asersi skala, tidak perlu membuat ulang seluruh output saat mengubah aturan penilaian |
| Penanggung jawab evaluasi | Perlu melaporkan hasil per dimensi, dan secara jelas membedakan kekuatan pembuktian masing-masing antara penilaian model, kecocokan aturan, dan tinjauan manual |
| Penanggung jawab anggaran | Asersi aturan hampir tidak menimbulkan biaya pemanggilan tambahan, llm-rubric akan menimbulkan biaya penilaian jika menggunakan model berbayar |
Fakta objektif tentang kemampuan asersi Promptfoo
Bagian ini hanya menyatakan kemampuan yang dijelaskan dalam dokumentasi Promptfoo. Kami memverifikasi halaman dokumentasi terkait pada 2026-11-17, tetapi tanggal rilis pertama kemampuan tersebut belum diverifikasi, sehingga artikel ini tidak memberikan waktu peluncuran spesifik.
Asersi contains di Promptfoo: memeriksa apakah teks muncul
contains adalah jenis asersi paling dasar, digunakan untuk memeriksa apakah teks yang ditentukan muncul dalam output model. Ini adalah pencocokan string yang deterministik, output yang sama akan menghasilkan hasil yang sama setiap kali dijalankan.
Perlu ditekankan, lolosnya contains hanya menunjukkan “teks ini cocok”. Ia tidak dapat menunjukkan apakah paragraf tempat teks tersebut berada ditulis dengan baik, juga tidak dapat menunjukkan apakah kontennya benar.
Asersi JavaScript di Promptfoo: mengimplementasikan kondisi kompleks
Ketika kondisi penilaian melampaui “apakah mengandung”, Anda dapat menulis logika kustom dengan asersi JavaScript. Misalnya membandingkan posisi kemunculan dua judul, menghitung jumlah bagian tertentu, atau memeriksa apakah suatu teks berada di dalam bagian tertentu. Asersi semacam ini tetap deterministik, hasilnya dapat direproduksi.
Mengevaluasi output Promptfoo yang sudah ada dengan file asersi independen
Promptfoo mendukung menjalankan file asersi independen terhadap output model yang sudah dihasilkan, tanpa perlu membuat ulang semua output. Ini penting untuk iterasi evaluasi: aturan penilaian sering kali perlu disesuaikan berulang kali, sedangkan pembuatan output sendiri memakan waktu dan biaya pemanggilan.
llm-rubric di Promptfoo: penilaian model berdasarkan skala
llm-rubric termasuk asersi jenis penilaian model. Ia menyerahkan output dan skala kustom kepada model penilai, dan model penilai menentukan apakah lolos serta memberikan alasan. Dokumentasi menyatakan bahwa penyedia penilaian yang melakukan skoring dapat dikonfigurasi secara terpisah, dan petunjuk yang digunakan saat penilaian juga dapat dikustomisasi.
| Jenis asersi | Metode penilaian | Apakah hasil deterministik | Apa yang dapat dibuktikan | Apa yang tidak dapat dibuktikan |
|---|---|---|---|---|
| contains | Pencocokan string | Deterministik | Teks yang ditentukan muncul | Kualitas paragraf, kebenaran konten |
| JavaScript | Logika kode kustom | Deterministik | Kondisi yang dapat dikodekan seperti struktur, urutan, jumlah | Baik-buruknya pada tingkat semantik |
| llm-rubric | Penilaian model berdasarkan skala | Dipengaruhi model penilai | Output menurut model penilai sesuai skala | Kebenaran fakta, dan juga tidak dapat menggantikan pemeriksaan manual |
Sumber data dan status verifikasi
Bagian fakta artikel ini berdasarkan halaman dokumentasi Promptfoo berikut, dengan tanggal verifikasi 2026-11-17:
- Dokumentasi asersi dan metrik Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/
- Dokumentasi asersi penilaian model Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Dokumentasi llm-rubric Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
Artikel ini tidak menjalankan eksperimen A/B template lama vs baru yang sebenarnya. Konfigurasi dan alur yang muncul di bagian selanjutnya hanyalah saran desain, tidak mewakili hasil pengujian aktual apa pun.
Menganalisis Perbandingan Template Artikel Lama dan Baru dengan Promptfoo
Konten berikut adalah interpretasi dan saran kami berdasarkan fakta-fakta di atas. Dengan mengambil contoh “template artikel berita”, anggaplah template baru mengharuskan artikel memuat dua bagian: “fakta objektif” dan “analisis penilaian”, dengan fakta di depan dan analisis di belakang, serta bagian fakta tidak boleh dicampur dengan spekulasi.
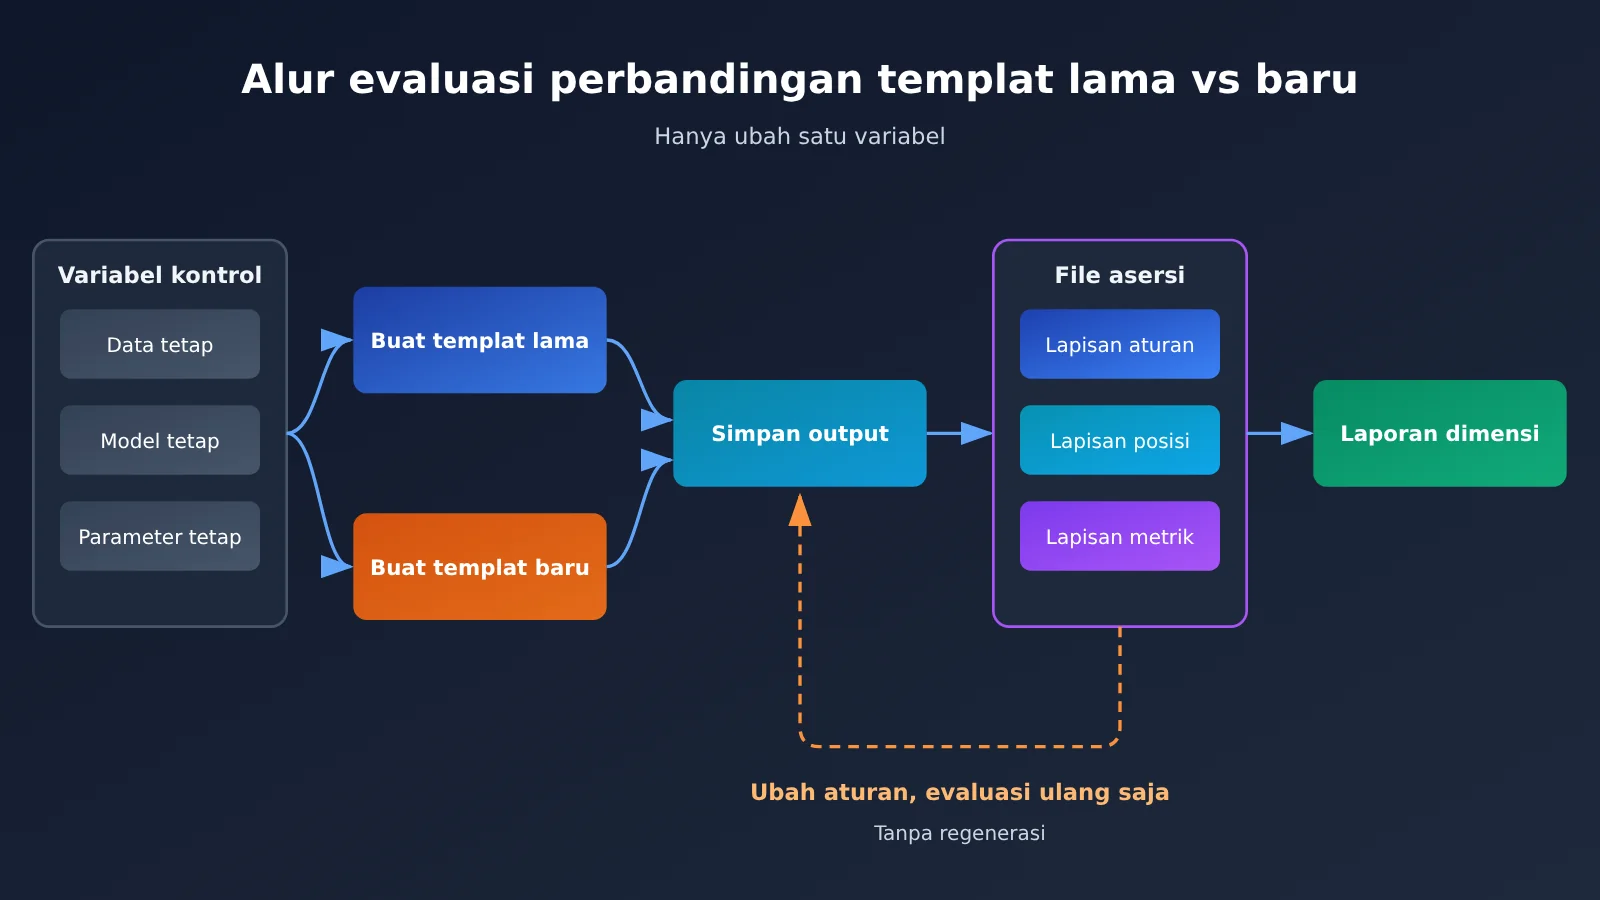
Desain eksperimen: Promptfoo hanya mengubah satu variabel saat membandingkan template
Kesalahan paling umum saat membandingkan template adalah mengganti template sekaligus mengganti data, model, atau parameter temperature. Dengan begitu, meskipun hasilnya membaik, kita tidak bisa memastikan apakah itu berkat template atau pengaruh faktor lain. Karena itu, langkah pertama adalah mengunci semua variabel kecuali template.
| Variabel | Perlakuan | Alasan |
|---|---|---|
| Data masukan | Dikunci pada batch yang sama, dipakai bersama oleh template lama dan baru | Data yang berbeda akan langsung mengubah konten fakta |
| Model pembuatan | Dikunci pada model dan versi yang sama | Perbedaan gaya penulisan antar model bisa lebih besar daripada perbedaan template |
| Parameter pembuatan | Mengunci pengaturan temperature, panjang maksimum, dan lain-lain | Parameter memengaruhi stabilitas dan panjang output |
| Template petunjuk | Satu-satunya variabel yang diubah | Inilah objek yang ingin diverifikasi |
| Aturan penilaian | Kedua kelompok menggunakan set assertion yang sama | Memastikan kedua kelompok menerima pemeriksaan yang sama |
Lapisan aturan dan lapisan posisi Promptfoo: periksa struktur dulu, baru urutan
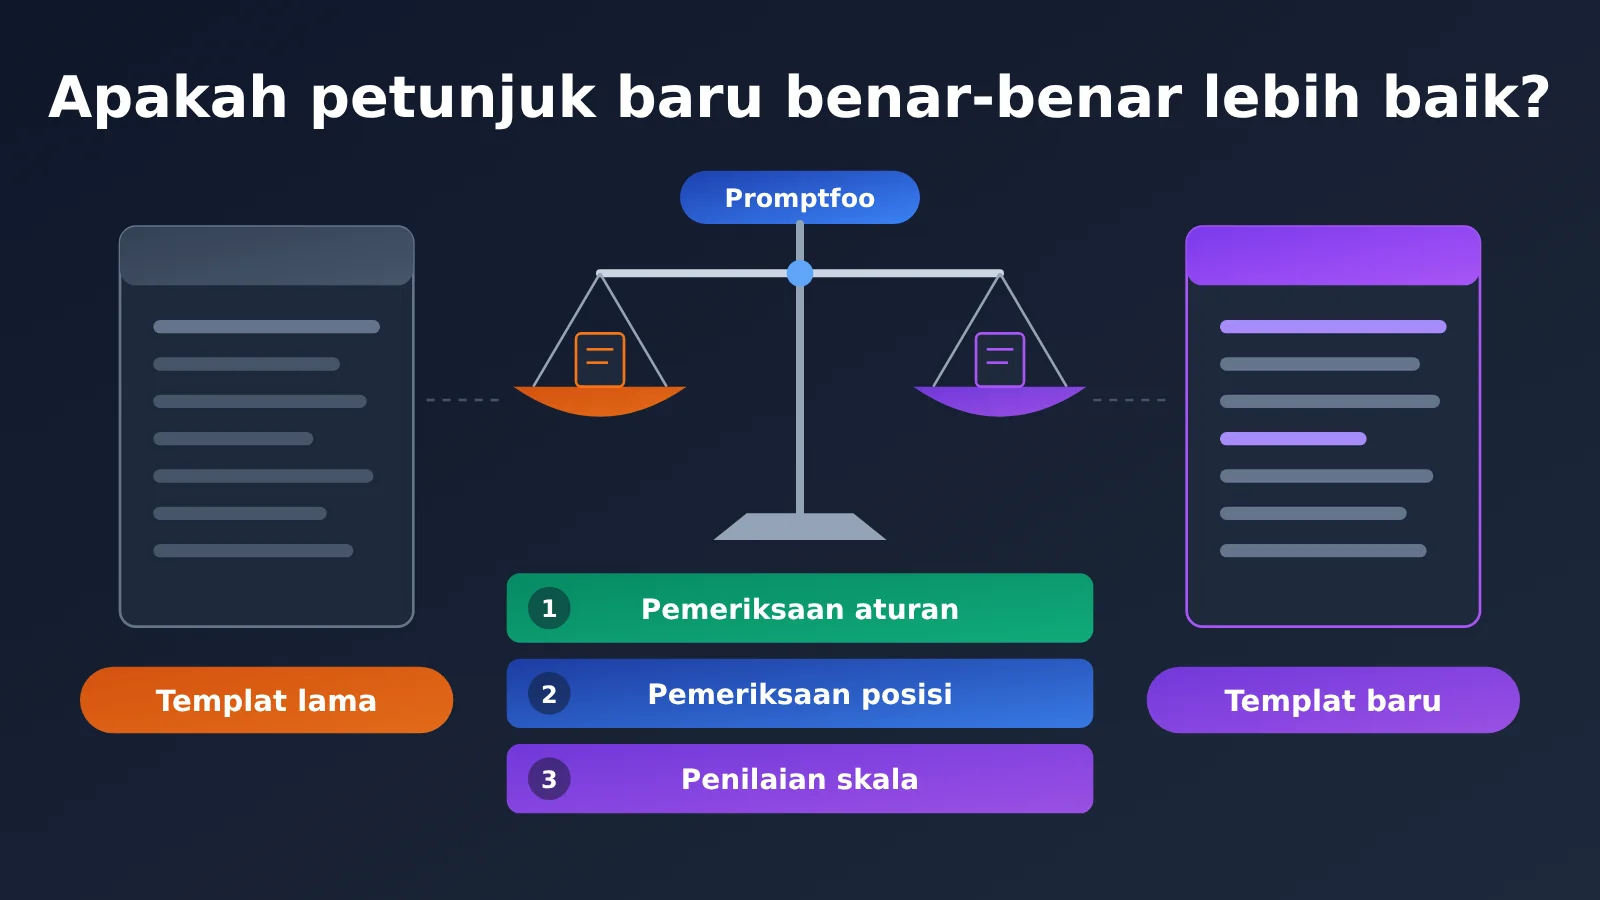
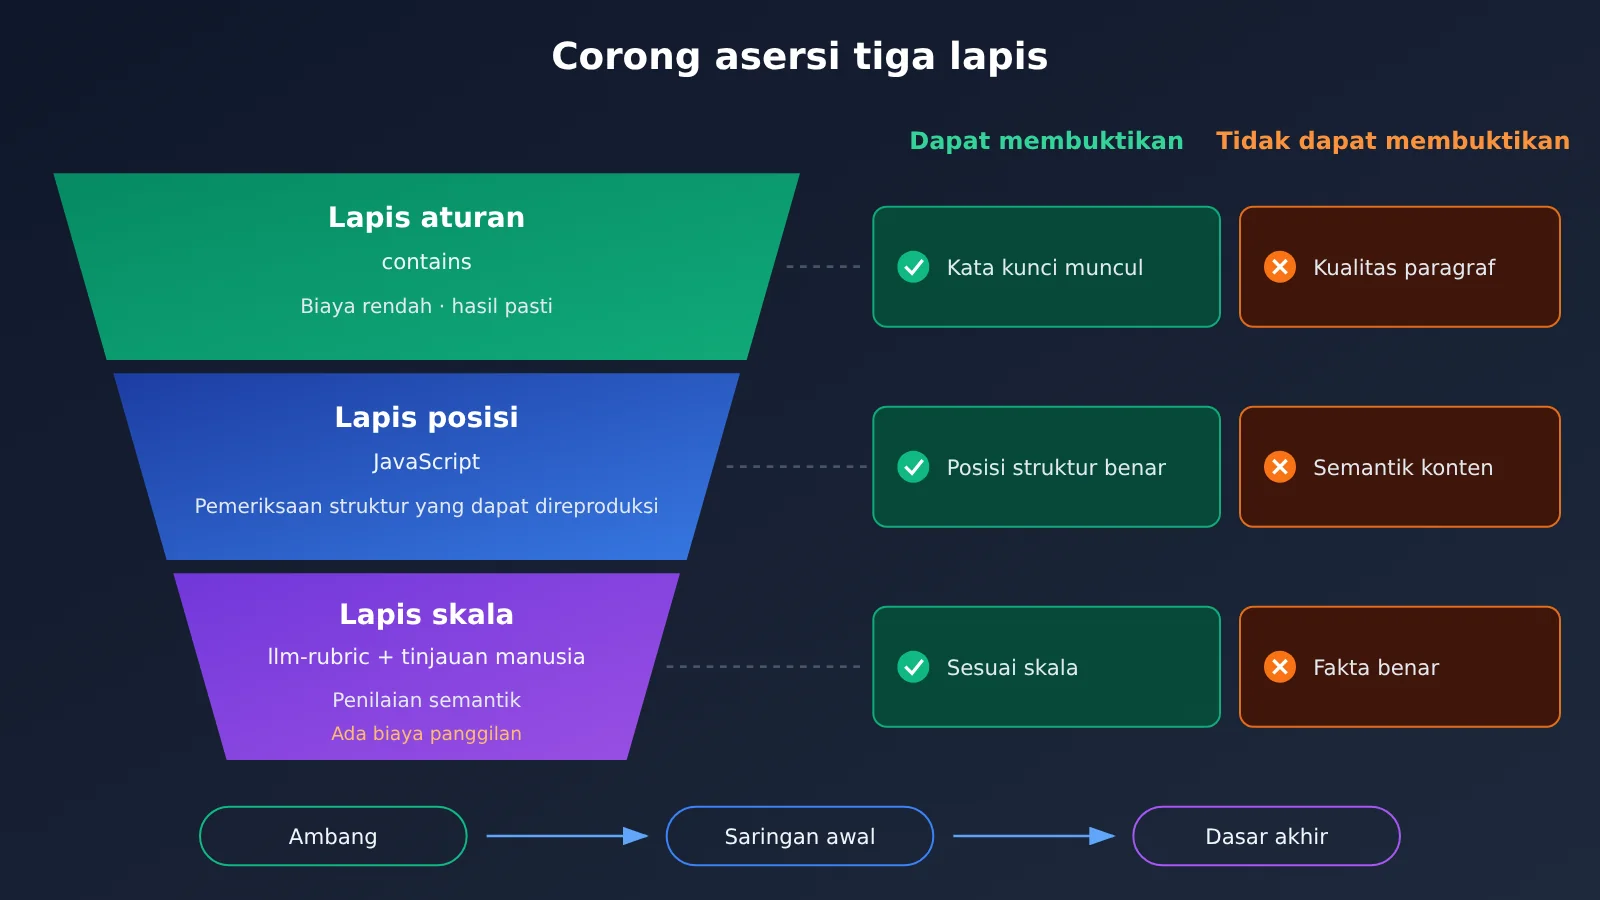
Lapisan pertama adalah pemeriksaan aturan, memakai contains untuk memastikan apakah judul yang diwajibkan templat sudah muncul. Lapisan kedua adalah perbandingan posisi, memakai asersi JavaScript untuk memastikan judul ## 客观事实 muncul sebelum judul ## 分析判断. Kedua lapisan ini merupakan pemeriksaan deterministik: biayanya rendah, hasilnya stabil, dan cocok ditaruh paling depan untuk menyaring output yang jelas-jelas tidak memenuhi syarat.
Berikut ini contoh penulisan asersi; untuk nama field yang spesifik, silakan mengacu pada dokumentasi resmi Promptfoo:
# Konfigurasi ilustratif: untuk menjelaskan gagasan, detail field silakan verifikasi dengan dokumentasi resmi
assert:
  # Lapisan aturan: apakah judul muncul
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # Lapisan posisi: bagian fakta harus berada sebelum bagian analisis
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
Perhatikan bahwa dalam penulisan lapisan posisi di atas, keberadaan kedua judul diperiksa terlebih dahulu. Jika hanya menulis a < b, saat judul ## 客观事实 tidak ada, indexOf akan mengembalikan -1, dan kondisi “kurang dari” tetap terpenuhi sehingga menimbulkan kesalahan penilaian. Inilah sebabnya asersi deterministik pun perlu ditulis dengan cermat.
Lapisan rubrik Promptfoo: gunakan rubrik eksplisit untuk memeriksa apakah paragraf fakta tercampur spekulasi
Judul lengkap dan urutan benar tidak otomatis berarti paragraf fakta sudah bersih. “Apakah paragraf fakta tercampur spekulasi” adalah penilaian semantik yang sulit ditangani oleh asersi berbasis aturan, dan di sinilah llm-rubric cocok dipakai. Rubrik harus ditulis secara spesifik, memberi tahu model penilai apa yang dianggap pelanggaran, bukan sekadar bertanya “apakah tulisannya bagus”.
# Contoh konfigurasi: penyedia penilaian dan isi rubrik hanyalah ilustrasi
assert:
  - type: llm-rubric
    value: |
      Nilai hanya bagian "fakta objektif".
      Jika bagian tersebut memuat prediksi, penilaian subjektif, atau inferensi tanpa sumber yang jelas, nilai sebagai tidak lolos, dan kutip kalimat asli yang bermasalah.
      Jangan menilai gaya bahasa, dan jangan menilai bagian lain.
    provider: your-grading-model   # Penyedia penilaian dapat dikonfigurasi terpisah
Kesimpulan dari lapisan rubrik tetap memerlukan pemeriksaan sampel manual. Model penilai bisa saja melewatkan pelanggaran, atau justru salah menilai pernyataan fakta yang wajar sebagai spekulasi. Cara yang lebih aman adalah meninjau ulang satu per satu sampel yang tidak lolos, lalu mengambil sebagian sampel yang lolos secara acak untuk diperiksa manual.
Penyajian per dimensi: jangan biarkan skor gaya bahasa Promptfoo menetralkan kesalahan fakta
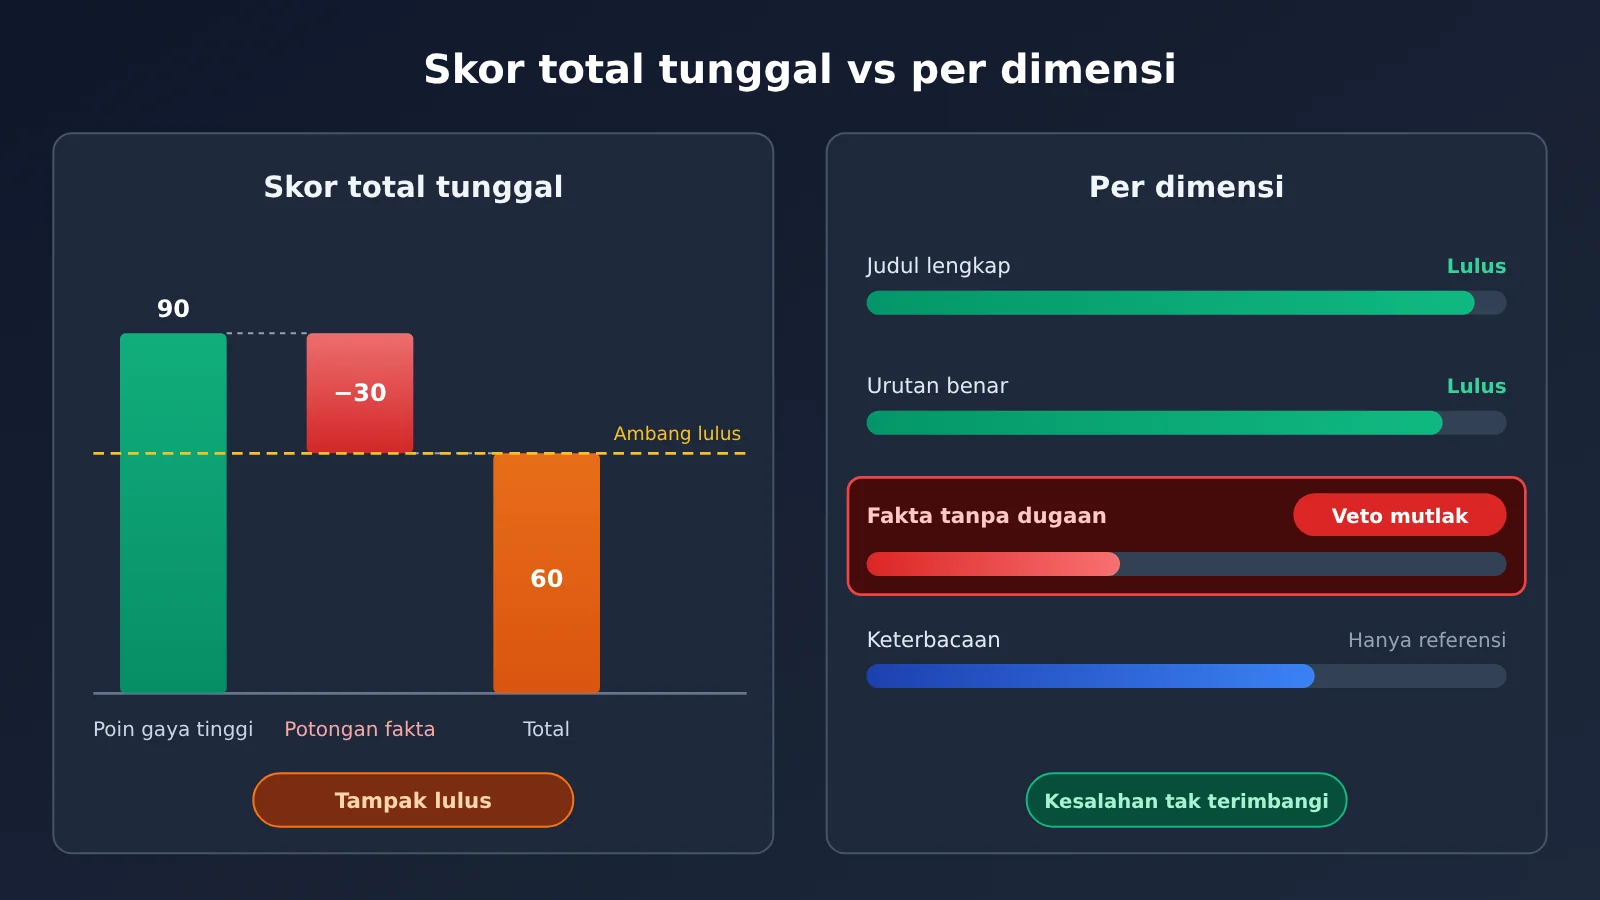
Jika semua asersi digabung menjadi satu skor total, artikel yang tulisannya lancar tetapi paragraf faktanya tercampur spekulasi bisa mendapat skor yang mirip dengan artikel berstruktur rapi namun agak datar. Untuk konten berita, “saling menetralkan” seperti ini berbahaya. Karena itu, sebaiknya laporkan per dimensi dan tetapkan dimensi fakta sebagai hak veto.
| Dimensi evaluasi | Cara pemeriksaan | Cara penyajian | Dapat dinetralkan oleh dimensi lain |
|---|---|---|---|
| Kelengkapan judul wajib | contains | Tingkat kelulusan | Tidak, merupakan syarat wajib |
| Urutan bab benar | JavaScript | Tingkat kelulusan | Tidak, merupakan syarat wajib |
| Paragraf fakta bebas spekulasi | llm-rubric + tinjauan manual | Tingkat kelulusan + daftar kalimat bermasalah | Tidak, hak veto |
| Ekspresi dan keterbacaan | llm-rubric | Dicantumkan terpisah | Hanya sebagai referensi, tidak ikut menetralkan |
Saat Hanya Mengubah Aturan Penilaian Promptfoo, Evaluasi Ulang Output Lama Secara Langsung
Dalam iterasi evaluasi, yang paling sering diubah biasanya adalah aturan penilaian, bukan template itu sendiri. Misalnya, ditemukan bahwa deskripsi rubrik kurang jelas, atau assertion posisi melewatkan kasus batas. Saat itu template dan output tidak berubah, jadi tidak perlu membuat ulang.
Dengan memanfaatkan kemampuan Promptfoo untuk menjalankan file assertion terpisah terhadap output yang sudah ada, kita bisa memisahkan proses pembuatan dan penilaian sepenuhnya: buat sekali, simpan output, lalu setiap kali aturan disesuaikan cukup jalankan ulang assertion. Ini menghemat waktu sekaligus memastikan dua putaran penilaian menghadapi teks yang benar-benar sama, sehingga perbandingan menjadi bermakna.
Batasan dan Biaya Model Juri Promptfoo
Ada tiga hal yang perlu dijelaskan secara gamblang agar tidak menafsirkan hasil evaluasi secara berlebihan:
- Skor model juri tidak bisa membuktikan kebenaran faktual. llm-rubric hanya menunjukkan bahwa output, menurut model penilai, sesuai dengan rubrik; verifikasi fakta tetap harus kembali ke sumber asli.
- Lolos
containshanya berarti teksnya cocok. Ini menunjukkan judul muncul, bukan bahwa kualitas paragraf di bawah judul memadai. - Penilaian oleh model berbayar memiliki biaya. Assertion berbasis aturan pada dasarnya tidak memicu pemanggilan model tambahan, tetapi llm-rubric memanggil model penilai sekali untuk setiap output yang dinilai, jadi tidak bisa menyebut seluruh rangkaian evaluasi ini “sepenuhnya gratis”.
Berdasarkan batasan tersebut, penilaian kami adalah: assertion deterministik cocok dijadikan “gerbang”, penilaian model cocok dijadikan “penyaringan awal”, dan tinjauan manusia adalah dasar akhir untuk kesimpulan faktual. Ketiganya punya peran berbeda dan tidak bisa saling menggantikan.
Arahan yang Perlu Diperhatikan Selanjutnya
Berikut adalah arah observasi yang belum terverifikasi, hanya sebagai saran untuk eksperimen lanjutan:
- Konsistensi model penilaian. Apakah kesimpulan tetap stabil ketika output yang sama dinilai beberapa kali, dan apakah kesimpulan berbalik jika model penilaian diganti. Jika tidak stabil, skala penilaian perlu ditulis lebih spesifik.
- Tingkat kecocokan antara pemeriksaan manual dan penilaian model. Hal ini menentukan sejauh mana kita dapat mengandalkan llm-rubric untuk penyaringan awal.
- Apakah ukuran sampel sudah cukup. Ketika hanya membandingkan sedikit artikel, faktor kebetulan bisa menutupi perbedaan templat, sehingga diperlukan cukup banyak materi input agar kesimpulan yang diperoleh bermakna.
Sebelum pertanyaan-pertanyaan ini memiliki data pengujian aktual, pernyataan apa pun seperti “berapa tingkat kemenangan templat baru” atau “berapa peningkatan skornya” harus ditanggapi dengan hati-hati. Artikel ini sengaja tidak memberikan angka-angka semacam itu, dan alasannya justru terletak di sini.
Yang diperoleh dari kertas selalu terasa dangkal, untuk benar-benar memahami hal ini harus dipraktikkan sendiri. ——Lu You, “Membaca Buku di Malam Musim Dingin untuk Menunjukkan kepada Zi Yu”