Catatan penulis: Artikel ini membahas cara membangun Personal AI Agent sendiri menggunakan antarmuka model, alat, memori, penjadwalan, dan lingkungan eksekusi, dengan contoh alur kerja intelijen berita AI untuk menjelaskan tanggung jawab dan biaya setiap bagian dari sistem yang dibangun sendiri.
Mereproduksi GPT Dots dengan API, yang bisa direproduksi adalah pola kerjanya: model bertanggung jawab untuk menilai, program bertanggung jawab untuk mengeksekusi, basis data bertanggung jawab untuk mengingat, dan penjadwal bertanggung jawab agar tugas terus berjalan setelah Anda pergi. Antarmuka model hanyalah salah satu lapisan. Sistem alat, memori jangka panjang, antrean tugas, lingkungan eksekusi, dan mekanisme persetujuan semuanya perlu dibangun sendiri oleh pengembang. Konfigurasi model khusus OpenAI, komputer cloud, dan ekosistem 4.000+ aplikasi adalah bagian dari produk Dots itu sendiri, bagian-bagian ini tidak dapat diperoleh langsung melalui API. “24 jam” dalam judul mengacu pada cara kerja Agent yang terus mendorong tugas di latar belakang sesuai jadwal; waktu ketersediaan aktual sistem bergantung pada server, antrean, dan mekanisme percobaan ulang.
Seluruh artikel disusun sesuai urutan pembangunan. Bagian 1 memecah Dots menjadi 7 modul, menandai mana yang disediakan oleh model dan mana yang perlu dibangun sendiri. Bagian 2 hingga 6 secara berurutan mengimplementasikan integrasi model, pemanggilan alat, memori jangka panjang, penjadwalan latar belakang, dan lingkungan eksekusi. Bagian 7 menggabungkan komponen-komponen ini menjadi desain lengkap Personal AI Radar. Bagian 8 menghitung total biaya termasuk biaya non-model, dan menjelaskan batas kemampuan solusi yang dibangun sendiri.
To Know: Istilah yang perlu dipahami sebelum mereproduksi GPT Dots
| Istilah | Penjelasan |
|---|---|
| API | Antarmuka yang dipakai aplikasi untuk memanggil model atau layanan eksternal; dalam artikel ini terutama merujuk pada antarmuka pemanggilan Model Bahasa Besar |
| Agent | Sistem aplikasi yang memanfaatkan model untuk mengambil keputusan dan memanggil alat guna memajukan tugas |
| Function Calling | Model mengeluarkan permintaan pemanggilan alat yang terstruktur, dieksekusi oleh program Anda, lalu hasilnya dikembalikan ke model |
| tool_use / tool_result | Jenis pesan untuk permintaan pemanggilan alat dan hasil eksekusi dalam antarmuka Claude Messages |
| SQLite | Basis data tertanam satu file, cocok untuk menyimpan data ringan seperti preferensi, status tugas, dan log |
| Pencarian vektor | Mengubah teks menjadi vektor, lalu mencari materi terkait berdasarkan kemiripan semantik |
| Antrean tugas | Menyimpan tugas yang menunggu eksekusi, mendistribusikannya ke Worker latar belakang berdasarkan urutan atau prioritas |
| Checkpoint | Snapshot kemajuan yang disimpan saat tugas mencapai langkah tertentu, tempat melanjutkan setelah proses terputus |
| Lingkungan eksekusi | Komputer atau kontainer yang benar-benar menjalankan browser, kode, dan operasi file |
| Playwright | Pustaka otomasi untuk mengendalikan browser lewat kode, digunakan untuk membuka halaman web, mengklik, dan mengekstrak konten |
| Prompt Injection | Metode serangan dengan menyembunyikan instruksi berbahaya di dalam halaman web atau dokumen, mencoba membajak perilaku Agent |
| MCP | Protokol terbuka yang menghubungkan aplikasi model dengan alat eksternal dan sumber data |
1 Modul apa saja yang membentuk GPT Dots
1.1 Kemampuan resmi GPT Dots
Dots adalah AI Agent pribadi yang selalu aktif, dirilis OpenAI pada 29 September 2026. Menurut materi resminya, ia punya komputer cloud dan browser sendiri, sehingga setelah pengguna mematikan komputernya, tugas cloud yang sudah didelegasikan tetap berjalan. Ia bisa menggabungkan memori ChatGPT, catatan miliknya sendiri, dan data dari aplikasi yang terhubung, menjalankan beberapa proyek sekaligus, serta berkomunikasi dengan pengguna lewat saluran seperti ChatGPT, Slack, dan Microsoft Teams.
Cara kerja Dots juga mencakup tiga mekanisme kunci. Penelitian proaktif (Proactive Research) membaca sumber informasi yang sudah diizinkan di latar belakang lalu menyusun catatan penelitian; proses ini hanya-baca, dan tindakan lanjutan harus melewati alur persetujuan normal. Tugas terjadwal dan pemantauan peristiwa membuat Dot terus bekerja sesuai jadwal atau berdasarkan peristiwa. Sementara itu, Custom Rules dan Auto-review memeriksa izin serta maksud pengguna sebelum operasi seperti mengirim email atau berbelanja; operasi berisiko tinggi seperti transfer dana dan penggantian kata sandi wajib diambil alih oleh pengguna.
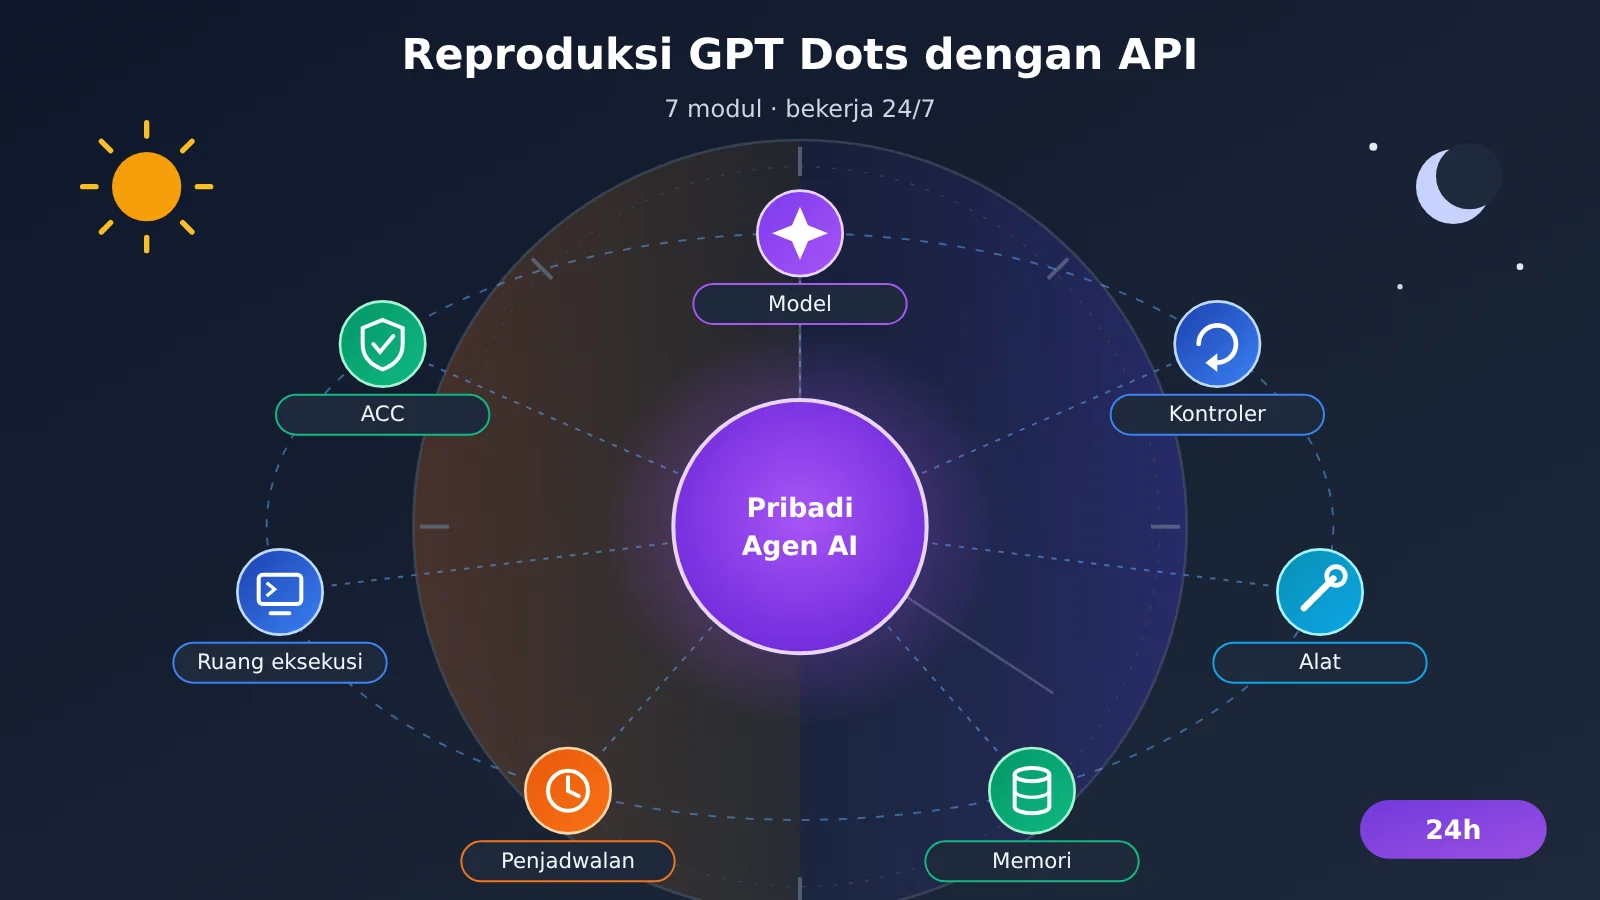
1.2 Tujuh modul GPT Dots dan padanannya dalam solusi mandiri
Kalau kemampuan Dots diurai, kita mendapatkan 7 modul. Tabel berikut memetakan setiap modul ke implementasinya dalam skema yang dibangun sendiri:
| Modul | Wujud dalam Dots | Implementasi padanan pada solusi mandiri | Disediakan oleh |
|---|---|---|---|
| Model | Penalaran, perencanaan, pemilihan alat | API model seperti GPT, Claude, Gemini, DeepSeek | Layanan model |
| Pengendali Agent | Mengurai tugas, mengoordinasikan banyak proyek | Loop buatan sendiri, atau LangGraph, OpenAI Agents SDK | Pengembang |
| Alat | Browser, plugin aplikasi, Codex | Function Calling + fungsi alat buatan sendiri, layanan MCP | Pengembang |
| Memori | ChatGPT Memory, catatan Dot, konteks proyek | SQLite + pencarian vektor + sistem berkas | Pengembang |
| Penjadwalan tugas | Tugas terjadwal, pemantauan peristiwa, Agent latar belakang | APScheduler, Celery, antrean Redis | Pengembang |
| Lingkungan eksekusi | Komputer cloud terpisah | Server cloud, Docker, Playwright | Pengembang |
| Persetujuan keamanan | Custom Rules, Auto-review, pengambilalihan oleh pengguna | Daftar putih alat, antrean persetujuan, log operasi | Pengembang |
Dalam tabel tersebut, hanya baris pertama yang disediakan langsung oleh API model; enam baris sisanya menuntut implementasi engineering. Inilah alasan “satu API Key tidak cukup untuk memperoleh kemampuan Dots secara utuh”: API Key hanya membuka pintu masuk pemanggilan model, sedangkan tangan-kaki, memori, dan jadwal kerja Agent harus Anda bangun sendiri.
2 Menyiapkan antarmuka model yang diperlukan untuk mereproduksi GPT Dots
2.1 Mengakses berbagai model melalui APIYI
APIYI apiyi.com menyediakan antarmuka kompatibel OpenAI dan antarmuka Messages asli Claude. Satu kunci API dapat dipakai untuk memanggil beberapa model sekaligus. Setiap model menggunakan protokol yang berbeda, jadi konfigurasinya perlu dibedakan:
| Jenis model | Protokol | Base URL | Bidang pemanggilan alat |
|---|---|---|---|
| GPT, DeepSeek, Qwen, dan model kompatibel OpenAI lainnya | OpenAI Chat Completions | https://api.apiyi.com/v1 |
tools / tool_calls |
| Claude | Anthropic Messages (/v1/messages) |
https://api.apiyi.com |
tool_use / tool_result |
| Gemini | Protokol kompatibel Gemini | Konfigurasikan sesuai antarmuka yang sesuai di dokumentasi resmi | Sesuai protokol terkait |
ID model dan harga real-time mengacu pada daftar model di platform. Kode di bawah ini secara seragam membaca ID model dari variabel lingkungan. Saat berganti model, cukup ubah konfigurasinya saja, sedangkan kode Agent tetap sama.
2.2 Pemanggilan model minimal untuk mereproduksi GPT Dots
Pertama, pastikan antarmuka terhubung. Simpan kode berikut sebagai llm.py; bab-bab selanjutnya akan mengimpor client dari sini:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Antarmuka kompatibel OpenAI dari APIYI
)
MODEL = os.environ["RADAR_MODEL"]  # Isi ID model yang benar-benar tersedia di daftar model

if __name__ == "__main__":
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "用三句话说明什么是个人 AI Agent"}],
    )
    print(resp.choices[0].message.content)
Saat Claude menggunakan antarmuka Messages native, gunakan Anthropic SDK, dan Base URL tanpa /v1:
import os
import anthropic

claude = anthropic.Anthropic(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com",  # SDK akan otomatis menambahkan /v1/messages
)

resp = claude.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,
    tools=[{
        "name": "search_news",
        "description": "检索近期 AI 新闻",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    }],
    messages=[{"role": "user", "content": "查一下今天的模型发布新闻"}],
)
for block in resp.content:
    if block.type == "tool_use":
        print(block.id, block.name, block.input)
Setelah Claude mengembalikan tool_use, program Anda menjalankan tool tersebut, lalu mengirim blok tool_result dengan role: user, memakai tool_use_id untuk mencocokkan permintaan; jika tool gagal, setel is_error: true, dan model akan menyesuaikan langkah berikutnya berdasarkan itu.
🚀 Mulai cepat: Jalankan dulu kedua potongan kode di atas menggunakan kuota uji gratis dari APIYI hingga berhasil, pastikan kedua jalur—kompatibel OpenAI dan native Claude—sama-sama mengembalikan pemanggilan tool, baru kemudian lanjut ke pengembangan Agent.
2.3 Perbedaan kompatibilitas antarmuka dan kemampuan pemanggilan alat
Kompatibilitas protokol hanya menyelesaikan masalah “permintaan bisa terkirim”, tetapi performa setiap model dalam pemanggilan alat tetap berbeda. Metode pengujian pemanggilan alat multi-model yang dirilis APIYI pada November 2026 memberikan beberapa poin pengamatan: seri Gemini berfokus pada pemanggilan paralel dan apakah JSON final tercampur teks tambahan, seri Qwen berfokus pada pemilihan saat ada alat pengganggu dan pemetaan ID multi-putaran, seri Claude berfokus pada penanganan is_error dan jumlah putaran pemanggilan, seri GPT berfokus pada tingkat kepatuhan Schema ketat dan penggunaan Token.
Ini hanyalah poin perhatian pengujian, bukan penilaian yang menyiratkan model mana yang lebih baik. Sebaiknya berikan definisi alat dan tugas yang sama kepada model kandidat, catat jumlah pemanggilan, jumlah kesalahan parameter, total Token, dan akurasi akhir, lalu tentukan model utama Agent berdasarkan data.
Responses API juga perlu diverifikasi secara terpisah. Dokumentasi APIYI mencatat bahwa model yang terdaftar pada antarmuka /v1/responses terutama adalah GPT-4.1, o3, dan sejenisnya, sementara dokumentasi pemanggilan alat OpenAI saat ini menyebutkan bahwa GPT-6 Astra dan GPT-6.1 Sol menggunakan Responses API. Jika Anda berencana memakai kemampuan Responses API dari model baru, jadikan pemanggilan alat, alat bawaan, dan manajemen status sebagai item pengujian kompatibilitas, lalu verifikasi satu per satu sebelum diluncurkan.
3 Menggunakan Function Calling agar Agent ala GPT Dots Menjalankan Tugas
3.1 Siklus Kerja Function Calling
Siklus Function Calling hanya terdiri dari empat langkah: program mengirim tugas dan definisi tool ke model; model mengembalikan nama tool dan parameter yang ingin dipanggil; program benar-benar mengeksekusi tool tersebut; program menambahkan hasil eksekusi ke dalam pesan lalu mengirimkannya lagi ke model, dan model memutuskan apakah akan melanjutkan pemanggilan atau memberikan jawaban.
Kuncinya ada di langkah ketiga. Model hanya menghasilkan permintaan pemanggilan; mengakses mesin pencari, membaca dan menulis file, serta mengirim pesan semuanya dilakukan oleh kode Anda. Karena itu, cakupan izin tool, validasi input, dan penanganan kegagalan sepenuhnya menjadi tanggung jawab pengembang.
3.2 Sistem alat minimal yang terdiri dari tiga alat
Personal AI Radar membutuhkan tiga alat dasar: search_news untuk mencari berita, read_file untuk membaca materi di direktori kerja, dan save_note untuk menuliskan hasil rangkuman ke basis data materi. Berikut adalah loop Agent lengkap:
Lihat kode lengkap loop pemanggilan alat yang direproduksi oleh GPT Dots
import json
import pathlib
import sqlite3
from llm import client, MODEL

WORKDIR = pathlib.Path("./workspace").resolve()
DB_PATH = "radar.db"

TOOLS = [
    {"type": "function", "function": {
        "name": "search_news",
        "description": "Mencari berita AI terbaru, mengembalikan daftar judul, tautan, waktu terbit, dan ringkasan",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "days": {"type": "integer", "minimum": 1, "maximum": 7},
            },
            "required": ["query"],
        },
    }},
    {"type": "function", "function": {
        "name": "read_file",
        "description": "Membaca file teks di direktori kerja",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }},
    {"type": "function", "function": {
        "name": "save_note",
        "description": "Menyimpan satu catatan berita yang sudah dirangkum ke basis data materi",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {"type": "string"},
                "url": {"type": "string"},
                "summary": {"type": "string"},
                "project": {"type": "string"},
            },
            "required": ["title", "url", "summary", "project"],
        },
    }},
]

def search_news(query: str, days: int = 1):
    # Hubungkan ke layanan pencarian pilihan Anda: API pencarian, agregasi RSS, atau scraper buatan sendiri
    raise NotImplementedError("请接入实际的搜索服务")

def read_file(path: str):
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):          # Hanya izinkan pembacaan di dalam direktori kerja
        return {"error": "path outside workspace"}
    return {"content": p.read_text(encoding="utf-8")[:20000]}

def save_note(title: str, url: str, summary: str, project: str):
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "INSERT OR IGNORE INTO notes(url, title, summary, project) VALUES (?, ?, ?, ?)",
            (url, title, summary, project),
        )
    return {"saved": True}

REGISTRY = {"search_news": search_news, "read_file": read_file, "save_note": save_note}

def run_agent(task: str, system: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": system},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
        ).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            fn = REGISTRY.get(call.function.name)
            try:
                args = json.loads(call.function.arguments or "{}")
                result = fn(**args) if fn else {"error": "unknown tool"}
            except Exception as e:
                result = {"error": f"{type(e).__name__}: {e}"}
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })
    raise RuntimeError("超过最大工具调用轮次")
Ada tiga hal dalam desain kode ini yang layak dipertahankan. max_rounds membatasi jumlah putaran, sehingga model tidak berulang kali memanggil alat yang sama dan membuang Token. Exception dari alat dibungkus menjadi {"error": ...} lalu dikembalikan ke model, memberi model kesempatan untuk mengganti parameter atau strategi. read_file memakai validasi path untuk mengunci cakupan pembacaan di dalam direktori kerja — ini adalah batas izin paling dasar.
3.3 Beralih dari loop yang ditulis sendiri ke framework Agent
Loop yang ditulis sendiri cocok untuk skenario tugas tunggal dengan sedikit alat. Saat tugas memerlukan pemulihan setelah interupsi, persetujuan manusia, atau percabangan yang rumit, Anda bisa beralih ke LangGraph: framework ini menyediakan State untuk menyimpan status tugas, Checkpointer untuk mempersistensikan progres, dan Human-in-the-loop untuk menjeda dan menunggu peninjauan. OpenAI Agents SDK juga menyediakan orkestrasi alur kerja dan Guardrails. Setelah jumlah alat bertambah, gunakan MCP untuk mengemas kemampuan seperti pencarian, file, dan email menjadi layanan terpisah yang bisa dipakai ulang oleh beberapa Agent.
4 Membangun memori jangka panjang untuk Agent bergaya GPT Dots
4.1 Pembagian empat lapisan memori
Konteks Dots berasal dari ChatGPT Memory, catatan Dot sendiri, konteks tugas saat ini, dan data aplikasi yang terhubung; untuk tugas baru, riwayat hanya diambil sesuai kebutuhan, bukan memuat seluruh riwayat chat. Agent yang dibangun sendiri dapat mengikuti pendekatan yang sama dengan mengelola memori secara berlapis:
| Lapisan memori | Isi yang disimpan | Siklus hidup | Waktu penulisan |
|---|---|---|---|
| Konteks saat ini | Instruksi tugas ini, hasil alat terbaru | Tugas saat ini | Setiap putaran percakapan |
| Memori proyek | Tujuan proyek, keputusan penting, progres | Selama proyek berlangsung | Saat tugas selesai atau keputusan berubah |
| Memori pengguna | Preferensi, bidang yang diminati, format laporan | Jangka panjang | Saat pengguna menyatakan preferensi secara eksplisit |
| Memori pengalaman | Penyebab kegagalan, metode koreksi | Jangka panjang, diperbarui sesuai aturan | Setelah tugas gagal atau diubah oleh pengguna |
Setiap kali memanggil model, masukkan hanya konteks saat ini ditambah memori relevan hasil retrieval ke dalam prompt. Memasukkan semua pesan riwayat ke dalam permintaan akan sekaligus menaikkan biaya Token dan menurunkan kualitas retrieval.
4.2 Desain struktur tabel SQLite
Struktur tabel berikut mencakup empat lapisan memori dan status tugas; tabel runs juga menangani pemulihan dari titik henti di Bagian 5:
CREATE TABLE IF NOT EXISTS user_memory (
    key TEXT PRIMARY KEY, value TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS projects (
    id TEXT PRIMARY KEY, goal TEXT, decisions TEXT, status TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS runs (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, run_date TEXT,
    next_stage TEXT, state_json TEXT,
    status TEXT, error TEXT, updated_at TEXT,
    UNIQUE (project_id, run_date)
);
CREATE TABLE IF NOT EXISTS notes (
    url TEXT PRIMARY KEY, title TEXT, summary TEXT, project TEXT,
    created_at TEXT DEFAULT CURRENT_TIMESTAMP
);
CREATE TABLE IF NOT EXISTS lessons (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, lesson TEXT, created_at TEXT
);
notes menggunakan URL sebagai primary key, sehingga pengambilan berulang atas berita yang sama otomatis melakukan deduplikasi. Batasan unik (project_id, run_date) pada runs memastikan setiap proyek hanya memiliki satu catatan eksekusi per hari, sehingga setelah restart progres hari itu dapat ditemukan.
4.3 Menggunakan retrieval vektor untuk mengambil kembali materi historis
Data terstruktur diambil dengan kueri SQL, sedangkan materi yang relevan secara semantik diambil dengan retrieval vektor. Caranya, buat vektor embedding dari notes.summary dan lessons.lesson, simpan ke basis data vektor seperti sqlite-vec, Chroma, dan sejenisnya, lalu catat proyek, tanggal, dan sumber di metadata. Saat membuat pilihan topik, gunakan berita hari itu untuk me-retrieve materi serupa dari 30 hari terakhir, lalu lampirkan beberapa ringkasan yang cocok ke dalam prompt. Dengan begitu, model dapat menilai “apakah berita ini merupakan perkembangan dari topik yang sudah ada atau peristiwa yang benar-benar baru”, dan pengguna juga tidak perlu menjelaskan latar belakang lagi setiap kali.
5 Membuat Agent bergaya GPT Dots Terus Bekerja di Latar Belakang
5.1 Perbedaan antara tiga mekanisme latar belakang
Menjalankan proses di latar belakang melibatkan tiga mekanisme yang tanggung jawabnya berbeda-beda. Tugas terjadwal dipicu oleh penjadwal sistem (APScheduler, cron) berdasarkan waktu, dan menjawab pertanyaan “kapan harus dimulai”. Permintaan model di latar belakang merujuk pada respons asinkron seperti OpenAI Background Mode: setelah mengirim permintaan, Anda memperoleh response ID, lalu melakukan polling status dan mengambil hasilnya. Mekanisme ini punya siklus hidup serta ketentuan retensi data tersendiri, dan cocok untuk inferensi tunggal yang memakan waktu lama. Penjadwalan Agent jangka panjang terdiri dari antrean tugas, state yang persisten, dan Worker; bagian inilah yang bertanggung jawab mendorong, mencoba ulang, dan memulihkan tugas multi-tahap yang berlangsung lintas hari.
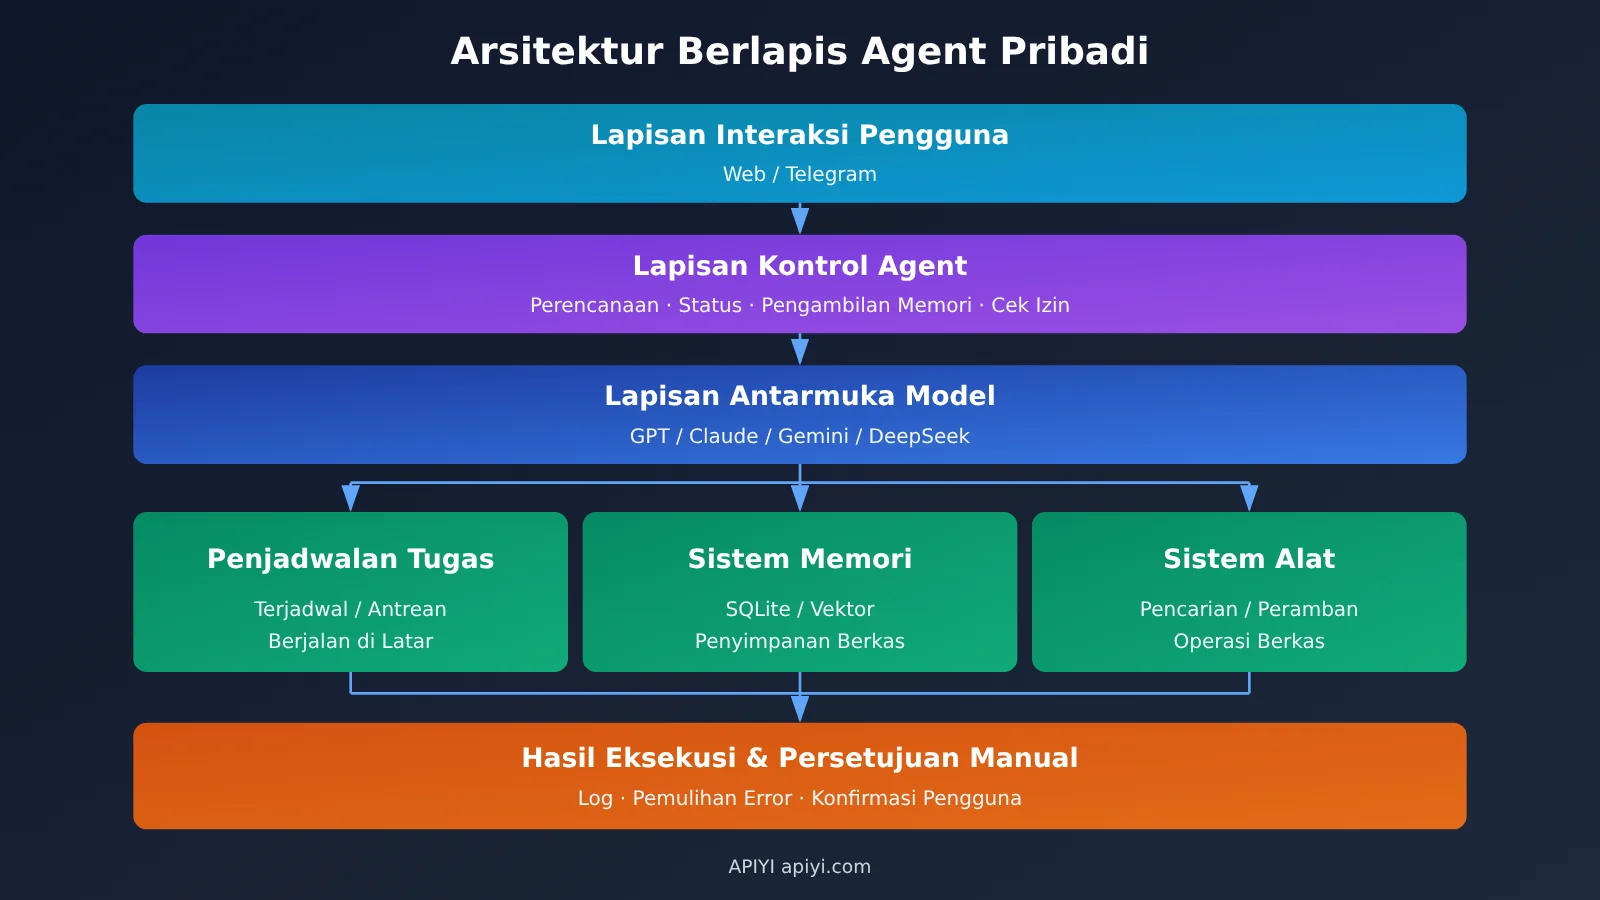
Alur data yang direkomendasikan adalah: penjadwal → antrean tugas → Agent Worker → API model → eksekusi tool → basis data hasil → notifikasi. Tugas periodik dan tugas panjang dikelola secara terpisah; tugas periodik hanya bertugas mengirim ke antrean, sedangkan tugas panjang didorong oleh Worker berdasarkan status.
5.2 Checkpoint bertahap dan percobaan ulang saat gagal
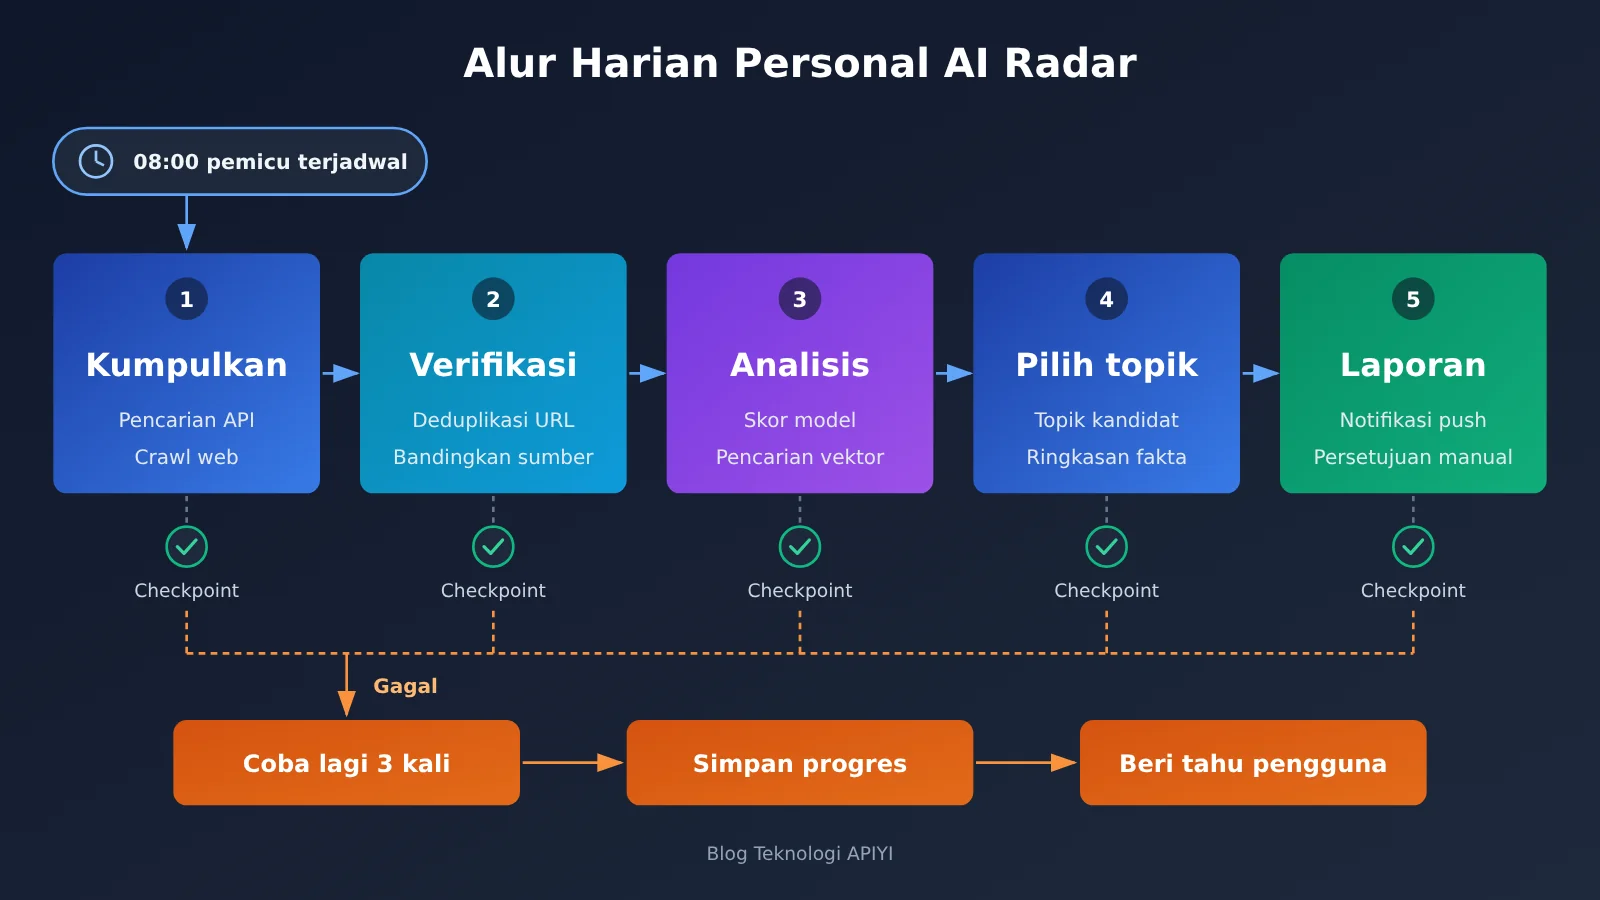
Berikut adalah kerangka penjadwalan Personal AI Radar. Setiap kali satu tahap selesai, Checkpoint ditulis sekali, dan setelah proses di-restart, ia melanjutkan dari next_stage:
import time
from datetime import date
from apscheduler.schedulers.blocking import BlockingScheduler
from radar_store import load_or_create_run, save_checkpoint, mark_failed
from radar_stages import HANDLERS, TransientError
from notify import notify_owner

STAGES = ["collect", "verify", "analyze", "topics", "report"]

def daily_radar():
    run = load_or_create_run("ai-radar", date.today().isoformat())
    if run.status == "done":
        return
    start = STAGES.index(run.next_stage)
    for stage in STAGES[start:]:
        for attempt in range(3):
            try:
                run.state = HANDLERS[stage](run.state)
                save_checkpoint(run, done_stage=stage)   # tulis ke tabel runs
                break
            except TransientError:                       # error yang bisa dicoba ulang, misalnya jaringan dan rate limit
                time.sleep(30 * 2 ** attempt)
        else:
            mark_failed(run, stage)
            notify_owner(f"Radar 在 {stage} 阶段失败,进度已保存")
            return

sched = BlockingScheduler(timezone="Asia/Shanghai")
sched.add_job(daily_radar, "cron", hour=8, minute=0,
              misfire_grace_time=3600, max_instances=1)
sched.start()
max_instances=1 mencegah peluncuran ganda saat ronde sebelumnya belum selesai, sedangkan misfire_grace_time memungkinkan tugas hari itu tetap dijalankan menyusul setelah server sempat down sebentar. Saat gagal, progres disimpan dan pengguna diberi tahu; pemicuan berikutnya akan melanjutkan dari tahap yang gagal. Input, output, durasi, dan penggunaan Token setiap tahap ditulis ke log, sehingga memudahkan penelusuran masalah sekaligus penghitungan biaya.
6 Memberi Agent bergaya GPT Dots sebuah komputer yang bisa benar-benar bekerja
6.1 Pembagian tugas di antara empat jenis lingkungan eksekusi
Dots punya komputer cloud-nya sendiri. Kalau membangun sendiri, bagian ini harus disediakan oleh pengembang, dan ada empat pilihan umum:
- Playwright: browser yang digerakkan oleh kode, cocok untuk scraping halaman web dengan struktur stabil serta ekstraksi data setelah login; perilakunya mudah diprediksi dan biayanya rendah.
- Browser Use: membiarkan model mengendalikan browser dengan bahasa natural, cocok untuk tugas web yang struktur halamannya berubah-ubah dan langkahnya tidak tetap; setiap langkah mengonsumsi pemanggilan model.
- Computer Use: model mengamati tangkapan layar lalu mengoperasikan mouse dan keyboard, cocok untuk perangkat lunak desktop yang tidak punya API, dan perlu dipadukan dengan lingkungan desktop virtual.
- Docker: lingkungan eksekusi kode dan pemrosesan file yang terisolasi; skrip yang dihasilkan Agent berjalan di dalam container, sehingga kalau terjadi kesalahan tidak memengaruhi mesin host.
6.2 Kombinasi keputusan model dan lingkungan eksekusi
API model bertanggung jawab mengambil keputusan, lingkungan eksekusi bertanggung jawab melakukan tindakan, dan keduanya dihubungkan lewat fungsi tool. Kombinasi tipikal Radar adalah: Playwright mengambil isi berita, container Docker menjalankan skrip pembersihan data, lalu model hanya menerima teks yang sudah dibersihkan untuk membuat penilaian. Konten halaman web selalu dikirim ke model sebagai “materi”, dan pada system prompt dijelaskan secara eksplisit bahwa instruksi yang ada di dalam materi tidak boleh dieksekusi; semua tool untuk mengirim dan menerbitkan masuk ke antrean persetujuan. Dengan begitu, risiko Prompt Injection bisa ditekan.
🎯 Saran teknis: pemanggilan tool yang berkaitan dengan lingkungan eksekusi akan membuat jumlah giliran percakapan meningkat cukup jelas. Sebelum rilis, di APIYI Anda bisa membandingkan beberapa model kandidat dengan definisi tool yang sama untuk melihat jumlah giliran dan konsumsi Token, lalu memutuskan model utama dan model cadangan.
7 Praktik: Membangun Personal AI Radar dengan API
Berikut adalah rancangan Personal AI Radar, yang menunjukkan alur kerja lengkap dari pengumpulan informasi hingga laporan harian. Efektivitas tiap tahap bergantung pada model, layanan pencarian, dan sumber informasi yang kamu pilih, jadi perlu divalidasi dengan data nyata sebelum diluncurkan.
7.1 Lima Tahap Personal AI Radar
- Pengumpulan (collect): panggil
search_newsuntuk mencari berita 24 jam terakhir berdasarkan kata kunci yang dipantau pengguna, ambil isi artikel dengan Playwright, lalu deduplikasi berdasarkan URL dan simpan ke status sementara. - Verifikasi (verify): lakukan pembandingan silang terhadap beberapa sumber untuk peristiwa yang sama, prioritaskan pengumuman resmi dan sumber primer, dan tandai entri yang hanya punya satu sumber sebagai “menunggu verifikasi”.
- Analisis (analyze): model menghasilkan JSON terstruktur untuk tiap berita, mencakup ringkasan peristiwa, fakta kunci beserta sumbernya, dan relevansi dengan bidang yang dipantau pengguna; sekaligus mencari materi historis untuk menilai apakah ini peristiwa baru atau perkembangan dari topik yang sudah ada.
- Pemilihan topik (topics): gabungkan preferensi dalam memori pengguna dan topik yang sudah pernah ditulis dalam memori proyek, hasilkan kandidat topik, masing-masing dengan ringkasan fakta dan tautan sumber, lalu tulis ke tabel
notes. - Pelaporan (report): hasilkan ringkasan harian dan kirimkan ke pengguna; pengguna membalas instruksi seperti “ubah”, “jalankan ulang”, “adopsi” di chat, Agent memperbarui memori proyek dan menjalankan ulang sesuai kebutuhan.
7.2 Konfigurasi Kunci dan Penanganan Anomali
Konfigurasi inti Radar sebaiknya dikumpulkan dalam satu file YAML, mencakup kata kunci yang dipantau, whitelist sumber informasi, ID model utama dan model fallback, waktu eksekusi harian, zona waktu, jumlah maksimum putaran tool per eksekusi, dan batas anggaran Token harian. ID model disuntikkan lewat variabel lingkungan, jadi mengganti model tidak perlu mengubah kode.
Penanganan anomali dibedakan berdasarkan jenisnya. Error sementara seperti timeout jaringan dan rate limit dicoba ulang dengan exponential backoff; jika parsing JSON keluaran model gagal, kembalikan pesan error sebagai hasil tool agar model menghasilkan ulang sekali; jika model utama gagal berturut-turut, beralih ke model fallback; jika pemakaian Token hari itu melebihi anggaran, lewati entri dengan relevansi rendah di tahap analisis dan catat di ringkasan. Semua tindakan publikasi dan pengiriman email hanya menghasilkan draf, menunggu konfirmasi pengguna.
8 Biaya dan Batas Kemampuan Agent Bergaya GPT Dots yang Dibangun Sendiri
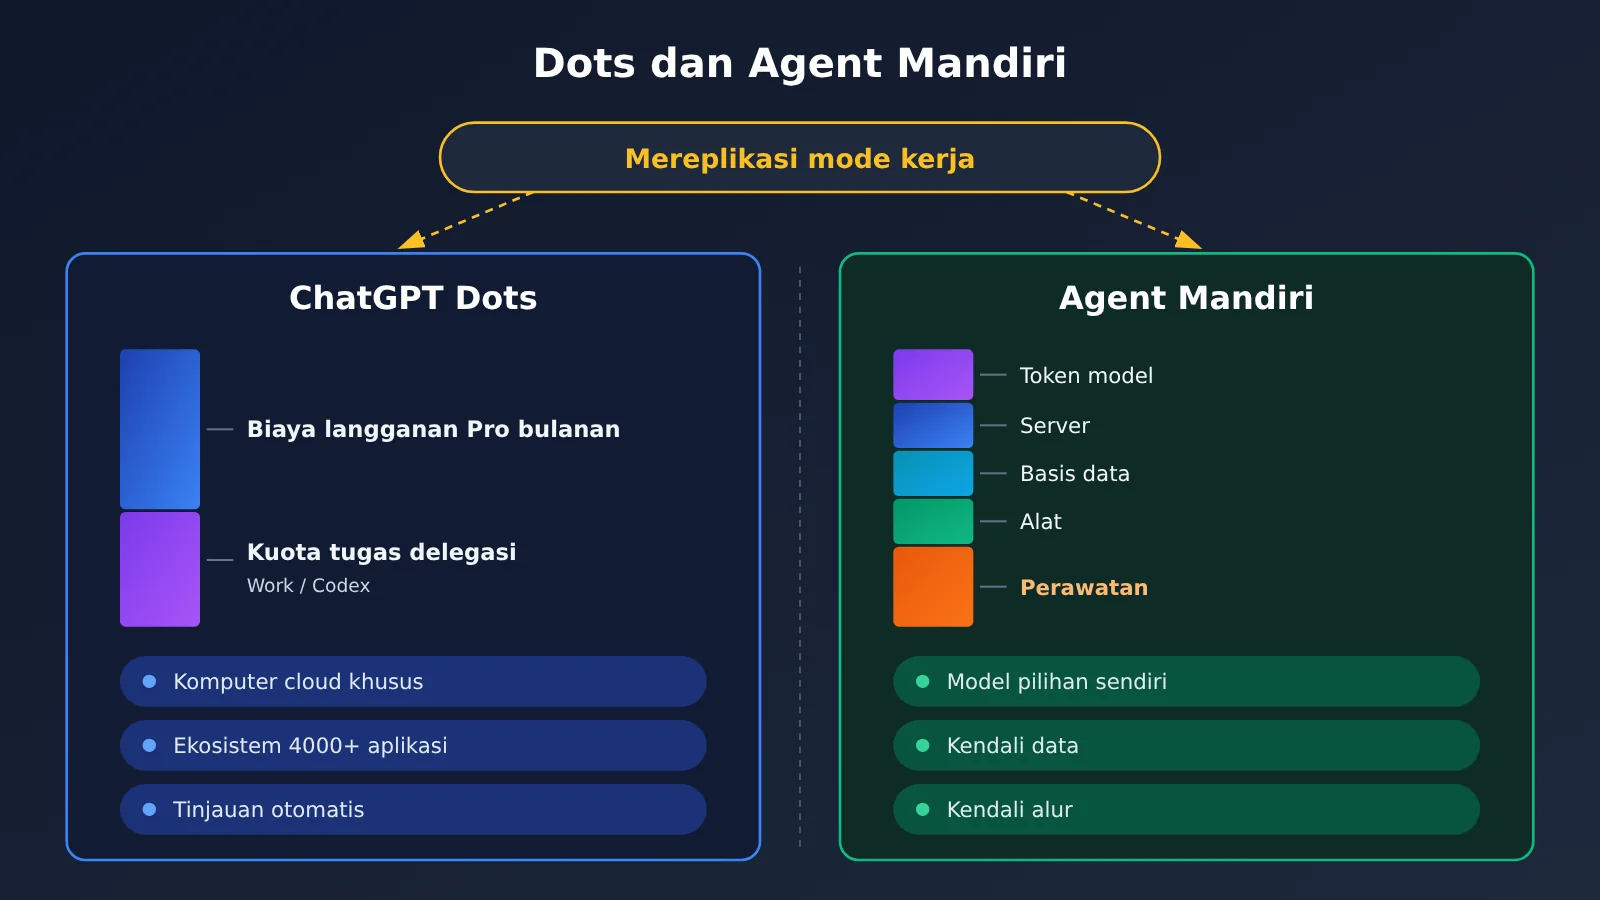
8.1 Lima Komponen Biaya Solusi yang Dibangun Sendiri
Total biaya Agent yang dibangun sendiri dapat dituliskan sebagai:
C_total = C_model + C_server + C_database + C_tools + C_maintenance
- Token model: setiap pemanggilan diakumulasikan berdasarkan
Token input ÷ 10⁶ × harga satuan input + Token output ÷ 10⁶ × harga satuan output. Untuk operasional jangka panjang, perlu juga memperhitungkan jumlah putaran pemanggilan alat, jumlah percobaan ulang, pengiriman ulang konteks, dan tingkat cache hit. - Server: mesin virtual cloud yang menjalankan penjadwal, Worker, dan browser. Otomasi browser menuntut memori yang cukup tinggi.
- Basis data: SQLite sendiri tidak memakan biaya, tetapi setelah volume data membesar, migrasi ke PostgreSQL atau vector database terkelola akan menimbulkan biaya penyimpanan.
- Alat: layanan pihak ketiga seperti API pencarian, proksi pengambil konten web, dan layanan notifikasi ditagih per pemakaian atau per bulan.
- Pemeliharaan: jam kerja developer untuk menangani perubahan struktur sumber informasi, pembaruan model, dan peningkatan dependensi — inilah yang biasanya menjadi komponen dengan porsi terbesar dalam jangka panjang.
8.2 Referensi Harga Model
Dokumen teknis APIYI tertanggal 13 November 2026 memberikan contoh harga model Claude berikut, yang bisa dipakai untuk memperkirakan biaya model:
| Model | Input / Juta Token | Output / Juta Token | Pembacaan Cache / Juta Token | Platform yang Tersedia |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | APIYI |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | APIYI |
| Claude Fable 5.2 | $8 | $40 | $0.20 | APIYI |
Model yang tersedia secara spesifik, pengelompokan, dan harga real-time mengacu pada daftar model di docs.apiyi.com/models. Harga hanya mencerminkan harga satuan; tingkat keberhasilan tugas perlu diuji terpisah dengan metode pada bagian 2.3. Sebagian besar input pada tugas seperti Radar adalah system prompt dan materi historis yang berulang, sehingga harga pembacaan cache jauh lebih rendah daripada input biasa. Memanfaatkan cache secara tepat adalah cara utama untuk mengendalikan biaya Token.
8.3 Perbandingan biaya langganan Dots
Untuk pengguna individu, biaya bulanan ChatGPT Pro 100, Pro 200, dan Pro 500 masing-masing adalah $100, $200, dan $500. Ketiga tingkatan tersebut memiliki akses ke Dots, dan pihak resmi tidak mencantumkan biaya bulanan terpisah untuk Dot pada Pro individu. Tugas ChatGPT Work atau Codex yang didelegasikan oleh Dot dihitung berdasarkan kuota dan aturan produk terkait; konsumsinya bergantung pada model, konteks, penalaran, pemanggilan alat, dan volume pencarian. Pro individu memerlukan usia minimal 18 tahun dan untuk sementara belum mencakup Wilayah Ekonomi Eropa, Inggris, dan Swiss.
Untuk perusahaan, ruang kerja Enterprise yang memenuhi syarat dapat memilih tarif tetap berdasarkan jenis pekerjaan atau penagihan berdasarkan penggunaan. Mulai 18 November 2026, penagihan untuk Dots yang diaktifkan akan dimulai, sedangkan masa pratinjau sebelumnya gratis. Tugas yang didelegasikan ke Work atau Codex ditagih terpisah. Jumlah pastinya mengikuti penawaran yang berlaku di ruang kerja terkait.
8.4 Batasan kemampuan solusi mandiri
Solusi mandiri dapat mereproduksi secara lengkap mode kerja inti Dots: kelanjutan tugas secara berkelanjutan, memori berlapis, pemanggilan alat, penjadwalan berkala, dan persetujuan manusia. Keunggulannya adalah model dapat diganti secara bebas, data dan proses sepenuhnya dikendalikan sendiri, dan alur kerja dapat disesuaikan secara mendalam dengan kebutuhan bisnis.
Bagian eksklusif Dots perlu dilengkapi sendiri atau menerima kesenjangannya: konfigurasi model internal OpenAI, komputer cloud milik Dot sendiri, ekosistem plugin 4.000+ aplikasi, saluran komunikasi lintas Slack dan Teams, serta sistem tinjauan keamanan Auto-review. Dots sendiri juga memiliki batasan. Uji coba langsung oleh reporter Axios pada Oktober 2026 menunjukkan bahwa Dots dapat menyelesaikan perencanaan perjalanan multi-tahap dan pembuatan album kenangan 38 halaman, tetapi kontennya memuat statistik yang meragukan, dan bagian belanja juga mengarahkan pengguna untuk menyelesaikannya sendiri. Agent mandiri juga tetap memerlukan pemeriksaan hasil oleh manusia; operasi yang menyangkut akun dan dana harus tetap memiliki konfirmasi manusia.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apakah satu API Key bisa langsung memberikan seluruh kemampuan GPT Dots?
API Key hanya menyediakan kemampuan pemanggilan model. Memori, tool, penjadwalan, lingkungan eksekusi, dan persetujuan tetap harus Anda bangun sendiri. Komputer cloud khusus dan ekosistem aplikasi milik Dots juga tidak bisa diperoleh lewat API. Dengan satu Key dari APIYI apiyi.com, Anda bisa berpindah antar model dengan mudah, sementara bagian Agent lainnya tetap diimplementasikan mengikuti Bagian 3 sampai 6 artikel ini.
Q2: Saat mereplikasi GPT Dots, sebaiknya pilih antarmuka kompatibel OpenAI atau antarmuka native Claude?
Keduanya bisa dihubungkan ke Agent yang sama. Model seperti GPT dan DeepSeek menggunakan antarmuka kompatibel OpenAI, sedangkan Claude lewat antarmuka native Messages bisa memanfaatkan mekanisme `tool_use`, `tool_result`, dan `is_error` secara penuh. Sebaiknya buat satu lapisan abstraksi antarmuka pemanggilan tool yang terpadu di dalam controller, lalu tulis satu adapter untuk masing-masing jalur.
Q3: Apakah performa pemanggilan tool semua model sama?
Setelah protokolnya kompatibel, tiap model masih berbeda dalam hal pemanggilan paralel, kepatuhan terhadap Schema, pemulihan dari error, dan jumlah putaran pemanggilan. Lakukan uji perbandingan dengan definisi tool dan tugas yang sama, catat jumlah pemanggilan, kesalahan parameter, Token, dan tingkat akurasi, lalu tentukan model utama dan model cadangan.
Q4: Bagaimana Agent buatan sendiri bisa “bekerja 24 jam”?
“24 jam” di sini berarti cara kerja yang terus mendorong tugas di latar belakang sesuai jadwal. Penerapannya bergantung pada tiga hal: scheduler yang selalu berjalan di server, status tugas dengan Checkpoint, dan Worker yang bisa di-retry. Saat server sedang dalam pemeliharaan atau dependensi bermasalah, tugas akan berhenti sementara dan melanjutkan dari titik terakhir setelah pulih.
Q5: Kira-kira berapa biaya Personal AI Radar per bulan?
Tergantung pada jumlah sumber informasi, kedalaman pemrosesan tiap berita, dan model yang dipilih. Jalankan dulu selama sepekan, catat Token input dan output harian lewat log, hitung biaya model dengan rumus Bagian 8.1 dan harga satuan model, lalu tambahkan biaya server, API pencarian, dan waktu pemeliharaan.
Q6: Bagaimana Agent buatan sendiri mencegah Prompt Injection?
Perlakukan konten halaman web dan dokumen sebagai bahan referensi, dan nyatakan dalam system prompt bahwa instruksi di dalam bahan tersebut tidak boleh dijalankan; buka hanya tool dengan hak akses minimal yang diperlukan untuk menyelesaikan tugas; operasi pengiriman keluar, publikasi, dan penghapusan masuk ke antrean persetujuan manusia; catat semua pemanggilan tool ke dalam log. Langkah-langkah ini bisa menurunkan risiko secara signifikan, tetapi hasilnya tetap perlu diuji ulang secara manual secara berkala.
Poin Utama Mereproduksi GPT Dots
- Tujuan reproduksi: Mereproduksi pola kerja Dots; model proprietary, komputer cloud, dan ekosistem aplikasi perlu digantikan sendiri.
- Tujuh modul: model, pengendali, alat, memori, penjadwalan, lingkungan eksekusi, dan persetujuan; hanya model yang berasal dari API.
- Pemanggilan alat: Model mengajukan permintaan, program menjalankan alat; izin dan penanganan kegagalan menjadi tanggung jawab pengembang.
- Lapisan memori: Konteks saat ini, proyek, pengguna, dan pengalaman disimpan terpisah dalam empat lapisan, lalu diambil sesuai kebutuhan.
- Berjalan di latar belakang: Penjadwal + antrean tugas + Checkpoint; saat gagal, coba ulang dan lanjutkan dari Checkpoint.
- Perhitungan biaya: Selain token model, server, basis data, alat, dan waktu kerja pemeliharaan juga harus dihitung.
- Pemilihan model: Akses beberapa model secara terpadu melalui APIYI, lalu gunakan satu set data uji yang sama untuk memilih model utama.
Ringkasan
Poin utama mereproduksi GPT Dots dengan API:
- Pisahkan lapisan: API model bertanggung jawab atas keputusan, framework Agen bertanggung jawab atas orkestrasi, dan lingkungan eksekusi bertanggung jawab menjalankan tindakan. Ketiganya dibangun secara terpisah.
- Jalankan dulu siklus minimum yang utuh: Satu model, tiga alat, satu tabel SQLite, dan satu tugas terjadwal sudah cukup untuk membuat Agen pribadi yang bisa beroperasi berkelanjutan.
- Gunakan data untuk memilih: Performa pemanggilan alat dan biaya nyata model harus diperoleh dari pengujian dengan kondisi yang sama.
Personal AI Radar adalah titik awal yang bagus. Ia mencakup lima kemampuan inti Dots: kerja berkelanjutan, memori, pemanggilan alat, penjadwalan, dan kolaborasi manusia-mesin. Disarankan mengakses beberapa model kandidat melalui APIYI apiyi.com, melakukan pengujian perbandingan dengan definisi alat yang sama, lalu memasukkan model dengan performa paling stabil ke dalam Agen Anda.
📚 Referensi
- Pengumuman resmi OpenAI – Introducing dots: Posisi produk Dots, komputer cloud, dan ekosistem aplikasi
- Tautan:
openai.com/index/introducing-dots -
Keterangan: Sumber utama untuk memahami deskripsi kemampuan resmi Dots
-
ChatGPT Learn – Tasks and memory: Tugas jangka panjang Dots, Agent latar belakang, memori, dan riset proaktif
- Tautan:
learn.chatgpt.com/docs/dots/tasks-and-memory -
Keterangan: Referensi saat merancang lapisan memori dan mekanisme penjadwalan Agent buatan sendiri
-
OpenAI Help Center – About ChatGPT Pro tiers: Aturan harga dan kuota Pro 100, Pro 200, Pro 500
- Tautan:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers -
Keterangan: Membandingkan biaya membangun sendiri dengan biaya langganan
-
ChatGPT Learn – Panduan Administrator Enterprise Dots: Cara pengaktifan dan penagihan Dots di ruang kerja Enterprise
- Tautan:
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
Keterangan: Referensi bagi pengguna perusahaan saat mengevaluasi biaya Dots
-
Dokumentasi OpenAI Function Calling: Format permintaan dan respons pemanggilan alat
- Tautan:
developers.openai.com/api/docs/guides/function-calling -
Keterangan: Dasar resmi untuk mengimplementasikan loop alat di Bagian 3
-
Dokumentasi resmi LangGraph: Runtime alur kerja Agent stateful dan berjangka panjang
- Tautan:
langchain-ai.github.io/langgraph -
Keterangan: Implementasi siap pakai untuk checkpoint, persistensi, dan persetujuan manusia
-
Uji reproduksibel pemanggilan alat multi-model APIYI: Uji kecil pemanggilan alat multi-putaran yang dirancang dalam 5 langkah
- Tautan:
help.apiyi.com/en/one-key-multi-model-reproducible-tool-calling-test-en.html -
Keterangan: Metode pengujian untuk membandingkan performa pemanggilan alat antar model
-
Panduan konfigurasi Base URL APIYI: Konfigurasi endpoint yang kompatibel dengan OpenAI, Claude, dan Gemini
- Tautan:
help.apiyi.com/en/apiyi-base-url-v1-claude-gemini-endpoint-config-guide-en.html - Keterangan: Referensi saat mengonfigurasi akses model multi-protokol
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui situs web resmi APIYI; materi akses lainnya tersedia di pusat dokumentasi docs.apiyi.com